我们如何把 LLM 评估吞吐量提升 20 倍
瓶颈出在 p90 有 82% 的时间在等容器,算力和限流都不是原因。Mercor 用一个每 10 秒跑一次的 Compute Scheduler,把静态 FIFO 队列换成按优先级、项目公平、先入先出三级规则分配全局工作池,吞吐量涨了 20 倍。
中文
复制
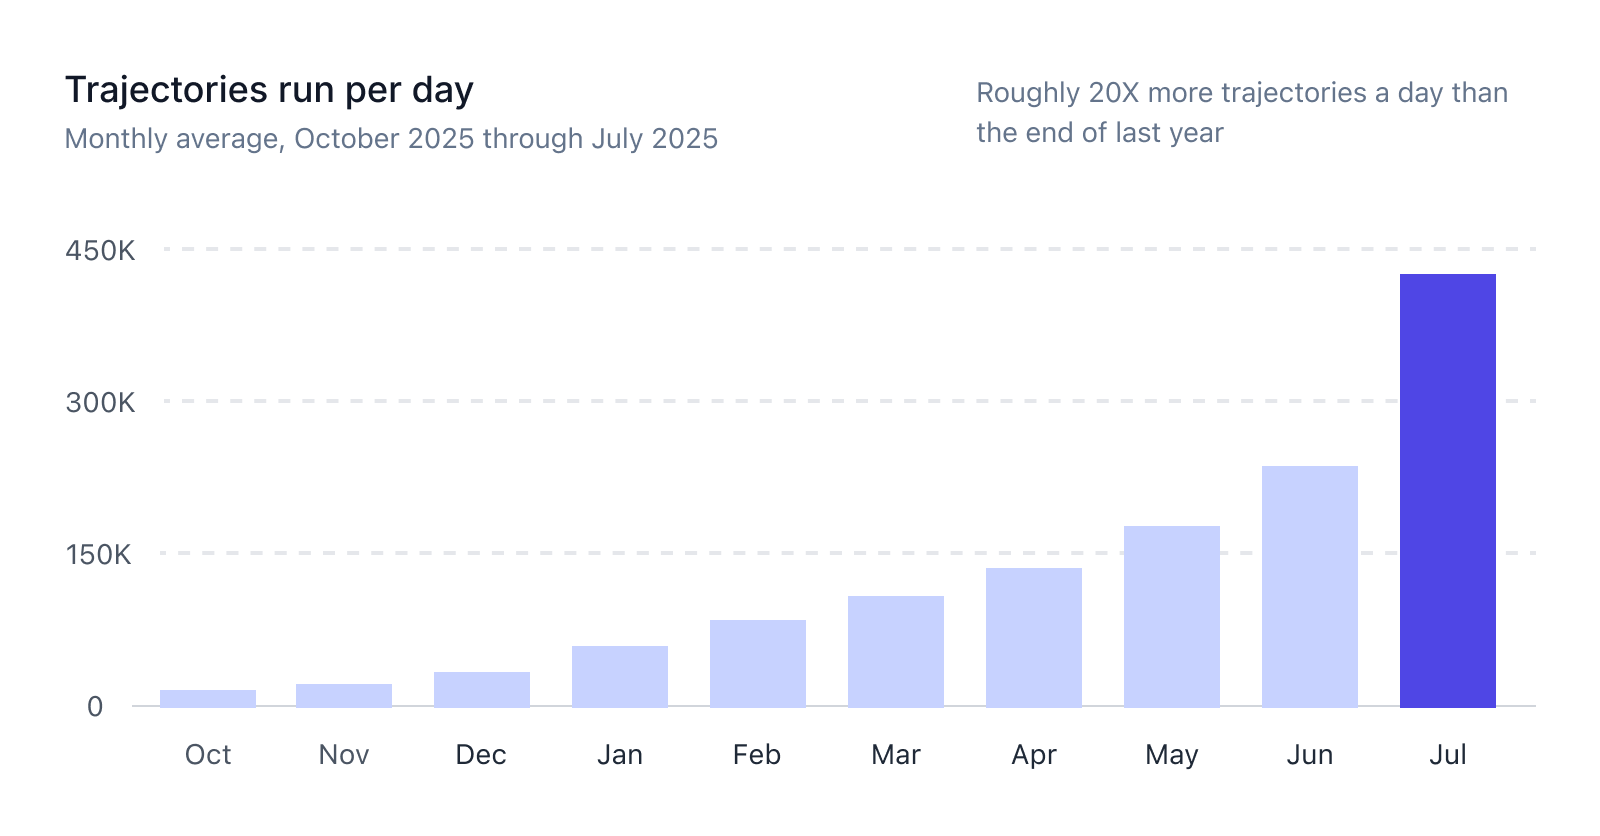
此刻,在 Mercor 基础设施的深处,一个模型正拿到它从未见过的 prompt,被要求完成一项工作。你读完这篇文章的工夫,大约又会跑完三千个。我们每周运行超过 250 万个这样的工作负载,每秒四个,覆盖 241 个不同的模型。每个工作负载都是一次评测运行,记录下逐步推理、工具调用以及其他有用信息,帮助我们评估所创建任务的整体难度——这些任务会作为强化学习的训练数据。任务在 Studio 上创建,那是 Mercor 专家撰写标注内容的平台,模型将针对这些内容接受测试和训练。
如果你觉得这些挑战有意思,欢迎来 加入我们!
规模问题
我们批量运行大量模型评测,为任务生成轨迹,然后打分。一个批次会展开成数千次评测;每次评测都在自己的容器里让模型跑一个任务。模型拿到一个沙箱环境、任务所需的工具,然后循环执行直到完成。自去年年底以来,我们的轨迹量出现了爆发式增长。
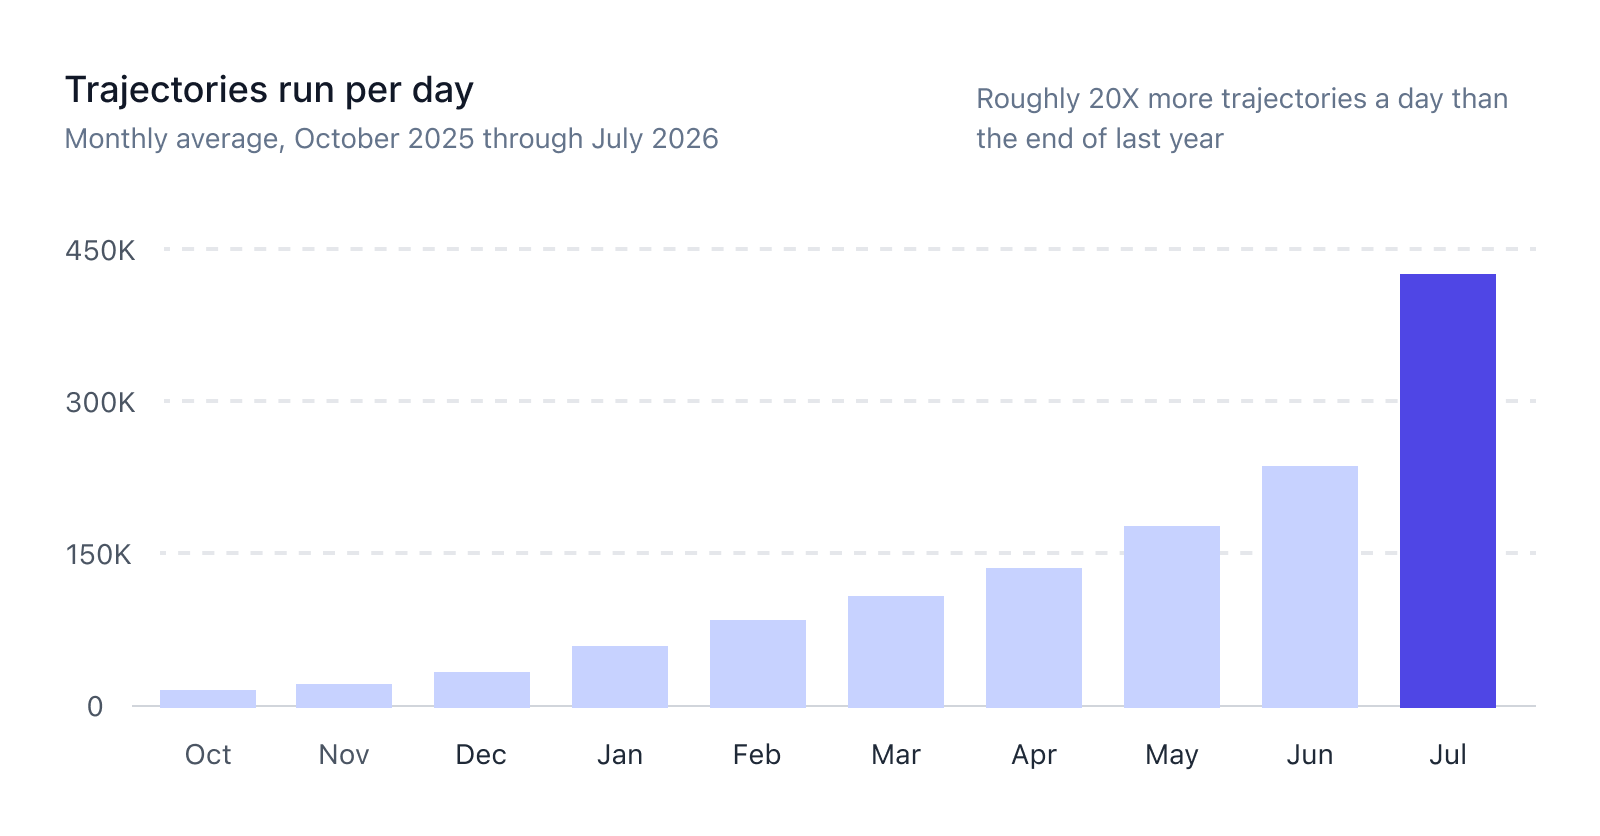
这种增长并没有以某一类具体错误的形式把什么东西弄坏。我们看到的是评测端到端运行时长的系统性上升。深挖时间到底花在哪里之后,答案和我们预想的不一样。
算力等待瓶颈
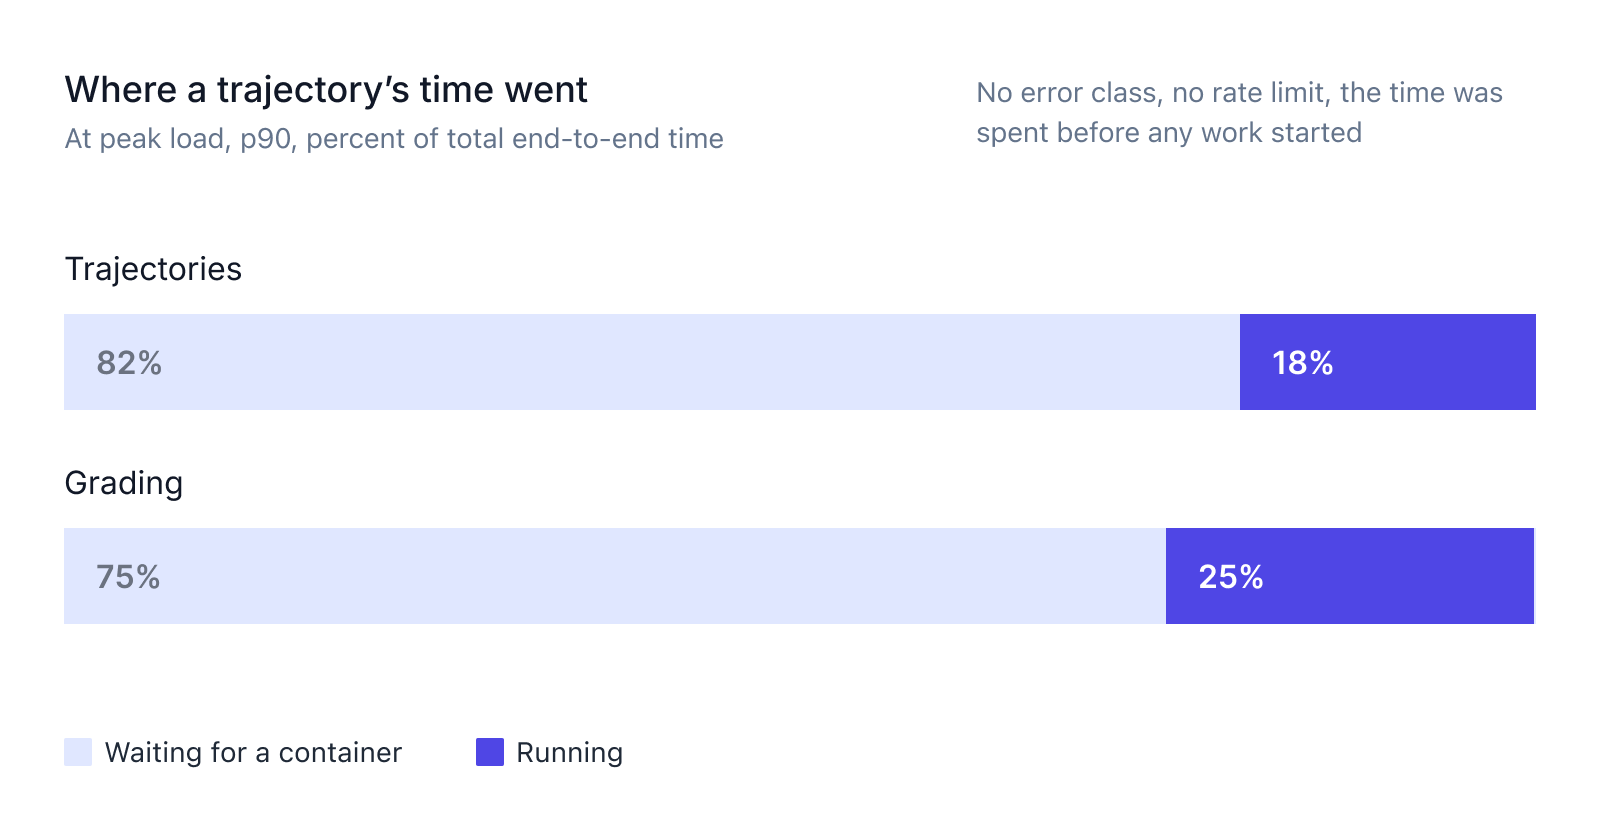
我们的 p90 轨迹有 82% 的时间在等待算力容器,18% 在运行;打分阶段则是 75% 等待、25% 运行。我们最初很自然地以为,是撞上了模型提供方的速率限制。但深入查看底层指标和日志后,我们发现了两处瓶颈——要让 Mercor 支撑下一阶段的规模,架构必须围绕它们演进。
全局容量分区
随着评估量的增长和模型数量的增加,我们开始看到某些模型出现热点,占据了系统上的大部分流量。大批次会阻塞其他工作负载,而这些工作负载要么是更小、更频繁的突发任务,要么跑在流量较低的模型上。我们逐步把这些高用量模型划分到独立的排队通道中,从全局上限中专门划出容量给它们。随着整体用量增长,我们不得不创建更多专用通道,而每一条通道都会压低任何单条通道的整体上限。我们需要改进架构:当流量集中时,把最大算力全部用于某一个模型;而在需要时,又能在多个模型之间公平分配。
供应商容量利用不足
随着我们最热门模型上的活动量增加,我们开始触及供应商能提供的容量上限。这时我们必须规划:当某个模型突然收到来自超大或大量批次的评估峰值时,并发可以涨到多高。过去这类情况靠硬性固定值来管理,但当我们真正要把上限用到极致时,这种做法容易出现吵闹邻居问题,或者略微超配、欠配。我们需要让扩缩容和退避机制更精细,在充分利用现有容量的同时,还能根据实测信号动态调整。为了解决这两个问题,并让架构支撑 Mercor 下一阶段的规模,我们设计了一个动态计算调度器,用来在不同使用模式和动态可用容量之间对工作负载进行优先级排序与执行。
Studio 计算调度器
改造前
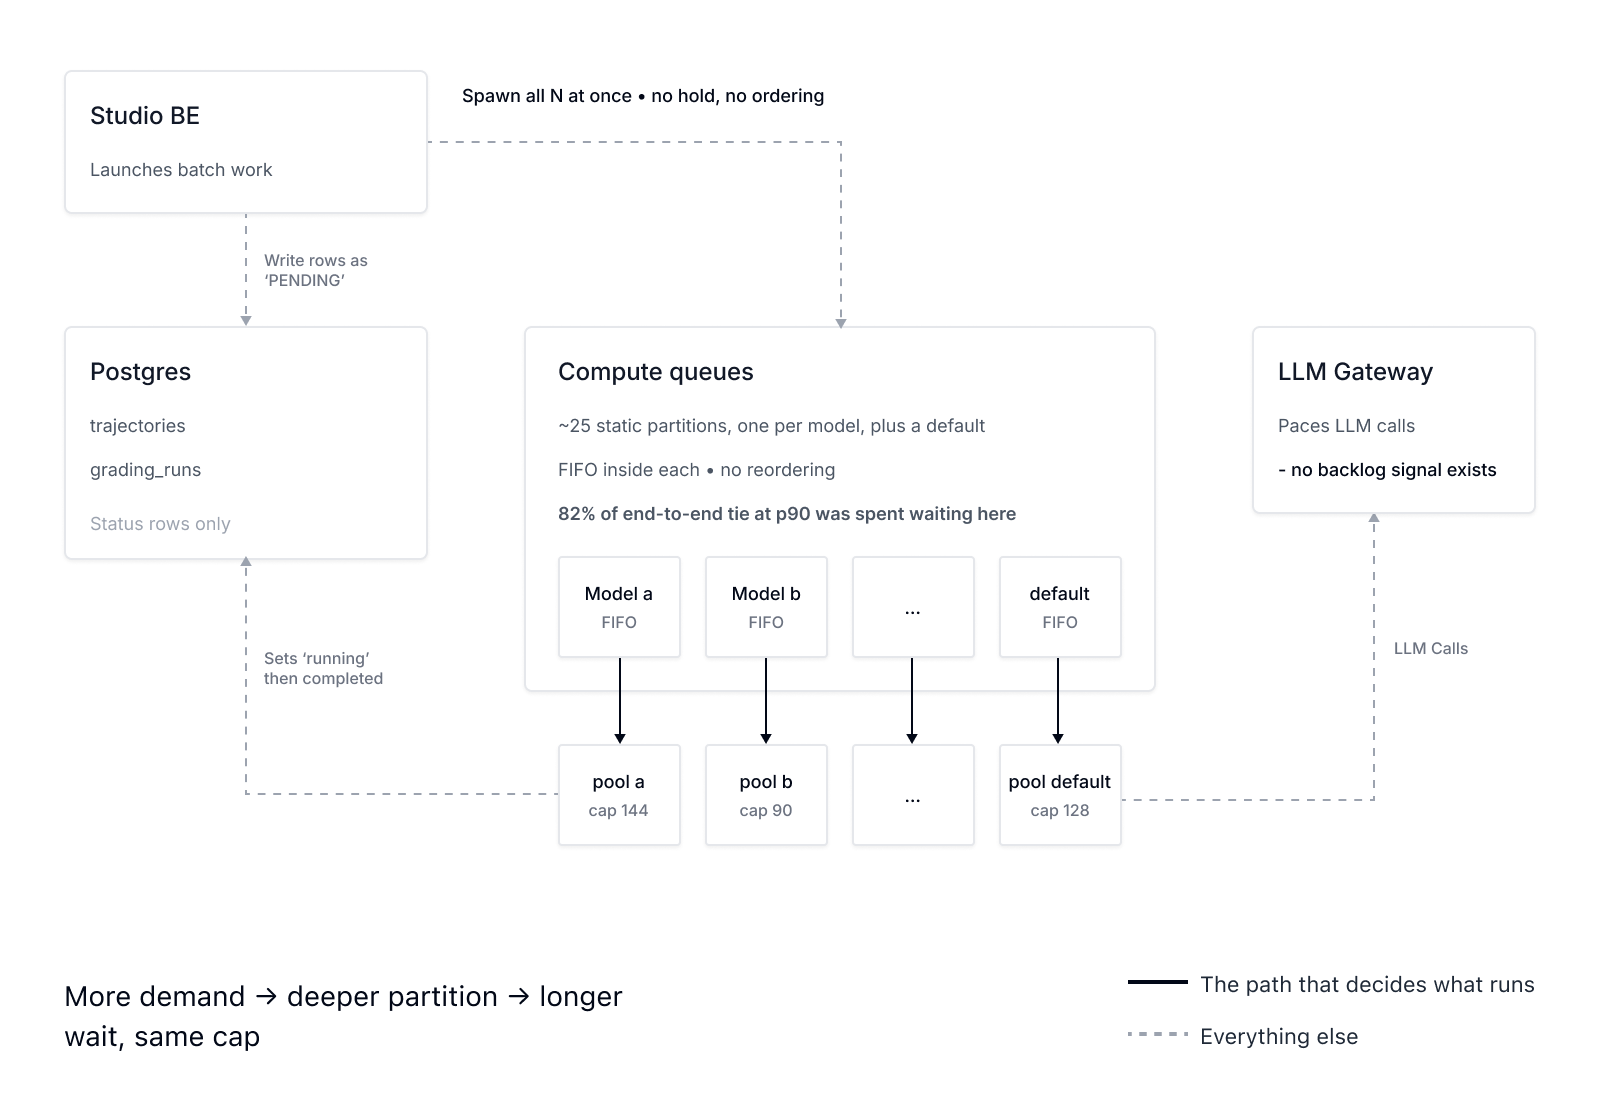
计算调度器重新设计之前的 Studio 评估排队系统
改造后
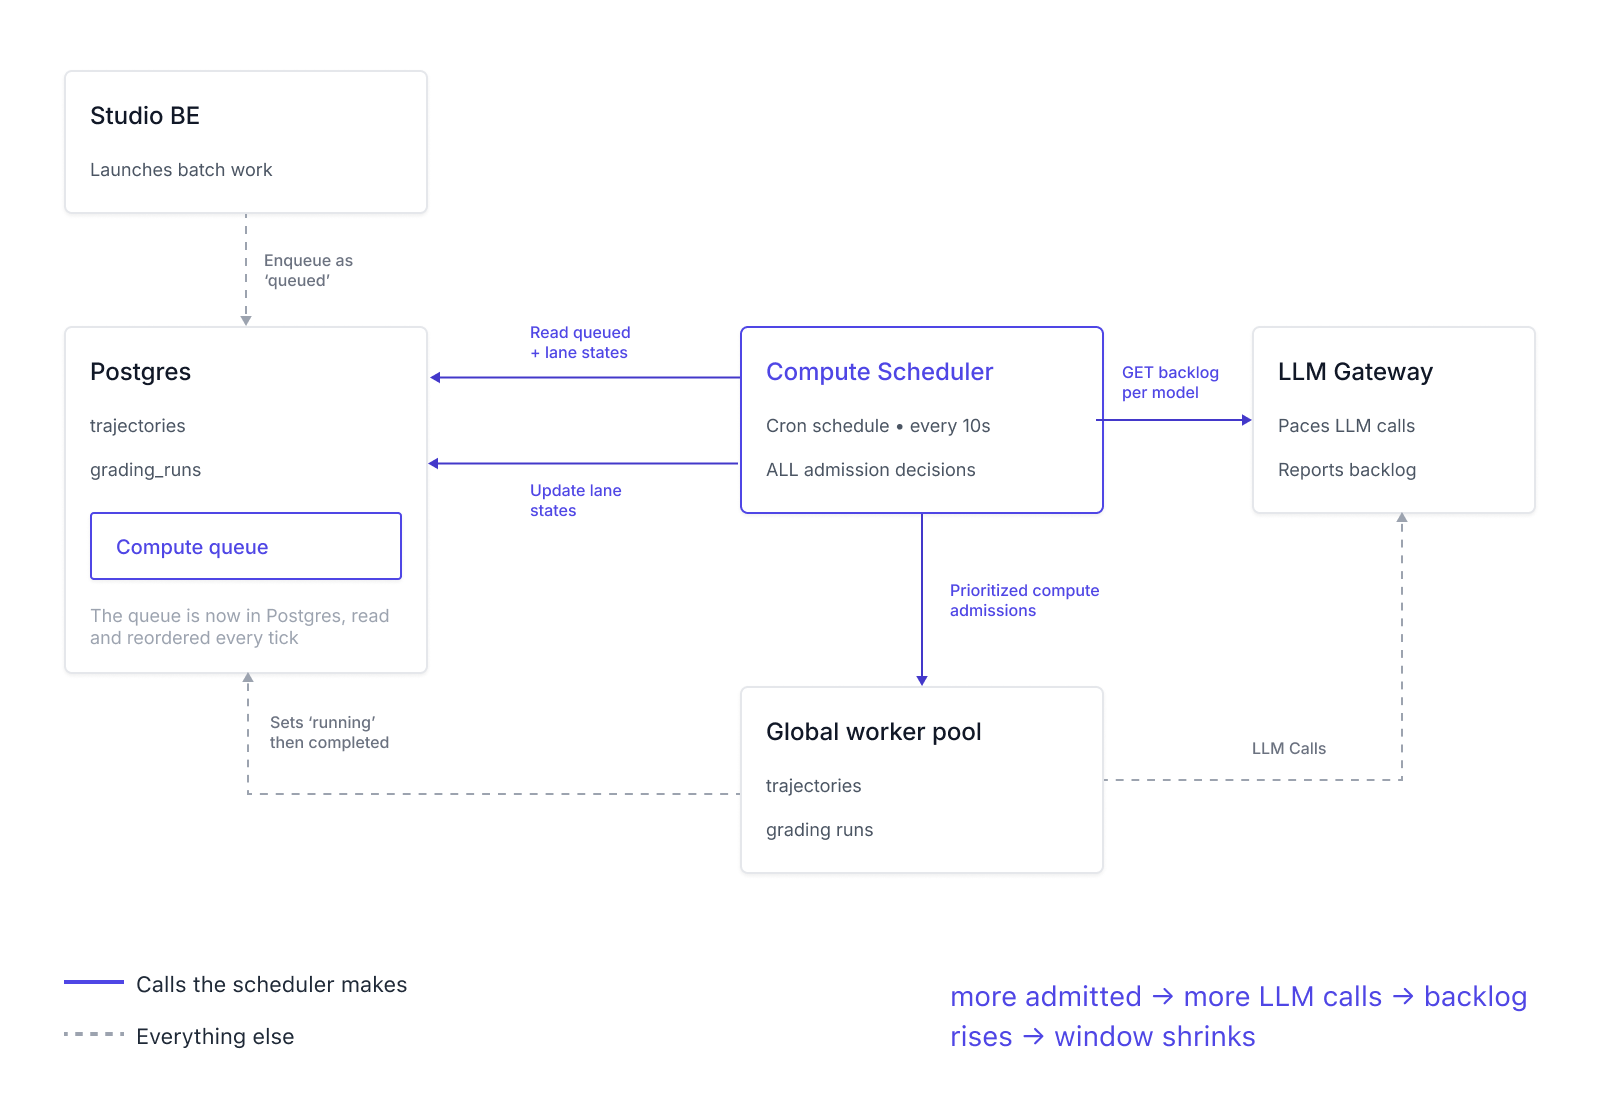
新的 Studio 评测计算调度器
概述
我们已经在各家 provider 前面跑了一个 LLM gateway,按模型分队列,避免把 provider 压垮:某个 provider 堵住时,发给它的 LLM 调用就停在 gateway 等着。这保护了 provider,却没保护我们自己的成本。LLM 调用只有在任务已经跑起来之后才会到达 gateway,而任务在 gateway 等待的整段时间里一直占着一个容器。gateway 能推迟一次 LLM 调用,却没法驱逐一个正在运行的任务,也没法判断它当初就不该启动。所以我们缺的那个队列在上一层——按任务排队,而不是按 LLM 调用排队。一个批次里的任务不再同时启动。它们在拿到容器之前先等着,这一步不花任何成本,而每十秒一次的调度决定哪些任务放行。每一轮调度做两个决定:每个模型该跑多少个任务,以及等待中的任务里哪些拿到这些名额。
并发
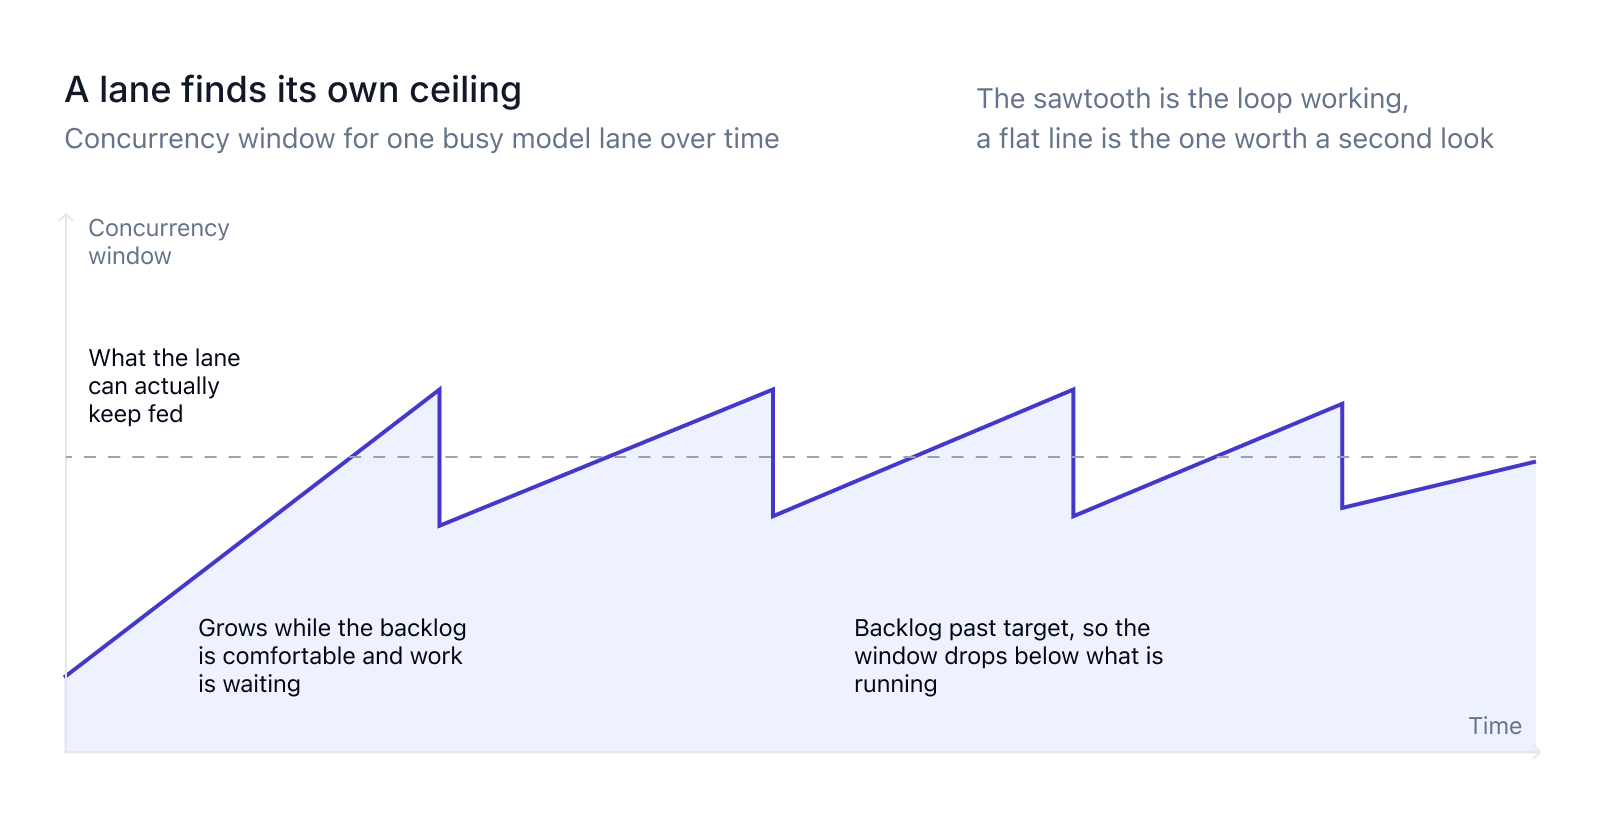
调度器会限制每个模型同时运行的任务数。gateway 自己也有上限,但那个上限管的是 LLM 调用而不是任务,而且它怎么分配某个 provider 的容量,从这里看是个黑盒。两个限制之间只有一个数字是共通的:某个模型在 gateway 的队列有多深。调度器需要的也就只有这个,因为它要回答的问题只有一个:多启动一些任务,真的能多干出活吗?gateway 队列为空或很浅,说明正在跑的任务产生的 LLM 调用不够快,喂不饱 provider,那答案就是能。gateway 队列持续变长,说明它们想要的已经超过 provider 愿意给的量,再加任务只会让队列更长。事先没法判断自己处在哪种情况,因为一个任务可能只发一次 LLM 调用,也可能展开成几十次,还可能中途切换。所以任务上限跟着 gateway 队列走:队列低于目标值且还有任务在等,就上调一档;队列超过目标值,就下调;两者之间保持不变。几分钟之内它就会稳定在一个数字上,既让模型保持忙碌,又不会把它压垮——这个数字以前是我们手工设的。
准入控制
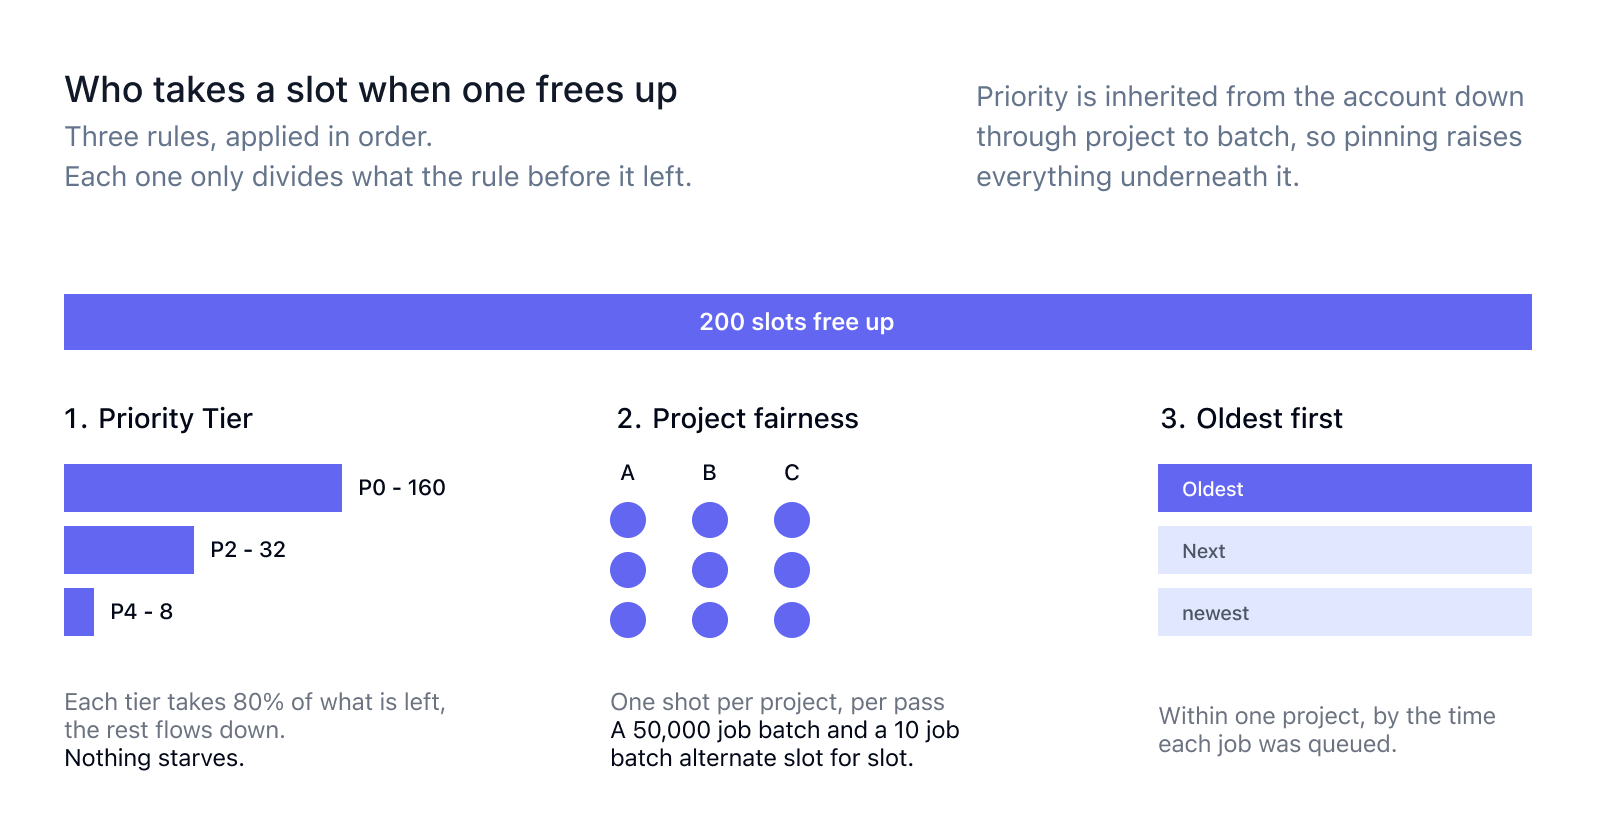
限流决定的是模型这一轮能启动多少任务,但具体启动哪些,还得有人来定。过去的做法是先到先得,于是某个客户的 20 个交付任务,就这样排在了五分钟前启动、共 5,000 个任务的评测批次后面。现在由三条规则来分配,每条只分上一条没用完的部分。优先级分层排在最前,但按权重而非绝对优先:某一层拿走分给它的 80%,这样低优先级的工作仍能缓慢推进,而不会在紧急任务出现时彻底停摆。同一层内,各项目轮流执行,一次一个任务,因此 50,000 个任务的批次和 10 个任务的批次推进速度相同,单靠体量换不来优先级。同一项目内,最老的先执行。优先级从账户向下继承到项目、再到批次,因此锁定一个账户就会提升其下所有内容的优先级——实践中这是我们用得最多的控制手段。
我们观察到的结果
| 模型 | 提升倍数 |
|---|---|
| GPT-5.5 | 20x |
| Claude Opus 4.8 | 12x |
| Claude Opus 4.7 | 12x |
| Claude Opus 5 | 9x |
| Claude Sonnet 4.6 | 9x |
| Claude Sonnet 5 | 6x |
调度器接管之后,我们最繁忙的 6 条通道各自的吞吐量相比旧上限提升了 6 到 20 倍。这些提升没有一分来自供应商新增的容量,用的全是我们本就拥有的配额。
下一步
目前调度器只依据一个信号做调整——网关处的积压深度,而它用来比对的各模型限额仍由人工在网关配置里设定。让网关自己调整这些限额,两层就能在供应商变慢时各自做出反应,无需任何人改文件。另一个方向是覆盖面——Mercor 内部还有其他大量依赖 LLM 的工作负载,完全没有走调度器。长期来看,我们希望任何大部分时间都在等待模型的任务,都默认走这条路径。