LLM評価のスループットを20倍に向上させた方法
ボトルネックは計算能力でもレート制限でもなく、p90の82%の時間がコンテナを待っていることだった。Mercorは10秒ごとに実行されるCompute Schedulerを使い、静的FIFOキューを優先度・プロジェクト公平性・先入先出の3段階ルールでグローバルワークプールを割り当てる方式に置き換え、スループットが20倍に増えた。
日本語
コピー
LLM 評価のスループットを 20 倍にした方法
今この瞬間も、Mercor のインフラの奥深くで、あるモデルが見たことのない prompt を渡され、仕事をこなそうとしている。この記事を読み終えるころには、さらに 3,000 件ほどが走り終わっているだろう。私たちはこうしたワークロードを週に 250 万件以上、毎秒 4 件、241 の異なるモデルにわたって実行している。ワークロードのひとつひとつが評価実行であり、ステップごとの推論やツール呼び出し、その他の有用な情報を記録して、作成したタスクの全体的な難易度を評価するのに役立てている。タスクは Studio で作られる。Mercor の専門家がアノテーションを書くプラットフォームで、モデルはその内容に対してテストされ、訓練される。
こうした課題に興味を持った方は、ぜひ仲間に加わってください!
規模の問題
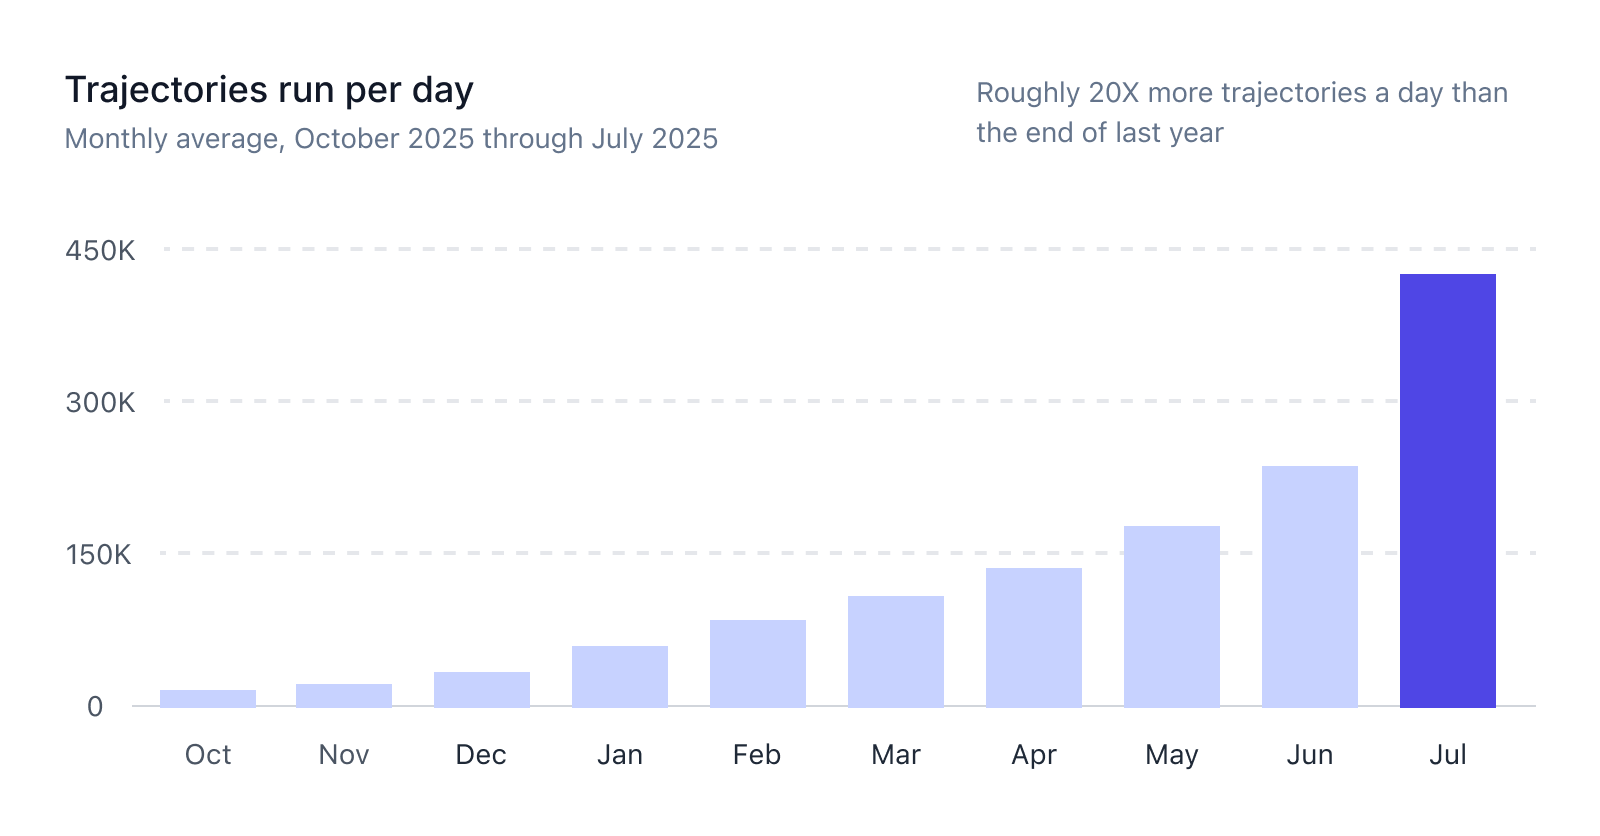
私たちは大量のモデル評価をバッチで実行し、タスクの trajectory を生成してから採点する。1 つのバッチは数千件の評価に展開され、各評価はそれぞれのコンテナの中でモデルにタスクを 1 つ走らせる。モデルはサンドボックス環境とタスクに必要なツールを受け取り、完了するまでループを回す。昨年末以降、trajectory の量は爆発的に増えた。
この増加は、特定の種類のエラーとして何かを壊したわけではない。私たちが見たのは、評価のエンドツーエンド実行時間の体系的な増加だった。時間がどこに消えているのかを掘り下げたところ、答えは想定とは違っていた。
計算資源待ちのボトルネック
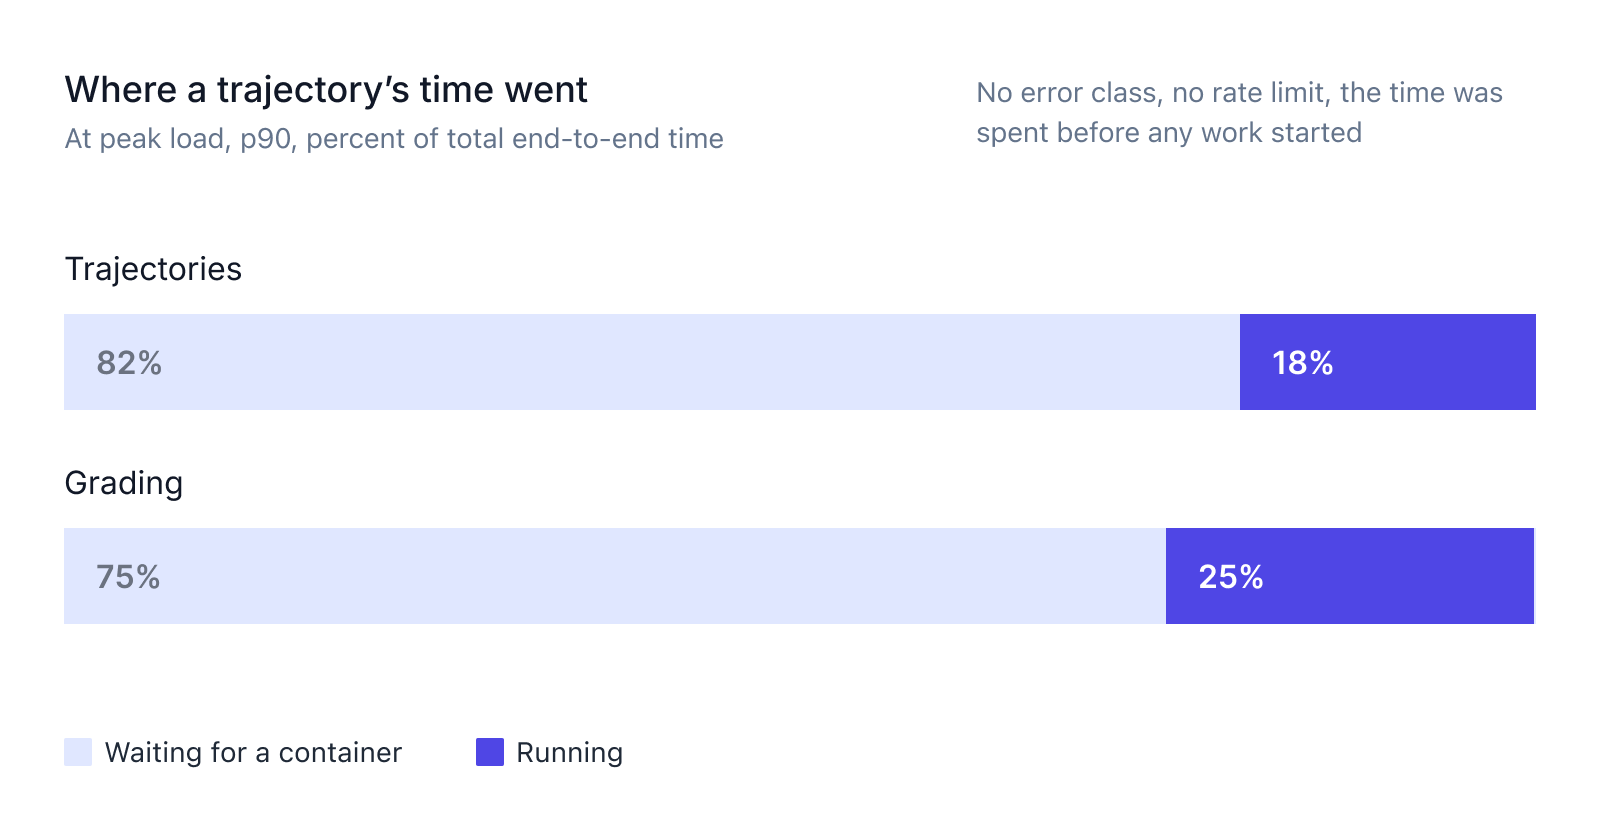
p90 の trajectory は時間の 82% を計算コンテナの待機に費やし、実行は 18%。採点フェーズでは 75% が待機、25% が実行だった。最初は当然、モデル提供元のレート制限にぶつかったのだと思った。しかし下位のメトリクスとログを詳しく見ていくと、2 つのボトルネックが見つかった。Mercor が次の段階の規模に耐えられるようにするには、アーキテクチャをこの 2 つを中心に進化させる必要がある。
グローバルな容量の分割
評価量が増え、モデルの数も増えるにつれて、特定のモデルにホットスポットが生まれ、システム上のトラフィックの大部分を占めるようになった。大きなバッチが他のワークロードをブロックする。ブロックされる側は、より小さく頻度の高いバーストタスクだったり、トラフィックの少ないモデルで走るものだったりする。私たちはこうした高使用量のモデルを徐々に独立したキューイングチャネルへと切り出し、グローバルな上限から専用の容量を割り当てていった。全体の使用量が増えるにつれて専用チャネルを増やさざるを得なくなり、チャネルが 1 本増えるたびに、どの単一チャネルの上限も押し下げられた。必要なのはアーキテクチャの改善だった。トラフィックが集中したときは最大の計算資源を 1 つのモデルにすべて注ぎ、必要なときには複数のモデルへ公平に配分できるようにする。
ベンダー容量の利用率不足
最も人気のあるモデルでの活動量が増えるにつれて、ベンダーが提供できる容量の上限に触れ始めた。ここで計画が必要になる。あるモデルが超大規模なバッチや多数のバッチから評価のスパイクを突然受けたとき、並列度をどこまで上げられるか。以前はこうしたケースを固定的なハードリミットで管理していたが、上限を本当に極限まで使い切ろうとすると、このやり方では noisy neighbor 問題が起きたり、わずかに過剰割り当てや過少割り当てになったりしやすい。必要だったのは、スケーリングとバックオフの仕組みをより細かくし、既存の容量を使い切りつつ、実測シグナルに応じて動的に調整できるようにすることだった。この 2 つの問題を解決し、Mercor の次の段階の規模をアーキテクチャで支えるために、私たちは動的コンピュートスケジューラを設計した。さまざまな使用パターンと動的に変動する利用可能容量の間で、ワークロードの優先順位づけと実行を行うためのものだ。
Studio コンピュートスケジューラ
改修前
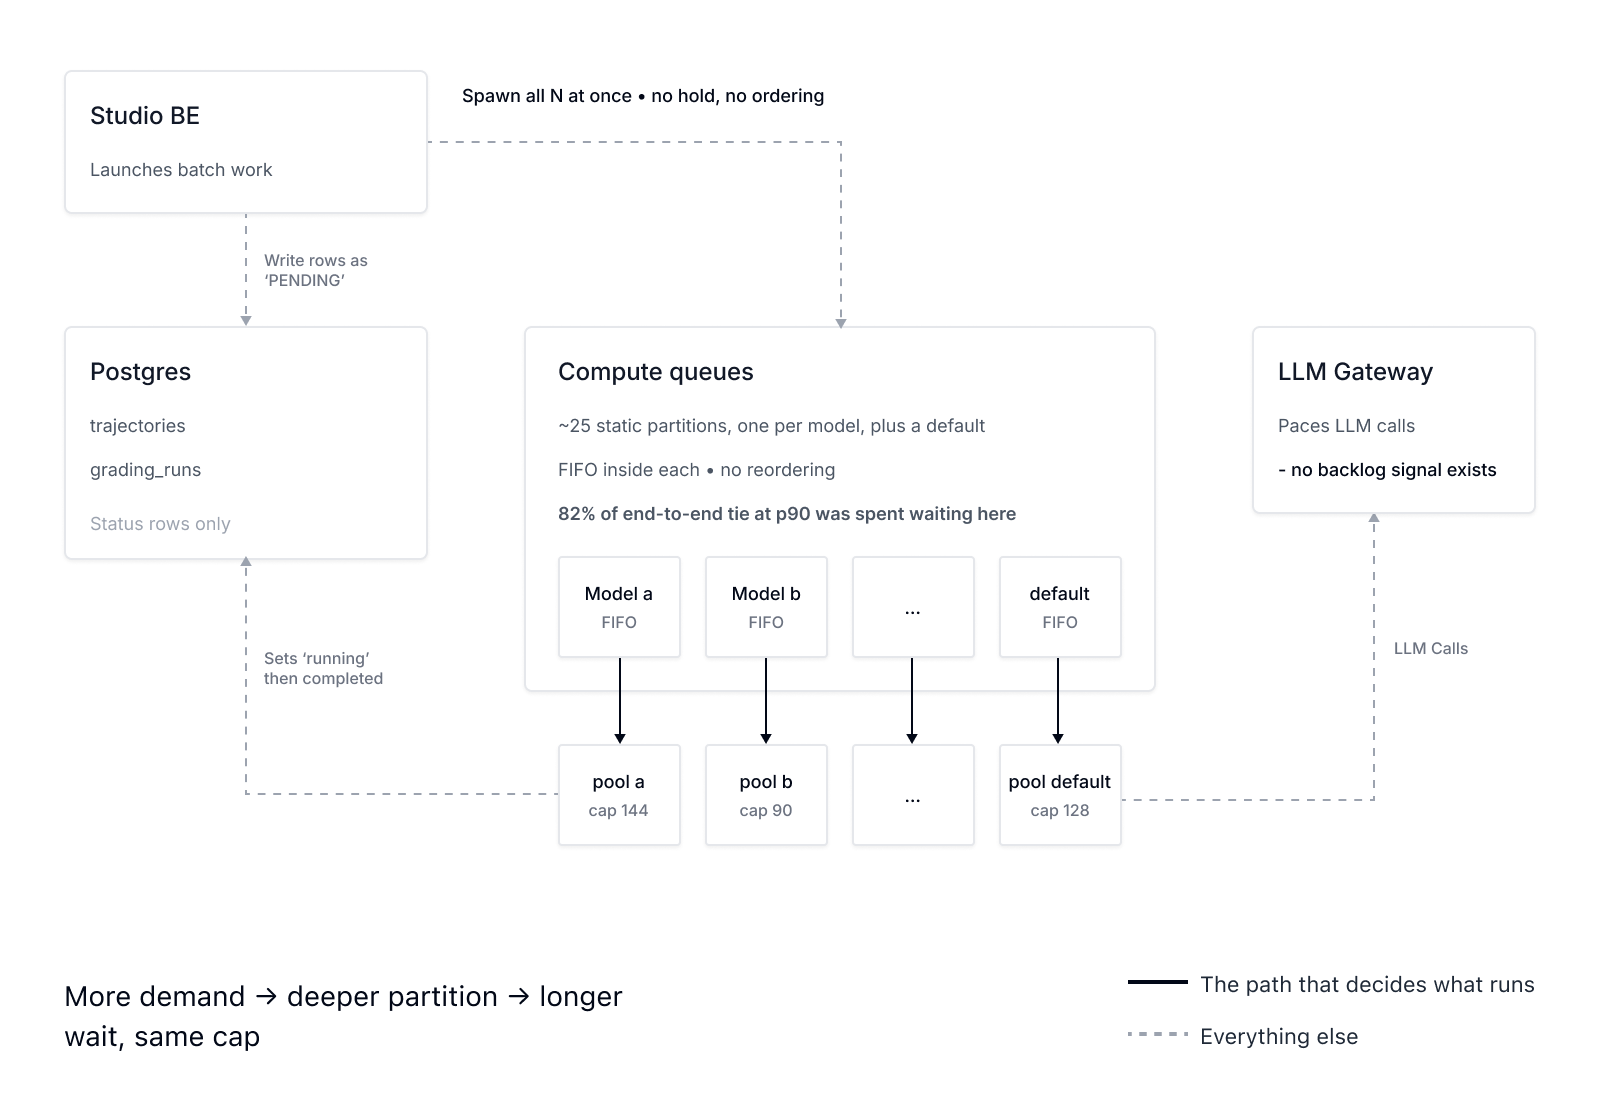
コンピュートスケジューラを再設計する前の Studio 評価キューイングシステム
改修後
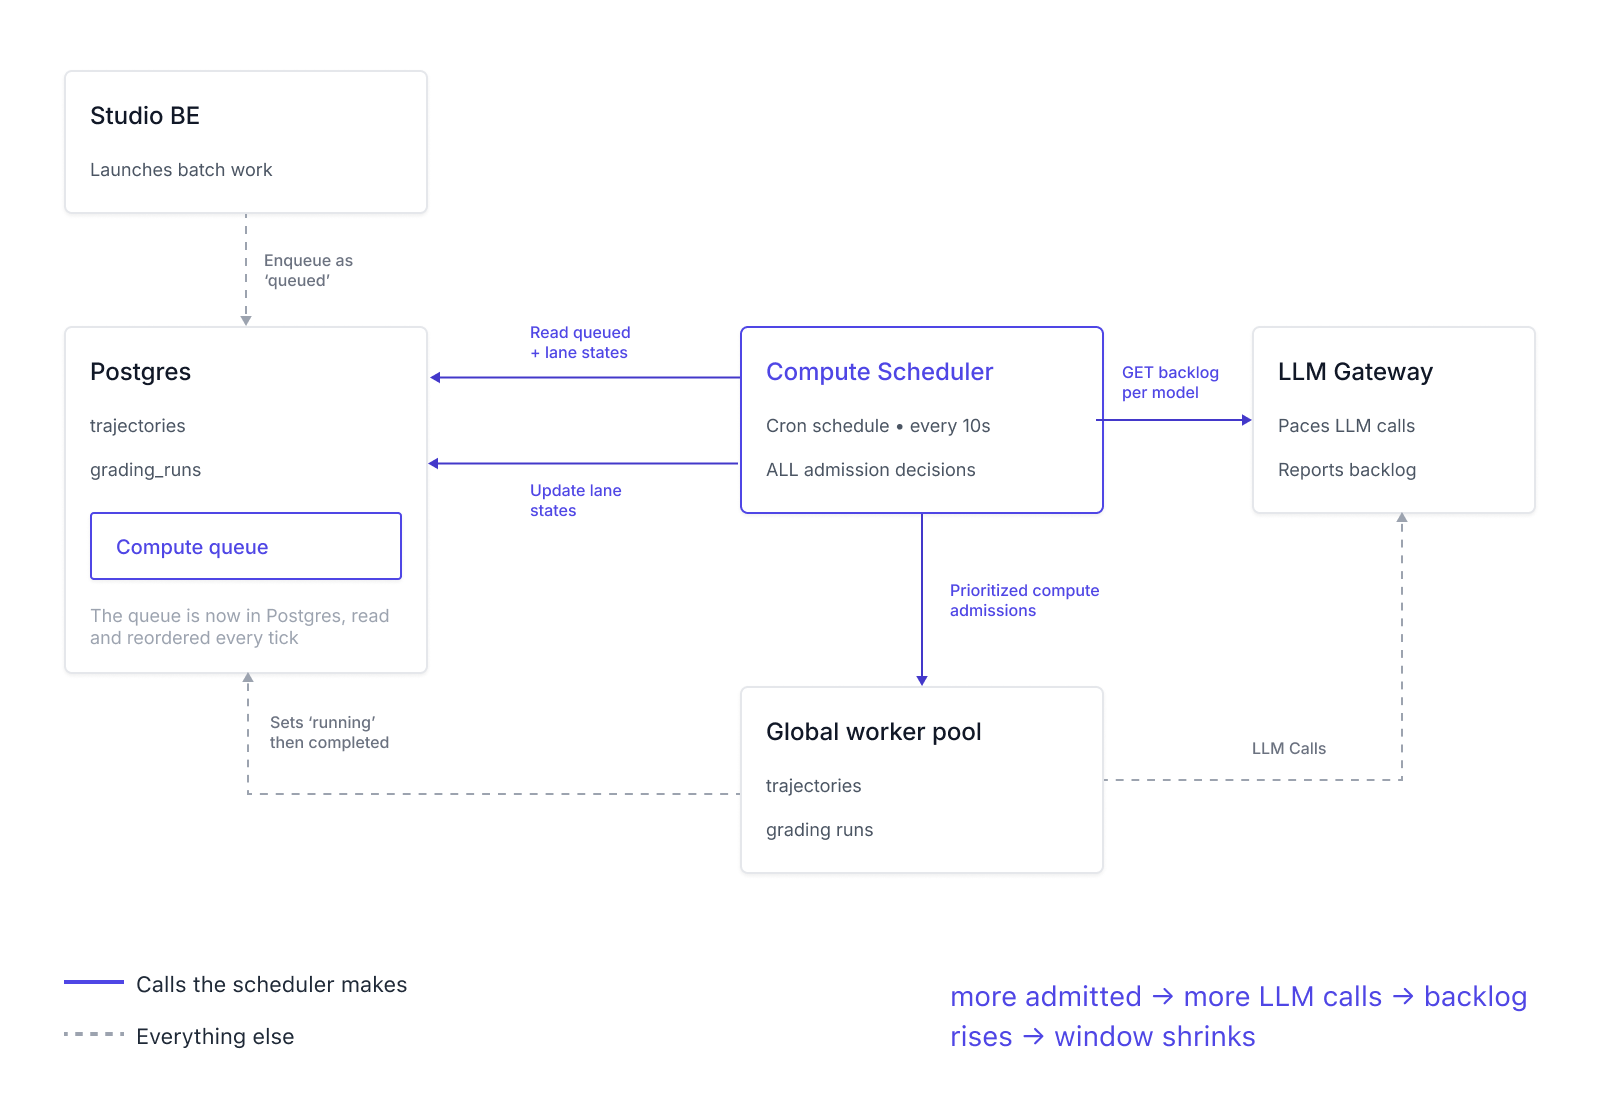
新しい Studio 評価コンピュートスケジューラ
概要
私たちはすでに各 provider の手前に LLM gateway を動かしており、モデルごとにキューを分けて provider を潰さないようにしていた。ある provider が詰まれば、そこへ送る LLM 呼び出しは gateway で待たされる。これで provider は守られたが、自分たちのコストは守られていなかった。LLM 呼び出しが gateway に届くのはタスクがすでに動き出した後で、タスクは gateway で待っている間ずっとコンテナを 1 つ占有し続ける。gateway は LLM 呼び出しを遅らせることはできても、実行中のタスクを追い出すことはできず、そもそもそのタスクを起動すべきでなかったと判断することもできない。だから足りなかったキューは 1 つ上の層にある。LLM 呼び出しではなくタスクを並べるキューだ。バッチ内のタスクはもう一斉に起動しない。コンテナを取る前に待つ。この待機にはコストがまったくかからず、10 秒ごとのスケジューリングがどのタスクを放すかを決める。各ラウンドでスケジューラは 2 つの決定を下す。モデルごとにいくつのタスクを走らせるか、そして待機中のタスクのうちどれがその枠を取るか。
並列度
スケジューラはモデルごとに同時実行するタスク数を制限する。gateway にも独自の上限があるが、それは LLM 呼び出しを対象にしたものでタスクを対象にしたものではなく、ある provider の容量をどう配分するかはここから見るとブラックボックスだ。2 つの制限の間で共通する数字は 1 つだけ。あるモデルの gateway キューがどれだけ深いかだ。スケジューラが必要とするのはこれだけで、答えるべき問いも 1 つしかない。タスクをもっと起動すれば、本当に仕事が増えるのか。gateway のキューが空かごく浅ければ、走っているタスクが生む LLM 呼び出しが provider を満たすほど速くなく、答えはイエスだ。gateway のキューが伸び続けているなら、要求が provider の出せる量をすでに超えており、タスクを足してもキューが長くなるだけだ。自分がどちらの状況にいるかは事前にはわからない。1 つのタスクが LLM 呼び出しを 1 回しか出さないこともあれば、何十回にも展開することもあり、途中で切り替わることもあるからだ。そこでタスクの上限は gateway のキューに追従する。キューが目標値を下回り、待機中のタスクがまだあれば 1 段上げる。キューが目標値を超えれば下げる。その間なら据え置く。数分のうちに、モデルを忙しく保ちつつ潰さない数字へと落ち着く。以前は私たちが手で設定していた数字だ。
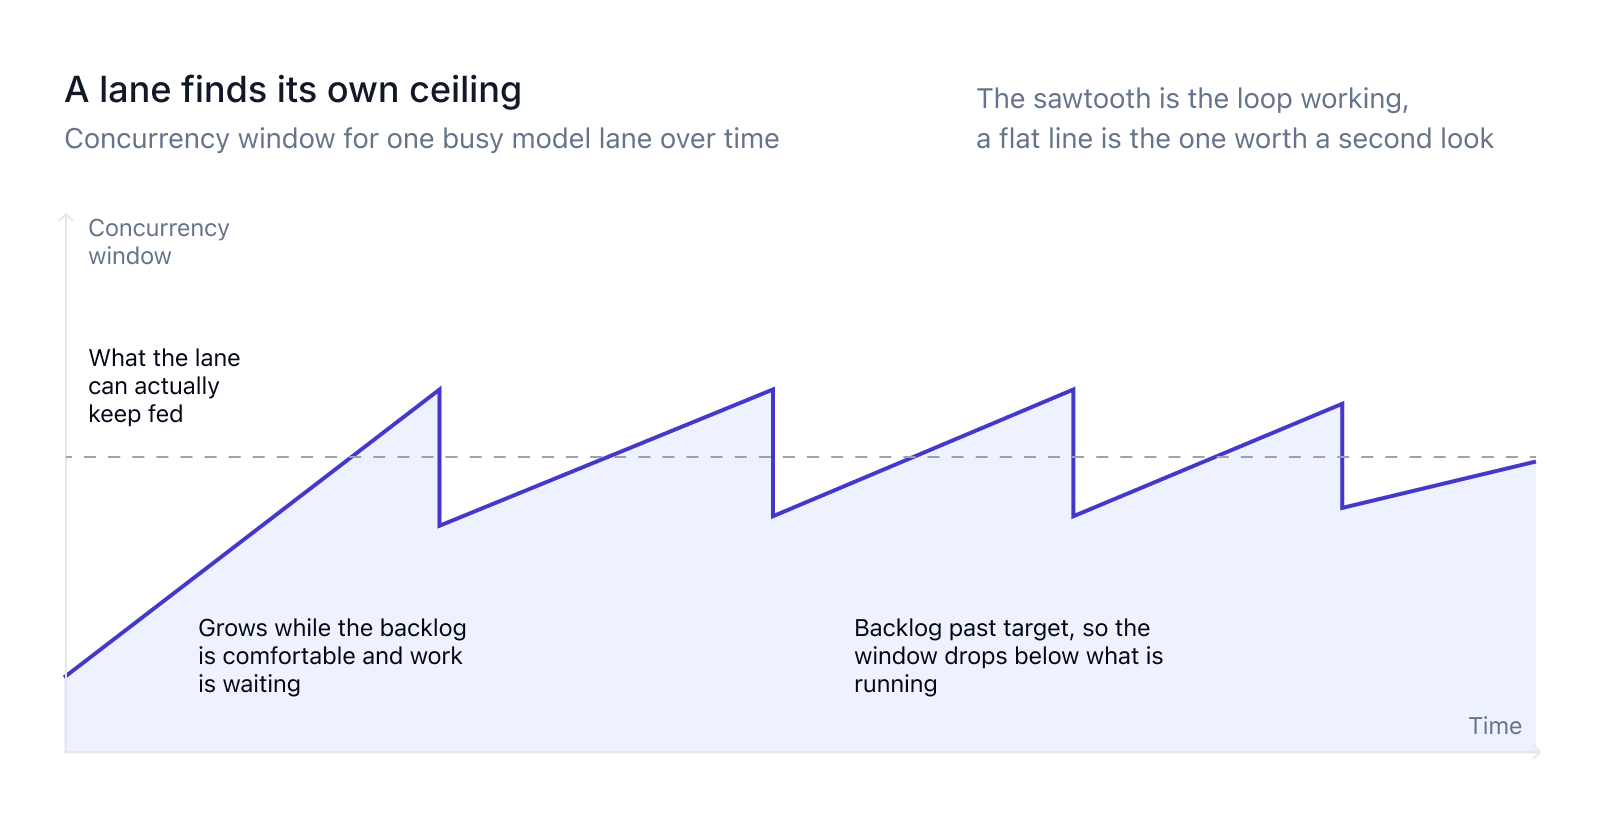
アドミッション制御
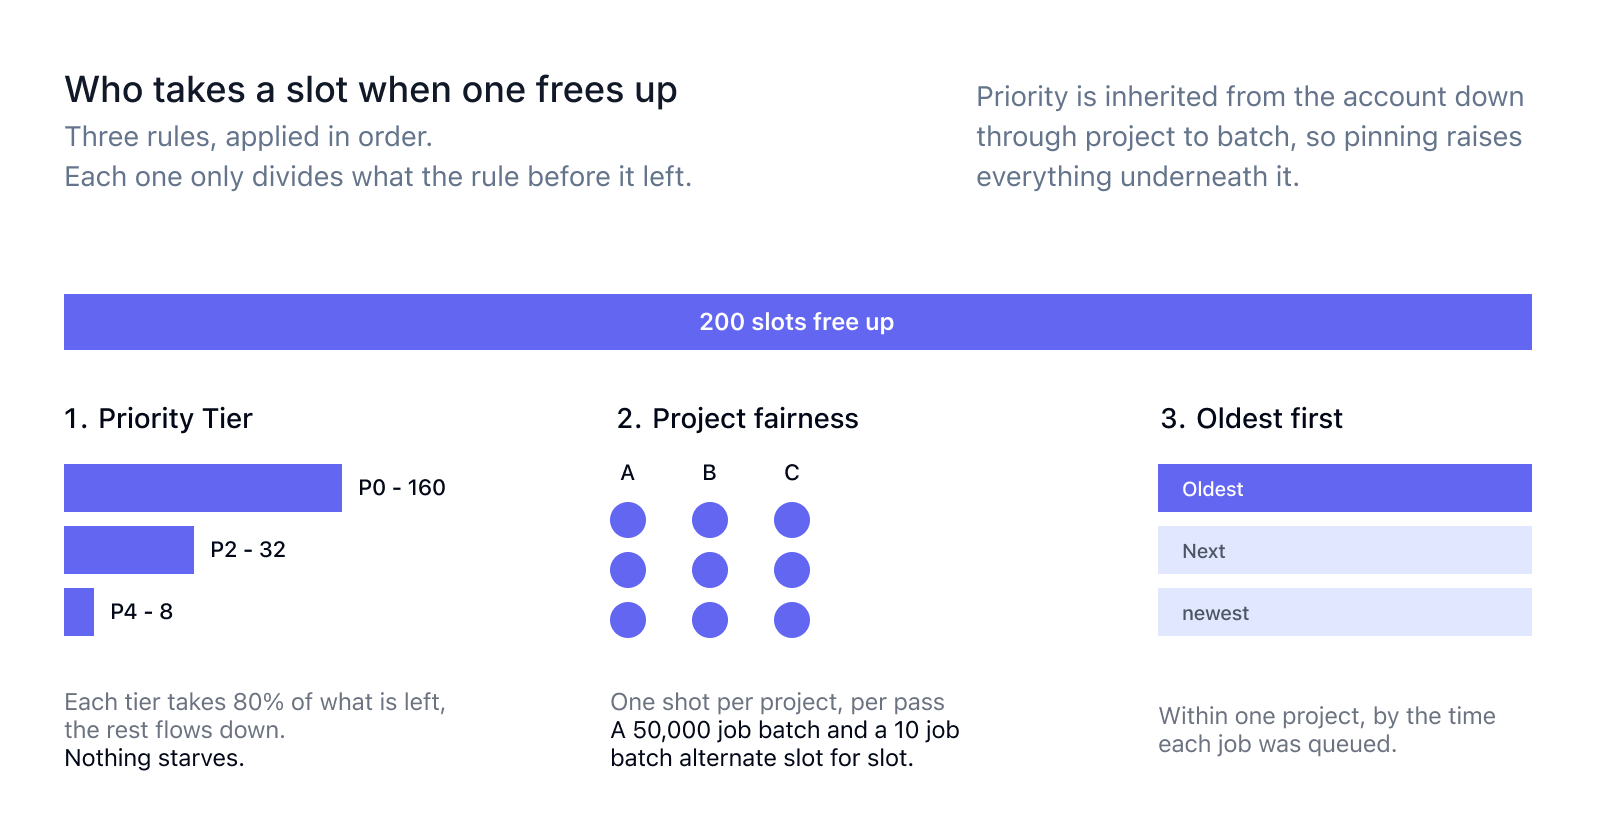
レート制限は、モデルがそのラウンドでいくつのタスクを起動できるかを決める。だが、具体的にどれを起動するかは別の誰かが決めなければならない。以前は先着順だった。その結果、ある顧客の納品タスク20件が、5分前に起動した5,000件の評価バッチの後ろに並ぶことになった。今は3つのルールで配分し、各ルールは前のルールで使い切れなかった分だけを扱う。最優先は優先度ティアだが、絶対優先ではなく重み付けで配分する。あるティアは割り当て分の80%を受け取り、低優先度の作業も細々と進み続けられる。緊急タスクが現れても完全に止まらない。同じティア内ではプロジェクトが順番に実行され、一度に1タスクずつなので、50,000件のバッチも10件のバッチも同じ速さで進む。量の多さだけでは優先度は得られない。同じプロジェクト内では最も古いものが先に実行される。優先度はアカウントからプロジェクトへ、さらにバッチへと継承されるため、あるアカウントをロックするとその配下すべての優先度が上がる——実際に最もよく使っている制御手段はこれだ。
観測された結果
| モデル | 向上倍率 |
|---|---|
| GPT-5.5 | 20x |
| Claude Opus 4.8 | 12x |
| Claude Opus 4.7 | 12x |
| Claude Opus 5 | 9x |
| Claude Sonnet 4.6 | 9x |
| Claude Sonnet 5 | 6x |
スケジューラが引き継いだ後、最も混雑している6つのチャネルそれぞれのスループットは旧上限比で6〜20倍に向上した。この向上分はベンダーが追加した容量によるものではなく、すべて元から持っていたクォータで賄っている。
次のステップ
現状、スケジューラが調整に使うシグナルは1つだけ——ゲートウェイにおけるバックログの深さであり、比較対象となるモデルごとの上限は依然として人間がゲートウェイの設定で決めている。ゲートウェイ自身がこれらの上限を調整できるようにすれば、ベンダーが遅くなったときに2つの層がそれぞれ反応でき、誰かがファイルを書き換える必要はなくなる。もう1つの方向は適用範囲だ。Mercor 内部には他にも LLM に依存する大量のワークロードがあり、スケジューラをまったく経由していない。長期的には、大半の時間をモデルの待機に費やすタスクは、デフォルトでこの経路を通るようにしたい。