从照片到可打印的3D
开源工具包 printable 把照片转成水密、毫米级、可直接切片的 STL,并在 AMD ROCm 上跑通五阶段流水线。
中文
复制
如果你用过 Meshy.ai、Hi3D 或 CSM(Common Sense Machines)这类商业 3D 生成工具,就知道丢进去一张 2D 照片、拿回来一个 3D 模型有多神奇。但作为一个用 AMD 工作站的创客和开发者,我一直有两个疑问:
- 这些流水线在现代开源模型下究竟是怎么跑通的?
- 我们能不能搭一条完整的本地流水线,直接输出可切片、可打印的 STL,而不是只能看不能打的视觉网格?
开源业余项目当然不会一夜之间取代商业多视角重建引擎,但我想亲手体验一遍:用开源组件从零搭一个照片转 3D 的工具,到底需要什么。成果就是 printable——一套 Python 工具包,能把照片、角色三视图和工程设计规格转成水密、以毫米为单位的 STL,并按真实 3D 打印机的约束做校验。下面是它的搭建过程、在现代 3D AI 上跑 AMD 硬件(Strix Halo / ROCm)遇到的坎,以及哪些做法效果最好。
1. 真正的问题:「给你一个网格」还是「给你一个能打印的件」
大多数开源生成式 3D 项目止步于生成一个看起来像样的网格。结果可能是 OBJ、PLY 或 GLB,在 3D 查看器里很漂亮,可一旦导入 OrcaSlicer、PrusaSlicer 或 Bambu Studio,现实就来了:
- 非流形几何与开放边:网格上的破洞会让切片器漏掉墙线或错误地填充空腔。
- 断开的悬浮碎块:悬浮岛对树脂打印和 FDM 打印都是灾难。
- 坐标系和比例随意:网格被塞进一个任意的 包围盒,没有真实世界的毫米尺度。
- 打印平台接触不稳定:纯粹为了外形好看而自动定向,常常把站立的人形放平仰躺,或者让模型靠几个极小的接触点立着,底下没有平整的底板。
在 printable 里,AI 生成只是 5 阶段流水线中的第 2 阶段:
flowchart LR
 A["2D Photo / Spec Sheet"] --> B["Preprocess & Background Keying"]
 B --> C["Geometry Backend (Hunyuan3D / TripoSR / CPU)"]
 C --> D["Repair Ladder (Manifold, Islands, Poisson)"]
 D --> E["Print Prep (Scale mm, Auto-Orient, Base, Hollow)"]
 E --> F["Validation Gate (Thin walls, Overhangs)"]
 F --> G["Slicer-Ready STL"]
如果网格无法做到水密,或者违反了最小壁厚规则,流水线会在验证关卡直接报错,而不是把一个坏掉的 STL 交给你,让它在 3D 打印进行到第 8 个小时才失败。
2. 硬件挑战:在 AMD ROCm(Strix Halo)上跑 3D AI
- BIOS 配置:把
UMA Frame Buffer Size设为 512 MB,让 Linux 的amdgpu驱动可以通过 GTT 从系统内存中动态调配计算显存。 - PyTorch 环境:本项目可用的环境使用 AMD 面向
gfx1151的 ROCm/TheRock 构建。但具体的 nightly 索引很关键:AMD 一直在调整 ROCm/TheRock 的分发结构,所以某个时间点能用的索引,未必还能提供当前的滚动构建。
# Example of the gfx1151-specific PyTorch environment
# Use the currently published TheRock index appropriate to your installation.
uv pip install --index-url https://rocm.nightlies.amd.com/v2/gfx1151/ torch torchvision
重要:上面的命令只是特定环境下的快照,不是一劳永逸的安装配方。做这个项目的过程中我发现,某个索引看起来是当前的 nightly 源,实际返回的却可能是更早的固定版本。后来的
TheRock布局换了索引和包命名方式,但新栈在这台机器上引入了原生扩展和 CMake 的兼容问题。完整的 A/B 测试和回滚过程见 §9。AMD 的 ROCm 10.0 公告给出了这次转变的更大背景:TheRock 现在是 ROCm 10.0 背后的自动化构建与发布基础,把 ROCm 组件和框架包纳入更统一的发布流水线。
3. 后端评估:哪些能用,哪些不能用
我试了几种生成方案,看它们如何处理单图和多视图输入。关键区别在于实验和如今 printable 中真正发布的后端。TRELLIS 和 SPAR3D 在开发阶段是有用的实验,但都没能进入当前的后端注册表,因为它们生成的拓扑对后续的可打印处理来说始终是个麻烦。
| 后端 | 硬件 | 典型速度 | 网格质量 | 切片水密性 |
|---|---|---|---|---|
| TRELLIS(AMD 实验) | GPU | ~30s | 视觉细节好 | ⚠️ 拓扑破碎/不连通 |
| SPAR3D(AMD 实验) | GPU | — | 有潜力 | ⚠️ 复杂姿态下出现多体碎片 |
| TripoSR | GPU + CPU | ~10s | 粗糙/草稿级 | ✅ 足够干净,可用于快速打印流水线 |
| Tencent Hunyuan3D 2.1 | GPU | ~1–2 分钟 | ⭐ 高保真 | ⭐ 最佳:致密、连贯的单体实体 |
当前printable后端阵容包含四个后端:
heightmaplithophanetriposrhunyuan3d
TRELLIS 和 SPAR3D 在历史上仍有意义,因为它们解释了这条流水线为什么最终倒向 Hunyuan3D,但在已发布的代码库中,它们已不再是可选后端。
- TRELLIS 与 SPAR3D:两者在视觉上都很有前景,但只有把生成的网格送进真正的可打印流水线之后,它们的失效模式才暴露出来。TRELLIS 经常生成互不相连的外壳,无法通过布尔并集;SPAR3D 则会把复杂的角色姿态打散成多个身体。在 Hunyuan3D 被证明在后续修复和打印准备上始终更合适之后,两者都被移除,而不是作为误导性的“受支持”选项留在那里。
- Hi3DGen:考虑过,从未尝试。 它在纸面上看起来不错,但对稀疏卷积的依赖让它在一条 AMD 优先的流水线里毫无吸引力。如果它的 ROCm 支持有所改善,它仍是未来评估的候选。
- TripoSR:快得惊人(约 10 秒),几乎没有冷门依赖。它充当草稿模式生成器和加速器尖峰测试。通过在表面顶点查询 triplane 解码器(
--opt texture=true),它可以在导出 STL 的同时导出一份带颜色的.glb预览。 - Tencent Hunyuan3D 2.1:在我的 AMD 工作站上完胜。 形状模型(
hunyuan3d-dit-v2-1,约 7.4 GB)生成的几何体致密、结构可靠,经得起二次误差度量简化与内壁掏空而不塌陷。
ROCm 提示:在 ROCm 上跑 Hunyuan3D 2.1 的 flow matching,需要启用 PyTorch 的实验性 AOTriton 注意力内核调度器:
TORCH_ROCM_AOTRITON_ENABLE_EXPERIMENTAL=1 printable generate assets/examples/figure.jpg \
-b hunyuan3d --size 80 --hollow --hollow-wall 1.6 --max-faces 500000 --no-base
4. 基准素材与 Antigravity 示例
为了在不依赖外部网页 URL 的情况下系统地测试每条流水线,参考素材被整理在 assets/examples/ 中(大多使用 Google Antigravity 和 Stable Diffusion 1.5 创建并做基准测试):
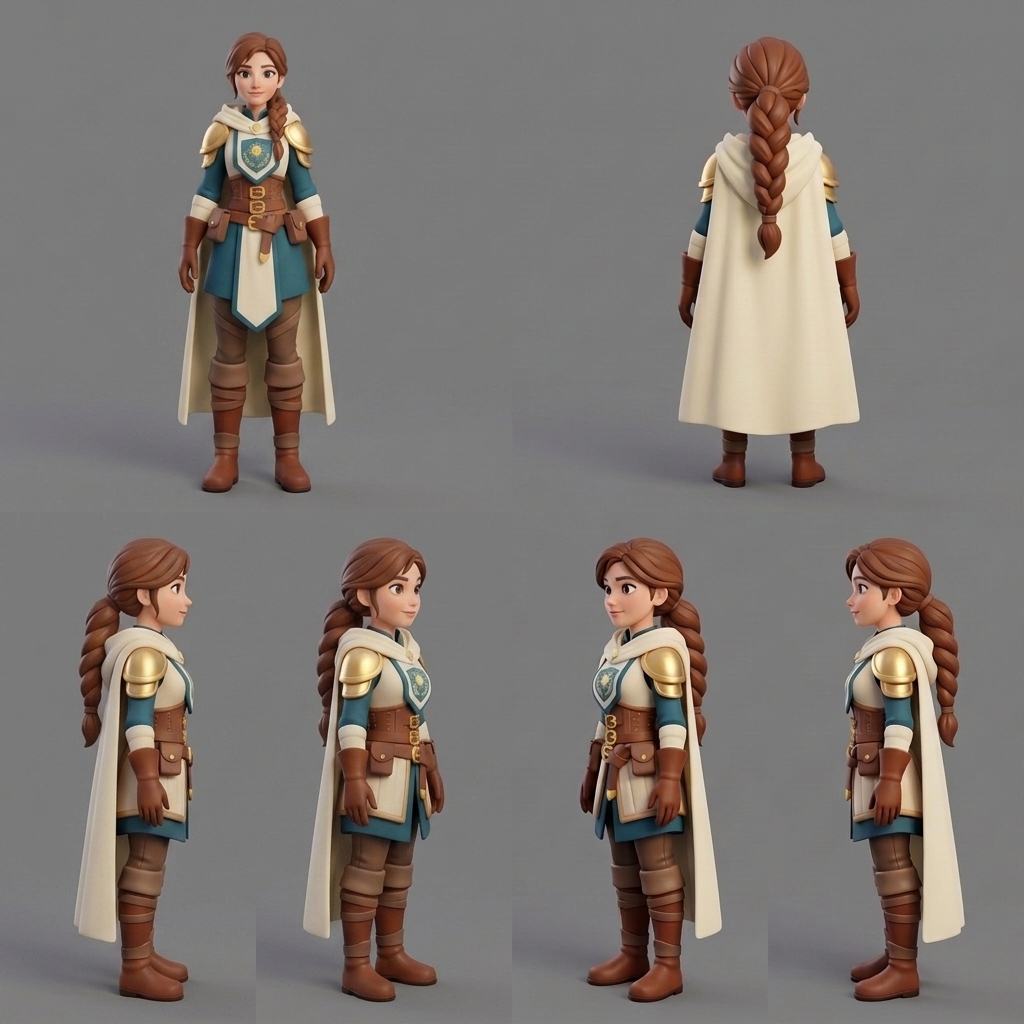
- 多视角转台图(
character_female_turnaround.png):单图 3D 模型对看不见的部分只能靠猜。多视角转台图提供 4 个角度(正面、背面、左侧、右侧)。配合printable generate --sheet,流水线会沿真实接缝切分转台图,对所有分块分别做完整重建,再自动保留水密性和可打印性最好的那个结果。
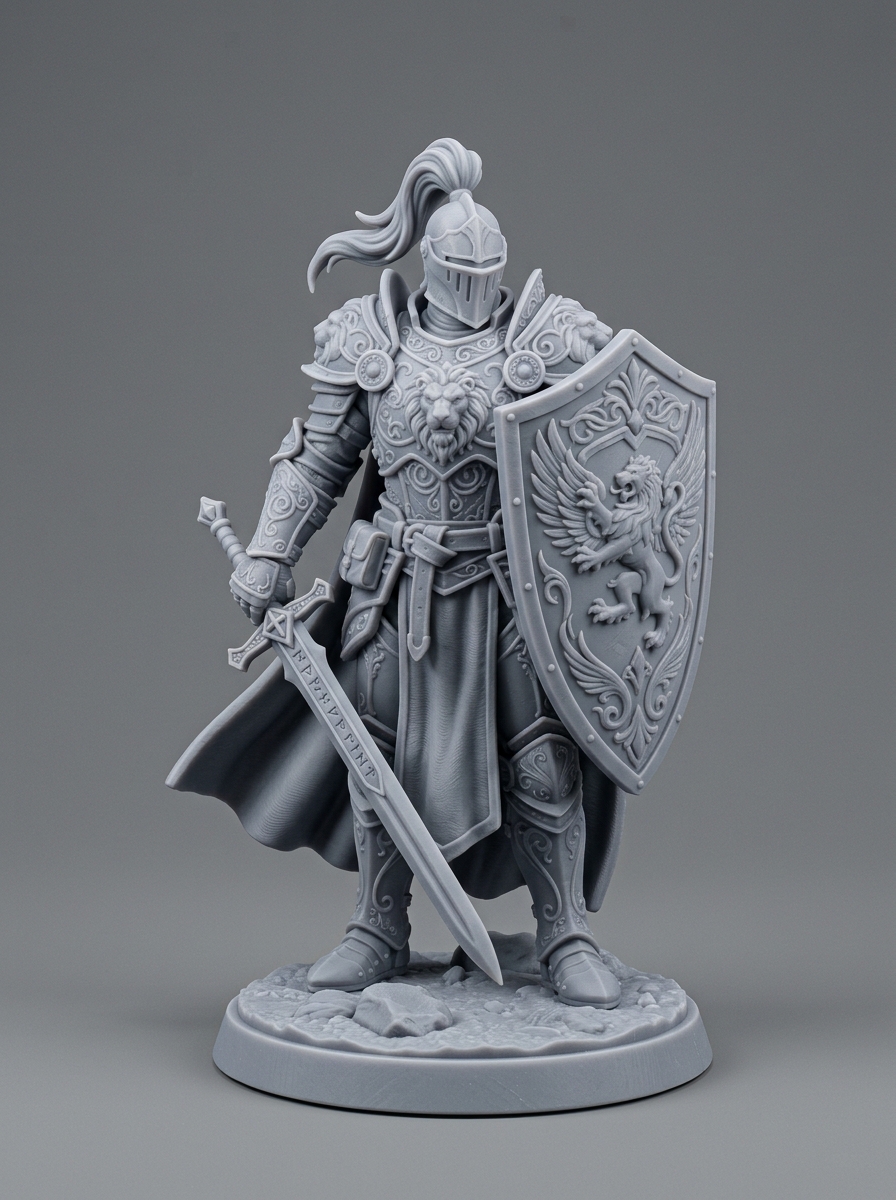
- 微缩模型(
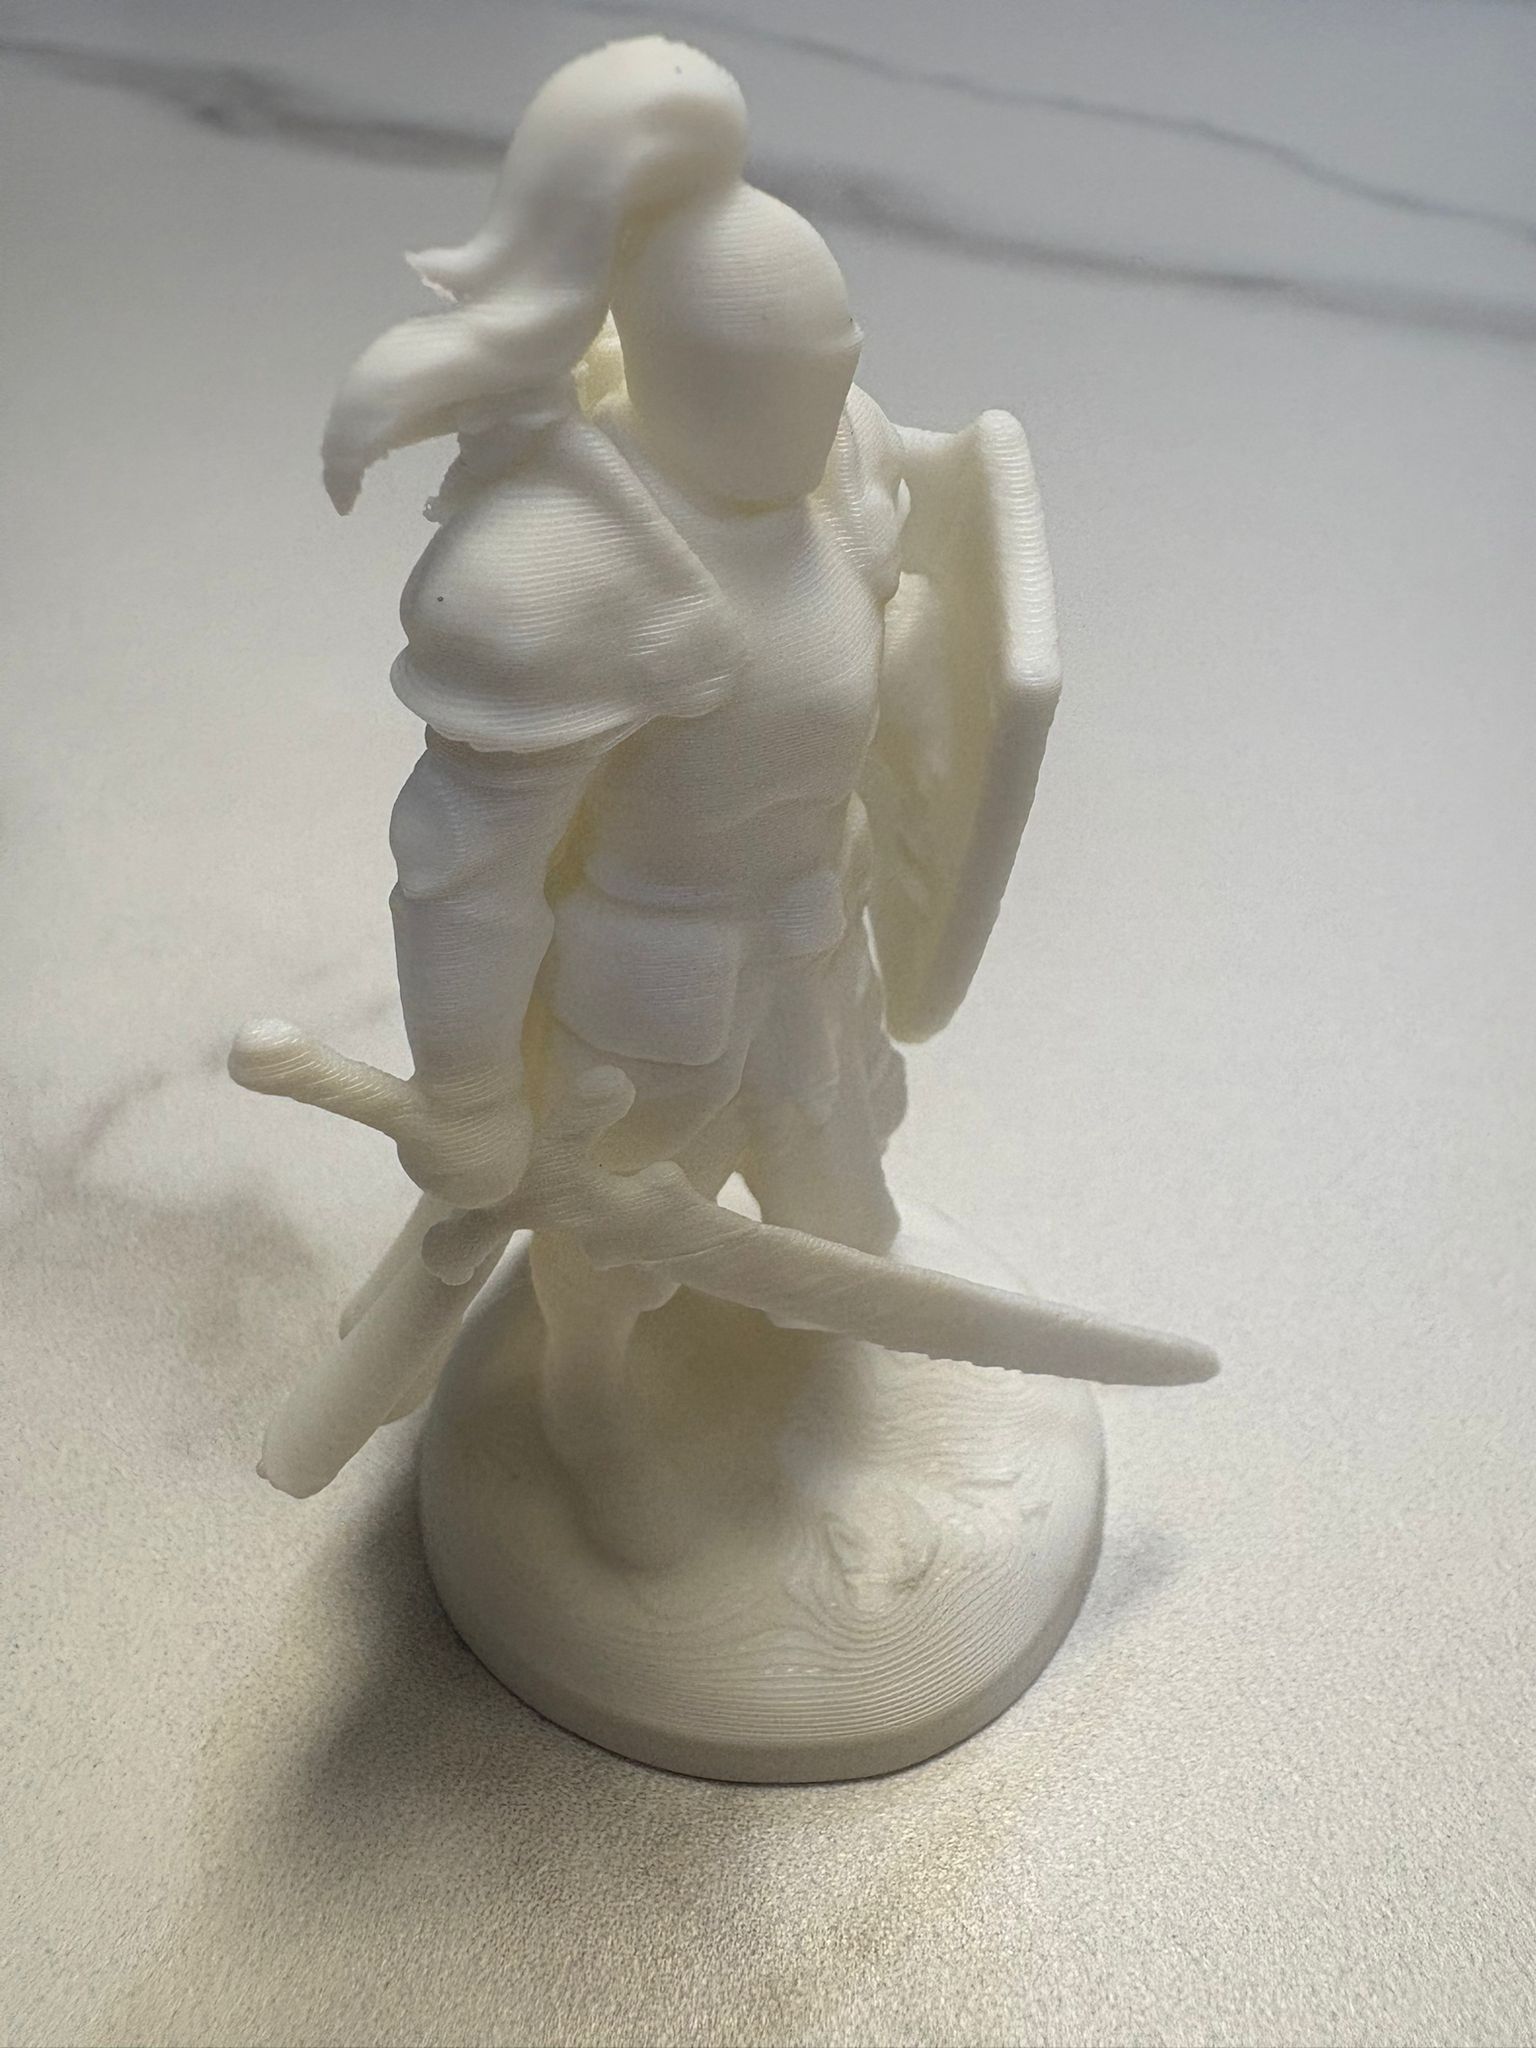
figure.jpg):一个圣骑士模型,用来测试内部壁面掏空(--hollow --hollow-wall 1.6)以节省树脂和耗材。
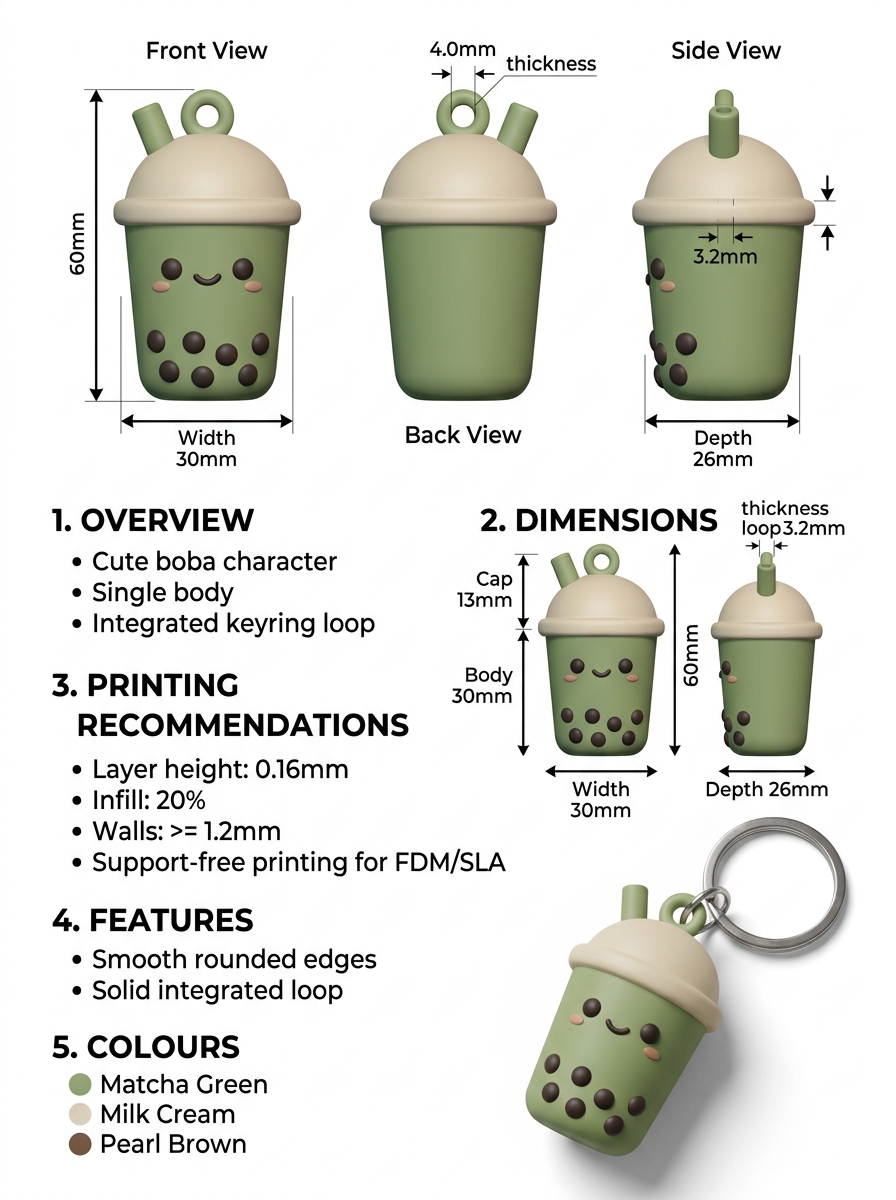
- 信息图设计稿(
keychain_boba_spec.jpg):一份带正交视图和尺寸标注的图纸(高 60 mm,钥匙孔 4 mm)。
- 压力测试(
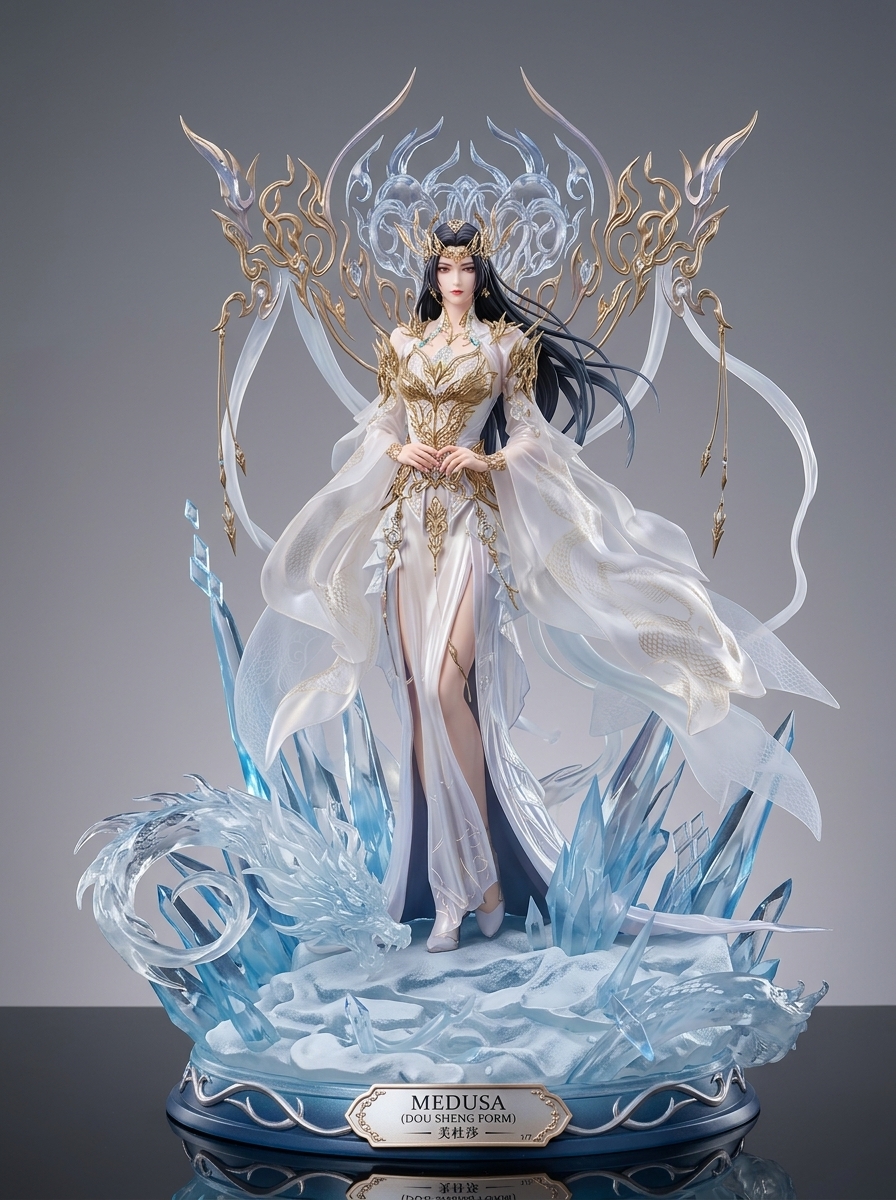
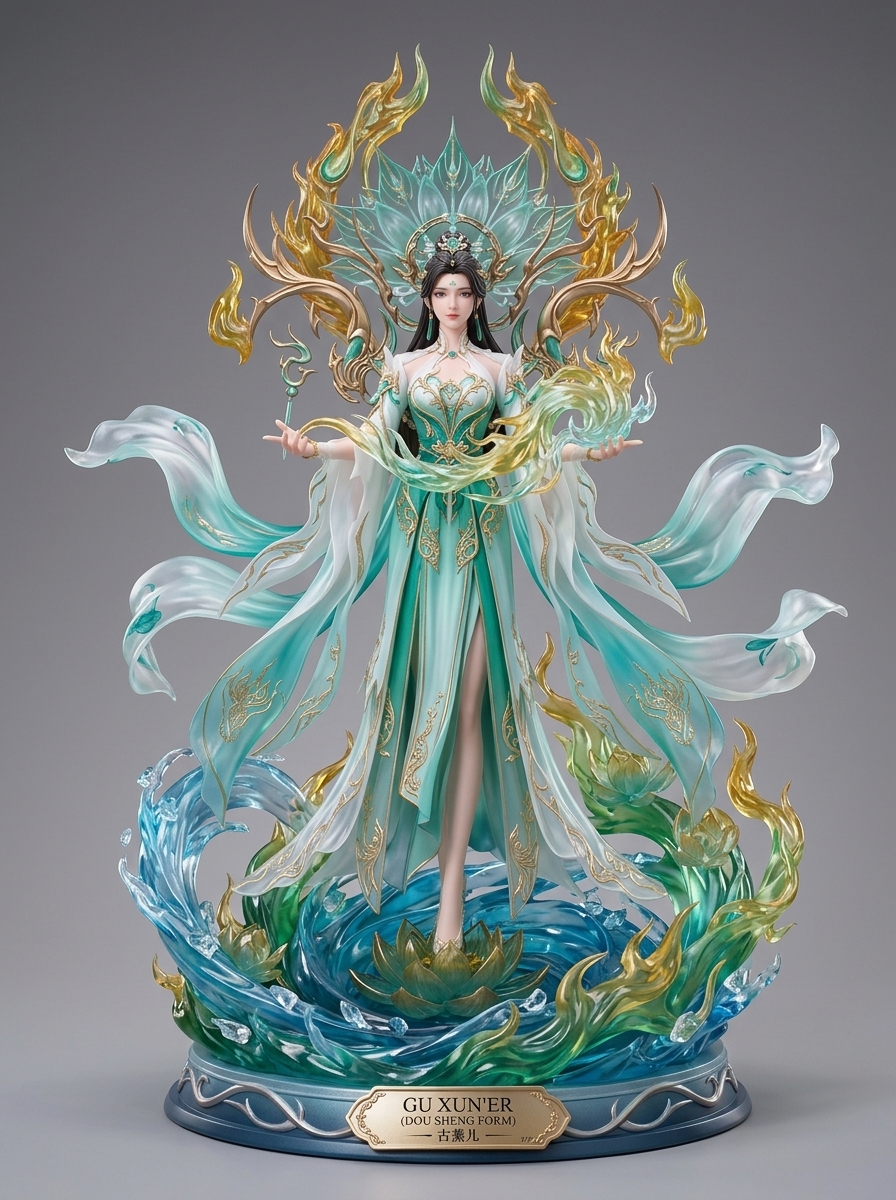
figure_medusa_scale_statue.jpg、figure_xuner_scale_statue.jpg):造型复杂的收藏级雕像,带有纯半透明布料和悬浮水晶结构。这些确实是真正的边缘案例,而不只是视觉上元素多,值得弄清原因:人物身后的飘动翅膀/面纱结构从hunyuan3d出来时变成了一块扁平、没有细节的板状物,而不是原本的网格细节——背后有两个叠加的原因,不是一个 bug。第一,u2net的背景移除模型主要用不透明主体训练,因此与背景之间边缘柔和、对比度低的半透明区域,往往会被当作“背景”剥掉,或者保留成一团没有形状的色块,而无法干净地分割出来。第二,即使蒙版完美,单图 3D 重建模型——主要用实心的日常物体训练——也倾向于把细密的蕾丝状或半透明几何压平,而不是还原出来。对于不透明材质的主体,这不是问题;对于由半透明布料、玻璃或水晶构成的主体,就要预期结果会被简化。目前没有任何参数能解决这一点——这是真实的能力上限,对于这种精细程度的作品,诚实的答案是摄影测量(30 张以上真实照片),而不是换一个更好的单图模型。
5. 视觉语言模型:它们真正擅长什么
printable 里有个很带劲的功能:VLM 引导的 spec-to-3D 生成。用户把一张设计规格表丢进管线——尺寸箭头、文字标注、正/背/侧三视图渲染——标准 3D AI 会把所有这些文字和版面当成几何体,生成一堆噪点。解法是先用一个本地 Vision-Language Model 读这张表,提取出结构化元数据(design_spec.json)以及真实物体的干净裁剪图,然后再跑几何生成:
# 1. Extract physical dimensions and clean crops via local VLM
printable generate-spec assets/examples/keychain_boba_spec.jpg

# 2. Reconstruct 3D mesh and automatically enforce target dimensions
printable generate --spec interim/design_spec.json --spec-all-views -b hunyuan3d
有一点得直说:第 1 步需要一个外部 VLM 服务器,它不在这个仓库里——这台机器上跑两个独立进程,llama-server-rocm 真正把模型装在内存里,前面再套一个轻量 FastAPI 代理,代理自己不加载任何模型。printable generate(不带 --spec)和手动后端的 Web UI 上传都不需要这些;只有规格表和 Auto-detect 这两条路径需要。
供参考,这是开发时实际用的 Qwen3.8-27B 配置:
# Download the vision projector
hf download unsloth/Qwen3.8-27B-GGUF mmproj-F16.gguf \
 --local-dir ~/models

mv ~/models/mmproj-F16.gguf \
 ~/models/mmproj-Qwen3.8-27B-f16.gguf

# Start the resident VLM server
llama-server-rocm \
 --model ~/models/Qwen3.8-27B-Q4_K_M.gguf \
 --mmproj ~/models/mmproj-Qwen3.8-27B-f16.gguf \
 --alias qwen3.8-27b \
 --n-gpu-layers 99 \
 --ctx-size 32768 \
 --parallel 1 \
 --flash-attn on \
 --jinja \
 --temp 0.7 --top-p 0.8 --top-k 20 --min-p 0 \
 --spec-type draft-mtp --spec-draft-n-max 2 \
 --kv-unified --fit off \
 --image-min-tokens 1024 \
 --host 0.0.0.0 --port 8080
为什么用
--ctx-size 32768? 早先的实验用262144,它会不必要地预分配一个巨大的 KV cache,加剧内存压力。而这里用的图像分类和提取提示词都很短,32K 已经绰绰有余,不必预留几十万个 token。
计划的大部分内容都原样保留了下来。但走到这一步的过程没有——而这段弯路让我对本地 VLM 究竟在哪些事上靠得住,比那个能跑的功能本身学到的还多。
弯路:两个不同的 bug,两个不同的模型
第一次尝试:Qwen2.5-VL-7B-Instruct,轻量级视觉模型里的显然之选。它立刻撞上一个真实且有记录的问题:llama.cpp 的 ROCm/HIP 视觉路径在 gfx1151 上会把任何图像输入搞乱(ggml-org/llama.cpp#17797)——这是驱动层面的 bug,不是改个配置开关能绕过去的。解决办法是彻底不用 llama.cpp 跑这个模型,改用 transformers/PyTorch 直接服务。
乱码问题解决了,但暴露出第二个不相干的 bug:让模型在一张图里找多个 bounding box——"找出正视图、背视图和侧视图"——它总能给第一个返回正确的框,然后后面几个就飘到无关的文字块上。这个问题上游也有记录(QwenLM/Qwen2.5-VL#1257):模型训练时用的指代表达式唯一确定 一个 实例,所以一旦要它同时定位多个相似目标,准确率从第二个开始就断崖式下跌。把提取拆成每个视图单独调一次 bounding box(而不是一次调用问全部)没用。把提示词改写成明确描述表格版面也没用。这个失败模式始终存在。
换模型——改用 Qwen3.8-27B,通过这台机器上常驻的 llama-server-rocm 提供服务(就是已经在跑本机文本模型的那个工具,走它兼容 OpenAI 的端点)——彻底绕开了 ROCm 乱码的 bug:用真实的描述和 grounding 调用验证过,它能正确读图。但它也有自己版本的同一个底层弱点:能可靠地 grounding 一张图里第一个、也就是视觉上最突出的视图,然后要么标错、要么干脆感知不到剩下的 caption,即使把 vision token 预算调高(--image-min-tokens 1024)、重写 prompt 让它明确锚定在印刷的 caption 文本上而不是靠视觉猜测,也一样。
真正的发现
两个不同的模型家族、两套不同的服务栈,失败形态却一样:对一张图做单一的整体判断是可靠的。在一张图里定位并正确标注多个区域则不是。 所有问「这整体是什么」的测试——描述它、分类它、提取尺寸——结果都准确。所有问「这 N 个东西具体在哪」的测试,过了第一个就开始退化。
这就重新定义了真正的工程问题。读 pipeline 代码确认了一件值得直说的事:printable 里没有任何一个 backend 会把多个视图融合成一次重建。 --spec-all-views 本来就只是把每个裁出来的 crop 当作独立的单图候选去试,留下重建效果最好的那个。所以正确的视图标注从来就不是输出质量的关键——只有 crop 的完整性才是。去追可靠的多视图 grounding,是在解一个根本不需要解的问题,用的还是这些模型本来就不具备的那项能力。
Auto-detect:顺着长处走,而不是硬碰短处
如果这些模型擅长的是单一整体判断,那有用的做法就是只问它这个——问一次——然后拿结果去路由到已有的、已经能跑通的 pipeline,而不是要求模型正确标注多个区域。
printable serve 的 Web UI 现在多了一个 Auto-detect 选项。一次分类调用就能判断上传内容的类型(设计规格图、角色三视图、人像、单物体照片,或“无法判断”——模型没把握时绝不瞎猜),判断结果再被送进一条现成且经过验证的流水线:
flowchart LR
 A["Upload"] --> B["One VLM call:
classify(image)"]
 B --> C{category}
 C -->|design spec sheet| D["spec extraction
-> hunyuan3d/triposr"]
 C -->|character turnaround| E["grid-split-and-pick-best
-> hunyuan3d/triposr"]
 C -->|portrait photo| F["lithophane"]
 C -->|object photo| G["hunyuan3d
(falls back to triposr)"]
 C -->|unclear| H["no mesh --
ask the user"]
分类结果——类别、一句话理由,以及选定的后端——会在生成开始前显示在进度面板里,所以它从来不是一次静默的猜测。路由这部分没有任何新工程;每个分支都是一条原本就能跑的命令。唯一的新代码是“先分类再路由”这一步,而它能奏效,恰恰是因为它只向模型问那一个它能稳定回答的问题。
6. Web 界面:printable serve
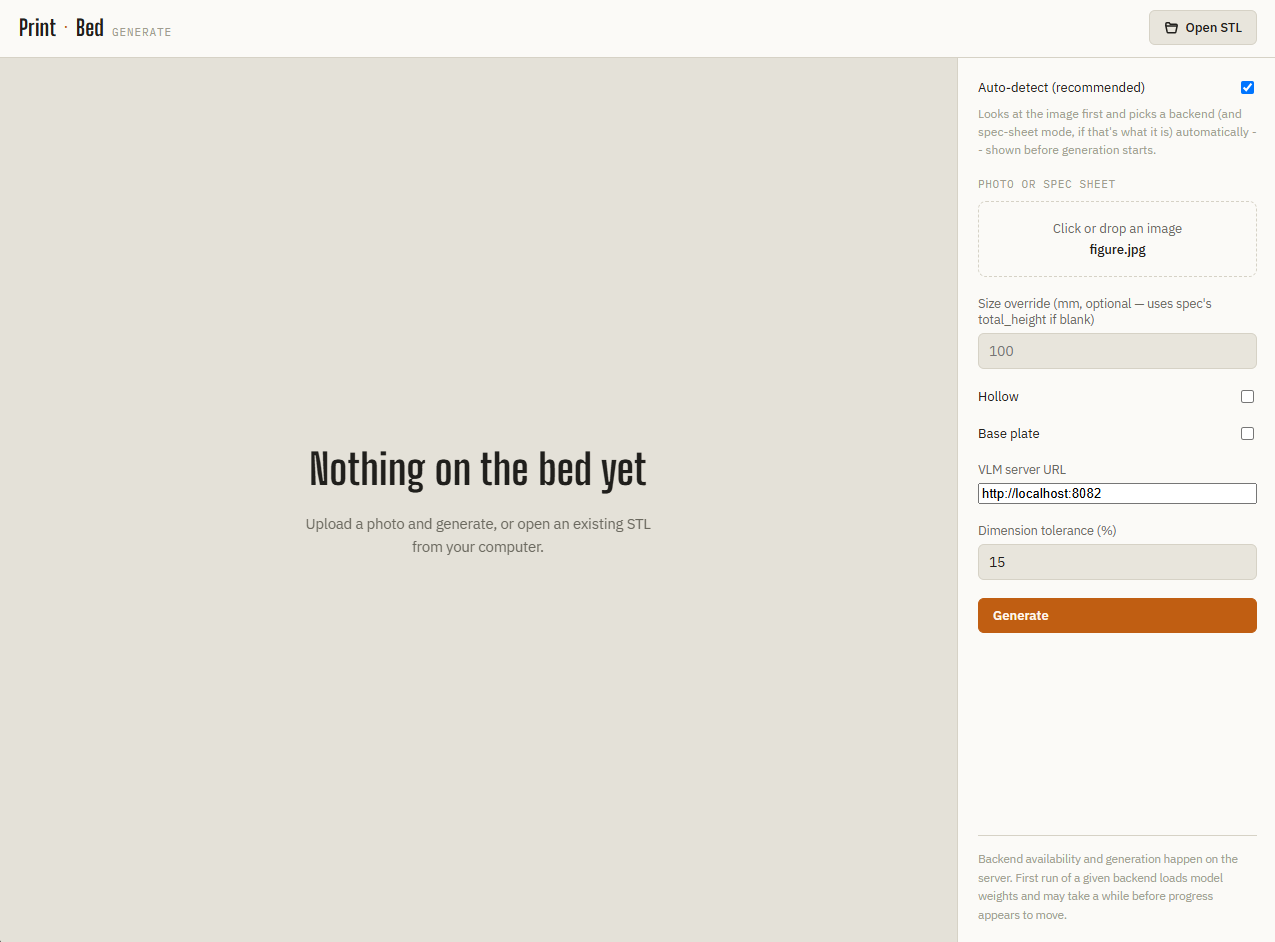
到这里为止讲的都是 CLI。printable serve 把同一条流水线包进了一个轻量的本地 Web 应用——适合在正式跑切片之前先看看规格图的裁切结果变成了什么样,也适合任何宁愿拖拽文件、不想记参数的人。
# ROCm: needs TORCH_ROCM_AOTRITON_ENABLE_EXPERIMENTAL=1 prefixed, same as any hunyuan3d CLI run
TORCH_ROCM_AOTRITON_ENABLE_EXPERIMENTAL=1 printable serve --host 0.0.0.0 --port 8000
打开打印出来的 URL,拖入一张照片,然后手动选一个后端(选项和 -b 一样),或者让 Auto-detect 保持开启——也就是上面说的“先分类再路由”。
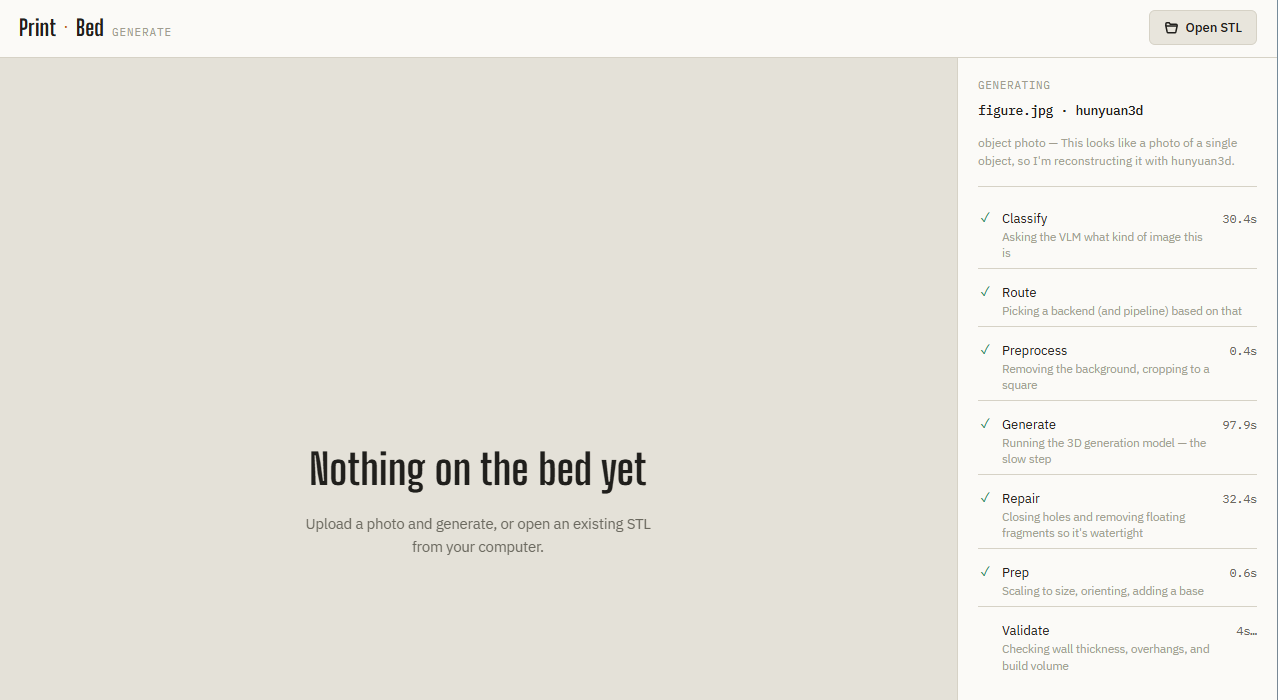
提交后会启动一个任务,并通过 Server-Sent Events 实时推送进度——不用轮询,也不用刷新页面。开启 Auto-detect 时,最先出现的就是分类结果本身:类别、一句话理由,以及它路由到了哪个后端,这一切都发生在生成开始之前。
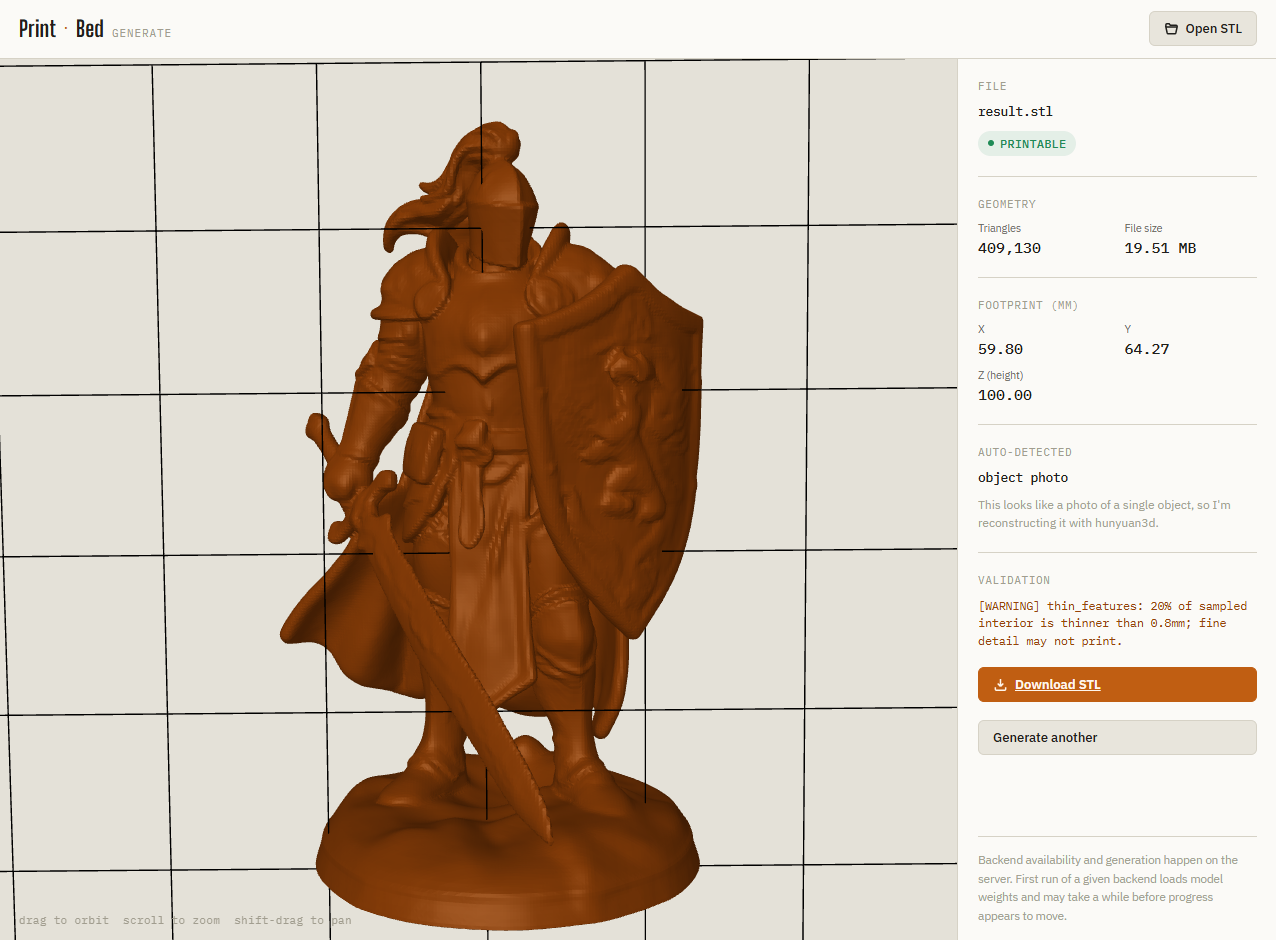
任务结束后,结果面板会同时提供用于打印的 .stl,以及(对支持的后端,即搭配 texture=true 的 TripoSR)带颜色的 .glb 预览下载——正是 §3 的 TripoSR 概览和 §10 的状态总结里提到的那一对。
7. 面向生产的加固:三个互不相干的内存 Bug
让一个长期运行的 Web 服务器去跑真实的 GPU 负载,暴露出了一连串内存溢出崩溃。真正有启发的不是某一次修复——而是在整个排查过程中,“OOM”从来都不是同一个 bug。它是三个互不相干的原因,恰好表现出同一种症状;如果把它们当成一个问题来处理,就会一次又一次地追着错误的修复方向跑。
-
孤立的重复进程。 本地 VLM 服务器每次重启(换了新参数,或从早先的崩溃中恢复),之前的
llama-server-rocm进程有时会变成 stopped 状态而非被终止——模型权重仍完整占着内存,只是进程被挂起了。在一次长时间会话中,这样的进程悄悄攒到了三个,白白吃掉约 9 GB 内存才被人发现。ps显示同一个服务器有多个实例,这就是线索;对残留进程执行kill -9(只用kill触及不到 stopped 进程)立刻收回了内存。 -
KV cache 开得过大。 VLM 服务器启动时用了
--ctx-size 262144——预分配了 25 万 token 的上下文,启动时就按这个量分配,与实际用量无关。这条流水线的 classify/extract 调用——一张图、一段短提示、一个限长的补全——真实需求从没超过大约 13,500 token。降到--ctx-size 32768(余量仍然充足,比之前小 8 倍)之后,之前必定触发崩溃的那张图不再崩溃了。 -
每次调用都重新加载模型。 这个问题出在
printable自己的代码里,不在 VLM 服务器。后端注册表在 每一次 生成调用时都会新建一个后端实例——并从磁盘重新加载整个模型,包括同一次 CLI 调用内部多面板或多视图循环中对同一后端的重复调用,而不只是不同的 Web 请求。同一个服务器进程里连续三次hunyuan3d生成,每次都完整重载约 110 秒,到第三次就把内存耗尽了。修复办法是按名称缓存后端实例,并在底层工厂发生变化时自动失效——这个细节在实践中很重要,因为正是它让现有测试套件在宣布修复完成之前抓到了一个真实的回归(一个为测试替换假后端的用例,被缓存中残留的真实实例遮蔽了)。
这些修复没有一个是猜出来的。每一个都从内核 OOM killer 的日志行、systemctl/journalctl 跟踪或可复现的测试失败中定位到根因,并且每一个都通过复现原始故障、确认不再发生来验证——而不是因为推理听起来对就认定修好了。
8. 评估 lemonade-sdk 作为替代方案
lemonade-sdk/lemonade 是一个社区项目,有 AMD 工程师参与贡献,明确面向 Strix Halo/gfx1151,并且自行维护了一个 ROCm llama.cpp 分支,而不是包装官方构建。相比手动运行 llama-server-rocm,它看起来是个有前途、维护成本更低的替代方案——统一的服务器管理、模型目录、AMD 调好的默认参数,不用自己推导命令行标志。
评估过程中确实遇到了不少摩擦,值得如实记录,而不是一笔带过:
- 版本差距。 通过 PPA 安装的 CLI 报告的是
10.2.0;项目官网目录反映的是更新的11.8.0。网站上展示的一个模型带有可直接复制的lemonade pull命令,但在本地执行却因命名空间错误而失败,原因就是这个模型根本还没进入已安装的旧目录。手动注册(--checkpoint main/mmproj、--recipe llamacpp)绕过了这个问题。 - 缓存位置的意外。
lemonade pull首次运行返回成功快得可疑,没有任何实际的下载进度——后来发现,这是根据早于本次拉取的文件时间戳,误判为“共享同一个模型缓存”。Lemonade 实际上作为独立的 systemd 服务运行在专用的系统用户下,模型缓存完全独立——第二次运行才显示出真正的传输进度,写入那个独立位置。这提醒我们:一条快速的“成功”消息并不能证明服务实际做了什么;在整个评估过程中,它自己的日志(journalctl -u lemonade-server)是唯一可靠的事实来源。 - 他们自己推荐的模型加载失败。 逐字节对照 Lemonade 自己的模型注册表(不只是网站)验证过,所用的拉取命令完全正确——而且这是他们针对该用例的
"suggested": true模型。它仍然失败了:在这套硬件上,他们的 ROCm 后端报出llama_model_load: error loading model: missing tensor 'blk.64.ssm_conv1d.weight'。这个张量名称本身就是个小发现——ssm_conv1d/ssm_d_inner/ssm_d_state证实 Qwen3.8-27B 是 SSM/Mamba+attention 混合架构,而非普通 transformer,这很可能正是通用 GGUF 转换流程会漏掉某个 SSM 层所需张量的原因。这不是这边的错误;而是截至本文写作时,他们的 gfx1151 ROCm 支持对这个特定模型存在的真实缺口。
搁置,不等于放弃。这次评估原本要回答的实际问题——手搓的那套环境该不该换掉——已经有结论了:暂时不换,现有的 llama-server-rocm 配置原样继续跑。等 Lemonade 对这个型号的 ROCm 支持成熟了,再回头看。
9. 评估更新的 ROCm/TheRock 技术栈:当天就回滚的回归问题
ROCm/TheRock 技术栈迭代得足够快,值得拿新包在已知可用的环境上试一把,而不是想当然地认为旧配置仍然是最优解。
实验结果挺有意思:新版 PyTorch 在 ROCm attention 路径上确实有实打实的提升,但整个环境一升级,printable 依赖的原生扩展就暴露出兼容性问题。
于是旧环境继续作为生产基线,新栈只当作实验分支处理。
以下结论有实测数据支撑,不是推测:
| PyTorch 版本 | 未加 flag 的 attention | AOTriton 实验性 flag |
|---|---|---|
| 7.13.0a20260513(已知可用) | 106ms/次,触发警告 | 8.66ms/次 |
| 10.1.0a20260829(实验性) | 约 4.7ms/次,无警告 | 约 4.7ms/次 |
这个结果很关键:新版本上不加 flag 的 attention,已经比旧版本上加 flag 的还快。所以继续盯着新的 ROCm 技术栈,是有实打实的性能理由的。
真正搞坏 printable 使用的地方
用 triposr 重新生成测试网格——它会从源码编译 torchmcubes,一个原生 marching-cubes 扩展——报错如下:
vol must be a CPU tensor
直接原因是 torch 升级之后,uv 的缓存里复用了一份旧的 torchmcubes 构建产物。清掉缓存、强制重新构建,这个报错就没了。
但紧接着暴露出第二个问题:新版 nightly 的 ROCm/CMake 打包本身,跟这条流水线用的原生扩展构建方式还不兼容。Torch 的 LoadHIP.cmake 在解析一个空的 HIP 版本变量时挂了:
math cannot parse the expression: "( * 100) + ": syntax error
较新的环境还需要额外配置 ROCm SDK,因为在对应的开发包初始化之前,找不到预期的 hip-lang CMake 配置。
决定:回退,而不是硬推
到这一步,正确的工程决策是回退,而不是把一个能正常工作的生产环境搞乱。
我重装了已知可用的 PyTorch 版本,针对它干净地重新编译了 torchmcubes,恢复了 printable 锁定的依赖,并再次验证了完整链路:
printable generate character.png --backend triposr --size 80 --sheet
→ PRINTABLE
完整测试套件重新全绿。
所以结论并不是「新的 ROCm 栈不行」。恰恰相反:attention benchmark 的结果令人鼓舞。结论是,在测试时,较新的栈还不能直接替换这套 Python 与原生扩展混用的特定工作负载。
对 printable 来说,旧环境仍是已知可用的基线。随着 TheRock 新栈在打包和原生扩展兼容性上逐渐成熟,值得重新测试。
10. 下一步:Hunyuan3D 纹理绘制
下一个里程碑不是基础的彩色 GLB 导出——那条路已经通过 TripoSR 跑通,前面也讲过了。还没做完的,是让 Hunyuan3D 的纹理绘制流水线在 AMD 上稳定运行。
这一点值得说清楚,因为「ROCm 还不支持」低估了它实际推进的程度。Hunyuan3D-2.1 自己的 README 里,这条流水线没有任何 ROCm 或 AMD 支持说明——这里描述的移植工作完全是本项目自己做的适配。
形状生成(printable 实际发布的部分)需要不少工作,但不涉及 GPU kernel 移植:一个自相矛盾的 requirements.txt 得手动过滤掉,为 hy3dshape 补写了一个缺失的 setup.py,还需要 TORCH_ROCM_AOTRITON_ENABLE_EXPERIMENTAL=1 来绕过 PyTorch 的 ROCm attention dispatcher。底层上,形状模型主要由 PyTorch 算子组成,所以用原生 ROCm 构建就能跑通。
纹理绘制则是另一回事。这里尝试了真正的 kernel 级移植,而不是止步于装依赖。custom_rasterizer 和第二个扩展 DifferentiableRenderer 通过 hipify 后的构建,为 gfx1151 原生编译。
让流水线跑通,前后修了六个互不相干的兼容性问题:
diffusers版本漂移- 缺少 Blender Python wheel
torchvisionAPI 变了- 上游 checkpoint 路径不一致
- 缺少系统 OpenGL 库
trimesh版本漂移
这些全部解决之后,剩下的那个失败才是真正的 GPU 故障。
custom_rasterizer 经过 hipify 的 kernel 可以稳定复现 [gfxhub] page fault,dmesg 中能看到 amdgpu ring timeout 和 GPU reset。驱动没有重启就恢复了,但 Radeon 8060S 是集成 GPU,这次 reset 也短暂影响了机器上其他使用 GPU 的进程。
所以这和前面那些依赖问题性质完全不同:流水线可以修到能构建,但 rasterizer kernel 本身在这套 ROCm 配置上还不可靠。
完整的安装与排查记录放在 docs/SETUP.md。
目前的结论:
- STL 生成: Hunyuan3D 2.1
- 快速/草稿生成: TripoSR
- 彩色 GLB 预览: TripoSR
- Hunyuan3D 贴图绘制: 实验性 / 在 AMD 上受阻
- 工程上的首要任务: 盯上游改动,或者换一套 ROCm / kernel 组合来测,而不是把可复现的 GPU page fault 遮过去
结论与代码
做 printable 的过程让我意识到,把 2D 图像变成现实中的 3D 物体,远不只是模型权重的事——真正见功夫的是那些不起眼的环节:网格修复、布尔运算、朝向优化和物理校验。
整个项目以 MIT 许可证开源:
👉 GitHub 仓库:seehiong/printable
如果你有 AMD 或 NVIDIA 显卡,也有一台 3D 打印机,把仓库 clone 下来,跑一遍 uv sync,试试把你最喜欢的角色设定图或人像变成实体模型。
评论(0)
登录账号后即可参与讨论。