写真から印刷可能な3Dへ
オープンソースの printable は、写真を水密でミリ単位、そのままスライスできる STL に変換する。AMD の ROCm 上で 5 段のパイプラインとして動かし、4 つのバックエンドの水密性を実測比較している。
日本語
コピー
Meshy.ai、Hi3D、CSM(Common Sense Machines)といった商用 3D 生成ツールを触ったことがある人なら、2D 写真を放り込むだけで 3D モデルが出てくるあの感覚がどれほど凄まじいか分かるはずだ。ただ、AMD ワークステーションで作業するメイカー兼開発者として、ずっと引っかかっていたことが二つある。
- こうしたパイプラインは、現代のオープンソースモデルで実際どうやって動いているのか?
- スライスして印刷できる STL を直接出力する完全ローカルなパイプラインは組めるのか? 見るだけのビジュアルメッシュではなく。
オープンソースの趣味プロジェクトが商用の多視点再構成エンジンを一夜にして置き換えるわけではない。それでも、オープンソースの部品だけで写真から 3D を作るツールをゼロから組むと何が必要なのか、自分の手で確かめてみたかった。その成果が printable だ。写真、キャラクターの三面図、エンジニアリング仕様を、水密でミリ単位の STL に変換し、実在の 3D プリンタの制約に照らして検証する Python ツールキットである。以下では、その組み立て方、モダンな 3D AI で AMD ハードウェア(Strix Halo / ROCm)を動かすときに踏んだ罠、そしてどのやり方が一番うまくいったかを書いていく。
1. 本当の問題は「メッシュを渡す」か「印刷できる部品を渡す」か
オープンソースの生成 3D プロジェクトの多くは、それらしい見た目のメッシュを出すところで止まる。出力は OBJ、PLY、GLB だったりして、3D ビューアでは美しい。だが OrcaSlicer、PrusaSlicer、Bambu Studio に読み込んだ瞬間、現実がやってくる。
- 非多様体ジオメトリと開いたエッジ:メッシュの穴は、スライサーに壁線を取りこぼさせたり、空洞を誤って埋めさせたりする。
- 切り離された浮遊片:浮島はレジン印刷でも FDM 印刷でも災難だ。
- 座標系とスケールがでたらめ:メッシュが任意の バウンディングボックスに押し込まれ、実世界のミリ尺度がない。
- ビルドプレートとの接触が不安定:見た目だけを狙った自動オリエンテーションは、立っている人型を平らに寝かせたり、ごく小さな接点だけでモデルを立たせたりする。下に平らな底板がないまま。
printable では、AI 生成は 5 段階パイプラインの第 2 段階にすぎない。
flowchart LR
 A["2D Photo / Spec Sheet"] --> B["Preprocess & Background Keying"]
 B --> C["Geometry Backend (Hunyuan3D / TripoSR / CPU)"]
 C --> D["Repair Ladder (Manifold, Islands, Poisson)"]
 D --> E["Print Prep (Scale mm, Auto-Orient, Base, Hollow)"]
 E --> F["Validation Gate (Thin walls, Overhangs)"]
 F --> G["Slicer-Ready STL"]
メッシュが水密にできなかったり、最小壁厚のルールに違反したりすれば、パイプラインは検証ゲートでエラーを出す。壊れた STL を渡して、3D 印刷が 8 時間目に失敗する、という事態にはしない。
2. ハードウェアの壁:AMD ROCm(Strix Halo)で 3D AI を動かす
- BIOS 設定:
UMA Frame Buffer Sizeを 512 MB に設定し、Linux のamdgpuドライバが GTT 経由でシステムメモリから計算用 VRAM を動的に割り当てられるようにする。 - PyTorch 環境:このプロジェクトで動く環境は、AMD の
gfx1151向け ROCm/TheRock ビルドを使う。ただし nightly のインデックスが肝心だ。AMD は ROCm/TheRock の配布構成を調整し続けているので、ある時点で使えたインデックスが、現在のローリングビルドを提供しているとは限らない。
# Example of the gfx1151-specific PyTorch environment
# Use the currently published TheRock index appropriate to your installation.
uv pip install --index-url https://rocm.nightlies.amd.com/v2/gfx1151/ torch torchvision
重要:上のコマンドは特定環境でのスナップショットにすぎず、一度書けば済むインストール手順ではない。このプロジェクトを進める中で分かったのは、あるインデックスが最新の nightly ソースに見えても、実際には古い固定バージョンを返してくる場合があるということだ。後の
TheRockではインデックスとパッケージ命名の方式が変わったが、新しいスタックはこのマシンにネイティブ拡張と CMake の互換問題を持ち込んだ。A/B テストとロールバックの全過程は §9 にある。AMD の ROCm 10.0 発表はこの移行の大きな背景を説明している。TheRock は現在、ROCm 10.0 を支える自動ビルドとリリースの基盤であり、ROCm コンポーネントとフレームワークパッケージをより統一されたリリースパイプラインに載せている。
3. バックエンド評価:使えるもの、使えないもの
単一画像と多視点入力の扱いを見るため、いくつかの生成手法を試した。肝心なのは実験と、現在の printable で実際にリリースされているバックエンドの違いだ。TRELLIS と SPAR3D は開発段階では有用な実験だったが、どちらも現在のバックエンドレジストリには入っていない。生成されるトポロジが、その後の印刷可能化処理にとって常に厄介ごとだったからだ。
| バックエンド | ハードウェア | 典型的な速度 | メッシュ品質 | スライス時の水密性 |
|---|---|---|---|---|
| TRELLIS(AMD 実験) | GPU | ~30s | 視覚的ディテールは良好 | ⚠️ トポロジが破綻/非連結 |
| SPAR3D(AMD 実験) | GPU | — | 伸びしろあり | ⚠️ 複雑なポーズで多体の断片が出る |
| TripoSR | GPU + CPU | ~10s | 粗い/ドラフト級 | ✅ 高速な印刷パイプラインには十分きれい |
| Tencent Hunyuan3D 2.1 | GPU | ~1〜2 分 | ⭐ 高忠実度 | ⭐ 最良:緻密で連続した単一ソリッド |
現在のprintableバックエンドは 4 つ:
heightmaplithophanetriposrhunyuan3d
TRELLIS と SPAR3D には歴史的な意味がある。このパイプラインがなぜ最終的に Hunyuan3D に傾いたのかを説明してくれるからだ。ただしリリース済みのコードベースでは、もはや選択可能なバックエンドではない。
-
TRELLIS と SPAR3D:どちらも見た目は有望だったが、生成したメッシュを実際の印刷パイプラインに通して初めて、それぞれの破綻の仕方が露呈した。TRELLIS は互いに接続していないシェルを頻繁に生成し、ブール和が通らない。SPAR3D は複雑なキャラクターのポーズを複数の身体に分解してしまう。Hunyuan3D のほうが後段の修復と印刷準備で一貫して適していると判明したため、どちらも削除した。誤解を招く「対応」オプションとして残しておくべきではない。
-
Hi3DGen:検討したが、試していない。 紙の上では悪くなさそうに見えるが、スパース畳み込みへの依存が AMD 優先のパイプラインでは魅力を欠く。ROCm 対応が改善すれば、将来の評価候補にはなる。
-
TripoSR:驚くほど速く(約 10 秒)、依存関係もほぼ癖がない。下書きモードの生成器と、アクセラレータのスパイクテストを担う。表面の頂点で triplane デコーダ(
--opt texture=true)をクエリすることで、STL を書き出しつつ色付きの.glbプレビューも同時に出力できる。 -
Tencent Hunyuan3D 2.1:私の AMD ワークステーションでは完全にこれが勝ち。 形状モデル(
hunyuan3d-dit-v2-1、約 7.4 GB)が生成するジオメトリは緻密で構造が堅牢、二次誤差メトリクスによる簡略化や内壁のくり抜きに耐え、潰れない。
ROCm のヒント:ROCm 上で Hunyuan3D 2.1 の flow matching を動かすには、PyTorch の実験的な AOTriton アテンションカーネルスケジューラを有効にする必要がある:
TORCH_ROCM_AOTRITON_ENABLE_EXPERIMENTAL=1 printable generate assets/examples/figure.jpg \
-b hunyuan3d --size 80 --hollow --hollow-wall 1.6 --max-faces 500000 --no-base
4. ベンチマーク素材と Antigravity の例
外部の Web URL に頼らず各パイプラインを体系的にテストするため、参考素材を assets/examples/ にまとめた(大半は Google Antigravity と Stable Diffusion 1.5 で作成し、ベンチマークを実施):
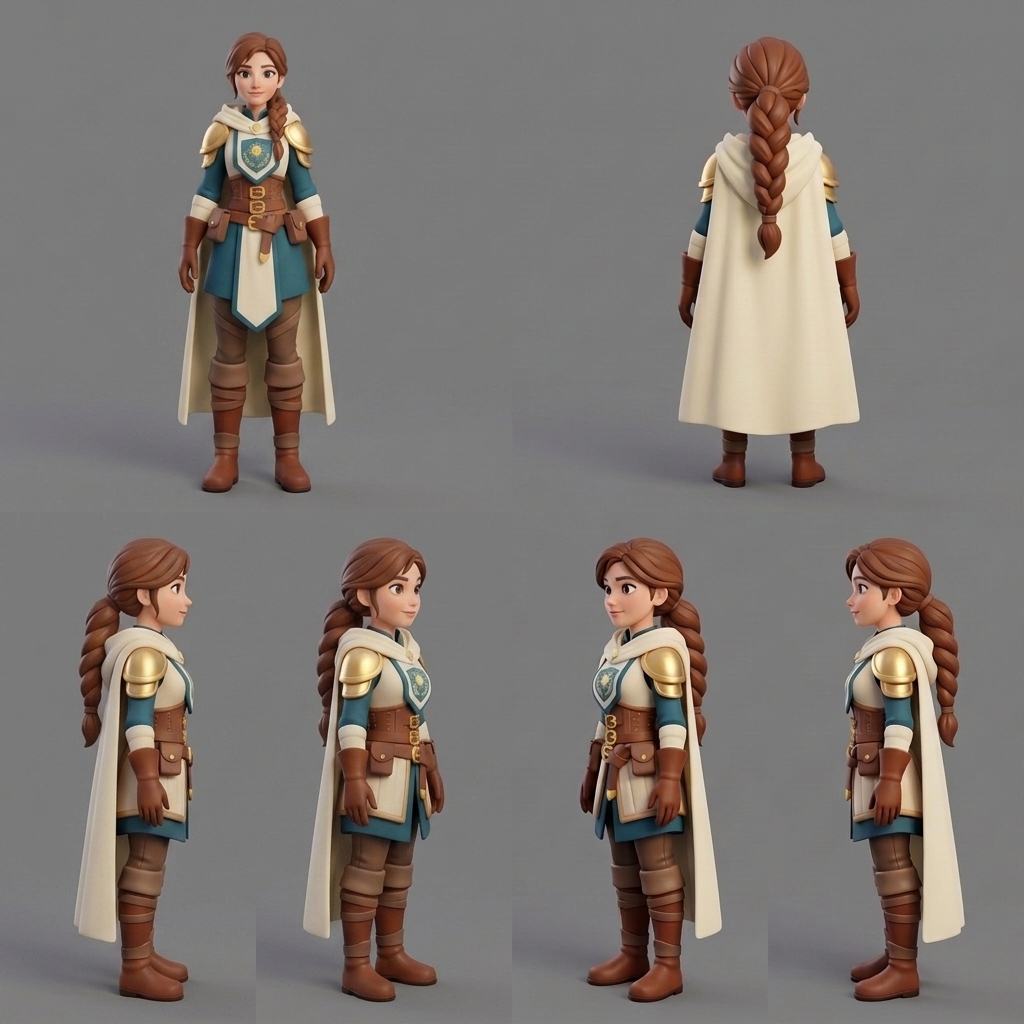
- 多視点ターンテーブル画像(
character_female_turnaround.png):単一画像の 3D モデルは、見えない部分を推測するしかない。多視点ターンテーブル画像は 4 方向(正面、背面、左側、右側)を提供する。printable generate --sheetと組み合わせると、パイプラインは実際の継ぎ目に沿ってターンテーブル画像を分割し、すべての断片を個別に完全再構成したうえで、水密性と印刷適性が最も高い結果を自動的に採用する。
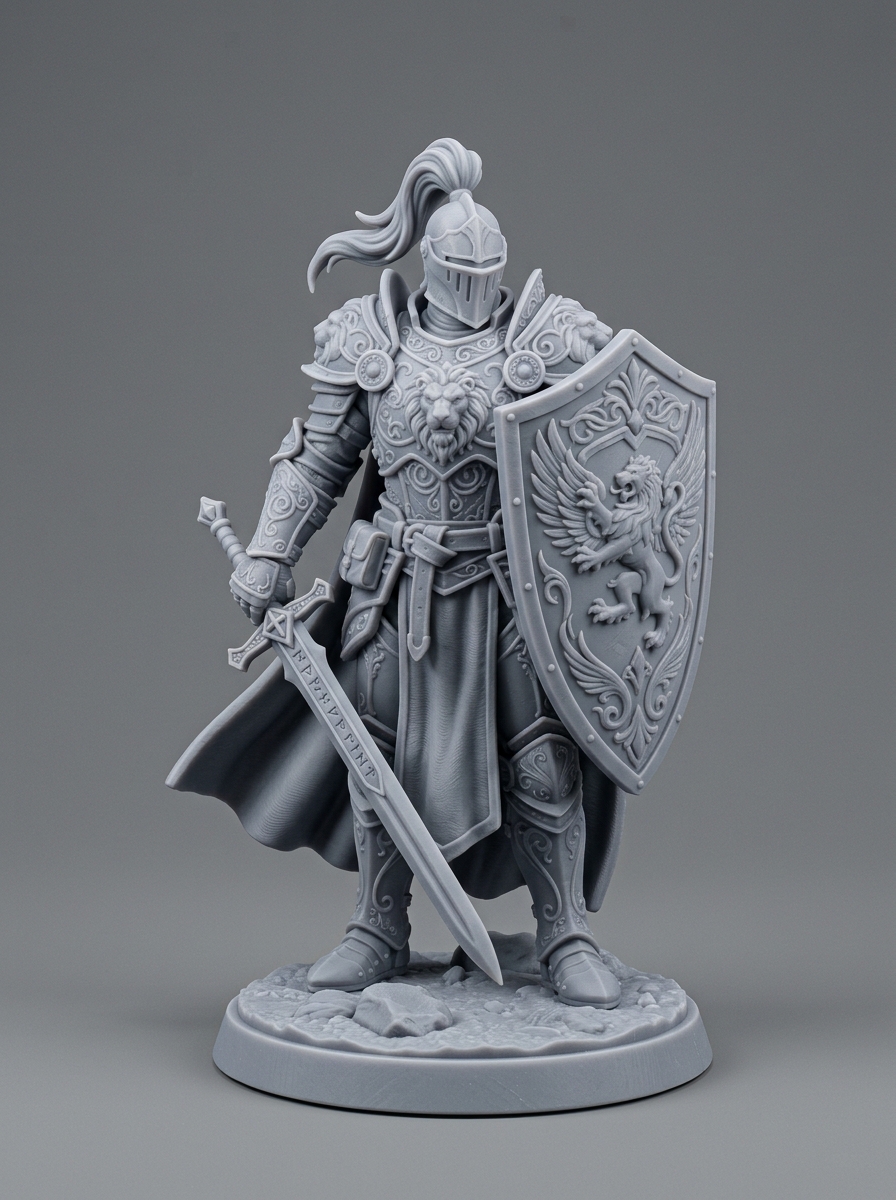
- ミニチュア(
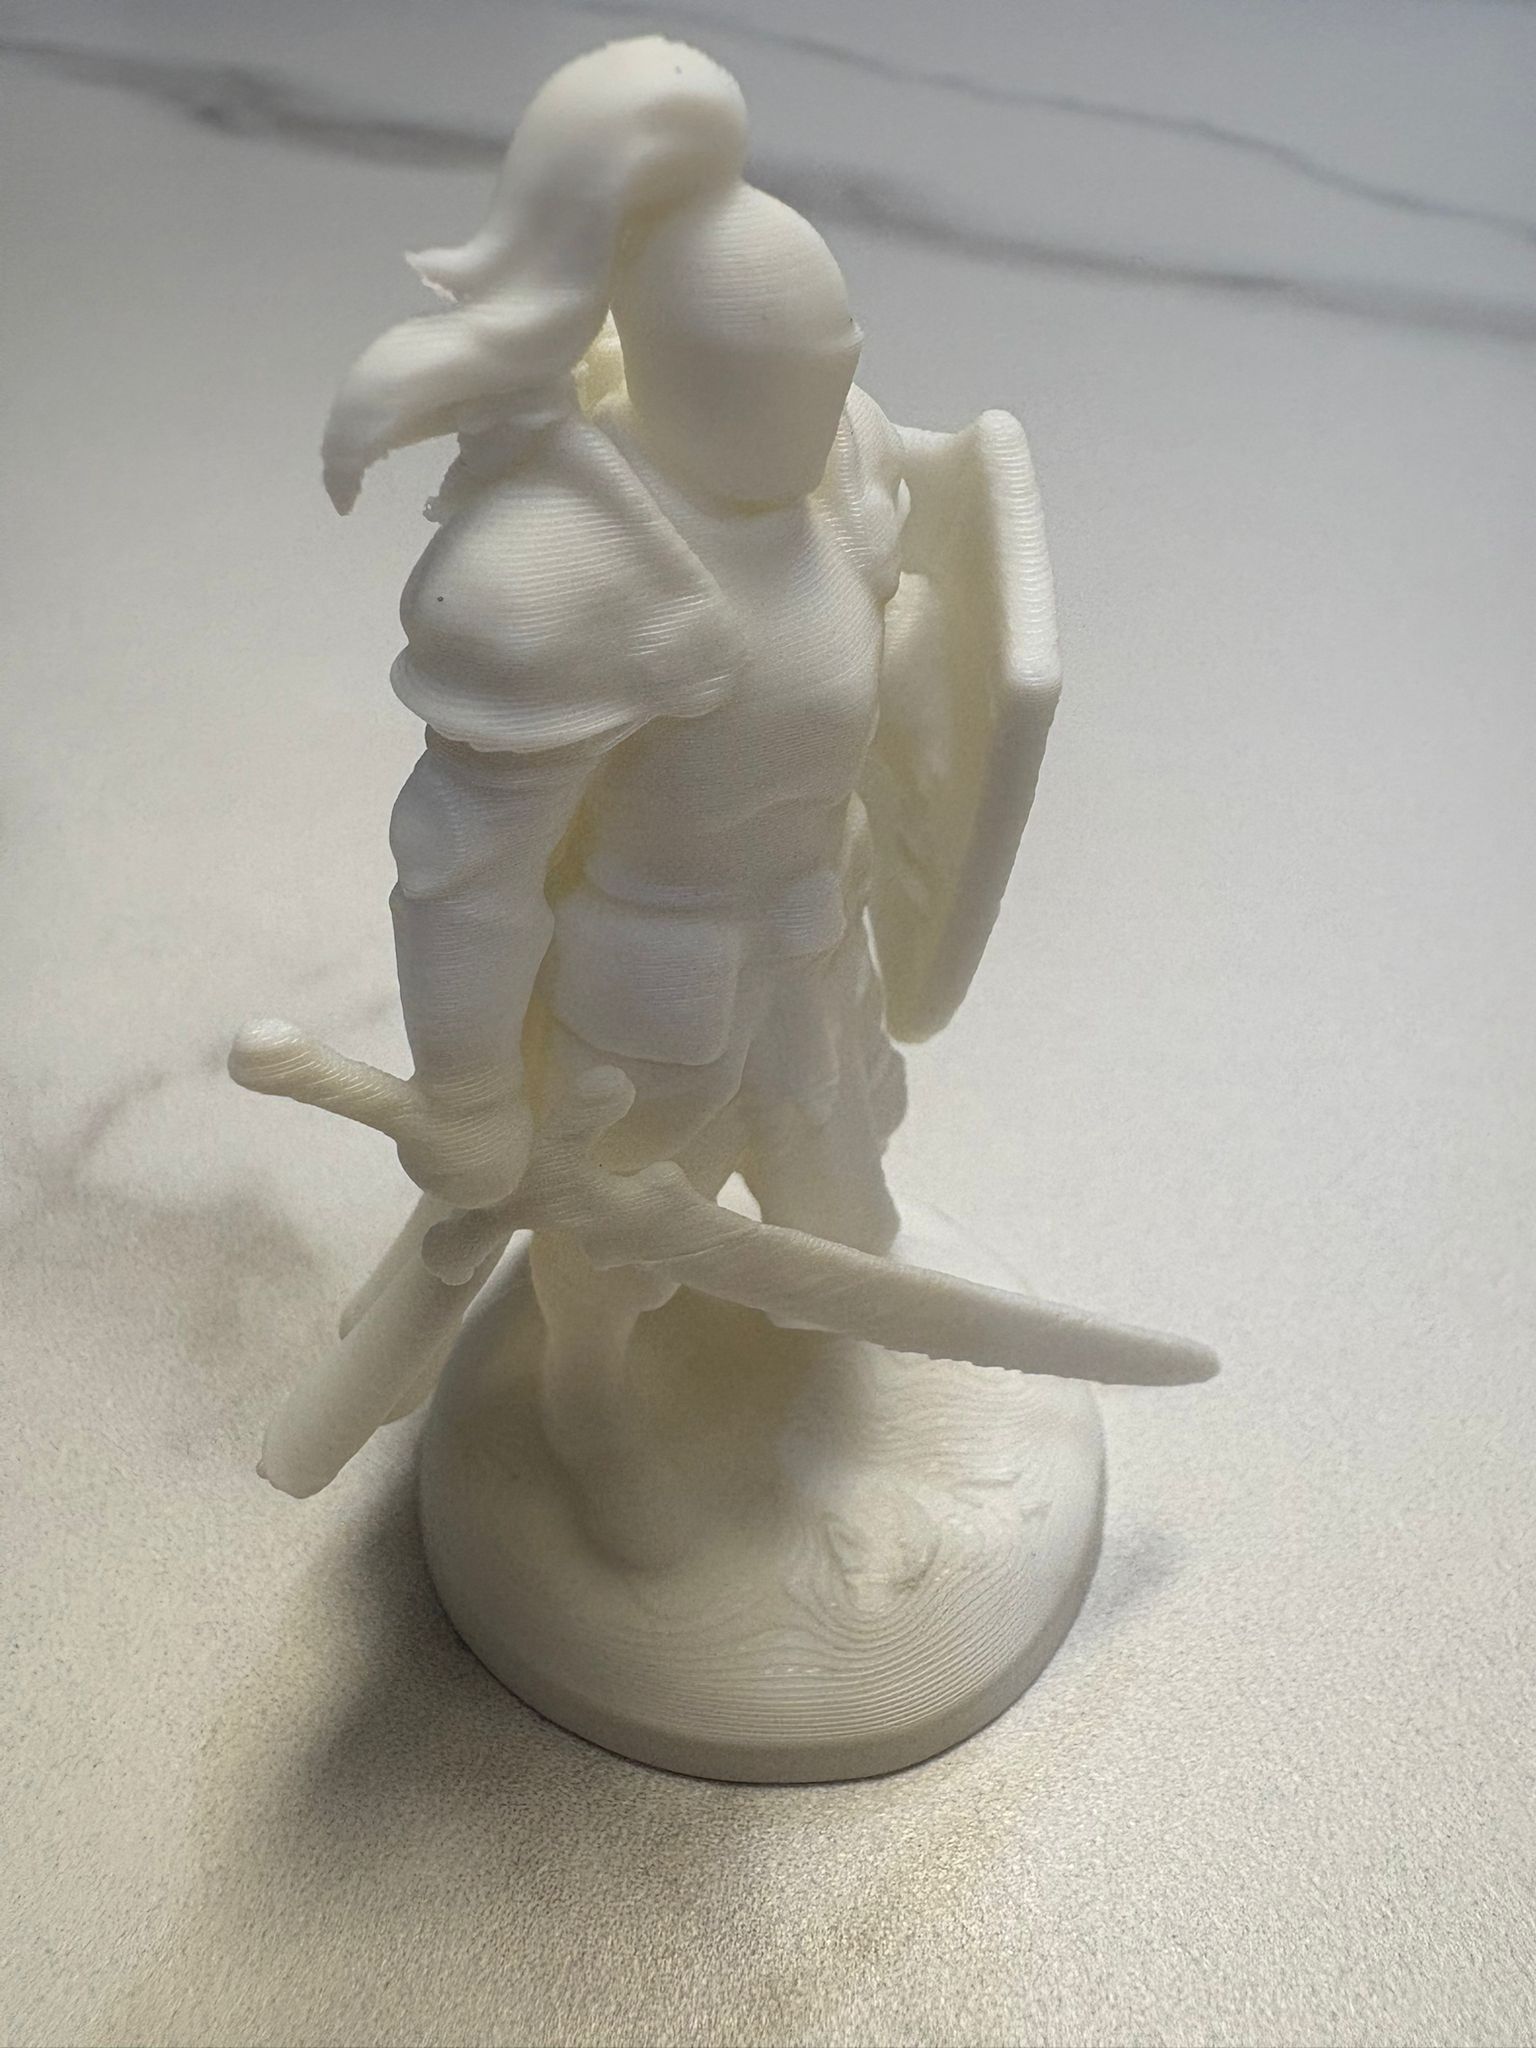
figure.jpg):パラディンのモデル。内部壁面のくり抜き(--hollow --hollow-wall 1.6)によるレジンとフィラメントの節約をテストするために使う。
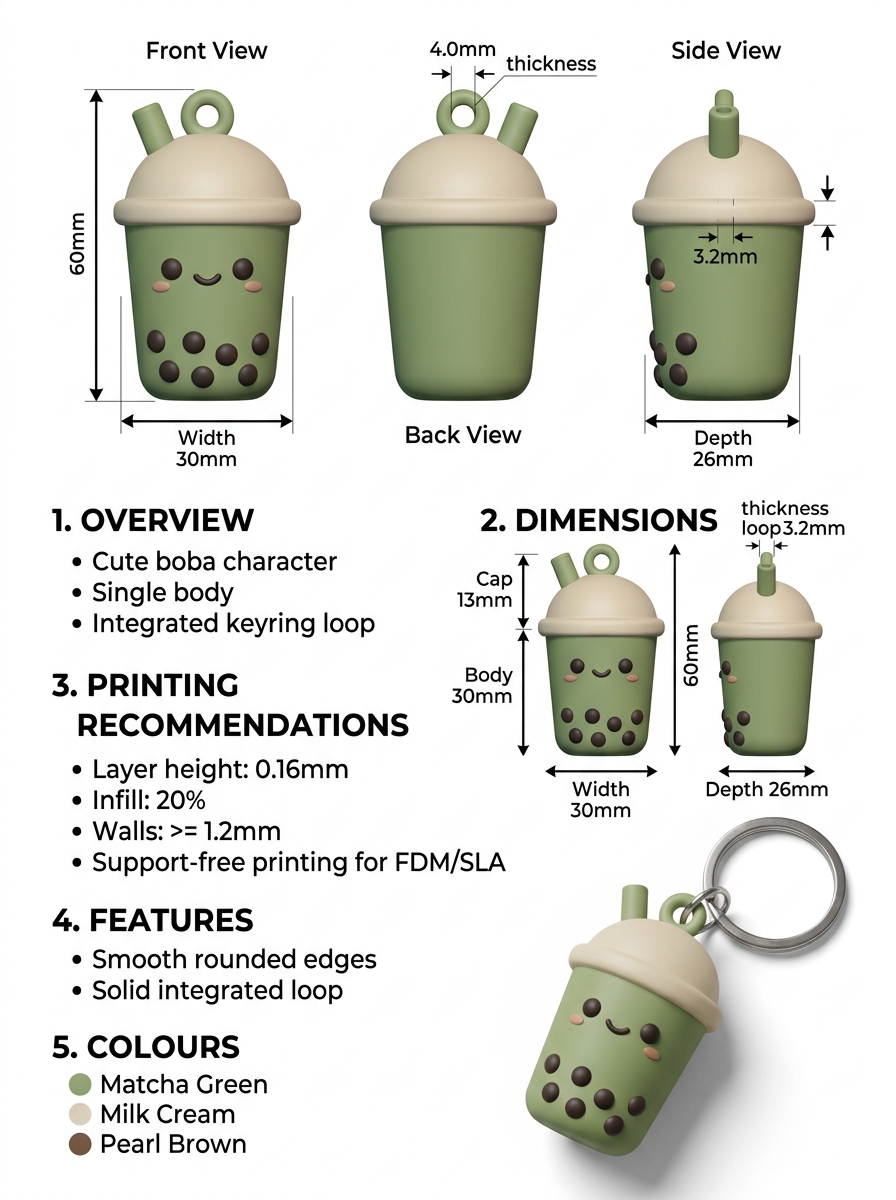
- インフォグラフィックの設計図(
keychain_boba_spec.jpg):正投影図と寸法注記付きの図面(高さ 60 mm、キーホール 4 mm)。
- ストレステスト(
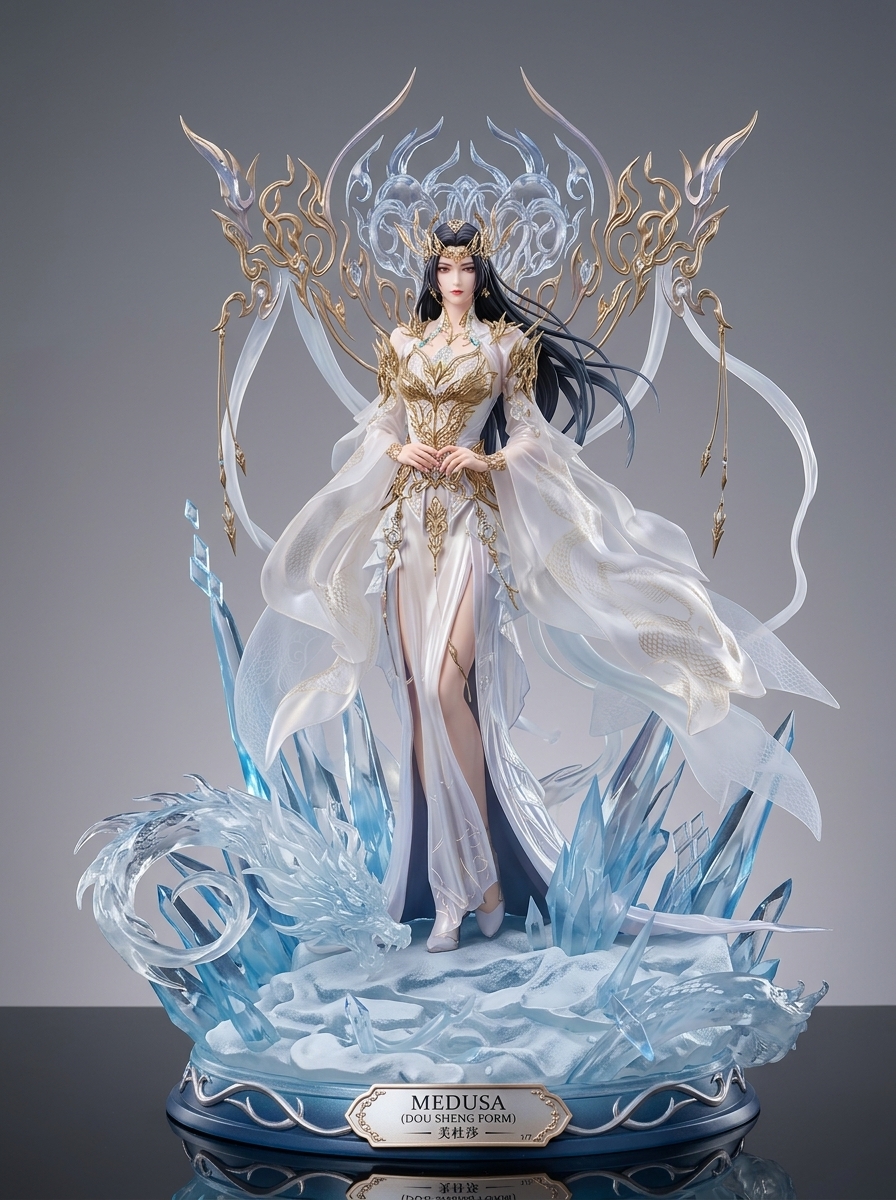
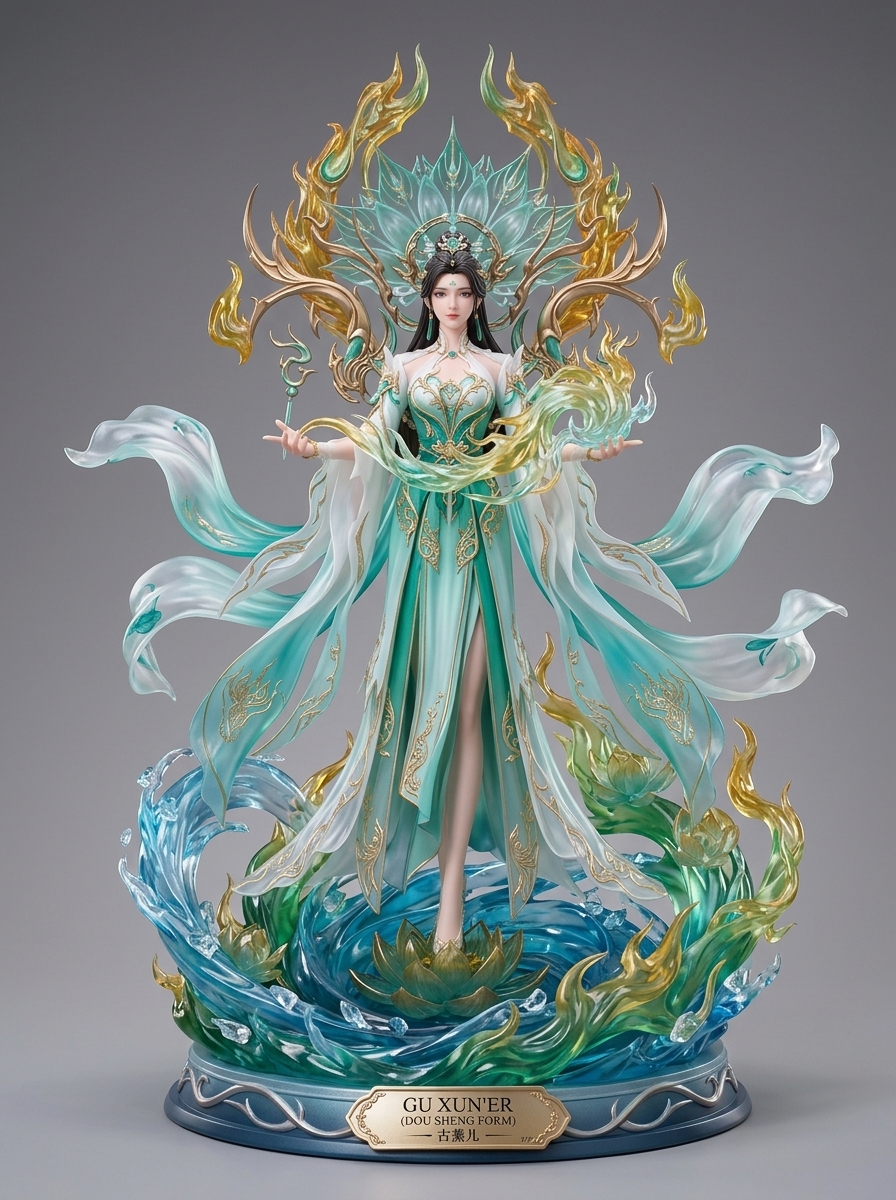
figure_medusa_scale_statue.jpg、figure_xuner_scale_statue.jpg):複雑な造形のコレクター向けフィギュアで、半透明の布と浮遊するクリスタル構造を持つ。これは見た目に要素が多いだけでなく、本当に限界的なケースであり、原因を突き止める価値がある。人物の背後にあるなびく翼/ベールの構造は、hunyuan3dから出てくるとき、本来のメッシュのディテールではなく、平坦で細部のない板状のものになる。背後には重なった2 つの原因があり、バグは 1 つではない。第一に、u2netの背景除去モデルは主に不透明な被写体で訓練されているため、背景との境界が柔らかくコントラストの低い半透明領域は「背景」として剥がされるか、形のない色の塊として残り、きれいにセグメンテーションできない。第二に、マスクが完璧であっても、単一画像の 3D 再構成モデルは——主に中身の詰まった日常物体で訓練されているため——細かいレース状や半透明のジオメトリを再現せず、平坦に潰す傾向がある。不透明な素材の被写体なら問題にならないが、半透明の布やガラス、クリスタルでできた被写体では、結果が簡略化されると想定しておくべきだ。これを解決するパラメータは現時点で存在しない——これは実際の能力の上限であり、この精細さの作品に対して正直な答えは、より優れた単一画像モデルに替えることではなく、フォトグラメトリ(実写 30 枚以上)だ。
5. Vision-Language Model:本当に得意なこと
printable にはかなり強力な機能がある:VLM による spec-to-3D 生成だ。ユーザーが設計仕様書をパイプラインに放り込む——寸法の矢印、文字注記、正/背/側の三面図レンダリング。標準的な 3D AI はこうした文字やレイアウトをすべてジオメトリとして扱い、ノイズの塊を生成してしまう。解決策は、まずローカルの Vision-Language Model でこの仕様書を読み、構造化メタデータ(design_spec.json)と実物体のきれいなクロップ画像を抽出し、それから幾何生成を走らせることだ:
# 1. Extract physical dimensions and clean crops via local VLM
printable generate-spec assets/examples/keychain_boba_spec.jpg

# 2. Reconstruct 3D mesh and automatically enforce target dimensions
printable generate --spec interim/design_spec.json --spec-all-views -b hunyuan3d
ひとつはっきり言っておく。ステップ1には外部のVLMサーバーが必要で、それはこのリポジトリには入っていない。このマシン上で2つの独立したプロセスを動かす。llama-server-rocmが実際にモデルをメモリに載せ、その手前に軽量なFastAPIプロキシをかぶせる。プロキシ自身はモデルを一切ロードしない。printable generate(--specなし)と手動バックエンドのWeb UIアップロードにはこれらは不要で、必要になるのはスペックシートとAuto-detectの2つの経路だけだ。
参考までに、開発時に実際に使っていたQwen3.8-27Bの設定はこうだ:
# Download the vision projector
hf download unsloth/Qwen3.8-27B-GGUF mmproj-F16.gguf \
 --local-dir ~/models

mv ~/models/mmproj-F16.gguf \
 ~/models/mmproj-Qwen3.8-27B-f16.gguf

# Start the resident VLM server
llama-server-rocm \
 --model ~/models/Qwen3.8-27B-Q4_K_M.gguf \
 --mmproj ~/models/mmproj-Qwen3.8-27B-f16.gguf \
 --alias qwen3.8-27b \
 --n-gpu-layers 99 \
 --ctx-size 32768 \
 --parallel 1 \
 --flash-attn on \
 --jinja \
 --temp 0.7 --top-p 0.8 --top-k 20 --min-p 0 \
 --spec-type draft-mtp --spec-draft-n-max 2 \
 --kv-unified --fit off \
 --image-min-tokens 1024 \
 --host 0.0.0.0 --port 8080
なぜ
--ctx-size 32768を使うのか。 初期の実験では262144を使っていたが、これは巨大なKV cacheを不必要に事前確保してメモリ圧迫を悪化させる。ここで使う画像分類と抽出のプロンプトはどれも短く、32Kで十分すぎるほどで、何十万トークンも確保する必要はない。
計画の大部分はそのまま残った。ただしそこに至る過程は残らなかった。そしてこの回り道のおかげで、ローカルVLMが何をどこまで信頼できるかについて、動く機能そのものよりも多くを学んだ。
回り道:2つの異なるバグ、2つの異なるモデル
最初の試みはQwen2.5-VL-7B-Instruct、軽量ビジョンモデルの定番だ。これがすぐに、実在し記録もされている問題にぶつかった。llama.cppのROCm/HIPビジョンパスはgfx1151上でどんな画像入力も文字化けさせる(ggml-org/llama.cpp#17797)。ドライバ層のバグで、設定スイッチひとつで回避できるものではない。対処として、このモデルをllama.cppで動かすのをやめ、transformers/PyTorchで直接サービングすることにした。
文字化けは解消したが、今度は無関係な2つ目のバグが露出した。1枚の画像から複数のbounding boxを探させる——「正面図、背面図、側面図を見つけろ」——と、最初の1つには必ず正しい枠を返すが、以降は無関係なテキストブロックへ飛んでいく。これも上流で記録されている(QwenLM/Qwen2.5-VL#1257)。モデルの学習時に使われた参照表現は1つのインスタンスを一意に指すため、似た対象を同時に複数定位させると、2つ目以降は精度が崖のように落ちる。抽出をビューごとに個別のbounding box呼び出しに分けても(全部を1回で問い合わせるのではなく)効かなかった。プロンプトを書き換えて表のレイアウトを明示的に記述しても効かなかった。この失敗モードは終始変わらなかった。
モデルを替え、Qwen3.8-27Bをこのマシンに常駐するllama-server-rocm経由でサービングした(すでにローカルのテキストモデルを動かしている、OpenAI互換エンドポイントを持つツール)。これでROCmの文字化けバグは完全に回避でき、実際の描写とgrounding呼び出しで検証したところ、画像を正しく読める。だがこのモデルにも同じ根本的な弱点の独自バージョンがあった。1枚の画像の中で最初の、つまり視覚的に最も目立つビューは確実にgroundingできるが、残りのキャプションは誤ってラベル付けするか、そもそも認識しない。vision tokenの予算を増やし(--image-min-tokens 1024)、視覚的な推測ではなく印刷されたキャプションのテキストに明示的にアンカーするようプロンプトを書き換えても同じだった。
本当の発見
異なる2つのモデルファミリー、異なる2つのサービングスタック、それでも失敗の形は同じ。1枚の画像に対する単一の全体的判断は信頼できる。1枚の画像内で複数の領域を定位し正しくラベル付けするのは信頼できない。「これは全体として何か」を問うテスト——描写、分類、寸法抽出——はすべて正確だった。「このN個は具体的にどこにあるか」を問うテストは、最初の1つを過ぎたあたりから劣化し始める。
これが本当のエンジニアリング課題を定義し直す。パイプラインのコードを読んで確認できた、はっきり言う価値のある事実がひとつある。printableのどのbackendも、複数のビューを融合して1回の再構築にはしない。--spec-all-viewsはもともと、切り出した各cropを独立した単一画像の候補として試し、再構築が最も良かったものを残すだけだ。つまり正しいビューのラベル付けは出力品質の鍵ではそもそもなく、鍵はcropの完全性だけだった。信頼できるマルチビューgroundingを追いかけるのは、解く必要のない問題を、これらのモデルがそもそも持っていない能力で解こうとしていた。
Auto-detect:長所に沿って進み、短所に無理に突っ込まない
これらのモデルが得意なのが単一の全体的判断なら、有効なのはそれだけを——1回だけ——問い、その結果を既存の、すでに動いているパイプラインへルーティングすることだ。モデルに複数領域の正しいラベル付けを要求するのではない。
printable serveのWeb UIにAuto-detectオプションが加わった。1回の分類呼び出しでアップロード内容の種類を判定する(デザインスペック図、キャラクター三面図、人物、単体オブジェクトの写真、または「判定不能」——モデルが確信を持てないときは決して推測しない)。判定結果は既存の検証済みパイプラインへ送られる:
flowchart LR
 A["Upload"] --> B["One VLM call:
classify(image)"]
 B --> C{category}
 C -->|design spec sheet| D["spec extraction
-> hunyuan3d/triposr"]
 C -->|character turnaround| E["grid-split-and-pick-best
-> hunyuan3d/triposr"]
 C -->|portrait photo| F["lithophane"]
 C -->|object photo| G["hunyuan3d
(falls back to triposr)"]
 C -->|unclear| H["no mesh --
ask the user"]
分類結果——カテゴリ、一行の理由、選ばれたバックエンド——は生成開始前に進捗パネルに表示されるので、黙って推測されることはない。ルーティング部分に新しいエンジニアリングは一切ない。どの分岐ももともと動いていたコマンドだ。新しいコードは「まず分類してからルーティングする」ステップだけで、これが機能するのは、モデルに安定して答えられるその1つの問いだけを投げているからだ。
6. Webインターフェース:printable serve
ここまではCLIの話だった。printable serveは同じパイプラインを軽量なローカルWebアプリに包む。本番のスライスを走らせる前にスペック図の裁切結果がどうなったかを確認したいときに便利で、パラメータを覚えるよりファイルをドラッグ&ドロップしたい人にも向いている。
# ROCm: needs TORCH_ROCM_AOTRITON_ENABLE_EXPERIMENTAL=1 prefixed, same as any hunyuan3d CLI run
TORCH_ROCM_AOTRITON_ENABLE_EXPERIMENTAL=1 printable serve --host 0.0.0.0 --port 8000
印刷した URL を開き、写真をドラッグして、バックエンドを手動で選ぶ(選択肢は -b と同じ)。あるいは Auto-detect をオンのままにする——前述の「まず分類してからルーティングする」だ。
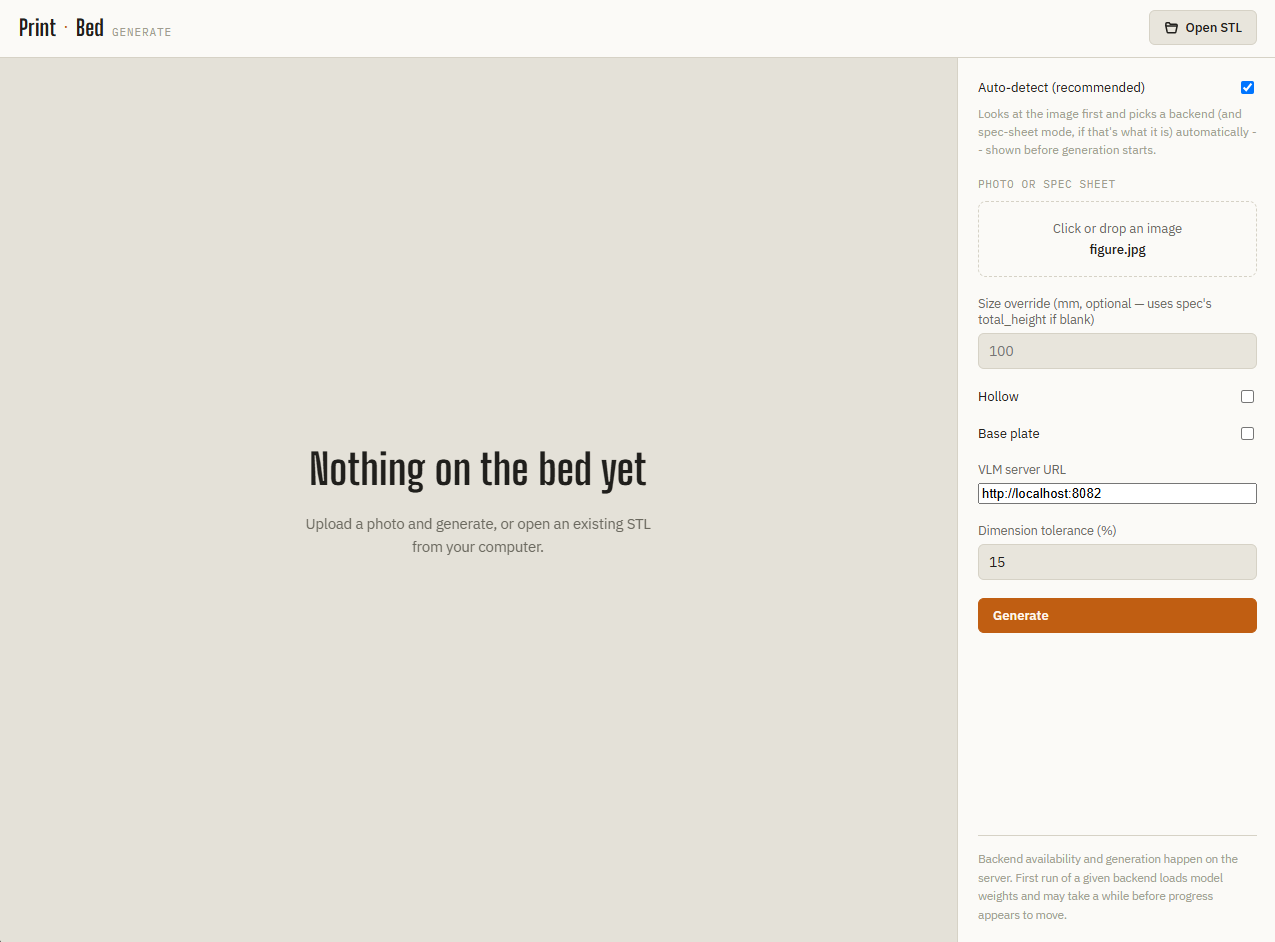
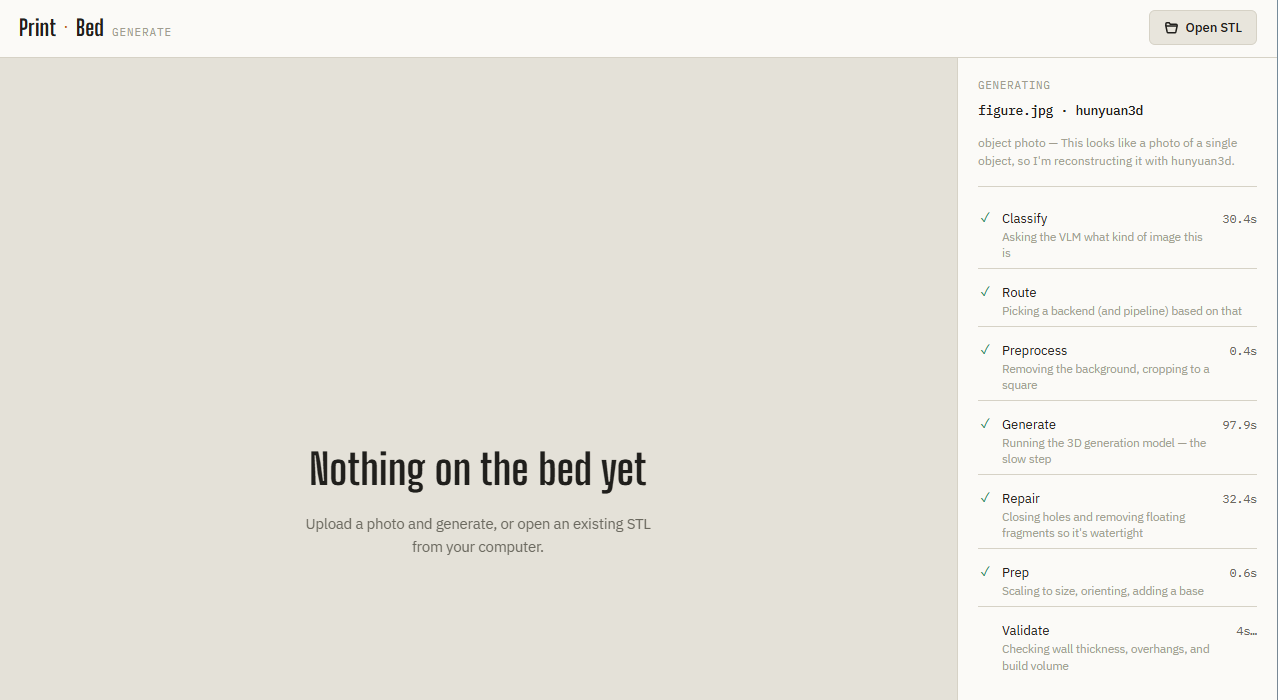
送信するとジョブが起動し、Server-Sent Events で進捗がリアルタイムに流れてくる。ポーリングもページの再読み込みも不要だ。Auto-detect をオンにしている場合、最初に現れるのは分類結果そのもの——カテゴリ、一行の理由、そしてどのバックエンドにルーティングされたか。これはすべて生成が始まる前に起きる。
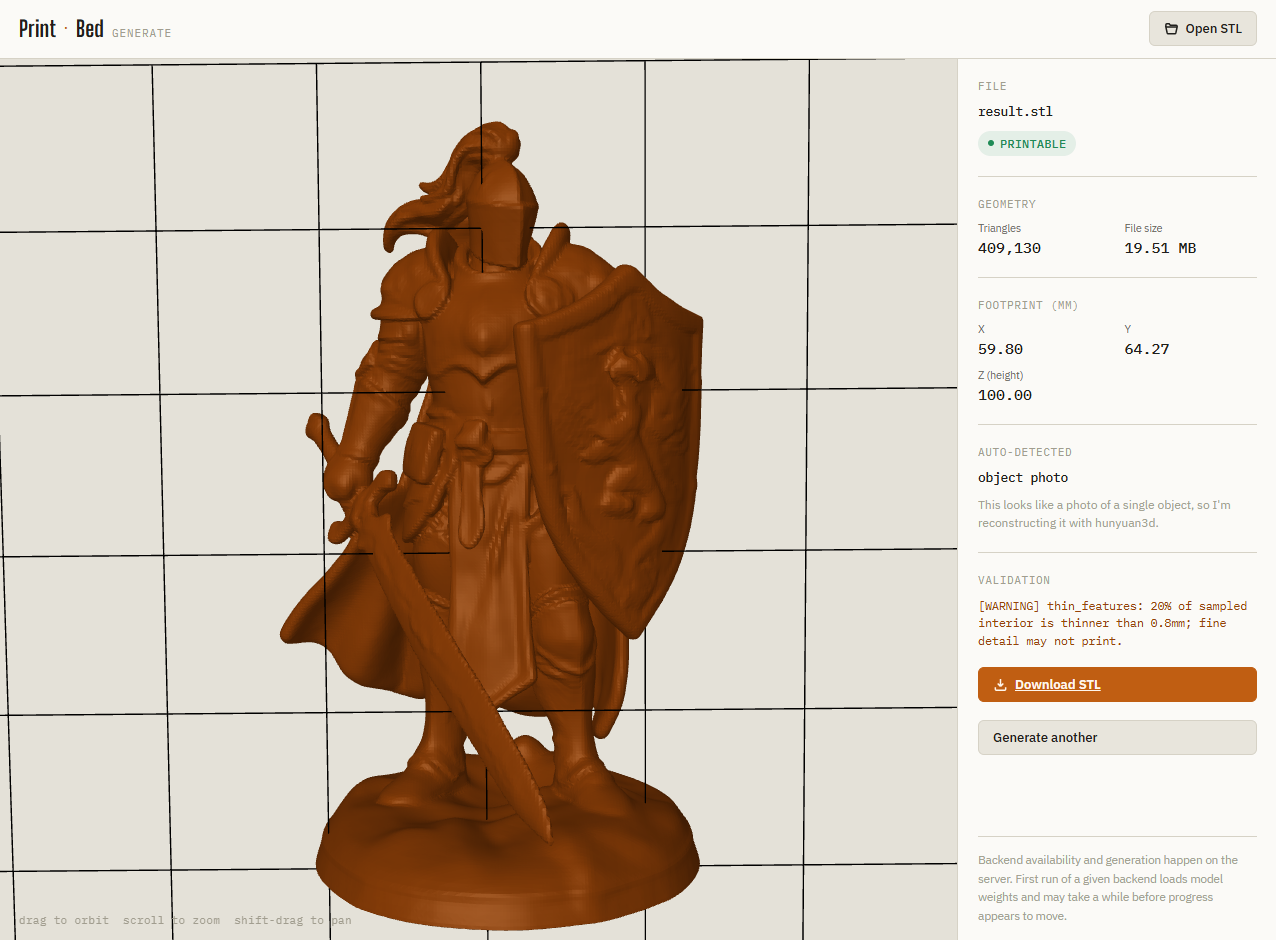
ジョブが終わると、結果パネルに印刷用の .stl と、対応バックエンド(texture=true を組み合わせた TripoSR)向けの色付き .glb プレビューのダウンロードが並ぶ——§3 の TripoSR 概観と §10 の状態まとめで触れた、あの一対だ。
7. 本番向けの堅牢化:無関係な三つのメモリバグ
長時間動く Web サーバーに実際の GPU 負荷を走らせたことで、メモリ枯渇によるクラッシュが次々と露呈した。本当にためになったのは個々の修正ではない。調査の全過程を通じて、「OOM」は決して同じバグではなかったことだ。三つの無関係な原因が、たまたま同じ症状を示していただけであり、これを一つの問題として扱えば、誤った修正方向を何度も追いかけることになる。
-
孤立した重複プロセス。 ローカルの VLM サーバーが再起動するたび(新しいパラメータに変えたとき、あるいは以前のクラッシュから復帰したとき)、以前の
llama-server-rocmプロセスが終了ではなく stopped 状態になることがあった——モデルの重みはメモリを丸ごと占有したまま、プロセスだけが停止している。長いセッションの間に、こうしたプロセスが気づかれないまま三つまで溜まり、約 9 GB を無駄に食っていた。同じサーバーのインスタンスが複数あることがpsで見えるので、これが手がかりになる。残ったプロセスにkill -9を実行すると(killだけでは stopped プロセスに届かない)、即座にメモリが戻った。 -
KV cache の過大な設定。 VLM サーバーは
--ctx-size 262144で起動していた——25 万トークンのコンテキストを事前確保し、実際の使用量とは無関係に起動時にその分を割り当てる。このパイプラインの classify/extract 呼び出し——画像一枚、短いプロンプト、長さを制限した補完——の実際の必要量は 13,500 トークン程度を超えたことがない。--ctx-size 32768まで下げると(余裕はまだ十分で、以前より 8 倍小さい)、必ずクラッシュしていた画像がクラッシュしなくなった。 -
呼び出しのたびにモデルを再読み込み。 これは VLM サーバーではなく
printable自身のコードの問題だ。バックエンドレジストリは 毎回 の生成呼び出しで新しいバックエンドインスタンスを作り、ディスクからモデル全体を再読み込みする——異なる Web リクエストだけでなく、同じ CLI 呼び出しの中のマルチパネルやマルチビューのループで同じバックエンドを繰り返し呼ぶ場合も含めて。同じサーバープロセスでhunyuan3dの生成を三回続けると、毎回まるごと約 110 秒かけて再読み込みし、三回目でメモリを使い果たした。修正はバックエンドインスタンスを名前でキャッシュし、基盤のファクトリが変わったときに自動で無効化するというもの——この細部は実際に重要で、まさにこれが既存のテストスイートに本物のリグレッションを捕まえさせた(テスト用に偽のバックエンドを差し替えるケースが、キャッシュに残った実インスタンスに覆い隠されていた)。修正完了を宣言する前に、だ。
これらの修正はどれも当て推量ではない。それぞれがカーネルの OOM killer のログ行、systemctl/journalctl のトレース、あるいは再現可能なテスト失敗から根本原因を突き止め、元の故障を再現して二度と起きないことを確認して検証した——推論が正しそうに聞こえるから直ったと見なしたのではない。
8. 代替案としての lemonade-sdk の評価
lemonade-sdk/lemonade は AMD のエンジニアも貢献しているコミュニティプロジェクトで、Strix Halo/gfx1151 を明確に対象とし、公式ビルドをラップするのではなく ROCm llama.cpp ブランチを独自に保守している。手動で llama-server-rocm を走らせるのに比べれば、有望で保守コストの低い代替案に見える——サーバー管理の統一、モデルカタログ、AMD が調整したデフォルト、コマンドラインフラグを自分で導出しなくて済む。
評価の過程では相応の摩擦に実際に遭遇した。さらっと流さず、正直に記録しておく価値がある:
- バージョンの隔たり。 PPA 経由でインストールした CLI が報告するのは
10.2.0だが、プロジェクト公式サイトのカタログが反映しているのはもっと新しい11.8.0だ。サイトに載っているモデルにはコピーできるlemonade pullコマンドが付いているが、ローカルで実行すると名前空間エラーで失敗する。そのモデルがインストール済みの古いカタログにまだ入っていないからだ。手動登録(--checkpoint main/mmproj、--recipe llamacpp)でこの問題は回避できた。 - キャッシュ位置の意外な落とし穴。
lemonade pullの初回実行は不自然なほど速く成功を返し、実際のダウンロード進捗が一切なかった——後に分かったのは、今回の取得より前のファイルタイムスタンプに基づいて「同じモデルキャッシュを共有している」と誤判定していたことだ。Lemonade は実際には専用のシステムユーザーの下で独立した systemd サービスとして動いており、モデルキャッシュは完全に別だ——二回目の実行でようやく本当の転送進捗が表示され、その独立した場所に書き込まれた。これは、素早い「成功」メッセージはサービスが実際に何をしたかの証明にならないという教訓だ。評価の全過程を通じて、信頼できる唯一の情報源は Lemonade 自身のログ(journalctl -u lemonade-server)だった。 - 彼ら自身が推奨するモデルのロード失敗。 Lemonade 自身のモデルレジストリ(サイトだけでなく)とバイト単位で突き合わせて検証し、使った取得コマンドは完全に正しかった——しかもこれはこのユースケース向けの彼らの
"suggested": trueモデルだ。それでも失敗した。このハードウェア上で、彼らの ROCm バックエンドがllama_model_load: error loading model: missing tensor 'blk.64.ssm_conv1d.weight'を報告する。このテンソル名自体がちょっとした発見だった——ssm_conv1d/ssm_d_inner/ssm_d_stateが、Qwen3.8-27B は通常の transformer ではなく SSM/Mamba+attention のハイブリッドアーキテクチャであることを裏付けており、おそらくこれが、汎用の GGUF 変換パイプラインが SSM 層に必要なテンソルを一つ見落とす原因だ。こちら側の誤りではない。本稿執筆時点で、この特定モデルに対する彼らの gfx1151 ROCm サポートに実在するギャップである。
保留する。ただし、諦めるわけではない。今回の評価が本来答えようとしていた実務上の問い——自作したあの環境を入れ替えるべきか——には結論が出た。当面は入れ替えない。既存の llama-server-rocm 構成のまま走らせる。Lemonade がこの型番の ROCm 対応を成熟させたら、あらためて検討する。
9. 更新された ROCm/TheRock スタックの評価:その日のうちにロールバックした回帰
ROCm/TheRock スタックは進化が速く、既存構成が今も最適だと決めつけるより、新しいパッケージを既知の動作環境で試す価値がある。
結果はなかなか興味深いものだった。新しい PyTorch は ROCm の attention パスで確かに実測できる改善を示したが、環境全体をアップグレードすると、printable が依存するネイティブ拡張の互換性問題が露呈した。
そこで旧環境は本番ベースラインとして残し、新スタックは実験ブランチとして扱うことにした。
以下の結論は推測ではなく実測データに基づく:
| PyTorch バージョン | flag なしの attention | AOTriton 実験的 flag |
|---|---|---|
| 7.13.0a20260513(既知の動作版) | 106ms/回、警告あり | 8.66ms/回 |
| 10.1.0a20260829(実験的) | 約 4.7ms/回、警告なし | 約 4.7ms/回 |
この結果は重要だ。新しいバージョンで flag なしの attention は、旧バージョンで flag ありのものよりすでに速い。新しい ROCm スタックを追い続けるだけの、実測に裏打ちされた性能上の理由がある。
printable の使用を実際に壊した箇所
triposr でテストグリッドを再生成した——ソースから torchmcubes(ネイティブの marching-cubes 拡張)をコンパイルする——ところ、次のエラーが出た:
vol must be a CPU tensor
直接の原因は、torch のアップグレード後、uv のキャッシュが古い torchmcubes ビルド成果物を再利用していたことだった。キャッシュを消して強制的に再ビルドすると、このエラーは消えた。
だが続けて2つ目の問題が露呈した。新しい nightly の ROCm/CMake パッケージング自体が、このパイプラインで使っているネイティブ拡張のビルド方法とまだ互換でない。Torch の LoadHIP.cmake が、空の HIP バージョン変数を解析しようとして落ちる:
math cannot parse the expression: "( * 100) + ": syntax error
新しい環境では ROCm SDK の追加設定も必要だった。対応する開発パッケージが初期化される前に、期待される hip-lang の CMake 設定が見つからないためだ。
判断:押し通さずロールバック
ここでの正しいエンジニアリング判断は、動いている本番環境を壊すのではなく、ロールバックすることだ。
既知の動作版 PyTorch を再インストールし、それに対して torchmcubes をクリーンに再コンパイルし、printable で固定した依存関係を復元し、パイプライン全体を再度検証した:
printable generate character.png --backend triposr --size 80 --sheet
→ PRINTABLE
テストスイートは再び全てグリーンになった。
つまり結論は「新しい ROCm スタックはダメ」ではない。むしろ逆で、attention ベンチマークの結果は心強い。結論は、テスト時点では、新しいスタックはこの Python とネイティブ拡張を混在させた特定のワークロードをそのまま置き換えられないということだ。
printable にとって、旧環境は依然として既知の動作ベースラインだ。TheRock の新スタックがパッケージングとネイティブ拡張の互換性の面で成熟してきたら、再テストする価値がある。
10. 次のステップ:Hunyuan3D のテクスチャペイント
次のマイルストーンは基本的なカラー GLB のエクスポートではない。その道は TripoSR で既に通っており、前述のとおりだ。まだ終わっていないのは、Hunyuan3D のテクスチャペイントパイプラインを AMD 上で安定して動かすことだ。
これは明確にしておく価値がある。「ROCm はまだ対応していない」という言い方では、実際にどこまで進んだかを過小評価してしまう。Hunyuan3D-2.1 自身の README には、このパイプラインに関する ROCm や AMD の対応記述が一切ない。ここで述べる移植作業は、完全に本プロジェクト独自の適応だ。
形状生成(printable が実際にリリースしている部分)にはかなりの作業が必要だが、GPU カーネルの移植は伴わない。自己矛盾した requirements.txt を手動で除外し、hy3dshape に欠けていた setup.py を書き足し、PyTorch の ROCm attention dispatcher を回避するために TORCH_ROCM_AOTRITON_ENABLE_EXPERIMENTAL=1 が必要だった。根底では、形状モデルは主に PyTorch 演算子で構成されているので、ネイティブ ROCm ビルドで動く。
テクスチャペイントは別物だ。ここでは依存関係のインストールで済ませず、実際のカーネルレベルの移植を試みた。custom_rasterizer と2つ目の拡張 DifferentiableRenderer を hipify 後のビルドで、gfx1151 向けにネイティブコンパイルした。
パイプラインを動かすまでに、互いに無関係な6つの互換性問題を修正した:
diffusersのバージョンドリフト- Blender Python wheel の欠如
torchvisionAPI の変更- 上流チェックポイントのパス不一致
- システム OpenGL ライブラリの欠如
trimeshのバージョンドリフト
これらを全て解決した後、残った失敗が本当の GPU 障害だった。
custom_rasterizer の hipify 済みカーネルは [gfxhub] page fault を安定して再現し、dmesg には amdgpu の ring timeout と GPU reset が見える。ドライバは再起動せずに復帰したが、Radeon 8060S は統合 GPU であり、この reset はマシン上の他の GPU 利用プロセスにも一時的に影響した。
つまり、これは前述の依存関係の問題とはまったく性質が異なる。パイプラインはビルドできるところまで修復できるが、この ROCm 構成では rasterizer kernel 自体がまだ信頼できない。
インストールと調査の全記録は docs/SETUP.md にある。
現時点での結論:
- STL 生成: Hunyuan3D 2.1
- 高速/ドラフト生成: TripoSR
- カラー GLB プレビュー: TripoSR
- Hunyuan3D のテクスチャ描画: 実験的/AMD ではブロックされる
- エンジニアリング上の最優先課題: 再現可能な GPU page fault を覆い隠すことではなく、上流の変更を追うか、別の ROCm/kernel の組み合わせを試すこと
結論とコード
printable を作る過程で気づいたのは、2D 画像を実在の 3D オブジェクトにするには、モデルの重みだけではまったく足りないということだ。本当に腕の見せどころとなるのは、地味な工程のほうだった——メッシュ修復、ブーリアン演算、向きの最適化、物理検証。
プロジェクト全体は MIT ライセンスで公開している:
👉 GitHub リポジトリ:seehiong/printable
AMD か NVIDIA の GPU があり、3D プリンタも持っているなら、リポジトリを clone して uv sync を一度走らせ、お気に入りのキャラクター設定画や人物像を実体モデルにしてみてほしい。
コメント(0)
ログインするとディスカッションに参加できます。