Postgres 中什么会被 TOAST
Postgres 19 将 TOAST 压缩从 pglz 切换为 LZ4。LZ4 更快,但不总是更小,而且使用它后某些读取会变慢。
中文
复制
Postgres 里什么会被 TOAST
往一张表里插入 2,000 个字母 x,表有一个 int 类型的 ID 和一个 text 列,Postgres 会原样存下这 2,000 字节,不做压缩。插入 2,001 个,Postgres 就用 LZ4 把这个值压到 26 字节。
多出来的这一个字节就足以触发 TOAST。TOAST 是 Postgres 的一部分,负责在行变得太大时压缩其中的值,压缩不够就把值移出该行。
目前处于 beta 阶段的 Postgres 19 改变了 TOAST 的压缩方式,在支持 LZ4 的构建中把默认值从 pglz 换成 LZ4。PlanetScale 已经在 Postgres 17 和 18 上做了这个切换。
下面我们看看哪些值会被 TOAST、TOAST 对它们做了什么,以及什么时候该选 LZ4。开始吧!
一行占多少字节
压缩就是为了省字节,所以我们先从一行里的字节都花在哪说起。
Postgres 把表数据存在固定的 8 KB 页里。一行不能跨页,所以每一行都必须塞进一页。
每行开头是 24 字节的头部,Postgres 用它来记录哪些事务能看到这一行,后面跟着各列的值。这些值占多少空间取决于类型,而所有类型都归入两类之一:
- 定长类型,比如
bigint、timestamptz、boolean,永远占相同的字节数。 - 变长类型,比如
text、jsonb、bytea,占多少字节取决于值本身,另外还要加一个长度头:值不超过 126 字节时是 1 字节,再长就是 4 字节。
pg_column_size 展示了同一行里的这两类:
SELECT pg_column_size(ROW(1::bigint, now(), true, 'Ada'::text));
 pg_column_size
----------------
             45
(1 row)
也就是 24 字节的头部,bigint、timestamptz、boolean 占 17 字节(8、8、1),'Ada' 占 4 字节:三个字符加 1 字节的长度头。把 'Ada' 改成 'Ada Lovelace',这一行就涨到 54 字节,而其他列还是 17。
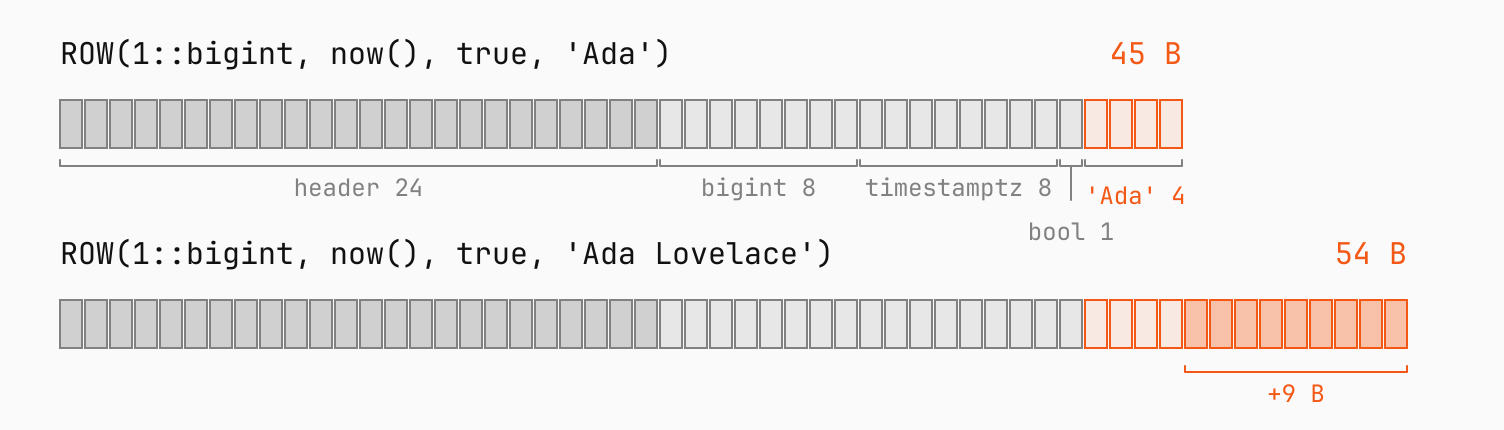
变长值是让行变大的原因,也是 Postgres 唯一能压缩的值。
小行不会触发压缩
TOAST 是 The Oversized-Attribute Storage Technique 的缩写。顾名思义,只有当行变得太大时,TOAST 才会介入。
一旦行超过 2,032 字节,Postgres 就认为它过大,这大约是 8 KB 页面的四分之一。这个阈值的设定是为了在扣除页面头部和每行的指针所需空间后,每页至少还能放下四行。
下面是我们存储最可压缩的值——单个重复字母——时,长度刚好低于和刚好高于阈值的情况。pg_column_compression 返回压缩每个值所用的算法,如果值未被压缩则返回 null,我们将其显示为 none。COMPRESSION lz4 子句用于选择算法。
CREATE TABLE t (id int PRIMARY KEY, body text COMPRESSION lz4);

INSERT INTO t VALUES
  (1500, repeat('x', 1500)),
  (2000, repeat('x', 2000)),
  (2001, repeat('x', 2001));

SELECT id AS chars,
       pg_column_size(body) AS stored_bytes,
       coalesce(pg_column_compression(body), 'none') AS compression
FROM t ORDER BY id;
 chars | stored_bytes | compression
-------+--------------+-------------
  1500 |         1504 | none
  2000 |         2004 | none
  2001 |           26 | lz4
(3 rows)
前两个值没有被压缩。每个值比其长度多占 4 字节,用于长度头部。而第三个值只多了一个字符,却被压缩到了 26 字节。
2,000 字符的行正好是 2,032 字节:24 字节的行头部,4 字节的 int,以及 2,004 字节的文本。这刚好卡在阈值上,所以 TOAST 不动它。2,001 字符的行则超出了一个字节。
TOAST 做两件不同的事
阈值针对的是整行,但 TOAST 处理的是单个变长值。一旦行超过阈值,TOAST 有两种缩小它的方式:
- 压缩值,把更小的版本留在行内,就像那个 2,001 字符的行。
- 把值移出行,放进一张单独的表中。
那张单独的表叫做 TOAST 表。含有可容纳大值的列的表,会在 pg_toast schema 中自动获得一张。
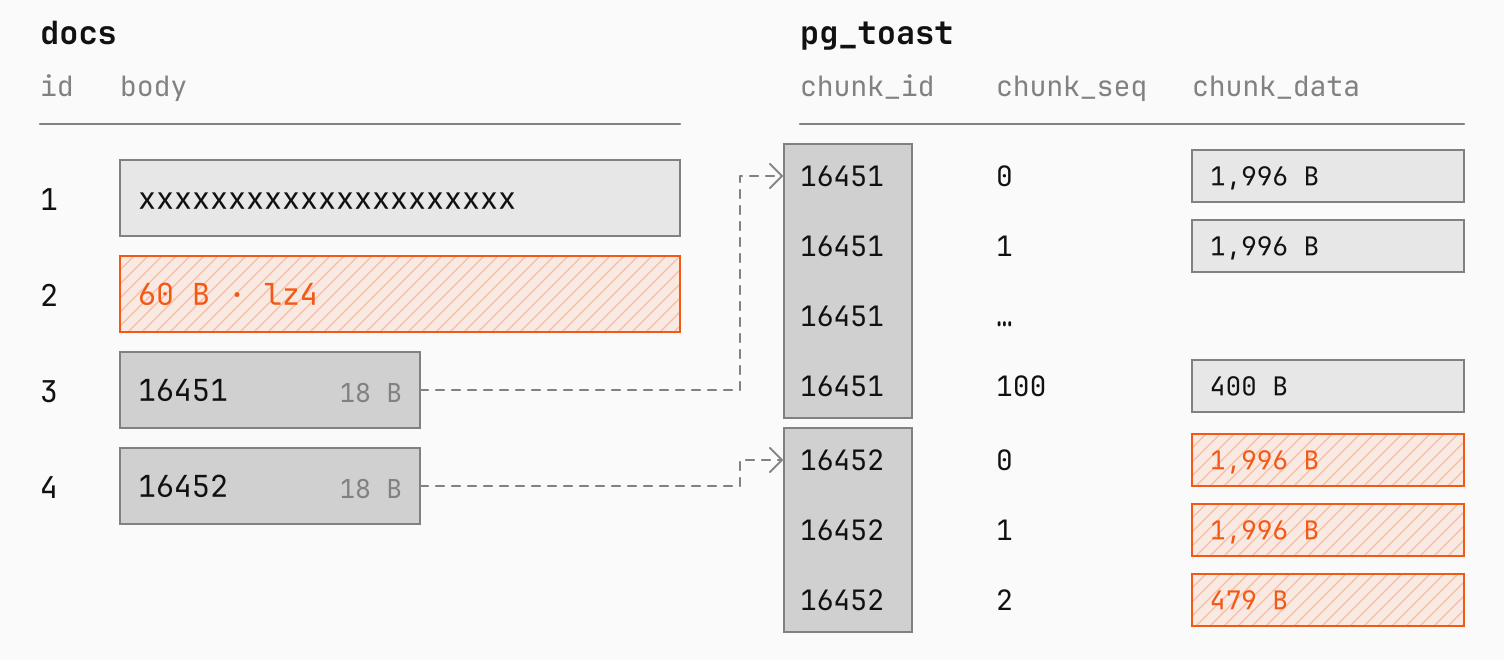
不过,移到 TOAST 表的值并不是整块存储的。TOAST 把它切成最大 1,996 字节的块,每块作为单独的一行存储,并标记上值的 ID(chunk_id)和它在值中的位置(chunk_seq)。2,032 字节中剩下的部分用于存放块行的头部和 ID,因此一页能放下四个块行。原始行保留一个 18 字节的指针,这样 Postgres 就能找到这些块并把它们重新拼起来。
TOAST 会从一行中最大的值开始,依次处理到最小的值。一旦该行重新降到 2,032 字节以下——也就是表的 toast_tuple_target——它就停止。
为了看到所有结果,我们在同一张表里存入四个差异极大的值:一个短字符串、10 KB 的重复文本、200 KB 的随机字符,以及 1.1 MB 的重复句子。stored_bytes 是值最终所在位置的大小,如果值被移出,就包括 TOAST 表。octet_length 返回值的未压缩大小,而 pg_column_toast_chunk_id(Postgres 17+)返回它在 TOAST 表中的 ID,如果值仍在行内则返回 null。
CREATE TABLE docs (id int PRIMARY KEY, body text COMPRESSION lz4);

INSERT INTO docs VALUES
  (1, repeat('x', 200)),
  (2, repeat('abc', 3400)),
  (3, (SELECT string_agg(md5(random()::text), '') FROM generate_series(1, 6250))),
  (4, repeat('The quick brown fox jumps over the lazy dog. ', 25000));

SELECT id,
       octet_length(body) AS raw_bytes,
       pg_column_size(body) AS stored_bytes,
       coalesce(pg_column_compression(body), 'none') AS compression,
       pg_column_toast_chunk_id(body) IS NOT NULL AS moved_out
FROM docs ORDER BY id;
 id | raw_bytes | stored_bytes | compression | moved_out
----+-----------+--------------+-------------+-----------
  1 |       200 |          204 | none        | f
  2 |     10200 |           60 | lz4         | f
  3 |    200000 |       200000 | none        | t
  4 |   1125000 |         4471 | lz4         | t
(4 rows)
每个值落在不同的地方:
- 第 1 行低于阈值,所以 TOAST 根本不会碰它。
- 第 2 行从 10 KB 压缩到 60 字节,小到足以留在行内。
- 第 3 行是随机的,压缩它省不下空间。TOAST 把值原样移出,不做压缩。
- 第 4 行压缩到 4,471 字节,对行来说仍然太大,所以 TOAST 把它压缩并移出。
每一列的存储策略决定了 TOAST 能执行上面哪些操作:
PLAIN:两者都不做。定长类型(如int)使用这一策略。EXTENDED:先压缩,必要时再移出。这是text、jsonb和bytea的默认值。EXTERNAL:移出,但从不压缩。MAIN:压缩,但只要整行还能放进一个页面,即使超过通常的 TOAST 阈值也把值留在行内。只有在万不得已时才移出。这是numeric的默认值。
可以用 ALTER TABLE docs ALTER COLUMN body SET STORAGE EXTERNAL 修改某一列的存储策略。不过,它不会改变已经存好的值。
TOAST 不是大对象
Postgres 还有另一种存储大值的方式,叫做大对象(large object),专为视频、PDF 这类完整文件而设计。
在 Can you put a video in Postgres? 中,我们把一个 4 GB 的视频存成了大对象。lo_import 把文件加载进 pg_largeobject 系统表,切成约 200 万个 2 KB 的块,并返回一个 OID,由我们的 video 表保存为引用。要把视频流式传给浏览器,lo_get 会直接从这些块中读取任意字节区间。
TOAST 和大对象都分块存储大值,但有三点不同:
- TOAST 是自动的。 任何变长列都会应用,不需要你主动要求。大对象只有在你创建之后才存在。
- TOAST 值最大 1 GB。 大对象可以存到 4 TB。
- TOAST 值随所在行一起删除。 大对象会一直保留,直到你用
lo_unlink删除它,即使引用它的那一行早已不存在。
超过 1 GB 的文件必须用大对象。更小的都能放进普通列,TOAST 还能顺便压缩。
pglz 和 LZ4 的工作方式
Postgres 可以用两种算法之一压缩 TOAST 值:pglz 或 LZ4。一列用哪种,取决于它的 COMPRESSION 子句指定了哪个,没指定就用 default_toast_compression 设置。改动这两者只影响此后压缩的值。已经压缩过的值会保留原来的算法,即使用 INSERT ... SELECT 复制它们,或用 VACUUM FULL 重写整张表也一样。
两种算法的基本思路相同:都是从头到尾扫描一段数据,寻找之前出现过的字节,一旦发现重复,就用一条简短的记录将其替换,并注明先前那份副本的位置和长度。
在{"status":"active"},{"status":"active"}中,第二个对象被存成一条几字节的记录,指回第一个对象。
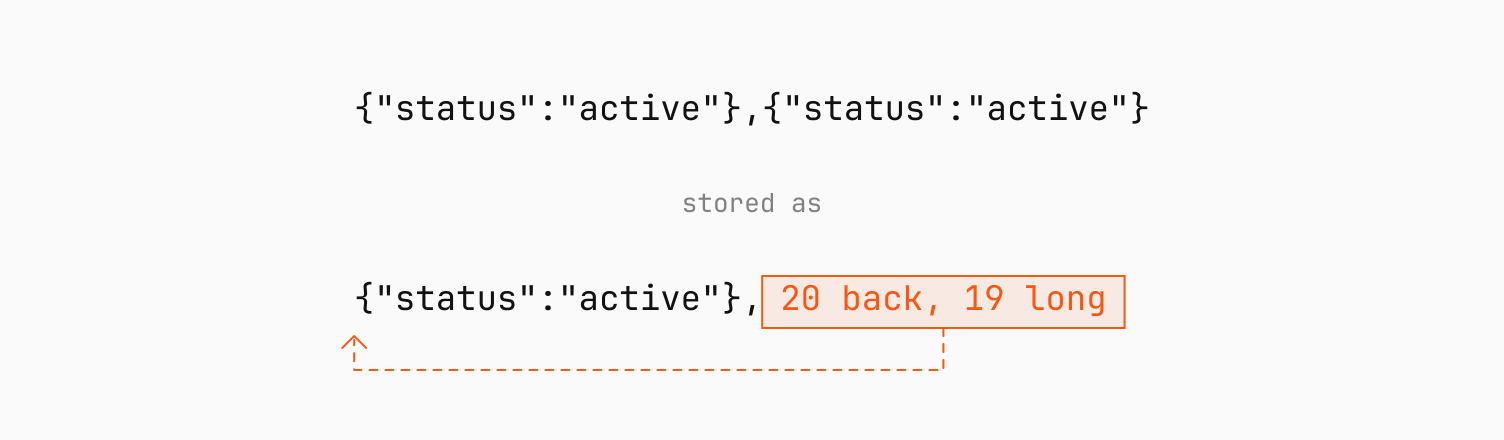
不过,这种引用能往回指的距离是有限的,这个上限叫做窗口。如果早先的那份副本落在窗口之外,算法就看不到它,只能把重复内容完整存下来。
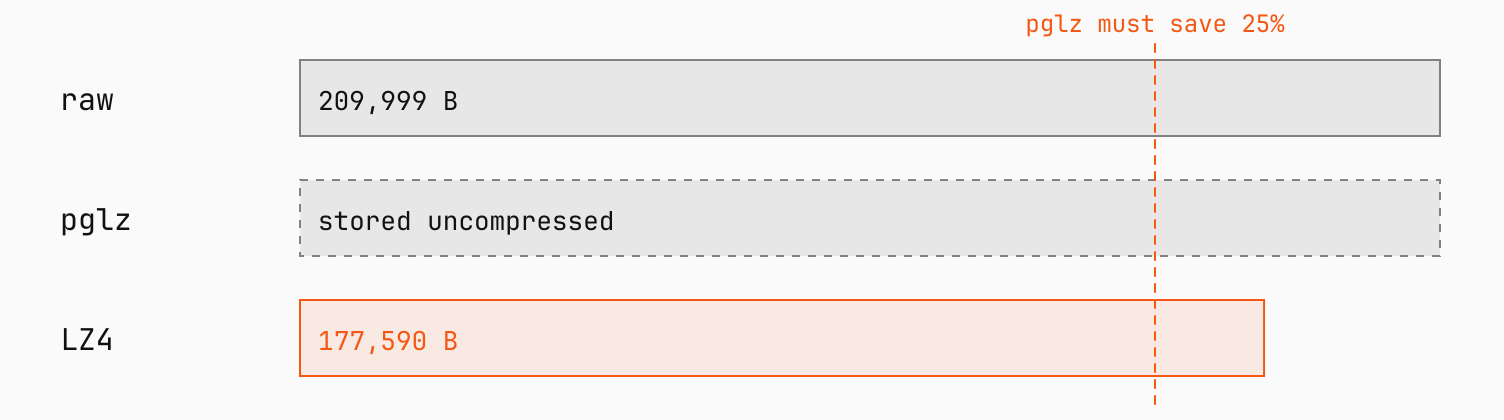
pglz 是 Postgres 自带的压缩器。它的窗口是 4 KB,在每个位置上它会检查若干个更早的匹配,保留最长的那个。除非能省下超过 25%,否则 Postgres 会丢弃 pglz 的结果;而遇到完全找不到重复的数据时,pglz 会提前放弃。
LZ4 是一款通用压缩器,用途远不止于 Postgres。Postgres 从 14 版开始支持它。它的窗口是 64 KB,但它不做搜索,而是从一张小的查找表里取出唯一一个更早的候选,因此快得多。这张表会不断用新条目覆盖旧条目,所以重复出现的位置越靠后,LZ4 越不容易找到它。只要 LZ4 的结果能省下超过 2 字节,Postgres 就会保留。
为了测试窗口,我们用 30,000 个随机的六字符单词拼出一个长字符串。每个单词后面加一个空格,占 7 字节,所以整个字符串大约 210 KB。
我们拼两遍,一遍从 500 个不同的单词里取,一遍从 5,000 个里取。用 500 个时,一个单词平均大约 500 个单词之后再次出现,也就是往回约 3.5 KB。用 5,000 个时,大约往回 35 KB。
我们把每个字符串分别存进一个 pglz 列和一个 LZ4 列。setseed 让每次运行时随机出的单词都相同,所以下面的体积在 Postgres 18 上可以复现:
CREATE TABLE words (vocab int, pglz text COMPRESSION pglz, lz4 text COMPRESSION lz4);

SELECT setseed(0.42);

INSERT INTO words
SELECT vocab, body, body
FROM (
  SELECT vocab, string_agg(substr(md5(floor(random() * vocab)::text), 1, 6), ' ') AS body
  FROM (VALUES (500), (5000)) AS v(vocab), generate_series(1, 30000)
  GROUP BY vocab
) s;

SELECT vocab,
       octet_length(pglz) AS raw_bytes,
       pg_column_size(pglz) AS pglz_bytes,
       pg_column_size(lz4) AS lz4_bytes
FROM words ORDER BY vocab;
 vocab | raw_bytes | pglz_bytes | lz4_bytes
-------+-----------+------------+-----------
   500 |    209999 |     105457 |     96022
  5000 |    209999 |     209999 |    177590
(2 rows)
用 500 个单词时,平均间隔落在 pglz 的 4 KB 窗口之内,但间隔有长有短,大约 30% 的重复落在更靠后的位置。LZ4 能找到其中大部分,所以它的结果比 pglz 小约 9%。
用 5,000 个单词时,大多数重复都在 pglz 够不到的地方。它省不下超过 25%,于是 Postgres 把这个值原样存储。LZ4 仍能把它压掉约 15%,靠的是那些恰好落在近处的重复。
在这些 JSON 文档上,pglz 胜出
在 JSON 数组里,每个对象都会重复出现相同的键,两个算法都能轻松找到它们。
我们把 10,000 条订单文档分别载入 PlanetScale Postgres 18 上的三张表:一张用 EXTERNAL,不做任何压缩;一张用 pglz;一张用 LZ4。每份文档包含 25 到 100 个行项目,每个行项目都重复同样的五个键:sku、name、qty、price_cents 和 tags。
未压缩的表是 103 MB。pglz 表是 19 MB,LZ4 表是 24 MB。
既然两者都能找到这些键,体积差异就取决于 pglz 额外的搜索——它能找到更长的匹配。LZ4 则用速度弥补:各跑两次,它载入同样的文档分别用了 0.48 秒和 1.09 秒,而 pglz 用了 1.59 秒和 1.73 秒。
读取预览时 pglz 更快
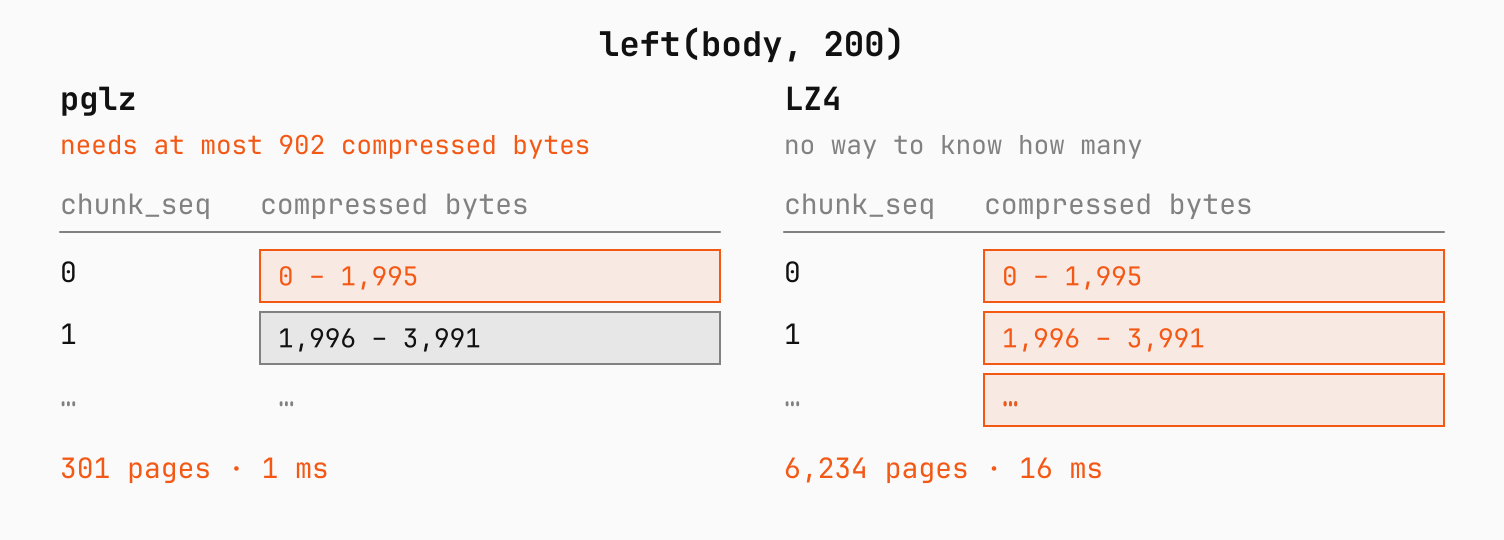
当你只读取一个大值开头的部分时,比如用 left(body, 200) 取 200 个字符的预览,pglz 同样胜出。pglz 存储原始数据的每个字节从不需要超过 9 位,外加整体 2 字节,所以 Postgres 可以给一个前缀需要多少压缩字节设一个上限。一个字符占 1 到 4 字节,因此 200 个字符最多 800 字节,而 800 字节的输出最多需要 902 个压缩字节。这小于一个 chunk 的 1,996 字节,所以 Postgres 只取第一个 chunk。LZ4 没有对应的上限,因此 Postgres 会先把整个值取出来。
我们存了 100 个约 1 MB 的文本值,两个算法都能把它们压缩到大约一半大小。对每个值的前 200 个字符,pglz 需要 301 次页面查找,全部命中内存,耗时约 1 ms;LZ4 则需要 6,234 次,耗时约 16 ms。未压缩的 EXTERNAL 版本同样需要 301 次,但占用的磁盘空间大约是两倍。
什么时候不该压缩
压缩后的值占用更少页面,意味着更省磁盘、表能更多留在内存里、需要发给副本和备份的 WAL 也更少。代价是 CPU:每一次跨过阈值的写入、每一次读取压缩值都要付出。压缩也不会减少出口流量,因为 Postgres 会先把值解压再发送。
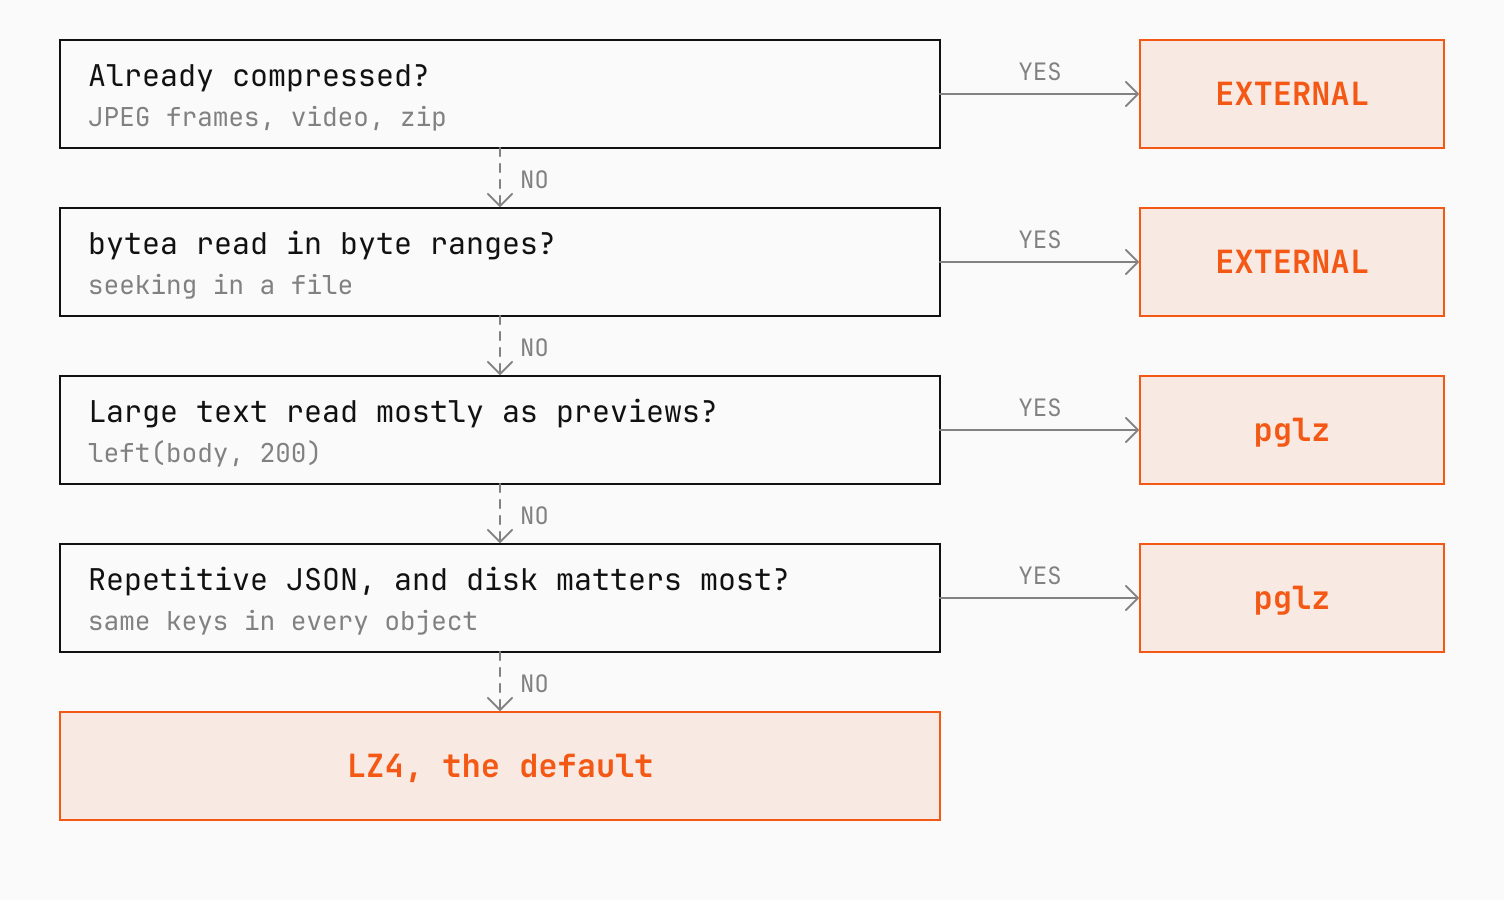
有两类数据不压缩更划算,用 EXTERNAL:
- 本身已经压缩的数据,比如我们视频会议 demo里的 JPEG 帧。LZ4 要为每一帧花 CPU,却几乎什么都省不下来。
- 从中间读取的大
bytea值,比如在文件里 seek。
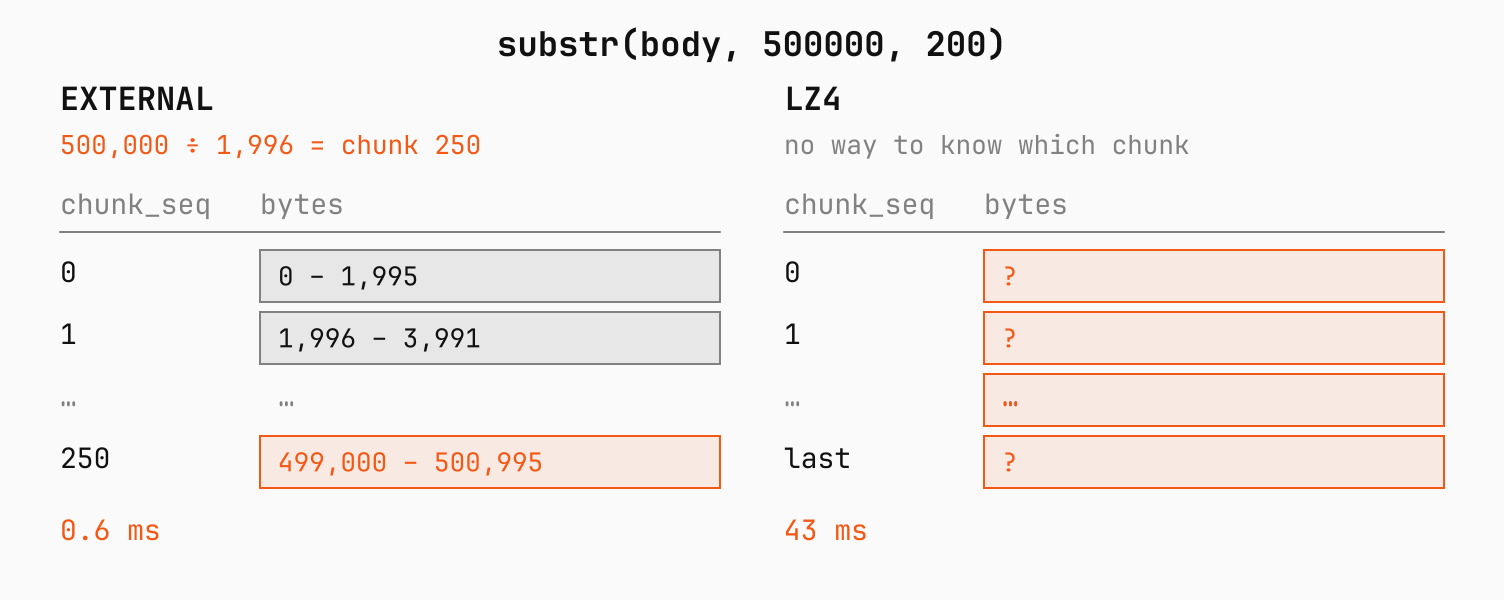
用 EXTERNAL 时,除最后一块外每块正好装 1,996 字节的值,所以 Postgres 能算出任意一个字节落在哪一块。前 250 块覆盖 499,000 字节,因此从 500,000 开始的 200 字节全在第 250 块里,Postgres 只取这一块。压缩之后,一块仍然装 1,996 字节,但这些字节能解压出多少值就说不准了。所以用 LZ4 时,Postgres 要取回每一块,并从开头开始解压。pglz 的上限来自 left(),但对第 500,000 个字节来说,这个上限比整个存储的值还大,于是它同样要读每一块。
对同样的 100 个值做这种读取,以 bytea 存储,用 EXTERNAL 不压缩耗时 0.6 ms,LZ4 是 43 ms,pglz 是 116 ms。
小结
只有当单行超过 2,032 字节时,TOAST 才会介入,因此很多值根本不会被压缩,比如开头那个 2,000 个 x。对于确实会被压缩的值,LZ4 是大多数表的合适默认选项:它的速度比压缩率差异更重要,而压缩率谁高谁低并不一定。对少数几类数据,值得手动选择 pglz 或 EXTERNAL: