Postgres で何が TOAST されるのか
Postgres 19 は TOAST 圧縮を pglz から LZ4 に切り替える。LZ4 はより高速だが、常に小さくなるわけではなく、使用すると一部の読み取りが遅くなる。
日本語
コピー
Postgres で TOAST されるもの
あるテーブルに 2,000 文字の x を挿入する。テーブルには int 型の ID と text 列がある。Postgres はこの 2,000 バイトをそのまま保存し、圧縮しない。2,001 文字にすると、Postgres は LZ4 でこの値を 26 バイトまで圧縮する。
たった 1 バイト多いだけで TOAST が発動する。TOAST は Postgres の一部で、行が大きくなりすぎたときにその中の値を圧縮し、それでも足りなければ値を行の外に移す役割を担う。
現在ベータ版の Postgres 19 は TOAST の圧縮方式を変え、LZ4 をサポートするビルドではデフォルトを pglz から LZ4 に切り替えた。PlanetScale はすでに Postgres 17 と 18 でこの切り替えを行っている。
ここからは、どの値が TOAST されるのか、TOAST がそれらに何をするのか、そしてどんなときに LZ4 を選ぶべきかを見ていく。はじめよう!
1 行が占めるバイト数
圧縮の目的はバイト数を減らすことだから、まず 1 行の中でバイトがどこに使われているかを押さえておこう。
Postgres はテーブルデータを固定長の 8 KB ページに保存する。行はページをまたげないので、各行は 1 ページに収まらなければならない。
各行の先頭には 24 バイトのヘッダがあり、Postgres はこれを使ってどのトランザクションがその行を認識できるかを記録する。その後に各列の値が続く。値が占める領域は型によって変わり、型はすべて次の 2 種類のどちらかに分類される。
- 固定長型:
bigint、timestamptz、booleanなど。常に同じバイト数を占める。 - 可変長型:
text、jsonb、byteaなど。占めるバイト数は値そのものによって変わり、さらに長さヘッダが付く。値が 126 バイト以下なら 1 バイト、それより長ければ 4 バイト。
pg_column_size は同じ行にあるこの 2 種類を示している。
SELECT pg_column_size(ROW(1::bigint, now(), true, 'Ada'::text));
 pg_column_size
----------------
             45
(1 row)
つまり、24 バイトのヘッダ、bigint、timestamptz、boolean で 17 バイト(8、8、1)、'Ada' で 4 バイト。3 文字に 1 バイトの長さヘッダが付く。'Ada' を 'Ada Lovelace' に変えると、この行は 54 バイトに増え、他の列は 17 のまま変わらない。
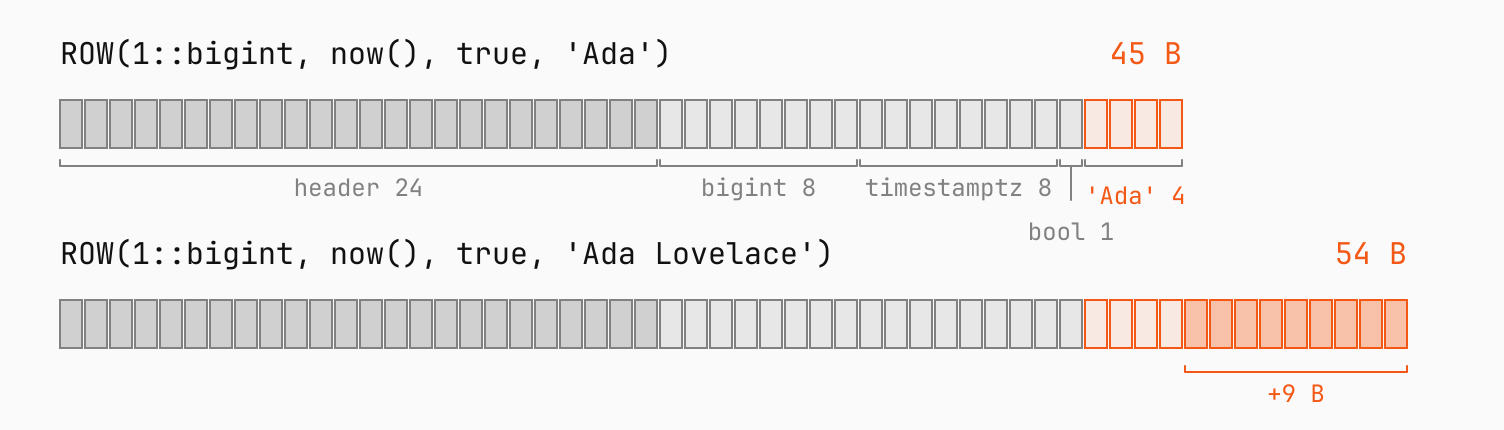
可変長値こそが行を肥大化させる原因であり、Postgres が圧縮できる唯一の値でもある。
小さい行は圧縮を発動させない
TOAST は The Oversized-Attribute Storage Technique の略だ。名前のとおり、行が大きくなりすぎたときだけ TOAST は動き出す。
行が 2,032 バイトを超えると、Postgres はそれを大きすぎるとみなす。8 KB ページのおよそ 4 分の 1 にあたる。このしきい値は、ページヘッダーと行ごとのポインタの分を差し引いても、1 ページに最低 4 行は収まるように決められている。
ここでは最も圧縮しやすい値——同じ文字の繰り返し——を、しきい値のちょうど下とちょうど上で保存してみる。pg_column_compression は値を圧縮したアルゴリズムを返し、圧縮されていなければ null を返す。表示上は none とする。アルゴリズムの選択には COMPRESSION lz4 句を使う。
CREATE TABLE t (id int PRIMARY KEY, body text COMPRESSION lz4);

INSERT INTO t VALUES
  (1500, repeat('x', 1500)),
  (2000, repeat('x', 2000)),
  (2001, repeat('x', 2001));

SELECT id AS chars,
       pg_column_size(body) AS stored_bytes,
       coalesce(pg_column_compression(body), 'none') AS compression
FROM t ORDER BY id;
 chars | stored_bytes | compression
-------+--------------+-------------
  1500 |         1504 | none
  2000 |         2004 | none
  2001 |           26 | lz4
(3 rows)
最初の 2 つの値は圧縮されていない。どちらも長さに 4 バイト上乗せされているだけで、これは長さヘッダーの分だ。ところが 3 つ目の値は 1 文字しか違わないのに、26 バイトまで圧縮されている。
2,000 文字の行はちょうど 2,032 バイトになる。24 バイトの行ヘッダー、4 バイトの int、そして 2,004 バイトのテキスト。しきい値にぴったり収まるので、TOAST は手を出さない。2,001 文字の行は 1 バイト超える。
TOAST は 2 つの異なることをする
しきい値が対象とするのは行全体だが、TOAST が扱うのは個々の可変長値だ。行がしきい値を超えると、TOAST は 2 通りの方法で行を小さくする。
- 値を圧縮し、小さくなった版を行内に残す。2,001 文字の行がそうだ。
- 値を行の外へ移し、別のテーブルに置く。
その別のテーブルを TOAST テーブルと呼ぶ。大きな値を保持しうる列を持つテーブルには、pg_toast スキーマ内に自動で 1 つ用意される。
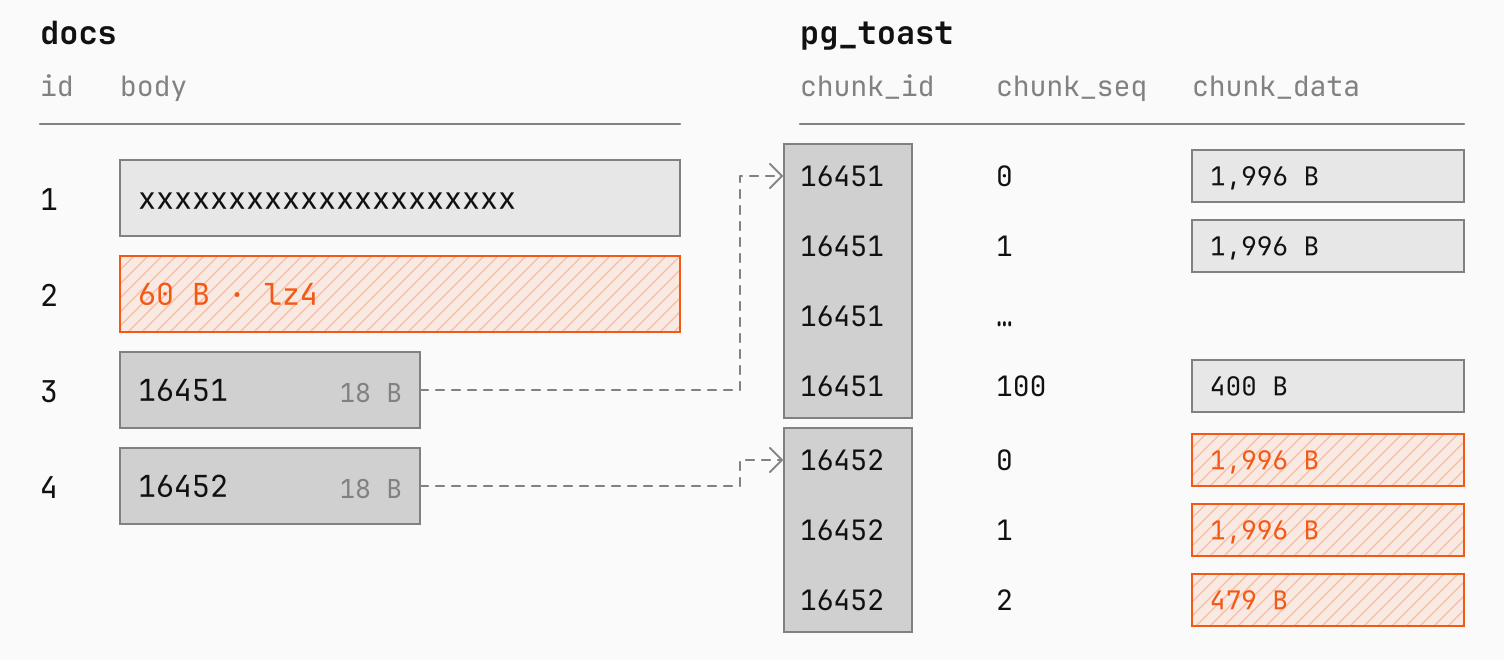
ただし、TOAST テーブルへ移された値がひとかたまりで保存されるわけではない。TOAST はそれを最大 1,996 バイトの塊に切り分け、それぞれを別の行として、値の ID(chunk_id)と値内での位置(chunk_seq)を付けて保存する。2,032 バイトの残りは塊の行のヘッダーと ID に使われるので、1 ページに 4 つの塊の行が収まる。元の行には 18 バイトのポインタが残り、Postgres はこれを使って塊を探し出し、再びつなぎ合わせる。
TOAST は行の中で最も大きな値から始め、小さい値へと順に処理していく。行が再び 2,032 バイト以下——テーブルの toast_tuple_target——に戻った時点で止める。
結果をひととおり見るために、大きく異なる 4 つの値を同じテーブルに保存する。短い文字列、10 KB の繰り返しテキスト、200 KB のランダムな文字、そして 1.1 MB の繰り返し文だ。stored_bytes は値が最終的に置かれた場所のサイズで、値が外へ移されていれば TOAST テーブルも含む。octet_length は値の非圧縮サイズを返し、pg_column_toast_chunk_id(Postgres 17 以降)は TOAST テーブル内での ID を返す。値がまだ行内にあれば null だ。
CREATE TABLE docs (id int PRIMARY KEY, body text COMPRESSION lz4);

INSERT INTO docs VALUES
  (1, repeat('x', 200)),
  (2, repeat('abc', 3400)),
  (3, (SELECT string_agg(md5(random()::text), '') FROM generate_series(1, 6250))),
  (4, repeat('The quick brown fox jumps over the lazy dog. ', 25000));

SELECT id,
       octet_length(body) AS raw_bytes,
       pg_column_size(body) AS stored_bytes,
       coalesce(pg_column_compression(body), 'none') AS compression,
       pg_column_toast_chunk_id(body) IS NOT NULL AS moved_out
FROM docs ORDER BY id;
 id | raw_bytes | stored_bytes | compression | moved_out
----+-----------+--------------+-------------+-----------
  1 |       200 |          204 | none        | f
  2 |     10200 |           60 | lz4         | f
  3 |    200000 |       200000 | none        | t
  4 |   1125000 |         4471 | lz4         | t
(4 rows)
それぞれの値は別々の場所に落ち着く。
- 1 行目はしきい値を下回るので、TOAST はまったく触らない。
- 2 行目は 10 KB から 60 バイトに圧縮され、行内に残せるほど小さくなる。
- 3 行目はランダムなので、圧縮しても容量は減らない。TOAST は値をそのまま外へ移し、圧縮はしない。
- 4 行目は 4,471 バイトまで圧縮されるが、行にはまだ大きすぎる。そこで TOAST は圧縮し、かつ外へ移す。
各列のストレージ戦略によって、TOAST が実行できる操作が決まる:
PLAIN:どちらもしない。固定長型(intなど)はこの戦略を使う。EXTENDED:まず圧縮し、必要なら行外に出す。text、jsonb、byteaのデフォルト。EXTERNAL:行外に出すが、圧縮はしない。MAIN:圧縮するが、行全体が 1 ページに収まる限り、通常の TOAST 閾値を超えても値を行内に残す。どうしても無理なときだけ行外に出す。numericのデフォルト。
列のストレージ戦略は ALTER TABLE docs ALTER COLUMN body SET STORAGE EXTERNAL で変更できる。ただし、すでに保存済みの値には影響しない。
TOAST はラージオブジェクトではない
Postgres にはラージオブジェクト(large object)という、大きな値を保存するもう一つの仕組みがある。動画や PDF のような完全なファイルを想定して設計されたものだ。
Can you put a video in Postgres? では、4 GB の動画をラージオブジェクトとして保存した。lo_import がファイルを pg_largeobject システムテーブルに読み込み、約 200 万個の 2 KB チャンクに分割し、OID を返す。それを video テーブルが参照として保持する。動画をブラウザにストリーミングするには、lo_get がこれらのチャンクから任意のバイト範囲を直接読み取る。
TOAST もラージオブジェクトも大きな値をチャンクに分けて保存するが、違いは 3 つある:
- TOAST は自動。 可変長列には必ず適用され、こちらから要求する必要はない。ラージオブジェクトは作成して初めて存在する。
- TOAST の値は最大 1 GB。 ラージオブジェクトは 4 TB まで保存できる。
- TOAST の値は行と一緒に削除される。 ラージオブジェクトは
lo_unlinkで削除するまで残り続ける。参照していた行がとうに消えていても同じだ。
1 GB を超えるファイルにはラージオブジェクトを使うしかない。それ以下なら通常の列に収まり、TOAST がついでに圧縮してくれる。
pglz と LZ4 の仕組み
Postgres は TOAST の値を pglz と LZ4 のどちらかで圧縮する。列がどちらを使うかは COMPRESSION 句で指定したほう、指定がなければ default_toast_compression の設定に従う。この 2 つを変更しても、以降に圧縮される値にしか影響しない。すでに圧縮済みの値は元のアルゴリズムのまま残る。INSERT ... SELECT でコピーしても、VACUUM FULL でテーブル全体を書き直しても同じだ。
両アルゴリズムの基本的な考え方は同じである。データを先頭から末尾まで走査して以前に現れたバイト列を探し、重複が見つかれば短い記録に置き換え、先のコピーの位置と長さを記す。
{"status":"active"},{"status":"active"}では、2番目のオブジェクトは数バイトの記録として保存され、最初のオブジェクトを指し返す。
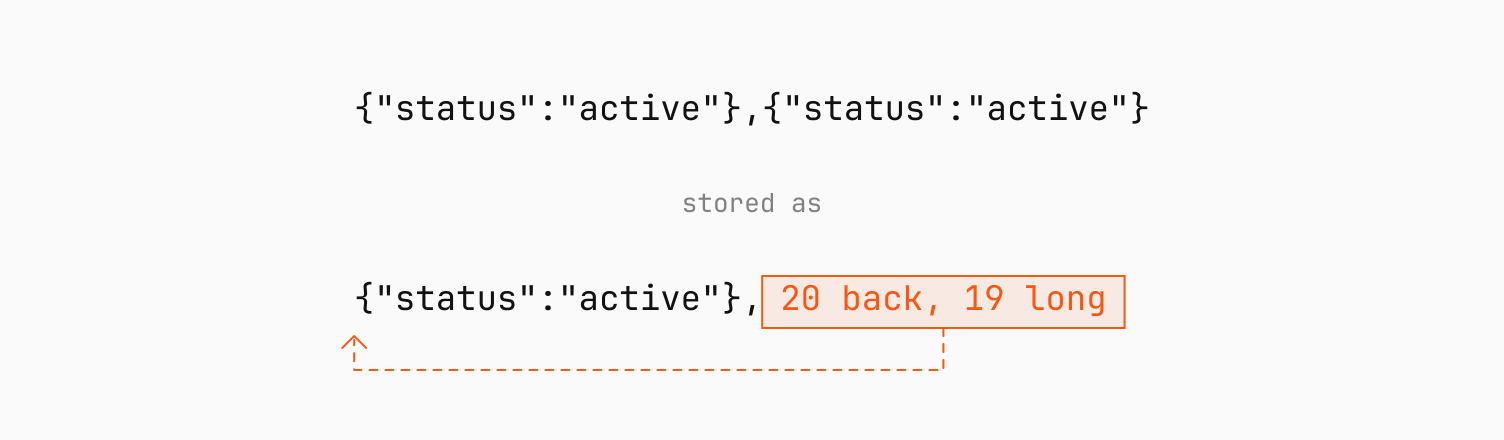
ただし、この引用がさかのぼって参照できる距離には限りがあり、その上限をウィンドウと呼ぶ。以前のコピーがウィンドウの外にあれば、アルゴリズムからは見えず、重複した内容をそのまま丸ごと保存するしかない。
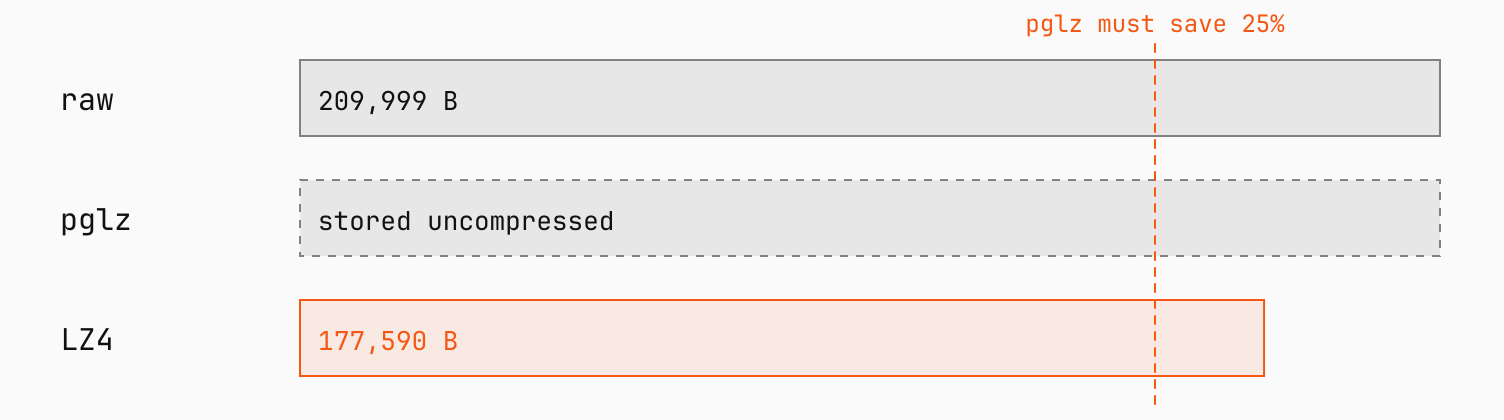
pglz は Postgres に標準で付属する圧縮器だ。ウィンドウは 4 KB で、各位置で過去の一致をいくつか調べ、最も長いものを残す。25% を超えて節約できない場合、Postgres は pglz の結果を破棄する。まったく重複が見つからないデータに当たると、pglz は途中で諦める。
LZ4 は汎用の圧縮器で、用途は Postgres にとどまらない。Postgres はバージョン 14 からこれをサポートしている。ウィンドウは 64 KB だが、探索は行わず、小さなルックアップテーブルから過去の候補をただ一つ取り出す。そのため格段に速い。このテーブルは新しいエントリで古いエントリを次々に上書きしていくので、同じ位置が後ろに現れるほど、LZ4 はそれを見つけにくくなる。LZ4 の結果が 2 バイトを超えて節約できれば、Postgres はそれを保持する。
ウィンドウを試すために、30,000 個のランダムな 6 文字の単語をつなげて長い文字列を作る。各単語の後ろにスペースを 1 つ付けるので 7 バイト、文字列全体でおよそ 210 KB になる。
これを 2 通り作る。500 個の異なる単語から取る場合と、5,000 個から取る場合だ。500 個なら、ある単語が平均しておよそ 500 単語後に再び現れる。つまり約 3.5 KB さかのぼることになる。5,000 個なら約 35 KB さかのぼる。
それぞれの文字列を pglz 列と LZ4 列に格納する。setseed により、実行のたびにランダムに生成される単語が同じになるので、以下のサイズは Postgres 18 で再現できる:
CREATE TABLE words (vocab int, pglz text COMPRESSION pglz, lz4 text COMPRESSION lz4);

SELECT setseed(0.42);

INSERT INTO words
SELECT vocab, body, body
FROM (
  SELECT vocab, string_agg(substr(md5(floor(random() * vocab)::text), 1, 6), ' ') AS body
  FROM (VALUES (500), (5000)) AS v(vocab), generate_series(1, 30000)
  GROUP BY vocab
) s;

SELECT vocab,
       octet_length(pglz) AS raw_bytes,
       pg_column_size(pglz) AS pglz_bytes,
       pg_column_size(lz4) AS lz4_bytes
FROM words ORDER BY vocab;
 vocab | raw_bytes | pglz_bytes | lz4_bytes
-------+-----------+------------+-----------
   500 |    209999 |     105457 |     96022
  5000 |    209999 |     209999 |    177590
(2 rows)
500 単語の場合、平均間隔は pglz の 4 KB ウィンドウに収まるが、間隔には長短があり、重複のおよそ 30% はより後ろの位置に落ちる。LZ4 はその大半を見つけられるので、結果は pglz より約 9% 小さくなる。
5,000 単語の場合、重複のほとんどは pglz の手が届かない場所にある。25% を超えて節約できないため、Postgres はこの値をそのまま保存する。LZ4 はそれでも約 15% 圧縮できる。たまたま近くに落ちた重複のおかげだ。
こうした JSON ドキュメントでは pglz が勝つ
JSON 配列では、どのオブジェクトにも同じキーが繰り返し現れる。どちらのアルゴリズムにとっても、それを見つけるのはたやすい。
10,000 件の注文ドキュメントを、PlanetScale Postgres 18 上の 3 つのテーブルにそれぞれロードした。1 つは EXTERNAL で圧縮なし、1 つは pglz、1 つは LZ4 だ。各ドキュメントには 25 から 100 の明細行があり、どの明細行も同じ 5 つのキーを繰り返す。sku、name、qty、price_cents、tags である。
非圧縮のテーブルは 103 MB。pglz のテーブルは 19 MB、LZ4 のテーブルは 24 MB だった。
どちらもこれらのキーを見つけられるのだから、サイズの差は pglz の追加の探索、つまりより長い一致を見つけられるかどうかで決まる。LZ4 は速度で埋め合わせる。同じドキュメントを 2 回ずつロードして、LZ4 は 0.48 秒と 1.09 秒、pglz は 1.59 秒と 1.73 秒だった。
プレビューの読み取りでは pglz が速い
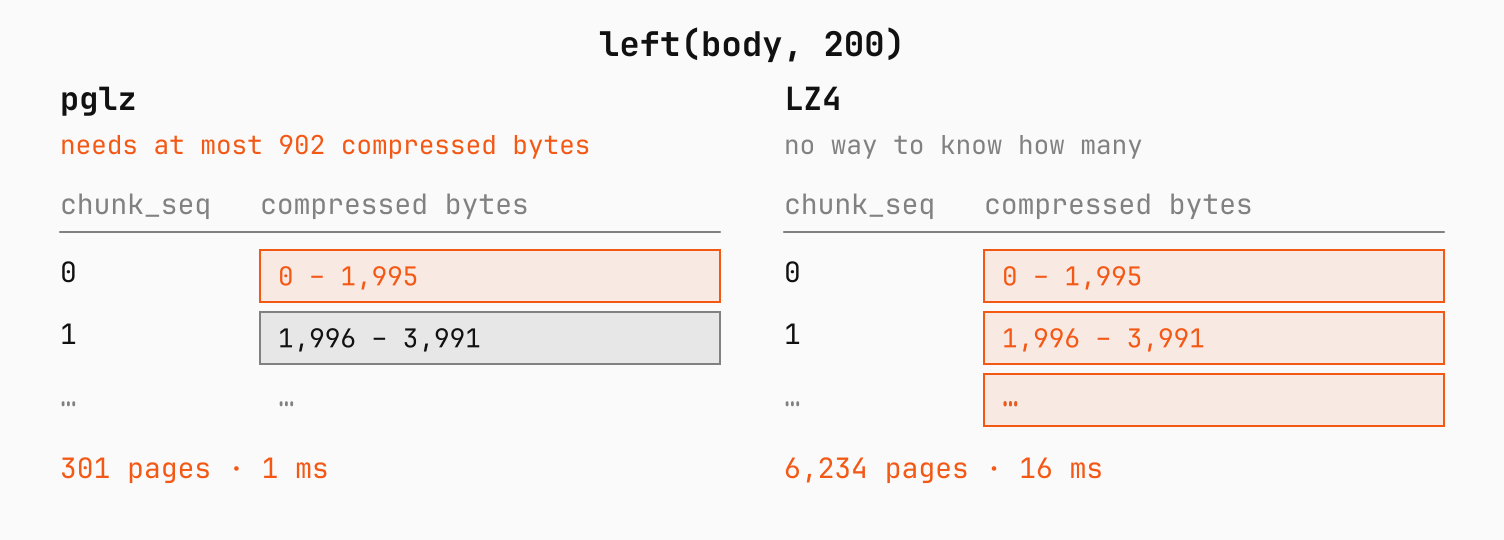
大きな値の先頭部分だけを読むとき、たとえば left(body, 200) で 200 文字のプレビューを取るときも、pglz が勝つ。pglz は元データの 1 バイトあたり 9 ビットを超えることはなく、それに全体で 2 バイトが加わるだけなので、Postgres はプレフィックスに必要な圧縮バイト数に上限を設けられる。1 文字は 1 から 4 バイトなので、200 文字は最大 800 バイト、800 バイトの出力に必要な圧縮バイト数は最大 902 バイトになる。これは 1 チャンクの 1,996 バイトより小さいので、Postgres は最初のチャンクだけを取る。LZ4 には対応する上限がないため、Postgres はまず値全体を取り出すことになる。
約 1 MB のテキスト値を 100 個保存したところ、どちらのアルゴリズムもおよそ半分のサイズに圧縮できた。各値の先頭 200 文字について、pglz は 301 回のページ参照で済み、すべてメモリにヒットして約 1 ms だった。LZ4 は 6,234 回で約 16 ms かかる。非圧縮の EXTERNAL も同じく 301 回だが、ディスク使用量はおよそ 2 倍になる。
圧縮すべきでない場面
圧縮した値はページを占有する量が減る。ディスクを節約でき、テーブルがメモリに残りやすくなり、レプリカやバックアップへ送る WAL も少なくなる。その代わりに CPU を払う。しきい値を超える書き込みのたび、圧縮された値を読むたびにコストがかかる。圧縮は下りトラフィックも減らさない。Postgres は値を展開してから送るからだ。
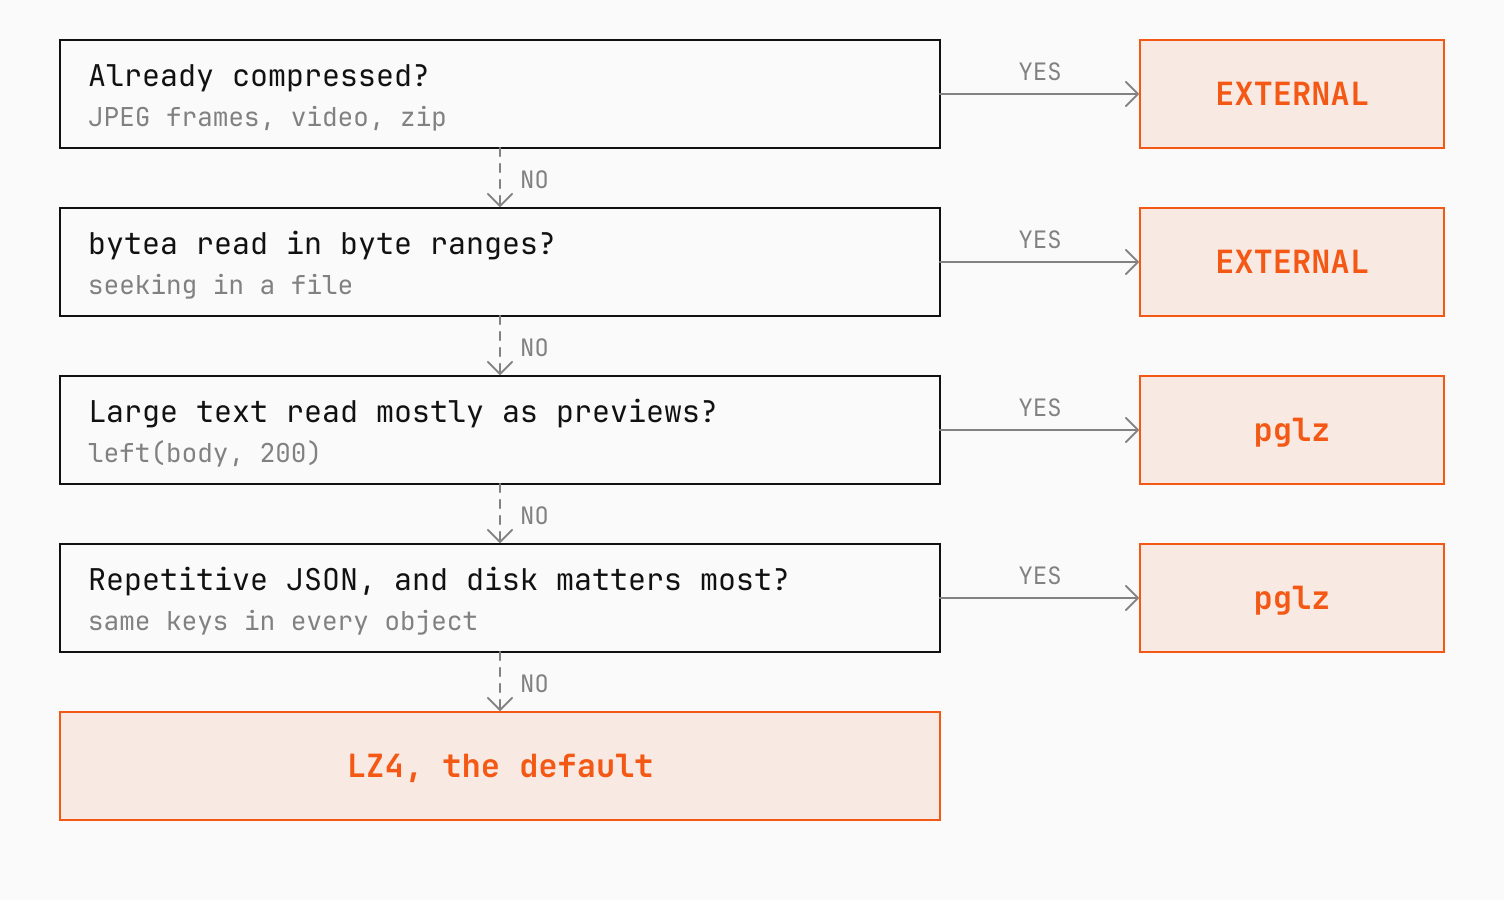
圧縮しないほうが得なデータは 2 種類あり、EXTERNAL を使う。
- すでに圧縮されているデータ。たとえばビデオ会議のデモの JPEG フレームだ。LZ4 はフレームごとに CPU を使うが、ほとんど何も節約できない。
- 途中から読む大きな
byteaの値。ファイル内を seek する場合などだ。
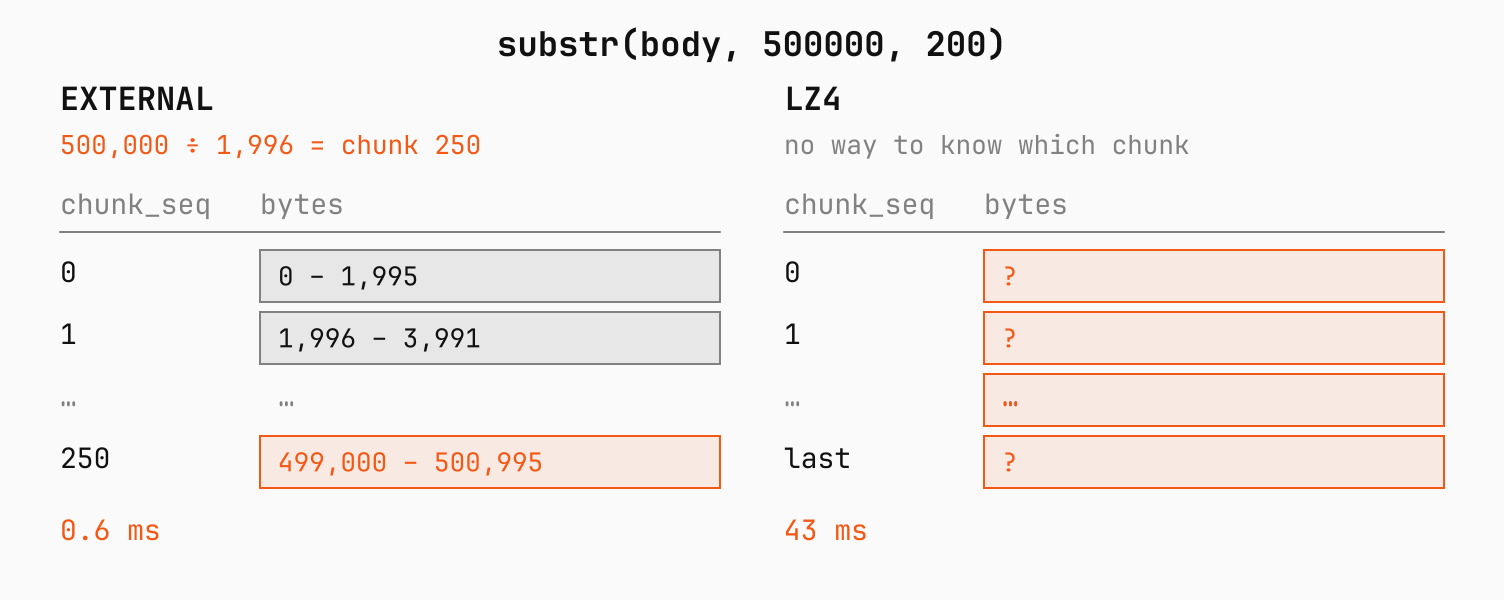
EXTERNAL では最終ブロックを除いて各ブロックがちょうど 1,996 バイトの値を収めるので、Postgres は任意のバイトがどのブロックにあるか計算できる。最初の 250 ブロックで 499,000 バイトを覆うから、500,000 バイト目から始まる 200 バイトはすべて 250 番目のブロックに入っており、Postgres はそのブロックだけを取る。圧縮すると、1 ブロックが収めるのは相変わらず 1,996 バイトだが、そのバイト列が何バイトの値に展開されるかはわからない。だから LZ4 では、Postgres がすべてのブロックを取り戻し、先頭から展開していく。pglz の上限は left() から来るが、500,000 バイト目にとってこの上限は保存された値全体より大きいので、やはりすべてのブロックを読むことになる。
同じ 100 個の値でこの読み方をしたところ、bytea に格納して EXTERNAL で圧縮しなければ 0.6 ms、LZ4 は 43 ms、pglz は 116 ms だった。
まとめ
TOAST が動作するのは、1 行が 2,032 バイトを超えた場合に限られるため、多くの値はそもそも圧縮されない。冒頭の 2,000 個の x がまさにその例だ。実際に圧縮される値については、ほとんどのテーブルで LZ4 が妥当なデフォルトとなる。圧縮率の差よりも速度が重要であり、しかも圧縮率でどちらが上かは一概には言えない。手動で pglz や EXTERNAL を選ぶ価値があるのは、ごく一部のデータ型に限られる。