纯函数式编程能多接近 C?
用 Roc 编写的 DEFLATE 包在 144 项 Silesia 基准测试中,在 M1 MacBook Pro 上中位数仅比手工调优的 C 慢 2.6%,在 Ryzen 3900X 上慢 8.9%。
中文
复制
在 Why Lean is Faster Than Rust 一文中,作者分享了一个令人印象深刻的结果:一个用 Lean 4(一种函数式编程语言兼证明助手)编写的 DEFLATE 压缩库,性能超过了对应的 Rust 包——crates.io 显示该包的下载量超过十亿次。文章写道:
lean-zip击败了miniz_oxide提供的每一个压缩级别,也就是说,我们能在更高吞吐量下提供相同的压缩率。在最快的设置下,我们快 15%,输出还小了 8.8%。
不过文章也指出,虽然他们成功超越了 Rust 的 miniz_oxide,却完全不是 DEFLATE 性能终极 boss 的对手:用 C 写的 libdeflate。
lean-zip在这里当然不是最好的:libdeflate毫无悬念地把它打得落花流水(之所以说毫无悬念,是因为这是一个经过精心调优、使用了架构相关 SIMD 的实现,而我们在 Lean 里碰不到这些)。
接下来登场的是 Roc,一门函数式编程语言(但不是定理证明器),明确以运行时性能为重心。
Roc 的口号是“Fast, Friendly, Functional”,而 Fast 排在第一位,因为跑得快和编译得快一直是它的核心目标。Roc 还不是一门成熟的语言(距离首个带版本号的发布 0.1.0 还有几周),其尚在起步阶段的包生态几乎没做过任何优化工作。尽管如此,凭借语言设计、长期积累的优化以及全新的编译器实现,我认为 Roc 已经具备了足够的基础去挑战冠军:libdeflate。
于是我花了不少时间在 roc-deflate 上反复打磨性能优化。这个包由 Niclas Ahden 编写(并用于他的付费生产工作),用于 DEFLATE 压缩。我没指望在各方面都超过 libdeflate,但想看看它在非流式 API 上能接近到什么程度(roc-deflate 尚未实现流式处理),基准测试使用经典的 Silesia 语料库,并验证两者输出完全一致。
慢不到 10%
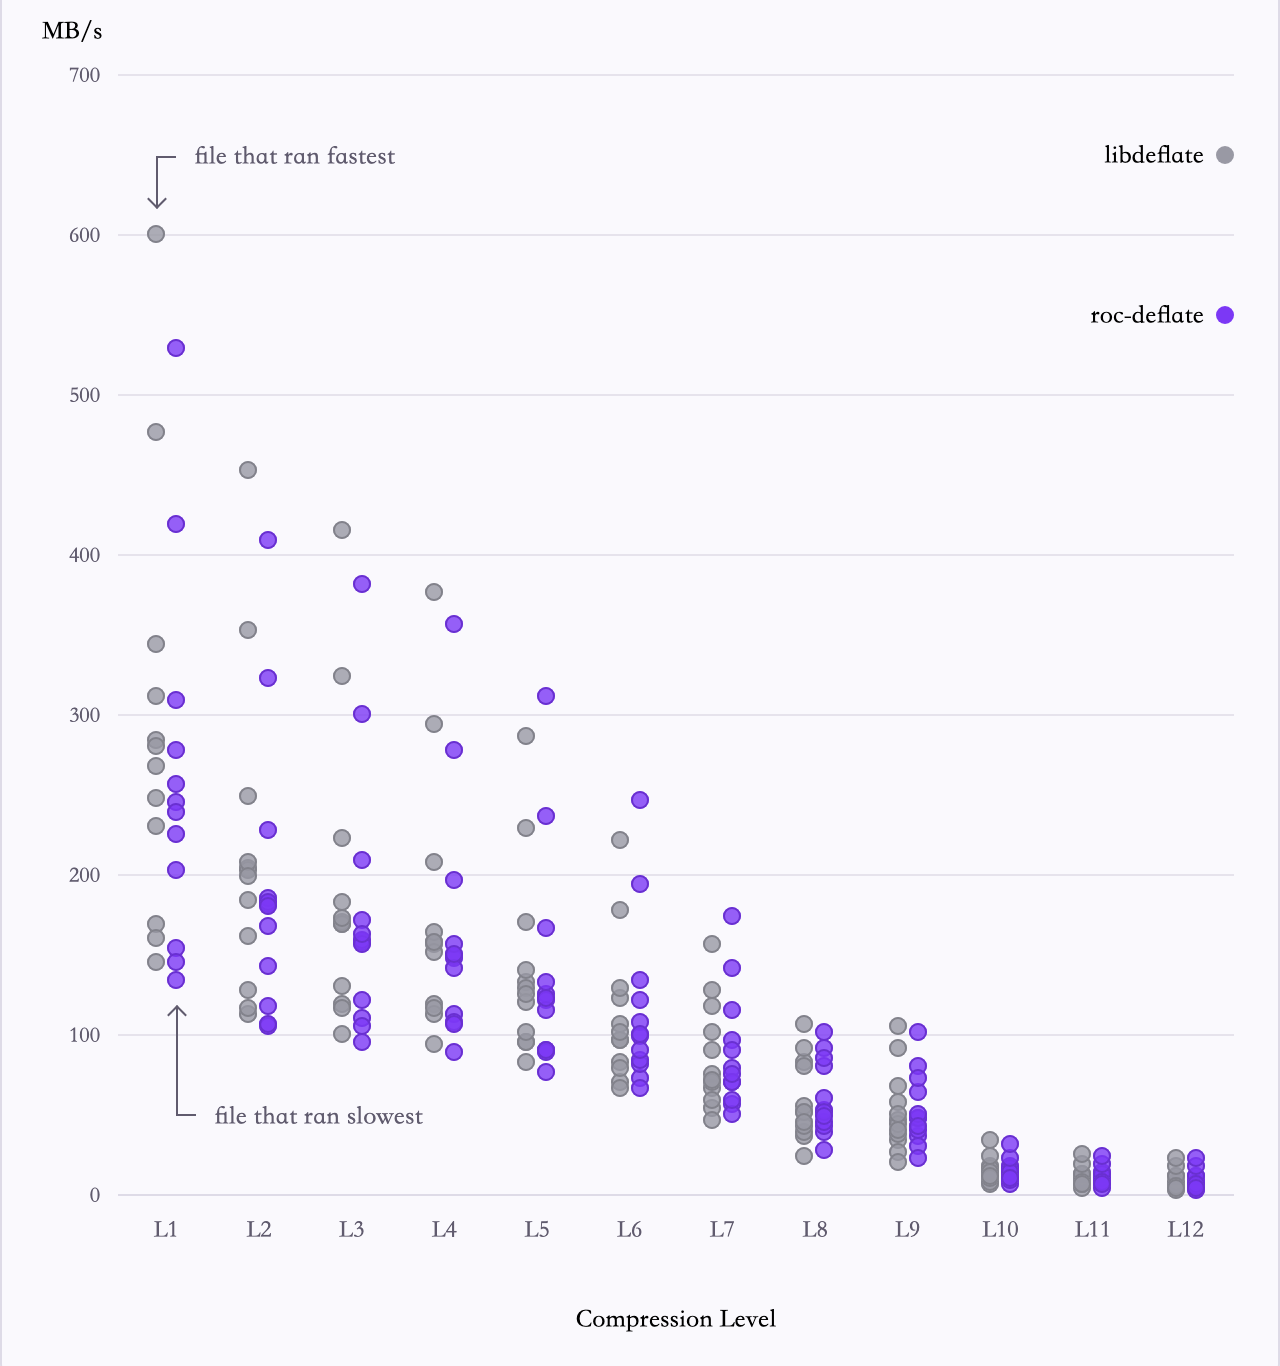
以下是目前的基准测试结果,分别跑在我做全部优化工作的那台 2021 款 M1 MacBook Pro 上,以及一台 AMD Ryzen 9 3900X 的 Ubuntu 机器上,用于 x64 对比。
在这 144 项基准测试中,roc-deflate 的平均成绩慢于 libdeflate:在 Ryzen 3900X 上中位数慢 8.9%,在 M1 MacBook Pro 上慢 2.6%。
Silesia 语料库上的压缩
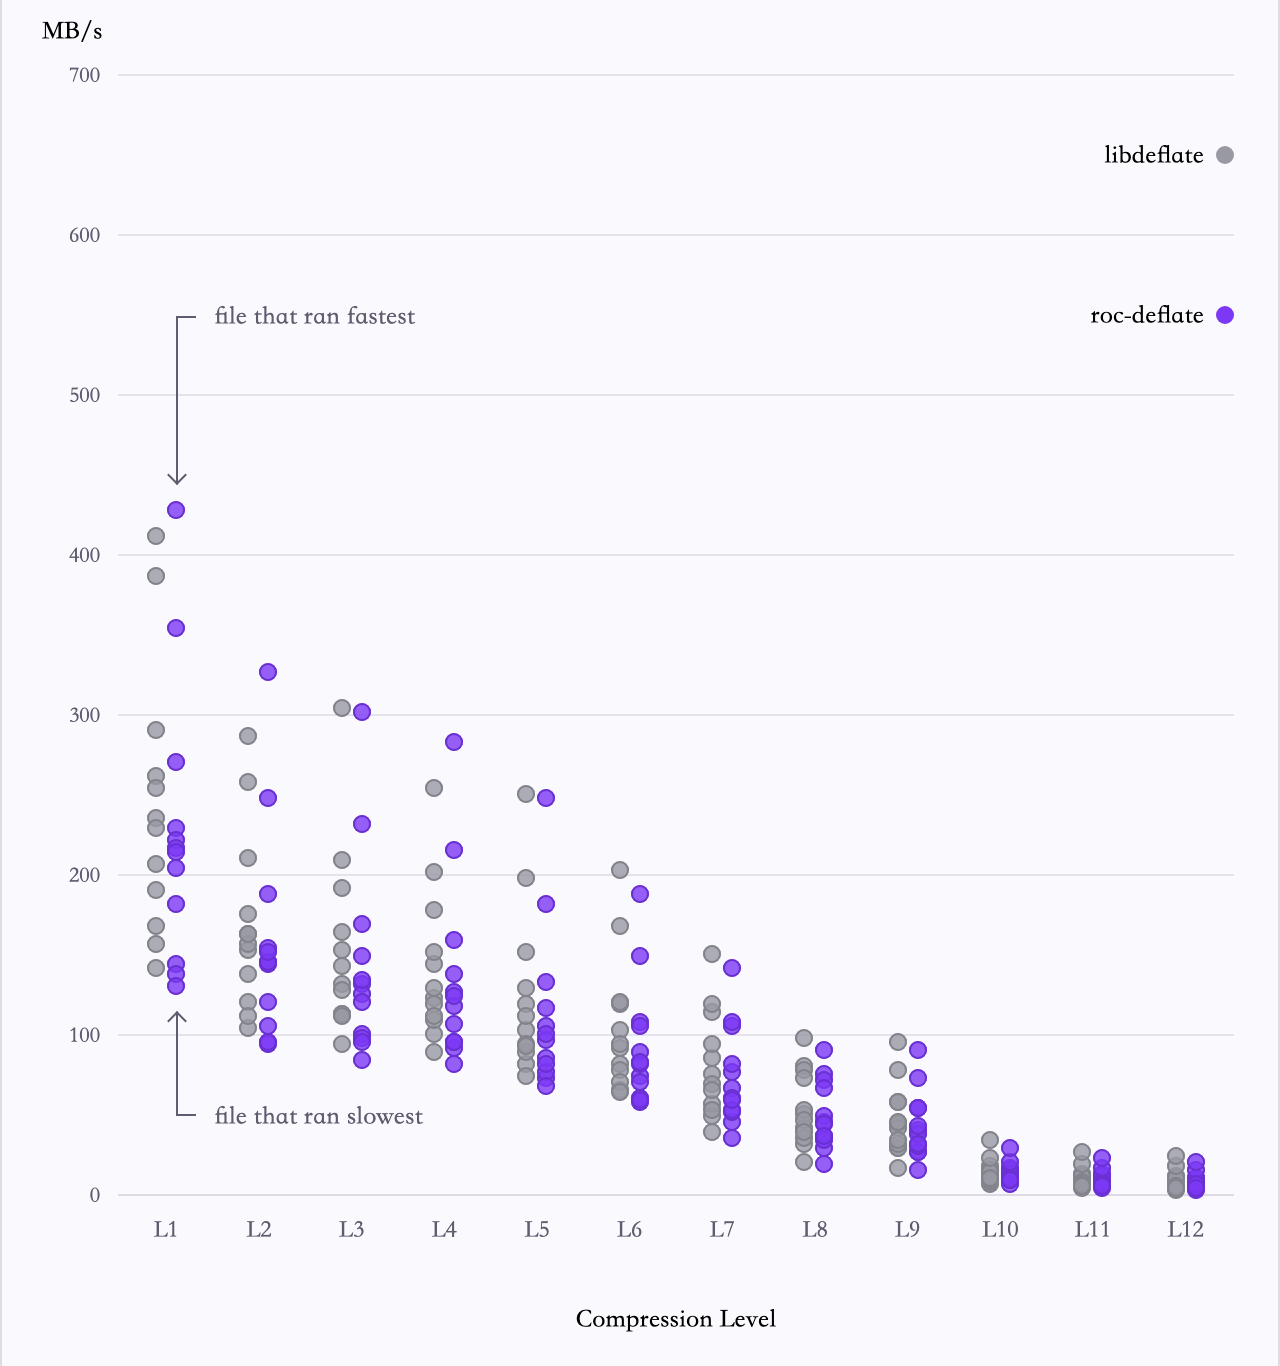
所以,尽管我们在平均值上没能胜过冠军,但面对这样一个精心调优、由 SIMD 驱动的 C 库,中位数只慢个位数百分比,这本身就离谱。说实话,动手之前我并不知道这个结果是可以做到的——Roc 是一门带自动内存管理的函数式语言,而它要对抗的代码根本不需要做边界检查。(边界检查有成本,但话说回来,上一次 C 压缩代码里漏掉边界检查导致严重的远程代码执行漏洞,就是昨天的事。)
这张图展示的不只是中位数差距。在最坏的输入上,roc-deflate 比 libdeflate 慢 18%,但在最好的输入上,roc-deflate 反而快了略超 18%!这并不是因为 Roc 有什么 C 用不了的魔法优化,只是两个实现不同,虽然平均下来 roc-deflate 更慢,但对某些输入它恰好更快。所以,从 libdeflate 换到 roc-deflate 确实有可能提速,但别指望平均情况如此。
需要说清楚的是,C 的性能上限比 Roc 高。凡是 roc-deflate 目前胜过 libdeflate 的输入,C 代码都能把这个差距补上。反过来则不成立:Roc 代码是内存安全的,会自动引用计数,会做边界检查,也没有 Rust 那种 unsafe 可以关掉这一切。这些特性让 Roc 代码拥有比 C、Zig、Rust 以及其他允许完全访问硬件的语言更强的安全保证——而它为此付出的代价,就是更低性能上限。
显然,仅凭这一个结果,我们无法推断 Roc 在一般情况下能逼近 C 到什么程度,但如今已经展示出了一些此前没人知道可以做到的事情。据我所知,这是迄今为止对任何 Roc 包投入优化精力最多的一次,所以别人能逼近这个结果到什么程度,目前完全是未知数。因此,尽管这个结果让我很兴奋,我也很清楚:在优化足够多真实世界的 Roc 代码库之前,我们无从得知它能推广到什么程度!
性能差距换来了什么
一个显而易见的问题是:“为什么要满足于慢上任何幅度?”如果你能够达到 C 级别的性能,为什么不直接用 libdeflate 本身,把剩下的差距彻底抹平?
纯 Roc 实现相比纯 C 实现有几项优势:
- 内存安全。 Roc 代码完全内存安全,语言层面不提供任何可以绕开这一点的原语。这段代码之所以能逼近 C 级别的性能,是因为 Roc 的优化流水线判定许多边界检查和引用计数操作可以被证明安全地优化掉。用纯 Roc 编写的压缩包无法使用那个导致昨天 Brotli 远程代码执行漏洞的未检查内存操作。
- 无副作用。 Roc 的类型系统会推断哪些函数是纯函数、哪些可以产生副作用。纯函数的类型使用细箭头,例如
Bool -> Bool,而有副作用的函数使用粗箭头,例如Bool => Bool。(与内存安全一样,Roc 强制执行这一点,且不提供任何绕开的方式。)因此,当你看到 roc-deflate 的函数注解里只有细箭头时,你就知道它们确实是纯函数。 - 供应链安全。 Roc 没有任意 FFI,这意味着你可以确定 roc-deflate 的纯函数连尝试做 I/O 或访问任意内存都做不到。鉴于供应链攻击的激增,知道这一点很有价值:在一个被攻陷的 Roc 包中,恶意行为者用纯函数所能造成的破坏仅限于返回错误的值、崩溃或浪费系统资源。Roc 包同样不支持构建脚本,而两个月前成功攻陷流行的 Rust
arrayref包所用的正是这条途径。 - 可移植性。 Roc 纯函数被设计得极具确定性:给定相同的参数,它们总是返回相同的值——不仅在同一台机器上如此,编译到任何目标平台上也是如此。(这些函数也可能崩溃或无法终止,但这类行为同样应当在各目标平台之间保持确定性。)Roc 纯函数在两个不同系统上运行时,唯一可能出现不同行为的情形,是其中一个系统在执行中途耗尽内存。
这些保证如果在实践中不成立,那只能是 Roc 编译器、应用所运行的平台或底层硬件出了缺陷。所以,当你在 roc-deflate 的文档里看到整个包 100% 是纯函数时,就可以确信包里提供的所有东西都具备上述全部性质。类型系统会强制保证这一点!
我们为什么一直在这上面下这么大功夫,把命题反过来看也许会更清楚:你愿意为了个位数的平均提速百分比,放弃有保证的内存安全、有保证的无副作用、有保证的跨所有目标平台的确定性行为,以及包中没有可被利用的构建脚本所带来的安全收益吗?
这个问题的答案因用例而异,完全合理——比如 Roc 自己的编译器就想要硬件能提供的最高性能——但我猜很多读到这里的读者都能明白,我们为什么对取得这个结果如此兴奋。
Roc 特有的优化
提升 roc-deflate 成绩的优化大多来自通用的优化技术,这些技术在各语言中普遍有益。(我一直推荐 Casey Muratori 的 Performance-Aware Programming 系列,我付费学过,收获很大。)不过其中也有一些优化是 Roc 特有的,我想在这里提一下,供其他人参考。即使你不写 Roc 代码,这也能让你大致了解 Roc 是如何实现其性能的。
避免不必要的共享
Roc 最有效的优化之一是机会式可变(Koka 称之为 "Functional but In-Place")。它的工作原理可以看 Roc 的机会式可变文档,但从性能优化的角度看,关键是避免不必要的共享,让值保持唯一,从而有资格进行原地修改。
外提边界检查
在 Roc 里,你没法像在 C、Zig 和 Rust 中那样关掉边界检查(比如从一个动态大小的集合里取值),但只要编译器能确定检查必定通过,它就会把这些检查优化掉。边界检查在循环里代价最高,所以在循环开始前加上类似 if collection.len() <= highest_index_used { return 0 } 这样的代码往往能省下不少开销。这多出来的一次检查看起来是多余的,但它能让优化器确认:有了这个提前返回,循环内部就不可能再走到失败分支,从而安全地删掉代价更高的检查。
在编译期构建查找表
只要不依赖运行时输入,就可以用 Roc 的编译期求值在编译期拼出查找表。更妙的是,由于长度在编译期已知,你可以写 Ok(entry) = lookup_table.get(5) 来做穷尽式模式匹配,Roc 编译器借助编译期求值能确认它是合法的。这样就免去了非常量表可能不得不付出的运行时边界检查。
考虑使用回绕算术
在 Roc 中,a + b 会被脱糖为 a.plus(b)。对于 U64 这样的整数,U64.plus 带有溢出检查,而 plus_wrap 没有。plus 虽然是更安全的默认选择,但溢出检查有运行时开销——CPU 执行回绕整数运算只需一条指令。当 Roc 编译器能证明不会溢出时,plus 和 plus_wrap 会优化成相同的指令;证明不了的时候,改用 plus_wrap 可能带来提速。
改进空间
roc-deflate 的性能肯定还有提升余地,尤其是在 x64 CPU 上,Roc 编译器的优化流水线也一样。
到这一步,我比较有把握低垂的果子已经摘完了。不过谁想自己试试的话,这是我在 Linux 上搭建并运行基准测试套件所用的脚本。(提醒一下:这个脚本是 Claude Opus 5.5 生成的,我没有做过安全审查;在沙箱之外运行,风险自负!)脚本把 Roc 编译器的两个版本和 roc-deflate 的版本都固定住了,所以如果你想试一些潜在的改进,记得改掉那些 commit。
接下来直到 Roc 0.1.0 发布为止,我会把全部精力都放在这个版本上。这个版本前后做了八年,能终于有一个带版本号的发布,我很高兴。想进一步了解 Roc,可以看 roc-lang.org,或者来 Roc Zulip 打个招呼。