純粋関数型プログラミングはどこまで C に近づけるか?
Roc で書いた DEFLATE パッケージが、Silesia コーパスの 144 項目で手作業チューニング済みの C に中央値で M1 MacBook Pro は 2.6%、Ryzen 3900X は 8.9% まで迫った。
日本語
コピー
Why Lean is Faster Than Rust の記事が、印象的な結果を紹介している。関数型プログラミング言語であり証明支援系でもある Lean 4 で書かれた DEFLATE 圧縮ライブラリが、対応する Rust クレートを性能で上回ったというのだ。crates.io の表示によれば、そのクレートのダウンロード数は10 億回を超える。記事にはこうある。
lean-zipはminiz_oxideが提供するすべての圧縮レベルを打ち負かした。つまり、同じ圧縮率をより高いスループットで実現できる。最速の設定では 15% 速く、出力は 8.8% 小さくなる。
ただし記事はこうも指摘している。Rust の miniz_oxide には勝てたものの、DEFLATE 性能のラスボスである C 製の libdeflate には全く歯が立たなかった、と。
lean-zipが最良でないのは当然だ。libdeflateに容赦なく打ち負かされている(容赦なく、というのも、これはアーキテクチャ依存の SIMD を使い、細かくチューニングされた実装であり、Lean ではそこに手が届かないからだ)。
次に登場するのが Roc だ。関数型プログラミング言語だが定理証明器ではなく、実行時性能を明確に重視している。
Roc のスローガンは「Fast, Friendly, Functional」で、Fast が先頭に来る。速く動くことと速くコンパイルすることが、一貫して中核目標だからだ。Roc はまだ成熟した言語ではない(最初のバージョン番号付きリリース 0.1.0 まであと数週間)。パッケージエコシステムもまだ初期段階で、最適化はほとんど行われていない。それでも、言語設計と長年にわたる最適化の蓄積、そして新しいコンパイラ実装によって、Roc には王者 libdeflate に挑むだけの土台がすでにあると私は考えている。
そこで私は roc-deflate の性能最適化にかなりの時間を費やした。このパッケージは Niclas Ahden が DEFLATE 圧縮のために書き(有償の実務でも使われている)、私はあらゆる面で libdeflate を超えようとは思わなかったが、非ストリーミング API(roc-deflate はまだストリーミングを実装していない)でどこまで迫れるか見てみたかった。ベンチマークには定番の Silesia コーパスを使い、両者の出力が完全に一致することも検証した。
10% 以内の遅さ
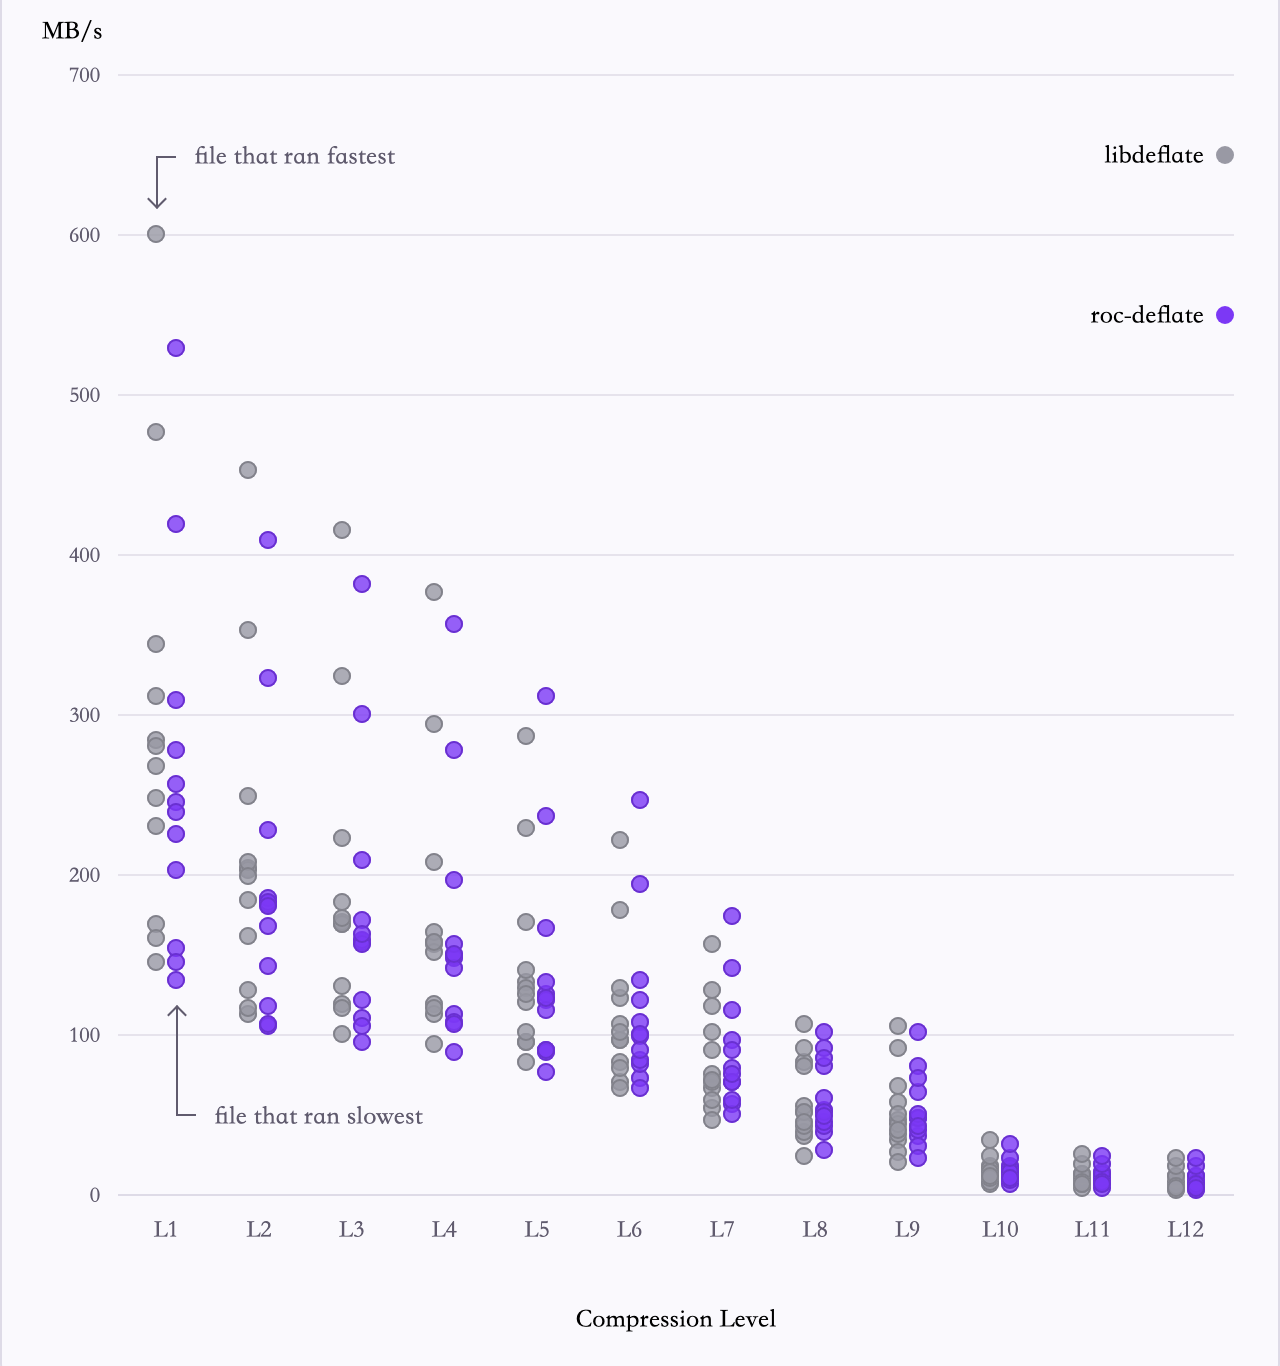
現時点のベンチマーク結果は以下のとおりだ。最適化作業をすべて行った 2021 年製 M1 MacBook Pro と、x64 での比較用に AMD Ryzen 9 3900X の Ubuntu マシンで計測している。
これら 144 項目のベンチマークで、roc-deflate は平均して libdeflate より遅い。中央値で Ryzen 3900X では 8.9% 遅く、M1 MacBook Pro では 2.6% 遅い。
Silesia コーパスでの圧縮
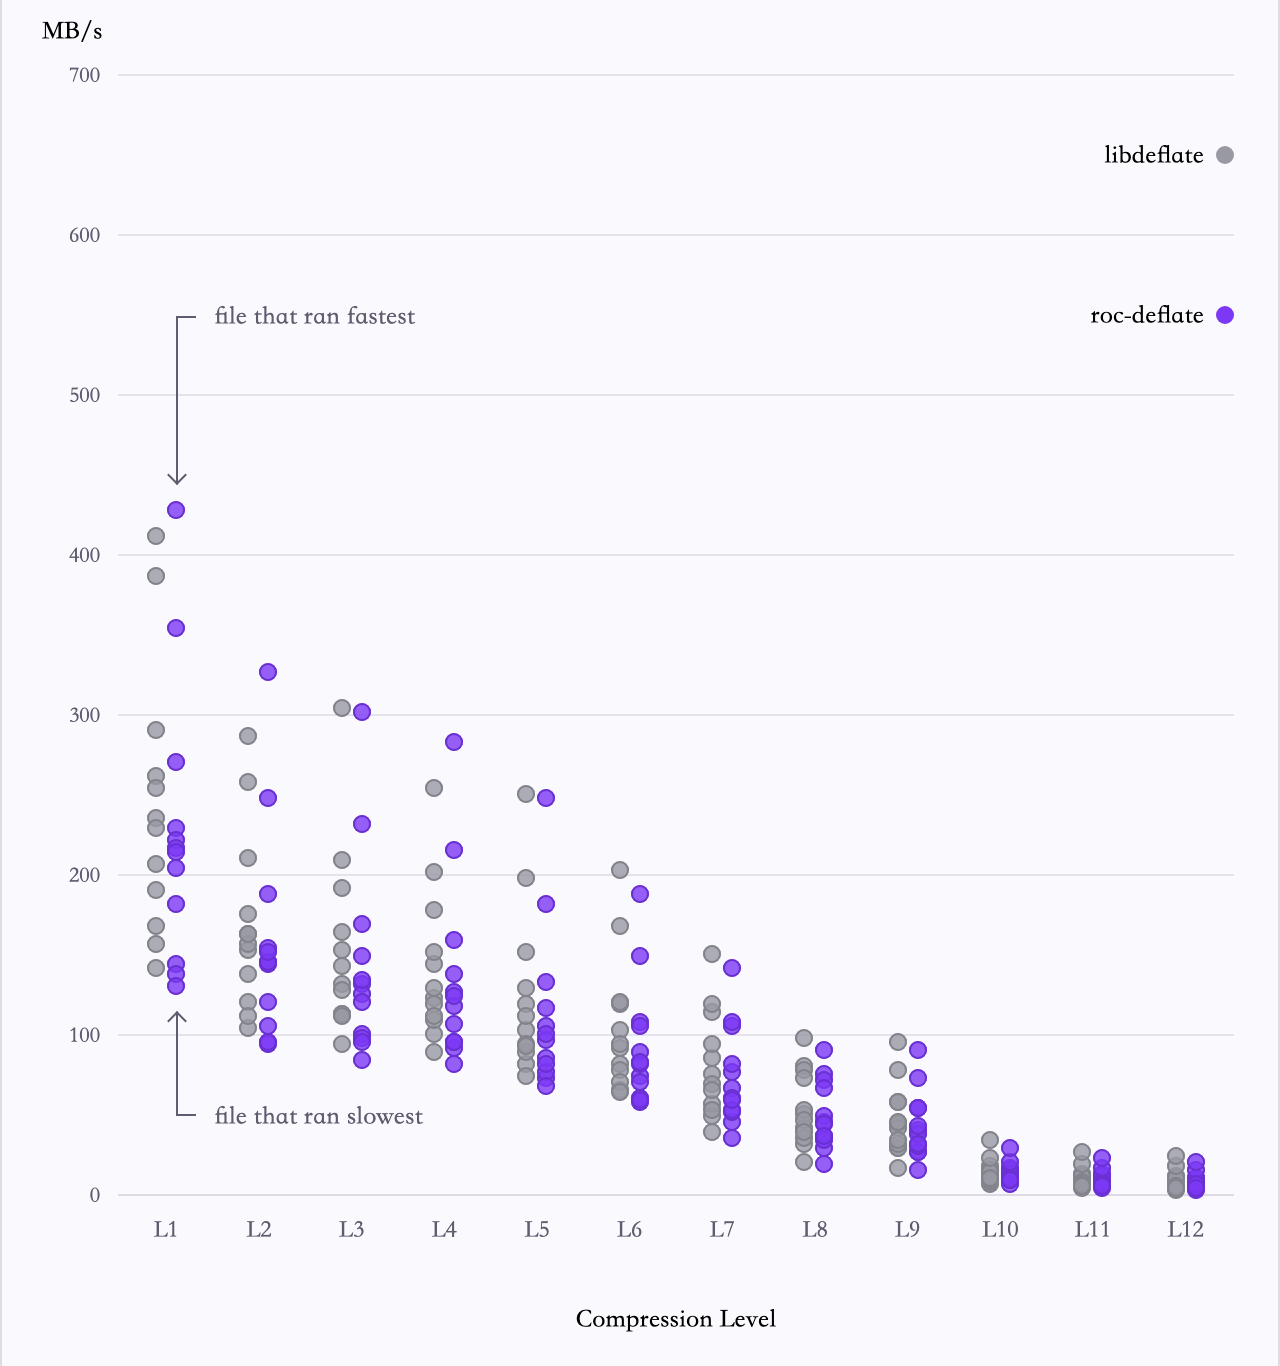
だからこそ、平均値ではチャンピオンに勝てなかったとはいえ、入念にチューニングされた SIMD 駆動の C ライブラリ相手に中央値で 1 桁台のパーセントしか遅くないというのは、それ自体がおかしい。正直に言うと、着手する前はこの結果が出せるとは思っていなかった。Roc は自動メモリ管理を備えた関数型言語で、相手のコードは境界チェックすら必要としない。(境界チェックにはコストがかかるが、そもそも C の圧縮コードで境界チェックを怠ったせいで深刻なリモートコード実行脆弱性が生まれたのは、つい昨日のことだ。)
このグラフが示しているのは中央値の差だけではない。最悪の入力では roc-deflate は libdeflate より 18% 遅いが、最良の入力では roc-deflate のほうが 18% 強も速い!これは Roc に C が使えない魔法の最適化があるからではなく、単に二つの実装が異なるというだけのことだ。平均すれば roc-deflate のほうが遅いが、特定の入力ではたまたま速い。つまり libdeflate から roc-deflate に乗り換えることで速度が上がる可能性は確かにあるが、平均的なケースでそうなるとは期待しないほうがいい。
はっきりさせておくと、C の性能上限は Roc より高い。roc-deflate が現在 libdeflate に勝っている入力はすべて、C のコードならその差を埋められる。逆は成り立たない。Roc のコードはメモリ安全で、自動参照カウントを行い、境界チェックもするし、Rust のようにこれらすべてを無効化できる unsafe も存在しない。こうした特性のおかげで、Roc のコードは C、Zig、Rust、その他ハードウェアへの完全なアクセスを許す言語よりも強い安全保証を持つ——その代償が、低い性能上限だ。
もちろん、この一つの結果だけから Roc が一般的にどこまで C に迫れるかは推測できない。それでも、これまで誰も可能だと知らなかったことが現実に示された。私の知る限り、これまでにどの Roc パッケージに対してもこれほど最適化の労力が注がれたことはないので、他の人がどこまでこの結果に迫れるかは現時点でまったく未知数だ。だから、この結果には興奮している一方で、はっきりと分かっている。現実の Roc コードベースを十分に最適化するまでは、これがどこまで一般化できるのか知るすべはないのだ。
性能差と引き換えに得たもの
当然出てくる疑問はこうだ。「なぜどんなに小さくても遅いことで満足するのか?C 並みの性能に到達できるなら、libdeflate そのものを使えば残りの差も完全に埋まるではないか?」
純粋な Roc 実装には、純粋な C 実装にない利点がいくつかある。
- メモリ安全。 Roc のコードは完全にメモリ安全で、言語レベルでこれを回避できるプリミティブは一切提供されていない。このコードが C 並みの性能に迫れているのは、Roc の最適化パイプラインが多くの境界チェックと参照カウント操作を安全に除去できると証明したからだ。純粋な Roc で書かれた圧縮パッケージは、昨日の Brotli リモートコード実行脆弱性を引き起こしたような未チェックのメモリ操作を使えない。
- 副作用なし。 Roc の型システムはどの関数が純粋で、どれが副作用を持ちうるかを推論する。純粋関数の型は細い矢印を使い、例えば
Bool -> Boolのようになり、副作用を持つ関数は太い矢印を使い、例えばBool => Boolのようになる。(メモリ安全と同様、Roc はこれを強制し、回避する手段を提供しない。)だから roc-deflate の関数注釈に細い矢印しか見当たらなければ、それらが本当に純粋関数だと分かる。 - サプライチェーンの安全性。 Roc には任意の FFI がない。つまり roc-deflate の純粋関数は I/O を試みることも任意のメモリにアクセスすることもできないと確信できる。サプライチェーン攻撃が急増する今、これは心強い事実だ。侵害された Roc パッケージの中で、悪意ある者が純粋関数でできることといえば、誤った値を返す、クラッシュする、システムリソースを浪費する程度に限られる。Roc パッケージはビルドスクリプトもサポートしていない。二か月前に人気の Rust
arrayrefパッケージの侵害に成功した際に使われた経路が、まさにこれだった。 - ポータビリティ。 Roc の純粋関数は徹底して決定的になるよう設計されている。同じ引数を与えれば常に同じ値を返す——同じマシン上だけでなく、どのターゲットプラットフォームにコンパイルしてもそうなる。(これらの関数はクラッシュしたり停止しなかったりすることもあるが、そうした挙動もターゲットプラットフォーム間で決定的であるべきだ。)Roc の純粋関数が二つの異なるシステム上で動作が異なりうる唯一のケースは、片方のシステムが実行の途中でメモリを使い果たしたときだ。
これらの保証が実際に成り立たないとすれば、それは Roc コンパイラ、アプリが動くプラットフォーム、あるいは基盤ハードウェアのいずれかに不具合があるということにすぎない。だから roc-deflate のドキュメントでパッケージ全体が 100% 純粋関数だと目にしたときは、パッケージが提供するすべてのものが上記の性質をすべて備えていると確信していい。型システムがそれを強制しているのだから!
なぜこれほど力を注いでいるのかは、命題を裏返すと分かりやすいかもしれない。1 桁台の平均速度向上のために、保証されたメモリ安全、保証された副作用のなさ、すべてのターゲットプラットフォームにわたる保証された決定的挙動、そしてパッケージに悪用可能なビルドスクリプトが存在しないことによる安全性を、あなたは手放すだろうか?
この問いへの答えはユースケースによって変わるし、それでまったく妥当だ——例えば Roc 自身のコンパイラはハードウェアが提供できる最高の性能を求めている——が、ここまで読んだ多くの読者なら、私たちがこの結果にこれほど興奮している理由を理解できるだろう。
Roc 固有の最適化
roc-deflate のスコアを押し上げた最適化の多くは、どの言語でも広く役立つ汎用的な手法によるものだ(Casey Muratori の Performance-Aware Programming シリーズではいつも勧めている。自分も有料で受講して、得るところが大きかった)。とはいえ、その中には Roc 固有のものもあり、他の人の参考になると思ったのでここに書いておく。Roc のコードを書かない人でも、Roc がどうやって性能を出しているのかの概要はつかめるはずだ。
不要な共有を避ける
Roc で最も効果の大きい最適化のひとつがopportunistic mutation(Koka では "Functional but In-Place" と呼んでいる)だ。仕組みは Roc のopportunistic mutation のドキュメントに譲るが、性能最適化の観点で肝心なのは、不要な共有を避けて値をユニークなまま保ち、インプレース変更の対象にすることだ。
境界チェックを外に出す
Roc では、C や Zig、Rust のように境界チェックを切ることはできない(動的なサイズのコレクションから値を取り出すときなど)。ただし、チェックが必ず通るとコンパイラが判断できれば、そのチェックは最適化で消える。境界チェックはループの中でこそ高くつくので、ループの前に if collection.len() <= highest_index_used { return 0 } のようなコードを足すだけでかなりのコストを節約できることが多い。余分に見えるチェックがひとつ増えるが、この早期リターンがあることで、ループ内では失敗側の分岐に到達し得ないと最適化器が確認でき、より高コストなチェックを安全に削除できる。
ルックアップテーブルをコンパイル時に構築する
実行時の入力に依存しないなら、Roc のコンパイル時評価を使ってルックアップテーブルをコンパイル時に組み立てられる。さらに、長さがコンパイル時に分かっているので、Ok(entry) = lookup_table.get(5) と書いて網羅的なパターンマッチができ、コンパイル時評価のおかげで Roc コンパイラがそれが正当だと確認できる。これで、可変長テーブルが払わざるを得ない実行時の境界チェックを省ける。
ラップアラウンド演算を検討する
Roc では a + b が a.plus(b) に脱糖される。U64 のような整数では、U64.plus にオーバーフローチェックがあり、plus_wrap にはない。plus はより安全な既定の選択だが、オーバーフローチェックには実行時コストがかかる——CPU がラップアラウンド整数演算を実行するのに必要なのは命令ひとつだ。オーバーフローしないと Roc コンパイラが証明できる場合、plus と plus_wrap は同じ命令に最適化される。証明できないときは、plus_wrap に切り替えることで速度が上がるかもしれない。
改善の余地
roc-deflate の性能にはまだ伸びしろがあるはずだ。とくに x64 CPU 上では。Roc コンパイラの最適化パイプラインも同じことが言える。
ここまで来ると、低く垂れている実はもう取り尽くしたという感触がある。自分で試したい人は、Linux でベンチマークスイートを構築して実行するのに使ったスクリプトがこれだ(注意:このスクリプトは Claude Opus 5.5 が生成したもので、自分はセキュリティレビューをしていない。サンドボックスの外で実行するなら自己責任で!)。スクリプトは Roc コンパイラの 2 つのバージョンと roc-deflate のバージョンを固定しているので、改善案を試すときはその commit を書き換えてほしい。
Roc 0.1.0 のリリースまでは、このバージョンに全力を注ぐつもりだ。8 年越しで、ようやくバージョン番号の付いたリリースを出せるのはうれしい。Roc についてもっと知りたいなら roc-lang.org を見るか、Roc の Zulip に挨拶しに来てほしい。