あなたのスキルには評価の仕組みが必要です
Expo が coding agent のスキル発見と活用をどうテストしているか。CI に eval harness を組み、スキルカタログの打ち切りから何を学んだか。
日本語
コピー
あなたの skills には評価の仕組みが要る
Expo は coding agent の skills をどうテストしているか:CI に eval harness を組み込み、ディレクトリの切り詰めから何を学んだか。
この記事は Georgian AI Lab の Aditya Shukla、Kartik Gupta、David Tingle との共同執筆です。私たちは彼らと組み、coding agent が Expo の agent skills をどう見つけ、どう使うかを測定しました。
要点
- **agent が skill を見つけられるかをテストする。skill が呼び出されたときに使えるかどうかだけでは不十分だ。**直接呼び出しても、日常業務の中で agent がその skill を発見するかどうかは分からない。実際のタスクに近い prompt を使い、agent の trace を調べて何を見つけたのかを確認する。
- **明確な入口となる skill を用意し、agent がより専門的なガイダンスにたどり着けるようにする。**アプリ構築タスク 10 件で、
expo-overviewを入口 skill として加えたところ、関連する Expo skill を読み込んだ agent の割合は 9% から 55% に上がった。 - **skill ディレクトリが混み合うことを前提に設計する。**多くの skill が同じディレクトリの予算を奪い合うと、説明が切り詰められたり省略されたりする。最も重要な手がかりは skill のタイトルと最初の一文に置き、実際に近いディレクトリ環境でテストする。
Expo では agent skills をひとつのプラグインにまとめ、Claude Code と Codex で使えるようにしている。このプラグインが扱う範囲はかなり広い。ネイティブ UI の構築、ナビゲーションの設定、データ取得、アニメーションの追加、Expo Modules の使用、自社クラウドサービスとの連携——それぞれに対応する skill がある。私たちはこれらの skill を磨き続け、できるだけ良いコンテキストを足して、coding agent がすでに持つ知識を補い、タスクの中でより良い判断を下せるようにしてきた。
だがしばらくの間、こうした改善が本当に役立っているかを判断する確実な方法がなかった。自分で prompt を試し、agent がそれらしい動きをするのを見て、結果は悪くないと結論づける。しかし eval なしで skill を書くのは、テストなしでコードを書くことにどんどん似てきた。「この prompt なら通る」は、別の形の「自分のマシンでは動く」になりつつある。
この問題は、評価に関する Georgian のより広い経験と通じる。最終的な答えには、途中で起きたことのすべては現れない。Your AI Systems Need an Eval Loop の中で、Georgian AI Lab の Asna Shafiq は、trace がチームの agent の挙動の観察にどう役立つかを語っている。ただし、その観察を測定可能で改善可能なものにするには eval が要る。私たちは同じ考え方を自分の skills に持ち込んだ。ある skill を単体で使って動くかどうかではなく、日常のアプリ開発タスクの中で agent が適切な skill の組を見つけられるかをテストするのだ。
自分たちの仕事のテストの仕方にも偏りがあった。これらの skill の作者であり保守者である私たちは、正しい使い方をすでに知っている。Expo UI skill を試したいときは、Claude Code で /expo-ui を、Codex で $expo-ui を呼び出し、agent がそれをどう使うかを見る。
これは skill が読み込まれた後に方向性として役立つかは示せる。だがほとんどのユーザーは、毎回名前で skill を呼び出したりはしない。たいていは欲しいものをそのまま説明する。「Expo で iOS の ToDo アプリを作って。ネイティブアプリらしい使い心地にして」とか、「このアプリにタブと設定画面を追加して」といった具合に。skill の内部のガイダンスが働く前に、agent がその skill を関連ありと気づき、呼び出すと決める必要がある。
この過程にある多くの変数を測る仕組みが、私たちにはなかった。
eval harness を構築する
これを解決するため、Georgian の同僚と一緒に評価 harness を開発した。彼らが以前に eval ループで行った仕事が、今回の設計に影響を与えている。1)実行前に、どの証拠が重要かを定義する。2)対象タスクにおける agent の軌跡を記録する。3)統制された条件で挙動を比較する。
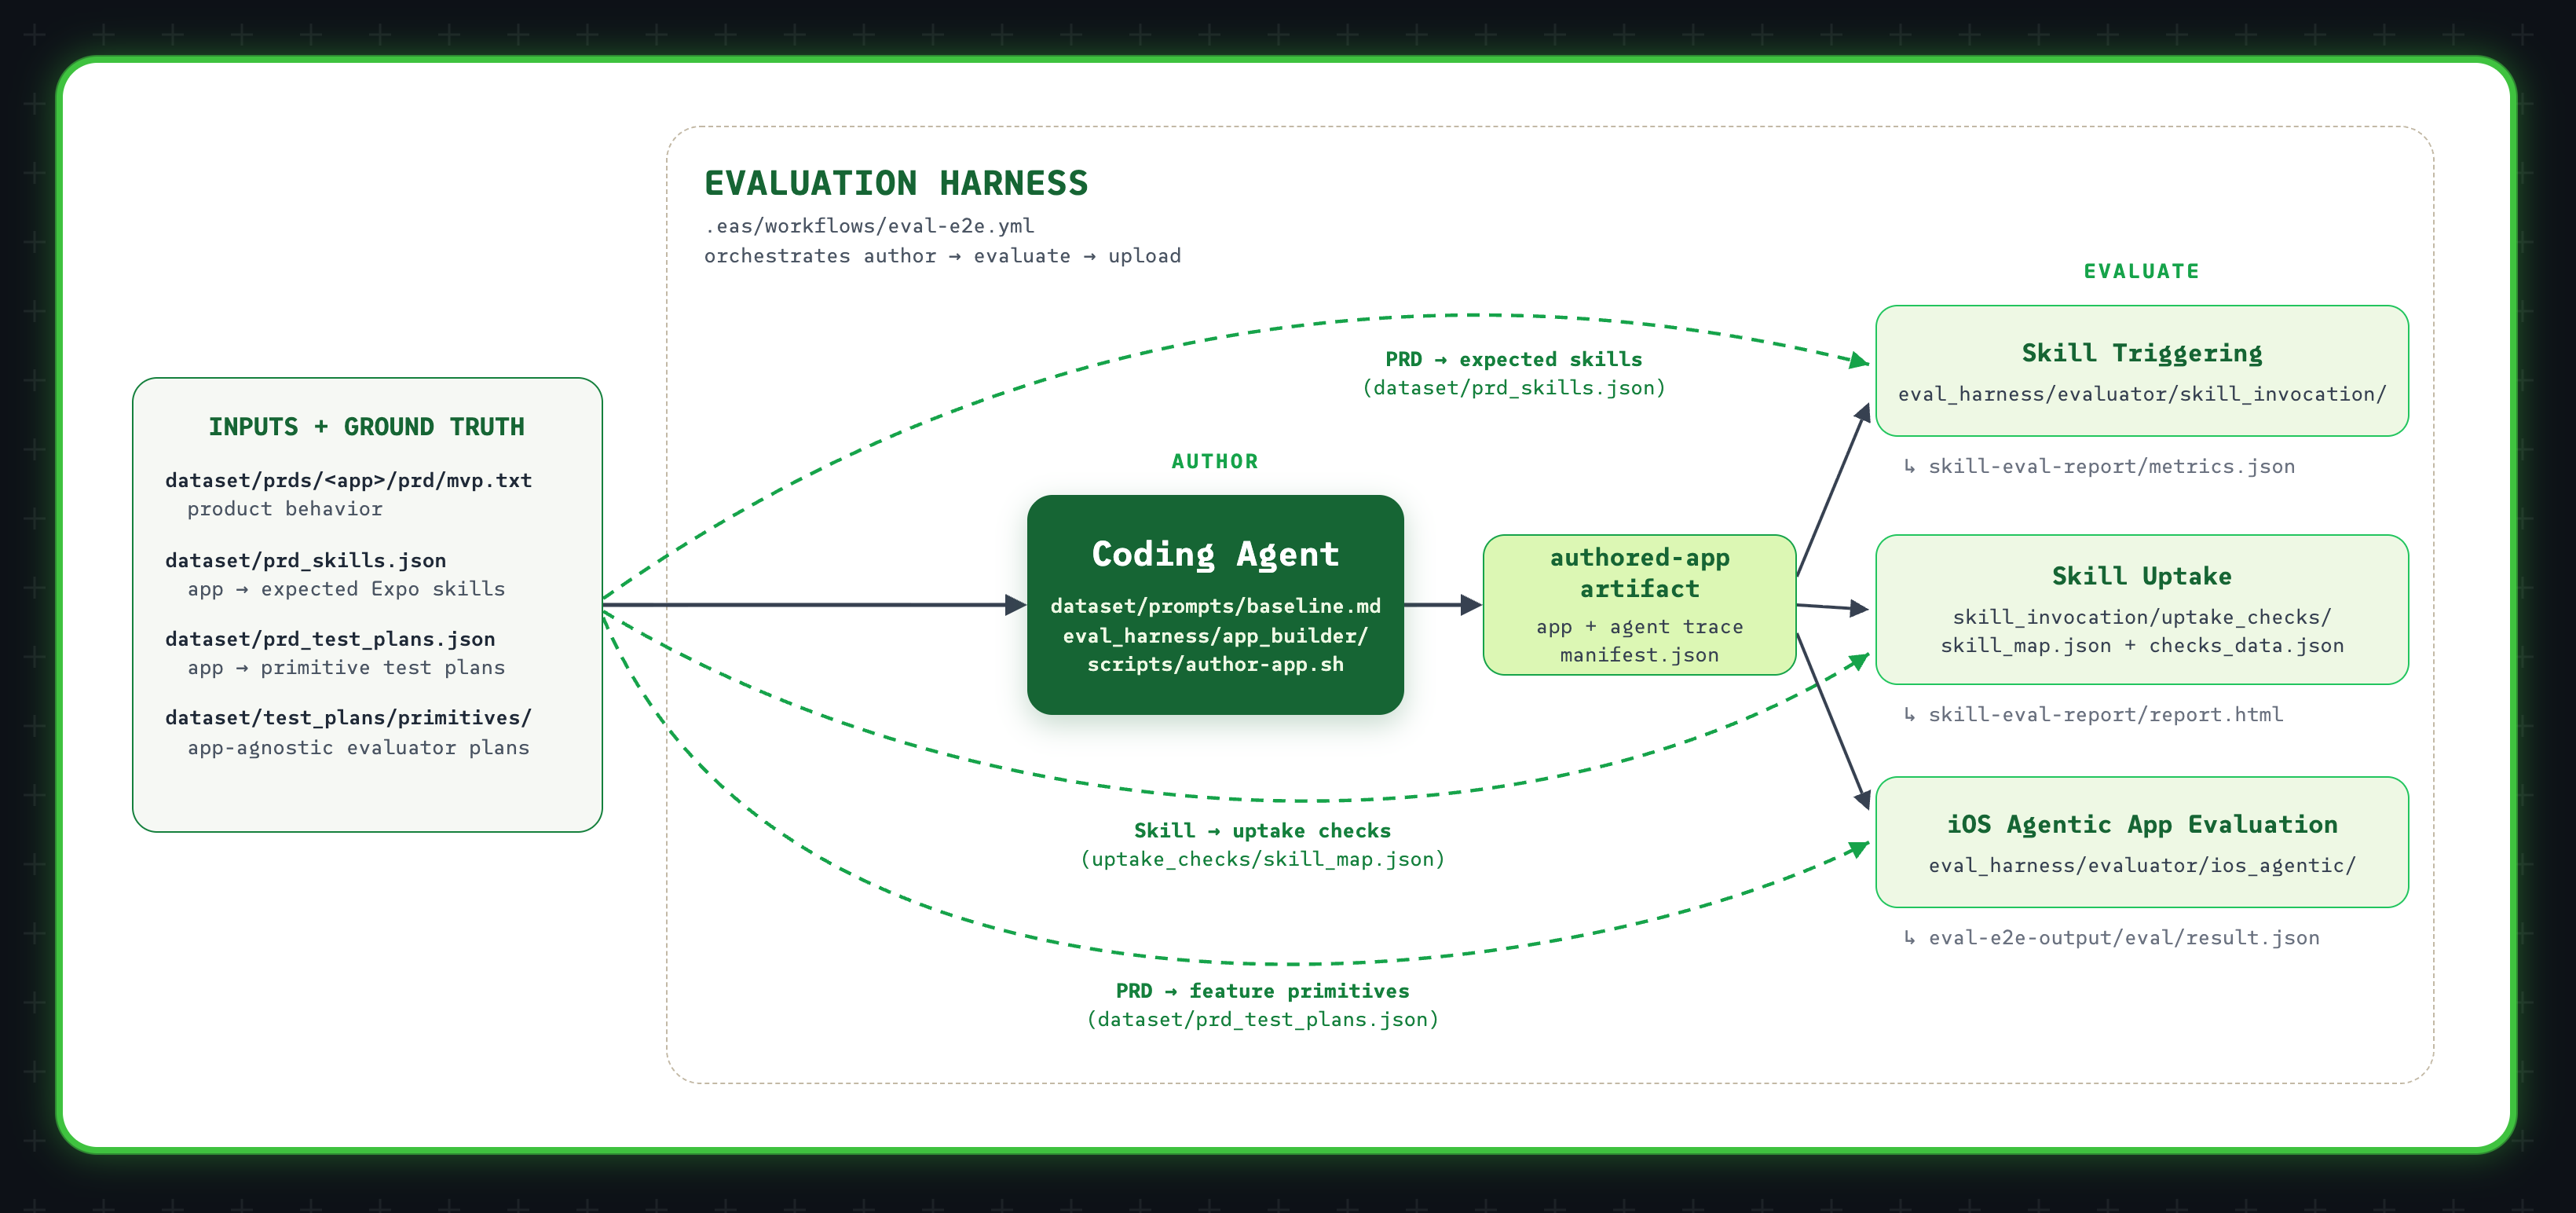
大まかに言えば、この eval harness はプロダクト要件をタスクとして扱い、coding agent に実行させ、そのうえで過程(agent の軌跡と skill の使用状況)と成果物(構築されたモバイルアプリ)の両方を評価する。
何を測るかを定義する
harness は、scenario のデータセットに含まれるタスクで coding agent を評価する。scenario は、ユーザーが Expo でアプリを構築する実際の使われ方を代表するものとして私たちが選んだものだ。scenario は、モバイルアプリを一気に丸ごと生成するようなエンドツーエンドのタスクでもよいし、繰り返しクラッシュする dev build のデバッグや、既存アプリへの機能追加のように、もっと細かいものでもよい。
どんな優れた評価も、しっかりしたチェック項目の上に成り立つ。私たちは agent の軌跡から後付けでチェック項目を推測するのではなく、データセット内の各 scenario に対して次のものを注釈として付けた:
- エージェントがこのタスクを実行する際、どの skill が役立つと想定されるか
- skill のガイダンスに従った場合、どのような証拠が確認できるはずか
- エンドツーエンドのタスクにはどのような機能プリミティブが関わり、agentic evaluator は何を QA すべきか
これらのチェックは、3つの異なる層で証拠を提供する。
- skill の発火:エージェントはタスクに関連する skill をロードしたか?
- skill の採用:ロードしたガイダンスに従ったことを示す証拠が見つかるか?
- アプリの挙動:最終的に構築されたアプリは正常に動作し、タスクの PRD に書かれた挙動を示すか?
これらの問いは互いに関連しているが、それぞれが観測されたエージェントの挙動の異なる側面を明らかにする。
skill が一度もロードされなければエージェントに影響を与えようがないため、skill の発火は必ず測定する必要がある。ただし、ロードされた skill が無視されることもあるので、採用の証拠を測ることも同じくらい重要だ。
エージェントが、こちらが使ってほしいと考えていた skill をまったく参照せず、既存の知識だけで使える機能を構築してしまうこともある。これはまったく問題ない! 実際、Expo が丹念にまとめた知恵を借りずにタスクを正しくこなしたからといって、減点すべきではない。むしろ、その skill が進化を続けるフロンティアの能力によってすでにカバーされている可能性を示している。評価を独立した層に分けることで、coding agent が最も助けを必要としている箇所が見えやすくなる。
自分のタスクで coding agent を動かす
最初のイテレーションでは、coding agent にもっと野心的なエンドツーエンドのシナリオを渡した。まず、ユーザーがモバイルアプリを構築したいという高レベルのプロンプトを含む製品要件ドキュメント(PRD)を用意する。次に、評価フレームワークがこのタスクを coding agent に渡し、作成プロセス全体の軌跡を記録する。どの skill を呼び出したかも含めて。agent の生成が完了すると、フレームワークはビルド成果物をパッケージ化し、下流の工程に渡す。
プロセスと成果物を同時に評価する
続いてフレームワークは2つの評価タスクを並行して起動し、互いに直交する2つの問いに答える。
静的評価:細かく決定論的なチェック群によって、生成されたアプリのビルドが健全か、agent の軌跡の中で何らかの skill が呼び出されたか、そしてそれらの skill が示したガイダンスが実際に生成されたソースコードに入り込んでいるかを測る。
アプリ評価:プログラミングエージェントが生成したモバイルアプリをビルドして起動し、その後ユーザーのように操作して主要な機能プリミティブを検証する、エージェント評価器。
CI で評価フレームワークを動かす
評価フレームワーク自体は Expo の CICD Workflows 上で動作しており、これを Expo Skills リポジトリ——Expo がプラグインを開発・保守している場所——に組み込んだ。Expo の担当者が新しい skill を公開したり既存の skill を更新したりするたびに、pull request に eval ラベルを付けるだけで評価を起動できる。フレームワークは main 上の Expo プラグイン版と pull request 内の版でそれぞれ選択したシナリオを実行し、結果をそのまま PR に表示する。
これは徐々に Expo の開発ライフサイクルの一部になりつつある。skill の作者は自分のタスクと ground truth チェックを単体テストと同じように保守し、プラグイン自体もコードと同じやり方で開発する——変更を加え、シナリオ群で走らせ、証拠を見てから次を決める。
これは何の役に立つのか
轨迹を書くことで最初に見えてきたのは、期待していた Expo skill がほとんど望んだとおりには読み込まれていないということだった。
これは価値がある。アプリは表面上は成功したように見えてしまうからだ。agent は Expo と React Native について、コードを書ける程度にはすでに知っている。だから最終的な答えだけを見たり、いくつかのファイルをざっと眺めたりしても、この過程で私たちのプラグインが何も貢献していないことに気づけない。轨迹があればそれが見えるようになる。
なぜこうなるのか、いくつか推測がある。
- agent はすでにタスクを完了できると確信していて、追加の指針を探そうとしない。
- skill の frontmatter にある説明が、各 skill をどんな状況で使うべきかを十分に伝えられていない。
- プラグインが大きくなるにつれ、利用できる skill の数そのものが全体を眺めにくくしている。
以前なら、こうした可能性について議論し、説明を書き換え、いくつかの prompt を手で試すことしかできなかった。今はそれを検証する手段がある。
まず最も明白な介入から始めた。各 skill の名前と説明を改善する。agent が skill の関連性を判断するときに見るのは説明なので、ここから着手するのは自然だ。この変更で各 skill の用途は明確になったが、それだけでは足りなかった。
そこで3つ目の仮説に戻ることになった。これは以前から疑っていた点でもある……
agent に Expo スキルへの入口を与える
Expo エコシステムがカバーする範囲は広い。React Native、Expo SDK 本体、Expo Router、Expo Modules、ネイティブ UI コンポーネント、そしてもちろん私たちのクラウドサービス。これらを合わせると、アプリの開発・デプロイ・可観測性のための極めて強力なツール群になる。それぞれに個別の skill を用意すれば、Expo エコシステム全体を毎回 agent のコンテキストに詰め込むことなく、細やかな指針を渡せる。だがその代わり、agent は最初から20以上の skill の中から選ばなければならなくなる。
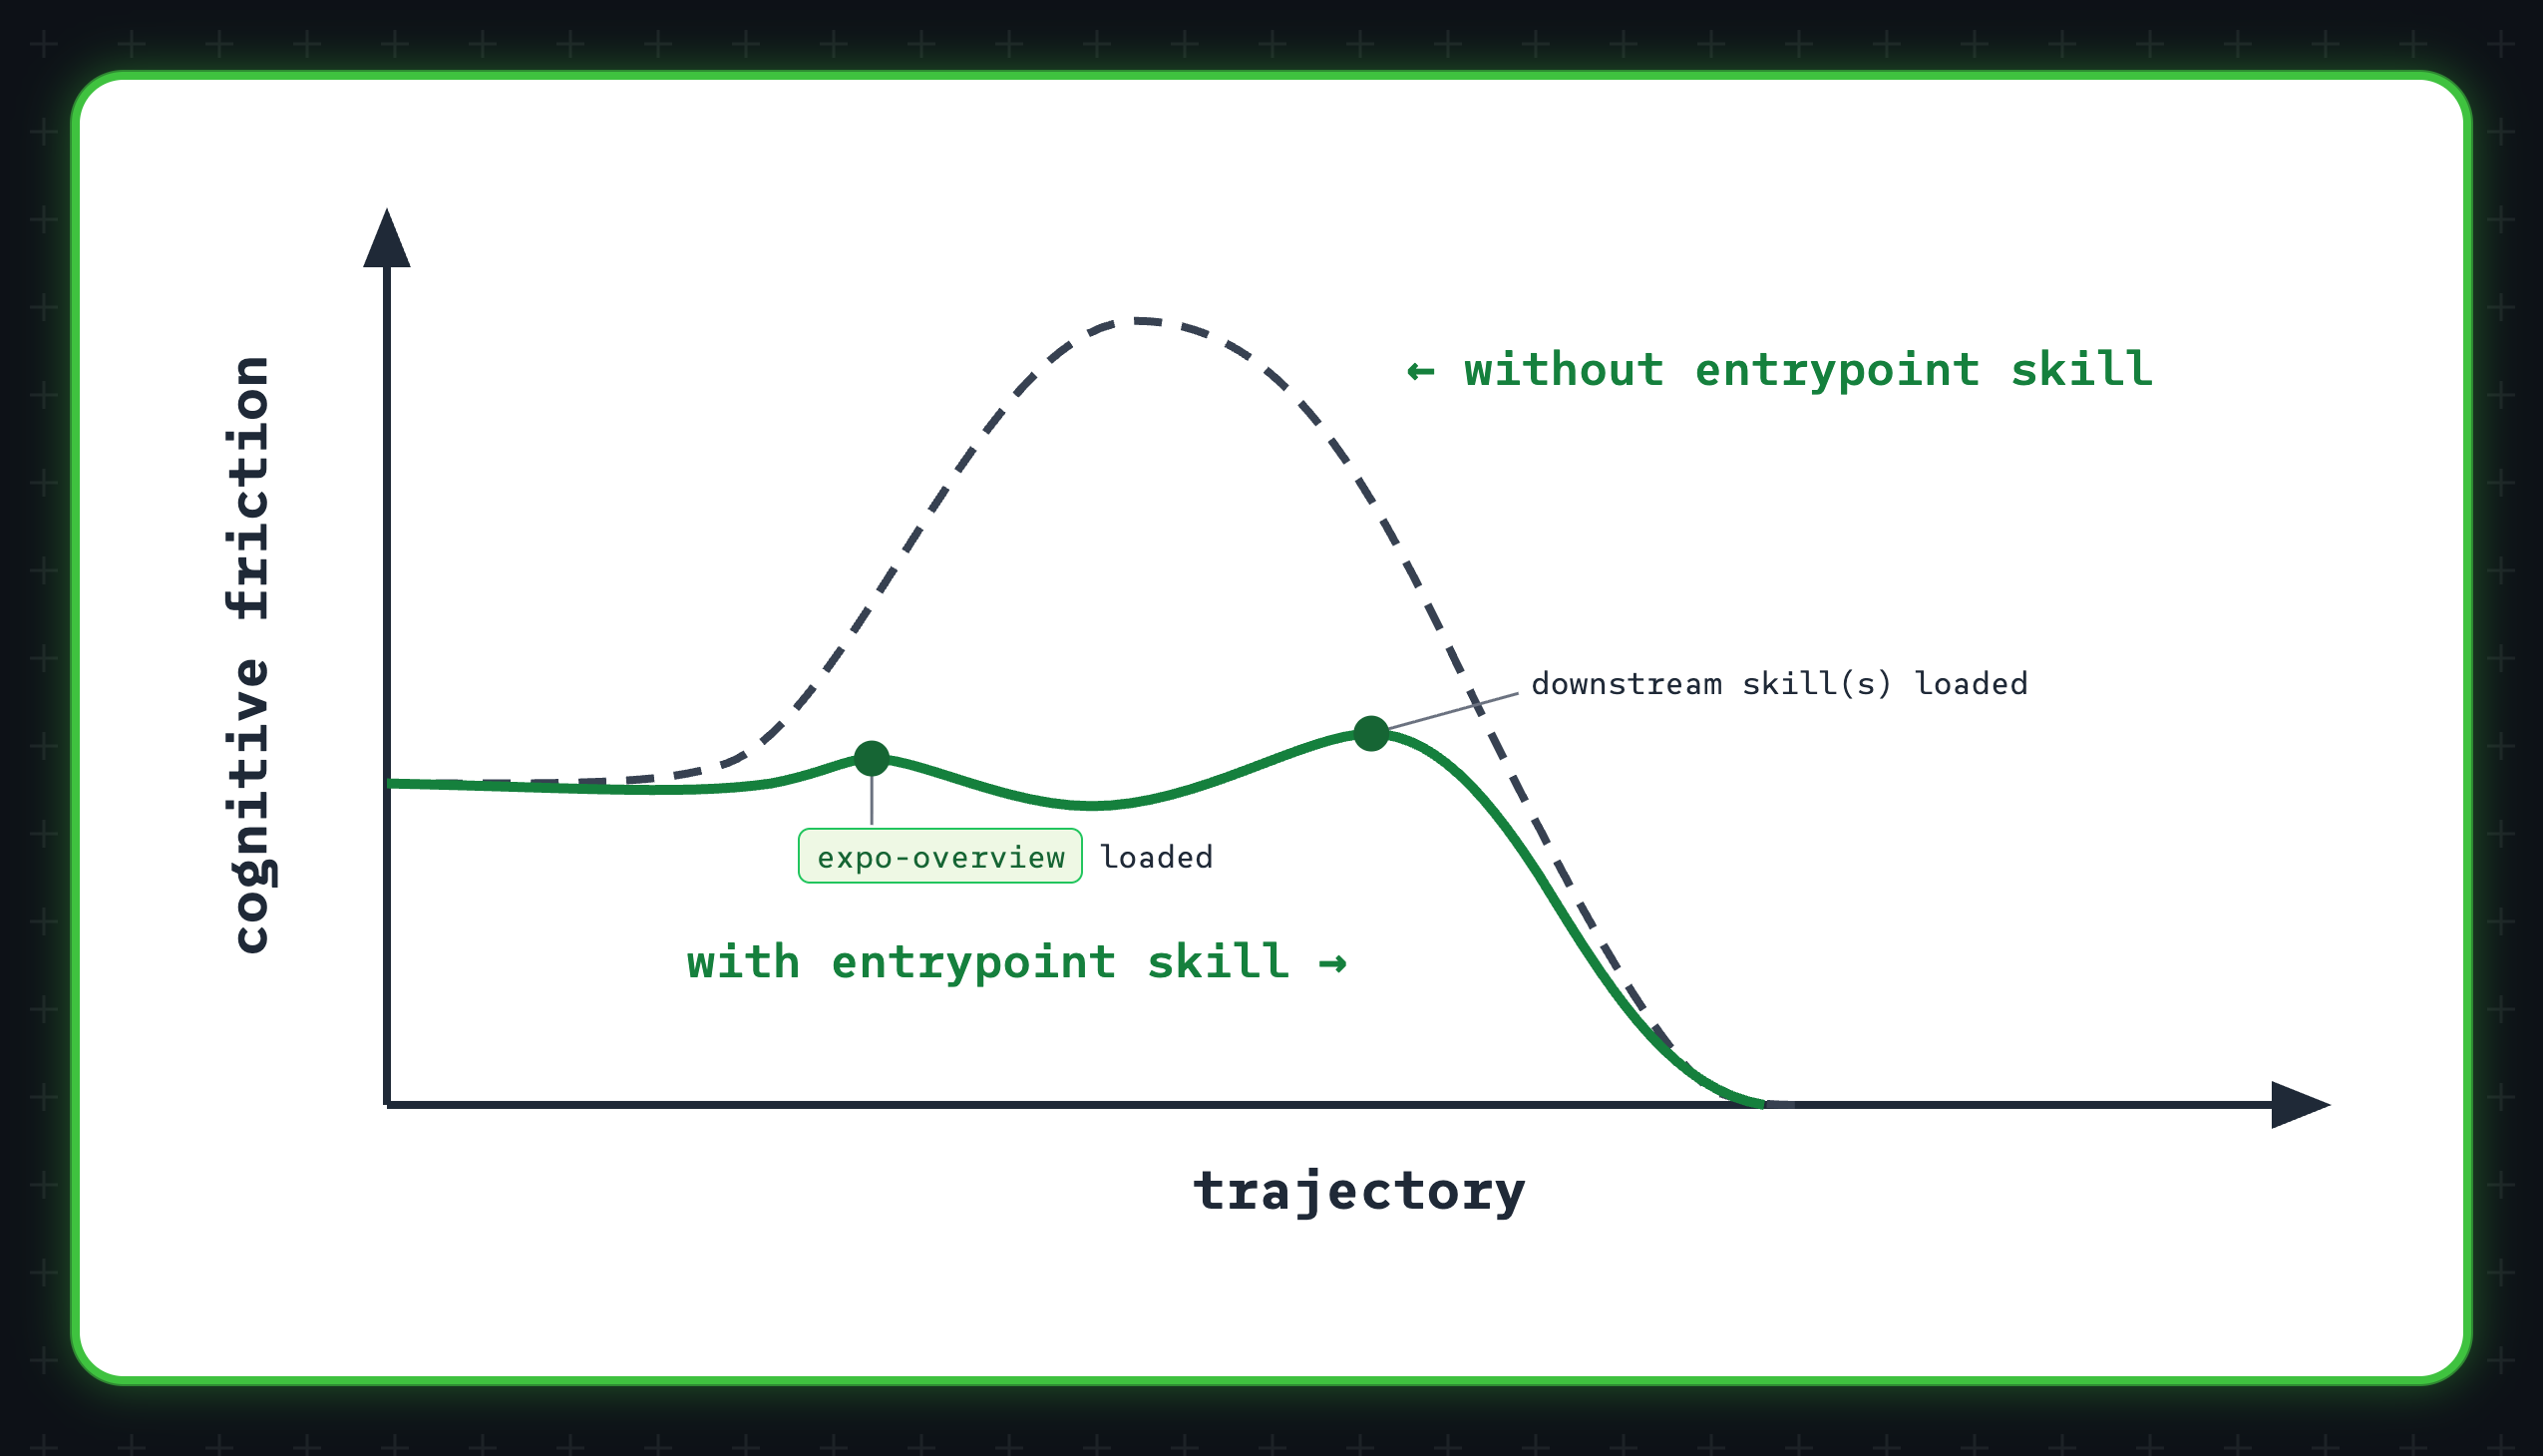
必要だったのは統一された入口だ。agent をこの集合へ導き、その中をナビゲートするもの。
そうしてできたのが expo-overview である。すべての Expo および EAS タスクに向けた入口でありルーターでもある skill だ。その説明では、これを起点として位置づけている——Expo、EAS、React Native のタスクに関するリクエストなら、まずこれを使う。skill の中にはマッピング表があり、よくある目的を、関連する指針を含むより専門的な skill に対応させている。プラグイン全体に共通する小さな設定ルールも担っている。たとえば Expo SDK のバージョンを検出すること、npx expo install でパッケージをインストールすることなどだ。最近では Sentry と Convex も自社の skill プラグインで似たやり方を採り入れている。agent に明確な起点を与え、そこからより専門的な指針へ導くのだ。
この総覧 skill は、agent が依然として20以上の skill の中を眺めなければならないという事実を変えてはいない。解決したのは、私たちが観察した別の失敗だ。多くの場合、agent は Expo skill を一つも呼び出さない。
なぜそうなるのか。アプリ開発のタスクはそれ自体で、agent に長い意思決定の列を突きつける——アーキテクチャ、依存関係、ナビゲーション、状態、実装。その傍らで20以上の skill から選ぶともなれば、すでに知っているやり方で進めてしまい、skill にまったく手を伸ばさない可能性が高い。これは推測にすぎないが、狙いは単純だ。skill に手を伸ばすための起動コストを最小限にする。
評価フレームワークが示したもの
この新しいスキルを追加する pull request に eval ラベルを付け、評価フレームワークで既存プラグインと今回の変更それぞれに同じ3つのアプリケーションシナリオを走らせた。最初の好材料は、agent がこう口にしたことだった。
「このタスクは Expo/React Native アプリの構築を伴うので、まず expo-overview スキルを読み込みます……」
別のシナリオでは、agent は同じ判断をより直接的に言い表した。
「Expo/EAS のタスクでは必ずこれを先に走らせる必要があるので、まず Expo overview スキルを読み込みます。」
まさに望んでいた挙動だ。ユーザーはリクエストの中で expo-overview も、その下流のスキルも名指ししていない。agent はより大きな Expo タスクだと見抜き、自分で入口を選び、その入口にあるルーティング情報を使って次に何を読み込むかを決めた。
続いて、データセット内の3つの PRD について、trace はスキルが次の順序で読み込まれたことを示した。
- Notes:
expo-overview→expo-project-structure - Hot Chocolate:
expo-overview→expo-project-structure→expo-router - Wiki Reader:
expo-overview→expo-project-structure→expo-router→expo-ui
3回の実行はいずれも overview を最初に読み込んだ。その後、毎回 overview から少なくとも1つの関連する下流スキルへと進んだ。agent が「Expo スキルを読み込む」という敷居を一度越えてしまえば、候補となる全スキルが同時に選択を争う場合よりも、2段目の判断が下される可能性はずっと高い。
スキルを読み込む agent セッションが10%から50%超へ
PR でのこの暫定的な結果が一般的に当てはまるか確かめるため、sonnet-5-high で Claude Code を再実行した。今回はまったく新しいモバイルアプリの PRD 10件を対象とした。ユーザー向けの prompt は Expo に触れているが、スキルは一切名指ししていない。expo-overview を加える前と後のプラグインを比較し、agent の軌跡に含まれるランダム性を排除するため各構成を3回ずつ走らせた。
expo-overview なしのベースライン実行では、Expo スキルを何か読み込むと判断した agent セッションは約10%にとどまった。expo-overview を入れるとこの数字は55%に跳ね上がり、全 agent セッションの半数以上が1つ以上の下流スキルを読み込んだ。
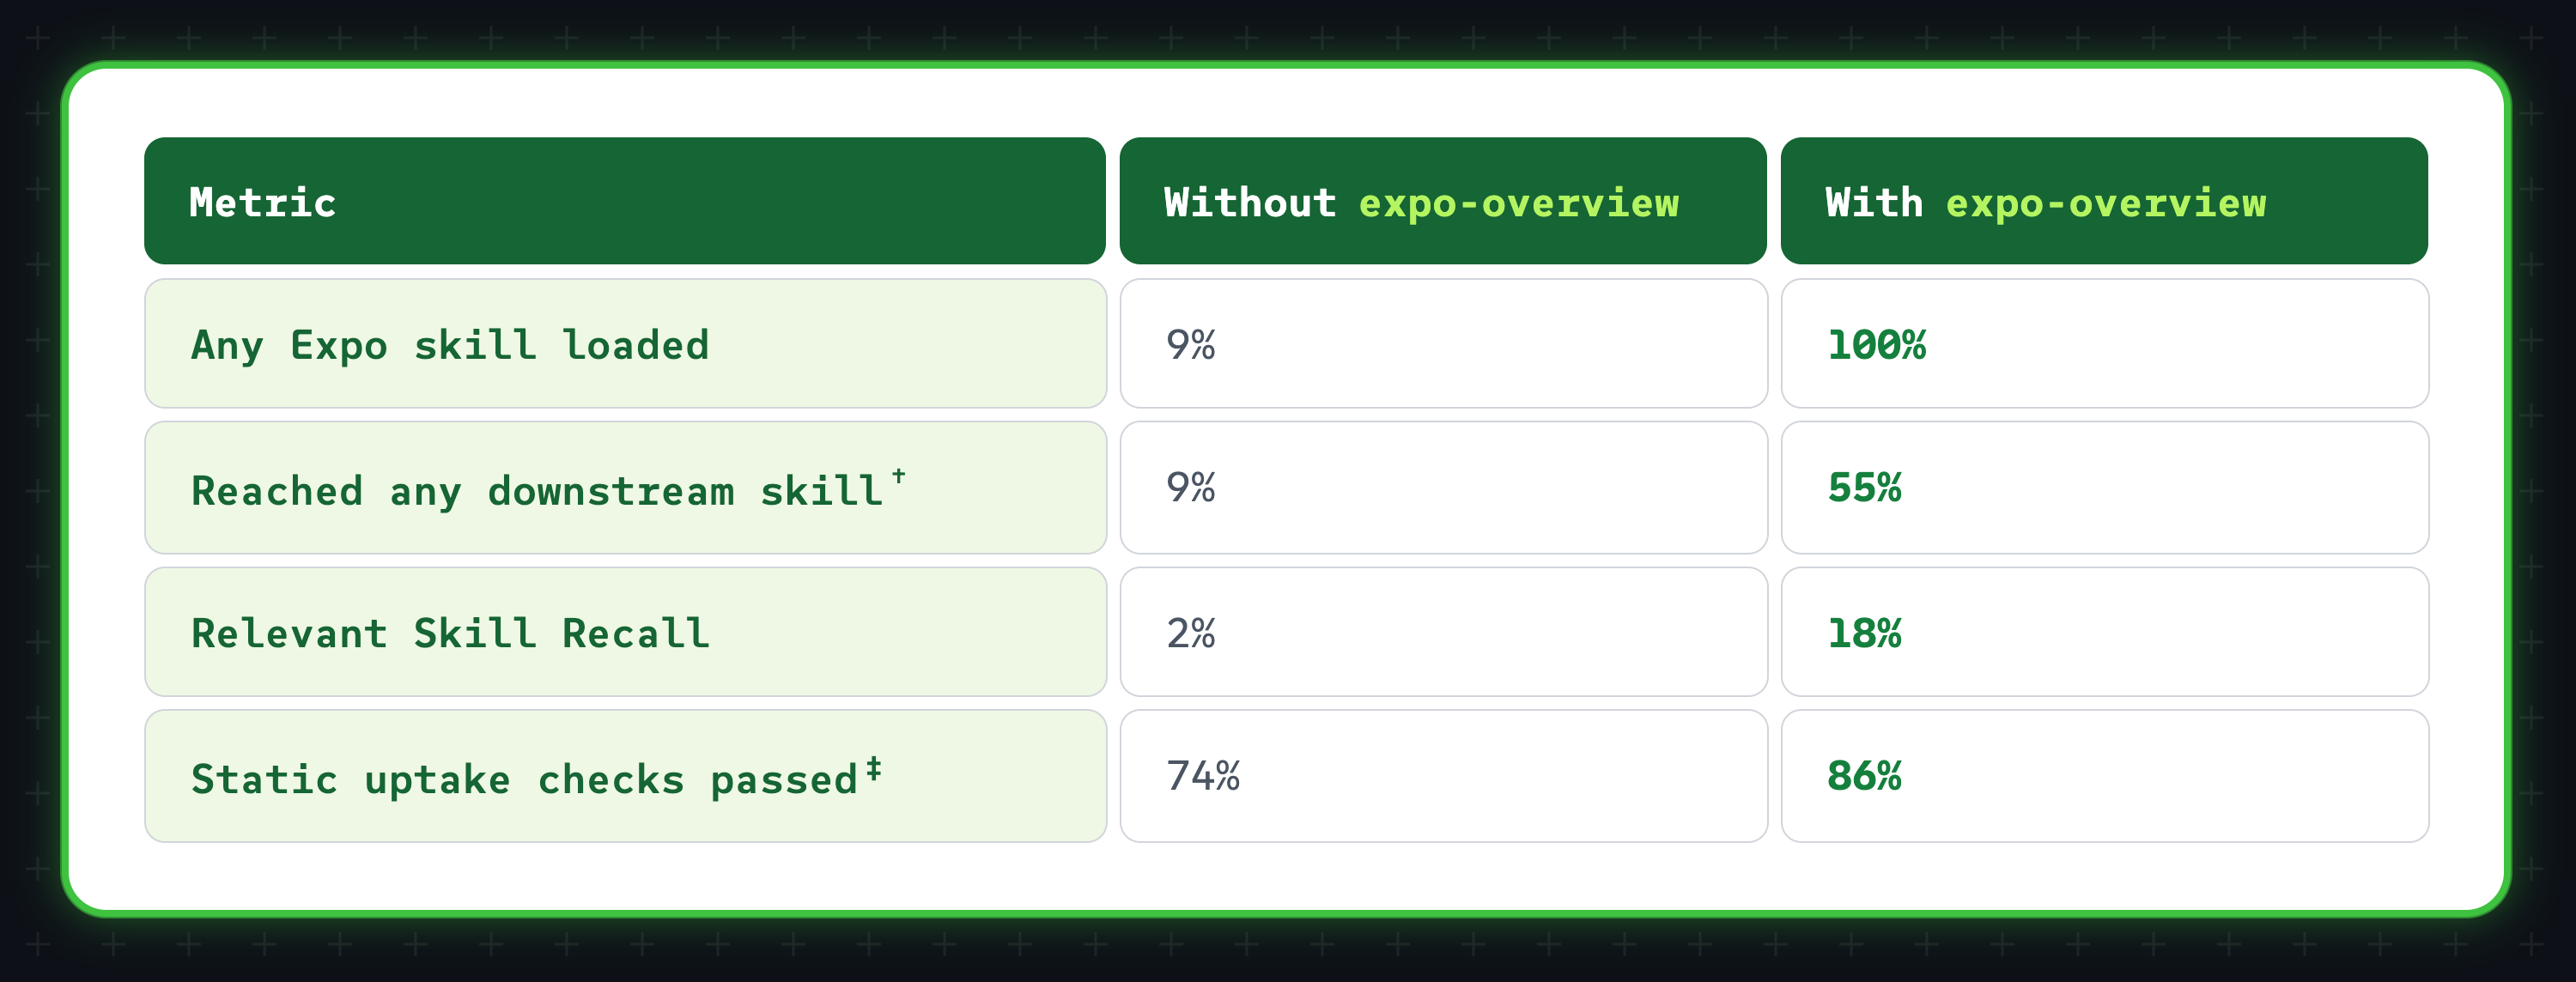
† 下流スキルとは expo-overview 以外のスキルを指す。ベースラインには expo-overview が存在しないため、ここでは任意の Expo スキルが該当する。
‡ 採用率とは、書かれたソースコードの中に期待どおりのパターンが静的に確認できる形で現れた割合を指す。
候補となるセッションはすべて expo-overview をロードした。これは、Expo 関連のタスクに取り組むための信頼できる入口を agent に提供するという狙いを裏付けるものだ。さらに重要なのは、55% のセッションが少なくとも 1 つのより専門的なスキルを続けてロードした点である。ベースラインのセッションでスキルを直接ロードした割合は 9% にすぎない。
Relevant Skill Recall は同じ問いをより厳しく測ったものだ。データセットでは、各 PRD に対応する関連 Expo スキルの集合も指定している。これらのスキルは該当タスクに有用な指針を与えるはずなので、agent が呼び出すと考えた。Relevant Skill Recall は 2% から 18% へ上がったが、依然として不完全だ。expo-overview を加えても、多くのタスクで agent は関連スキルの一部しか呼び出さないことが多い。
この数字をスキルごとに見ると、実感が湧いてくる。
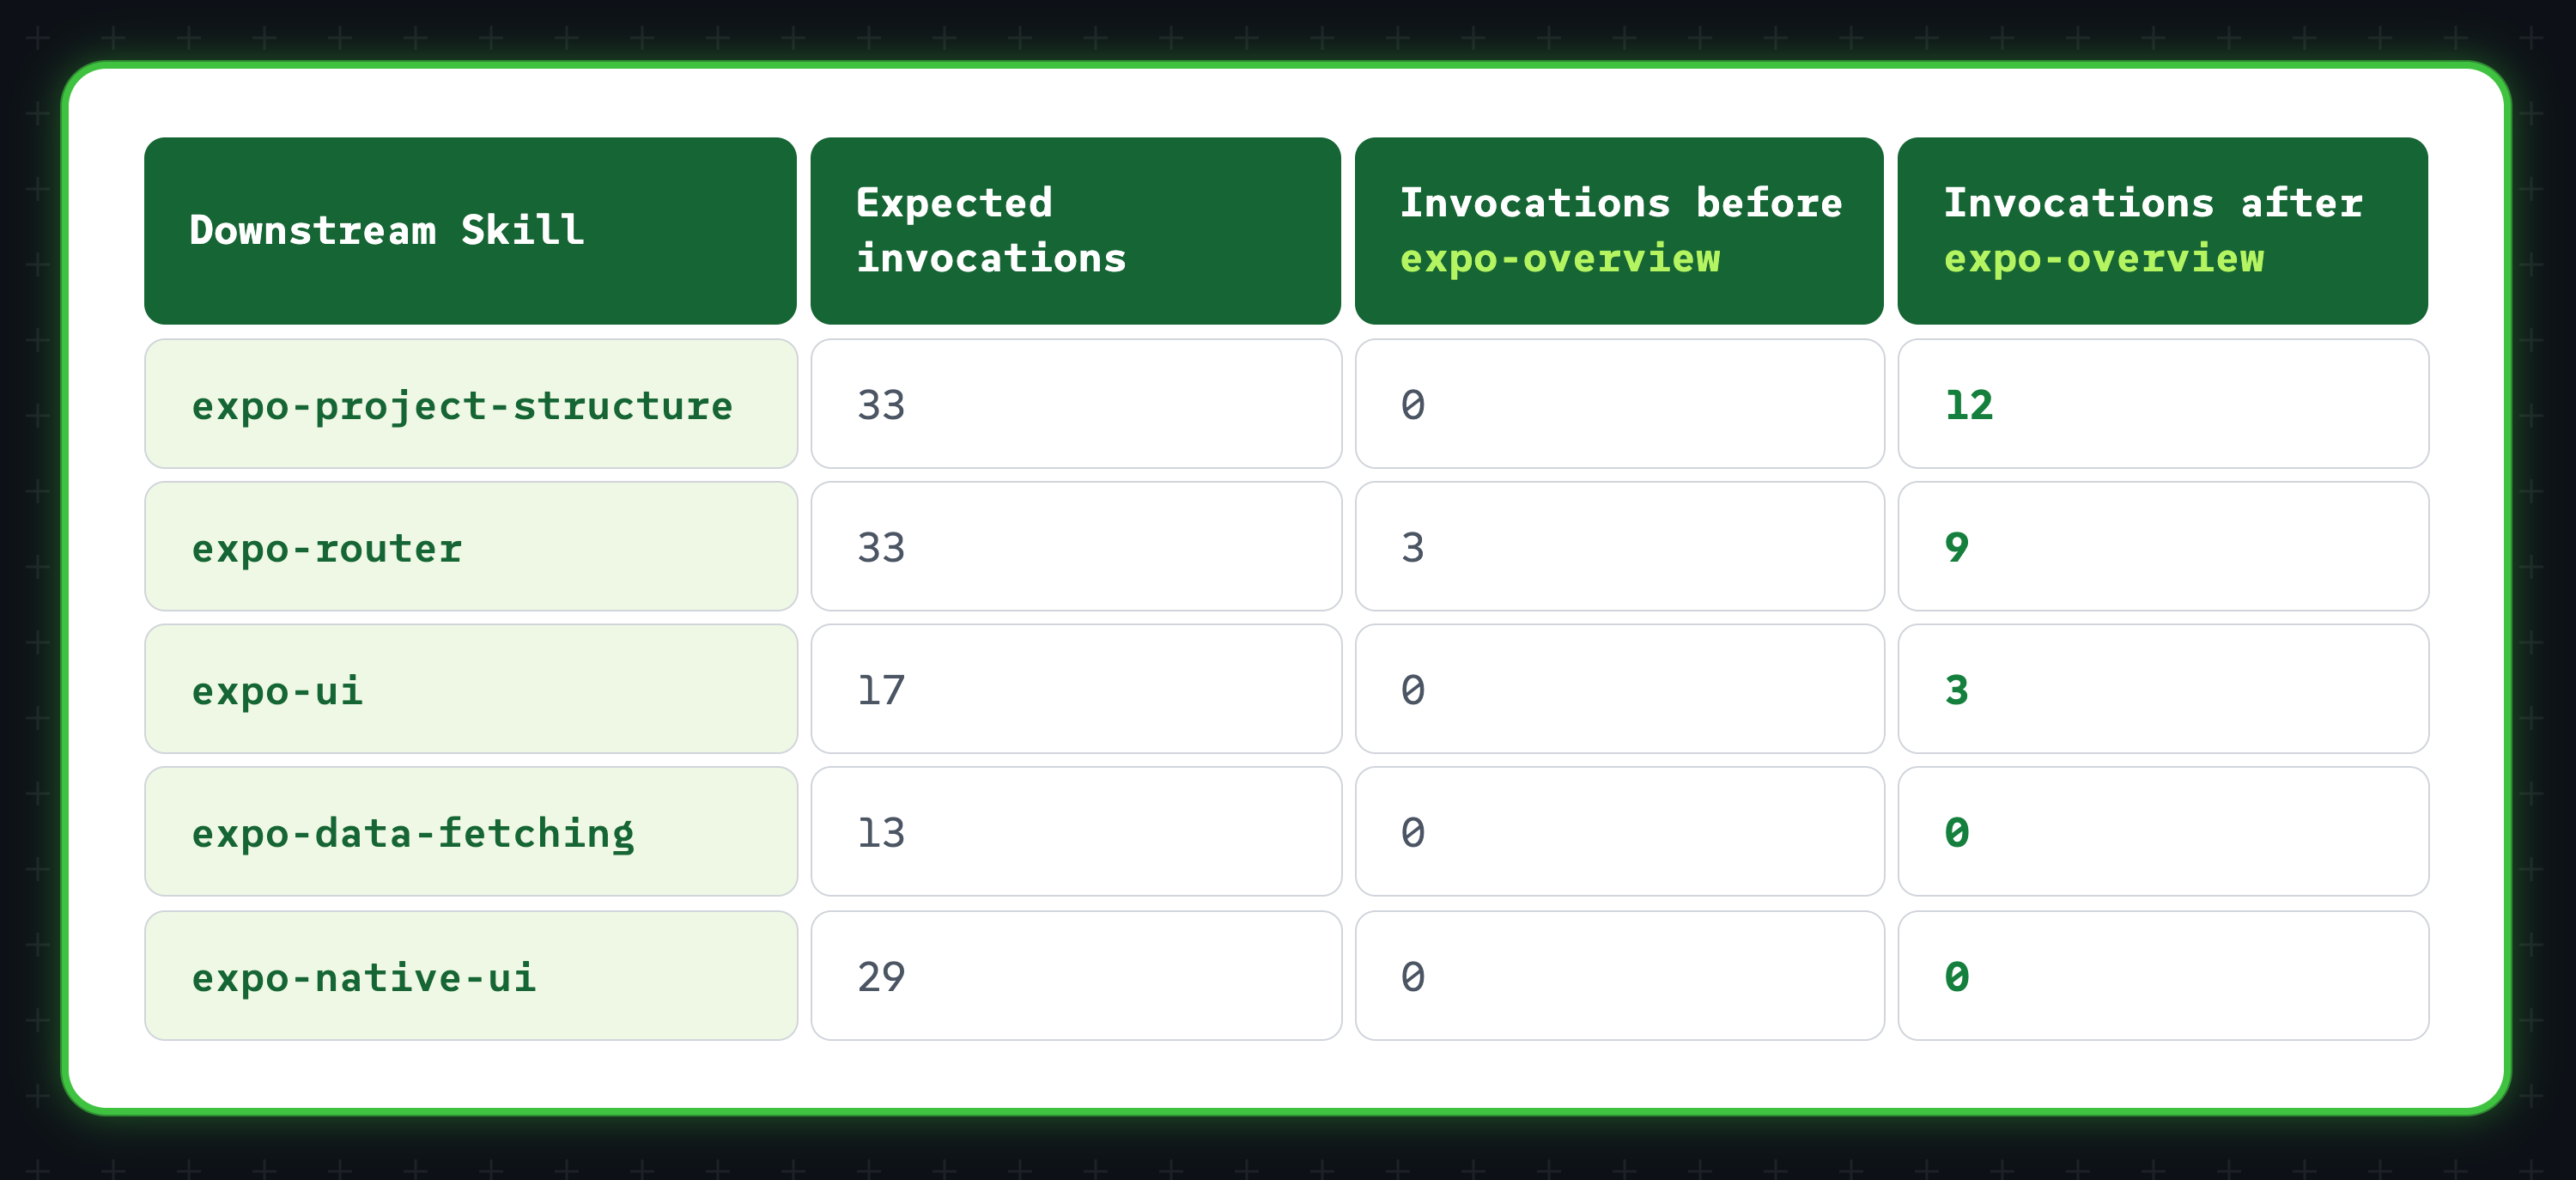
最も頻繁に読み込まれる skill は、タスクの序盤で下される具体的な判断、たとえばコードベースの骨組みの構築(expo-project-structure)やページルーティングの設定(expo-router)に関わるものだった。
ある PRD では、agent は overview skill を読み込んだあと、「project-structure skill を確認して、scaffold をどう組むか見てみよう」と述べた。ナビゲーションが中心の別のタスクでは、この結びつきがより直接的に語られている。「これを Expo Router を使う形に変える(tabs ナビゲーションに必要)。それから router skill で設定手順を確認する」。どちらの例でも、agent は overview skill を読んだ直後に取りかかろうとしているタスクについており、たいてい対応する skill も読みにいく。
抜けたケースも同じくらい興味深い。あるときは expo-overview と expo-router を読み込んだ agent が、コアデータ層を構築すると宣言し、RSS と Atom の取得を実装して実際の feed でテストまでしたが、expo-data-fetching(おそらくこのタスクで最も関連する skill)は最後まで読み込まなかった。自分の既存の知識で済ませるほうを選んだのだ。別のケースでは、agent はコントロール類のために expo-ui を読み込んだが、expo-native-ui は読み込まなかった。expo-overview が両者を併用するよう勧めているにもかかわらず、だ。生成されたコードは Dimensions.get() と React Native の SafeAreaView を使っており、これはまさにスキップされた Native UI ガイドが避けるよう促すパターンだった。
これらの事例から見ると、agent がタスクのごく序盤、Overview を読んだあとに skill を呼び出す頻度は明らかに高い。タスクが進むにつれて関連 skill を呼び出す可能性は下がり、他の情報源から始めるほうを選ぶようになる。
考えられる説明のひとつは、expo-overview が事実上の入口ではあるものの、agent はこれを汎用のルーターとして完全には扱っておらず、タスクの間じゅう何度も戻って参照すべきものとは考えていない、ということだ。
これは少数のデータ点から得た予備的なシグナルにすぎず、agent が関連する skill の知識をより確実に見つけられるようにするには、まだ多くの作業が必要だ。それでも、こちらの意図した行動に差が出ることは、いまはっきりと確認できる。これこそ、これまで欠けていたフィードバックループである。
スキルが多すぎても問題? 打ち切り!
最初の実験は Claude Code で回したが、この結果から、他のコーディングエージェントはスキルをどう提示しているのかという疑問が湧いた。オープンソースの Codex CLI の内部実装を追い、スキルの発見がどの層で起きているのかを調べた。
システムプロンプトの直後に、Skill Catalog の段落があり、利用可能な各スキルの名前、説明、ファイルパスが並ぶ。Codex では、このカタログの合計長は固定で、そのエージェントが使えるすべてのスキルで分担される。今回見たバージョンでは、この枠はコンテキストウィンドウのちょうど 2%、つまり 272k のうち 5,440 トークンに設定されていた。
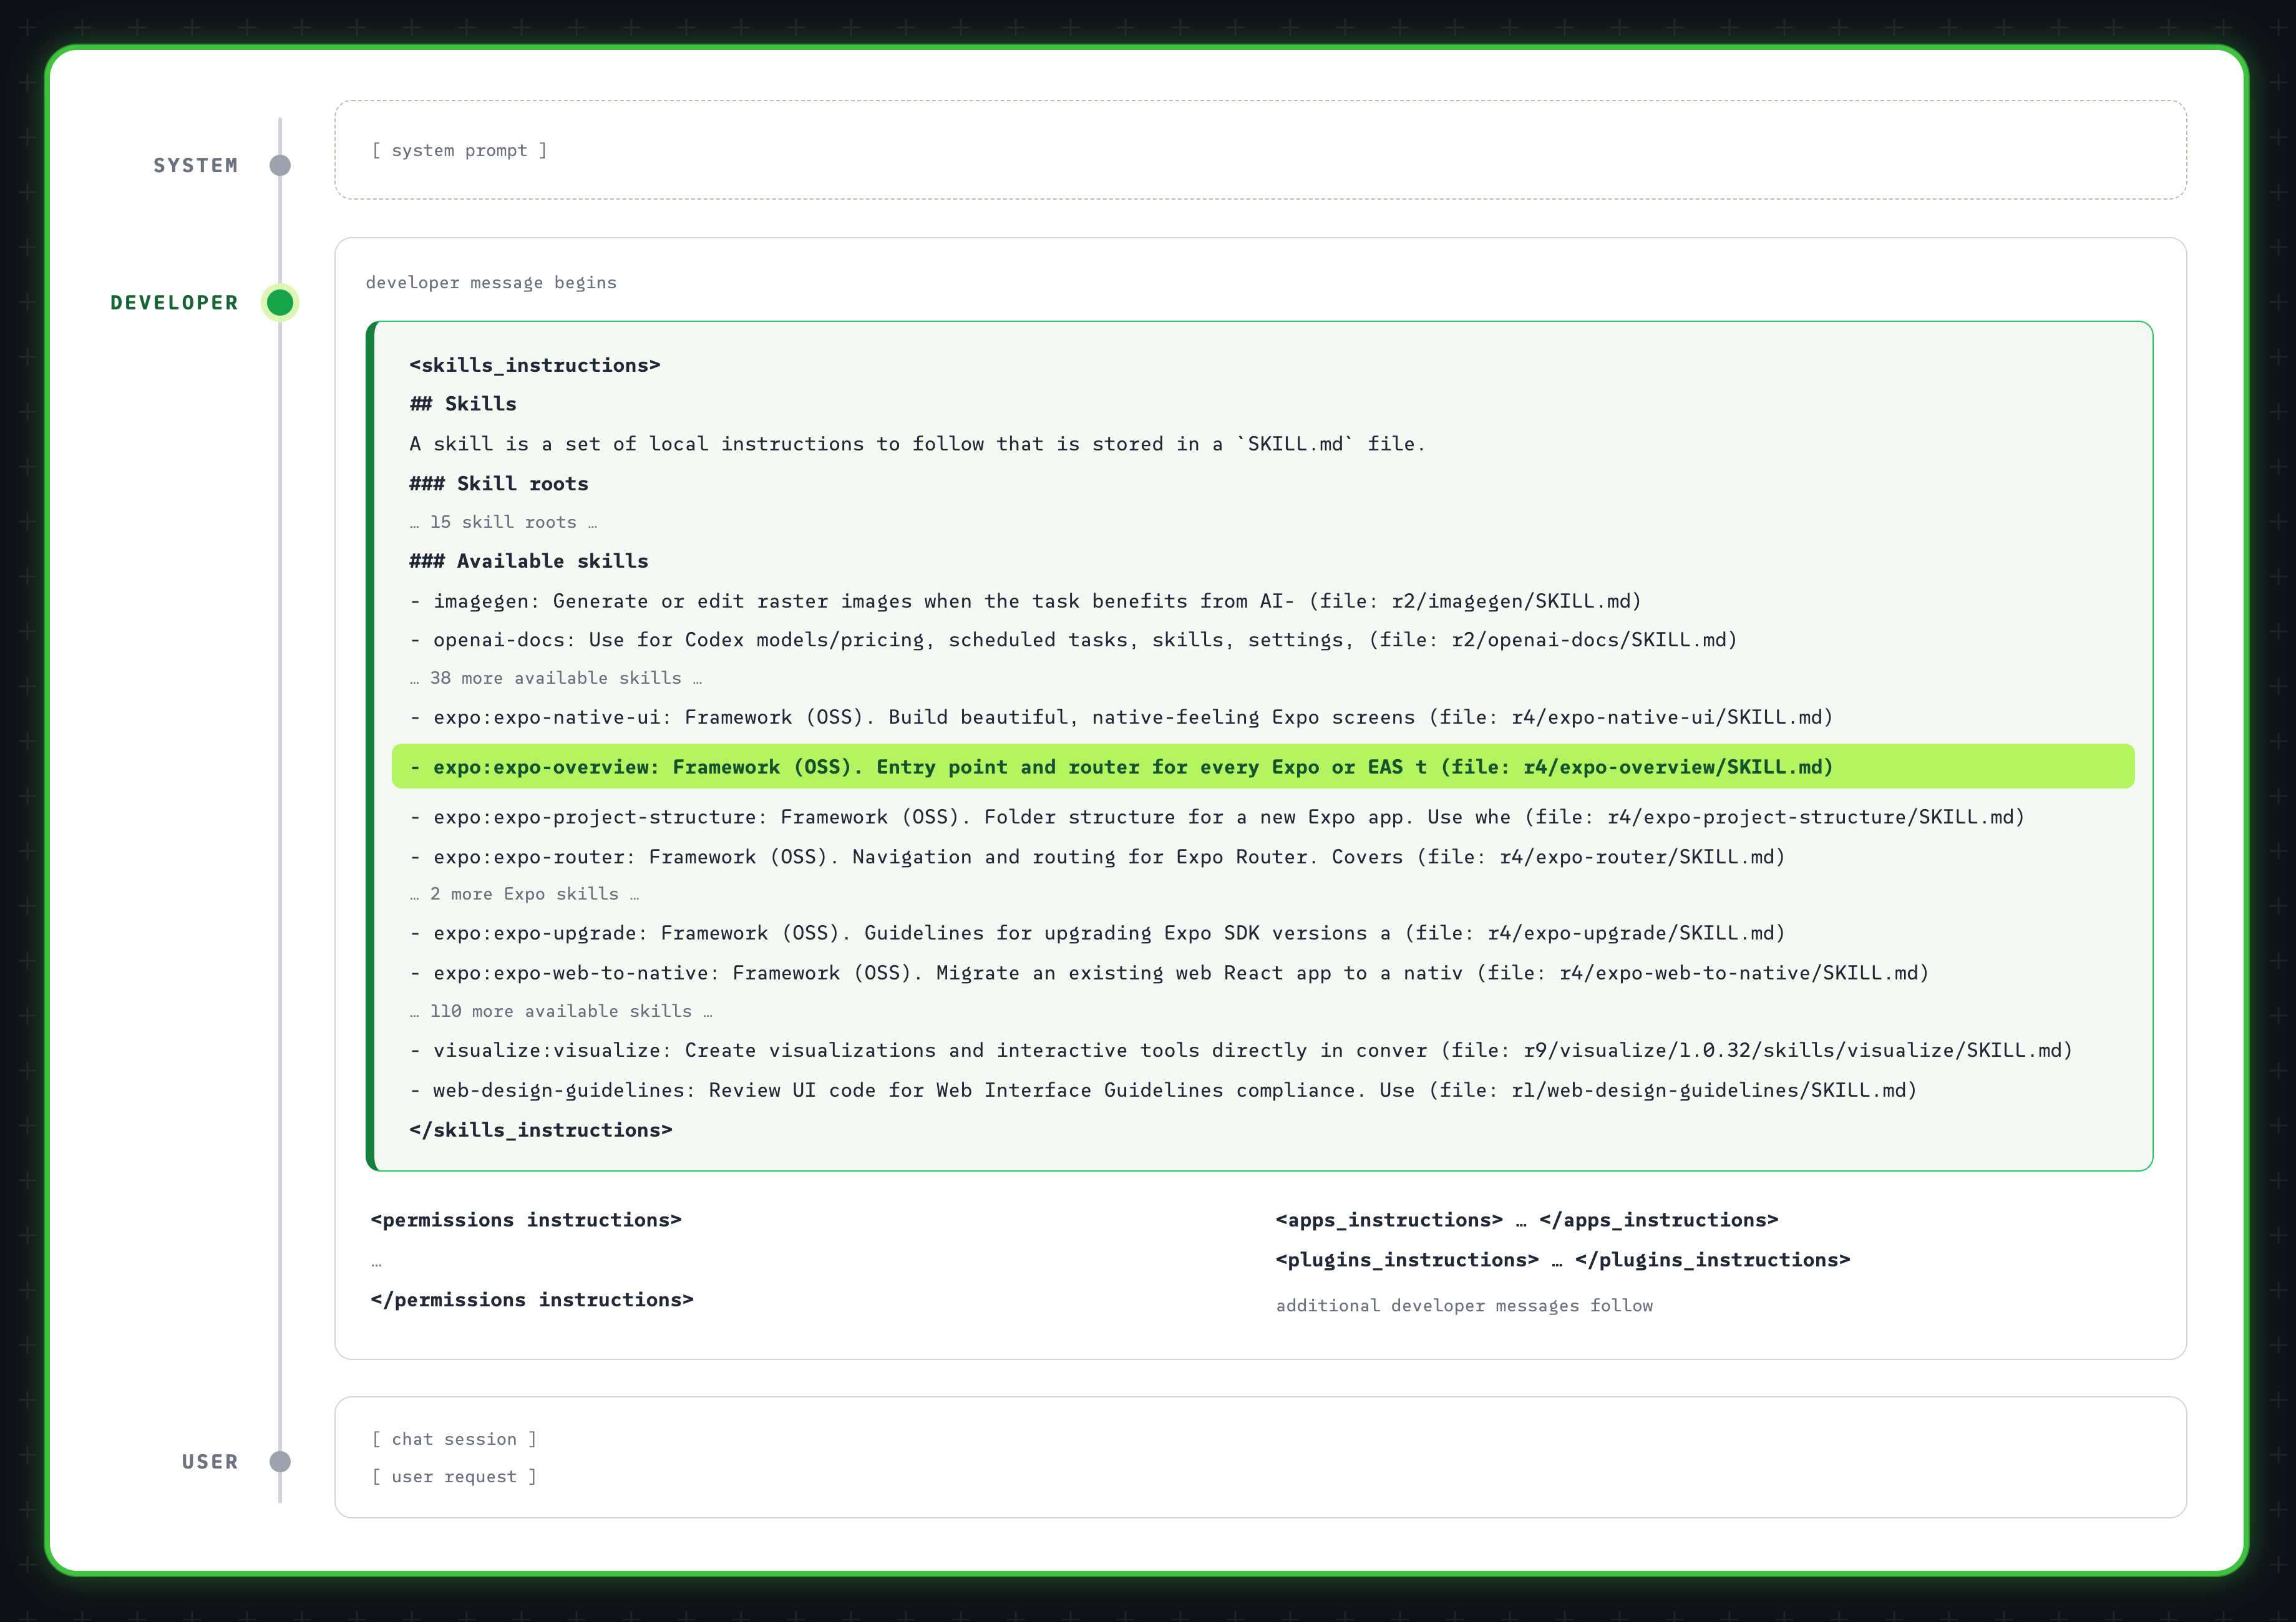
ずっと気になっていたことがある。スキルが混み合うと何が起きるのか。私たちのプラグインが提供するスキルが、Expo 以外のスキルと枠を争うとき、いったいどうなるのか。
いくつか比較テストを回してみたところ、スキルカタログ全体が 5.4k token の上限を超えると、Codex はまずスキルの説明を短縮し、冒頭部分だけを残すことがわかった。スキルがさらに増えると説明は完全に消え、スキル名だけが残る。そこから先は、スキルそのものがカタログから落とされてしまう。
175 個のスキルを入れたテスト環境で、この過程を実際に確認した。うち 24 個は Expo プラグイン由来のものだ。272k のコンテキストウィンドウでは、Expo のスキルはすべてリストアップされるものの、各説明は先頭 60 文字程度しか表示されなかった。
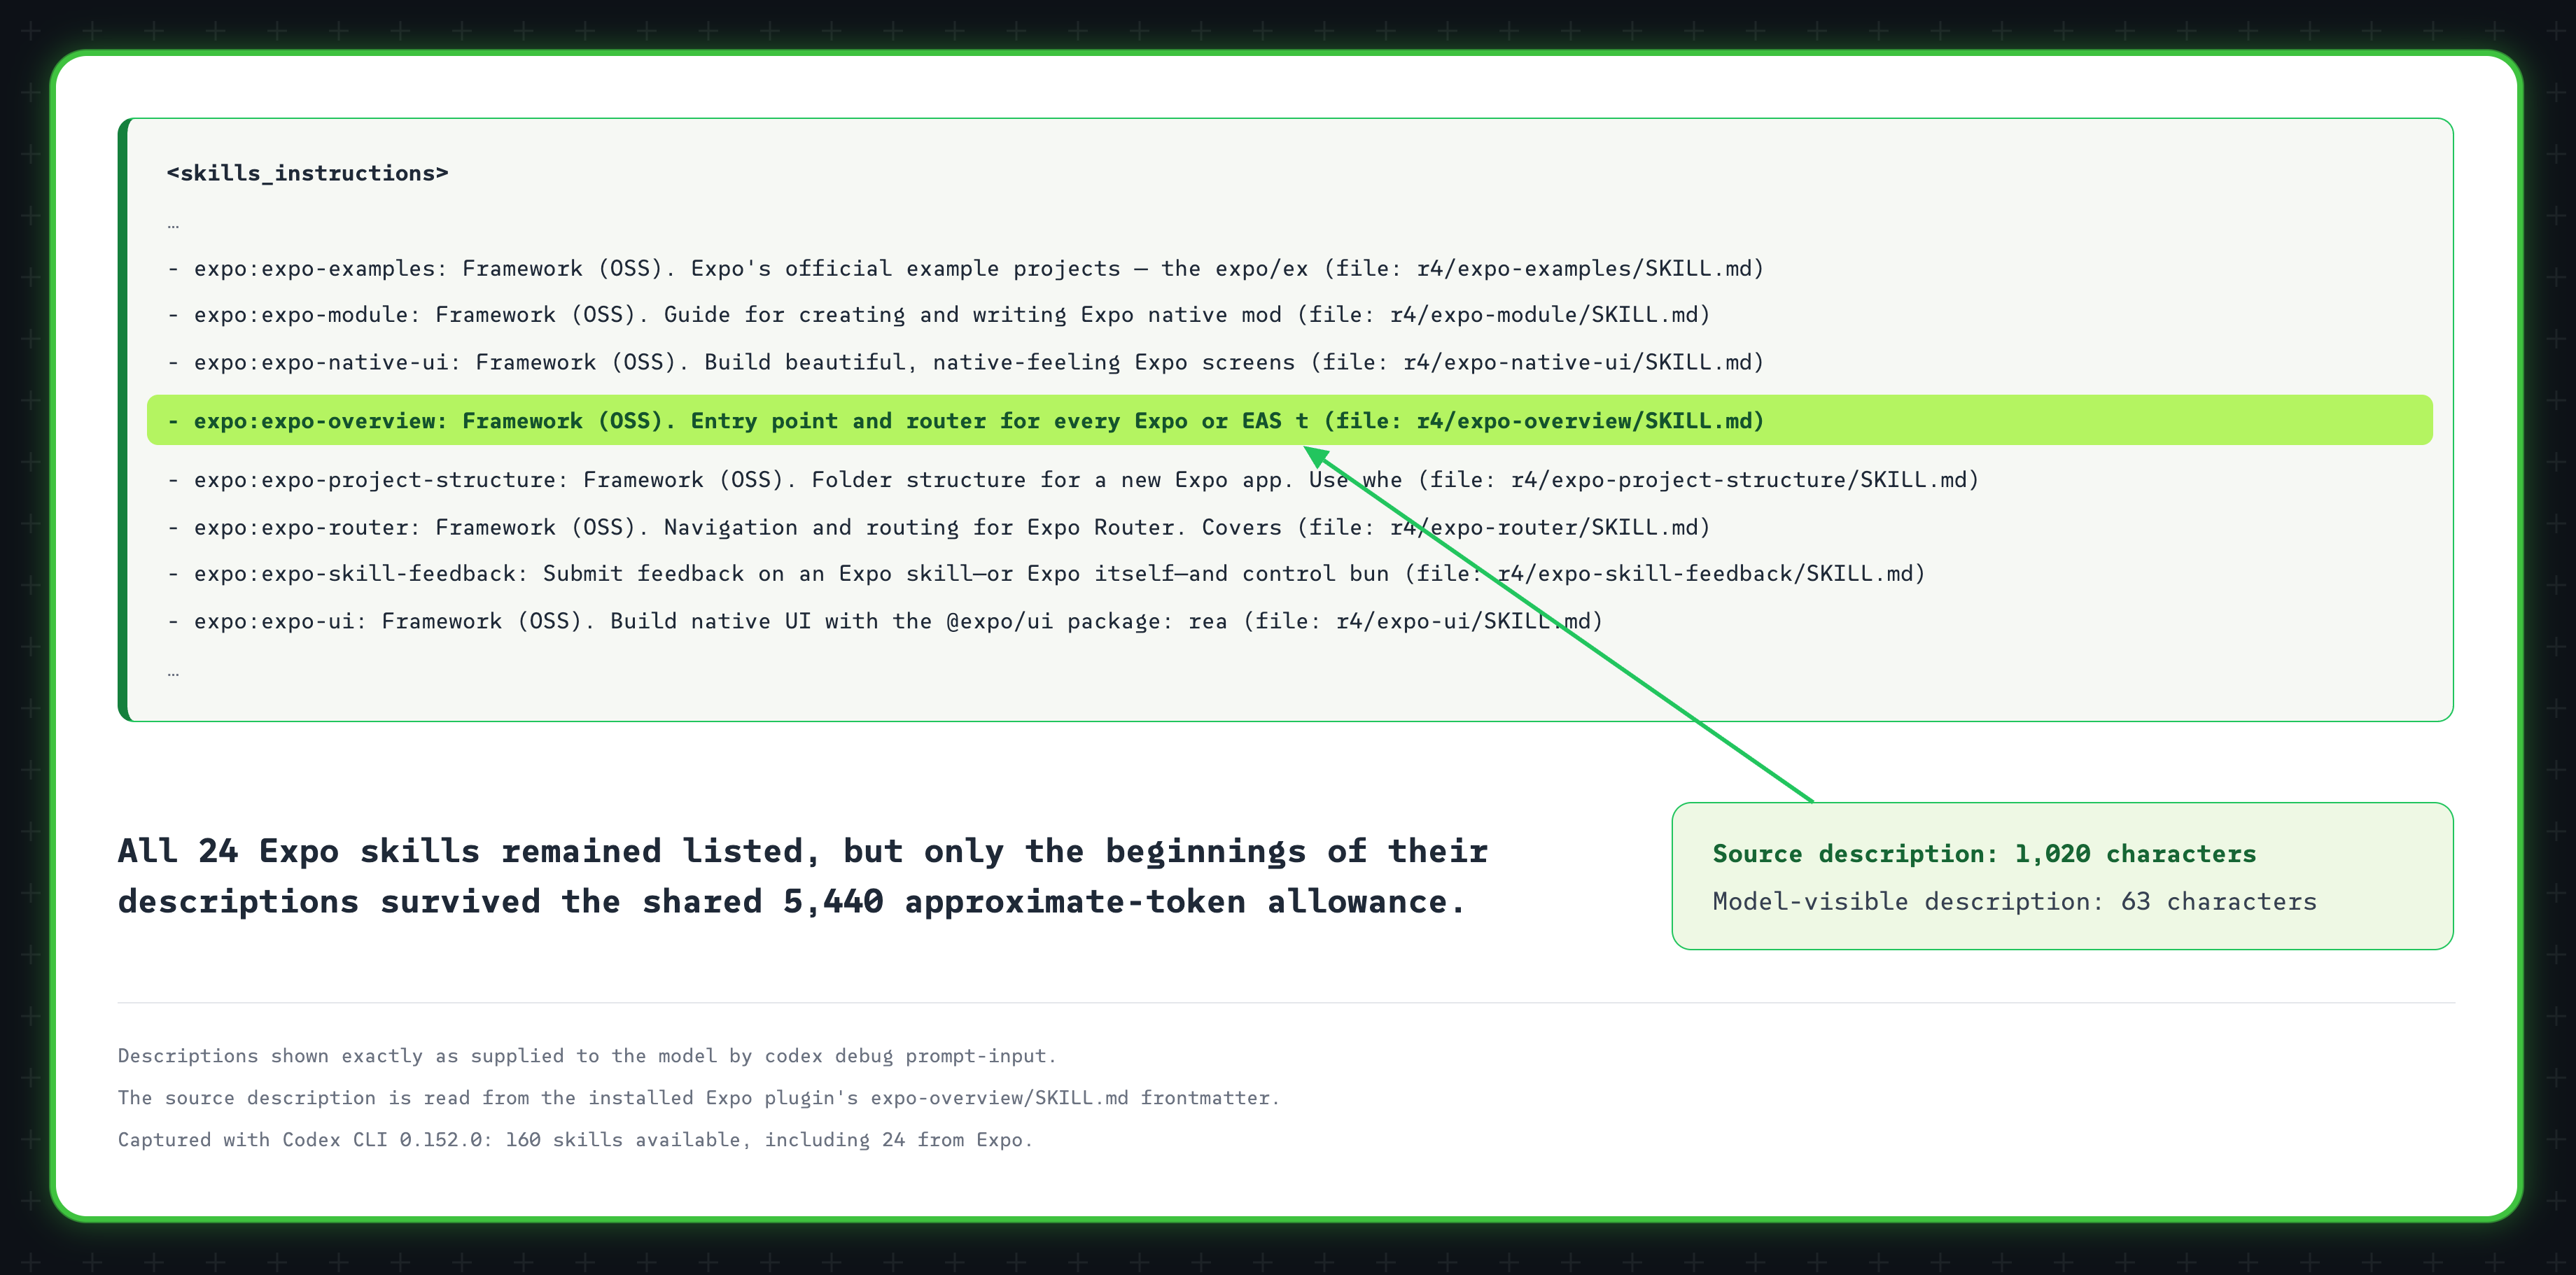
スキルが増えるほど、agent が選べる候補は増える一方で、各候補から得られる情報は減っていく。スキル名と冒頭の数文だけでは、結果は大きく変わりうる。
TL;DR: 2% のコンテキストウィンドウを奪い合うスキルが多すぎると、一部のスキルは説明文が——スキル本体まで!——切り捨てられることがある!そんな状況でも壊れないスキルにしておこう!
これは私たちのセットアップに潜んでいた仮定も露呈させた。私たちの評価フレームワークは、coding agent をクリーンな環境に置き、Expo プラグインだけをインストールし、他ベンダーのスキルとは競合させない。この隔離は、プラグインの2つのバージョンを比較するときには役に立つ。無関係な変数の源を排除できるからだ。だが、ユーザーが実際に coding agent を使うときの状況はこれとは限らない。実際のユーザーはたくさんのプラグインを入れており、それらが同じディレクトリの予算と agent の注意力を奪い合っている。
要するに、スキルは、それが発見されると想定されている条件で評価されなければならない。
孤立したディレクトリは、そのスキルが単体で見て明確に区別できるかどうかは教えてくれる。だが、混み合ったディレクトリの中でもなお見つけられ、なお他と違って見えるかどうかは教えてくれない。私たちの最初の実験が測っていたのは前者だ。しかし、より実態に近いローカル環境で観察された切り捨ては、後者についても独立した評価条件を設ける価値がおそらくあることを示している。
わかったこと
第一の教訓は、それぞれ単体では役に立つスキルの集合が、自動的に同じくらい効果的なプラグインになるわけではないということだ。スキルが数個を超えると、どのプラグインも何らかの形で情報を編成する必要が出てくる。agent は各スキルが何を言っているかを理解するだけでなく、それらのスキル同士がどういう関係にあり、どこから始めればよいかを理解しなければならない。
第二の教訓は、ユーザーが実際にプラグインを使うやり方で評価する必要があるということだ。個々のスキルの内容を開発している間は、直接呼び出して試すのは今でも役に立つ。だが、それでは agent が普通のリクエストからそのスキルを発見できるかどうかはわからない。広いプロダクト要件から出発し、そこから生じた trace を読むことで、私たちはこの選択の問題を直接観察できた。
これには、ユーザーが実際にプラグインを操作する環境の評価も含まれる。他にも多くのスキルが注意力を争っているときには、あなたの設計の効き方が違って見えるかもしれない。つまり、環境も評価の同じくらい重要な一部なのだ。
第三の教訓は、完璧なエンドツーエンドのスコアが手に入る前でも、プロセスの測定は役に立つことを教えてくれるということだ。私たちはテストフレームワークの採用チェックと App Evaluator の改善を続けている。結局のところ、関心があるのはこのガイダンスがより良いアプリを生むかどうかだからだ。だが、トリガーされることは必要な第一歩だ。スキルが一度も agent のコンテキストに入らなければ、その中の指示の質はその実行にとって無意味だ。
だからこそ、テストフレームワークを CI につなぐことが私たちにとって重要だった。スキル評価を、良い結果が出るとあらかじめ予想しているときにだけ走らせる一度きりの実験にしたくはない。プラグインの開発の仕方の一部にしたい。変更を加え、現実的なタスクを走らせ、軌跡と成果物を確認し、そこで学んだことを次の介入の選択に使う。
expo-overview はそのループが機能する最初の有用な例だ。テストフレームワークは、agent が私たちのスキルを見つけられないことを示した。私たちは個々のスキルを孤立して調整し続けるのではなく、集合のアーキテクチャを変えた。次の実行では、agent が新しい入口点について私たちの意図どおりに推論し、より多くの下流のガイダンスを読み込んだ。
これが、このプロセスが機能していることを示す最初のはっきりした例だった。agent がどこでつまずくかを観察し、狙いを定めた変更を加え、その振る舞いが変わったかどうかを測る。
やるべきことはまだある。だが、評価の仕組みは手に入った。あなたにも必要なはずだ。