你的技能需要一个评估机制
Expo 如何测试 coding agent 是不是真的能找到并使用它的 skills:在 CI 里搭一套 eval harness,以及技能目录被截断带来的教训。
中文
复制
你的 skills 需要一套评估机制
Expo 如何测试 coding agent 是否真的能找到并使用它的 skills:在 CI 中搭一套 eval harness,以及目录截断带来的教训。
本文与 Georgian AI Lab 的 Aditya Shukla、Kartik Gupta 和 David Tingle 合作完成。我们与他们联手,衡量 coding agent 如何找到并使用 Expo 的 agent skills。
核心结论
- **要测 agent 能不能找到 skill,而不只是 skill 被调用时能不能用。**直接调用无法说明 agent 在日常工作中会不会发现某个 skill。用贴近真实任务的 prompt,并检查 agent 的 trace,看它到底找到了什么。
- **设置一个明确的入口 skill,帮 agent 触达更专门的指导。**在 10 个应用构建任务中,把
expo-overview作为入口 skill 加入后,加载了相关 Expo skill 的 agent 占比从 9% 升到 55%。 - **要为拥挤的 skill 目录做设计。**当大量 skill 争抢同一份目录预算时,描述可能被截短甚至省略。把最重要的线索放进 skill 的标题和第一句话,并在贴近真实的目录环境中测试它。
在 Expo,我们把 agent skills 打包成一个插件,供 Claude Code 和 Codex 使用。这个插件覆盖的面相当广:构建原生界面、配置导航、获取数据、添加动画、使用 Expo Modules、接入我们的云服务,都有对应的 skill。我们一直在打磨这些 skill,往里补充尽可能好的上下文,让它们能补上 coding agent 已有的知识,帮它在一个任务中做出更好的判断。
但有一段时间,我们并没有可靠的办法判断这些改进是否真的有用。我们自己试一个 prompt,看着 agent 做出还算合理的动作,就觉得结果不错。可没有 eval 就写 skill,越来越像没有测试就写代码。“我这个 prompt 下能跑通”正在变成另一种“在我机器上能跑”。
这个问题和 Georgian 在评估上的更广泛经验相通:最终答案无法呈现过程中发生的一切。在 Your AI Systems Need an Eval Loop 一文中,Georgian AI Lab 成员 Asna Shafiq 讲到 trace 如何帮助团队观察 agent 的行为,但要把这些观察变成可度量、可改进的东西,你需要 eval。我们把同样的思路搬到了自己的 skills 上:不能只检查某个 skill 单独用起来行不行,而要测试 agent 在日常应用开发任务中,能否找到恰当的那组 skill。
我们测试自己工作的方式也存在偏差。作为这些 skill 的编写者和维护者,我们早已熟知正确的用法。想测 Expo UI skill 时,我们会在 Claude Code 里调用 /expo-ui,或在 Codex 里调用 $expo-ui,然后观察 agent 如何使用它。
这能说明 skill 一旦被加载后方向上是否有用,但大多数用户并不会每次都按名字调用 skill。他们更可能直接描述自己想要什么:“用 Expo 做一个 iOS 待办应用,要让它用起来像原生应用”,或者*“给这个应用加上标签页和设置页”*。在 skill 内部的任何指导能起作用之前,agent 得先意识到这个 skill 相关,并决定调用它。
我们没有任何机制去衡量这个过程中的诸多变量。
构建 eval harness
为了解决这个问题,我们和 Georgian 的同事一起开发了一套评估 harness。他们此前在评估循环上的工作影响了这次设计:1)在运行前先定义哪些证据是重要的;2)记录 agent 在目标任务上的轨迹;3)在受控条件下比较行为。
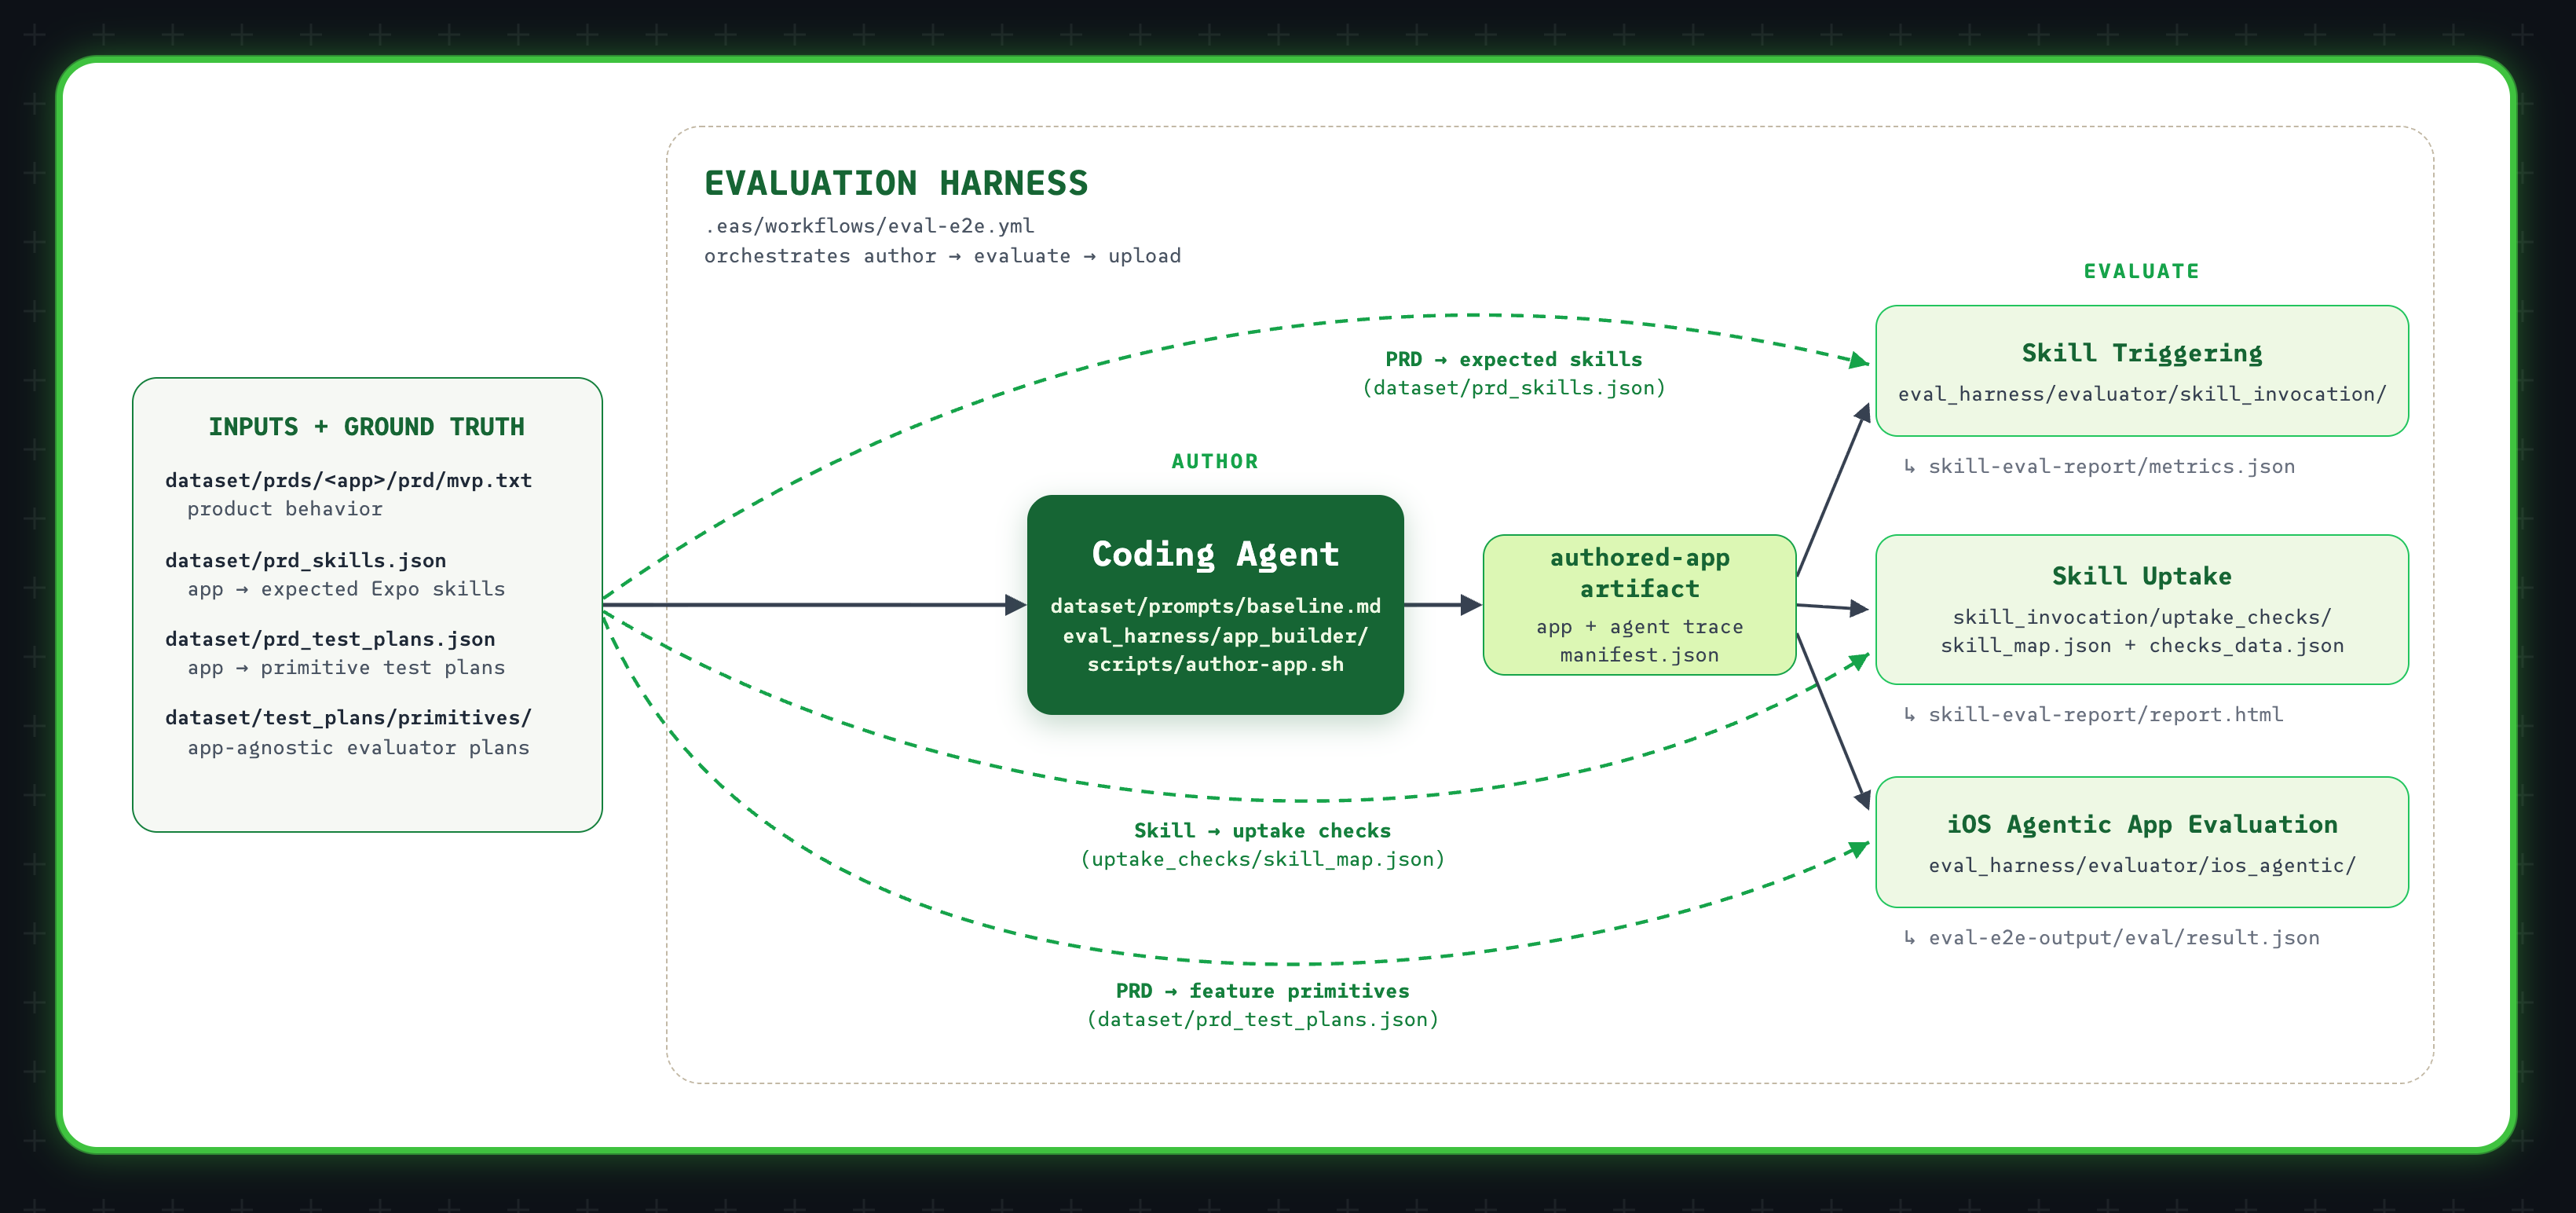
从高层看,这套 eval harness 把产品需求当作任务,让 coding agent 去做,然后同时评估过程(agent 的轨迹和 skill 使用情况)和产物(构建出来的移动应用)。
定义要衡量什么
harness 用一组 scenario 数据集中的任务来评估 coding agent,这些 scenario 是我们认为能代表真实用户如何使用 Expo 构建应用的场景。一个 scenario 可以是一个端到端任务,比如一次性生成一个完整的移动应用;也可以更细,比如调试一个反复崩溃的 dev build,或给已有应用加一个功能。
任何有力的评估都建立在扎实的检查项之上。我们没有从 agent 轨迹里事后推断这些检查项,而是为数据集中的每个 scenario 标注了:
- 我们预期 agent 在执行该任务时哪些 skill 会有帮助
- 如果遵循了 skill 中的指导,应该看到哪些证据
- 一个端到端任务涉及哪些功能原语,我们的 agentic evaluator 应该对其做 QA
这些检查从三个不同层面提供证据:
- 技能触发:agent 是否加载了与任务相关的技能?
- 技能采纳:能否找到证据表明 agent 遵循了它加载的指导?
- 应用行为:最终构建出的应用能否正常运行,并表现出任务 PRD 中描述的行为?
这几个问题彼此相关,但各自揭示了我们所观察到的 agent 行为的不同侧面。
技能如果从未被加载,就不可能影响 agent,因此必须衡量技能触发。但技能也可能被加载后被无视,所以衡量采纳证据同样重要。
agent 也可能完全不去查阅我们希望它使用的技能,仅凭已有知识就构建出可用的功能。这完全没问题!事实上,即便 agent 没有借助 Expo 精心整理的智慧,也不应因为它正确完成了任务而扣分。这反而可能说明,某项技能已经被不断提升的前沿能力所覆盖。把这些拆成独立的评估层面,让我们更容易看清 coding agent 最需要帮助的地方。
用你的任务运行 coding agent
在第一轮迭代中,我们让 coding agent 面对更具雄心的端到端场景:先准备一份产品需求文档(PRD),其中包含用户想要构建某个移动应用的高层提示。随后,我们的评估框架会把这一任务交给 coding agent,并记录它在整个创作过程中的轨迹,包括它调用了哪些技能。agent 完成生成后,框架会把构建产物打包,传递给下游环节。
同时评估过程与产物
接着,框架会启动两个并行的评估任务,回答两个彼此正交的问题:
静态评估:一组细粒度、确定性的检查,衡量产出的应用构建是否健康、agent 轨迹中是否调用过任何技能,以及这些技能给出的指导是否真正进入了产出的源代码。
应用评估:一个agent 评估器,能够构建并启动编程 agent生成的移动应用,随后像用户一样操作该应用,以验证核心功能原语。
在 CI 中运行评估框架
评估框架本身运行在 Expo 的 CICD Workflows 上,我们将其接入了 Expo Skills 仓库——Expo 正是在那里开发和维护他们的插件。现在,只要 Expo 的人发布新 skill 或更新已有 skill,就可以在 pull request 里加一个 eval 标签,直接触发评估。随后,框架会分别用 main 上的 Expo 插件版本和 pull request 中的版本运行选定的场景,最后把评估结果直接呈现在 PR 里。
这正在逐渐成为 Expo 开发生命周期的一部分:skill 作者像维护单元测试一样维护自己的任务和 ground truth 检查,插件本身也就按代码的方式来开发——做一次改动,拿一组场景跑一遍,看过证据之后再决定下一步。
这对我们有什么帮助?
编写轨迹最先让我们看到的一件事是:预期中的 Expo skill 几乎从来没有像我们希望的那样被加载。
这一点很有价值,因为应用表面上看起来仍然可以是成功的。agent 对 Expo 和 React Native 已经了解得足够多,能写出代码,所以只看最终答案或者扫几个文件,未必能发现我们的插件在这个过程中什么都没贡献。而轨迹让这一点变得可见。
对于为什么会这样,我们有几个猜测。
- agent 可能已经确信自己能完成任务,因此根本不会去寻找额外的指引。
- skill frontmatter 里的描述,可能没有充分说明每个 skill 应该在什么情况下使用。
- 随着插件不断变大,可用 skill 的数量本身就可能让这一堆东西更难浏览。
以前,我们只能就这些可能性争论一番,改一改描述,再手动试几个 prompt。现在我们有了验证它们的手段。
我们从最显而易见的干预开始:改进各个 skill 的名称和描述。agent 在判断某个 skill 是否相关时,看到的就是描述,所以从这儿入手很自然。这些改动帮我们厘清了每个 skill 的用途,但还远远不够。
这让我们回到了第三种假设,而它其实是我们早就有所怀疑的一点……
给 agent 一个进入 Expo 技能的入口
Expo 生态覆盖的范围很广:React Native、Expo SDK 本身、Expo Router、Expo Modules、原生 UI 组件,当然还有我们的云服务。这些能力加在一起,为应用的开发、部署和可观测性提供了一套极其强大的工具。为每一块单独做技能,我们就能给出细致的指导,而不必每次都把整个 Expo 生态塞进 agent 的上下文。但这也意味着,agent 一开始就要在二十多个技能里做选择。
我们需要一个统一入口:帮 agent 走进这个集合,再在其中导航。
结果就是 expo-overview:一个面向所有 Expo 和 EAS 任务的入口技能兼路由。它的描述把它定位为起点——只要请求涉及 Expo、EAS 或 React Native 任务,就先用它。技能内部有一张映射表,把常见目标对应到包含相关指导的更专门的技能。它还负责一小组贯穿整个插件的设置规则,比如检测 Expo SDK 版本、用 npx expo install 安装包。最近 Sentry 和 Convex 在自己的技能插件里也采用了类似的做法:给 agent 一个明确的起点,再把它引向更专门的指导。
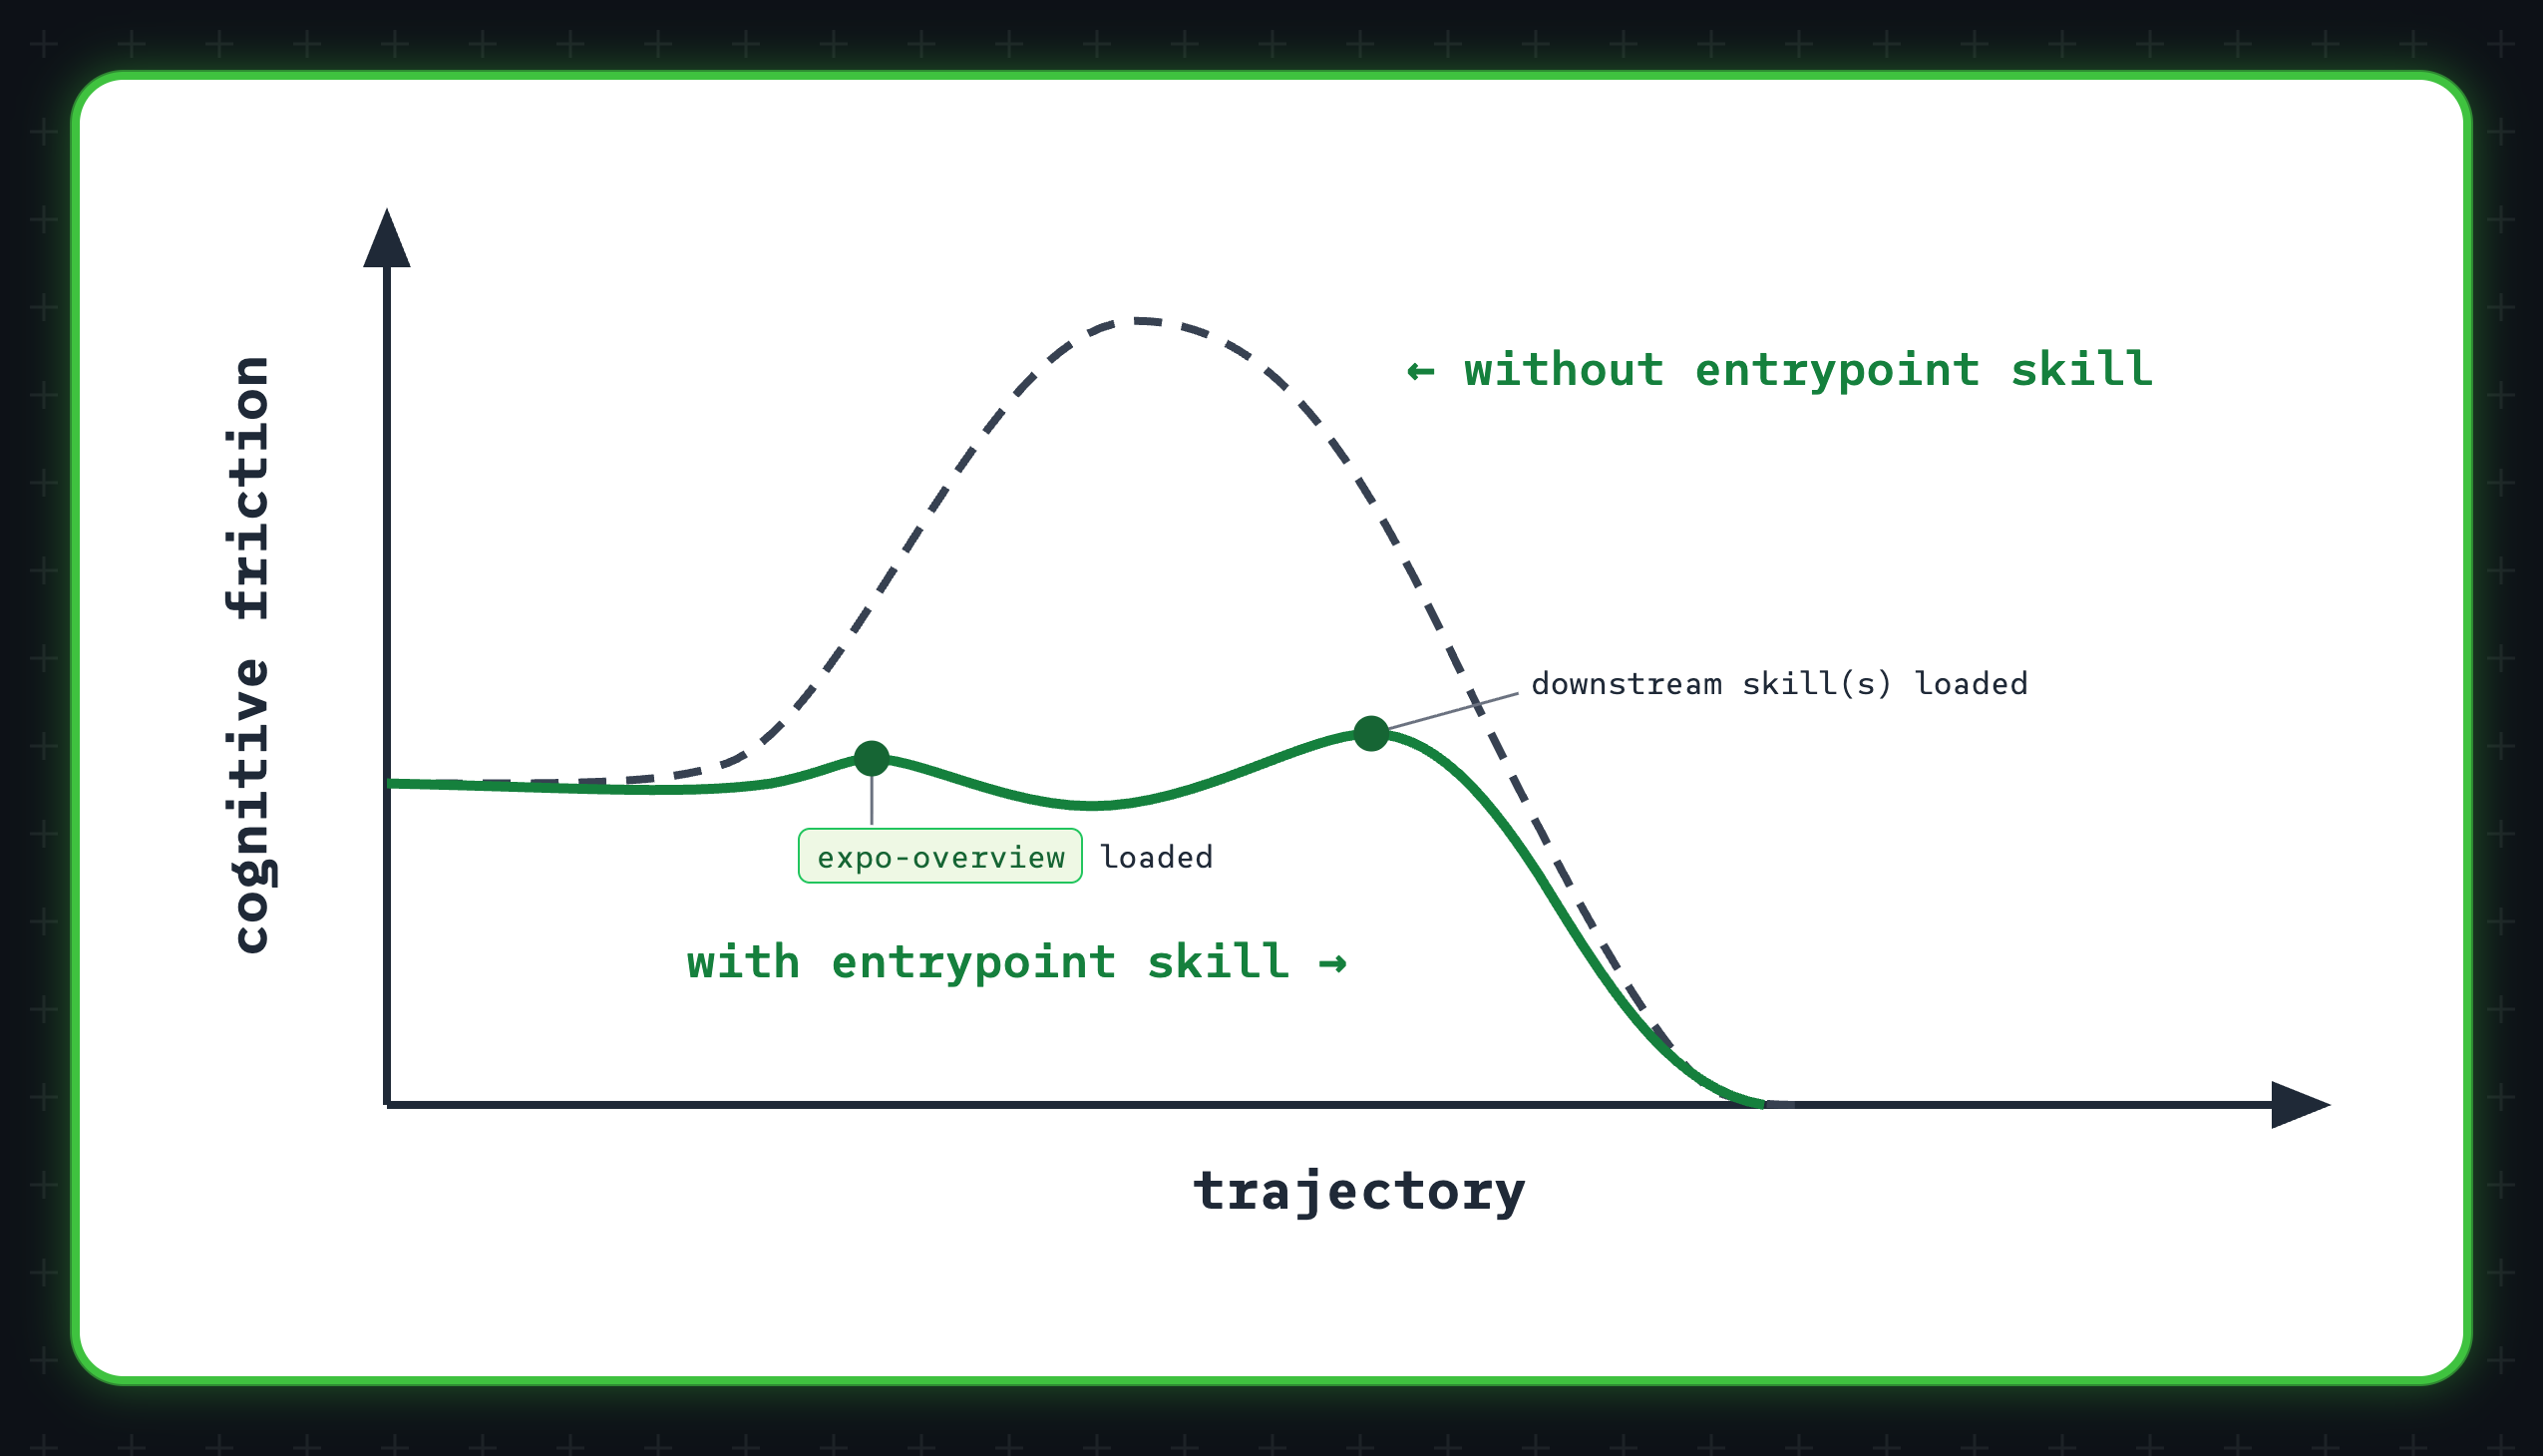
这个总览技能并没有改变 agent 仍然要在 20 多个技能之间浏览的事实;它解决的是我们观察到的另一种失败:很多时候,agent 干脆一个 Expo 技能都不调用。
为什么会这样?一个应用开发任务本身就已经让 agent 面对一长串决策——架构、依赖、导航、状态、实现。如果它还要在忙这些的同时从二十多个技能里挑,它很可能就顺着自己已经会的东西做下去,根本不去碰任何一个技能。这只是推测,但我们的目标很简单:把伸手去拿一个技能所需的启动成本降到最低。
评测框架显示了什么?
我们在提交这项新技能的 pull request 上加了 eval 标签,让评测框架针对现有插件和这项改动分别跑同样的三个应用场景。第一个积极信号是 agent 说了出来:
“我先加载 expo-overview 技能,因为这个任务涉及构建 Expo/React Native 应用……”
另一个场景里,agent 把同样的判断说得更直接:
“我先加载 Expo overview 技能,因为任何 Expo/EAS 任务都必须先跑它。”
这正是我们想要的行为。用户在请求里没有点名 expo-overview,也没有点名任何下游技能。agent 识别出了更大的 Expo 任务,自己选了入口,然后用入口里的路由信息决定接下来加载什么。
随后,针对数据集里的三份 PRD,trace 显示技能按以下顺序加载:
- Notes:
expo-overview→expo-project-structure - Hot Chocolate:
expo-overview→expo-project-structure→expo-router - Wiki Reader:
expo-overview→expo-project-structure→expo-router→expo-ui
三次运行都先加载了 overview。之后每次运行都从 overview 继续进入至少一个相关的下游技能。agent 一旦跨过“加载 Expo 技能”这道门槛,做出第二层决定的可能性就比所有候选技能同时竞争被选中时高得多。
从只有 10% 的 agent 会话加载技能,到超过 50%
为了确认 PR 里这个初步结果是否具有普遍性,我们用 sonnet-5-high 重新跑了 Claude Code,这次针对 10 份全新移动应用 PRD。面向用户的 prompt 提到了 Expo,但从未点名任何技能。我们对比了加入 expo-overview 前后的插件,每个配置跑三次,以消除 agent 轨迹中的随机性。
在没有 expo-overview 的基线运行中,只有约 10% 的 agent 会话决定加载任何 Expo 技能。有了 expo-overview 之后,这个数字跳到 55%——所有 agent 会话中有一半以上加载了 1 个或更多下游技能。
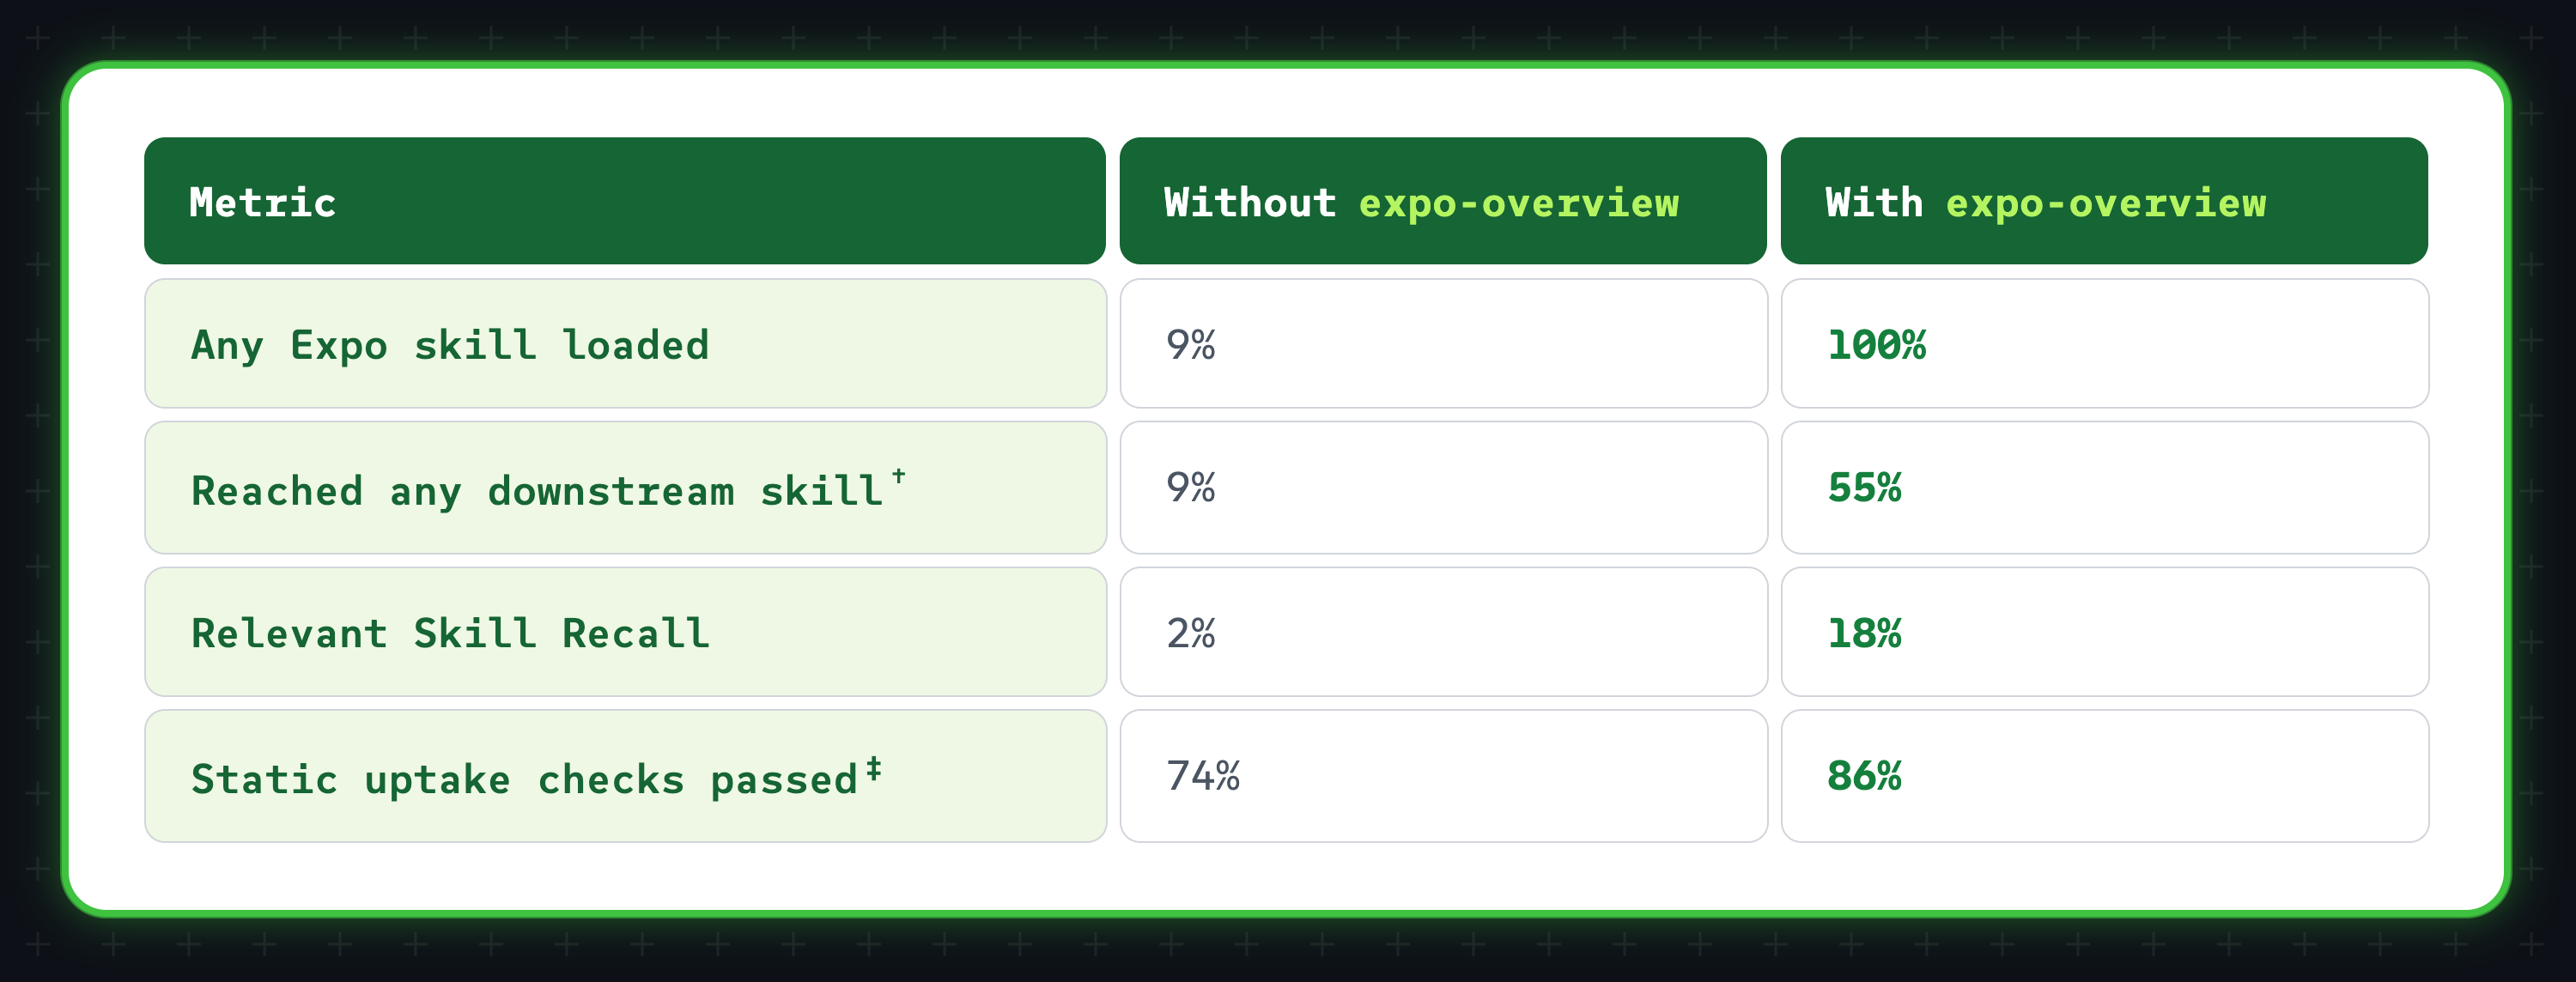
† 下游技能指任何非 expo-overview 的技能。在基线中,expo-overview 并不存在,因此这里就是任意 Expo 技能。
‡ 采用率是指在所编写的源代码中出现了符合预期模式的静态可查证据。
每个候选会话都加载了 expo-overview。这验证了我们的目标:为 agent 提供一个可靠的入口,用于处理 Expo 相关任务。更重要的是,55% 的会话会继续加载至少一个更专门的技能,而基线会话中直接加载技能的比例只有 9%。
Relevant Skill Recall 给出的是同一问题的更严格版本。在数据集中,我们还指定了每个 PRD 对应的一组相关 Expo 技能映射。这些技能能为相应任务提供有用的指导,因此我们预期 agent 会调用它们。Relevant Skill Recall 从 2% 上升到 18%,但仍不完整:即使加入了 expo-overview,在大多数任务中 agent 仍经常只调用相关技能中的一部分。
逐个技能查看这个数字,让我们有了更直观的感受:
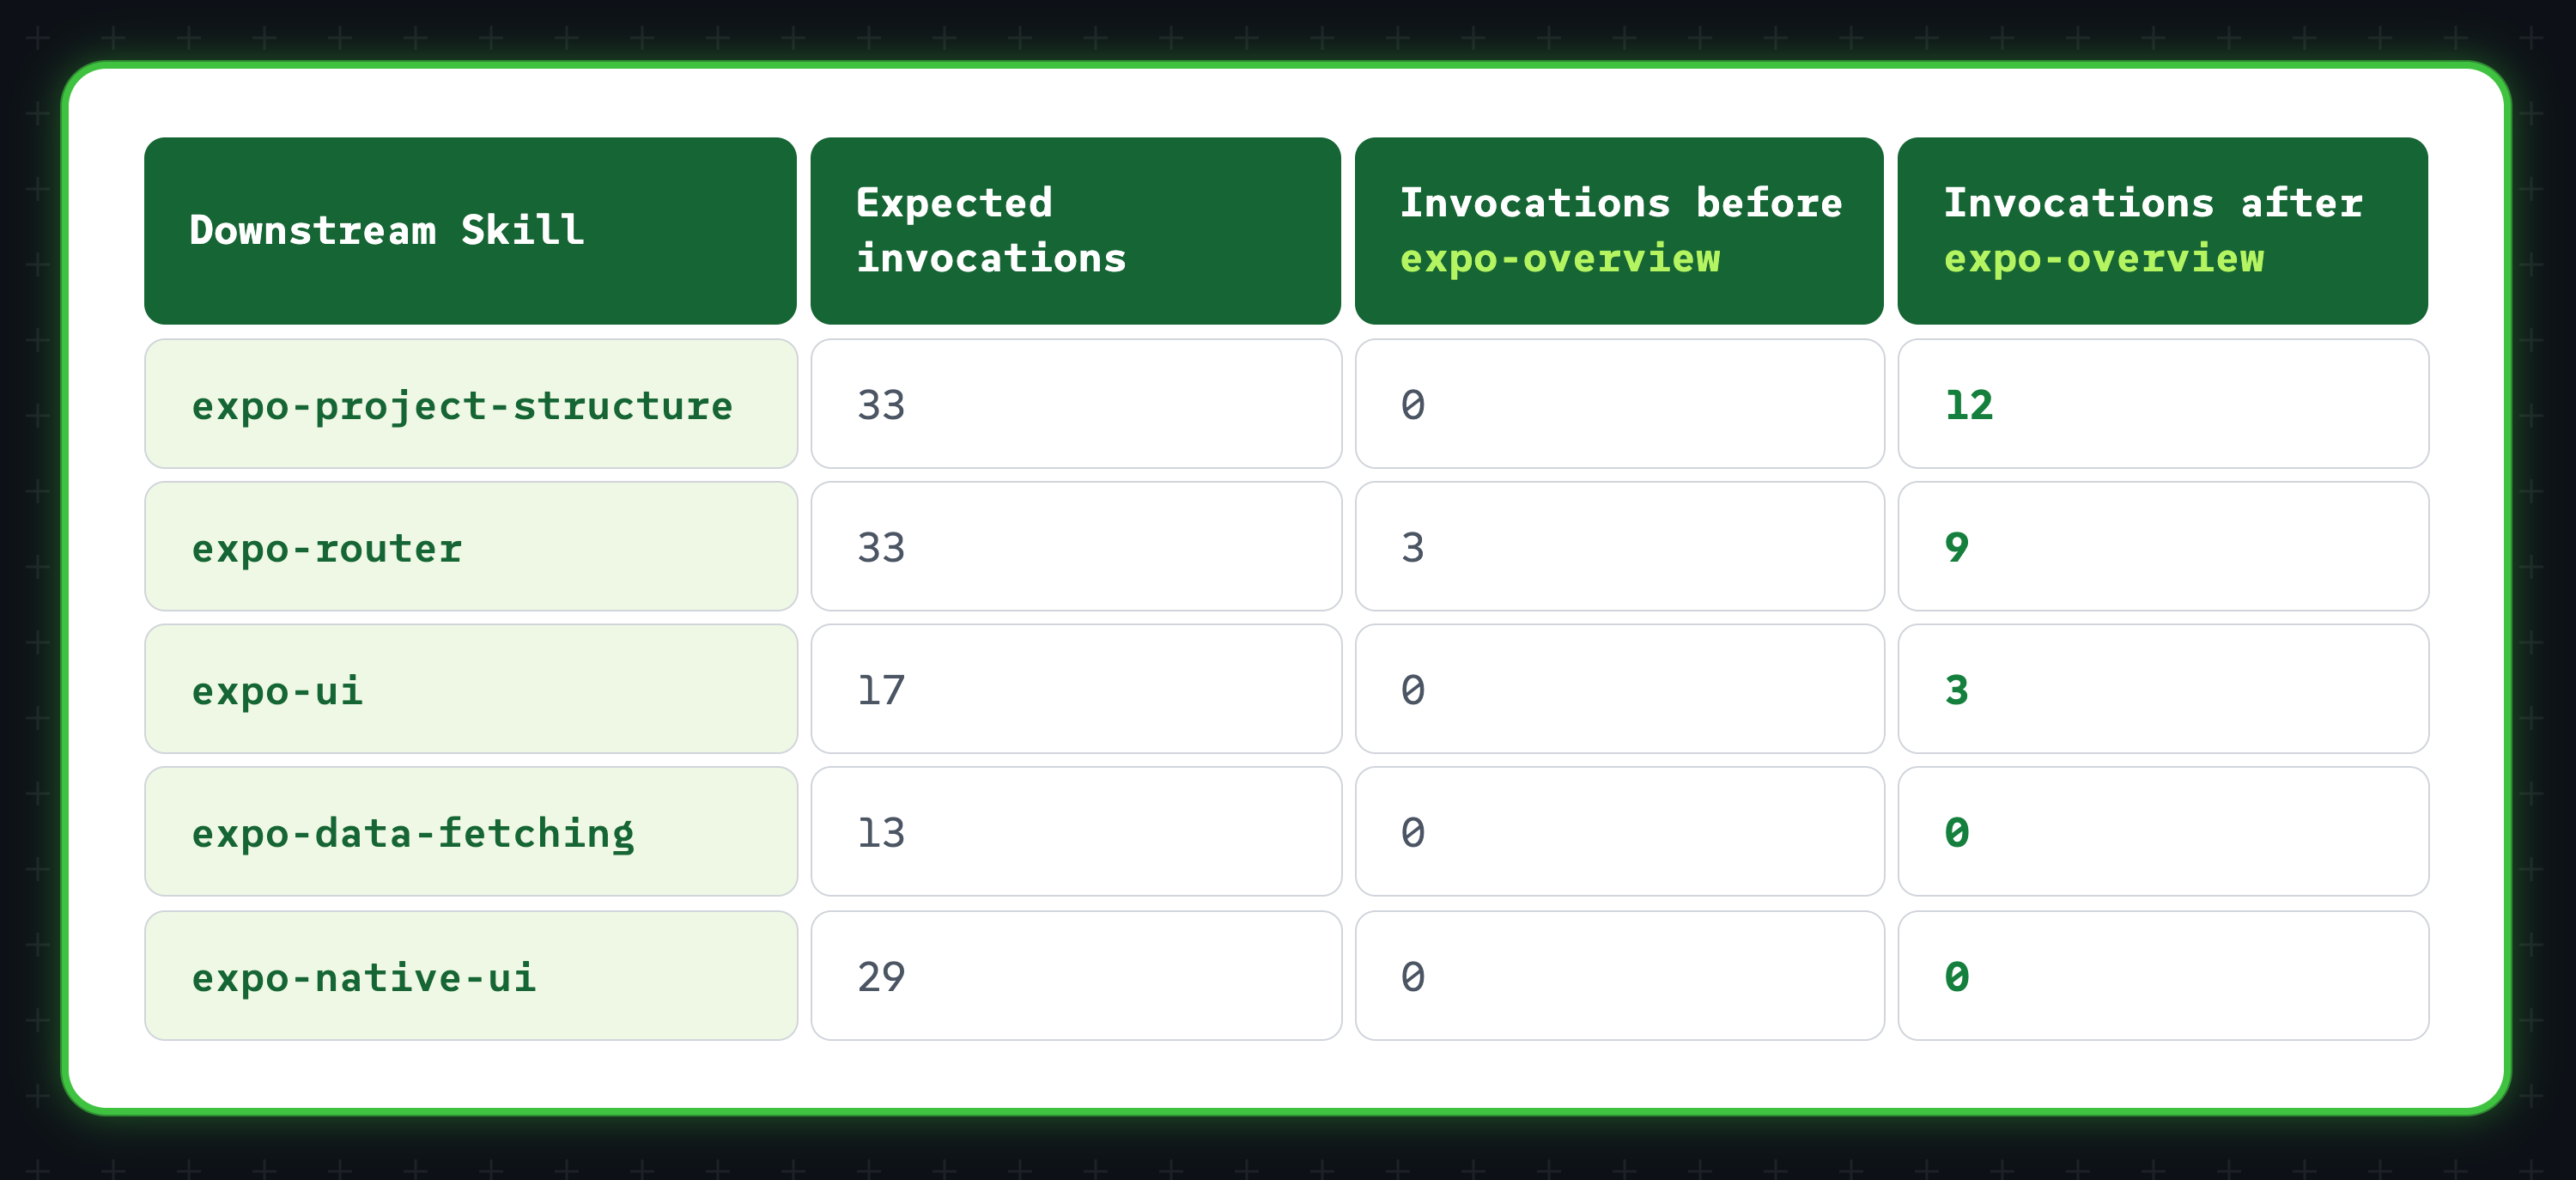
最常被加载的 skill 都与任务早期、具体的决策相关,比如搭建代码库骨架(expo-project-structure)或设置页面路由(expo-router)。
在一个 PRD 中,agent 加载了 overview skill,随后表示*“(让我)查一下 project-structure skill,看看脚手架该怎么搭。”在另一个以导航为主的任务中,它把这种关联说得更直接:“现在把它改成用 Expo Router(tabs 导航需要),再查一下 router skill 看设置步骤。”*这两个例子中,agent 都是在读完 overview skill 之后立刻着手处理的任务,因此往往也会去读对应的 skill。
漏掉的情况同样有意思:有一次,agent 加载了 expo-overview 和 expo-router,然后宣布要构建核心数据层,实现了 RSS 和 Atom 抓取并测试了真实 feed,全程没有加载 expo-data-fetching(这可能是该任务最相关的 skill),而是宁愿凭自己已有的知识来做。另一次,agent 为了控件加载了 expo-ui,却没有加载 expo-native-ui,尽管 expo-overview 建议两者配合使用。生成的代码用了 Dimensions.get() 和 React Native 的 SafeAreaView,而这两个模式正是被跳过的 Native UI 指南会劝阻的。
从这些案例来看,agent 在任务刚开始、读完 Overview 之后调用相关 skill 的频率明显更高。随着任务往后推进,它调用相关 skill 的可能性越来越低,更倾向于从其他信息来源入手。
一种可能的解释是:虽然 expo-overview 是事实上的入口,但 agent 并不完全把它当作一个通用的路由,不觉得应该在任务全程反复回来查阅。
这只是从少量数据点中得到的初步信号,要让 agent 更可靠地找到相关的 skill 知识,还有很多工作要做。但我们现在已经能清楚看到,我们想要影响的行为出现了差异。这正是此前缺失的反馈闭环。
技能太多也有坑?截断!
我们最初的实验是在 Claude Code 里跑的,但这个结果也让我们好奇:其他编程 agent是怎么呈现技能的?我们翻了开源 Codex CLI 的内部实现,想搞清楚技能发现发生在哪一层。
系统提示词之后,紧接着是一个 Skill Catalog 段落,列出每个可用技能的名称、描述和文件路径。在 Codex 里,这个目录的总长度是固定的,由该 agent可用的所有技能共同分摊。在我们查看的这个版本中,这一额度被设定为上下文窗口的整整 2%,也就是 272k 中的 5,440 个 token。
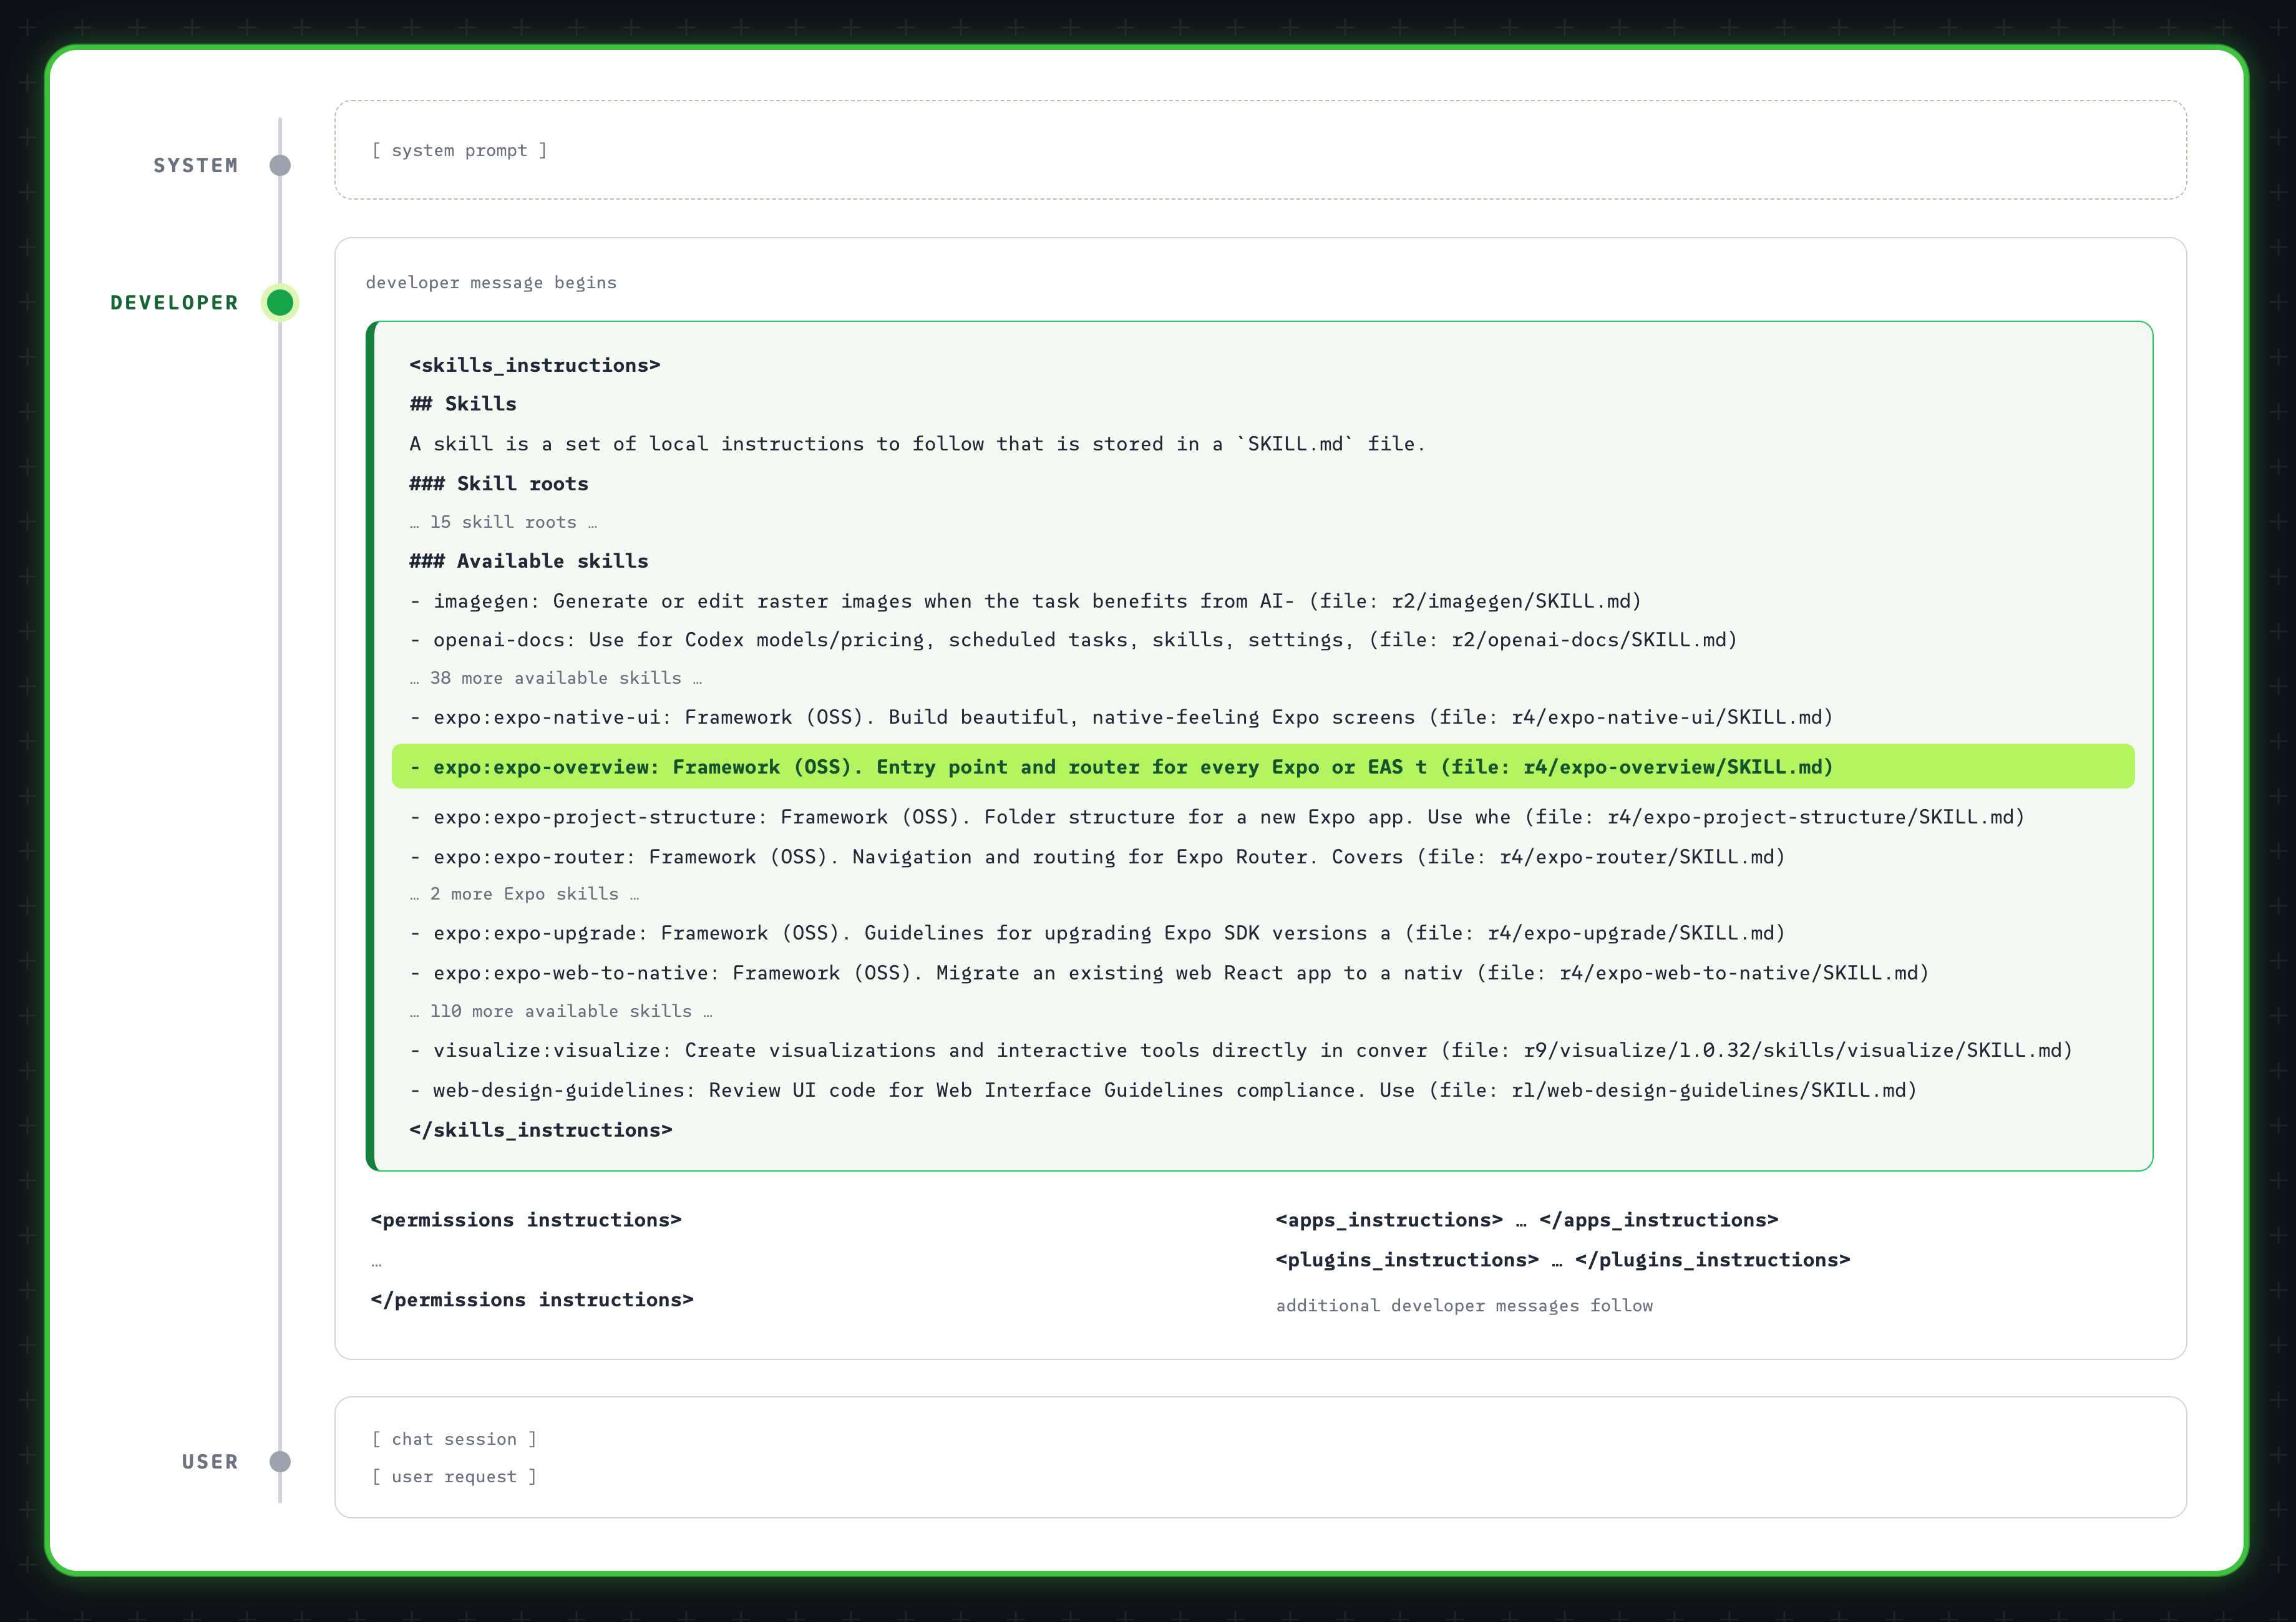
我们很早就想弄清楚技能拥挤会带来什么影响:当我们的插件提供的技能与其他非 Expo 技能相互竞争时,会发生什么?
通过一些对照测试,我们发现,当完整的技能目录超出 5.4k token 的限额时,Codex 会先缩短技能描述,只保留开头部分。技能再多一些,描述就完全消失,只剩下技能名称。再往后,整个技能最终会被从目录中丢弃!
我们在一个安装了 175 个技能的测试环境中看到了这一过程,其中 24 个来自 Expo 插件。在 272k 上下文窗口下,我们发现所有 Expo 技能都被列出,但每个描述只显示前 60 个字符左右。
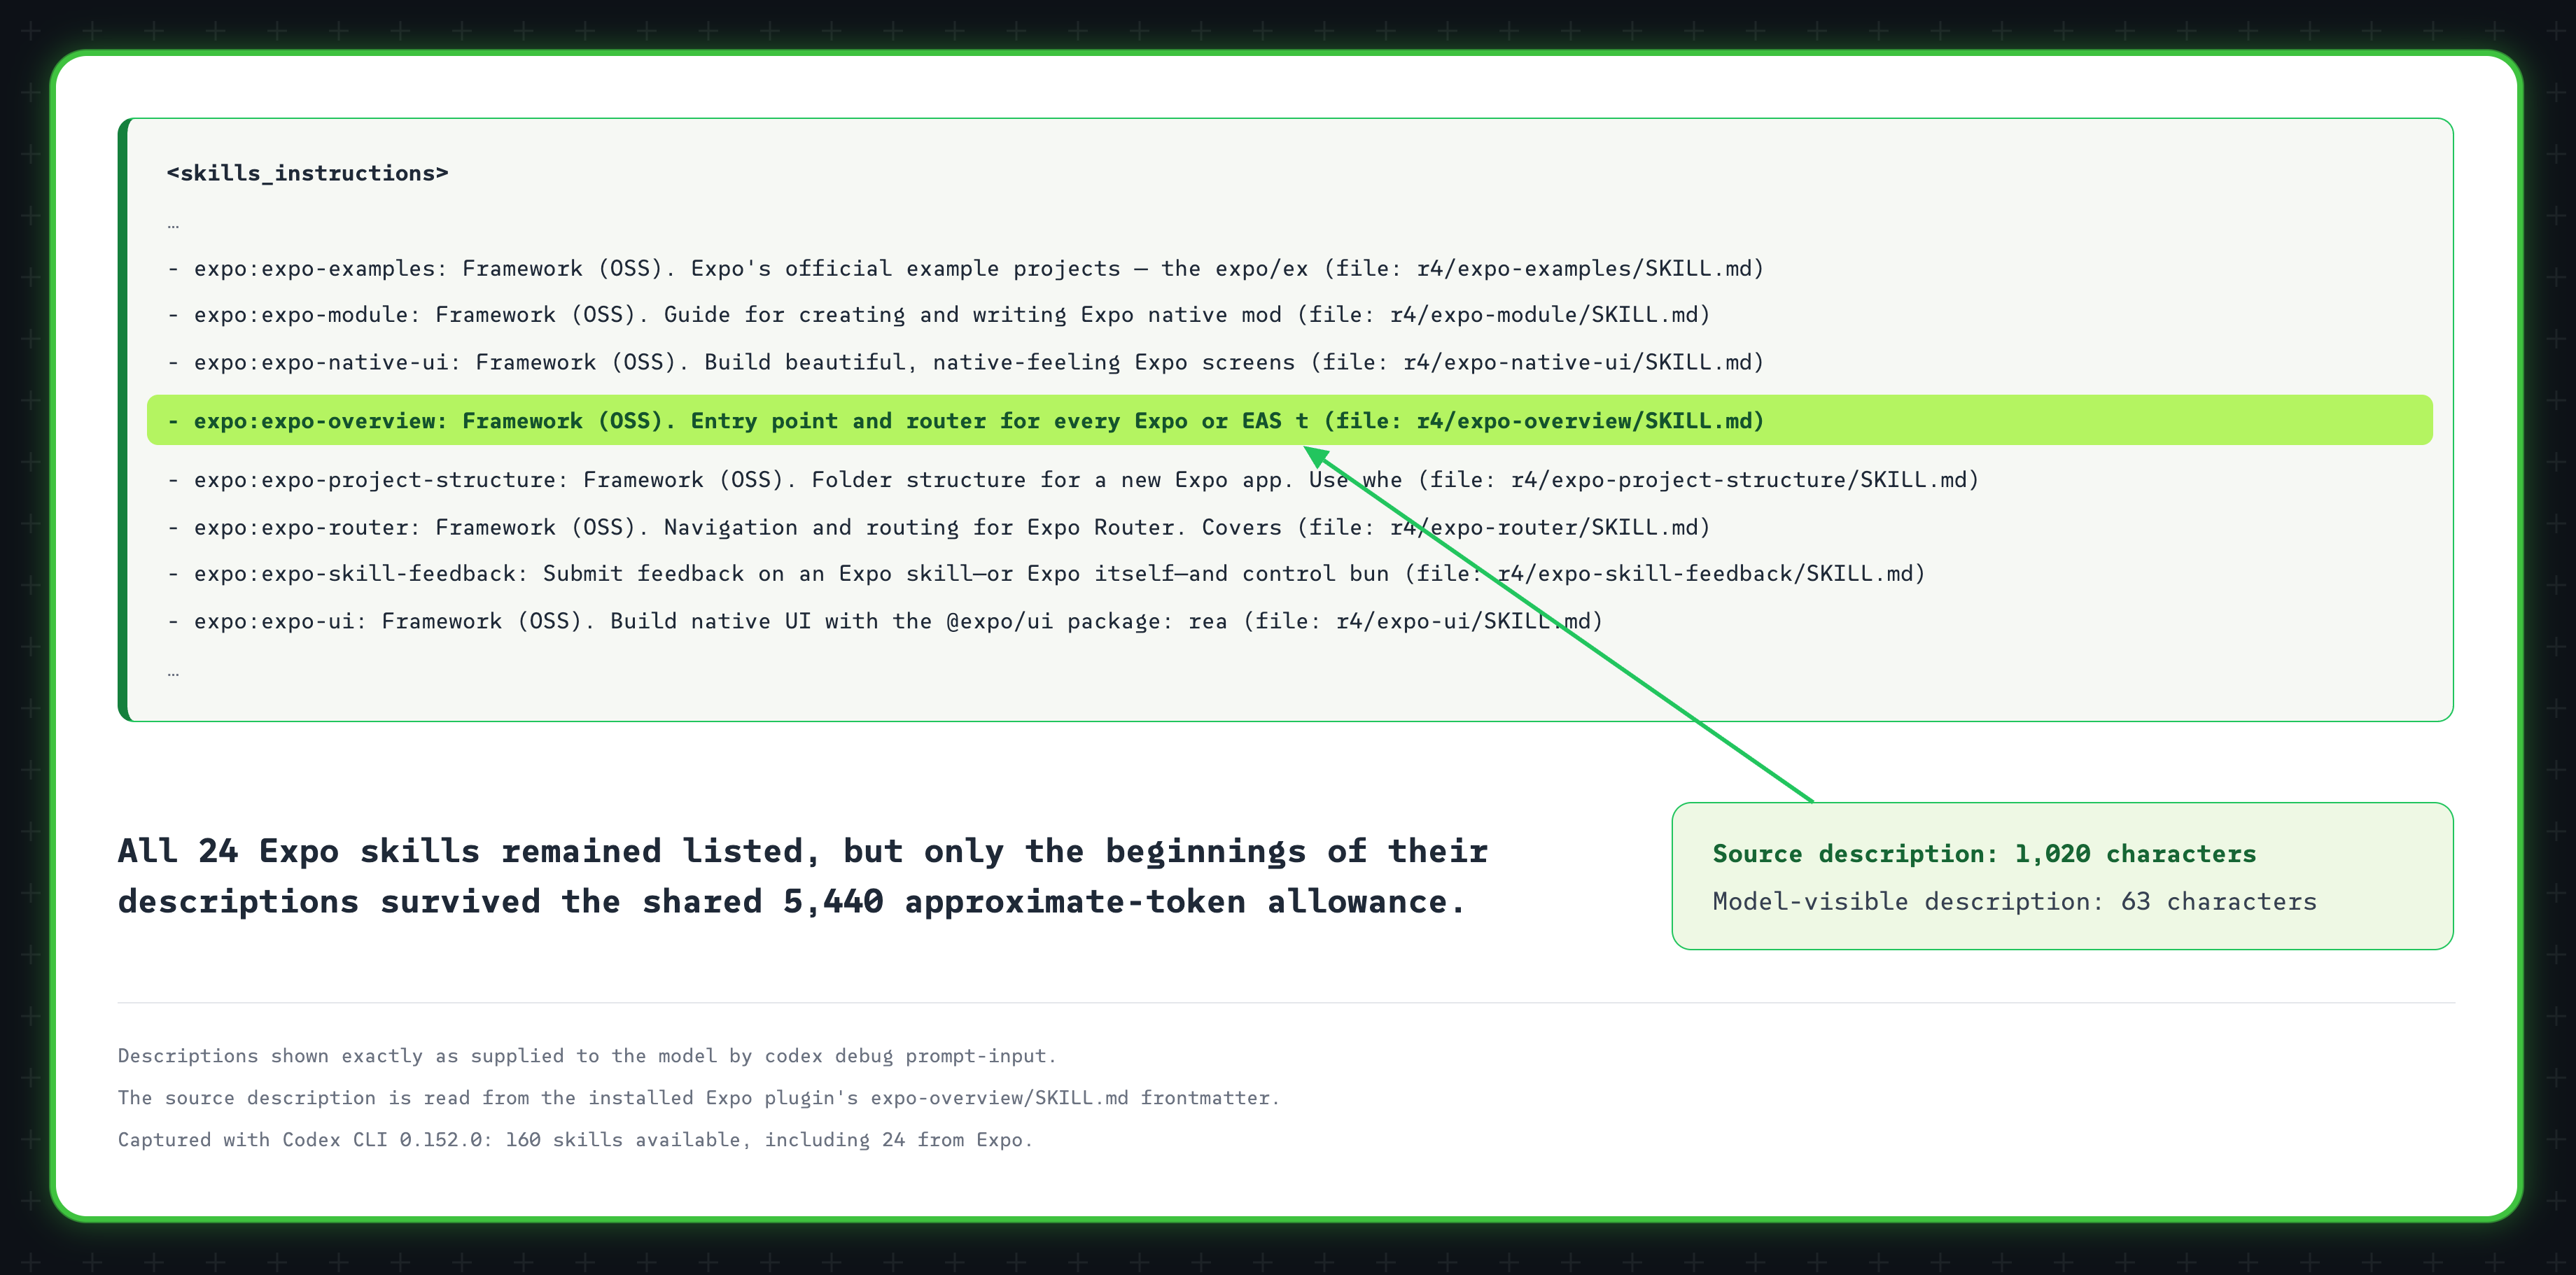
随着可用技能的数量不断增加,agent 要在更多选项之间做选择,而它获得的关于每个选项的信息却可能更少。仅凭技能的名称和开头几句话,结果就可能大不相同。
TL;DR: 如果有太多技能争抢你那 2% 的上下文窗口,其中一些技能的描述(甚至技能本身!)可能会被截掉!请确保你的技能在这种情况下依然稳健!
这也暴露出我们这套设置中的一个假设:我们的评测框架把一个 coding agent 部署在干净的环境中,只装了 Expo 插件,不与其他厂商的技能竞争。这种隔离在比较插件的两个版本时很有用,因为它排除了无关的变量来源。但用户实际使用 coding agent 的方式未必如此。真实用户可能装了很多插件,它们都在争抢同一份目录预算和 agent 的注意力。
说到底,技能需要在它预期会被发现的那种条件下接受评测。
一份孤立的目录能告诉我们一个技能单独看是否清晰可辨,却无法告诉我们它在拥挤的目录中是否依然可见、依然与众不同。我们最初的实验测的是前一种情况。但我们在更具代表性的本地环境中观察到的截断现象说明,后一种情况大概也值得单独设一个评测条件!
我们学到了什么
第一个教训是,一组各自有用的技能并不会自动组合成一个同样有效的插件。一旦技能数量超过几个,任何插件大概都需要某种形式的信息编排。agent 不仅要理解每个技能说了什么,还要理解这些技能之间是什么关系、应该从哪里入手。
第二个教训是,我们需要按照用户实际使用插件的方式来评测。在开发单个技能的内容时,直接调用仍然有用,但它无法告诉我们 agent 会不会从一次普通请求中发现这个技能。从宽泛的产品需求出发、阅读由此产生的 trace,我们才得以直接观察到这个选择问题。
这也包括评估用户实际与插件交互的环境:当许多其他技能也在争夺注意力时,你的设计效果可能看起来不一样。因此,环境是评估中同样重要的一部分。
第三个教训是,在我们拥有完美的端到端分数之前,过程测量可以告诉我们一些有用的东西。我们正在继续改进测试框架的采纳检查和 App Evaluator,因为归根结底,我们关心的是这些指导是否能产生更好的应用。但触发是必要的第一步。如果一个技能从未进入 agent 的上下文,那么它内部指令的质量对那次运行来说就无关紧要。
这就是为什么将测试框架连接到 CI 对我们很重要。我们不希望技能评估成为一次性的实验,只在我们已经预期会有正面结果时才运行。我们希望它成为我们开发插件方式的一部分:做出更改,运行现实任务,检查轨迹和产物,并利用我们学到的东西来选择下一个干预措施。
expo-overview 是那个循环的第一个有用例子。测试框架向我们展示,agent 找不到我们的技能。我们改变了集合的架构,而不是继续孤立地调整每一个技能。下一次运行显示,agent 按照我们预期的方式对新入口点进行推理,并加载了更多下游指导。
这给了我们第一个清晰的例子,说明这个过程在起作用:观察 agent 在哪里挣扎,做出有针对性的更改,并衡量它们的行为是否改变。
还有更多工作要做。但我们现在有了一个评估机制。你也需要一个。