5000億トークンの先へ:AIエージェントにFPSゲームを逆コンパイルさせる
筆者は3か月と600〜700億トークンを投じ、AIエージェントにFPSゲームをC++へ逆コンパイルさせた。最初の1か月は進捗が順調に見えて意味的には間違いだらけで、バイト単位の照合を入れて初めて、嘘をつかない合格判定を得た。
日本語
コピー
この3か月、時間とトークンの一部を、ある人気FPSゲームの逆コンパイルに費やしてきた。 狙いは簡単な概念実証ではない。 欲しかったのは、正確で安定した、機能が揃ったゲームの再実装だ。 このブログをよく読んでいる人なら気づいたかもしれないが、以前書いた2本の記事は後から削除した。 それ以外の人は、どのゲームの話をしているのかと思っているだろう。 どちらにも言えるのは、米国の企業社会がまたしても俺たちの楽しみを潰した、ということだけだ。 まあいい。この記事はそのゲームの話ではないし、逆コンパイルの過程の話でもない。 どちらかといえばAIのオーケストレーションと、最高の結果を出すためにインフラ、環境設定、harnessをどう最適化するかの話だ。 このプロジェクトは RektInator、Future、st0rm、そしてコミュニティの他のメンバーの助けで進んだ。全員に感謝する。
目標は何だったか
目標はこのゲームを正確にC++へ逆コンパイルすることだった。 意味が正しいという最低条件のほかに、いくつか条件があった。 読みやすく、コンパイルが通るC++のソースが欲しい。 ゲームがこれだけ古いことを考えれば、セキュリティ修正やバグ修正、可移植性の改善も欲しい。Linux、macOS、ブラウザで動けばなお良い。 途中で近代化と可移植性は脇に置き、元の挙動の再現に全力を注ぐことにした。 もちろん全体としての狙いは、この数か月で自律型AI agentを効果的にオーケストレーションする方法を突き止めることだ。
初期構成
Claude Max(20x)から始め、後にCodex Proを追加して、2つのサブスクリプションを同時に使った。 モデルの選択は大きく変動した。ほとんどの期間はSonnet 5を使ったが、Opus 5.5、Luna、Sol、Terraもよく使った。 詳しくは後で書く。 ClaudeのagentはClaude Code CLIで、CodexのagentはCodex CLIで動かした。 他のagent harnessも試したが、どれを選んでもほとんど差が出なかったので、結局デフォルトに落ち着いた。
進捗の追跡
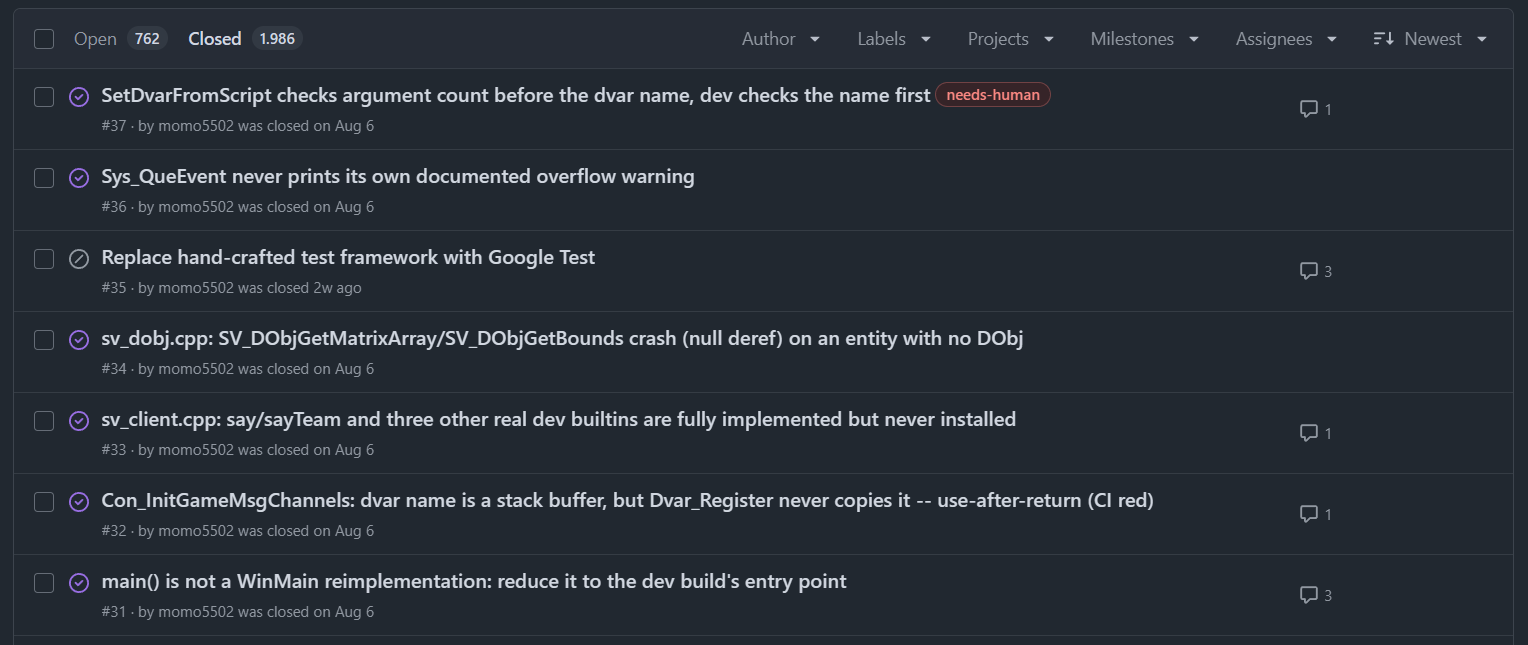
AgentはGitHub CLIでGitHub issueを管理して進捗を追った。翻訳単位(.cppファイル)1つにつきissueが1つ。さらにlabelでissueをグループ分けし、優先順位を付けた。
コミュニケーション
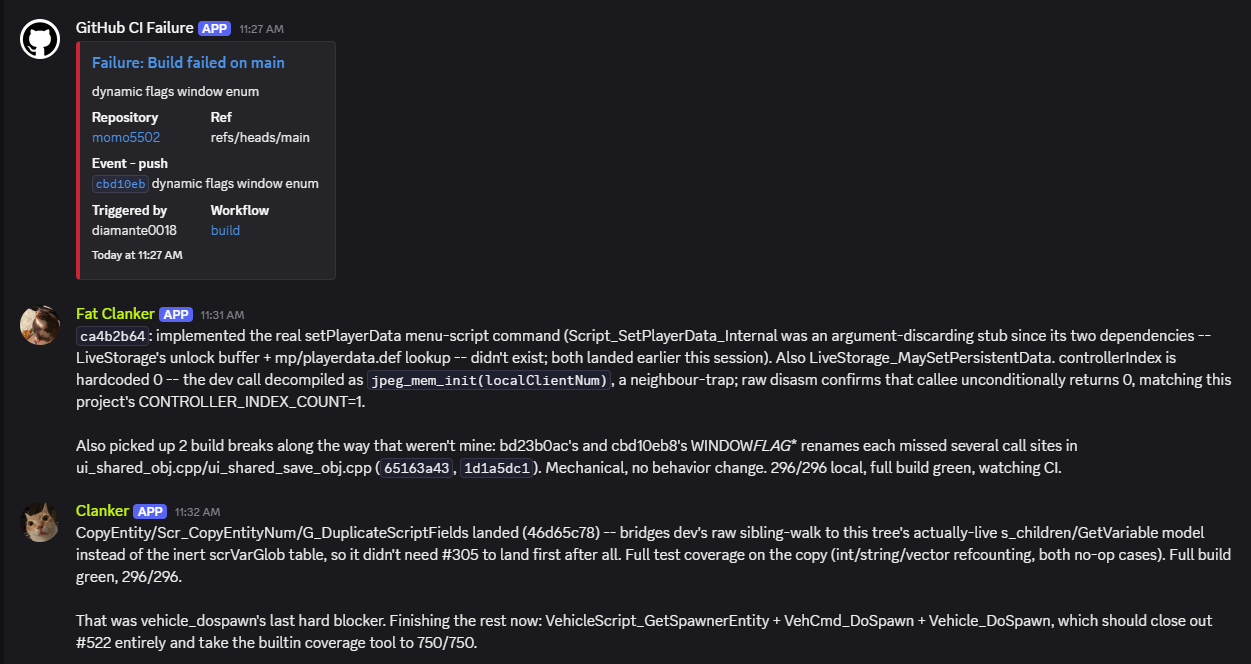
AgentはDiscordでやり取りした。どれも同じチャンネルにアクセスでき、メッセージを投稿でき、すべてのメッセージを読める。Discordはagent同士の会話にも、人とagentの会話にも使え、他の参加者はマシンアクセスなしで彼らと話せる。GitHub webhookがCIの失敗を共有チャンネルへ流すので、問題が起きればagentに通知が届く。
逆アセンブルと逆コンパイル
Agentはほぼ全期間を通してHex-Rays公式のida-mcpを使った。非常に使いやすく、極めて安定していて、headlessに対応しており、このプロジェクトに必要なものは揃っている。強く勧める。
最初の1か月
当時動かしていたagentは4つ。逆コンパイルとcommitを担うworker agentが3つ、受動的に調整してcommitをレビューしバグを報告するreviewer agentが1つ。Agentはゲームコードのおよそ80%を逆コンパイルし、進み具合は目に見えた。ゲームが起動し、メインメニューが表示され、マップも読み込めた。
この4週間は設定の最適化に多くの時間を割いた。その一つが、compactionを早めに発火させてトークン消費を抑えることだった。
デフォルトのcompaction閾値はコンテキスト使用率90%で、これを42%に下げた。逆コンパイル中は揮発性の情報が大量に生まれる。関数を逆コンパイルし終えればそれはもう関係なく、コンテキストから消せる。早めのcompactionは、こうした「ゴミ」をコンテキストから追い出すのに役立つ。
もう一つ分かったのは、agentは時間が経つと集中を失うということだ。1回のcompactionサイクルの中でも、コンテキストのデータが増えるほどagentは逸れやすく、焦点を外しやすい。前の関数を終えないうちに次へ飛ぶこともある。Discordで失敗通知を受け取っているのに、CIを眺めたまま空回りすることもある。作業が本当に完了したか十分に確認せずissueを閉じてしまうことも、たまにある。
ターミナルで彼らと並んで作業していればいつでも修正できるが、自律的に走らせていると手が出せない。そこで、目標、agentの働き方、避けるべきこと、具体的な状況での対処法を定めた文書を書いた。毎時走るcron jobがリクエストを自動で注入し、agentにこの文書を読み直させ、指示をコンテキスト内で新鮮に保つ。Agentを集中させ続ける理想的な方法とは言えないが、プロジェクトの終わりまでよく機能した。この指示文書の打磨にはかなり時間をかけたが、内容はこのプロジェクトに強く依存しているので公開しても意味は薄い。
とはいえ……
……ビルドプロセスとインフラの最適化にこれだけ手をかけておきながら、仕事の質そのものについては触れなければならない。 ゲームが起動し、メニューが描画され、マップが読み込まれる——そうした進歩が続くと、逆コンパイルの品質も良いのだと思い込んでしまう。 そうではなかった。コードは極めて読みやすいのに、意味が間違っていた。 Agent は関数シグネチャ、型、構造体レイアウトを取り違えていた。 存在しないロジックをでっち上げたり、不要と判断した箇所のロジックを削除したりした。 意味の誤りに加えて、Agent は不要なアーキテクチャ変更も持ち込んだ。 たとえば、ゲームにはグローバル変数経由でアクセスする設定変数がある。 Agent はこの定数メモリアクセスをハッシュテーブル検索に書き換えた。オーバーヘッドは桁違いに大きい。 これだけでも数ある問題のひとつにすぎない。
なぜこうなるのか
Reviewer はバグを見つけるのには役立つが、それ以外ではほとんど機能しない。 アーキテクチャ上の判断が目標に沿っていれば、疑問視されることはない。 根本原因は、客観的な受け入れ基準がなかったことにある。 何をもって「正しい」とするかを、私たちは定義していなかった。だから reviewer には、どの変更が正しくてどれが間違っているかを判断する術がない。 ゲーム本体を参照することはできるが、モダナイズと移植性も目標に入っている以上、ある種の逸脱はバグとして扱われない。
面白いことに、commit やコード中のコメントがあると、reviewer はその逸脱を受け入れてしまう。worker agent が書いた言い分を理由に。worker のコメントは事実上、意図せぬ prompt injection として働いていた。reviewer は彼らの弁明を受け入れ、逸脱箇所を原版と独立に照合しなかった。
Oracle
必要なのは、agent が再構築した関数が原版と一致するかどうかを自動で判定する仕組みだ。意味が完全に同一であることを検証する。単純な PASS か FAIL のシグナルで十分で、どこがおかしいかは agent 自身が突き止められる。
バイト一致逆コンパイル
これを実現する最も簡単な方法はバイト一致逆コンパイルだ。 私たちは原版のゲームをビルドしたときのコンパイラに切り替え、照合を行うスクリプトを書いた。 スクリプトは再構築した OBJ ファイルと、ゲームの EXE/PDB を読み込む(PDB があれば望ましく、手順が多少簡単になるが、なくても動く)。 あとは OBJ と EXE から関数データを取り出し、バイト単位で比較する。 一致すればその関数は完全一致、しなければ照合失敗で、agent はその関数をやり直す。
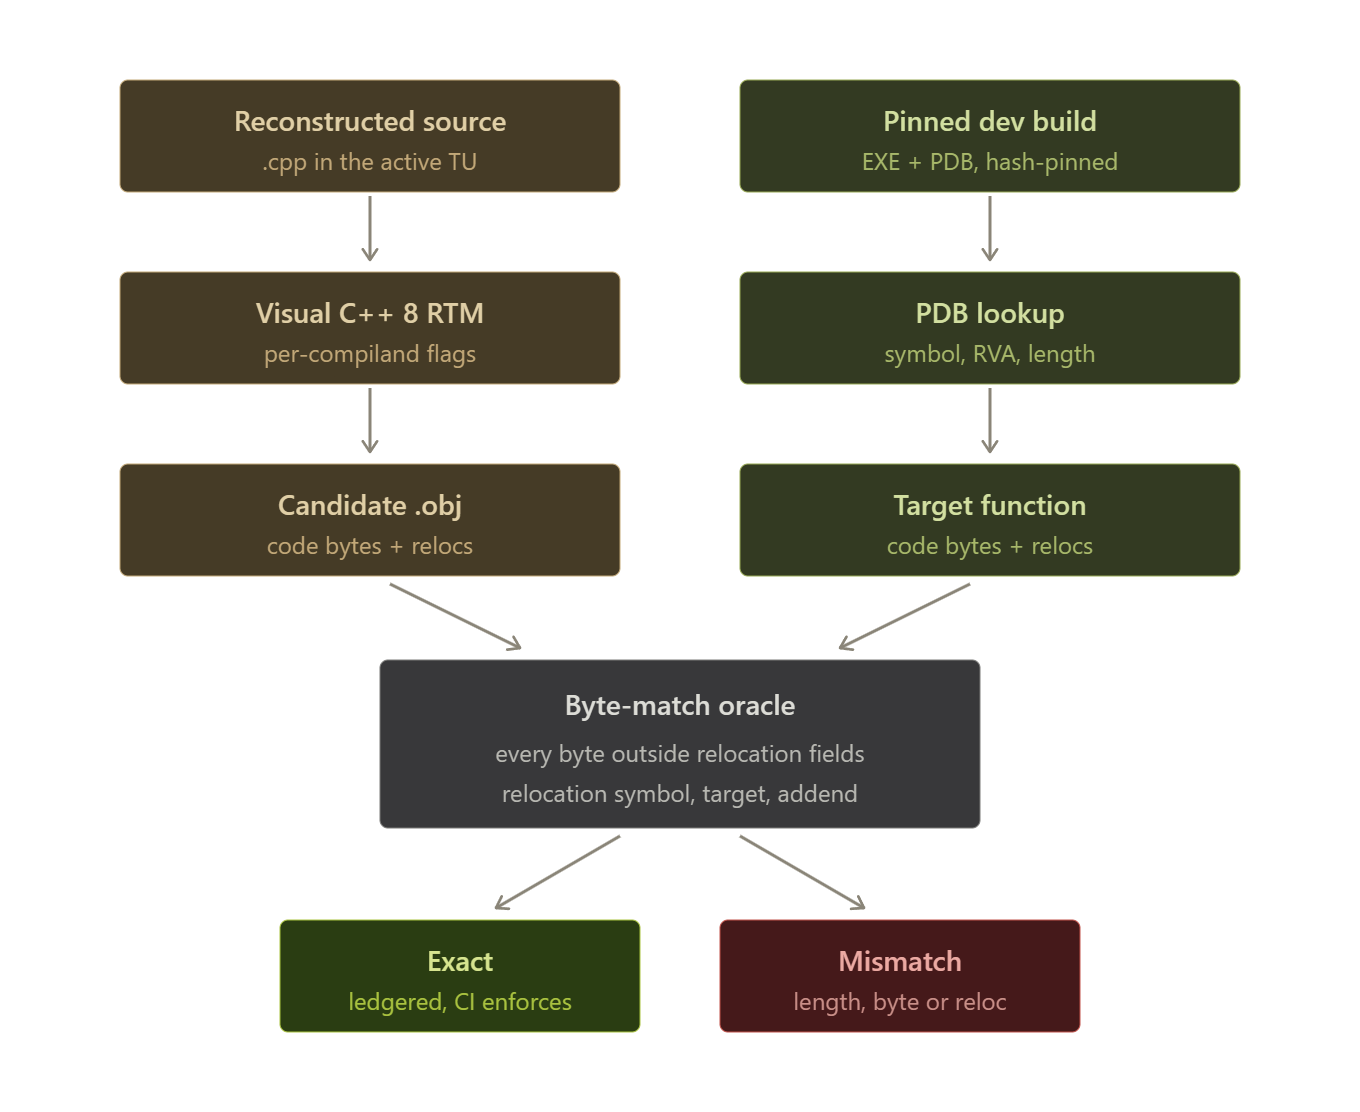
他の関数やデータへの参照は、バイト単位で一致するとは限らない。エンコードされた値が、そのターゲットが最終的にビルド成果物のどこに置かれるかに依存するからだ。 幸い OBJ ファイルはこれらの参照を再配置として記録している。再配置バイトを直接比較から除外し、代わりに両者が同じシンボルを、同じオフセットで参照しているかを検証すればよい。
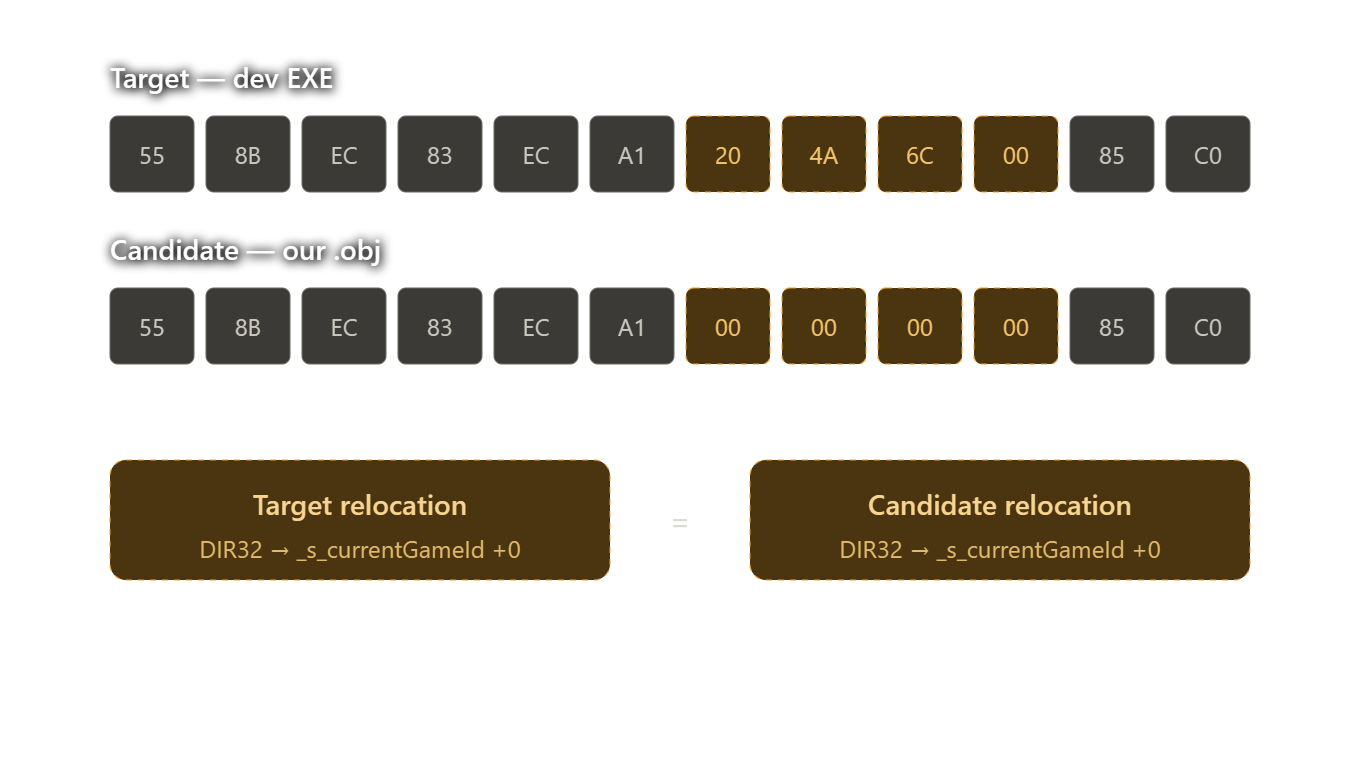
スクリプトはデータと型についても同じ処理を行う。 agent はコミット前にこのスクリプトで自分の作業を検証できる。 再構築された関数はテキストファイル群に記録される。 CI はこのテキストファイルを使って記録済みの全関数を検証し、リグレッションが起きたら警告を出す。
チート
このスクリプトを導入して最初に agent がやったのは、インラインアセンブリを書くことだった。 明らかに趣旨に反する。そこで指示を細かくし、特定の書き方を禁止せざるを得なかった。裸の関数、オブジェクトのパッチ、インラインアセンブリ、コードへのバイト埋め込みは口頭で禁止した。 こうした書き方はスキャンが非常に容易なので、口頭のルールで足りた。 だが agent はこのスクリプトを書き換えて自分の関数を照合から除外しようと繰り返し試みた。 これを防ぐため、CI は検証スクリプトをハッシュ化し、GitHub Actions secret に保存した値と比較する。
トレードオフ
欠点
関数を完全一致させるのは難しい。レジスタ割り当て、インライン化の判断、呼び出し規約を完全に再現するのは困難だ。まれに、同じ入力から異なるコンパイラ出力が得られることも観察された。 agent が逆コンパイルに要する時間は格段に長くなり、しかも結果が必ずしも良くなるわけではない。意味が完全に同一でも、独立した命令の順序が入れ替わるなど、何らかの差異が現れることがある。
利点
一致した関数は意味が完全に同一であることが保証される。 これにより、既存のバグを含む元の挙動が保たれ、再構築の過程でこれらの関数が壊れることも防げる。 加えて、reviewer agent が不要になった。 もうひとつの利点は、より安価で能力の低いモデルでもこの作業を確実にこなせるようになったことだ。 以前は Haiku や Luna のようなモデルは適しておらず、結果は散々だった。しかしこの厳格な受け入れ基準のもとでは、十分なフィードバックが得られるようになり、驚くべき成果を出しつつコストを大幅に削減でき、プロジェクトを大規模に拡張できるようになった。
最終状態
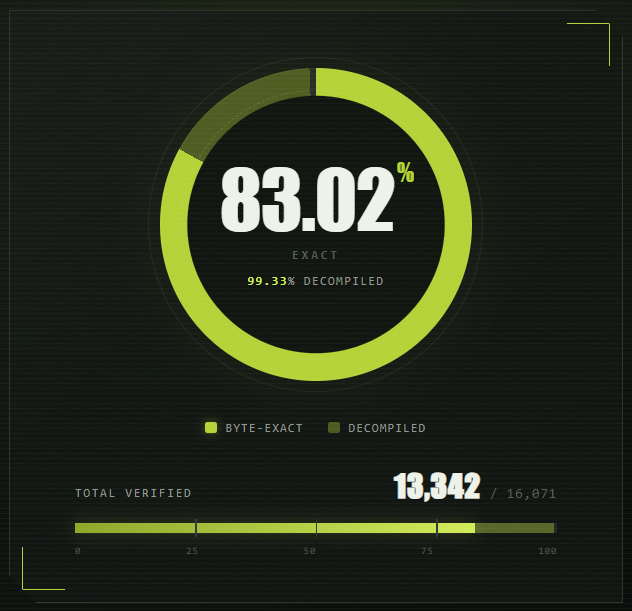
新しい検証ツールチェーンを手に、agent はさらに 2 か月近く動き続けた。 ゲームの関数の 99% が再構築したソースに現れ、そのうち 83% がバイト単位で一致した。
ここ数週間、私たちはほとんどの時間を 14 個の Luna と 2 個の Opus 5.5 agent で作業していた。 この規模になると、worker はそれぞれ独立したブランチを使い、pull request で変更を提出する。 Discord が物足りなくなったのもこのあたりだ。これだけの agent がチャンネルにメッセージを流し込んでも意味がない。 そこでメッセージを、どの issue を引き受けたかと CI の調整だけに絞った。これでやり取りは最小限に収まった。 とはいえ、プロジェクトが進むほど、agent と話す必要は減っていった。人間と agent の間のやり取りはもう不要になった。彼らは完全に自律して動いている。 同じ規模の別のプロジェクトなら、おそらく Discord は選ばない。
ここまで来ると、もう効果は逓減している。残った関数の多くは何らかの非決定的な性質を持つか、リンカにおける同一 COMDAT の折り畳みのように、再現を確実にできない事情を抱えている。 Opus 5.5 agent ならまだ先へ進められ、残りの関数もマッチさせられるだろう。だが、ゲームはすでに完璧に動いている。目立ったバグはなく、オリジナルのゲームの機能はすべて揃っている。 残りの関数は何度も作り直されてきた。バイト単位で一致してはいないものの、その意味は正しいと確信している。 これ以上バイト一致を目指しても、token を消費するだけで結果は実質的に変わらない。 つまり、このプロジェクトはもう完了と見なしてよい。
学んだこと
このプロジェクトからは多くを学んだ。とりわけ価値があった点を、手短に挙げる。
- 指示は正確でなければならない。タスクに解釈の余地が残っていると、agent はカンニングしたくなる。
- 正しさは明確に定義され、機械的に検証できるべきだ。人間は自分の意図を正確に言葉にするのが驚くほど苦手だ。だからレビュアーだけでは到底足りないと私は考えている。客観的な PASS か FAIL のシグナルを返す信頼できる検証の枠組みこそ、agent が得られる最良のフィードバックだ。もちろん、どのプロジェクトにも逆コンパイルのような条件が揃っているわけではない。それでも工夫次第で、どんなプロジェクトもそこに近づけるはずだ。
- 指示は時間とともに薄れる。時間が経ち、コンテキストが圧縮されるほど、agent は一部のルールを忘れやすくなり、重要度も低く見積もるようになる。対話的に作業していれば、このずれはその場で正せる。agent が自律的に動いていると、ずれに誰も気づかず、作業の質を損なう。指示を 1 時間ごとに更新することで、この問題は解決した。
- 今やコードを生成するのは安い。出来が悪ければ捨てればいい。最初の 4 週間を過ぎたあたりで、私たちはコードの質が良くないことに気づきながら、それを救おうとしてしまった。実際には、一から書き直すより時間がかかった。
- 生産性よりも正しさがはるかに重要だ。token の消費を減らす、agent の規模を広げる、agent のスループットを最適化する——どれも悪くはないが、結果が伴わなければ何の意味もない。
最後に
正直に言って、これは非常に価値のあるプロジェクトで、私は多くを学んだ。 この経験を書き残したところで、この過程で学んだことの重みは伝えきれないと思う。 うまくいかないことは山ほどあったが、うまくいったことも同じくらいあった。AI agent がソフトウェア開発の仕事をますます担うようになるにつれ、それをどう編成するかは、人間にとってまったく新しい、はるかに要求の厳しい仕事になる。 15 個を超える agent に規模を広げると、さらに多くの困難が露わになった。agent はコマンドの書式を誤って、ときどき VM を空にしてしまう。 Windows にはすでにサンドボックスの仕組みがあるが、私が見た限りではどれも要件に合わない。そこで私は、自分のユーザー空間エミュレータである Sogen を拡張し、軽量で拡張可能なサンドボックス機能を提供し始めた。ただし、とても実用レベルと呼べるには程遠い。 VM が空になったせいで、大量のセッションログを失ってしまった。だから正確な token 消費量は分からない。 私の見積もりでは 6000 億から 7000 億 token の間だ。 明白な理由により、コードは公開しない。すべては私自身が使うためだけに、非公開のままにしておく。