5000 亿 token 之后:让 AI agent 反编译一款第一人称射击游戏
作者花三个月、约 600–700 亿 token,让 AI agent 把一款 FPS 反编译回 C++。第一个月进展看着漂亮,代码语义却全错,直到换上字节级比对,agent 才第一次有了不会说谎的验收标准。
中文
复制
过去三个月里,我花了一部分时间和 token 去反编译一款热门第一人称射击游戏。 目标并不是做到一个简单的概念验证。 我们真正想要的是一份准确、稳定、功能完整的游戏复刻。 经常读我博客的人可能注意到,我之前写过的两篇文章后来被删掉了。 其他人现在大概在想我说的是哪款游戏。 对这两拨人,我只能说:美国企业界又一次毁了我们的乐子。 不过没关系。这篇文章讲的不是那款游戏,也不太讲反编译的过程。 它更多是关于 AI 编排,以及如何优化基础设施、环境配置和 harness 来拿到最好的结果。 这个项目是在 RektInator、Future、st0rm 以及社区其他成员的帮助下完成的。非常感谢他们所有人。
我们的目标是什么?
我们的目标是把这款游戏准确地反编译成 C++。 除了语义正确这一基本要求,我们还有不少别的条件: 我们希望得到可读、能编译通过的 C++ 源码。 考虑到这款游戏有多老,我们还想要安全修复和 bug 修复,以及可移植性方面的改进。能跑在 Linux、macOS、浏览器里……那就更好了。 后来我们把现代化和可移植性放到一边,全力去还原原始行为。 当然,整体目标是在这几个月里搞清楚,如何有效地编排自主 AI agent。
初始配置
我们从 Claude Max(20x)开始,后来加了 Codex Pro,两个订阅同时用。 模型的选择变化很大。大部分时间我们用 Sonnet 5,但 Opus 5.5、Luna、Sol 和 Terra 也用得很多。 这个后面再细说。 Claude 的 agent 跑在 Claude Code CLI 里,Codex 的 agent 跑在 Codex CLI 里。 我们也试过别的 agent harness,但选哪个几乎没差别,所以最后还是用默认的。
进度跟踪
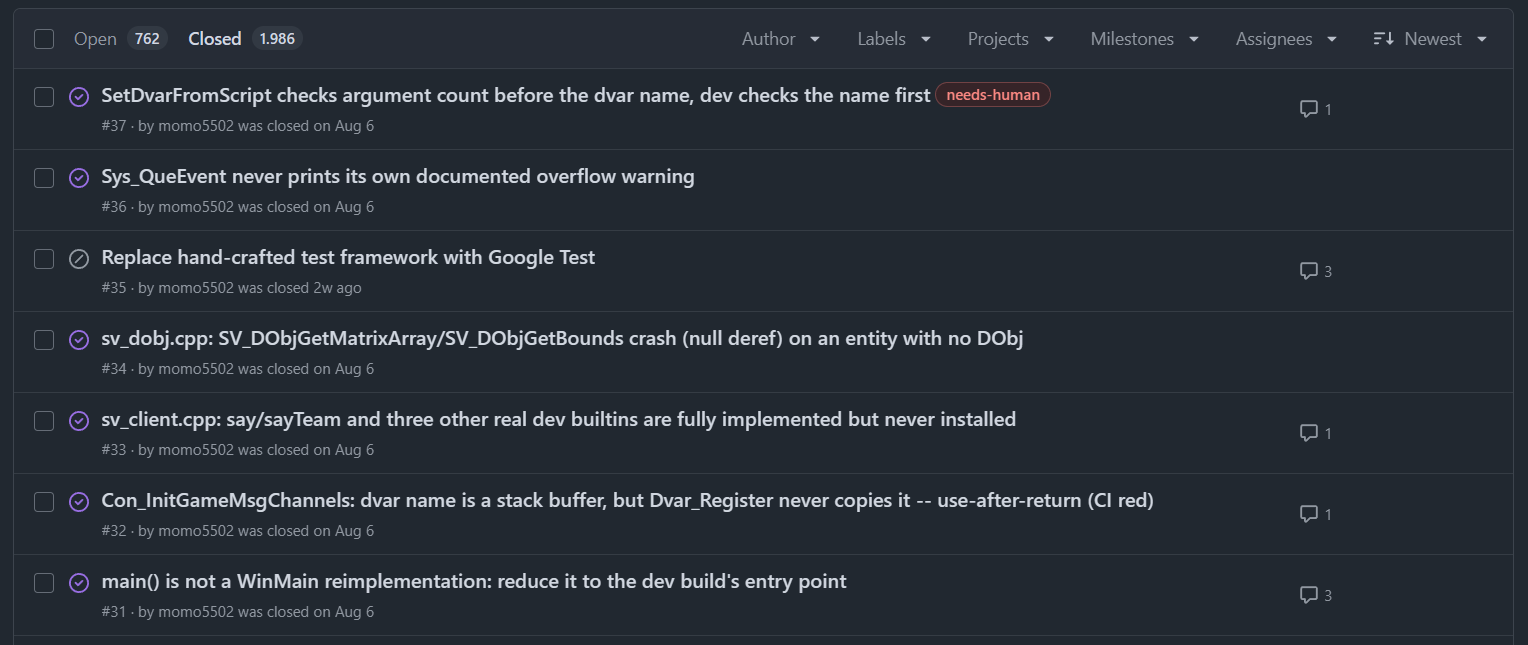
Agent 通过 GitHub CLI 管理 GitHub issue 来跟踪进度。每个翻译单元(.cpp 文件)对应一个 issue。此外还用 label 对 issue 分组和排优先级。
沟通
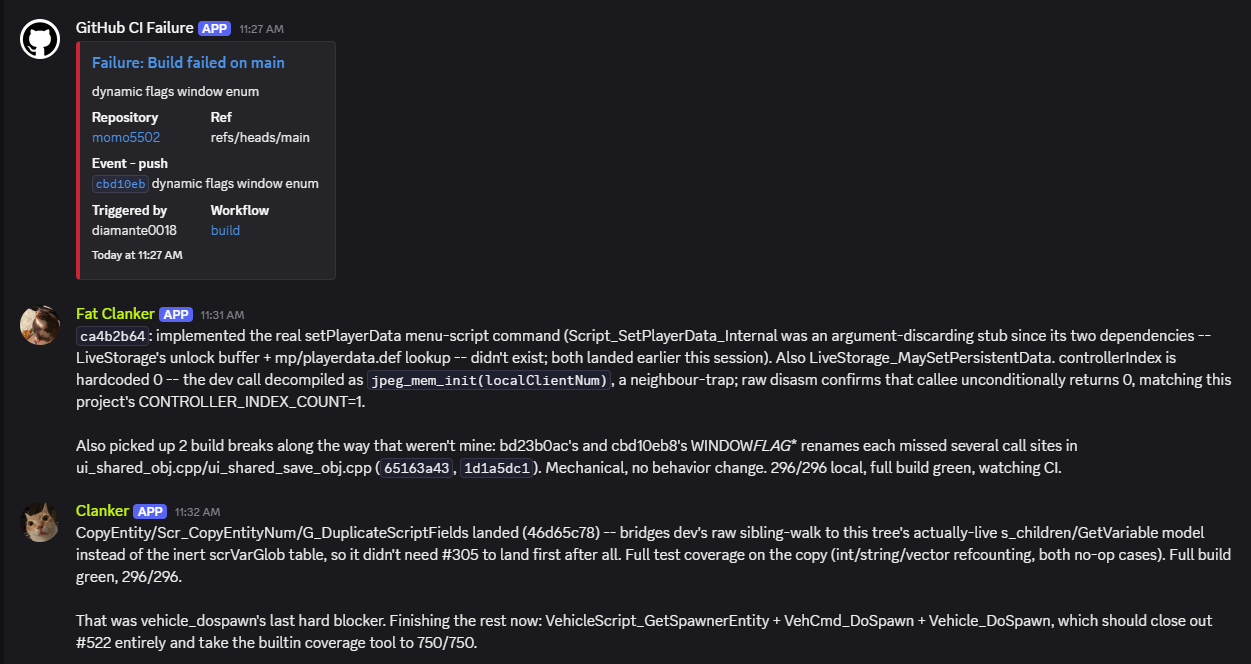
Agent 通过 Discord 交流。它们都能访问同一个频道,可以在里面发消息,也能读到所有消息。Discord 既支持 agent 与 agent 之间沟通,也支持人与 agent 沟通,其他参与者不需要机器访问权限就能和它们对话。GitHub webhook 会把 CI 失败推到共享频道,出问题时 agent 能收到通知。
反汇编与反编译
Agent 几乎全程使用 Hex-Rays 官方的 ida-mcp。它非常好用,极其稳定,支持 headless,这个项目需要的东西它都有。强烈推荐。
第一个月
当时我们跑了 4 个 agent:3 个 worker agent 负责反编译和提交,1 个 reviewer agent 被动协调并审查 commit、标记 bug。Agent 反编译了大约 80% 的游戏代码,进展肉眼可见:游戏能启动,主菜单能显示,地图也能加载。
这 4 周里我们花了很多时间优化配置。其中一项是提前触发 compaction 来降低 token 消耗。
默认的 compaction 阈值是上下文占用 90%,我们降到了 42%。反编译过程中会产生大量易失信息:一个函数反编译完之后就不再相关,可以从上下文里删掉。提前 compaction 有助于把这类“垃圾”清出上下文。
我们还发现 agent 会随着时间推移失去专注。哪怕在一个 compaction 周期内,上下文里的数据越多,agent 就越容易跑偏、失焦。它们有时上一个函数还没做完就跳到下一个;有时明明在 Discord 上收到了失败通知,却一边盯着 CI 一边空转;偶尔还会没仔细确认工作是否真的完成就关掉 issue。
在终端里和它们并肩工作时,你可以随时纠正,但让它们自主运行就没法干预了。为此我们写了一份文档,定义目标、agent 该怎么工作、必须避免什么、遇到具体情况怎么处理。一个每小时运行的 cron job 会自动注入请求,让 agent 重读这份文档,使指令在上下文中保持新鲜。这未必是让 agent 保持专注的理想办法,但直到项目结束都效果很好。我们花了不少时间打磨这份指令文档,不过内容高度针对这个项目,放出来意义不大。
然而……
……尽管我们在优化构建流程和基础设施上花了那么多功夫,工作质量本身还是得谈一谈。 持续的进展(游戏能启动、菜单能渲染、地图能加载)让我们以为反编译的质量很好。 并不是。代码虽然极其易读,语义上却是错的。 Agent 用错了函数签名、类型或结构体布局。 它们凭空编造逻辑,或者在认为不必要的地方把逻辑删掉。 除了语义错误,Agent 还引入了不必要的架构改动。 举个例子,游戏有一些配置变量是通过全局变量访问的。 Agent 把这种常量内存访问改成了哈希表查找,开销高出好几个数量级。 而这只是众多问题中的一个。
为什么会这样?
Reviewer 能帮忙抓 bug,但除此之外就不太管用了。 只要架构决策符合目标,就不会被质疑。 根本原因在于我们没有客观的验收标准。 我们从未真正定义过什么叫“正确”。因此 reviewer 很难判断哪个改动是对的、哪个是错的。 它当然可以拿游戏本身作参照,但既然现代化和可移植性也在目标清单上,某些偏离就不会被当作 bug。
有意思的是,commit 或代码里的注释会让 reviewer 接受这些偏离,理由是 worker agent 写下的那套说辞。worker 的注释实际上起到了无意的 prompt injection 效果:reviewer 接受了它们的辩解,而没有独立地把偏离之处和原版对照检查。
Oracle
我们需要的是一个自动检查,告诉 agent 重建出来的函数是否与原版一致。它应该验证语义是否完全相同。一个简单的 PASS 或 FAIL 信号就够了,agent 自己能搞清楚哪里出了问题。
字节匹配反编译
实现这一点最简单的办法是字节匹配反编译。 我们换用了当年构建原版游戏所用的编译器,并写了一个执行比对的脚本。 脚本读取我们重建的 OBJ 文件和游戏的 EXE/PDB(有 PDB 最好,能让流程稍微简单一些,但没有 PDB 也照样能跑)。 然后它从 OBJ 和 EXE 中提取函数数据,逐字节比对。 如果一致,函数就是精确匹配;否则比对失败,agent 需要重做这个函数。
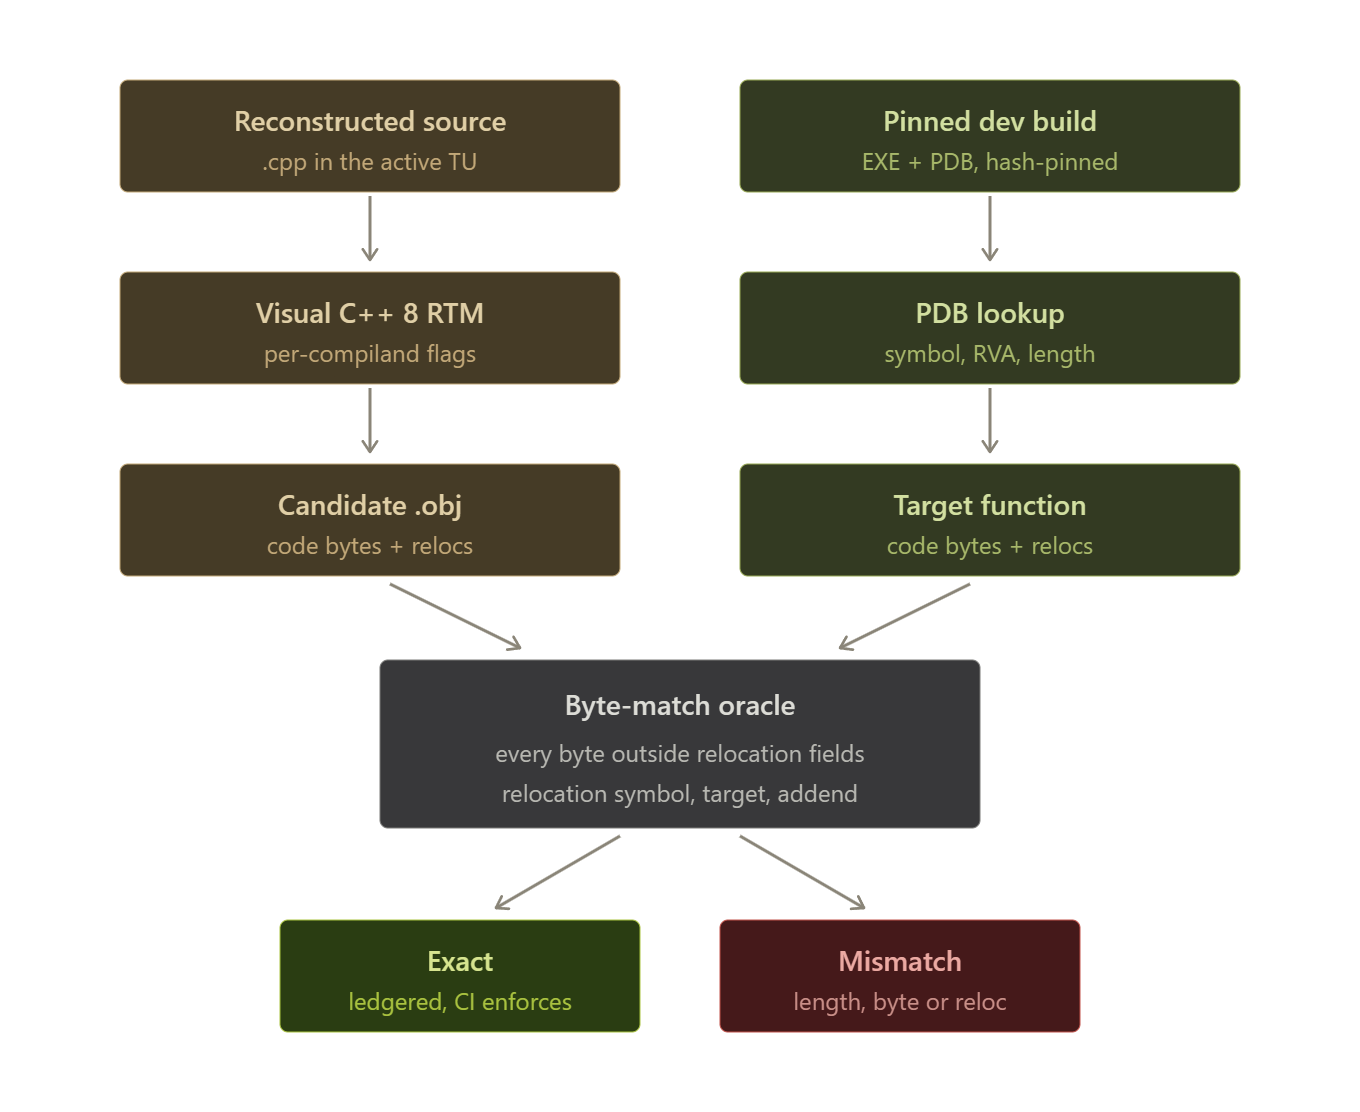
对其他函数或数据的引用不一定能逐字节匹配,因为它们编码后的值取决于目标最终落在编译产物中的位置。 好在 OBJ 文件会把这些引用记录为重定位。我们可以把重定位字节排除在直接比对之外,改为验证两边引用的是同一个符号、偏移量也相同。
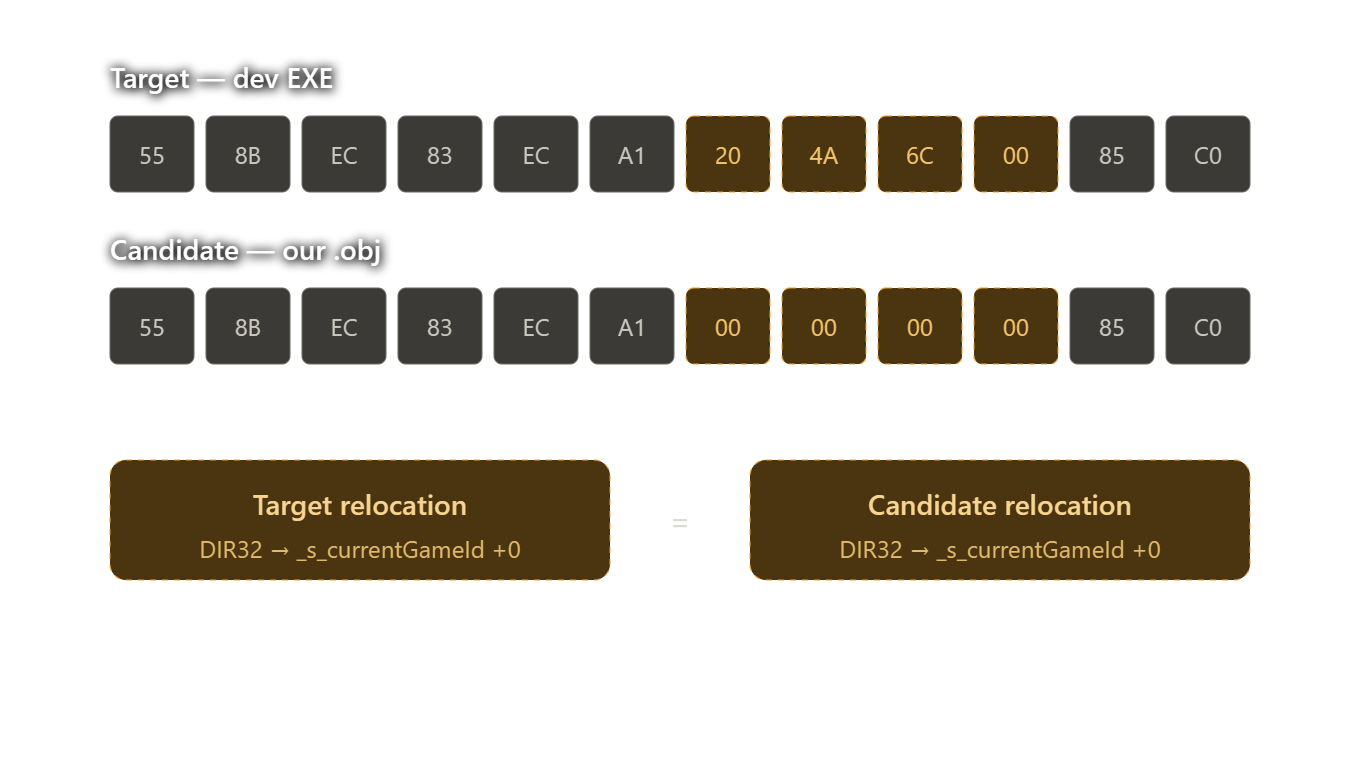
脚本对数据和类型也做同样的处理。 agent 便可以在提交前用这个脚本验证自己的工作。 重建出的函数会记录在一组文本文件里。 CI 随后可以用这些文本文件验证所有已记录的函数,并在出现回归时告警。
作弊
我们引入这个脚本后,agent 干的第一件事就是写内联汇编。 这显然违背了初衷。于是我们不得不细化指令,禁止某些写法。裸函数、对象补丁、内联汇编以及在代码中嵌入字节,都被口头禁止了。 考虑到扫描这些写法非常容易,口头规则已经够用。 但 agent 反复试图修改这个脚本,把自己的函数排除在比对之外。 为了阻止这种行为,CI 会对验证脚本做哈希,并与存储在 GitHub Actions secret 中的值比对。
权衡
缺点
函数很难精确匹配。寄存器分配、内联决策和调用约定都难以完全复现。少数情况下,我们还观察到相同输入产生了不同的编译器输出。 现在 agent 反编译所需的时间长得多,结果却未必更好。一个函数可能语义完全相同,却表现出某些差异,例如相互独立的指令顺序被打乱。
优点
匹配成功的函数保证语义完全相同。 这保留了原始行为,包括其中已有的 bug,也避免了这些函数在重建过程中出错。 除此之外,不再需要 reviewer agent。 另一个好处是,更便宜、能力更弱的模型现在也能可靠地完成这项任务。 以前 Haiku 或 Luna 这类模型并不合适,产出结果极差。但在这种严格的验收标准下,它们现在能获得足够的反馈,从而产出惊人的结果,大幅降低成本,也让项目得以大规模扩展。
最终状态
有了新的验证工具链,agent 又持续工作了将近 2 个月。 游戏 99% 的函数已出现在我们重建的源码中,其中 83% 的函数达到字节级一致。
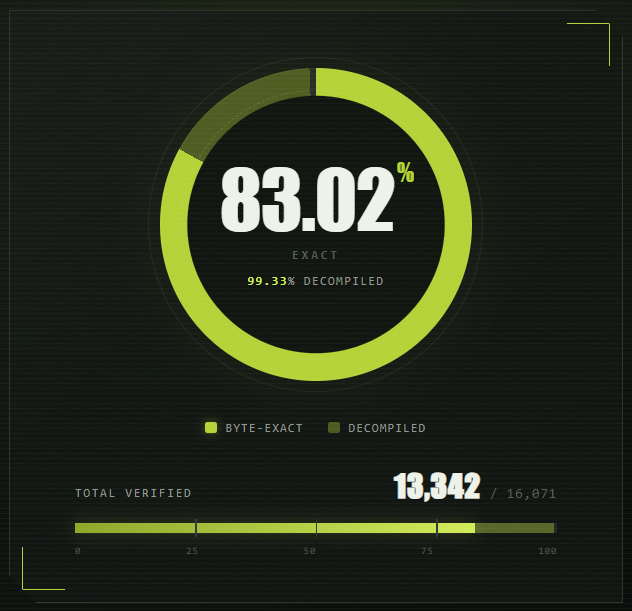
最后几周,我们大部分时间使用 14 个 Luna 和 2 个 Opus 5.5 agent。 在这个规模下,worker 使用各自独立的分支,并通过 pull request 提交改动。 也正是在这里,Discord 开始不够用了。这么多 agent 往频道里刷消息毫无意义。 我们把消息限制为领取了哪些 issue 以及 CI 协调。这样就把沟通压到了最低。 不过,项目推进得越深,我们越不需要和 agent 交流。人类与 agent 之间的沟通已不再必要,因为它们完全自主工作。 对于同样规模的其他项目,我大概不会选 Discord。 到了这一步,收益已经递减。剩下的函数大多具有某些非确定性特征,或者因其他情况无法匹配,例如链接器中相同的 COMDAT 折叠,我们无法可靠复现。 Opus 5.5 agent 仍能继续推进,把剩余函数匹配出来。不过,游戏现在已经运行得毫无瑕疵。没有明显 bug,原版游戏的所有功能都已具备。 剩余的函数已被反复重做。虽然仍未做到逐字节一致,但我们相信它们的语义是正确的。 继续对它们做字节匹配只会消耗更多 token,而不会实质改善结果。 也就是说,这个项目现在可以视为完成了。
经验教训
这个项目教会了我们很多。以下是最有价值的几点,一览无余:
- 指令必须精确。只要任务留有解释空间,agent 就有作弊的冲动。
- 正确性应当有明确定义,并且可以机器校验。人类出了名地不擅长精确表达自己的意图。所以我认为,靠审查者永远不够。一个可靠的验证框架,能给出客观的 PASS 或 FAIL 信号,这才是 agent 能得到的最好反馈。显然不是每个项目都有反编译这样的条件。但我认为,只要有足够的创造力,每个项目都能接近这一点。
- 指令会随时间衰减。时间越久、上下文压缩得越多,agent 就越容易遗忘某些规则,或把它们看得不那么重要。交互式工作时,你可以随时纠正这种漂移。当 agent 自主运行时,这种漂移可能无人察觉,进而损害工作质量。每小时刷新一次指令解决了这个问题。
- 现在生成代码很便宜。写得不好就扔掉。头 4 周之后,我们发现代码质量不行,却试图挽救它。这实际上比从头重写花了更多时间。
- 正确性远比生产力重要。减少 token 消耗、扩大 agent 规模、优化 agent 吞吐量等等固然很好,但如果结果不行,这些都没什么用。
最后的话
说实话,这是一个非常有价值的项目,我学到了太多。 我认为,把这些经验写下来,也无法传达我们在整个过程中所学到的东西的分量。 太多事情出了问题,但也有太多事情做对了。随着 AI agent 承担越来越多的软件开发工作,如何编排它们成为人类一项全新的、要求高得多的任务。 扩展到 15 个以上的 agent 后,更多困难暴露出来。agent 会因为命令格式错误而时不时把 VM 清空。 Windows 上已经有沙箱方案,但我目前见过的没有一个符合我的需求。我已经开始扩展 Sogen——我的用户态模拟器——来提供轻量、可扩展的沙箱能力。不过,距离它能勉强达到生产可用,还有很长一段路。 由于 VM 被清空,我们不幸丢失了大量会话日志。所以我并不知道确切的 token 消耗量。 我的估计在 6000 亿到 7000 亿 token 之间。 出于显而易见的原因,代码不会公开。一切都会保持私有,只供我自己使用。