JavaScript フレームワークの AI コスト
同じポケモンアプリを 12 のフレームワークでエージェントに 5 回ずつ書かせたところ、Hono+htmx が最も安く、Angular が最も高くついた。コード量は 7 割の差、Lighthouse のスコアはほぼ同じ。
日本語
コピー
Web開発コミュニティに対して、僕がずっと不満に思っていることがある。僕たちが下す決定の多くが、勘に頼っているということだ。フレームワークは「爆速」で、ツールは開発を「超強化」し、正しい抽象化を選べば開発者にもユーザーにもいいことずくめ(DXとUXの一石二鳥!)。こうした触れ込みには、たいてい何の根拠もない。Alex Russellはこの現象を「フロントエンドの失われた10年」と呼び、Baldur Bjarnasonはプログラミングを一種のポップカルチャーと呼んだ。僕もこの風潮に事実とベンチマークで対抗してきた(少なくとも調子のいいときは)。
長いあいだ、コミュニティの証拠アレルギーはより高いDXへの渇望に由来するように見えた。つまり、開発者はReactでJSXを打ち込むあの感覚が好きなだけで、Reactや関連ツールを擁護する言説(「仮想DOMは速い!」)は、最初の直感を正当化するための後付けの理屈であることが多かった。(Jonathan Haidtもこの判断に同意するだろう。)
ところがagentの時代になり、開発者は自分でコードを打たなくなり、DXの制約も薄れたのに、それでも勘がすべてを支配しているように見える(しかも「vibe-coding」的な意味だけでなく)。フロントエンドが書き直される理由は、あるフレームワークが「agentにとってより扱いやすい」から。(agent自身に聞いてみた人はいるのだろうか?)書き直されたコードは「より速く」、agentの「ミスも少ない」、などなど。こうした主張にも、やはり根拠がないことが多い。この手の語りを読むたびに思う。「ベンチマークはどこだ?」
興味が湧いたので、ベンチマークを書いてみた。構造はシンプルだ。
- PokéAPIを使って、小さくても単純ではないポケモンアプリを設計する(僕の仕事を追いかけている人なら驚かないだろう)
- agentに、特定のJavaScriptフレームワーク/メタフレームワーク(Next.js、Nuxt、SvelteKitなど)でこのアプリを構築するよう指示する
- 仕様適合テストのスイートで成果物を検証する(agentのズルを防ぐため)
- 開発時間、消費トークン数、コード行数、そしてLighthouseのパフォーマンススコアとアクセシビリティスコアという観点で結果を評価する
アプリはかなりシンプルだ。ポケモンの一覧があり、それぞれのタイプ、技、各ゲームからのデータが含まれている。検索やフィルタリングもできる。
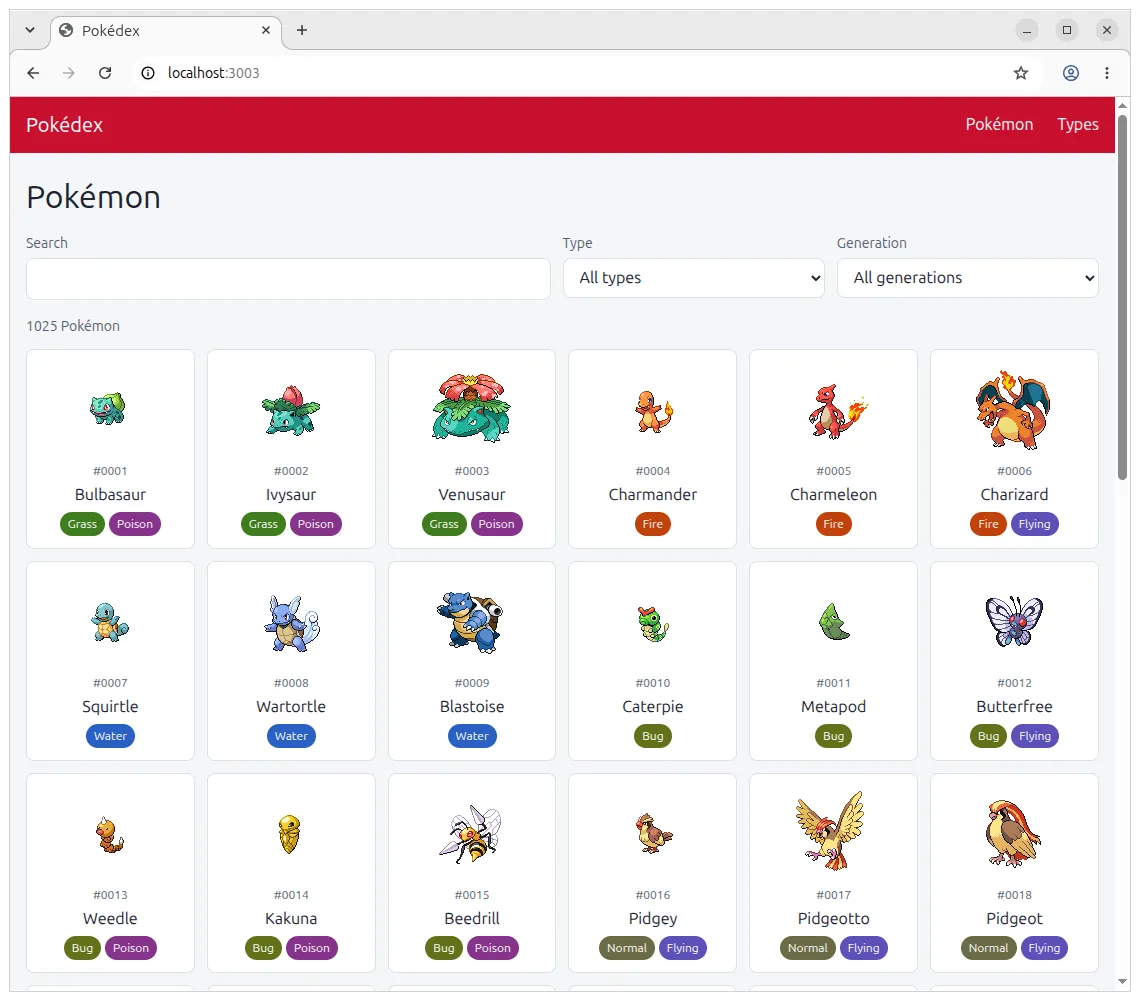
いくつか前提を先に書いておく。これは完璧な実験ではない。このアプリはひとつのholotypeにすぎず、内容寄りでインタラクションが少なく、FigmaやGMailというよりWikipediaに近い。とはいえ、何かアプリを選んで作る必要はあるし、少なくともこのアプリは高レベルでは理解しやすく、仕様とテストを書くのも比較的素直だった。
出発点をなるべく揃えるため、各フレームワーク/メタフレームワークにはそのツール公式のMCPまたはskillsを使わせた。「このフレームワークは学習データでの代表性が低いので、自作のMCPを用意したから使ってほしい」といった言い訳はしたくない。特定のアーキテクチャ(SSRかCSRかなど)を過度に指定することも、アプリの性能を可能な限り高めるよう要求することもしていない。仕様をOpus 5.5に渡し、high effortで、指定フレームワークの最新バージョンを使わせただけだ。各agentはサンドボックス内で動作し、Lighthouseで性能とアクセシビリティを測られることは事前に知らされていない。ただし適合性テストスイートは渡してある。
加えて、CSSの方法論は一切指定していない。Tailwind、Bootstrap、その他のコンポーネントフレームワークを使わないこと、視覚的な一貫性を保つために仕様トークンのセットに基づいてデザインすることだけを求めた。CSSの腕比べにしたくなかったからで、焦点はJSフレームワーク、CSRとSSR、SPAとMPAといった点にある。最終的なアプリは適合性テストを通すが、このテストは生のDOMではなくアクセシビリティツリーに基づいている。特定のHTML構造を規定せずに済むからだ。あるフレームワークはshadow DOMに依存するweb componentsを使っていたので、なおさらこの方式が必要だった。
この実験で学んだことのひとつは、測っているものすべてが極めてランダムだということだ。LLMはランダムな単語生成器で、低い目が出るとagentは妙な方向へ逸れてトークンを浪費する。これはフレームワークのせいでもツールのせいでもない。Lighthouse自体も一貫しない結果を返す。Largest Contentful Paint(LCP)が、あるときはある画像を「最大」要素と判定し、次には別の画像を選ぶ。完全に公平な実験は難しいが、複数回走らせると確かに助けになる。このばらつきについてはできるだけ正直に書いておく。
前置きはこれくらいにして、結果を見よう。
結果
構築コスト、品質、保守性の観点で分解する。各フレームワーク/メタフレームワークについて、5回の実行の中央値を取った。つまり同じアプリを同じフレームワークで5回作ったということだ。(そう、今どきコーディングagentを使えばこんな無茶もできる。)
Angularは例外で、2回は計測可能なアプリを作れなかったため、一部の指標は3回分の反復しかない。(理由は後述する。)
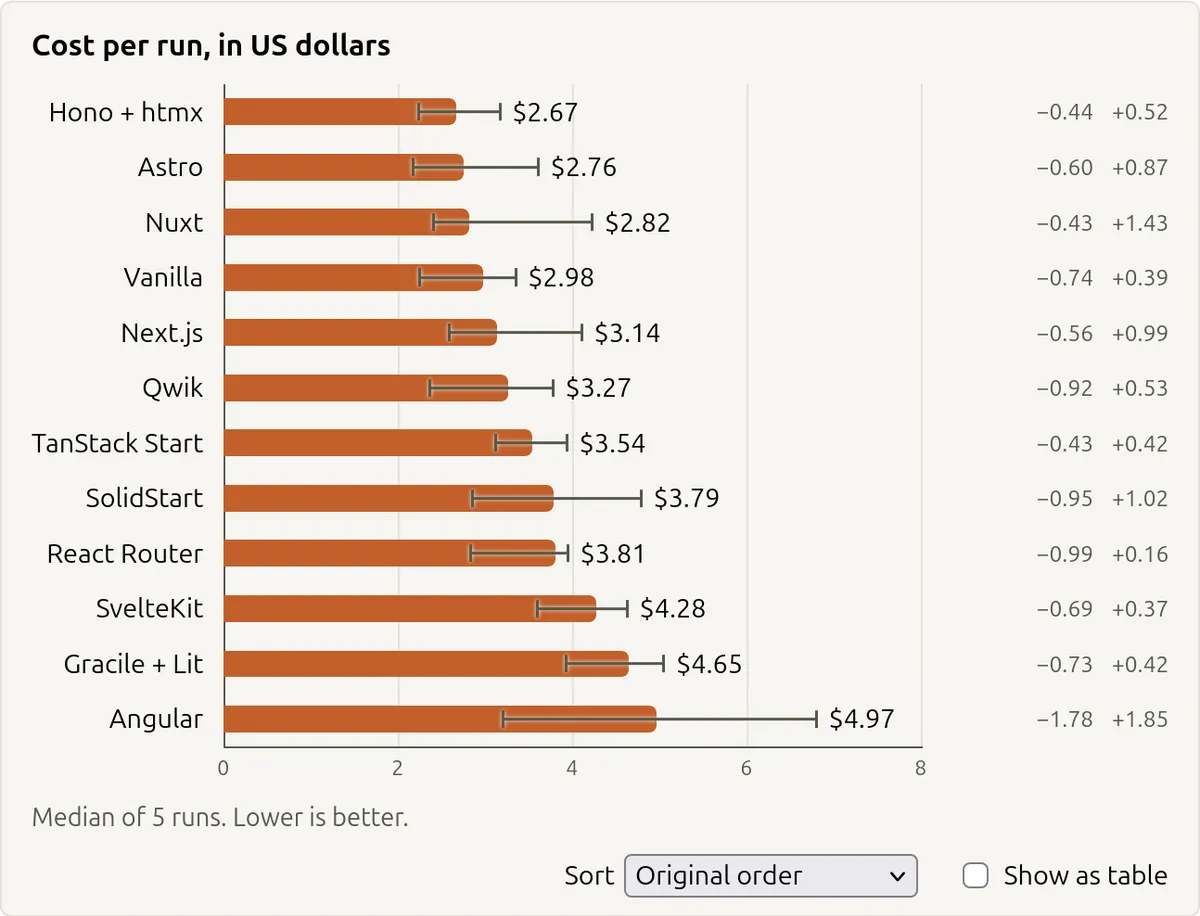
コスト
| フレームワーク | コスト(米ドル) |
|---|---|
| Hono+htmx | $2.67 (2.23–3.19) |
| Astro | $2.76 (2.16–3.63) |
| Nuxt | $2.82 (2.39–4.25) |
| Vanilla | $2.98 (2.24–3.37) |
| Next.js | $3.14 (2.58–4.13) |
| Qwik | $3.27 (2.35–3.80) |
| TanStack Start | $3.54 (3.11–3.96) |
| SolidStart | $3.79 (2.84–4.81) |
| React Router | $3.81 (2.82–3.97) |
| SvelteKit | $4.28 (3.59–4.65) |
| Gracile+Lit | $4.65 (3.92–5.07) |
| Angular | $4.97 (3.19–6.82) |
1回の実行あたりのコスト(米ドル)。5回の実行の中央値。
ここに挙げたのはClaude Codeが直接示すAPI価格であり、実際に私が支払った金額ではない。Maxプランを使っているので、これらは月額$100の枠の一部にすぎない。
ばらつきにも注意してほしい。React Router の中央値は Hono+htmx より約 2.82)は、それでも Hono+htmx で最も高かった実行($3.19)より安い。とはいえ、いくつか確かな傾向は見えてきた。
最も明らかなのは、SvelteKit、Gracile+Lit、Angularの構築コストが他より高いことだ。SvelteKitは、agentが毎回SvelteKit v3移行ガイドを読んでいたのが原因だろう。おそらく新しすぎてOpus 5.5の学習データに入っていないためだ。Gracileも同様で、agentはこのフレームワークに詳しくなく、Gracileのリポジトリをcloneするか、node_modulesからコンパイル済みソースを読んでいた。Angularはコード量そのものが原因のようだ(後述)。
付け加えると、すべてのagentがMCP/skill/Claude Codeプラグインを使ったわけではなく、すべてのフレームワークに対応するプラグインがあるわけでもない。
AI ツールの使用状況
| フレームワーク | インストール済み | Agentは使ったか? |
|---|---|---|
| Angular | Angular MCP と Angular agent skills | 5回中3回がMCPを使用、5回中4回がskillツールを使用、5回中2回がskillファイルを読んだ |
| Astro | Astro MCP server | 5回中2回がMCPを使用 |
| Gracile+Lit | 該当なし | 該当なし |
| Hono+htmx | Hono skills | 5回すべてがskillツールを使用 |
| Next.js | next-devtools-mcp と next-dev-loop skill | 5回中1回がskillファイルを読み、5回中2回がAGENTS.mdを使用 |
| Nuxt | Nuxt MCP | 該当なし |
| Qwik | 該当なし | 該当なし |
| React Router | React Router skill | 5回すべてがskillツールを使用、5回すべてがskillファイルを読んだ |
| SolidStart | 該当なし | 該当なし |
| SvelteKit | Svelte Claude Code plugin | 5回すべてがMCPを使用 |
| TanStack Start | 該当なし | 5回中2回がskillファイルを読んだ |
| Vanilla | 該当なし | 該当なし |
TanStack Start を例に挙げると、agent が skill ファイル(プロジェクトの node_modules と一緒に配布される)を見つけたのは 5 回の実行のうち 2 回だけだった。Nuxt の MCP は agent に一度も使われなかった。Next.js では、agent が skill ファイルを読んだのは 5 回のうち 1 回、AGENTS.md を使ったのは 5 回のうち 2 回だった。結果のばらつきがこれほど大きいとなると、話は LLM のランダム性に戻ってくる。それでもこの実験は有効だと考えている。全大文字で agent に怒鳴りつけて MCP を使わせるような vibe-coder がどれだけいるか、想像がつかないからだ(そもそもインストールすらしていない人も多そうだ)。
なぜ Hono+htmx を選んだのか気になる人のために補足すると、htmx に代表を出してほしかったのが主な理由で、Hono はその相手として良さそうに見えた(Rails や Django などの JavaScript 版という位置づけだ)。Gracile+Lit のほうは、web components の代表として web components の定番フレームワーク(Lit)を使いたかったのだが、私が知るメタフレームワークは Gracile しかない。もっと適した候補があれば、今後の実験にぜひ使いたい。
「Vanilla」については、agent が「vanilla JavaScript または TypeScript と Vite を使い、UI フレームワークは使わない」よう指示されていたことを書いておく。意外なことに、その成績はいくつかのフレームワークを下回った。何らかのフレームワークがあったほうがマシだということらしい(少なくとも、素の Vite よりは)。Vite を選んだのは、多くのフレームワークの土台になっていて、標準的で汎用的な JavaScript 基盤を代表しているからだ。
総所要時間と token 使用量・コストはほぼ一致している。
| フレームワーク | 時間(分) |
|---|---|
| Astro | 8.2 分(6.2–9.7) |
| Hono+htmx | 8.6 分(5.9–9.6) |
| Nuxt | 9.0 分(8.0–17.6) |
| Vanilla | 10.1 分(6.9–18.6) |
| TanStack Start | 10.3 分(8.3–13.9) |
| Qwik | 10.7 分(7.1–12.9) |
| SvelteKit | 10.8 分(8.6–13.8) |
| Next.js | 10.9 分(8.3–11.9) |
| SolidStart | 11.2 分(8.2–15.9) |
| Gracile+Lit | 12.1 分(10.8–12.9) |
| React Router | 12.5 分(8.4–13.6) |
| Angular | 17.2 分(9.8–23.7) |
1 回の実行あたりの所要時間。agent から見た実時間(wall-clock)で、5 回の実行の中央値。
| フレームワーク | Token(百万) |
|---|---|
| Nuxt | 3.85 M(3.16–8.18) |
| Astro | 4.13 M(3.03–7.57) |
| Hono+htmx | 4.26 M(3.40–5.61) |
| Next.js | 4.99 M(3.54–8.82) |
| Vanilla | 5.00 M(3.44–6.32) |
| Qwik | 5.64 M(3.41–7.03) |
| TanStack Start | 7.07 M(5.85–7.99) |
| SolidStart | 7.13 M(5.02–10.07) |
| React Router | 7.58 M(4.55–8.18) |
| SvelteKit | 8.53 M(6.79–9.29) |
| Gracile+Lit | 9.04 M(7.36–11.10) |
| Angular | 9.76 M(4.92–14.94) |
1 回の実行あたりの token 数(百万単位)。キャッシュ読み取り、非キャッシュ入力、出力を含む。5 回の実行の中央値。
ちなみに、token の数値は Claude Code が報告したもので、時間のほうは単純に総実時間だ。
品質
もちろん肝心なのは結果だと思っているので、Lighthouse で agent の成果物も測定した。ソフトウェア開発者としては、安く作れることだけでなく、性能とアクセシビリティも良いことが重要だと考える。
まず、このベンチマークの前提を 2 つ挙げておく。
- このポケモンアプリは小規模で、大規模で複雑な実アプリを代表するものではない。
- Lighthouse と Core Web Vitals の体系はそもそも SPA に不利なので、MPA 系フレームワークは Total Blocking Time(TBT)や JavaScript のバイト数といった指標でほぼ確実に勝つ。アプリ内の性能指標もいくつか加えることを検討したが、やめた。ベンチマークの複雑さとばらつきが増すうえ、その指標は業界標準ではなく私が勝手に考えたものだからだ。
簡潔にするため、ここではトップページのスコアだけを報告する。他のページにもデータはあるが、スコアはほぼ同じか、LCP のように変動が大きい指標だと話がややこしくなるだけなので載せていない。
要するに、Performance、Accessibility、CLS(Cumulative Layout Shift)の Lighthouse スコアはほぼ満点で、フレームワークによる差はほとんどない。
| フレームワーク | CLS | Performance | Accessibility |
|---|---|---|---|
| Angular | 0.000 | 98 | 100 |
| Astro | 0.000 | 100 | 100 |
| Gracile+Lit | 0.000 | 100 | 100 |
| Hono+htmx | 0.000 | 100 | 100 |
| Next.js | 0.000 | 99 | 100 |
| Nuxt | 0.000 | 100 | 100 |
| Qwik | 0.000 | 100 | 100 |
| React Router | 0.000 | 100 | 100 |
| SolidStart | 0.000 | 100 | 100 |
| SvelteKit | 0.000 | 100 | 100 |
| TanStack Start | 0.000 | 99 | 100 |
| Vanilla | 0.111 | 97 | 100 |
より興味深い数字を見たいなら、別の指標を見る必要がある。最も信頼できるのは転送される JavaScript のバイト数で、これはクライアント側フレームワークのサイズをほぼそのまま反映している。
| フレームワーク | JS (KiB) |
|---|---|
| Astro | 0 KiB (0–1) |
| Vanilla | 7 KiB (6–7) |
| Gracile+Lit | 8 KiB (1–13) |
| Hono+htmx | 18 KiB (18–18) |
| SvelteKit | 36 KiB (35–36) |
| SolidStart | 40 KiB (38–40) |
| Qwik | 40 KiB (40–41) |
| Nuxt | 84 KiB (83–85) |
| Angular | 93 KiB (81–102) |
| React Router | 115 KiB (115–119) |
| TanStack Start | 118 KiB (112–119) |
| Next.js | 142 KiB (136–143) |
転送された JavaScript のバイト数。Lighthouse による計測。5 つのアプリの中央値(Angular は 3 つ)。
Total Blocking Time(TBT)が面白いのは、JavaScript のバイト数だけでは決まらない点だ。他のアプリよりメインスレッドに時間をかけているものもある。とはいえ、どの数字も小さい。
| フレームワーク | TBT (ms) |
|---|---|
| Astro | 0 ms (0–0) |
| Gracile+Lit | 0 ms (0–0) |
| Hono+htmx | 0 ms (0–0) |
| SvelteKit | 0 ms (0–1) |
| Vanilla | 0 ms (0–0) |
| TanStack Start | 1 ms (0–36) |
| Qwik | 3 ms (0–30) |
| SolidStart | 11 ms (0–12) |
| React Router | 17 ms (0–52) |
| Nuxt | 40 ms (14–54) |
| Next.js | 71 ms (66–121) |
| Angular | 103 ms (93–123) |
Total Blocking Time(TBT)。データは Lighthouse による、モバイル回線の低速化をシミュレートしたもの。各アプリで 5 回の Lighthouse 実行の中央値を取り、さらに 5 つのアプリの中央値を取った(Angular は 3 つ)。
Largest Contentful Paint(LCP)は前述の指標自体が抱える問題の影響を受け、変動が大きい。ただ、予想どおり総じて SPA に不利で MPA に有利に出る。
| フレームワーク | LCP(ms) |
|---|---|
| Astro | 810 ms(792–1662) |
| Gracile+Lit | 956 ms(796–980) |
| Hono+htmx | 978 ms(977–1662) |
| Qwik | 979 ms(954–1278) |
| SvelteKit | 1130 ms(1129–1131) |
| SolidStart | 1204 ms(1203–1278) |
| Vanilla | 1667 ms(764–1676) |
| Nuxt | 1727 ms(1427–1844) |
| React Router | 1729 ms(1729–1770) |
| Angular | 1954 ms(1351–1955) |
| TanStack Start | 2028 ms(1805–2104) |
| Next.js | 2090 ms(1028–2187) |
Largest Contentful Paint(LCP)。データは Lighthouse によるもので、モバイル回線の速度低下をシミュレートしている。各アプリにつき Lighthouse を 5 回実行した中央値、さらに 5 アプリの中央値(Angular は 3 アプリ)。
Next.js の数値のばらつきがこれほど大きいのは、1 つのアプリが画像を遅延読み込みしておらず、残りの4 つのアプリは遅延読み込みしているためだ。Astro と Vanilla にも同様の上下があり、優先度の扱いか LCP 自体の癖によるものと思われる。
とはいえ全体として、この指標は HTML で素早く描画を終える MPA を優遇し、クライアント側の JavaScript の実行が終わるまで描画しない SPA(しかも Pokémon データの取得に、速度制限のかかった往復を何度も挟むことがある)には不利に働く。驚くことではない。ばらつきを除けば、ここでの LCP はほぼ JavaScript バンドルのサイズで決まる。(Qwik は明らかな例外だ。厳密にはクライアントルーティングを使う SPA でありながら、スコアは MPA 系フレームワークの列に並んでいる。)
ただし、各フレームワークがクライアント寄りかサーバー寄りかは一貫しておらず、クライアント側フレームワークを使うかどうかすら定かでないものもある。たとえば Gracile の agent は2 回の実行で Lit をまったく使っていない。「Vanilla」に至っては agent に完全な自由を与えた(Vite を使うことだけを条件とした)が、5 回すべて SPA を構築する道を選んだ。
SSR と CSR のどちらを選ぶかという問題は、ある意味で Angular が苦戦した原因でもある。2 回の実行で、agent が構築した SSR アプリが localhost 以外からのリクエストを拒否した(指示にはアプリがリバースプロキシの背後にデプロイされることが明記されていたにもかかわらず)。これは仕様に従わなかった妥当な失敗だと判断し、失敗したこの 2 回は再実行しないことにした。(影響するのはコード量とパフォーマンス測定のみ。「コスト」の節では Angular の 5 回分すべての結果を報告している。)
保守性
保守性を測る方法はいろいろある(循環的複雑度のような気の利いた指標も含めて)が、単純にいくことにして、実績のあるコードの総行数をそのまま報告する。
| フレームワーク | コード行数 |
|---|---|
| Hono+htmx | 1370 (1264–1489) |
| Nuxt | 1415 (1382–1458) |
| Astro | 1461 (1379–1503) |
| Vanilla | 1492 (1437–1742) |
| Next.js | 1539 (1452–1627) |
| React Router | 1564 (1421–1621) |
| SvelteKit | 1611 (1503–1816) |
| SolidStart | 1630 (1528–1894) |
| TanStack Start | 1697 (1506–1771) |
| Gracile+Lit | 1717 (1412–1748) |
| Qwik | 1744 (1646–1827) |
| Angular | 2009 (2003–2051) |
コード行数。ソースファイル内の空でない行の数。5 アプリの中央値(Angular は 3 アプリ)。
個人的には、これが一番面白い図だと思っている。ある意味でフレームワークの存在意義とは、保守すべきコード量を減らすことにあるからだ。Rich Harris の印象的な言葉を借りれば:
「フレームワークはコードを整理する道具ではなく、思考を整理する道具だ。」 Rich Harris、「Rethinking reactivity」
agent の時代には、この点はさらに的を射る。コード量は最終的にトークン数に響き、将来の変更にも響く。つまりコードベースを長期的に保守する実際のコストに直結する。簡潔さだけが唯一の価値だと言うつもりはないが、Hono+htmx が Angular とほぼ同じことを約 70% のコードで(しかも速く)やってのけるのを見ると、やはり興味深い。
結論
このベンチマークにはまだまだ改善の余地がある。たとえば agent に Service Worker でオフラインキャッシュを実装させる、Pokémon の画像ファイルを最適化させる、遅延読み込みやfetchpriority、Speculation Rules API などを使わせる、といったことができる。こうしたパフォーマンス手法のほとんどは私も知っていたが、典型的な vibe-coder はやらないだろうからと、あえて agent を誘導しなかった。
一方で、このベンチマークはすべての HTML ファイルをあらかじめ生成して静的アセットとして置けば簡単にズルができる(Pokémon の数はたかが知れている)。私は説明文でこの方法を明確に禁じ、テストハーネスに明示的なチェックを入れた。ベンチマークの趣旨に合わないと判断したからだ。(狙いは、動的に変わりうる大量のデータを模すことで、純粋な静的サイトより難しくすることにあった。)
ベンチマークの走らせ方を改善することもできる。たとえば試行回数を増やす、別のコーディング agent に変える、effort レベルを変える、別のフレームワークやフレームワークの別バージョンを使う、MCP/skill ありとなしでそれぞれ試す、Chromium 以外のブラウザでも測る、別種のアプリを構築する、などなど。やらなかったのは主に時間を節約するためだ。とはいえ、このベンチマークを自分で走らせたい人や fork したい人は、コードがGitHub にあるので、自由にいじってほしい。結果をここで報告できれば嬉しい(見つけたバグや欠陥も含めて)。
ここでの目的は、「自分は vibe-coder だが、どのフレームワークを選ぶべきか」という問いに答える究極のベンチマークを書くことではない。伝えたいのは、AI コーディングの時代でも、感覚ではなく証拠に基づいて決断できるということだ。ベンチマーク自体のかなりの部分は vibe-coded で書いている。ただしコードには目を通したので、誤りがあれば責任は自分にある。競合フレームワークがこの仕組みを改良してくれるのを見るのも大歓迎だ。
特定のフレームワークを貶めるつもりもない。ベンチマークを走らせる前は、どれが「勝つ」か分かっていなかった。もっとも、MPA が SPA に勝つだろうという疑いは持っていた(それはこの記事全体で正直に認めている)。SPA 寄りのベンチマークを書くことも当然できる。たとえば複雑なダッシュボードやビデオゲーム、生産性ツールをアプリとして作るとか。指標を変えることもできる。Lighthouse と Core Web Vitals は SPA にかなり厳しいので、アプリ内のインタラクティブ性を測る手もある。
フレームワークの作者自身が、自分のフレームワークや AI ツールを改良してこのベンチマークでより良い成績を出せるはずだとも思っている。たとえば、現状の MCP や skills の一群はむしろ害の方が大きいのではないかと強く疑っている。だから、この記事がこれらのフレームワークの性能に関する最終結論になってしまったら、とても残念だ。この種のベンチマークで頭角を現そうとしている新しいフレームワークもある。
もう一歩引いて言えば、この vibe coding という奇妙な新時代において、JavaScript フレームワークの選択をもう少し吟味するきっかけになればとも思う。本当に証拠に基づいて技術スタックを選んでいるのか。それとも、すでに慣れ親しんだものをただ使い続けているだけなのか。コードを自分で読み、レビューし、デバッグしているなら、それも十分理解できる。しかし、ほぼ手放している状態なら、原始人のように一行ずつコードを打っていた頃の選択に、いったい何の執着があるというのか。ソフトウェアの作り方そのものを見直しているなら、npm install の後に打ち込んだものも見直す価値があるかもしれない。ただの余談だが。
個人的には、上で評価したフレームワークのどれにも執着はない。唯一の信念は、ユーザーにとって可能な限り最高の体験を作るために努力すべきだということだ。これらのフレームワークの作者の多くは知人であり、尊敬しているし、自分が支持するのと同じ価値のために懸命に取り組んでいることも知っている。ただ、コミュニティ全体をより良い方向へ導き、次世代の Web アプリを支える、より良く、より速く、より使いやすいフレームワークが生まれてほしいだけだ。
付録
テストに使用したフレームワークのバージョン(Qwik はテストの途中でパッチバージョンがリリースされている点に注意)。
| フレームワーク | バージョン |
|---|---|
| Angular | @angular/core 22.2.3 |
| Astro | astro 7.4.2 |
| Gracile+Lit | @gracile/gracile 0.11.0, lit 3.3.3 |
| Hono+htmx | hono 4.13.14, htmx.org 2.0.11 |
| Next.js | next 16.4.3, react 19.3.1 |
| Nuxt | nuxt 4.6.2, vue 3.5.44 |
| Qwik | @builder.io/qwik-city 1.20.2(第 1 回),1.20.3(第 2、3、4、5 回),@builder.io/qwik 1.20.2(第 1 回),1.20.3(第 2、3、4、5 回) |
| React Router | react-router 8.5.0, react 19.3.1 |
| SolidStart | @solidjs/start 2.1.0, solid-js 1.9.17 |
| SvelteKit | @sveltejs/kit 3.1.0, svelte 5.57.2 |
| TanStack Start | @tanstack/react-start 1.169.4, react 19.3.1 |
| Vanilla | vite 8.3.5 |