JavaScript 框架的 AI 成本
同一个宝可梦应用,12 个框架各让 agent 写 5 遍,结果 Hono+htmx 最便宜,Angular 最贵,代码量差了七成,Lighthouse 分数却几乎一样。
中文
复制
我对 Web 开发社区的一大不满是,我们做出的许多决定都凭感觉。框架“快得飞起”,工具能给开发“超级充电”,选对抽象层对开发者和用户都有好处(DX 和 UX 一举两得!)。这些吹嘘通常毫无证据。Alex Russell 把这种现象称为“前端失去的十年”,Baldur Bjarnason 把编程称为一种流行文化,而我一直在博客里用事实和基准测试来对抗这股风气(至少在我状态好的时候)。
很长一段时间里,社区对证据的过敏似乎源于对更高 DX 的渴望。换句话说,开发者就是喜欢在 React 里敲 JSX 的那种感觉,而支持 React 或相关工具的说法(“虚拟 DOM 很快!”)多半是事后合理化,用来为最初的直觉找理由。(Jonathan Haidt大概会同意这个判断。)
但到了 agent 时代,开发者不再手敲代码,受 DX 的约束也随之减少,我却看到感觉依然主导一切(而且不只是“vibe-coding”意义上的)。前端被重写,是因为某个框架“对 agent 更友好”。(有人想过问问 agent 自己吗?)重写后的代码“更快”,agent 犯的“错误更少”,诸如此类。这些说法同样往往没有证据。每次读到这类叙述,我都会想:“基准测试在哪?”
我很好奇,于是写了一个基准测试。它的结构很简单。
- 用 PokéAPI 设计一个小巧但不简单的宝可梦应用(关注过我的作品的人不会感到意外)
- 指示 agent 用某个特定的 JavaScript 框架/元框架(比如 Next.js、Nuxt、SvelteKit 等)构建这个应用
- 用一套规范符合性测试来检验产出(防止 agent 作弊)
- 从开发时间、消耗的 token 数、代码行数,以及 Lighthouse 的性能和无障碍评分这几个维度评估结果
这个应用相当简单。你有一份宝可梦列表,包含它们的属性、招式以及来自各款游戏的数据。你可以搜索、筛选等等。
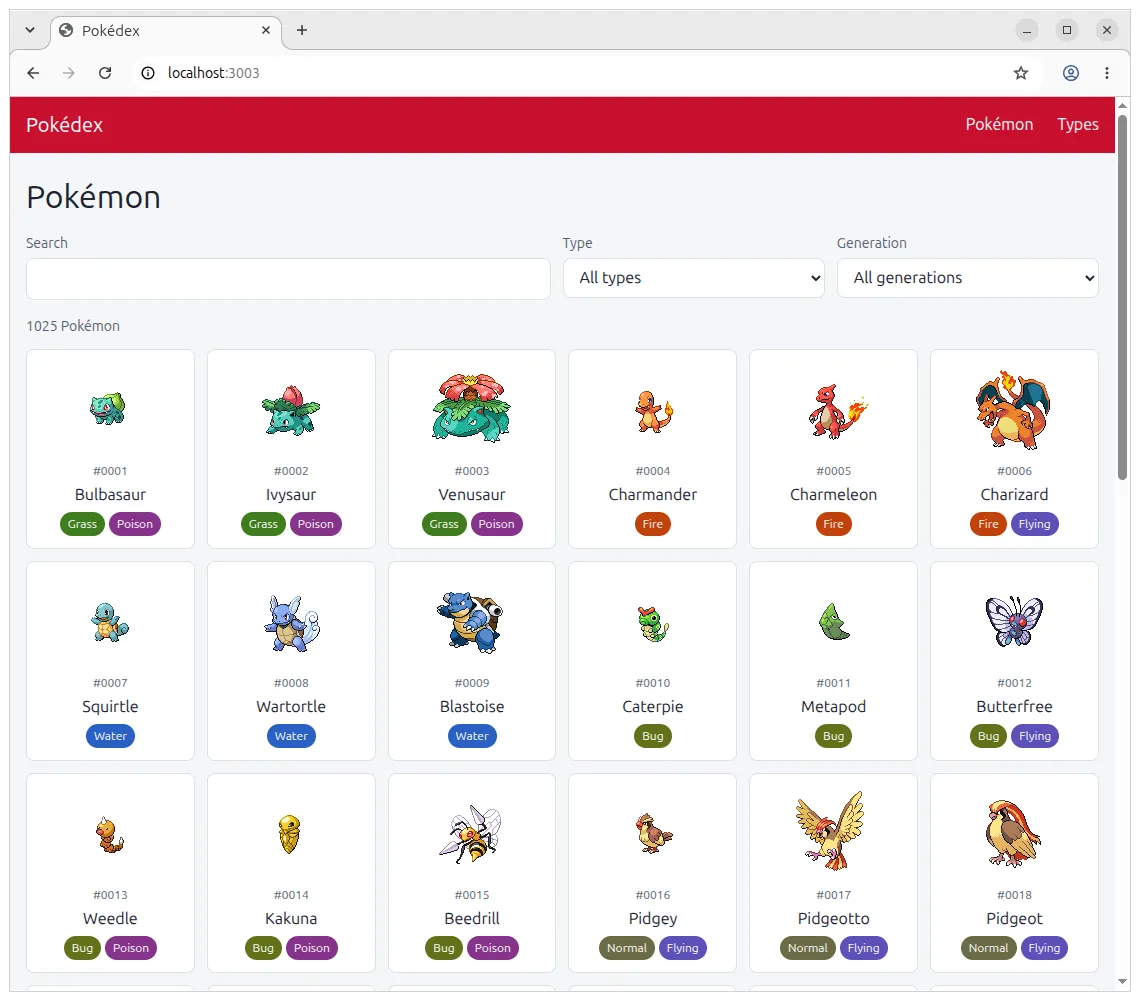
先说明几点前提。这不是一个完美的实验。这个应用只代表一个holotype,它偏内容型,交互很少,更像 Wikipedia,而不是 Figma、GMail 之类。话虽如此,我总得挑某个应用来构建,至少这个应用在高层面上容易理解,写规格和测试也相对直接。
为了尽量拉平起点,我让每个框架/元框架都使用该工具的官方 MCP 或 skills。我不想被人说“这个框架在训练数据里代表性不足,所以我们做了自己的 MCP,希望大家用”之类。我也没有过度指定具体架构(比如 SSR 还是 CSR),也没有要求应用性能尽可能高。我只是把规格交给 Opus 5.5,用 high effort,让它使用指定框架的最新版本。每个 agent 都在沙箱里运行,事先不知道会在 Lighthouse 上测性能和可访问性,不过拿到了符合性测试套件。
另外,我没有规定任何 CSS 方法论,只要求不用 Tailwind、Bootstrap 或其他组件框架,并基于一组规格 token 来设计,以保证视觉上的一致性。我不想让这个测试变成 CSS 的比拼,重点在 JS 框架、CSR 与 SSR、SPA 与 MPA 这些方面。最终的应用跑一套符合性测试,测试基于可访问性树而非原始 DOM,这样就不必规定某种 HTML 结构。有一个框架用了依赖 shadow DOM 的 web components,所以必须这么做。
这个实验让我学到的一点是,我测的每样东西都高度随机。LLM 是随机词生成器,有时掷出的骰子点数低,agent 就跑偏到某个奇怪的方向,浪费一堆 token,这既不是框架的错,也不是它工具的错。Lighthouse 本身也会给出不一致的结果。Largest Contentful Paint(LCP)可能这次认定某张图是“最大”元素,下次又换成另一张。要做到完全公平的实验很难,但多跑几轮确实有帮助,我也尽量如实说明这些波动。
废话少说,直接看结果。
结果
我从构建成本、质量、可维护性这几个维度来拆解。每个框架/元框架我都取了 5 次运行的中位数。也就是说,同一个应用我在同一个框架里构建了 5 遍。(没错,如今用编码 agent 就能干这种离谱的事。)
Angular 是例外,它有两次没能创建出可测量的应用,所以部分指标只取了 3 次迭代。(下面会解释。)
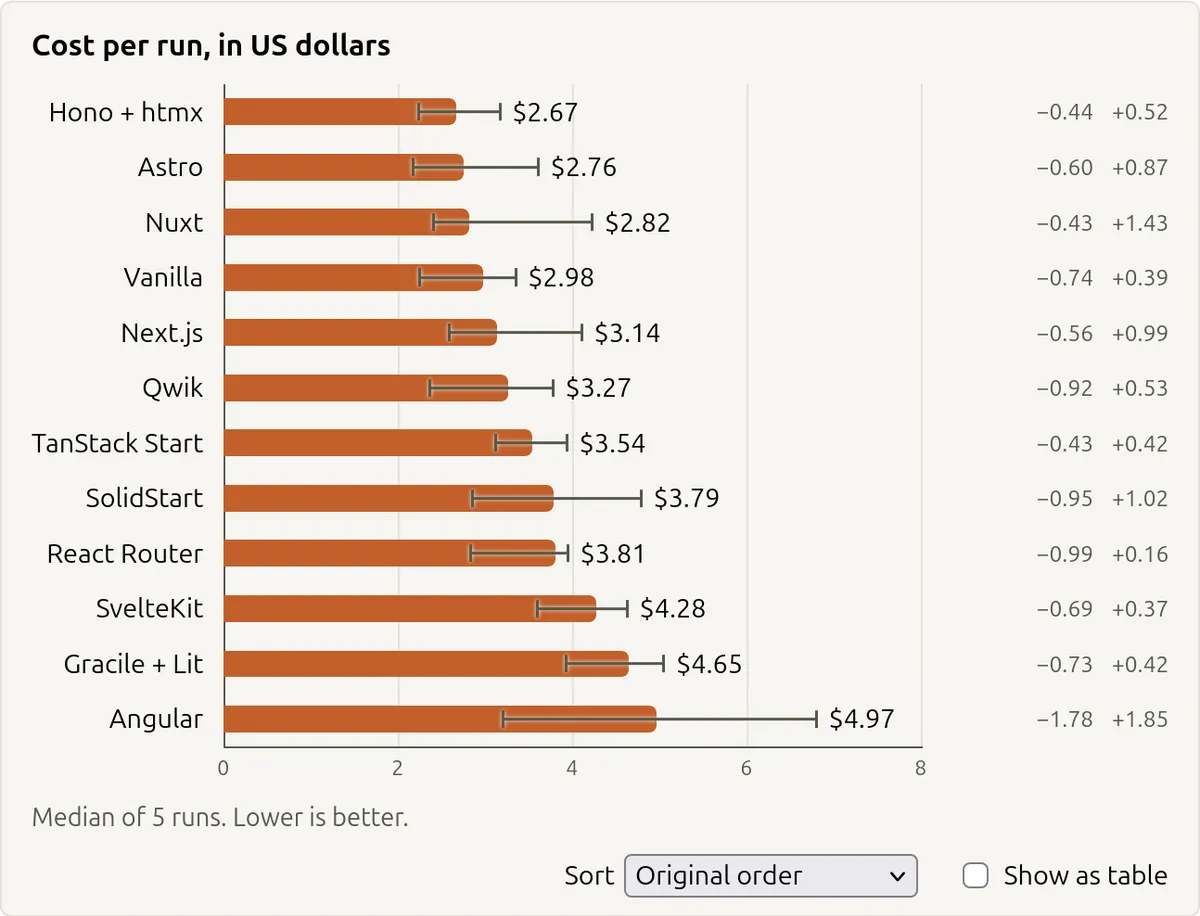
成本
| 框架 | 成本(美元) |
|---|---|
| Hono+htmx | $2.67 (2.23–3.19) |
| Astro | $2.76 (2.16–3.63) |
| Nuxt | $2.82 (2.39–4.25) |
| Vanilla | $2.98 (2.24–3.37) |
| Next.js | $3.14 (2.58–4.13) |
| Qwik | $3.27 (2.35–3.80) |
| TanStack Start | $3.54 (3.11–3.96) |
| SolidStart | $3.79 (2.84–4.81) |
| React Router | $3.81 (2.82–3.97) |
| SvelteKit | $4.28 (3.59–4.65) |
| Gracile+Lit | $4.65 (3.92–5.07) |
| Angular | $4.97 (3.19–6.82) |
单次运行成本,单位美元。取 5 次运行的中位数。
注意,这里引用的是 Claude Code 直接给出的 API 价格,并不代表我实际花了多少钱。我用的是 Max 套餐,这些只是我每月 $100 总额的一部分。
还要注意方差。React Router 的中位数大约比 Hono+htmx 差 2.82)仍然比 Hono+htmx 最贵的一次($3.19)便宜。不过,一些可靠的规律还是浮现了出来。
最明显的是,SvelteKit、Gracile+Lit 和 Angular 的构建成本高于其他框架。SvelteKit 可能是因为 agent 每次运行都会去读 SvelteKit v3 迁移指南,大概是因为它太新了,不在 Opus 5.5 的训练数据里。Gracile 类似,agent 对这个框架不太熟,要么克隆了 Gracile 仓库,要么从 node_modules 读了它的编译后源码。Angular 则似乎是代码总量导致的(见下文)。
还要提一句,并非每个 agent 都用上了 MCP/skill/Claude Code 插件,也不是每个框架都有对应的插件。
AI 工具使用情况
| 框架 | 已安装 | Agent 是否使用? |
|---|---|---|
| Angular | Angular MCP 和 Angular agent skills | 5 次运行中 3 次用了 MCP,5 次运行中 4 次用了 skill 工具,5 次运行中 2 次读取了 skill 文件 |
| Astro | Astro MCP server | 5 次运行中 2 次用了 MCP |
| Gracile+Lit | 不适用 | 不适用 |
| Hono+htmx | Hono skills | 5 次运行全部用了 skill 工具 |
| Next.js | next-devtools-mcp 和 next-dev-loop skill | 5 次运行中 1 次读取了 skill 文件,5 次运行中 2 次用了 AGENTS.md |
| Nuxt | Nuxt MCP | 不适用 |
| Qwik | 不适用 | 不适用 |
| React Router | React Router skill | 5 次运行全部用了 skill 工具,5 次运行全部读取了 skill 文件 |
| SolidStart | 不适用 | 不适用 |
| SvelteKit | Svelte Claude Code plugin | 5 次运行全部用了 MCP |
| TanStack Start | 不适用 | 5 次运行中 2 次读取了 skill 文件 |
| Vanilla | 不适用 | 不适用 |
以 TanStack Start 为例,agent 只在 5 次运行中的 2 次发现了它的 skill 文件(这些文件随项目的 node_modules 一起发布)。Nuxt 的 MCP 则从未被 agent 使用过。Next.js 这边,agent 只在 5 次运行中的 1 次读取了 skill 文件,5 次运行中 2 次用了 AGENTS.md。结果分布如此之广,又回到了 LLM 的随机性上。不过我仍然认为这是个有效的实验,因为我不觉得有多少 vibe-coder 会全大写地冲 agent 吼,逼它去用 MCP(而且很多人可能压根就没装)。
另外,如果你好奇 Hono+htmx 是怎么选出来的,我主要是想让 htmx 有个代表,而 Hono 看起来是个不错的搭配(也就是作为 Rails/Django 等的 JavaScript 替代方案)。至于 Gracile+Lit,我想通过 web components 的标杆框架(Lit)来代表 web components,而我知道的元框架只有 Gracile。如果有更合适的候选,很适合拿来做后续实验。
关于“Vanilla”,需要说明 agent 被要求使用“vanilla JavaScript 或 TypeScript 配合 Vite,不使用 UI 框架”。出乎意料的是,它的表现不如好几个框架,这似乎说明有某个框架总比没有强(或者说,至少比裸用 Vite 强)。选 Vite 是因为它是许多框架的底层,也代表了相当标准和通用的 JavaScript 基础设施。
总耗时和 token 用量与成本基本吻合。
| 框架 | 时间(分钟) |
|---|---|
| Astro | 8.2 分钟(6.2–9.7) |
| Hono+htmx | 8.6 分钟(5.9–9.6) |
| Nuxt | 9.0 分钟(8.0–17.6) |
| Vanilla | 10.1 分钟(6.9–18.6) |
| TanStack Start | 10.3 分钟(8.3–13.9) |
| Qwik | 10.7 分钟(7.1–12.9) |
| SvelteKit | 10.8 分钟(8.6–13.8) |
| Next.js | 10.9 分钟(8.3–11.9) |
| SolidStart | 11.2 分钟(8.2–15.9) |
| Gracile+Lit | 12.1 分钟(10.8–12.9) |
| React Router | 12.5 分钟(8.4–13.6) |
| Angular | 17.2 分钟(9.8–23.7) |
每次运行的耗时。从 agent 视角看的实际耗时(wall-clock),取 5 次运行的中位数。
| 框架 | Token(百万) |
|---|---|
| Nuxt | 3.85 M(3.16–8.18) |
| Astro | 4.13 M(3.03–7.57) |
| Hono+htmx | 4.26 M(3.40–5.61) |
| Next.js | 4.99 M(3.54–8.82) |
| Vanilla | 5.00 M(3.44–6.32) |
| Qwik | 5.64 M(3.41–7.03) |
| TanStack Start | 7.07 M(5.85–7.99) |
| SolidStart | 7.13 M(5.02–10.07) |
| React Router | 7.58 M(4.55–8.18) |
| SvelteKit | 8.53 M(6.79–9.29) |
| Gracile+Lit | 9.04 M(7.36–11.10) |
| Angular | 9.76 M(4.92–14.94) |
每次运行的 token 数,单位为百万。包含缓存读取、未缓存输入和输出。取 5 次运行的中位数。
顺带一提,token 数据由 Claude Code 报告,时长则只是总的实际耗时。
质量
当然,我认为结果才是关键,所以我也用 Lighthouse 测了这些 agent。作为软件开发者,我觉得重要的不只是把东西做得便宜,还要做得性能好、可访问性好。
先说我的基准测试的两个前提。
- 这个宝可梦应用很小,代表不了一个大型、复杂的真实应用。
- Lighthouse 以及整个 Core Web Vitals 体系对 SPA 天然不利,所以 MPA 框架在 Total Blocking Time(TBT)、JavaScript 字节数这类指标上几乎稳赢。我考虑过加一些应用内性能指标,但最终放弃了,因为那会给基准测试增加复杂度和波动,而且那些指标是我自己发明的,不是行业标准。
为简单起见,我只报告首页的分数。其他页面也有数据,但得分都差不多,或者像 LCP 这类指标波动很大,放进来只会让事情变复杂。
简而言之,Performance、Accessibility 和 CLS(Cumulative Layout Shift)的 Lighthouse 分数几乎已经拉满,各框架之间差别不大。
| 框架 | CLS | Performance | Accessibility |
|---|---|---|---|
| Angular | 0.000 | 98 | 100 |
| Astro | 0.000 | 100 | 100 |
| Gracile+Lit | 0.000 | 100 | 100 |
| Hono+htmx | 0.000 | 100 | 100 |
| Next.js | 0.000 | 99 | 100 |
| Nuxt | 0.000 | 100 | 100 |
| Qwik | 0.000 | 100 | 100 |
| React Router | 0.000 | 100 | 100 |
| SolidStart | 0.000 | 100 | 100 |
| SvelteKit | 0.000 | 100 | 100 |
| TanStack Start | 0.000 | 99 | 100 |
| Vanilla | 0.111 | 97 | 100 |
所以要想看到更有意思的数字,得看别的指标。最可靠的是传输的 JavaScript 字节数,它基本反映了客户端框架的体积。
| 框架 | JS (KiB) |
|---|---|
| Astro | 0 KiB (0–1) |
| Vanilla | 7 KiB (6–7) |
| Gracile+Lit | 8 KiB (1–13) |
| Hono+htmx | 18 KiB (18–18) |
| SvelteKit | 36 KiB (35–36) |
| SolidStart | 40 KiB (38–40) |
| Qwik | 40 KiB (40–41) |
| Nuxt | 84 KiB (83–85) |
| Angular | 93 KiB (81–102) |
| React Router | 115 KiB (115–119) |
| TanStack Start | 118 KiB (112–119) |
| Next.js | 142 KiB (136–143) |
传输的 JavaScript 字节数,由 Lighthouse 报告。取 5 个应用的中位数(Angular 为 3 个)。
Total Blocking Time(TBT)有意思的地方在于,它并不单纯取决于 JavaScript 字节数;有些应用在主线程上花的时间比其他应用更多。不过这些数字都很小。
| 框架 | TBT (ms) |
|---|---|
| Astro | 0 ms (0–0) |
| Gracile+Lit | 0 ms (0–0) |
| Hono+htmx | 0 ms (0–0) |
| SvelteKit | 0 ms (0–1) |
| Vanilla | 0 ms (0–0) |
| TanStack Start | 1 ms (0–36) |
| Qwik | 3 ms (0–30) |
| SolidStart | 11 ms (0–12) |
| React Router | 17 ms (0–52) |
| Nuxt | 40 ms (14–54) |
| Next.js | 71 ms (66–121) |
| Angular | 103 ms (93–123) |
总阻塞时间(TBT)。数据来自 Lighthouse,模拟移动端降速。每个应用取 5 次 Lighthouse 运行的中位数,再取 5 个应用的中位数(Angular 为 3 个)。
最大内容绘制(LCP)受前述指标自身问题的影响,波动很大。不过正如预期,它总体上不利于 SPA、有利于 MPA。
| 框架 | LCP(ms) |
|---|---|
| Astro | 810 ms(792–1662) |
| Gracile+Lit | 956 ms(796–980) |
| Hono+htmx | 978 ms(977–1662) |
| Qwik | 979 ms(954–1278) |
| SvelteKit | 1130 ms(1129–1131) |
| SolidStart | 1204 ms(1203–1278) |
| Vanilla | 1667 ms(764–1676) |
| Nuxt | 1727 ms(1427–1844) |
| React Router | 1729 ms(1729–1770) |
| Angular | 1954 ms(1351–1955) |
| TanStack Start | 2028 ms(1805–2104) |
| Next.js | 2090 ms(1028–2187) |
最大内容绘制(LCP)。数据来自 Lighthouse,模拟移动端降速。每个应用取 5 次 Lighthouse 运行的中位数,再取 5 个应用的中位数(Angular 为 3 个)。
注意,Next.js 那组数字波动之所以这么大,是因为其中一个应用没有对图片做懒加载,而另外四个应用做了懒加载。Astro 和 Vanilla 也有类似的起伏,看起来是优先级处理或 LCP 本身的怪癖造成的。
不过总的来说,这个指标倾向于奖励用 HTML 快速完成绘制的 MPA,而不利于等客户端 JavaScript 执行完才绘制的 SPA(后者可能还要经历多次受降速限制的往返来获取宝可梦数据),这并不意外。抛开波动不谈,这里的 LCP 基本取决于 JavaScript 包的体积。(Qwik 是个明显的例外。严格来说它是使用客户端路由的 SPA,但得分却处在 MPA 框架之列。)
不过要注意,各框架在偏向客户端还是服务端上并不一致,有的甚至不确定是否使用客户端框架。例如 Gracile 的 agent 在两次运行中根本没有用到 Lit。至于“Vanilla”,agent 拥有完全的自由(只被要求使用 Vite),但 5 次全都选择了构建 SPA。
SSR 与 CSR 之争,某种程度上也是 Angular 麻烦的来源。有 2 次运行中,agent 构建的 SSR 应用会拒绝非 localhost 的请求(尽管指令中已明确说明应用会部署在反向代理之后)。我认为这属于未遵循规范的合理失败,因此决定不重跑这 2 次失败的迭代。(这只影响代码量和性能测量;在“成本”一节中,我报告了 Angular 全部 5 次迭代的结果。)
可维护性
衡量可维护性的方法很多(包括圈复杂度之类花哨的指标),但我决定从简,直接报告久经检验的代码总行数。
| 框架 | 代码行数 |
|---|---|
| Hono+htmx | 1370 (1264–1489) |
| Nuxt | 1415 (1382–1458) |
| Astro | 1461 (1379–1503) |
| Vanilla | 1492 (1437–1742) |
| Next.js | 1539 (1452–1627) |
| React Router | 1564 (1421–1621) |
| SvelteKit | 1611 (1503–1816) |
| SolidStart | 1630 (1528–1894) |
| TanStack Start | 1697 (1506–1771) |
| Gracile+Lit | 1717 (1412–1748) |
| Qwik | 1744 (1646–1827) |
| Angular | 2009 (2003–2051) |
代码行数。指源文件中非空行的数量。取 5 个应用的中位数(Angular 为 3 个)。
在我看来,这是比较有意思的一张图。某种意义上,框架的全部意义就在于减少你需要维护的代码量。用 Rich Harris 那句令人印象深刻的话说:
“框架不是组织代码的工具,而是组织思维的工具。” Rich Harris,“Rethinking reactivity”
在 agent 时代,这一点更加切中要害。代码量最终会影响 token 数量,未来的修改也不例外,也就是说,它直接影响长期维护一个代码库的实际成本。这并不是说简洁是唯一重要的价值,但看到 Hono+htmx 用大约 70% 的代码就能做到和 Angular 差不多的事(而且还更快),确实很有意思。
结论
这个基准测试还有很多可以改进的地方。比如,你可以要求 agent 用 Service Worker 做离线缓存,或者优化宝可梦图片文件,或者使用懒加载、fetchpriority、Speculation Rules API 等等。这些性能技巧我大多知道,但我刻意没有引导 agent 去用,因为典型的 vibe-coder 不会这么做。
另一方面,这个基准测试完全可以靠预先生成所有 HTML 文件作为静态资源来作弊(Pokémon 也就那么多)。我在说明里明确禁止了这种做法,并在测试框架里加了显式检查,因为我觉得这不符合基准测试的本意。(我的目标是模拟大量可能动态变化的数据,这比纯静态站点更有挑战性。)
你也可以改进我跑基准测试的方式,比如跑更多轮次、换不同的编码 agent、试不同的 effort 等级、用不同的框架或框架的不同版本、分别在有和没有 MCP/skill 的情况下测试、在 Chromium 之外的更多浏览器里测、构建不同类型的应用,等等。我没做这些主要是为了省时间。不过,如果有人想自己跑这个基准测试或者 fork 它,代码在 GitHub 上,欢迎随便折腾。我很乐意在这里汇报你的结果(也包括你可能发现的任何错误或缺陷)。
我在这里的目标不是写出一个终极基准测试来回答“我是 vibe-coder,该选哪个框架?”这篇文章的重点是说明,在 AI 编码时代,仍然可以基于证据而不是感觉来做决定。基准测试本身很大程度上是 vibe-coded 的,不过代码我审过,所以如果有错误,请算在我头上。我也非常乐意看到竞品框架在我这套东西上做出改进。
我也不想抹黑任何特定框架。跑基准测试之前,我并不知道哪个会“赢”,尽管我确实怀疑 MPA 会胜过 SPA(这一点我在全文里都坦然承认了)。你当然可以写一个更偏向 SPA 的基准测试,比如把应用做成复杂的仪表盘、电子游戏、生产力工具等等。你也可以选不同的指标。Lighthouse 和 Core Web Vitals 对 SPA 相当苛刻,所以你可以改为衡量应用内交互性。
我也相信,这些框架的作者本人也能改进自己的框架或 AI 工具,在这个基准测试上取得更好的成绩。比如我强烈怀疑,眼下这批 MCP 和 skills 可能弊大于利。所以,如果这篇文章成了这些框架性能表现的最终定论,我会非常失望。我也相信,还有一些新兴框架正跃跃欲试,想在这类基准测试中崭露头角。
退一步说,我也希望这篇文章能让你在这个 vibe coding 的怪异新时代里,对 JavaScript 框架的选择多一分审视。你真的是依据证据在选技术栈吗?还是只是沿用自己已经熟悉的东西?这完全可以理解,尤其是如果你还在亲自阅读、审查和调试代码的话。但如果你基本已经放手不管了,那你对当年像原始人一样一行行敲代码时做出的选择,究竟还有什么执念?如果你正在重新审视自己构建软件的整体方式,那也许值得重新审视一下你在 npm install 后面敲下的东西?随口一说。
就我个人而言,我对上面评估过的这些框架没有任何执念,唯一的信念是我们应当努力为用户打造尽可能好的体验。上面这些框架的作者,我认识并尊重其中许多人,我也知道他们正在为我所拥护的同样价值而不懈努力。我只是希望推动整个社区朝更好的方向走,做出更好、更快、更易用的框架,去支撑下一代 Web 应用。
附录
测试所用的框架版本(注意 Qwik 在测试中途发布过一个补丁版本)。
| 框架 | 版本 |
|---|---|
| Angular | @angular/core 22.2.3 |
| Astro | astro 7.4.2 |
| Gracile+Lit | @gracile/gracile 0.11.0, lit 3.3.3 |
| Hono+htmx | hono 4.13.14, htmx.org 2.0.11 |
| Next.js | next 16.4.3, react 19.3.1 |
| Nuxt | nuxt 4.6.2, vue 3.5.44 |
| Qwik | @builder.io/qwik-city 1.20.2(第 1 轮),1.20.3(第 2、3、4、5 轮),@builder.io/qwik 1.20.2(第 1 轮),1.20.3(第 2、3、4、5 轮) |
| React Router | react-router 8.5.0, react 19.3.1 |
| SolidStart | @solidjs/start 2.1.0, solid-js 1.9.17 |
| SvelteKit | @sveltejs/kit 3.1.0, svelte 5.57.2 |
| TanStack Start | @tanstack/react-start 1.169.4, react 19.3.1 |
| Vanilla | vite 8.3.5 |