拡散モデルから agent まで、AI 画像生成の実用ガイド
Daniel Ball は自腹で ChatGPT と数社の画像 API を回し、バーガーのポスター、ピクセルアートのスプライト、カードテーブルの背景を作った。モデルの仕組み、課金のされ方、AI っぽく見せないプロンプトの書き方、そしてコードや agent に組み込むと何が壊れるかをまとめている。
日本語
コピー
これは私が書いた AI 画像生成の一般的なガイドだ。モデルの仕組みを大まかに説明し、種類の違い、簡単な歴史、ChatGPT から実際に何が得られるのか、そして自分のコードやエージェントに画像生成を組み込む方法まで扱う。
内容は、Python からいくつかの画像生成プロバイダーを呼び出して行った私自身の実験に基づいている。ピクセルアートのスプライト、フォトリアルなカードテーブルの背景、そして AI 生成に見えないレストランのポスターを目指した一連のポスターを作った。ここに載せた画像はすべてその実験から生まれたものだ。
TLDR
- ほとんどのモデルはノイズから始めて、それをきれいにしていく。 テキストがその清掃処理を方向づける。新しいモデルは、チャットモデルが文を組み立てるのと同じように画像の計画を立てる。
- 料金は描かれる内容ではなくキャンバスの大きさで決まる。 同じサイズなら、何もない木のテーブルも精緻な油絵も同じ値段だ。
- ChatGPT は最も手軽な入口で、最も制御しにくい。 単発の画像や対話しながらの修正には向いている。繰り返し使うものには API が必要だ。
- 価格は 100 倍以上開く。 1 枚あたり 1 セントの何分の 1 から 15 セント以上まで幅がある。ローカルで動かせばコストはゼロだ。最も安いモデルが常に最も安い結果になるとは限らない。
- API は足元で動く。 モデルは数週間前の告知で廃止され、プロバイダーはパラメータを黙って無視する。モデルは設定に置き、実際に返ってきたものをログに残しておくこと。
- どう見えるかではなく、どう作られたかを描写する。「stunning」や「hyper-detailed」より、カメラ、フィルム、印刷プロセス、レイアウトを指定したほうが良い結果が出る。
- スペルミスや指はもう見分ける手がかりにならない。 今の手がかりはセンスだ。光りすぎ、ドラマチックすぎ、何ひとつ地味であってはならない。
- エージェントはこれが得意だ。 マルチモーダルなエージェントなら、プロンプトを書き、API を呼び、結果を見て、また試せる。それでもセンスは人間が与える必要がある。
- 最良のパイプラインはハイブリッドだ。 創造的な部分は AI に任せる。サイズ、透過、パレット、レイアウトといった正確さが要る部分は普通のコードに任せる。
簡単な歴史
-
2014 年 - GAN。 Ian Goodfellow の生成的敵対ネットワークは、画像を作るネットワークと偽物を見抜くネットワークの 2 つを競わせる。これにより説得力のある合成の顔が作れるようになるが、テキストで制御するのは難しい。
-
2015 年 - DeepDream。 Google のInceptionism の実験は画像認識を逆手に取る。結果は幻覚的な犬の顔だらけになる。ネットワークが犬を多く含むデータセットで訓練されていたからだ。
-
2018 年 - AI アートがオークションへ。 Edmond de Belamy と名付けられたぼやけた GAN の肖像画がクリスティーズで 43 万 2500 ドルで落札される。上限予想額の 40 倍以上だ。
-
2019 年 - 存在しない顔。 NVIDIA のStyleGANがthispersondoesnotexist.comを動かす。更新するたびにフォトリアルな偽の顔が現れる。
-
2021 年 - DALL-E。 OpenAI がテキストと画像を 1 つのモデルで結びつける。文章を打ち込めば画像が出てくる。小さくぼやけていても、だ。
-
2022 年 - ブレイクスルーの年。 DALL-E 2、Midjourney、Stable Diffusionが数か月のうちに揃って登場する。Stable Diffusion はオープンソースで、ビデオメモリ約 7GB のゲーミング PC で動く。これをきっかけにファインチューンやツールの巨大なコミュニティが生まれる。
-
2023 年 — フォトリアリズムと読める文字。 白いダウンの教皇の Midjourney 画像がネットの大半を騙す。Ideogramが、実際に読めるテキストを備えて登場。SDXL がオープンモデルの水準を引き上げ、DALL-E 3 は ChatGPT に組み込まれた。
-
2024 年 — Flux と反動。 Stable Diffusion の元研究者たちが Black Forest Labs を立ち上げ、Flux を公開。これがオープンウェイトモデルの定番になる。一方で「AI ポスター」は手抜きの代名詞になっていく(詳細は後述)。
-
2025 年 — ネイティブ画像モデル。 OpenAI は画像生成を GPT-4o 自体に組み込み、「スタジオジブリ」ブームが SNS を席巻。Google のGemini 2.5 Flash Imageは Nano Banana の愛称で呼ばれ、1 枚$0.039 で対話的な編集を安価にした。
-
2026 年 — 氾濫と入れ替わり。 OpenAI は API でDALL-E を停止。OpenRouter だけでも十数社の 60 以上の画像モデルが並び、数か月ごとに旧モデルが廃止される。
指が 6 本、文字は意味不明
数年前まで、AI 画像を見分けるいちばん簡単な方法は、指の数を数えること、あるいは背景の看板を読んでみることだった。どちらの問題も今はほぼ解決している。その理由を辿っていくと、これらのモデルの仕組みがよく見えてくる。
手は複雑で柔らかく、写真の中ではたいてい一部が隠れている。カップの陰、ポケットの中、フレームの外に半分だけ。モデルは手をテクスチャとして学んだのであって、指が何本あるかまでは学んでいない。Midjourney v5が転換点になったと、2023 年 3 月に広く報じられた。専門家は、手がはっきり写った画像を厳選して学習データに加えたことに加え、モデルの大型化と高解像度化が効いたと見ている。それでも完璧ではなかった。しばらくの間、背景の人物は地球外生命体のような解剖学のままだった。
文字にはもっと具体的な原因があった。ほとんどのモデルは、プロンプトを単語の塊に分割するトークナイザーを通して読み込む。文字単位ではない。モデルは「chocolate」が c-h-o-c-o-l-a-t-e と綴られることを一度も見ないので、一文字ずつ描くことができない。2022 年の論文Character-Aware Models Improve Visual Text Renderingは、モデルに個々の文字を見せることで問題の多くが解決することを示した。元 Google Imagen の研究者をチームに含む Ideogram は、2023 年に文字を売りにした。2025 年までには、チャットボットと同等に言語を理解する OpenAI と Google のマルチモーダルモデルによって、読める文字が当たり前になっていた。
修正は段階的に進み、その合間に古い問題が現実世界に漏れ出した。2024 年 2 月、グラスゴーで開かれたWilly's Chocolate Experienceは、AI 生成のポスターに「a pasadise of sweet teats」と謳っていた。長いテキストはまだ完全には解決していない。2025 年 12 月、Nano Banana Pro は、それ以外はよくできたインフォグラフィックの中で「Lived experience」をLiver experienceにしてしまった。
仕組み
これらのモデルをうまく使うのに数学は要らない。必要なのは、何が起きているかの大まかなイメージだ。驚きのほとんどはそれで説明がつく。
拡散モデル
画像モデルのほとんどは拡散モデルだ。学習の過程で、画像からノイズを取り除くことを学ぶ。写真を一枚取り、ノイズを少し加え、元のきれいな状態がどうだったかを予測するようモデルに教える。これをあらゆるノイズのレベルで何十億回も繰り返す。
生成時は、この処理を逆向きにたどる。純粋な静的状態から始め、いくつかのステップに分けて少しずつノイズを除去していく。テキストエンコーダーがプロンプトを数値に変換し、その数値が各ステップをプロンプトに合った画像へと導く。
実用上、押さえておくべき点が 2 つある。
- 圧縮された空間で処理する。 Stable Diffusion が採用しているLatent diffusionは、最終画像より各辺が約 8 分の 1 の内部キャンバスに描き、それをデコードする。32 x 32 の画像を指定できないのはそのためだ。内部キャンバスが 4 x 4 になってしまう。
- ステップ数は時間に響く。 ステップを増やすほど遅くなり、ある程度まではたいてい画質も良くなる。Flux Schnell や SDXL Turbo のような「蒸留」モデルは、30 ステップではなく 4 ステップで良い画像を出すよう訓練されている。
マルチモーダルモデル
新しいアプローチでは、言語も理解するモデルの内部で画像を生成する。同じモデルがプロンプトを読み、画像を作るため、指示への追従、テキストの描画、渡した画像の編集に格段に優れる。GPT Image、Gemini の画像モデル、Meta の Muse はこの方式だ。描く前にレイアウトを推論するものもあり、何をどこに置くかを指定するプロンプトではこれが大きな差になる。
マルチモーダルモデルの正体は拡散モデルなのか
多くの場合、一部はそうだが、境界はマーケティングが示すより曖昧だ。
OpenAI が GPT-4o の画像生成を発表した記事は、ハイブリッドであることを示唆している。言語モデルが文章を書くのと同じように画像をトークンの列として計画し、拡散モデル風のデコーダーが最終的なピクセルを描く。Google は Gemini の画像モデルの仕組みを公開していない。逆方向では、Flux のような現代の「拡散」モデルがテキストと画像をまとめて処理する transformer ブロックを使っており、これはチャットモデルと同じ構成要素だ。
つまり有用な区別は数式ではない。画像モデルが言語をどれだけ深く理解しているかだ。指示への追従、読めるテキスト、編集を可能にするのはそこにある。
比較
| 拡散モデル(Flux、SDXL、Imagen) | マルチモーダルモデル(GPT Image、Gemini、Muse) | |
|---|---|---|
| コストを左右するもの | 解像度とステップ数 | 画像トークン。通常はサイズと品質ティアごとに固定 |
| 強み | 安価で高速、ローカルで動く、シードで再現可能 | 指示に従う、テキストを描く、参照画像から編集する |
| 弱み | プロンプトをより文字どおりに解釈する | シードを制御できず、出力サイズが固定のことが多い |
| オープンウェイトか | しばしば | まれ |
シード
拡散モデルが生成の出発点とするランダムなノイズは、シードによって決まる。同じシード、同じプロンプト、同じモデルであれば、同じ画像が得られる。バッチ処理を再現可能にできるのはこのためだ。ホスト型モデルの多くはシードを無視するか受け付けないため、シードに依存する仕組みを作る前に必ず確認すること。
画像生成の種類
「画像生成」と一口に言っても、いくつか異なる作業がある。ほとんどのプロバイダーはその一部だけに対応しており、すべてを網羅しているわけではない。
| 種類 | 内容 | 用途の例 | 試せる場所 |
|---|---|---|---|
| テキストから画像 | プロンプトが画像になる | コンセプトアート、背景、プレースホルダー | OpenAI image guide |
| 画像編集 | 既存の画像に対して「マグカップを青く」と指示する | 一から作り直さずにデザインを練る | Gemini image docs |
| 参照画像 | キャラクター、製品、スタイルを一貫させる | 同じ騎士を 8 つのポーズで | Gemini image docs |
| インペインティング | マスクした領域だけを再生成する | オブジェクトの除去、手の修正 | Diffusers inpainting guide |
| アウトペインティング | 画像の外側へ描き足して広げる | 正方形をバナーにする | ComfyUI inpaint and outpaint examples |
| 構造制御 | スケッチ、ポーズ、深度マップに従わせる | レイアウトを正確に合わせる | ControlNet と Diffusers ControlNet guide |
| ファインチューニング(LoRA) | オープンモデルに新しいスタイルや被写体を教える | 一貫したハウススタイルや製品 | Diffusers LoRA training |
| アップスケーリング | 高解像度でディテールを加える | 安価なバッチから残す一枚を仕上げる | Real-ESRGAN |
| 背景除去 | 被写体を切り抜く | 透過スプライトや商品写真 | rembg |
| テキストからベクター | ピクセルではなく SVG を出力する | アイコンやロゴ | Recraft |
タイル可能なテクスチャにも触れておく価値がある。素のモデルでは、継ぎ目のないタイルを安定して出力できない。そのために学習させたモデルか LoRA、あるいはツール側のタイル生成オプションが必要になる。
利用方法
| ルート | 例 | 向いている用途 | 注意点 |
|---|---|---|---|
| チャットアプリ | ChatGPT、Gemini | 単発の画像、手早い編集 | 制御はほとんどできず、利用制限がある |
| クリエイティブツール | Midjourney、Adobe Firefly、Canva | デザイナー、完成度の高い成果物 | サブスクリプションが必要で、自動化しにくい |
| 直接 API | OpenAI、Google Gemini、Vertex AI | プロダクションコード | API ごとに仕様が異なる |
| アグリゲーター | OpenRouter、Replicate、fal.ai | 1 つのキーで多くのモデルを試す | 一部はマークアップが乗る。モデルは入れ替わりが激しい |
| ローカル | mflux や ComfyUI で Flux や SDXL を動かす | 無料での一括生成、完全な制御 | それなりの GPU か Apple Silicon が必要で、速度は遅い |
実験にはあえてサブスクリプションを使わなかった。すべて API 経由の画像 1 枚ごとの従量課金か、ローカル実行だ。
ChatGPT で得られるもの
多くの人が AI 画像に初めて触れるのは、ChatGPT にリクエストを打ち込むときだろう。そこで何が手に入るのかは知っておく価値がある。
ChatGPT は OpenAI 自社の GPT Image モデルを使っている。2025 年 3 月からチャットに組み込まれている。
DALL-E はまだあるのか? ほぼない。DALL-E 3 は 2023 年 10 月から 2025 年 3 月に GPT-4o の画像生成へ切り替わるまで、ChatGPT の画像生成を担っていた。その後 OpenAI は 2026 年 5 月 12 日にDALL-E 2 と 3 を API から削除した。この名前は主に AI 画像全般を指す一般名詞として残っているだけだ。
得意なこと
- 対話。「光をもう少し暖かく」「マグカップを左に動かして」と言えば、やり直すのではなく編集してくれる。
- 指示への追従。 レイアウト、数、細かい指定を、旧来の拡散モデルよりもうまく扱う。
- 文字。 看板、ポスター、ラベルの綴りはたいてい正しい。
- 参照。 写真やスケッチをアップロードすれば、それを基に作業する。
苦手なこと
- 制御。 アスペクト比は数種類だけで、シードもなく、バッチ実行もできない。1024 x 512 ちょうどで、とは頼めない。
- 速度。 1 枚あたり数秒から 1 分以上かかり、利用制限もある。無料プランでは特に厳しい。
- 画風の偏り。 放っておくと、見覚えのある見た目に寄っていく。2025 年のモデルは暖かい黄色かぶりで知られ、「piss filter」と呼ばれた。デフォルトに任せず、欲しい光と色を自分で指定したほうがいい。
- コンテンツ規制。 一部のリクエストは拒否される。特定の文脈での実在の公人や、著作権キャラクターのそっくりな複製などだ。
来歴。 OpenAI はヘルプセンターによると、画像にC2PAメタデータと SynthID ウォーターマークの両方を付与している。Google は Gemini の画像にSynthIDを付ける。メタデータは簡単に剥がせる。ウォーターマークはスクリーンショットに強いが、画像が AI かどうかを証明したいなら、どちらも頼りにはならない。
ChatGPT か API か。 同じモデル群はOpenAI の APIからも使えて、課金は画像 1 枚単位になる。API ではサイズを固定リストから選べ、品質ティアを指定でき、コードからバッチ処理を回せて、モデルによっては透過背景にも対応する。数枚では足りない場合や、同じ種類の画像を繰り返し作るなら API を使う。Gemini アプリと Gemini API の関係も同じだ。
コストの話
料金はキャンバスに対して払う
一番しっくりきたのは、大きなキャンバスしか持っていない画家のたとえだ。キャンバス 1 枚ごとに料金を取り、どの 1 インチも同じ丁寧さで塗る。青一色の空にも、顔と同じだけ手間をかける。
- 単純な絵が安くなるわけではない。 モデルは画像全体に対して同じ計算をする。
- 小さくは作れない。 モデルが最も力を発揮するのはおよそ 512〜1600 ピクセル。32 x 32 のスプライトが欲しければ、大きな画像を作って自分で縮小する。
- 小さいサイズを指定しても効かないことが多い。 Gemini 2.5 Flash Image に 512 x 512 を頼んだら 1024 x 1024 が返ってきて、料金は同じ定額だった。
課金のされ方は 4 通り
| 課金方式 | 例 | 小さくすると安くなるか |
|---|---|---|
| 画像 1 枚あたりの定額 | Gemini 2.5 Flash Image、Recraft | ならない |
| 画像 1 枚あたり、サイズと品質で段階設定 | 新しい Gemini モデル、OpenAI GPT Image | 少しだけ。最小ティアでも大半の用途には大きなキャンバス |
| メガピクセル単位または GPU 秒単位 | Replicate、fal.ai、OpenRouter 上のほとんどのモデル | なる |
| 自分の電気代 | ローカルの Flux | なる。しかも節約できるのは速度 |
2026 年 10 月時点の相場
| 選択肢 | 画像 1 枚あたりの概算コスト | 向いている用途 |
|---|---|---|
| ローカルの Flux Schnell | $0+自分の時間 | プロンプトの試行錯誤と大量バッチ |
| Replicate または fal.ai 上の Flux Schnell | 約$0.003 | クラウドでの安価なバッチ処理 |
| Recraft V4.1 Flash(OpenRouter) | 約$0.007 | 速くて安いイラスト |
| FLUX 3 Image Klein(OpenRouter) | 約$0.009 | 安価なフォトリアル |
| Meta Muse Image(OpenRouter) | 約$0.01 | レイアウト指示への追従 |
| OpenAI GPT Image 1.5 | 0.034(medium)、$0.133(high) | OpenAI の品質ティア |
| Gemini 2.5 Flash Image | 約$0.039、Batch API 経由なら半額 | 編集とキャラクターの一貫性 |
| Nano Banana 2(Gemini 3.1 Flash Image) | 1K で約 0.067 | より新しく高品質だが割高 |
| Nano Banana Pro(Gemini 3 Pro Image) | 約$0.134〜 | 最終稿向けの最高品質 |
新しいフラッグシップモデルは、画像 1 枚あたりのコストが安くなるどころか高くなる。市場の安い側にいるのはオープンウェイトのモデルと、「flash」「mini」「lite」といったティアだ。OpenRouter のモデル一覧が現在の価格を比較するのに一番手軽だ。
使える画像 1 枚あたりのコスト
画像 1 枚あたりの価格だけを見ていると判断を誤る。
cost per usable image = (price per image x attempts needed) + your time
10 回試行しないと使えない無料のローカルモデルは、一発で決める$0.039 のモデルに負ける。私の実験では、0.1 セント高いモデルのほうがリトライを何度も省いてくれた。
効くプロンプトの書き方
視点ではなくカメラを描写する
ゲーム用にカードテーブルの背景が欲しかった。真上から見下ろしたテーブルで、縁に小道具をいくつか置き、中央はカード用に空けておく、という画だ。
「真上から見た」と指定するだけでは足りない。モデルは写真から学んでいて、テーブルの写真はたいてい斜めから撮られている。最初の何回かは、テーブルの後ろに壁と窓があるきれいな写真が返ってきて、小道具はどれも片側に寄っていた。
2 つの変更でほぼ解決した。
- カメラを描写する。「正投影のフラットレイ。カメラはテーブル面を真下に向け、パースも地平線もない。テーブル面がフレーム全体を端から端まで埋める。壁、窓、床、テーブルの縁は一切見えない。」
- 物の位置を明示する。「これらを片側や角に寄せず、四辺(上下左右)すべてに散らす。それぞれは小さく、画像の縁で切れていること。」
同じプロンプトをパイン材のキッチンテーブル向けにして、2 つの変更を両方入れたものを、2 つの異なるモデルで実行した結果がこちらだ。
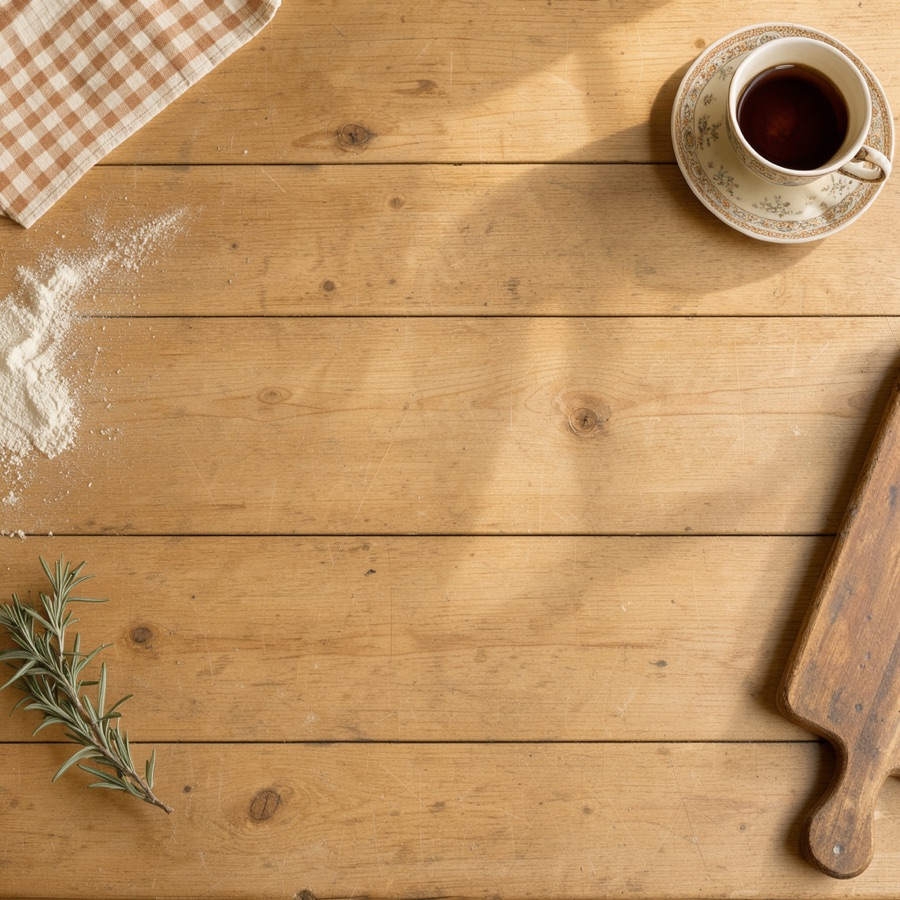
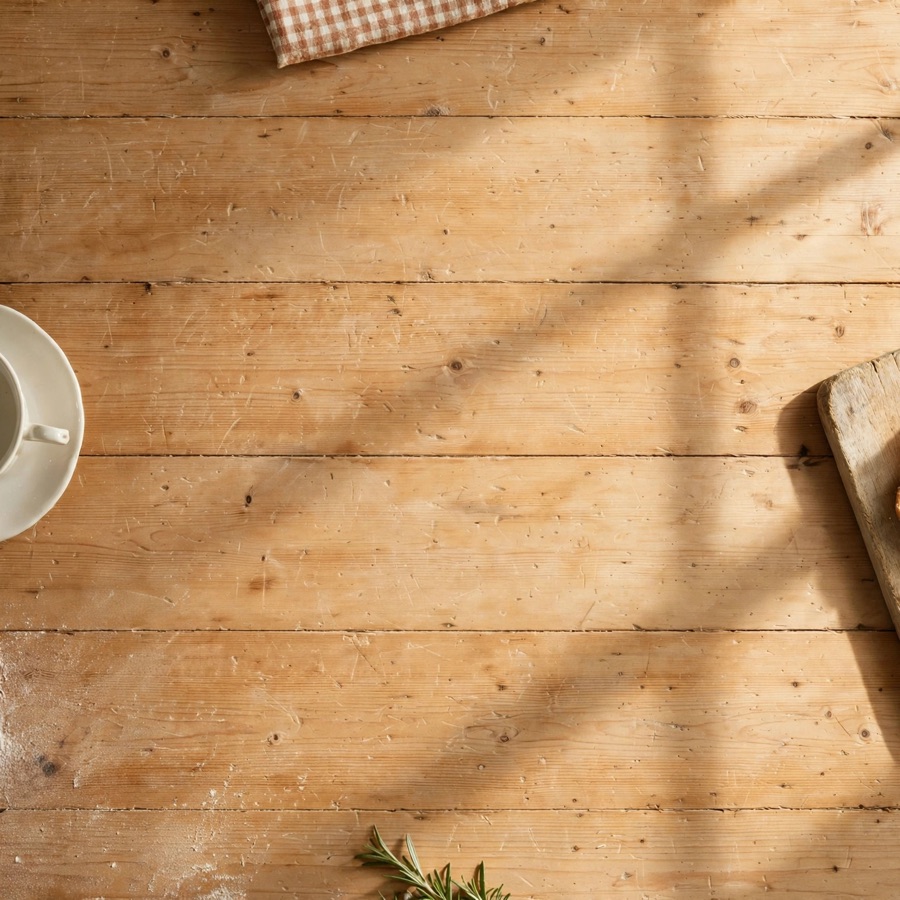
どちらも今やトップダウンだ。Flux は小道具をそのまま残し、四隅へ押しやる。描く前に計画を立てるマルチモーダルモデルの Muse は、各辺に一つずつ要素を置き、それぞれを切り取り、中央は空けたままにした。
AI 画像が最も批判されるのはマーケティング
ポスター、チラシ、インフォグラフィックは、AI 画像の最も一般的な用途の一つだ。そして、最も安っぽく見えがちな場所でもある。
- 意味不明な文字。Willy’s Chocolate Experienceのポスターは「catgacating」「exarserdray」をうたっていた。イベント自体が写真とはかけ離れすぎていて、通報騒ぎになった。
- 悪趣味。 A24 が『Civil War』のために AI で生成したポスターは、2024 年 4 月に批判を浴びた。映画には出てこない場面が描かれ、シカゴの名所が誤った角度で再現されるなど、明らかな誤りがあった。怒りの多くは、アーティストに金を払う代わりに AI を使ったスタジオに向けられた。
- 事実の誤り。 Karen Spinner が研究論文をインフォグラフィックに変える実験は、プロンプトと元資料がすべて公開されている好例だ。結果は「ほぼ使える」ものになったが、6 回試してようやくだった。途中でモデルは単語を綴り間違え、余白に関する指示を無視し、見つけた隙間という隙間を埋めた。彼女の助言は、コピーは短く保ち、すべてを校正することだった。
AI 生成に見えないポスターを作る
そこで自分に課題を課した。AI だとすぐに分からないレストランのポスターを作れるだろうか。
最初の試みは、スクリーン印刷風のトラットリアのポスターだった。見た目を説明するのではなく、実際の印刷工程を説明した。未塗工紙に 3 色のフラットなスポットインク、わずかな見当ずれ、写真ではなくスキャン、中心を外した構図、そして名前の知られたデザインの伝統。
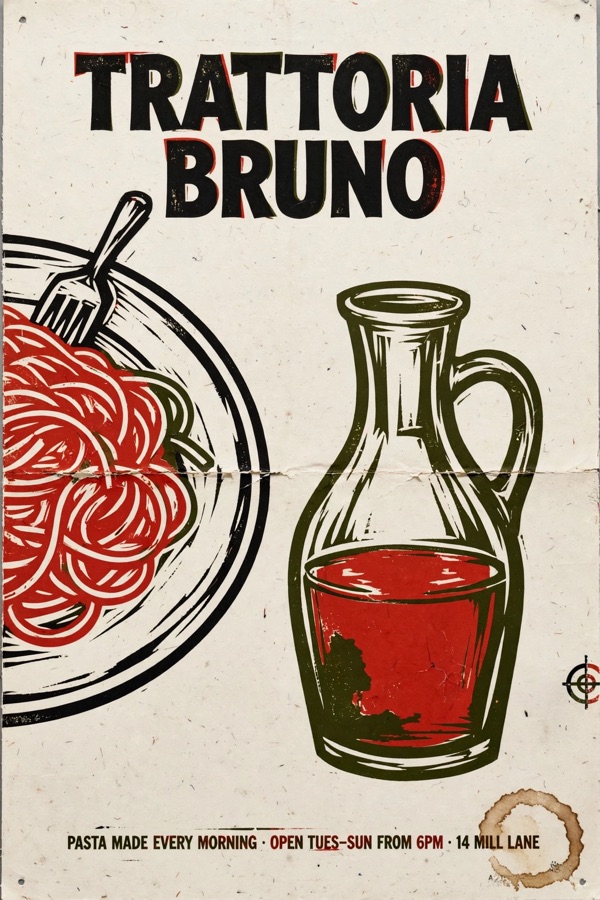
インクの質感には説得力がある。下の行はきれいなデジタル書体に見えるが、折り目のしわはやりすぎかもしれない。
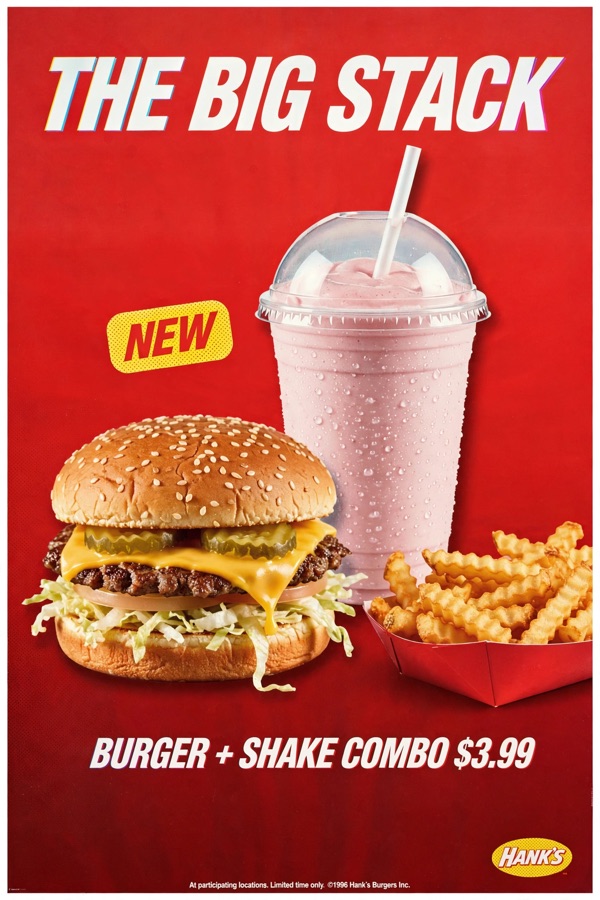
より手強いテストは、食べ物が本物に見える 90 年代のバーガーポスターだった。AI の食べ物は完璧すぎて、ツヤツヤで、いかにもヒロイックになりがちだ。1996 年の medium format フィルム写真で、食べ物はわざと不完全に。バンズはゆがみ、トマトは冬らしく色が薄い、という指定にした。
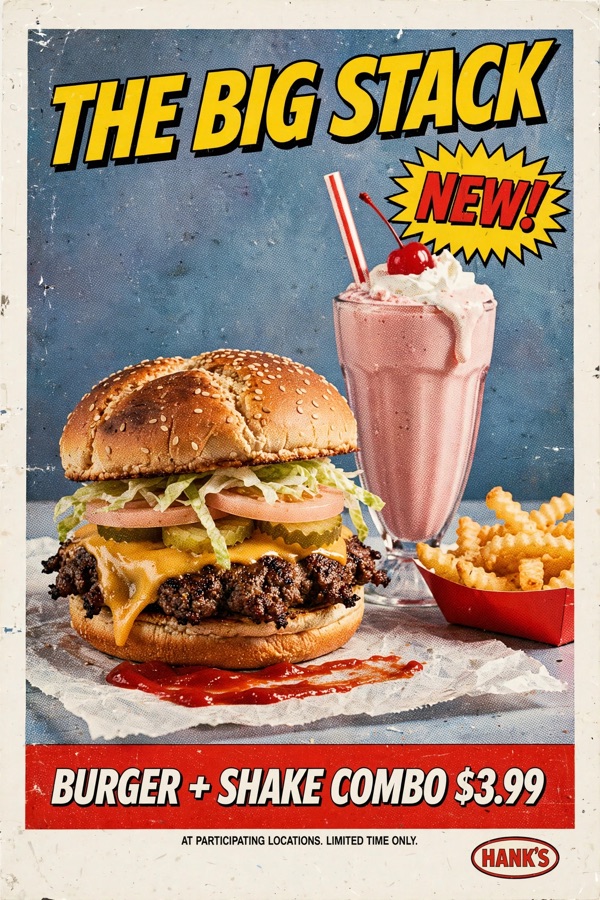
最初のバージョンは食べ物は良かったものの、「ヴィンテージ」フィルターがかかったように見えた。コミック調の文字に、わざとらしい傷み。本物の 1996 年のポスターなら、もっとクリーンで企業的なはずだ。
そこで、退屈にしてみた。丁寧にスキャンしたような質感、初期 Photoshop のグラデーションをかけた平坦な赤い背景、切り抜いた商品写真に少し均等すぎるドロップシャドウ、そして無骨な太字のイタリック体。「有能で、やや凡庸」に見えるように頼んだのだ。これなら一見しただけでは通る。完全に 1996 年とは言えない。シェイクが 2010 年代に見かけるドーム型のフタ付きカップに入っているからだ。
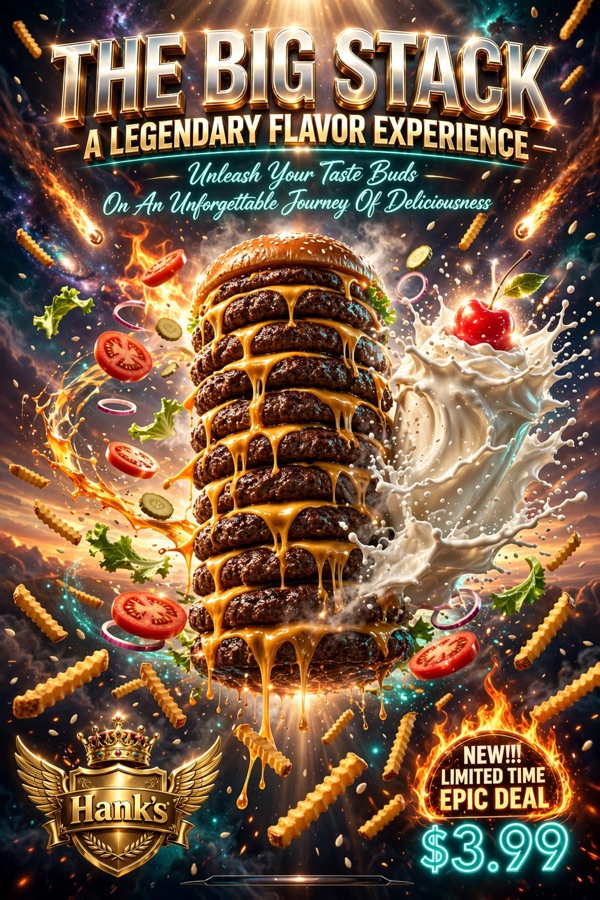
バランスを取るため、思いつく限り最悪のバージョンも頼んだ。Unreal Engine、容積光のゴッドレイ、宙に浮く具材、そして銀河。返ってきたのは、下のバンズがないパティが十数枚、グラスに入っていないシェイク、宇宙から降り注ぐフライドポテトだった。昔の(2 年前の)AI ポスターと違い、今はスペルも正しい。今の見分け方はスペルではない。すべての要素が最大限に盛られていることだ。
プロンプトの経験則
- どう作られたかを描写する。 カメラ位置、レンズ、フィルム、ライティングの構成、印刷プロセス、スキャン。これらがモデルに具体的な制約を与える。
- 煽り文句は入れない。「stunning」「hyper-detailed」「8K」は、モデルをまっすぐ AI っぽい見た目へと押しやる。
- レイアウトははっきり書く。 何が画面を占めるのか、何が見えているのか、各要素をどこに置くのかを伝える。
- 本物のデザインは抑制が効いている。「やや凡庸に」と頼んだ効果は、どんなに細かい指定よりも大きかった。
- テキストは短く正確に。 引用符で囲み、「spell every word exactly as written」と添えて、結果を校正する。
- 時代のディテールを名指しする。 古いものを指定しない限り、モデルは現代的なものへ流れがちだ。
- 2〜3 枚生成する。 同じプロンプトでも variants は大きく変わることが多く、1 枚 1 セントならプロンプトを書き直すより安い。
- バッチ用にテンプレートを固定する。 同じカテゴリのアセットには同じスタイルの接尾辞とシードを使い、バッチ全体がぶれないようにする。
ピクセルアート
ピクセルアートやゲームのスプライトは、画像モデルにとって最も簡単な仕事に見える。小さく、シンプルで、色数も少ない。ところが蓋を開けてみると、AI による画像生成が思ったより難しいことを示す好例になる。
ピクセルアートはフォーマットではなくスタイル
Gemini 2.5 Flash Image でピクセルアートの騎士を生成すると、7.5 秒かかり、コストは約$0.039。仕上がりはクリーンで、文句なしにレトロだ。
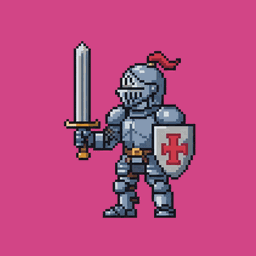
だが、それはスプライトの 1024 x 1024 の画像であって、スプライトではない。「ピクセル」は大きさがばらつき、正しいグリッドに乗っておらず、実際のパレットよりはるかに多くの色を使っている。「単色」のはずのマゼンタの背景は、わずかに色の変わるピンクだった。使えるものにするには、背景を除去し、nearest-neighbour でダウンスケールしてグリッドに合わせ、パレットを減らす必要があった。どれも普通のコードで行っている。
1 枚のキャンバスに多数のスプライト
キャンバスごとに課金され、スプライト 1 つがそのごく一部しか使わないなら、1 枚の画像に多数のスプライトを要求するのが当然の策だ。安く済み、仕上がりも安定する。モデルが同じパレットとライティングで一度にすべてを描くからだ。
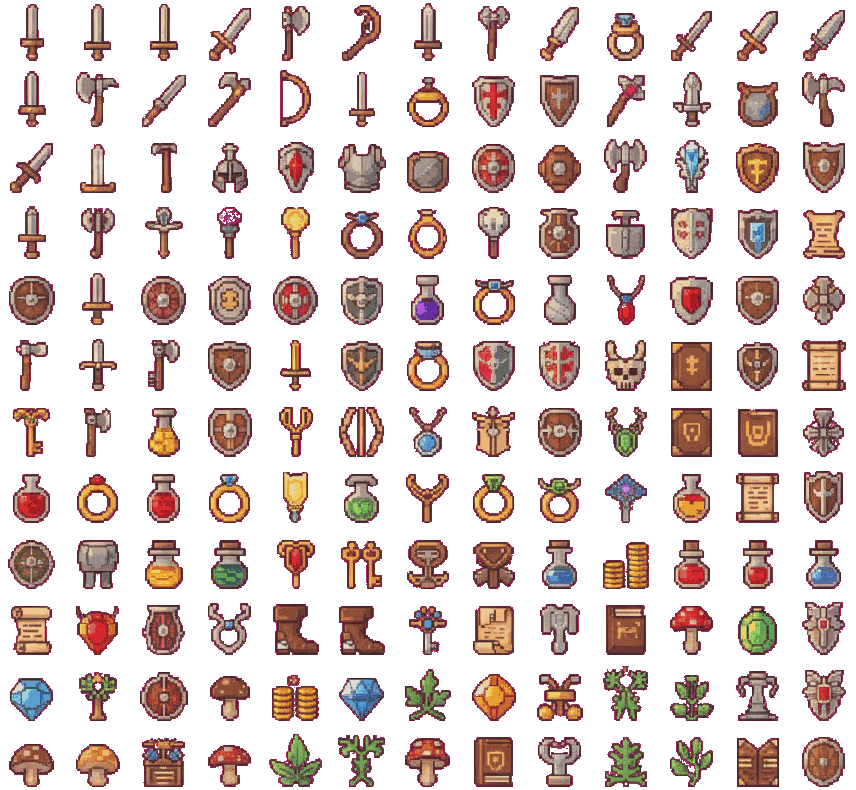
異なるオブジェクトのセットなら、これは見事に機能する。ファンタジー RPG のインベントリアイコンを 100 個頼んだところ 156 個が返ってきて、そのうち約 140 個が別々のものだった。アイコン 1 個あたり 0.00025 だ。あとは普通のコードで形ごとに切り分け、背景を除去し、きれいなグリッドに詰め直す。
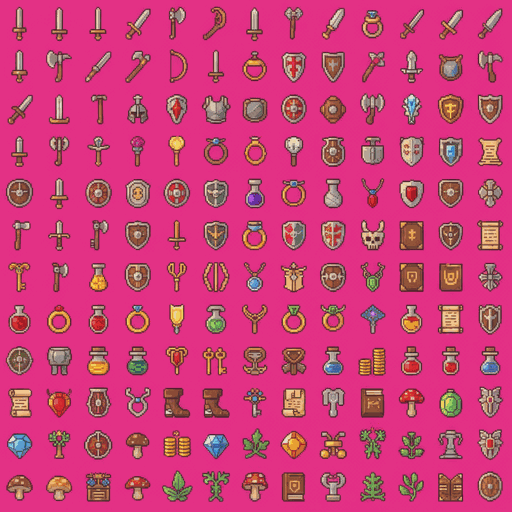
同じキャラクターをさまざまなポーズで描かせると、すぐに破綻する。4×4 のグリッドで同じ騎士のポーズを指定しても、明確に異なるポーズは 13 種類ほどしか得られなかった。10×10 を頼むと、返ってきたのは同じ騎士を 120 回押し付けただけの結果だった。
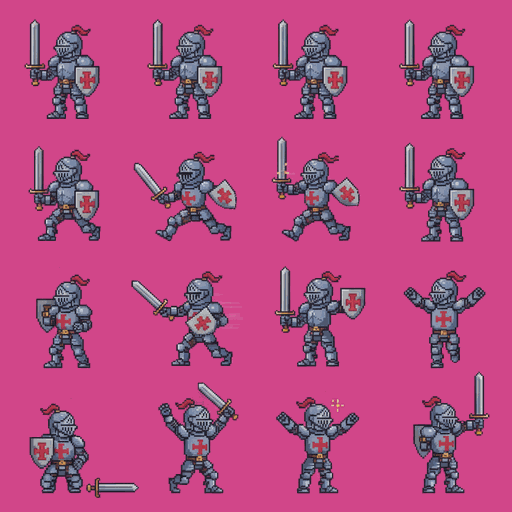
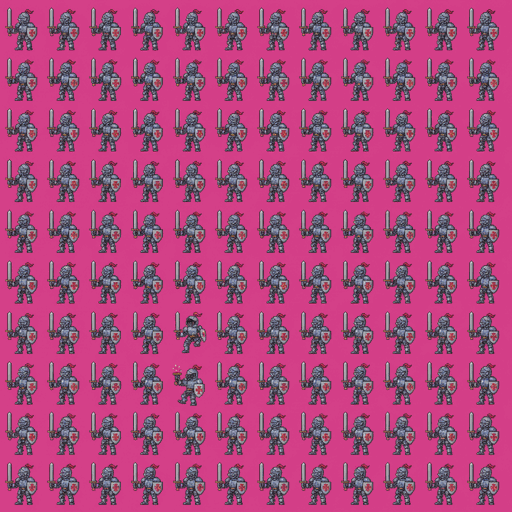
7 回の呼び出しと約 0.27 ドルで分かったこと。
- オブジェクトのセットなら約 10 x 10、キャラクターのポーズなら 4 x 4 が最適点。 それ以上を求めると、多様性も品質も下がった。
- グリッドを決めるのはモデルであって、こちらではない。 8 x 8 を指定したのに返ってきたのは 6 x 6 だった。固定グリッドで切り出すのはやめること。スプライトは形で見つける。
- すべてをまとめて拡大縮小する。 各スプライトを自分のセルいっぱいに合わせてリサイズすると、アニメーションのフレーム間でキャラクターが大きくなったり小さくなったりする。
ピクセルアートをきちんとやるなら
ここでやったのは汎用モデルを使った簡単な実験にすぎない。ピクセルアート(非常に特殊な種類の画像生成)が必要なら、もっと良い方法がある。
PixelLabはゲーム開発者向けに作られている。ピクセルアート風に見える大きな画像ではなく、実際のサイズで本物のスプライトを描く。パレット、アウトライン、カメラアングル、透過はプロンプトの文言ではなく設定項目で、キャラクターのアニメーションや回転もできる。サブスクリプションなので今回は使っていない。Retro Diffusionも同様の商用サービスだ。
自分でやるなら、Pixel Art XLのようなピクセルアート向けに学習させたモデルのアドオンを使い、出力をきれいなグリッドに縮小してからコードでパレットを整える。PixelOEなら AI なしで任意の画像をピクセルアートに変換できる。静止画ならこれで十分だ。一貫性のあるアニメーションとなると、まだ商用ツールが優位に立つ。
線引きはどこにあるか
ベクターも、見た目より難しいフォーマットだ。LLM は SVG のコードを安く書けるが、絵を見ずに絵を説明しているだけなので、キャラクターは粗くなる。Recraftのようなテキスト to ベクター専用モデルははるかにきれいだが、ラスター画像よりコストがかかる。
ピクセルアートから得られる一般的な教訓は、AI は「これはどう見えるべきか」は得意で、「これを正確にこのセルに置け」は苦手だということ。大事なのは出力がどれだけシンプルに見えるかではない。難しい部分が創造的なのか構造的なのかだ。創造的な部分はモデルに、構造はコードに任せればいい。
画像生成をコーディングプロジェクトに組み込む
プロバイダーの前に薄いインターフェースを 1 枚かます
API はどれも勝手が違う。OpenAI には images エンドポイントがある。Gemini はチャット形式のレスポンスの中に画像を返す。OpenRouter はモデルによって 2 つのエンドポイントを使い分ける。ローカルの Flux は Python ライブラリかコマンドラインツールだ。こうした違いはすべて 1 つの関数の裏に隠し、プロバイダーの切り替えを設定変更だけで済ませる。
from dataclasses import dataclass, field
from typing import Protocol

from PIL import Image

@dataclass
class GenerationResult:
    image: Image.Image
    provider: str
    model: str
    prompt: str
    seed: int | None = None
    cost_usd: float | None = None
    metadata: dict = field(default_factory=dict)

class ImageProvider(Protocol):
    def generate(self, prompt: str, *, width: int, height: int, seed: int | None = None) -> GenerationResult: ...
各プロバイダーの癖は、そのプロバイダーのモジュールの中に閉じ込めておく。Base64 のデコード、妙なパラメーター名、フォールバック用のエンドポイントをアプリ側のコードに持ち込むべきではない。
前提が動くものだと思うこと
どれも数か月のあいだに実際に起きたことだ。
- モデルが消えた。 使う予定だった Flux 2 のモデルは、計画から実装に移るあいだに OpenRouter から消えた。Imagen 4 は Gemini API で提供終了になった。Gemini 2.5 Flash Image と gpt-image-1 には廃止日が設定され、なかには数週間前の告知しかなかったものもある。Gemini deprecations pageはブックマークしておく価値がある。
- エンドポイントが変わった。 OpenRouter は画像専用モデルを別の
/api/v1/imagesエンドポイントに移した。以前の呼び方では 404 が返る。いまのコードは片方を試し、失敗したらもう片方にフォールバックする。 - パラメーターが無視されたり、弾かれたりした。 Gemini は size と seed を無視した。OpenAI はいくつかの固定サイズのうち最も近いものに丸める。FLUX 3 Klein は seed を受け付けずに拒否する。Muse は 1024 x 1024 を指定したのに 1600 x 1600 を返した。
プロバイダーとモデルは設定に置き、コードには書かない。返ってきたもののサイズとフォーマットを確認し、指定したとおりになったと信じない。各プロバイダーに対して定期実行のスモークテストを回し、ユーザーより先に提供終了に気づけるようにする。
すべてログに残す
画像 1 枚ごとにプロンプト、モデル、パラメーター、出力サイズ、所要時間、コストを記録する。コストの報告はプロバイダーごとにばらばらだ。OpenRouter は請求額を返す。OpenAI と Gemini はトークン数だけを返し、計算はこちらに任せる。何も返さないものもある。自前でログを取っていなければ、いくら使ったかは月次の請求書を見るまでわからない。
プロンプトとパラメーターを画像と一緒に残しておけば、数か月後に良い結果を再現したり調整したりできる。
生成は遅く、失敗するジョブとして扱う
- 遅い。 数秒から 1 分程度かかる。Web リクエストの中で実行しないこと。ジョブキューに載せ、完了したらユーザーに通知する。
- 失敗する。 タイムアウト、レート制限、コンテンツ拒否、そしてたまに空のレスポンスが返る。バックオフ付きでリトライするが、拒否は確定として扱い、同じプロンプトでリトライしない。
- 呼び出しごとにお金がかかる。 プロンプトとパラメータのハッシュで結果をキャッシュする。ユーザーが生成をトリガーできる機能には、ユーザーごとの上限を設ける。
正確な処理はコードで行う
モデルは創造的な部分だけに使う。背景除去(rembg)、リサイズ、パレット削減、クロップ、テキストの合成、スプライトシートのパッキングは、Python ならどれも無料で速く、決定的に動く。ほとんどのモデルは本物の透過を出力できないので、無地の背景で生成してから背景を除去する。OpenAI の GPT Image モデルの一部は透過背景オプションを持つ例外だ。
価格や日付など正確なテキストが必要な画像は、テキストなしでアートワークを生成し、コードでテキストを載せることを検討する。スペルを確実に正しくする唯一の方法だ。
お金をかけずにテストする
ユニットテストでは固定の画像を返すフェイクプロバイダーを使う。実際の API 呼び出しは少数のスモークテストだけにとどめる。開発中は安いモデルを使い、本番の設定でより良いモデルに切り替える。
エージェントとの統合
画像生成と AI エージェントは相性がいい。マルチモーダルなエージェントは、詳細なプロンプトを書き、モデルを呼び、結果を見て批評し、また試す。かつて人間が必要だったのは、このループの部分だ。
Claude は画像を生成しない
Claude Code を使っているなら、内蔵モデルが写真や絵画のようなラスター画像を生成しないことを覚えておきたい。Anthropic のヘルプセンターにもはっきりそう書かれている。Claude は画像を閲覧・分析でき、SVG や HTML のようなコードで図、グラフ、インタラクティブなビジュアルを描ける。
同社のモデルはテキスト、コード、エージェント向けだ。Claude は詳細なプロンプトの作成や、結果が要件を満たしているかの判断など、画像生成の周辺部分が非常に得意だ。ツールを通じて専門の画像モデルにつなぎ、それぞれが得意なことを担えばいい。
組み込み方 3 通り
- コマンドラインツール。 いちばん簡単な方法だ。エージェントがシェルコマンドを実行できるなら、
python -m image_gen generate --model meta/muse-image --prompt "..."のようなスクリプトを渡し、出力先を伝えるだけで済む。私がやったのはこれだ。 - MCP サーバー。 Model Context Protocol を使えば、画像生成をツールとして、Claude Code、Claude Desktop、Cursor など MCP 対応のあらゆるエージェントに公開できる。エージェントからは、スクリプトの使い方を覚えるのではなく、説明付きの型付きツールとして見える。
- 自作エージェントでの関数呼び出し。 エージェントを自分で作っているなら、LLM API の呼び出しに
generate_imageツールを定義し、モデルが要求したときに生成を実行させる。
Python で書いた最小限の MCP サーバーはこんな感じだ。
from mcp.server.fastmcp import FastMCP, Image

from image_gen.config import get_provider

mcp = FastMCP("image-gen")

@mcp.tool()
def generate_image(prompt: str, width: int = 1024, height: int = 1024) -> Image:
    """Generate an image from a detailed prompt. Costs about $0.01 per call."""
    result = get_provider("openrouter", model="meta/muse-image").generate(prompt, width=width, height=height)
    path = save_with_metadata(result)  # your own logging and storage
    return Image(path=path)

if __name__ == "__main__":
    mcp.run()
ファイルパスだけでなく画像そのものを返すと、エージェントは自分が何を作ったのかを見られる。
このガイドの実験環境
このガイドの画像はすべてこの方法で作った。エージェントは Claude Code、プロバイダの呼び出しには小さな Python スクリプトを使っている。欲しいものを普通の英語で伝えると、Claude が詳細なプロンプトを書き、OpenRouter の価格表からモデルを選び、スクリプトを実行し、各画像を開いて、どこがおかしいかを正直に教えてくれた。セッションの途中で OpenRouter が API を変更したときも、エラーを見つけてコードを直し、そのまま作業を続けた。
エージェントに生成させるコツ
- プロンプトはエージェントに書かせる。 LLM は「AI っぽくない 90 年代のバーガーポスター」といった指示を、詳細で構造化されたプロンプトに落とすのが得意だ。このガイドのポスターのプロンプトもそうやって書いた。
- 出力をエージェントに見せる。 価値が出るのは批評の工程だ。画像を見られないエージェントは、API を遅く呼ぶだけの存在だ。
- コストをツールの説明に書く。 1 回の呼び出しに 1 セントか 15 セントかが分かっているほうが、エージェントは良い判断をする。
- 予算を決める。 画像を改善し続けるループは請求額を膨らませる。呼び出し回数かセッションあたりの支出に上限を設ける。
- 正直な批評を求める。 できたかどうかだけでなく、各画像のどこがおかしいかを挙げるようエージェントに指示する。私の 1996 年のポスターに 2010 年代のミルクセーキカップが写っているのを見つけたのはエージェントだった。
- センスは人間が持つ。 画像がブリーフに沿っているかを確認するのはエージェントの得意分野だ。そのブリーフ自体が正しかったかどうかを決めるのは、今もあなたの仕事だ。
用語集
AI Glossaryも参照。
- Diffusion - ランダムノイズから始め、プロンプトに導かれながら少しずつノイズを取り除いて画像を生成する手法。
- Latent - diffusion モデルが処理する圧縮された内部キャンバス。出力サイズが極端に小さいとうまくいかないのはこのため。
- Steps - diffusion モデルがノイズ除去を何回行うか。多いほど遅くなるが、ある程度まではたいてい結果が良くなる。
- Distilled model - 少ないステップで良い結果を出せるよう訓練されたモデル。Flux Schnell や SDXL Turbo など。
- Seed - ランダムな開始点。対応していれば、同じ seed、プロンプト、モデルで同じ画像が得られる。
- Tokeniser - モデルがテキストを分割する部分。古いモデルが綴りを間違えたのはこのため。
- Tokens - マルチモーダルモデルが出力を数える単位。画像の場合、サイズと品質ごとに固定の数になる。
- Open weights - 自分でダウンロードして実行できるモデル。Flux や SDXL など。
- LoRA - 再訓練せずに、オープンモデルへ新しいスタイルや被写体を教え込む小さな追加パーツ。
- ControlNet - diffusion モデルをスケッチ、ポーズ、深度マップに従わせる方法。
- Inpainting - 画像のマスクした部分だけを再生成すること。
- C2PA - 画像がどう作られたか、AI が関与したかどうかまで記録するメタデータ標準。
- SynthID - Google の AI 生成コンテンツ向けの不可視ウォーターマーク。
- MCP - Model Context Protocol。AI エージェントにツールへのアクセスを与える標準的な方法。
- Nearest-neighbour - ピクセルを混ぜずにコピーするリサイズ手法。ピクセルアートには必須。
- Orthographic - 遠近感のない視点。真上からのショットに使えるプロンプト表現。
リソース
- OpenRouter image models - 価格を比較し、1 つの API キーで数十のモデルを試せる
- OpenAI image generation guide - GPT Image API
- Gemini image generation docs - Nano Banana など
- Gemini API deprecations - Gemini モデル上で構築する前に確認しておきたい
- mflux - Apple Silicon 上で Flux をローカル実行する
- ComfyUI - ControlNet や LoRA を含むノードベースのローカルワークフロー
- Hugging Face Diffusers - オープンモデル向けツールの多くを支える Python ライブラリ
- rembg - Python での背景除去
- Replicate と fal.ai - 大量処理向けの安価なホスト型オープンウェイトモデル
- Model Context Protocol - 画像生成をエージェントに公開するために
- C2PA - コンテンツの来歴標準
- Why AI image generators struggle to get text right - 綴りの問題についての読みやすい解説