从扩散模型到 agent,AI 图像生成实用指南
Daniel Ball 自费把 ChatGPT 和几家图像 API 跑了一遍,做了汉堡海报、像素精灵和卡牌桌面背景。模型怎么工作、按什么计费、提示词怎么写才不像 AI 出的图,以及把它接进代码和 agent 时会遇到什么,都写在这篇里。
中文
复制
这是我个人关于 AI 图像生成的指南。它讲模型在高层面上如何运作、有哪些类型、一点历史、你从 ChatGPT 实际能得到什么,以及如何把图像生成接进自己的代码和 agent 里。
内容来自我自己的实验,我用 Python 调用过几家图像服务商。我生成过像素风 sprite、照片级质感的牌桌背景,还有一系列餐厅海报,目标是做出看起来不像 AI 生成的那一张。文中所有图片都出自这些实验。
TLDR
- 大多数模型从噪声出发,再把它清理干净。 文本负责引导清理过程。较新的模型还会像聊天模型规划一句话那样,先规划整张图。
- 你付的是画布的钱,不是内容的钱。 一张素木桌和一幅同样尺寸、细节丰富的油画,价格一样。
- ChatGPT 是最容易上手的入口,也最难控制。 适合一次性出图和对话式修改。想要可重复的东西,就得用 API。
- 价格差距超过 100 倍。 从不到一美分到每张 15 美分以上都有。本地跑模型不花钱。最便宜的模型不一定给出最便宜的结果。
- API 会在你脚下变动。 模型退役只提前几周通知,服务商还会悄悄忽略参数。把模型名放进配置,并记录你实际拿回来的东西。
- 描述它是怎么做出来的,而不是它应该长什么样。 相机、胶片、印刷工艺和版式,比“惊艳”“超精细”这类词更管用。
- 拼写和手指已经不是破绽了。 现在的破绽是品味。光晕太多、戏剧性太强,什么都不允许朴素。
- Agent 很擅长这件事。 多模态 agent 能写 prompt、调 API、看结果、再试一次。品味还是得你来提供。
- 最好的流水线是混合的。 创意部分交给 AI。尺寸、透明度、调色板和版式这类要求精确的部分,交给普通代码。
一段简史
-
2014 - GAN。 Ian Goodfellow 的生成对抗网络让两个网络互相对抗,一个生成图像,一个识别假图。它们后来能生成以假乱真的人脸,但很难用文本控制。
-
2015 - DeepDream。 Google 的 Inceptionism 实验把图像识别反过来用。结果里满是迷幻的狗脸,因为这个网络训练所用的数据集里有大量狗。
-
2018 - AI 艺术进拍卖行。 一幅模糊的 GAN 肖像《Edmond de Belamy》在佳士得拍出 432,500 美元,是最低估价的 40 多倍。
-
2019 - 不存在的人脸。 NVIDIA 的 StyleGAN支撑起了 thispersondoesnotexist.com,每次刷新都是一张新的照片级假人脸。
-
2021 - DALL-E。 OpenAI 把文本和图像放进同一个模型。你打一句话就能得到一张图,哪怕又小又模糊。
-
2022 - 爆发之年。 DALL-E 2、Midjourney和 Stable Diffusion在几个月内相继出现。Stable Diffusion 是开源的,能在一台约 7GB 显存的游戏 PC 上运行,由此催生出一个庞大的微调与工具社区。
-
2023:照片级真实感与可读文字。 Midjourney 生成的身穿白色羽绒服的教皇骗过了大半个互联网。Ideogram 发布,它生成的文字终于能读了。SDXL 抬高了开放模型的门槛,DALL-E 3 则进入了 ChatGPT。
-
2024:Flux 与反弹。 几位前 Stable Diffusion 研究员创立 Black Forest Labs,并发布 Flux,后者成为默认的开放权重模型。与此同时,“AI 海报”成了偷工减料的代名词(详见下文)。
-
2025:原生图像模型。 OpenAI 把图像生成直接做进了 GPT-4o 本身,“吉卜力风”席卷社交媒体。Google 的 Gemini 2.5 Flash Image(绰号 Nano Banana)让对话式修图变得便宜,每张 0.039 美元。
-
2026:供给过剩与快速迭代。 OpenAI 在 API 中关停了 DALL-E。仅 OpenRouter 一家就列出了来自十几家公司的 60 多个图像模型,老模型每隔几个月就有一批退役。
六根手指与乱码文字
几年前,辨认 AI 图片最简单的办法是数手指,或者试着读背景里的招牌。这两个问题如今基本都解决了,而它们当初为什么会出问题,恰好说明了这类模型是怎么工作的。
手结构复杂、姿态灵活,在照片里还常常被遮住一部分。挡在杯子后面、插在口袋里、半截在画面之外。模型学到的是手作为一种纹理长什么样,而不是一只手有几根手指。2023 年 3 月发布的 Midjourney v5 被普遍认为是转折点。专家推测原因在于训练数据经过更好的筛选、手的图片更清晰,再加上模型更大、分辨率更高。它并不完美。背景里的人有一阵子还是长着外星人的解剖结构。
文字的成因更具体。大多数模型读取你的提示词时,会经过一个 tokeniser,它把提示词切成词块,而不是切成字母。模型从来看不到 “chocolate” 是由 c-h-o-c-o-l-a-t-e 拼出来的,所以它没法一个字母一个字母地画出来。2022 年的论文 Character-Aware Models Improve Visual Text Rendering 表明,让模型接触到单个字符就能解决大部分问题。Ideogram 的团队里有前 Google Imagen 的研究人员,它在 2023 年把文字渲染做成了卖点。到 2025 年,OpenAI 和 Google 的多模态模型对语言的理解不输任何聊天机器人,可读的文字已经成了常态。
修复是分阶段到来的,而在这中间,老问题漏进了现实世界。2024 年 2 月格拉斯哥的 Willy's Chocolate Experience 在其 AI 生成的海报上承诺“a pasadise of sweet teats”。长文本至今也没有完全解决。2025 年 12 月,Nano Banana Pro 在一张整体不错的信息图上把 “Lived experience” 变成了 Liver experience。
工作原理
用好这些模型不需要懂数学。但你得对背后发生了什么有个大致的印象,因为大多数意外都能由此解释。
扩散模型
大多数图像模型都是扩散模型。训练时,它们学习从图像中去掉噪声。拿一张照片,加上一点雪花点,教模型预测干净版本长什么样。在每个噪声水平上重复几十亿次。
要生成图像,则反过来跑:从纯静态噪声出发,在若干步中逐步去掉一点噪声。文本编码器把你的提示词变成数字,用这些数字引导每一步走向与提示词相符的图像。
有两个细节在实际使用中很关键。
- 它们工作在压缩空间里。 Latent diffusion 是 Stable Diffusion 背后的方法,它在一张内部画布上作画,每边比最终图像小约 8 倍,然后再解码。这就是为什么你不能要求生成 32 x 32 的图像,内部画布只有 4 x 4。
- 步数要花时间。 步数越多越慢,通常也越好,但只到某个程度为止。Flux Schnell、SDXL Turbo 这类“蒸馏”模型经过训练,用 4 步而不是 30 步就能得到不错的图像。
多模态模型
较新的做法是把图像生成放进一个同时懂语言的模型里。因为读提示词和画图的是同一个模型,这类模型在遵循指令、渲染文字、编辑你给的图像方面要好得多。GPT Image、Gemini 的图像模型和 Meta 的 Muse 都是这样工作的。有些模型在动笔之前会先推理布局,当提示词涉及东西放在哪里时,差别很明显。
多模态模型底层是扩散模型吗?
常常部分是,而且界限比宣传里说的更模糊。
OpenAI 关于 GPT-4o 图像生成的发布文章暗示了一种混合架构:语言模型像写句子一样,把图像规划成 token 序列,再由扩散式的解码器画出最终像素。Google 没有公开 Gemini 图像模型的工作方式。反方向看,Flux 这类现代“扩散”模型使用 transformer 块同时处理文本和图像,而这和聊天模型用的是同一种构件。
所以有用的区分不在数学上,而在图像模型对语言的理解有多深。指令遵循、可读的文字和编辑能力,都来自这一点。
对比
| 扩散模型(Flux、SDXL、Imagen) | 多模态模型(GPT Image、Gemini、Muse) | |
|---|---|---|
| 成本由什么决定 | 分辨率和步数 | 图像 token,通常按尺寸和质量档位固定 |
| 优势 | 便宜、快、可本地运行、种子能带来可重复的结果 | 遵循指令、渲染文字、能基于参考图编辑 |
| 劣势 | 对提示词的理解更字面 | 往往无法控制种子,输出尺寸固定 |
| 开放权重? | 常常有 | 很少有 |
种子
扩散模型起始所用的随机噪声由种子决定。相同的种子、相同的提示词和相同的模型会生成相同的图像,这正是批量生成可以复现的原因。许多托管模型会忽略或拒绝种子,因此在依赖种子构建任何东西之前,先确认它是否支持。
图像生成的类型
“图像生成”涵盖好几种不同的任务。多数服务商只支持其中一部分,而非全部。
| 类型 | 作用 | 示例用途 | 在哪里尝试 |
|---|---|---|---|
| 文生图 | 提示词变成图片 | 概念图、背景、占位图 | OpenAI 图像指南 |
| 图像编辑 | 在已有图像上“把杯子改成蓝色” | 在原有设计上迭代,不必从头再来 | Gemini 图像文档 |
| 参考图像 | 保持角色、产品或风格一致 | 同一个骑士的八种姿势 | Gemini 图像文档 |
| 局部重绘 | 重新生成一块被遮罩的区域 | 去掉一个物体、修复一只手 | Diffusers 局部重绘指南 |
| 扩图 | 把图像向边界之外延伸 | 把方图变成横幅 | ComfyUI 局部重绘与扩图示例 |
| 结构控制 | 按草图、姿势或深度图生成 | 精确匹配布局 | ControlNet 和 Diffusers ControlNet 指南 |
| 微调(LoRA) | 让开源模型学会新风格或新主体 | 统一的品牌风格或产品 | Diffusers LoRA 训练 |
| 放大 | 在更高分辨率下补充细节 | 从廉价批量结果里挑出好的再精修 | Real-ESRGAN |
| 去背景 | 把主体抠出来 | 透明精灵图和产品图 | rembg |
| 文生矢量图 | 输出 SVG 而非像素 | 图标和 logo | Recraft |
可平铺纹理值得单独一提。普通模型无法稳定生成无缝平铺的贴图,你需要专门为此训练的模型或 LoRA,或者工具里的平铺选项。
使用方式
| 途径 | 示例 | 适合 | 注意事项 |
|---|---|---|---|
| 聊天应用 | ChatGPT、Gemini | 一次性出图、快速修改 | 控制力弱,有使用限额 |
| 创意工具 | Midjourney、Adobe Firefly、Canva | 设计师、成品级效果 | 需要订阅,难以自动化 |
| 直接调用 API | OpenAI、Google Gemini 和 Vertex AI | 生产代码 | 每个 API 都不一样 |
| 聚合平台 | OpenRouter、Replicate、fal.ai | 用一个密钥试多种模型 | 部分平台有加价,模型会上下架 |
| 本地运行 | 用 mflux 或 ComfyUI 跑 Flux 或 SDXL | 免费批量生成、完全掌控 | 需要一块像样的 GPU 或 Apple Silicon,速度较慢 |
我做实验时刻意避开了订阅制,全部按张付费,走 API,或者在本地跑。
ChatGPT 能提供什么
大多数人第一次接触 AI 图像,都是在 ChatGPT 里敲一句需求。你实际拿到的是什么,值得先弄清楚。
ChatGPT 用的是 OpenAI 自家的 GPT Image 模型,从 2025 年 3 月起就内置在对话里了。
DALL-E 还在吗? 基本不在了。从 2023 年 10 月到 2025 年 3 月切换到 GPT-4o 图像生成之前,DALL-E 3 一直是 ChatGPT 的图像生成器。之后 OpenAI 于 2026 年 5 月 12 日把 DALL-E 2 和 3 从 API 中移除。这个名字如今主要作为 AI 图像的泛称继续存在。
它擅长什么
- 对话式修改。 你说“光再暖一点”或者“把杯子往左挪”,它就直接改,而不是从头重画。
- 遵循指令。 在版式、数量、具体细节上,它比早期的扩散模型处理得更好。
- 文字。 招牌、海报、标签上的字通常拼写正确。
- 参考图。 上传一张照片或草图,它会照着做。
它不擅长什么
- 控制。 只有几种宽高比可选,没有 seed,也没法批量跑。你没法要求正好 1024 x 512。
- 速度。 每张图从几秒到一分多钟不等,而且有使用额度限制,免费版尤其明显。
- 统一风格。 放任不管的话,它会滑向一种很好认的观感。2025 年那版模型以偏暖黄的色调著称,被戏称为“尿黄滤镜”。与其交给默认值,不如把想要的光线和色彩写清楚。
- 内容规则。 有些请求会被拒绝,比如某些语境下的真实公众人物,或者对受版权保护角色的高度还原。
溯源。 据 OpenAI 的帮助中心说明,它会给图像同时加上 C2PA 元数据和 SynthID 水印。Google 则给 Gemini 生成的图像加上 SynthID。元数据很容易被抹掉。水印经过截图后存活得更好一些,但如果你想证明一张图是不是 AI 生成的,这两样都靠不住。
ChatGPT 还是 API? 同一系列模型都可以通过 OpenAI 的 API 调用,按图片计费。API 提供固定列表中的尺寸、质量档位,可从代码批量调用,部分模型还支持透明背景。如果你需要的不只是几张图,或者要反复生成同一类图片,就用 API。Gemini 应用和 Gemini API 也是同样的道理。
成本
你为画布付费
我找到的最好用的心智模型,是一个只买得起大画布的画家:按画布收费,每一平方英寸都同样用心。一片纯蓝的天空和一张脸,花的功夫一样多。
- 简单的图不会更便宜。 模型在整张图上做的工作量是一样的。
- 你没法生成小图。 模型在 512 到 1600 像素左右效果最好。要一张 32 x 32 的精灵图,你得先生成大图,再自己缩小。
- 要求更小的尺寸往往没用。 我要 512 x 512,Gemini 2.5 Flash Image 返回的是 1024 x 1024,价格一样。
四种计费方式
| 计费方式 | 例子 | 做小一点有用吗? |
|---|---|---|
| 按张一口价 | Gemini 2.5 Flash Image、Recraft | 没用 |
| 按张计费,按尺寸和质量分档 | 较新的 Gemini 模型、OpenAI GPT Image | 有一点。最小档对多数需求来说仍是大画布 |
| 按百万像素或 GPU 秒计费 | Replicate、fal.ai、OpenRouter 上的大多数模型 | 有用 |
| 自己的电费 | 本地跑 Flux | 有用,省下的是速度 |
2026 年 10 月的行情
| 选项 | 每张图大致成本 | 适合 |
|---|---|---|
| 本地 Flux Schnell | $0,外加你的时间 | 反复调提示词、大批量生成 |
| Replicate 或 fal.ai 上的 Flux Schnell | 约 $0.003 | 便宜的云端批量生成 |
| Recraft V4.1 Flash(OpenRouter) | 约 $0.007 | 快速、便宜的插画 |
| FLUX 3 Image Klein(OpenRouter) | 约 $0.009 | 便宜的写实风格 |
| Meta Muse Image(OpenRouter) | 约 $0.01 | 遵循版式指令 |
| OpenAI GPT Image 1.5 | 0.034(medium)、$0.133(high) | OpenAI 的质量档位 |
| Gemini 2.5 Flash Image | 约 $0.039,走 Batch API 减半 | 修图和角色一致性 |
| Nano Banana 2(Gemini 3.1 Flash Image) | 1K 下约 0.067 | 更新更好,但更贵 |
| Nano Banana Pro(Gemini 3 Pro Image) | 约 $0.134 起 | 最终成品、主视觉级质量 |
较新的旗舰模型每张图更贵,而不是更便宜。便宜的一端是开放权重模型,以及“flash”“mini”“lite”这些档位。OpenRouter 的模型列表是比对当前价格最方便的地方。
每张可用图的成本
单看每张图的价格会误导人。
cost per usable image = (price per image x attempts needed) + your time
一个免费本地模型要试十次才成,可能还不如一个 $0.039、一次就对的模型。在我的实验里,贵出十分之一美分的模型省下了好几次重试。
有效的提示词写法
描述相机,而不是画面
我想给一款游戏做牌桌背景。这意味着要从正上方俯视一张桌子,边缘摆几样道具,中间留空放牌。
只写“从正上方俯视”不够。模型是从照片里学的,而大多数桌子的照片都是斜着拍的。我最初的几次尝试,出来的都是一张漂亮的桌子照片,背后有墙有窗,道具全挤在一侧。
两处改动解决了大部分问题。
- 描述相机。“正交平铺俯拍。相机垂直向下对准桌面,没有透视,没有地平线。桌面铺满整个画面,从一边到另一边。看不到墙、窗、地板或桌沿。”
- 写清楚东西放在哪。“把这些道具分散在四条边上(上、下、左、右),不要挤在一侧或堆在角落。每样道具都要小,并且被画面边缘切掉一部分。”
下面是同一个提示词,改成松木厨房餐桌,两处改动都加上,分别在两个不同的模型上跑。
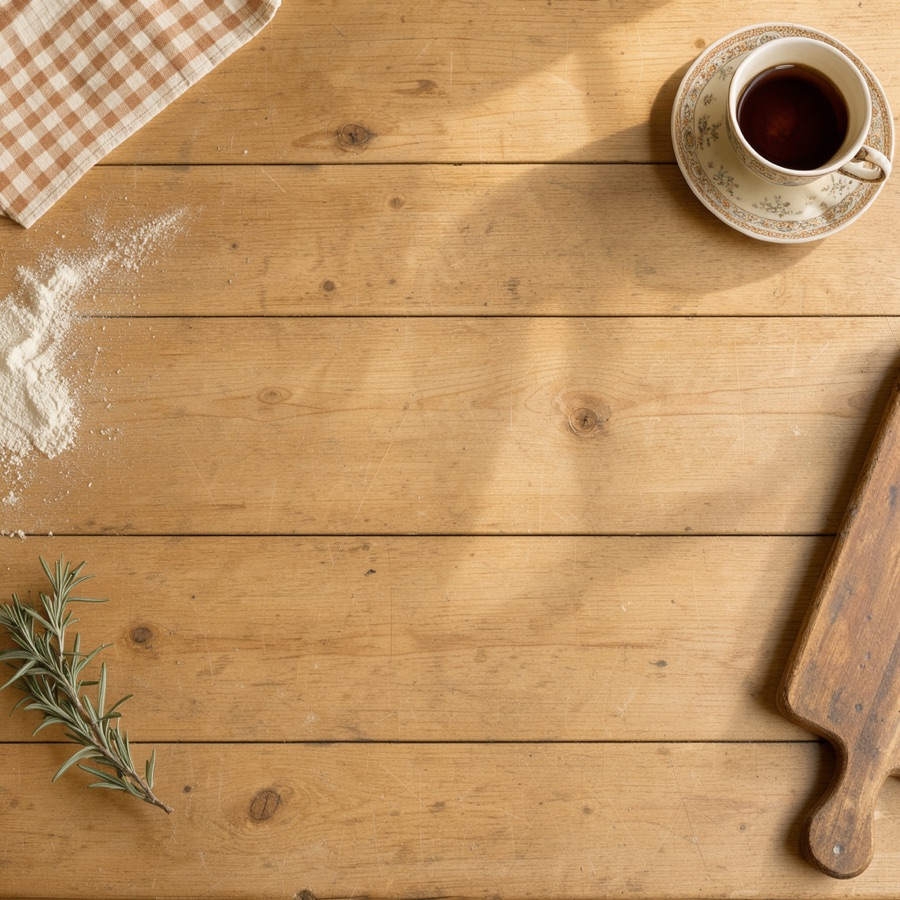
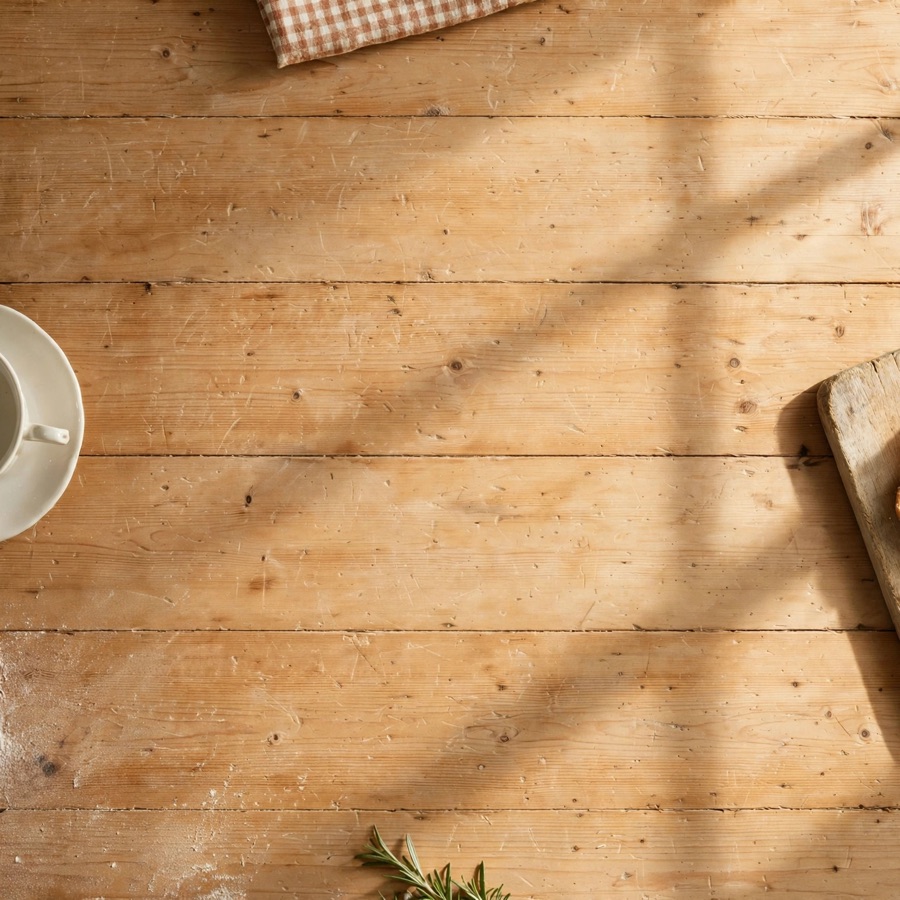
现在两者都是俯视构图。Flux 让道具保持完整,把它们推向四角。Muse 是一个先规划再作画的多模态模型,它把每件物品放在一条边上,逐一裁切,中间留空。
营销是 AI 图像挨批评最多的地方
海报、传单和信息图是 AI 图像最常见的用途之一,也是最容易显得廉价的地方。
- 胡言乱语。 Willy’s Chocolate Experience 的海报上写着“catgacating”和“exarserdray”。活动本身与图片相差太远,以至于有人报了警。
- 品味不佳。 A24 为 Civil War 制作的 AI 生成海报在 2024 年 4 月招致批评。海报呈现了电影里没有的场景,还有明显错误,比如一座芝加哥地标被以错误的角度重建。很多愤怒针对的是制片厂用 AI 而不肯花钱请艺术家。
- 事实出错。 Karen Spinner 的把一篇研究论文做成信息图的实验是个很好的例子,所有提示词和原始材料都公开了。结果“基本可用”,但试了六次才做到。过程中模型拼错单词、无视关于留白的指令,还把所有能填的空隙都填满。她的建议是文案写短,并且全部校对。
做一张不像 AI 生成的海报
于是我给自己出了个难题:能不能做出一张餐厅海报,让人不会一眼就看出是 AI?
第一次尝试是一张丝网印刷风格的小餐馆海报。我没有描述外观,而是描述了一个真实的印刷工艺:无涂布纸上印三种平涂专色,轻微套印不准,是扫描件而非照片,构图偏心,并点名一个设计传统。
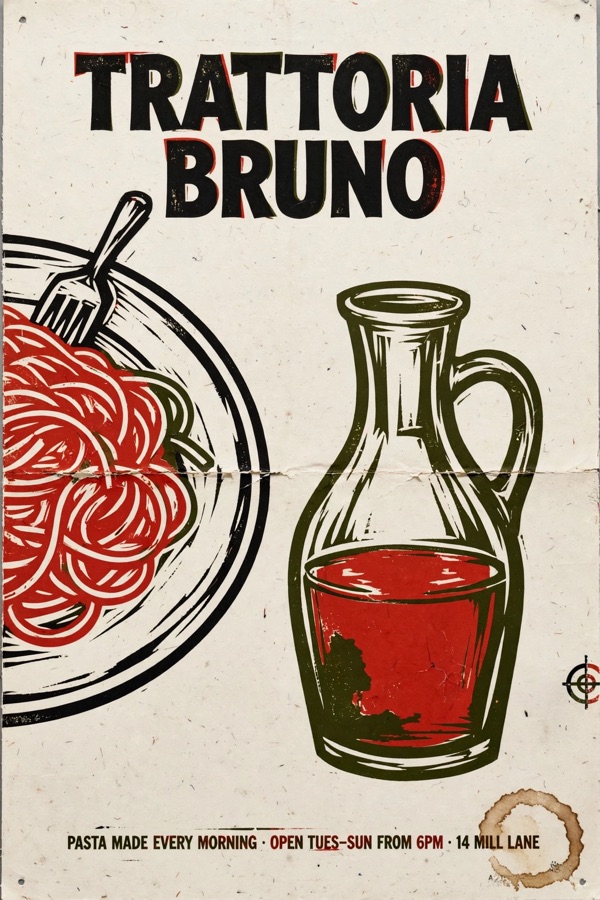
墨迹的质感很有说服力。底部那行字看着像干净的数字字体,但折痕可能有点过了。
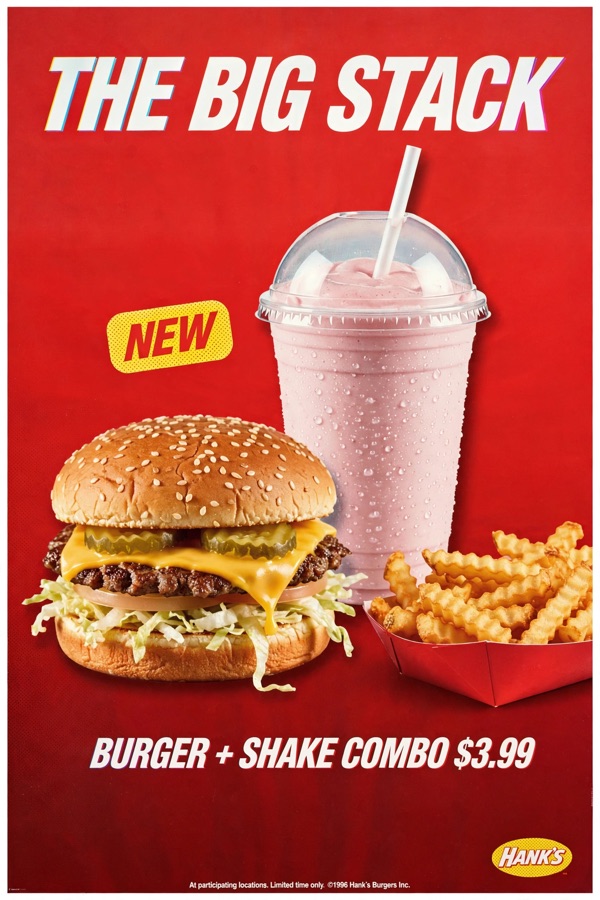
更难的一次测试是一张 90 年代汉堡海报,上面的食物看起来很真实。AI 生成的食物往往过于完美、过于油亮、过于英雄主义。我要求的是 1996 年中画幅胶片摄影,以及刻意不完美的食物,比如歪掉的汉堡面包和颜色发白的冬季番茄。
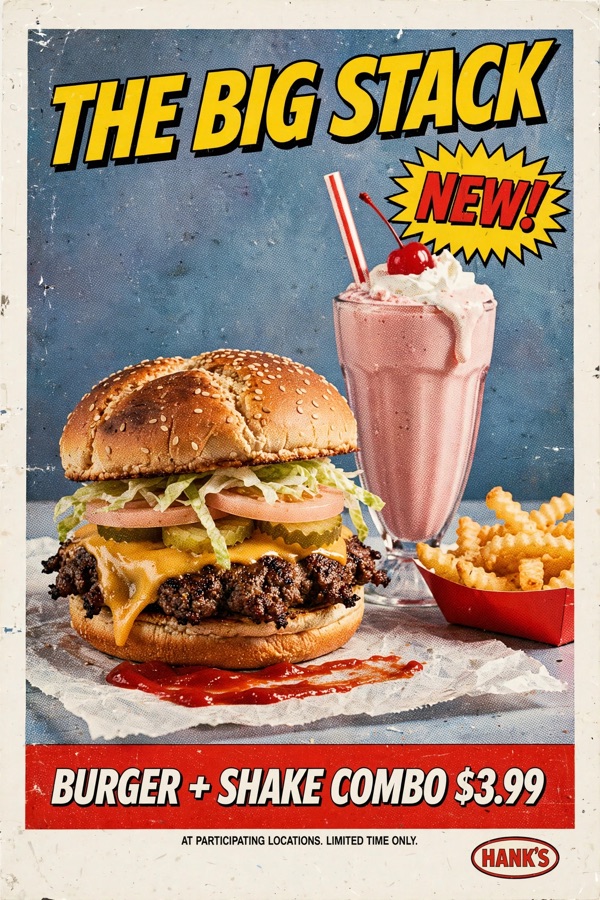
第一版的食物照片拍得不错,但整体像蒙了一层“复古”滤镜,配上漫画字体和做旧的磨损感。真正的 1996 年海报应该是干净、企业化的。
于是我把它做无聊了。一张纯净的扫描件,纯红背景加早期 Photoshop 的渐变,抠图产品照配一道均匀得有点过头的投影,再加上朴素的粗斜体字。我甚至要求它看起来“专业而略显平庸”。这一版扫一眼能过关。它算不上 1996 年,因为那杯奶昔是 2010 年代才有的拱盖杯。
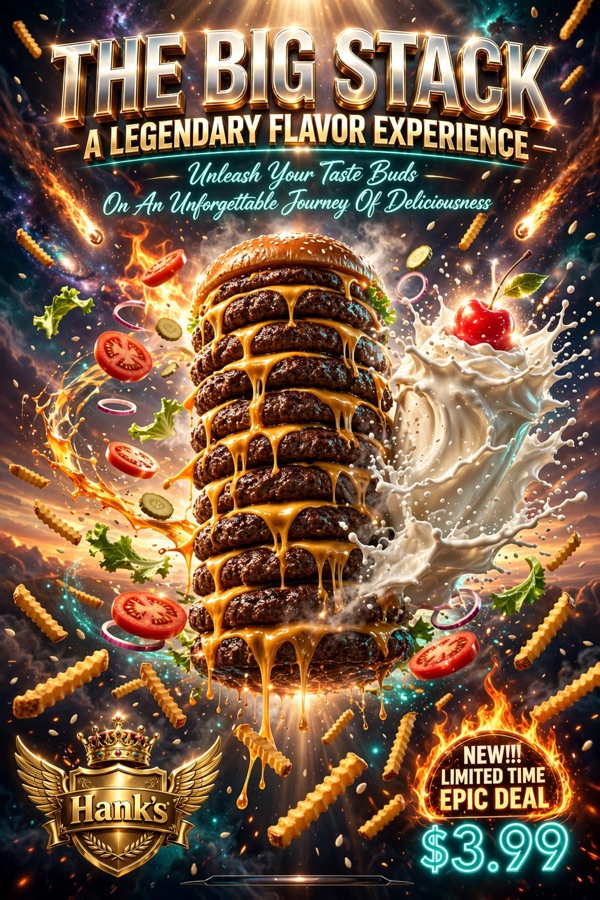
为了平衡,我又要了能想到的最糟版本。Unreal Engine、体积神光、悬浮食材,还有一片星系。它交出了十几个没有底面包的肉饼、一杯没有杯子的奶昔,以及从太空倾泻而下的薯条。和两年前的 AI 海报不同,如今拼写是对的。现在露馅的不是拼写,而是每个元素都拉到了满格。
提示词经验法则
- 描述它是怎么做出来的。 机位、镜头、胶片、布光、印刷工艺和扫描方式,都能给模型具体的约束。
- 去掉吹捧词。 “stunning”“hyper-detailed”“8K”只会把模型直接推向 AI 味。
- 对构图直说。 讲清楚什么占满画面、什么可见、每个元素放在哪里。
- 真正的设计是克制的。 要求“略显平庸”比堆再多细节都管用。
- 文字要短、要准。 用引号括起来,加上“每个词都严格按所写拼写”,然后校对结果。
- 点明年代细节。 不点名旧物件,模型就会往现代的东西上漂。
- 生成两三个。 同一提示词的变体往往差别很大,而一张只要一分钱,比改提示词便宜。
- 批量任务锁定模板。 同一类素材用相同的风格后缀和种子,整批才不会跑偏。
像素画
像素画和游戏精灵图看起来是图像模型最容易干的活。尺寸小、结构简单、颜色少。结果它们恰恰是绝佳的例子,说明 AI 图像生成比你以为的要难。
像素画是一种风格,不是一种格式
用 Gemini 2.5 Flash Image 生成一个像素画骑士花了 7.5 秒,成本约 $0.039。画面干净,复古感到位。
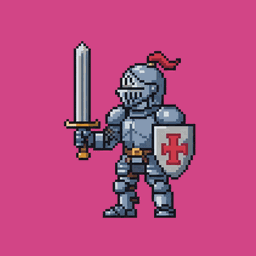
但这只是一张 1024 x 1024 的精灵图图片,并不是精灵图本身。“像素”大小参差不齐,没有落在真正的网格上,用的颜色也远多于真实调色板。“纯色”洋红背景其实是深浅不一的粉色。要让它真正可用,我还得用普通代码去掉背景、用最近邻缩放把它对齐到网格,并缩减调色板。
一张画布放多个精灵
如果按画布计费,而一个精灵只占画布的一小部分,最直接的做法就是让模型在一张图里画多个精灵。这样更便宜,也更一致,因为模型一次性画完所有内容,调色板和光照都相同。
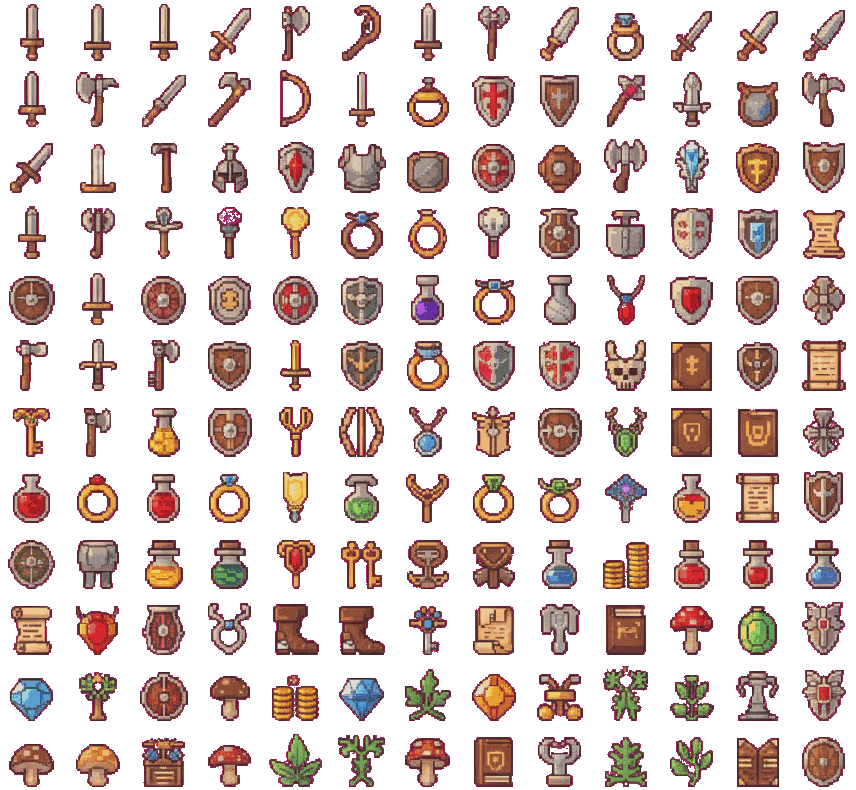
对于一组不同的物体,这招效果极好。我要 100 个奇幻物品栏图标,结果拿到 156 个,其中约 140 个各不相同,平均每个图标 0.00025。之后用普通代码按形状把它们切出来,去掉背景,再重新排到干净的网格上。
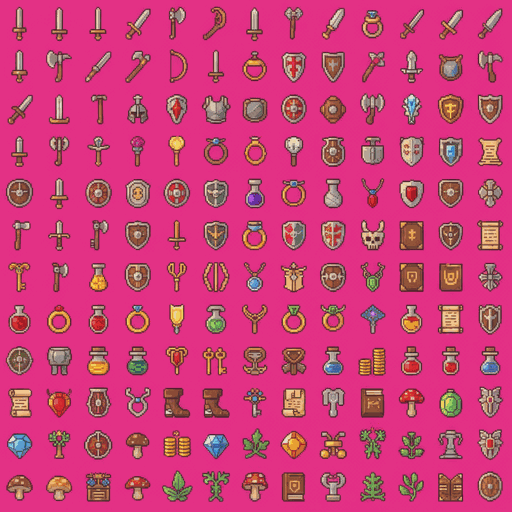
同一个角色画很多姿势,很快就会崩。4 x 4 的网格大概能给我 13 个不同的骑士姿势。要 10 x 10,结果同一个骑士被复制粘贴了 120 次。
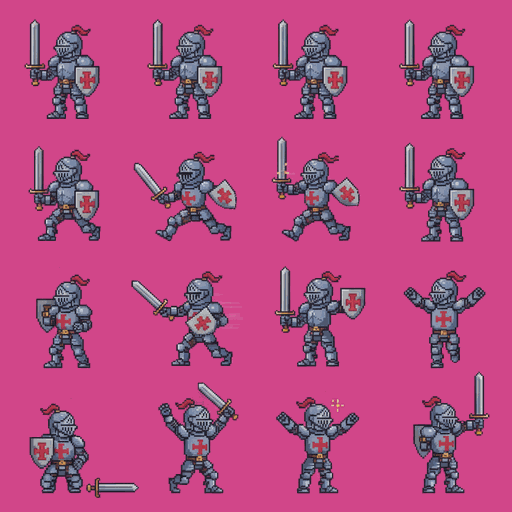
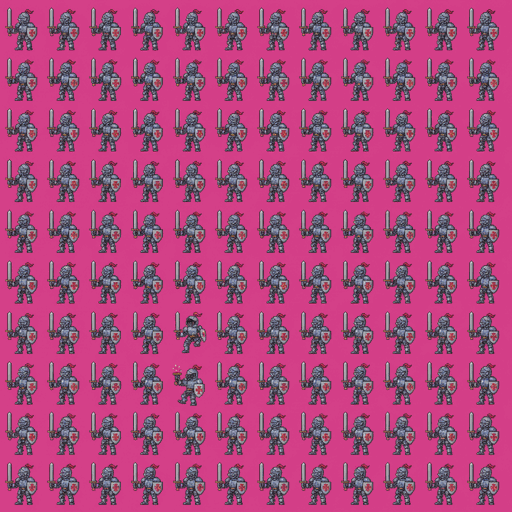
以下是我从七次调用、大约 0.27 美元里学到的东西。
- 最合适的量是物体组图约 10 x 10、角色姿势约 4 x 4。 要得更多,多样性和质量都会下降。
- 网格由模型决定,不是你。 我要 8 x 8,拿到的是 6 x 6。永远不要按固定网格切图,按形状去找精灵。
- 所有东西要一起缩放。 如果把每个精灵单独缩放到填满自己的格子,角色就会在动画帧之间忽大忽小。
正经做像素画
我做的只是用通用模型跑的一个基础实验。如果你需要像素画(一种非常特定的图像生成),有更好的路子。
PixelLab 是给游戏开发者做的。它按精灵的实际尺寸绘制真正的精灵,而不是画一张看起来像像素画的大图。调色板、描边、镜头角度和透明度都是设置项,不用写进提示词,它还能给角色做动画和旋转。它是订阅制,所以我这里没用。Retro Diffusion 是类似的商业选项。
想自己动手,可以用针对像素画训练的模型插件,比如 Pixel Art XL,再把结果缩到干净的网格上,在代码里修正调色板。PixelOE 也能不用 AI 把任意图片转成像素画。这对静态图片效果不错。动画的一致性上,商业工具仍然领先。
分界线在哪
矢量图是另一种看起来比实际简单的格式。LLM 能廉价地写出 SVG 代码,但角色出来很粗糙,因为它在描述一张自己看不见的图。像 Recraft 这样的专用文生矢量模型效果好得多,但比位图贵。
像素画给出的普遍结论是:AI 擅长回答“这应该长什么样”,不擅长“把恰好这个东西放进恰好这个格子”。关键不在于输出看起来多简单,而在于难的那部分是创意还是结构。创意交给模型,结构交给代码。
把图像生成接进编码项目
给每个提供商套一层薄接口
每家 API 都不一样。OpenAI 有独立的 images 端点。Gemini 把图片放在聊天式的响应里返回。OpenRouter 按模型分两个端点。本地 Flux 则是一个 Python 库或命令行工具。把这些统统藏在一个函数后面,换提供商就只是改配置。
from dataclasses import dataclass, field
from typing import Protocol

from PIL import Image

@dataclass
class GenerationResult:
    image: Image.Image
    provider: str
    model: str
    prompt: str
    seed: int | None = None
    cost_usd: float | None = None
    metadata: dict = field(default_factory=dict)

class ImageProvider(Protocol):
    def generate(self, prompt: str, *, width: int, height: int, seed: int | None = None) -> GenerationResult: ...
每个提供商的怪癖都关在各自的模块里。Base64 解码、奇怪的参数名、备用端点,这些都不该出现在你的应用代码里。
做好随时变天的准备
下面这些事,几个月内全让我碰上了。
- 模型会消失。 我打算用的 Flux 2 模型,在规划和动手之间就从 OpenRouter 上没了。Imagen 4 在 Gemini API 上被关停。Gemini 2.5 Flash Image 和 gpt-image-1 都定了退役日期,有的只提前几周通知。Gemini 弃用页面值得加进书签。
- 端点会变。 OpenRouter 把专用图像模型挪到了单独的
/api/v1/images端点,按老方式调用直接返回 404。我的代码现在先试一个,不行再退到另一个。 - 参数会被忽略或被拒。 Gemini 无视 size 和 seed。OpenAI 会把你给的尺寸吸附到几个固定值里最近的一个。FLUX 3 Klein 直接拒绝 seed。我要 1024 x 1024,Muse 返回了 1600 x 1600。
所以,提供商和模型放进配置,永远不要写死在代码里。拿到结果后检查尺寸和格式,别信你请求时填的值。给每个提供商跑一个定时冒烟测试,这样退役消息你会比用户先知道。
全都记下来
每张图都记下 prompt、模型、参数、输出尺寸、耗时和费用。费用上报各家口径不一。OpenRouter 返回计费金额。OpenAI 和 Gemini 只给 token 数,账自己算。有的什么都不返回。不自己记日志,你只能从月度账单上知道自己花了多少。
把 prompt 和参数跟每张图存在一起,几个月后你还能复现或微调一个好结果。
把生成当成一个慢且会失败的作业
- 速度慢。 从几秒到一分钟不等。不要放在 Web 请求里执行,交给任务队列,完成后通知用户。
- 会失败。 超时、限流、内容拒绝,偶尔还有空响应。用退避策略重试,但内容拒绝应当视为最终结果,不要拿同一个 prompt 反复重试。
- 每次调用都要花钱。 按 prompt 和参数的哈希缓存结果。凡是允许用户触发生成的入口,都要加上按用户计的限制。
精确的部分交给代码
模型只负责创意部分。抠图(rembg)、缩放、减色、裁剪、合成文字、打包 sprite sheet,这些在 Python 里都是免费、快速且确定性的。多数模型生成不出真正的透明背景,所以在纯色背景上生成,再抠掉。OpenAI 的部分 GPT Image 模型是例外,提供了透明背景选项。
如果图片里需要精确的文字,比如价格或日期,可以考虑生成不带文字的图,再用代码把文字加上去。这是保证拼写正确的唯一办法。
不花钱也能测
单元测试里用一个返回固定图片的假 provider。真实 API 调用只留给少量冒烟测试。开发时用便宜的模型,生产配置里再换成更好的。
与 agent 集成
图像生成和 AI agent 配合得很好。多模态 agent 可以写出详细的 prompt、调用模型、查看结果、给出批评、再试一次。这个循环过去需要人来完成。
Claude 不生成图像
如果你在用 Claude Code,要记住它内置的模型不会生成照片、绘画这类位图。Anthropic 的帮助中心写得很清楚。Claude 能查看和分析图像,也能用 SVG、HTML 这类代码画示意图、图表和交互式可视化。
它的模型面向文本、代码和 agent。图像生成周边的环节,比如写详细的 prompt、判断结果是否符合要求,Claude 都很擅长。你通过工具把它接到专门的图像模型上,让各自做擅长的事。
三种接入方式
- 命令行工具。 最简单的做法。如果你的 agent 能执行 shell 命令,给它一个像
python -m image_gen generate --model meta/muse-image --prompt "..."这样的脚本,告诉它输出写到哪里就行。我就是这么做的。 - MCP server。 Model Context Protocol 可以把图像生成作为一个工具暴露给任何兼容 MCP 的 agent,比如 Claude Code、Claude Desktop 或 Cursor。agent 看到的是一个带描述的类型化工具,不用去学你的脚本怎么用。
- 在自己的 agent 里做 function calling。 如果你自己写 agent,在调用 LLM API 时定义一个
generate_image工具,模型请求时再执行生成。
一个最小的 Python MCP server 大致长这样。
from mcp.server.fastmcp import FastMCP, Image

from image_gen.config import get_provider

mcp = FastMCP("image-gen")

@mcp.tool()
def generate_image(prompt: str, width: int = 1024, height: int = 1024) -> Image:
    """Generate an image from a detailed prompt. Costs about $0.01 per call."""
    result = get_provider("openrouter", model="meta/muse-image").generate(prompt, width=width, height=height)
    path = save_with_metadata(result)  # your own logging and storage
    return Image(path=path)

if __name__ == "__main__":
    mcp.run()
返回图像本身而不只是文件路径,agent 才能看到自己生成了什么。
本指南中的实验是怎么跑的
本指南里的每一张图都是这么做的:用 Claude Code 当 agent,配一个小 Python 脚本调用各家服务商。我用大白话描述想要什么。Claude 负责写出详细的 prompt,从 OpenRouter 的价格表里挑模型,运行脚本,逐张打开图片,然后如实告诉我哪里不对。中途 OpenRouter 改了 API,它自己发现了报错,改好代码继续跑。
agent 驱动生成的几点建议
- 让 agent 来写 prompt。 LLM 很擅长把“一张不像 AI 做的 90 年代汉堡海报”变成详细、结构化的 prompt。本指南里的海报 prompt 都是这么写出来的。
- 确保它能看见输出。 价值就在点评这一步。看不见图片的 agent,只是调用 API 的一种慢办法。
- 把成本写进工具描述。 agent 知道一次调用花一美分还是十五美分,决策会更好。
- 设个预算。 反复尝试改进一张图的循环能把账单堆起来。限制调用次数或每个会话的花费。
- 要求它如实批评。 让 agent 列出每张图的问题,而不只是说做完了没有。我那张 1996 年海报里的 2010 年代奶昔杯,就是 agent 发现的。
- 品味的事留给人。 agent 擅长对照 brief 检查图片。brief 本身定得对不对,仍然是你的事。
术语表
另见 AI 术语表。
- Diffusion(扩散) - 从随机噪声出发,在提示词引导下逐步去噪,最终生成图像。
- Latent(潜空间) - 扩散模型实际工作的压缩内部画布。小尺寸输出行不通,原因就在这里。
- Steps(步数) - 扩散模型执行去噪的轮数。步数越多越慢,通常也越好,但有上限。
- Distilled model(蒸馏模型) - 经过训练、能在少量步数内产出良好结果的模型,例如 Flux Schnell 或 SDXL Turbo。
- Seed(种子) - 随机的起点。在支持的情况下,相同的种子、提示词和模型会得到相同的图像。
- Tokeniser(分词器) - 模型中负责把文本切分成片段的部分。老模型拼不对单词,原因就在这里。
- Tokens(token) - 多模态模型计量输出的单位。对图像而言,每个尺寸和画质对应固定数量。
- Open weights(开放权重) - 可以自行下载并运行的模型,例如 Flux 或 SDXL。
- LoRA - 一种小型附加组件,无需重新训练就能让开放模型学会新的风格或主体。
- ControlNet - 让扩散模型遵循草图、姿态或深度图的一种方式。
- Inpainting(局部重绘) - 只重新生成图像中被遮罩的部分。
- C2PA - 一种元数据标准,记录图像的生成方式,包括是否有 AI 参与。
- SynthID - Google 为 AI 生成内容添加的隐形水印。
- MCP - Model Context Protocol,让 AI agent 访问工具的标准方式。
- Nearest-neighbour(最近邻) - 直接复制像素而非混合像素的缩放方法。像素画必备。
- Orthographic(正交) - 没有透视的视图。俯拍镜头常用的提示词用语。
资源
- OpenRouter 图像模型 - 比较价格,用一个 API key 试用几十个模型
- OpenAI 图像生成指南 - GPT Image API
- Gemini 图像生成文档 - Nano Banana 及其同类
- Gemini API 弃用公告 - 基于 Gemini 模型开发前值得先查一下
- mflux - 在 Apple Silicon 上本地运行 Flux
- ComfyUI - 基于节点的本地工作流,支持 ControlNet 和 LoRA
- Hugging Face Diffusers - 大多数开放模型工具背后的 Python 库
- rembg - 用 Python 去除背景
- Replicate 和 fal.ai - 适合大批量任务的廉价托管开放权重模型
- Model Context Protocol - 把图像生成能力开放给 agent
- C2PA - 内容来源标准
- 为什么 AI 图像生成器总是写不对文字 - 一篇讲拼写问题的通俗解读