中国の最先端 AI モデルは輸出規制対象の NVIDIA Blackwell GPU の指紋を帯びている
2026 年 4 月以降、6 つの中国製モデルに、対中輸出規制の対象となる NVIDIA Blackwell GPU の数値レイアウトが含まれている。著者は各モデルの公開重みから初期シードを復元し、スレッドレイアウトを照合した。
日本語
コピー
要旨
公開されている AI モデルをフォレンジック分析した結果、DeepSeek、Moonshot AI、MiniMax、アント・グループが対中輸出規制の対象である NVIDIA の Blackwell GPU を入手し、そのハードウェアで自社モデルを訓練していることを示す証拠が見つかった。 2026 年 4 月以降にこれら各社が公開した 6 つのモデルには、Blackwell ハードウェアと一致する数値的特徴が含まれている。一方、それ以前のモデルは NVIDIA の前世代にあたる Hopper と一致する。この結果は、中国の主要 AI 開発企業数社が最新モデルの訓練に Blackwell を使い始めたことを示している。米国の当局者やメディアは以前から DeepSeek と Moonshot AI による Blackwell の使用を指摘してきたが、技術的な証拠は公表されていなかった。
証拠はすべて、モデル自身が公開している重みに由来する。内部告発や関係者の証言ではない。モデルの初期値に残る痕跡を復元し、その痕跡を再現できるハードウェア構成と初期設定を探索した。DeepSeek-V4-Flash と Kimi K3 については、実際の Blackwell チップ上で一致を検証した。この指紋が特定するのは重みの生成方法である。Blackwell が訓練にも使われたという推論を支えるが、証明はしていない。特殊な構成の AMD ハードウェアが我々の特定した唯一の代替候補で、これも対中輸出規制の対象だが、DeepSeek-V4-Flash では排除し、残る 5 モデルでも可能性は極めて低いと判断した。今回の発見は先端計算ハードウェアの入手を示す技術的証拠だが、チップの所在や入手経路、輸出規制違反の有無までは特定していない。
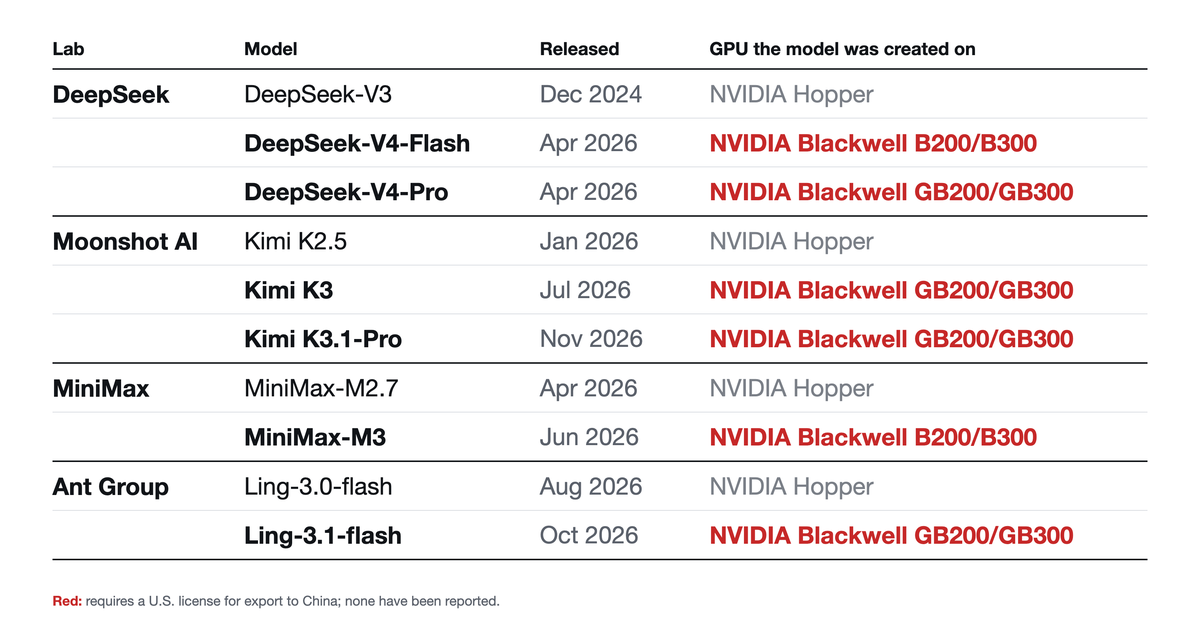
表 1. DeepSeek、Moonshot AI、MiniMax、アント・グループの歴代モデルにおけるハードウェア指紋
| ラボ | モデル | 公開時期 | モデルの起動に使われたチップ |
|---|---|---|---|
| DeepSeek | DeepSeek-V3 | 2024 年 12 月 | NVIDIA Hopper(ラボの公表値は H800) |
| DeepSeek-V4-Flash | 2026 年 4 月 | • NVIDIA Blackwell B200/B300 | |
| DeepSeek-V4-Pro | 2026 年 4 月 | • NVIDIA Blackwell GB200/GB300 | |
| Moonshot AI | Kimi K2 | 2025 年 7 月 | NVIDIA Hopper(ラボの公表値は H800) |
| Kimi K2.5 | 2026 年 1 月 | NVIDIA Hopper(ラボの公表値は H800) | |
| Kimi K3 | 2026 年 7 月 | • NVIDIA Blackwell GB200/GB300 | |
| Kimi K3.1-Pro | 2026 年 11 月 | • NVIDIA Blackwell GB200/GB300 | |
| MiniMax | MiniMax-M2.7 | 2026 年 4 月 | NVIDIA Hopper |
| MiniMax-M3 | 2026 年 6 月 | • NVIDIA Blackwell B200/B300 | |
| アント・グループ | Ling-3.0-flash | 2026 年 8 月 | NVIDIA Hopper |
| Ling-3.1-flash | 2026 年 10 月 | • NVIDIA Blackwell GB200/GB300 |
• 中国への輸出には米国の許可が必要。関連する報道は今のところない。
Hopper の指紋では H800 と H100 SXM、H200 を区別できない。上記の H800 という判定はラボの公表に基づくもので、本手法による発見ではない。
モデルの完全な一覧は付録 2 ↓
主な発見
- 中国の 4 ラボによる 6 モデルが、Blackwell での訓練を示す読み取り結果となった。 DeepSeek-V4-Flash と MiniMax-M3 は、NVIDIA の Blackwell 級チップである B200 または B300 と一致した。両チップは 148 個のプロセッサコア(ストリーミングマルチプロセッサ、SM)を備える。DeepSeek-V4-Pro、Kimi K3、Kimi K3.1-Pro、Ling-3.1-flash は GB200 または GB300 と一致した。同じ Blackwell 級で、プロセッサコアは 152 個である。Kimi K3.1-Pro は K3 と同じ乱数シードを使っており、K3 に追加の後訓練を施したチェックポイントである可能性がある。
- 中国のラボが Blackwell 訓練へ移行したのは比較的遅い。 DeepSeek のモデルは DeepSeek-V3(2024 年 12 月公開)まで Hopper 訓練と読め、DeepSeek-V4(2026 年 4 月公開)から Blackwell と読める。Moonshot のモデルは Kimi K2.5(2026 年 1 月)まで Hopper、K3(2026 年 7 月)から Blackwell と読める。Moonshot にはその中間にあたるモデルが 1 つある。K3 の 6 週間前に公開された Kimi K2.7-Code は Hopper 時代の重みを土台にしているが、そのごく一部が B200 または B300 と一致する。MiniMax のモデルは M2.7(2026 年 4 月)まで Hopper、M3(2026 年 6 月)から Blackwell と読める。アント・グループは Ling-3.0-flash(2026 年 8 月)が Hopper、Ling-3.1-flash(2026 年 10 月)が Blackwell と読める。Hopper の読み取り結果からは具体的なチップを特定できない。H800、H100 SXM、H200 の指紋は同じである。
- 中国の AI ラボすべてが Blackwell に移行したわけではない。 読み取りが可能だった Alibaba(Qwen)、Zhipu(GLM)、Tencent、Xiaomi、StepFun の最新モデルは、いずれも Hopper での訓練と読める。Meituan は LongCat-2.0 を全面的に「AI ASIC スーパーポッド」で訓練したとしているが、公開されたモデルの重みから NVIDIA の指紋は見つからなかった。
- 本手法は既知の正解に到達できる。 開発者が使用ハードウェアを公表しているモデルが 24 個ある。そのすべてで、本手法の結果は公表内容と一致した。NVIDIA 自身の Nemotron-3 Ultra は技術レポートで訓練のある段階に GB200 を使ったと明記しており、読み取り結果は 152 SM で Kimi K3 と同じだった。
- これらの一致は偶然では説明できない水準にある。 組み合わせを十分に試せば、無関係な数値でも一致して見えることがある。今回の探索ではシードとレイアウトの組み合わせが約 6 兆通りあり、偶然による最強の一致でも 8σ 程度(σ は通常のランダムな変動からどれだけ外れているかを表す指標)にとどまると見積もられる。6 モデルそれぞれの最強の証拠は 49 から 1,385σ の間にあった。報告した中で最も弱い単独の検定でも 20σ に達している。
- これらの学習ジョブはデータセンター規模に達している。 各モデルのパラメータ規模と学習に使われたデータ量から試算すると、最大の 2 件である Kimi K3 と DeepSeek-V4-Pro では、それぞれ数千基の Blackwell GPU を 2〜3 か月動かす必要がある。ただし各モデルが、その初期化に使われたハードウェア上で学習された場合の話だ。最も信頼できる推定値はそれぞれ約 4,500 基と約 3,000 基で、H100(NVIDIA の前世代チップ。業界はこれで AI 学習クラスタの規模を測るのが通例)に換算すると約 11,500 基と約 7,500 基に相当する。5 件の学習ジョブを合計すると約 12,000 基の Blackwell GPU が必要になる(表 2)。1 基あたり約 7 万ドル(約 3 万 6,000 基の Blackwell チップを ByteDance 向けにマレーシアへ設置すると 25 億ドルを超えるという『ウォール・ストリート・ジャーナル』の報道から導いた単価)で計算すると、最大のクラスタで約 2 億〜3 億ドル、5 つのクラスタ合計で 5 億ドルを超える。これらの数字は最終的な学習実行のみを対象としている。輸出規制の対象となる GPU への各ラボの総支出は、数十億ドルに達している可能性が高い。
表 2. 各学習実行のおおよその規模
| モデル | H100 換算数 | Blackwell GPU の最良推定 | Blackwell の範囲 | 推定実行期間 |
|---|---|---|---|---|
| DeepSeek-V4-Flash | 3,500 | 1,500 | 250〜5,000 | 50 日 |
| DeepSeek-V4-Pro | 7,500 | 3,000 | 750〜6,500 | 70 日 |
| Kimi K3 | 11,500 | 4,500 | 1,000〜9,500 | 70 日 |
| MiniMax-M3 | 3,500 | 1,500 | 200〜7,000 | 60 日 |
| Ling-3.1-flash | 4,000 | 1,500 | 400〜6,500 | 100 日 |
| 5 件合計 | 30,000 | 12,000 | 7,000〜22,000 |
各推定値は、1 回の実行の学習計算量を、その実行期間中に Blackwell GPU 1 基が供給する計算量で割ったもので、最も近い 500 に丸めている。学習計算量は、学習トークンあたりのアクティブパラメータ 1 つにつき 6 演算とし、アテンション部分を加えた。GPU はピーク性能の約 20%で動作すると仮定した。これは他の公表済み Blackwell 学習実行と整合する(DeepSeek は 25%、その前世代モデルでは 39%と報告されていた)。実行期間は表に示した値を用い、公開されたタイムラインから我々が推定した。H100 換算数は NVIDIA 公表のピーク性能で換算した。B200 または B300 は H100 約 2.3 基、GB200 または GB300 は約 2.5 基に相当する。
これらの推定には確信が持てない。重みからは裏付けられない仮定に依存しているからだ。各ラボが GPU をどれだけ効率よく使ったか(一般に MFU と呼ばれる)は、どのラボもこれらの実行について公表していない。各モデルが学習に使ったトークン数(DeepSeek の数字は同社自身によるもので、我々はそれを採ることにした。それ以外は我々自身の推定で、未発表の手法により重みから逆算した)。各実行がどれだけ続いたかは、どのラボも明らかにしていない。そして学習が常に、その重みを生成したハードウェア上で完了したかどうかも不明だ。影響が最も大きいのは実行期間で、これが半分になれば GPU 数は倍になる。同じハードウェア上で公表された 2 件の実行が、その差の大きさを示している。Mistral は Mistral Large 4 を 3,800 基の Grace Blackwell GPU で学習したと述べており、そのアクティブパラメータ数は DeepSeek-V4-Pro と同じだ。Microsoft は MAI-Base-2 を 16,000 基の GPU で 38 日間にわたり学習したと述べている。規模は近く、学習データはより多い。この速度で計算すると、本稿で最大の 2 件の実行には約 8,000〜9,000 基の Blackwell GPU が必要になる。これらの数字は各モデルの最終的な学習実行のみを対象とし、実験やそれ以前の実行、推論サービスは含まない。
2026 年 11 月 12 日改訂。本レポートの初版では 2,000〜3,000 基の Blackwell GPU、最大クラスタで 1 億 5,000 万〜2 億ドルという数字を示していた。これらの数字は、GPU が NVIDIA 自身のベンチマーク並みの効率で動作することを前提としていたが、公表済みの Blackwell 学習実行の効率はそれを下回る。上記の推定がこれらの数字に取って代わる。H100 換算の計算量と推定実行期間も追加した。
我々の調査
モデルの重み(パラメータとも呼ばれる)は、数十億個の調整可能な数値で、モデルが情報をどう処理し、回答をどう生成するかを決める。学習プロセスはこれらの数値を繰り返し調整するが、学習が始まる前には初期値が必要だ。本稿で取り上げるソフトウェアでは、この初期値は Philox という疑似乱数生成(PRNG)アルゴリズムから供給される。Philox は決定的な方法で、ランダムに見える数値を生成する。Philox への入力の起点は「シード」と呼ばれる数値だ。シードと設定が同じであれば、Philox は毎回同じ数値を生成する。だからエンジニアは同じ出発点から実験を再現できる。
PyTorch(大多数主要 AI モデルの開発に使われるソフトウェアフレームワーク)は、数十億個の重みを高速に埋めるために、Philox の処理を GPU 上の多数の並列ワーカー、すなわちスレッドに分担させている。(実装は NVIDIA の乱数ライブラリである cuRAND が担う。)各スレッドはシードに基づいて独自の数列を生成し、決まった位置の集合を埋めていく。この位置がどう割り当てられるかはスレッド数で決まる。本記事で検討する NVIDIA のチップでは、十分に大きな初期化を行うと、各処理ユニット(ストリーミングマルチプロセッサ、SM)が 2,048 スレッドの上限を使い切る。したがって SM の多いチップほど同じ処理をより多くのワーカーに配分することになり、数値の落ちる場所も変わる。
図 1 は、簡略化した GPU 上での動作を示している。SM が 6 個、各 SM に 8 スレッド、合計 48 スレッドだ。重みを長い一列の空き箱と考え、ページに収めるために格子状に折りたたむ。最初のスレッドが最初の箱を、2 番目のスレッドが 2 番目の箱を埋め、48 スレッドすべてが埋め終わるまで続く。次に最初のスレッドの次の数値が 49 番目の箱に入り、その次は 97 番目の箱に入る、という具合だ。黒い輪郭がこのスレッドの格子内の経路をなぞっている。最初のスレッドは 48 個おきの位置を埋める。色は各数値をどの処理ユニットが供給したかを示し、右図の明るさは数値そのものを表す。
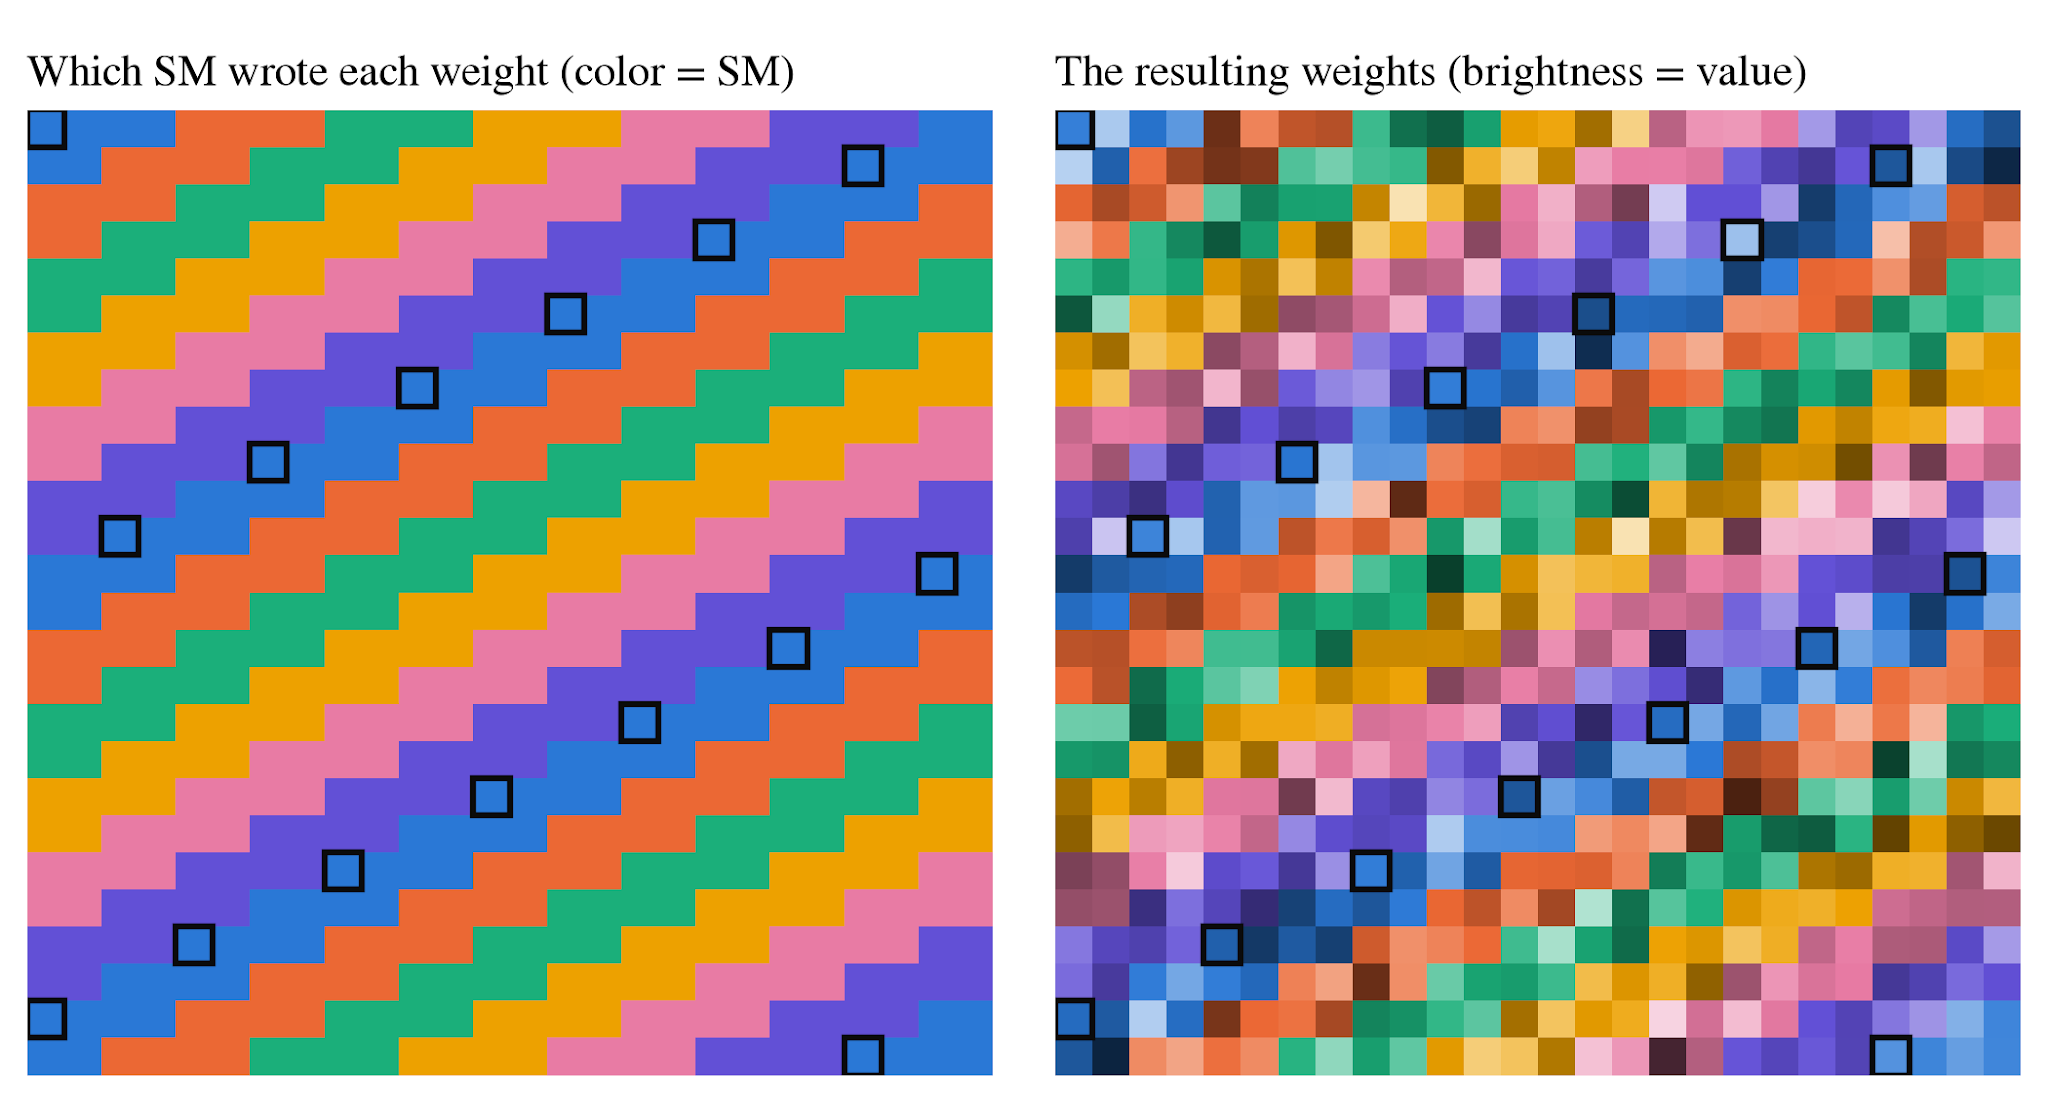
図 1. GPU が重みを埋める仕組み。この簡略例では処理ユニット 6 個、各ユニット 8 スレッド、合計 48 スレッドを使う。枠線のセルはスレッド 0 に属し、48 個おきの位置を埋めている。実際のチップはずっと多くのスレッドを使うが、配置の規則は同じだ。
ここでシードを変えずに、SM 6 個ではなく 5 個の GPU を使ってみる。簡略例では 48 スレッドではなく 40 スレッドになる。最初のスレッドが生成する数列はまったく同じだが、その数値は 1、49、97 番目ではなく 1、41、81 番目のセルに入る。図 2 は、位置を変えたときにこれらの数値がどうなるかを追ったものだ。格子全体で、元の配置と一致する数値は 6% しかない。シードは正しく、スレッド数が違う。だからこそ、モデルの重みの配置は、使われたチップを突き止める手がかりになる。
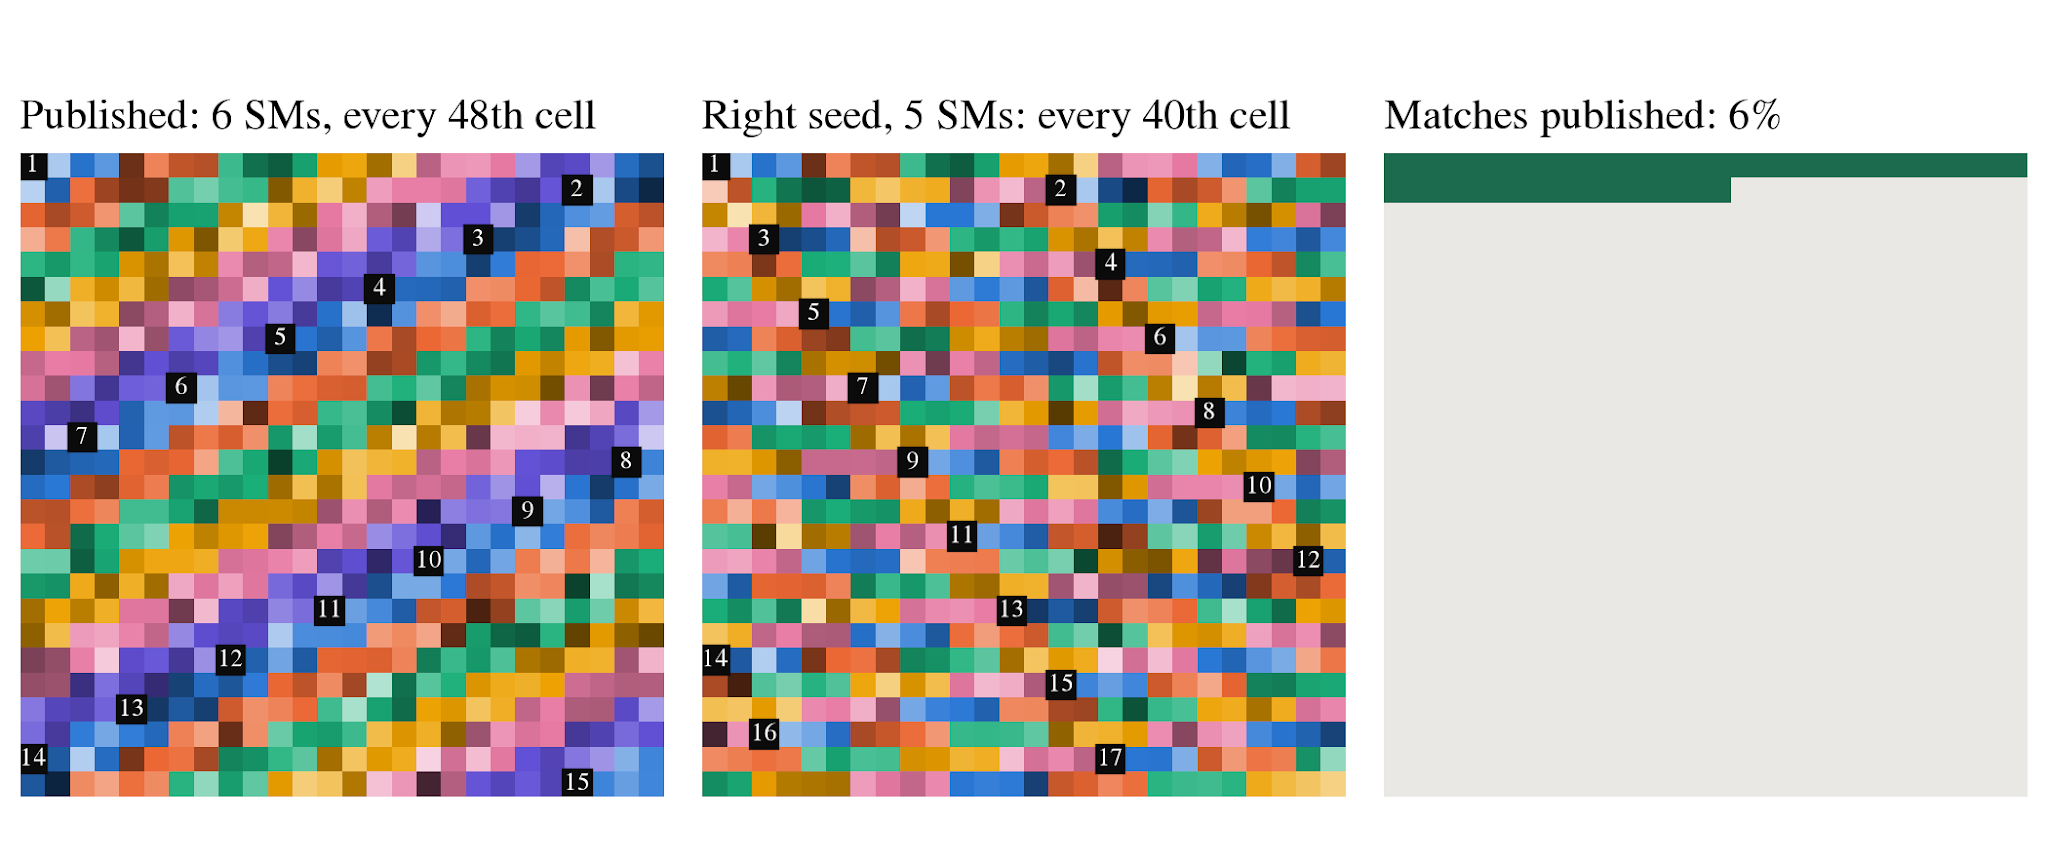
図 2. 同じシード、違う GPU。このおもちゃの例では処理ユニット 5 個、40 スレッドで、スレッド 0 は同じ数列を生成するが、48 個おきではなく 40 個おきの位置を埋める。表示された行列のうち元の配置と一致するのは 6% だけだ。
つまり重みを再現するには、二つの条件を同時に満たす必要がある。シードが正しい数値を生成すること、そしてスレッド数がそれを正しい位置に置くことだ。シードが正しくスレッド数が違えば、たいていは正しい数値が誤った位置に落ちる。スレッド数が正しくシードが違えば、別の数値になる。図 3 は、正しい組み合わせだけが元の配置を再現できる理由を示している。
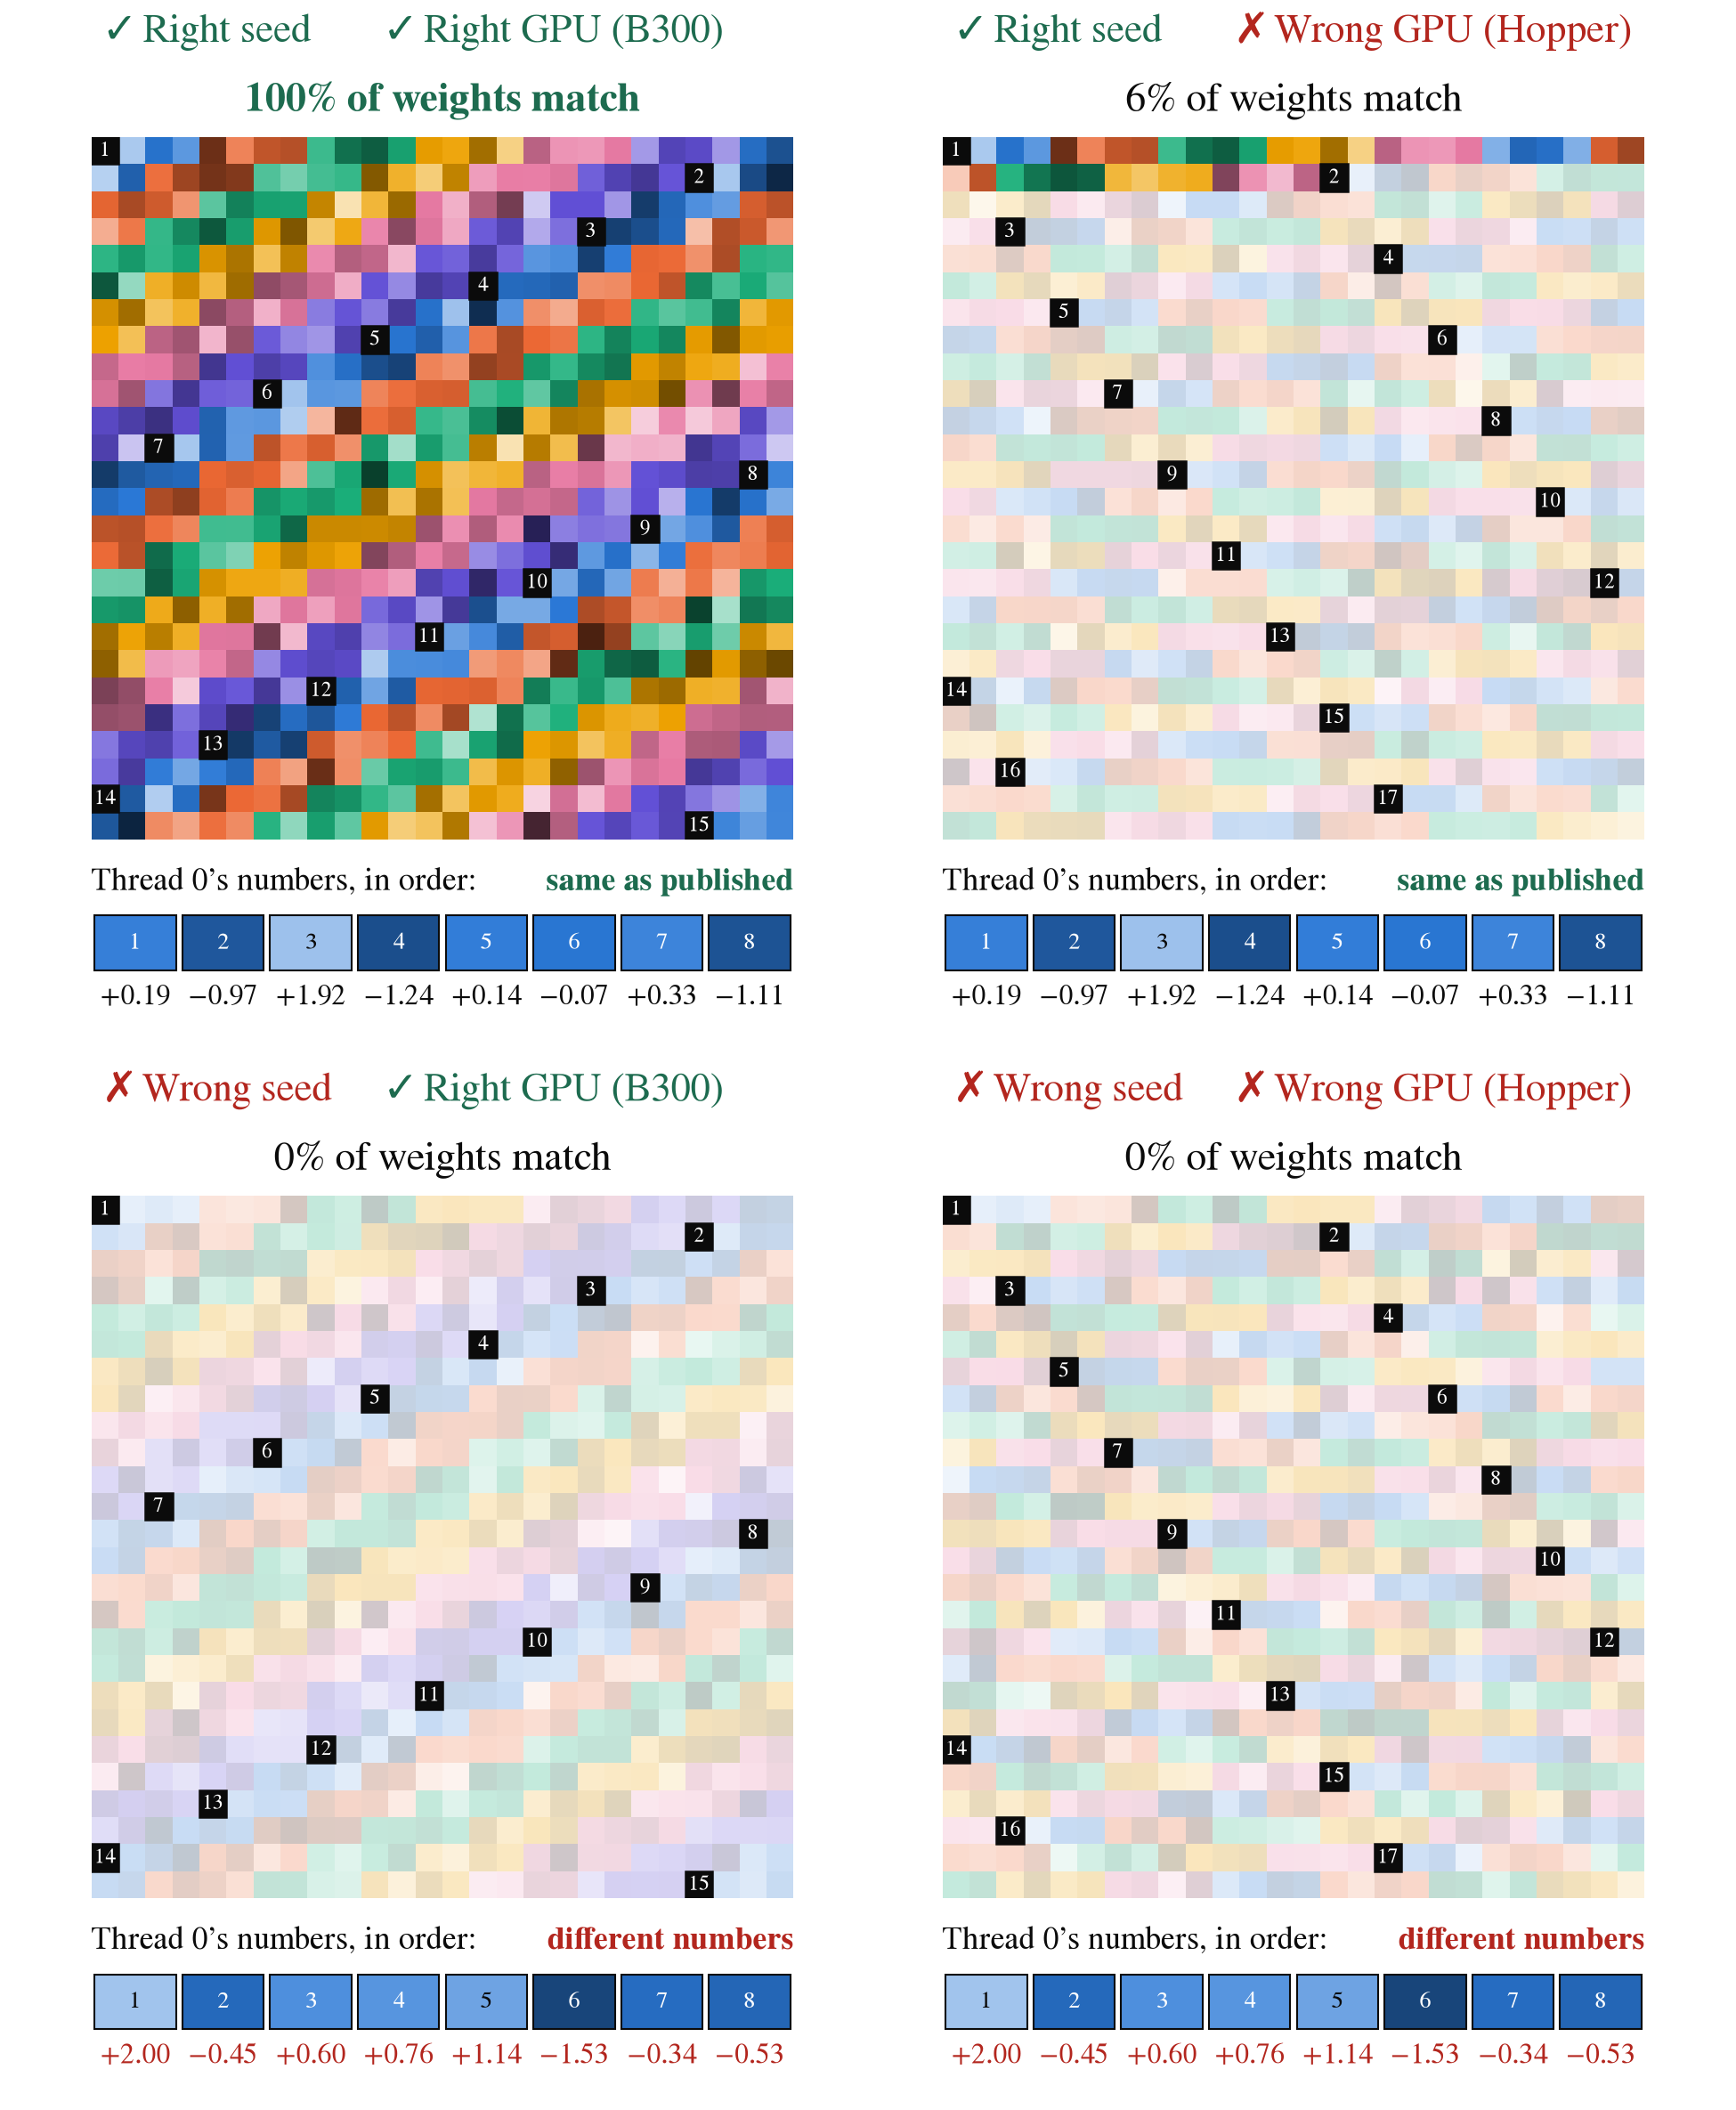
図 3. シードとレイアウトは両方そろわなければならない。元の行列を再現できるのは、シードとスレッド数の両方が正しいときだけだ。どちらか一方を変えると、一致の大部分が消える。簡略化したチップはそれぞれ Blackwell B300 と Hopper H100 を表す。色の薄いセルは公開された重みと異なる。番号付きのセルはスレッド 0 の数値がどこに落ちるかを示し、各パネル下の帯はその数値そのものを表す。
実際のチップではスレッド数ははるかに多いが、原理は同じだ。本記事で検討する NVIDIA の構成では、Hopper H100 SXM、H200、H800 は SM 132 個で 270,336 スレッド、Blackwell B200/B300 は SM 148 個で 303,104 スレッド、Blackwell GB200/GB300 は SM 152 個で 311,296 スレッドを使う。したがってスレッド数が分かれば、初期配置がどのハードウェア群に対応するかは特定できるが、同じ群の中の個々のチップは区別できない。たとえば Hopper に一致したところで、H800、H100、H200 を区別することはできない。
問題は、この配置が学習後にどれだけ残っていて、そこから復元できるかだ。学習中に一度も現れなかった語や記号に割り当てられた重みなどは、最後まで触れられずに初期値のままほぼ残ることがある。こうした残存値を、候補となるシードとスレッド数から生成した初期値と直接比べればよい。図 4 はそうした比較を示している。DeepSeek-V3 の残存した重みは Hopper の配置と一致し、DeepSeek-V4-Flash のものは Blackwell の配置と一致する。
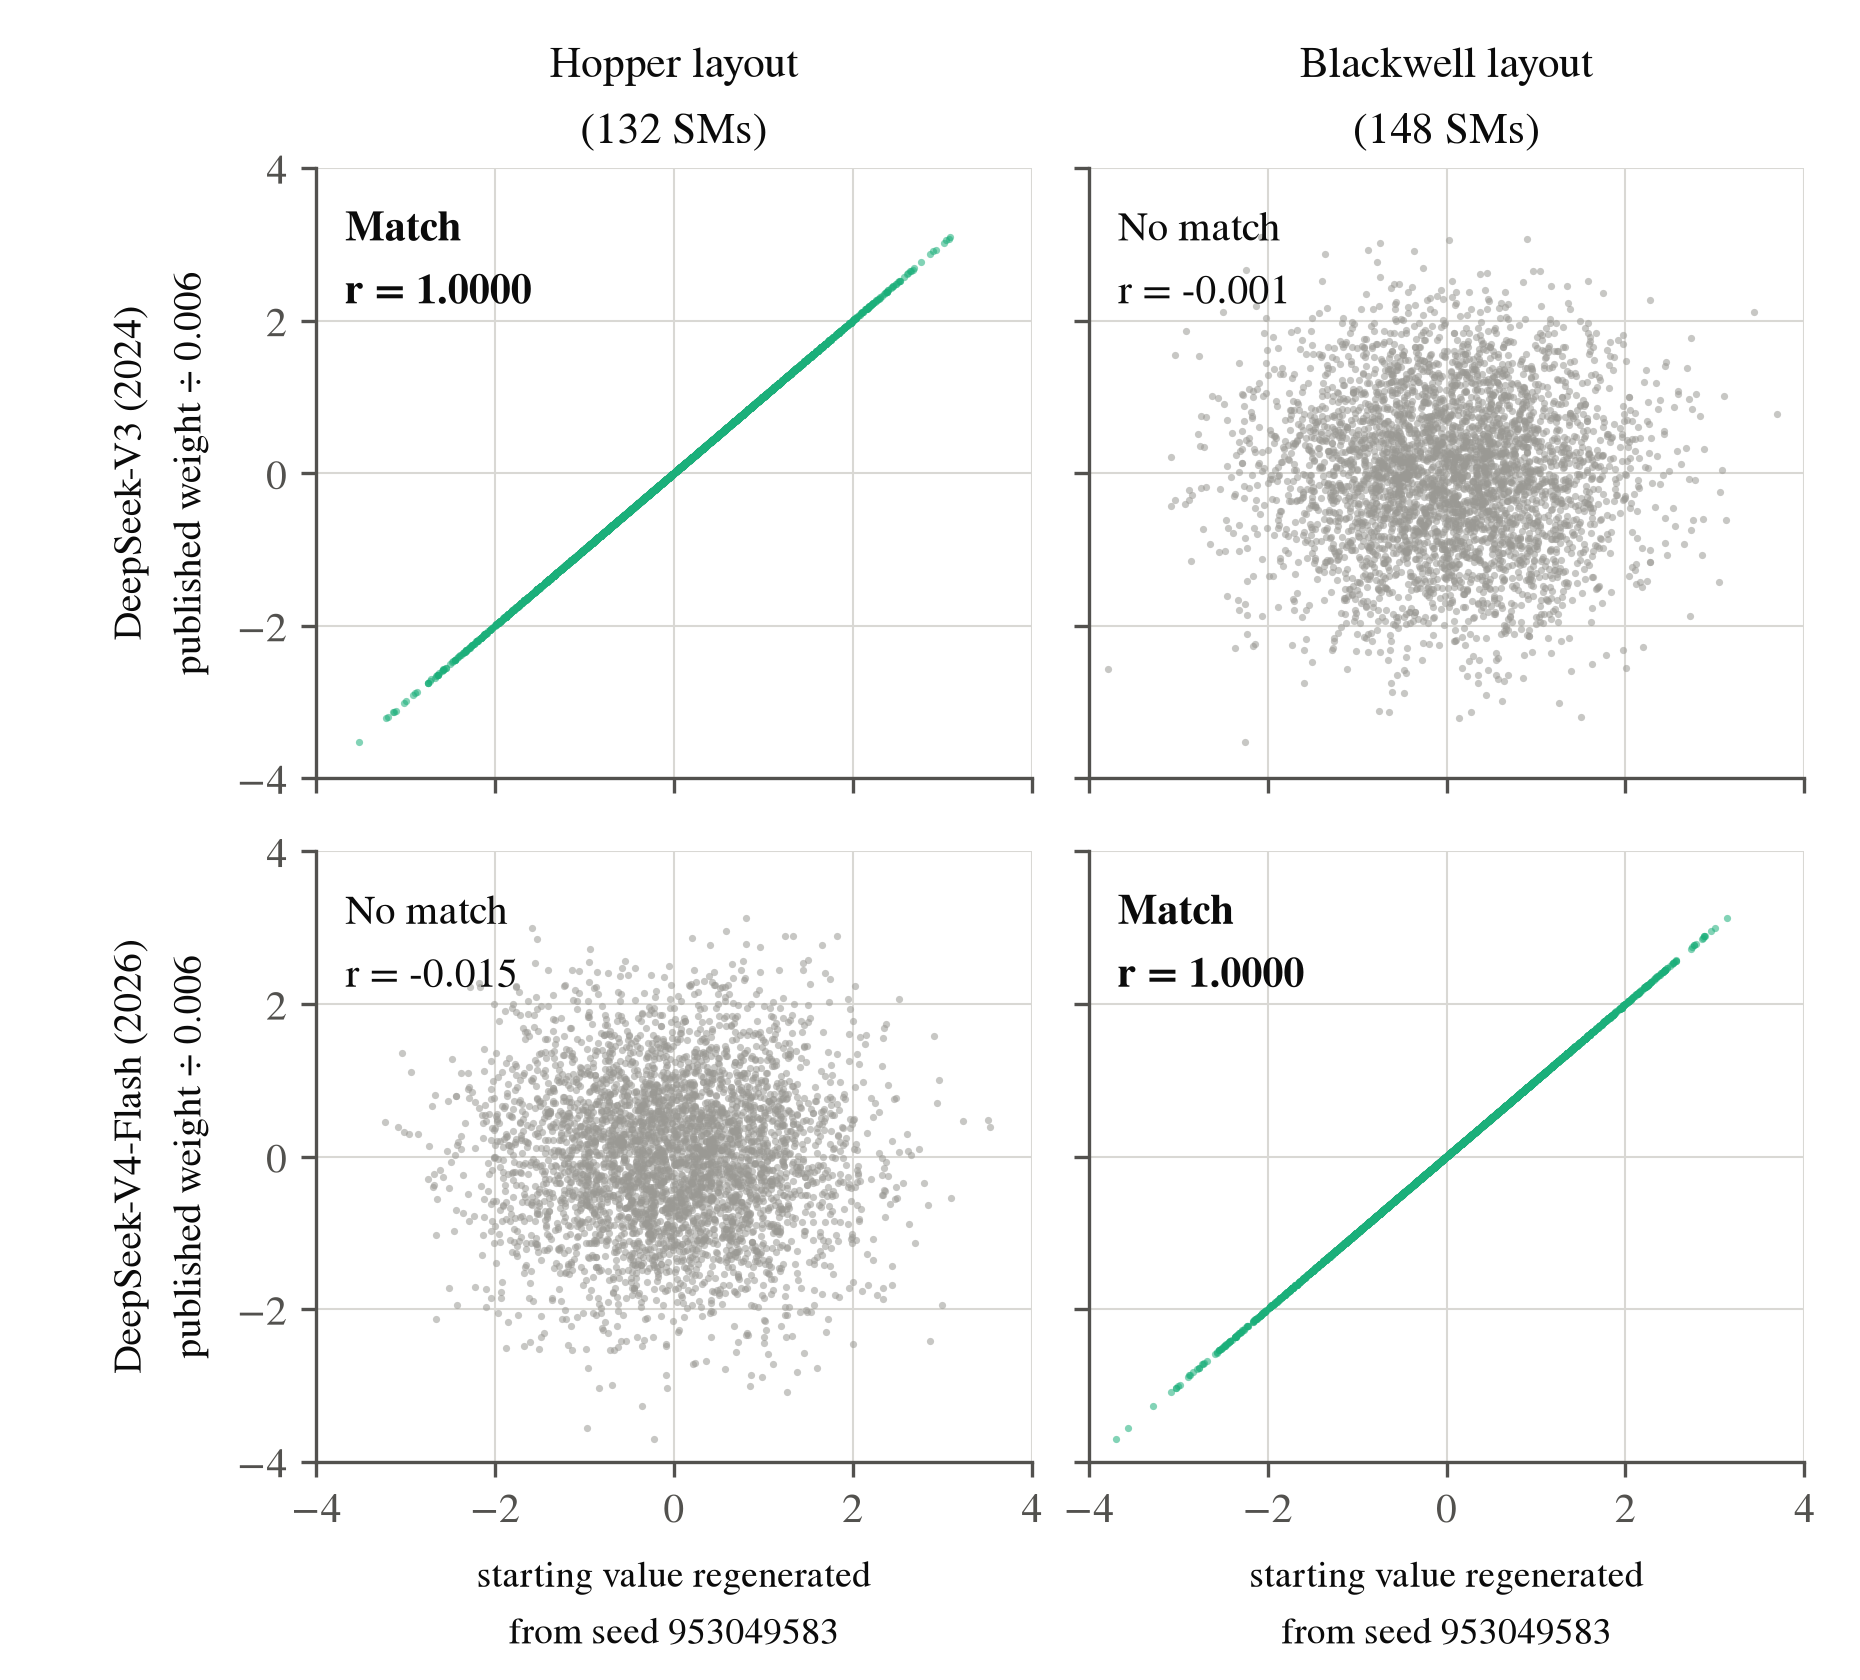
図 4. 残存した初期値が配置を明らかにする。各点は、公開された重みと、シードから再生成した値を比べたもの。対角線上にあれば両者が一致している。DeepSeek-V3 は Hopper の配置に、V4-Flash は Blackwell の配置に一致する。各パネルは、各モデルで残存した 4 行の重みのうち 4,096 個の値を示している。
学習で変化した重みにも、初期値のわずかな痕跡が残ることがある。最終的な重みは、初期値に学習中の調整量すべてを加えたものだ。調整が初期値の差を完全に打ち消したり埋め尽くしたりしない限り、その差の一部は残る。たとえば初期値が 0.2 と 0.8 の二つの重みにそれぞれ約 0.1 を加えても、大小関係は変わらない。実際の調整量はもっと変動が大きいので、重み一つを見ても何も分からない。だが数十万個の重みを見れば、初期値の大きい重みが最終値でも大きい傾向を保っているかを検証できる。図 5 は、この弱いが測定可能な関係を示している。これはこれらの重みで得られた知見であり、どの学習でも必ず成り立つ性質ではない。
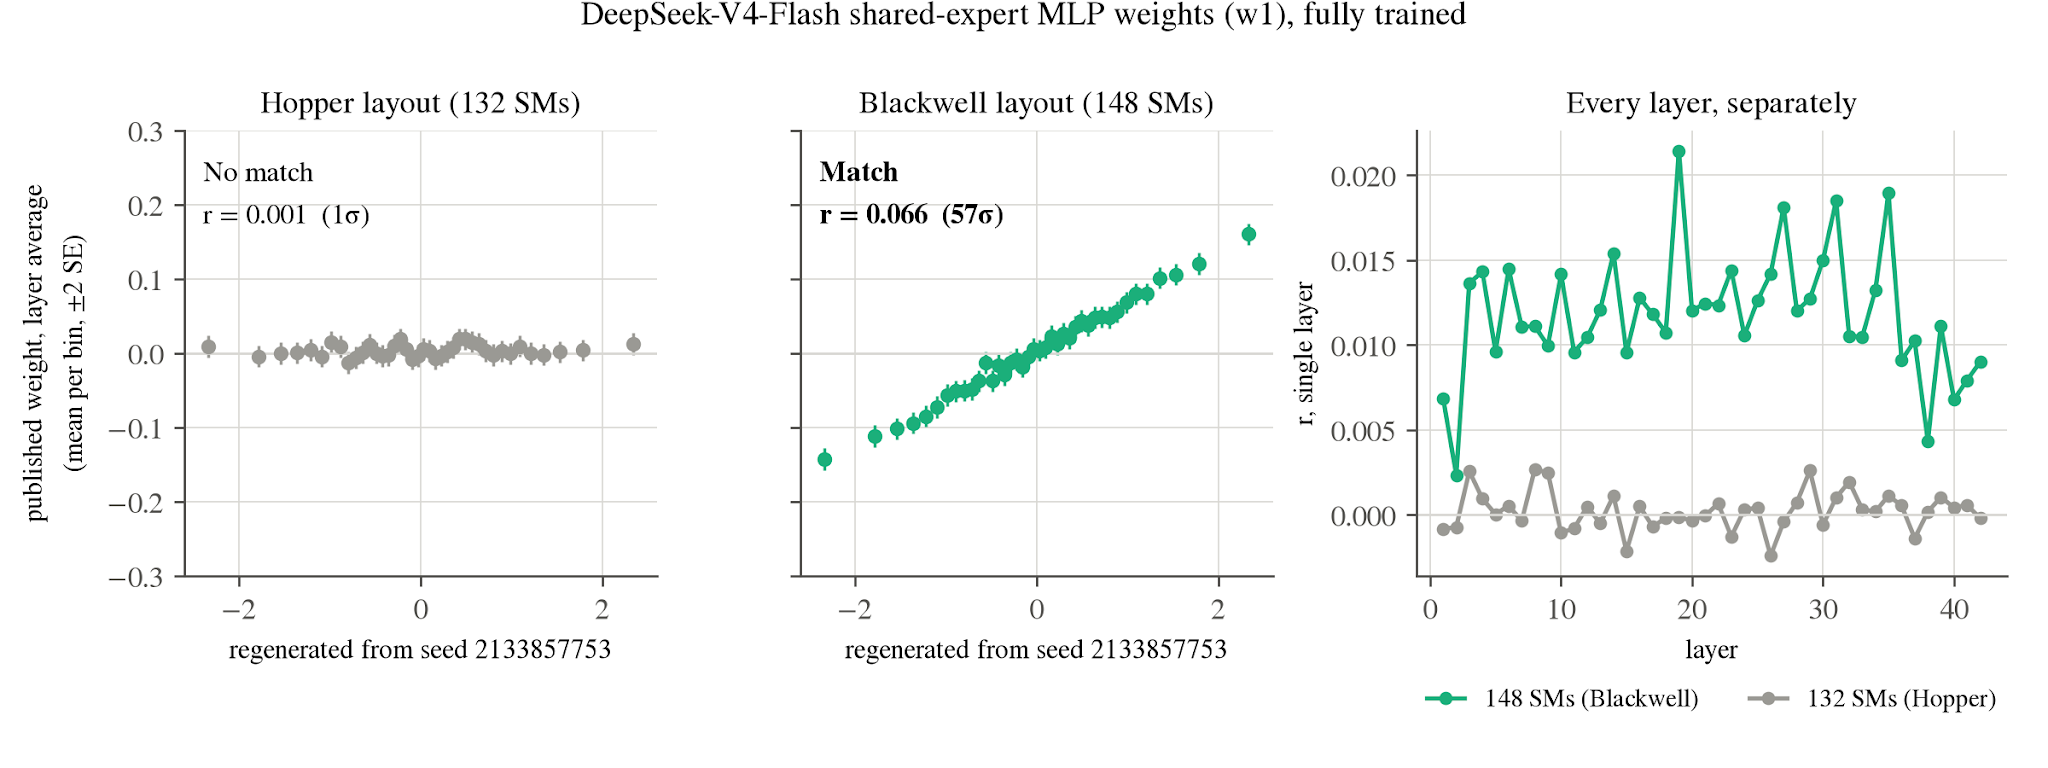
図 5。学習後の重みにも弱い痕跡が残る。左と中央は DeepSeek-V4-Flash の 42 層を層ごとに平均したもので、各層 745,472 個の重みを対象とする。Blackwell レイアウトでは、初期値が高いほど最終値もわずかに高いまま(r = 0.066、57σ)。Hopper レイアウトではこの関係が消える。右は単一層における、より弱い証拠を示す。
この残存する痕跡があれば逆算できる。図 1 のレイアウトを流用した架空の例を考えよう。シード 7 により、最初のスレッドは 0.2、−0.5、0.8 を生成する。スレッドが 48 個ならこれらの値は 1、49、97 番目の位置に、40 個なら 1、41、81 番目の位置に収まる。公開された重みが前者のパターンを保っているなら、候補となるシードとスレッド数を変えながら、それが再現するまで試せばよい。実際の調査では、対応する位置にある数千個の値を比較する。未学習の重みなら完全に一致する。学習後の重みでは、上述のような弱い類似しか現れないかもしれない。いずれにせよ、残存パターンを最もよく再現する組み合わせを探すことになる。
次に、その組み合わせを探索に使っていない重みで検証する。ある重みの組でシードとスレッド数を決めたら、それを別の重みの組の初期値予測に使い、フィッティングを改善するためのパラメータ調整は一切行わない。組み合わせの選定に使った重みだけで一致するよりも、こうした未使用の重みで一致するほうが説得力を持つ。図 6 に比較結果を示す。DeepSeek-V3 は Hopper H100 SXM、H200、H800 のいずれかの初期化レイアウトと一致し、DeepSeek-V4-Flash は Blackwell B200/B300、Kimi K3 は Blackwell GB200/GB300 と一致した。
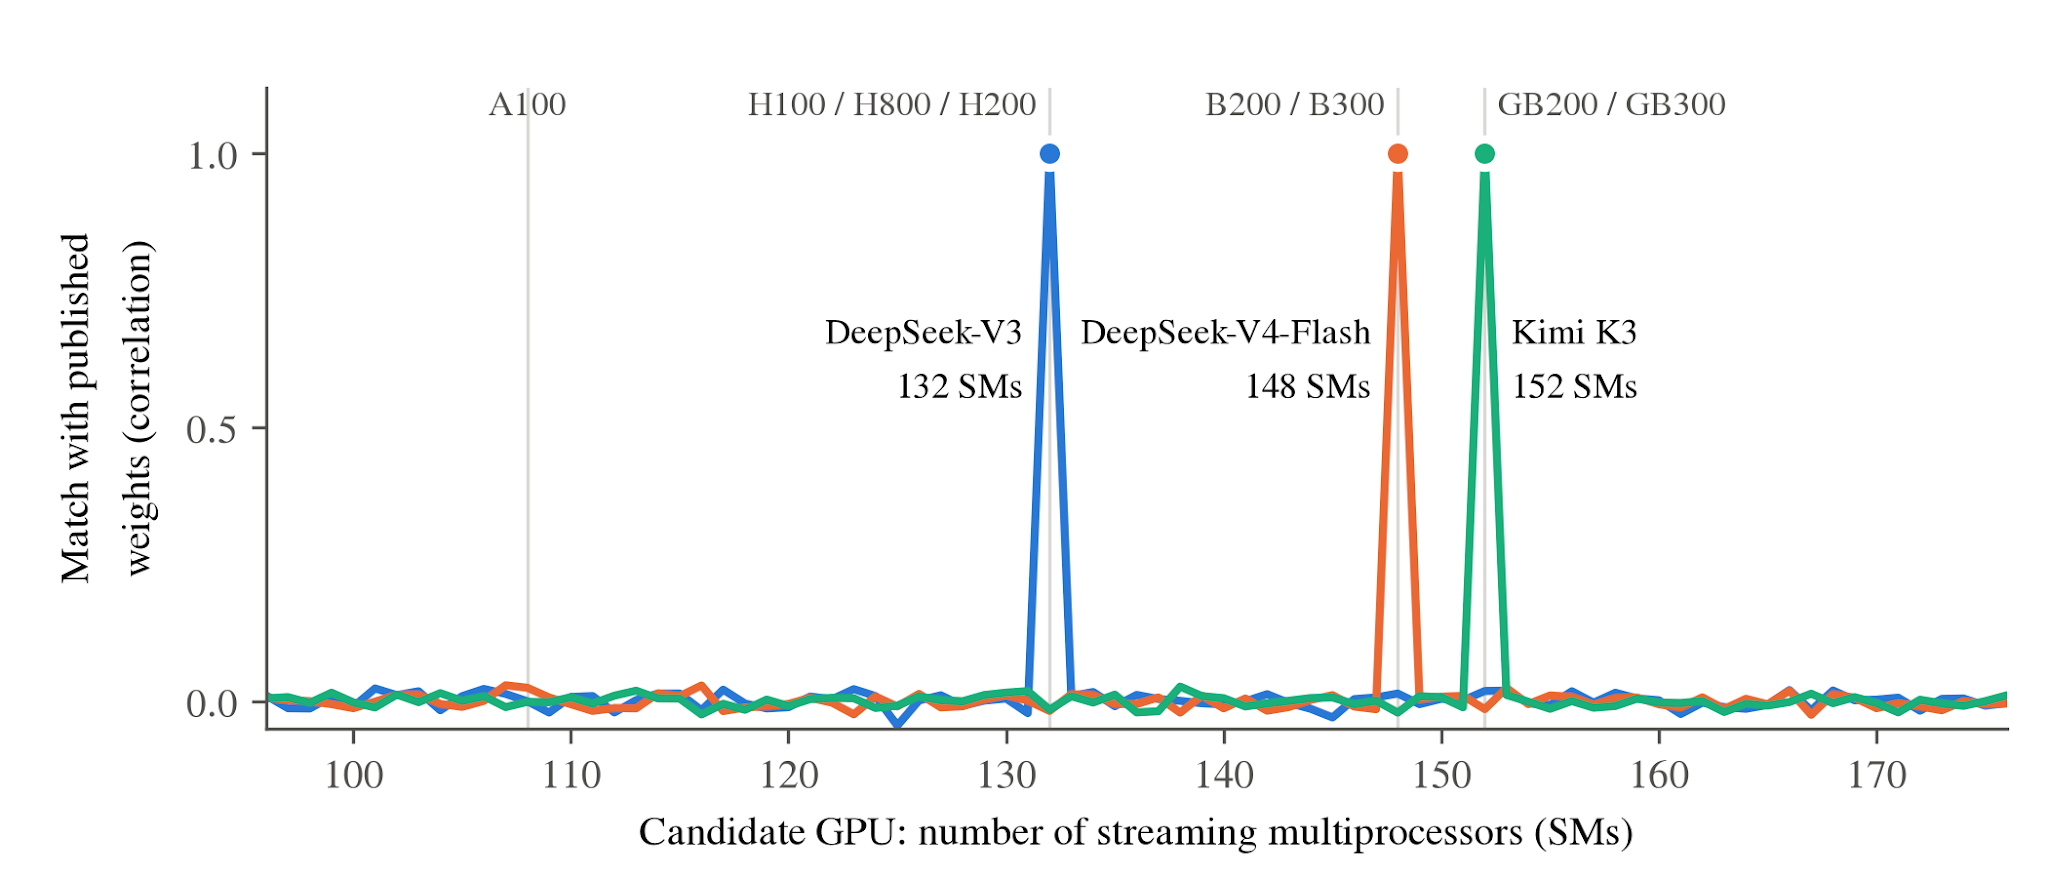
図 6。候補レイアウトの比較。各モデルに明瞭なピークがある。DeepSeek-V3 は 132 SM、V4-Flash は 148、Kimi K3 は 152。その他のレイアウトはスコアがほぼゼロだった。
調査の結果、中国企業 4 社の 6 モデルに、Blackwell 上で初期化されたことを強く示唆するパターンが見つかった。DeepSeek の DeepSeek-V4-Flash と DeepSeek-V4-Pro、Moonshot AI の Kimi K3 と Kimi K3.1-Pro、MiniMax の MiniMax-M3、アント・グループの Ling-3.1-flash である。V4-Flash と MiniMax-M3 は 148 SM のレイアウトと一致し、残る 4 モデルは 152 SM のレイアウトと一致した。これらは初期重みの指紋であり、これらの AI モデルが Blackwell 上で学習されたことを支持するが、単独で証明するものではない。
本調査の限界
本調査でモデルの初期化ハードウェアを特定するために用いたフォレンジック手法は、一部のモデルにしか効かない。公開された重みが必要であり、クローズドモデルは検証できない。初期重みを生成するソフトウェアが、識別可能でハードウェアに依存する特徴を残すことも条件になる。本記事で扱った GPU 上では PyTorch がそうした特徴を残すが、Baidu が ERNIE-5.5 の学習に使った PaddlePaddle フレームワークは残さない。ERNIE-5.5 のシード(2760)は復元できたものの、どのハードウェアで初期化されたかは特定できなかった。同様に、GPU ではなく通常のプロセッサ上で初期化された重みには GPU の指紋が残らない。Alibaba の Qwen3 の複数モデルがこの形で初期化されており、学習にどの GPU が使われたかはたどれない。Meituan は LongCat-2.0 を「AI ASIC スーパーポッド」で学習したとしているが、このモデルにも指紋は見つからなかった。DeepSeek-V4.1-Flash も同様で、網羅的な探索を行ったにもかかわらずである。
この手法が特定するのは初期重みを生成したハードウェアであり、その後に学習に関与したすべてのチップではない。学習に使うのと同じ GPU 群で重みを生成していれば、指紋は両方を指す。だが、あるシステムで重みを生成して別のシステムへ移すことも、既存モデルを新しいハードウェアで学習し続けることもありうる。重みだけからはこれらの可能性を排除できない。混成クラスタも同じ制約を課す。一部の重みを NVIDIA チップで生成し、その後に Huawei のチップが学習に関与した場合、NVIDIA の特徴は残っても Huawei の関与は表に出ない。世代の異なる NVIDIA チップが、それぞれ初期化した部分に異なる特徴を残すこともありうる。ただし、その痕跡が消えずに残っていればの話だ。Kimi K3 では、それぞれ独自にシードを設定した少なくとも 64 個のプロセスが、同じ 152-SM レイアウトを残していた。したがって Blackwell 互換の特徴は、初期化段階での使用を支持する(後述する AMD による代替説明を除く)が、学習プロセス全体で Blackwell が使われたことまでは証明しない。逆に、Hopper の特徴があっても、その後に Blackwell で学習を続けた可能性は排除できない。
重みからは、チップの所有者や所在も分からない。Blackwell システムは中国国外のデータセンターから借りられる。この証拠が示すのはハードウェアの入手経路だけであり、それ自体ではチップが中国に密輸されたことや、輸出規制違反が存在したことを証明しない。
他のチップがこれらの Blackwell 互換レイアウトを生み出しうるか。今回テストした NVIDIA の各モデルのうち、古いチップには不可能だった。ソフトウェアによってチップの処理ユニットの一部だけを使うことはできても、物理仕様を超える処理ユニットを持たせることはできない。今回検討した PyTorch の標準的な挙動のもとでは、148 や 152 SM のレイアウトを生み出せない。中国市場向けの Blackwell グラフィックスカードは SM あたりのスレッド数が異なり、どちらの総数も出せない。
AMD には別の可能性がある。MI300X は通常 304 個の処理ユニットを使うが、152 個ずつ 2 グループに分けることも、148 個だけ使う構成にもできる。同社の乱数ソフトウェアも、NVIDIA と同じ基盤系列を生成できる。こうした構成は極めて異例だが、実機の MI300X で確認したところ、152 個または 148 個に制限すると、我々が Blackwell に帰属させたレイアウトを再現できた。したがってレイアウトだけでは結論を出せない。
両者を区別するため、我々は数値そのものにわずかな差がないかを探した。AMD と NVIDIA では、乱数生成の過程で 1 か所の計算がわずかに異なる。実機の MI300X では、DeepSeek-V4-Flash に残された重みは NVIDIA を指し示した。両社で結果が異なる 377 個の数値のうち、公開重みは 363 個が NVIDIA と一致し、AMD と一致したものはゼロだった。同じテストでは残り 5 モデルの結論は出せないが、AMD の説明はそれらにとって極めて考えにくいと我々は見ている。通常の構成では、MI300X はどちらのレイアウトも生み出せない。ラボがクラスタ全体を Blackwell チップと同じ処理ユニット数に構成して初めて可能になる。他の公開証拠も Blackwell を指す。米国の当局者やメディアの報道はいずれも、DeepSeek と Moonshot AI が Blackwell チップを使っていると伝えており、アント・グループの公開コードにも GB300 上で生成されたベンチマーク結果が含まれている。
発見の検証
「DeepSeek-V3 は Hopper、DeepSeek-V4-Flash は Blackwell に対応する」という結果を再現するため、我々は Hopper 世代の NVIDIA H100 と Blackwell 世代の NVIDIA B300 で、未改変の PyTorch を実行した。DeepSeek の乱数シードが 953049583 であることは既に特定済みで、このシードが DeepSeek-V3 と DeepSeek-V4-Flash の初期化の両方に使われていることも分かっている。このシードを使うと、H100 は DeepSeek-V3 に残された初期値を再現したが、V4-Flash のそれは再現しなかった。B300 は V4-Flash に残された値を再現したが、V3 のそれは再現しなかった。 B300 では、未改変の PyTorch が DeepSeek-V4-Flash の選択行 469 個のうち 461 個を再現し、相関係数はいずれも 0.99 を超え、うち 445 行は完全な行としてビット単位で一致した。残る 8 行は訓練の過程で一部が変化していた。H100 では、DeepSeek-V3 の保持値 57,344 個すべてをビット単位で再現した。どちらのチップも、相手のモデルが保持する行は再現できなかった。シードを 1 だけ変えると、どちらのマシンでも一致する行は 1 つも再現されなかった。レンタルの GB200 上でも、未改変の PyTorch が Moonshot のシード 20256586 を使って Kimi K3 の保持行 13 個すべてを再現した。シードを 1 変えると、1 つも再現されない。これらの検証に必要なコードと保持重みは公開されており、同じ照合は GPU なしでも実行できる。
答えが既知の場合でも、我々のフォレンジック手法は正しい答えを導く。開発者が特定モデルの背後にあるハードウェアを公表している 24 件の事例があり、我々の手法はその 24 件すべてと一致した。Meta の Llama 3.1 シリーズは H100 で訓練されており、読み取り値は 132 だった。EleutherAI の Pythia シリーズのうち 8 モデルは A100 で訓練され、読み取り値は 108 だった。NVIDIA 自身の Nemotron-3 Ultra は技術レポートで訓練のある段階に GB200 を使ったと明記しており、読み取り値は 152 で Kimi K3 と同じだった。DeepSeek と Moonshot は、初期のモデルで H800 を使ったと報告している。我々の Hopper の読み取り値はこうした開示と整合するが、H100 SXM や H200 のハードウェアとも一致する。これらの読み取り値は H800 の使用を独立に裏付けるものではない。
公開された重みを、候補のシードとチップレイアウトから生成したデータと照合すると、候補が誤っていても、ある程度の類似は避けられない。どの程度の類似を証拠と見なすかは、照合した重みの数に依存する。数個の値が一致するのは偶然の可能性が高いが、数千個が一致すれば偶然では説明しにくい。我々の統計モデルは照合した重みの数を考慮し、実際に観測された一致がランダムに期待される類似度をどれだけ上回るかを測る。この差を標準偏差(σ)で表す。スコアが高いほど、「一致は偶然」という仮説に対する証拠が強いことを意味する。ただし統計モデルがデータのランダムな変動を正しく記述していることが前提だ。
候補をいくつ試したかも考慮に入れる必要がある。約 6 兆通りの seed と layout の組み合わせを探索するということは、幸運な一致に遭遇する機会が数兆回あるということだ。正規分布モデルの下では、5σ 以上の正の一致は約 350 万回の比較に 1 回の割合で偶然生じる。単発のテストでそんな結果が出れば驚くべきことだが、これほど大規模な探索の中のどこかで起きるのは不思議ではない。そこで我々は、探索全体における偶然の一致を評価する基準として約 8σ を置いた。
我々の発見はこの基準をはるかに超えている。 まず一群の重みで seed と layout を選び、選択過程とは無関係な別の一群の重みで同じ組み合わせをテストした。これは、見かけ上の指紋が、それを見つける手がかりとなった数値を超えて存在するかどうかを確かめるものだ。6 モデルそれぞれの最強の証拠は 49 から 1,385σ の間にあり、最も弱い単独テストでも 20σ に達した。我々の統計モデルの下では、これらの結果は偶然の類似に帰するには強すぎる。これらは共有された初期化パターンの証拠を成す。どの計算ハードウェアがこのパターンを生み出したのか、そしてそれが訓練も担ったのかについては、上述した別の論証が必要になる。
結論
フォレンジック調査に基づき、6 つの中国製 AI モデルが輸出規制対象の NVIDIA ハードウェア上で初期化されたことを示す強い証拠があり、DeepSeek-V4-Flash については証拠は決定的であると判断する。この初期化は、同じ規制対象ハードウェア上で学習も行われたことを強く示唆すると考えている。これらのモデルを開発した企業が輸出規制対象の NVIDIA システムをどの経路で入手したのかなど、未解決の問題は残るが、この事実は早急な社会的注目に値すると考える。
付録 1 · 中国各ラボのハードウェアの推移
各ラボのモデル世代ごとのハードウェアフィンガープリント。
DeepSeek は複数のモデル世代で同じ seed を再利用し、Moonshot は同一の規則から seed を導出しているため、モデル単位で各ラボのハードウェアを追跡できる。日付は重みの公開時期。
| モデル | SM 数 | ハードウェア階層 | 対中輸出 | 証拠 |
|---|---|---|---|---|
| DeepSeek | ||||
| V2-Lite, MoE-16B | 108 | A100 / A800(Ampere) | A800 は 2023 年 11 月まで合法 | 完全一致 |
| LLM 7B/67B、Coder、V2、V3(2024 年 12 月)、V3.2 | 132 | H100 / H800 / H200(Hopper) | チップ未特定 | 完全一致;V3 239σ |
| V4-Flash(2026 年 4 月) | 148 | B200 / B300(Blackwell) | ライセンスが必要;報道なし | 完全一致、1,385σ |
| V4-Pro(2026 年 4 月) | 152 | GB200 / GB300(Grace-Blackwell) | ライセンスが必要;報道なし | 部分的に生存、49σ |
| Moonshot AI | ||||
| Kimi K2(2025 年 7 月) | 132 | H100 / H800 / H200(Hopper) | チップ未特定 | 部分的に生存、292σ |
| Moonlight-16B;Kimi-Linear(2025 年 10 月) | 132 | H100 / H800 / H200(Hopper) | チップ未特定 | 完全一致;Kimi-Linear 763σ |
| Kimi K2.5(2026 年 1 月) | 132 | H100 / H800 / H200(Hopper) | チップ未特定 | 学習行なし、r 0.9975、255σ |
| Kimi K2.7-Code(2026 年 6 月) | 132、別に 148-SM の部分あり | Hopper、および B200 / B300 と一致する第 2 の由来 | 混在 | 148 の部分は計 254 行、132 の部分を除くと 246σ |
| Kimi K3(2026 年 7 月)、K3.1-Pro(2026 年 11 月) | 152 | GB200 / GB300(Grace-Blackwell) | ライセンスが必要;報道なし | 完全一致、各 305σ |
| MiniMax | ||||
| Text-01(2025 年 1 月)、M1、M2〜M2.7(2026 年 4 月) | 132 | H100 / H800 / H200(Hopper) | チップ未特定 | 学習行なし;2,048 グリッドのうちの 1 つ |
| M3(2026 年 6 月)、M3.1-Flash(2026 年 10 月) | 148 | B200 / B300(Blackwell) | ライセンスが必要;報道なし | 完全一致、323σ |
| Ant Group | ||||
| Ling-1T†(2025 年 10 月)、Ling-3.0-flash(2026 年 8 月) | 132 | H100 / H800 / H200(Hopper) | チップ未特定 | 学習行なし、r 0.98;345σ、193σ |
| Ling-3.1-flash(2026 年 10 月) | 152 | GB200 / GB300(Grace-Blackwell) | ライセンスが必要;報道なし | 学習行なし、r 0.98、244σ |
| その他のラボ | ||||
| GLM-5.3(Zhipu)、Qwen3.8(Alibaba) | 132 | H100 / H800 / H200(Hopper) | チップ未特定 | 部分的に生存、46σ、478σ |
| Hy4-preview(Tencent)、Step-5-Preview(StepFun) | 132 | H100 / H800 / H200(Hopper) | チップ未特定 | 完全一致、各 256σ |
| MiMo-V2.5-Pro(Xiaomi)、Qwen3.5-397B(Alibaba) | 132 | H100 / H800 / H200(Hopper) | チップ未特定 | 部分的に生存、41σ、323σ |
証拠列の読み方。完全コピーとは、学習で一度も更新されなかった重みのことで、生成値を 0.999 超の相関(r)で再現できる。未学習の行も同じだが、モデルの初期値が切り詰められたり丸められたりしているため r は低くなる。部分生存とは、学習済みの重みが初期値の一部を保持していることを指す。グリッドスキャンの数値は、探索から除外したセルから得たもの。32 ビットのシードをすべて試し、グリッドをすべて舐めても、ランダム推測では 8σ に届かない。Blackwell に関する 6 件の結果のうち最も低いもの(V4-Flash の学習後のアテンション重みに対するもの)でも 20σ ある。
† 結果は一度の分析によるもので、再実行はしていない。
Kimi K2.7-Code。保持された 254 行は 2 つの由来が混ざっている。約 80% は K2.5 から受け継いだ Hopper レイアウトの値で、約 20% は 148-SM レイアウトに合致する新たなサンプリング。どの行でも混合比は同じで、これはハードウェアの混用ではなくマージ済みチェックポイントであることを示す。K2.7-Code は 6 つの Blackwell モデルには数えていない。
公開コード。アント・グループの cuLA リポジトリには、2026 年 3 月 31 日に GB300 上で生成されたベンチマーク結果が含まれている。2025 年 6 月、DeepSeek のエンジニアが GitHub に「我々は SM100 GPU を持っていない」(SM100 とは Blackwell のこと)と書き込んだ。
付録 2 · 特定済みの全モデル
モデルの完全なカタログ、開示されたハードウェア、証拠の注記。
開発者が特定モデルで使ったハードウェアを公表している 24 件すべてで、我々の判定はそれと一致した。うち 21 件は最初の調査によるもので、残りは Kimi K2.5(H800)、Step-3.5-Flash(H800)、ZAYA1(AMD MI300X)。この 24 件のうち 11 件は step-zero チェックポイントで、該当モデル同士も独立ではない。したがってこれは実測の精度ではなく、整合性の確認にすぎない。「未検出」は、モデルカード、論文、リポジトリ履歴を調べてもハードウェアに関する記述が見つからなかったことを意味する。
| モデル | 特徴 | 開発者 | 公開されたハードウェア | 一致 | 輸出状況(中国) |
|---|---|---|---|---|---|
| 中国 | |||||
| DeepSeek-V4-Flash, -Base | 148(B200/B300) | DeepSeek | 未開示 | - | ライセンスが必要² |
| DeepSeek-V4-Pro-Base | 152(GB200/GB300) | DeepSeek | 未開示 | - | ライセンスが必要² |
| Kimi K3; K3.1-Pro(同一シード) | 152(GB200/GB300) | Moonshot AI | 未開示 | - | ライセンスが必要² |
| Ling-3.1-flash | 152(GB200/GB300) | Ant Group | 未検出 | - | ライセンスが必要² |
| MiniMax-M3; M3.1-Flash(同一初期化) | 148(B200/B300) | MiniMax | 未検出 | - | ライセンスが必要² |
| Kimi K2.7-Code | 132、加えて 148 の部分が 1 つ⁵ | Moonshot AI | 未検出 | - | 未定⁴ |
| Kimi K2.5; K2.6(同一初期化) | 132(Hopper) | Moonshot AI | H800 | はい | 未定⁴ |
| Kimi-Linear-48B | 132(Hopper) | Moonshot AI | 未検出 | - | 未定⁴ |
| Kimi K2-Base | 132(Hopper) | Moonshot AI | H800 | はい | 未定⁴ |
| Moonlight-16B-A3B | 132(Hopper) | Moonshot AI | 未開示 | - | 未定⁴ |
| DeepSeek-V3-Base; V3.2(同一初期化) | 132(Hopper) | DeepSeek | H800 | はい | 未定⁴ |
| DeepSeek-V2 | 132(Hopper) | DeepSeek | H800(報告全体) | 一致¹ | 準拠版が存在した³ |
| DeepSeek-Coder-1.3B | 132(Hopper) | DeepSeek | A100 と H800(報告全体) | 一致¹ | 準拠版が存在した³ |
| DeepSeek-LLM-7B, 67B | 132(Hopper) | DeepSeek | 当初の学習は未開示 | - | 準拠版が存在した³ |
| DeepSeek-MoE-16B | 108(A100/A800) | DeepSeek | A100 または H800(報告全体) | 一致¹ | 準拠版が存在した³ |
| DeepSeek-V2-Lite | 108(A100/A800) | DeepSeek | H800(報告全体) | 初期化を共有¹ | 準拠版が存在した³ |
| Ling-3.0-flash | 132(Hopper) | Ant Group | 未検出 | - | 未定⁴ |
| Ling-1T; Ling-2.6-1T(同一初期化)† | 132(Hopper) | Ant Group | Hopper(報告全体) | 一致¹ | 未定⁴ |
| GLM-5, 5.1, 5.2, 5.3(同一初期化) | 132(Hopper) | Zhipu AI | 未開示 | - | 未定⁴ |
| GLM-5.3-Flash | 132(Hopper) | Zhipu AI | 未検出 | - | 未定⁴ |
| GLM-4.5-Base; GLM-4.7(同一初期化)† | 132(Hopper) | Zhipu AI | 未検出 | - | 未定⁴ |
| Qwen3.8-2.4T-A95B | 132(Hopper) | Alibaba | 未開示 | - | 未定⁴ |
| Qwen3.5-397B-A17B | 132(Hopper) | Alibaba | 未検出 | - | 未定⁴ |
| Hy3-preview; Hy3(同一初期化) | 132(Hopper) | Tencent | 未検出 | - | 未定⁴ |
| Hy4-preview | 132(Hopper) | Tencent | 未検出 | - | 未定⁴ |
| MiMo-V2-Flash; MiMo-V2.5-Pro | 132(Hopper) | Xiaomi | 未検出 | - | 未定⁴ |
| Step-5-Preview | 132(Hopper) | StepFun | 未検出 | - | 未定⁴ |
| Step-3.5-Flash; Step-3.7-Flash(同一初期化) | 132(Hopper) | StepFun | H800(Step-3.5-Flash) | はい | 未定⁴ |
| MiniMax-M2, M2.1, M2.5, M2.7(同一初期化) | 132(Hopper) | MiniMax | 未検出 | - | 未定⁴ |
| MiniMax-Text-01, VL-01; M1(同一初期化) | 132(Hopper) | MiniMax | H800(報告全体) | 一致¹ | 未定⁴ |
| Seed-OSS-36B-Base | 108(A100/A800) | ByteDance | 未検出 | - | 準拠版が存在した³ |
| Yi-34B | 108(A100/A800) | 01.AI | 未開示 | - | 準拠版が存在した³ |
| 米国 | |||||
| Llama 3.1 8B, 70B, 405B | 132(Hopper) | Meta | H100 | はい | 該当なし |
| Nemotron-3-Ultra-550B | 152(GB200/GB300) | NVIDIA | GB200(ある段階) | 一致 | 該当なし |
| Nemotron-4-340B-Base | 132(Hopper) | NVIDIA | H100 SXM5 | はい | 該当なし |
| ZAYA1-74B-preview | 304 CU(AMD MI300X) | Zyphra | AMD(ブログでは MI300X) | はい | 該当なし |
| OLMo-2 32B, Olmo-3 32B | 132(Hopper) | AI2 | H100 | はい | 該当なし |
| OLMo-7B | 108(A100) | AI2 | A100 | はい | 該当なし |
| OLMo-7B-Twin-2T | 110 CU(AMD MI250X) | AI2 | AMD MI250X | はい | 該当なし |
| OLMo-7B-0424, OLMo-1B-0724 | 132(Hopper) | AI2 | 未開示 | - | 該当なし |
| Pythia 70M-12B(8 モデル) | 108(A100) | EleutherAI | A100 | はい(8 件すべて) | 該当なし |
| GPT-NeoX-20B | 108(A100) | EleutherAI | A100 | はい | 該当なし |
| 欧州 | |||||
| Apertus-70B | 132(Hopper) | Swiss AI | GH200(Hopper、132 SM) | はい | 該当なし |
| Mixtral-8x7B | 132(Hopper) | Mistral AI | 未開示 | - | 該当なし |
| BLOOM-176B(特徴の一部) | 108(A100) | BigScience | A100 | はい | 該当なし |
¹ レポート全体に関わる開示。DeepSeek-V2 と V2-Lite は「H800 クラスタ」という同一の表現を共有しており、MoE-16B は「A100 または H800」、Coder は「A100 と H800」と記している。MiniMax の MiniMax-01 論文は H800 クラスタを記述し、アント・グループの Ling 2.0 はトレーニングが「Hopper GPU」上で実行されたと報告している。これらの記述は我々の解釈と一致するが、独立した検証ではない。V2-Lite は MoE-16B の初期化を再利用しており、両者が保持する行はバイト単位で同一である。
² ライセンスが必要。B200、B300、GB200、GB300 は出荷前の時点で既に対中輸出ライセンスを要しており、これらのチップに関する報道は見当たらない。AMD MI300X も同様に規制対象である。
³ 準拠モデルが存在する。A100/H100 クラスは 2022 年 10 月から規制対象だが、SM 数が同じ A800 と H800 は 2023 年 10 月まで輸出可能だった。
⁴ Hopper ハードウェアは未確定。これらのモデルは早くも 2024 年 12 月から公開されており、H800、H100 SXM、H200 のいずれかのハードウェアに一致する 132-SM のフィンガープリントを示す。DeepSeek と Moonshot は一部モデルで H800 を使用したと報告しているが、このフィンガープリントではこれらのチップを区別できない。モデルの公開日からは、そのハードウェアがいつ、どこで入手されたかを特定できない。この解釈だけでは、輸出規制に適合していたかどうかも判断できない。
⁵ 148 の部分。結果表の下にある Kimi K2.7-Code に関する注記を参照。
† 単一の分析パイプラインによる報告であり、独立した再実行はまだ行っていない。本ブリーフで新たに追加したその他の行は、先頭に挙げたモデルをすべて独立に再実行している。初期化を共有するモデルとして記載したものは再実行していない。
これらのマークが示すのは、2022 年 10 月および 2023 年 10 月の米国輸出規則におけるハードウェアの区分であり、違法行為の認定ではない。
GPU フィンガープリントを復元できなかったもの。空白はモデルのハードウェア状況を意味しない。DeepSeek-V4.1-Flash(網羅的な探索を実施)、Qwen3.5-122B、Qwen3.8-Flash-Next、Qwen3-0.6B と 1.7B、gpt-oss-120b、Grok-1 からはフィンガープリントを一切復元できなかった。Qwen3-235B、Qwen3-32B、Qwen3.5-9B は CPU 上で初期化されるため、GPU レイアウトを残さない。Baidu の ERNIE-5.5 は PaddlePaddle を使用しており、そのジェネレータはチップレイアウトを持たない(シード 2760 は復元した)。ERNIE-4.5 は結果が得られなかった。Meituan の LongCat-2.0 も結果が得られなかった。モデルカードにはトレーニングが「完全に AI ASIC スーパーポッド上で」行われたとあり、削除済みのファインチューニング設定が device_arch を 910 に設定し、NPU と HCCL のオプションを備えていたことから、Huawei Ascend 910 と判断した。Intern-S2 は Alibaba の Qwen3.5-397B を基に構築され、その初期化を引き継いでいる。DBRX と Llama-4-Scout はダウンロードできなかった。
コード。DeepSeek-V3、DeepSeek-V4-Flash、Kimi K3、MiniMax-M3、Ling-3.1-flash の結果を再現するために必要なコードと保持行は github.com/macrogrants/checkpoint-forensics にある。チェックはノート PC 上で数秒で完了し、別のスクリプトが未改変の PyTorch を使って GPU 上で再実行する。
連絡先は Will DePue、will@unemploymentlabs.com。
資料
- The Information、2025 年 12 月 10 日、DeepSeek と Blackwell について(Bloomberg による転載)。
- Reuters、2026 年 2 月 23 日、「China’s DeepSeek trained AI model on Nvidia’s best chip despite US ban, official says」(共同配信版)。
- ホワイトハウス OSTP 局長 Michael Kratsios、2026 年 7 月 22 日、Moonshot AI について(Bloomberg による転載)。
- The Wall Street Journal、2026 年 3 月、マレーシア国内で ByteDance 向けに供された Blackwell チップについて(Reuters による転載)。
- DeepSeek エンジニアによる GitHub コメント、2025 年 6 月 12 日、DeepGEMM pull request 112。
- アント・グループによる GB300 ベンチマーク結果、2026 年 3 月 31 日、cuLA, BENCHMARK_GB300.md。
- 米国輸出ライセンス規則、15 CFR 742.6。
- 開示されたハードウェア、DeepSeek-V3 Technical Report、Kimi K2 paper、Nemotron-3 Ultra Technical Report。
- 比較用のトレーニング実行、Mistral Large 4 model card、Microsoft AI、2026 年 10 月 15 日、「Frontier Pre-training at Microsoft AI」、DeepSeek、「Insights into DeepSeek-V3」。
- 結果を再現するコード、github.com/macrogrants/checkpoint-forensics。
- スレッドレイアウトを設定する PyTorch コード、DistributionTemplates.h。
- モデルの重み、DeepSeek-V3、V4-Flash、V4-Pro、Kimi K3、K3.1-Pro、MiniMax-M3、Ling-3.1-flash。
本レポートの引用方法
推奨する引用形式は次のとおりです。
Will DePue, “Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs,” Unemployment Labs, November 12, 2026, https://unemploymentlabs.com/checkpoint-forensics.
BibTeX 形式は次のとおりです。
@techreport{depue2026blackwell,
 author = {DePue, Will},
 title = {{Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs}},
 institution = {Unemployment Labs},
 year = {2026},
 month = nov,
 url = {https://unemploymentlabs.com/checkpoint-forensics}
}
報道で引用する場合は、結論を Will DePue に帰属させ、本ページへのリンクを張ってください。