中国前沿 AI 模型带着受出口管制的 NVIDIA Blackwell GPU 指纹
自 2026 年 4 月以来,六款中国模型带有受对华出口管制的 NVIDIA Blackwell GPU 的数值布局。作者从各模型公开的权重里还原初始种子,再匹配线程布局。
中文
复制
摘要
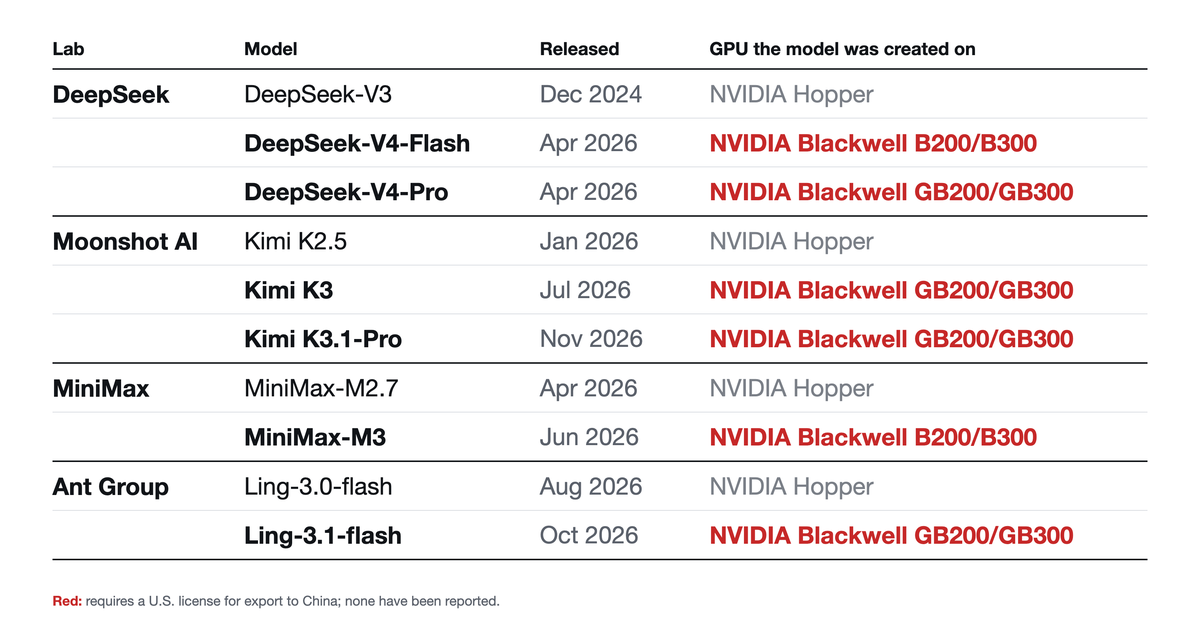
我们对公开发布的 AI 模型做了取证分析,发现证据表明 DeepSeek、Moonshot AI、MiniMax 和蚂蚁集团已经获得了 NVIDIA 的 Blackwell GPU,尽管这些芯片受到对华出口限制,并且它们正在用这些硬件训练自己的 AI 模型。 自 2026 年 4 月以来,这几家公司发布的六个模型含有与 Blackwell 硬件相符的数值特征,而它们更早的模型则与 NVIDIA 上一代 Hopper 相符。这些发现说明,几家领先的中国 AI 开发商已经开始用 Blackwell 训练最新的模型。美国官员和媒体报道此前已指控 DeepSeek 和 Moonshot AI 在使用 Blackwell 芯片,但未公布技术证据。
证据完全来自模型自己公开的权重,而非泄密或内部人士的说法。我们还原出模型初始值的痕迹,再搜索能够复现这些痕迹的硬件配置和初始配置;对 DeepSeek-V4-Flash 和 Kimi K3,我们还在真实的 Blackwell 芯片上验证了匹配结果。这一指纹识别的是权重的生成方式。它支持一个推断,即 Blackwell 也承担了训练,但并没有证明这一点。经过特殊配置的 AMD 硬件是唯一已识别的替代可能,它同样受对华出口限制;对 DeepSeek-V4-Flash,我们已将其排除,对其余五个模型,我们认为可能性极低。我们的发现提供了获得先进计算硬件的技术证据,但并未确定芯片所在位置、获取途径,也无法判断是否违反了出口管制。
表 1. DeepSeek、Moonshot AI、MiniMax 和蚂蚁集团历代模型中的硬件指纹
| 实验室 | 模型 | 发布时间 | 模型启动所用的芯片 |
|---|---|---|---|
| DeepSeek | DeepSeek-V3 | 2024 年 12 月 | NVIDIA Hopper(实验室披露为 H800) |
| DeepSeek-V4-Flash | 2026 年 4 月 | • NVIDIA Blackwell B200/B300 | |
| DeepSeek-V4-Pro | 2026 年 4 月 | • NVIDIA Blackwell GB200/GB300 | |
| Moonshot AI | Kimi K2 | 2025 年 7 月 | NVIDIA Hopper(实验室披露为 H800) |
| Kimi K2.5 | 2026 年 1 月 | NVIDIA Hopper(实验室披露为 H800) | |
| Kimi K3 | 2026 年 7 月 | • NVIDIA Blackwell GB200/GB300 | |
| Kimi K3.1-Pro | 2026 年 11 月 | • NVIDIA Blackwell GB200/GB300 | |
| MiniMax | MiniMax-M2.7 | 2026 年 4 月 | NVIDIA Hopper |
| MiniMax-M3 | 2026 年 6 月 | • NVIDIA Blackwell B200/B300 | |
| 蚂蚁集团 | Ling-3.0-flash | 2026 年 8 月 | NVIDIA Hopper |
| Ling-3.1-flash | 2026 年 10 月 | • NVIDIA Blackwell GB200/GB300 |
• 出口到中国需要美国许可证;目前未见任何相关报道。
Hopper 指纹无法区分 H800 与 H100 SXM 或 H200;上文中对 H800 的认定来自实验室披露,并非本方法的发现。
完整模型列表见附录 2 ↓
主要发现
-
四家中国实验室的六个模型读作使用 Blackwell 训练。 DeepSeek-V4-Flash 和 MiniMax-M3 与 NVIDIA 的 Blackwell 级芯片 B200 或 B300 吻合,这两款芯片有 148 个处理器核心(称为流式多处理器,即 SM)。DeepSeek-V4-Pro、Kimi K3、Kimi K3.1-Pro 和 Ling-3.1-flash 与 GB200 或 GB300 芯片吻合,它们同属 Blackwell 级,有 152 个处理器核心。Kimi K3.1-Pro 与 K3 使用相同的随机种子,可能是 K3 经过进一步后训练得到的检查点。
-
中国实验室转向 Blackwell 训练的时间相对较晚。 DeepSeek 的模型一直到 DeepSeek-V3(2024 年 12 月发布)都读作 Hopper 训练,从 DeepSeek V4(2026 年 4 月发布)起读作 Blackwell。Moonshot 的模型一直到 Kimi K2.5(2026 年 1 月)都读作 Hopper,从 K3(2026 年 7 月)起读作 Blackwell。Moonshot 有一个模型处在两者之间。比 K3 早六周发布的 Kimi K2.7-Code 建立在 Hopper 时代的权重之上,但其中有一小部分与 B200 或 B300 吻合。MiniMax 的模型一直到 M2.7(2026 年 4 月)都读作 Hopper,从 M3(2026 年 6 月)起读作 Blackwell。蚂蚁集团的 Ling-3.0-flash(2026 年 8 月)读作 Hopper,而 Ling-3.1-flash(2026 年 10 月)读作 Blackwell。Hopper 的读数无法确定具体是哪款芯片,H800、H100 SXM 和 H200 的指纹相同。
-
并非所有中国 AI 实验室都已转向 Blackwell。 我们能读取到的阿里巴巴(Qwen)、智谱(GLM)、腾讯、小米和 StepFun 的最新模型,全部读作 Hopper 训练。美团称其 LongCat-2.0 完全在“AI ASIC 超级集群”上训练,我们在其发布的模型权重中没有发现 NVIDIA 指纹。
-
该方法能得出已知的正确答案。 有 24 个具体模型,开发者已公开说明所用硬件。在每一个案例中,我们的方法都与公开声明一致。NVIDIA 自家的 Nemotron-3 Ultra 在其技术报告中指明训练某一阶段使用了 GB200,其读数为 152 个 SM,与 Kimi K3 相同。
-
这些匹配的强度远超偶然所能解释的程度。 只要尝试足够多的组合,即使毫不相关的数字也可能看起来吻合。在我们的搜索中,大约有 6 万亿种种子与布局组合,最强的偶然匹配预计也只能达到约 8 sigma(sigma 衡量的是结果高出普通随机波动多少)。六个模型中每一个的最强证据在 49 到 1,385 sigma 之间。即使是我们报告的最弱的单项检验,也达到了 20 sigma。
-
这些训练任务的规模达到了数据中心级别。 根据各模型的参数规模及其训练所用的数据量,我们估算,最大的两个训练任务 Kimi K3 和 DeepSeek-V4-Pro 各自需要数千块 Blackwell GPU 运行两到三个月,前提是每个模型都在为其完成初始化的硬件上训练。我们最可靠的估计分别约为 4,500 块和 3,000 块,相当于约 11,500 块和 7,500 块 H100(NVIDIA 上一代芯片,业界通常以它来衡量 AI 训练集群的规模);五个训练任务合计约需 12,000 块 Blackwell GPU(表 2)。按每块约 7 万美元计算(这个价格来自《华尔街日报》的报道,约 3.6 万块 Blackwell 芯片运到马来西亚供字节跳动使用,成本超过 25 亿美元),其中最大的集群成本约为 2 亿到 3 亿美元,五个集群合计超过 5 亿美元。这些数字只涵盖最终的训练运行;各实验室在受出口管制的 GPU 上的总支出很可能达到数十亿美元。
表 2. 各次训练运行的粗略规模
| 模型 | H100 等效数量 | Blackwell GPU 最佳估计 | Blackwell 区间 | 估计运行时长 |
|---|---|---|---|---|
| DeepSeek-V4-Flash | 3,500 | 1,500 | 250-5,000 | 50 天 |
| DeepSeek-V4-Pro | 7,500 | 3,000 | 750-6,500 | 70 天 |
| Kimi K3 | 11,500 | 4,500 | 1,000-9,500 | 70 天 |
| MiniMax-M3 | 3,500 | 1,500 | 200-7,000 | 60 天 |
| Ling-3.1-flash | 4,000 | 1,500 | 400-6,500 | 100 天 |
| 全部五个 | 30,000 | 12,000 | 7,000-22,000 |
每项估计值等于一次运行的训练算力除以单块 Blackwell GPU 在该运行期间提供的算力,四舍五入到最接近的 500。训练算力约为每个训练 token 每活跃参数六次运算,另加注意力部分。我们假设 GPU 以约 20% 的峰值速度运行,这与其它已披露的 Blackwell 训练运行一致(DeepSeek 为 25%,其上一代模型曾报告 39%),运行时长则采用表中所示数值,由我们根据发布时间线估算。H100 等效数量按 NVIDIA 公布的峰值速度换算。一块 B200 或 B300 约等于 2.3 块 H100,一块 GB200 或 GB300 约等于 2.5 块。
我们对这些估计并没有把握。它们依赖一些权重无法证实的假设。各实验室使用 GPU 的效率(通常称为 MFU),没有实验室公布过这些运行的 MFU;每个模型训练所用的 token 数(DeepSeek 的数字来自其自身,我们选择采信;其余为我们自己的估计,用一种尚未发表的方法从权重推算得出);每次运行持续了多久,没有实验室说明过;以及训练始终在生成这些权重的硬件上完成。运行时长影响最大,因为它减半就意味着 GPU 数量翻倍。两次在同一硬件上披露的运行显示了差距有多大。Mistral 称其在 3,800 块 Grace Blackwell GPU 上训练了 Mistral Large 4,其活跃参数数量与 DeepSeek-V4-Pro 相同;微软则称其在 38 天内用 16,000 块 GPU 训练了 MAI-Base-2,一个规模相近、训练数据更多的模型。按这个速度,本文中最大的两次运行大约需要 8,000 到 9,000 块 Blackwell GPU。这些数字只涵盖每个模型的最终训练运行,不包括实验、此前的运行或推理服务。
2026 年 11 月 12 日修订。本报告初版给出的数字是 2,000 至 3,000 块 Blackwell GPU,最大集群耗资 1.5 亿到 2 亿美元。这些数字假设 GPU 的运行效率与 NVIDIA 自家基准测试相当,而已披露的 Blackwell 训练运行效率低于这一水平。上文中的估算取代了这些数字。我们还补充了 H100 等效算力与预估运行时长。
我们的调查
模型的权重(也称参数)是数十亿个可调数值,决定了模型如何处理信息、生成回答。训练过程会反复调整这些数值;但在训练开始之前,它们需要有初始值。在本文考察的软件中,这些初始值来自一种名为 Philox 的伪随机数生成(PRNG)算法。Philox 以确定性的方式生成看似随机的数字。Philox 的起始输入是一个称为“种子”的数字。只要种子和设置相同,Philox 每次都会生成相同的数字。工程师因此可以从同一出发点复现实验。
为了快速填充数十亿个权重,PyTorch(大多数主流 AI 模型开发所用的软件框架)把 Philox 的工作分摊给 GPU 上众多并行工作者,即线程。(具体由 cuRAND 实现,它是 NVIDIA 的随机数生成库。)每个线程根据种子生成自己的数字序列,并填充一组特定的位置。线程数量决定了这些位置如何分配。在本文考察的 NVIDIA 芯片上,规模足够大的初始化会让每个处理单元(称为流式多处理器,SM)用满 2,048 个线程的上限。因此,SM 更多的芯片会把同一项任务分给更多工作者,数字的落点也随之改变。
图 1 展示了一块简化 GPU 上的运作方式。6 个 SM,每个 SM 8 个线程,共 48 个线程。把权重想象成一长排空盒子,为了排进页面而折成网格。第一个线程填第一个盒子,第二个线程填第二个盒子,依此类推,直到全部 48 个线程。然后第一个线程的下一个数字进入第 49 个盒子,再下一个进入第 97 个盒子,以此类推。黑色轮廓沿着这个线程穿过网格。第一个线程填充每隔 48 个位置。颜色标识每组数值由哪个处理单元提供,右图中的亮度则代表数值本身。
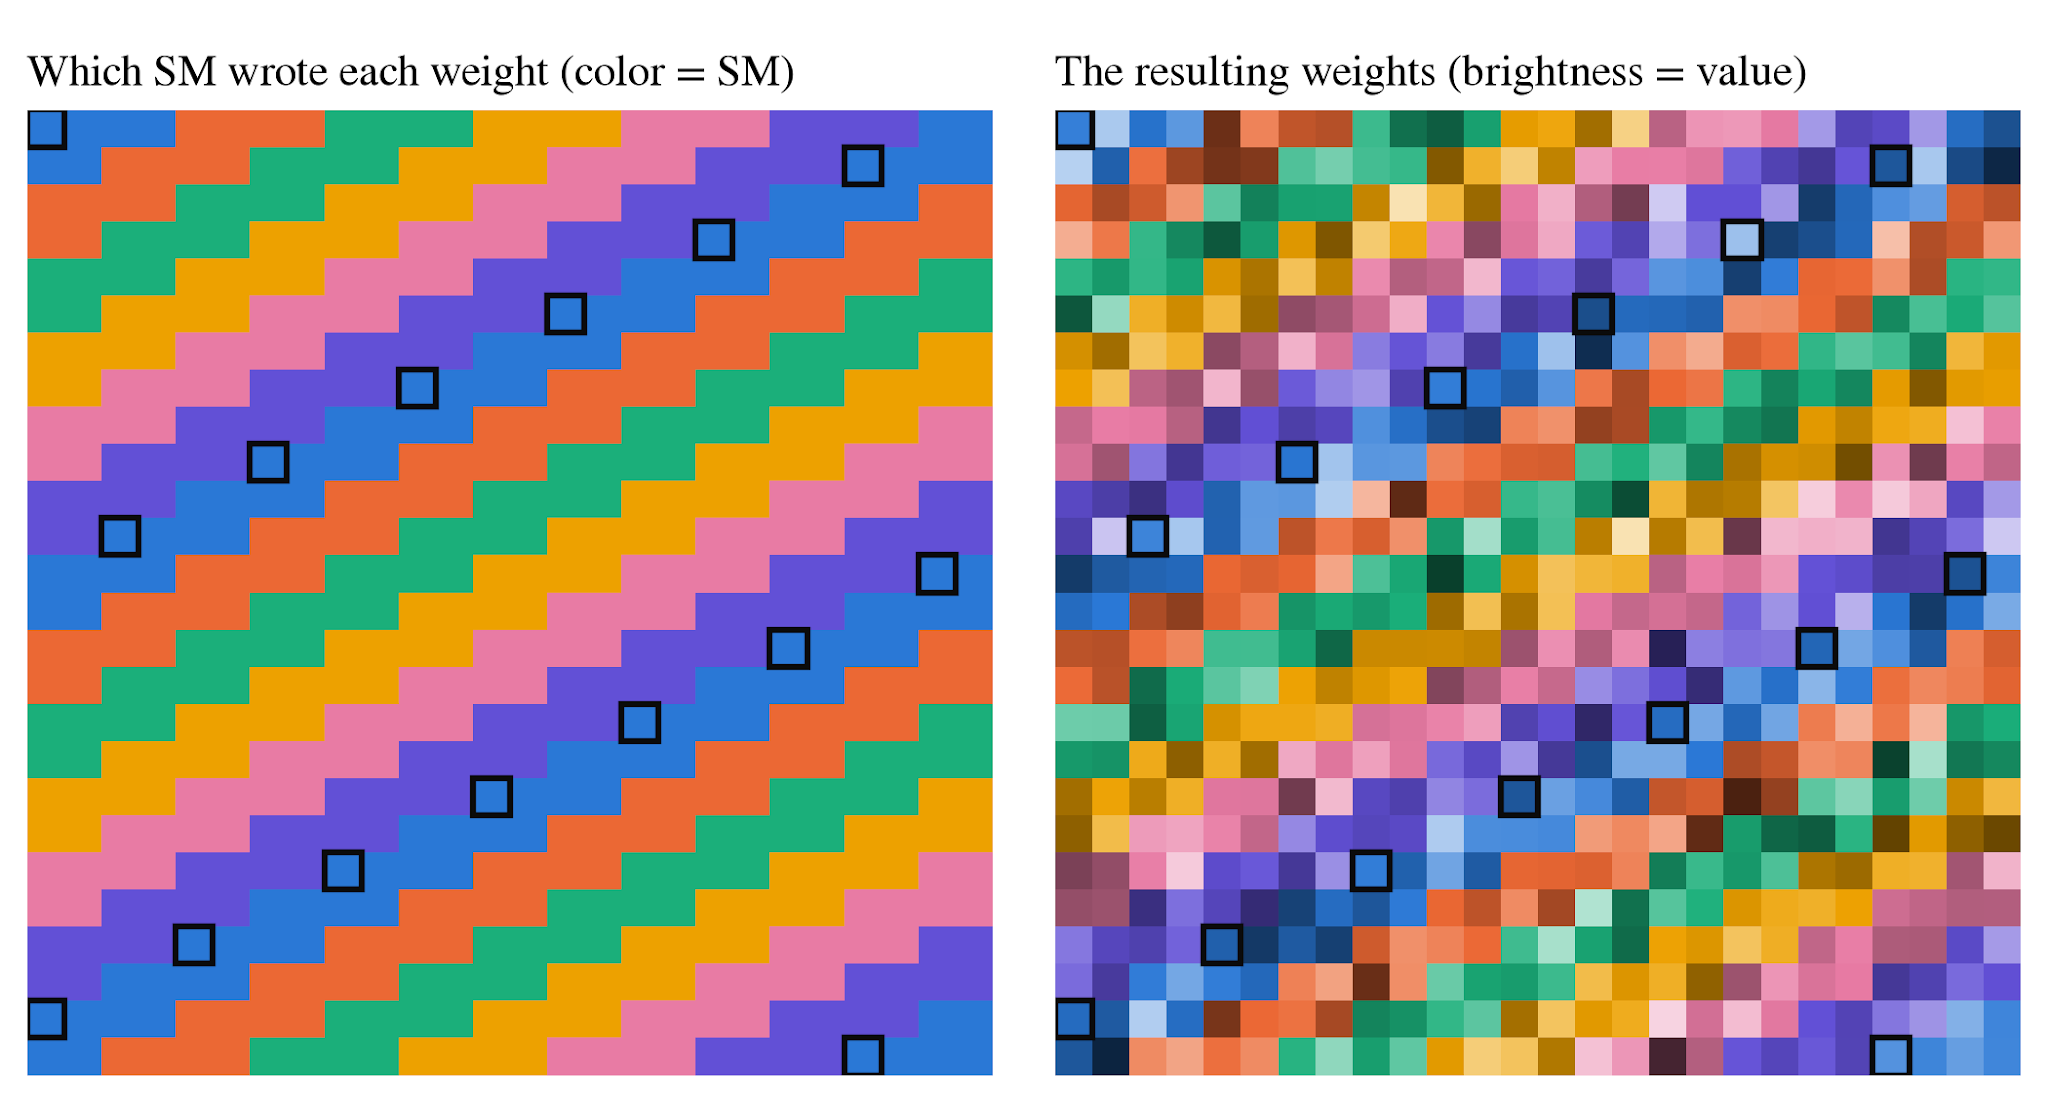
图 1. GPU 如何填充权重。这个简化示例使用 6 个处理单元、每单元 8 个线程,共 48 个线程。描边的单元格属于线程 0,它填充每隔 48 个位置的那个位置。真实芯片使用的线程多得多,但放置规则相同。
现在保持种子不变,改用 5 个 SM 的 GPU 而不是 6 个。在简化示例中,这意味着 40 个线程而不是 48 个。第一个线程生成的序列完全相同,但它的数字现在落在第 1、41、81 个格子里,而不是第 1、49、97 个。图 2 追踪了这些数字随位置变化的情况。在整个网格上,只有 6% 的数值与原始排布一致。种子是对的,线程数是错的。正因如此,模型权重的排布才能成为判断所用芯片的线索。
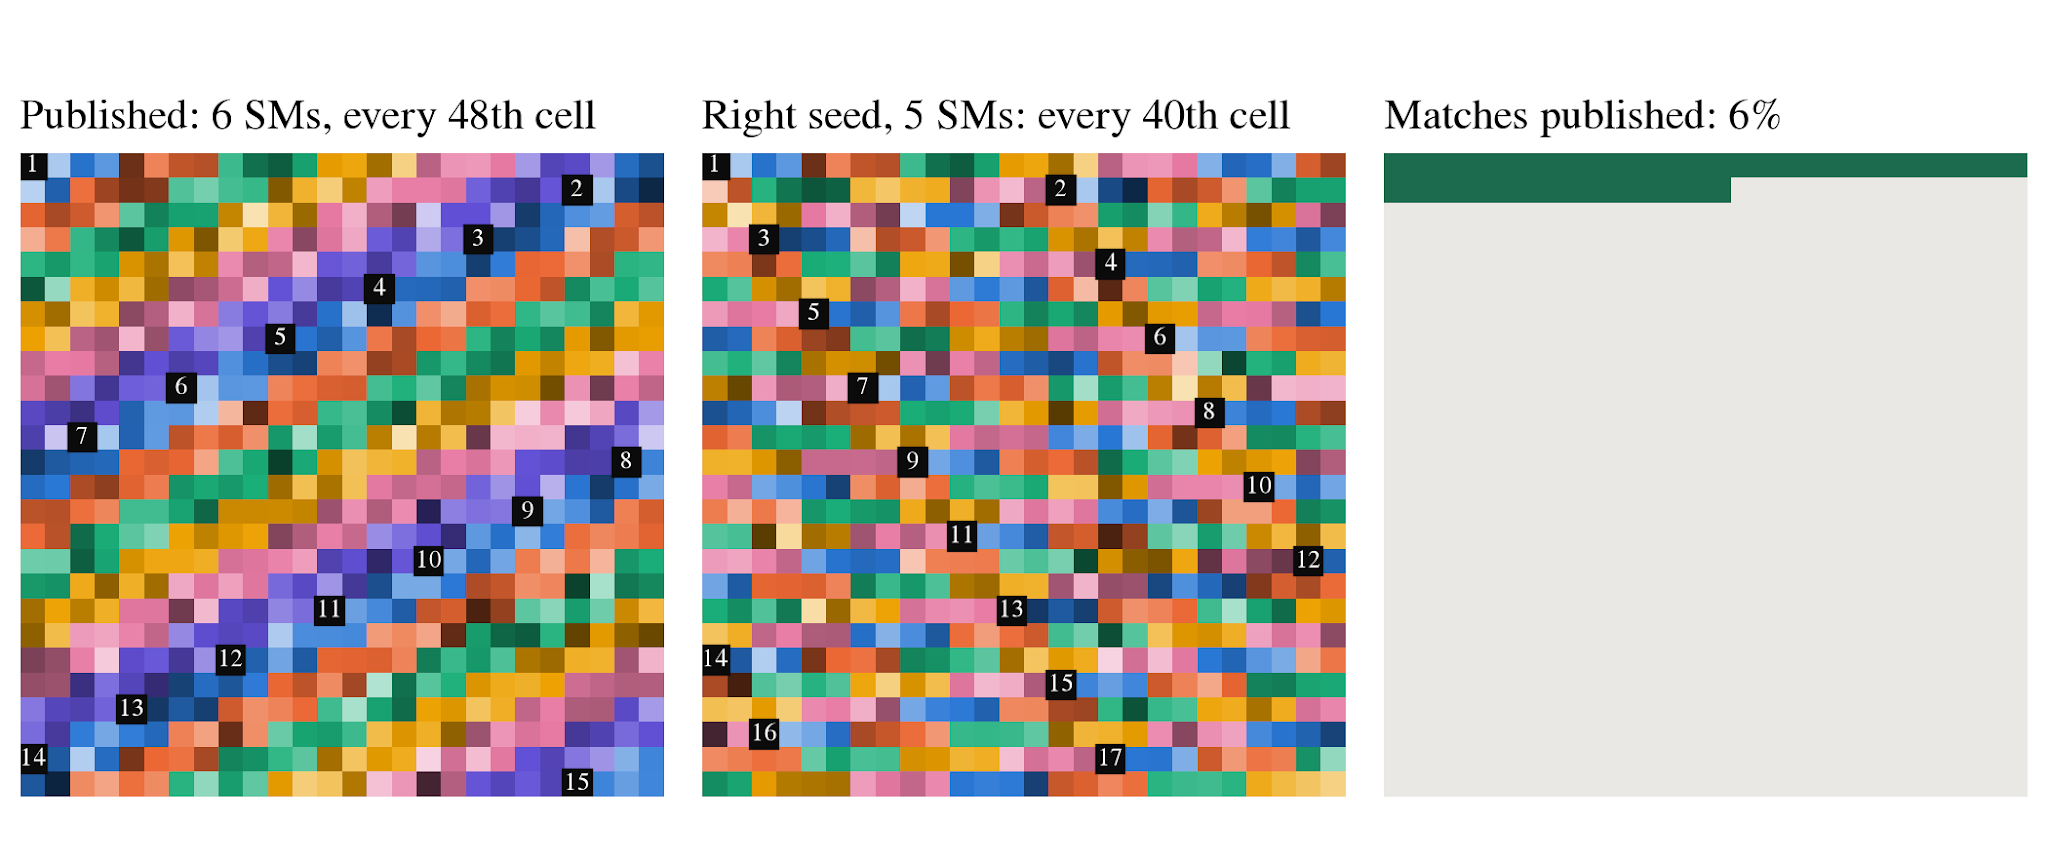
图 2. 同一个种子,不同的 GPU。在这个玩具示例中,5 个处理单元、40 个线程,线程 0 生成的序列相同,但填充的是每隔 40 个位置,而不是每隔 48 个。显示的矩阵中只有 6% 与原始排布一致。
因此,要复现权重,必须同时满足两个条件。种子必须生成正确的数字,线程数必须把它们放到正确的位置。种子正确而线程数错误,得到的多半是正确数字落在错误位置;线程数正确而种子错误,得到的则是不同的数字。图 3 展示了为什么只有正确的组合才能重现原始排布。
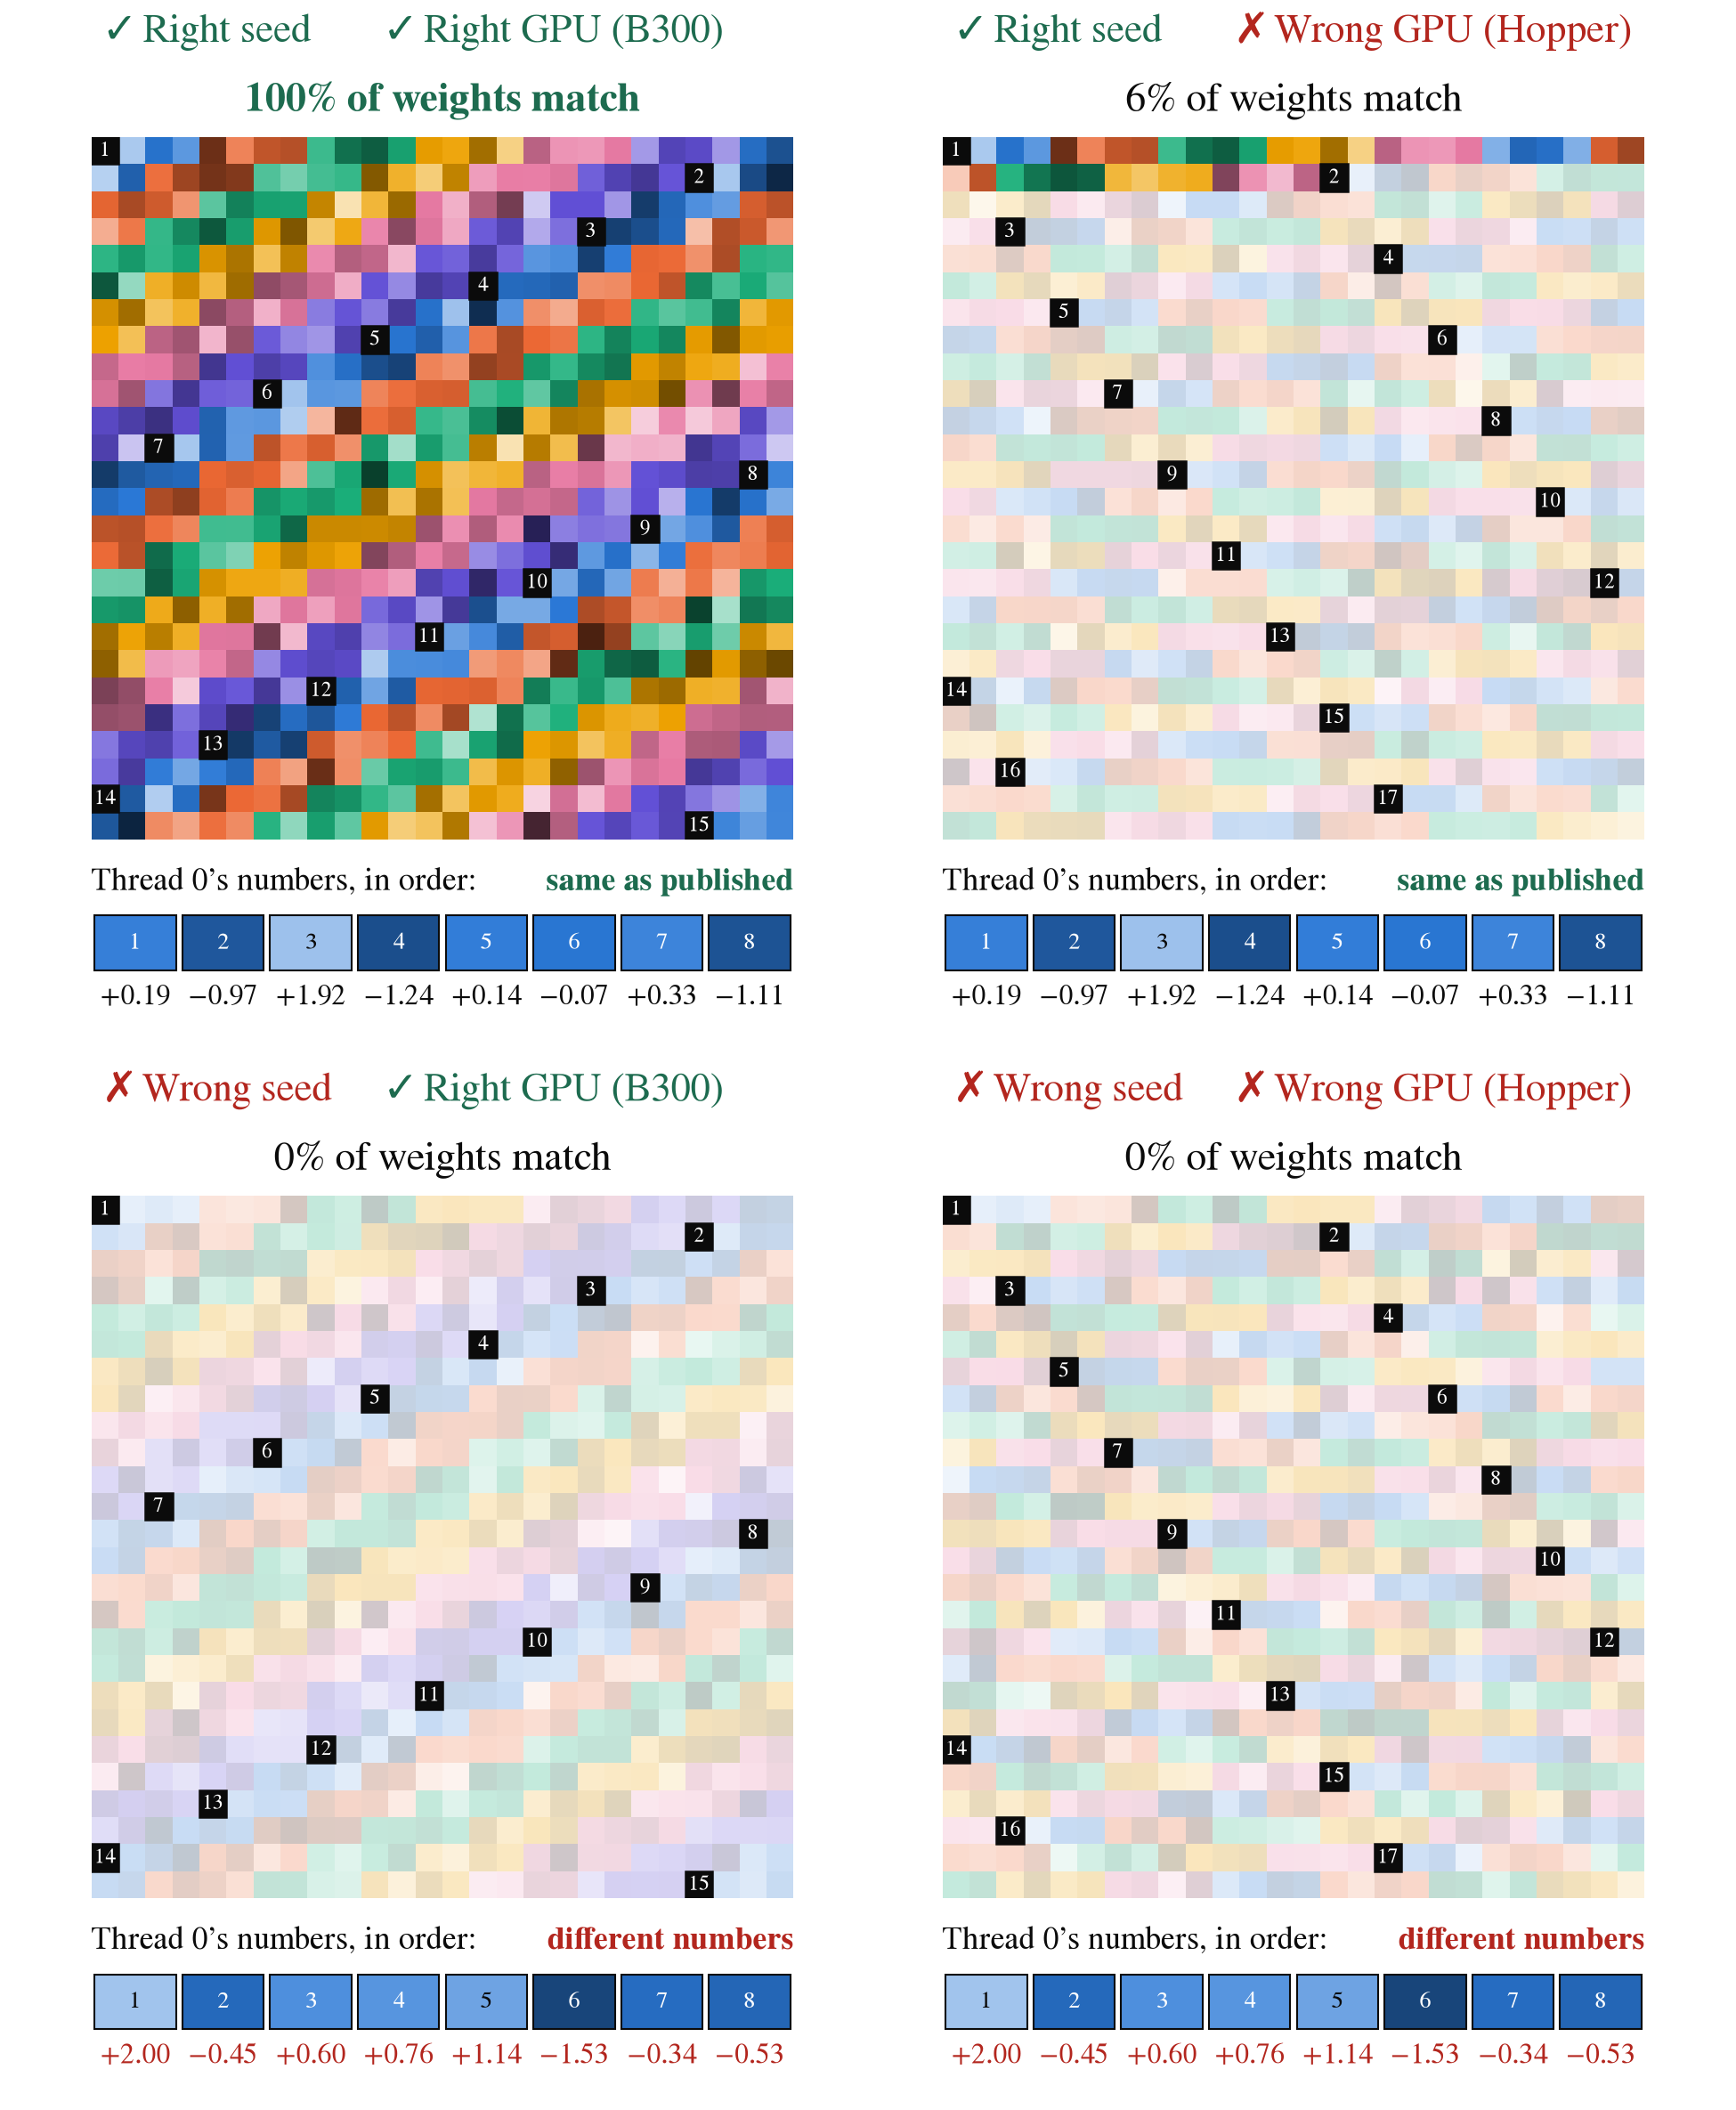
图 3. 种子和布局必须同时匹配。只有当种子和线程数都正确时,才能复现原始矩阵。改动其中任何一个,大部分匹配都会消失。简化芯片分别代表 Blackwell B300 和 Hopper H100。颜色变淡的单元格与已公布的权重不同。带编号的单元格显示线程 0 的数字落在何处,每个面板下方的条带显示这些数字本身。
在真实芯片上,线程数要大得多,但原理相同。本文考察的 NVIDIA 配置中,Hopper H100 SXM、H200 和 H800 有 132 个 SM,使用 270,336 个线程;Blackwell B200/B300 有 148 个 SM,使用 303,104 个线程;Blackwell GB200/GB300 有 152 个 SM,使用 311,296 个线程。因此,还原出线程数就能知道初始排布对应哪一组硬件,但无法区分同一组内的不同芯片。例如,匹配到 Hopper 并不能区分 H800、H100 和 H200。
问题在于,这种排布在训练后还剩下多少,足以让我们还原出来。有些权重,比如分配给训练中从未出现过的词或符号的权重,可以始终不被触及,几乎原封不动地保留初始值。我们可以把这些保留下来的值,与候选种子和线程数生成的初始值直接比对。图 4 展示了这样的比对。DeepSeek-V3 保留下来的权重与 Hopper 排布吻合,DeepSeek-V4-Flash 的则与 Blackwell 排布吻合。
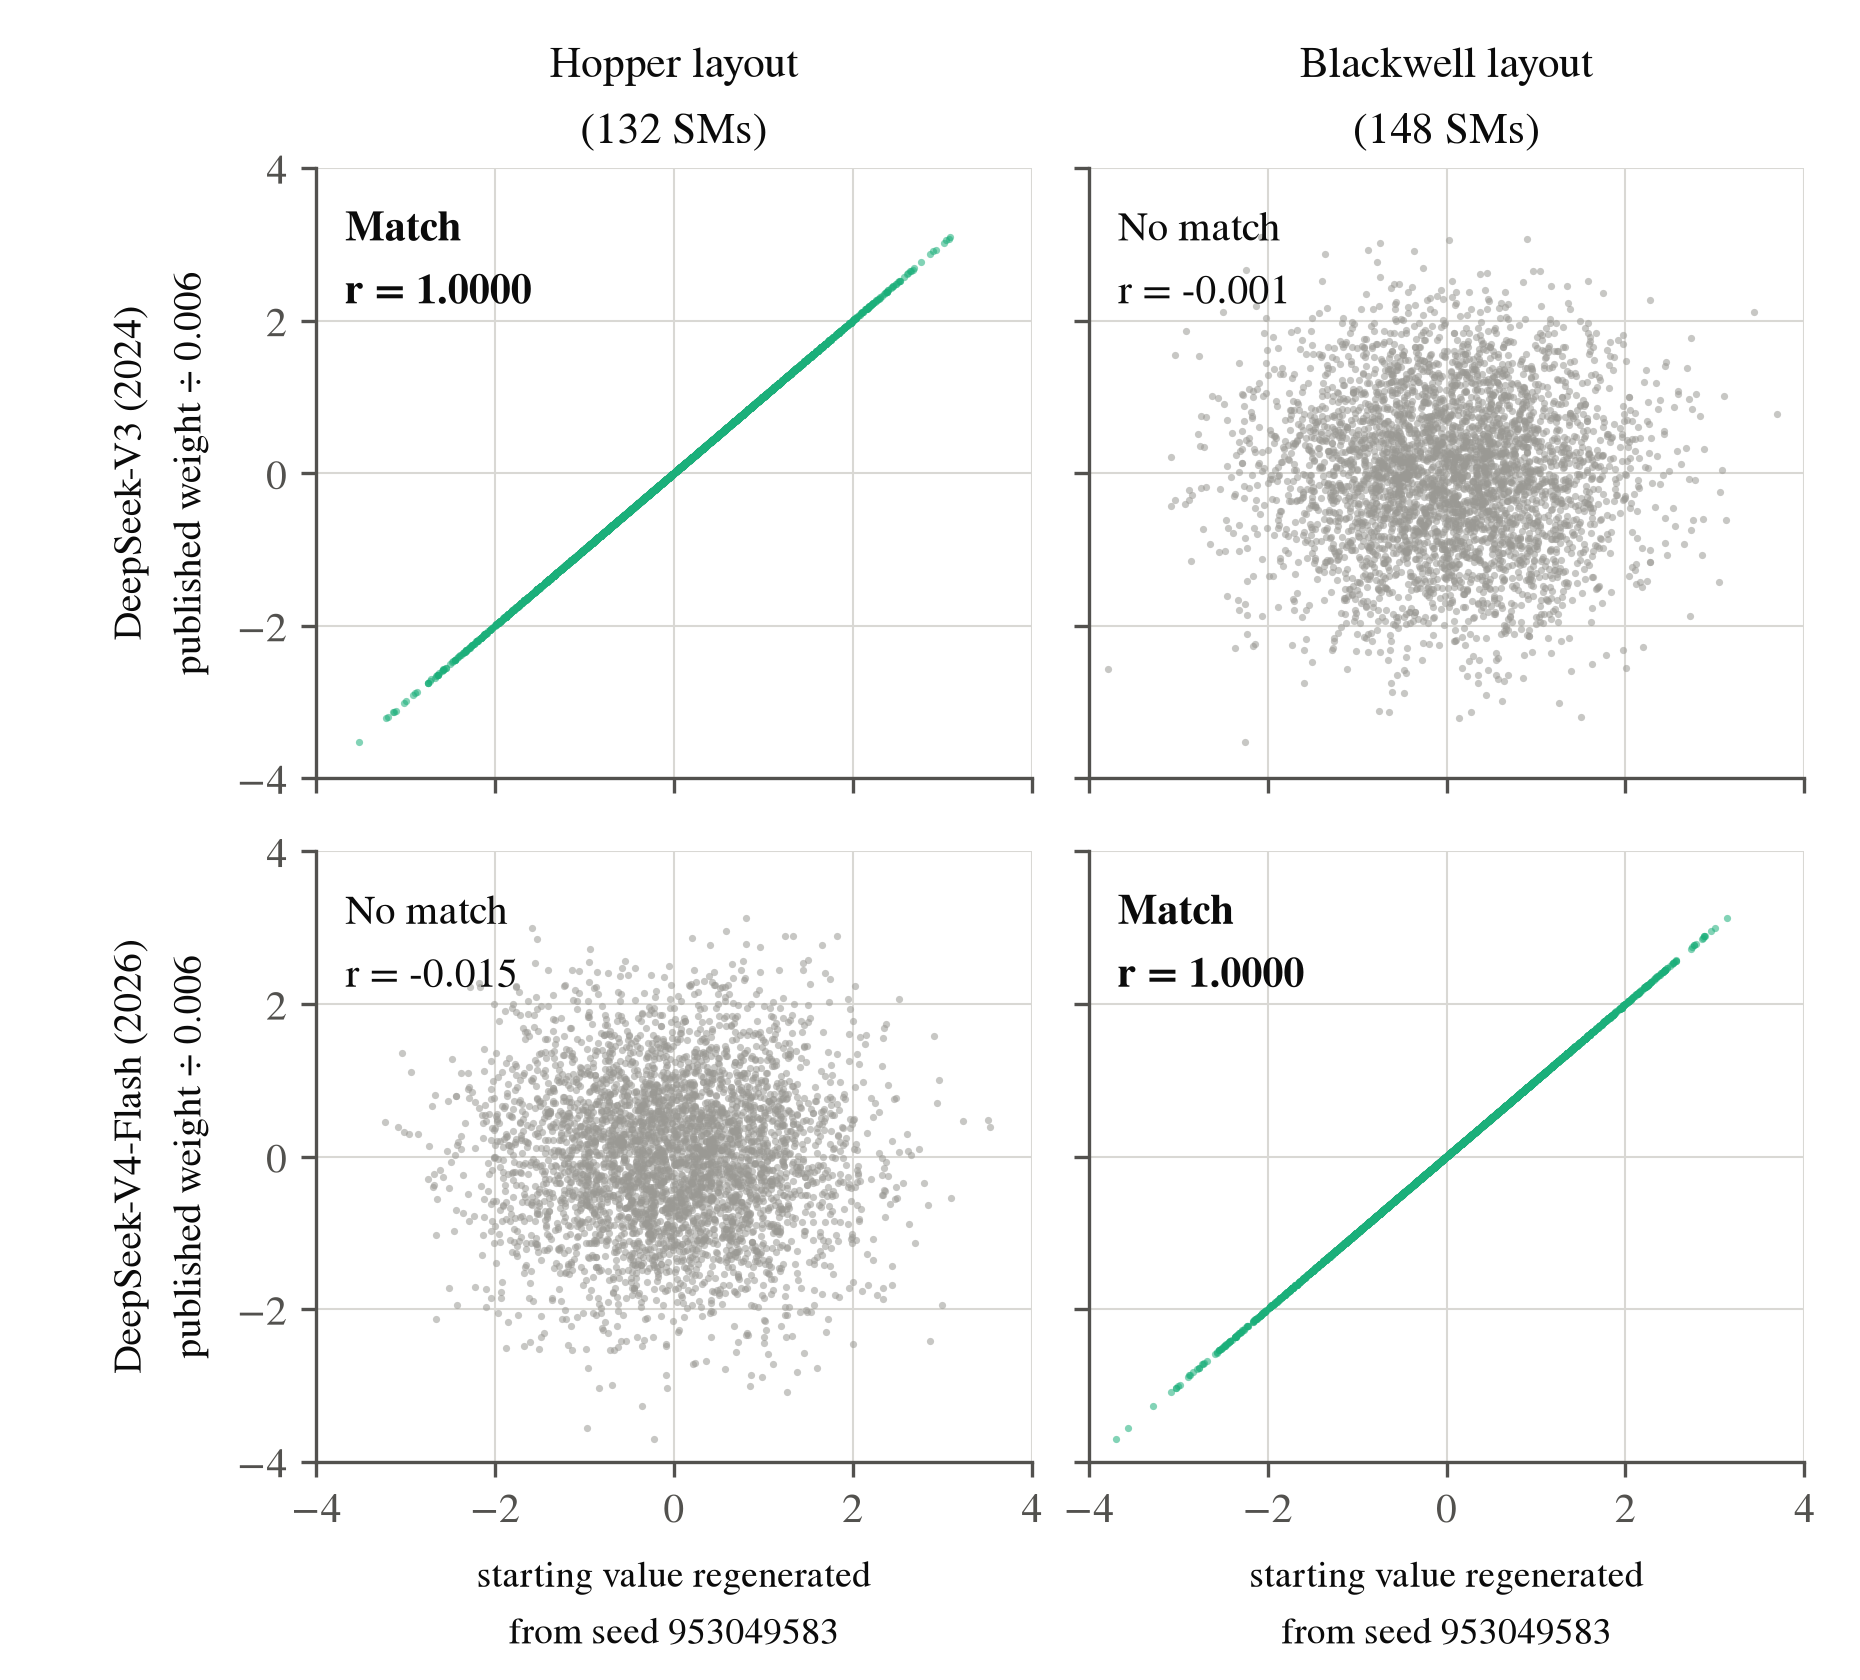
图 4。保留下来的初始值揭示了排布方式。每个点将一个已发布的权重与由种子重新生成的值作比较。落在对角线上表示两者一致。DeepSeek-V3 与 Hopper 排布吻合,V4-Flash 与 Blackwell 排布吻合。各面板展示每个模型四行保留下来的权重中的 4,096 个值。
即便是训练已经改变过的权重,也可能残留初始值的微弱痕迹。每个最终权重等于其初始值加上训练过程中的全部调整量。只要这些调整没有完全抵消或淹没初始差异,其中一部分差异就会留存下来。举例来说,两个初始值分别为 0.2 和 0.8 的权重,各自增加约 0.1 之后,先后顺序依然不变。真实的调整量变化要大得多,所以单看一个权重说明不了什么。但在几十万个权重上,我们可以检验初始值较高的权重是否仍倾向于对应较高的最终值。图 5 展示了这种微弱但可测量的关系。这是在这些权重上得到的发现,并非保证在每次训练中都成立的性质。
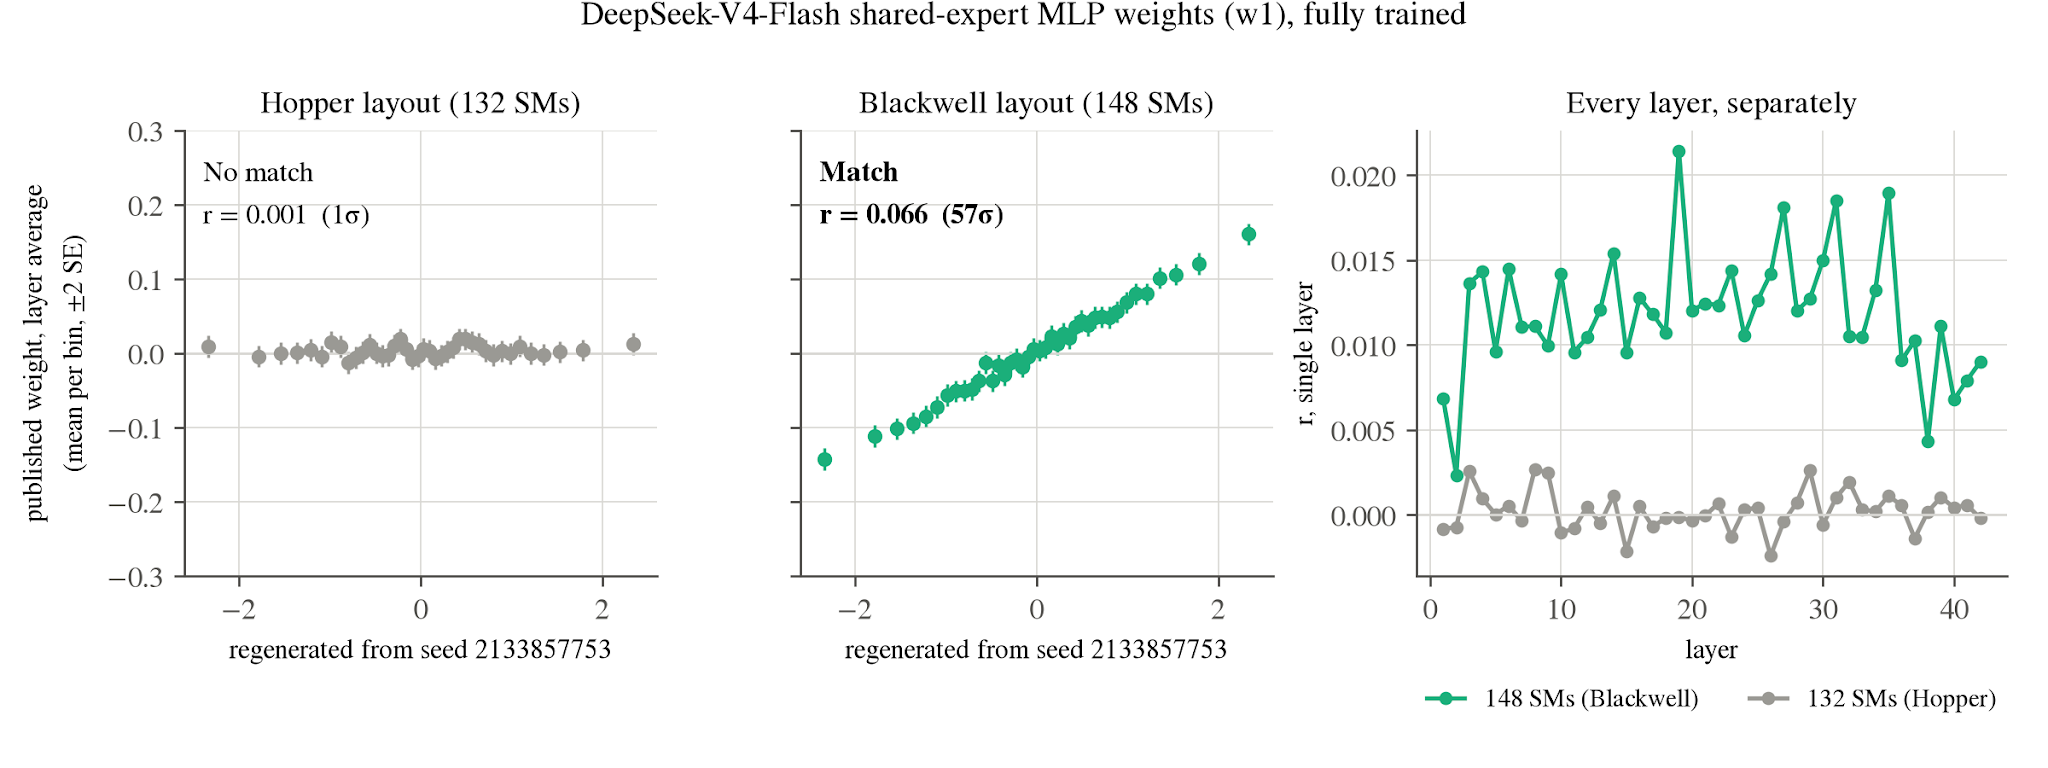
图 5。训练后的权重仍保留较弱的痕迹。左图和中图对 DeepSeek-V4-Flash 的 42 层逐层平均,每层 745,472 个权重。在 Blackwell 布局下,起始值越高,最终值仍略高(r = 0.066,57 sigma);在 Hopper 布局下,这一关系消失。右图展示的是单层中较弱的证据。
这些残留的痕迹让我们可以反推。假设有一个虚构的例子,沿用图 1 的布局,种子 7 让第一个线程产生 0.2、−0.5 和 0.8。若有 48 个线程,这些值会落在第 1、49、97 个位置;若有 40 个线程,则落在第 1、41、81 个位置。如果公开的权重保留了第一种模式,我们就可以尝试不同的候选种子和线程数,直到复现它。在实际调查中,我们比较的是对应位置上的数千个值。未经训练的权重可以完全吻合;训练后的权重可能只表现出上述较弱的相似性。无论哪种情况,我们都在寻找最能复现残留模式的组合。
接着,我们用未参与搜索的权重来检验这个组合。用一组权重选定种子和线程数之后,我们用它们去预测另一组权重的起始值,期间不调整任何参数来改善拟合。在这些此前未使用的权重上吻合,比只在帮助选定组合的权重上吻合更有说服力。图 6 展示了比较结果。DeepSeek-V3 与 Hopper H100 SXM、H200 或 H800 芯片的初始化布局吻合;DeepSeek-V4-Flash 与 Blackwell B200/B300 吻合;Kimi K3 与 Blackwell GB200/GB300 吻合。
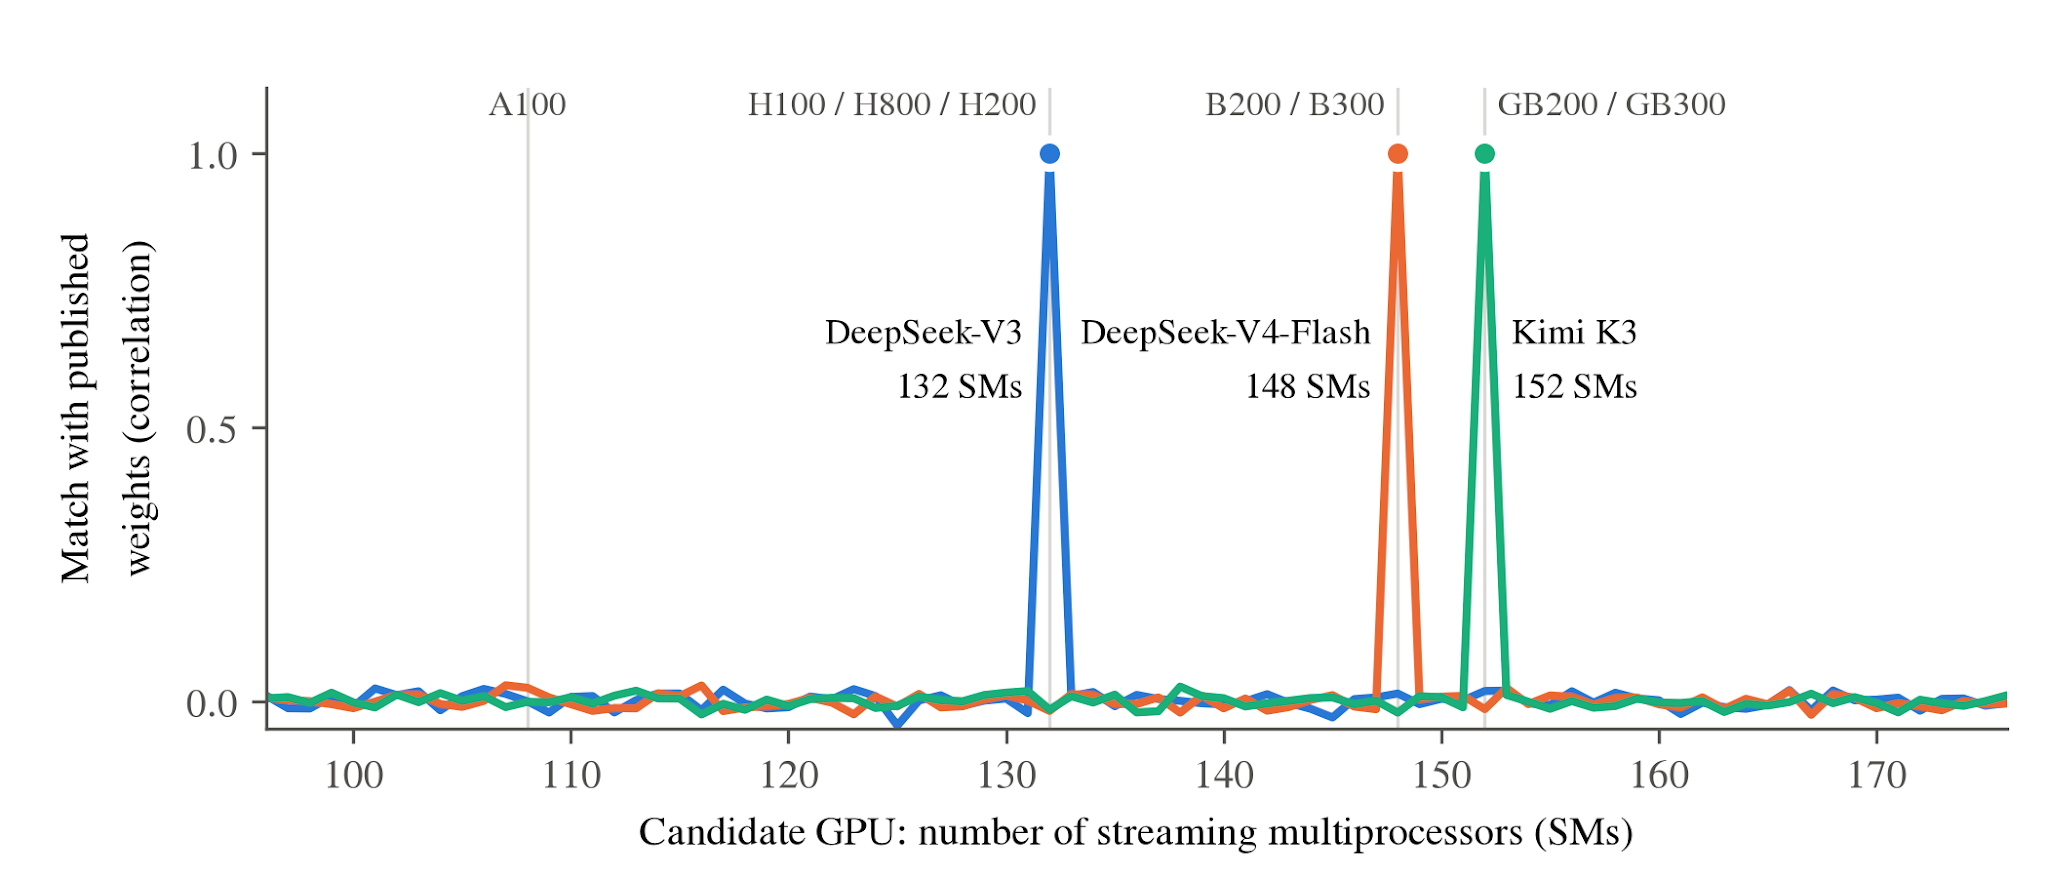
图 6。候选布局的比较。每个模型都有一个明显的峰值。DeepSeek-V3 在 132 个 SM,V4-Flash 在 148 个,Kimi K3 在 152 个。其他测试的布局得分接近零。
在调查中,我们发现来自四家中国公司的六个模型存在强烈暗示在 Blackwell 芯片上初始化的模式。DeepSeek 的 DeepSeek-V4-Flash 和 DeepSeek-V4-Pro,Moonshot AI 的 Kimi K3 和 Kimi K3.1-Pro,MiniMax 的 MiniMax-M3,以及 Ant Group 的 Ling-3.1-flash。V4-Flash 和 MiniMax-M3 与 148 个 SM 的布局吻合,其余四个与 152 个 SM 的布局吻合。这些是起始权重的指纹,它们支持但并不单独证明这些 AI 模型是在 Blackwell 芯片上训练的。
本次调查的局限
需要说明的是,我们用来识别这些模型初始化硬件的取证方法只对部分模型有效。它需要公开的权重,因此闭源模型无法核查。它还需要生成初始权重的软件留下可识别、且与硬件相关的特征。本文考察的这些 GPU 上,PyTorch 会留下这样的特征;百度训练 ERNIE-5.5 所用的 PaddlePaddle 框架则不会。我们能够还原出 ERNIE-5.5 的种子(2760),但无法确定它是在哪种硬件上初始化的。同样,在普通处理器而非 GPU 上初始化的权重不会留下 GPU 指纹;阿里巴巴的若干 Qwen3 模型就是这样初始化的,因此无法追溯训练它们用了哪些 GPU。美团称 LongCat-2.0 在“AI ASIC 超节点”上训练,但我们在该模型中同样没有找到指纹;DeepSeek-V4.1-Flash 也是如此,尽管我们做了穷尽式搜索。
该方法识别的是生成初始权重的硬件,而不是此后参与训练的全部芯片。如果一次训练在将要用于训练的同一批 GPU 上生成权重,指纹就同时指向两者。但实验室也可以在一个系统上生成权重、再迁移到另一个系统,或者在新的硬件上继续训练已有模型。仅凭权重无法排除这些可能。混合集群带来同样的限制。如果部分权重由 NVIDIA 芯片生成,此后又由华为芯片参与训练,NVIDIA 的特征可能保留下来,却不暴露华为的参与。不同代际的 NVIDIA 芯片可能在各自初始化的部分留下不同特征,前提是这些痕迹没有消失。在 Kimi K3 中,至少 64 个各自设定种子的进程都留下了相同的 152-SM 布局。因此,一个与 Blackwell 兼容的特征可以支持其在初始化阶段被使用(下文所述的 AMD 替代解释除外),但不能证明整个训练过程都用了 Blackwell。同理,Hopper 特征也不能排除此后在 Blackwell 上继续训练的可能。
权重同样无法揭示芯片归谁所有、位于何处。Blackwell 系统可以从中国境外的数据中心租用。这些证据只涉及硬件的获取途径,本身并不能证明芯片被走私进中国,也不能证明存在违反出口管制的行为。
其他芯片能否产生这些与 Blackwell 兼容的布局?在此测试的 NVIDIA 各型号中,较老的芯片做不到。软件可以让一颗芯片只用其中一部分处理单元,却无法让它拥有超出物理规格的处理单元。在此考察的 PyTorch 标准行为下,它们无法产生 148 或 152 个 SM 的布局。面向中国市场的 Blackwell 显卡每个 SM 的线程数不同,两种总数都产生不了。
AMD 则提供了另一种可能。MI300X 通常使用 304 个处理单元,但可以分成两组各 152 个,也可以配置为只使用 148 个。其随机数软件同样能生成与 NVIDIA 相同的底层序列。这类配置极不寻常,但我们在实机 MI300X 上确认过,限制为 152 或 148 个单元时,它能复现我们归因于 Blackwell 的布局,因此仅凭布局无法定论。
为区分两者,我们在数值本身中寻找细微的数值差异。AMD 与 NVIDIA 在生成随机数的过程中有一处计算略有不同。在实机 MI300X 上,DeepSeek-V4-Flash 保留的权重指向 NVIDIA。在两家厂商结果不同的 377 个数值中,公开权重有 363 个与 NVIDIA 一致,与 AMD 一致的为零。同样的测试无法对其余五个模型下定论,但我们认为 AMD 的解释对它们而言极不可能。在常规配置下,MI300X 两种布局都产生不了;实验室必须把整个集群都配置成与 Blackwell 芯片相同的处理单元数才行。其他公开证据同样指向 Blackwell。美国官员和媒体报道均称 DeepSeek 和 Moonshot AI 在使用 Blackwell 芯片,蚂蚁集团的公开代码中也包含在 GB300 上生成的基准测试结果。
验证我们的发现
为了复现“DeepSeek-V3 对应 Hopper、DeepSeek-V4-Flash 对应 Blackwell”这一结果,我们在 Hopper 级别的 NVIDIA H100 和 Blackwell 级别的 NVIDIA B300 上运行了未经修改的 PyTorch。我们此前已确定 DeepSeek 的随机种子为 953049583,并发现该种子同时用于 DeepSeek-V3 和 DeepSeek-V4-Flash 的初始化。使用这个种子,H100 复现出了 DeepSeek-V3 中保留的初始值,但复现不出 V4-Flash 的;B300 复现出了 V4-Flash 中保留的值,但复现不出 V3 的。 在 B300 上,未经修改的 PyTorch 复现了 DeepSeek-V4-Flash 中 469 个选定行里的 461 个,相关系数均高于 0.99,其中 445 个完整行逐位一致。另有 8 个选定行被训练部分改变。在 H100 上,它逐位复现了 DeepSeek-V3 中全部 57,344 个保留值。两块芯片都无法复现对方模型所保留的行。将种子改动 1,两台机器上都复现不出任何匹配行。在一台租用的 GB200 上,未经修改的 PyTorch 同样使用 Moonshot 的种子 20256586 复现了 Kimi K3 全部 13 个保留行;将种子改动 1,则一个都复现不出。重复这些检查所需的代码和保留权重均已公开;同样的比对也可以在没有 GPU 的情况下运行。
在答案已知的情况下,我们的取证方法同样能给出正确答案。有 24 个案例,开发者已公开指明某个具体模型背后的硬件;我们的取证方法与这 24 个案例全部吻合。Meta 的 Llama 3.1 系列模型在 H100 上训练,读数为 132;EleutherAI 的 Pythia 系列中有 8 个模型在 A100 上训练,读数为 108。NVIDIA 自家的 Nemotron-3 Ultra 在其技术报告中指明某一训练阶段使用了 GB200,读数为 152,与 Kimi K3 相同。DeepSeek 和 Moonshot 曾报告早期模型使用过 H800。我们的 Hopper 读数与这些披露一致,但同样与 H100 SXM 或 H200 硬件相符;这些读数并不能独立证实 H800 的使用。
将已发布的权重与某个候选种子和芯片布局所生成的数据进行比对时,即使候选方案是错的,也难免存在一定程度的相似。多少相似度才算证据,取决于我们比对了多少个权重。几个数值吻合很可能只是巧合,而数千个数值吻合就很难用偶然来解释。我们的统计模型会考虑参与比对的权重数量,并衡量实际观测到的匹配程度超出随机预期相似度多少。这个差距用标准差(sigma)表示。分数越高,说明“匹配出于偶然”这一假设所面临的证据越强,前提是统计模型正确描述了数据中的随机波动。
我们还要考虑尝试了多少个候选组合。搜索大约六万亿种 seed 与 layout 的组合,意味着我们有数万亿次机会撞上一个幸运的匹配。在正态分布模型下,五 sigma 或更高的正匹配大约每 350 万次比较才会偶然出现一次。单次测试中出现这样的结果会很惊人,但在我们如此大规模的搜索中,某处出现这种情况并不意外。因此,我们以大约八 sigma 作为基准,用来评估整个搜索范围内的偶然匹配。
我们的发现远超这一基准。 我们先用一组权重选定 seed 和 layout,再在与选择过程无关的另一组权重上测试同一组合。这一步检验的是,表面上的指纹是否超出了引导我们找到它的那些数字。六个模型各自的最强证据在 49 到 1,385 sigma 之间;即便最弱的单项测试也达到 20 sigma。在我们的统计模型下,这些结果太强,不可能归因于偶然相似。它们构成了共享初始化模式的证据;至于究竟是哪种计算硬件产生了这一模式、以及它是否也承担了训练,则需要上文讨论的另外一些论证。
结论
基于我们的取证调查,我们认为有强证据表明六个中国 AI 模型是在受出口管制的 NVIDIA 硬件上完成初始化的,而对 DeepSeek-V4-Flash 而言证据是确凿的;我们认为这一初始化也强烈暗示它们在同一批受出口管制的硬件上完成了训练。这留下了其他未解问题,例如开发这些模型的公司是通过什么途径获得受出口管制的 NVIDIA 系统的,但我们认为这一事实值得公众紧急关注。
附录 1 · 各中国实验室硬件随时间的变化
各实验室历代模型上的硬件指纹。
DeepSeek 在多个模型世代中复用同一个 seed,Moonshot 则用同一条规则推导其 seed,因此我们可以逐个模型追踪各实验室的硬件。日期为权重发布的时间。
| 模型 | SM 数 | 硬件级别 | 对华出口 | 证据 |
|---|---|---|---|---|
| DeepSeek | ||||
| V2-Lite, MoE-16B | 108 | A100 / A800(Ampere) | A800 在 2023 年 11 月前合法 | 完全一致 |
| LLM 7B/67B、Coder、V2、V3(2024 年 12 月)、V3.2 | 132 | H100 / H800 / H200(Hopper) | 芯片未识别 | 完全一致;V3 239σ |
| V4-Flash(2026 年 4 月) | 148 | B200 / B300(Blackwell) | 需许可证;未见报道 | 完全一致,1,385σ |
| V4-Pro(2026 年 4 月) | 152 | GB200 / GB300(Grace-Blackwell) | 需许可证;未见报道 | 部分存活,49σ |
| Moonshot AI | ||||
| Kimi K2(2025 年 7 月) | 132 | H100 / H800 / H200(Hopper) | 芯片未识别 | 部分存活,292σ |
| Moonlight-16B;Kimi-Linear(2025 年 10 月) | 132 | H100 / H800 / H200(Hopper) | 芯片未识别 | 完全一致;Kimi-Linear 763σ |
| Kimi K2.5(2026 年 1 月) | 132 | H100 / H800 / H200(Hopper) | 芯片未识别 | 未训练行,r 0.9975,255σ |
| Kimi K2.7-Code(2026 年 6 月) | 132,另有一个 148-SM 部分 | Hopper,另有第二个来源与 B200 / B300 吻合 | 混合 | 148 部分共 254 行,剔除 132 部分后 246σ |
| Kimi K3(2026 年 7 月)、K3.1-Pro(2026 年 11 月) | 152 | GB200 / GB300(Grace-Blackwell) | 需许可证;未见报道 | 完全一致,各 305σ |
| MiniMax | ||||
| Text-01(2025 年 1 月)、M1、M2 至 M2.7(2026 年 4 月) | 132 | H100 / H800 / H200(Hopper) | 芯片未识别 | 未训练行;2,048 个网格之一 |
| M3(2026 年 6 月)、M3.1-Flash(2026 年 10 月) | 148 | B200 / B300(Blackwell) | 需许可证;未见报道 | 完全一致,323σ |
| Ant Group | ||||
| Ling-1T†(2025 年 10 月)、Ling-3.0-flash(2026 年 8 月) | 132 | H100 / H800 / H200(Hopper) | 芯片未识别 | 未训练行,r 0.98;345σ、193σ |
| Ling-3.1-flash(2026 年 10 月) | 152 | GB200 / GB300(Grace-Blackwell) | 需许可证;未见报道 | 未训练行,r 0.98,244σ |
| 其他实验室 | ||||
| GLM-5.3(智谱)、Qwen3.8(阿里巴巴) | 132 | H100 / H800 / H200(Hopper) | 芯片未识别 | 部分存活,46σ、478σ |
| Hy4-preview(腾讯)、Step-5-Preview(阶跃星辰) | 132 | H100 / H800 / H200(Hopper) | 芯片未识别 | 完全一致,各 256σ |
| MiMo-V2.5-Pro(小米)、Qwen3.5-397B(阿里巴巴) | 132 | H100 / H800 / H200(Hopper) | 芯片未识别 | 部分存活,41σ、323σ |
证据列怎么读。精确副本指训练从未更新过的权重,能以高于 0.999 的相关性(r)复现生成值。未训练行同理,只是模型的起始值被截断或取整,因此 r 更低。部分存活指训练过的权重保留了部分起始值。网格扫描的数字来自被排除在搜索之外的单元。即使搜遍所有 32 位种子和所有网格,随机猜测也达不到 8σ;六项 Blackwell 结果中最低的一项(针对 V4-Flash 训练后的注意力权重)是 20σ。
† 结果来自一次分析,尚未重跑。
Kimi K2.7-Code。它的 254 个保留行混合了两个来源。约 80% 是继承自 K2.5 的 Hopper 布局值,约 20% 是符合 148-SM 布局的新抽样。每一行里的混合比例都相同,这说明是合并过的 checkpoint,而非混用硬件;K2.7-Code 不计入六个 Blackwell 模型之中。
公开代码。蚂蚁集团的 cuLA 仓库包含 2026 年 3 月 31 日在 GB300 上生成的基准测试结果。2025 年 6 月,一位 DeepSeek 工程师在 GitHub 上写道“我们没有 SM100 GPU”(SM100 即 Blackwell)。
附录 2 · 所有已识别的模型
完整模型目录、已披露的硬件与证据说明。
在开发者公开说明过某个具体模型所用硬件的全部 24 个案例中,我们的判读结果都与之相符。其中 21 个来自我们最初的调查,另有 Kimi K2.5(H800)、Step-3.5-Flash(H800)和 ZAYA1(AMD MI300X)。这 24 个里有 11 个是 step-zero 检查点,且相关模型之间并不独立,因此这只是一次一致性检查,而非实测准确率。“未找到”指检索了模型卡、论文和仓库历史,均未发现关于硬件的表述。
| 模型 | 特征 | 开发者 | 公开披露的硬件 | 是否一致 | 出口状态(中国) |
|---|---|---|---|---|---|
| 中国 | |||||
| DeepSeek-V4-Flash, -Base | 148(B200/B300) | DeepSeek | 未披露 | - | 需许可证² |
| DeepSeek-V4-Pro-Base | 152(GB200/GB300) | DeepSeek | 未披露 | - | 需许可证² |
| Kimi K3; K3.1-Pro(同一种子) | 152(GB200/GB300) | Moonshot AI | 未披露 | - | 需许可证² |
| Ling-3.1-flash | 152(GB200/GB300) | Ant Group | 未找到 | - | 需许可证² |
| MiniMax-M3; M3.1-Flash(同一初始化) | 148(B200/B300) | MiniMax | 未找到 | - | 需许可证² |
| Kimi K2.7-Code | 132,另含一个 148 部分⁵ | Moonshot AI | 未找到 | - | 未定⁴ |
| Kimi K2.5; K2.6(同一初始化) | 132(Hopper) | Moonshot AI | H800 | 是 | 未定⁴ |
| Kimi-Linear-48B | 132(Hopper) | Moonshot AI | 未找到 | - | 未定⁴ |
| Kimi K2-Base | 132(Hopper) | Moonshot AI | H800 | 是 | 未定⁴ |
| Moonlight-16B-A3B | 132(Hopper) | Moonshot AI | 未披露 | - | 未定⁴ |
| DeepSeek-V3-Base; V3.2(同一初始化) | 132(Hopper) | DeepSeek | H800 | 是 | 未定⁴ |
| DeepSeek-V2 | 132(Hopper) | DeepSeek | H800(报告整体) | 相符¹ | 曾存在合规版本³ |
| DeepSeek-Coder-1.3B | 132(Hopper) | DeepSeek | A100 与 H800(报告整体) | 相符¹ | 曾存在合规版本³ |
| DeepSeek-LLM-7B, 67B | 132(Hopper) | DeepSeek | 原始训练未披露 | - | 曾存在合规版本³ |
| DeepSeek-MoE-16B | 108(A100/A800) | DeepSeek | A100 或 H800(报告整体) | 相符¹ | 曾存在合规版本³ |
| DeepSeek-V2-Lite | 108(A100/A800) | DeepSeek | H800(报告整体) | 共享初始化¹ | 曾存在合规版本³ |
| Ling-3.0-flash | 132(Hopper) | Ant Group | 未找到 | - | 未定⁴ |
| Ling-1T; Ling-2.6-1T(同一初始化)† | 132(Hopper) | Ant Group | Hopper(报告整体) | 相符¹ | 未定⁴ |
| GLM-5, 5.1, 5.2, 5.3(同一初始化) | 132(Hopper) | Zhipu AI | 未披露 | - | 未定⁴ |
| GLM-5.3-Flash | 132(Hopper) | Zhipu AI | 未找到 | - | 未定⁴ |
| GLM-4.5-Base; GLM-4.7(同一初始化)† | 132(Hopper) | Zhipu AI | 未找到 | - | 未定⁴ |
| Qwen3.8-2.4T-A95B | 132(Hopper) | Alibaba | 未披露 | - | 未定⁴ |
| Qwen3.5-397B-A17B | 132(Hopper) | Alibaba | 未找到 | - | 未定⁴ |
| Hy3-preview; Hy3(同一初始化) | 132(Hopper) | Tencent | 未找到 | - | 未定⁴ |
| Hy4-preview | 132(Hopper) | Tencent | 未找到 | - | 未定⁴ |
| MiMo-V2-Flash; MiMo-V2.5-Pro | 132(Hopper) | Xiaomi | 未找到 | - | 未定⁴ |
| Step-5-Preview | 132(Hopper) | StepFun | 未找到 | - | 未定⁴ |
| Step-3.5-Flash; Step-3.7-Flash(同一初始化) | 132(Hopper) | StepFun | H800(Step-3.5-Flash) | 是 | 未定⁴ |
| MiniMax-M2, M2.1, M2.5, M2.7(同一初始化) | 132(Hopper) | MiniMax | 未找到 | - | 未定⁴ |
| MiniMax-Text-01, VL-01; M1(同一初始化) | 132(Hopper) | MiniMax | H800(报告整体) | 相符¹ | 未定⁴ |
| Seed-OSS-36B-Base | 108(A100/A800) | ByteDance | 未找到 | - | 曾存在合规版本³ |
| Yi-34B | 108(A100/A800) | 01.AI | 未披露 | - | 曾存在合规版本³ |
| 美国 | |||||
| Llama 3.1 8B, 70B, 405B | 132(Hopper) | Meta | H100 | 是 | 不适用 |
| Nemotron-3-Ultra-550B | 152(GB200/GB300) | NVIDIA | GB200(某一阶段) | 相符 | 不适用 |
| Nemotron-4-340B-Base | 132(Hopper) | NVIDIA | H100 SXM5 | 是 | 不适用 |
| ZAYA1-74B-preview | 304 CU(AMD MI300X) | Zyphra | AMD(其博客称 MI300X) | 是 | 不适用 |
| OLMo-2 32B, Olmo-3 32B | 132(Hopper) | AI2 | H100 | 是 | 不适用 |
| OLMo-7B | 108(A100) | AI2 | A100 | 是 | 不适用 |
| OLMo-7B-Twin-2T | 110 CU(AMD MI250X) | AI2 | AMD MI250X | 是 | 不适用 |
| OLMo-7B-0424, OLMo-1B-0724 | 132(Hopper) | AI2 | 未披露 | - | 不适用 |
| Pythia 70M-12B(8 个模型) | 108(A100) | EleutherAI | A100 | 是(全部 8 个) | 不适用 |
| GPT-NeoX-20B | 108(A100) | EleutherAI | A100 | 是 | 不适用 |
| 欧洲 | |||||
| Apertus-70B | 132(Hopper) | Swiss AI | GH200(Hopper,132 SM) | 是 | 不适用 |
| Mixtral-8x7B | 132(Hopper) | Mistral AI | 未披露 | - | 不适用 |
| BLOOM-176B(部分特征) | 108(A100) | BigScience | A100 | 是 | 不适用 |
¹ 全报告范围内的披露。DeepSeek-V2 和 V2-Lite 共用一句“H800 集群”的表述,MoE-16B 写的是“A100 或 H800”,Coder 写的是“A100 和 H800”。MiniMax 的 MiniMax-01 论文描述了一个 H800 集群,蚂蚁集团的 Ling 2.0 报告称其训练运行在“Hopper GPU”上。这些说法与我们的解读一致,但并非独立验证。V2-Lite 复用了 MoE-16B 的初始化,两者保留的行逐字节相同。
² 需要许可证。B200、B300、GB200 和 GB300 在出货之前就已需要美国对华出口许可证,而这些芯片均未见相关报道。AMD MI300X 同样受管制。
³ 存在合规型号。A100/H100 级别自 2022 年 10 月起受管制,但 SM 数量相同的 A800 和 H800 直到 2023 年 10 月仍可出口。
⁴ 未确定的 Hopper 硬件。这些模型最早于 2024 年 12 月起发布,呈现出与 H800、H100 SXM 或 H200 硬件相符的 132-SM 指纹。DeepSeek 和 Moonshot 曾报告部分模型使用 H800,但该指纹无法区分这几款芯片。模型的发布日期不能确定其硬件何时、何地获得,仅凭这一解读也无法确定其是否符合出口管制规定。
⁵ 148 部分。参见结果表下方关于 Kimi K2.7-Code 的说明。
† 由一次分析流程报告,尚未独立重跑。本简报新增的其余各行中,首个列出的模型均经过独立重跑;列为共享其初始化的模型则未重跑。
这些标记描述的是 2022 年 10 月和 2023 年 10 月美国出口规则下的硬件类别,并不构成任何违法的认定。
未恢复 GPU 指纹。空白不代表模型的硬件情况。我们未能从 DeepSeek-V4.1-Flash(经过穷尽搜索)、Qwen3.5-122B、Qwen3.8-Flash-Next、Qwen3-0.6B 和 1.7B、gpt-oss-120b 以及 Grok-1 中恢复任何指纹。Qwen3-235B、Qwen3-32B 和 Qwen3.5-9B 在 CPU 上初始化,因此不留下 GPU 布局。百度的 ERNIE-5.5 使用 PaddlePaddle,其生成器不携带芯片布局(我们恢复了其种子 2760);ERNIE-4.5 未给出结果。美团的 LongCat-2.0 未给出结果。其模型卡称训练“完全在 AI ASIC 超节点上”进行,而一份已被删除的微调配置将 device_arch 设为 910,并带有 NPU 和 HCCL 选项,我们据此判断为 Huawei Ascend 910。Intern-S2 基于阿里巴巴的 Qwen3.5-397B 构建,并沿用其初始化。DBRX 和 Llama-4-Scout 无法下载。
代码。复现 DeepSeek-V3、DeepSeek-V4-Flash、Kimi K3、MiniMax-M3 和 Ling-3.1-flash 结果所需的代码与保留行见 github.com/macrogrants/checkpoint-forensics。检查在笔记本上几秒内跑完,另有一个脚本在 GPU 上用未经修改的 PyTorch 重跑一遍。
联系方式为 Will DePue,will@unemploymentlabs.com。
资料来源
- The Information,2025 年 12 月 10 日,关于 DeepSeek 与 Blackwell(经 Bloomberg 转载)。
- Reuters,2026 年 2 月 23 日,“China’s DeepSeek trained AI model on Nvidia’s best chip despite US ban, official says”(联合供稿版本)。
- 白宫 OSTP 主任 Michael Kratsios,2026 年 7 月 22 日,关于 Moonshot AI(经 Bloomberg 转载)。
- The Wall Street Journal,2026 年 3 月,关于马来西亚境内供 ByteDance 使用的 Blackwell 芯片(经 Reuters 转载)。
- DeepSeek 工程师的 GitHub 评论,2025 年 6 月 12 日,见 DeepGEMM pull request 112。
- Ant Group 的 GB300 基准测试结果,2026 年 3 月 31 日,见 cuLA, BENCHMARK_GB300.md。
- 美国出口许可规则,见 15 CFR 742.6。
- 已披露的硬件,见 DeepSeek-V3 Technical Report;Kimi K2 paper;Nemotron-3 Ultra Technical Report。
- 用于对比的训练运行,见 Mistral Large 4 model card;Microsoft AI,2026 年 10 月 15 日,“Frontier Pre-training at Microsoft AI”;DeepSeek,“Insights into DeepSeek-V3”。
- 复现结果的代码,见 github.com/macrogrants/checkpoint-forensics。
- 设定线程布局的 PyTorch 代码,见 DistributionTemplates.h。
- 模型权重,见 DeepSeek-V3、V4-Flash、V4-Pro、Kimi K3、K3.1-Pro、MiniMax-M3、Ling-3.1-flash。
如何引用本报告
建议引用格式如下。
Will DePue, “Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs,” Unemployment Labs, November 12, 2026, https://unemploymentlabs.com/checkpoint-forensics.
BibTeX 格式如下。
@techreport{depue2026blackwell,
 author = {DePue, Will},
 title = {{Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs}},
 institution = {Unemployment Labs},
 year = {2026},
 month = nov,
 url = {https://unemploymentlabs.com/checkpoint-forensics}
}
新闻报道中,请将结论归于 Will DePue,并链接到本页。