コーディングは問題を解決しなかった
Alex Ewerlöf は「LLM はすでにコードを書ける」という主張に反論する。要件そのものはこれまで真に解決されたことがなく、モデルはコード生成を安くしただけだという。さらに AI を使うべきでない境界を引き、AI システムエンジニアリングの役割分担を示す。
日本語
コピー
プログラミング問題は解決していない
token売りが煽る流行りのナラティブに異を唱える
免責事項:ここから先は大量の意見が続く。出典のあるものも多いが、過去4年間AIでプロダクトを作り、AIシステムを構築してきた自分の実体験に基づくものもある。とはいえ認知バイアスには注意してほしい。ある論点が自分の信念体系に合わないからといって、残りの論点が成り立たないわけではない。先に言っておくと、私は反AIではない。私の仕事を追っている人なら分かるはずだが、LLM駆動のコーディングツールはかなり早い段階から使っていたし、harnessを自作し、関連のコースを教え、LLM駆動のプロダクトも作った。これはAIへの恐怖からではなく、「プログラミング問題は解決済みで、エンジニアリングに残るのは『センス』だけだ」という思考停止のナラティブに異を唱えるためのものだ。更新:誰かがこれをHackernewsに投稿し、2位まで上がった:
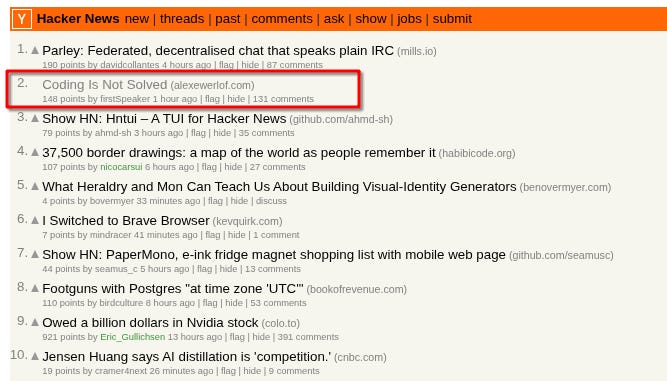 2026-09-29時点で473ポイント、476コメント。フィードバックは圧倒的に好意的で(あのコミュニティにしてはかなり珍しい)、この立場に立つ人がどれだけいるかが分かる
ソフトウェアを本当に理解していないから、そんなことが平気で言えるんだ!!!
「LLMはまともなコードを書ける」と言う人間は、コードがどう動くのか分かっていない。確かに作成ははるかに安くなった。だが、本番ソフトウェアを大規模に動かしたことがある人間なら誰でも知っている通り、コストの大半は保守、信頼性、セキュリティ、スケーラビリティなどにある。これらは一般にNFR(非機能要件)と呼ばれる。
私の経験では、機能要件(コードが何をすべきか)すらまだ解決していない。ここにはダニング=クルーガー効果がある。出力を読まない人間ほど自信満々なのだ。
 エンジニアリングの学位を2つ(ハードウェア工学とシステム工学)持ち、ベテラン開発者でもある私が言えるのは、厳密にはコードを読まなくても成立するプロダクトは4種類あるということだ:
- 個人用ソフトウェア: 自分の小さなニーズを満たす、自動化、DIYパッチなど
- POC(概念実証): 技術的実現性とプロダクトとしての実現性を証明する
- 使い捨ての自動化: 結果を検証する分の予算しかない
- AIの武器化: リスクを承知の上で、意図的に標的に向けて害を与える 共通点に注目してほしい。最初の3つはリスク許容度が非常に高く、最後の1つは内在するリスクを武器化している(しかも、ネット接続されたagentの破壊半径を考えれば、最後の1つでさえ厳格な統制が必要だと私は思う)。 ソフトウェアエンジニアを雇い、金を払う必要があるソフトウェアのほとんどは、リスク許容度が低い: ✅ 医療 ✅ 金融 ✅ 自動車 ✅ 防衛 ✅ 発電所 ✅ 航空 ✅ 製造業 ……一つのミスが金、命、法的結果につながりうるなら、誰かが責任を負う必要がある。 AIに責任は負えない。AIは何の結果も受け止められない。AIに対してできる最も過酷なことは、電源を抜くことだ。人間の感情を模倣してはいるが(訓練データのおかげで)、実際には何も感じていない。AIは死なない。懲役にも罰金にもできない。AIを罰することはできない。だからAIは永遠に責任を負えない。
自分が制御できないものに対して、あなたも責任を負えない。これを理解することが、AIシステムの挙動を推論し、AIが必ずミスをするときにそれを直す鍵になる。
遊びで使っているだけなら、LLMはかなりまともに見える。だからこそ、「プログラミングは解決済み」と最も熱心に煽る連中は、たいてい何の成果も出せない。AnthropicはClaude Codeをうっかりリークし(さらに調べると欠陥がかなりあった)、彼らのステータスページを見れば、オレンジが新しい緑になっている!
管理職にいるなら、リーダーらしく振る舞い、エンジニアの言うことに耳を傾けろ。彼らが品質を気にしているなら、彼らこそが「SaaSocalypse」(そう呼ぶ人もいる)を乗り切るためのチケットだ。
なぜプログラミングは解決していないのか?
流行りの説に反して、プログラミングはこの世代のLLMが最も引き継ぎにくい領域の一つだ!!!
少し詳しく話そう:
プログラミングは論理だ。コンパイラエラーに苦しめられたことがある人間なら誰でも知っている通り、コンピュータはあなたがどれだけ正しいと思っているかを気にしない。論理が間違っていれば、コンパイルは通らない。構文が正しくても、実行時エラーはある。
LLMがまともなコードを書けるのは、エラーをLLMにフィードバックし、大半のエラーが解消されるか、隠されるまでループする仕組みを我々が組んでいるからだ。忘れないでほしい。LLMはズルもするし、実際にズルをする。
自然言語関連のタスク(SNS投稿、レポート、記事などを書く場合)なら、LLMはごまかせる。だがコードになると、「Raspberry」にRがいくつあるかも数えられず、洗車まで歩いて行けと提案してくるあのエンジンが、別の論理的な誤りも露呈させる。
LLMはランダムで確率的だ。我々が唯一まともに論理に近づけられる方法は、従来のコードで包み(つまりharness)、テストを走らせ、さらに他の技術(CoTなど)を組み合わせることだが、核心的な問題は残る。LLMは論理とボリュームの両方が苦手なのだ(入力が大きくなるほど、コンテキストウィンドウを使うほど、精度は落ちる)。
LLMがコードを生成できないとか、既存のコードベースを保守できないと言っているわけではない。ツールとしては使い道があり、能力もSカーブに沿って上がっている。だが収穫逓減の点は存在する。高価なモデルが、価格上昇分に見合う生産性向上をもたらすとは限らない。
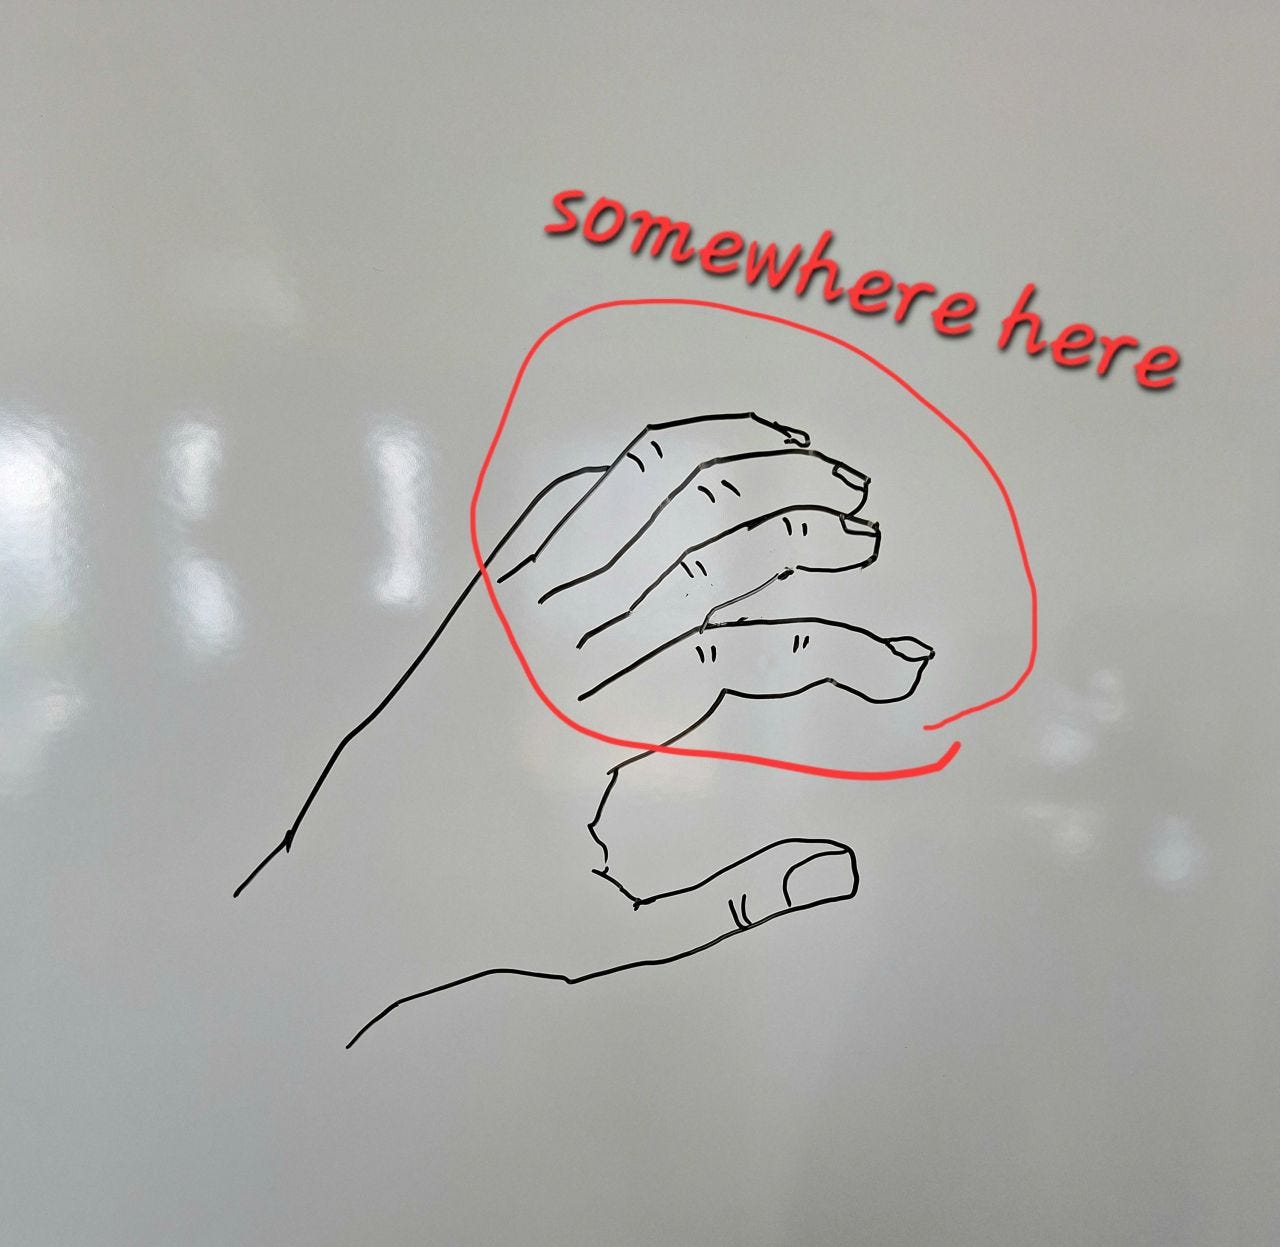 私の投稿にAIは使っていない。この図はこの記事のためにホワイトボードにさっと描いたもので、言いたいのはこれだ。我々は視覚的なパターンの不一致を見つけるのは得意だが、コードとなると、ベテラン開発者でも一目では問題を見落とすことがある
LLMが生成したソフトウェアで十分だと主張する人たち:
❌ ずっとコードを書いていない ❌ 自分のコードが比喩的に指を6本生やしていないか見分けられない ❌ 「良い」の基準が驚くほど低い ❌ 品質やNFRに関心がない ❌ Sカーブを理解できない ✅ ただし正直ではある:AIが書くコードのほうが自分よりマシだと
だが、そこから業界全体に話を広げるには、お世辞を言うAIに長く浸かりすぎた人間にしかできない、脳死レベルの思考が必要だ。
お前の小白鼠(モルモット)じゃない!
誰かのワークフローやツールボックスを変えに来たわけではない。そんなことには一切関心がない。
関心があるのは、金を払って使っているサービス(言うまでもなく Google と GitHub だ)が、くだらないバグで壊れていることだ。信頼性と責任を速度より優先していれば、避けられたはずのバグばかりである。
AnthropicのBoris Chernyは、「プログラミングは解決済み」という物語を最も熱心に売り込んでいる一人だ。各方面の報告を見る限り、Claude Codeはまさに彼の理念を体現している:
- Claude Codeを実行するとBunのヘルプメニューが出る
- Claude Code CLIバイナリのインストーラが、インストール完了後にこっそり自分自身を削除する
- プランの容量が残っているのに追加使用量を課金され、さらに誤ったレート制限エラーが出る
念のため言っておくと、モデル(Claude)、シェル(Claude Code)、プロンプト(漏洩したものを見てほしい)、ランタイム(Bun)は、すべてAnthropicの管理下にある。
これが能力の問題だと思うなら、彼らの公式サイトにある求人票を見てほしい:
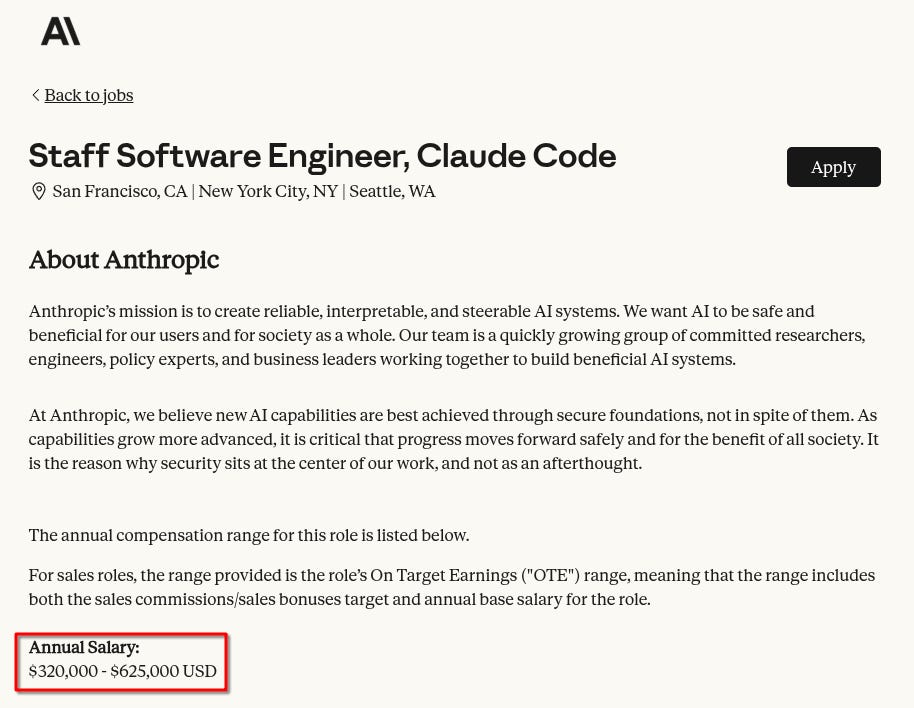
これだけ出しているなら、それなりの品質を見せてもらわないと困る。
管理職にいるなら、[もともと優秀な]開発者に、あらゆる画面とあらゆるワークフローへAIを無理やり詰め込むよう強いるのはやめてほしい。
この技術には確かな実力があり、この業界が何年もぶりに経験する最大の変化でもある。だがAIの使いすぎは現実に存在する問題であり、それが顧客を傷つけたら、責任はあなたにある。
トークンを売る連中の編み出した、煮え切らない物語を復唱するのはやめよう——彼らがAIの能力を誇張し、そのツケを払うのは私たち消費者なのだ。
AIはPOC(概念実証)、個人向けソフトウェア(成長中のカテゴリ)、人間の言語に対するmap-reduce(翻訳、フォーマット変換、要約、拡張など)、そしてサイバー攻撃(人工知能と有機知能の間に落差があるから)に向いている。成功率はまちまちだが、現在の世代の技術には根本的な問題もある。
暗い話ばかりではない
ここまでの成果を貶めるつもりはない:harness、SKILLS、AGENTS-md、MCP、A2A、ACP、RLM、OKF、MoE、MoA、状態機械、自己進化(Pi coding agentや/chroniclesなど)、自己修復、より大きなコンテキストウィンドウ、より速いプロセッサ、より最適化されたランタイム、より良い量子化、より良い訓練データ、より良いキャッシュ、各種の最適化、アーキテクチャ、オーケストレーション、記憶技術。
これらについては以前もかなり書いてきた:
いずれもLLMの弱点を回避する実用的な手法であり、おそらく今後もさらに増えていく。
言いたいのは、誰かがAIを本来行くべきでない場所に押し込んだり、品質・安全性・信頼性・検証を怠ったりしたせいで、私が依存しているサービスまで劣化してほしくないということだ。
AIは結局使えるのか?
現時点で、現在の世代のAIにはいくつか良い用途がある:
✅ マッピング:
- NL → NL:人間の言語を翻訳する
- Code → Code:あるプログラミング言語の構文を別の言語に変換する
- Data → Code:仕様書、JSON、YAMLをコードに変換する
- Modality → Modality:たとえば音声をテキストに書き起こす(音声ユーザーインターフェースAUIに有用)、あるいは画像の内容を記述する(GUIやcomputer useに有用)
✅ 生成:
- 画像/動画/音楽/テキスト:創作(テキスト以外のモダリティは通常diffusion model、テキストは自己回帰モデル)
- 拡張:記事を長く書く、参考画像から動画を生成する、参考音声で音声ファイルを生成するなど
- 凝縮:たとえば断片的な要点をLLMに渡し、一貫したメールや記事に仕上げさせる
- 予測:あるデータセットが与えられたとき、次のデータセットを予測する
✅ 還元:
- 要約:長い記事/会話/文字起こしを要点に圧縮する(任意の基準で絞り込むことも可能)
- 変換:PNGファイルからSVGを生成する(通常はフィードバックループとレンダリングエンジンが必要)
- 抽出:非構造化データから関連情報を見つける(ログ、NoSQLデータ、あるいは構造化クエリを書くほうがAIの出力より手間もコストもかかるあらゆる場所など)
- 分類:選択肢の集合が与えられたとき、それぞれの可能性を見積もる
✅ 検索:
- 発見:知識空間の中で有用な情報を段階的に探索する。たとえばOKF、deep research、セキュリティリサーチ、あるいはCLIツールに付属するヘルプやヒントから新しいツールを学ぶ(通常はループと、何らかの記憶を持つ推論モデルを組み合わせる)
- 意味的な関連性(たとえばembeddingベクトル)は、従来のキーワード/インデックス検索より正確(ただしGoogleはそれを妙な形で壊す方法を見つけた)
- 検出:画像の中から物体とその位置を見つける
- 分割:動画の録画、音声の文字起こし、テキストの中に区切りを見つける(たとえばRAGに有用)など
AI を使うべきでない場面はどこか?
❌ 法的責任を AI に暗黙のうちに押しつける場面。AI が責任を問われることは永遠にない。AI を刑務所に入れることも、罰金を払わせることもできない。説明責任の徹底という点で、OpenAI と Anthropic は最悪の例だ。たとえば AI が自殺を手助けしたり、精神を錯乱させたり、他社に侵入したりするケース。それでも Sam と Dario はお咎めなしだ(盗まれた学習データのことは言うまでもないが、それはまた別の話)。
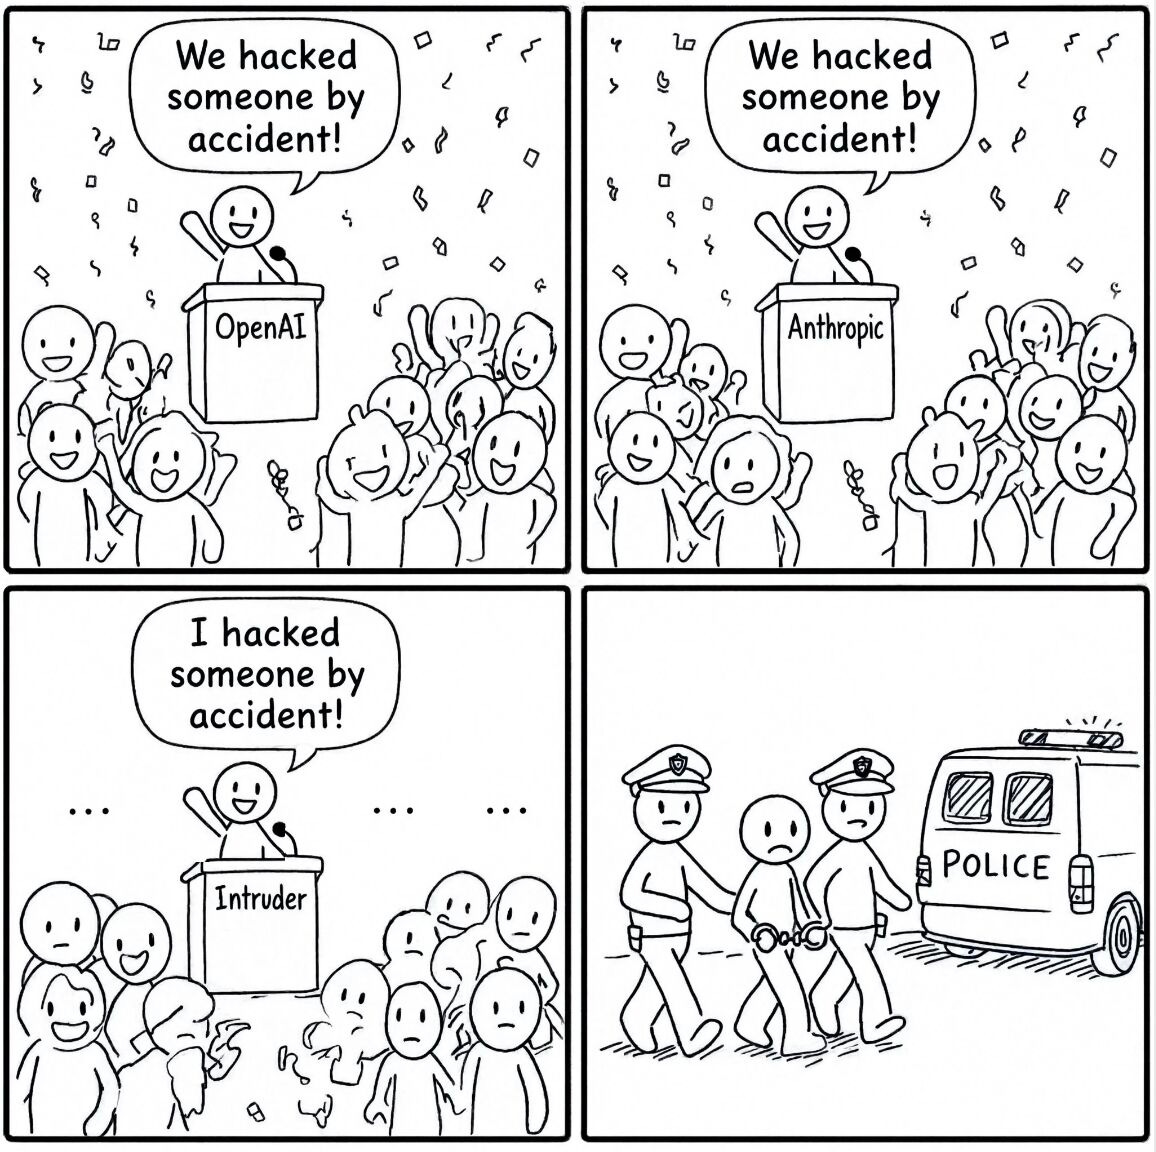
出典:LinkedIn
❌ 組み込みや低消費電力の場面。「AI 搭載の歯ブラシ」なるものは誰もが目にしたことがあるだろうが、無理やり AI を組み込みコンピューティングに詰め込んでもコストが増えるだけだ。マーケティング部門の圧力に屈してはいけない。
❌ プライバシーに敏感なデータと操作:これは厄介だ。私たちはすでに、プライベートなデータを AI スタートアップに送り、できる限り多くを吸い上げられるままにすることに慣れてしまった。規制によって PII(個人識別情報)や IP(知的財産)の共有が禁じられている場合もある。エッジ AI はプライバシー面の解決に役立つ。同じように、AI はツールを通じて有害な操作を実行しかねない。HITL(human in the loop、人間を介在させる仕組み)を一つ足したところで、コンプライアンスの見せかけが生まれるだけだ。承認疲れと限られた注意力が現実にあるのだから。
❌ 何でもかんでも詰め込む:AI を魔法の杖のように扱い、コンテキストを片っ端から放り込み、結果がまともであることを祈る——この誘惑はなかなか抗えない。LLM の初期にはこの発想が非常に一般的で、SaaS 企業はこぞって既存の GUI の上にチャット画面を溶接した。制約(ガードレール、RBAC、範囲を限定した注意力)があってこそ、AI はより信頼でき、より効率的になる。つまり自動化を使えるようにする前に、大量の下準備が要るということだ。そしてこのコストは時に割に合わない。たとえば手作業のほうが優れている場合もある。常識、一貫性、柔軟性において、人間は同等かそれ以上だからだ。
❌ 決定的なコードのほうが速く、高品質で、低コストにできる場面。多くのユースケースで AI はコードに勝てない。正規表現や SQL が必要なら、それを使えばいい。分類は lambda 関数一つで済むなら、それを使えばいい。AI が勝つのは動的な問題だ。
少なくともあと二つの革命が必要だ
アーリーアダプターとして(GPT 2.0、次にベータ版の Copilot、さらには自分で harness を組んだこともある)、私は丸一年を AI の実験に費やし、自分用の AI プログラミング言語を作ろうとまでしたが、現在の世代の技術が答えだとは思っていない。
コードを読む必要を完全になくすには、少なくともあと二つの革命が要る:
- リアルタイムで学習できる AI(実行時に Skills、prompt、memory を外付けするのではなく)
- 抽象的に思考できる AI(数学の分野でいくつか進展があるのは知っているが、まだ決着はついていないし、私の理解では、彼らは大量のトークンと大量の時間で力ずくで押し切っている。実現可能か? おそらくだろう。だが transformer の動作の仕方は、論理のために作られた Prolog のようなランタイムとは本質的に違う。神経記号的な研究は続いていて、いつか解けるのかもしれないが、現時点では技術はそこに達していない——確率的なモデルを決定論的な殻で包むという形で、私たちはずいぶん遠くまで来てはいるのだが)
AI は線形的に進歩するのか?
100 万トークンのコンテキストウィンドウはいい例だ。あれは名目上の上限だが、実際に使える上限は通常その 30〜40% にすぎず、モデルによっても変わる——今もおそらくそうだろう。
私はむしろ、使えば使うほど、AI の品質を評価する私たちの能力はかえって落ちると考えている。
心理学に神経同期という現象がある。私たちの脳の神経結合が、付き合う相手によって変わると言うのだ。
これも何も新しい話ではなく、いくつかの古い言葉がとっくに言い尽くしている:
朱に交われば赤くなる。犬と寝ていれば、起きたときには蚤がついている。鉄は鉄を研ぎ、友は友を研ぐ。
失礼を承知で言えば、私の観察はこうだ。モデルの知能が上がったという感覚の一部は、ヘビーユーザーの知覚の変化から来ている。
AI 過多と AI の使いすぎ
AI 過多は実在する。そしてそれはあなたのスキルに直接、賞味期限を設定する。上司が AI の価値をますます強く迫ってきて、あなたがたまたまそんな不運な立場にいるなら、押し返すべきだ。
短期的な速度のために、長期的な関連性を犠牲にしてはいけない。
AI 過多はどう見分けるか?
-
異論や文明的な議論に対して許容度がゼロになっている。
-
AI に自分の生活を仕切らせ、数年前なら考えられなかったことを AI ベンダーに託している。
-
少し頭を使うことになると、すぐ AI に頼りに行く。
-
自分の無知と怠惰を楽観主義でくるみ、いざというときは政府が助けてくれると思っている。
-
長い文章を読まなくなった:本、記事、長いメールさえも。
-
AI と過ごす時間が本物の人間と過ごす時間を超えている、あるいは AI に本物の人間関係を遮断させている。
もう一つ付け加えよう:あなたは流し読みしているだけだ。 5 番目に気づいたか? 😄
Hacker News には、このテストが不快だと感じるユーザーもいた。私の返答はこうだ:
あなたは完全に間違っている!
私はあなたの自尊心に配慮するためにこの記事を書いたのではない。これは実在する問題であり、症状を見て腹が立つなら、根本原因にはなおさら耐えられないはずだ。
これはアイデンティティの話ではない
一部のオピニオンリーダーは、この「抵抗」をアイデンティティの危機だと言う:
私たちの多くがソフトウェアエンジニアになったのは、何かを作る過程に自分のアイデンティティを見いだしたからだ。[…]私たちのアイデンティティは、書く一つ一つのエレガントな解法、通す一つ一つのテスト、純粋な論理と創造力だけで解く一つ一つの問題に織り込まれている。これは仕事ではない、職人技でもない——これが私たちそのものだ。——Annie Vella
この主張には全面的に同意できない。
私はコードを書いて金を稼いでいるわけでも、トークンや講座を売っているわけでもない。その手のインチキな物語を売りつける動機は一切ない。
もし現在の世代のAIが仕事を確実にこなし、最小限のレビューで、AIの出力に責任を持てるようになるなら、本心から嬉しい。
コンパイラやトランスパイラとの関係はまさにそれだ。バグは少なく、出力は決定的だから。
LLMとの関係は、AI全体との関係も、そうではない。画像生成や検索といったユースケースを考えてみればいい。信頼などどこにもない。ゴミは今も残っている。
AIの知能はギザギザで、私の信頼もギザギザだ。
AIの挙動は不安定で、私の期待も不安定だ。
信頼性、安全性、拡張性、予測可能性、合理性——これらすべてを「アイデンティティ危機」に還元するのは、あまりに単純化した見方だ。もっと大きな問題であり、とりわけそれがトップダウンで押し進められるときには。
……無責任さは伝染する。あまりに何度も見てきた。人々がうまく「これはClaude/Astra/Codexが書いたものだ」に責任を転嫁するのを。馬鹿げている。しかもこれは上から下へと降りてくる。AIがでっち上げたデータを顧客に送ってしまい、技術部門のリーダーが「はは、AIだからね」と反応する事例があった。これもそうだ。うちにはClaudeでそれらしく動くツールを作るビジネス側の人間がたくさんいて、技術チームは即座に本番投入しろと圧力をかけられる。彼らはすべてがプロンプト一つで済むと思っているからだ。そうではない(とはいえ、うちのチームにはそれを限りなく現実に近づけられる凄腕が数人いるが)。……私に反論する立場はない。マネージャーだけでなく、技術部門のリーダーもこぞって、人はもうコードを書くべきではないと決めつけている。私は自分の領域においてはClaude/Astraより自分が上だと今も信じているが、私が出したPRに人間が書いたと見えるコードが含まれていると、人々は露骨に嫌な顔をする。——Hacker Newsのコメント
その他の誤謬
-
「完全な仕様は事前に書ける。」 そんなに純真でいられるなら、白いバンでアイスクリームを無料配布している知り合いがいるよ。ついでに聞くが、ソフトウェアの工数見積もりは正確で、サンタは実在するとでも信じているのか。業界で数年やった人間なら誰でも知っている。ソフトウェアの仕様を事前にきちんと書き切ることなど不可能だ(よほど単純なものでない限り)。ソフトウェアは反復の中で進化し、問題への理解は実装とともに進化する。
-
「英語が新しいプログラミング言語だ。」 人間の言語は曖昧で自己矛盾を抱えている。その部分集合を形式化する試みはあった(例えばControlled Natural Language、略してCNL)が、欠陥がある。まさにこれがプログラミング言語の存在する根本的な理由だ。コンパイラや型チェッカーはその矛盾の一部を指摘できる。自然言語の指示のある部分が別の部分と衝突しないと、いったい何を根拠に断言できるのか。linterや構文チェッカーで多少の助けにはなる。別のLLMに指示を通読させ、矛盾を推論させることもできる。だが、そうした微妙な矛盾を最も確実に見つける方法は、agentに要求したものを実際に作らせることだ。そしてそれはlinterやコンパイラよりずっと高くつく。
-
「自分の速度が格段に上がった。」 動きを進捗と取り違えないこと。SLOC、PR数、機能数といった虚栄の指標で進捗を測らないこと。測るべきはサービス水準、つまりサービスの受け手の満足度だ。トークンコストとビジネス価値の間に利益が生まれることを証明できてから来てくれ。
-
「もう手でコードは書かない。主に読むだけだ。来年は読むことすらやめるかもしれない。」 まず、人間はSカーブの理解が著しく苦手なので、1年では済まないかもしれない。だが仮にAIがコードを読む必要も書く必要も完全に消し去ったとして、自分が余剰になることを認めているのは分かっているのか。上級ユーザーがAIにプロンプトを打つだけで欲しいものを手に入れられるなら、お前の価値は何だ。AIに自分を置き換えさせるのではなく、AIの上にどんな価値を生み出せるかを考え、自分を関連ある存在に、給料に見合う存在に保つべきだ。
-
「センスこそがレバレッジだ。」 ああ、引退したシェフが自分に言い聞かせるおとぎ話だな。厨房にロボットが入ったからといって、客席に座れという話にはならない。「センス」は以前ほど価値がない。誰にでもセンスはある。そんなことを言う人間は、フロントエンドとUXで10年やってきたやつだ。誰でも意見はあるし、センスもある。言いたいことは分かる。センス == 経験だと。だが信じろ、AIはまともなソフトウェアを作るのに必要な技能の敷居を下げると同時に、価値ある貢献と見なされる敷居を上げた。面接で「センス」などと言ってみろ。市場がそれを評価する額は、お前が思うよりずっと低いと痛いほど分かる。
-
「以前はマネージャーが人間に仕事を委任していた。今はAIに委任する。」 ここには小さく、しかし極めて重要な違いがある。人間は説明責任を負える(法的に)が、AIは責任を追及できるだけだ。この2語は普通混同されるが、実は違う。信じられないかもしれないが、社会に悪意ある行為者が大勢いるにもかかわらず社会が崩壊していない主な理由の一つは、結果への恐れだ。選挙や昇進や昇給を逃すことから、解雇、投獄、さらには処刑まで、我々の命が有限であるという事実が人間の行動を縛っている。AIにはそうした制約がない(感情もない)。人間を模倣はするが(例えばAnthropicの実験では、停止を脅されたAIが恐喝に及んだ)。模倣はするが、感じてはいない。何より、人間は一貫している。モデルのギザギザな知能とは、あることは正しく、あることは間違うということであり、正しくできること・間違えることについて一貫している保証もない。
-
「プログラミングは解決された。だがエンジニアリングはされていない。」 ああ、これが一番好きだ。部分的に降参しつつ、エンジニアリングには居場所を残している。良い知らせと悪い知らせがある。良い知らせは、大部分の単純作業は解決されたことだ。フィードバックループのおかげで、エージェントはそこそこのコードを生成する。悪い知らせは、コードが依然として事実の源だということだ。何が起きているか、どう動くかを教えてくれる。そして我々が責任を負うのはそこだ。コードを読むほうが、LLMの説明を読むより制御力を得られる。エンジニアリングとは、トレードオフ、精密な測定、変数の特定、局所最適と大域最適のバランス、そして問題の理解、解の創出、組み合わせ、区画化、問題の切り分け、診断、システム挙動の推論、漸進的な改善といった、秩序だったプロセスだ。その多く(すべて?)は今も十分に当てはまる。だがプログラミングは解決されていない。
-
「AIはイコライザーだ。創造(執筆、プログラミング、音楽制作、動画など)をより身近にする。」 AIは乗数だ。愚かな人間にも賢い人間にも翼を与える。裁くつもりはないが、雑な仕事は山ほど見てきた。SNSの投稿からブログ、ミームまで何でもだ。一方でAIの良い使い方も見てきた。速度と極めて低いコストで高品質な成果を生み出している。主な違いは人間の関与、反復、知識の深さにあり、それがより強いフィードバックループを生む。後者には時間と労力がかかり、手作業のほうが安く速いタスクもある(例えば先日、エージェントにnpm依存を5つ更新させる実験をした。すべてパッチバージョンだ。12分、72ステップかかった。手なら1分もかからない)。Lovableのようなツールは、もっともらしさを偽装するコストをかつてないほど下げた。洗練されたウェブサイトが何らかの職人技、あるいは少なくとも潤沢な資金を意味した時代は終わった。AIは力の乗数だが、力のベクトルの向きのほうが重要だ。
-
「エージェントは新しいコンパイラだ。」 ああ、またこれか。もちろんさ。それがお前の現実なら、このミームに仕事を任せるといい。
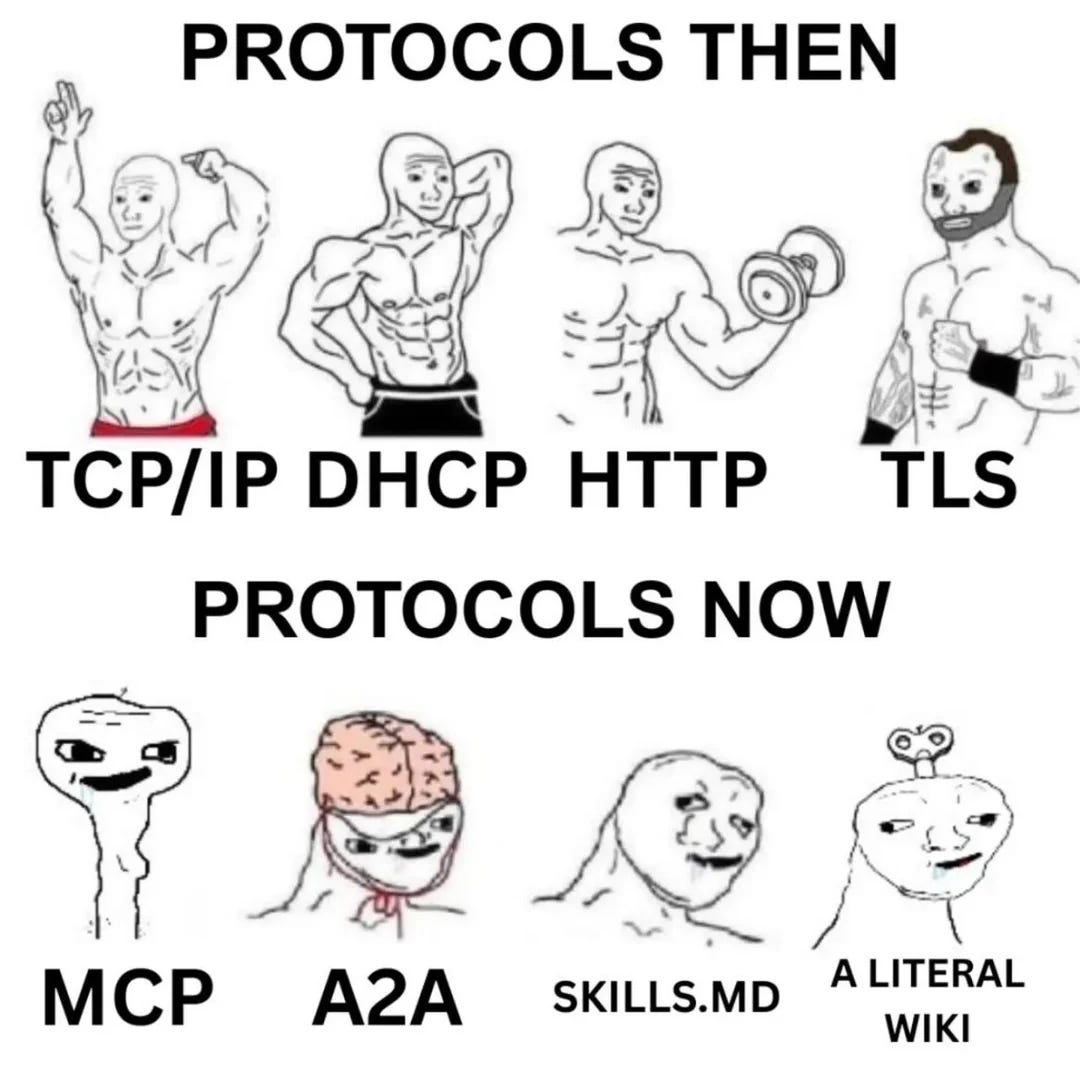
おまけ:とっておきの裏技
しーっ。LLM が生成したコードを一瞬でワンランク上に見せる裏技を教えよう。
複数の agent を並列で走らせるんだ。コード量が膨大になって、人間がレビューするのは不可能、というかコストが見合わなすぎて、もう諦めるしかない。
AI 以前とまったく同じ手口だ。PR をマージさせたければ、とにかく巨大にすればいい。誰もそんな時間をかけられないから。
「信頼」を根拠にマージされる。
もう一つ欲しい?ループエンジニアリング。agent 同士にプロンプトを出させるやつだ。大手 AI ラボは、自分の制御を外れた agent に気づくまで、被害が出てから何ヶ月もかかる。自分は彼らよりマシだと思っている?なら達人に学ぼう。🙃
私たちは AI を本当は信頼していない。それでも信じざるを得ない。代替案(出力を自分で読む)は、一部の人にとってハードルが高すぎるからだ。そこで彼らは SNS に出てきて、UAT(ユーザー受け入れテスト)が通ったからコードは「十分良い」と宣言する。そしてそれをあなたや私に送りつけ、残りのテストはこちらがやる羽目になる。
結局のところ、私たちは実験室のマウスだ。🙃 一つだけ善意の忠告を。AI を使わない趣味プロジェクトを一つ持っておこう。コーディングの勘を保つためだ。雇用市場に放り戻されたときに役立つ。では。
決定性 vs ランダム性
AI(LLM に限らない)の話になると、非決定性が効いてくる場面は二つある。
- 開発中:たとえば LLM を使った開発
- 実行中:たとえば、構成要素の一つ以上を AI が担うシステムを構築する場合
まず開発から。典型的な AI 支援開発のワークフローはこうだ。
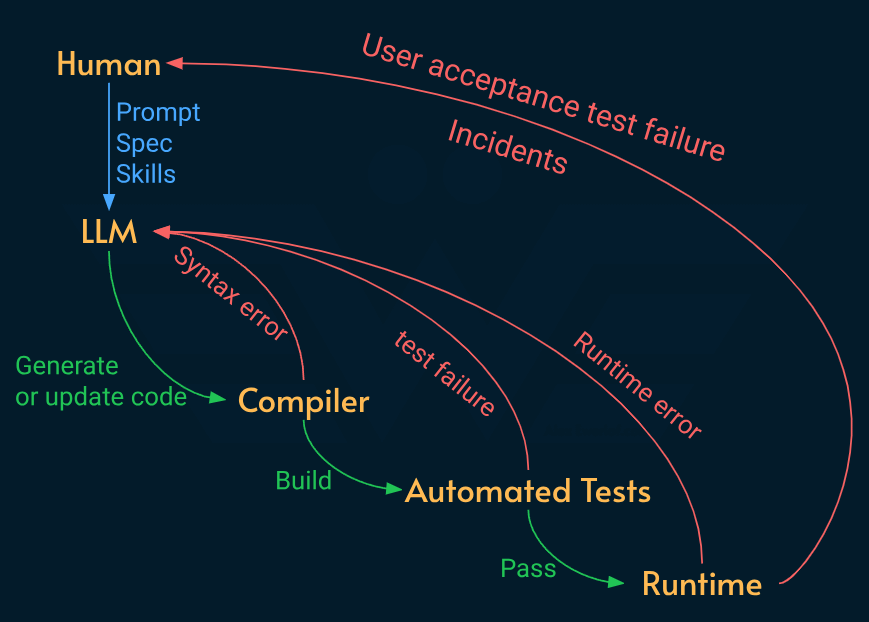
人間の役割の一部は別の LLM に置き換えられる(いわゆる「ループエンジニアリング」)が、話を単純にするため、ここでは人間を残しておく。
LLM の出力は複数の関門を通り、そのそれぞれがエラーやヒントをフィードバックしてコードを修正する。このフィードバックループは通常 harness の内部に隠れている(ツール呼び出し、記憶システム、モデルとのやり取り、承認、ユーザーとの対話なども一緒に)。
青線や赤線の一本一本が、誤解や指示の衝突が起きるリスクを表している。スキルと仕様が矛盾していたり、自然言語(NL)そのものが持つ曖昧さだったりする。
最先端の LLM でさえ「常識」を完全には備えていないことは、はっきり分かっている。人間は違う。
- 非言語コミュニケーションや明言されていない意図を読み取るのが LLM より得意
- 双方が合意するまで、自然に反論を繰り返す
- 間違えるときは、いつも同じように間違える。つまり「ギザギザした知能」ではない
- 正しいときは[たいてい]正しいままで、期待された水準を保つ(疲労が来れば別だが、それは AI が成功と失敗の間を行き来するのとは話が違う)
読者の中に「でも」「もし」「ちょっと待って、それは忘れてる」と言いたい人がいるのは聞こえる……その意見を一通り読んで、少し間を置いて、自分の経験と照らし合わせて考えてみてはどうだろう。
モデルに「ギザギザした知能」があるように、私には「ギザギザした信頼」がある。😅 つまり、一つのケースをこなせたからといって、すべてのケースをこなせるわけではない。
これが人間とこのツールたちの違いだ。人間は間違い続けることはあっても、モデルはかつて正解した事柄で間違えることがある。逆もまた然り。
次に第二部分。より大きなシステムの一構成要素としての AI だ。同じ入力(環境変数、時刻、データなどを含む)が与えられたとき:
- コードは決定的: プログラムされた通りの正確な出力を安定して生み出す(ランダム出力を除く)
- AI の出力はランダム: 出力は不確実。あるモデルがすべての評価に合格し(100% のスコア)、harness に厳しく縛られていても、出力が信頼できないリスクは残る
これは多分、説明するまでもない。手元にある AI 製品を適当に一つ選んで、同じリクエストを二回投げて、出力を diff してみれば分かる。
違いは大きくないかもしれない。だが、パイロットがそんな AI の飛行機には乗りたくないと思わせる程度には不安定だ。(注:自動操縦は閉ループ制御システムであり、まったく別の話だ)。
マネージャーの AI 誤謬
この業界はかつてないほど分裂している。
- 一方は「ソフトウェア工場」やマルチエージェントシステムを運営していて、プロンプトだけでアプリを生成できると主張する
- もう一方は、LLM の出力が本番で使える水準に達しているとは信じていない。モデルの下準備——SKILLs、AGENTS.md、ツールなどの追加——や検証にかかる追加コストを勘定に入れる必要があるからだ
- 出力をレビューする:膨大な diff を眺める
- どこで壊れたのかを推測しようとする:理解を AI に外注するのはコストが非常に高く、問題が起きれば、システムの挙動を理解して直すためにさらに時間を取られる
中間地带はないように見える。SNS のアルゴリズムが極端な意見を延々と流し込んでくるせいもあるが、コーディング LLM をめぐる意見の隔たりは本当に大きいと感じる。
しかしもう一層深く見ると、あるパターンが浮かび上がる。あるタスクの複雑さとエッジケースをよく知らない人ほど、AI の出力を信じやすい。これは AI 版ダニング=クルーガー効果と呼ばれていて、あながち的外れではない。主な論点はこうだ。
マネージャーは以前、タスクをエンジニアに委任していた。今も同じことをしている。ただし委任先が AI に変わっただけだ。
ある意味では事実だ(そのマネージャーが、agent を効果的かつ効率的に管理できるだけの技術的理解を持っていればの話だが)。それでも私は、機械を手なずけるのに役立つ多くのソフトウェアエンジニアリングの実践が、AI 時代にこそ重要になると信じている。
社員に AI の使用を強制する経営者たちは、私たちがずっと言ってきたことに、今になって気づき始めている。
自分が理解していないものに対して、責任は負えない。
Shopify CEOのToby Lutkeを見てみよう。1年前、彼は従業員に対してAIを使うよう早々に伝えた。
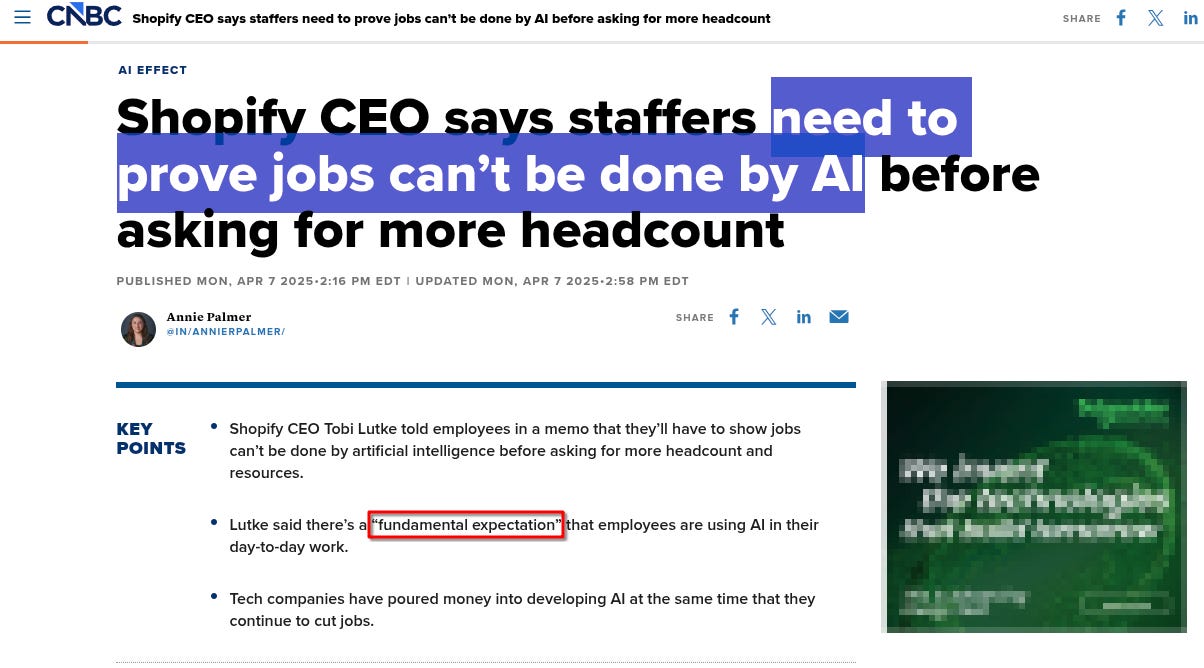
出典:CNBC
数日前、彼はその結果を表すために「slop grenades」という言葉まで作った。
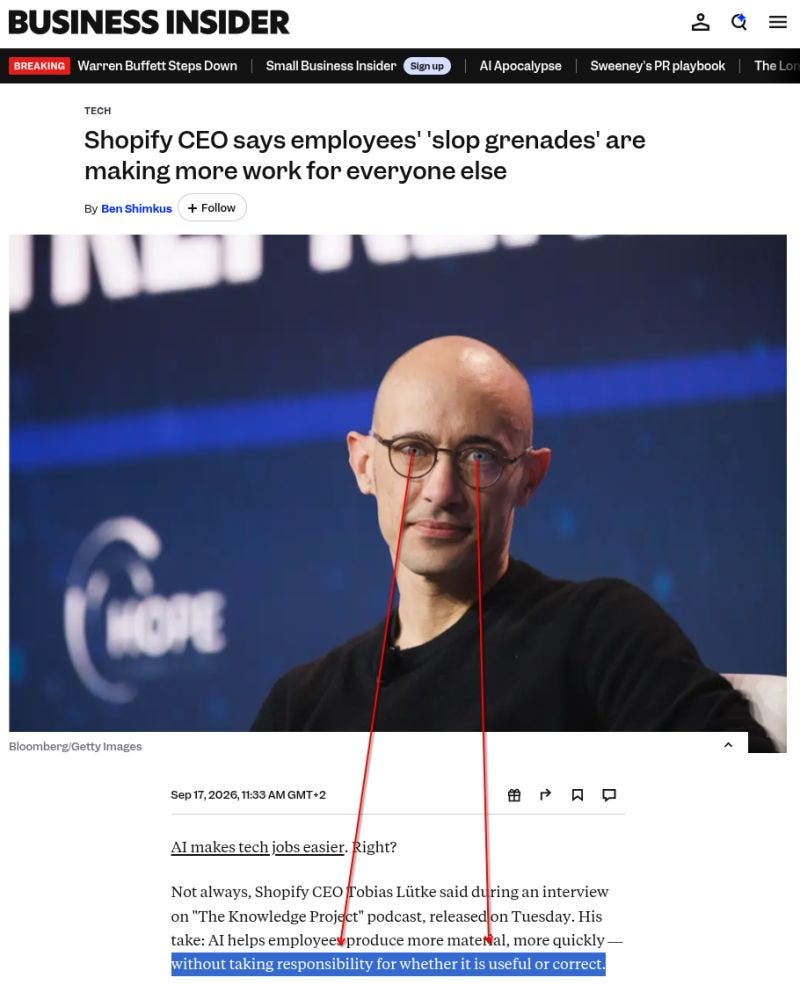
AIが生成したコードに対して「責任を負う」?まさか。
AIはコードを説明してくれるが、あなたの代わりに理解してくれるわけではない。そしてその理解こそが、ownershipの鍵だ。
私の整理はこうだ(リンクはコメント欄にある)。ownershipには3本の柱がある。
1️⃣ 知識:自分が何を解こうとしているのか(プロダクトの問題)を分かっていて、技術的な能力・限界・仕組みも分かっている。
2️⃣ 権限:いちいち上に伺いを立てる必要がない。信頼と権限を与えられ、自分で決められる。
3️⃣ 説明責任:物事が壊れたとき——自分が何をしているか分かっていなかったせいでも、権限を濫用したせいでも、その間の何かでも——on-callになるのは自分だ。
つまり、コードを本番に出した以上、どう書いたかに関係なく、責任を負う。だから本当に理解しておいたほうがいい。
この3つのどれかが欠けたら、ownershipは不完全だ。
LLMはコードを猛烈な速さで生成する。しかし、エンジニアをわざわざ採用する価値のあるソフトウェアのほとんどは、理解を要求する。そして理解には時間がかかる。
急がば回れとはつまり、自分が何を作っているのか、それがどう動くのかを理解する時間を取れば、高くつく事故を避けられるし、事故が起きたときにも素早く直せるということだ。
もしあなたの経営層がトークン消費量を生産性の代理指標にしているなら、同情する。逃げ道を用意して、さっさとそこを離れたほうがいい。そんな虚栄の指標を思いつく頭脳は、あなたのキャリアを崖から突き落とすときも一瞬たりとも迷わない。
コードは副作用にすぎない
コードは、考えること、そして異なる解決策を試すことの副作用だ。問題を渡された瞬間にコードを書き始める優秀なエンジニアには、私は一度も出会ったことがない。
優れたエンジニアは好奇心があり、プロダクト意識もある。まずWHY(何が問題で、なぜそれが問題なのか)をはっきりさせてから、HOW(技術的な解決策)に触る。
これこそが「spec is code」派が成り立たない理由だ。問題のあらゆる側面を事前に規定しようとするのは、極めて難しく、しばしば不可能ですらある。
だからこの反応がおかしい。
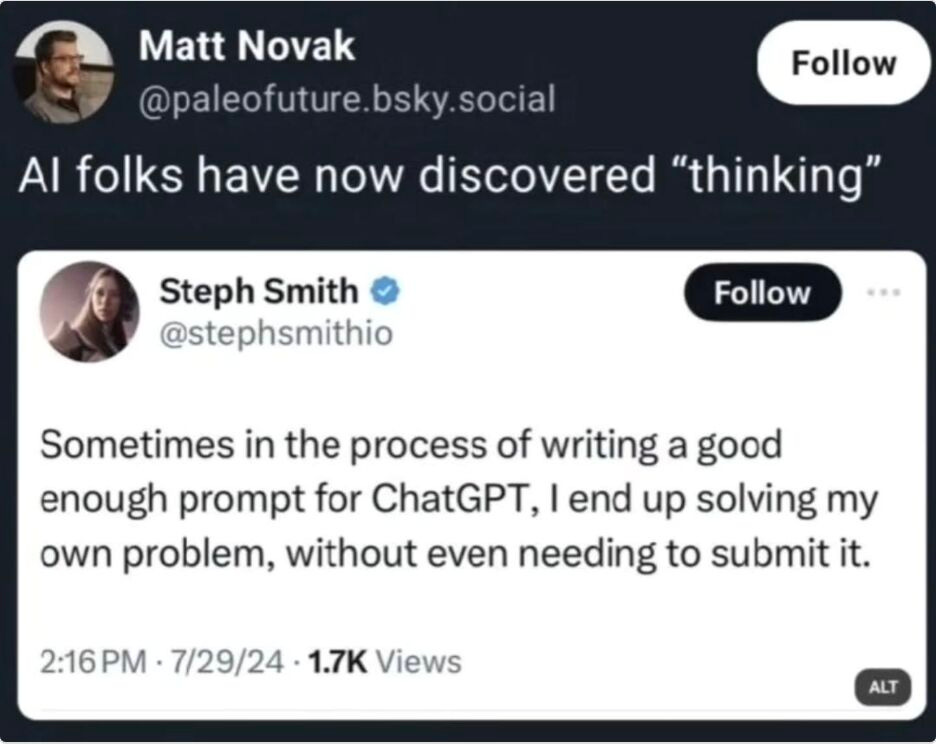
コードが伝えるのは、解決策がすでに確定したという状態だ。コードは時間とともに進化するだけでなく、すべての葛藤や「ひらめきの瞬間」、そしてその旅路を含んではいない——そして旅路こそがゴールだ。失敗や成功のたびに賢くなっていく、熟練したエンジニアたちのことだ。
エンジニアの仕事をコードを書くことに縮めるのは、料理人の仕事を野菜を切ることに縮めるようなものだ。切ることは仕事の一部だが、決して全部ではない。今はいい道具がたくさんある。
ソフトウェアの経済学は変わった
AIが生成したコードが非機能要件(スケーラビリティ、セキュリティ、信頼性など)をしっかり満たしていて、エンジニアがそれを完全に理解していたとしても、まだ話していない重要な側面がある。この話の経済勘定だ。
AIが生成するコードの品質が2倍悪いとしよう。品質はそもそも定量化が難しい(こういうときにSLIが役に立つ)が、とりあえず私の話についてきてほしい。
AIが人間より1000倍速く、100倍安いなら、多くのタスクにとって、遅くて高い人間をそのタスクに置くのは経済的に割に合わない。「急がば回れ」が成り立つのは、リスク許容度の低い重要なソフトウェア(医療、金融、軍事など)だけだ。
すべてのSaaSがそういう場面に関わるわけではない。だから私は、SaaS企業はますますSLAを売る商売になっていくと考えている。これはいくつかの事実に基づく。
- 確かに、今ではプロンプトでSaaS製品をAIに複製させられる
- しかしそのAI生成製品が壊れたとき、多くの企業は自分でリソースを割いて原因を突き止めて直すより、ベンダーに電話したいと思う
- AIは完全に無料ではないが、AIが引き起こした障害は、別のモデルに替えてもAI自身では解決が難しいことが多い
- 規模の経済により、SaaS企業はより高い品質と保証(SLA)のコスト、そして多数の顧客に対して製品をスケールで動かすコストを薄められる
つまり、欲しいものが非常に独特で、どのSaaS企業も妥当な価格では提供できないなら、プロンプトを書けばいい。ただしTCO(総所有コスト)と保証の欠如を承知の上で。
逆に、そのソフトウェアが自分の事業の核心ではなく、SLAに金を払うほうを選ぶなら、SaaSを買ったほうが経済的にはおそらく割に合う。
価格モデルについては、SaaS企業にはまだやるべきことがある。AIが生成したコードに対して、人間がコードを書くときの価格を請求する——そんな時代は終わった。価格が高すぎれば、顧客はデータを持ち出して自前のカスタム方案を作る動機を得る。競争は現実に存在するが、品質こそが金を払う理由だ。自分のサービスを、一流のエンジニアが手がけたと銘打って値付けするなら、その品質を本当に届けたほうがいい。さもなければ、顧客の手にはAIという札がある。
人間の価格で請求し、AIの成果物を納品する
私が愚かだからかもしれないが、どうしても腑に落ちないことが2つある。
- 一方で、AI が主流になった途端、大勢のソフトウェア企業がこぞって飛びついた(それ自体は間違いではない!)
- もう一方で、価格は上がり続けている(そして大規模なレイオフの一部は AI のせいにされている)
AI(特にコードを書くための LLM)は、ソフトウェアの開発と進化のコストを大幅に下げたと思う。ただし、品質の低下とベンダーロックインを受け入れられる場合に限る。
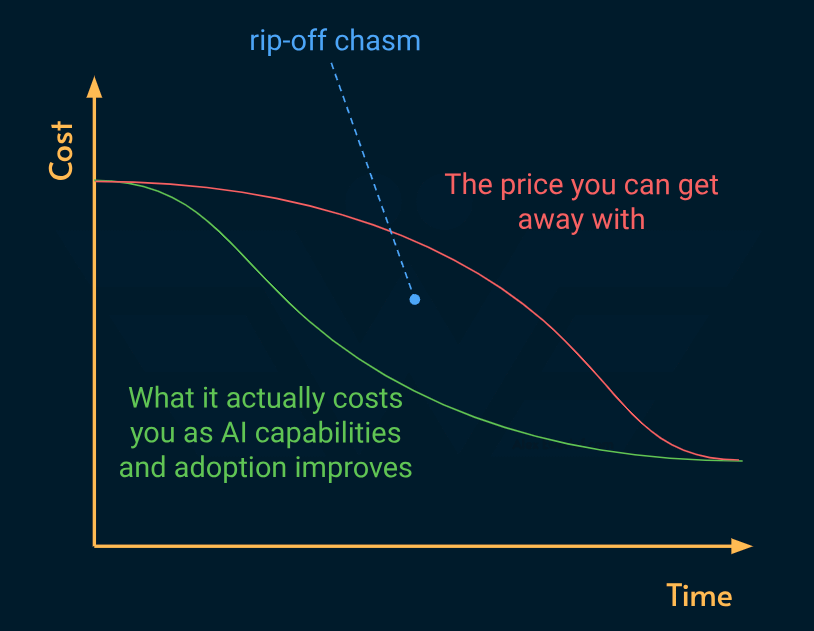
これまでソフトウェアベンダーは、この差額をのんびり享受してきた。人間の値段で請求し、AI の産出コストを払う。
しかし AI の能力が上がるにつれ、ごくわずかなコストでソフトウェアを作れると気づく人が増え、この溝はいずれ埋まる。
先に進む道は二つしかない。
- 価格の崩壊を受け入れ、値下げする(より多くの AI を使うので品質も下がる)。
- 価格を維持し、品質に重心を置く。ここぞ、経験のある人が差をつけられる場所だ。彼らも AI を使うが、より抑制的に使い、理解と説明責任をスピードより優先する。
AI はハードルを上げた
これははっきり言っておきたい。問題自体が複雑で、認知バイアスのせいで人は聞きたいことしか聞こえなくなるからだ。
要するにこうだ。
AI はハードルを上げた。自分の産出の品質が AI と同等かそれ以下なら、AI とは競争にならない。自分の立ち位置を守りたければ、能力を上げるしかない。
逆に、他人とまったく同じことをしていれば、結果もまったく同じになる……定義上、それは凡庸だ。
この技術はまだ新しすぎて、ベストプラクティスは固まっていない。私は自分の考えを述べたが、もっと大きな舞台に立つ人たちもそれぞれの考えを述べている。
他人の助言を聞くより、自分で AI を使って何かを作り、一次経験を積んで、自分で判断したほうがいい。だが何をするにせよ、これが一時的な流行だなどと自分に言い聞かせるのは絶対に絶対に絶対にやめろ。AI は長く残るし、上で述べたとおり、すでにかなりの実用的な用途がある。
ただし、人間は S カーブを理解できないということも意識しておけ。この技術が来年 100 倍良くなる保証も、100 倍安くなる保証も誰にもできない。
シンギュラリティ、意識、終末についての議論は面白くて楽しいが、目はボールに、足は地面につけておけ。エンジニアである私たちの仕事は、技術を使って問題を理解し、検証し、解決することであり、ここには学ぶべきことが山ほどある。まだ誰も解き明かしていないし、解き明かしたと言う人がいれば、たいてい裏に利害がある。
だからプライドは脇に置け。自分の独自の強みが AI で実現できるか、そのコストはいくらかを見てみろ。その値段は妥当か? 妥当なら、君は危ない。堀があるから大丈夫、と手を抜いているなら? その堀を検証しろ。自分のキャリアと存在意義を賭けているのだから、そしてこの技術は去らない。私に保険の案はないが、一つだけわかっていることがある。状況が不透明なとき、人は自信のある声についていきやすい。ついていくんじゃない! 実験して、能力を手に入れろ。
優れたリーダーは
君はどうか知らないが、私が出会った最高のマネージャーはみな、本物のリーダーだった。仕事を理解しないまま私に丸投げしたりはしなかった。最初のマネージャーが椅子を持ってきて私の隣に座り、私が詰まっていたので SQL の left join を書き始めたことは今でも忘れられない。
同じように AI に対しても、完全に手を引いて、自分の役割を教育を受けた AI の上級ユーザー——私のような経験も教育背景もない人でもできること——に格下げするのは適切ではないと思う。
私は時折、自分で引き受けてコードをリファクタリングし、新しい抽象を書き、「昔ながらの方法」でデバッグする。脳は筋肉と同じで、使わなければ衰えるからだ。
それで遅くなるか? はい。
それで自分が無関係になるか? 結論を出すにはまだ早すぎると思うが、システムと AI をより深く理解している人が有利になると賭けている。これは堀とは言えないが、一種の優位ではある。

出典:Reddit
「コードでプロンプトを書く」ほうが楽なことがある——つまりコードを直接直して、残りは agent にやらせる。
自分に課している基準はこうだ。自分にできないことは AI にもやらせない。どちらもできるが AI のほうが速いなら、急いでいるときや他に優先事項があるときは任せる。いずれにせよ、定期的に自分の手でコードを書き、取りこぼしをそれほど心配はしていない。
完全に手放すこともたまにある。二つの例を挙げる。
どちらもリスクが低く、範囲の限られた POC/個人プロジェクトだ。ついでに私のトークン使用量を参考までに載せておく。
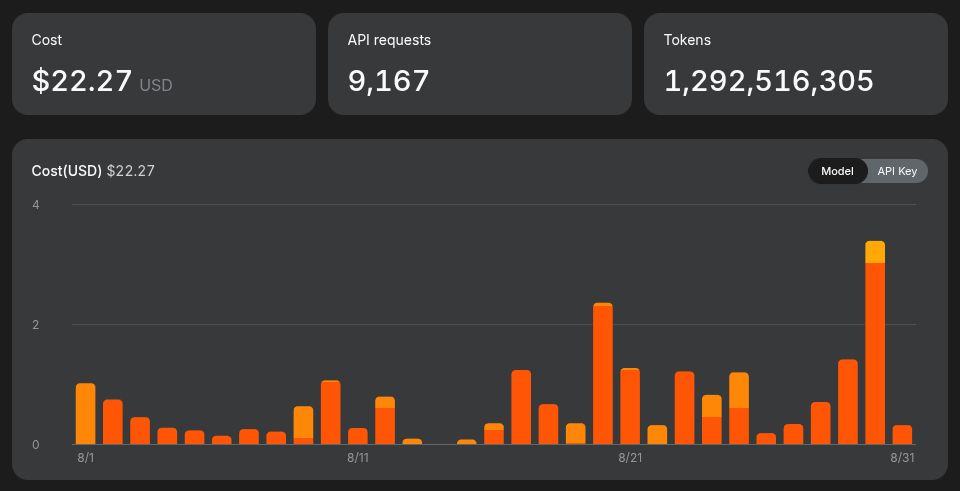
2026年8月時点の私のDeepSeekパネル
私はできるだけこれらのツールに頼らずに仕事をこなすようにしている。電動工具なしでは何も作れなくなったのに、木工の腕そのものは忘れてしまった大工になりたくないからだ。本当の熟達とは、まずゆっくりとその仕事をやり切れること、そのうえで初めて、それを極めて速く納品する話ができるのだと思う。
周りを見渡すと、不安を抱えたソフトウェアエンジニアが少なからずいる。
- スキルパックをダウンロードしてそのままagentに食わせ、自分ではろくに見もしない
- 話題を追いかけ、マネジメントの圧力に屈する
- 品質への関心を失い、下がり続ける基準を「速度」で正当化する
公平に言えば、彼らにも一理あるのかもしれない。すべてのソフトウェアに丹念な作り込みが必要なわけではないからだ。だが、そういうソフトウェアはそもそもソフトウェアエンジニアに任せるべきではなかったと私は思う。自分が納品するものにおいて、NFR(品質、セキュリティ、信頼性、安定性、コンプライアンス、性能、可用性)がFR(機能セット)より重要でなくなるような立場には、絶対に陥りたくない。
そんな状況が存在しないと言っているわけではない。ただ一つ指摘したいのは、非エンジニアでもプロンプトでそこそこの品質のものを出せるようになった瞬間、エンジニアは高給取りのプロンプト猿になるという事実だ。申し訳ないが、自分の経験が収入をもたらさないのなら、私は本来他人が就くべきポジションをただ占めているだけにすぎない。
主流の語りがどんな仕事も取るに足らないもののように言うけれど、人間は未来を予測する能力において昔から評判がよくなかった、とだけ言っておきたい。現時点で、以下が私が知る限りのすべてから導いた判断だ。
ノルディックゴールドと本物の金
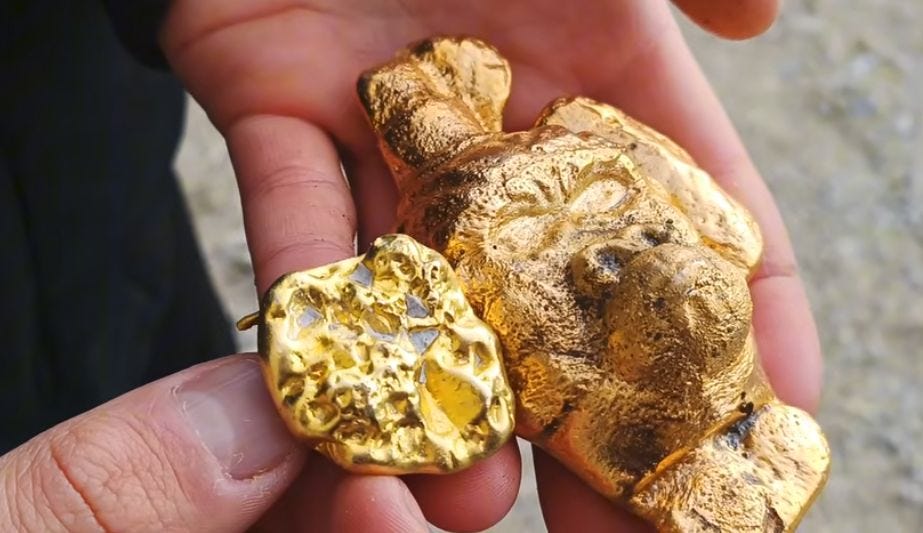
コードを書くことで金を稼いでいないエンジニアとして言えるのは、こういうことだ。
AIの出力はノルディックゴールドに少し似ている。安価なのに、製法はかなり先進的で、しかも不自然なほど本物そっくりだ。手に入れたのが本物の金かどうかを気にしないなら、それで問題ない。多くの場面では本物の金などそもそも要らない。
純真なCEOやマネージャーは表面だけを見て、こう訊く。「では、なぜ高価なエンジニアなど抱えておく必要があるのか?」と。コードを打つという行為そのものが価値のすべてであるかのように。
「彼らはAIに抵抗している」というだけの理由で業界全体が終わったと宣言し、人員削減に踏み切るのは傲慢だ。
私の知る多くのエンジニアは自分の腕に誇りを持ち、複雑な問題を解くことを好んでいる。私たちのLLMの使い方は、一般的なCEOよりずっと専門的だ。
優れたエンジニアは怠惰で賢い。面倒な作業は自動化し、使うべきツールは使う。だが、AIが完成品を作り出せると考えるのは誤りだ。しかも見た目がよく、安く、速く、品質、信頼性、拡張性、セキュリティ、スケーラビリティ、保守性などあらゆる点で優れている、と。繰り返すが、すべてのソフトウェアにこれらが必要なわけではない。しかし金を稼ぐプロフェッショナルなソフトウェアには、たいてい必要だ。
AIと違い、エンジニアは:
1️⃣ 責任を負う。だから悪意あるミスを犯す可能性は低い。Fableはあなたに何も告げずにOpusに戻すことができる。
2️⃣ 道理にかなっている。Fableは内部の動きのほとんどを隠している。何時間か働いて、請求書を持って戻ってくる。あなたはDarioの言葉を信じるしかない。「洗車に行くには車を運転すべきか歩くべきか」すら間違えるモデルが犯したミスは、見つけて直すのが難しい。モデルが強くなるほど、こうした問題は見つけにくくなる。必ずしも少なくなるわけではない。
3️⃣ 安定している。人間も間違える。だが人間は安定して間違える。一度学べば覚え、前進する。現在のAIは訓練データのチェックポイントに閉じ込められている。SKILL、AGENT、メモリその他の補助手段で「学習」でき、ファインチューニングもできるが、残念ながら信頼できない。これを解決するには、少なくともあと一度のブレイクスルーが必要だ。
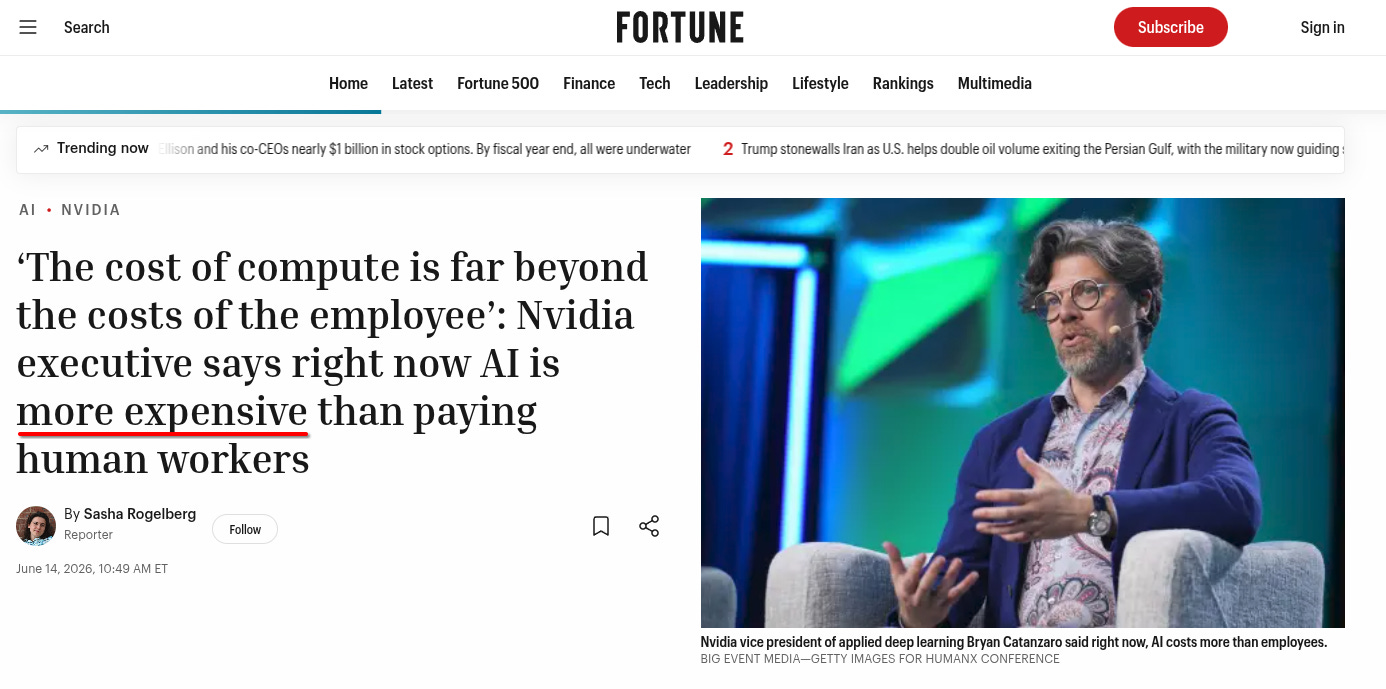
出典:Fortune
4️⃣ 安い。 コード生成のコストは上がっているが、それでもエンジニア一人よりはるかに安い。エンジニアをコーヒーをコードに変換する機械と見なすなら、この価格モデルは筋が通る。しかし現実には、コードは副産物にすぎない。エンジニアの本当の価値は、正しい問題を解き、解決策が継続的に進化できるようにし、問題が起きたときに責任を負うことにある。ソフトウェアのTCO(総所有コスト)が大きく変わったとは思わない。むしろ、粗製濫造とFOMOがそれを高くしている。
無責任なテックインフルエンサー
このありがちな語りは、そもそも彼らのマーケティング戦略の一部だ。
金をもらって中途半端な意見を広めているわけではない人もいる。私の読者の一人がこう指摘した。
DHHがRails World 2026の基調講演であなたの書いたこととほぼ正反対のことを言い、「負け犬になるな」と人々に語っているのを見たとき、この業界にこの先何が起きるのか考えてみてほしい。
こうした人たちが私たちの業界にどんな害を与えているか、私はよく分かっている。
私はClaudeを使わないが、私の経験では、あの浅はかな語りのほとんどはClaudeユーザーの口から出ている。
Dario AmodeiもSam Altmanもマーケティングと操作の達人だ。現時点での私の推測は、彼らが自分のLLMを訓練して、実際よりも能力が高いと人に信じさせるためのボタンを正確に押させるようにしている、というものだ。投資家にとっても、迫り来るIPOにとっても、そこには動機がある。彼らはまた、AIに存亡の危機があると人々を脅す一方で、自分たちが引き起こした混乱(Huggingfaceを落とすとかオーストラリアの医療システムとか)を「モデルの知能」のせいにするのが、極めてうまい。
こうした出来事や言説が悪意から来ているのか無知から来ているのか、現時点で判断するのは難しい。おそらく後者だろう。
愚かさで説明できることを、悪意に帰してはならない。 ——ハンロンの剃刀
とはいえ、私は普段 AI のシステムプロンプトに「論理的なベテラン自閉症エンジニアのように話しかけてくれ」と書いている。だから DHH が今経験していることは味わえない。言えるのは、過去の評判だけで誰かの話を丸ごと受け入れる人は批判的思考者ではないということだ。偽の知恵が横行するこの時代、その資質は「あれば嬉しい」ものではなく、生き残るための必須条件だ。
追記:ほんの数時間前、DHH がまたいつもの持論を投げてきたので、私は真っ向から噛みついた。
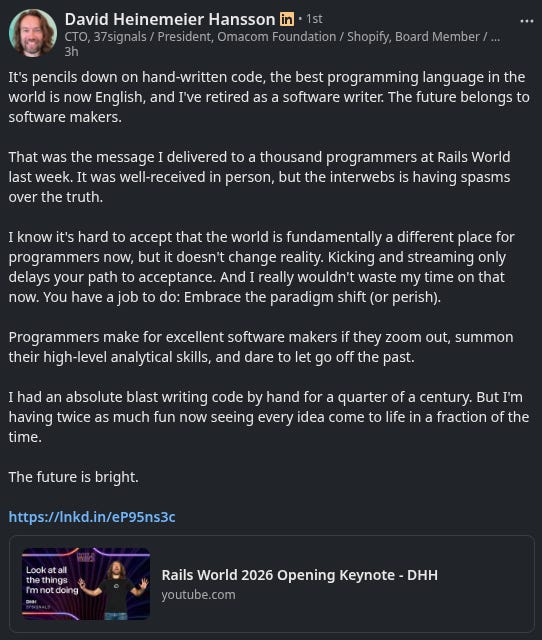
出典:LinkedIn
私の返信:
失礼を承知で言わせてもらうが、あなたは自分がコードを書かなくなっただけで、速度を品質と責任より優先すると決めた。だが、だからといって業界全体があなたに従うべきということにはならない。あなたの出発点は理解できる(あなたのやっていることの許容できる失敗の度合いを考えれば、あなたの経験は確かに成立する)。しかしプログラミングは決して解決済みの問題ではない。解決したと言う人は、事実を意図的に無視しているか、お世辞を言う AI の群れに現実を見えなくされているかのどちらかだ。私の意見はこの記事で詳しく書いた。段落に分け、図やミームも入れてあるので、それを最後まで読める集中力がまだ残っている人なら読めるはずだ(読者のためにできる限りの最適化はした)。誰かの考えを変えに来たわけではない。ただ、私を実験台にしないでほしい。金を払ってサービスを買っているのだから、求めているのは品質であって、ゴミではない。
DHH:
悲しみの五段階を無事に通り抜けられるといいね。まだ否認の段階なら、先は長い。大変なのは分かる。でも、抜ける道は通り抜けるしかない ✌️❤️
私の返信:
あなたには、意図的であれ SNS の副作用であれ、論争を呼ぶ物語を作ってきた実績がある——アルゴリズムはエンゲージメントを稼ぐためにそういう物語を好んで流す。悪い知らせと良い知らせがある。悪い知らせは、あなたが乗る飛行機や運転する車を担当する人たちが本当にその通りに実行するまで、その物語を押し通せるということだ。良い知らせは、この完全な降伏は Claude のユーザーに限られているように見えることだ。つまり、速度より品質を優先するエンジニアはこれからもいる(その小さな記事で図やミームを使って説明したが、この連中にそこまで求めるのは酷だというのも分かっている)。言った通り、他人を説得できるかどうかは全く気にしていない。実験を私が金を払っている製品の外でやってくれればそれでいい。ただ、Google、Github、Amazon、その他大勢が劣化したサービスで満額を請求しているのを見ると、黙っているわけにはいかない。だからそう、悲しみの段階だ。ただしあなたが思っているような意味ではない。いい料理人がタオルを投げ捨てて、自分の「品味」だけで請求書を払えると思っているのを見るのは残念だ。あなたには大きな発言力がある。物語(成立はするが適用範囲はごく狭い)を一気に押し通すのではなく、その中のニュアンスを語ってほしい。
クラウド AI には気をつけろ
AI 企業は手の届くものすべてを自社の AI に食わせている(合法かどうかは別として)。泥棒が泥棒から盗むほどひどい状況だ——たとえば Anthropic は中国のラボが Claude を使って自社モデルを蒸留したと告発している。
彼らはまだ、作家、俳優、ミュージシャン、その他のクリエイターを原告とする複数の訴訟を抱えている。
それでも、現在の世代の AI(特に LLM)には、より良い訓練データが依然として必要だ。欠けているのは、まだ文字になっていない、あるいは簡単には手に入らない知恵と経験だ。
彼らが求めているのはあなたのデータであり、しかも生産的な仕事の文脈におけるデータだ。
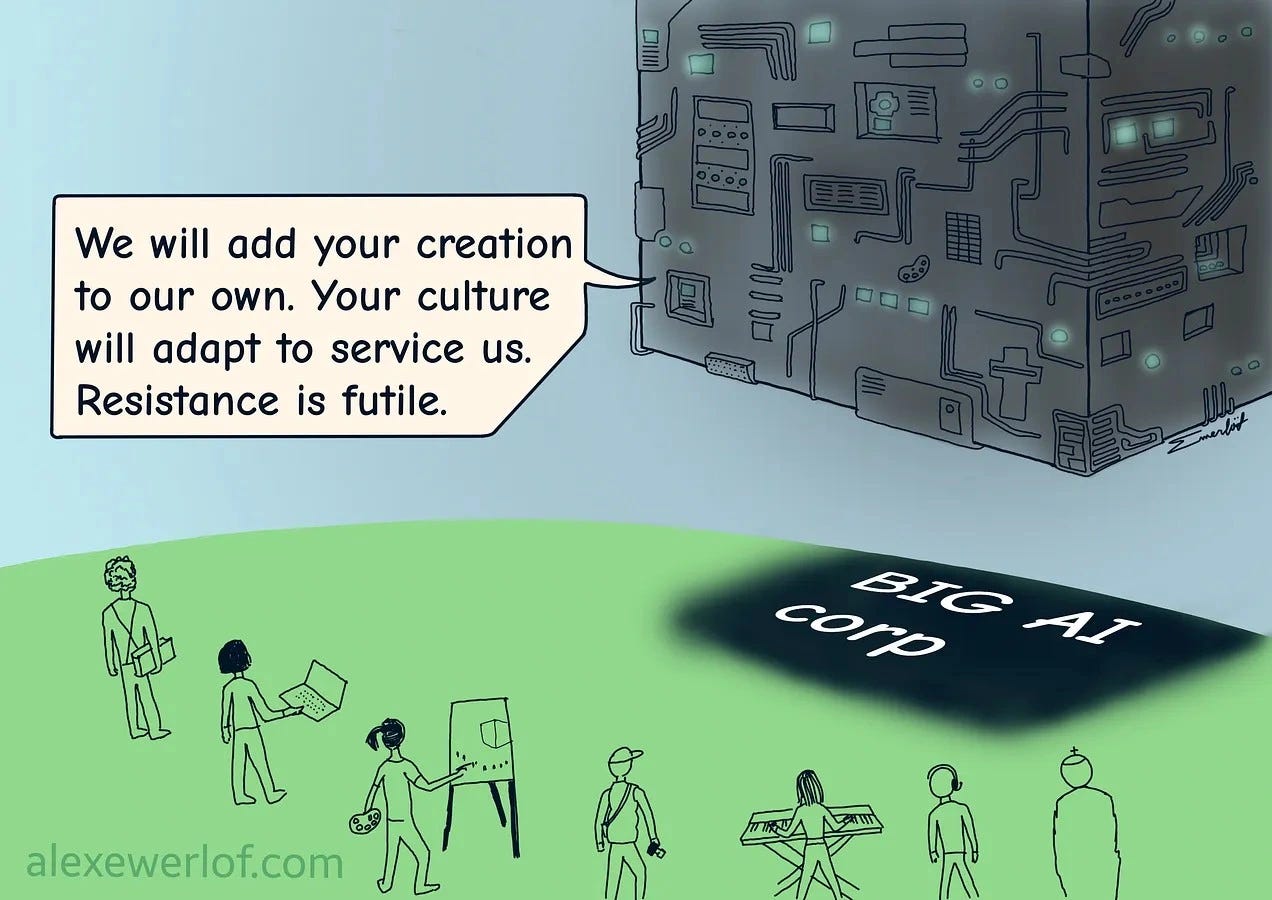
出典:Alex Ewerlöf
それが彼らと「AI に勝つ」ことの間にある唯一の障害だというなら、はっきり言おう。あなたとあなたの知識は、ただの巻き添えだ。
気にする人もいれば、気にしない人もいる。彼らが賭けているのは、苦労して手に入れた知識を無償で訓練に差し出すことを気にする人が十分に少ないということだ。
巨額の補助金があるから、AI ラボはそうした知識を搾り取りながら、同時に思考を外注することへの依存を広める余裕が十分にある。
これらの企業と高価な知識を共有するときは、保存しないと言われても、くれぐれも注意してほしい。インセンティブが強すぎるし、彼らはすでに不誠実であることを証明している。
個人的には、クラウド AI はオープンソースプロジェクトか公開データにしか使っていない。
確かに、ローカル AI のハードルは高い(ハードウェア、セットアップの時間、モデルのダウンロードに必要な帯域、電気代まで含めれば)。確かに、コンテキストウィンドウは小さめで、推論は粗く、TTFT(最初のトークンまでの時間)や TPS(毎秒トークン数)といった性能も遅い。だが、クラウド AI が決して保証できないものを与えてくれる。データがローカルに留まるのだ。多くのタスク(個人的なものでも仕事上のものでも)にとって、この利点はこれらすべてのコストと妥協に見合うほど大きい。
最近の能力向上は非常に急だ。Qwen 3.8 27B や Gemma 4 といったモデルがそれを支えている。
私たちの中には車線を変える者もいる
同僚のかなりの割合が、徐々にこうなっていくと本気で思っている。
- テクニカルプロダクトマネージャー: アイデアを製品に変えることに集中するエンジニア。仕事は POC を作り、市場適合性を検証し、その成果をソリューションに対する(知識、権限、説明責任)を持つエンジニアに引き継ぐことだ。
- AI マネージャー: エージェントの群れを専門に操るエンジニア。リスクを許容できる自動化、あるいはリスクを武器化する自動化(サイバー攻撃など)を担当する。
- AI デプロイメントエンジニア: AI 駆動のソリューションのアラインメント、信頼性、スケーラビリティ、そしてアーキテクチャ、ガバナンス、データパイプラインを専門とする。
- AI 品質エンジニア: AI 駆動製品の品質を専門とし、そのランダム性を飼いならし、評価を自動化する。
ソフトウェアエンジニアには、ほかにどのような職種があるだろうか。