自動的に一貫性のある長編動画を生成
Google のマルチエージェントの枠組みは、長尺の動画生成を大局的な最適化問題として扱う。数分の物語を通して人物と場面の一貫性を保つ。
日本語
コピー
時間的に一貫した長尺の動画ナラティブを自律的に生成する、統一的なマルチエージェントフレームワークを提案する。現在の線形な AI パイプラインが抱えるアイデンティティ・ドリフトとカスケード障害を克服するものだ。
クイックリンク
動画拡散モデルの最近の進歩により、モデルは数秒でリアルなシーンを描画できるようになり、その生成品質は目を見張るものがある。しかし、拡散モデルが高忠実度の動画クリップを生成できても、それを一貫性のある長尺ナラティブのエンジンに変えるのは依然として難しい。既存のエージェントパイプラインの多くはモジュールを連結してこの工程を自動化するが、プロンプトがそれぞれ独立して手書きされるため、意味ドリフト(キャラクターの衣装やシーンがショット間で微妙に変化する)やカスケード障害(上流の素材の欠陥が下流の動画合成を壊すなど)に陥る。初期の誤りが伝播して長期的な一貫性を損なうため、プロセス全体に大量の人手による介入が必要になることが多い。構造的に見れば、これは古典的な信用割り当ての問題を反映している。最終的な失敗を特定のプロンプトまで遡るのは難しい。さらに既存の手法には、実体や環境が意図せず徐々に変化する特徴ドリフトや、ナラティブが有効に進まなくなる内容崩壊も見られる。本日私たちは AI video co-director に関する研究を紹介する。マルチショットのナラティブにおいて視覚的な連続性を明示的に計画する、統一的なマルチエージェントフレームワークだ。Gemini と Veo の上に構築され、オーケストレーション層として SynthID ウォーターマークなどの安全機構をそのまま継承する。私たちは長尺動画の生成を大域最適化と世界状態の追跡の問題と捉え、それに基づいて一連のフレームワークを開発した——Co-Director(COLM 2026 で発表予定)、CANVAS(EMNLP 2026 で発表予定)、A²RD、VQQA である。これらは人間の高次の創作意図を実行可能な操作に変換し、マルチモデルのプロンプティングからショットの連結、閉ループの視覚最適化まで、反復的な編成作業を自動でこなす。私たちがこれらのフレームワークを設計したのは、反応の良い創作パートナーとなり、視覚的な連続性を保つ負担をユーザーに代わって引き受け、ユーザーが物語そのものに集中できるようにするためだ。このアーキテクチャは品質をテスト時の最適化目標としてモデル化し、それによって創造的な合成と一貫性を切り離す。包括的な評価において、私たちのフレームワークはマルチショットのナラティブ一貫性とキャラクターの持続性のいずれも大幅に向上させ、数分長の動画を生成することに成功しつつ、視覚的ドリフトとパイプラインの誤りの伝播を緩和する。
仕組み
長期的な動画は多次元の問題だ。これを解くために、私たちは研究を4つの基礎的な柱に分解した。各柱は生成プロセスにおける具体的なボトルネックに対応する。
1. AI video co-director で創作意図を編成する
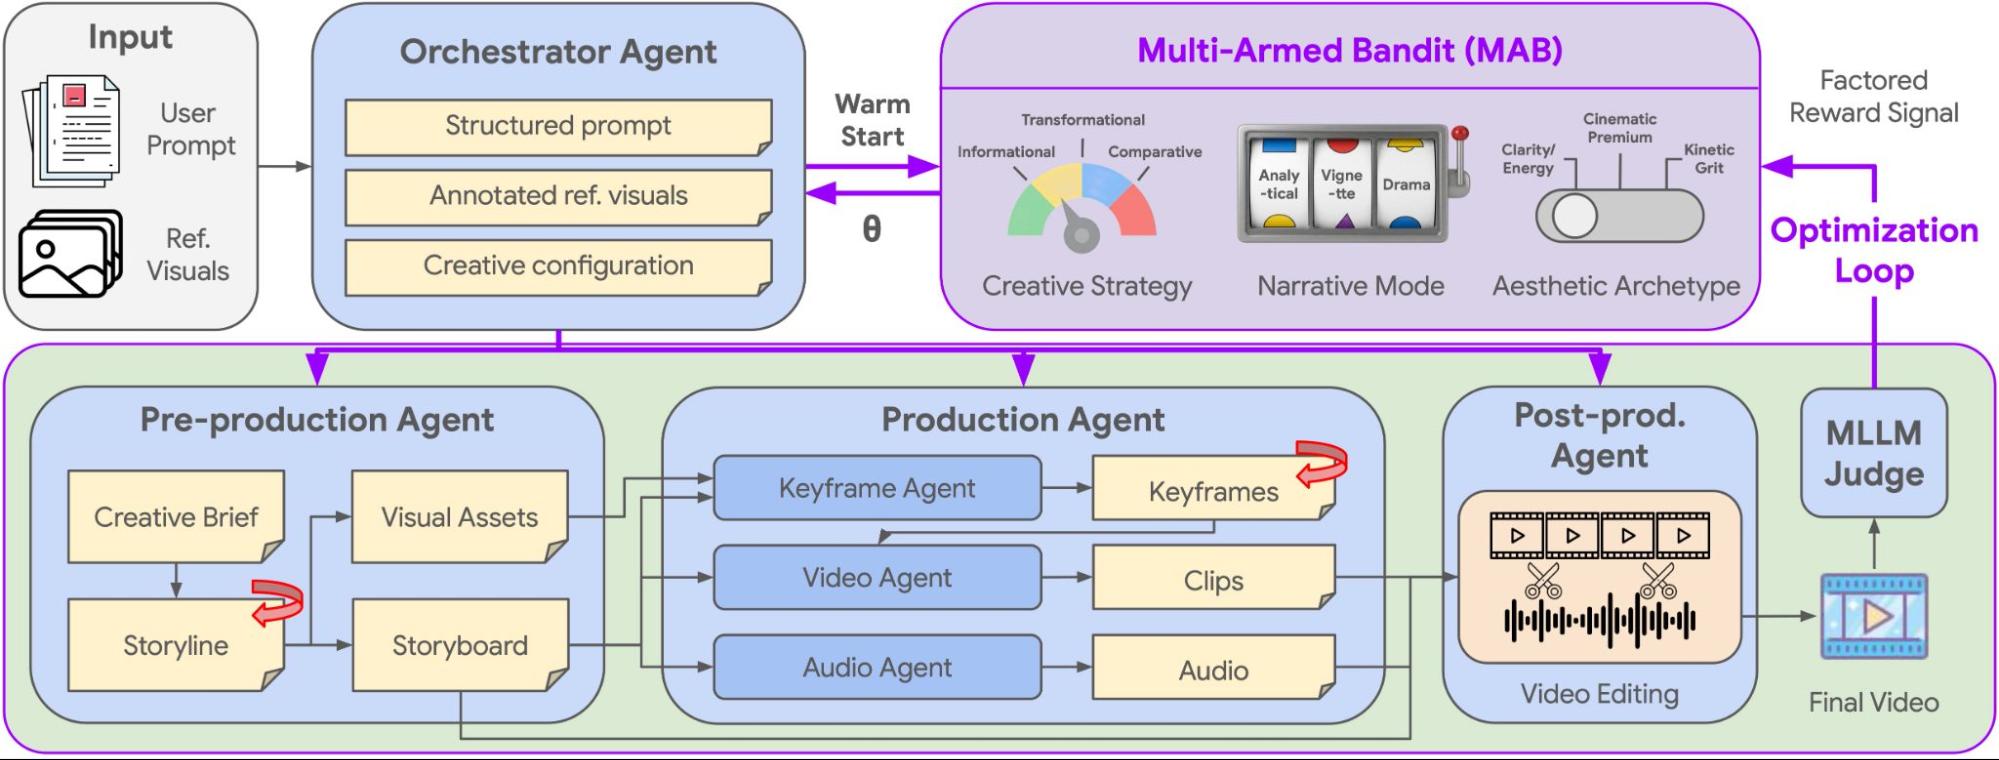
動画全体を通して意味的な一貫性を保つため、私たちは AI video co-director を提案する。動画ナラティブを大域最適化問題として定式化する階層型マルチエージェントフレームワークだ。硬直的で線形なプロンプトの連鎖に頼るのではなく、階層的なパラメータ化を導入する。多腕バンディット(MAB)を使い、大域レベルで有望な創作の方向性を見出すのだ。これにより創作プロセスは探索として定式化される。新しいナラティブ戦略の探索と、有効な創作設定の活用との最適なバランスを探る。システムは抽象的な創作軌跡をサンプリングする。たとえば情報型の戦略を小品風のナラティブパターンや特定の美学アーキタイプと組み合わせ、その軌跡を動的にサブエージェントのシステムプロンプトに注入する。このトップダウンの誘導が、パイプライン全体を統一された構想の下で動かす。AI video co-director フレームワーク自体はオーケストレーション層であり、これらの構造化プロンプトを基盤の Gemini と Veo モデルに直接渡すことでこの構想を実現する(ただしそのアーキテクチャはモデル非依存で、任意の基盤生成モデルの上に載せられる)。このアーキテクチャにより、生成される画像・動画・音声はすべて SynthID ウォーターマークを含むネイティブの安全対策を備える。本番環境では、最終動画に追加の安全分類器を適用し、単体では安全なクリップが文脈の相互作用の中で予期しない効果を生むのを防ぐこともできる。パイプライン全体は、互いに接続された2つのループを通じて大域最適化を実行する。戦略誘導と多段階の制作だ。まず Orchestrator Agent が MAB アルゴリズムで入力を評価し、3つの次元で創作設定を1つ選ぶ。(1)創作戦略(意図)、(2)ナラティブモード(物語構造)、(3)美学アーキタイプ(視覚的な基調と撮影スタイル)。この設定が制作階層全体を駆動する。Pre-Production Agent はシーンごとのストーリーラインと視覚素材を統合し、1つの分鏡スクリプトにまとめる。続いて Production Agent が専門のサブエージェントで分鏡スクリプトを具体的な視聴覚メディアに変換する。Keyframe Agent がキャラクターとシーンの視覚を固定し、Video Agent が動きを加え、Audio Agent が合ったナレーションと音楽を重ねる。最後にマルチモーダル LLM(MLLM)の Judge が編集済みの完成品を上記の3次元で評価し、分解された報酬信号を MAB に返す。これを生成ループの各回で繰り返し、選択を絶えず洗練させ最適化する。
2. CANVAS による視覚的絵コンテ
スクリプトを統一しても、長い連続ショットを生成するとキャラクターのドリフトや環境の不安定さがしばしば生じる。これを解決するために導入したのが Continuity-Aware Narratives via Visual Agentic Storyboarding(CANVAS)だ。マルチショットの物語において視覚的な連続性を明示的に計画するマルチエージェントフレームワークである。CANVAS はキャラクター、場所、オブジェクトの状態を構造化して保持し、物語の進行に合わせて更新することで一貫性を強制する。Gemini 上に構築され、オーケストレーション層として動作し、永続的な視覚メモリに依存する。メモリから視覚アンカーを検索し、必要なら新しいアンカーを初期化することで、CANVAS は同一シーン内の滑らかな遷移を保証する。この明示的な世界状態のモデリングにより、キャラクターは再登場しても同一性を保ち、環境は再訪時にも空間構造を維持する。効果を直感的に示すため、以下の図ではマルチショットの美術館窃盗シーンで CANVAS を代表的なベースラインと比較している。基盤モデル(Gemini-3.1-Pro)で直接生成する場合と、別のマルチエージェントフレームワーク(AutoStudio)である。図の下部のプロンプトは、同じ視覚的特徴を保つ必要がある反復要素——泥棒、展示室、宝石——を強調している。各手法が連続的な遷移(キャラクターの服装など)と非連続的な遷移(ショットが回り道をしてメインホールに戻るなど)をどう扱うかに注目してほしい。Gemini-3.1-Pro だけで生成すると、小道具の不一致(工芸品が変わる)や背景のドリフト(部屋のレイアウトがずれる)が生じ、誘導のない生成の限界が露呈する。AutoStudio もショット切り替えで同様に劣化し、キャラクターのドリフト(泥棒の帽子が消える)と背景の不一致を引き起こす。対照的に、CANVAS の永続的な視覚メモリは、キャラクター、空間幾何、オブジェクトの状態を物語全体を通して完全に一致させる。
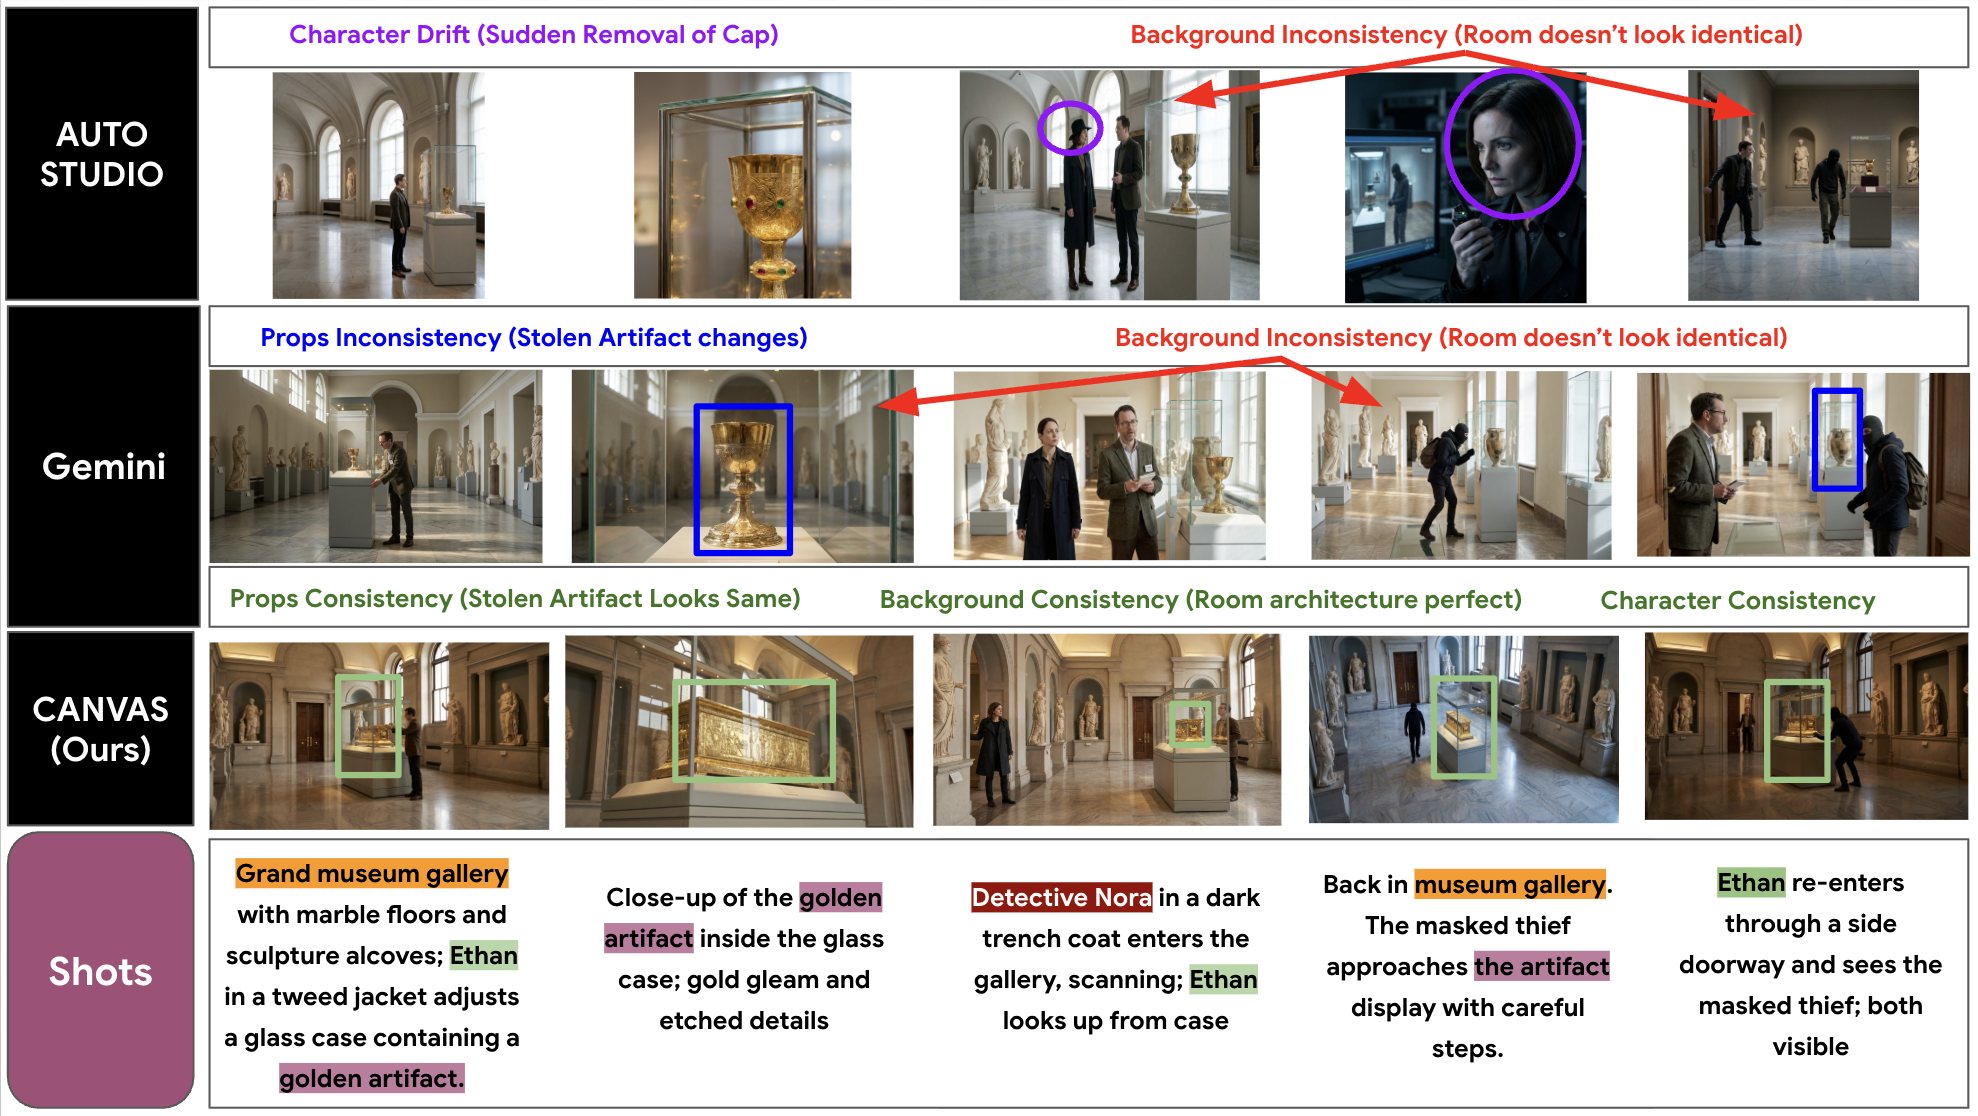
HardContinuityBench の美術館窃盗クリップにおける絵コンテ比較。CANVAS を AutoStudio および Gemini-3.1-Pro ベースラインと比較。
3. A²RD による時間的ダイナミクスの拡張
絵コンテを本当に数分にわたる動画にするために開発したのが A²RD、エージェント型自己回帰動画生成アーキテクチャである。A²RD はセグメントごとに生成し、各セグメントの文脈とダイナミクスを追跡するマルチモーダル動画メモリを備える。セグメントを生成するたびに、検索・合成・精緻化・更新のループを回す。このループの鍵となるのが、そのセグメントの生成モードをエージェントが適応的に決める点だ。外挿と内挿を滑らかに切り替える——外挿は物語を自然に進め、内挿はクリップを既存の実体やシーンに固定する。これにより物語を前へ進めながら、シーンの物理的なリアリティを保つ。このシステムを検証するため、以下の10分間の映像は、数分にわたる時間スパンで物語の一貫性を保つことを要求される長距離生成を示している。映像はまた、システムが2つのモードをどう動的に切り替えるかも示す。外挿でプロットを新たな物語の節点へ押し進め、内挿で回帰したキャラクターやシーンを当初の設計に戻す。通常の動画生成器は深刻な視覚的減衰——キャラクターの変形、シーンの崩れ——を起こすが、A²RD はマルチモーダル動画メモリを継続的に照会し、最初のショットから最後のフレームまでキャラクターの同一性、服装の細部、構造幾何を維持する。
映像を見る
長距離映像。A²RD が連続する10分間、厳密な視覚的一貫性と物語の進行を維持する能力を示す。
4. VQQA による閉ループ精緻化
最後に、システムが視覚的な瑕疵を自律的に識別して修復する方法が必要だ。既存のテスト時最適化手法は計算コストが大きすぎるか、モデル内部へのホワイトボックスアクセスを必要とする。そこで開発したのが Video Quality Question Answering(VQQA)——多様な入力モダリティと動画生成タスクに汎化する統一マルチエージェントフレームワークである。
VQQA は具体的なプロンプトに応じて視覚的な質問を動的に生成し、そこから得られる Vision-Language Model(VLM)の評語を意味的勾配として使う(つまり自然言語で方向性のあるフィードバックを与え、反復的な精緻化を導く。その働きは逆伝播における数値勾配に似ている)。これにより、従来の受動的な評価指標を、人間が理解でき行動に移せるフィードバックで置き換える。システムはその後、自然言語インターフェースを通じて効率的な反復フィードバックループを実行できる(モデルが動画を生成し、視覚的な質問で評価し、評語に基づいてテキストプロンプトを精緻化する)。精緻化の過程で意味的ドリフトを防ぐため、VQQA は Global Selection 機構を導入する。最後のラウンドの出力を盲目的に採用するのではなく、グローバル VLM スコアラーが最適化軌跡上で生成された各動画を、元の未変更のプロンプトと一つずつ比較し、最も高いスコアの候補を選ぶ。こうして局所的な修正が全体の文脈を壊さないようにする。
実際に動かしてみると、VQQA はピクセル単位の編集ツールというより、ブラックボックスのプロンプト最適化器に近い。ピクセルを直接いじるのではなく、テキストプロンプトを反復的に磨き込み、属性の結び付きの誤りやキャラクター属性の前後不整合といった高次の構図上の欠陥を正す。更新されたプロンプトが、生成器にその潜在空間で経路を再サンプリングさせる。以下の例で VQQA は、元のフレームにマスクをかけたり上書き描画したりしていない。写実的な mylar 風船の質感を厳密な立方体の幾何形状にレンダリングすることで、モデルが苦手とするマテリアルの結び付きを解消している。また、バイオリニストとピアニストがカットが切り替わるたびにそれぞれの楽器と正しく対応するようにし、演奏の途中で楽器が入れ替わる問題を修正している。
属性バインディングの誤りを解決。 プロンプト:「直方体の風船が丸い窓のそばを漂い、陽光がガラス越しに差し込む。」素の生成(左)は風船の性質を捉えられず、硬く質感のない立方体を描いてしまう。VQQA(右)は膨らんだ風船のテクスチャと材質を保ったまま、意図した直方体の形状を実現する。反復的な視覚フィードバックにより、最適化されたプロンプトが生成器を導き、縁と縫い目のある箱型の mylar 風船を、陽光の差す窓のそばで滑らかに漂わせる。
時間的な不一致を解決。 プロンプト:「バイオリニストとピアニストが調和のとれた二重奏を聴かせる。」素の生成(左)はカットの切り替わりで深刻な連続性の断絶を起こし、最初は女性ピアニストと男性バイオリニストだったのが、カット後には女性がバイオリンを弾いている。VQQA(右)は演奏を通して厳密な意味的一貫性を保ち、女性ピアニストと男性バイオリニストをそれぞれの楽器に継続的に固定する。
主な結果とベンチマーク
私たちのフレームワークを厳密に評価するため、プロの映像制作における課題を模した 3 つの専用ベンチマークを開発した。
- GenAD-Bench:ヒューマン・イン・ザ・ループの工程で Gemini 3 Pro と専用の画像モデルを組み合わせ、50 の架空ブランドを構築し、各ブランドに 4 つの異なる製品を持たせる。400 の独自シーンで、著作権上の衝突や学習時の事前分布に頼ることなく、厳密なマーケティング上の制約を試す。
- HardContinuityBench: 空間的・環境的な連続性を評価するために設計されている。複雑な GPT-5.2 のマルチショット物語絵コンテで生成し、シーンが再登場するまでの大きな間隔、俳優の頻繁な衣装と小道具の変化、相互作用する小道具の複雑な状態変化によってモデルを試す。
- LVBench-C: 長期的な時間動態を対象とする。このデータセットは 120 のテキストのみのシーンを含み、変化するキャラクター状態、変化する物体属性、段階的な環境の開示に分けられ、重要な視覚的資産は少なくとも 10 セグメント消えてからでなければ、物語に沿った本物の変化として戻ってこられないという厳密な間隔規則を保っている。
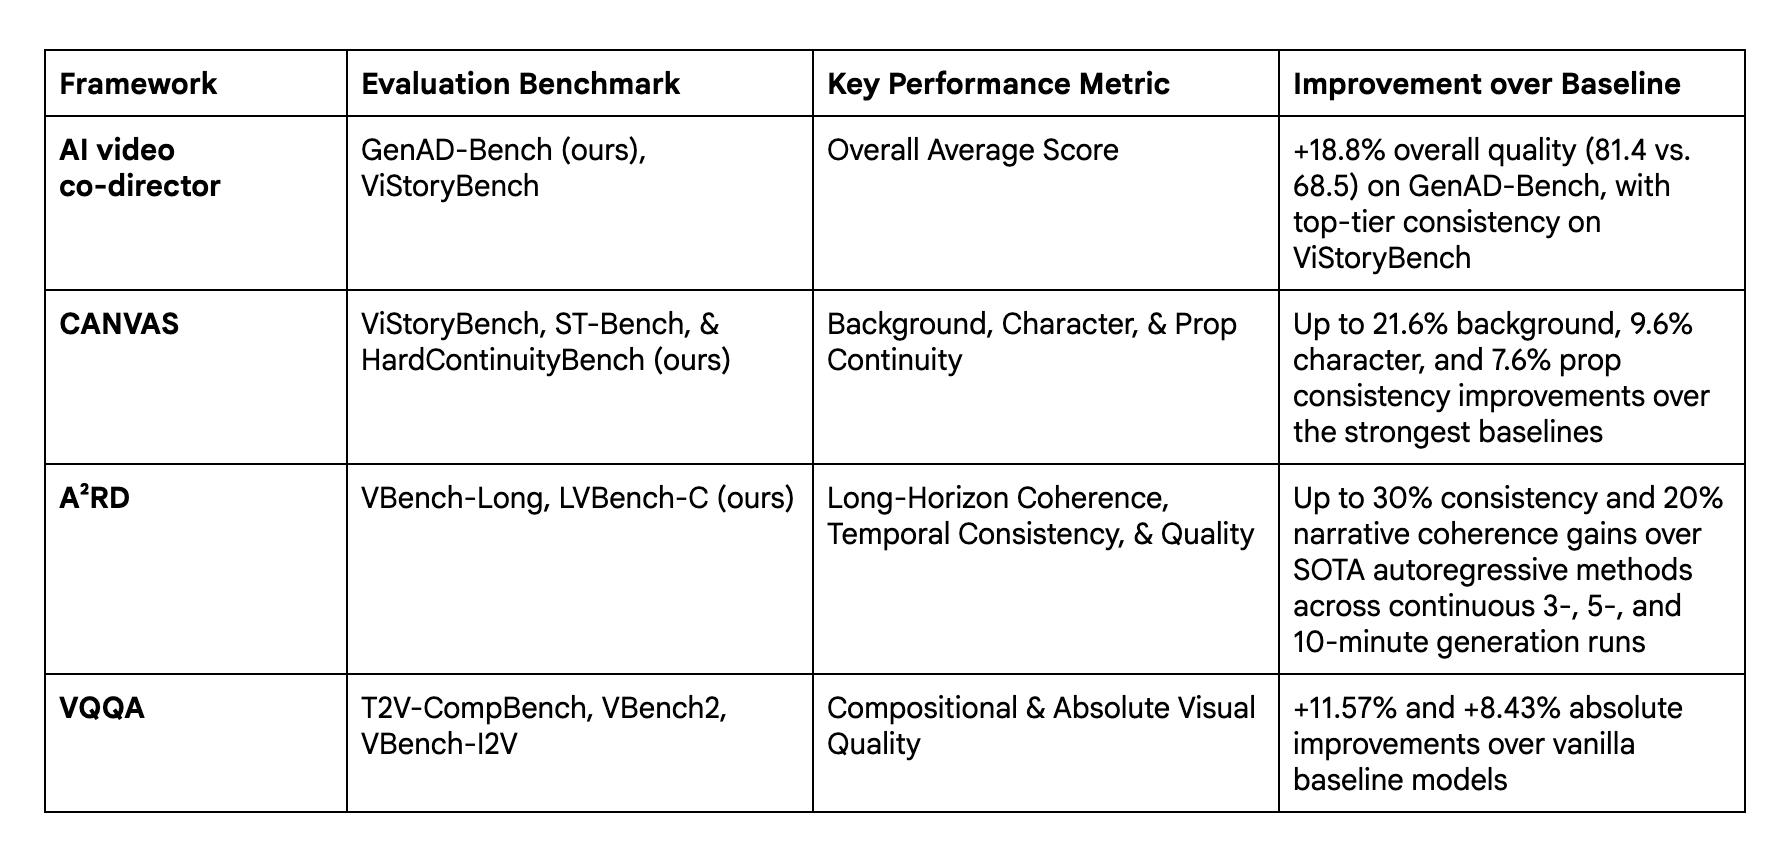
私たちの評価は、これらの手法が既存の動画生成アーキテクチャと比べて測定可能な性能向上をもたらすことを示している。創作戦略の空間を探索することで、AI video co-director は GenAD-Bench で 81.4 のピーク品質スコアを達成し、ViStoryBench で物語の一貫性を高めている。CANVAS は構造化された視覚記憶によってシーンのドリフトを緩和し、ST-Bench と HardContinuityBench でシーン再登場時の連続性を大幅に改善している。長時間にわたる時間動態に対しては、A²RD がレイアウトのドリフトを最小限に抑え、VBench-Long and LVBench-C で数分間にわたる生成においてキャラクターと環境の一貫性を高めている。VQQA は閉ループのプロンプト最適化によって物理と構図の不整合を解消し、T2V-CompBench、VBench2、VBench-I2V で明確な絶対品質の向上を達成している。各モデルのアーキテクチャ、学習設定、ベースライン評価の完全な詳細は、それぞれの論文を参照されたい。
今後の方向性
これらのフレームワークは、一貫性のある長期的な視覚的物語へ向けた最初の一歩にすぎない。こうしたエージェント型アーキテクチャを磨き続ける一方で、私たちは human-in-the-loop のワークフローにどう組み込むかを探っている。最終的な目標は人間の語り手を置き換えることではなく、時間的一貫性や世界状態の追跡といった煩雑で複雑な作業を抽象化し、クリエイターが創作の方向性と物語設計の主導権を常に握れるようにすることだ。
謝辞
この研究は Google の各研究チームの協力なしには成し遂げられなかった。Andrew Pan、Brett Slatkin、Burak Gokturk、Carina Claassen、Daniel Vlasic、Do Xuan Long、Ishani Mondal、Jasmine Leon、Jingyun Liu、Joe Timmons、Jordan Boyd-Graber、Khanh G. LeViet、Kuang Su、Long T Le、Mihir Parmar、Min-Yen Kan、Nathan Hodson、Nick Losier、Palash Goyal、Rhyard Zhu、Sebastian Ko、Scott Penberthy、Yan Xu、Yang Li、Ye Jin、Zack Chomyn、Tomas Pfister の各氏に、この一連の研究への貴重な貢献を感謝する。