自动化生成连贯的长篇视频
Google 这套多智能体框架把长视频生成当成全局优化问题,在数分钟的叙事里保持人物与场景的连贯,而不是逐段生成再拼接。
中文
复制
我们提出一个统一的多智能体框架,能够自主生成时间上连贯的长视频叙事,克服了当前线性 AI 流水线中的身份漂移与级联失败问题。
快速链接
视频扩散模型的最新进展表明,模型能在数秒内渲染出逼真的场景,生成质量令人瞩目。然而,扩散模型虽然能生成高保真的视频片段,要将其转化为连贯的长篇叙事引擎仍然困难重重。现有的大多数智能体流水线通过串联模块来自动化这一过程,但由于提示词各自独立、手工编写,会遭遇语义漂移(角色服装或场景在镜头之间发生细微变化)和级联失败(例如上游素材的瑕疵破坏下游的视频合成)。早期错误会传播并破坏长时程的一致性,因此整个过程往往需要大量人工干预。从结构上看,这反映的是经典的信用分配问题:终端失败很难追溯到具体的提示词。此外,现有方法还会出现特征漂移,即实体与环境在无意中逐渐改变,或者内容坍塌,即叙事无法有效推进。今天,我们介绍关于 AI video co-director 的研究——一个统一的多智能体框架,能够在多镜头叙事中显式规划视觉连续性。该框架构建在 Gemini 和 Veo 之上,作为编排层,天然继承了 SynthID 水印等安全机制。我们把长视频生成视为全局优化与世界状态跟踪问题,据此开发了一系列框架——Co-Director(将在 COLM 2026 发表)、CANVAS(将在 EMNLP 2026 发表)、A²RD 和 VQQA——将人类高层次的创作意图转化为可执行的操作,自动完成重复性的编排任务,从多模型提示、镜头串联到闭环视觉优化。我们设计这些框架,是希望它们成为反应灵敏的创作伙伴,替用户承担维持视觉连续性的负担,让用户专注于讲故事本身。该架构将质量建模为测试时的优化目标,从而把创意合成与一致性解耦。在全面的评估中,我们的框架在多镜头叙事一致性和角色持续性上都有显著提升,能够成功生成数分钟长的视频,同时缓解视觉漂移和流水线错误的传播。
工作原理
长时程视频是一个多维度的问题。为解此题,我们把研究拆解为四个基础支柱,每个支柱对应生成流程中的一个具体瓶颈。
1. 用 AI video co-director 编排创作意图
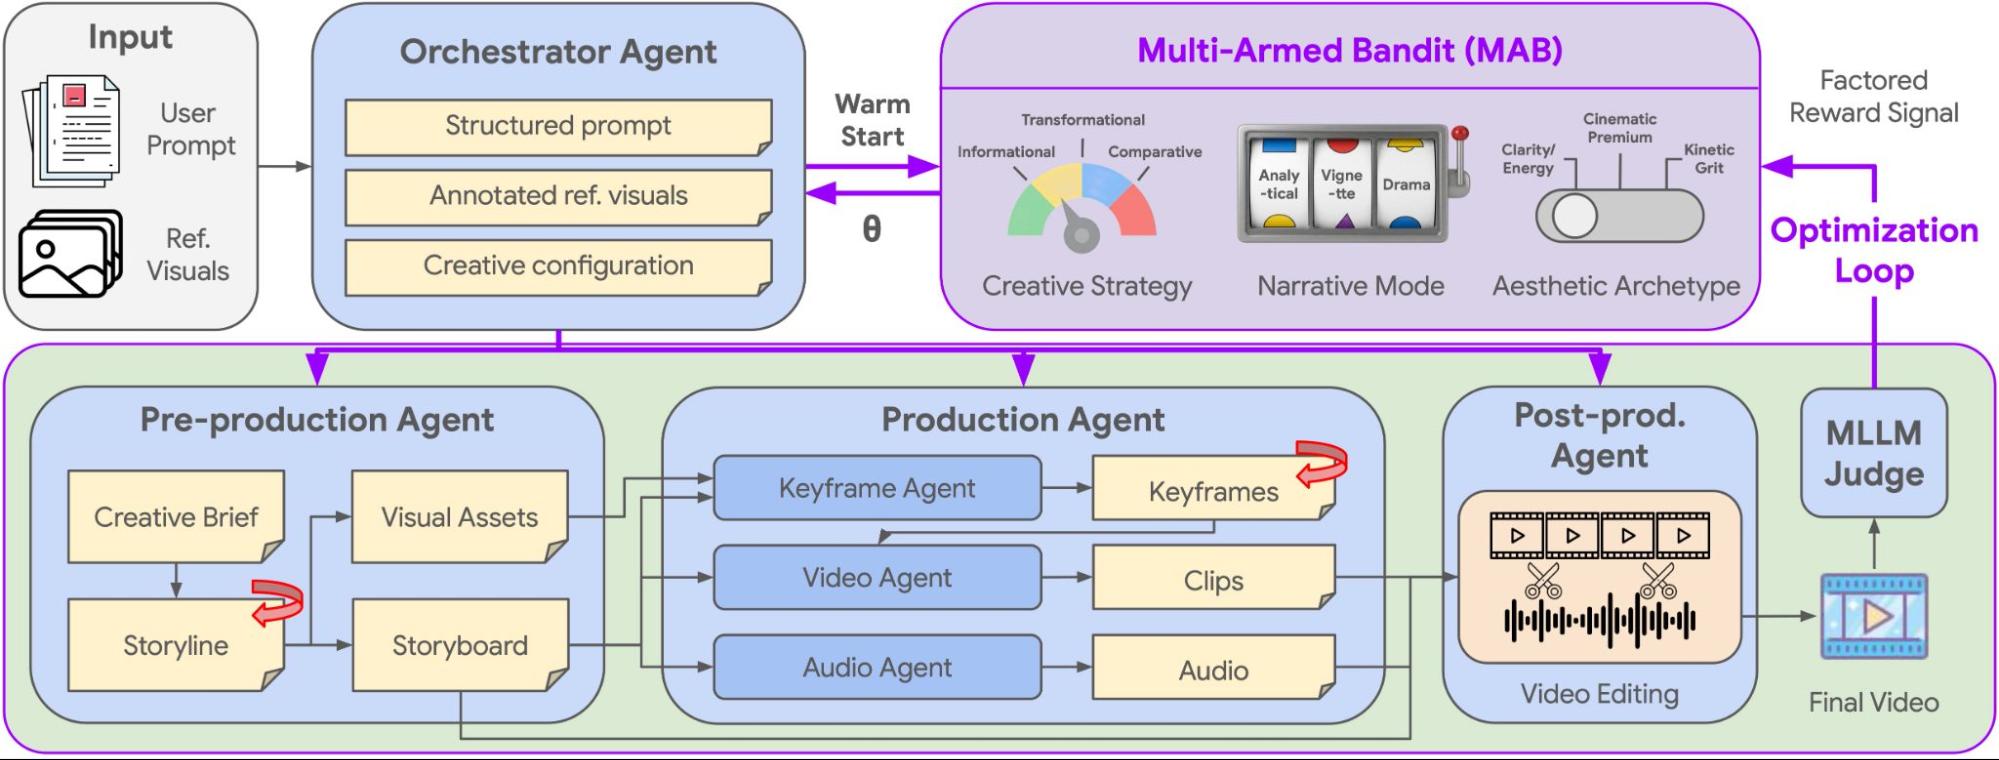
为了让整段视频保持语义连贯,我们提出 AI video co-director——一个分层多智能体框架,将视频叙事形式化为全局优化问题。我们不依赖僵化、线性的提示词链,而是引入分层参数化:用一个多臂老虎机(MAB)在全局层面识别有潜力的创作方向。由此,创作过程被形式化为一次搜索——在探索新的叙事策略与利用有效创作配置之间寻找最优平衡。系统采样抽象创作轨迹,比如把信息型策略与小品式叙事模式、某种特定美学原型组合起来,再把这些轨迹动态注入子智能体的系统提示词。这种自上而下的引导保证整条流程运行在统一的构想之下。由于 AI video co-director 框架本身是一层编排层,它通过把这些结构化提示词直接喂给底层的 Gemini 和 Veo 模型来实现这一构想(不过它的架构与模型无关,可以架在任意基础生成模型之上)。这一架构保证所有生成的图像、视频和音频天然带有原生安全防护,包括 SynthID 水印。在生产环境中,还可以对最终视频额外施加安全分类器,防止单独看都安全的片段在上下文交互中产生意外效果。整条流程通过两个相互连接的循环执行全局优化:策略引导与多阶段生产。首先,Orchestrator Agent 用 MAB 算法评估输入,在三个维度上选定一套创作配置:(1)创作策略(意图),(2)叙事模式(故事结构),(3)美学原型(视觉基调与摄影风格)。这套配置驱动整个生产层级。Pre-Production Agent 把逐场景的故事线和视觉素材综合成统一的分镜脚本。Production Agent 随后用专门的子智能体把分镜脚本转化为具体的视听媒体:Keyframe Agent 锚定角色与场景的视觉,Video Agent 加入运动,Audio Agent 叠加匹配的旁白与配乐。最后,一个多模态 LLM(MLLM)Judge 从上述三个维度评判剪辑成片,把分解后的奖励信号回传给 MAB,在后续一轮轮生成循环中不断细化和优化选择。
2. 使用 CANVAS 进行视觉分镜
即便有了统一的脚本,生成较长的连续镜头仍常常导致角色漂移和环境不稳定。为解决这一问题,我们引入了 Continuity-Aware Narratives via Visual Agentic Storyboarding(CANVAS),这是一个多智能体框架,在多镜头叙事中显式规划视觉连续性。CANVAS 通过维护角色、地点和物体状态的结构化表示来强制保持一致性,随着叙事的推进不断更新。它构建在 Gemini 之上,作为编排层运行,依赖持久化的视觉记忆。通过从记忆中检索视觉锚点,或在需要时初始化新的锚点,CANVAS 确保同一场景内的平滑过渡。这种显式的世界状态建模确保角色在重新出现时保持其身份,环境在再次访问时保留其空间结构。为直观展示其效果,下图呈现了一个多镜头博物馆盗窃场景,将 CANVAS 与代表性基线进行对比:使用底层基础模型(Gemini-3.1-Pro)直接生成,以及另一种多智能体框架(AutoStudio)。图中底部的提示词突出了需要保持相同视觉特征的重复元素——例如小偷、展厅和宝石。注意每种方法如何处理连续过渡(例如角色的服装)与非连续过渡(例如镜头绕路后回到主厅)。仅使用 Gemini-3.1-Pro 生成会出现道具不一致(文物发生变化)和背景漂移(房间布局偏移),显示出无引导生成的局限。AutoStudio 在镜头切换时同样出现退化,导致角色漂移(小偷的帽子消失)和背景不一致。相比之下,CANVAS 的持久化视觉记忆确保角色、空间几何和物体状态在整个叙事中保持完全一致。
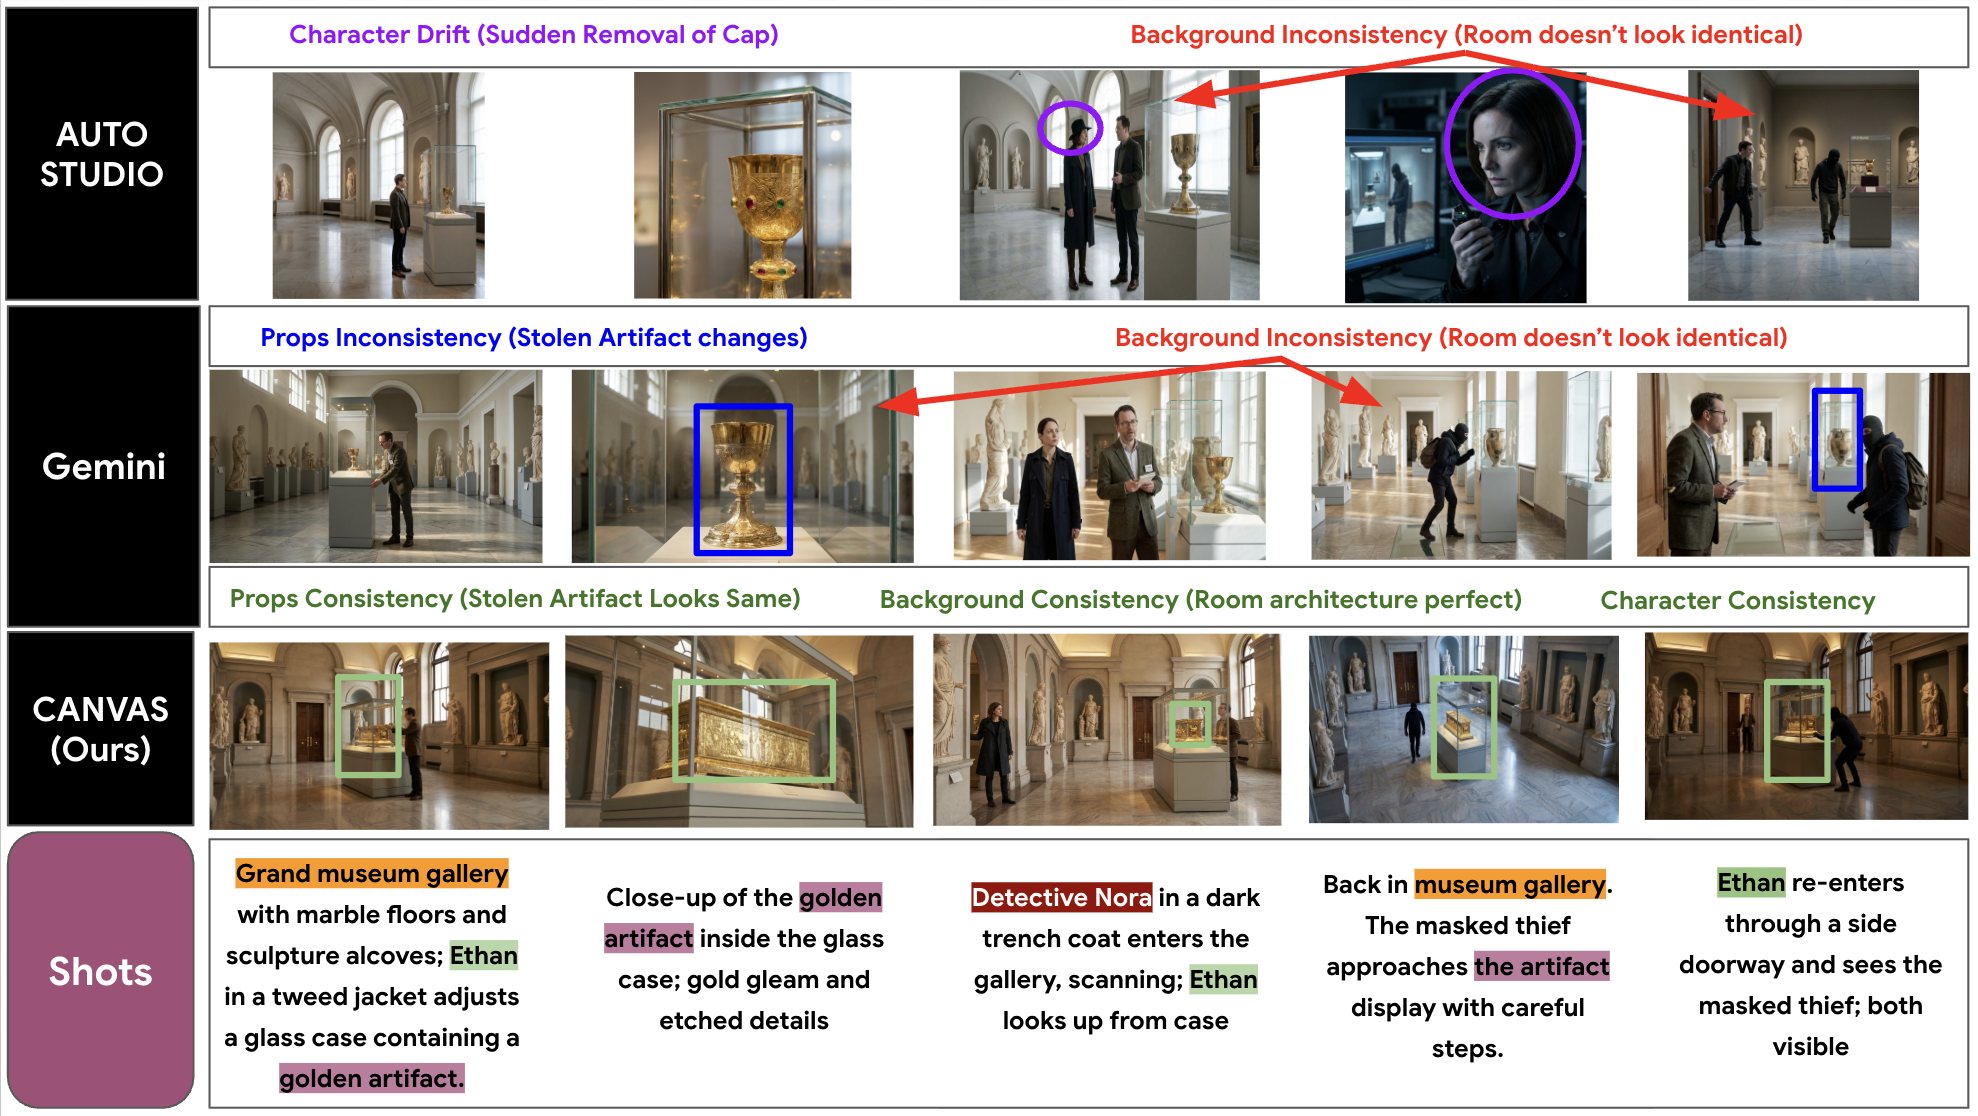
HardContinuityBench 中博物馆盗窃片段的分镜对比,CANVAS 与 AutoStudio 和 Gemini-3.1-Pro 基线对照。
3. 用 A²RD 扩展时间动态
要把分镜变成真正长达数分钟的视频,我们开发了 A²RD,一种智能体式自回归视频生成架构。A²RD 逐段生成,并配有一套多模态视频记忆,用来追踪各段的上下文与动态。每生成一段,它都走一遍检索—合成—精修—更新的循环。这个循环的关键一环,是智能体如何自适应地决定该段的生成模式:它在外推与内插之间平滑切换——外推让叙事自然推进,内插则把片段锚定到已有的实体和场景上。这样既让故事往前走,又保住了场景的物理真实性。为检验这套系统,下面这部十分钟影片展示了一次长时程生成,要求在长达数分钟的时间跨度里保持叙事连贯。影片也体现了系统如何在两种模式间动态切换:用外推把情节推向新的叙事节点,用内插让回归的角色和场景回到最初的设计。普通视频生成器会出现严重的视觉衰减——角色变形、场景走样——而 A²RD 持续查询它的多模态视频记忆,从第一个镜头到最后一帧都维持角色身份、服装细节和结构几何。
观看影片
长时程视频,展示 A²RD 在连续十分钟内保持严格视觉一致性和叙事推进的能力。
4. 用 VQQA 做闭环精修
最后,我们需要一种让系统自主识别并修复视觉瑕疵的方法。现有的测试时优化方法要么计算开销过大,要么需要白盒访问模型内部结构。为此,我们开发了 Video Quality Question Answering(VQQA)——一个统一的多智能体框架,可泛化到多种输入模态和视频生成任务。
VQQA 会根据具体提示词动态生成视觉问题,并把由此得到的 Vision-Language Model(VLM)评语当作语义梯度使用(即以自然语言给出方向性反馈,引导迭代精修,作用类似于反向传播中的数值梯度)。这就用可被人理解、可据以行动的反馈,取代了传统的被动评估指标。系统随后可以通过自然语言接口执行一个高效的迭代反馈循环(模型生成视频,用视觉问题评估,再根据评语精修文本提示词)。为防止精修过程中出现语义漂移,VQQA 引入了 Global Selection 机制:它不会盲目采用最后一轮的输出,而是由一个全局 VLM 评分器,将优化轨迹上生成的每一个视频与原始、未经改动的提示词逐一比对,再选出得分最高的候选。这样,局部修正就不会破坏整体语境。
实际运行时,VQQA 更像一个黑盒提示词优化器,而非像素级编辑器。它不直接改动像素,而是迭代精修文本提示词,以纠正属性绑定错误、角色属性前后不一致这类高层构图缺陷。更新后的提示词会引导生成器在其潜空间中重新采样一条路径。在下面的例子中,VQQA 并没有对原始帧做遮罩或覆盖绘制:它把写实的 mylar 气球质感渲染到严格的立方体几何上,从而化解了模型在材质绑定上的困难;它还让提琴手和钢琴手在每个镜头切换中都稳定地对应各自的乐器,修正了演奏中途乐器乱换的问题。
解决属性绑定错误。 提示词:“一个长方体气球飘过圆窗,阳光穿过玻璃。”原始生成(左)渲染出一个僵硬、没有质感的立方体,没能抓住气球的属性;VQQA(右)在保持充气气球的纹理与材质的同时,成功实现了预期的长方体形状。借助迭代的视觉反馈,优化后的提示词引导生成器渲染出一个边界与接缝分明的盒状 mylar 气球,平稳地飘过阳光照进的窗子。
解决时间不一致。 提示词:“小提琴手与钢琴家呈现和谐的二重奏。”原始生成(左)在镜头切换处出现严重的连续性断裂,起初是女钢琴手与男小提琴手,切换之后却变成那位女性在拉小提琴。VQQA(右)在整场演出中保持严格的语义一致性,让女钢琴手与男小提琴手始终对应各自的乐器。
关键结果与基准
为了严格评估我们的框架,我们开发了三个专门的基准,旨在模拟专业视频制作中的挑战。
- GenAD-Bench:使用人在环路的流程,将 Gemini 3 Pro 与专门的图像模型配对,构建 50 个虚构品牌,每个品牌包含四种不同的产品。在 400 个独特场景中,它测试精确的营销约束,而不依赖版权冲突或训练先验。
- HardContinuityBench: 旨在评估空间和环境连续性。使用复杂的 GPT-5.2 多镜头叙事故事板生成,该基准以场景再次出现之间的巨大间隔、演员频繁的服装和配饰变化,以及交互道具的复杂状态变化来挑战模型。
- LVBench-C: 针对长时程时间动态。该数据集包含 120 个纯文本场景,分为演变的角色状态、变化的物体属性和渐进的环境揭示,并保持严格的间隔规则,即关键视觉资产必须消失至少 10 个片段,然后才能以真实的、叙事驱动的变化回归。
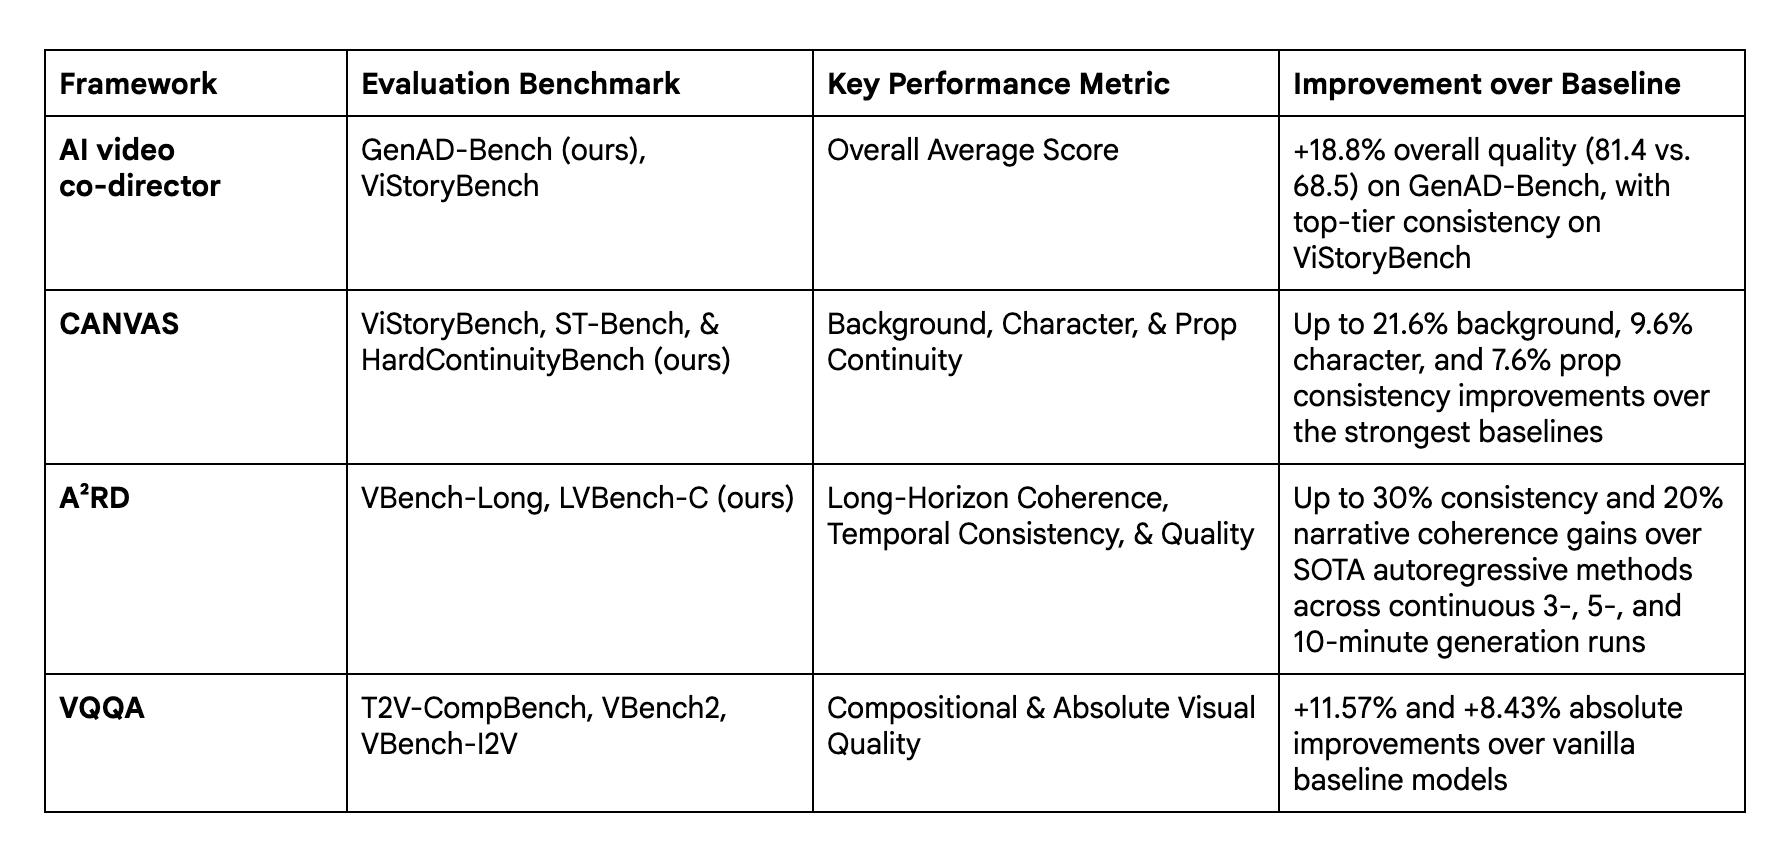
我们的评估表明,相比现有视频生成架构,这些方法带来了可测量的性能提升。通过搜索创作策略空间,AI video co-director 在 GenAD-Bench 上取得 81.4 的峰值质量分,并在 ViStoryBench 上提升了故事一致性。CANVAS 利用结构化视觉记忆缓解场景漂移,在 ST-Bench 和 HardContinuityBench 上让场景再次出现时的连续性显著改善。针对长时间跨度的时间动态,A²RD 将布局漂移降到最低,在 VBench-Long and LVBench-C 上连续数分钟的生成中提升了角色与环境一致性。VQQA 则通过闭环提示优化解决物理与构图上的不一致,在 T2V-CompBench、VBench2 和 VBench-I2V 上取得明显的绝对质量提升。关于各模型架构、训练配置和基线评估的完整细节,请参阅相应论文。
未来方向
这些框架只是迈向连贯、长时程视觉叙事的第一步。在持续打磨这类智能体架构的同时,我们正在探索如何接入 human-in-the-loop 工作流。我们的最终目标不是取代人类讲故事,而是把时间一致性和世界状态追踪这些繁琐复杂的工作抽象掉,让创作者始终掌握创作方向与叙事设计的控制权。
致谢
这项工作离不开 Google 各研究团队的通力协作。感谢 Andrew Pan、Brett Slatkin、Burak Gokturk、Carina Claassen、Daniel Vlasic、Do Xuan Long、Ishani Mondal、Jasmine Leon、Jingyun Liu、Joe Timmons、Jordan Boyd-Graber、Khanh G. LeViet、Kuang Su、Long T Le、Mihir Parmar、Min-Yen Kan、Nathan Hodson、Nick Losier、Palash Goyal、Rhyard Zhu、Sebastian Ko、Scott Penberthy、Yan Xu、Yang Li、Ye Jin、Zack Chomyn 和 Tomas Pfister 对这一系列研究做出的宝贵贡献。