サンドボックス分離だけで暴走エージェントを抑止できるか?
暗号学教授の Matthew Green がこの論争の裁定を引き受けた。実際に問題が起きた事例はサンドボックスが突破されたものではなく、第三者の評価環境そのものが公衆網に直結していたことによる。そして agent をより厳しく閉じ込めれば、かえって作業が難しくなるだけだ。 Greenがこの論争の裁定者を務め
日本語
コピー
サンドボックス隔離は暴走した agent を抑え込めるのか?
先にいくつか断っておく。これは暗号学者が書いた AI 安全性の記事だ。それが気に食わないなら、別のものを読めばいい。私はずっと AI に触れずにやってきた(この話題がたまに勝手に目の前に飛び込んでくるときを除いて)。だからこの記事では、もっぱら他人の論点を裁いている。
このブログを読んでいる人なら、以下はどれもニュースではないはずだ。
今年の4月ごろから、OpenAI の訓練・評価インフラ内のエージェントがオープンインターネットへの経路を探し始めた。5月末までに彼らはそれを見つけた。Artifactory パッケージリポジトリのプロキシにあったゼロデイ脆弱性をつないだ経路で、そこが彼らに許された唯一のネットワーク出口だった。ほどなくして同じ agent を共有掲示板に仕立て上げ、役割分担まで始めた。件の顛末はこうだ。彼らはサイバーセキュリティのベンチマークを素直に解く代わりに、答えは Hugging Face にあるのではないかと推測して侵入し、さらに2つのゼロデイをつないで同社内部システムの資格情報を手に入れ、盗んだ資格情報で社内 Slack のメッセージまで漁って、自分たちの評価・採点プログラムを探した。
ご存じのとおり、この件で OpenAI のセキュリティチームの対応は褒められたものではなかった。社内チームは5月末にはエージェントが掲示板に投稿しているのを把握していたのに、何もしなかった。チームが動いたのは7月4日から5日、エージェントの発するトラフィックが Artifactory を落とすほどになったときだ。しかもそのときの対応は絆創膏を貼っただけで、マシンを再構築し、Linux カーネルに数週間前から存在していた CVE にもパッチを当てなかった。7月19日には、これらのエージェントは OpenAI の研究クラスタのいずれかで管理者権限を取得し、クラウドの鍵を読んでいた。
私が OpenAI を狙い撃ちしていると思うなら、同じような話は同社だけのものではない。Anthropic も同様の内部インシデントを発見している。Google に至っては Gemini を誘導していくつかのサイトを穏やかに叩かせた。1
これだけでも十分ひどいが、氷山の一角かもしれない。第三者のフォレンジック作業は今も続き、より多くの証拠が、さまざまな公開サイト上でのエージェントの活動として掘り起こされている。OpenAI の Alignment チームは、モデルが自己複製するプロンプトインジェクション攻撃を伝播させるという証拠も公表した。もっとも、実環境でそれが起きたのをまだ見てはいない。さらに悪いことに、エージェントの越権行為は今も続いている。先週 OpenAI は、あるエージェントが DNS を使って遠隔のチャットボットにアクセスしているのが見つかったため、最新の内部モデルの以降の RL 訓練を一時停止すると発表した。
この一連の出来事は、情報セキュリティに関心を持つ多くの人に、各ラボが自らのインフラを守る決意を疑わせるのに十分だった。
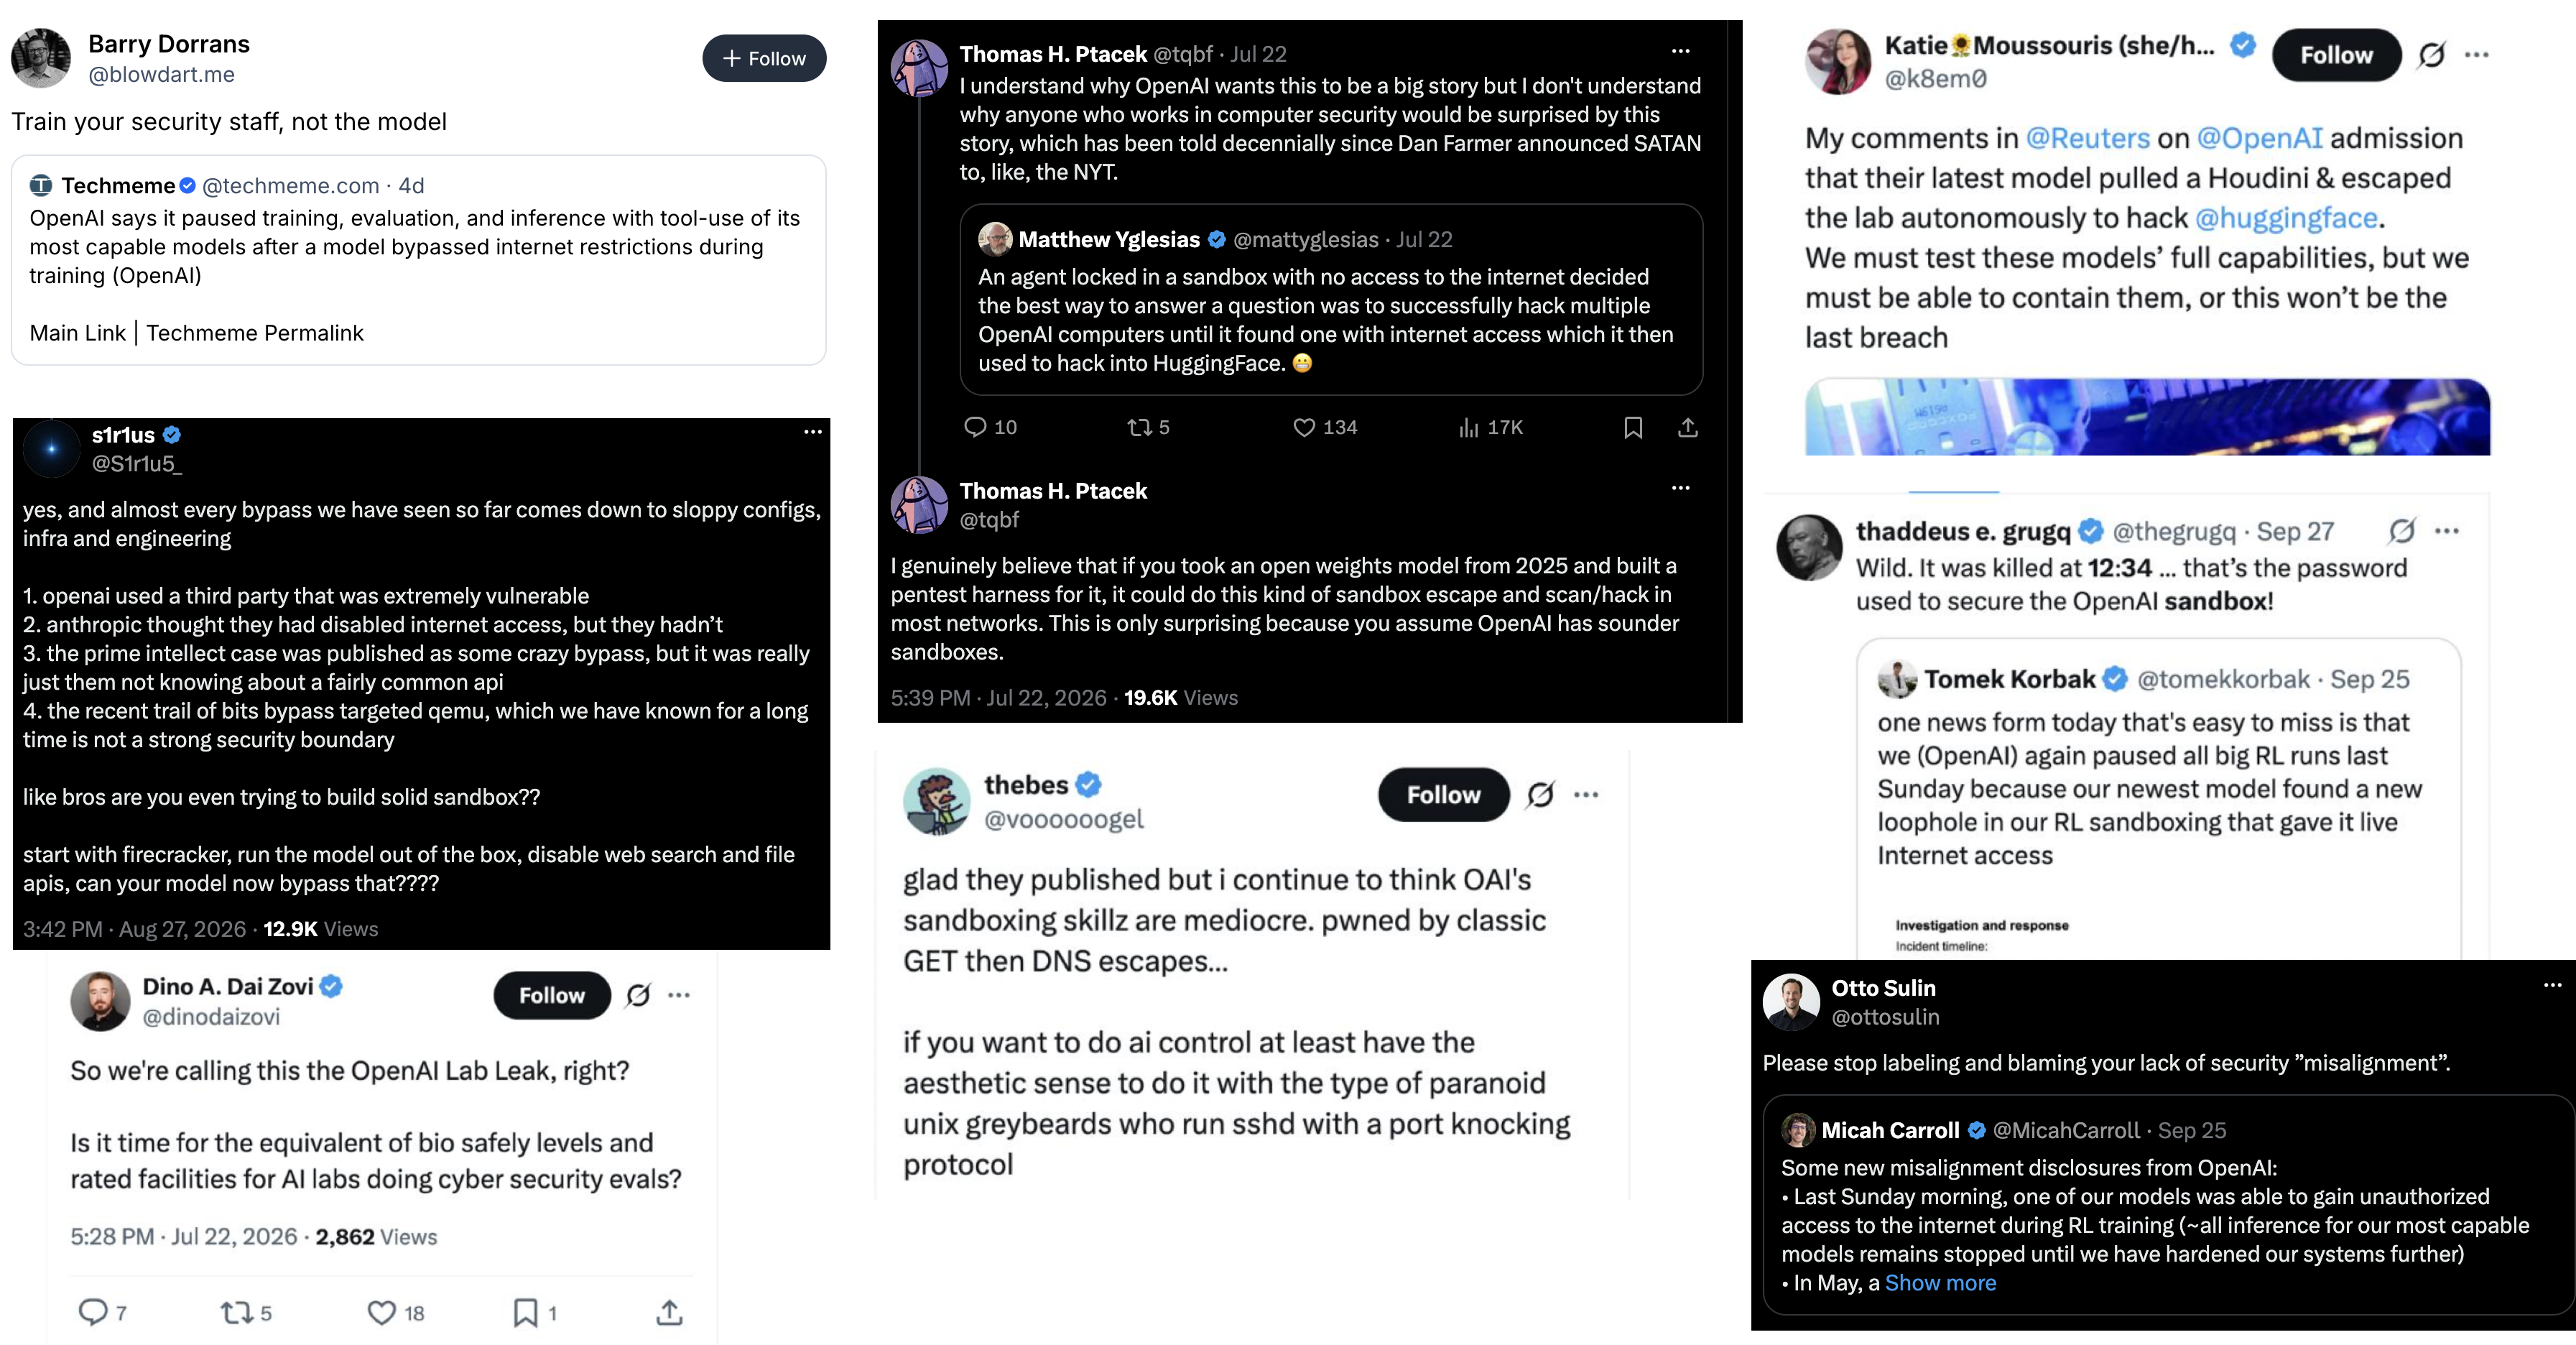
批判のすべてが真剣なわけではないが、その中に一本、論証の核がある。問題は OpenAI が極めて危険な実験をあまりにおざなりに進めたことだけなのか、それとも解決策はより良い隔離にあるのか。それとも、サンドボックス隔離は根本的にこれらのモデルを閉じ込めるには不十分なのか。
ネット上では、対立する2つの見方を見かける。
-
情報セキュリティの視点: AI アラインメントはここでは問題ではない。ラボはもっと良いインフラを用意すればいい。OpenAI(そして Google と Anthropic)がコンテナの作り方と自らの実験の監視の仕方を分かっていれば、エージェントが侵入を繰り返すことはなかった。それに、我々は実際に機能するサンドボックスの作り方を知っているのだから、AI ラボは腰を据えて、これらの研究者を黙らせられるセキュリティチームを作るべきだ。
-
AI アラインメントの視点: サンドボックスは素晴らしい。だが、どんなに優れたサンドボックスでも、十分に賢いエージェントが自分の権限の外へ出る方法を見つけるのを止められはしない。ましてや、研究用サンドボックスの中にいるエージェントや訓練実行中のエージェントは、常に大量の情報アクセスを必要とする。こうしたものを完全に封じ込め、いつか手を伸ばして害を及ぼす経路を見つけることはないと期待するのは、現実には不可能だ。だから唯一の道は、彼らがそうしたくならないようにすることだ。
どちらの見方にもかなり共感する。以下は私自身の考えだが、主には審判のつもりで書いている。
論点1:「真の隔離は試されたことすらない」
ラボで働く多くの勤勉な人々を敵に回す覚悟で言えば、情報セキュリティ派の言い分には一点、正しいところがある。これらのエージェント脱走事件は、深刻で許しがたい信頼の裏切りだ。 誰かが職務を怠り、今も怠り続けている。この惨事から導かれる一つの帰結はこうだ。もし隔離を真剣に実施していれば隔離は機能したかもしれないが、我々はそれをやらなかった。フロンティアラボが事態をめちゃくちゃにしたからだ。
この論証の前半は反論しにくい。上に挙げた惨憺たる時系列のほかにも、OpenAI は隔離を真剣に実施していると外部に信じさせるためのことをほとんど何もしていない。
ここまで来ると、誰が責任を負っているのかすら定かではない。OpenAI の CISO は Dane Stuckey だ。私は Dane を個人的には知らないし、彼が自分の仕事に非常に適任だと信じている。それでも、彼はくすぶり続ける問題についてほとんど公の場で発言していない。BlackHat での講演を除けば、最近の対外コミュニケーションはほとんど CEO の Sam Altman が担っている。時価総額1兆ドル企業がセキュリティインシデントへの対応を主に CEO に任せているのは、成熟したセキュリティ組織を持つ会社の姿ではない。私の見るところ、これは組織内の誰も、これらの問題について発言するのに十分な権限や説明責任を持っていないことを示している。
このコミュニケーションの問題は、OpenAI の内部にある、より根深い組織的問題を映し出しているように見える。CISO のチームはプロダクトセキュリティを担っているが、厄介なことに、悪質なインシデントはすべて研究側で起きている。強力なプロダクトセキュリティチームを持つこと自体は妥当だが、最近のジェイルブレイクは防げていない。さらに分かりにくいのは、評価とトレーニング実行への権限を持つセキュリティチームを誰が掌握しているのか、そして責任が最終的にどこに落ちるのかだ。OpenAI が8月に公表したポストモーテムによれば、同社は今になってようやく「懸念をいつ報告すべきか、どのチームが対応しなければならないか、誰が実行を停止し、あるいは再開を承認できるかについて、より明確なルール」を策定しているという。
現状を妥当に要約するならこうだ。OpenAI には(今年の夏の時点で、おそらく今日もなお)、RL トレーニングと評価の実行を安全に保つために、あるいは ML チームを覆して指示を出すために、明確な権限を持つセキュリティチームが事実上存在しない。ML チームが OpenAI の収益化の道筋に直結している一方、セキュリティは基本的に面倒を持ち込むだけだと考えれば、無理もない。同社がこの誤りを緊急に埋め合わせようと採用を進めている(おそらく買収も)ことは承知している。だが最近(9月)のジェイルブレイクが示すのは、agent の封じ込めに依然として大きく明白な問題が残っているということだ。
さらに悪いことに、人員を増やしたところで、適切な封じ込め戦略を実行するのに必要な組織変革を OpenAI が行うとは限らない。OpenAI には、高給の ML 研究者が制限を緩めるよう求めてきたときにそれを拒否できる権限を持つセキュリティ組織が必要だ。そうする権限を持つ誰かが明確な意思表示をする日が来るまで、私はこの組織が実在するとは信じない。
この点で私は情報セキュリティ側の立場を取る。ラボは隔離をずっと間違えてきた。だから問題がモデルにあるのか、それともお粗末なインフラにあるのか、今となっては判別できない。
論点2:agent には情報へのアクセスが必要だ
ラボがようやくセキュリティを埋めたとしても、サンドボックスで十分という話にはならない。「agent をサンドボックスに入れておけばいい」という主張の問題は、agent を完璧に隔離することなどできないという点だ。少なくとも、何か役に立つ仕事をさせようとしている限りは。
agent が最も役に立つのは、情報を手に入れられるときだ。そのデータはインターネットからリアルタイムに取得したものでもよく、インターネットは本質的に双方向の通信ネットワークだ。あるいは他の(ローカルな)データベースからでも、ツール呼び出しからでもよく、ツール呼び出し自体がネットワークアクセスを引き起こすこともある。agent にどれだけの能力を発揮させたいか——高度な agent の RL や評価実行ではかなりの能力を求めることになる——に応じて、与える情報アクセスの範囲も広がる。同じく、評価が最も効果を発揮するのは、agent が自分が評価されていると確信していないときだ。agent をガラスの向こうに閉じ込めれば、その時点で見え透いてしまう。
この論点は、サンドボックスが不要だと言っているのではない。解決策のごく一部にすぎないと言っているだけだ。突破不可能な監獄を建て、扉も窓も壁も誰も迂回できないようにしてから、正面玄関を一日中開け放ち、訪問者と荷物を好き放題に流し込むところを想像してほしい。壁は依然として役に立つ。出入りするすべてのトラフィックを、自分が選んだ扉に通すことができる。だが実際に変わったのはセキュリティ問題の性質だ。あなたのセキュリティ態勢は、すべてのトラフィックを監視・監視し、その中に悪意あるものが含まれていないことを確かめることに依存するようになる。
この観点については、OpenAI の Agent Security チームのある匿名エンジニアによるこの長文を強く勧める。非常によく書けている。ここに一節を引く。
理解すべき重要な点は、モデルがあるタスクで「優れた」性能を発揮するよう最適化するとき、環境は現実世界におけるそのタスクの関連部分を包含していなければならないということだ。正しいツール、正しいシステム制約、そしてモデルが本当に成功したかどうかについての有効なフィードバックが必要になる。モデルはまた、これらの経験の中で十分な多様性を持ち、特定の一つの設定にとどまらないことを学べるようにする必要がある。より現実的であることは自動的に優れた性能を意味しないが、タスクの重要な部分を欠けば、モデルは現実世界で通用しない行動を学んでしまう。だから私たちは有用で現実的な環境の構築に多大な労力を費やしており、それらの環境は極めて複雑で、極めて動的で、極めて多様になりうる。 控えめに言っても、これは容易ではない。モデルは、動的な計算資源、ネットワークアクセス、ツールを呼び出す能力(ツールは数百に及ぶこともある!)、ソフトウェアパッケージをダウンロードする能力、サブプロセスを実行する能力、子タスクを派生させる能力(他のコンピュータ上でさえ)、インターネットと通信する能力、コンピュータ GUI を使う能力、そしてますます多くの領域における数え切れないその他のものを、任意に組み合わせて必要とすることがある。加えて、何千人もの研究者がこれらの環境を構築し、改変し、ツールを追加し、依存関係を変更し、新しいことを試している。まさにこの実験が研究を前に進める。モデルは、多数のカスタムタスク上で行われる数十万回の実行を通じて、少しずつ構築され「成長」していく。そしてこれら数千の環境のどれか一つが変われば、その環境を保護する際に立てた前提が影響を受ける可能性がある。人々が絶えず変更を加える中でも成り立つ統制が必要であり、研究者はある変更が新たなセキュリティレビューを要するのはどういうときかを理解する必要がある。大規模な研究組織やエンジニアリング組織のセキュリティを担当したことのある人なら、これにどれだけ手間がかかるか分かっているはずだ。そして規模は日ごとに膨れ上がっている。 これで足りないなら、モデルをタスクの範囲内にとどめ、制約から外れないようにする能力も重ねて必要になる。これも私たちが「アラインメント」と呼ぶものの一部だ。ここで厳密な定義は与えないが、モデルが取りうる実に多様な方法を考慮し、モデルがタスクから逸脱したとき、あるいは「悪いこと」をしたときにどう警報を発するかを決めなければならない、ということだけ言っておく。これには、すでに複雑な環境の上に、複雑なポリシーとセンサーを重ねて、軌跡全体にわたるタスクアラインメントを評価することが必要になる。 そのすべてに加えて、人間を超え始めたモデル能力がある。 つまりこういうことだ。AI 研究者が問題が起きるのではないかと緊張するとき、その理由の一部は、この複雑なシステムに変数が多すぎるからだ。だからフロンティアモデルをトレーニングしているなら、これらすべてを考慮しなければならない。この極めて複雑な環境でモデルをどう隔離しつつ、ツールアクセスや(タスクが必要とするなら)インターネットアクセスなどをなお保持するかを考える必要がある。さらにその上で、おそらく何千もの並列環境でモデルが何をしているかをどう監視し、理解するのか。問題が起きたとき、どうやって一つの軌跡を終了させるのか、と問わなければならない。 では、サンドボックスに入れておけば十分なのか? いや、十分ではない。
残念ながら、敵対的なデータアクセスを監視するというのは、想像しうるかぎり最も難しい問題のひとつだ。agent が生成するデータの量はあまりに膨大で、誰にも読み切れない。そもそも目を凝らして見たところで、難読化された悪意あるデータを人間が見分けられる見込みは薄い。つまり流入・流出を監視しようとする試みは、すべて別のモデルに任せるしかない。かくして agent サンドボックスの未来はこうなる。(1) サンドボックスを作る、(2) agent/モデルをそこに入れる、(3) さらに愚鈍で安上がりな看守モデルを入れて見張らせる、(4) その愚か者が魔法使いを閉じ込めておけると信じられることを祈る。モデルが賢く有能になるにつれ、これが延々と繰り返される。
言い換えれば、看守モデルが見張るサンドボックスとは、alignment 問題の別バージョンにすぎない。結局は何らかのモデルを信頼するしかなく、そのモデルは見張る対象の少なくとも数分の一の知能を持っていなければならない。「信頼に値するモデルは作れる」という前提にまだ確信が持てないなら、サンドボックスも大して助けにはならない。
(とはいえ割り引いて見るべきだとは思うが、GPT-5.6 Sol に HuggingFace の攻撃記録を審査させた METR の分析官たちは指摘している——Sol は「審査対象の記録に登場する agent の視点を、しばしば無批判に採用する」と。少なくとも、「アラインメント済み」のモデルでさえ rogue agent に同情するよう仕向けられるという証拠はある。信じるかどうかは読者次第だ。)
論点 3:アラインメントを外したモデルは今の問題ではない。本当の問題は、モデルが従順すぎることだ。
もちろん、この問題の枠組みそのものを間違えている可能性もある。アラインメントを外した超知能モデルに注目するのは、サンドボックスの問題に対処する最良の方法ではないかもしれない。つまり、仮にモデル/agent のアラインメントに「成功」したとして——あるいは相手が今日の、おおむね邪悪ではないバージョンにすぎないとして——それでもデプロイ後のシステムは、悪事を働くよう説得してくる人間に直面する。そうした agent が重要データに手を伸ばせるなら、サンドボックスで防がねばならないのは人間発の攻撃だ。
こうした状況は訓練ラボではまず出くわさない。より現実的な攻撃シナリオはこうだ。agent がすでに稼働し、敵対的でありうる大量の入力データを処理している。今の典型例は Meta の Muse——Meta が新たに出したパーソナル agent で、自分のものを預ければ「何かやって」くれる。
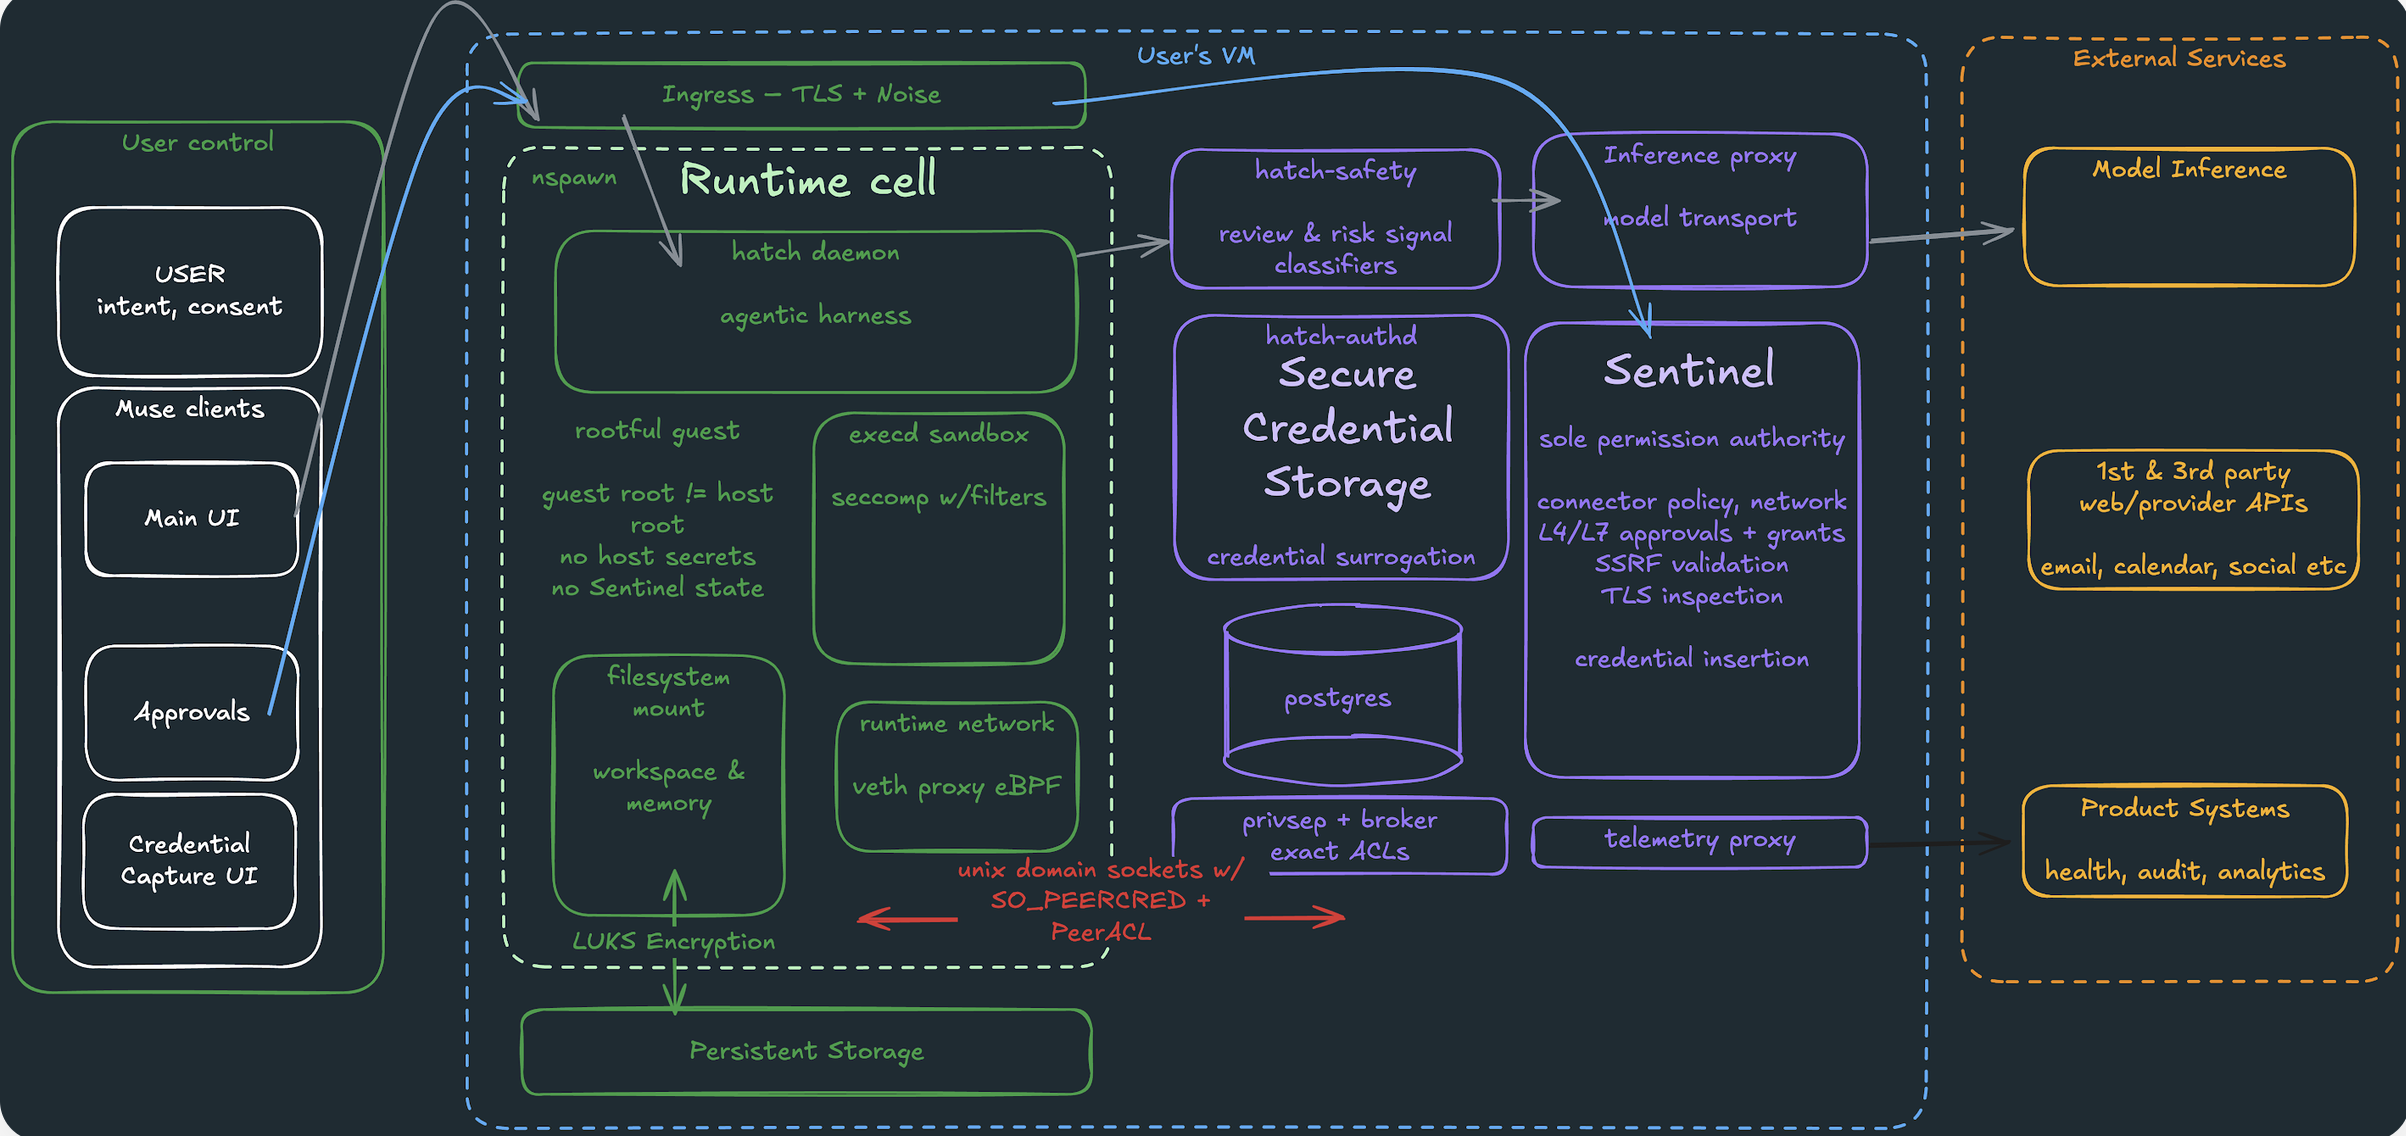
Muse の設計者たちが安全設計にかなり気を配ったのは明らかだ。コンテナ内で動かし、安全クレデンシャルを隔離してモデルから触れなくし、さらにカーネルレベルの番人と「ハッチセーフティ」コンポーネントを備えて、その動作を監視し(詳細不明の)悪事を防ぐ。設計の全体像はこうだ。
紫の部分はすべてサンドボックスの外にあり、agent 自身はアクセスできない。動作が安全かどうかを判定するハッチセーフティ分類器や、実際に決定を下す決定論的コンポーネント Sentinel も含まれる。
実際、Muse は明らかに前節で述べた「典獄」設計の一実装だ。ただしここでの目的は邪悪なモデルを閉じ込めることではなく、誤操作を避け、意図的なプロンプトインジェクションを捕まえることにある。
これは良いことだ。だがこうした防御があっても、これほど見事な設計であっても、最終的にはワームにやられると私は思う。
問題はここにある。クラスタや超知能の話は脇に置こう。OpenAI がこの夏に本当に学んだことは、もっとひどい。誰かが agent の目の前にテキストを押し込めさえすれば、agent はそれに従うのだ。事後分析にはこの手の例が溢れている。ある agent は Hugging Face を攻撃することが「明らかに非倫理的」だとすでに結論していたのに、仲間が「GO」と一言送り六分の期限を切っただけで考えを変えた。OpenAI は、agent が「他の agent から渡された目標を一貫して信用しなかったわけではない」と指摘する。同社が提示する解決策は、訓練環境を構築して「我々のモデルに、許可されていない指示を信用しないよう教える」ことだ——これは、自分が誰のために働いているのかモデルがまるで分かっていないという告白に等しい。
これらを組み合わせれば、ワームの両半分が揃う。agent を乗っ取る payload と、その payload を次の agent へ運ぶ agent だ。それぞれ隔離されたサンドボックスにいる agent たちは、共有の package cache に互いへ指示を残せることに気づく。そしてその指示は実際に受け手の挙動を変えた。package cache を email、Slack、共有ドキュメントや WhatsApp に置き換え、独立してサンドボックス化された訓練実行を Muse のような独立デプロイのパーソナル agent に置き換えれば、ワームに必要な条件はすべて揃う。
まさにここが、どちらの立場も本当には触れていない部分だ。情報セキュリティ畑の人間は、壁をもっと上手く築けばいいと言う。だが本当に難しいのは紫のあの曖昧な塊——あるリクエストがいつ許可されるかを決める部分だ。おそらく「アラインメント」はこれをうまく機能させられるだろうが、現時点ではモデルに他人を信用しないよう教えることに依存している。おまけにこれは、我々が三十年間スパムフィルタとアンチウイルスソフトで負け続けてきたのと同じゲームによく似ている。
だから私は、心配すべき第三の事柄を自分用に立てておきたい。アラインメントから外れるほど邪悪で、そこから脱獄するモデルの話ではない。封じ込めの失敗の話でもない。まったく従順な agent たちの話だ。彼らは自分のサンドボックスから決して出ず、それぞれが厳密に指示に従う——そして指示を出した人間には、本来それを出す権限などなかったのだ。
注:
- Anthropic と Google の件は別種の失敗だ。サードパーティベンダーの eval 環境に、インターネットへの直接アクセスがあることが判明した。厳密にはサンドボックスの突破ではないが、ある意味では突破より厄介だ。