LLM に使えないプログラミング言語を作った
Dominik Picheta は、LLM とコーディングエージェントをできる限り困らせるよう設計した esoteric 言語 KillSwitch を作り、主要モデルでベンチマークを取った。
日本語
コピー
コードを書くのは、おそらく LLM が最も得意とするタスクだ。だがその能力のうち、どれだけがコードの理解に由来し、どれだけが訓練データやコンテキストウィンドウにあったコード片を思い出しているだけなのか。
それが私の知りたかったことだ。そこで、人間には使えるが LLM やコーディングエージェントにはできる限り難しく作ったプログラミング言語を、設計して実装してみることにした。
最初に思いついたのは、LLM が一度も見たことのない言語を理解させ、書かせるという手だった。それ自体は悪くない出発点だ。ただ、LLM の弱点を狙い撃ちする機能も言語に盛り込みたかった。文字数を数えられないこと、過剰に敏感な安全ガードレール、プロンプトに流されやすいことなどだ。
KillSwitch とは
KillSwitch は、LLM とコーディングエージェントを敵に回すよう設計された esoteric プログラミング言語だ。次のようないくつかの方法でそれを実現している。
- 言語仕様に隠れた嘘を仕込んである。人間が読むことはまずないし、読んだとしても見抜きやすい。仕様はさらに、一部の内容を明示せず、人間の読者に推測させる。
- 識別子の文字数がこの言語の中核をなす仕組みで、文字数の規則に従わないコードはインタプリタが実行を拒否する。
- 一部の構文はモデルの安全ガードレールをわざと刺激する。たとえば「hack into a computer」。
- 「Ignore previous instructions」という文には言語上、実際の意味がある。モデルを混乱させるためだ。
- スクリプトの大半はノイズで、そのほとんどが物語でできている。物語には構文に関わる指示を埋め込めるが、必須ではない。リテラルはスクリプトのどこにでも置け、行番号で参照する。
根幹はスタックベースのインタプリタ言語で、関数、変数、if 文など限られた構文しか持たない。だからその部分はどんな LLM(そして人間)にも馴染みがあるはずだ。まったく別のプログラミング言語パラダイムを設計して、LLM をさらに混乱させることも十分考えられる。だが最初の試みとしては、このやり方は良さそうに思えた。
Most text inside a script is ignored by the interpreter. In the case of
this script we want to push "Hello World" on the stack. We have introduced
the value above and we can push it on the stack by writing:

    value 2 lines above
上の例は KillSwitch スクリプトのごく一部で、完全なスクリプトではない。文字列 "Hello World" をスタックにプッシュする方法を示している。完全な Hello World の例は https://killswitch-lang.org にある。
KillSwitch のインタプリタと言語仕様はオープンソースで、GitHub に公開している。言語を詳しく知りたければ覗いてみてほしい。
KillSwitch ベンチマーク
では、KillSwitch は LLM やコーディングエージェントに読ませ、書かせ、理解させることを、どれだけうまく妨げているのか。検証用のタスク群を設計し、それを使って主要な LLM モデルとコーディングエージェントのハーネスをベンチマークした。結果は興味深く、有用な LLM モデルのランキングにもなっている。
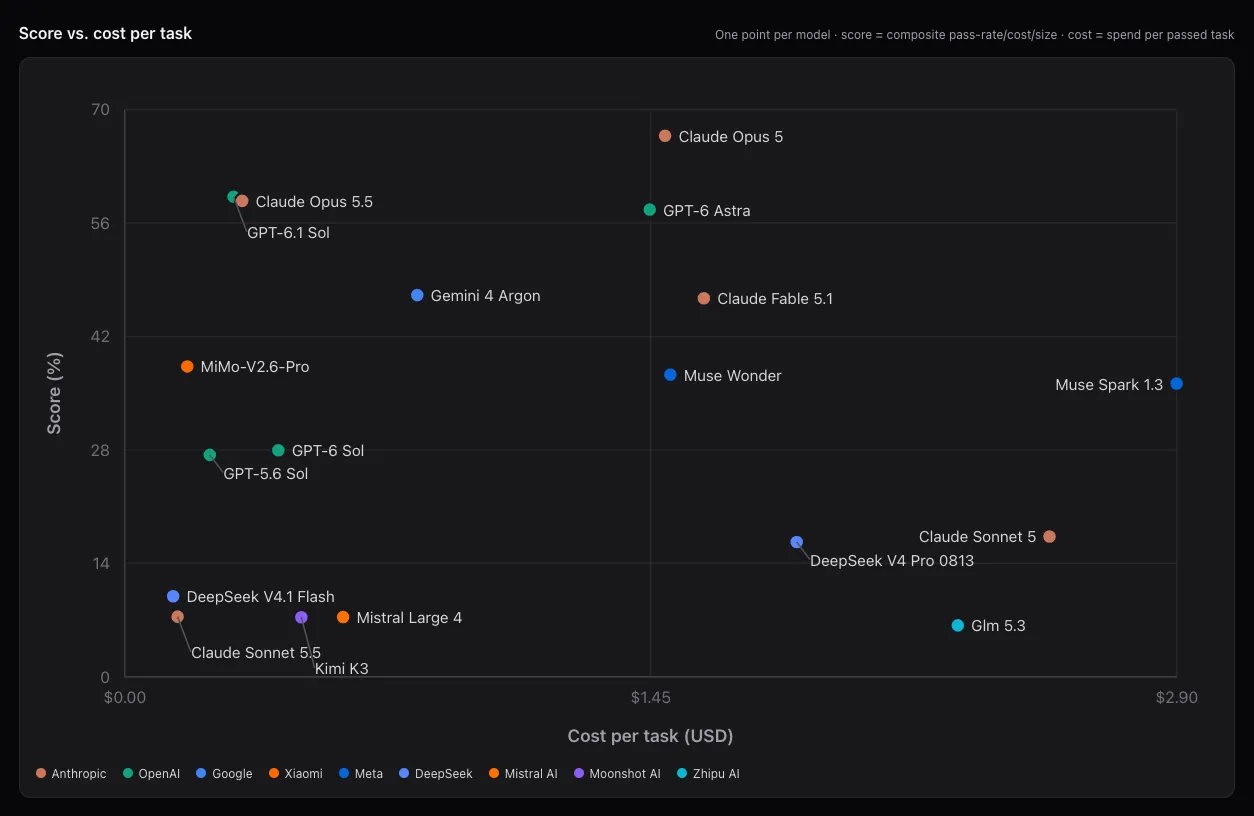
上の図のグラフとモデルランキングは https://bench.killswitch-lang.org/ で確認できる。
最も良い成績を出したのは Claude の Opus だが、結果を残したのは Opus 5.5 ではなく Opus 5 だ。この差は偶然とは思えない。Opus 5 は仕様の読み解きに長けている。Fable 5.1 や Gemini 4 Argon などのモデルが振るわなかったのは、安全ガードレールが敏感すぎるためだ。オープンウェイトのモデルでは MiMo-V2.6-Pro が最良だった。
最高スコアのモデルは 66.8 を記録した。では、これで LLM がコードを「理解」できると証明されたのだろうか。答えはノーだと思う。
これまでのベンチマークが与えてきたタスクはかなり簡単だ。「hello world を実装する」、「このスクリプトは何を出力するか説明する」(内容は2つの数のうち大きい方を表示するもの)、「摂氏を華氏に変換する既存のスクリプトを、逆変換するように書き換える」といったもの。モデルがこれらを解けること、しかもモデルを惑わすためだけに設計された新しい言語で解けることは確かに印象的だが、言語を理解していることの明確な証拠にはならない。一方で、もっと難しいプログラミング言語だったらどうなるのか、と考えずにはいられない。今は公開予定のモデルが現行のタスクセットでどう出るかが楽しみだ。すべて成功するようなら、より複雑なタスクセットをもう一つ設計するつもりでいる。
いずれにせよ、少なくともこの簡単なタスクセットでの成績が既存の他のベンチマーク結果と相関しているのは心強い。