言語モデル
言語モデルの「形」は harness に合わせるべきなのか、逆に harness がモデルの形に合わせるべきなのか。ChatGPT 以降のモデル設計をめぐる短い考察。
日本語
コピー
言語モデルの形についての雑な思考。たとえば、言語モデルを harness に合わせて設計するのではなく、その逆を行うとはどういうことか。
ChatGPT の登場以降、言語モデルの入出力の形はほとんど変わっていない。もっともな推測はこうだ。ユーザーは常に最良のモデルを選ぶ傾向があり、フロンティアラボも実証済みのモデル形態から離れようとしない。他の選択肢に賭けるコストが高すぎるからだ。その結果、言語エージェントの設計とは、自己回帰的な言語モデルに合わせて harness1 を設計する仕事になってしまった。多くの人には馬鹿げて見えるかもしれないが、私が興味を持つ自然な問いはこうだ。逆に言語モデルの形を harness に合わせて変えることは、検討に値するのではないか。
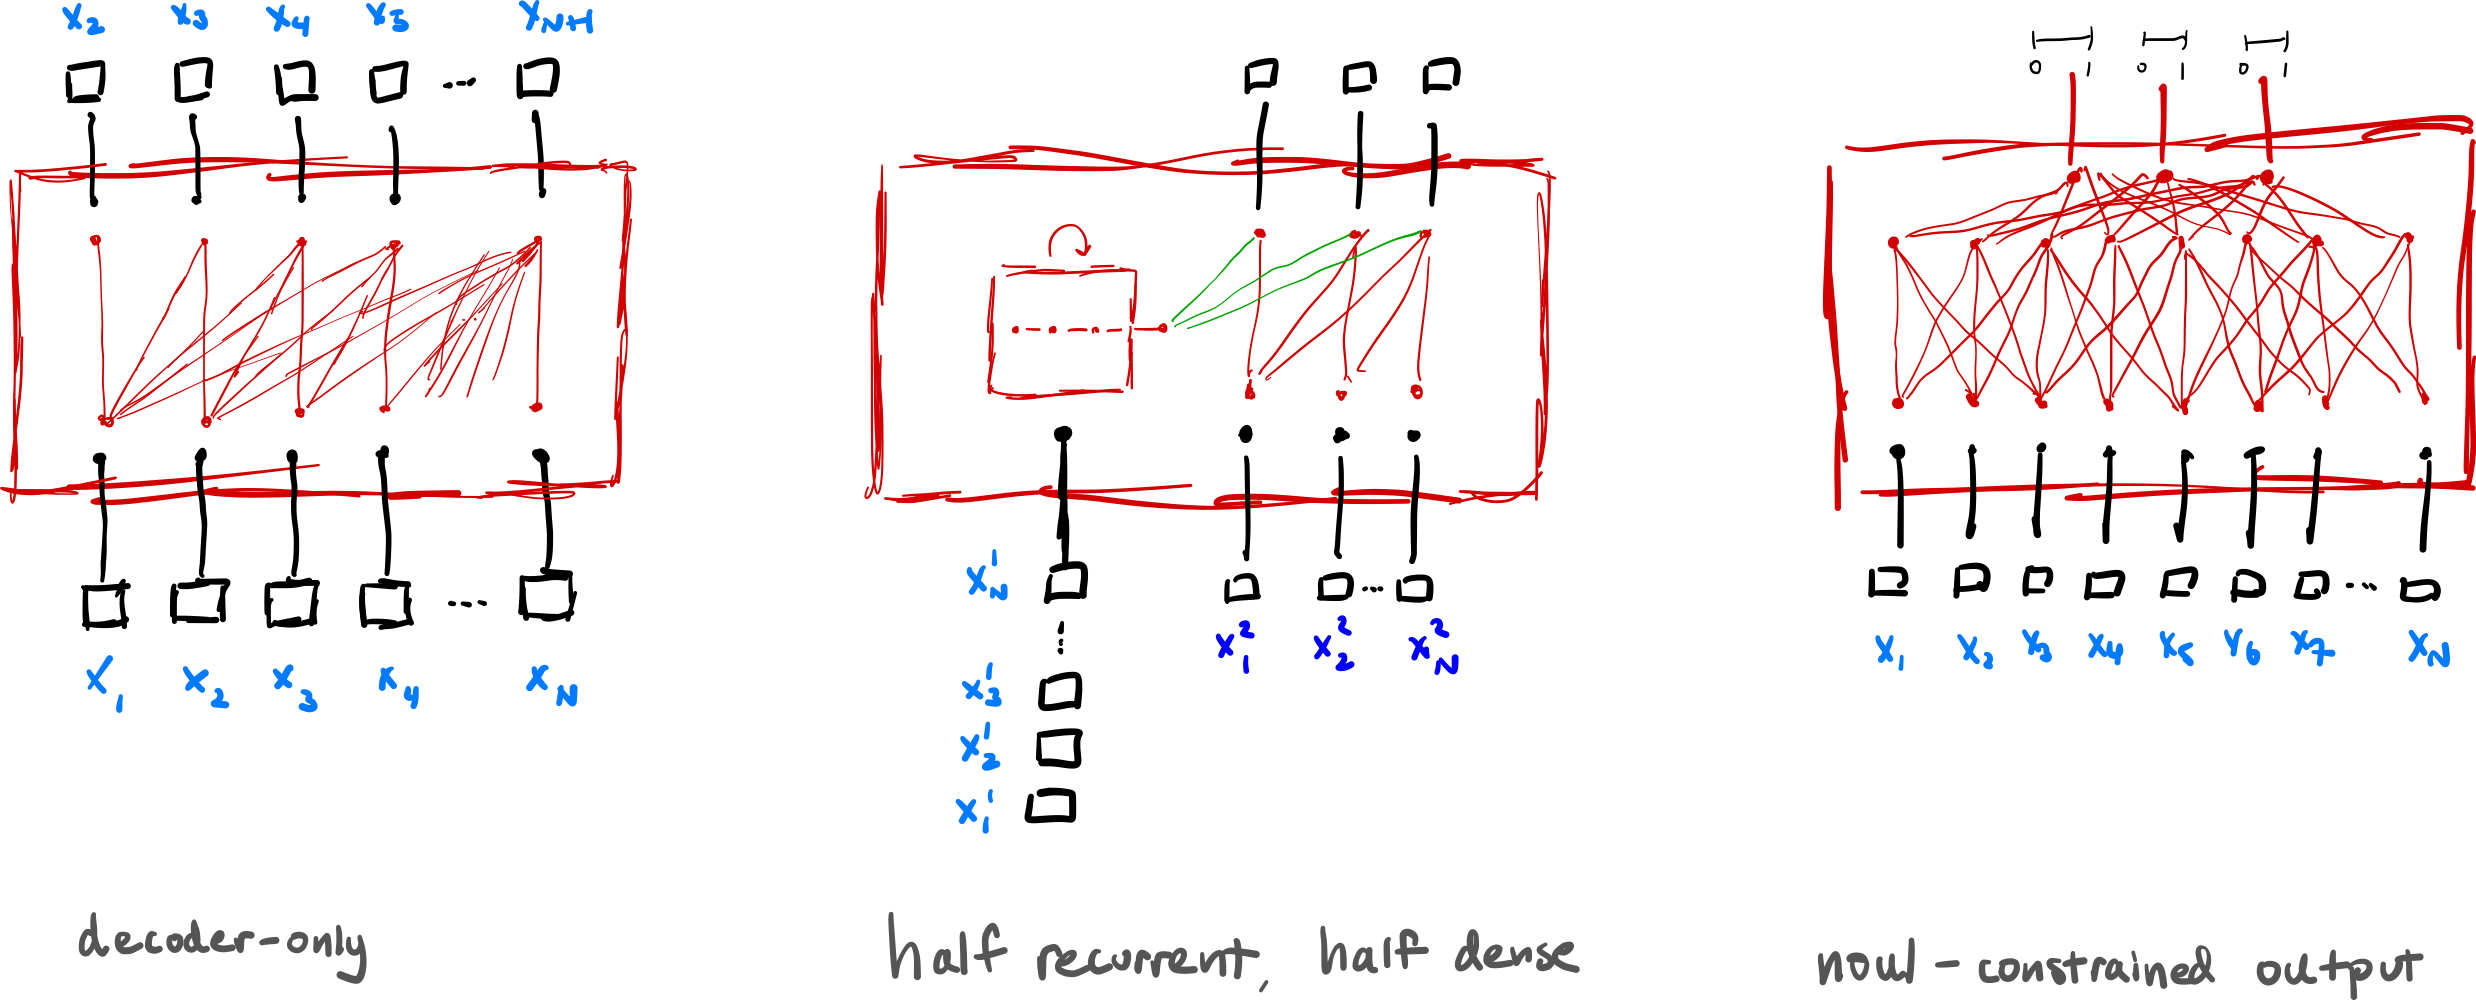
言語モデルの「形」とは、おおまかに言えばモデルの入出力構造のことだ。最も柔軟で広く使われている形は自己回帰的な decoder-only Transformer だが、この約束を一度変えると、効率や長文脈など一連のトレードオフが生じる。私たちは通常、タスクの形に合わせて harness を変える。そのほうがはるかに安いからだ。しかし言語モデルの形をうまく合わせるほうが、償却コストで見れば最終的に安くつくかもしれない。
この方向の仕事は「モデルアーキテクチャ研究」に属するが、現代のモデルアーキテクチャ研究が主に関心を向けるのは、より大きなモデル内部の各層の順序や性質といった細部であり、モデル全体は依然として decoder-only Transformer だ。理由は明快だ。1)decoder-only 言語モデルは極めて強力かつ柔軟である。2)scaling の過程では、賢明なアーキテクチャ選択が数百万ドルの価値を持つ。3)稠密な次トークン予測は任意のテキストに適用できる自然な目的関数である。この分野にはまだかなり多くの研究余地があり、フロンティアラボの関心の中心になるのは妥当だ。2
数年前、State-Space Models(SSM)や Mamba のような新しい再帰アーキテクチャが登場したとき、私はかなり興奮した。だがその後、それらのほとんどが decoder-only Transformer の形を保ったハイブリッドモデルに使われていると知って、かなり失望した。もっと面白いと思ったのは、ここでの「ハイブリッド」とは注意機構と SSM 層を縦に交互に積むことであって、並列な残差ストリームに作用させることではないという点だ!経験に基づくさまざまな理由から最終的にこの方法が選ばれたのだろう3が、私が言いたいのは、これらの層が Transformer とは異なる特性を持ち、その特性は harness 側でもっと活かせる余地があるのではないかということだ。decoder-only Transformer はすべて「任意のテキスト → 任意のテキスト」という形を前提にしている。だが、使うモデルの入出力の形に何らかの構造的な仮定を置けるとしたらどうだろう。
良い例が今月初めに公開された Jev (Typesafe AI, 2026) だ。これは出力空間を に明示的に制約した言語モデルと見なせる。この制約により、サンプリング時に prefill-only が可能になり、ある種の特定の問いに答えるときは極めて速い。この構成の実用性や妥当性をどう見るかは別として4、Jev が示しているのは、言語モデルの形をめぐるもうひとつのトレードオフ空間を構築できる可能性だ。非常に限られたユースケースでは、フロンティアモデルより Jev を選びたくなる場面は十分ありうるし、それを活かせる harness 設計が存在する可能性もある。たとえば、曖昧な if 文のロジックを扱う高速な条件付き予測ツールとして使う実装をネットで見かけたが、これは Recursive Language Model (RLM) harness にとって実はかなり有用だ。Jev は特に、(少なくとも執筆時点では非公開の)Reinforcement Learning for Calibrated Decisions(RLCD)という新しい目的関数を提案している。他の入出力形態についても、正しい振る舞いを本当に最適化するには、修正された目的関数を考案する必要があるだろう。
この方向に私が特に惹かれるのは、単なる規模拡大よりも筋が通っており、創造性を要するからだ。問題構造のある種の観察や直感に頼りながら、カスタムのモデル形態を設計・訓練し、コスト効率でフロンティアモデルを上回らせることになるだろう。
エージェントにおける言語モデルの形。
私の「暴論」はこうだ。decoder-only Transformer はエージェントの軌跡を扱う自然な形でも最終形でもないと考えている。そしてこれこそが compaction のようなコンテキスト管理テクニックが存在する根本的な理由だ。5 LLM 時代のエージェントは通常 ReAct (Yao et al., 2022) の変種であり、時間の経過とともにコンテキストを蓄積していく。各 ターン で、エージェント は行動 (たとえば推論+ツール呼び出し)を生成し、そこから観測 が得られ、軌跡に追加される。エージェントの軌跡は通常次の形をとる:
[a_{t+1} \sim \pi_{\theta}(\cdot | \mathcal{H_{
- harness とは、言語モデルを何らかの形で呼び出し、より大きなタスクの遂行を助けるプログラムやコードのことだ。たとえば、ソフトウェアエンジニアリングのタスクを基盤言語モデルにそのまま投げてできることを期待するのは普通は無理で、harness を書いてモデルをループに入れ、grep ツールを渡し、ターミナルとやり取りする手段を与える、といったことが必要になる。 ↩
- フロンティアラボに属さない個人(たとえばアカデミアの研究者)にとって、この研究路線はほぼ通れない。 ↩
- 私の(かなり限られた)理解では、こうした選択は次のようにして決まってきた。まず大規模ラボの多くの人間と大量の計算資源がさまざまなアイデアを手当たり次第に試し、うまくいったものが残り、他のラボへ広がり、最終的にオープンソースへ流れていく。私がここで述べたことの多くが、実は過去にどこかのラボで何らかの形ですでに検討されていたとしても驚かないが、おそらく何らかの理由で先には進まなかったのだろう。だからこそ、代替となる賭けを研究するのは面白いのだ。 ↩
- もっとも、それはしばしば誤用されたり曲解されたりすると思うが、多くの刺激的なアイデアは往々にしてそういうものだ。Jev はどの問題についても神託のような分類器ではないし、単なる自明な分類器でもない。 ↩
- 実際、言語モデルの他の多くの応用についても同じことが言えると思う。ただ「agent」はすでに遍在し高度に標準化されているので、考えてみる価値はある。agent harness を差し込む相手の言語モデルに、他にトレードオフできる選択肢はないのだろうか、と。 ↩
- Navier-Stokes の発表には驚いた——噂が出た当初は偽物だと思っていたと認めよう(まあ、当時は実際に偽物だったのだと思う)。それから間もなく、Astra が NetHack で飛昇できる という結果にも同じくらい驚いた。多くの人にとってはそこまで面白い話ではないかもしれないが。これらのモデルは今、非常に強力だ。 ↩