语言模型
语言模型形态是否该反过来适配 harness,而非只让 harness 迁就自回归 Transformer,Jev 用输出约束到 [0,1] 的 prefill-only 采样给出了一个可能。
中文
复制
关于语言模型形态的一些零散思考,比如围绕 harness 来设计语言模型、而不是反过来,意味着什么。
ChatGPT 发布之后,我观察到语言模型的输入/输出形态基本没怎么变过。一个合理的猜测是:用户总是倾向于用最好的模型,而前沿实验室也不愿偏离已经被验证可行的模型形态,因为押注其他方案代价太高。于是,所有设计语言智能体的工作,都变成了设计一个 harness1 去适配语言模型的自回归形态。这个想法在多数人看来可能很傻,但我感兴趣的一个自然问题是:反过来改变语言模型的形态去适配 harness,是否值得考虑。
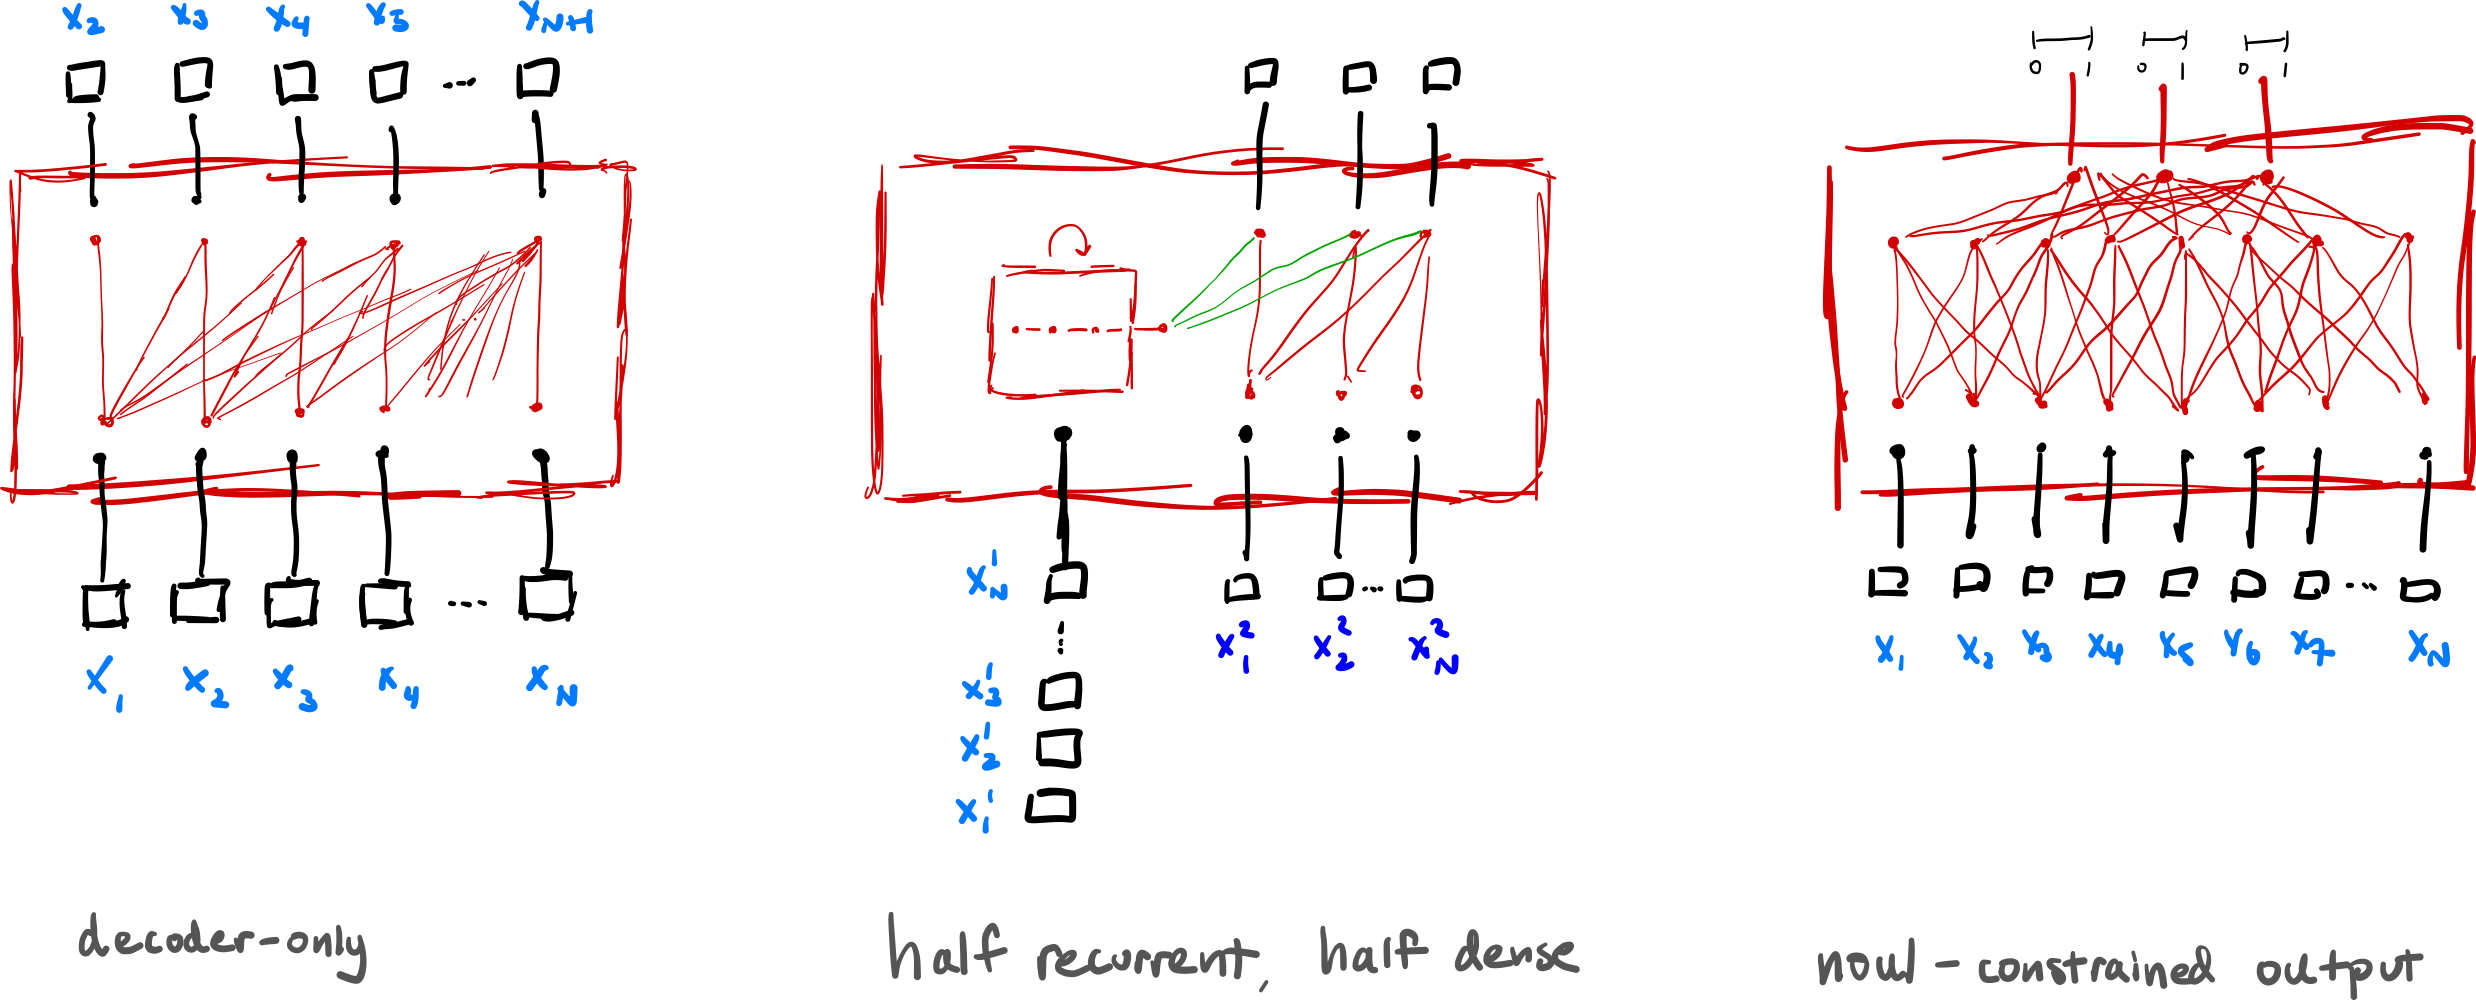
语言模型的“形态”大致就是模型的输入/输出结构。最灵活、使用最广的形态是自回归的 decoder-only Transformer,但一旦改动这个约定,就会有一系列权衡(效率、长上下文等等)。我们通常改 harness 去适配任务的形态,因为这样便宜得多,但把语言模型形态适配好的摊销成本,最后可能反而更低。
这条线的工作属于“模型架构研究”,但现代模型架构研究主要关心的是更大模型内部各层的顺序与性质这类细节,整体模型仍然是一个 decoder-only Transformer。原因很清楚:1)decoder-only 语言模型极其强大且灵活;2)在 scaling 的过程中,聪明的模型架构选择价值数百万美元;3)稠密的下一 token 预测是适用于任意文本的自然目标。这个领域也还有相当多研究可做,所以它成为这些前沿实验室的关注中心是合理的。2
几年前,State-Space Models(SSM)和 Mamba 这类较新的循环架构刚出现时,我相当兴奋,但后来颇为失望地发现,它们大多被用在保留 decoder-only Transformer 形态的混合模型里。更让我觉得有意思的是,这里的“混合”指的是把注意力和 SSM 层纵向交替堆叠,而不是让它们作用于并行的残差流!我确信,我们最终之所以选择这种做法,有各种各样基于经验的原因3,但我想说的是,这些层相对于 Transformer 具有不同的特性,而这些特性在 harness 中或许还有更多利用空间。所有 decoder-only Transformer 都假定“任意文本 → 任意文本”的形态,但如果我们能对所用模型的输入/输出形态作出某种结构假设呢?
一个很好的例子是本月初发布的 Jev (Typesafe AI, 2026),可以把它看作一个输出空间被显式约束为 的语言模型。这一约束使模型在采样时能够做到 prefill-only,从而在回答某一类特定问题时极快。无论你怎么看待这种构造的实用性或合理性4,Jev 所代表的是围绕语言模型形态构建 另一种权衡空间 的可能性。在非常特定的用例中,你很可能会更愿意用 Jev 而不是前沿模型,甚至可能存在某些 harness 设计能让它派上用场;举个例子,我在网上见过一些实现把它当作快速的条件预测工具,用来做模糊的 if 语句逻辑,这对 Recursive Language Model (RLM) harness 来说其实相当有用。Jev 尤其提出了一种(保密的,至少截至写作时如此)新目标函数,叫做 Reinforcement Learning for Calibrated Decisions(RLCD),我猜对于其他输入/输出形态,我们也得提出修改过的目标函数,才能真正针对正确的行为做优化。
这个方向让我格外兴奋,因为它比单纯的规模扩张更有章法,也更需要创造力。你很可能得依靠直觉,或者对某一类问题结构的观察,去设计和训练定制化的模型形态,让它在成本效率上超过前沿模型。
语言模型在 agent 中的形态。
我的“暴论”是:我不认为 decoder-only Transformer 是处理 agent 轨迹的天然形态或最终形态,这也正是 compaction 这类上下文管理技巧存在的根本原因。5 LLM 时代的 agent 通常是 ReAct (Yao et al., 2022) 的变体,随着时间推移不断累积上下文。每一 轮,agent 产生一个动作 (例如推理 + 工具调用),由此得到一个观测 ,并被追加到轨迹中。agent 轨迹通常形如:
[a_{t+1} \sim \pi_{\theta}(\cdot | \mathcal{H_{
- harness 就是一段程序或代码,它以某种方式调用语言模型,帮助完成更大的任务。比如,你通常没法直接把一个软件工程任务丢给基础语言模型就指望它能做,你得写一个 harness 把它放进循环里,给它 grep 工具,给它一个和终端交互的方式,等等。 ↩
- 对非前沿实验室的个人(比如学术界人士)来说,这条研究路线几乎不可能走通。 ↩
- 据我(相当有限的)了解,这些选择是怎么做出的:一开始是这些大实验室里许多人、大量算力对各种想法进行一通乱枪打鸟式的探索,能跑通的就留下来,扩散到其他实验室,最终流向开源。如果我说的很多东西过去其实已经在某个实验室里以某种形式被探索过,我不会太意外,但多半因为某些原因没走远。这正是研究替代性赌注如此有趣的地方! ↩
- 尽管我认为它经常被误用或曲解,很多令人兴奋的想法往往如此。Jev 不是任何问题上的神谕分类器,也不只是一个平凡的分类器。 ↩
- 事实上,我认为语言模型的许多其他应用也是如此。但“agent”已经变得无处不在且高度标准化,所以值得想一想:你插入 agent harness 的那个语言模型,是否存在其他可以权衡的取舍。 ↩
- Navier-Stokes 的公告让我震惊——我承认,传闻刚出现时我以为那是假的(不过我想当时它确实是假的)。没过多久,Astra 能在 NetHack 中飞升 这个结果同样让我震惊,尽管对很多人来说可能没那么有意思。这些模型现在非常强大。 ↩