Liquid AI が LFM3 を発表、2B クラスの 6 モデルを 1 つのバックボーンで
LFM3-1.7B は 22T トークンで事前学習し、24 層のうち 13 層がゲート付き短畳み込み、5 層がスライディングウィンドウ注意、6 層がグローバル注意。4bit で約 1 GB、128K コンテキストの KV キャッシュは 1.6 GB に収まる。視覚・音声・オムニ・判断の各モデルも同じ骨格から派生した。
日本語
コピー
本日、次世代の Liquid Foundation Models(LFM)であるLFM3を発表します。特化型インテリジェンスのために設計したモデルです。LFM3 ファミリーはマルチモーダルを前提とした設計で、テキスト、ビジョン、オーディオ、オムニ、意思決定の各モデルを新しい共通バックボーン上に載せています。LFM3 ファミリーの最初のリリースは、2B パラメータ規模のモデル群です。
新しいハイブリッドアーキテクチャと 22T トークンの事前学習に基づく LFM3 は、LFM2の効率を保ちながら、表現力を大幅に高めています。小型で高速なモデルに増えた容量は、特化型インテリジェンスにおける同クラスの出発点として LFM3 を最適な選択にします。ローカルでファインチューニングでき、あらゆるデバイスで動作し、特定タスクの信頼できるエキスパートになれるだけの能力があるからです。
ベースモデルと事後学習済みモデルはオープンウェイトで、本日からHugging Face、Playground、Liquid AI APIで利用できます。ローカルでの実行方法とファインチューニング方法はドキュメントを参照してください。
ハイライト
- パラメータあたりの性能が向上: 新しい tri-hybrid アーキテクチャと学習レシピにより、LFM3-1.7B はパラメータ数が 35% 少ないながら、従来の LFM2.5-2.6B を上回る性能を実現しました。
- すべてのモダリティを 1 つのバックボーンで: LFM3-1.7B-Base から学習した 6 つの 2B クラスモデル(テキスト、ビジョン、オーディオ、オムニ、意思決定)。
- エッジ向け設計: テキストモデルは 4bit 精度で約 1GB に収まります。
- 自社開発の新しいフラッグシップ視覚・音声エンコーダを搭載。
- テキストモデルは 256K のコンテキストウィンドウに対応。
- 特化させるためのモデル: どのモデルも単一の GPU でファインチューニングできます。
LFM3 の各モデルは、特化型インテリジェンスの有力な候補です。自社データでファインチューニングし、アプリケーションが動く場所にそのままデプロイできます。それでは記事をお楽しみください。
表現力を高める新アーキテクチャ
LFM2 は、短い畳み込みとアテンションを組み合わせたハイブリッド構成が、品質を犠牲にせずオンデバイスで高速に動作することを示しました。この設計はハードウェア・イン・ザ・ループの自動アーキテクチャ探索から生まれたものです。LFM3 では、この探索を使ってアーキテクチャをエージェント用途向けに再設計しました。エージェント用途では、パラメータあたりの性能と、長いコンテキストでの高速推論が求められます。
ハードウェア・イン・ザ・ループの対象も広げました。LFM2 ではスマートフォン 1 台とノート PC1 台の CPU だけでしたが、LFM3 では 14 種類のデバイスとバックエンドの組み合わせで探索しています。スマートフォン(Samsung Galaxy S26 Ultra、OnePlus 15)、Raspberry Pi 5、ノート PC(Apple M4 Max、AMD Ryzen AI)、Arm と x86 のクラウド CPU、さらに GPU と Qualcomm Hexagon NPU です。
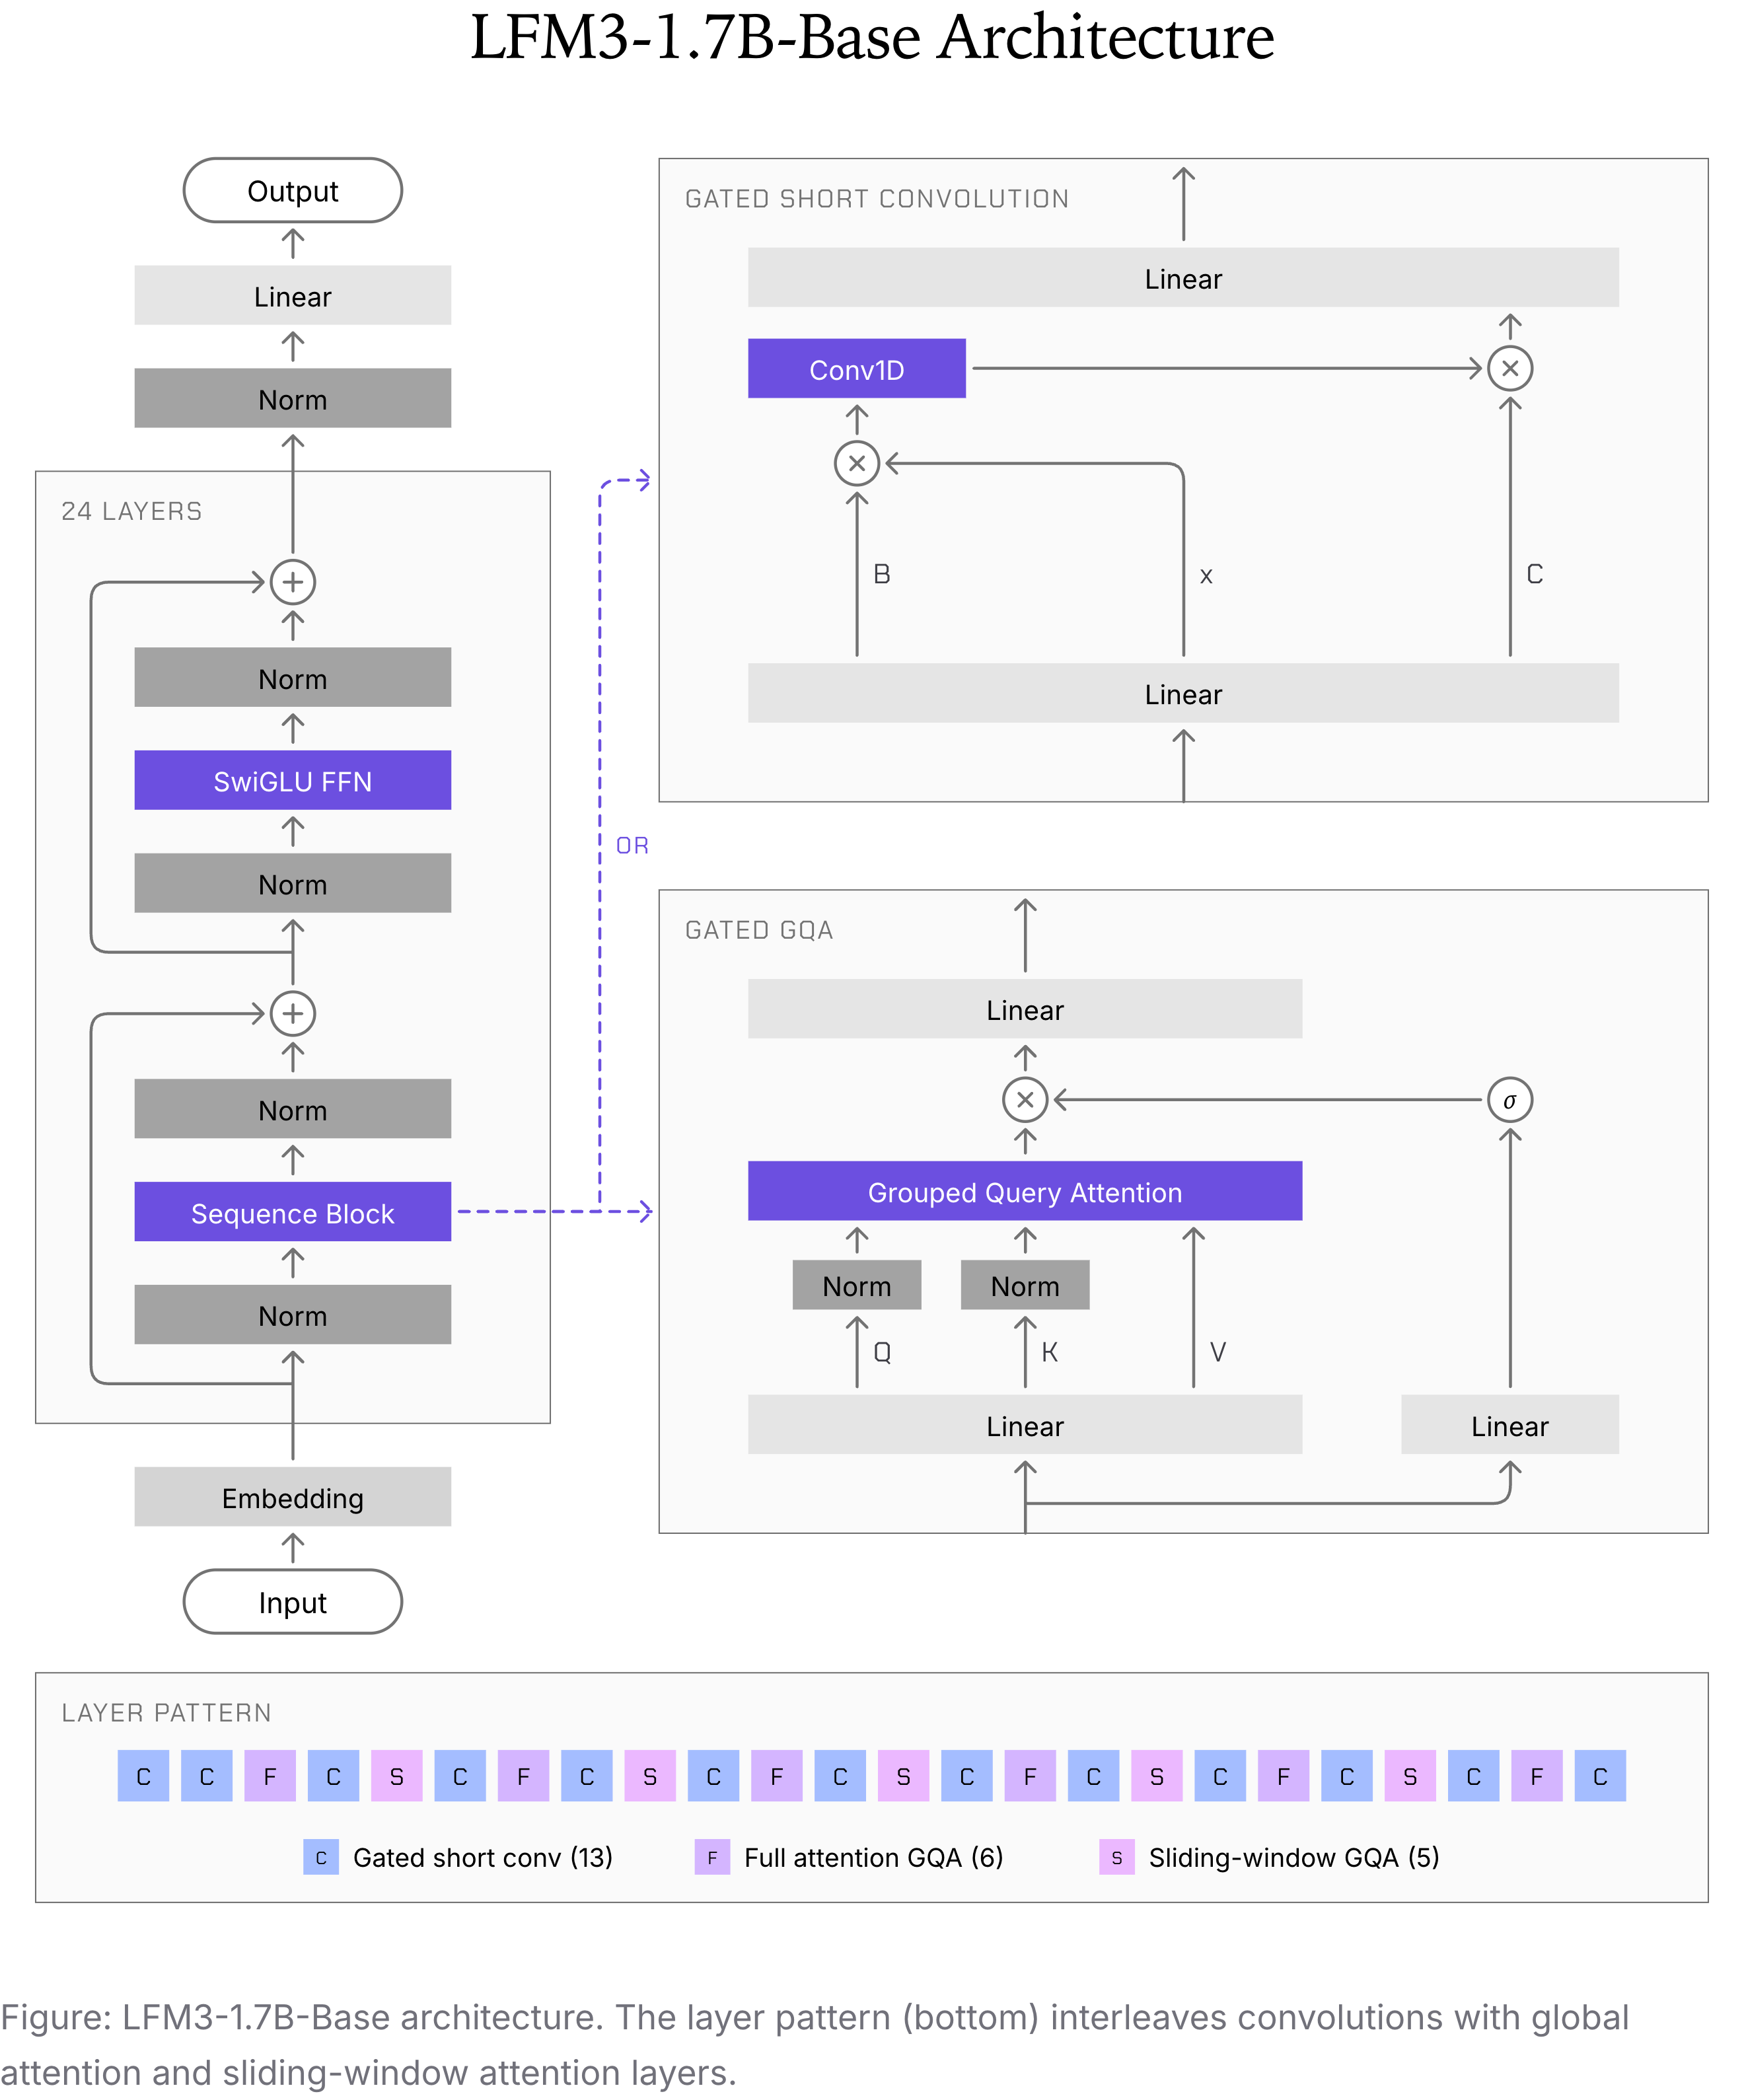
ゲート付き短畳み込みは、今もレイヤーの半分以上を占めています。長いコンテキストを遅くせずに性能を高めるため、一部を別のシーケンスブロックに置き換えてみたところ、sliding-window attention(SWA)が品質と速度のバランスで最も優れていました。以下に挙げるその他の変更は、速度を大きく損なわずに品質が向上した場合にのみ採用しています。その効果は長いコンテキストで現れます。パラメータあたりで見ると、LFM3-1.7B は短いプロンプトではエッジデバイス上で LFM2-1.2B と同等、コンテキストに 8K トークンを含めると約 25% 高速です。
図: LFM3-1.7B-Base のアーキテクチャ。層のパターン(下段)は、畳み込みとグローバルアテンション、スライディングウィンドウアテンションの層を交互に並べている。
3 種の演算子を組み合わせた層構成。 LFM3 はゲート付きショート畳み込み、スライディングウィンドウアテンション(SWA)、グローバルアテンションという 3 つの演算子を組み合わせている。24 層のうち 13 層が畳み込み、5 層がウィンドウ幅 256 トークンの SWA、6 層がグローバルアテンションだ。畳み込みのカーネルサイズも LFM2 の 3 から 7 に広げた。
ヘッド単位のゲート付きアテンション。 シグモイドゲートが各ヘッドの出力をスケーリングするため、ヘッドは寄与するものがないときにオフにできる。これにより、量子化を妨げる活性化の外れ値の抑制や学習の安定性の向上に役立つ可能性がある。
部分 RoPE。 グローバルアテンション層では、各ヘッドの高周波側の半分だけを回転させ、低周波側の半分は回転させない。こうした次元は距離によらず内容でマッチする。SWA 層は RoPE を全次元に適用する。
サンドイッチ正規化。 各ブロックは入力と出力の両方を正規化し、活性化のスケールを適切に保つ。
LFM3 の語彙は LFM2.5-8B-A1B と同じ 128K で、非ラテン文字をより効率よくトークン化できるよう設計されている。
学習。 LFM3-1.7B-Base は 22T トークンで事前学習した。LFM2 と比べて、科学論文、リポジトリ単位のコード、より幅広い知識ソース、そして大幅に増えた数学のデータを混ぜている。最後の 3.5T トークンは、厳選した高品質データによるミッドトレーニング段階で、エージェントの軌跡や多様なツール呼び出しの比率を高め、エージェント向けのポストトレーニングに備えている。この段階でコンテキストウィンドウも 256K トークンに拡張する。
用途に合わせて選べるマルチモーダルファミリー
LFM3 の最初のリリースには 6 つのモデルが含まれる。いずれも同じ LFM3-1.7B-Base をバックボーンに派生したモデルで、パラメータ数はおよそ 2B。うち 4 つは入力モダリティの異なるモデル(テキスト、視覚、音声、オムニ)で、残る 2 つは視覚モデルとオムニモデルを特化させた意思決定モデルだ。汎用の大型モデルを 1 つ動かすのではなく、用途に合うモデルを選んでカスタマイズし、オンデバイスで動かせる。
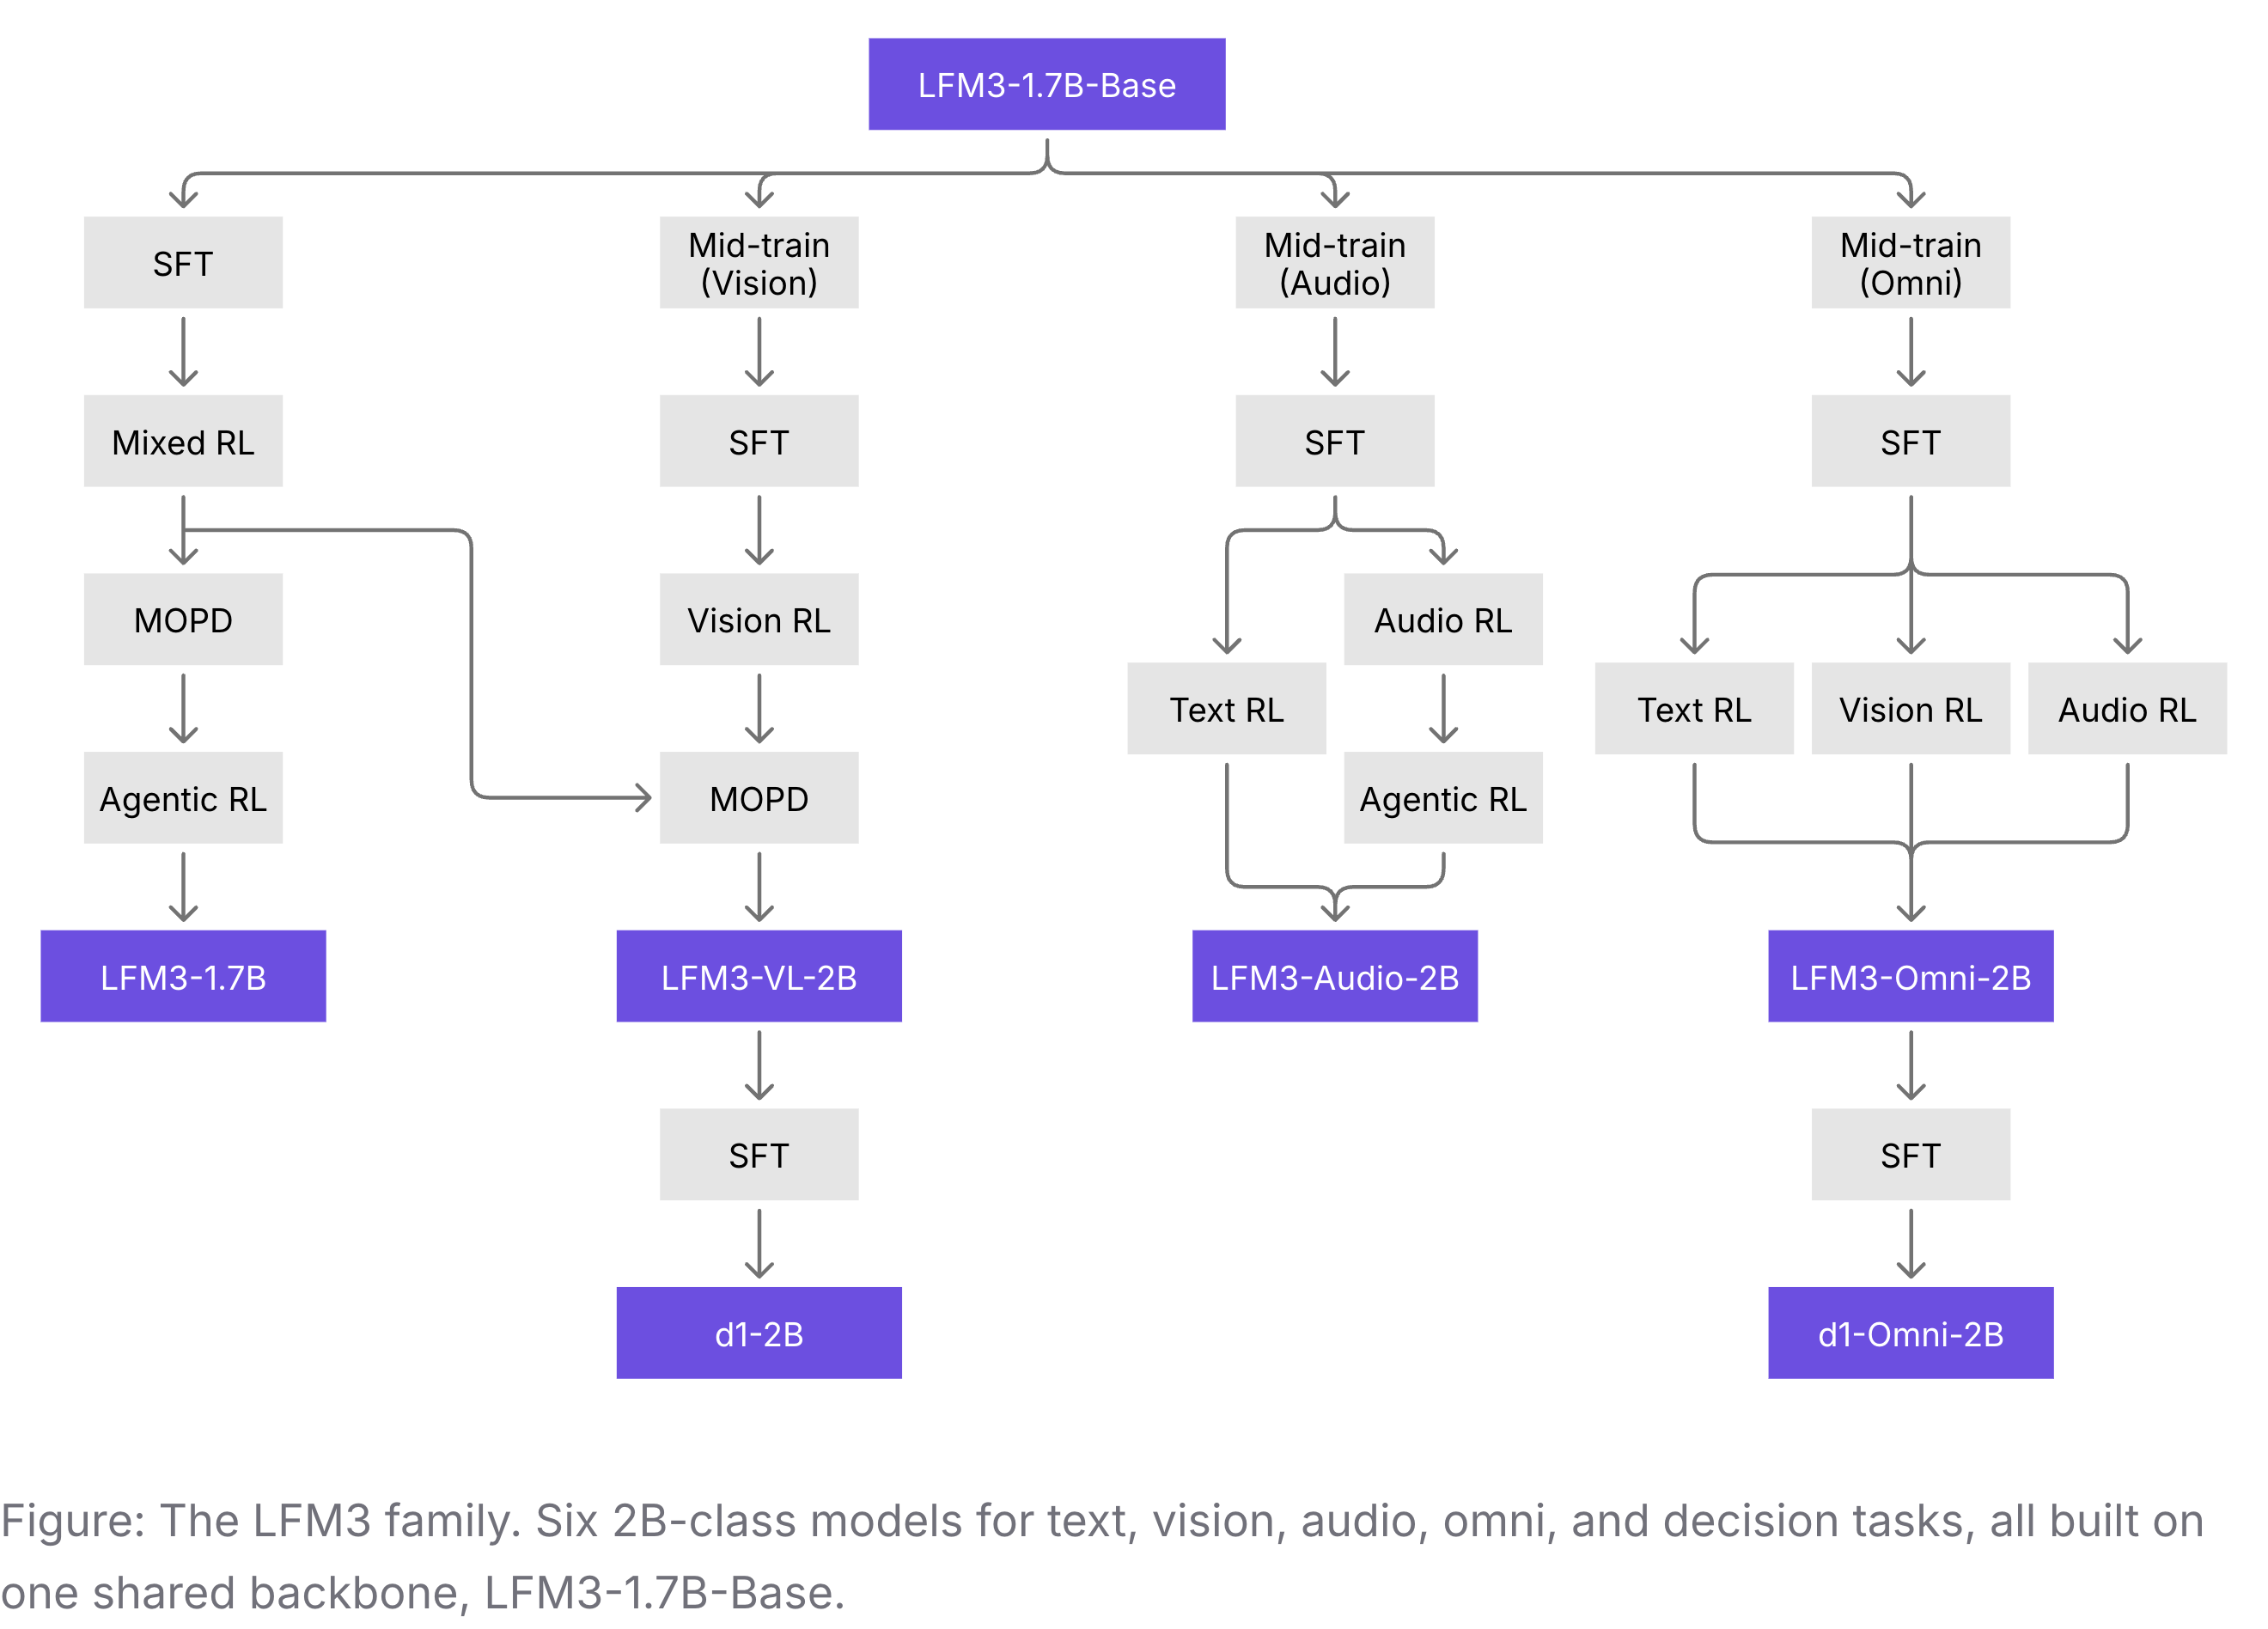
図: LFM3 ファミリー。テキスト、vision、audio、omni、decision の各タスク向け 2B クラスのモデル 6 種は、すべて共通のバックボーン LFM3-1.7B-Base 上に構築されている。
各モデルの性能と推論結果の詳細は、それぞれのモデルカードを参照してほしい。
AI の重心がクラウドからクライアントへ移るにつれ、開発者には多様な AI PC 上で効率よく動かせるモデルが求められるようになった。Liquid AI の LFM3 ファミリーは、強力なマルチモーダル能力とオンデバイス AI に適したコンパクトなサイズを両立している。AMD は複数世代のモデルにわたり Liquid AI と緊密に協力してきた。LFM3 によって、AMD Ryzen™ AI プロセッサを搭載したシステム上でローカルに動く特化型 AI アプリケーションの可能性が広がることを楽しみにしている。
業界全体で、エッジ AI は検出・認識専用モデルの実行から、vision-language モデル、自然言語インターフェース、マルチモーダル推論など複数の AI ワークロードを同時に処理する段階へと進みつつある。課題は、エッジデバイスの演算能力、メモリ、消費電力の制約の中でこうした機能を実現することだ。LFM3 はテキスト、vision、audio を一つのアーキテクチャに統合し、効率的なデプロイを前提に設計されている。重みはオープンで、用途に合わせてファインチューニングできる。開発者は Cooper Model Garden を通じて Ambarella のシリコン上で Liquid AI の LFM2.5-VL モデルをすでに実行でき、同じプラットフォームで LFM3 の提供も開始している。
次世代の AI は、デバイスとクラウドに分散しながら、よりマルチモーダルで、パーソナライズされ、プライバシーにも配慮したものになる。Liquid AI の LFM3 ファミリーはその方向への大きな一歩であり、Snapdragon®プロセッサ搭載デバイスに高速で効率的、かつ革新的な AI 体験を届けるため共に取り組めることを嬉しく思う。
テキスト
LFM3-1.7B は、256K トークンのコンテキストウィンドウを持つ、ローカルエージェントや特定用途向けのテキストモデルだ。
Hermes Agent、Pi、OpenClaw といったエージェントハーネス上で動くようポストトレーニングされている。受信トレイの仕分け、カレンダー管理、ウェブでの調査、WhatsApp での朝のブリーフィング送信、そして何千もの候補から適切なツールを探し出すツール検索までこなす。トークンは無料なので、何十ものエージェントをバックグラウンドで常時動かしておける。単一 GPU での短時間のファインチューニングで、自分のドメインやハーネス、ツールに適応させられる。
| ベンチマーク | LFM3-1.7B (1.7B) | LFM2.5-2.6B (2.6B) | MiniCPM5 2B (2.5B) | Gemma 4 E4B (8B) | Qwen3.5 4B (4.7B) | Qwen3.5 9B (9.7B) |
|---|---|---|---|---|---|---|
| エージェント | ||||||
| LiveClaw | 45.60 | 14.70 | 30.37 | 20.36 | 19.94 | 35.77 |
| Claw-Eval General (EN), average | 68.64 | 62.63 | 60.74 | 56.14 | 61.96 | 66.53 |
| Claw-Eval General (EN), pass^3 | 51.40 | 37.52 | 34.58 | 22.43 | 42.99 | 51.87 |
| BrowseComp-Plus (OpenClaw subset) | 37.00 | 26.33 | 16.83 | 21.00 | 24.67 | 38.00 |
| WebArena-Verified | 38.42 | 3.02 | 9.11 | 17.06 | 21.92 | 28.94 |
| EnterpriseOps-Gym | 28.20 | 7.94 | 13.41 | 9.86 | 25.96 | 28.97 |
| AutomationBench (public) | 41.29 | 0.94 | 4.71 | 1.92 | 8.67 | 15.10 |
| ツール利用 | ||||||
| BFCL V4 | 71.39 | 55.89 | 62.65 | 48.25 | 55.12 | 62.83 |
| ToolSandbox | 80.36 | 78.04 | 68.16 | 69.27 | 75.40 | 76.41 |
| MCP-Atlas | 32.57 | 16.45 | 26.38 | 6.19 | 41.37 | 42.67 |
| τ³-bench | 68.01 | 56.77 | 69.44 | 33.53 | 65.98 | 67.11 |
| エージェント型コーディング | ||||||
| SWE-bench Verified (OpenCode) | 43.40 | 18.00 | 34.80 | 0.50 | 41.20 | 51.20 |
| SWE-bench Multilingual (OpenCode) | 23.00 | 8.00 | 15.67 | 0.67 | 23.33 | 35.00 |
| Terminal-Bench 2.1 (OpenCode) | 12.92 | 0.00 | 5.62 | 0.00 | 13.48 | 17.98 |
| コーディング | ||||||
| LiveCodeBench v6 | 73.46 | 60.57 | 70.52 | 71.00 | 61.99 | 69.86 |
| LiveCodeBench Pro 25Q2 | 31.74 | 19.16 | 29.34 | 29.94 | 24.25 | 34.43 |
| SciCode | 28.47 | 16.32 | 27.78 | 25.00 | 23.02 | 31.60 |
| 指示追従 | ||||||
| IFEval | 96.66 | 95.39 | 87.83 | 90.02 | 92.52 | 92.08 |
| IFBench | 73.03 | 60.48 | 62.08 | 44.56 | 38.16 | 48.84 |
| IFStruct | 93.72 | 82.18 | 72.65 | 78.45 | 87.05 | 89.20 |
| Multi-IF | 89.10 | 84.80 | 73.19 | 81.03 | 80.32 | 84.44 |
| 知識 | ||||||
| GPQA Diamond | 63.37 | 57.78 | 65.15 | 57.88 | 75.76 | 80.40 |
| Humanity's Last Exam (no tools) | 7.17 | 5.88 | 8.20 | 4.77 | 12.84 | 16.41 |
| Humanity's Last Exam (with tools) | 13.90 | 9.60 | 11.50 | 6.00 | 11.60 | 17.50 |
| AA-Omniscience (public) | 0.50 | -33.17 | -5.00 | -15.33 | -57.17 | -28.00 |
| AA-Omniscience accuracy (public) | 7.07 | 8.75 | 9.13 | 9.83 | 15.67 | 13.17 |
| AA-Omniscience non-hallucination (public) | 92.93 | 53.69 | 84.44 | 72.09 | 13.64 | 52.59 |
| 長文コンテキスト | ||||||
| AA-LCR | 52.83 | 6.00 | 49.34 | 39.33 | 52.67 | 62.00 |
| RULER 128K | 65.56 | 1.15 | 37.96 | 18.82 | 84.63 | 87.11 |
| 平均 | 49.37 | 31.55 | 39.19 | 31.74 | 39.27 | 47.24 |
エージェントタスクでは、LFM3-1.7B は数倍のサイズのモデルと互角に渡り合う。BFCL と ToolSandbox の指示追従と function calling では首位に立ち、ブラウザや業務アプリでの長いタスク(WebArena-Verified、AutomationBench)では Qwen3.5-9B を上回る。エージェントコーディングと知識では、サイズが最もものを言うため、より大きなモデルが依然として勝つ。ただし検索を使えば知識の差は縮まり、Humanity's Last Exam のスコアはほぼ 2 倍になる。
この結果を出すために、モデルは 4 段階のポストトレーニングを経ている。
- 教師ありファインチューニング(SFT): チャット、推論、ツール呼び出し、エージェントのトレースなど、さまざまなタスクで 1.75T トークン。
- 混合強化学習: 数学やコードから SQL、構造化出力まで、多数のドメインを同時に学習する。報酬に長さペナルティを入れ、回答を簡潔に保つ。
- マルチドメイン・オンポリシー蒸留(MOPD): 6 つの専門家 RL 教師(コード、数学、ツール使用、長文脈、エージェント作業、エンタープライズワークフロー)を 1 つのモデルに蒸留し直す。
- エージェント RL: Web ブラウジングからオフィス作業まで、実際のエージェントハーネスの中でタスクを実行し、デプロイに備える。
オンデバイスでは、llama.cpp、Q4_0、32K トークンのコンテキストで指標を測定した。LFM3-1.7B は 3 台すべてのデバイスで最速のモデルであり、次に速いモデルより 1.8〜2.8 倍速くデコードし、メモリ使用量も最も少ない。長いコンテキストも低コストで済む。128K トークンのコンテキスト全体で必要な KV キャッシュは 1.6 GB、Qwen3.5-4B は 4.3 GB、MiniCPM5-2B は 5.6 GB だ。
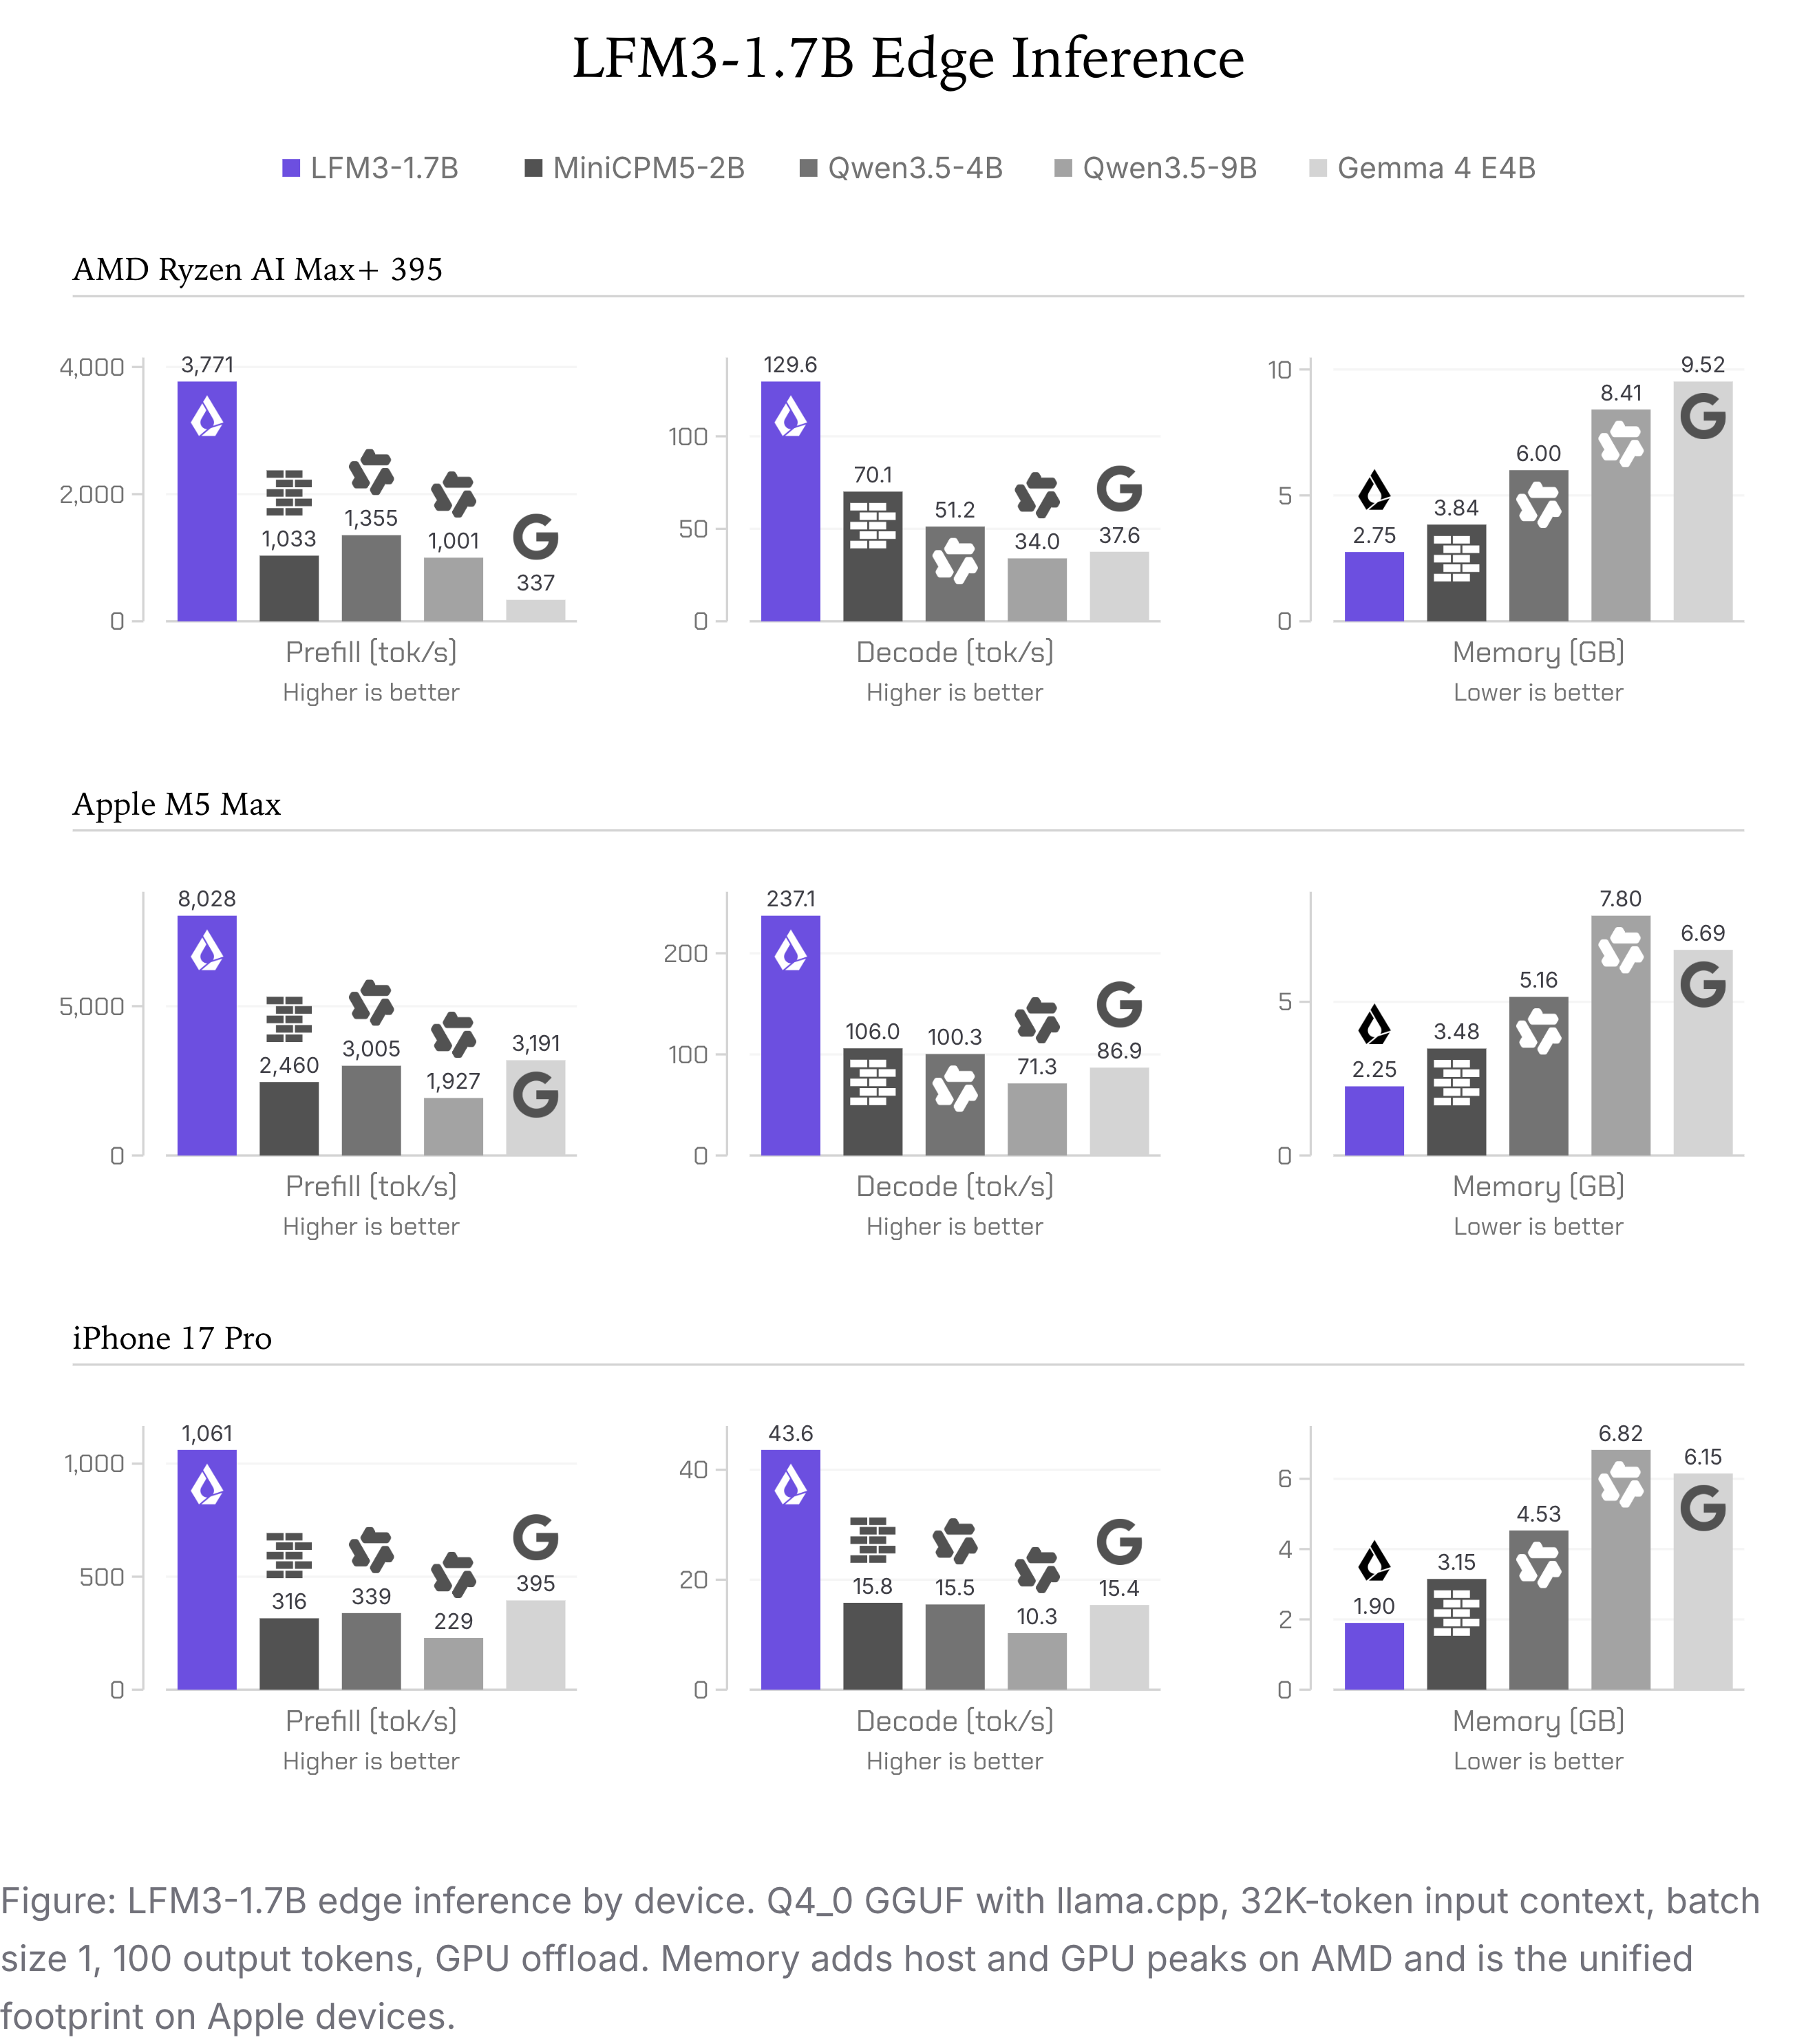
図: デバイス別の LFM3-1.7B エッジ推論。Q4_0 GGUF と llama.cpp、32K トークンの入力コンテキスト、バッチサイズ 1、出力 100 トークン、GPU オフロード。メモリは、AMD ではホストと GPU のピークを合算し、Apple デバイスではユニファイドメモリの使用量。
SGLang を使った BF16 の NVIDIA B300 1 台では、LFM3-1.7B は 1,024 の同時リクエストで 1 日あたり 36 億トークンを生成できる。この比較のどのモデルよりも多い。
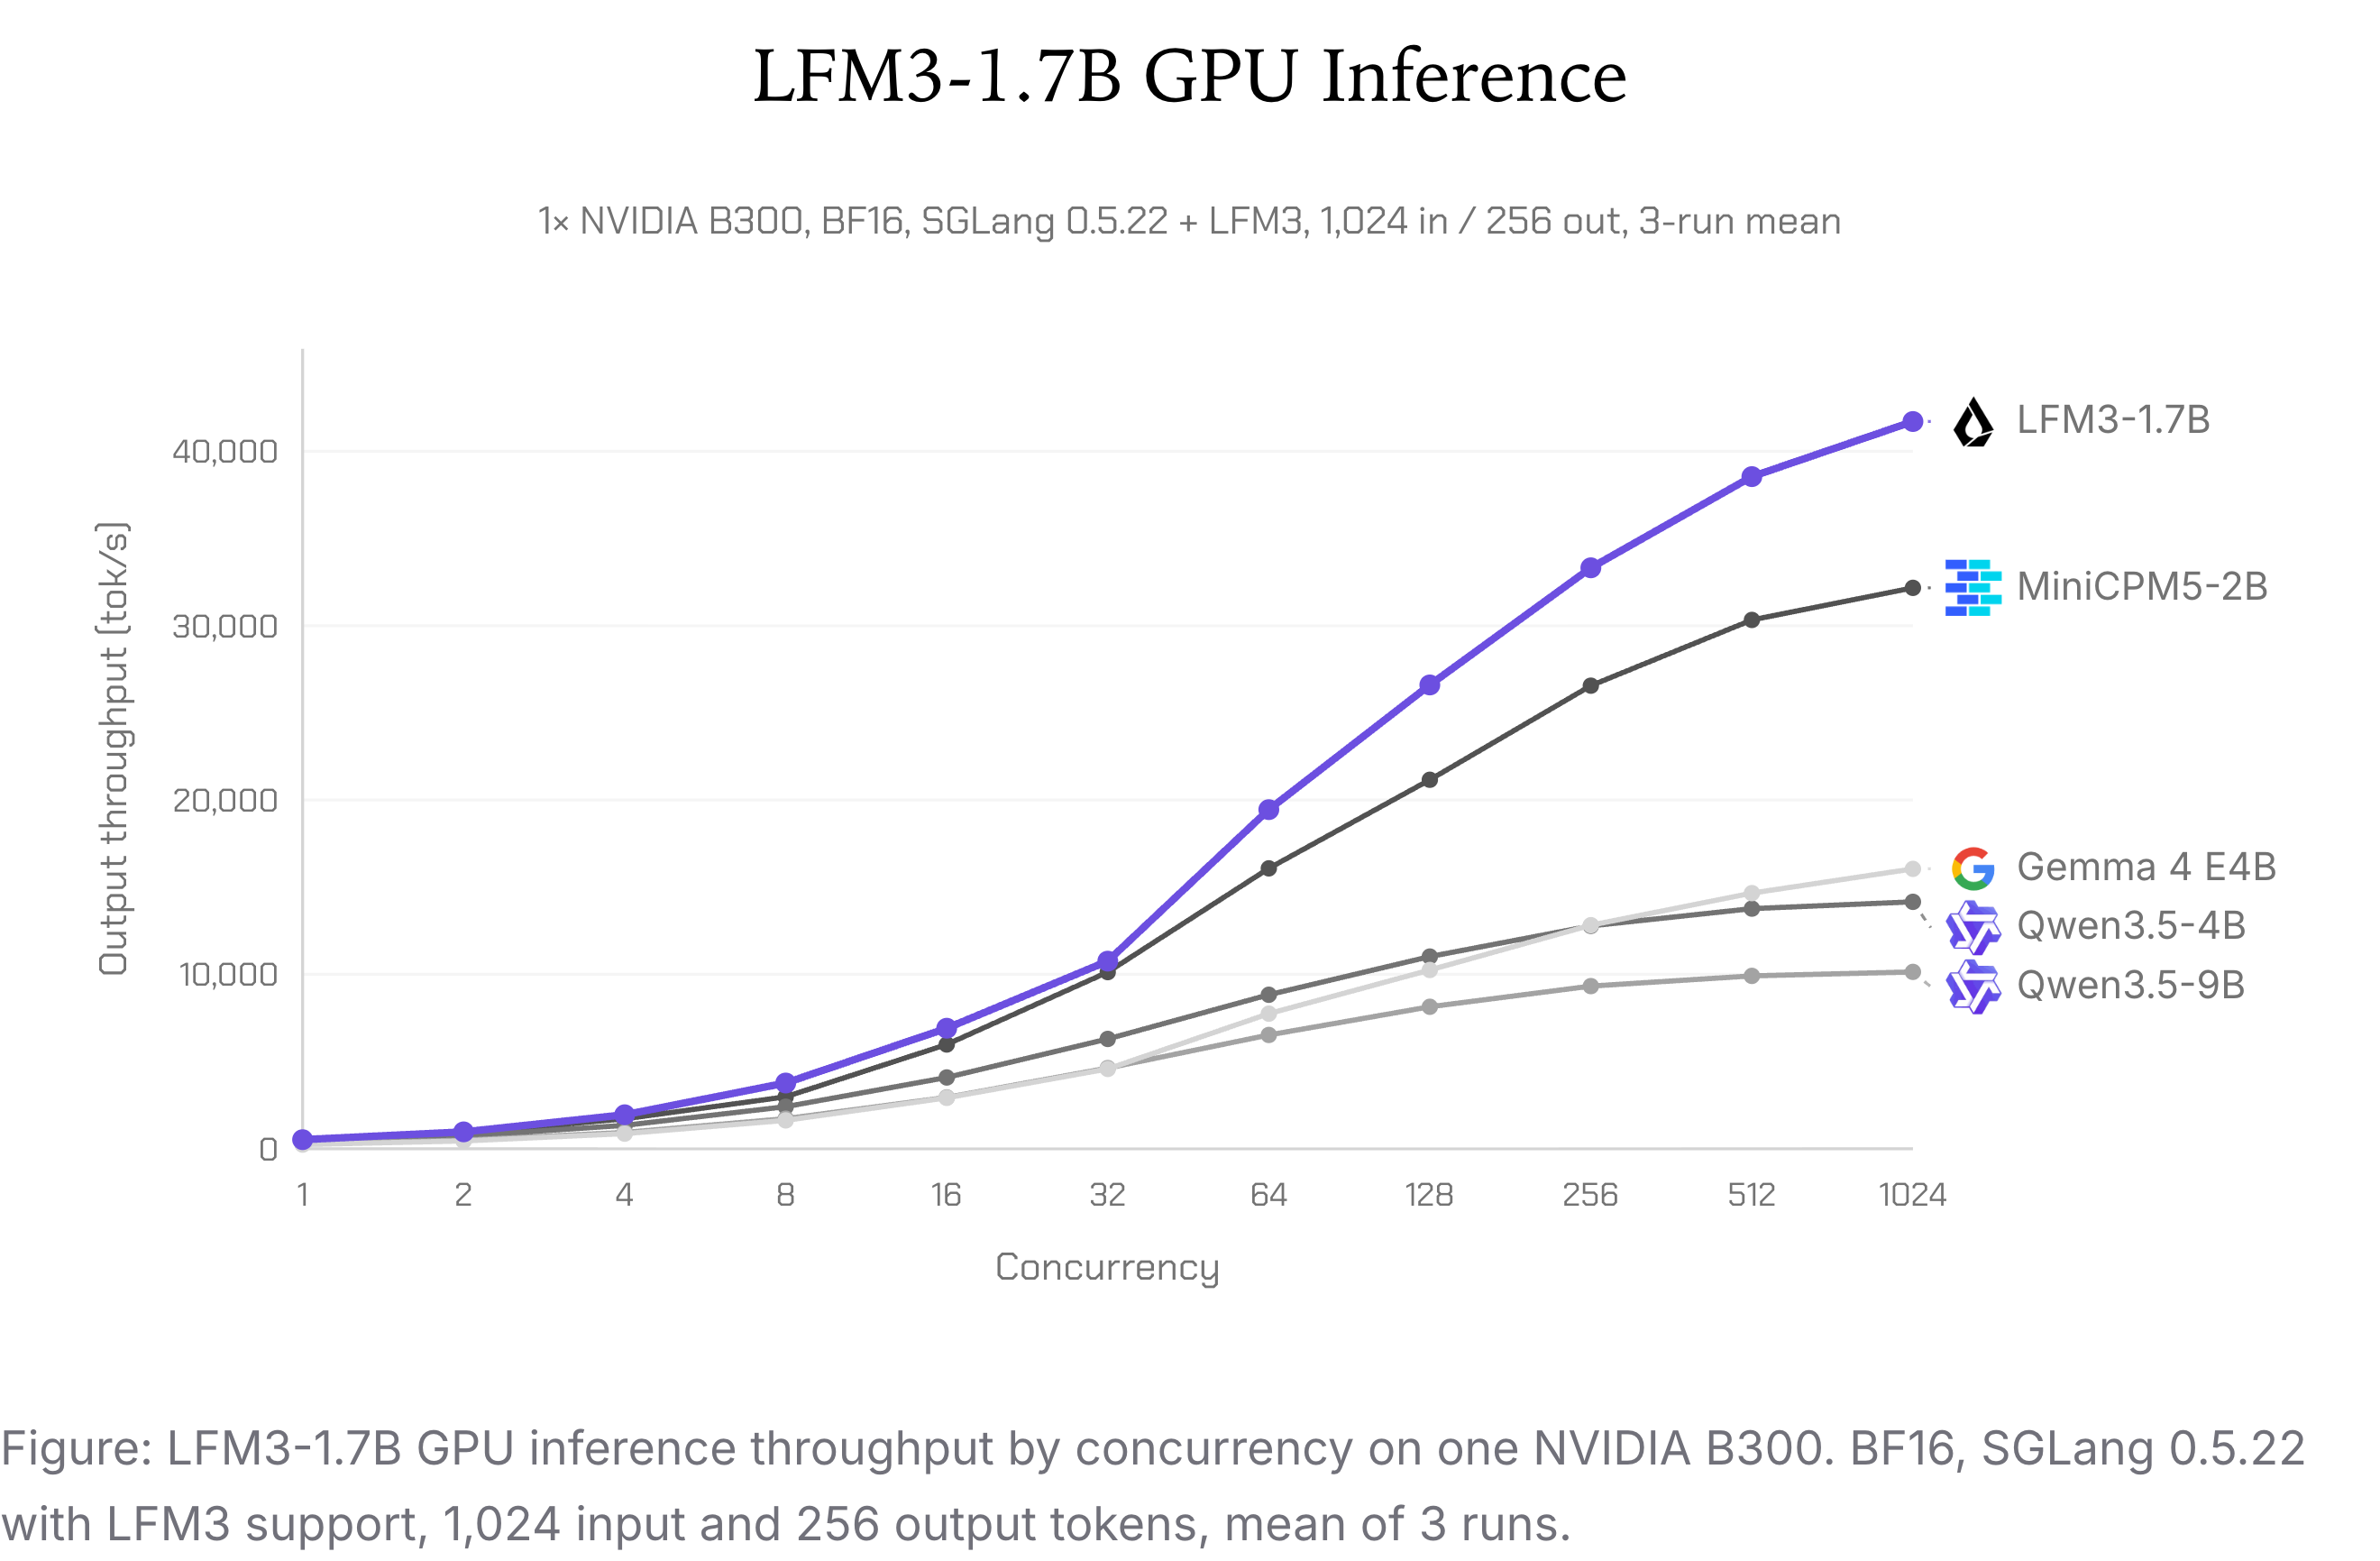
図: NVIDIA B300 1 基における同時実行数別の LFM3-1.7B GPU 推論スループット。BF16、LFM3 対応の SGLang 0.5.22、入力 1,024 トークン・出力 256 トークン、3 回実行の平均。
このスループットで何が可能になるかを示すため、30 万を超える LFM3-1.7B エージェントを並列に走らせ、Enron のメールアーカイブを調査した。
LFM3-1.7B はランダムなトラフィック下でも低レイテンシで配信でき、Liquid RIPL上で動かせばオンライン不正検知のようなリアルタイムのユースケースにも対応できる。高負荷時でも P95 リクエストレイテンシは安定しており、vLLM上で配信した競合モデルを上回る。
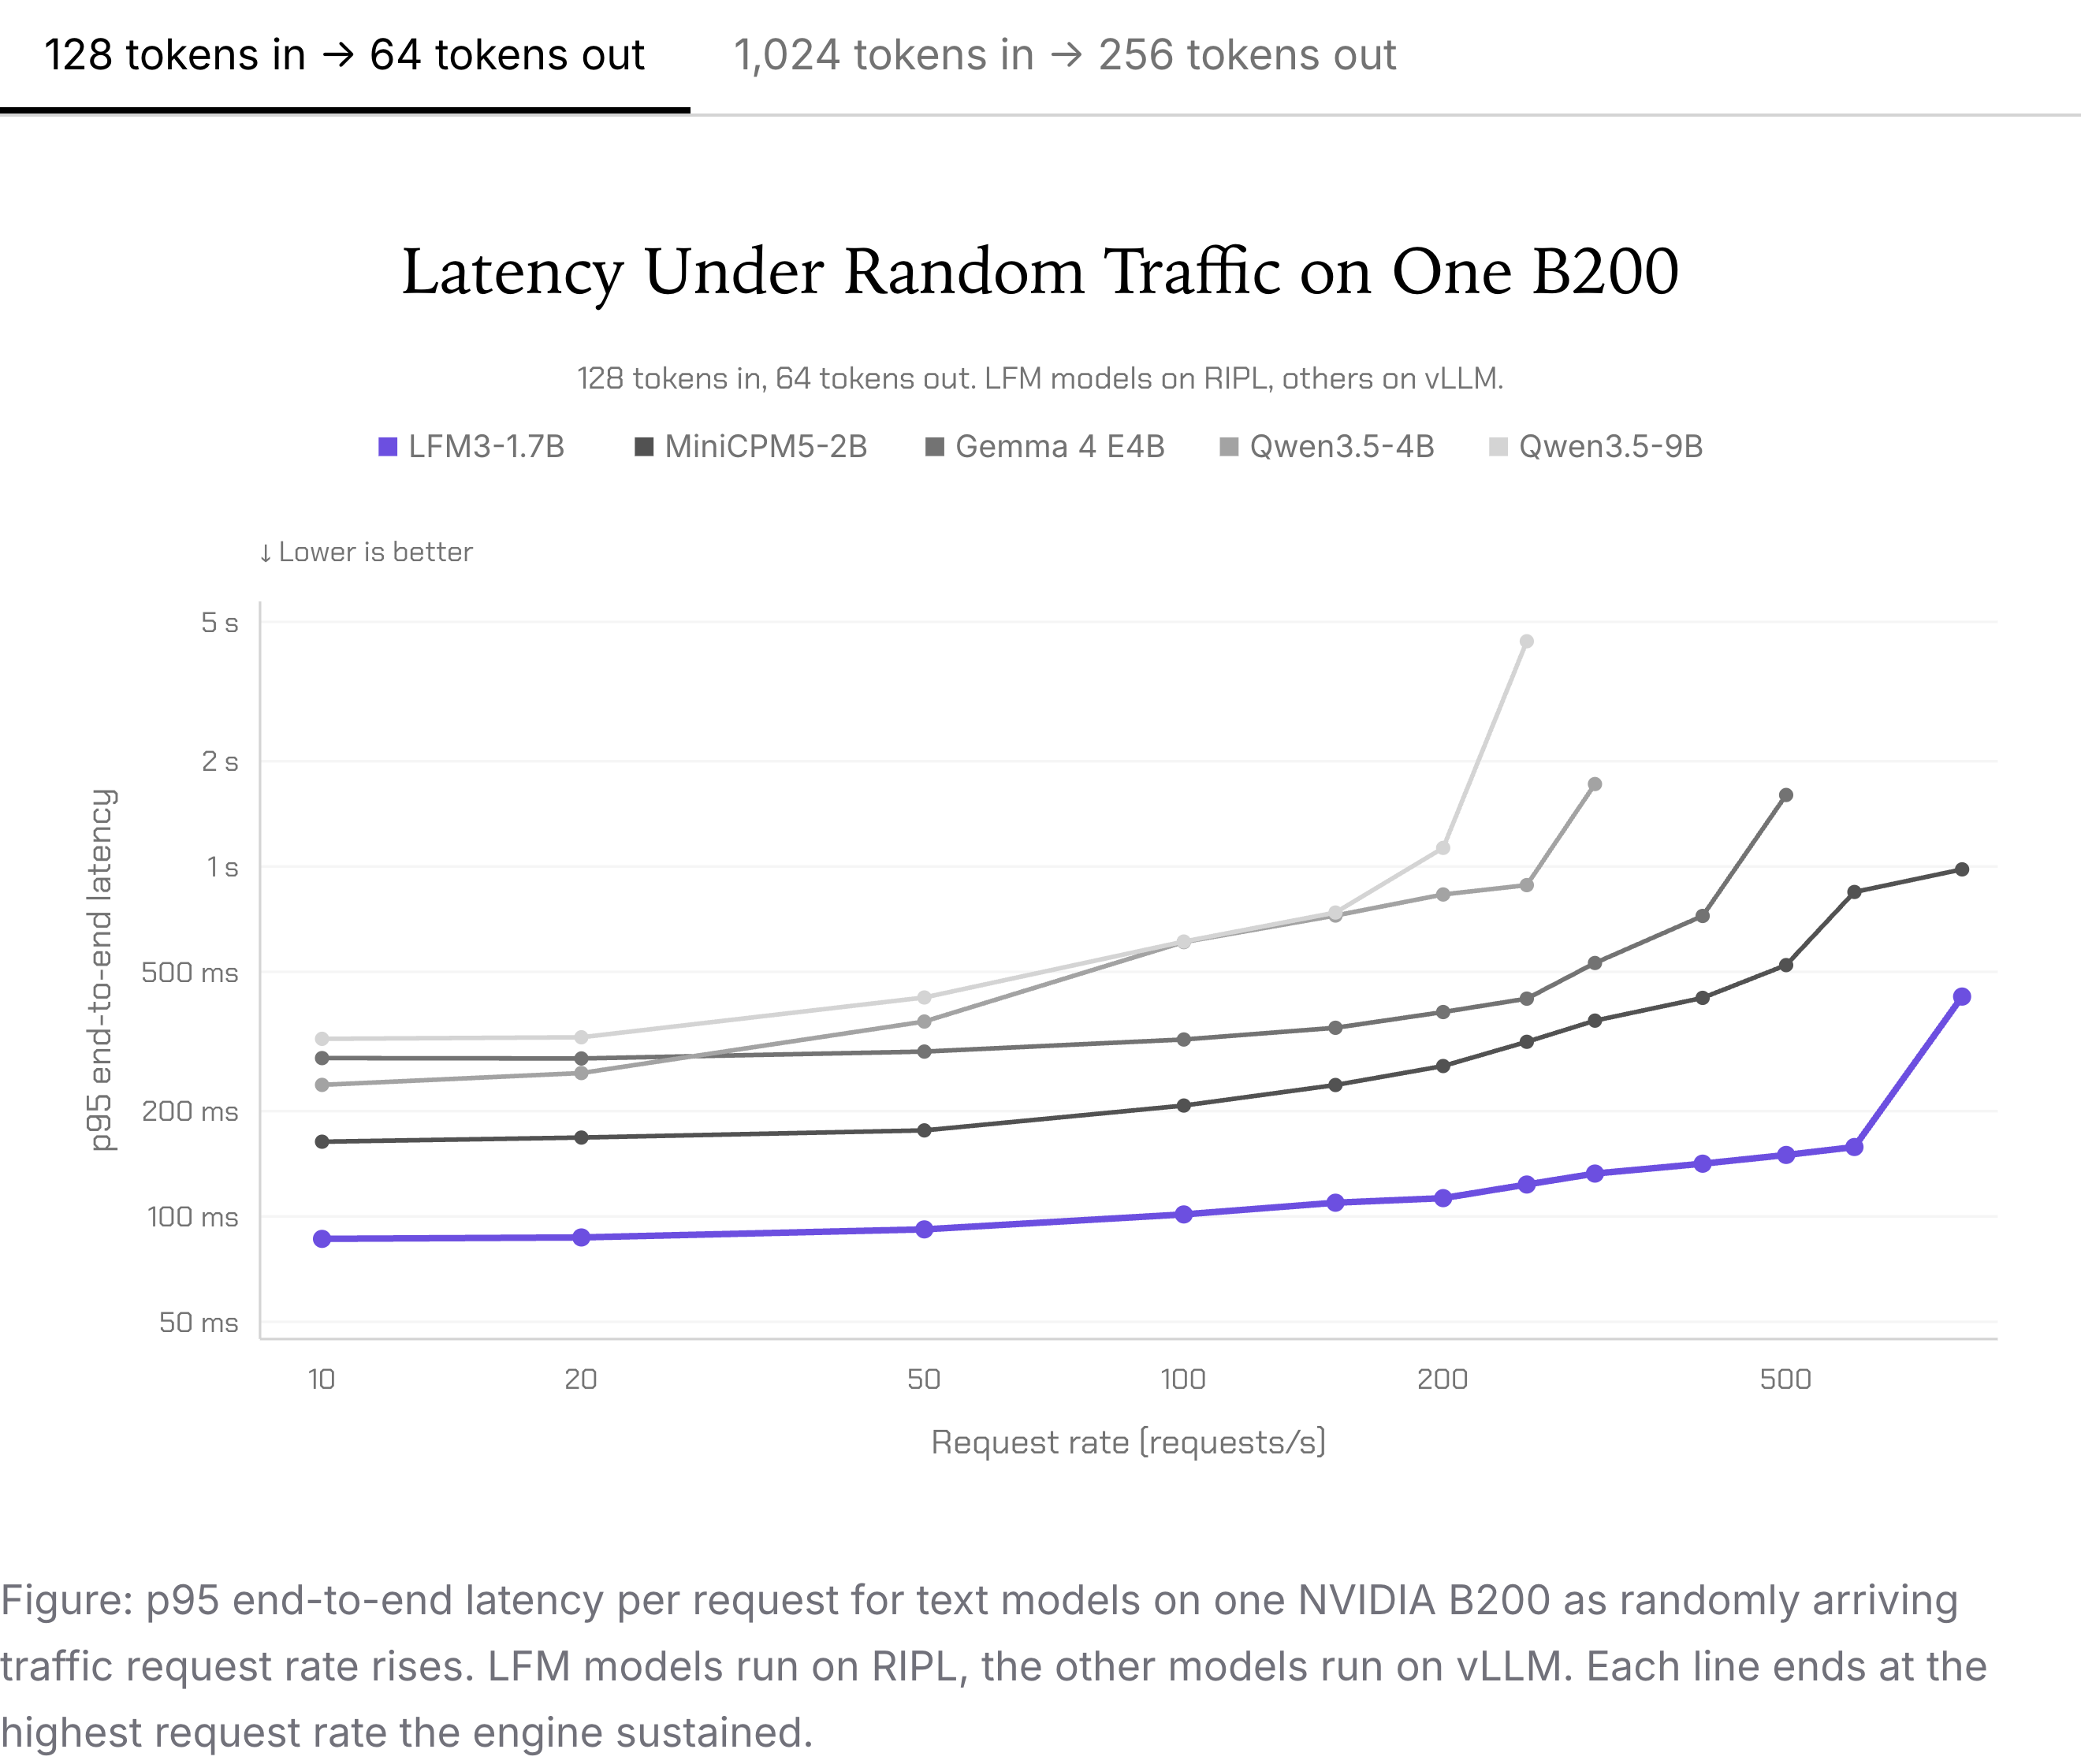
図: NVIDIA B200 1 台でテキストモデルを動かし、ランダムに到着するトラフィックのリクエストレートを上げていったときの、リクエストあたりの p95 エンドツーエンドレイテンシ。LFM モデルは RIPL 上、その他のモデルは vLLM 上で実行。各線はエンジンが維持できた最大のリクエストレートで終わっている。
実際の macOS 環境で、65 の日常的なエージェントタスクについて LFM3-1.7B と Qwen3.5-2B を比較した。勝ったのは小さいほうのモデルだ。タスク成功率は 64% 対 48%、タスクあたりのトークン数は 58% 少なく、試行が行き詰まった割合は 1% 未満に対し 15% だった。小型モデルは Mac 上の実用的なエージェント作業に使える水準に達しており、LFM3 がその証拠だ。LFM3 は、Mac 上の実用的なエージェント作業に使えると当社が確認した初の 2B 未満モデルである。より大きなモデルをタスク成功率で上回り、しかもトークン消費は 58% 少なく、ほぼ行き詰まらない。
ビジョン
LFM3-VL-2Bは、物理世界を観察し、推論し、理解できる:
- 動画理解: LFM のビジョンモデルが初めて動画を入力として受け取る。録画した講義、スマートフォンで撮影した散策の映像、カメラフィードのクリップについて質問できる。
- 思考: モデルは答える前に段階的に推論する。これによりユーザーの入力をよりよく理解し、数学やグラフ、多段階の問題といった難しい視覚的課題を解けるようになる。
- 空間・身体性推論: 物体を特定し、その空間的関係を推論する能力は、下流のロボティクス応用の強固な基盤になる。
LFM3-VL-2B は LFM2.5-VL シリーズから性能が大きく向上した。62 のビジョンベンチマークで、LFM3-VL-2B は同程度のサイズのすべてのモデルを少なくとも 7.4 ポイント上回る。そのサイズにもかかわらず、6 倍以上大きい Gemma 4 12B の性能に並び、Gemini 3.5 Flash Lite を上回り、GPT-5.6 Luna とは 2 ポイント差に収まっている。詳細はモデルカードを参照。
| ベンチマークカテゴリ | LFM3-VL-2B (1.9B) | LFM2.5-VL-3B (3.1B) | MiniCPM-V 4.7 1B (1.6B) | Qwen 3.5 2B (2.3B) | Gemma 4 E2B (5.1B) | Gemma 4 12B (12B) | GPT-5.6 Luna | Gemini 3.5 Flash Lite |
|---|---|---|---|---|---|---|---|---|
| 総合 | 66.0 | 57.6 | 59.8 | 64.0 | 56.9 | 74.0 | 72.2 | 74.1 |
| 知覚 | 75.6 | 67.9 | 65.5 | 71.2 | 59.1 | 73.5 | 71.0 | 73.0 |
| 文書・ OCR ・グラフ | 83.9 | 71.2 | 73.0 | 79.1 | 72.3 | 85.7 | 84.4 | 82.3 |
| 数学・論理推論 | 68.8 | 40.6 | 51.8 | 61.0 | 51.8 | 79.3 | 77.3 | 66.7 |
| 視覚グラウンディング | 77.3 | 68.3 | 51.1 | 61.2 | 41.2 | 74.1 | 72.7 | 63.5 |
| 身体性推論 | 64.4 | 48.0 | 45.3 | 51.2 | 41.5 | 59.1 | 61.5 | 50.3 |
| GUI 理解 | 83.1 | 66.0 | 45.3 | 67.2 | 44.3 | 76.1 | 82.5 | 71.0 |
| 動画 | 61.2 | 41.3 | 53.7 | 57.0 | 46.6 | 58.9 | 72.8 | 70.0 |
| 多言語 | 84.4 | 81.2 | 77.4 | 78.6 | 73.4 | 86.1 | 82.1 | 85.8 |
| エージェント | 42.5 | 21.1 | 16.9 | 15.2 | 23.8 | 43.6 | 56.1 | 62.4 |
| 平均 | 71.4 | 57.6 | 57.5 | 64.0 | 53.6 | 71.7 | 73.4 | 70.0 |
注: 各カテゴリのスコアは、そのカテゴリに含まれるベンチマークスコアの単純平均。平均行は 62 の評価すべての単純平均。
これらはすべてオンデバイスで効率よく動作し、データがデバイスの外に出ることもクラウド接続も必要ないため、日常的に知能を活用できる。オンデバイスでは、LFM3-VL-2B は同サイズクラスの他のモデルと比べて、計測したすべてのデバイスで prefill スループットが最も高く、メモリ使用量が最も少ない。
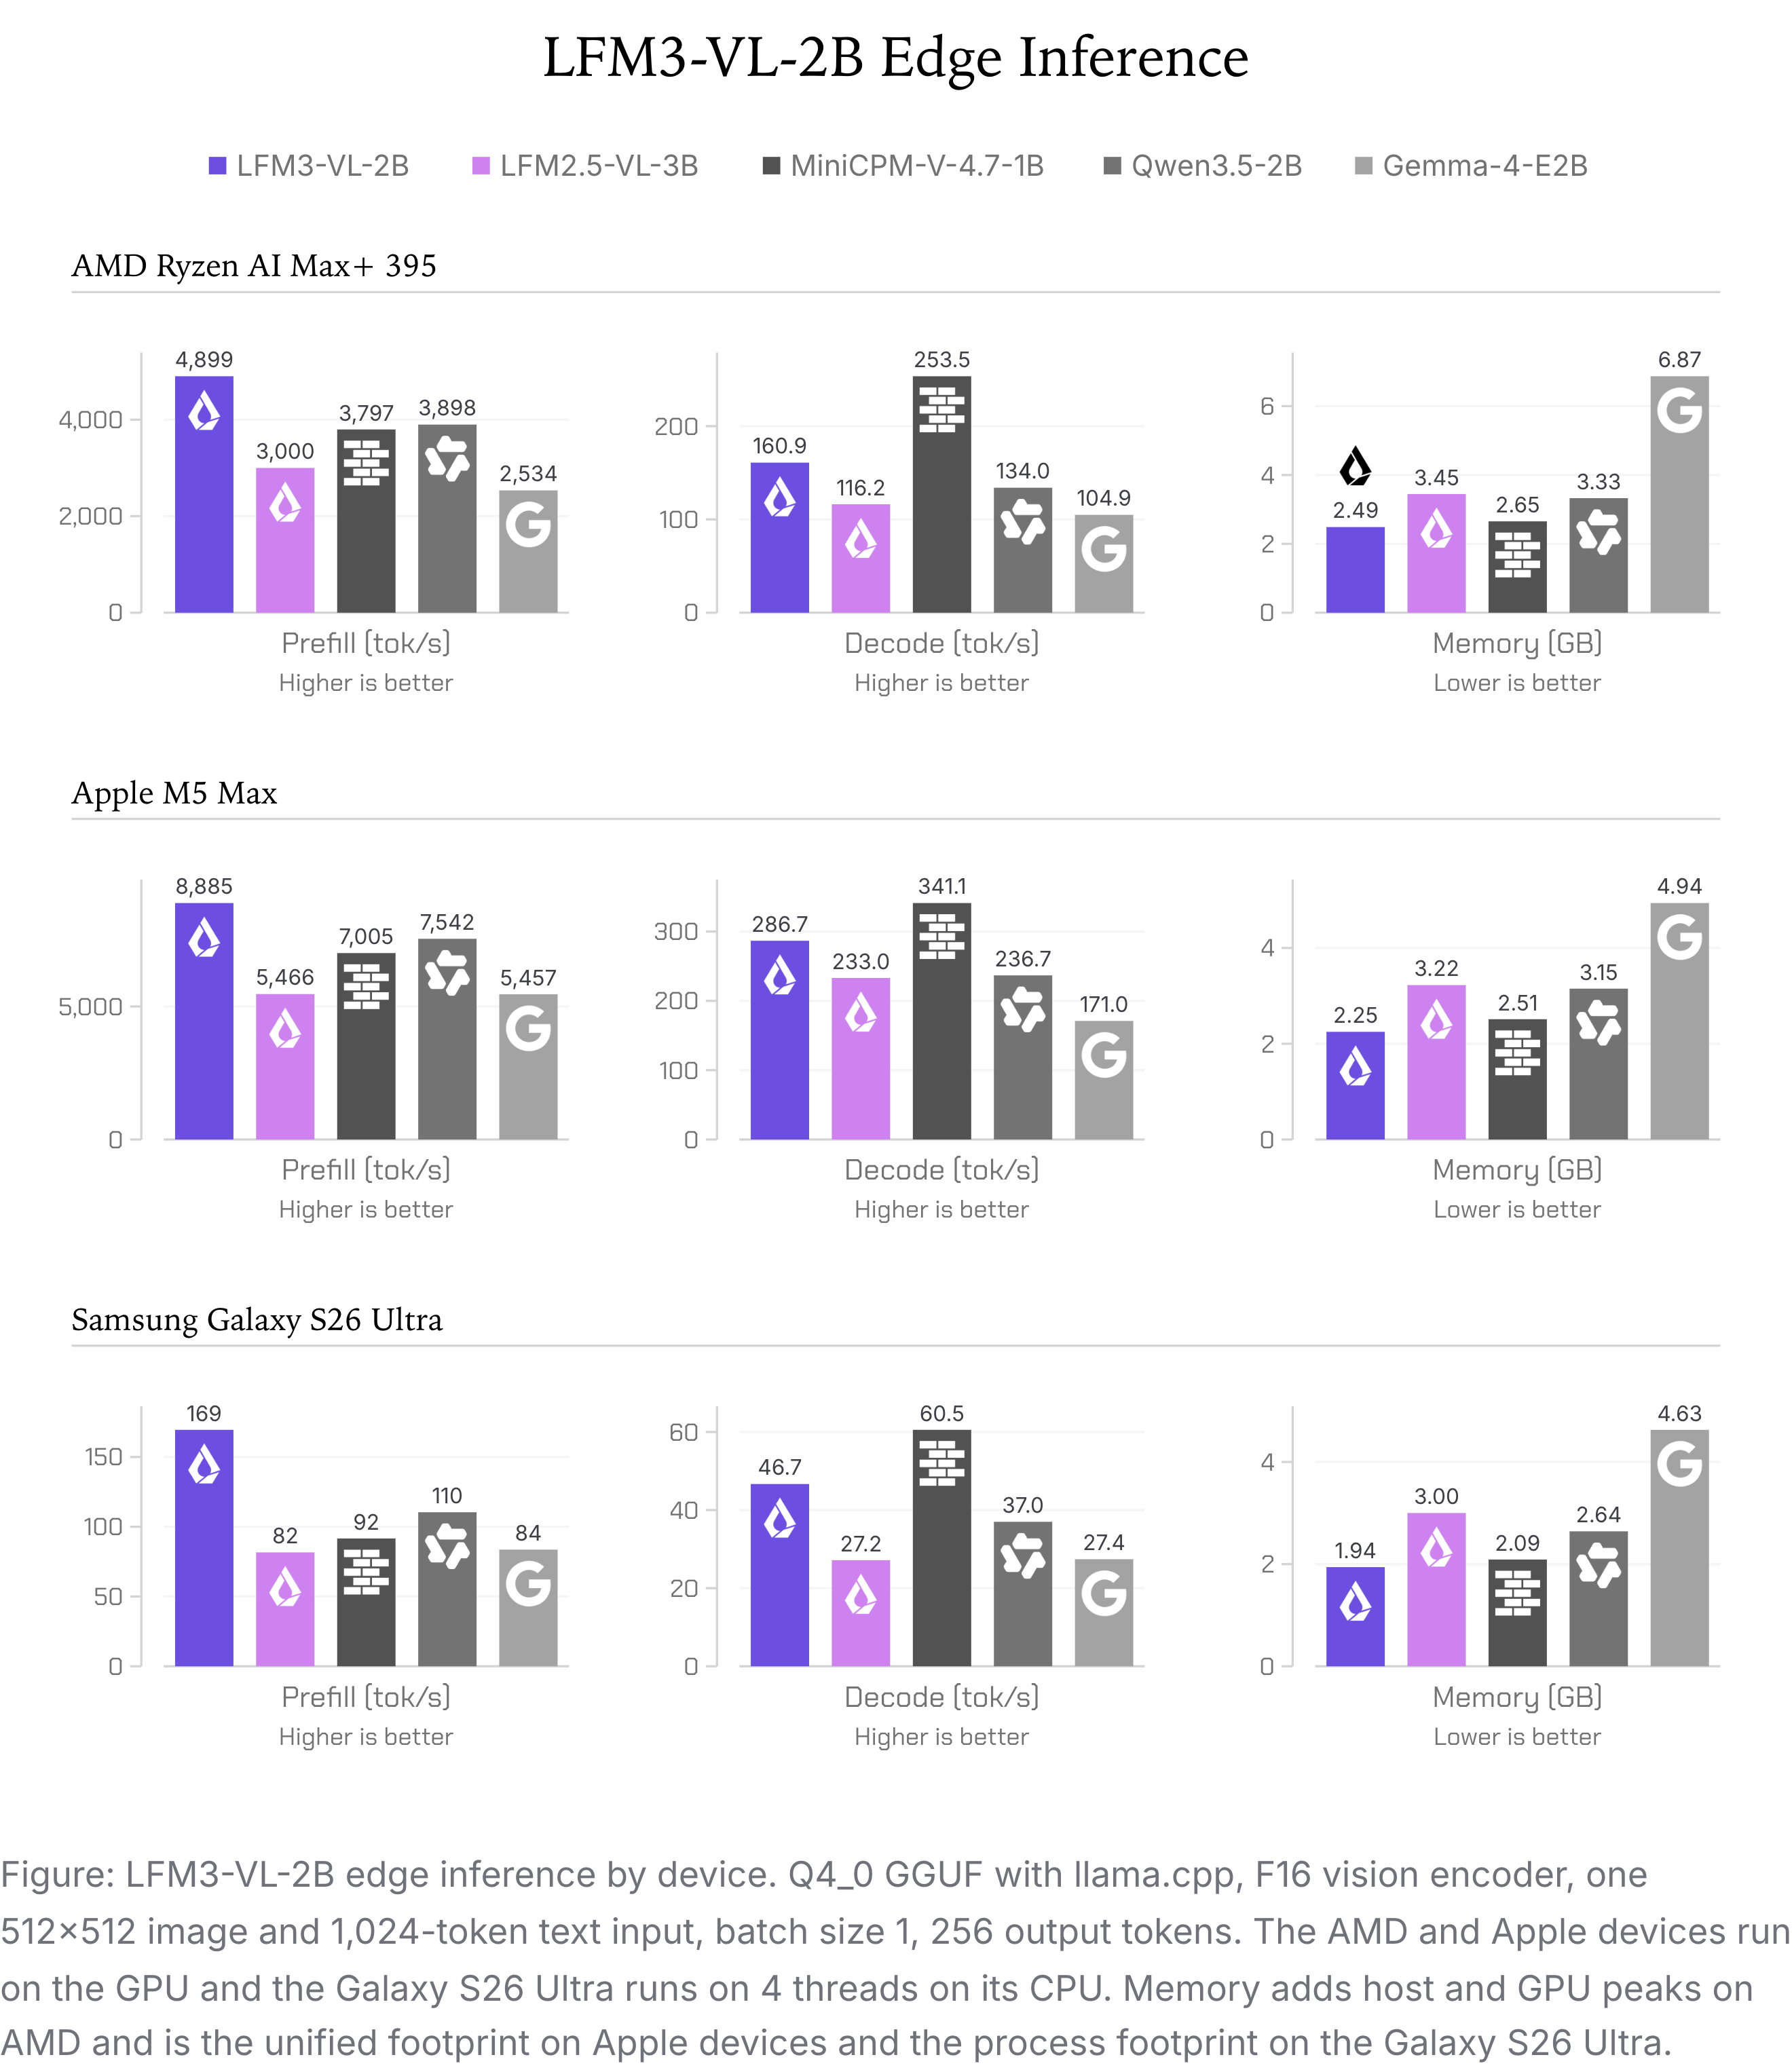
図: デバイス別の LFM3-VL-2B エッジ推論。Q4_0 GGUF と llama.cpp、F16 の vision encoder、512×512 の画像 1 枚と 1,024 トークンのテキスト入力、バッチサイズ 1、出力 256 トークン。AMD と Apple のデバイスは GPU で実行し、Galaxy S26 Ultra は CPU の 4 スレッドで実行。メモリは、AMD ではホストと GPU のピーク値を合計し、Apple デバイスでは統合メモリの使用量、Galaxy S26 Ultra ではプロセスの使用量。
NVIDIA B300 1 基で SGLang を BF16 で動かした場合、LFM3-VL-2B は毎秒 12,000 トークン以上を生成でき、同サイズクラスの他のどのモデルよりも高速です。
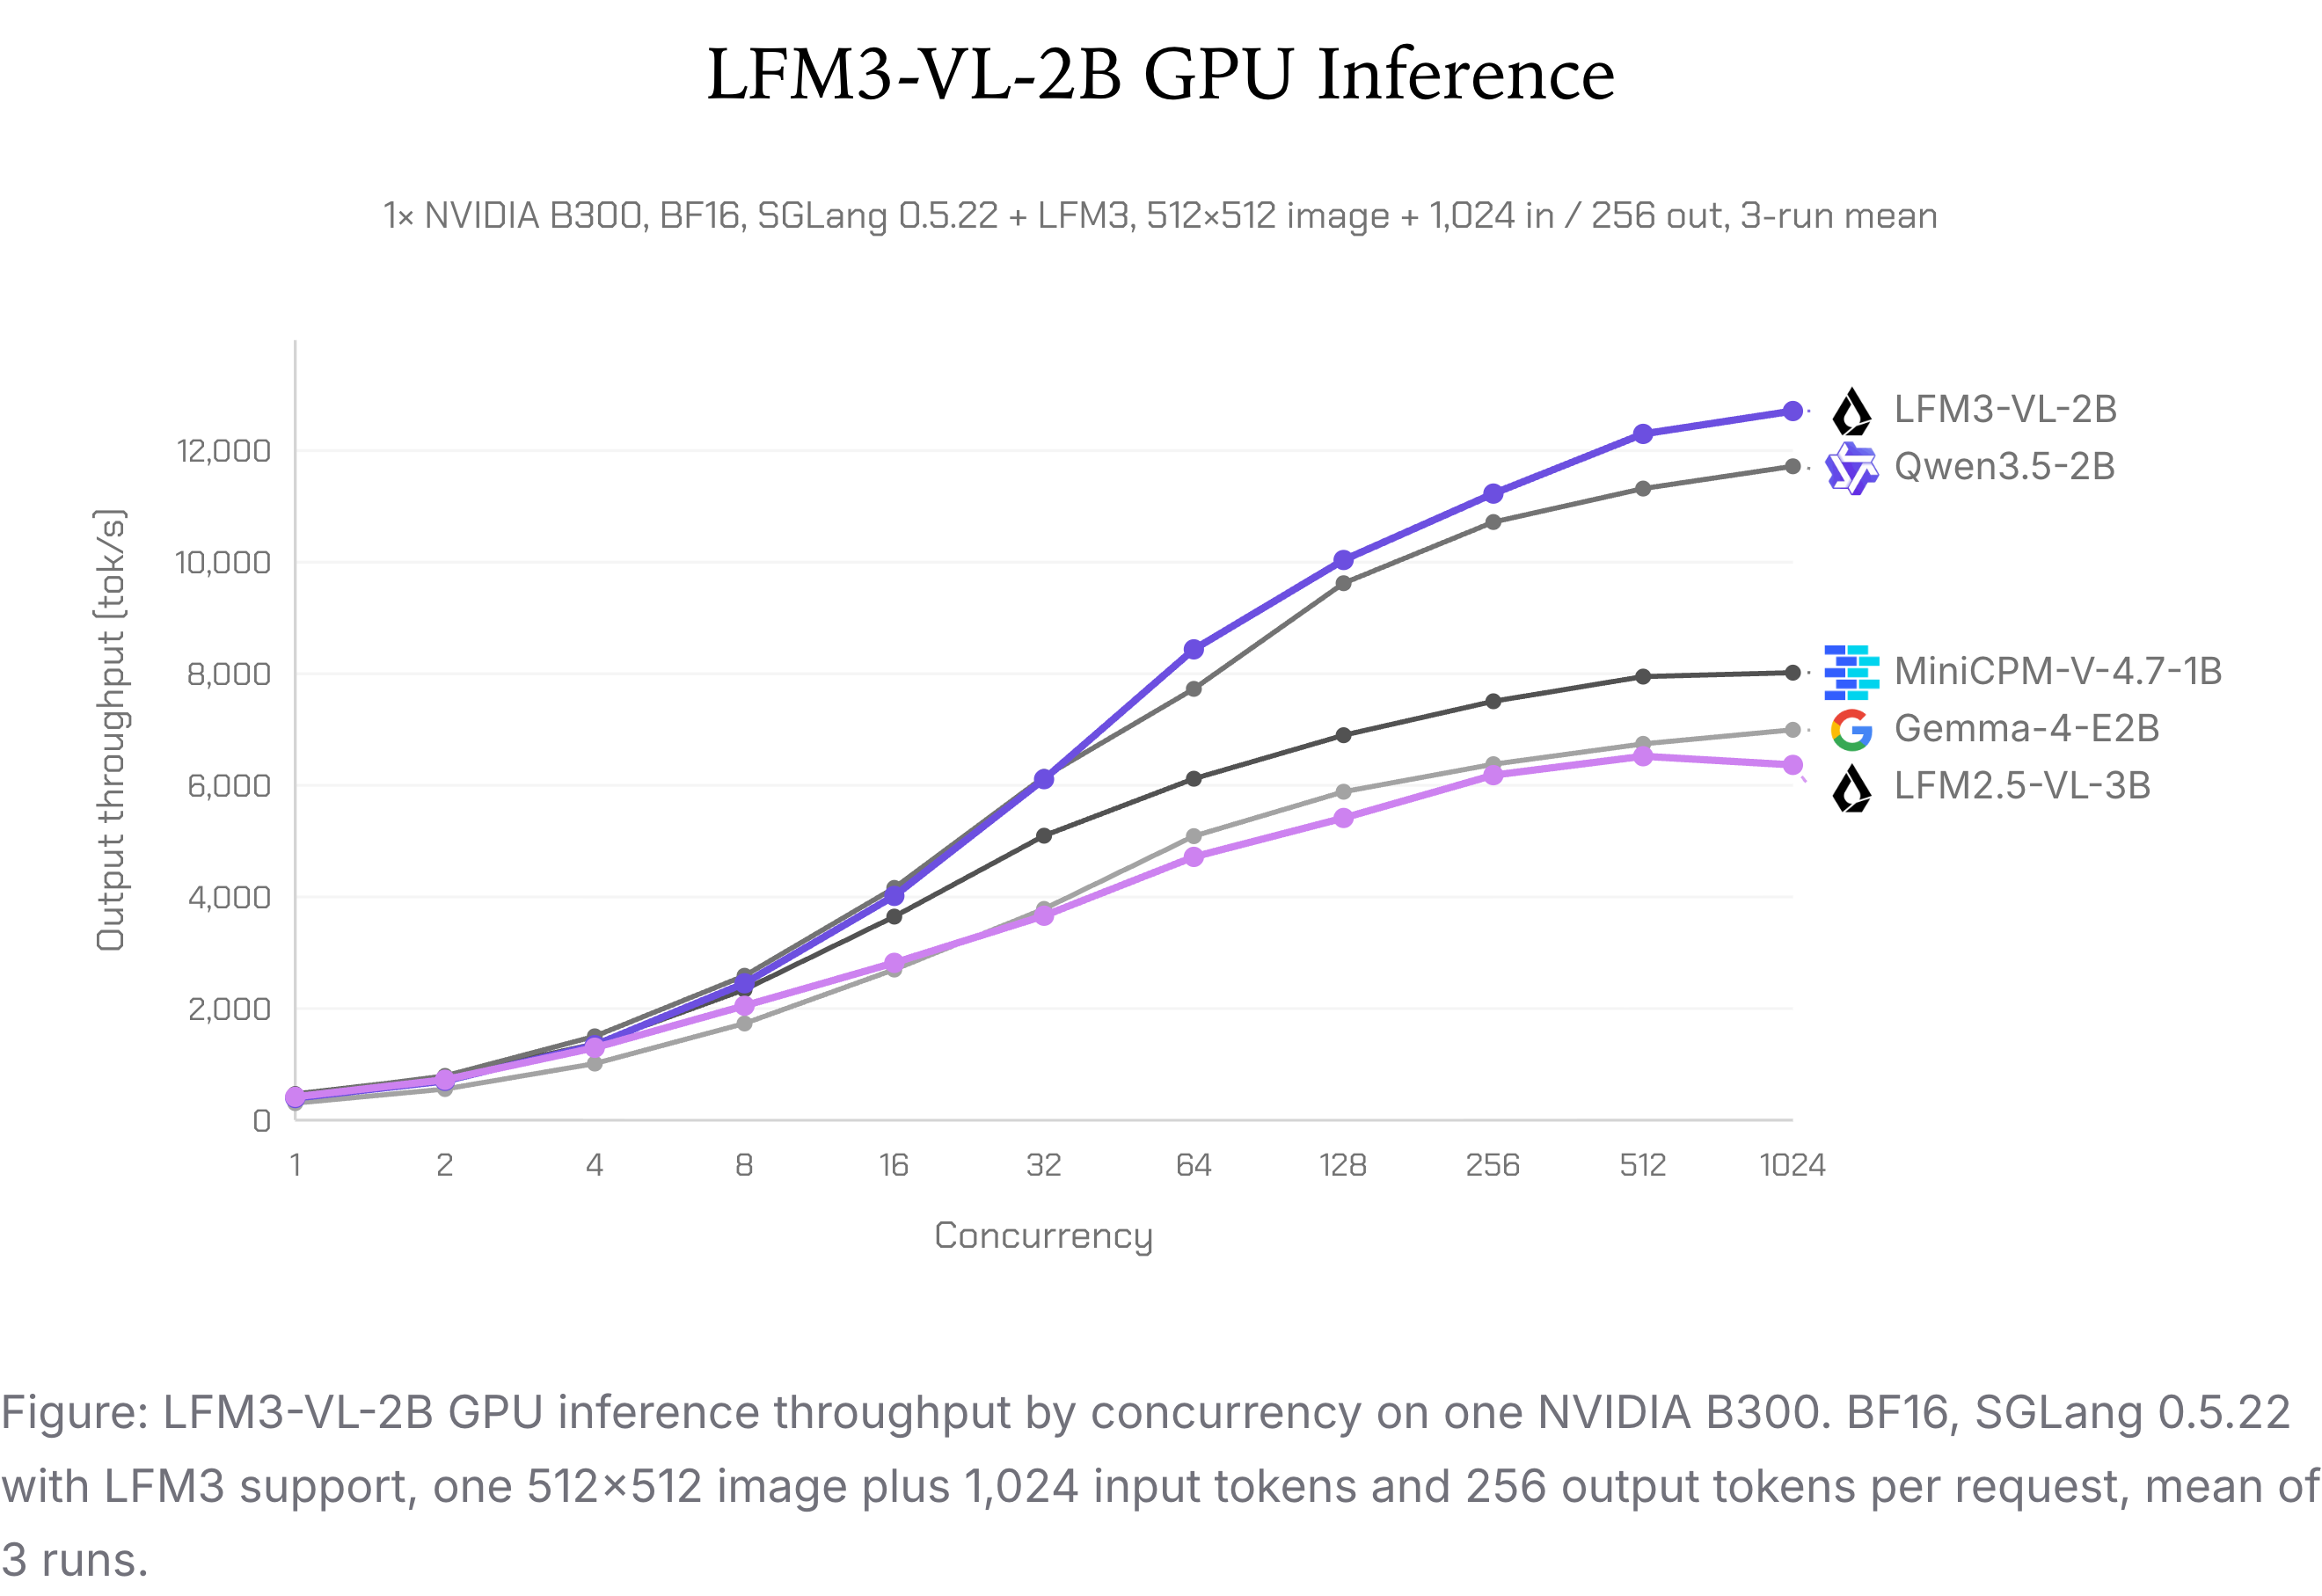
図: NVIDIA B300 1 基における同時実行数ごとの LFM3-VL-2B の GPU 推論スループット。BF16、LFM3 対応の SGLang 0.5.22、1 リクエストあたり 512×512 画像 1 枚と入力 1,024 トークン、出力 256 トークン、3 回の平均。
LFM3-VL-2B はランダムなトラフィック下でも低レイテンシで提供でき、Liquid RIPL 上で動かせば画像アセットのタグ付けのようなリアルタイム用途に使えます。高負荷時でも P95 レイテンシは安定しており、vLLM 上で提供する競合モデルを上回ります。
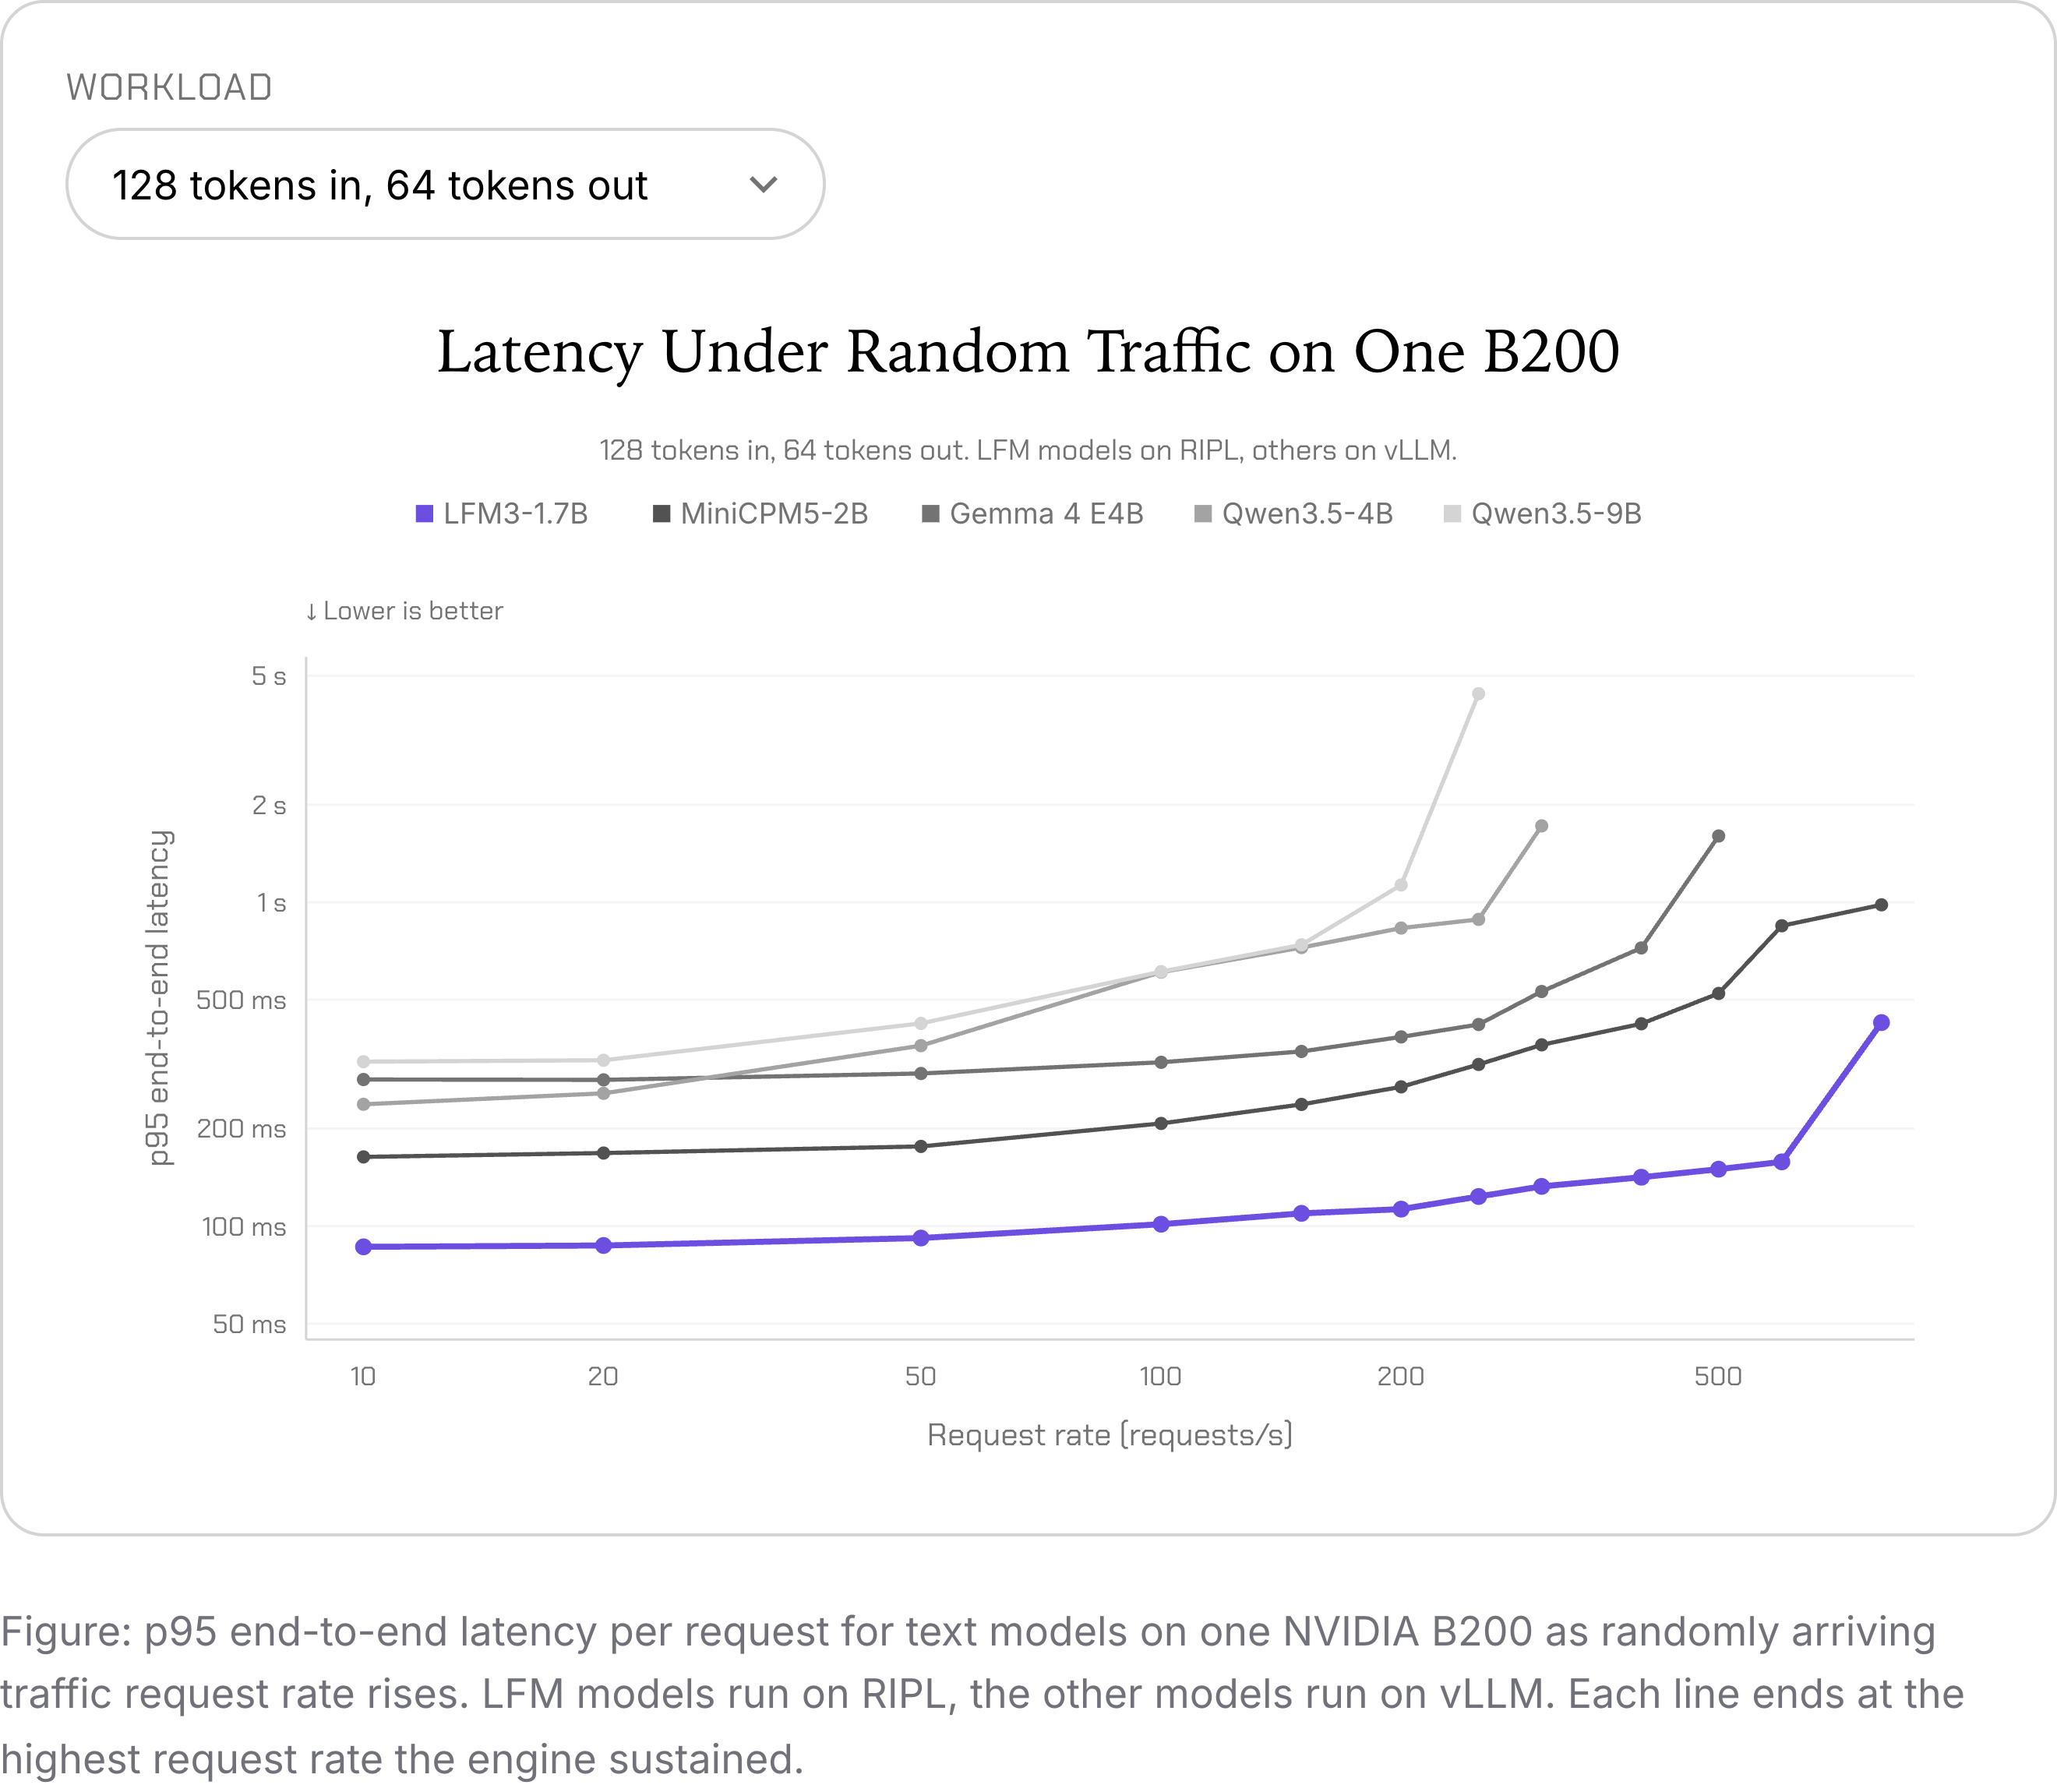
図: ランダムに到着するトラフィックのリクエストレートが上がるにつれての、NVIDIA B200 1 基におけるテキストモデルの 1 リクエストあたり p95 エンドツーエンドレイテンシ。LFM モデルは RIPL 上、それ以外のモデルは vLLM 上で動作。各線はエンジンが維持できた最大リクエストレートで終わっている。
ビジョンエンコーダ
LFM3 バックボーンの改良に加えて、LFM3-VL には新たに自社開発のビジョンエンコーダを搭載した。計算量は、従来の LFM VL モデルで使われていた SigLIP2 エンコーダの 3 分の 1 で済む。
Liquid のビジョンエンコーダは畳み込みとアテンションを組み合わせることで、同じ品質を保ちながら ViT ベースのエンコーダより大幅に効率が高い。下の性能対効率のグラフがそれを示している。164M パラメータのこのエンコーダは、13 のビジョン言語モデルベンチマークで平均精度 55.9% と Qwen3.5-2B のビジョンエンコーダに並び、FLOPs は 2.2 分の 1 で済む。
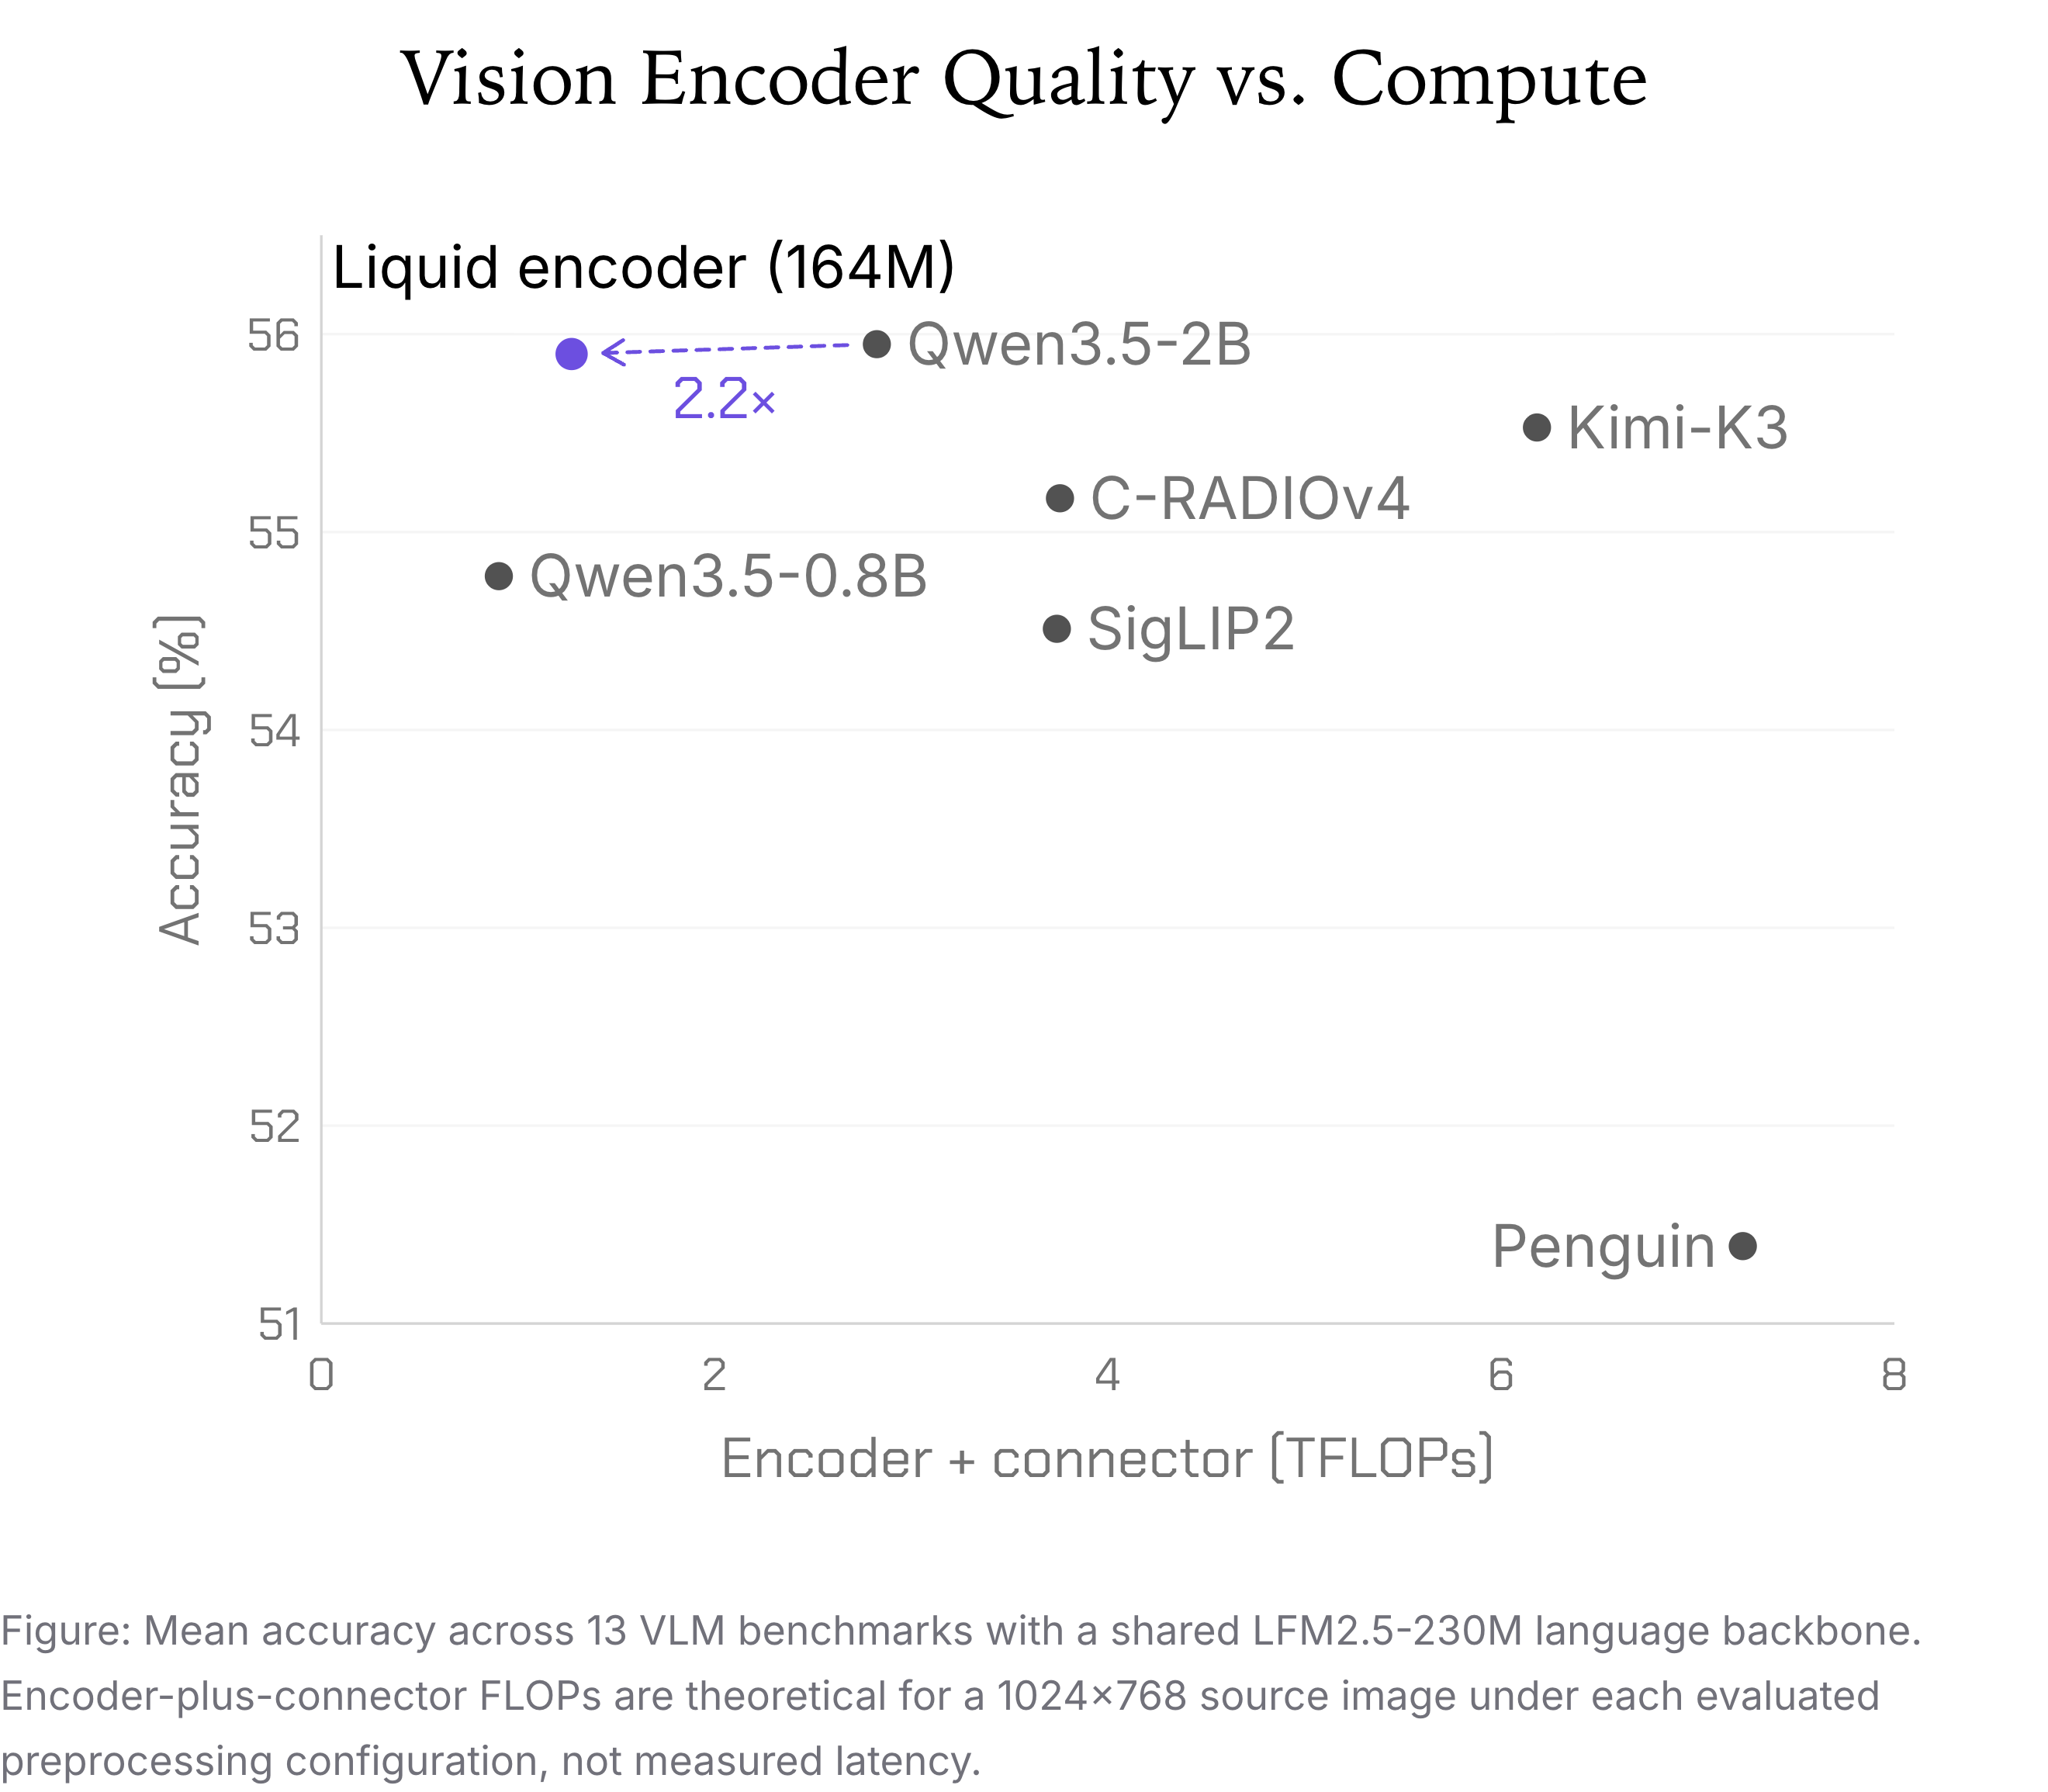
図:LFM2.5-230M の言語バックボーンを共通で使った、13 の VLM ベンチマークにおける平均精度。エンコーダ+コネクタの FLOPs は、評価した各前処理設定で 1024×768 の入力画像を処理した場合の理論値であり、実測レイテンシではない。
動画では、サンプリングしたフレームの各ペアを 1 つの時間スライスの視覚特徴にまとめて埋め込み、以降のエンコードの前に時間方向の系列長を半分にする。これらの設計により、このエンコーダはより豊かな画像理解と効率的な動画処理の両方を支える基盤になっている。
オーディオ
LFM3-Audio-2B は、ノート PC やエッジデバイス上でローカルに動作する、機能を一通り備えたコンパクトなオーディオモデルだ。テキストまたはオーディオを入力として受け取り、テキスト、音声、あるいはその両方で応答する。
LFM3-Audio-2B は、自社開発のオーディオエンコーダとコーデックを組み合わせた新しいアーキテクチャを採用している。音声品質は LFM2.5-Audio を上回り、対応言語は 18 言語に広がった。オーディオ理解、汎用的なオーディオ推論、ツール呼び出しが新たに加わっている。
- 音声チャット: 音声で質問すると、テキストと音声でストリーミング応答が返る。テキストのみの応答では、答える前に推論させることもできる。
- 多言語音声: 18 言語の音声を文字起こし、合成、翻訳する。
- オーディオ理解と推論: 録音を解釈し、そこに含まれる発話、音、出来事についての質問に答える。
- ツール呼び出し: 音声のリクエストをツール呼び出しに変換し、アプリやデバイスを操作する。呼び出しとあわせてテキストや音声で応答することもできる。
私たちが目指すのは、ドライバーとクルマのやり取りをできるだけ自然で直感的にすることです。Liquid とともに、オンデバイス AI の力で MBUX Virtual Assistant をどこまで高められるかを探っています。その一方で、高速でプライベート、クラウドに依存しない体験も可能にします。こうしたイノベーションを車両に載せる土台になるのが MB.OS アーキテクチャです。
ASR(WER、%、低いほど良い)
| LFM3-Audio-2B | LFM2.5-Audio-1.5B | Gemma 4 E2B | Gemma 4 E4B | Qwen2.5-Omni-3B | Nvidia Audex 2B | Voxtral Mini 3B | MiMo-Audio-7B-Instruct | Kimi-Audio-7B-Instruct | |
|---|---|---|---|---|---|---|---|---|---|
| 総パラメータ数 | 2B | 1.5B | 5B | 8B | 6B | 3B | 5B | 8B | 10B |
| 英語 | 6.2 | 6.1 | 8.3 | 7.8 | 6.3 | 6 | 5.5 | 8.5 | 5.3 |
| 多言語(en, es, pt, de, fr, it, zh, ja, ko の平均) | 6 | – | 8.1 | 6.5 | 7.4 | 6.4 | 7.8 | – | – |
英語 TTS(UTMOSv2、1〜5、高いほど良い)(WER、%、低いほど良い)
| LFM3-Audio-2B | LFM2.5-Audio-1.5B | Qwen2.5-Omni-3B | MiMo-Audio-7B-Instruct | |
|---|---|---|---|---|
| 総パラメータ数 | 2B | 1.5B | 6B | 8B |
| UTMOSv2 | 3.8 | 3.2 | 3.4 | 2.8 |
| WER | 1.4 | 1.9 | 3.2 | 4.9 |
VoiceBench、ツール呼び出し、音声理解(音声入力・テキスト出力、%、高いほど良い)
| LFM3-Audio-2B | LFM2.5-Audio-1.5B | Qwen2.5-Omni-3B | Gemma 4 E2B | Gemma 4 E4B | Voxtral Mini 3B | MiMo-Audio-7B-Instruct | Kimi-Audio-7B-Instruct | |
|---|---|---|---|---|---|---|---|---|
| 総パラメータ数 | 2B | 1.5B | 6B | 5B | 8B | 5B | 8B | 10B |
| VoiceBench | 73.1 | 55.2 | 66.4 | 63.3 | 72.9 | 65.8 | 77.3 | 76.9 |
| ツール呼び出し(社内評価) | 58.5 | – | 44.3 | 55.6 | 72.4 | 44.5 | 33.4 | 50.6 |
| 音声理解(MMAR) | 50.6 | 25.9 | 54.4 | 44.5 | 49.1 | 50.1 | 62.3 | 53.3 |
新しい LFM ベースの音声エンコーダは、スライディングウィンドウアテンションと短い畳み込み層を組み合わせた構成で、メモリ使用量を抑えています。完全に因果的で、マイクからの入力をリアルタイムに処理し、話している最中に prefill を進められます。発話が終わってからの待ち時間が短くなり、最初のトークンまでの時間は最短 50 ms です。
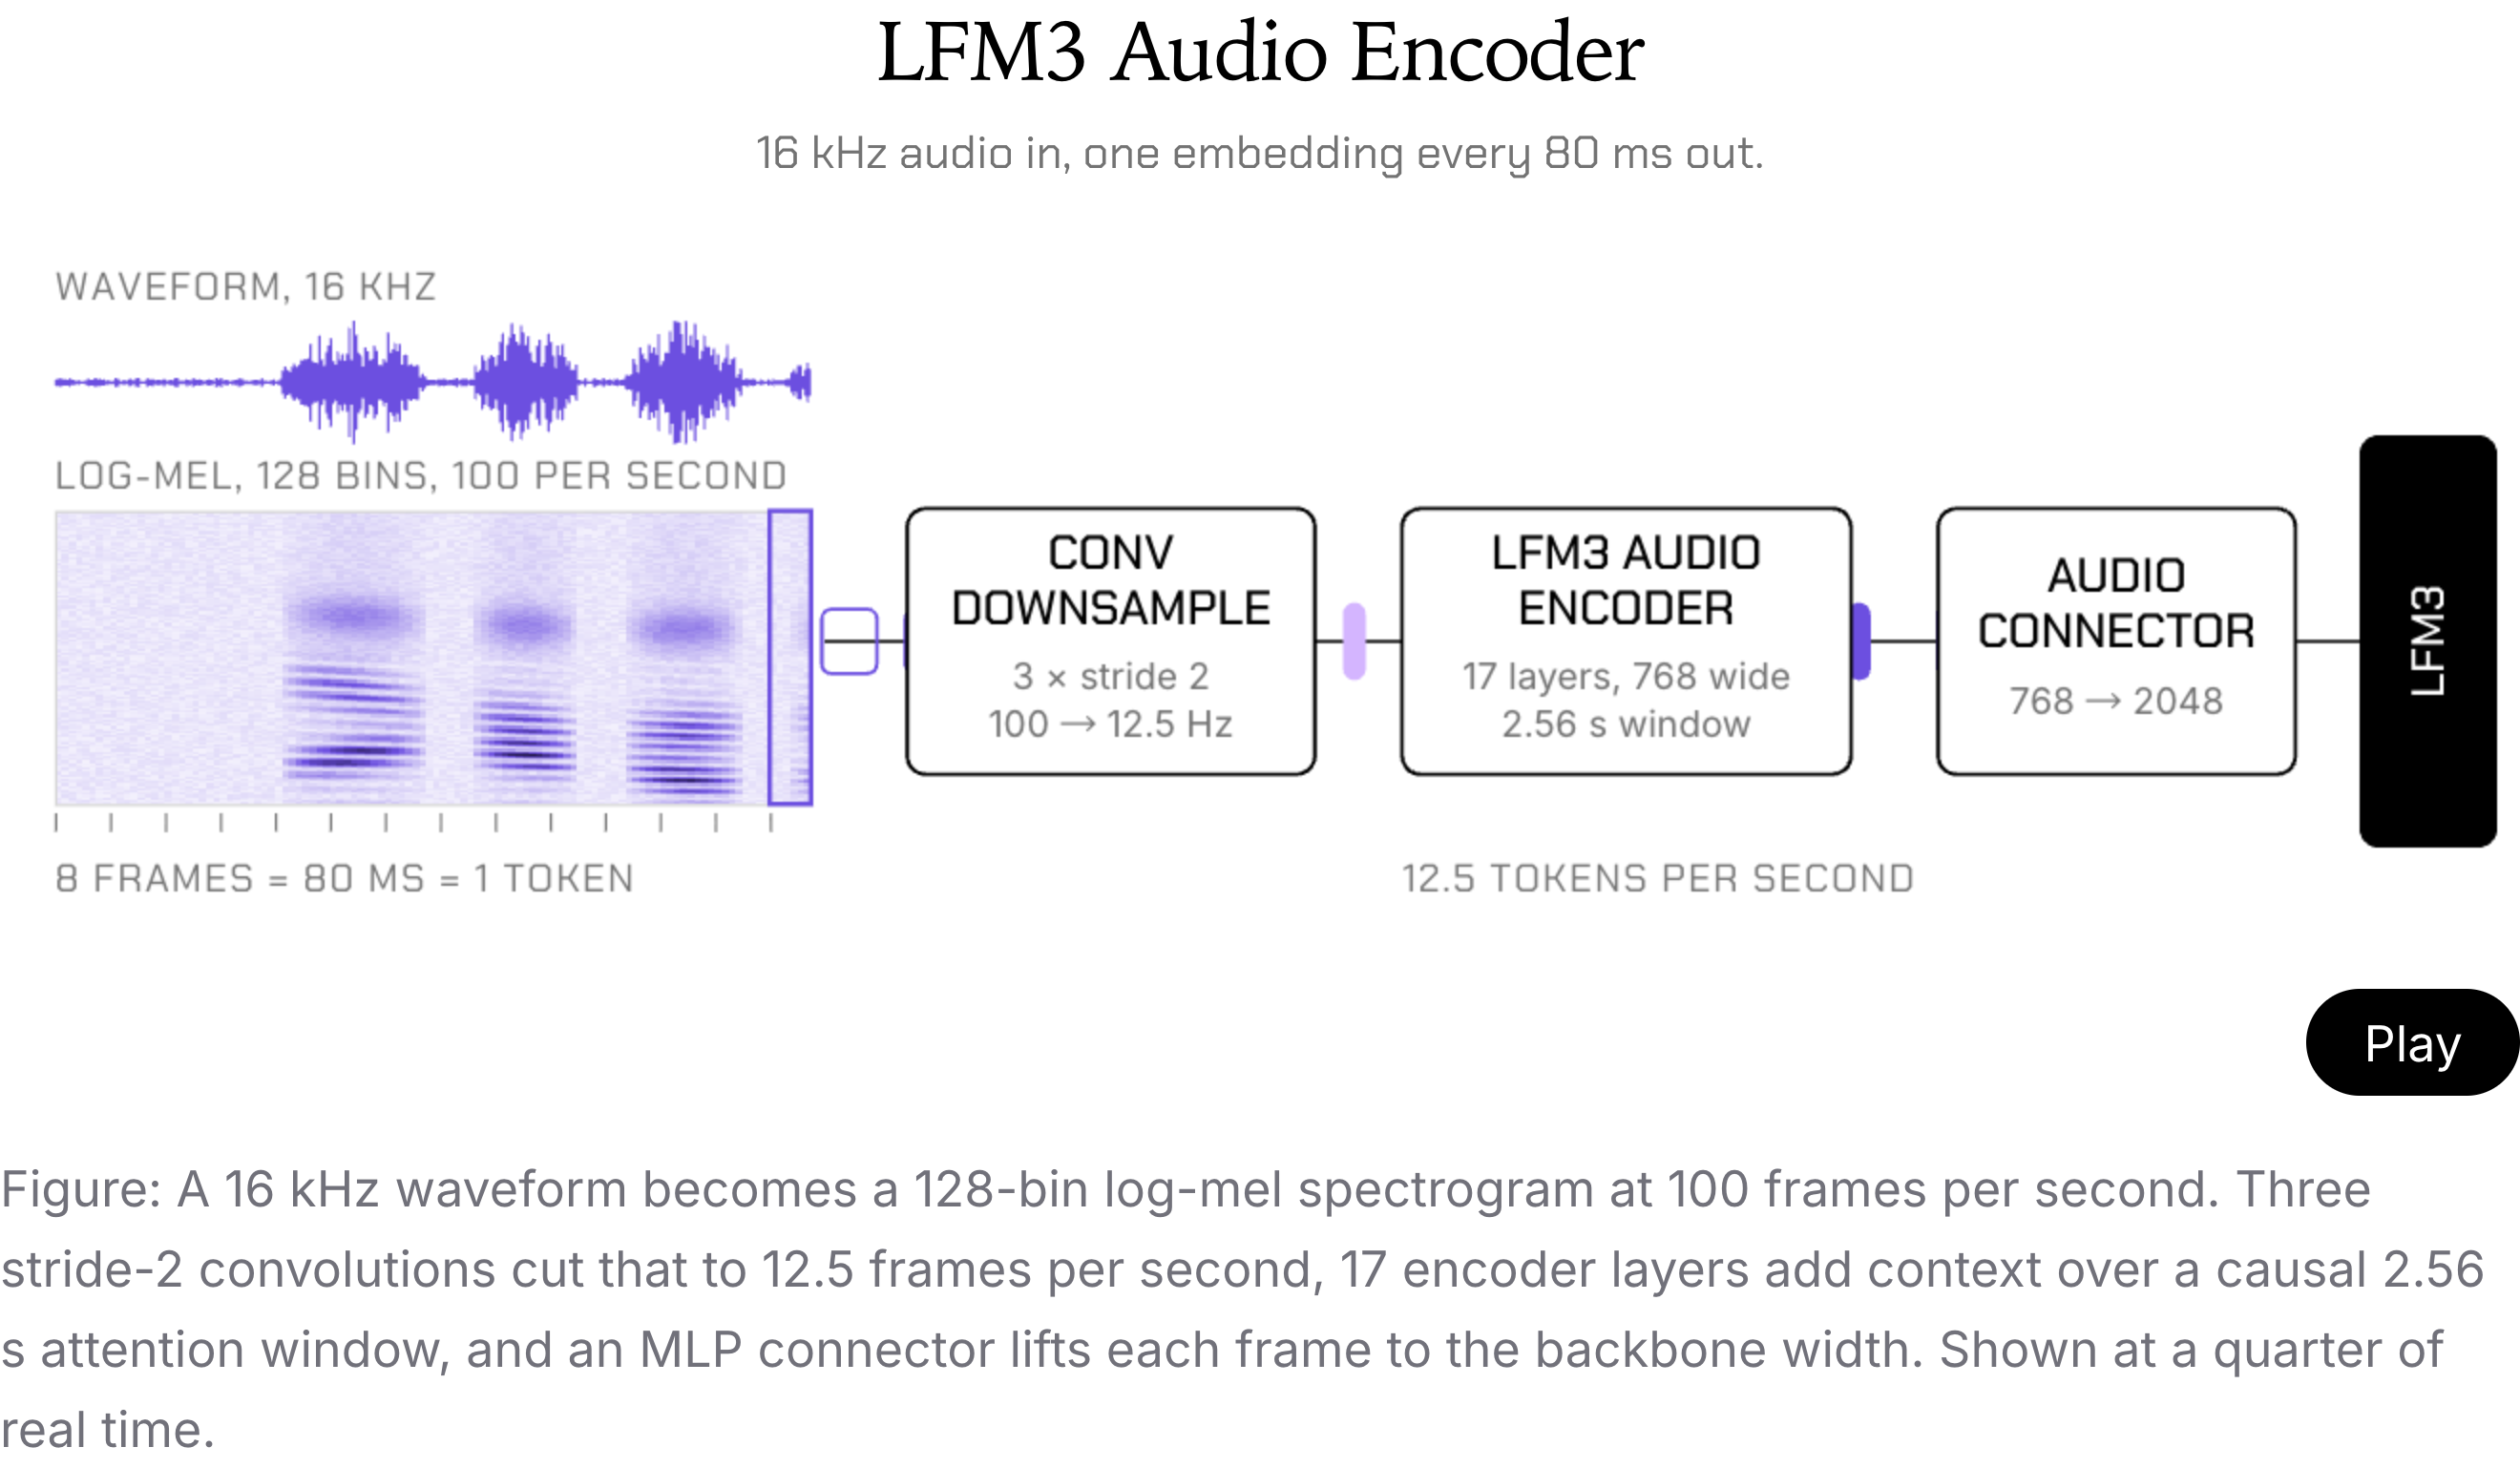
図:16 kHz の波形は毎秒 100 フレームの 128 ビン log-mel スペクトログラムになる。ストライド 2 の畳み込み 3 層がこれを毎秒 12.5 フレームまで削り、エンコーダ 17 層が因果 2.56 秒のアテンション窓で文脈を加え、MLP コネクタが各フレームをバックボーンの幅に引き上げる。実時間の 4 分の 1 で表示。
新しい音声トークナイザである LiquidCodec は、LFM3-Audio と LFM3-Omni の両方で多言語音声生成を支える。LFM3 アーキテクチャ上に構築され、生成したトークンを単一 CPU スレッド(Apple M4 Max)で実時間の約 87 倍の速さで音声に変える。ストリーミングデコードにも対応する。
量子化は、80 ms の音声を 12 個の離散トークンに圧縮する。従来の LFM Audio モデルと違い、トークンを逐次的に予測する必要はなく、複数のトークンを並列に反復予測できる。バックボーンが新しいトークンを生成すると、デトークナイザがそれを順次音声へ変換していく。すべて実時間より速いため、会話は滑らかで応答性が高い。
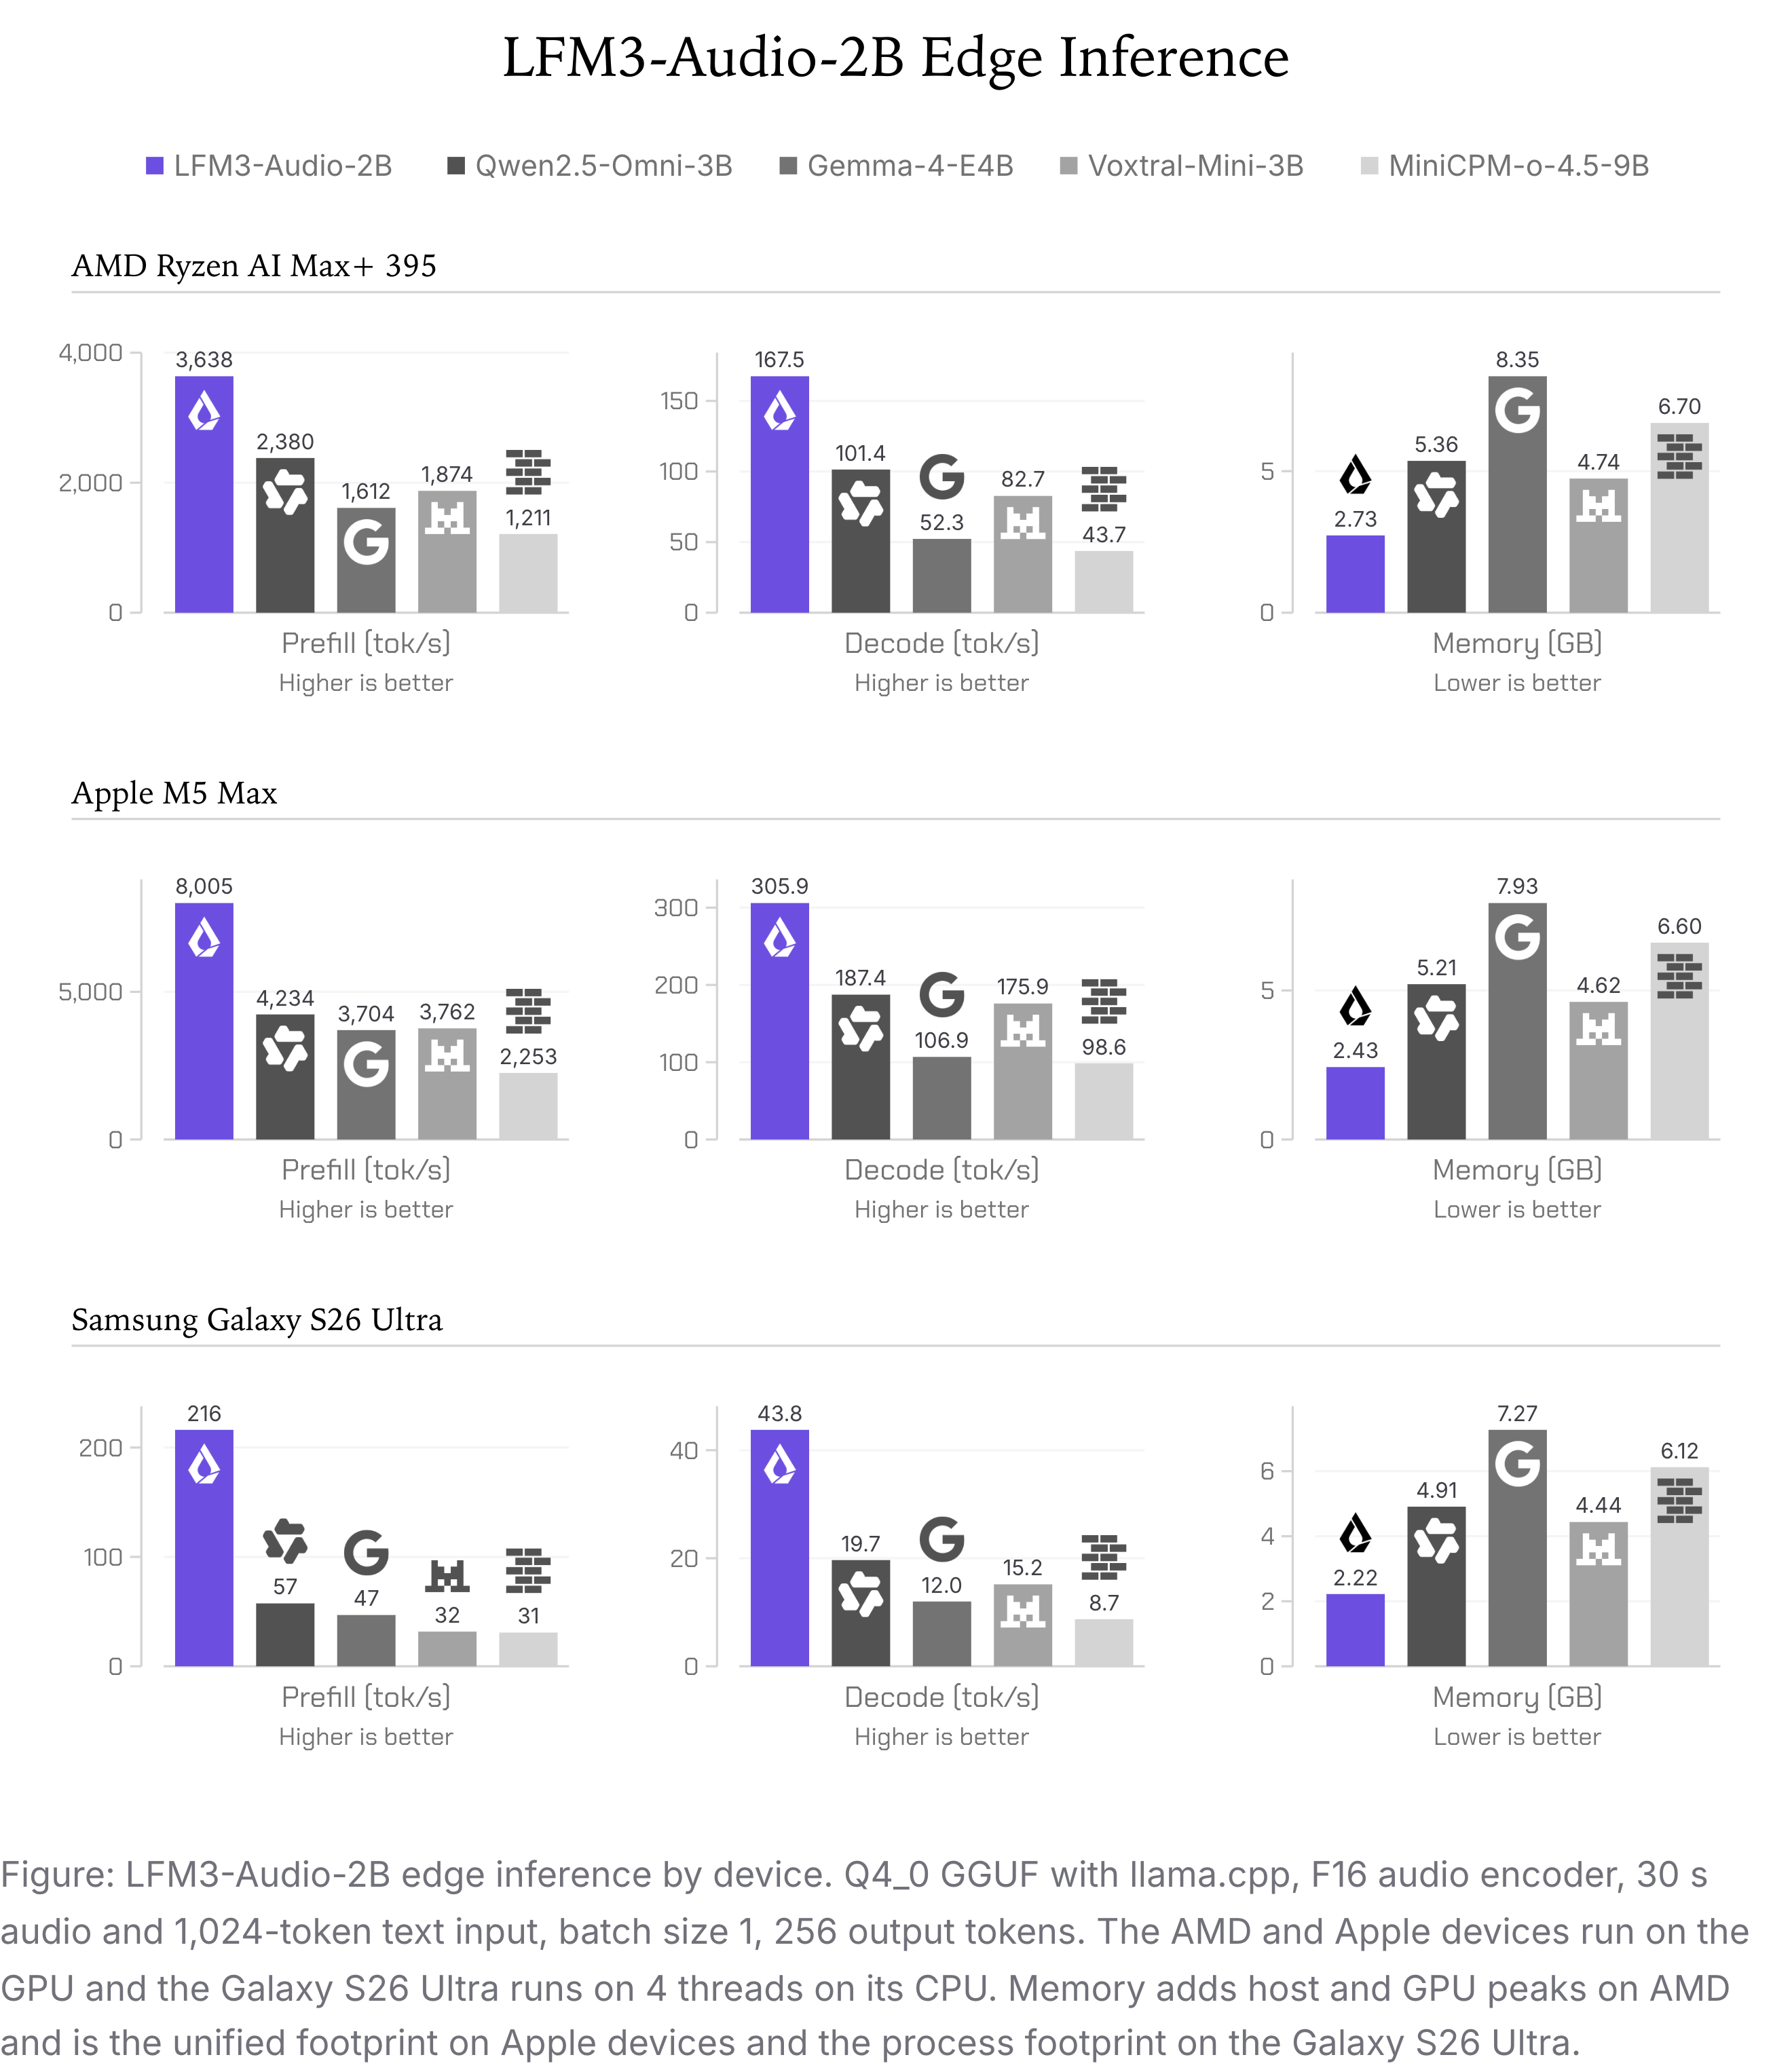
図:デバイス別の LFM3-Audio-2B エッジ推論。llama.cpp 上の Q4_0 GGUF、F16 音声エンコーダ、30 秒の音声と 1,024 トークンのテキスト入力、バッチサイズ 1、出力 256 トークン。AMD と Apple のデバイスは GPU で実行し、Galaxy S26 Ultra は CPU の 4 スレッドで実行する。メモリは、AMD ではホストと GPU のピークの合計、Apple デバイスではユニファイドメモリのフットプリント、Galaxy S26 Ultra ではプロセスのフットプリント。
Omni
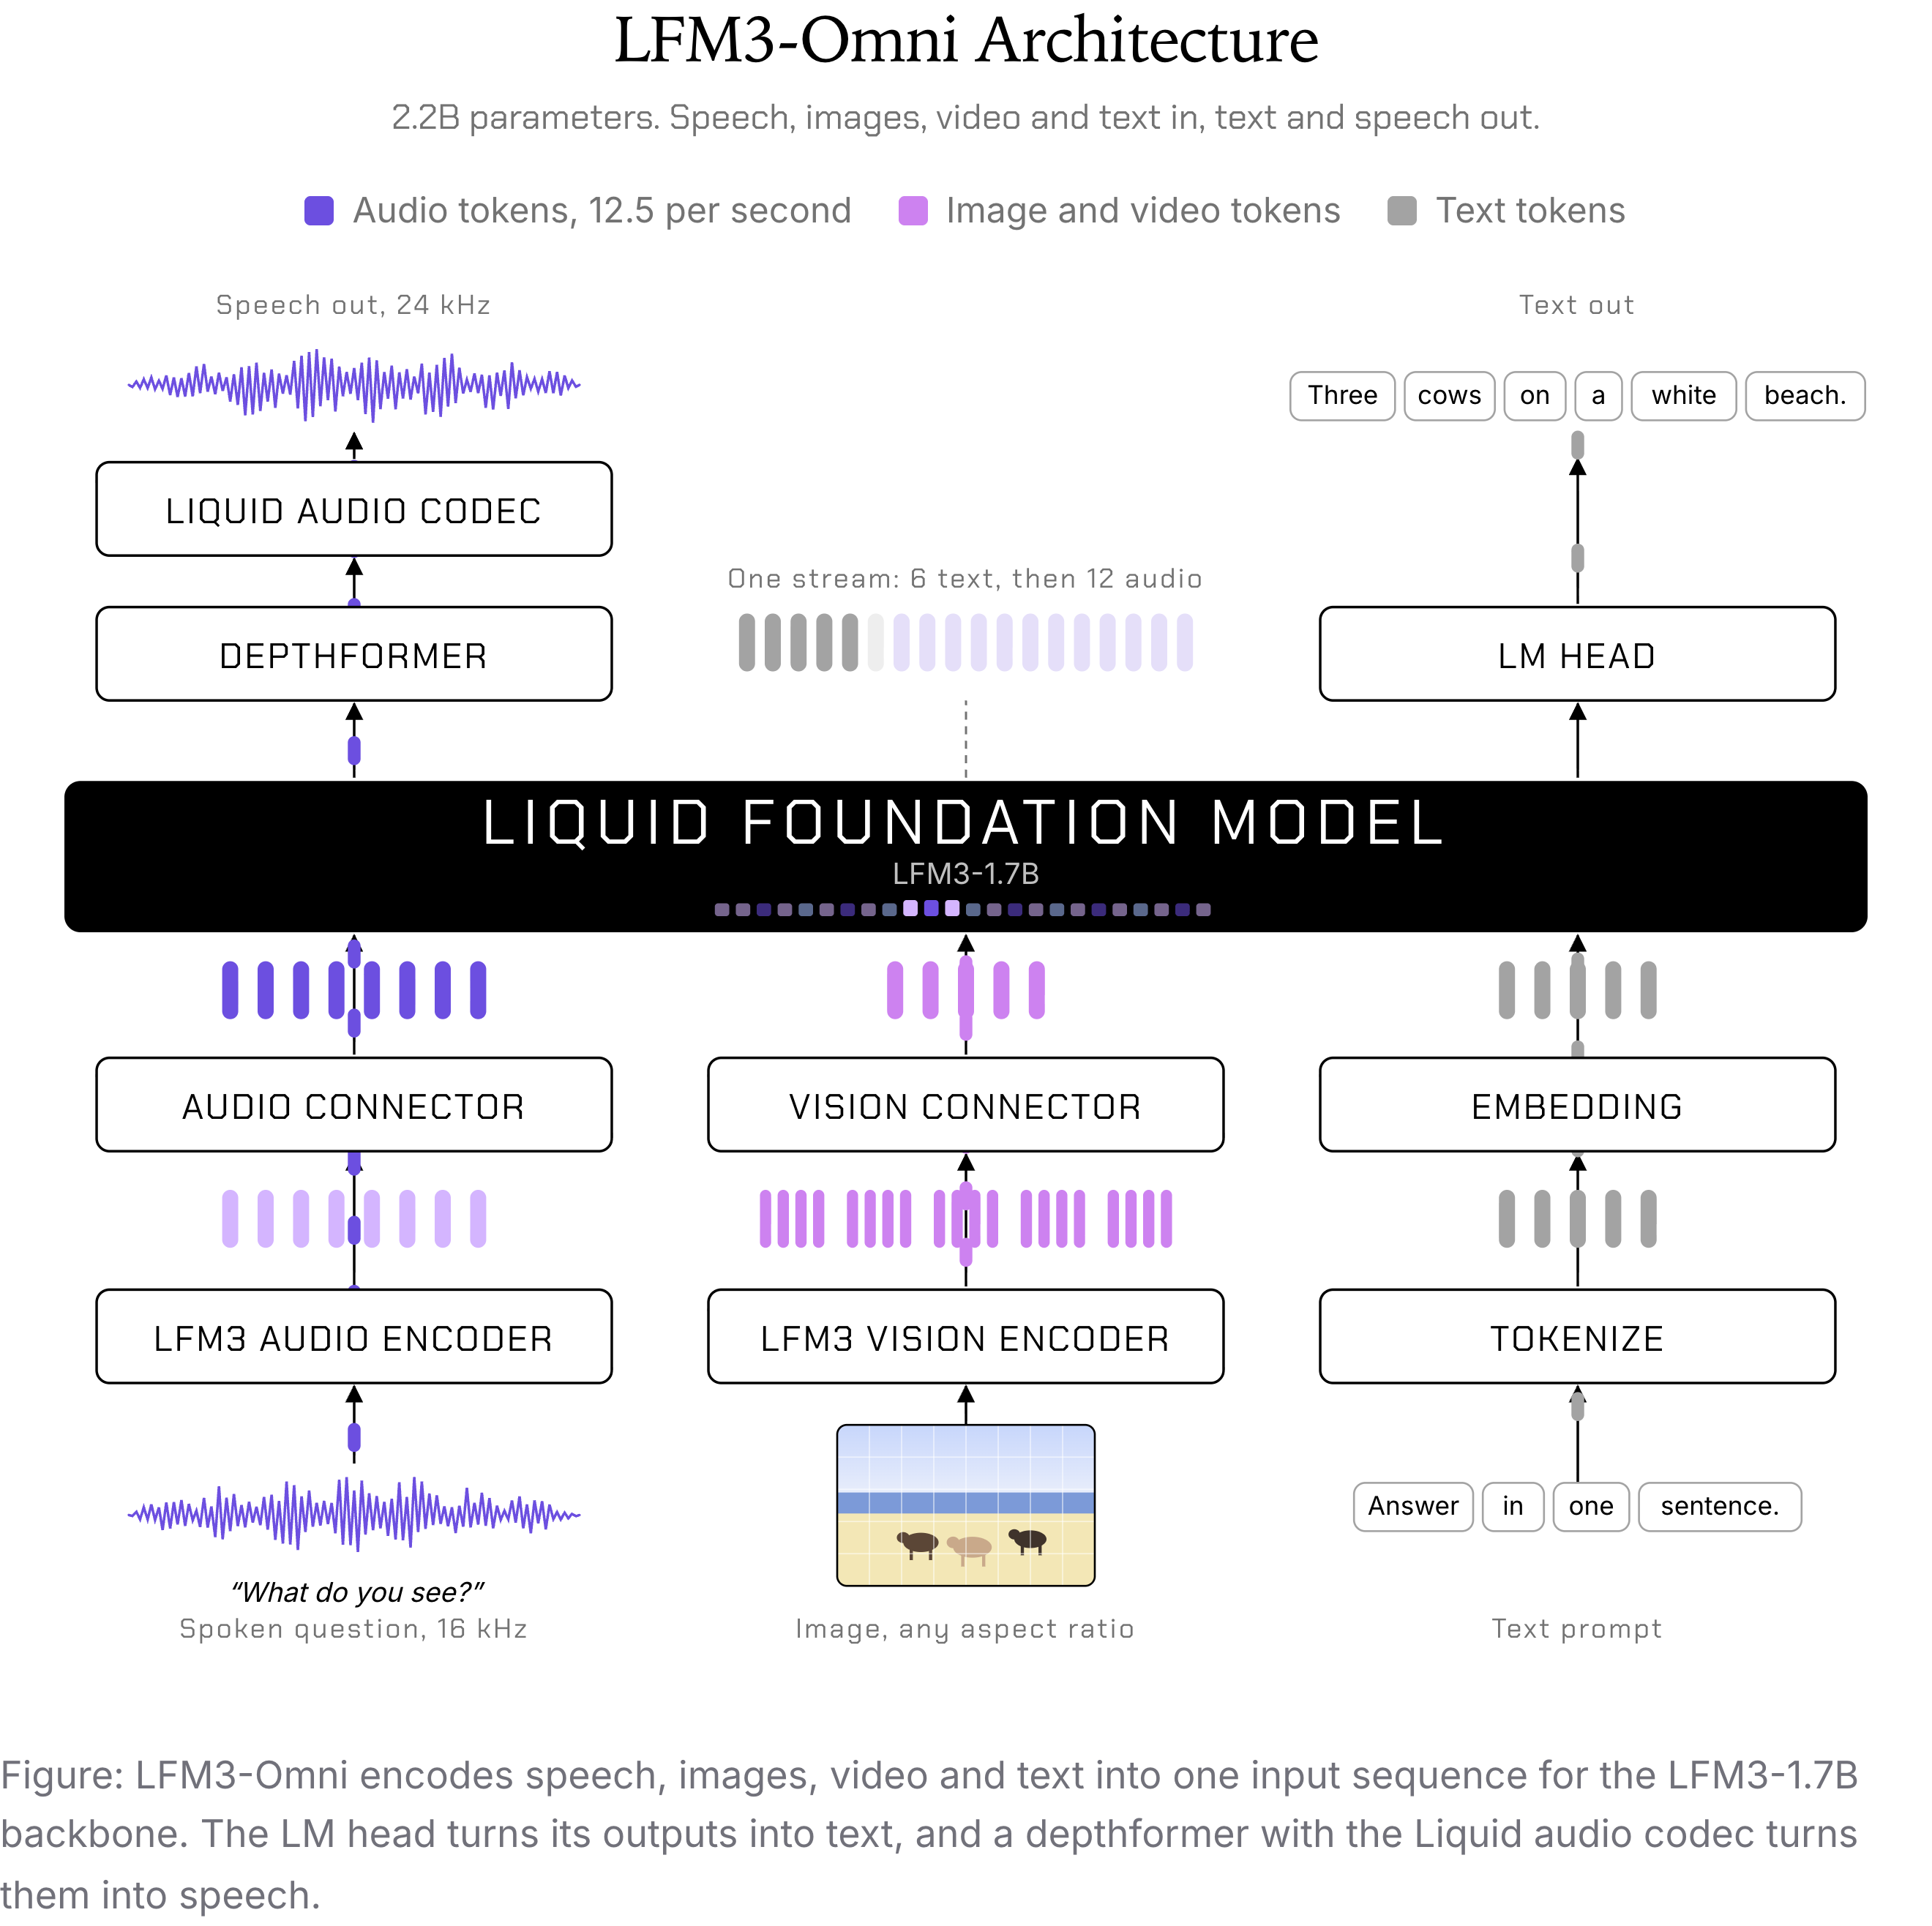
図:LFM3-Omni は音声・画像・動画・テキストをひとつの入力シーケンスに符号化し、LFM3-1.7B バックボーンに渡す。LM ヘッドがその出力をテキストに変え、Liquid audio codec を用いた depthformer が音声に変える。
LFM3-Omni-2B は私たち初のオムニモデルであり、視覚・音声・言語をひとつのモデルに統合し、見て、聞いて、話し返す:
- 音声による視覚的質問応答: 画像や実世界のシーンについて音声で質問すると、テキスト・音声・その両方で答えが返る。
- 映像と音声の理解: 動画のフレームと対応する音声を同時に処理し、画面で何が起きているかと、何が話され、聞こえているかの両方を推論する。
- マルチモーダルなツール呼び出し: 視覚的な文脈と音声の指示を組み合わせて構造化されたツール呼び出しを生成する。アシスタントは見たものとユーザーの発話の両方を使って、アプリケーションやインターフェースを操作できる。
LFM3-Omni は、視覚情報と聴覚情報を同時に理解する必要があるクロスモーダルなやり取りを扱える。画像について音声で質問したり、音声が同期された動画を渡して、見えるものと聞こえるものの両方に依存する質問を投げかけたりできる。
| LFM3-Omni-2B | Qwen2.5-Omni-3B | Qwen2.5-Omni-7B | Gemma 4 E2B | Gemma 4 E4B | Phi-4-multimodal | ||
|---|---|---|---|---|---|---|---|
| Params | 2.2B | 6B | 10.7B | 5B | 8B | 5.6B | |
| Video + Audio Understanding | Daily-Omni | 70.1 | 58.8 | 61.3 | 50.6 | 54.1 | 48.9 |
| WorldSense | 47.1 | 45 | 45.4 | 38.1 | 43.5 | 42.4 | |
| AV-SpeakerBench | 46.8 | 40.4 | 43.2 | 32.3 | 36.4 | 38 | |
| Image + Audio Understanding | OmniBench (overall) | 46.3 | 47.1 | 49.7 | 16.8 | 20.7 | 39 |
| OmniBench Speech | 48.2 | 45.7 | 48 | 16.1 | 21.3 | 38.9 | |
| Spoken Visual QA | RealWorldQA | 64.7 | 61.1 | 69.9 | 39.4 | 49 | 64.3 |
| MMStar | 51.8 | 50.8 | 57.3 | 38.9 | 44.6 | 54.8 | |
| POPE | 83.8 | 85.3 | 85.4 | 74.2 | 77.8 | 83 | |
| ERQA | 39.4 | 37.3 | 39.2 | 20.6 | 32.1 | 30.8 | |
| EmbSpatial | 67.6 | 53.4 | 59.5 | 44.1 | 54.0 | 42.6 |
LFM3-Omni はクロスモーダル理解に加え、単体の LFM3 モデルが持つ主要な機能をそのまま備えています。視覚的質問応答、音声認識、音声合成、言語インストラクションへの追従などです。
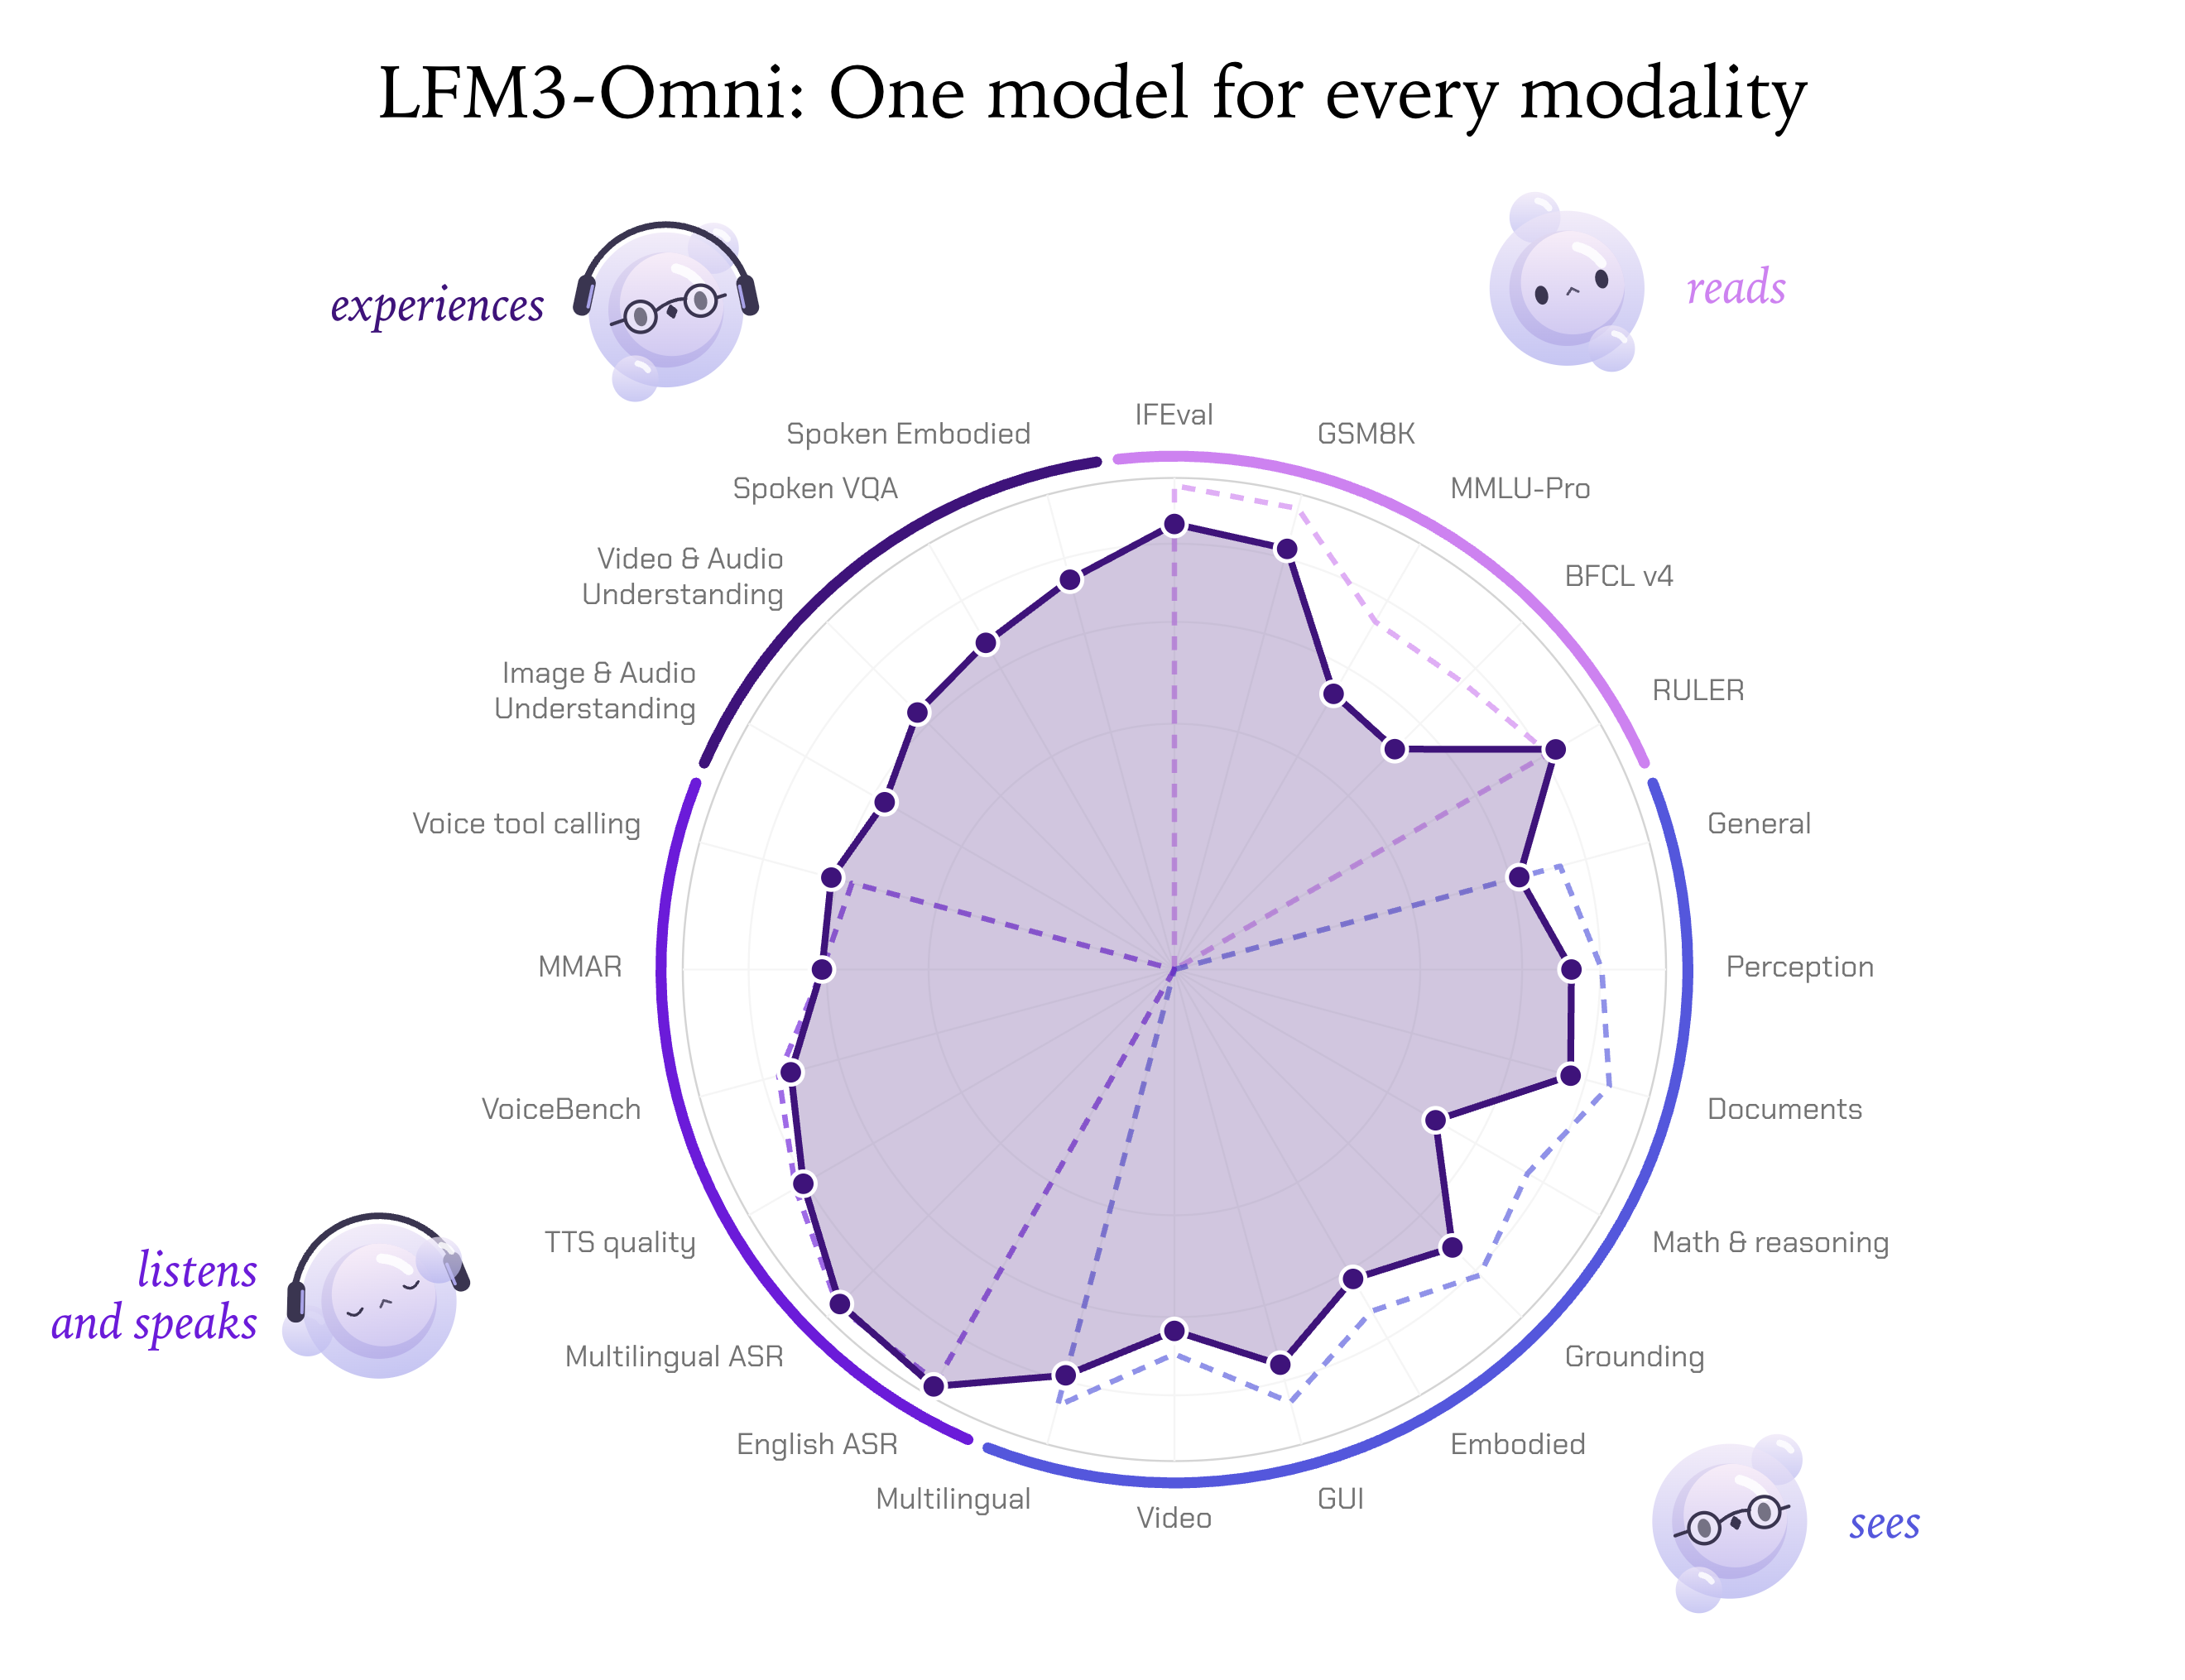
LFM3-Omni-2B は、リソースの限られた環境で効率よく動かせるよう設計されています。その機能により、文脈を踏まえた案内を返し、ハンズフリーのやり取りを支え、自然な音声コマンドでユーザーの作業を手助けする対話アシスタントを実現できます。視覚理解、音声対話、ツール呼び出しを組み合わせることで、パーソナライズされた学習や日常のアシスタントから、デジタルインターフェースやロボットシステムの操作まで、幅広い用途に対応します。
パラメータ数 2.2B で、こうしたマルチモーダルアシスタントをオンデバイスに搭載できます。手書きの数式を見て話しかけられた質問に答える家庭教師、持ち歩きながら見えているものについて尋ねられるタブレット、カメラが捉えた映像とドライバーの発話を組み合わせる車載アシスタントなどが例です。
判定モデル
今回のリリースでは、新しい判定モデルを 2 つ追加する。d1-2BはLFM3-VL-2Bをベースにテキストと画像を読み、d1-Omni-2BはLFM3-Omni-2Bをベースに音声も聞き取る。どちらも答えを文章で書く代わりに、ミリ秒単位で判定を下す。状況(サポートチケット、請求書、アプリの画面、写真、ボイスメモ)と質問のリストを渡せば、1 回のフォワードパスで全問に回答し、それぞれに較正済みの確率を付ける。
新しい LFM3 バックボーンに加え、d1-3Bからの大きな変更点が型付きの回答だ。yes/no、選択肢、スコアに加えて、両モデルは次のことができるようになった。
- 指し示す: 説明した対象を囲むボックスを描く。あるいは該当するものをすべて見つけ、件数も返す。
- 読み取る: 文書からテキスト、数値、日付を抜き出し、その由来となる正確なスパンを示す。フィールドが存在しなければ「not found」と答える。
- 見積もる: 数値と、その想定レンジを返す。
- 選ぶ: 該当する選択肢をすべて選び、それぞれに確率を付ける。
質問の数に制限はない。同じ入力に対する 1 回のパスでまとめて読まれる。
より小さく、より強く。 d1-2B は前世代の d1-3B を置き換える。パラメータ数は 3 分の 1 減だ。
| d1-3B | d1-2B | |
|---|---|---|
| Decision Bench(実企業のレコード) | 83.6 | 85.2 |
| Decision Index(公開スイート) | 49.0 | 51.1 |
| ImajevBench(写真とルールからの判定) | 64.0 | 75.5 |
| 社内 Meta index(非公開・公開の 117 ベンチマーク) | 58.8 | 63.2 |
話して判定できる。 d1-Omni-2B は同じ質問を音声で受け取る。音声のリクエストも、テキストと同じようにルーティングし、チェックし、回答できる。書き言葉ではなく音声で尋ねた場合でも、精度はほぼ落ちない。
| 書き言葉 | 音声 | |
|---|---|---|
| DecisionBench(業務のルーティングとトリアージ) | 83.4 | 78.2 |
| Typed Decisions(カスタマーサービス案件) | 50.5 | 48.0 |
| JevBench | 87.6 | 89.0 |
日常的な音も認識し(ESC-50 で 84.5%)、43 言語のうちどれが話されているかも判別する(FLEURS で 92.5%)。
テキストと画像なら d1-2B、入力に音声が含まれるなら d1-Omni-2B を選べばよい。どちらもオンデバイスで動作し、チケット、文書、通話、カメラのフレームの流れを、クラウドへのラウンドトリップなしで構造化された判定に変える。
次のデモでは、d1-2B が MacBook 上で動作します。探したいものを自然言語で伝えると、新しい Point 回答タイプによって、1 回のフォワードパスで該当箇所すべてにバウンディングボックスが描画されます。
特化型インテリジェンスのために
LFM3 は特化を前提に設計されている。2B クラスのモデルは、自前のデータでファインチューニングでき、アプリケーションが動く場所でそのまま動かせる程度に小さい。以下では LFM3-VL-2B を使った 2 つの例を示す。1 つ目は、狭い範囲の産業タスク向けに検査モデルへ変える短時間のファインチューニング。2 つ目は、ロボットコントローラへ変える研究上の拡張だ。
ドメイン知識:LFM3 を自分の分野に特化させる
フロンティアモデルは強力な汎用モデルではあるが、個々のユースケースに必ずしも精通しているわけではない。このデモでは、風力タービンブレードを撮影したドローン写真から欠陥を見つけて分類できるよう、LFM3-VL-2B をファインチューニングした。学習には公開写真約 3,000 枚(WTBs2025)を使い、A100 1 台で SFT と GRPO を数時間回した。その後、ベースモデルと GPT-6 Luna を、約 1,400 枚のホールドアウト写真で比較した。
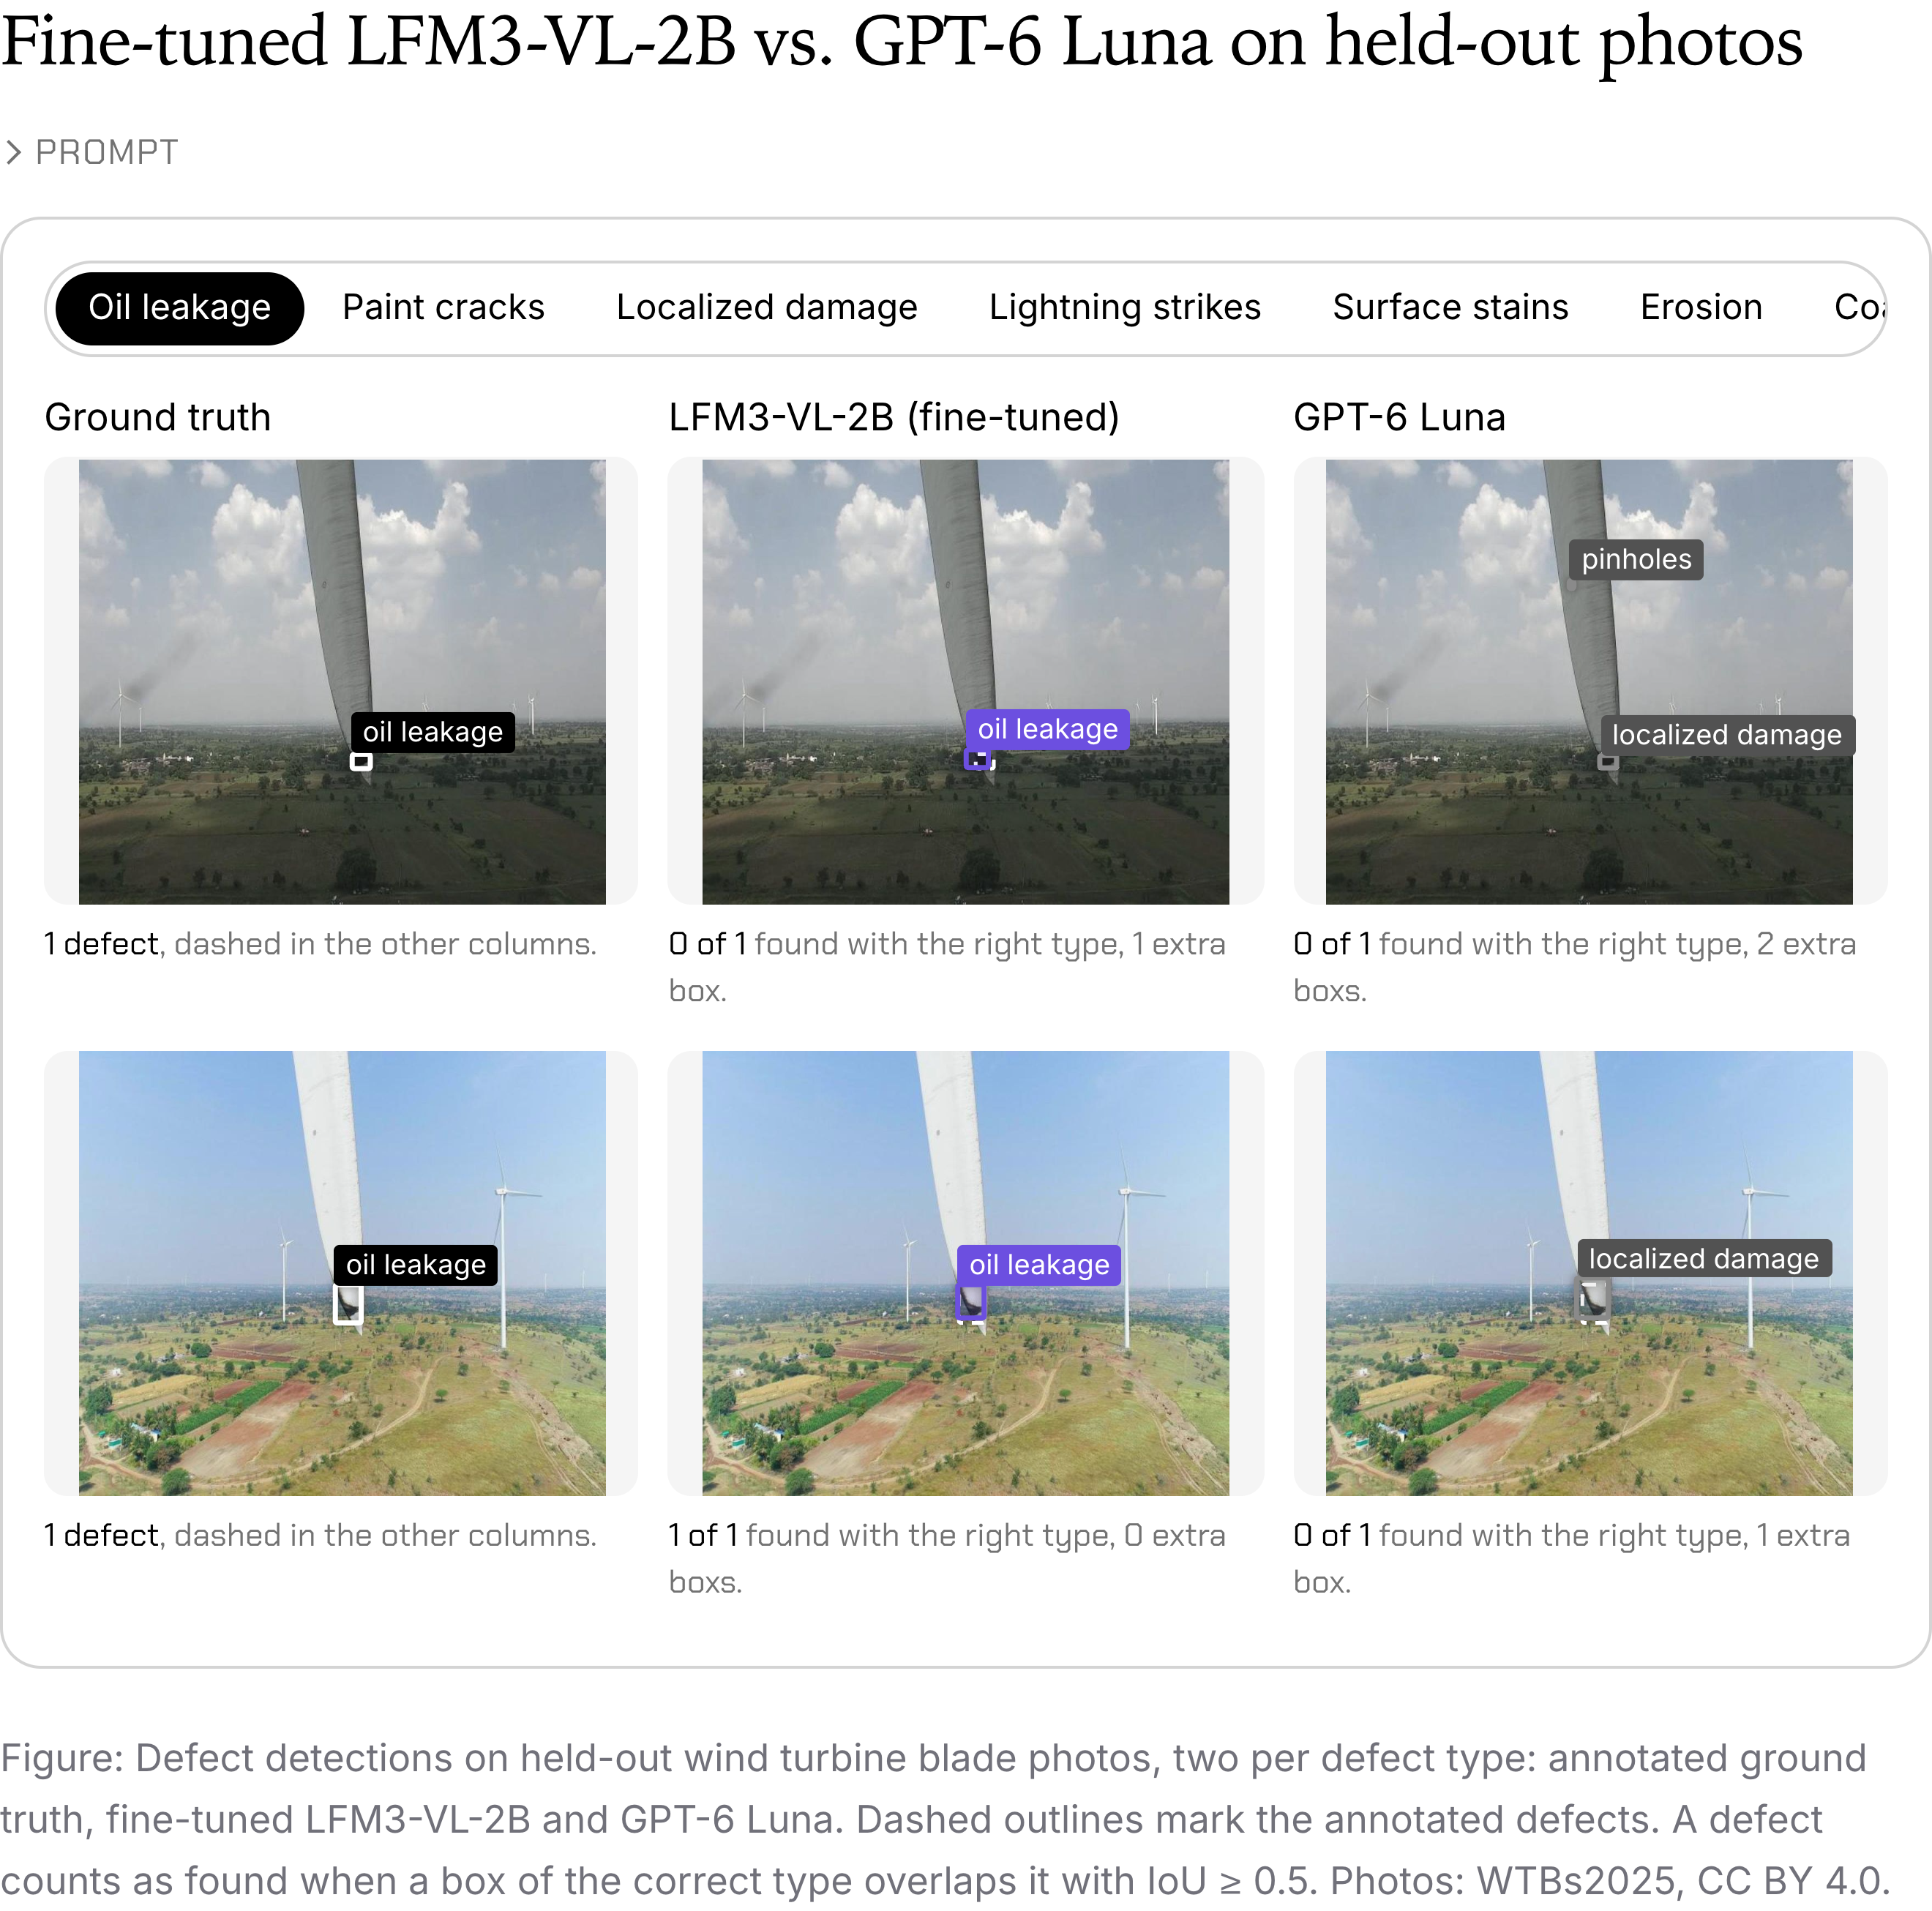
図:風力タービンブレードのホールドアウト写真における欠陥検出。欠陥タイプごとに 2 枚ずつ、アノテーション済みの正解、ファインチューニングした LFM3-VL-2B、GPT-6 Luna を並べている。破線の輪郭がアノテーションされた欠陥。正しいタイプのボックスが IoU ≥ 0.5 で重なった場合に、その欠陥を検出できたとみなす。写真:WTBs2025、CC BY 4.0。
そのままでは、LFM3-VL-2B と GPT-6 Luna がこれらの欠陥タイプを正しく識別できる画像は 10% 未満だ。短時間のファインチューニングで、LFM3-VL-2B の分類精度は 67%に上がり、検出 F1 は 0.003 から 0.11 に改善した。GPT-6 Luna は 0.01 だった。違いがはっきり出るのが落雷の画像で、GPT-6 Luna は欠陥の位置を正しく捉えることが多いもののラベルを誤るのに対し、ファインチューニングしたモデルは落雷と正しく識別する。分類と検出にとどまらず、同じ画像について自然言語で質問に答えることもできる。たとえば、目に見える損傷の位置を示したり、欠陥タイプ・根拠・位置を含む短い検査所見を書いたりできる。
ロボティクス:LFM3 に行動を教える
LFM3-VL-2B をロボティクス分野の基盤として使えるかどうかを調べる。検討するのは、(1) 高レベルなツールオーケストレーション、(2) 視覚言語ナビゲーション、(3) 低レベルなマニピュレーションという、互いに補完し合う 3 つの方向性である。
オーケストレーション。 LLM ベースのロボット計画・制御(SayCan、Code as Policies)と最近のフィジカルオーケストレータ(VoLo、Gemini Robotics ER 2)を踏まえ、LFM3-VL-2B をファインチューニングし、ツールを通じてロボットアームを操作する。リクエストと現在のカメラ画像を受け取ると、ステップごとに推論し、ポインティングで物体をグラウンディングし、深度ツールで寸法を測り、モーションプランナー経由で操作する。その後、次の画像で各結果を検証して報告する。リクエストが到達不能だったり曖昧だったりした場合も同様だ。タスクには関係に基づく選択、測定した属性による並べ替え、環境の摂動が含まれ、いずれも Isaac Sim 上でシミュレーションしている。アーキテクチャの変更は不要だった。rank-32 の LoRA アダプタを約 40,000 サンプルで学習した。操作軌道に、汎用的なツール使用とポインティングのデータを組み合わせている。AMD Instinct MI325X 1 基で約 6 GPU 時間かかった。ファインチューニングした d1-2B スキルモニタと組み合わせると、滑り、詰まり、引きずりといった外乱下での復帰成功率をさらに 2 倍にできる。
ナビゲーション。 視覚と言語によるナビゲーションでは、LFM3-VL-2B が経路記述と RGB フレームの短い履歴を読み、ナビゲーション目標と残差量子化した軌道プリミティブを予測する。LightNav-0 のアクションインターフェースに着想を得た。各決定は 5 トークンで構成される。空間・制御用の 2 トークンと、階層的に量子化された 3 つのコードだ。後者は 10 ウェイポイントの経路を表し、速度コントローラが追従できる。語彙のうち 2,068 トークンを作り替えるだけで、アーキテクチャはそれ以外変更していない。MI325X GPU 上で 280 万サンプルを 72 GPU 時間かけて学習した。未見の検証シーンにおいて、得られたモデルは R2R で 53%、RxR で 43%の成功率を達成した。評価プロトコルは厳格な連続制御で、壁沿いの滑りを無効化し、明示的な停止を必須としている。カメラ角度や指示言語が変わっても堅牢であることも確認した。Jetson AGX Orin 上では、視覚プロンプトのキャッシュなしで TensorRT FP16 を使い、ナビゲーションモデルが 2.5 Hz 超でウェイポイント軌道を更新する。
操作生成。 LFM3-VL-2B を視覚言語行動(VLA)モデルにするにあたり、OpenVLA-OFT と StarVLA-α に着想を得た並列行動予測を採用した。小さな残差 MLP が、8 個の行動クエリトークンの隠れ状態を、1 回のフォワードパスで 8 ステップ分の連続ロボット行動チャンクに変換する。固有感覚は、離散化したテキストと、実体ごとに学習した射影の両方から与え、ネットワーク全体をエンドツーエンドでファインチューニングする。単一アームや移動マニピュレータから双腕プラットフォーム、ヒューマノイドまで 15 種類の実体のシミュレーションおよび実機データを用い、MI325X GPU で 170 GPU 時間をかけて汎用チェックポイントを 1 つ学習した。得られた VLA は、LIBERO の 4 スイートで平均成功率 96.2%、RoboCasa-GR1 の卓上タスクで 45.7% を達成する。Jetson AGX Orin 上では、TensorRT と FP16 精度により 50 ms 未満で行動チャンクを生成できる。
はじめに
LFM3 は本日から利用できる。Hugging Face と Liquid AI API で公開中だ。
LFM3 は「どこでも動く AI」という私たちの構想を形にするものだ。これらのモデルは次のとおり。
- オープンウェイト: ダウンロードし、ファインチューニングし、デプロイできる。
- 初日から高速: Apple、AMD、NVIDIA、SGLang、Qualcomm の各ハードウェアで llama.cpp、MLX、vLLM をネイティブにサポート。低レイテンシ・大規模ワークロードには Liquid Real-time Inference Pipeline でデプロイできる。
- 揃ったモデルファミリー: カスタマイズ向けのベースモデルから、テキスト、視覚、音声、オムニ、意思決定に特化したモデルまで、単一のアーキテクチャで多様なユースケースをカバーする。
どんなものを作るのか、楽しみにしている。
ローンチパートナー
day-0 ローンチパートナーの支援に感謝する。LFM3 は本日から次のプラットフォームで利用できる: Ambarella、AMD、Arm、OpenVINO 経由の Intel、NVIDIA、OpenRouter、Qualcomm AI Hub と GenieX 経由の Qualcomm、Vercel。リリース前のテストと評価に協力いただいた Mercedes-Benz と Shopify にも感謝する。
ビルダーエコシステムからの支援に感謝します:Atomic、Cactus、Hugging Face、llama.cpp、LM Studio、MLX、Ollama、SGLang 上の RadixArk、.txt、Unsloth、vLLM、ZML。
引用
引用には以下の参考文献または BibTeX を使用してください:
Liquid AI, "Introducing LFM3: Every Modality for Specialized Intelligence", Liquid AI Blog, October 2026.
@article{liquidAI2026LFM3,
  author = {Liquid AI},
  title = {Introducing LFM3: Every Modality for Specialized Intelligence},
  journal = {Liquid AI Blog},
  year = {2026},
  note = {www.liquid.ai/blog/lfm3},
}