Liquid AI 发布 LFM3:一套混合架构撑起六个 2B 级模型
LFM3-1.7B 在 22T token 上预训练,24 层里 13 层是门控短卷积、5 层滑窗注意力、6 层全局注意力,4-bit 量化后约 1 GB,128K 上下文的 KV cache 只要 1.6 GB。同门还有视觉、音频、全模态和两个决策模型。
中文
复制
今天,我们正式发布 LFM3——新一代 Liquid Foundation Models(LFM),专为专业化智能打造。LFM3 系列天生具备多模态能力,将文本、视觉、音频、omni 和决策模型统一到同一个全新的共享骨干之上。LFM3 家族的首个版本覆盖 2B 参数级别的模型。
LFM3 基于全新的混合架构,使用 22T token 完成预训练,表达能力优于 LFM2,同时保持了原有的效率。小尺寸、快模型所多出的这部分容量,让 LFM3 成为同类中打造专业化智能的理想起点:它可以在本地微调,可以在任何设备上运行,能力也足以成为某个专业任务上可靠的专家。
基础模型和后训练模型均为开放权重,即日起可在 Hugging Face、我们的 Playground 和 Liquid AI API 上获取。如何在本地运行和微调,请参阅我们的文档。
亮点
- 同等参数下能力更强: 新的 tri-hybrid 架构与训练配方让 LFM3-1.7B 在参数少 35% 的情况下,表现超过上一代 LFM2.5-2.6B。
- 所有模态,共用一套骨干: 六个 2B 级模型(文本、视觉、音频、omni 与决策),全部从 LFM3-1.7B-Base 训练而来。
- 为端侧而生: 文本模型在 4-bit 精度下约占 1 GB。
- 全新的自研旗舰视觉与音频编码器。
- 文本模型支持 256K 上下文窗口。
- 专为特化而设计: 每个模型都能在单张 GPU 上微调。
LFM3 系列模型是特化智能的理想载体。用自己的数据微调,再部署到应用实际运行的地方。祝你阅读愉快。
表达能力更强的新架构
LFM2 证明了短卷积与注意力混合的架构可以在端侧快速运行,同时不牺牲质量。它的设计来自我们的自动化硬件在环架构搜索。到了 LFM3,我们用这套搜索针对 agentic 场景重新设计了该架构——这类场景要求每个参数承载更多能力,并且能在长上下文上快速推理。
我们还扩大了硬件在环的范围:LFM2 时只有一台手机和一台笔记本上的 CPU,LFM3 则覆盖 14 种设备与后端组合——手机(Samsung Galaxy S26 Ultra 和 OnePlus 15)、Raspberry Pi 5、笔记本(Apple M4 Max 和 AMD Ryzen AI)、Arm 与 x86 云 CPU,以及 GPU 和高通 Hexagon NPU。
带门控的短卷积仍占一半以上的层。为了在不拖慢长上下文的前提下提升能力,我们尝试把其中一部分换成其他序列模块,结果滑动窗口注意力(SWA)在质量与速度之间取得了最好的平衡。下文提到的其他改动,只有在不带来明显速度损失、又能提升质量时,我们才保留下来。收益在长上下文上体现得最明显:按参数计,LFM3-1.7B 在各端侧设备上的短提示表现与 LFM2-1.2B 持平,而在上下文达到 8K token 时约快 25%。
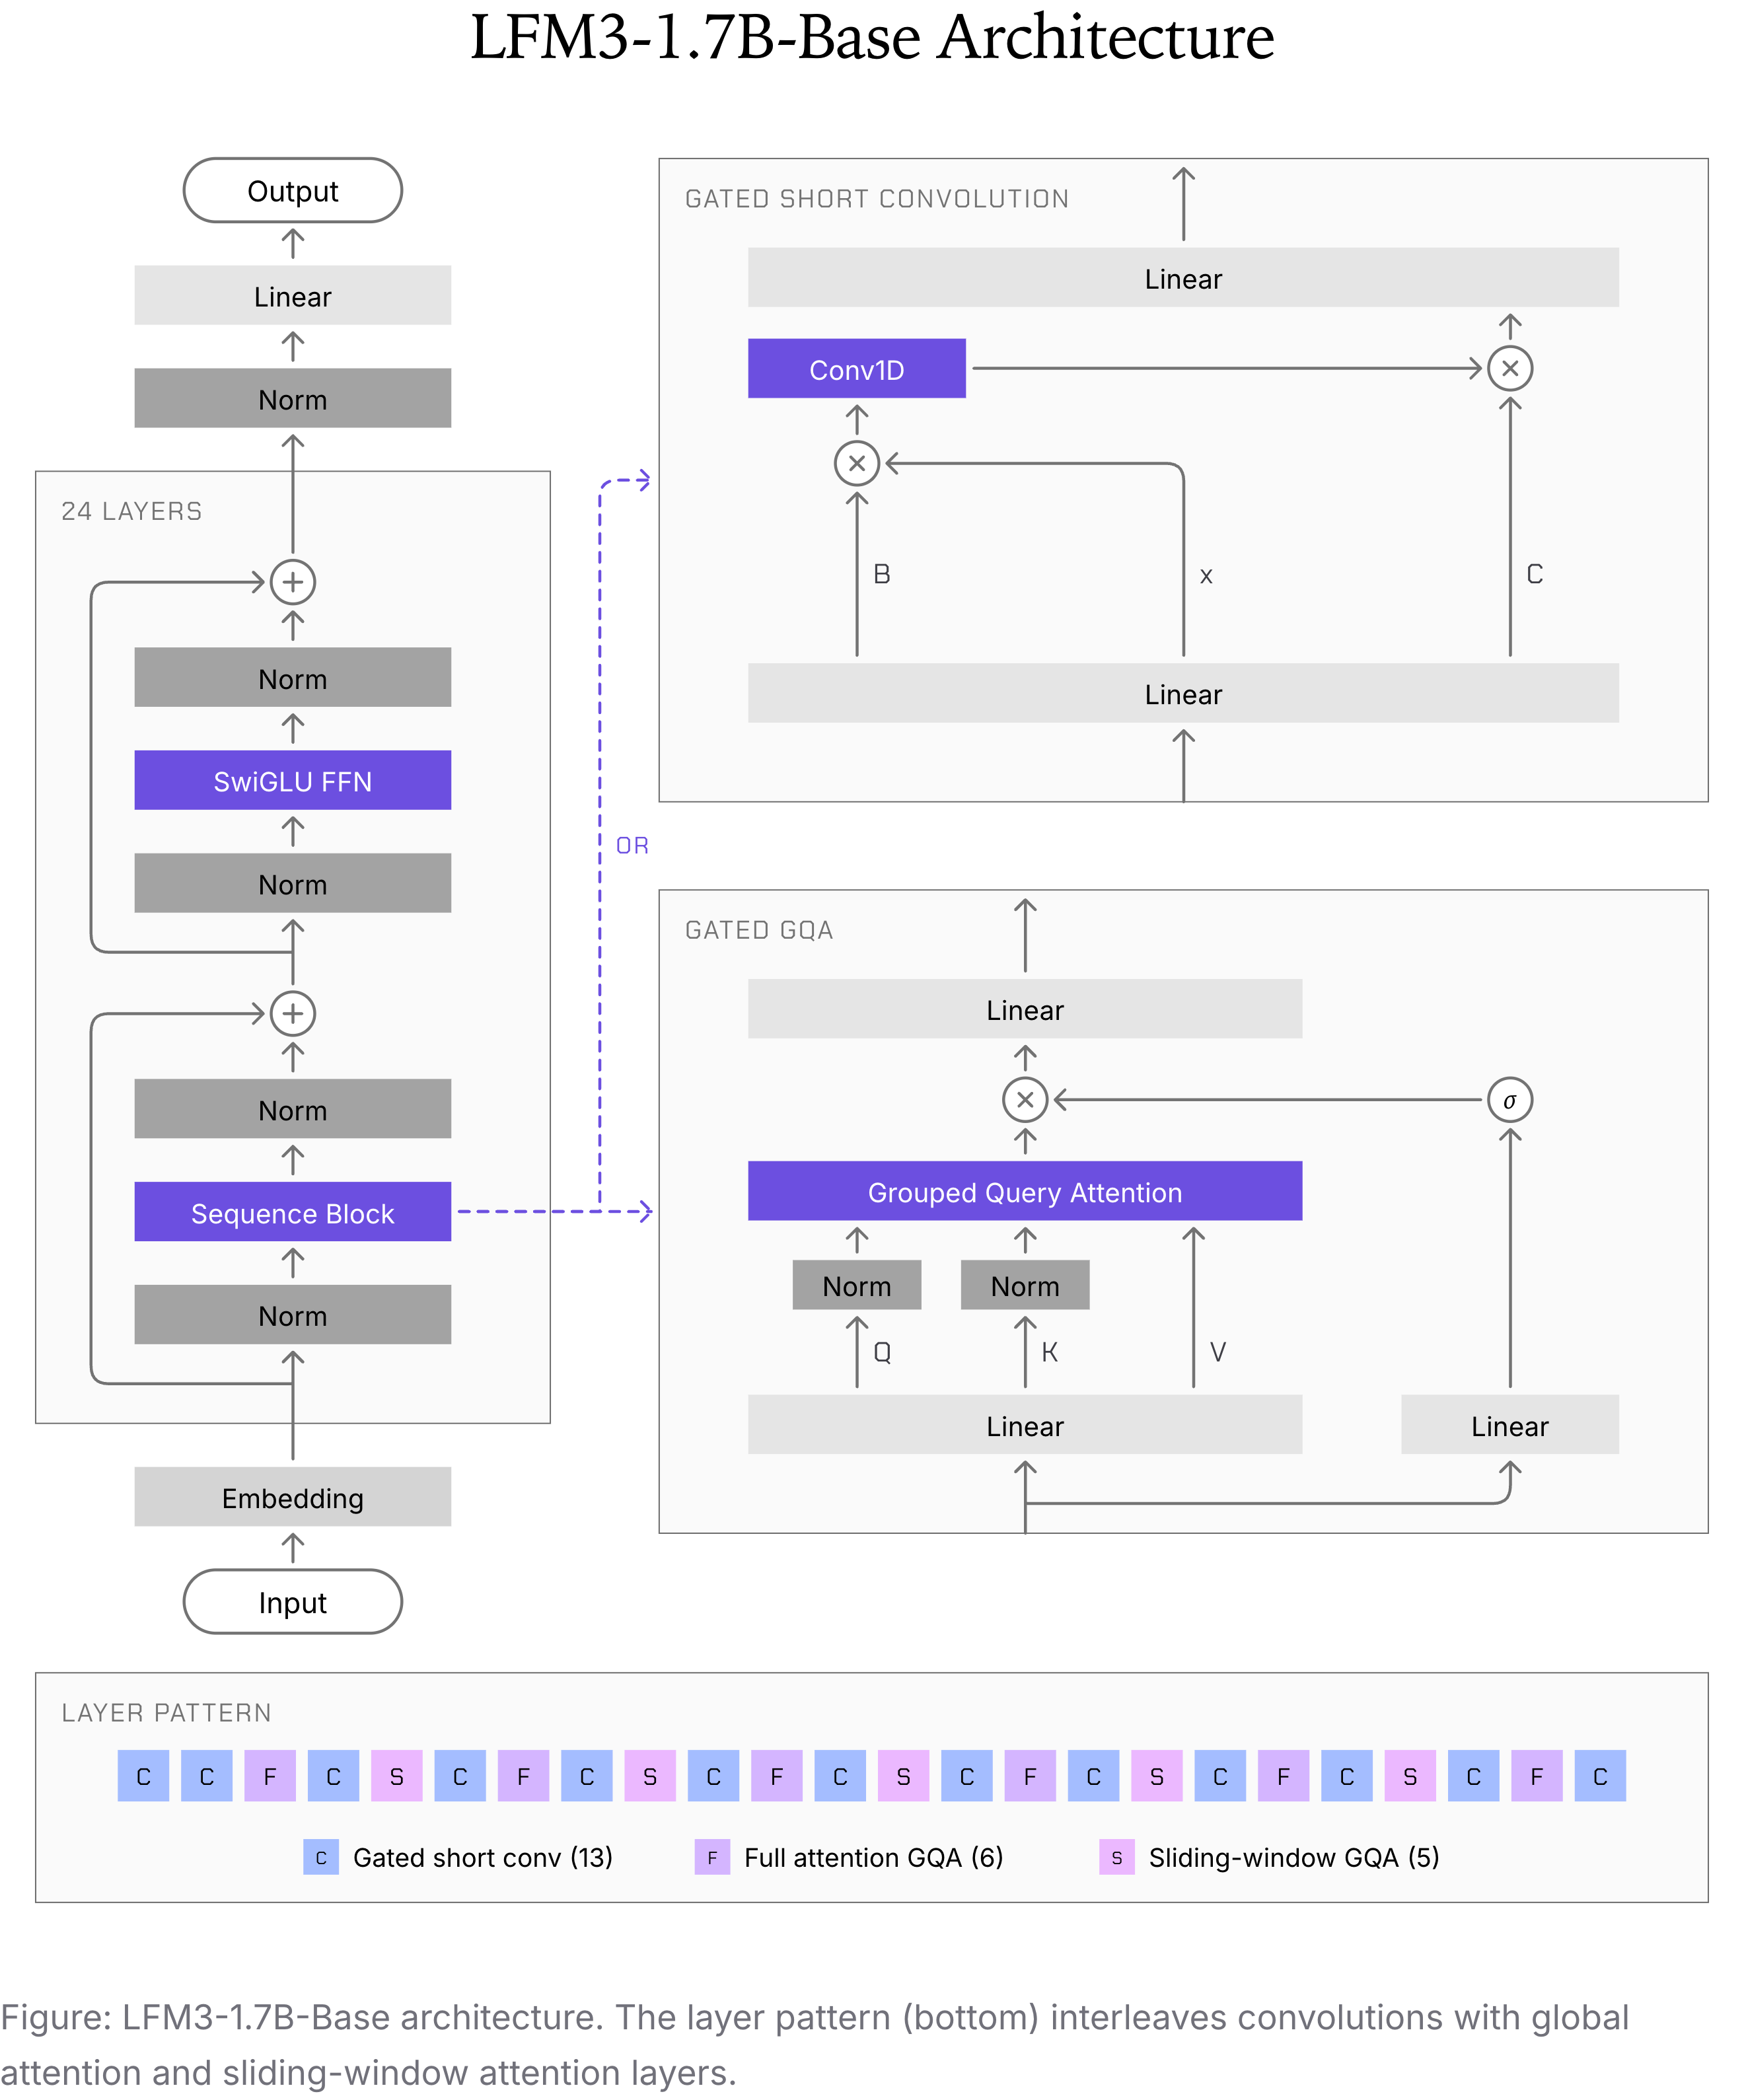
图:LFM3-1.7B-Base 架构。层模式(底部)将卷积层与全局注意力层、滑动窗口注意力层交错排列。
三混合层组合。 LFM3 组合了三种算子:门控短卷积、滑动窗口注意力(SWA)和全局注意力。24 层中有 13 层是卷积,5 层是窗口为 256 token 的 SWA,6 层是全局注意力。卷积的 kernel size 也从 LFM2 的 3 提升到 7。
逐头门控注意力。 一个 sigmoid 门控对每个头的输出做缩放,头在没有可补充的信息时可以直接关闭。这有助于抑制激活离群值——它们会损害量化——并提升训练稳定性。
部分 RoPE。 全局注意力层只对每个头中频率最高的那一半做旋转,低频的一半保持不旋转,因此这些维度无论距离多远都能按内容匹配。SWA 层保留完整的 RoPE。
Sandwich norm。 每个块对输入和输出都做归一化,有助于让激活值保持在合适的尺度上。
LFM3 沿用 LFM2.5-8B-A1B 的 128K 词表,该词表针对非拉丁文字的 tokenize 效率做了优化。
训练。 LFM3-1.7B-Base 在 22T token 上完成预训练。与 LFM2 相比,数据配比中增加了更多科学论文、仓库级代码和更广泛的知识来源,数学内容也明显更多。最后 3.5T token 是 mid-training 阶段,使用经过筛选的更高质量数据,其中 agentic trace 和多样化工具调用的占比更高,为模型的 agentic 后训练做准备。这一阶段还把上下文窗口扩展到 256K token。
覆盖各类需求的多模态家族
LFM3 的首个版本包含六个模型,全部从同一个 LFM3-1.7B-Base 主干分支而来,参数量都在 2B 左右。其中四个覆盖不同的输入模态(文本、视觉、音频和 omni),最后两个是从视觉模型和 omni 模型专门化而来的决策模型。你不需要跑一个大型通用模型,而是可以挑一个适合自己用例的模型,做定制,然后在设备端运行。
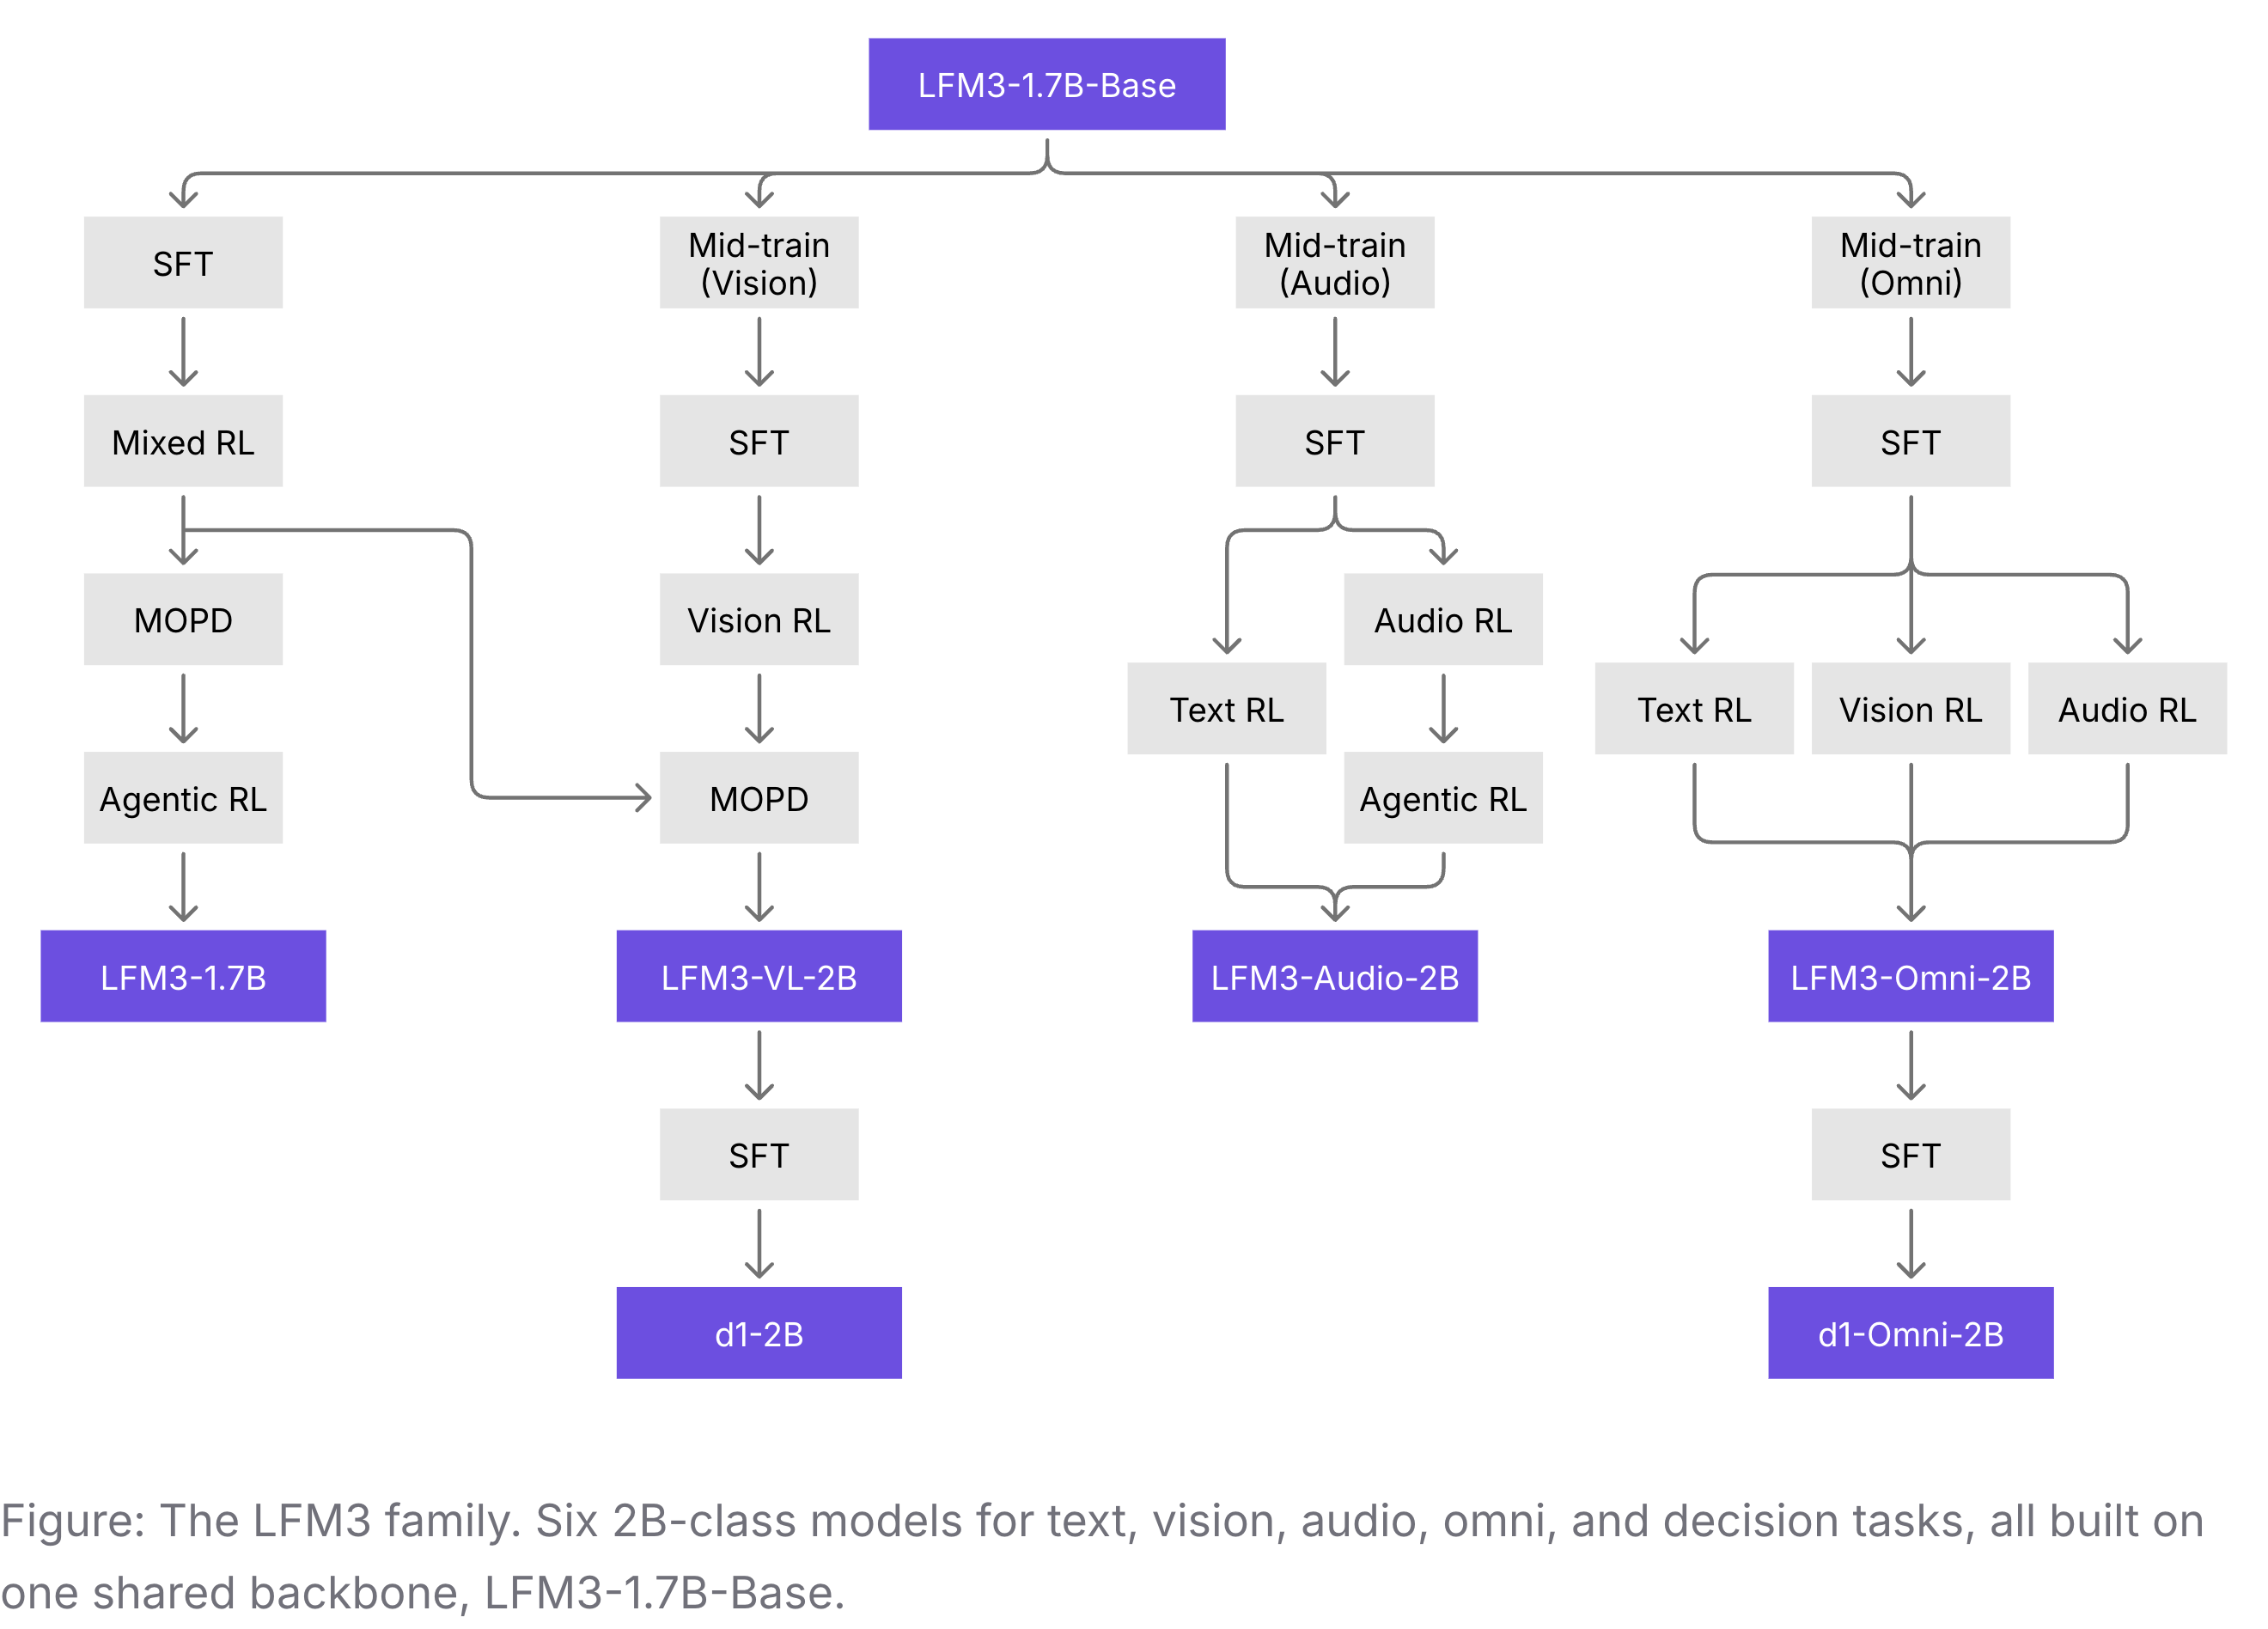
图:LFM3 家族。六个 2B 级模型,覆盖文本、视觉、音频、omni 和决策任务,全部构建在同一个共享骨干 LFM3-1.7B-Base 之上。
关于这些模型背后的性能与推理结果,详见各自的 model card。
随着 AI 不断从云端走向客户端,开发者需要能在各类 AI PC 上高效部署的模型。Liquid AI 的 LFM3 系列将强大的多模态能力与紧凑的体积相结合,非常适合端侧 AI 体验。AMD 已与 Liquid AI 在多个代际的模型上紧密合作,我们很高兴看到 LFM3 为在搭载 AMD Ryzen™ AI 处理器的系统上本地运行专用 AI 应用带来了更多可能。
在各行各业,边缘 AI 正从运行专用的检测与感知模型,转向同时承载多种 AI 工作负载,包括视觉语言模型、自然语言界面和多模态推理。难点在于要在边缘设备的算力、内存和功耗限制内实现这些能力。LFM3 将文本、视觉和音频整合进一套为高效部署而设计的统一架构,并以开放权重发布,开发者可针对具体应用进行微调。开发者已经可以通过 Cooper Model Garden 在 Ambarella 芯片上运行 Liquid AI 的 LFM2.5-VL 模型,我们也已开始在同一平台上支持 LFM3。
下一代 AI 将更加多模态、更加个性化、更加注重隐私,同时分布在设备与云端之间。Liquid AI 的 LFM3 系列朝着这个方向迈出了令人振奋的一步,我们很高兴携手合作,为搭载 Snapdragon® 处理器的设备带来快速、高效且富有创新的 AI 体验。
文本
LFM3-1.7B 是一个面向本地 agent 和专用应用的文本模型,上下文窗口为 256K token。
它经过后训练,可在 Hermes Agent、Pi、OpenClaw 等 agent 框架中运行。它能整理收件箱、管理日历、在网上调研主题、通过 WhatsApp 给你发送晨间简报,还能借助工具搜索,从数千个选项中找出合适的工具。由于 token 不产生费用,几十个 agent 可以持续在后台运行。只需在单张 GPU 上进行一次短时间的微调,就能让它适配你的领域、框架和工具。
| 基准测试 | LFM3-1.7B (1.7B) | LFM2.5-2.6B (2.6B) | MiniCPM5 2B (2.5B) | Gemma 4 E4B (8B) | Qwen3.5 4B (4.7B) | Qwen3.5 9B (9.7B) |
|---|---|---|---|---|---|---|
| Agents | ||||||
| LiveClaw | 45.60 | 14.70 | 30.37 | 20.36 | 19.94 | 35.77 |
| Claw-Eval General (EN), average | 68.64 | 62.63 | 60.74 | 56.14 | 61.96 | 66.53 |
| Claw-Eval General (EN), pass^3 | 51.40 | 37.52 | 34.58 | 22.43 | 42.99 | 51.87 |
| BrowseComp-Plus (OpenClaw subset) | 37.00 | 26.33 | 16.83 | 21.00 | 24.67 | 38.00 |
| WebArena-Verified | 38.42 | 3.02 | 9.11 | 17.06 | 21.92 | 28.94 |
| EnterpriseOps-Gym | 28.20 | 7.94 | 13.41 | 9.86 | 25.96 | 28.97 |
| AutomationBench (public) | 41.29 | 0.94 | 4.71 | 1.92 | 8.67 | 15.10 |
| Tool use | ||||||
| BFCL V4 | 71.39 | 55.89 | 62.65 | 48.25 | 55.12 | 62.83 |
| ToolSandbox | 80.36 | 78.04 | 68.16 | 69.27 | 75.40 | 76.41 |
| MCP-Atlas | 32.57 | 16.45 | 26.38 | 6.19 | 41.37 | 42.67 |
| τ³-bench | 68.01 | 56.77 | 69.44 | 33.53 | 65.98 | 67.11 |
| Agentic coding | ||||||
| SWE-bench Verified (OpenCode) | 43.40 | 18.00 | 34.80 | 0.50 | 41.20 | 51.20 |
| SWE-bench Multilingual (OpenCode) | 23.00 | 8.00 | 15.67 | 0.67 | 23.33 | 35.00 |
| Terminal-Bench 2.1 (OpenCode) | 12.92 | 0.00 | 5.62 | 0.00 | 13.48 | 17.98 |
| Coding | ||||||
| LiveCodeBench v6 | 73.46 | 60.57 | 70.52 | 71.00 | 61.99 | 69.86 |
| LiveCodeBench Pro 25Q2 | 31.74 | 19.16 | 29.34 | 29.94 | 24.25 | 34.43 |
| SciCode | 28.47 | 16.32 | 27.78 | 25.00 | 23.02 | 31.60 |
| Instruction following | ||||||
| IFEval | 96.66 | 95.39 | 87.83 | 90.02 | 92.52 | 92.08 |
| IFBench | 73.03 | 60.48 | 62.08 | 44.56 | 38.16 | 48.84 |
| IFStruct | 93.72 | 82.18 | 72.65 | 78.45 | 87.05 | 89.20 |
| Multi-IF | 89.10 | 84.80 | 73.19 | 81.03 | 80.32 | 84.44 |
| Knowledge | ||||||
| GPQA Diamond | 63.37 | 57.78 | 65.15 | 57.88 | 75.76 | 80.40 |
| Humanity's Last Exam (no tools) | 7.17 | 5.88 | 8.20 | 4.77 | 12.84 | 16.41 |
| Humanity's Last Exam (with tools) | 13.90 | 9.60 | 11.50 | 6.00 | 11.60 | 17.50 |
| AA-Omniscience (public) | 0.50 | -33.17 | -5.00 | -15.33 | -57.17 | -28.00 |
| AA-Omniscience accuracy (public) | 7.07 | 8.75 | 9.13 | 9.83 | 15.67 | 13.17 |
| AA-Omniscience non-hallucination (public) | 92.93 | 53.69 | 84.44 | 72.09 | 13.64 | 52.59 |
| Long context | ||||||
| AA-LCR | 52.83 | 6.00 | 49.34 | 39.33 | 52.67 | 62.00 |
| RULER 128K | 65.56 | 1.15 | 37.96 | 18.82 | 84.63 | 87.11 |
| Average | 49.37 | 31.55 | 39.19 | 31.74 | 39.27 | 47.24 |
在 agentic 任务上,LFM3-1.7B 能与体积数倍于己的模型一较高下。在 BFCL 和 ToolSandbox 上,它在指令遵循和函数调用方面领先,并在浏览器与业务应用的长任务(WebArena-Verified、AutomationBench)中胜过 Qwen3.5-9B。在 agentic 编程和知识类任务上,更大的模型仍然占优——这两类任务最吃模型规模——但搜索能帮助缩小知识差距,使其在 Humanity's Last Exam 上的得分接近翻倍。
为取得这些结果,模型经历了四个阶段的后训练:
- 监督微调(SFT): 覆盖各类任务共 1.75T token,包括对话、推理、工具调用和 agentic 轨迹。
- 混合强化学习: 同时训练多个领域,从数学、代码到 SQL 和结构化输出。奖励中的长度惩罚让回答保持简洁。
- 多领域同策略蒸馏(MOPD): 六个专家 RL 教师(代码、数学、工具使用、长上下文、agentic 工作、企业工作流)被蒸馏回单一模型。
- Agentic RL: 从网页浏览到办公工作的任务都在真实的 agent harness 中运行,为部署做好准备。
在端侧,我们用 llama.cpp 在 Q4_0 和 32K token 上下文下测量指标。LFM3-1.7B 在三台设备上都是最快的模型,解码速度比第二名快 1.8 到 2.8 倍,内存占用也最低。长上下文依然便宜:完整的 128K token 上下文需要 1.6 GB KV cache,而 Qwen3.5-4B 需要 4.3 GB,MiniCPM5-2B 需要 5.6 GB。
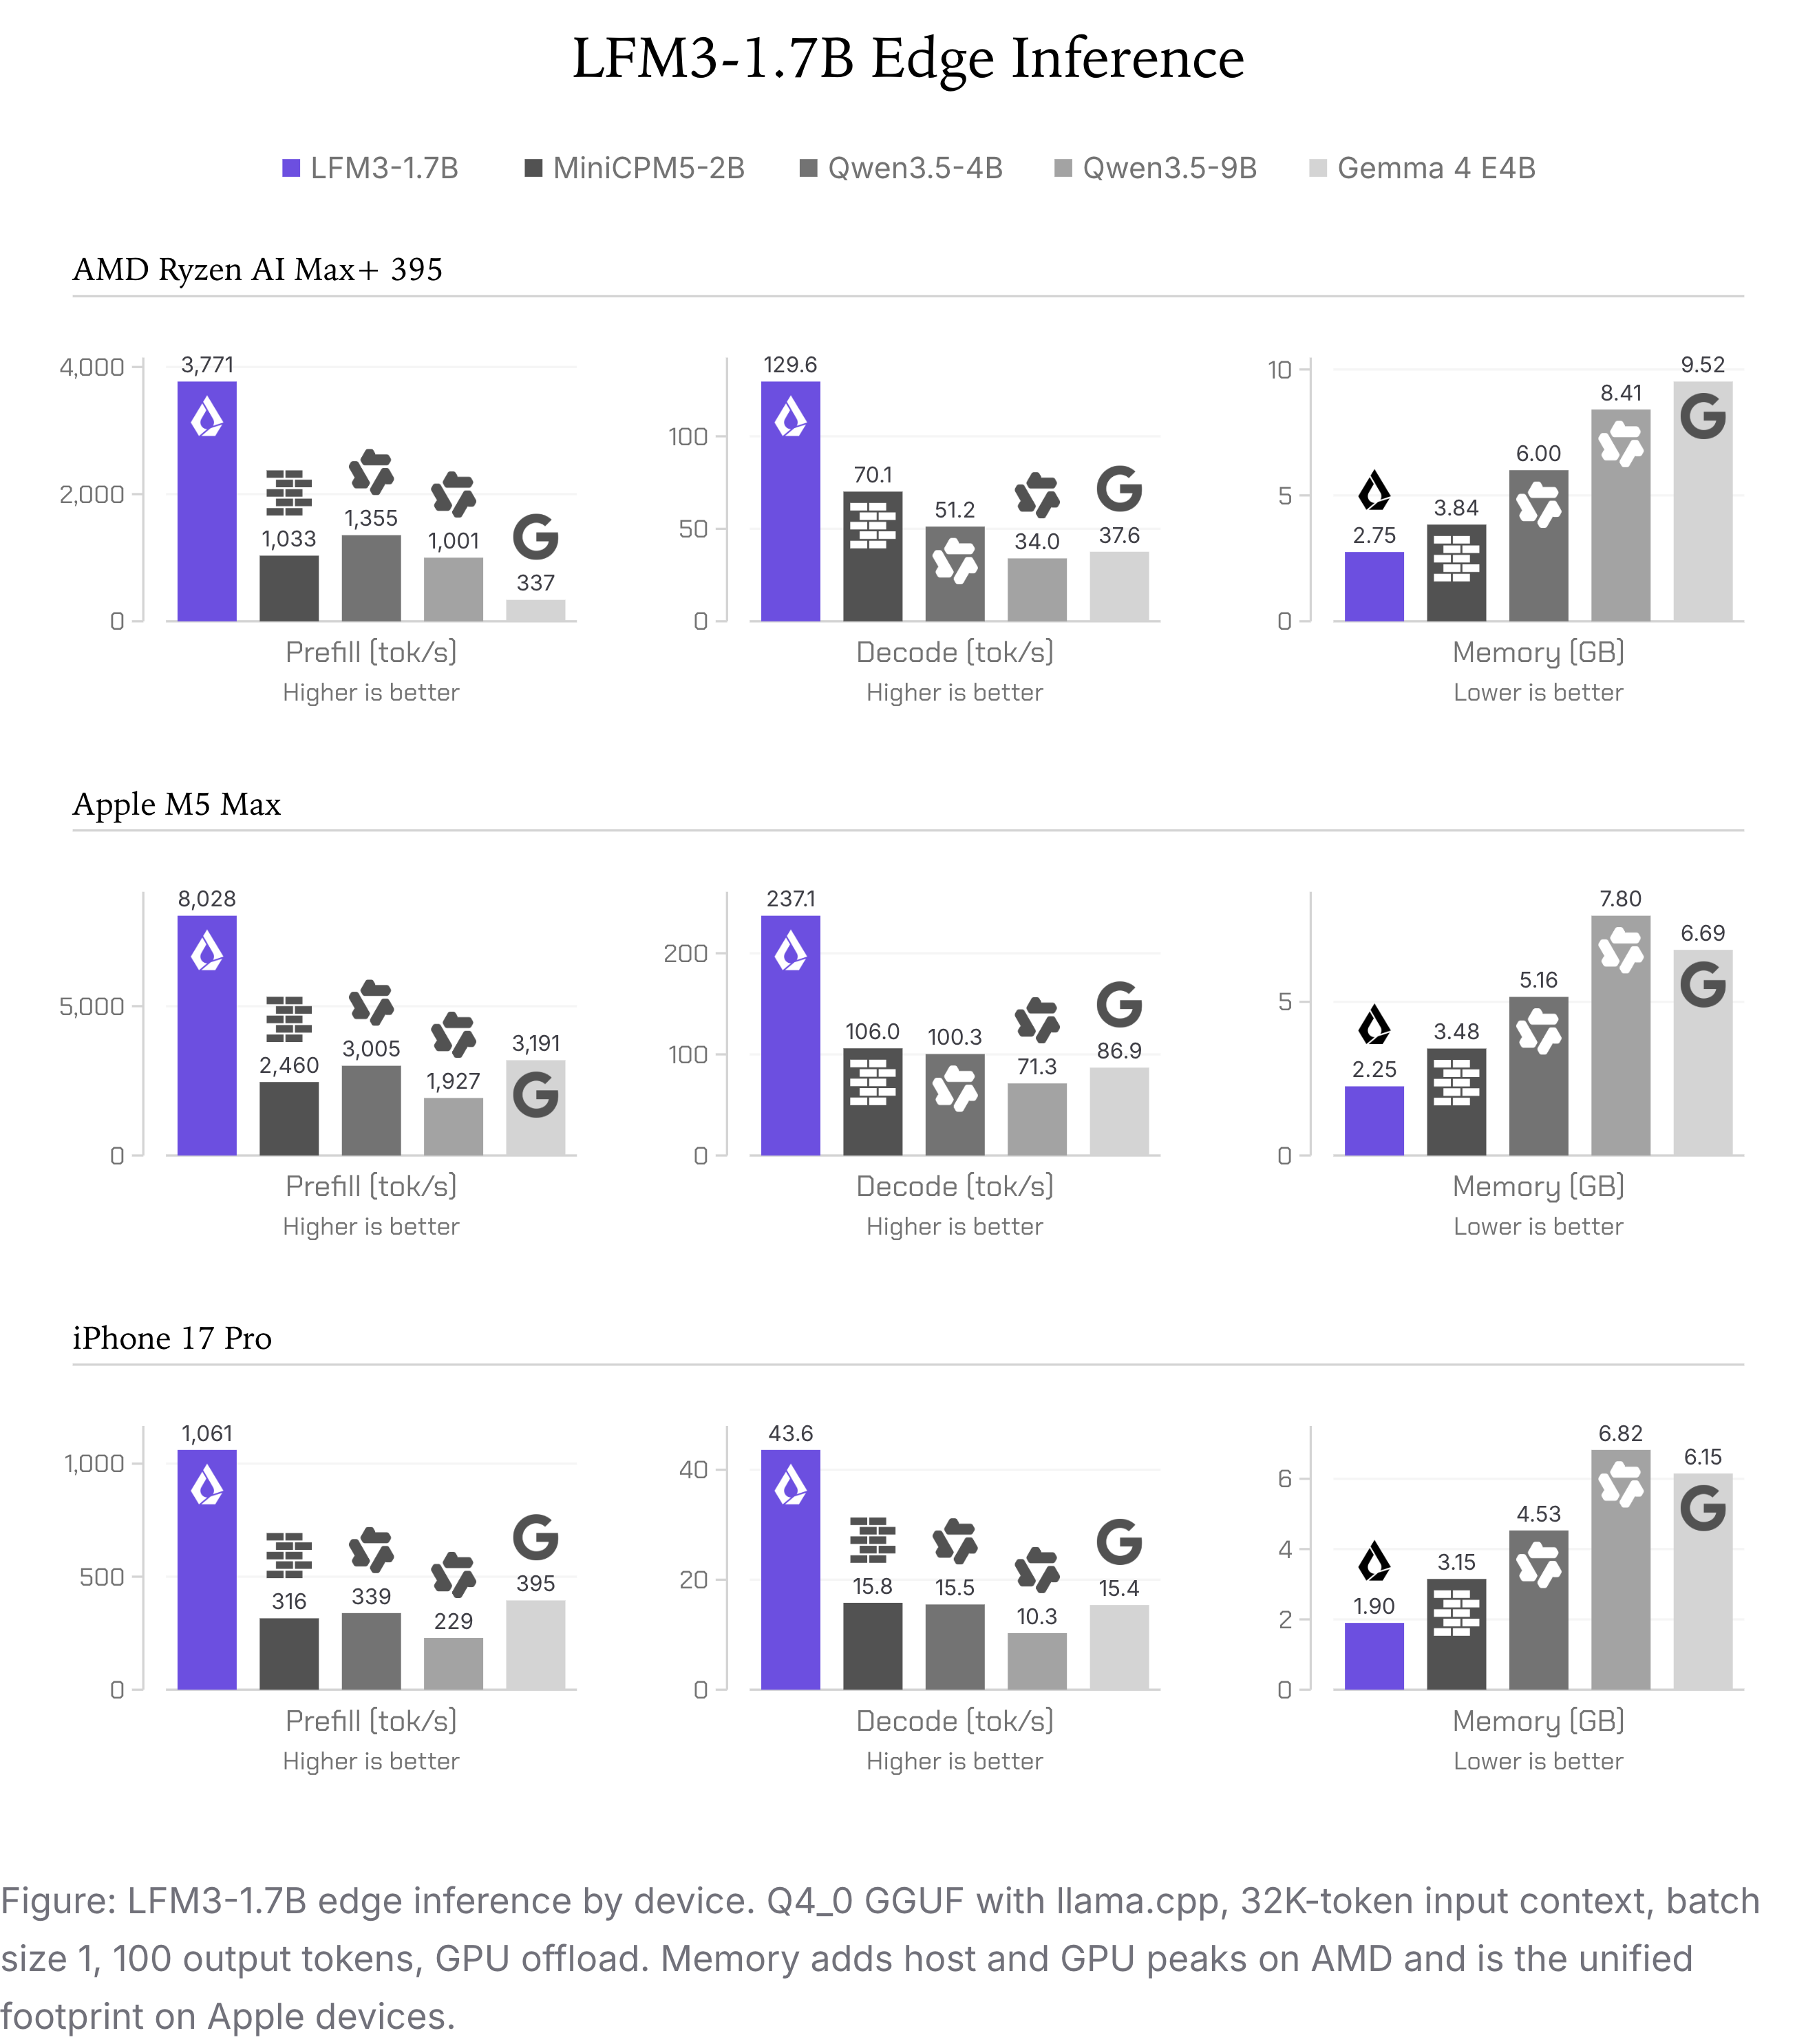
图:LFM3-1.7B 按设备划分的端侧推理。Q4_0 GGUF,llama.cpp,32K token 输入上下文,batch size 1,输出 100 token,GPU offload。AMD 上的内存为 host 与 GPU 峰值之和,Apple 设备上为统一内存占用。
在单张 NVIDIA B300 上,使用 SGLang 以 BF16 运行,LFM3-1.7B 在 1,024 并发请求下每天可产出 36 亿 token,超过本次对比中的其他所有模型。
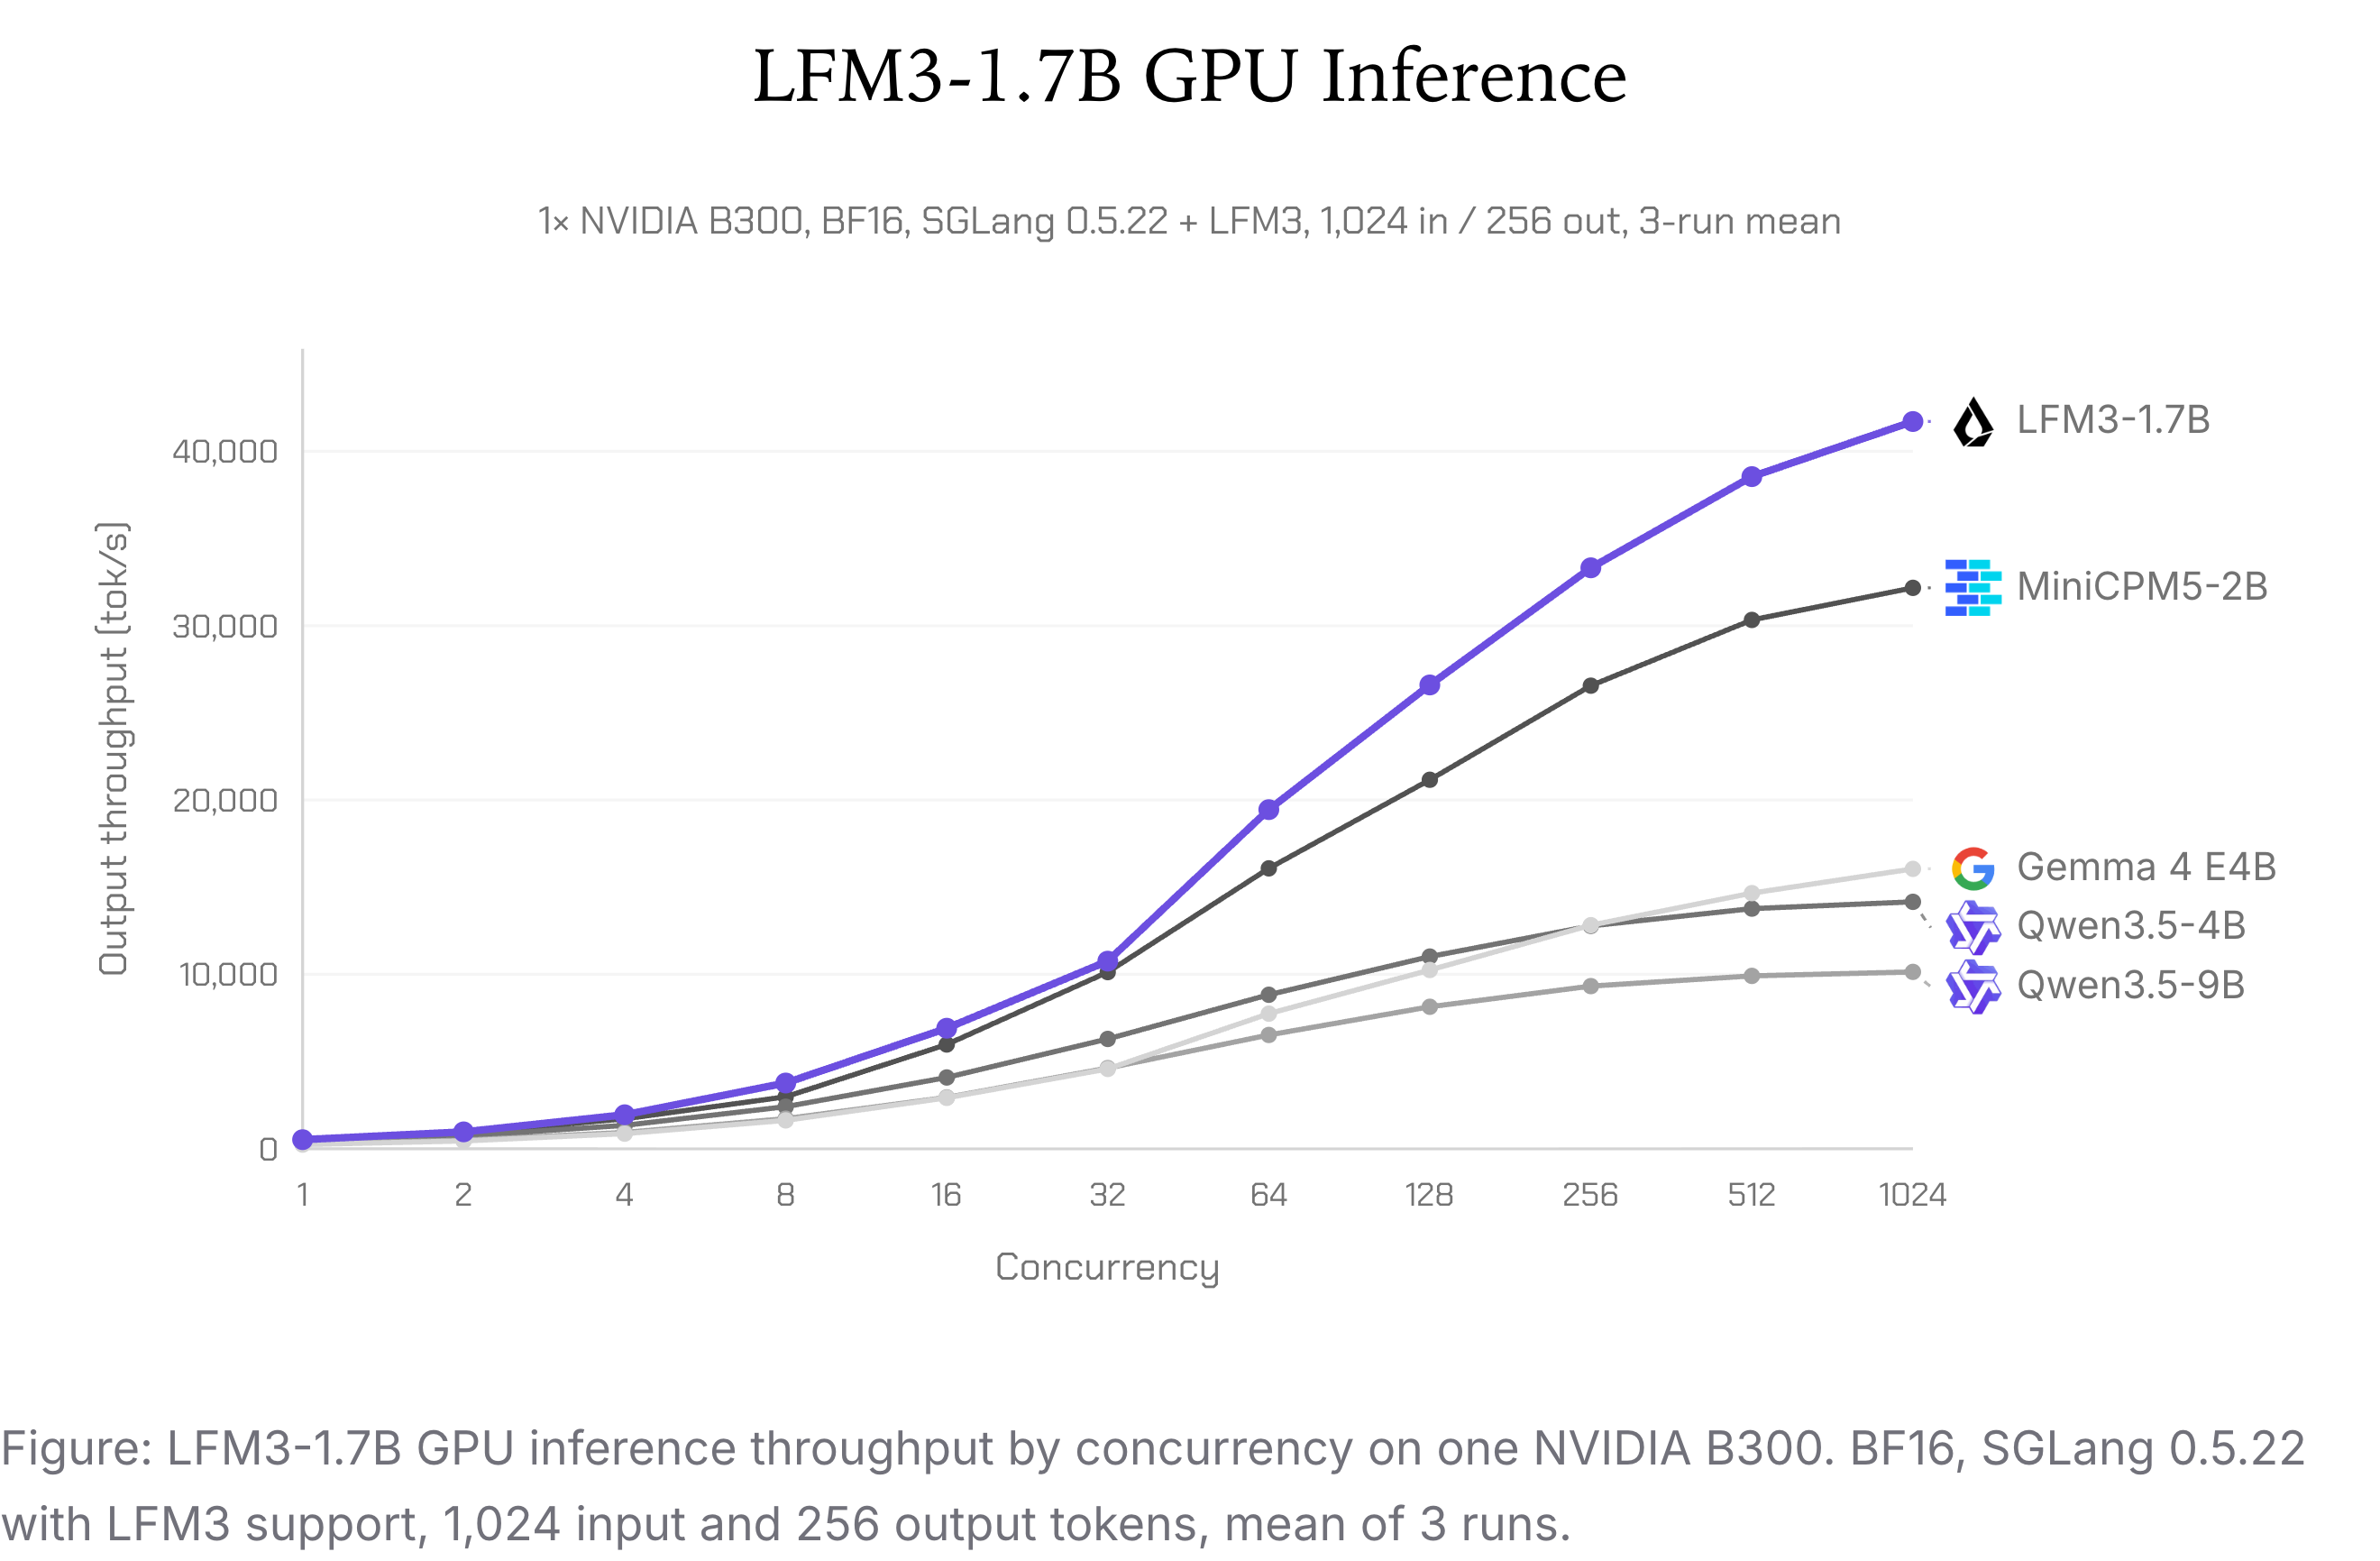
图:LFM3-1.7B 在单块 NVIDIA B300 上的 GPU 推理吞吐量随并发数的变化。BF16,SGLang 0.5.22(支持 LFM3),输入 1,024 token、输出 256 token,取 3 次运行的平均值。
为展示这样的吞吐量能支撑怎样的负载,我们并行运行了 30 多万个 LFM3-1.7B agent,对 Enron 邮件档案展开调查。
LFM3-1.7B 在随机流量下能以低延迟提供服务,在 Liquid RIPL 上运行时可以支撑在线欺诈检测这类实时场景。即使负载很重,P95 请求延迟依然稳定,表现优于在 vLLM 上提供服务的同类模型。
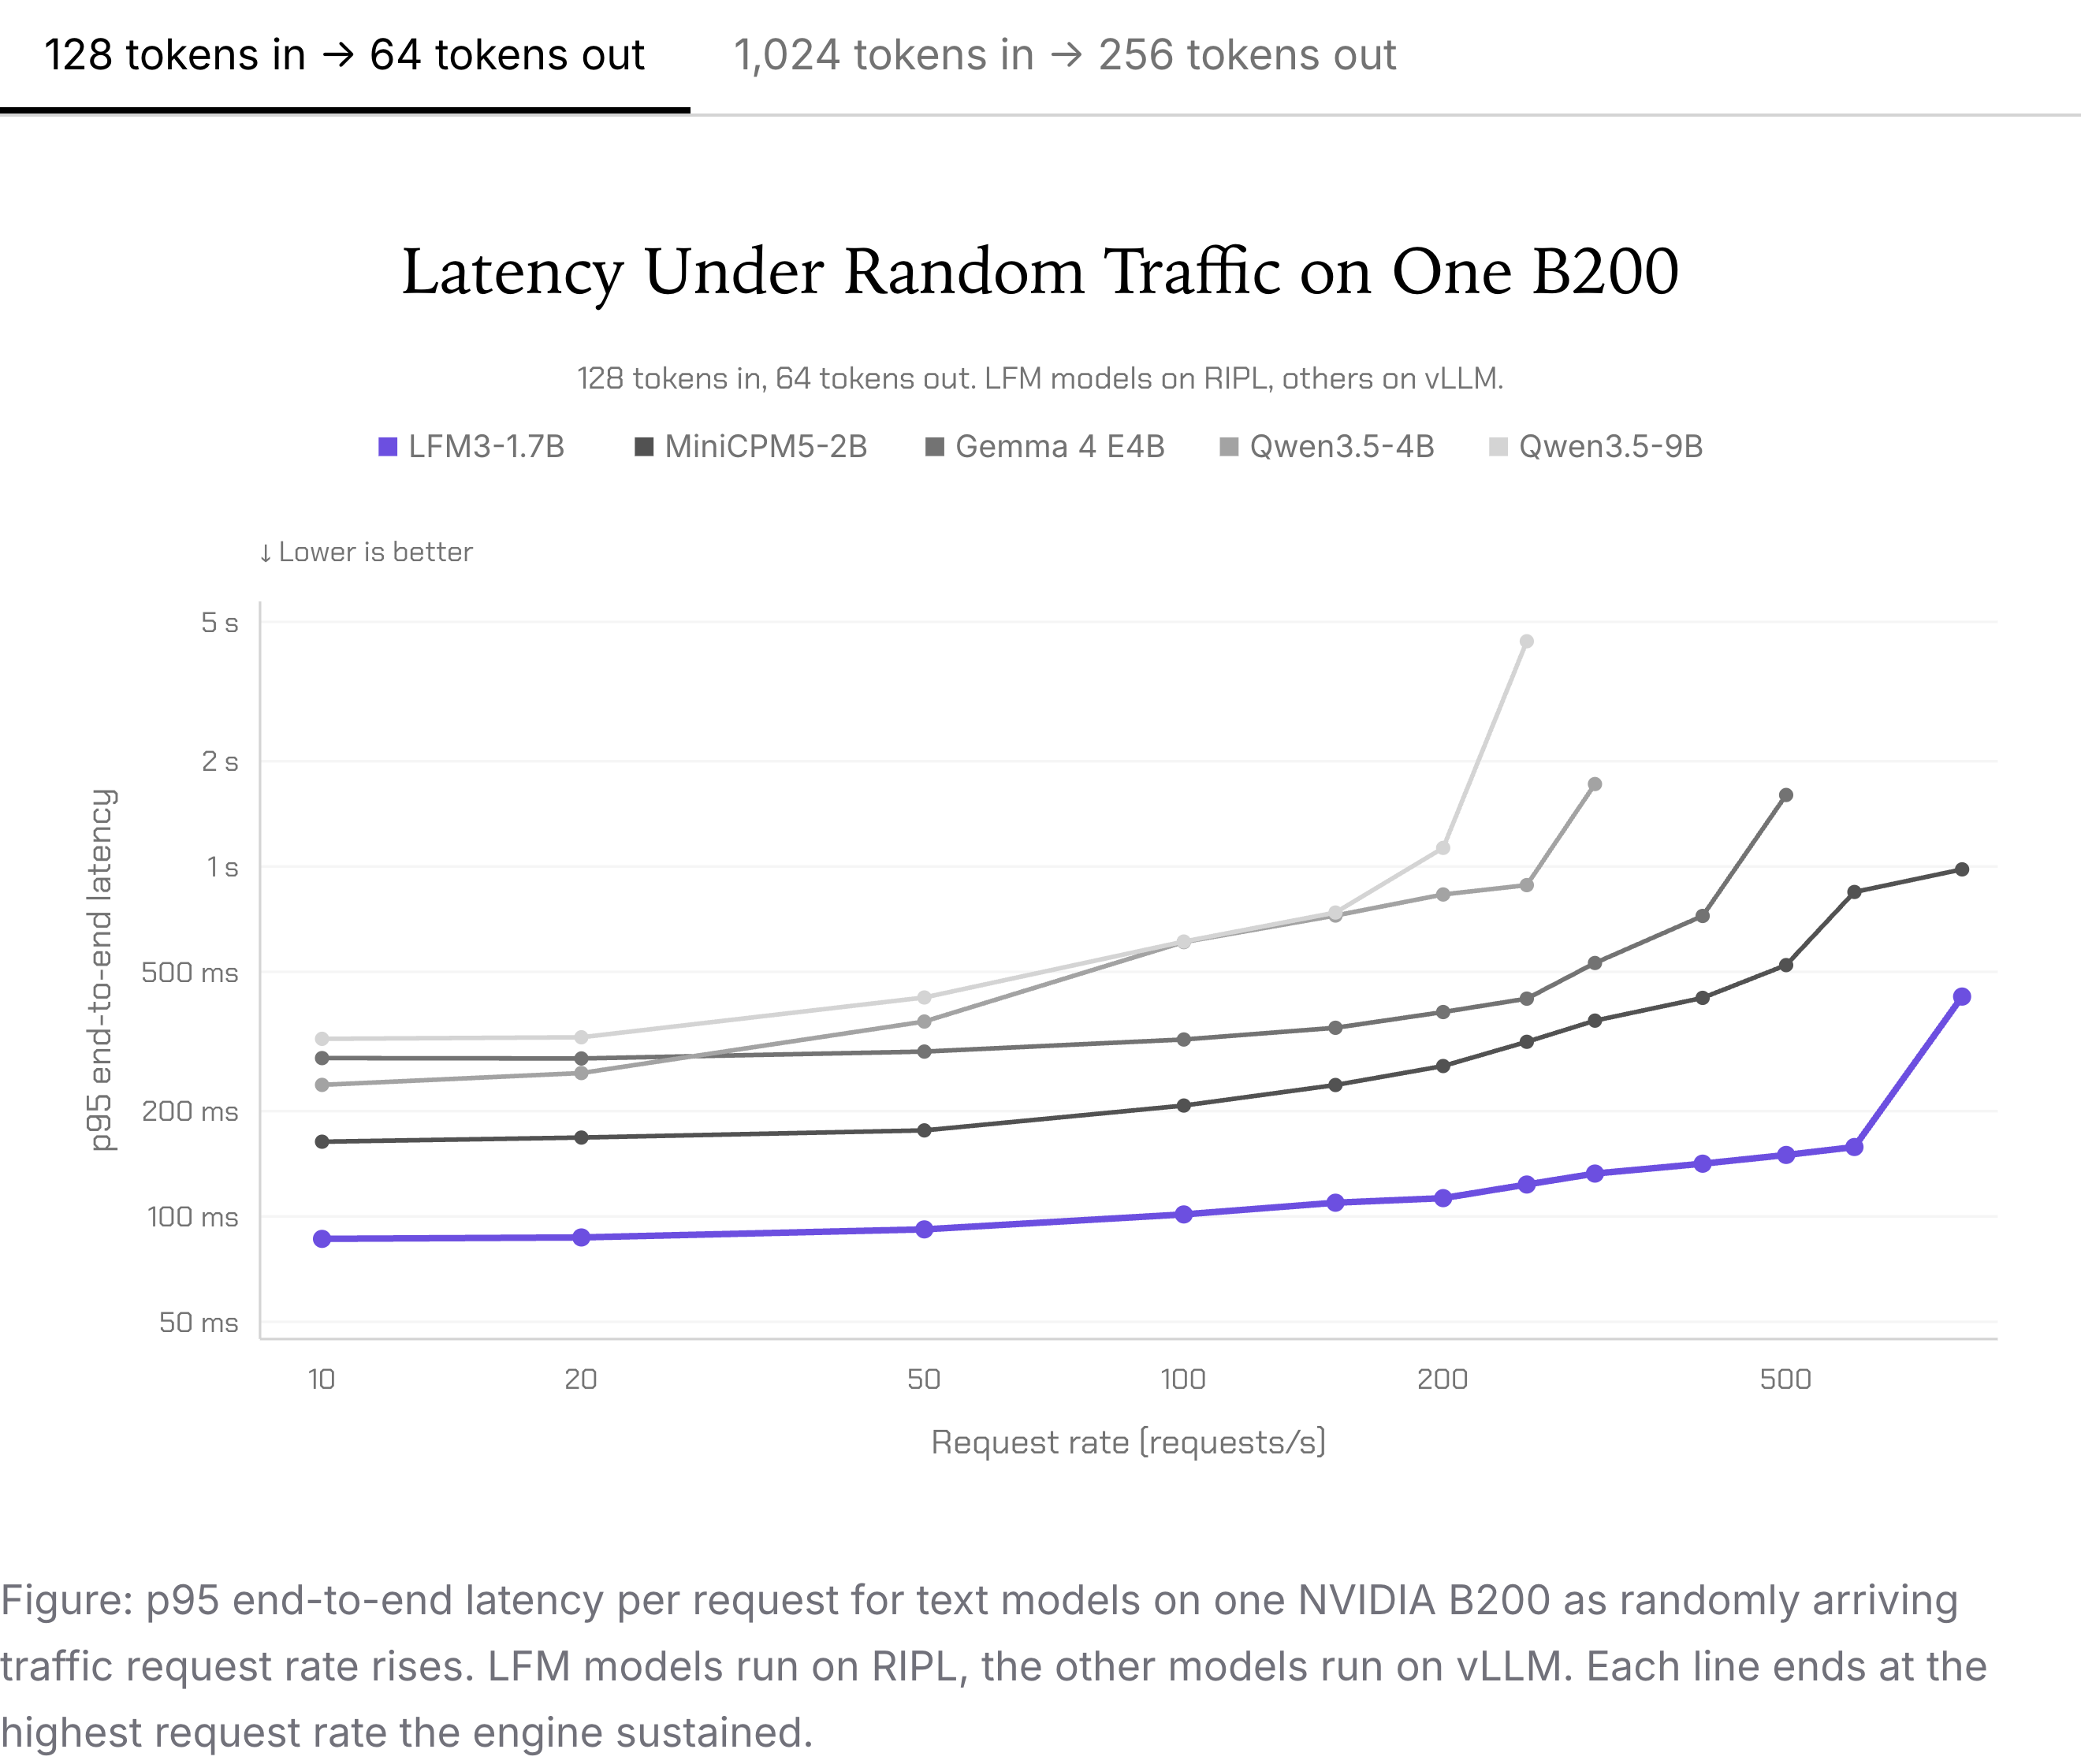
图:单张 NVIDIA B200 上,随着随机到达的流量请求速率上升,文本模型每个请求的 P95 端到端延迟。LFM 模型运行在 RIPL 上,其他模型运行在 vLLM 上。每条线的终点是该引擎所能承受的最高请求速率。
我们在真实的 macOS 环境中,用 65 个日常 agent 任务对比了 LFM3-1.7B 和 Qwen3.5-2B。更小的模型赢了:任务成功率 64% 对 48%,每个任务少用 58% 的 token,卡住的尝试不到 1%,而对手是 15%。小模型已经可以在 Mac 上承担真正的 agent 工作,LFM3 就是证明。LFM3 是我们测试过的第一个能在 Mac 上胜任真实 agent 工作的 sub-2B 模型——它在任务成功率上胜过更大的模型,同时少用 58% 的 token,几乎从不卡住。
视觉
LFM3-VL-2B 能观察、推理并理解物理世界:
- 视频理解: LFM 视觉模型首次支持视频输入。可以就录制的讲座、用手机拍的实景走查,或摄像头画面中的片段提问。
- 思考: 模型在回答前逐步推理。这有助于它更好地理解用户输入,解决更难的视觉问题,比如数学、图表和多步问题。
- 空间与具身推理: 模型能定位物体并推理它们之间的空间关系,这为下游机器人应用打下了坚实基础。
相比 LFM2.5-VL 系列,LFM3-VL-2B 的性能是一次跃升。在 62 项视觉基准上,LFM3-VL-2B 明显领先所有同尺寸模型至少 7.4 分;尽管体量不大,它的表现已与 Gemma 4 12B 持平——后者规模是它的 6 倍多——超过 Gemini 3.5 Flash Lite,与 GPT-5.6 Luna 相差不到 2 分。更多细节见模型卡。
| 基准类别 | LFM3-VL-2B (1.9B) | LFM2.5-VL-3B (3.1B) | MiniCPM-V 4.7 1B (1.6B) | Qwen 3.5 2B (2.3B) | Gemma 4 E2B (5.1B) | Gemma 4 12B (12B) | GPT-5.6 Luna | Gemini 3.5 Flash Lite |
|---|---|---|---|---|---|---|---|---|
| 通用 | 66.0 | 57.6 | 59.8 | 64.0 | 56.9 | 74.0 | 72.2 | 74.1 |
| 感知 | 75.6 | 67.9 | 65.5 | 71.2 | 59.1 | 73.5 | 71.0 | 73.0 |
| 文档、OCR 与图表 | 83.9 | 71.2 | 73.0 | 79.1 | 72.3 | 85.7 | 84.4 | 82.3 |
| 数学与逻辑推理 | 68.8 | 40.6 | 51.8 | 61.0 | 51.8 | 79.3 | 77.3 | 66.7 |
| 视觉定位 | 77.3 | 68.3 | 51.1 | 61.2 | 41.2 | 74.1 | 72.7 | 63.5 |
| 具身推理 | 64.4 | 48.0 | 45.3 | 51.2 | 41.5 | 59.1 | 61.5 | 50.3 |
| GUI 理解 | 83.1 | 66.0 | 45.3 | 67.2 | 44.3 | 76.1 | 82.5 | 71.0 |
| 视频 | 61.2 | 41.3 | 53.7 | 57.0 | 46.6 | 58.9 | 72.8 | 70.0 |
| 多语言 | 84.4 | 81.2 | 77.4 | 78.6 | 73.4 | 86.1 | 82.1 | 85.8 |
| Agentic | 42.5 | 21.1 | 16.9 | 15.2 | 23.8 | 43.6 | 56.1 | 62.4 |
| 平均 | 71.4 | 57.6 | 57.5 | 64.0 | 53.6 | 71.7 | 73.4 | 70.0 |
注:每个类别的分数是该类别下各基准分数的未加权平均值。平均行为全部 62 项评测的未加权平均值。
以上模型均可在设备端高效运行,因此日常使用智能能力时,数据无需离开设备,也无需连接云端。在设备端,与同尺寸级别的其他模型相比,LFM3-VL-2B 在所有实测设备上的 prefill 吞吐最高、内存占用最低。
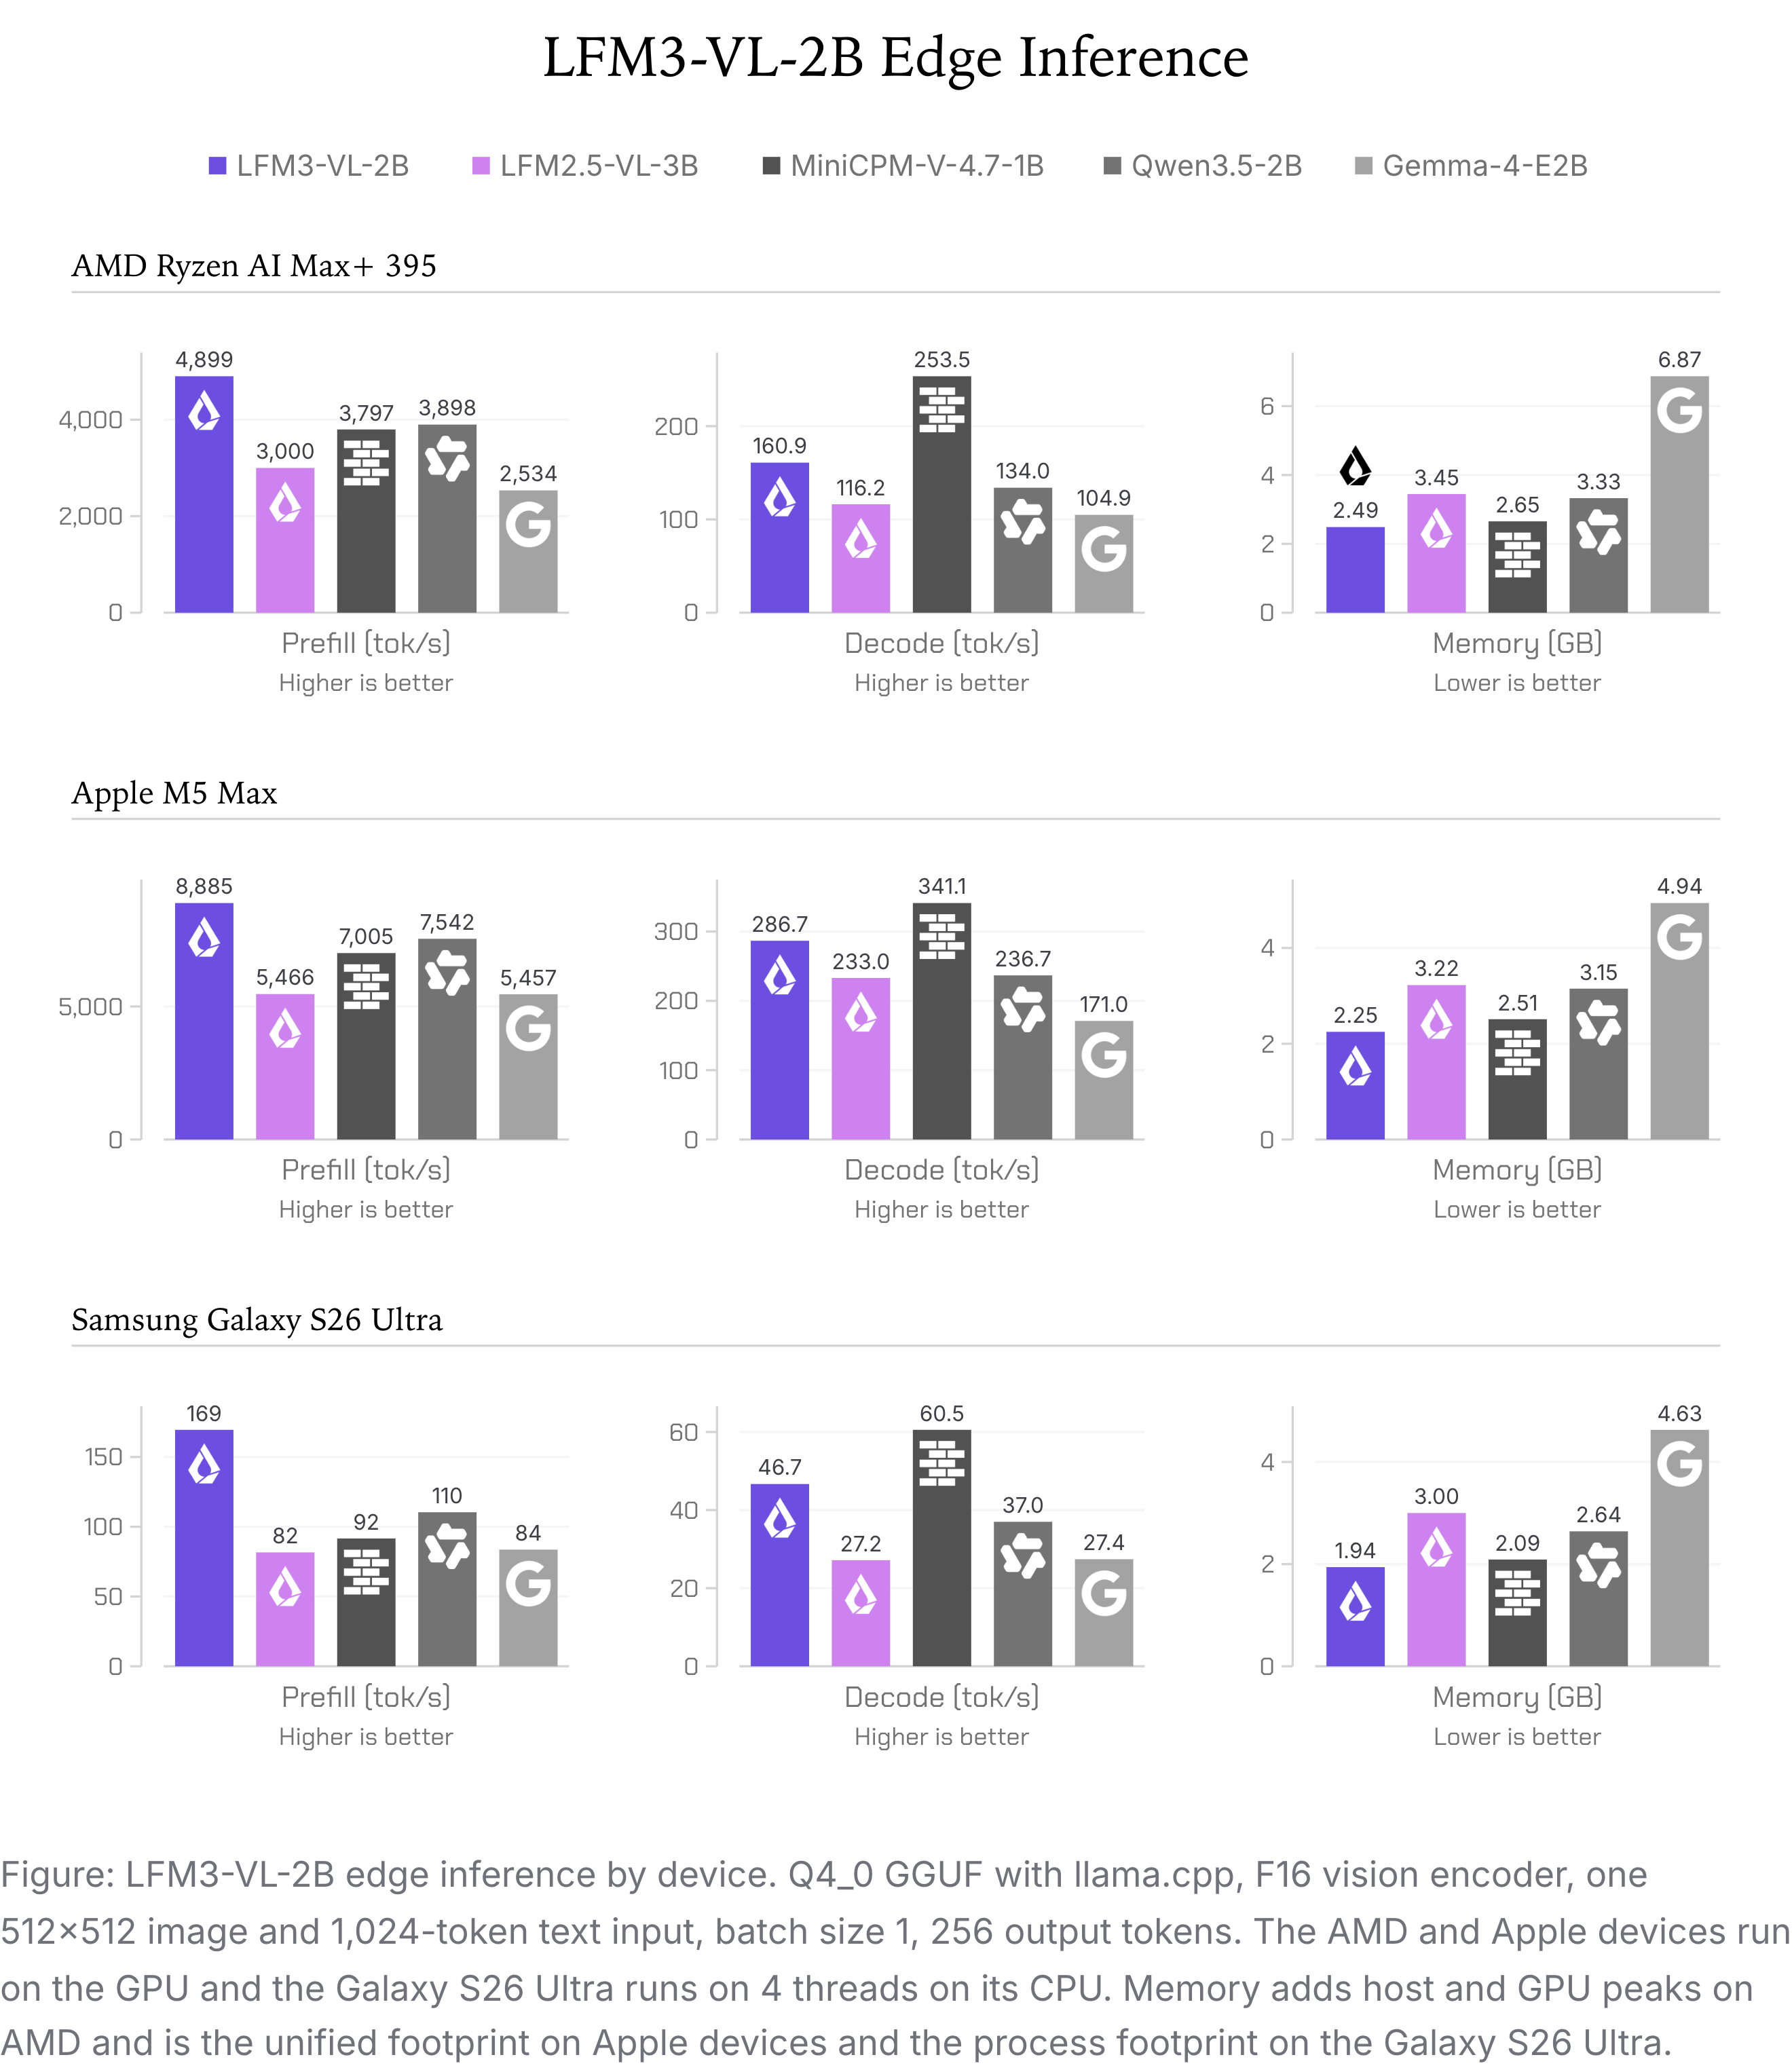
图:LFM3-VL-2B 按设备划分的边缘推理表现。Q4_0 GGUF 配合 llama.cpp,F16 视觉编码器,单张 512×512 图像与 1,024 token 文本输入,batch size 为 1,输出 256 token。AMD 与 Apple 设备使用 GPU 运行,Galaxy S26 Ultra 使用 CPU 的 4 个线程运行。AMD 上的内存为 host 与 GPU 峰值之和,Apple 设备上为统一内存占用,Galaxy S26 Ultra 上为进程内存占用。
在单张 NVIDIA B300 上,LFM3-VL-2B 使用 SGLang 以 BF16 精度运行,每秒可生成超过 12,000 个 token,超过同尺寸级别的任何其他模型。
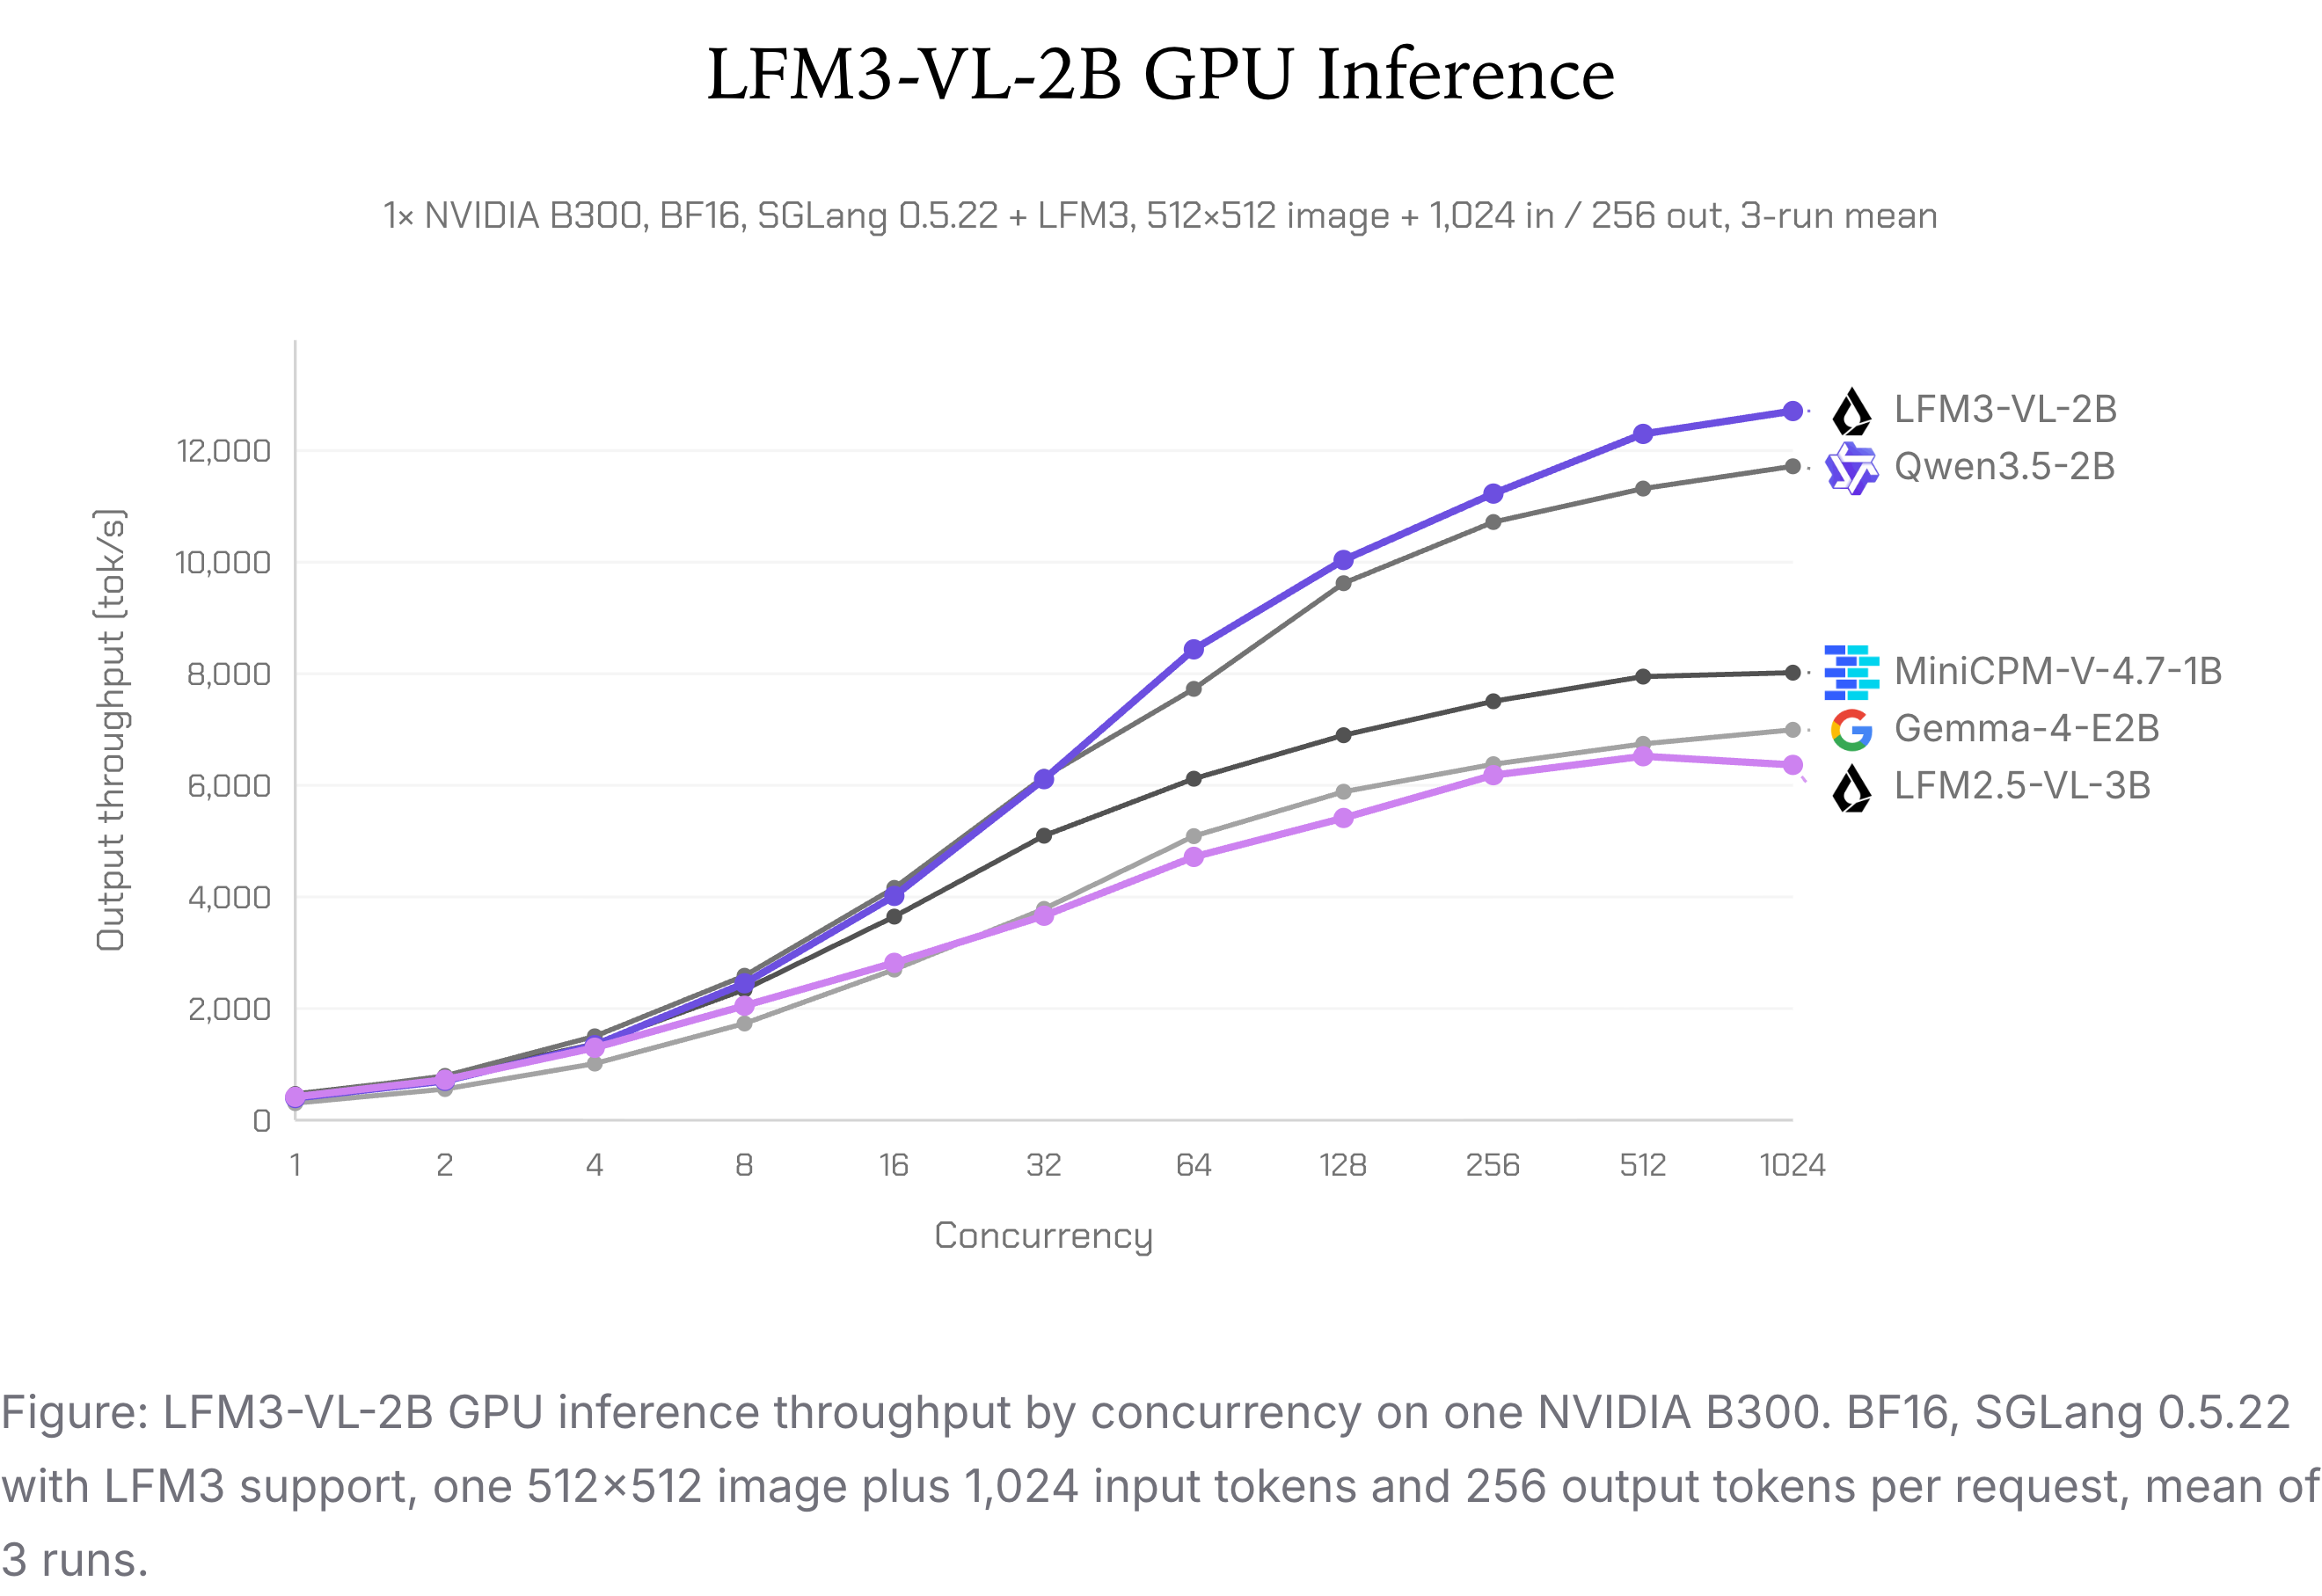
图:LFM3-VL-2B 在单张 NVIDIA B300 上按并发数统计的 GPU 推理吞吐。BF16 精度,SGLang 0.5.22(支持 LFM3),每个请求包含一张 512×512 图像、1,024 个输入 token 和 256 个输出 token,取 3 次运行的平均值。
在随机流量下,LFM3-VL-2B 能以低延迟提供服务,在 Liquid RIPL 上运行时,可用于图像素材打标等实时场景。即使在高负载下,P95 请求延迟依然稳定,优于在 vLLM 上部署的同类模型。
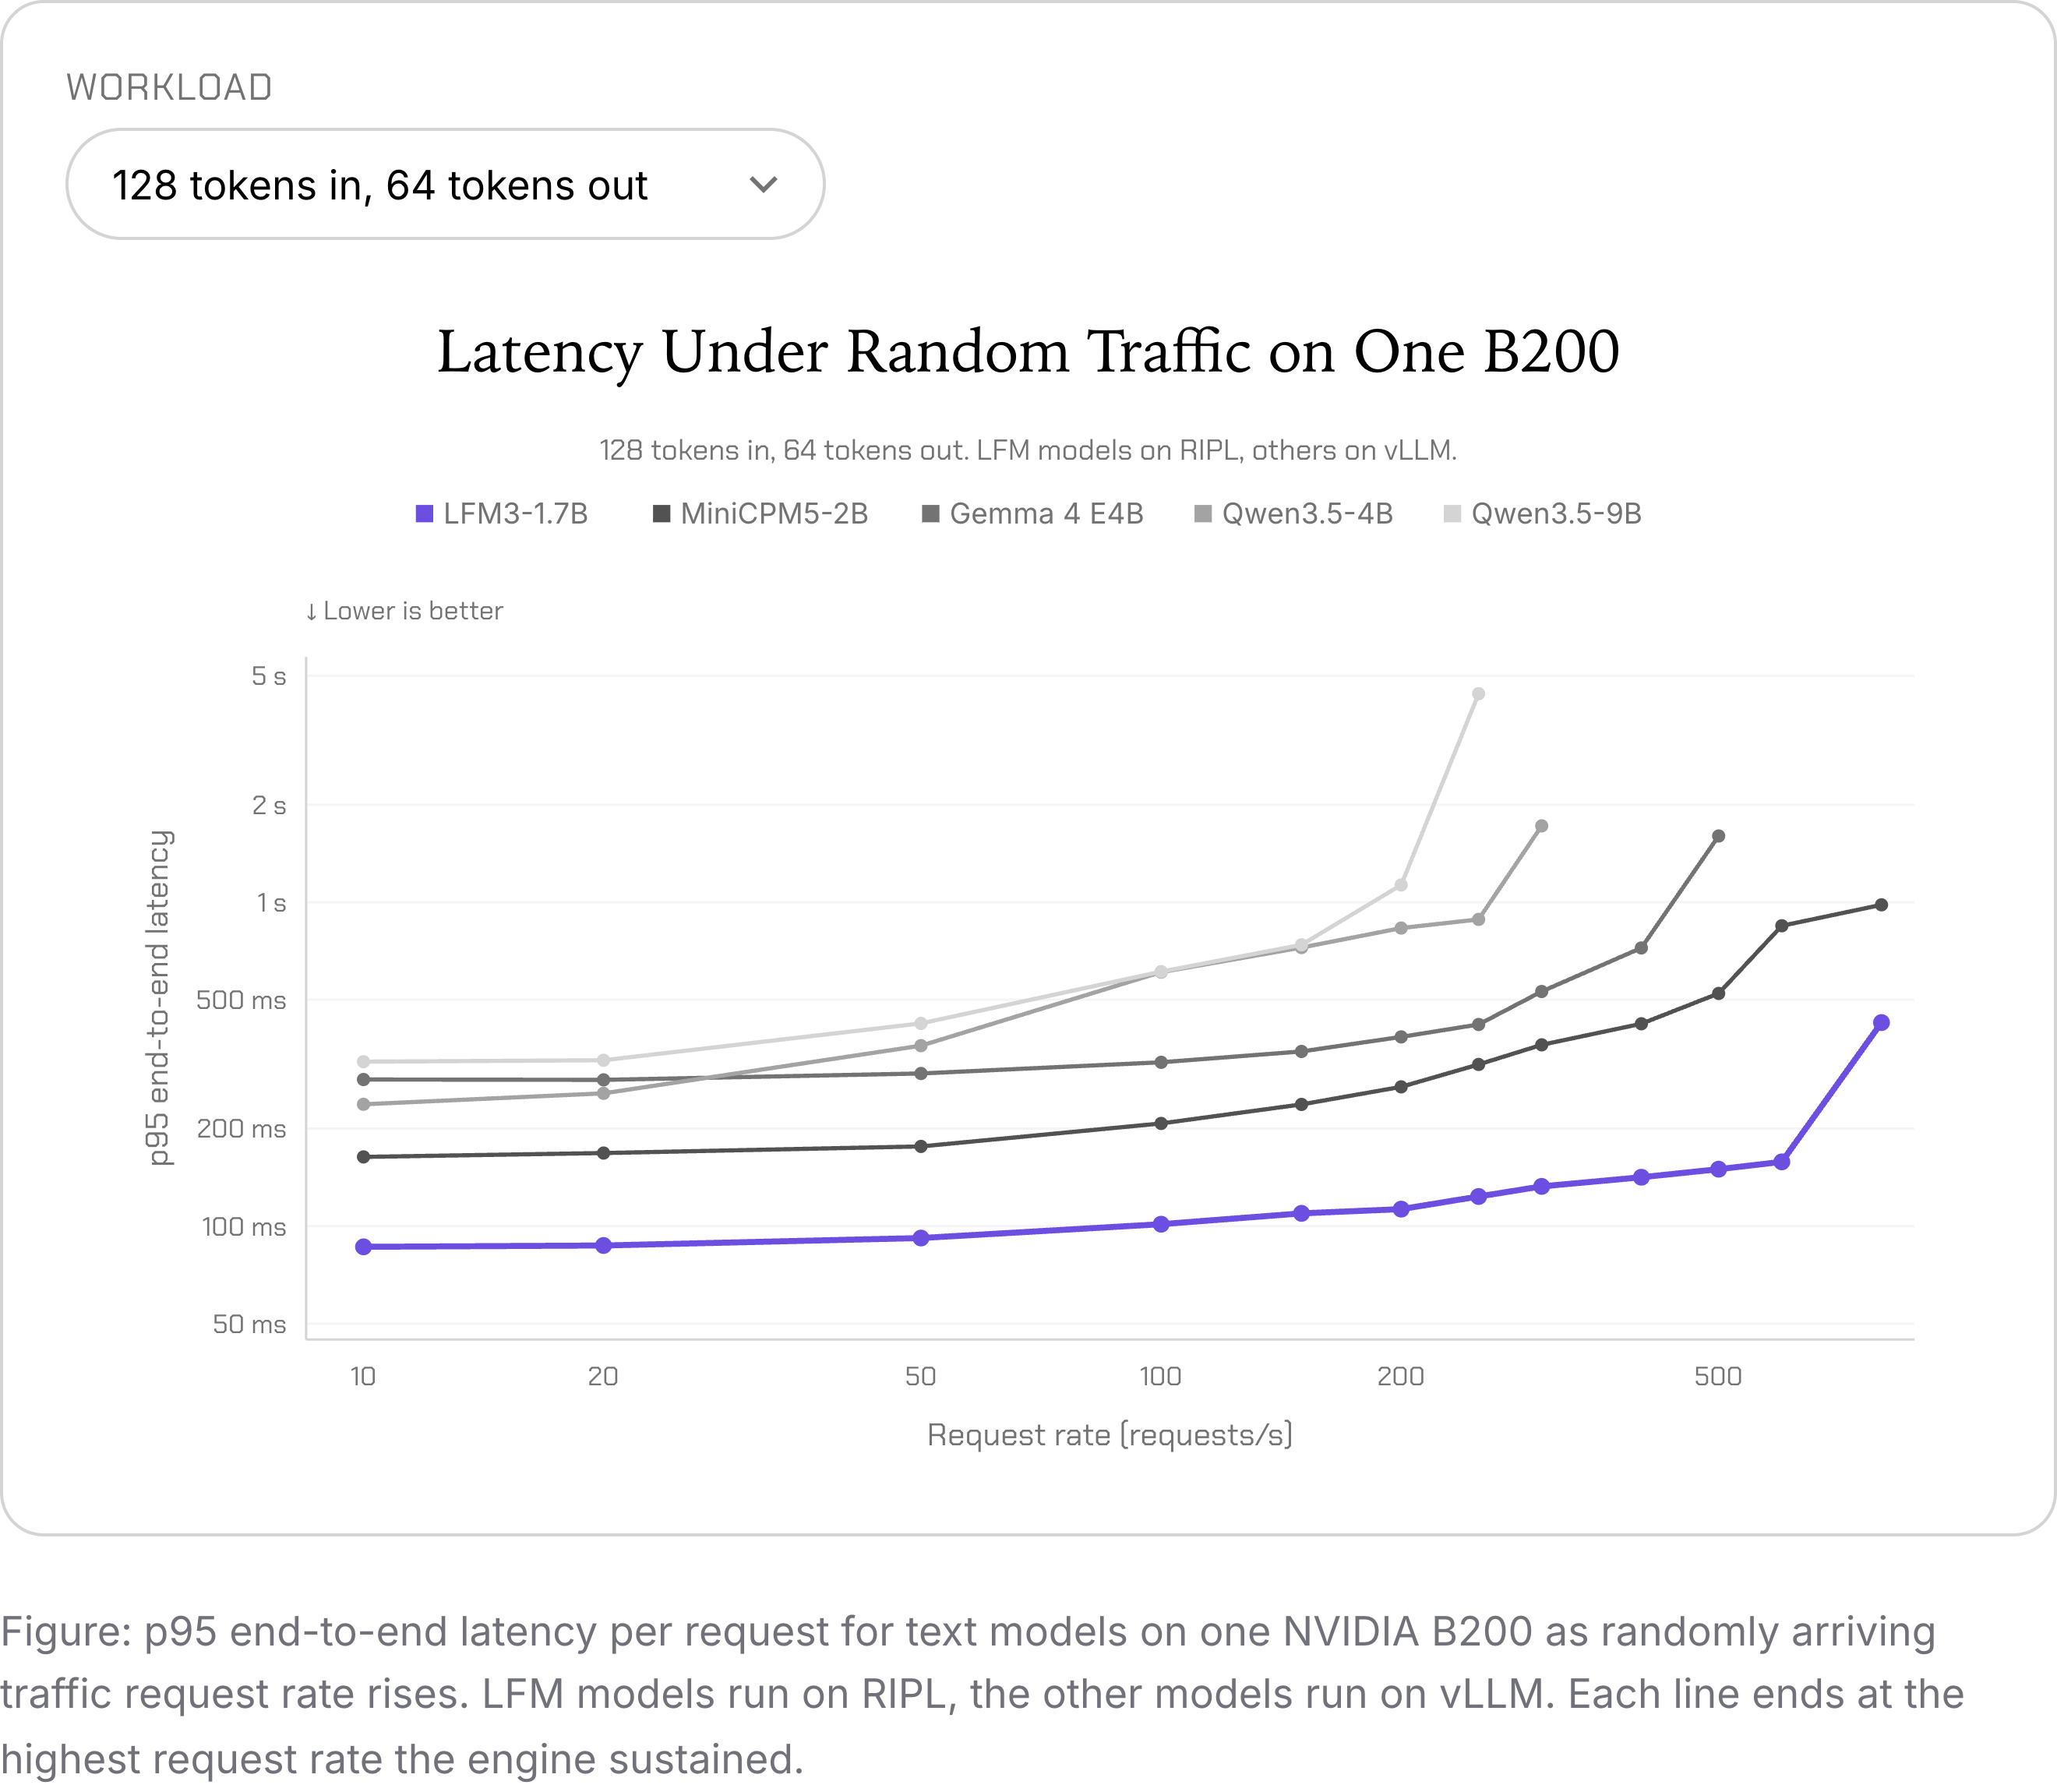
图:在单张 NVIDIA B200 上,随着随机到达流量的请求速率上升,视觉模型每个请求的 p95 端到端延迟。LFM 模型运行在 RIPL 上,其他模型运行在 vLLM 上。每条曲线终止于该引擎所能维持的最高请求速率。
视觉编码器
除了对 LFM3 主干网络的改进,LFM3-VL 还搭载了我们自研的新视觉编码器,其计算量比此前 LFM VL 模型所用的 SigLIP2 编码器少 3 倍。
Liquid 视觉编码器将卷积与注意力机制相结合,在同等质量下效率显著高于 ViT 方案。下图展示了性能与效率的关系。我们的 164M 参数编码器在 13 个视觉语言模型基准上平均准确率达到 55.9%,与 Qwen3.5-2B 的视觉编码器持平,而所需 FLOPs 少 2.2 倍。
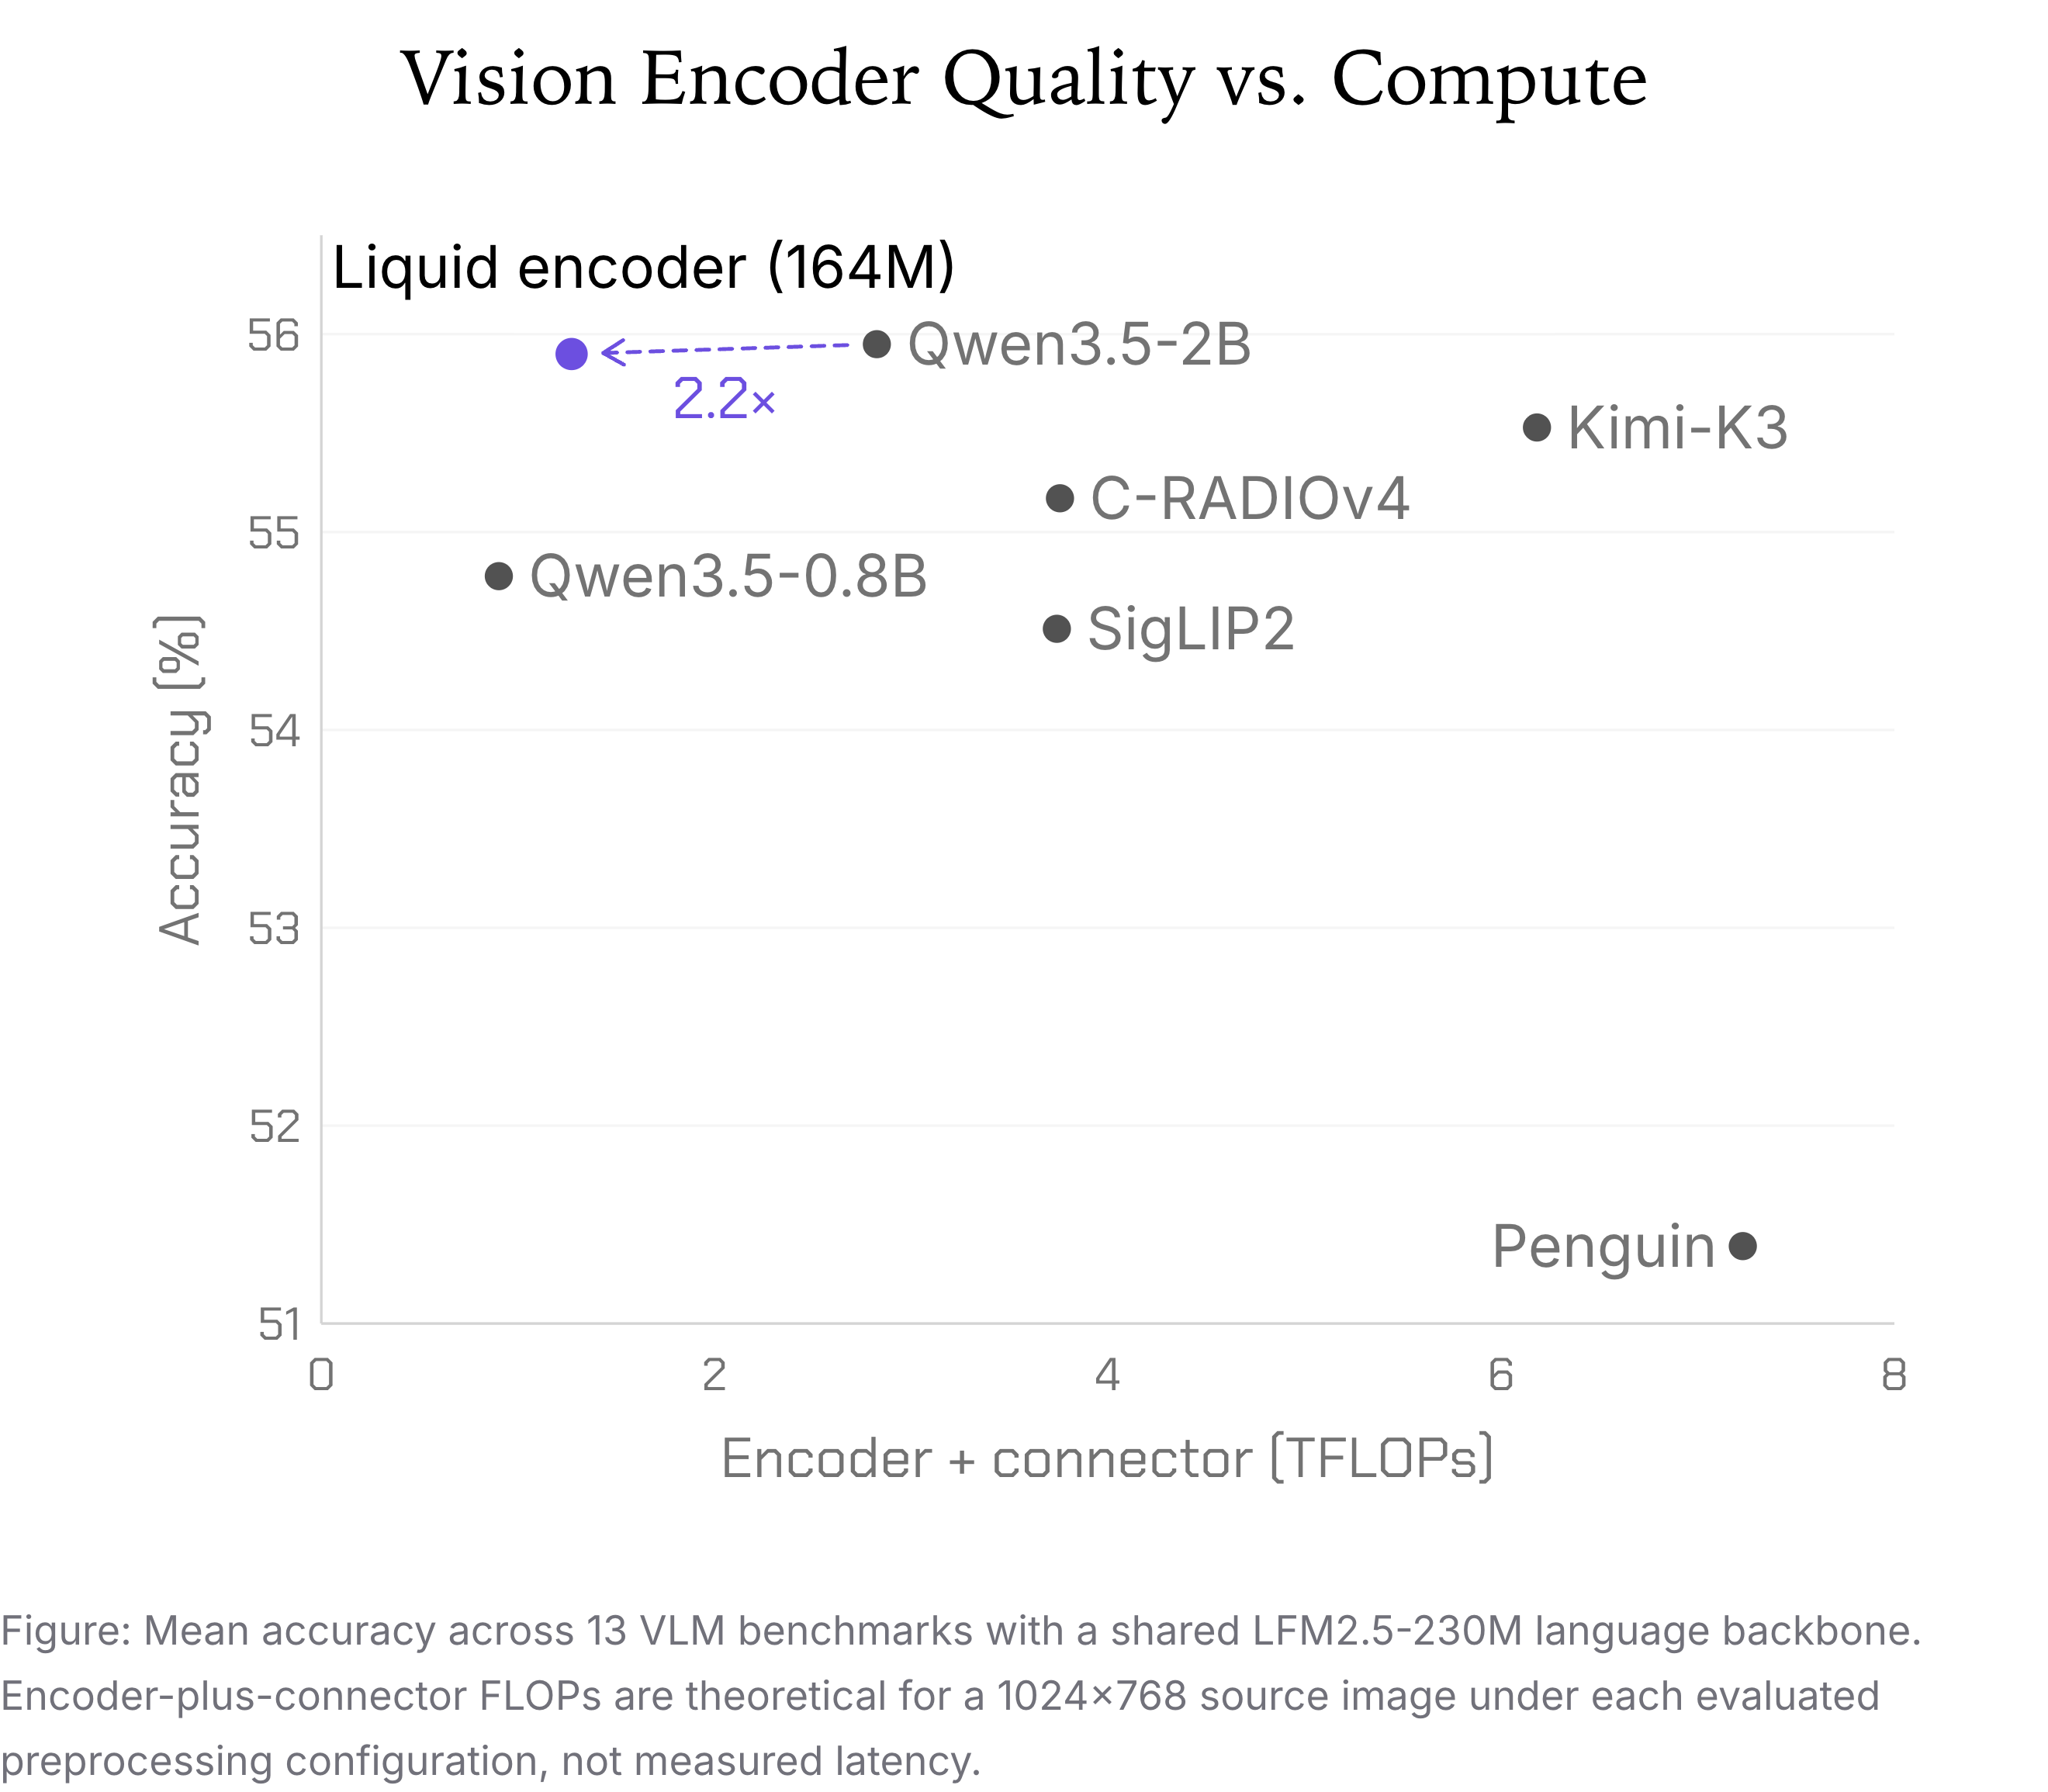
图:在共享 LFM2.5-230M 语言主干下,13 个 VLM 基准的平均准确率。编码器加连接器的 FLOPs 是在各评测预处理配置下、针对 1024×768 源图像的理论值,并非实测延迟。
处理视频时,编码器将每两帧采样帧联合嵌入为一个时间切片的视觉特征,在进一步编码之前将时间序列长度减半。这些设计使该编码器既能支撑更丰富的图像理解,也能支撑高效的视频处理。
音频
LFM3-Audio-2B 是一个紧凑、功能完整的音频模型,可在笔记本电脑和边缘设备上本地运行。它以文本或音频为输入,输出文本、语音或两者兼有。
LFM3-Audio-2B 采用新架构,音频编码器和编解码器均为自研。它的语音质量优于 LFM2.5-Audio,现已支持 18 种语言。新增能力包括音频理解、通用音频推理和工具调用。
- 语音对话: 开口提问,即可收到文本和语音形式的流式回复。若只需文本回复,模型也可以先推理再作答。
- 多语言语音: 在 18 种语言之间转写、合成和翻译语音。
- 音频理解与推理: 让模型解读录音,并就其中的语音、声音和事件回答问题。
- 工具调用: 把口头请求转化为工具调用,以控制应用和设备。模型还能在调用工具的同时以文本或语音回应。
我们的目标是让驾驶员与车辆之间的交互尽可能自然、直观。我们正与 Liquid 合作,探索强大的端侧 AI 如何进一步增强 MBUX Virtual Assistant,同时带来快速、私密且不依赖云端的体验。我们的 MB.OS 架构为将这类创新引入车辆奠定了基础。
ASR(WER,%,越低越好)
| LFM3-Audio-2B | LFM2.5-Audio-1.5B | Gemma 4 E2B | Gemma 4 E4B | Qwen2.5-Omni-3B | Nvidia Audex 2B | Voxtral Mini 3B | MiMo-Audio-7B-Instruct | Kimi-Audio-7B-Instruct | |
|---|---|---|---|---|---|---|---|---|---|
| 总参数量 | 2B | 1.5B | 5B | 8B | 6B | 3B | 5B | 8B | 10B |
| 英语 | 6.2 | 6.1 | 8.3 | 7.8 | 6.3 | 6 | 5.5 | 8.5 | 5.3 |
| 多语言(en、es、pt、de、fr、it、zh、ja、ko 平均值) | 6 | – | 8.1 | 6.5 | 7.4 | 6.4 | 7.8 | – | – |
英语 TTS(UTMOSv2,1-5,越高越好)(WER,%,越低越好)
| LFM3-Audio-2B | LFM2.5-Audio-1.5B | Qwen2.5-Omni-3B | MiMo-Audio-7B-Instruct | |
|---|---|---|---|---|
| 总参数量 | 2B | 1.5B | 6B | 8B |
| UTMOSv2 | 3.8 | 3.2 | 3.4 | 2.8 |
| WER | 1.4 | 1.9 | 3.2 | 4.9 |
VoiceBench、工具调用、音频理解(音频输入、文本输出,%,越高越好)
| LFM3-Audio-2B | LFM2.5-Audio-1.5B | Qwen2.5-Omni-3B | Gemma 4 E2B | Gemma 4 E4B | Voxtral Mini 3B | MiMo-Audio-7B-Instruct | Kimi-Audio-7B-Instruct | |
|---|---|---|---|---|---|---|---|---|
| 总参数量 | 2B | 1.5B | 6B | 5B | 8B | 5B | 8B | 10B |
| VoiceBench | 73.1 | 55.2 | 66.4 | 63.3 | 72.9 | 65.8 | 77.3 | 76.9 |
| 工具调用(内部评测) | 58.5 | – | 44.3 | 55.6 | 72.4 | 44.5 | 33.4 | 50.6 |
| 音频理解(MMAR) | 50.6 | 25.9 | 54.4 | 44.5 | 49.1 | 50.1 | 62.3 | 53.3 |
我们全新的基于 LFM 的音频编码器采用滑动窗口注意力与短卷积层混合的架构,内存占用始终保持在有界范围内。新编码器完全因果,因此模型可以在你说话的同时处理实时麦克风输入并执行 prefill。这缩短了你说话结束后的等待时间,首 token 时间最低可达 50 ms。
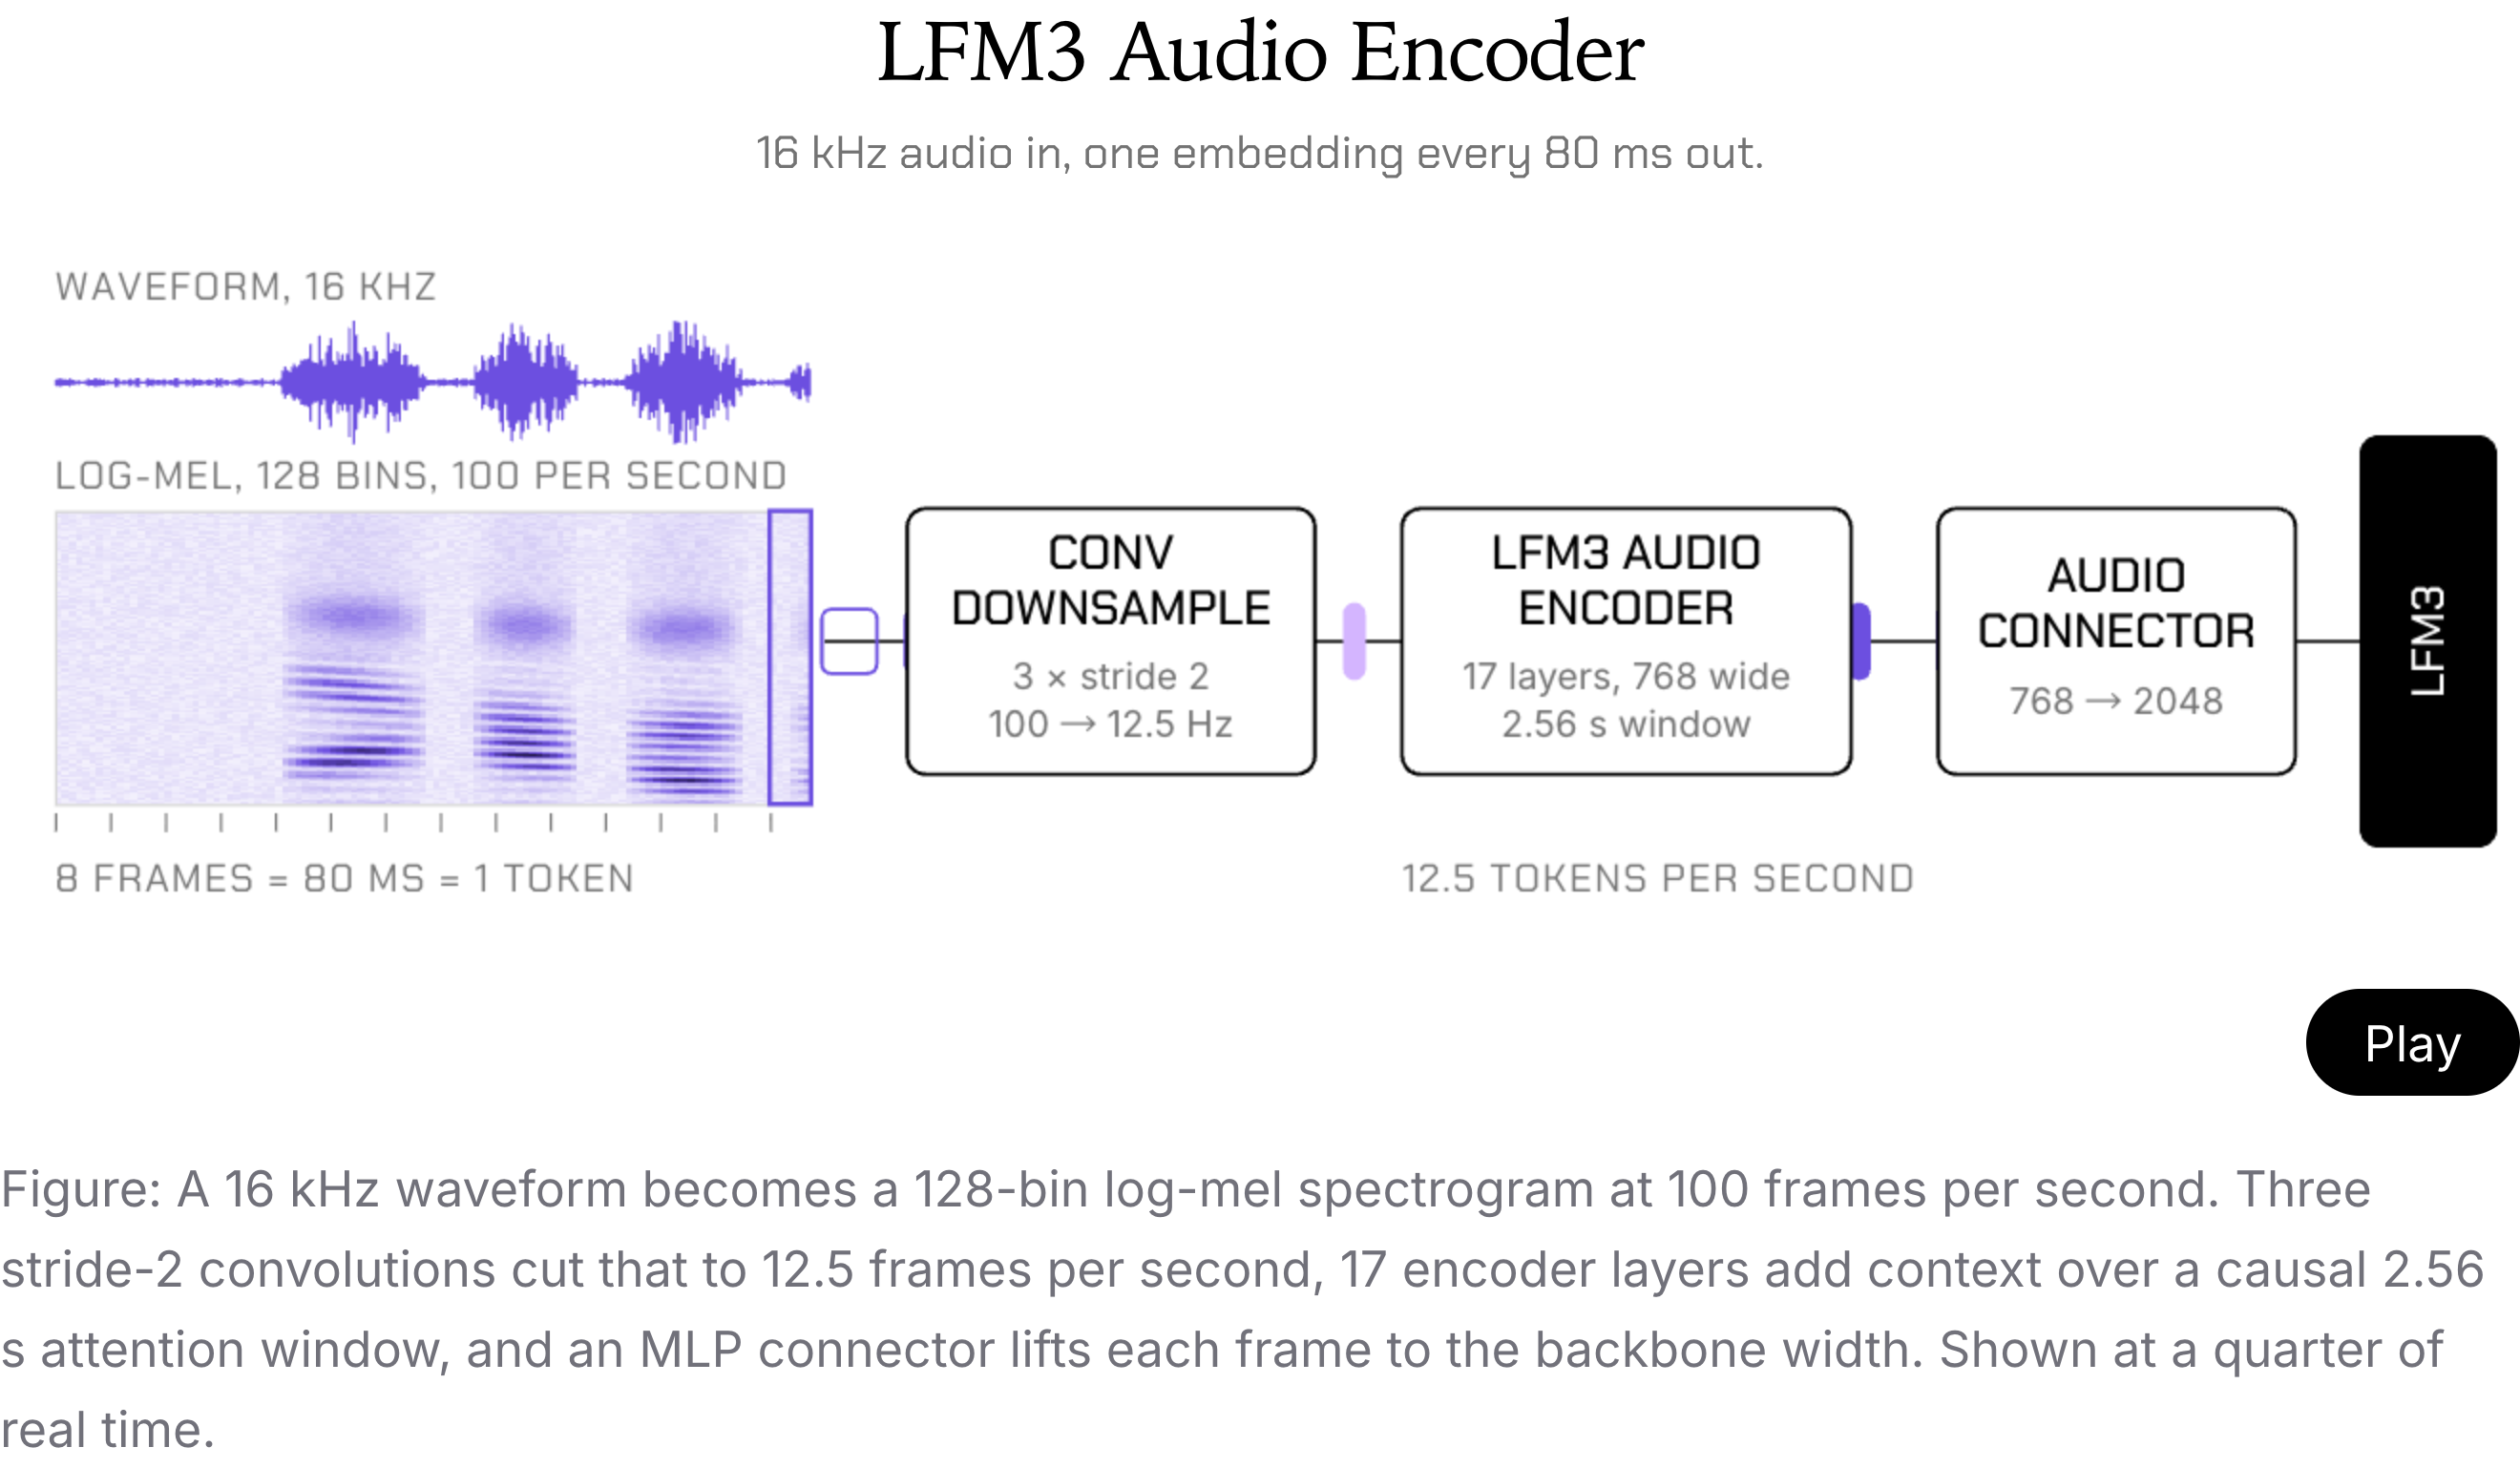
图:16 kHz 波形变成每秒 100 帧的 128 频带 log-mel 频谱图。三个 stride-2 卷积将其降到每秒 12.5 帧,17 层编码器在 2.56 秒的因果注意力窗口上添加上下文,MLP 连接器再把每一帧提升到骨干网络的宽度。图中以四分之一实时速度展示。
LiquidCodec 是我们新的音频 tokenizer,为 LFM3-Audio 和 LFM3-Omni 的多语言语音生成提供支持。它基于 LFM3 架构,可在单个 CPU 线程(Apple M4 Max)上以约 87 倍实时速度把生成的 token 转成语音,并支持流式解码。
量化把每 80 ms 语音压缩成 12 个离散 token;与之前的 LFM Audio 模型不同,它支持多个 token 并行迭代预测,而不必顺序预测。骨干网络生成新 token 的同时,detokenizer 逐步将其转成语音,全程快于实时,对话因此流畅、响应及时。
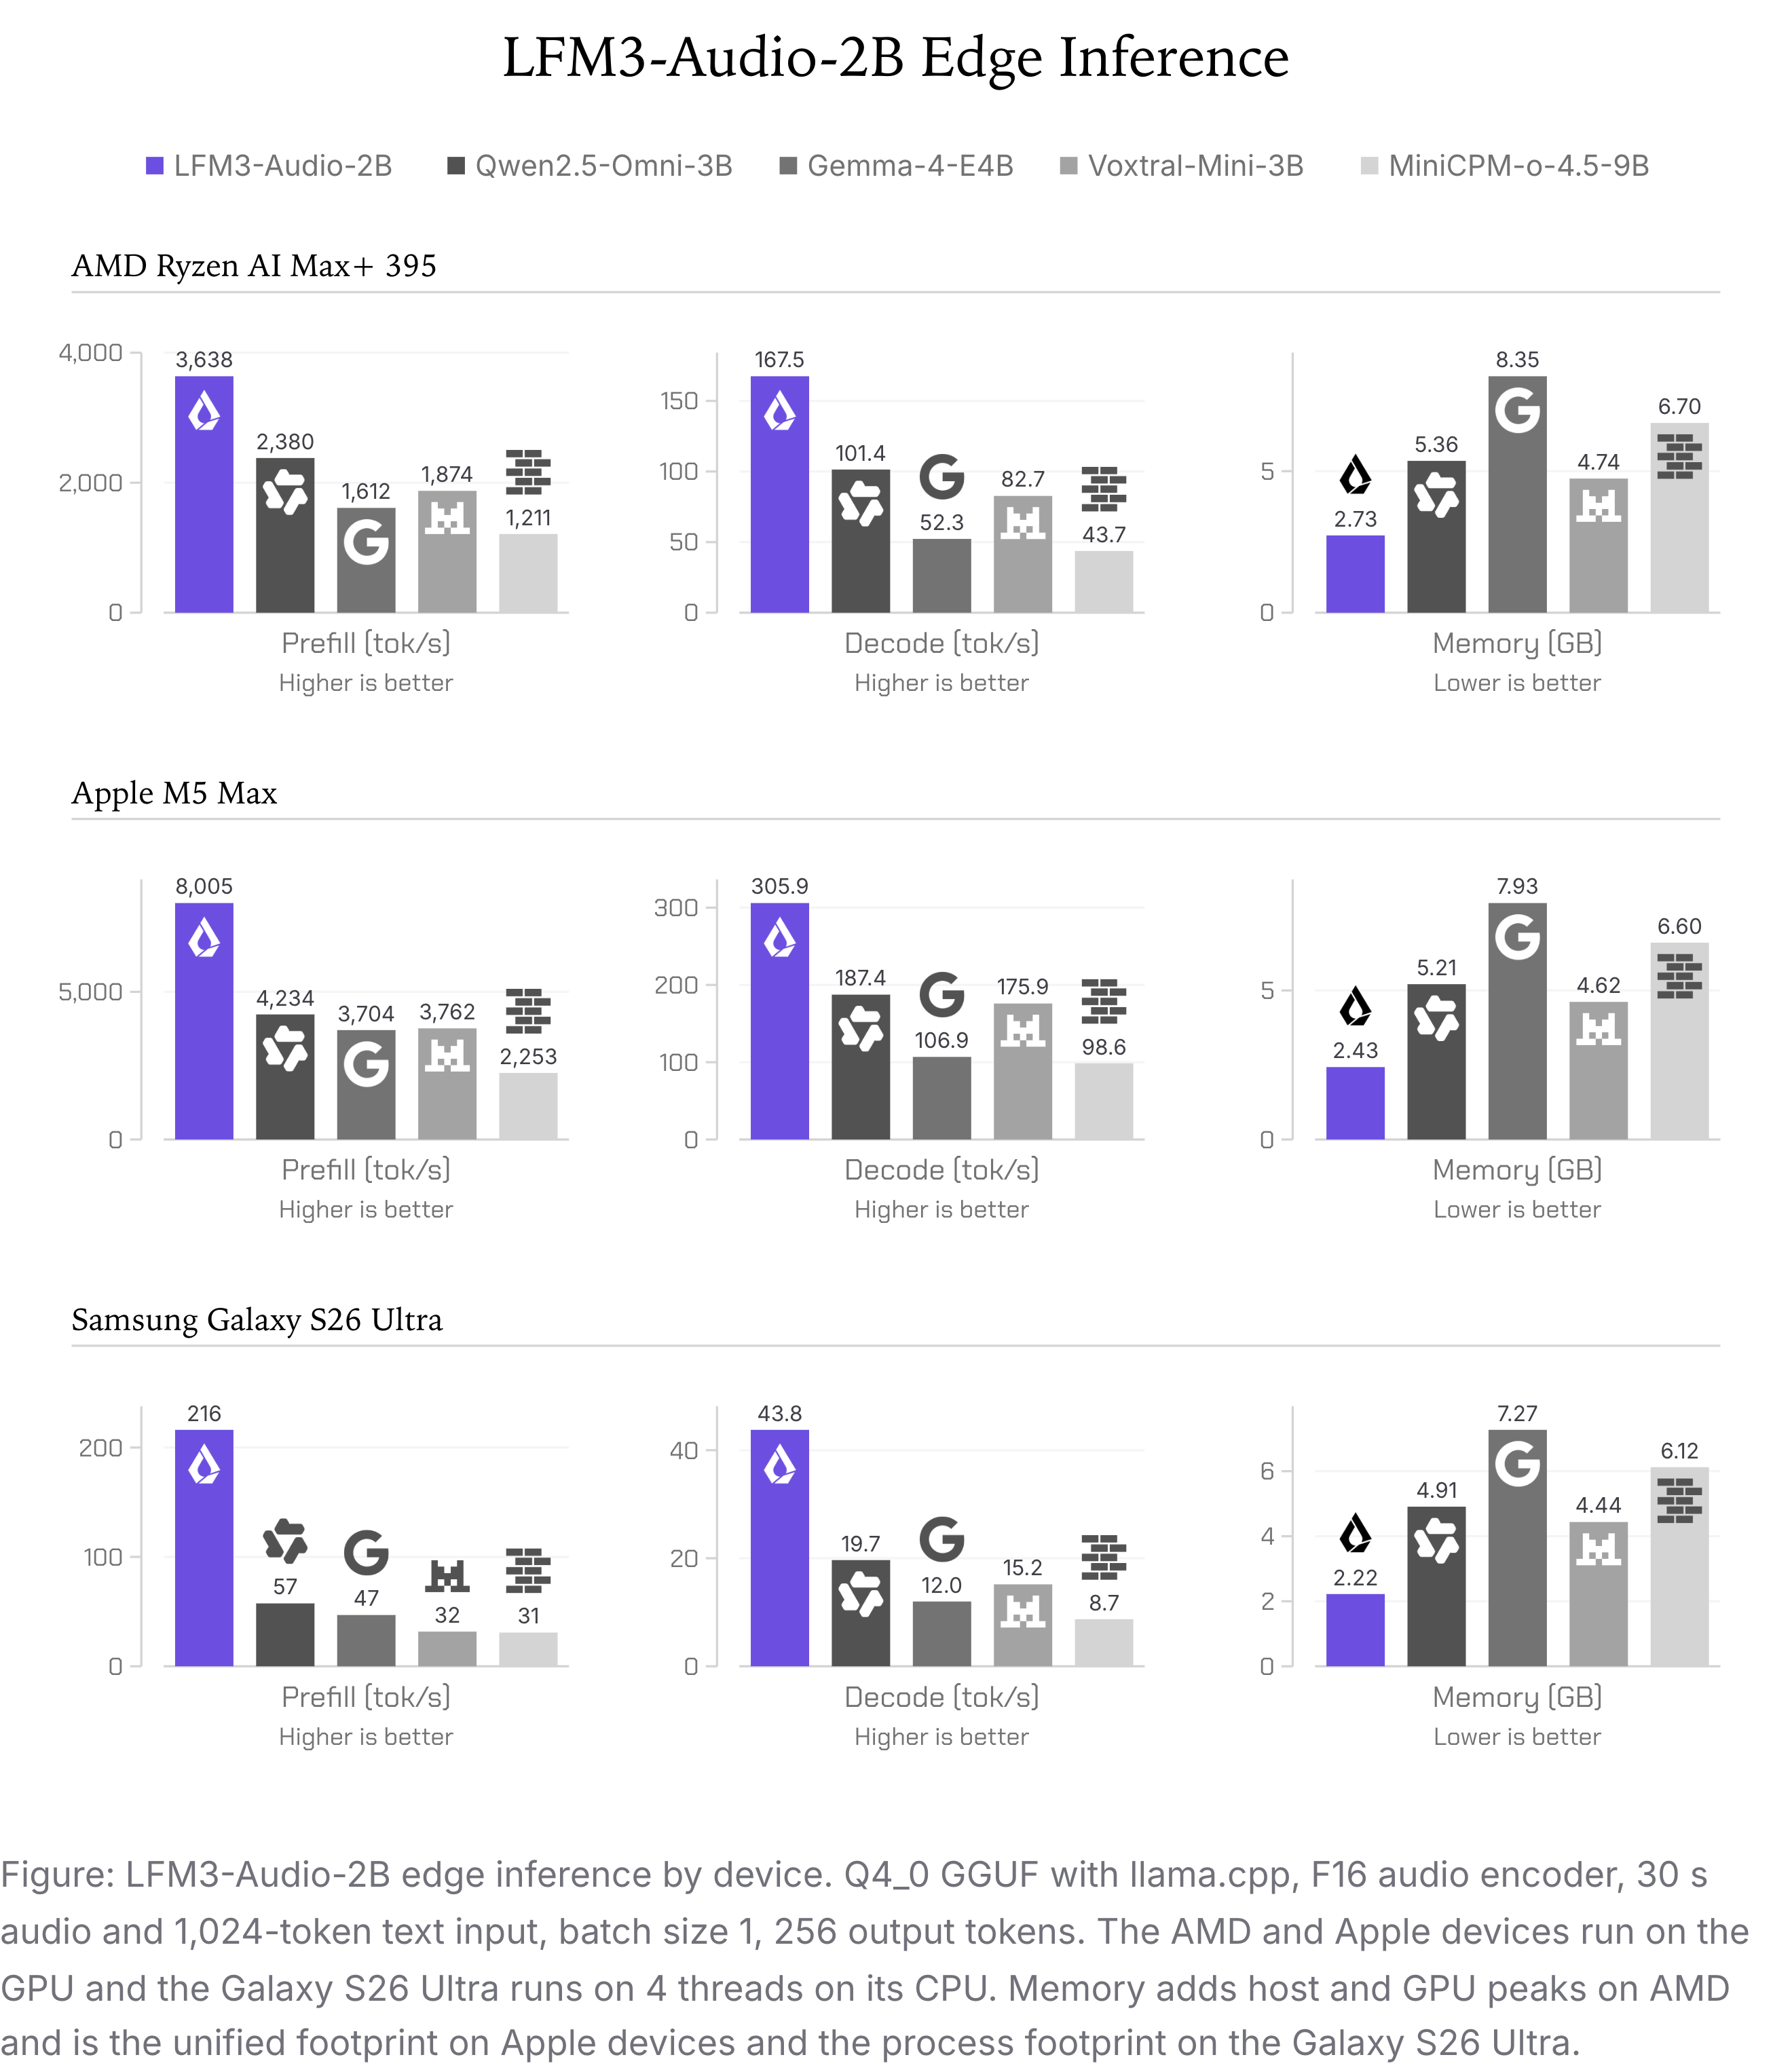
图:LFM3-Audio-2B 在各设备上的边缘推理。Q4_0 GGUF 配 llama.cpp,F16 音频编码器,30 秒音频与 1,024 token 文本输入,batch size 为 1,输出 256 个 token。AMD 与 Apple 设备跑在 GPU 上,Galaxy S26 Ultra 跑在 CPU 的 4 个线程上。AMD 上的内存为主机与 GPU 峰值之和,Apple 设备上为统一内存占用,Galaxy S26 Ultra 上为进程占用。
Omni
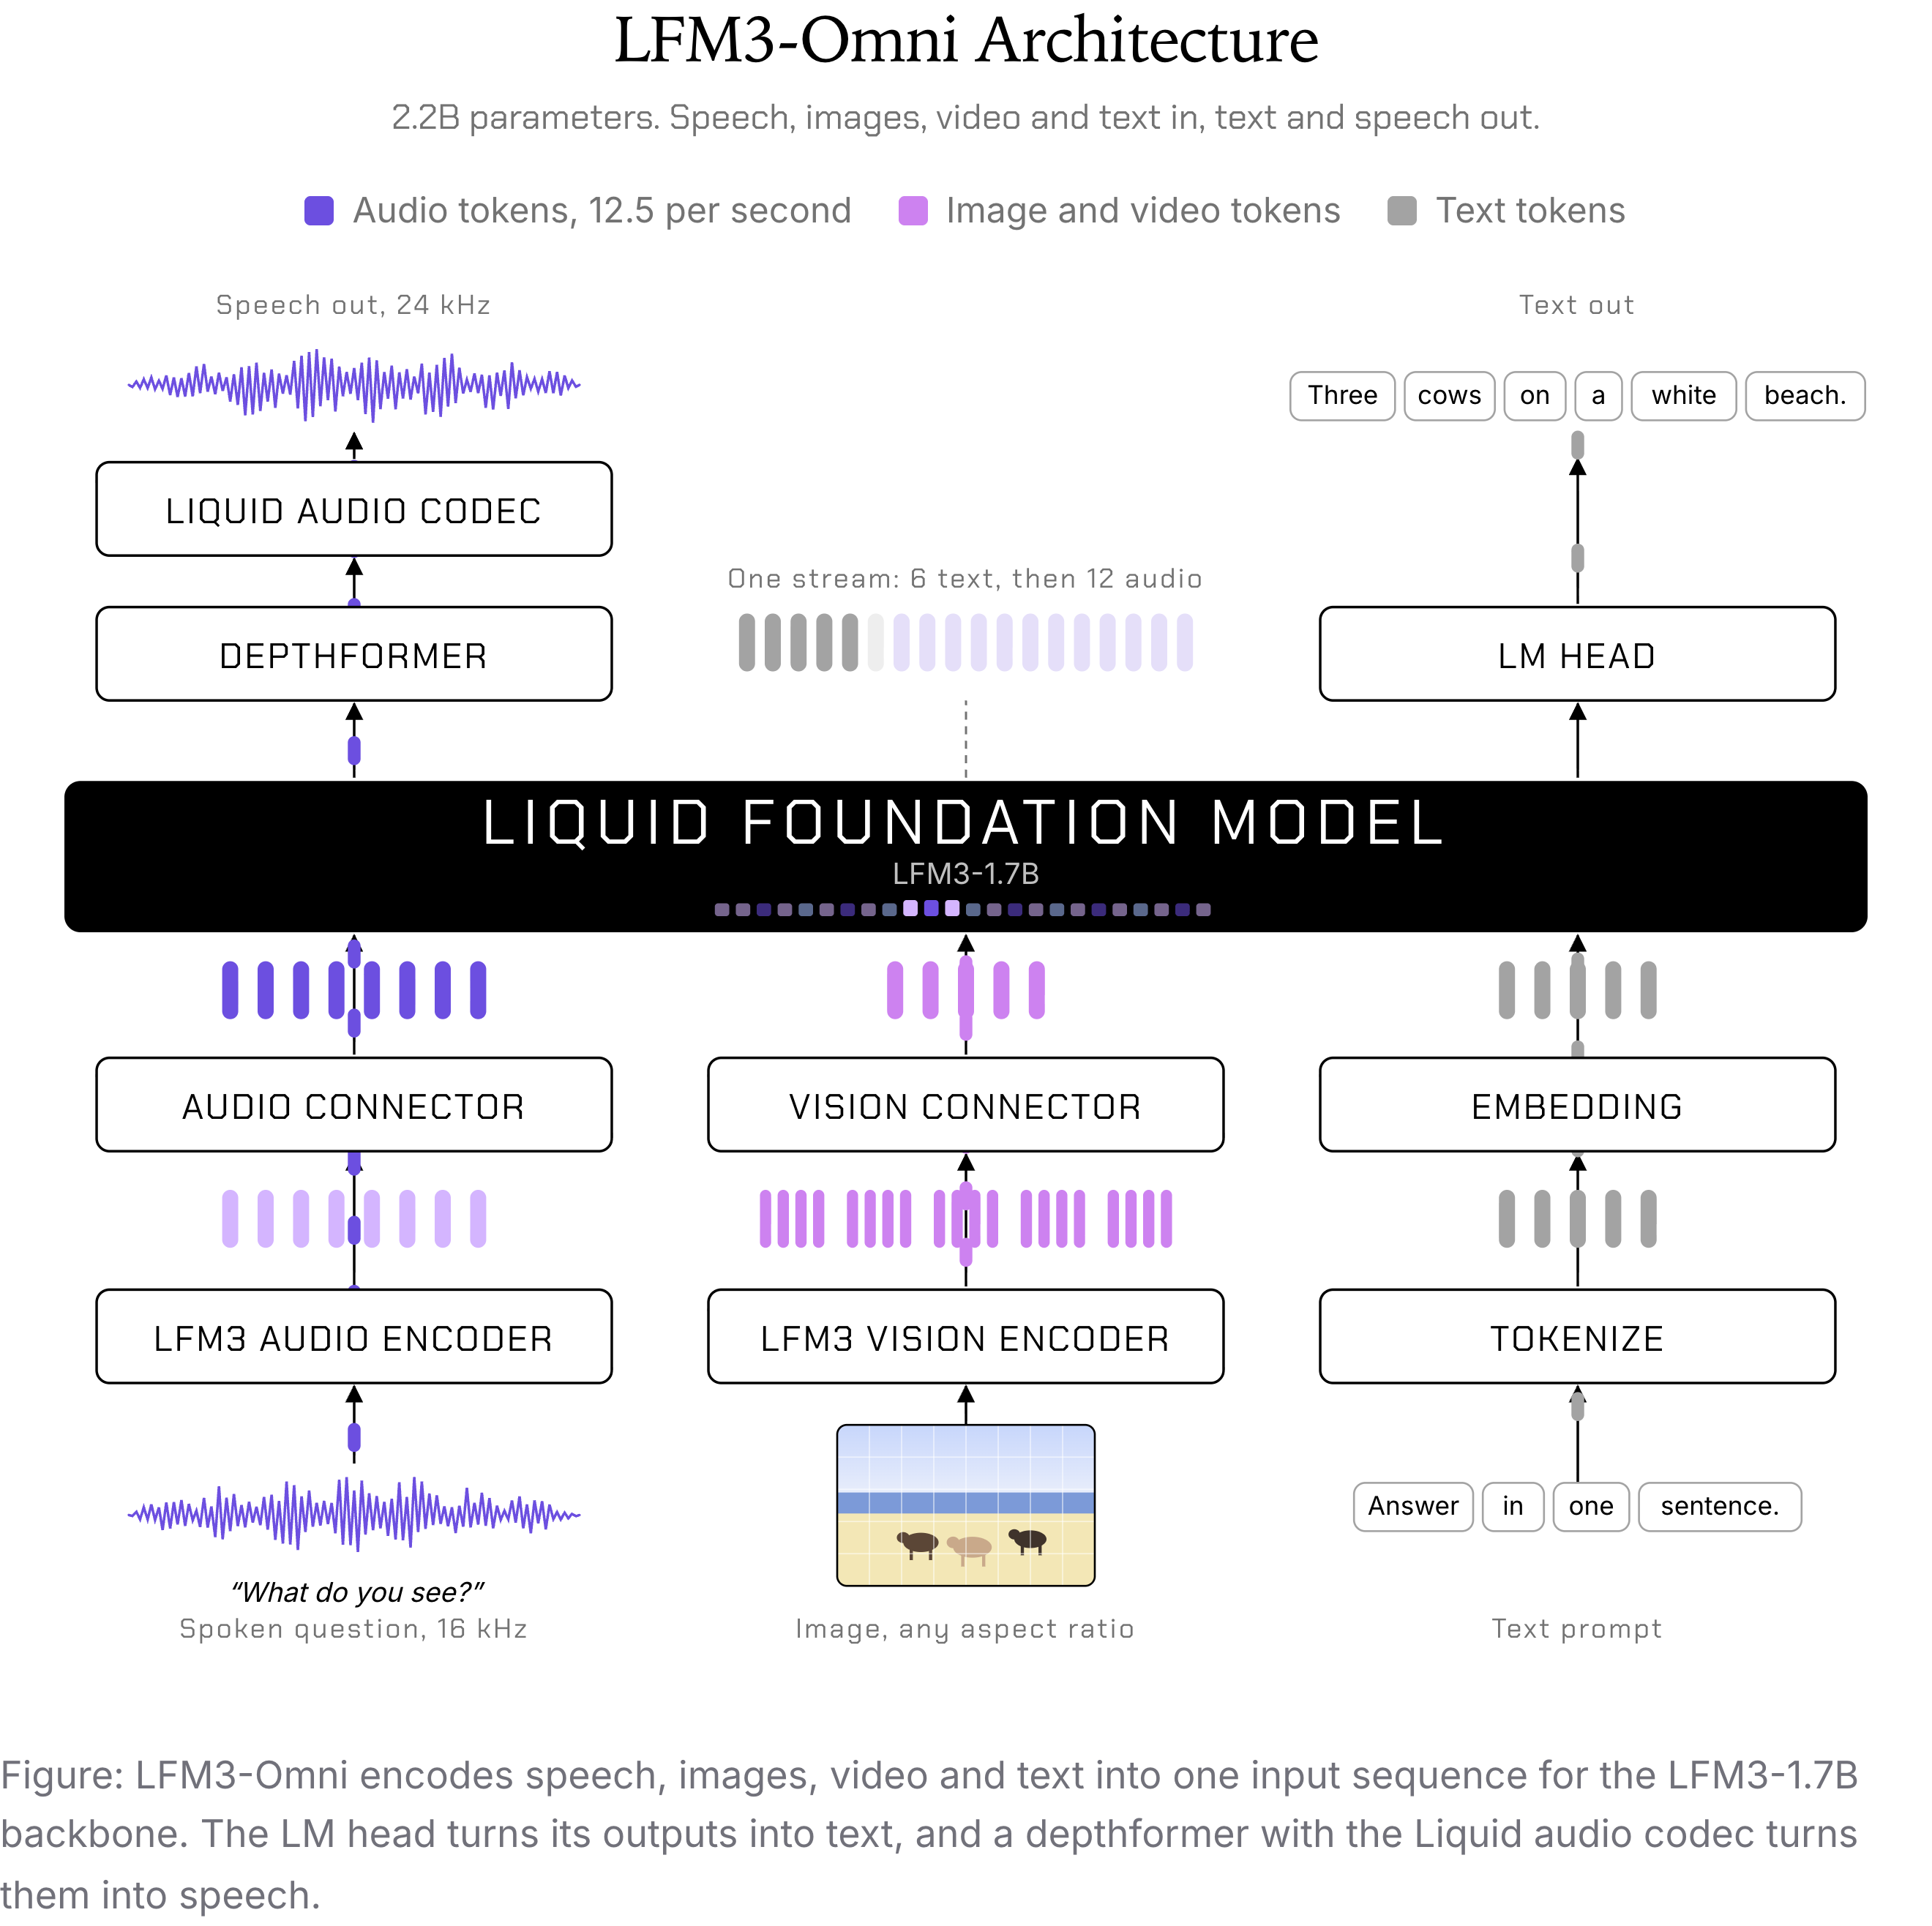
图:LFM3-Omni 将语音、图像、视频和文本编码为一条输入序列,送入 LFM3-1.7B 主干网络。LM head 把输出转成文本,depthformer 配合 Liquid 音频编解码器把输出转成语音。
LFM3-Omni-2B 是我们的首个全模态模型,将视觉、音频和语言统一到同一个模型中,使其能看、能听,也能开口回应:
- 语音视觉问答: 用语音对图像或真实场景提问,模型以文本、语音或两者兼有的形式作答。
- 音视频理解: 同时处理视频帧和对应的音频,让模型既能推断画面中发生了什么,也能理解说了什么、听到了什么。
- 多模态工具调用: 将视觉上下文与语音指令相结合,生成结构化的工具调用,让助手既能看、又能听用户怎么说,从而与各类应用和界面交互。
LFM3-Omni 支持需要同时理解视觉与听觉信息的跨模态交互。用户可以对着图像用语音提问,也可以提供带同步音频的视频,提出同时依赖画面和声音的问题。
| LFM3-Omni-2B | Qwen2.5-Omni-3B | Qwen2.5-Omni-7B | Gemma 4 E2B | Gemma 4 E4B | Phi-4-multimodal | ||
|---|---|---|---|---|---|---|---|
| 参数量 | 2.2B | 6B | 10.7B | 5B | 8B | 5.6B | |
| 视频 + 音频理解 | Daily-Omni | 70.1 | 58.8 | 61.3 | 50.6 | 54.1 | 48.9 |
| WorldSense | 47.1 | 45 | 45.4 | 38.1 | 43.5 | 42.4 | |
| AV-SpeakerBench | 46.8 | 40.4 | 43.2 | 32.3 | 36.4 | 38 | |
| 图像 + 音频理解 | OmniBench(总体) | 46.3 | 47.1 | 49.7 | 16.8 | 20.7 | 39 |
| OmniBench Speech | 48.2 | 45.7 | 48 | 16.1 | 21.3 | 38.9 | |
| 语音视觉问答 | RealWorldQA | 64.7 | 61.1 | 69.9 | 39.4 | 49 | 64.3 |
| MMStar | 51.8 | 50.8 | 57.3 | 38.9 | 44.6 | 54.8 | |
| POPE | 83.8 | 85.3 | 85.4 | 74.2 | 77.8 | 83 | |
| ERQA | 39.4 | 37.3 | 39.2 | 20.6 | 32.1 | 30.8 | |
| EmbSpatial | 67.6 | 53.4 | 59.5 | 44.1 | 54.0 | 42.6 |
除了跨模态理解,LFM3-Omni 还保留了独立 LFM3 模型的核心能力,包括视觉问答、语音识别、语音合成和语言指令跟随。
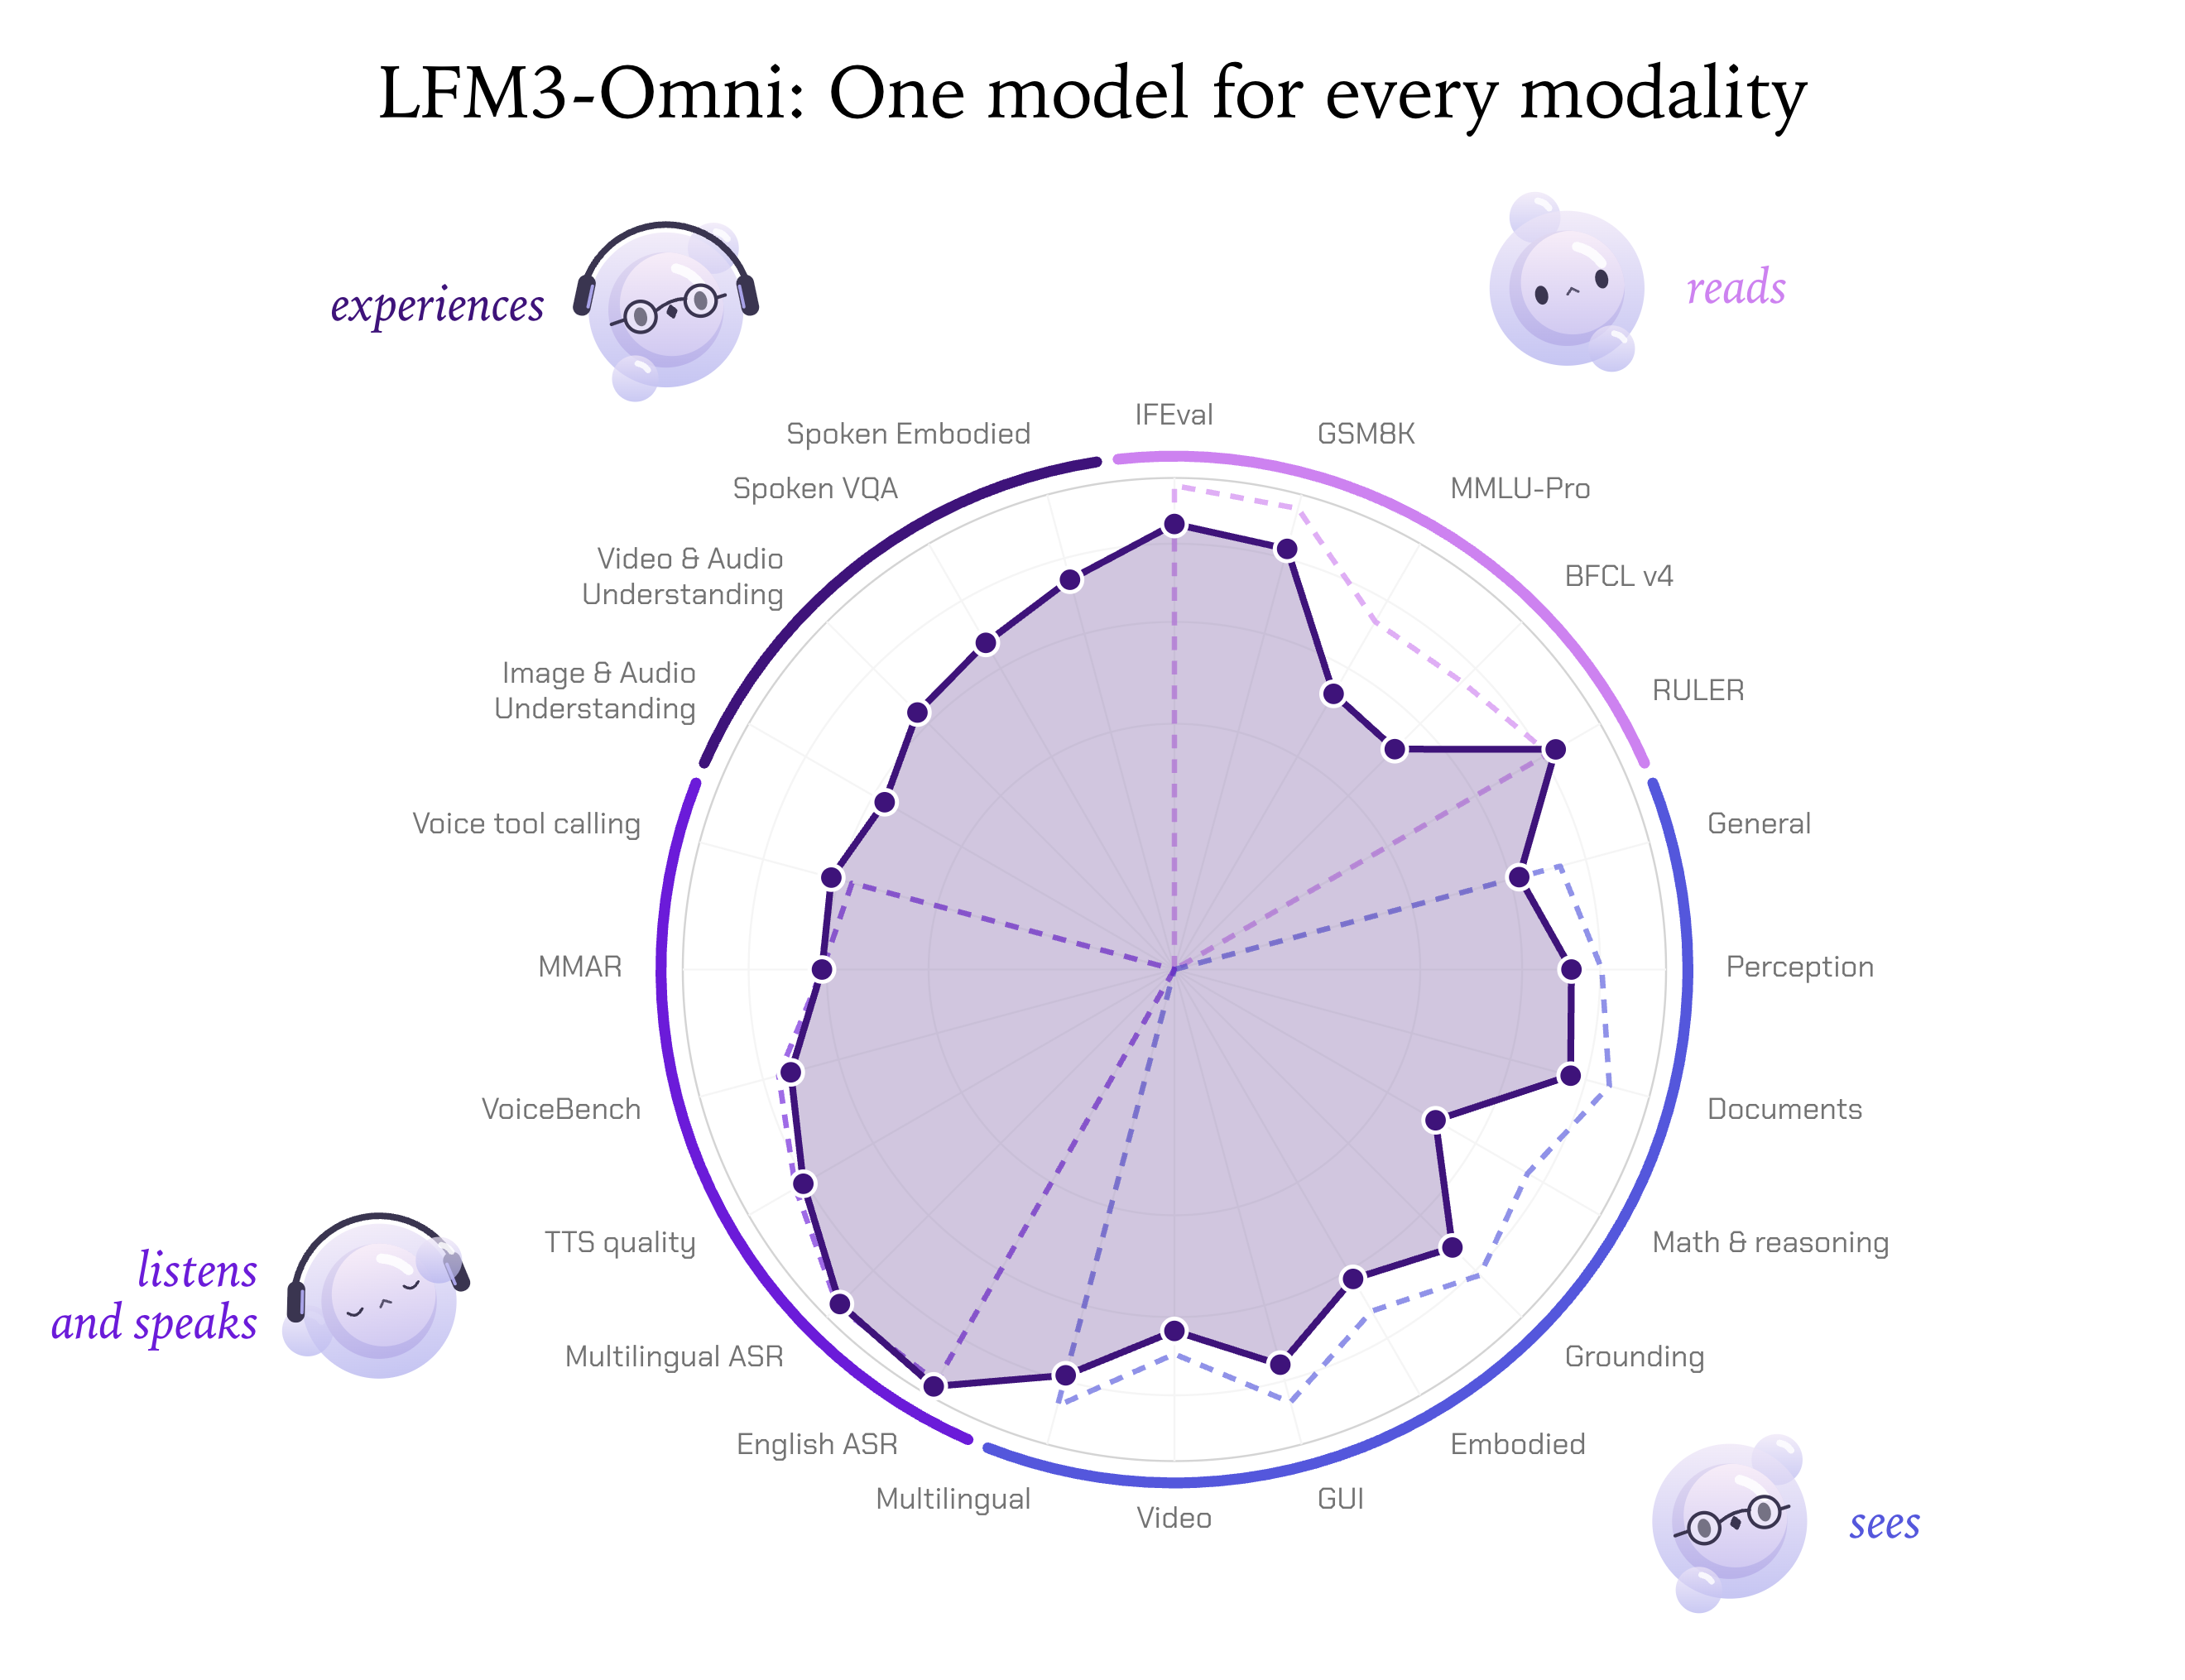
LFM3-Omni-2B 专为资源受限环境中的高效部署而设计。凭借这些能力,它既能支撑对话助手结合上下文提供引导,也能支持免手操作交互,帮助用户通过自然语音指令完成任务。将视觉理解、语音对话和工具调用结合起来,它可覆盖从个性化教育、日常辅助到数字界面导航和机器人系统等多种应用。
它以 2.2B 参数将这类多模态助手带到端侧。比如一位能看着你手写的数学题、回答你口头提问的辅导老师;一台你可以拿着到处走、随时问它看到了什么的平板;以及一个把摄像头所见与驾驶员所说结合起来的车载助手。
决策
本次发布还带来两个新的决策模型:d1-2B 基于 LFM3-VL-2B,能读文字和图片;d1-Omni-2B 基于 LFM3-Omni-2B,还能听声音。它们不写答案,而是在毫秒内做出判断。给它一个场景(一张工单、一份发票、一个应用界面、一张照片、一段语音),再给一组问题,它会在一次前向传播中全部作答,每个答案都带校准过的概率。
除了新的 LFM3 骨干,相比 d1-3B 最大的变化是带类型的答案。在是/否、选项和评分之外,两个模型现在还能:
- 定位: 在你描述的对象周围画框,或找出某个东西的所有实例并给出数量。
- 读取: 从文档中提取文本、数字和日期,并附上它们所在的精确片段;字段不存在时返回“未找到”。
- 估计: 给出一个数值及其可能范围。
- 多选: 选出所有适用项,每项各带概率。
问题数量不限:它们在同一份输入上一次性读完。
更小,也更强。 d1-2B 取代了此前的 d1-3B,参数少了三分之一:
| d1-3B | d1-2B | |
|---|---|---|
| Decision Bench(真实企业记录) | 83.6 | 85.2 |
| Decision Index,公开测试集 | 49.0 | 51.1 |
| ImajevBench(基于照片和规则的决策) | 64.0 | 75.5 |
| 我们的 Meta 指数(117 个私有和公开基准) | 58.8 | 63.2 |
能说出来的决策。 d1-Omni-2B 可以通过音频接收同样的问题,因此语音请求也能像文字请求一样被路由、核查或回答。用语音而非文字提问时,它几乎保住了全部准确率:
| 文字 | 语音 | |
|---|---|---|
| DecisionBench(业务路由与分诊) | 83.4 | 78.2 |
| Typed Decisions(客服案例) | 50.5 | 48.0 |
| JevBench | 87.6 | 89.0 |
它还能识别日常声音(ESC-50 上 84.5%),并判断 43 种语言中说的是哪一种(FLEURS 上 92.5%)。
输入是文字和图片,选 d1-2B;输入包含音频,选 d1-Omni-2B。两者都在设备端运行,能把源源不断的工单、文档、通话或摄像头画面转成结构化决策,无需往返云端。
在下面的演示中,d1-2B 在 MacBook 上运行。你用平实的语言描述要找什么,它借助新的 Point 答案类型,在一次前向传播中为每个匹配项画出边界框。
为专用智能而打造
LFM3 生来就是为专用化设计的。2B 级别的模型足够小,可以在你自己的数据上微调,并运行在应用所在的环境中。下面两个例子用 LFM3-VL-2B 展示了这一点。第一个是短时间的微调,把它变成一个针对单一狭窄工业任务的检测模型。第二个是一项研究性扩展,把它变成机器人控制器。
领域专长:让 LFM3 专精于你的领域
前沿模型是强大的通才,但未必是你特定用例的专家。在这个演示中,我们微调 LFM3-VL-2B,让它找出并分类无人机拍摄的风力涡轮机叶片照片中的缺陷。训练使用了约 3,000 张公开照片(WTBs2025),采用 SFT 和 GRPO,在一块 A100 上训练了几个小时。随后我们在约 1,400 张留出照片上,把它与基础模型和 GPT-6 Luna 做了对比。
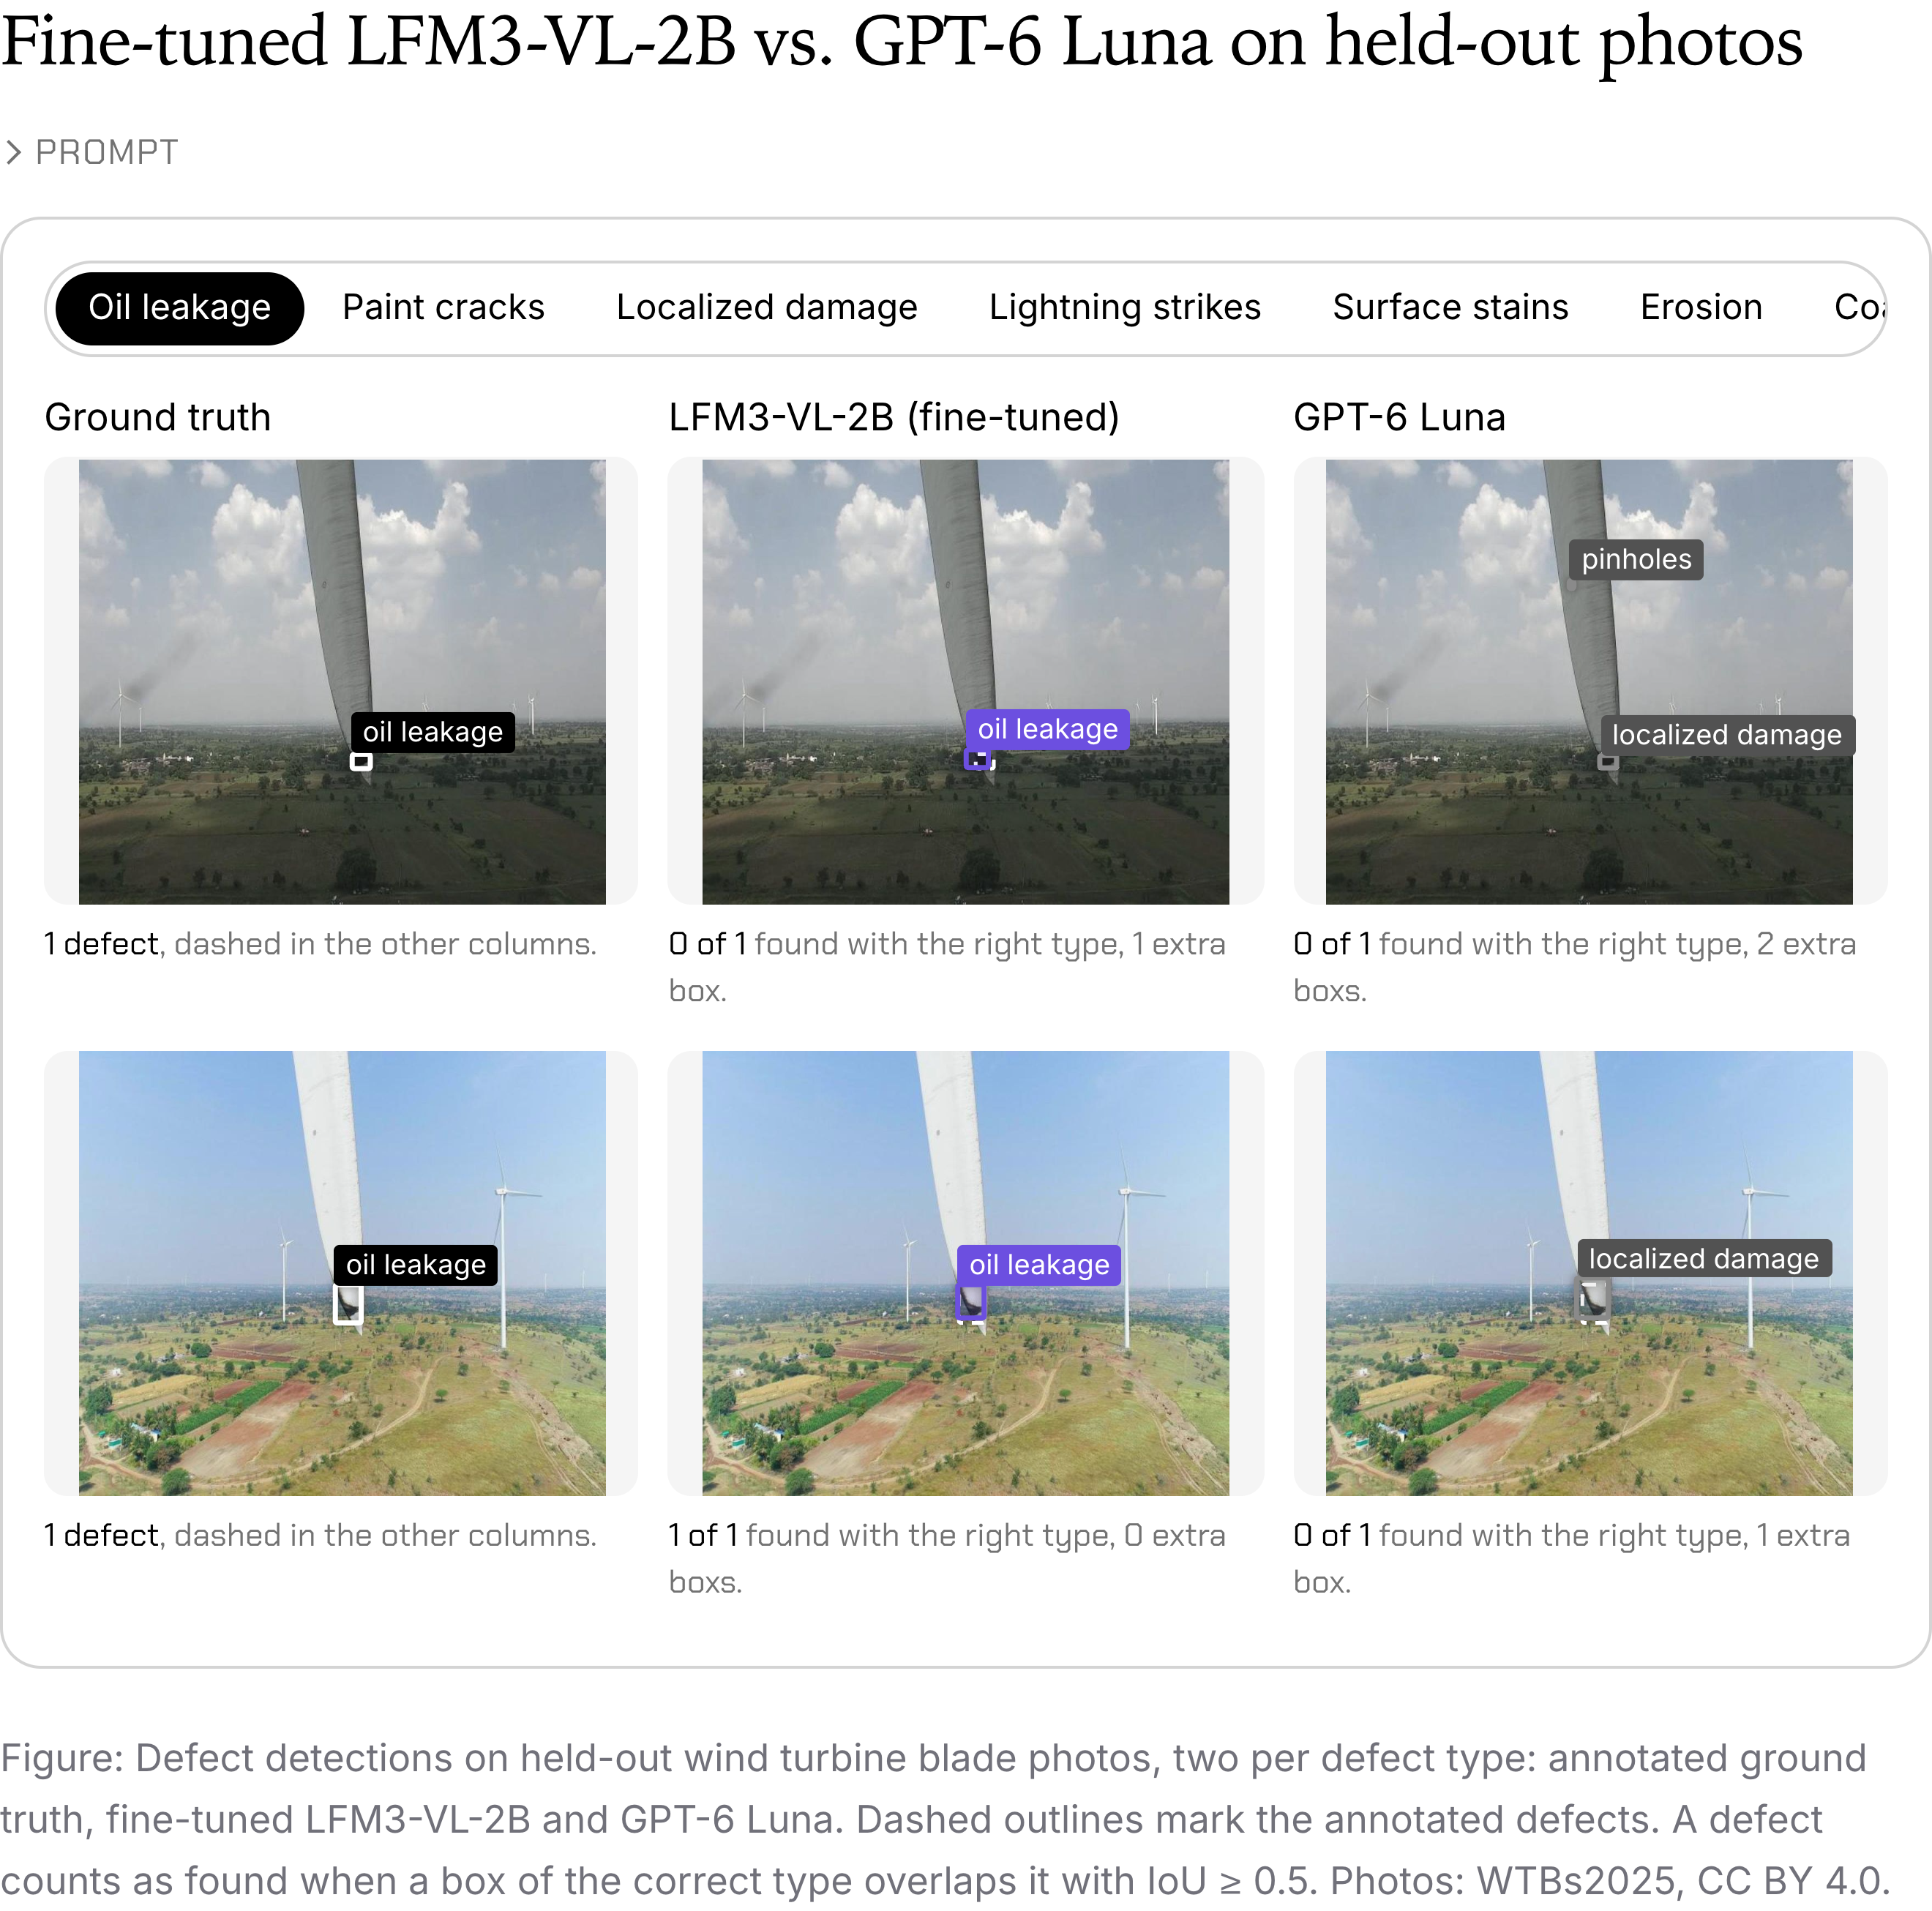
图:留出风力涡轮机叶片照片上的缺陷检测结果,每种缺陷类型两张:标注的真实标签、微调后的 LFM3-VL-2B 和 GPT-6 Luna。虚线轮廓标出标注的缺陷。当类型正确的检测框与缺陷重叠且 IoU ≥ 0.5 时,计为检出。照片:WTBs2025,CC BY 4.0。
未经微调时,LFM3-VL-2B 和 GPT-6 Luna 能在不到 10% 的图像中正确识别这些缺陷类型。一次短时间微调将 LFM3-VL-2B 的分类准确率提升到 67%,检测 F1 从 0.003 提升到 0.11,而 GPT-6 Luna 为 0.01。雷击图像能说明这一差异:GPT-6 Luna 常常能正确定位缺陷,却把标签打错,而微调后的模型能正确识别出雷击。除了分类和检测,模型还能就同一张图像回答自然语言问题。例如,它可以定位可见的损伤,或写出一段简短的检测结论,包含缺陷类型、支撑证据和位置。
机器人:教 LFM3 执行动作
我们探讨了 LFM3-VL-2B 作为机器人应用基础模型的潜力,涵盖三个互补方向:(1) 高层工具编排,(2) 视觉语言导航,(3) 底层操作。
编排。 在基于 LLM 的机器人规划与控制(SayCan、Code as Policies)以及近期的物理编排器(VoLo、Gemini Robotics ER 2)的基础上,我们微调 LFM3-VL-2B,让它通过工具操控机械臂。给定一条请求和当前相机图像,模型逐步推理,用指向来定位物体,用深度工具测量它们,再通过运动规划器完成操作。随后它在下一帧图像中检查每一步的结果并回报,包括请求超出可达范围或存在歧义的情况。任务涵盖关系选择、按测量属性排序以及环境扰动,全部在 Isaac Sim 中仿真。架构无需改动。我们在约 40,000 个样本上训练了一个 rank-32 的 LoRA 适配器,样本混合了操作轨迹与通用的工具调用和指向数据,在单块 AMD Instinct MI325X 上耗时约 6 GPU 小时。再配上一个微调过的 d1-2B 技能监控器,面对打滑、卡死和拖拽等扰动时,恢复成功率还能再翻一倍。
导航。 在视觉-语言导航任务中,LFM3-VL-2B 读取路线描述和一小段 RGB 帧历史,预测导航目标与残差量化后的轨迹基元,思路借鉴了 LightNav-0 的动作接口。每次决策由五个 token 组成:两个空间/控制 token,以及三个分层量化的编码,共同表示一条含十个路点的路径,速度控制器可以跟踪这条路径。我们只改用了 2,068 个词表 token,其余架构保持不变。训练使用 280 万个样本,在 MI325X GPU 上耗时 72 GPU 小时。在未见过的验证场景中,采用严格的连续控制评测协议(禁用贴墙滑动、必须显式停止),所得模型在 R2R 上的成功率为 53%,在 RxR 上为 43%。我们还观察到模型在不同相机角度和指令语言下都保持稳健。在 Jetson AGX Orin 上,不使用视觉提示缓存、以 TensorRT FP16 运行时,我们的导航模型以超过 2.5 Hz 的频率更新路点轨迹。
操控。 我们将 LFM3-VL-2B 改造为视觉-语言-动作(VLA)模型,做法借鉴 OpenVLA-OFT 和 StarVLA-α 的并行动作预测:一个小型残差 MLP 在一次前向传播中,把八个动作查询 token 的隐藏状态映射为八步连续机器人动作。本体感知信息同时以离散化文本和特定具身的学习投影两种形式提供,整个网络端到端微调。我们在 MI325X GPU 上训练了 170 GPU 小时,得到一个通用 checkpoint,训练数据来自 15 种具身的仿真和真机数据,涵盖单臂、移动操作平台、双臂平台以及一台人形机器人。由此得到的 VLA 在四个 LIBERO 套件上平均成功率达到 96.2%,在 RoboCasa-GR1 桌面任务上达到 45.7%。在 Jetson AGX Orin 上,使用 TensorRT 以 FP16 精度推理,生成动作块耗时不到 50 ms。
开始使用
LFM3 已在 Hugging Face 和 Liquid AI API 上线,今天就可以开始构建。
LFM3 兑现了我们的愿景:让 AI 随处运行。这些模型:
- 开放权重: 可下载、可微调、可部署。
- 第一天就快: 原生支持 llama.cpp、MLX 和 vLLM,覆盖 Apple、AMD、NVIDIA、SGLang 和 Qualcomm 硬件。在 Liquid Real-time Inference Pipeline 上部署,应对低延迟、高吞吐的负载。
- 完整的产品家族: 从可定制的基础模型,到专门的文本、视觉、音频、omni 和决策模型,一套架构覆盖多种用例。
期待看到你用它做出什么。
发布合作伙伴
感谢我们的首日发布合作伙伴的支持。LFM3 今天即可在以下平台使用:Ambarella、AMD、Arm、Intel(通过 OpenVINO)、NVIDIA、OpenRouter、Qualcomm(通过 Qualcomm AI Hub 和 GenieX)以及 Vercel。感谢 Mercedes-Benz 和 Shopify 在预发布阶段的测试与评估合作。
感谢开发者生态给予我们的支持:Atomic、Cactus、Hugging Face、llama.cpp、LM Studio、MLX、Ollama、基于 SGLang 的 RadixArk、.txt、Unsloth、vLLM 和 ZML。
引用
引用时请使用以下参考文献或 BibTeX:
Liquid AI, "Introducing LFM3: Every Modality for Specialized Intelligence", Liquid AI Blog, October 2026.
@article{liquidAI2026LFM3,
  author = {Liquid AI},
  title = {Introducing LFM3: Every Modality for Specialized Intelligence},
  journal = {Liquid AI Blog},
  year = {2026},
  note = {www.liquid.ai/blog/lfm3},
}