Liquid AI 发布 LFM3:一套混合架构撑起六个 2B 级模型
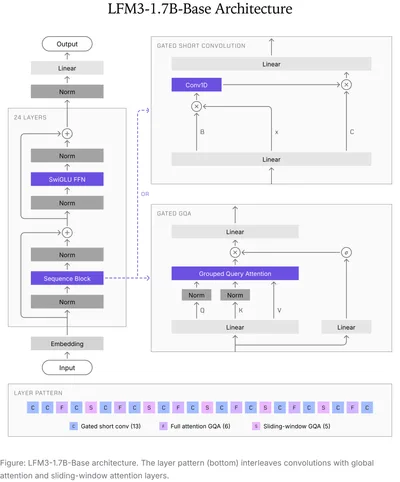
LFM3-1.7B 在 22T token 上预训练,24 层里 13 层是门控短卷积、5 层滑窗注意力、6 层全局注意力,4-bit 量化后约 1 GB,128K 上下文的 KV cache 只要 1.6 GB。同门还有视觉、音频、全模态和两个决策模型。
LFM3-1.7B 在 22T token 上预训练,24 层里 13 层是门控短卷积、5 层滑窗注意力、6 层全局注意力,4-bit 量化后约 1 GB,128K 上下文的 KV cache 只要 1.6 GB。同门还有视觉、音频、全模态和两个决策模型。