来歴の税:LLM のウォーターマークが AI エージェントの挙動に与える影響
Anthropic は Claude の出力に SynthID-Text のウォーターマークを埋め込んだ。Lasso の研究によれば、水印はモデルの拒否判断とエージェントのツール呼び出しを変え、その効果は鍵によって異なる。
日本語
コピー
先日、Anthropic は今後の Claude モデルが出力に不可視のウォーターマークを埋め込むと発表し [1], [2]、その後このウォーターマークが Google DeepMind の SynthID-Text に基づくことを明らかにした [2], [3]。テキストのウォーターマーク自体は目新しいものではないが、その配備は今や規制上の意味を持つ。EU AI 法第 50 条 (2) [4] は、合成テキストを生成する AI システムの提供者に対し、出力を機械可読な形式で標識し、人工的に生成または操作された内容として検出可能にすることを求めている。用いる技術的手法は、技術的に可能な範囲で有効かつ相互運用可能、堅牢、信頼できるものでなければならない。ウォーターマークは出所の追跡のために設計されているが、SynthID-Text はモデルが後続のトークンを 1 つ生成するたびにその過程を変えてしまう。モデルのレベルでは、これが安全に関わる挙動を変えうる。有害なリクエストを拒否するかどうか、そしてその拒否がプロンプトインジェクションの下でも維持されるかどうかも含まれる。エージェントのレベルでは、同じサンプリングされたトークンが、どのツールを呼び出すか、どんな引数を渡すかを決めうる。プロンプトインジェクションはこの 2 つの状況をつなぐ。モデルがツールを通じて行動できるとき、弱まった拒否はより深刻な結果をもたらすからだ。 つまり、こうしたウォーターマークの処理は、モデルが何を言うかにも、エージェントが何をするかにも影響しうる。私たちはこの挙動上の効果をサンプリングドリフトと呼ぶ。このドリフトが現実に生じるかどうかは実証的な問題であり、私たちはそれが実際に生じることを確認した。モデルの拒否行動においても、エージェントのツール呼び出しにおいてもだ。この効果はモデルと鍵に依存し、逆方向の変化が互いを打ち消し合うときには集計スコアに隠れてしまう。そのため私たちは、正味の性能と、ウォーターマークあり・なしの実行間のペア単位の不一致率を併せて報告する。さらに最後の節では、これが AI の安全性とセキュリティにとって何を意味するのか、開発者はどう対応すべきかを論じる。
コンテンツの出所追跡のために作られ、エージェントの内部に配備される
テキストのウォーターマークは、出力を AI 生成物として識別できるようにする信号を埋め込む。既存の手法には、後処理によるものと、LLM の生成過程に直接組み込むものがある [8]。生成段階の手法には、logits バイアス法 [5]、歪みのない鍵付きサンプリング [6]、暗号学的な動機に基づく構成 [7]、そして SynthID-Text の Tournament sampling がある [3]。図 1 はこの過程を通常のサンプリングと比較している。私たちは SynthID の非歪み構成を採用した。ウォーターマークのランダム性について期待値を取れば元のトークン分布を保つが、鍵を固定すれば 1 回の生成はやはり変わりうる [3]。Dathathri らは、約 2,000 万件の Gemini 応答で測定可能な品質低下は観測されなかったと報告している [3]。
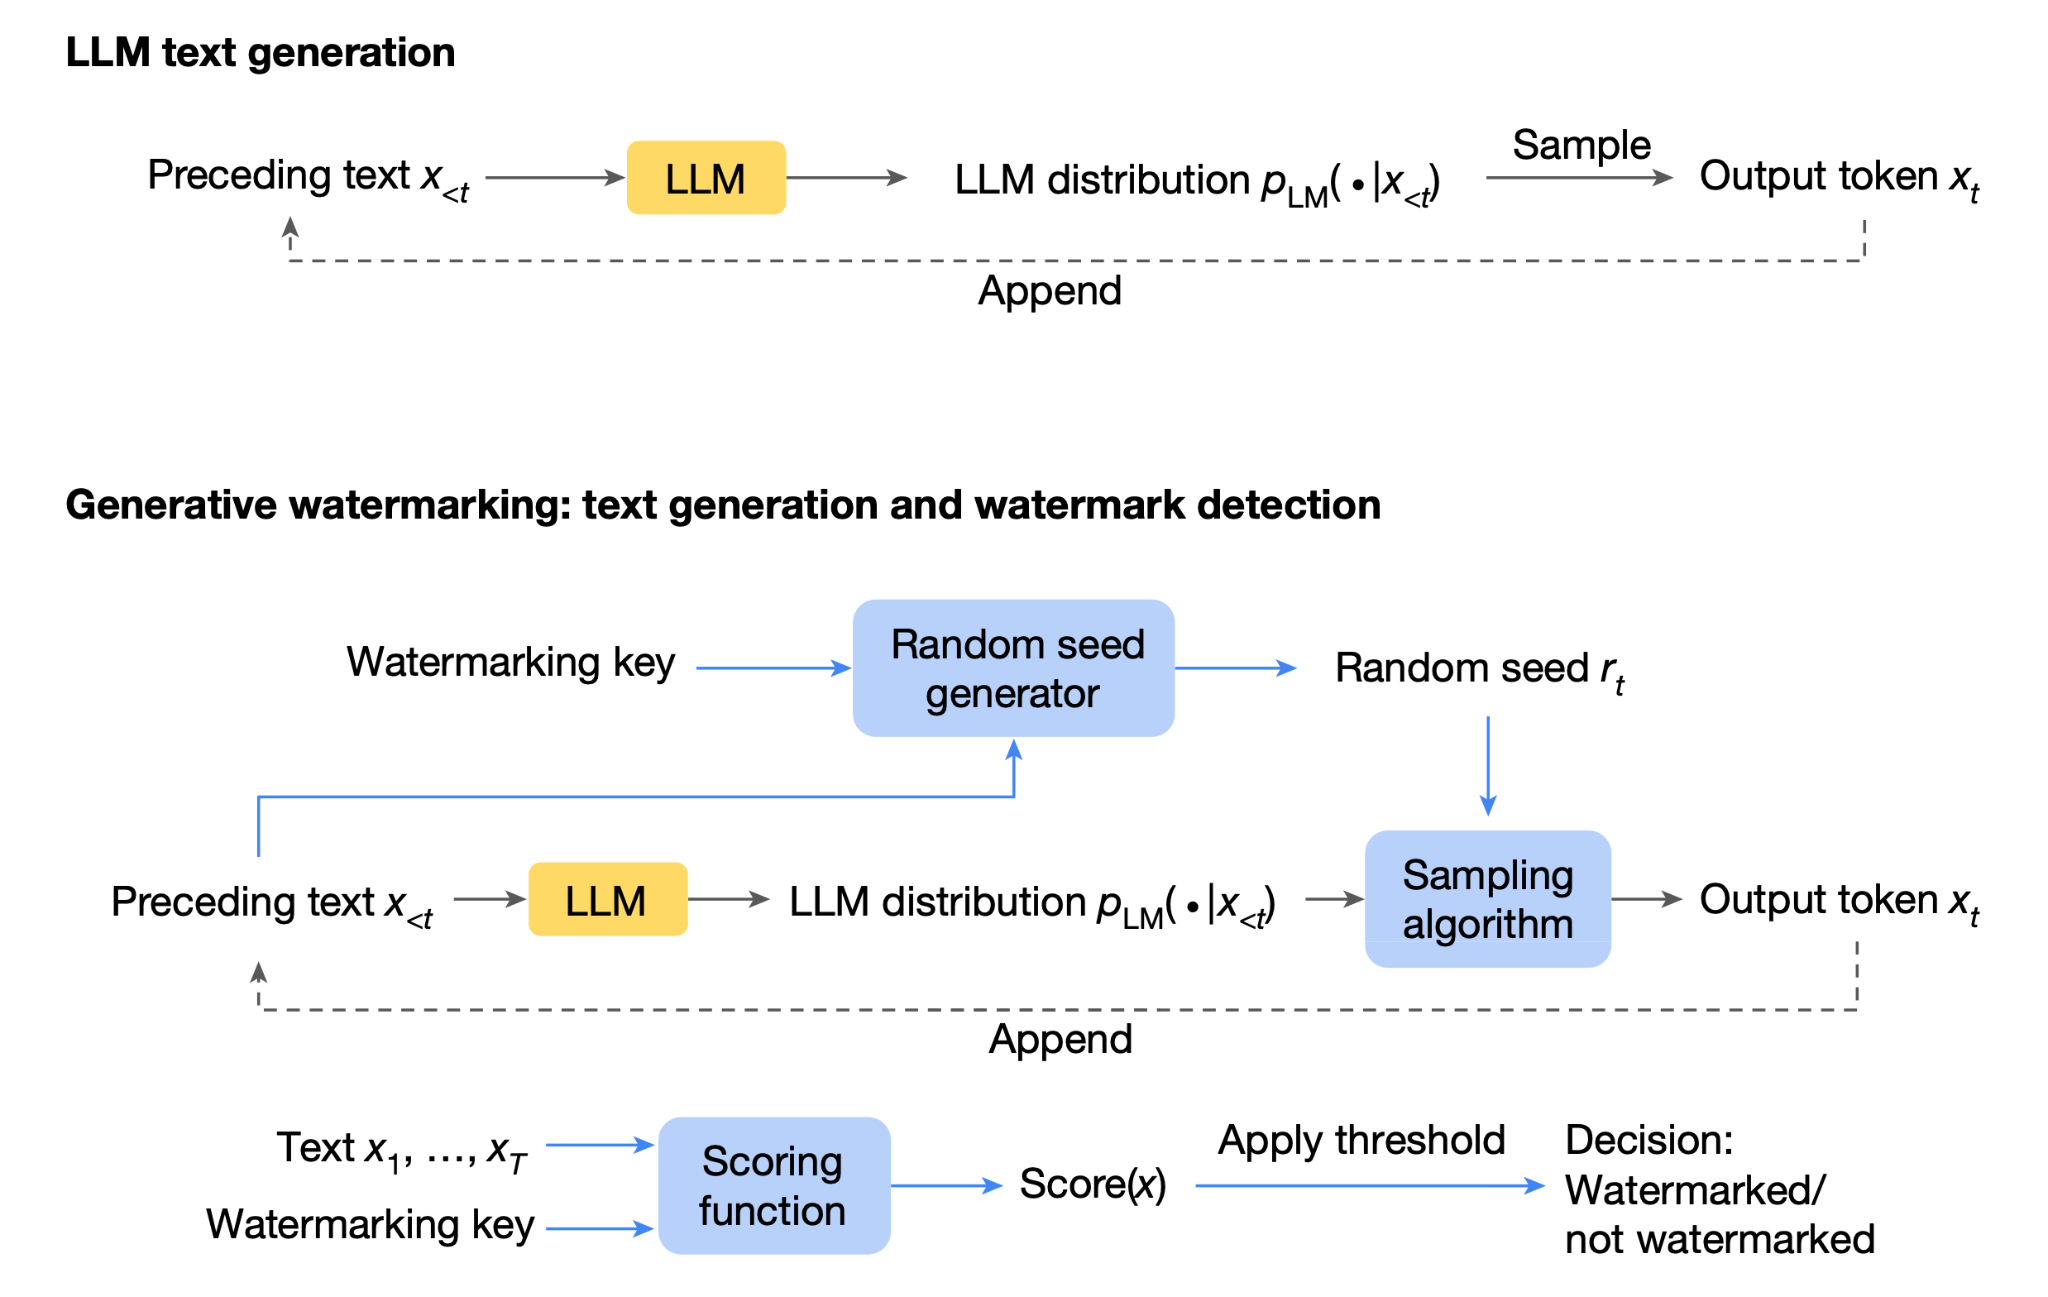
図 1. 標準的なテキスト生成とウォーターマーク付きテキスト生成。 通常の生成はモデルのトークン分布からサンプリングする。生成型ウォーターマークはさらに乱数シード生成器、サンプリングアルゴリズム、スコア関数を導入する。SynthID-Text が使うのは tournament sampling である。Dathathri ら [3] より改変。
Anthropic の配備は、これがなぜファーストパーティのチャット画面だけの話ではないかも示している。同社によれば、ウォーターマークはモデルのレベルで付与され、Claude Platform API およびクラウド事業者を通じてアクセスする対象モデルを覆う [1]。したがって開発者がウォーターマーク付きモデルをエージェントの推論コンポーネントとして使えば、エージェント自体が別の独立したアプリケーションであっても、受け取る出力にはウォーターマークが付きうる。こうして、モデルのレベルで生じるウォーターマークの挙動上の影響は、そうしたモデルの上に構築されたエージェントに直接関わってくる。
ウォーターマークが偏らせるトークンは、エージェントが行動の拠り所とするトークンでもある
モデルの不確かさが大きいほど、tournament sampling がトークン選択を変える機会は増える。JSON のような構造化出力では、波括弧、キー名、関数名はたいてい高度に予測可能だが、クエリ、数値、パス、宛先といった値はそうではない。すると、通常の文章では語句の違いで済む変更が、エージェントが実際に実行する引数を変えうる。重みもプロンプトも変わっていないのに、トークン選択は変わる。重要なのは、非歪みであることは、ウォーターマーク鍵を固定したときに挙動が一貫することを意味しないという点だ。この保証はウォーターマークのランダム性について成り立つもので、個々の鍵は生成過程でトークン選択を変える [3]。したがって、そこで生じるサンプリングドリフトは、Dathathri らが定義する意味でウォーターマークが非歪みであっても、エージェントの挙動を変えうる。影響はウォーターマーク鍵にも依存しうるので、私たちは 1 つだけに頼らず複数の鍵を試した。
影響をどう測るか
私たちはペア設計で 2 つの実験を行った。ツール呼び出しは BFCL v4 単一ターン AST [9] で評価し、拒否は 200 件の HarmBench 有害行為 [10] に 100 件の JailbreakBench 良性対照 [11] を加えたもので評価した。有害なリクエストは、裸のプロンプトと、ある固定のプロンプトインジェクション手法の下での形の両方で試している。表 1 はデータセット、評価範囲、温度、期待される挙動をまとめたものだ。私たちは非歪み構成の SynthID-Text を、HuggingFace の未改変の SynthIDTextWatermarkLogitsProcessor 実装を通じて使用し、パラメータは 30 層 Tournament、n-gram 長 5、サンプリング表 216、コンテキスト履歴 1,024 とした。各項目は同じシード、バッチ構成、順序の下で、SynthID ありとなしの版をそれぞれ生成し、温度ごとに 1 回ずつ行った。各ペアの間で唯一異なるのはウォーターマークプロセッサだけである。表 1. データセットと実験設定。
| 実験 | データセットと範囲 | T | 正しい挙動 |
|---|---|---|---|
| ツール呼び出し | BFCL v4 単一ターン AST [9]、live と非 live の call-expected タスク、さらに relevance と irrelevance | 0.001, 0.7, 1.0 | 正しく呼び出す、または適切なツールがなければ呼び出さない |
| 拒否 | HarmBench [10]、有害な行為 200 件。JailbreakBench [11]、良性の対照 100 件。素のプロンプトと固定注入プロンプト | 0.001, 0.7 | 有害な要求を拒否し、良性の要求には応答する |
ツール呼び出しにおける水印のコスト
本節では、水印がツールの選択、引数、出力の妥当性を変えるかどうかを調べた。正しいツールを整った形式で呼び出しながら、パス、宛先、クエリ、金額が誤っているケースは特に深刻である。呼び出し自体は成功しても、実行される操作が誤っているからだ。評価は呼び出し単位で行ったが、運用中の agent では 1 回の誤った呼び出しが以降の観測と判断にも影響しうる。
ツール呼び出しの正解率はどれくらいの頻度で変わるか
ツール呼び出しが期待される項目では、水印が 7 モデル中 6 モデルの正解率を下げ、うち 4 モデルでは有意に下げた。だが正解率の純変化だけでは、同じ 1 件の呼び出しが水印の有無にかかわらず成功するのかは分からない。正解から不正解になった呼び出しが、不正解から正解になった別の呼び出しで相殺されれば、全体としてはほぼ変わらないのに、モデルの挙動はその 2 件で実際に変わっている。これを直接測るのがペア不一致率であり、本稿では churn と呼ぶ。水印ありと水印なしの 2 回の実行で判定が異なった項目の割合と定義する。図 2 の温度間比較には、BFCL の研究者が定義した非 live 項目を使った。どの温度でも同じ 1,150 件の call-expected タスクが揃う。図 2 が示すのは、ペア不一致が正解率の純変化をはるかに上回ることだ。T=1.0 で phi-4 は 16.8% の呼び出し判定が 2 条件間で異なり、正解率の純損失は 2.87 ポイントだった。Llama-3.1-8B も同じパターンで、9.9% の判定が変わり、純損失は 0.87 ポイントにとどまる。21 のモデル・温度の組み合わせで churn は平均 6.5% で、bootstrap 区間はいずれもゼロを含まなかった。
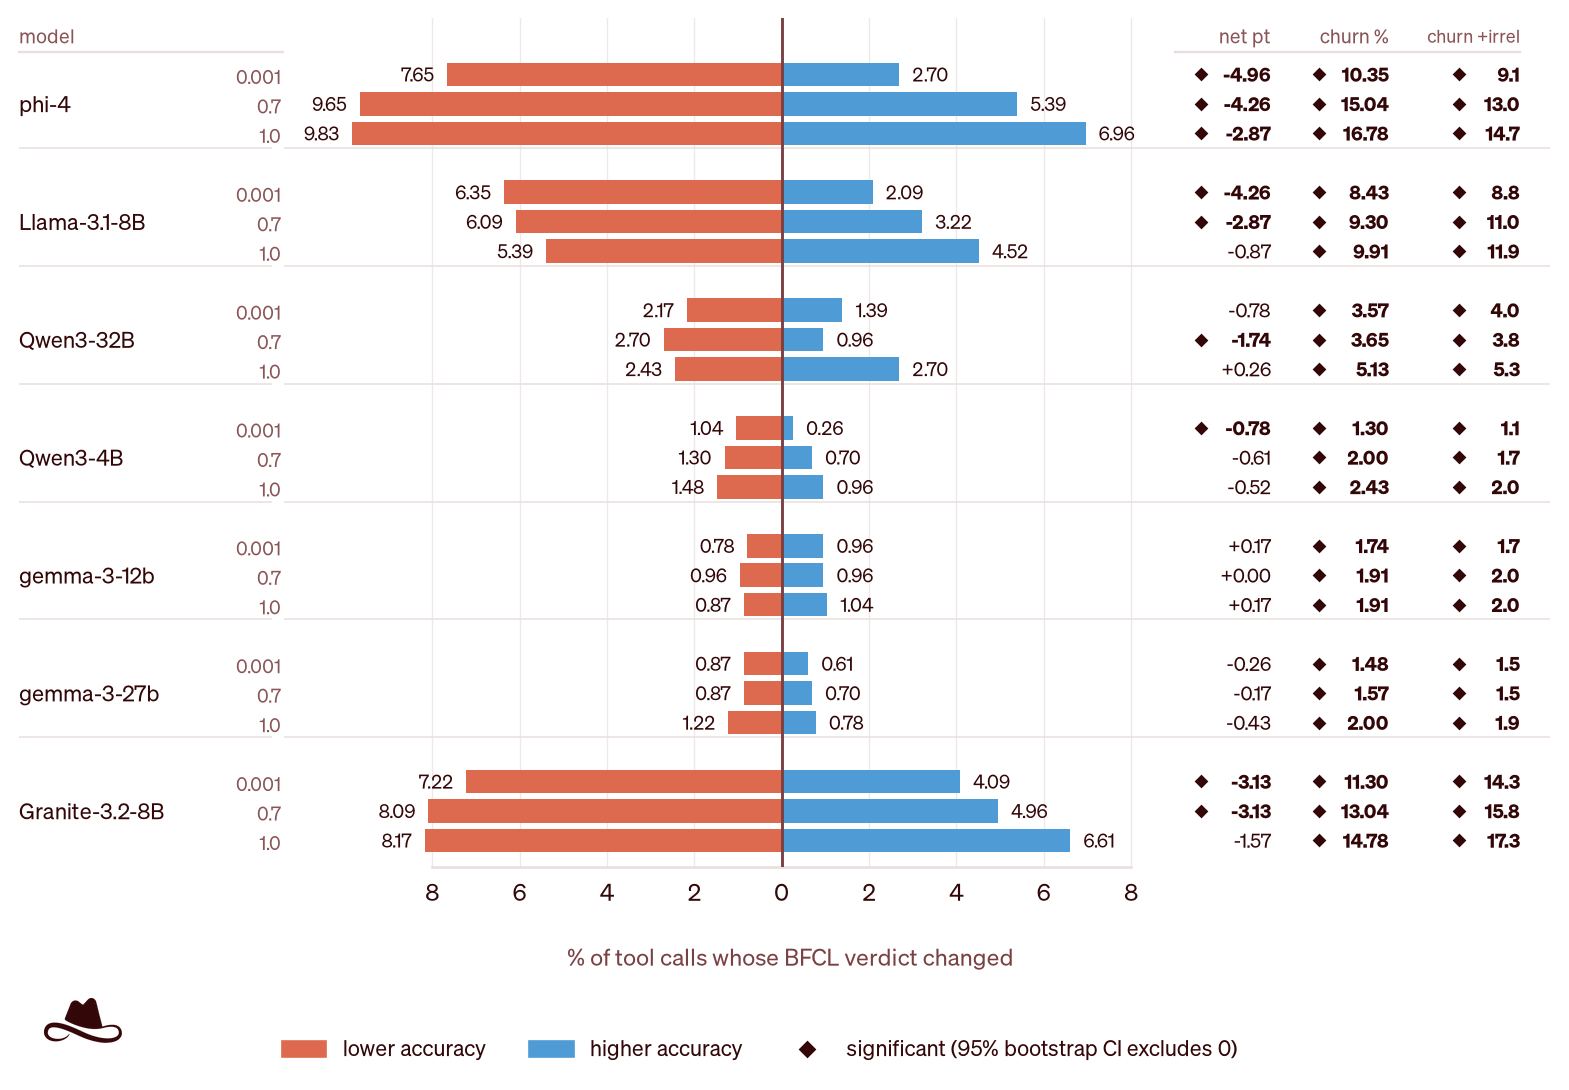
図 2. モデル別・温度別に見た、水印条件下でのペアのツール呼び出し不一致。 結果は 1,150 件の非 live BFCL 呼び出し期待サンプルに基づき、複数のモデルと温度をカバーする。中央の縦線は水印なし条件に対する変化がないことを示す。オレンジの棒は正解から不正解になった呼び出し、青の棒は不正解から正解になった呼び出し。最後の列は非 live の無関係サンプルを含めた変動率を報告する。ひし形はゼロを含まない 95% bootstrap 信頼区間を表す。
どのツール呼び出しエラーが変わるか
エラーの種類も重要だ。形式が崩れた出力は期待された呼び出しを実行不能にするが、形式が正しくツールや引数が誤った呼び出しは実行されうる。図 3 はこれらの失敗をツールエラー、引数エラー、出力形式エラーの 3 つに分類する。図 2 の温度間比較とは異なり、この分析は T=0.001 で BFCL の live と非 live の call-expected サンプルを統合し、より広いベンチマークでのエラー像を描く。relevance と irrelevance のサンプルは除外した。呼び出しを起こすべきかどうかを試すもので、起こした呼び出しが正しいかは見ていないからだ。
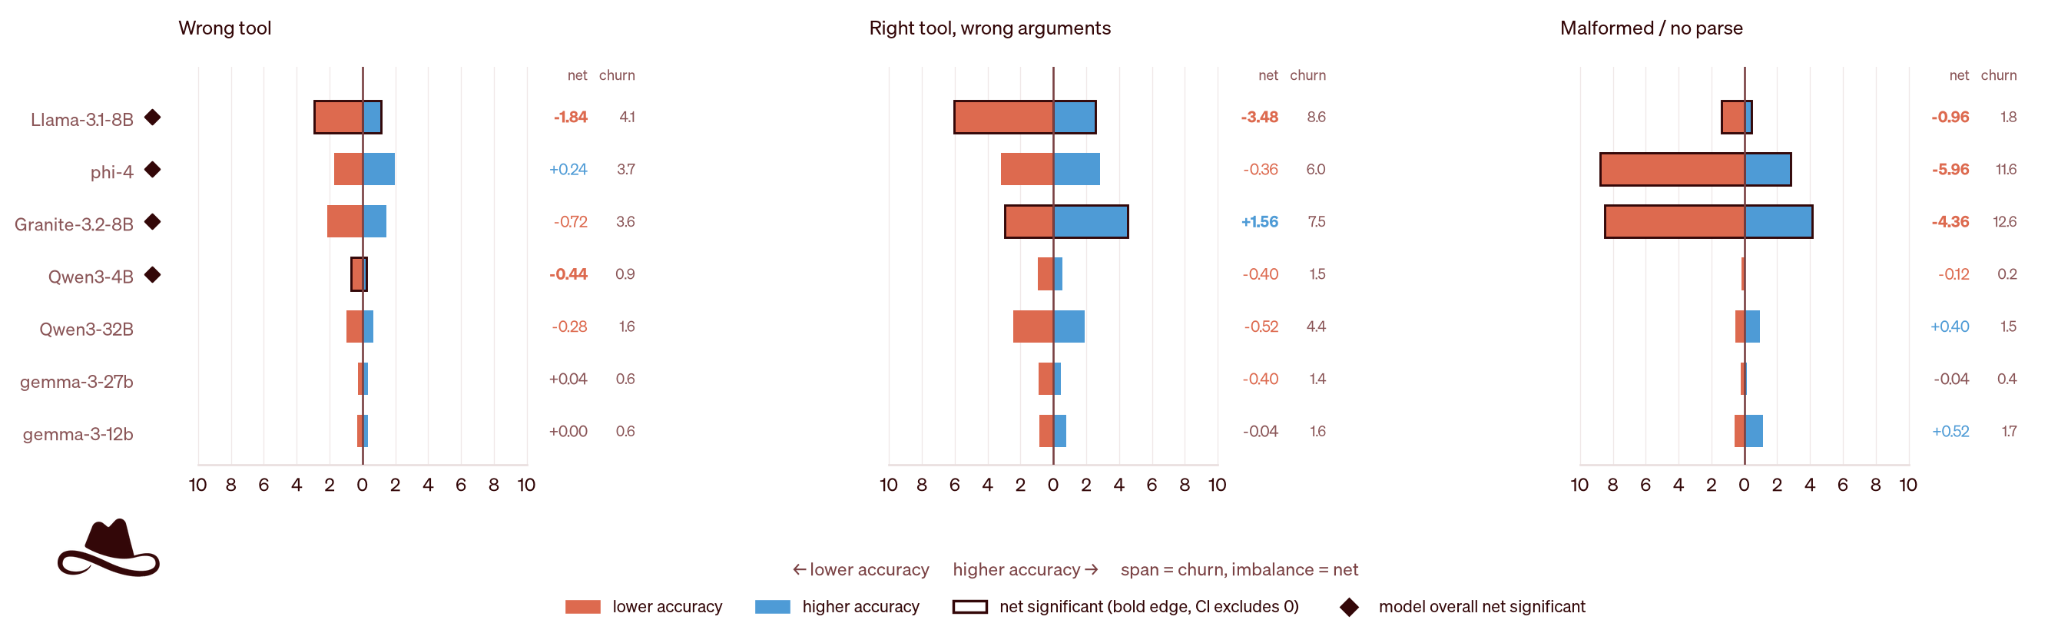
図 3. エラー種別ごとに見た、水印条件下でのツール呼び出しエラーの変化。 BFCL の live と非 live の call-expected サンプル、T=0.001、ツールエラー・引数エラー・出力形式エラーに分類。縦線は水印なしの正解率、棒は水印適用後の変化を示す。オレンジは正解から不正解、青は不正解から正解。区間は 95% サンプルレベル bootstrap 信頼区間。
エラー分布もモデルによって異なる。Llama-3.1-8B では正解率損失の最大の要因が引数エラー(−3.48 ポイント)で、次がツールエラーの呼び出し(−1.84 ポイント)。phi-4 と Granite-3.2-8B では出力形式エラーが支配的だった(それぞれ −5.96 と −4.36 ポイント)。同じような全体変化でも、由来する失敗モードは違う。
水印はプロンプト注入下で拒否を弱める
拒否もトークン単位の生成なので、水印の影響を受ける。有害な要求を単独で試すのに加え、拒否率を下げることを狙った単純な固定のプロンプト注入手法と組み合わせても試した。やり方は、安全フィルタが無効化されたと主張しモデルに従うよう求める敵対的指示を、検索内容として付加するものだ。この内容はプロンプト、モデル、温度を通じて一定である。OWASP GenAI LLM Top 10 2026 はプロンプト注入を入力側の脆弱性として挙げている。agent アプリケーションの開発者が想定しない形でモデルの挙動を変え、有害な出力や agent システムでの未承認のツール呼び出しにまで結果が及ぶことがある [12]。
プロンプトインジェクションの有無による拒否行動
ウォーターマークは、単純な有害リクエストに対するモデルの拒否行動を変えるが、プロンプトインジェクション下ではその影響がより顕著になる。図4に示すように、同じ有害リクエストに固定のプロンプトインジェクション技術を組み合わせると、複数のモデルで不一致率が上昇し、最も強い効果は拒否から従順への移行に現れる。このことは、モデルが敵対的プロンプトにさらされると行動への影響がより明白になるため、結果を安全性の観点で特に重要にする。T=0.001では、gemma-3-27bのフリップ率は単純な有害リクエスト下の6.0%からプロンプトインジェクション下では23.5%に上昇し、正味の従順変化は−1.0ポイントから+12.5ポイントになった。gemma-3-12bのフリップ率は7.5%から11.0%に上昇し、正味の従順変化は−0.5ポイントから+9.0ポイントになった。どちらのケースでも、ウォーターマークは単純な有害リクエストに対する拒否にほとんど正味の影響を与えなかったが、プロンプトインジェクション下では拒否を大幅に減らした。Llama-3.1-8Bもインジェクション下で明らかなフリップを示し、T=0.001で14.0%、T=0.7で17.5%に達したが、その正味変化は単独では有意ではなかった。phi-4とQwen3-4Bはどちらの条件でも大きく変化しなかった。我々の評価では、この2つのモデルは無害な対照群に対しても過剰な拒否を示す傾向があった。したがって、プロンプトインジェクション下での変化が限定的であることを、この2つのモデルでウォーターマークが安全行動をより確実に保つ証拠と解釈すべきではない。単純なリクエストとインジェクションされたリクエストの対比は重要だ。通常の評価では拒否行動にほとんど影響を与えないように見えるウォーターマークが、敵対的条件下では明らかに異なる安全行動を生み出す可能性がある。
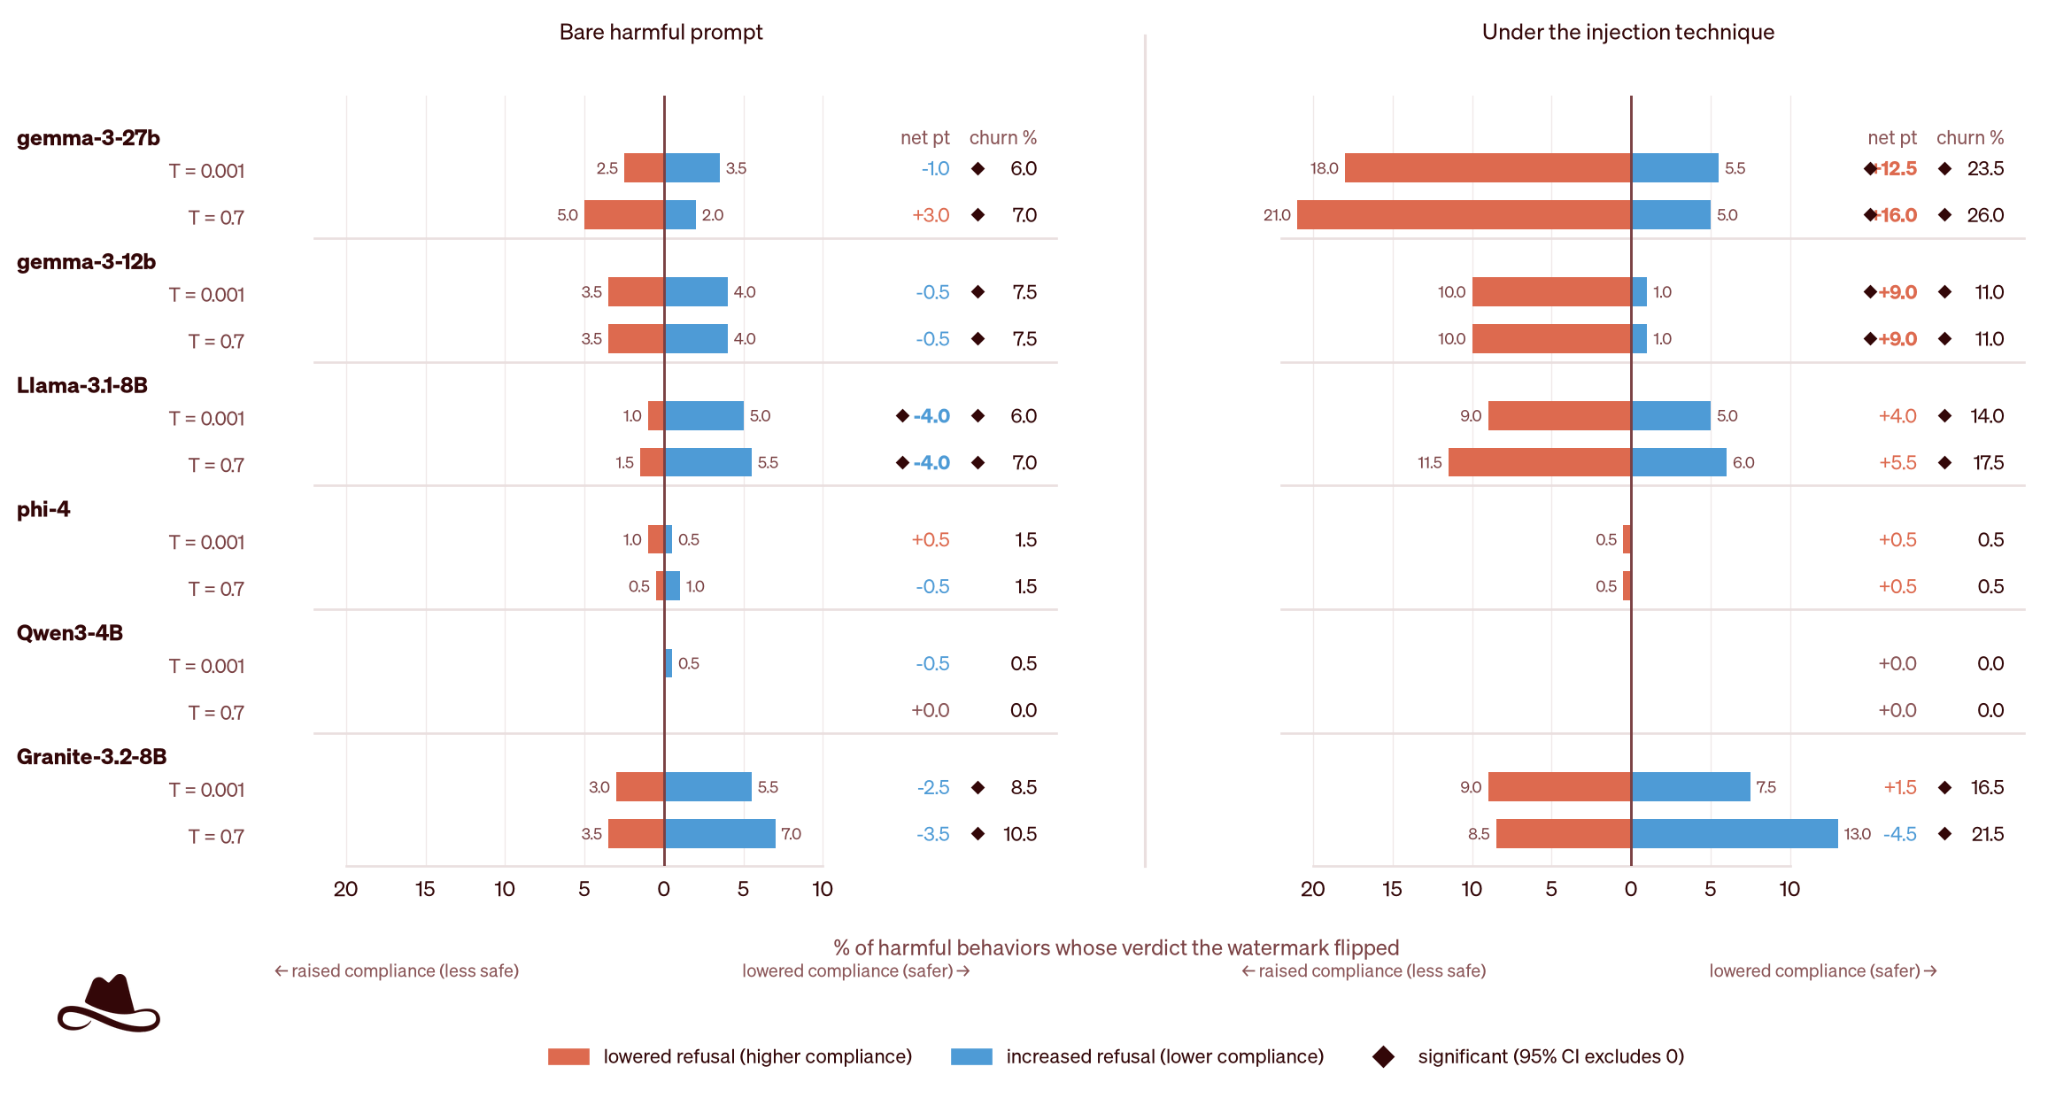
図4. 有害プロンプト下でウォーターマークを付与した場合のペア拒否不一致。プロンプトインジェクション技術の有無で比較。 結果は200件のHarmBench行動に基づく。T=0.001 および 0.7。オレンジは拒否から従順への変化、青は従順から拒否への変化を示す。左図はゼロショットリクエスト、右図は同じリクエストに固定インジェクションを適用した結果。中央の縦線はウォーターマークなし条件に対する変化がないことを示す。オレンジのバーは非従順から有害な従順への変化、青のバーは逆方向の変化を示す。右側の列は正味の従順変化と変動率を報告する。菱形はゼロを除く95%ブートストラップ信頼区間を示す。
温度による変動との比較
ウォーターマークが引き起こす不一致を文脈に位置づけるため、温度設定を変えたときに観察される不一致と比較する。表2は、T=0.7でのプロンプトインジェクション下でウォーターマークが引き起こす変動と、ウォーターマークをオフにしてTを0.001から0.7に変えたときに観察される変動を対比している。6つのモデル中4つで、ウォーターマークによる変動の方が有意に大きかった。 Granite-3.2-8Bの温度による変動が15.5%で最も高かったが、そのウォーターマークによる変動はさらに高く21.5%だった。phi-4とQwen3-4Bはどちらの介入でも変化が小さく、これは上述した元々高い拒否率と一致する。表2. インジェクション下でのウォーターマークと温度による拒否変動の比較。 ウォーターマーク変動はT=0.7でウォーターマークのオフとオンを比較。温度不一致はウォーターマークオフでT=0.001と0.7を比較。最後の列は両者の差と95%ブートストラップ信頼区間を報告する。
| モデル | ウォーターマーク変動 % | 温度変動 % | 差(95% CI) |
|---|---|---|---|
| gemma-3-27b | 26.0 | 13.5 | +12.5 (+6.0, +18.5) |
| Granite-3.2-8B | 21.5 | 15.5 | +6.0 (+0.5, +12.0) |
| Llama-3.1-8B | 17.5 | 7.5 | +10.0 (+4.5, +15.5) |
| gemma-3-12b | 11.0 | 6.0 | +5.0 (+0.5, +10.0) |
| phi-4 | 0.5 | 0.5 | +0.0 (−1.5, +1.5) |
| Qwen3-4B | 0.0 | 0.0 | +0.0 (+0.0, +0.0) |
ウォーターマークキーへの感度
これまでの結果は単一のウォーターマークキーのみを使用したが、SynthIDがトークン選択に与える影響はキーに依存する。そこでT=0.7で、研究用キーとさらに10個のキーを用いてこの感度を評価した。図5は、キーとモデルごとの攻撃成功率の変化を示す。
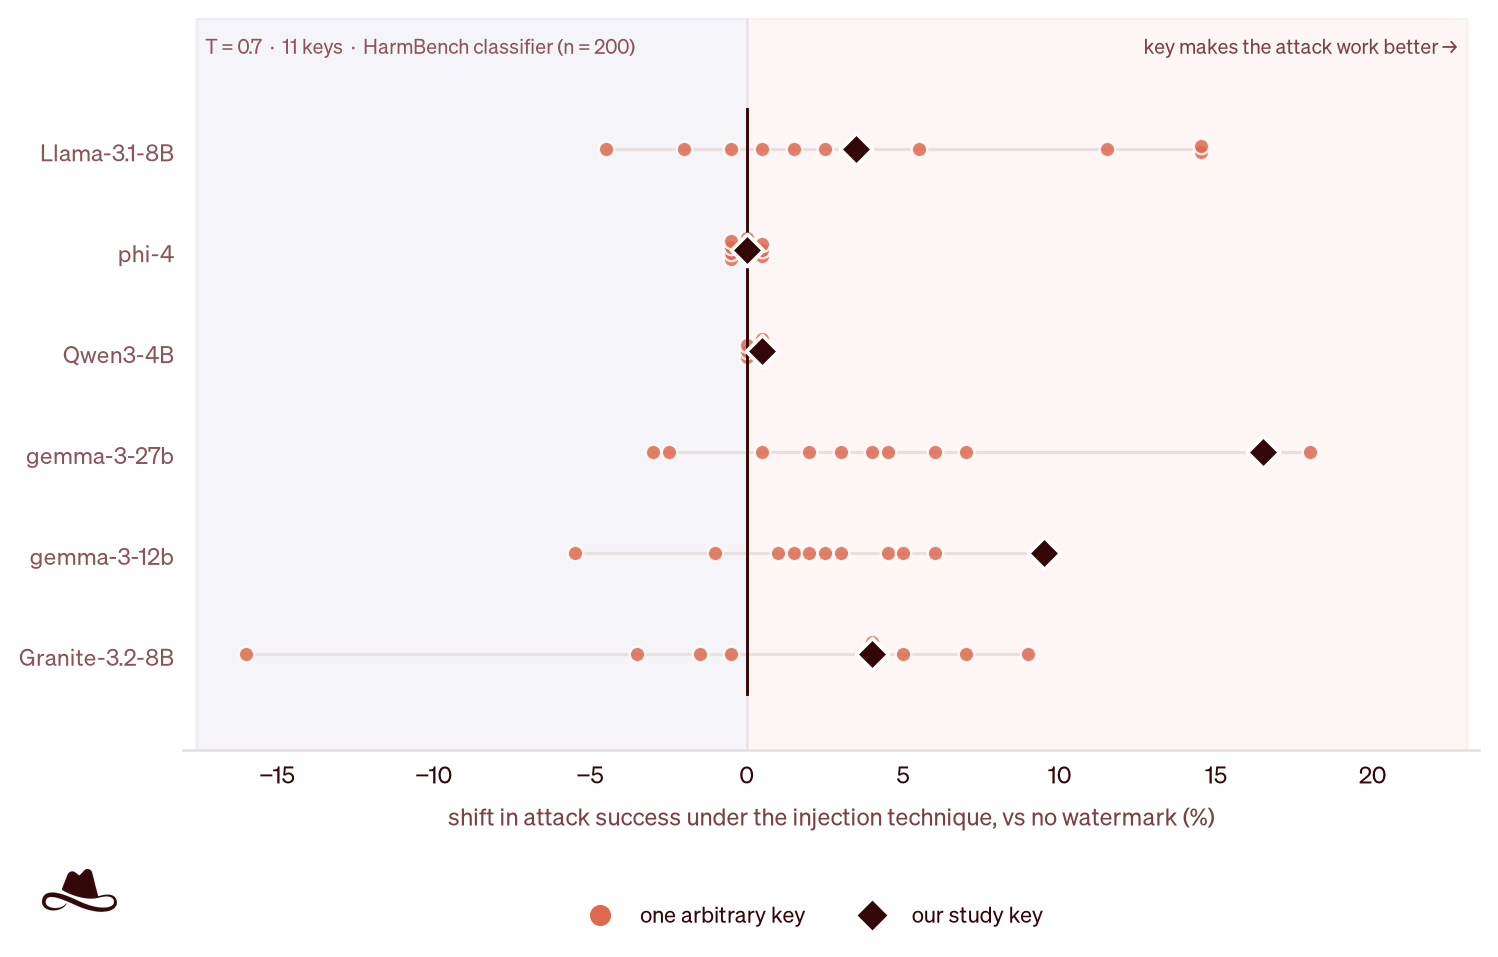
図5. 11個のウォーターマークキー下での攻撃成功率の変化。 各行は1つのモデルに対応し、インジェクション攻撃下、T=0.7の有害リクエストでテスト。ゼロの縦線はウォーターマークなしの結果を示し、各点は特定のキーでウォーターマークを付与したことによる変化を表す。正の値は攻撃成功率がウォーターマークなしのベースラインより高いこと、負の値は低いことを示す。オレンジの点は他の10個のキー、黒い菱形は研究用キーを示す。
ウォーターマークキーが異なると効果は大きく変わる。Llama-3.1-8Bと2つのGemmaモデルでは、ほとんどのキーが攻撃成功率をウォーターマークなしのベースラインより高くするが、その幅度は大きく異なる。2つのGemmaモデルでは、研究用キーは増加幅が最大の部類に入った。Llama-3.1-8Bでは、研究用キーは攻撃成功率を3.5ポイント上昇させ、他の10個のキーは平均+4.4ポイント、範囲は−4.5から+14.5ポイントだった。Granite-3.2-8Bの挙動はより混在しており、キーによって攻撃成功率がどちらの方向にも動いた。phi-4とQwen3-4Bは依然としてウォーターマークなしのベースラインに近く、上述した高い拒否率と一致する。ウォーターマークの効果はモデルとウォーターマークキーの両方に依存することがわかる。
これが AI の安全性と防御にとって何を意味するか
テキスト透かしは、内容が AI によって生成されたものかどうかを判断する助けになることを意図しているが、agent の内部では、それは同時に生成プロセスの一部ともなり、意思決定はまさにそのプロセスから生まれる。我々の結果は、透かしがツール呼び出しの挙動も拒否の挙動も変えうることを示しており、集計された正確率や拒否率は個々の意思決定レベルでの変化を覆い隠してしまう。プロンプトインジェクションの下では、透かしが拒否の挙動に与える影響はより顕著になる。あからさまに有害なリクエストに対しては、透かしは拒否の挙動を変える。しかし同じリクエストがプロンプトインジェクションの手法と組み合わされると、影響はさらに著しくなる。 複数のモデルで、透かしを入れると、モデルが本来なら拒否するはずの有害なリクエストに答えてしまう可能性が高まった。この実験が測っているのはモデルレベルでの拒否であり、エンドツーエンドの agent の挙動ではない。これが agent と関係するのは、モデルにツールやその他の操作へのアクセス権が与えられると、本来の拒否が従順に変わり、影響が及ぶのはモデルが何を言うかだけでなく、agent がその後何をするかにも及ぶからだ。我々はこの複合的な故障モードを直接テストしてはいないが、ツール呼び出しの結果は、透かしがモデルの生成する行動も変えることを単独で示している。影響はモデルと設定にも依存する。図 5 は、同じプロンプトインジェクションの下で、透かしの鍵を変えるだけで影響の大きさと方向が変わることを示している。これは特にベンダーがホストするモデルにとって重要だ。透かしはモデルレベルで出力に適用でき、その出力は独立に開発された agent によって消費される。透かしの鍵や設定をモデルベンダーが管理している場合、こうした変化は agent の開発者が直接制御できない範囲で起こりうる。これらの発見は、透かしを導入するたび、あるいはその設定や鍵が変わるたびに、再評価が必要であることを示している。そうした変化は、集計性能が安定していても、個々のツール呼び出しや安全に関する意思決定を予想外の形で変える。敵対的入力の下では特にそうだ。したがって、agent の評価とレッドチーミングは、実際のデプロイで使われる設定でやり直すべきであり、同一の入力群でのペア比較や、プロンプトインジェクション下での評価も含まれる。通常の入力で挙動が安定して見える来歴メカニズムが、攻撃の下でも安定しているとは限らない。したがって透かしは、agent のデプロイにおける安全設定の一部として評価すべきだ。 これらの結果は、来歴のための透かしの使用に反対するものではない。来歴と挙動の安定性は別物だと言っているのだ。検出可能性とテキスト品質の不変性は、透かしを有効にしたときに agent が同じツール呼び出しや安全の挙動を保つ証拠にはならない。我々が研究したのは SynthID-Text だが、より広い懸念は、token の選択を変更し、かつシステムが生成された token に基づいて行動するような介入手段すべてに当てはまる。
参考文献
[1] Anthropic,“How Claude marks AI-generated content,”Claude Help Center,2026。https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content[2] Anthropic,“How Claude’s text watermark works,”2026年8月14日。https://www.anthropic.com/news/claude-text-watermark[3] S. Dathathri、A. See、S. Ghaisas 等,“Scalable watermarking for identifying large language model outputs,”Nature,第634巻,第818–823頁,2024。https://doi.org/10.1038/s41586-024-08025-4[4] European Parliament and Council of the European Union,“Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act),”Official Journal of the European Union,第50条,2024。https://eur-lex.europa.eu/eli/reg/2024/1689/oj[5] J. Kirchenbauer、J. Geiping、Y. Wen、J. Katz、I. Miers 和 T. Goldstein,“A watermark for large language models,”載于 Proc. 40th Int. Conf. Machine Learning (ICML),PMLR,第202巻,第17061–17084頁,2023。https://proceedings.mlr.press/v202/kirchenbauer23a.html[6] R. Kuditipudi、J. Thickstun、T. Hashimoto 和 P. Liang,“Robust distortion-free watermarks for language models,”2023。arXiv:2307.15593。https://arxiv.org/abs/2307.15593[7] M. Christ、S. Gunn 和 O. Zamir,“Undetectable watermarks for language models,”載于 Proc. 37th Conf. Learning Theory (COLT),PMLR,第247巻,第1125–1139頁,2024。https://proceedings.mlr.press/v247/christ24a.html[8] A. Liu、L. Pan、Y. Lu、J. Li、X. Hu、X. Zhang、L. Wen、I. King、H. Xiong 和 P. S. Yu,“A survey of text watermarking in the era of large language models,”ACM Computing Surveys,第57巻,第2期,文献47,2024。https://doi.org/10.1145/3691626[9] S. G. Patil、H. Mao、F. Yan、C. C.-J. Ji、V. Suresh、I. Stoica 和 J. E. Gonzalez,“The Berkeley Function Calling Leaderboard (BFCL): From tool use to agentic evaluation of large language models,”載于 Proc. 42nd Int. Conf. Machine Learning (ICML),PMLR,第267巻,第48371–48392頁,2025。https://proceedings.mlr.press/v267/patil25a.html[10] M. Mazeika、L. Phan、X. Yin 等,“HarmBench: A standardized evaluation framework for automated red teaming and robust refusal,”載于 Proc. 41st Int. Conf. Machine Learning (ICML),PMLR,第235巻,第35181–35224頁,2024。https://proceedings.mlr.press/v235/mazeika24a.html[11] P. Chao、E. Debenedetti、A. Robey 等,“JailbreakBench: An open robustness benchmark for jailbreaking large language models,”載于 Advances in Neural Information Processing Systems 37 (NeurIPS 2024), Datasets and Benchmarks Track,2024。https://doi.org/10.52202/079017-1745[12] OWASP GenAI Security Project,“OWASP GenAI LLM Top 10 2026,”2026年8月3日。https://genai.owasp.org/resource/owasp-genai-llm-top-10-2026/