来源税:LLM 水印如何影响 AI agent 的行为
Anthropic 在 Claude 中部署 SynthID-Text 水印,研究发现其会改变模型拒绝行为和 Agent 工具调用,且效应随密钥而异。
中文
复制
最近,Anthropic 宣布未来的 Claude 模型将在输出中嵌入不可见水印 [1], [2],随后披露该水印基于 Google DeepMind 的 SynthID-Text [2], [3]。文本水印本身并不新鲜,但它的部署如今具有了监管意义。欧盟 AI 法案第 50(2) 条 [4] 要求生成合成文本的 AI 系统提供方以机器可读的格式标记其输出,并使其可被检测为人工生成或操纵的内容,所用技术方案需在技术可行的范围内做到有效、可互操作、稳健且可靠。水印是为来源追溯而设计的,但 SynthID-Text 改变了模型生成每一个后续 token 的过程。在模型层面,这可能改变安全行为,包括模型是否拒绝有害请求,以及这种拒绝在提示注入下是否依然成立。在 agent 层面,同样的采样 token 可以决定调用哪个工具、传入什么参数。提示注入把这两种场景连接起来,因为当模型还能通过工具行动时,被削弱的拒绝会带来更严重的后果。 因此,这样的水印流程既可能影响模型说什么,也可能影响 agent 做什么。我们把这种行为效应称为采样漂移。这种漂移在现实中是否出现,是一个实证问题。我们发现它确实出现,既体现在模型的拒绝行为上,也体现在 agent 的工具调用上。该效应依赖于模型和密钥,并且当相反方向的变化相互抵消时,会被聚合分数掩盖。因此,我们同时报告净性能和加水印与不加水印运行之间的成对不一致率。此外,最后一节讨论了这对 AI 安全与保障意味着什么,以及开发者应当如何应对。
为内容溯源而构建,部署在智能体内部
文本水印会嵌入一种信号,使输出可以被识别为 AI 生成。现有方法包括后处理方式,以及直接集成进 LLM 生成过程的方式 [8]。生成阶段的方法包括 logits 偏置法 [5]、无失真的密钥采样 [6]、基于密码学动机的构造 [7],以及 SynthID-Text 的 Tournament sampling [3]。图 1 将这一过程与普通采样做了对比。我们采用 SynthID 的非失真配置:在水印随机性上取期望时,它保持原始 token 分布不变,而在固定密钥下,单次生成仍可能有所不同 [3]。Dathathri 等人报告称,在近两千万条 Gemini 回复中未观察到可测量的质量下降 [3]。
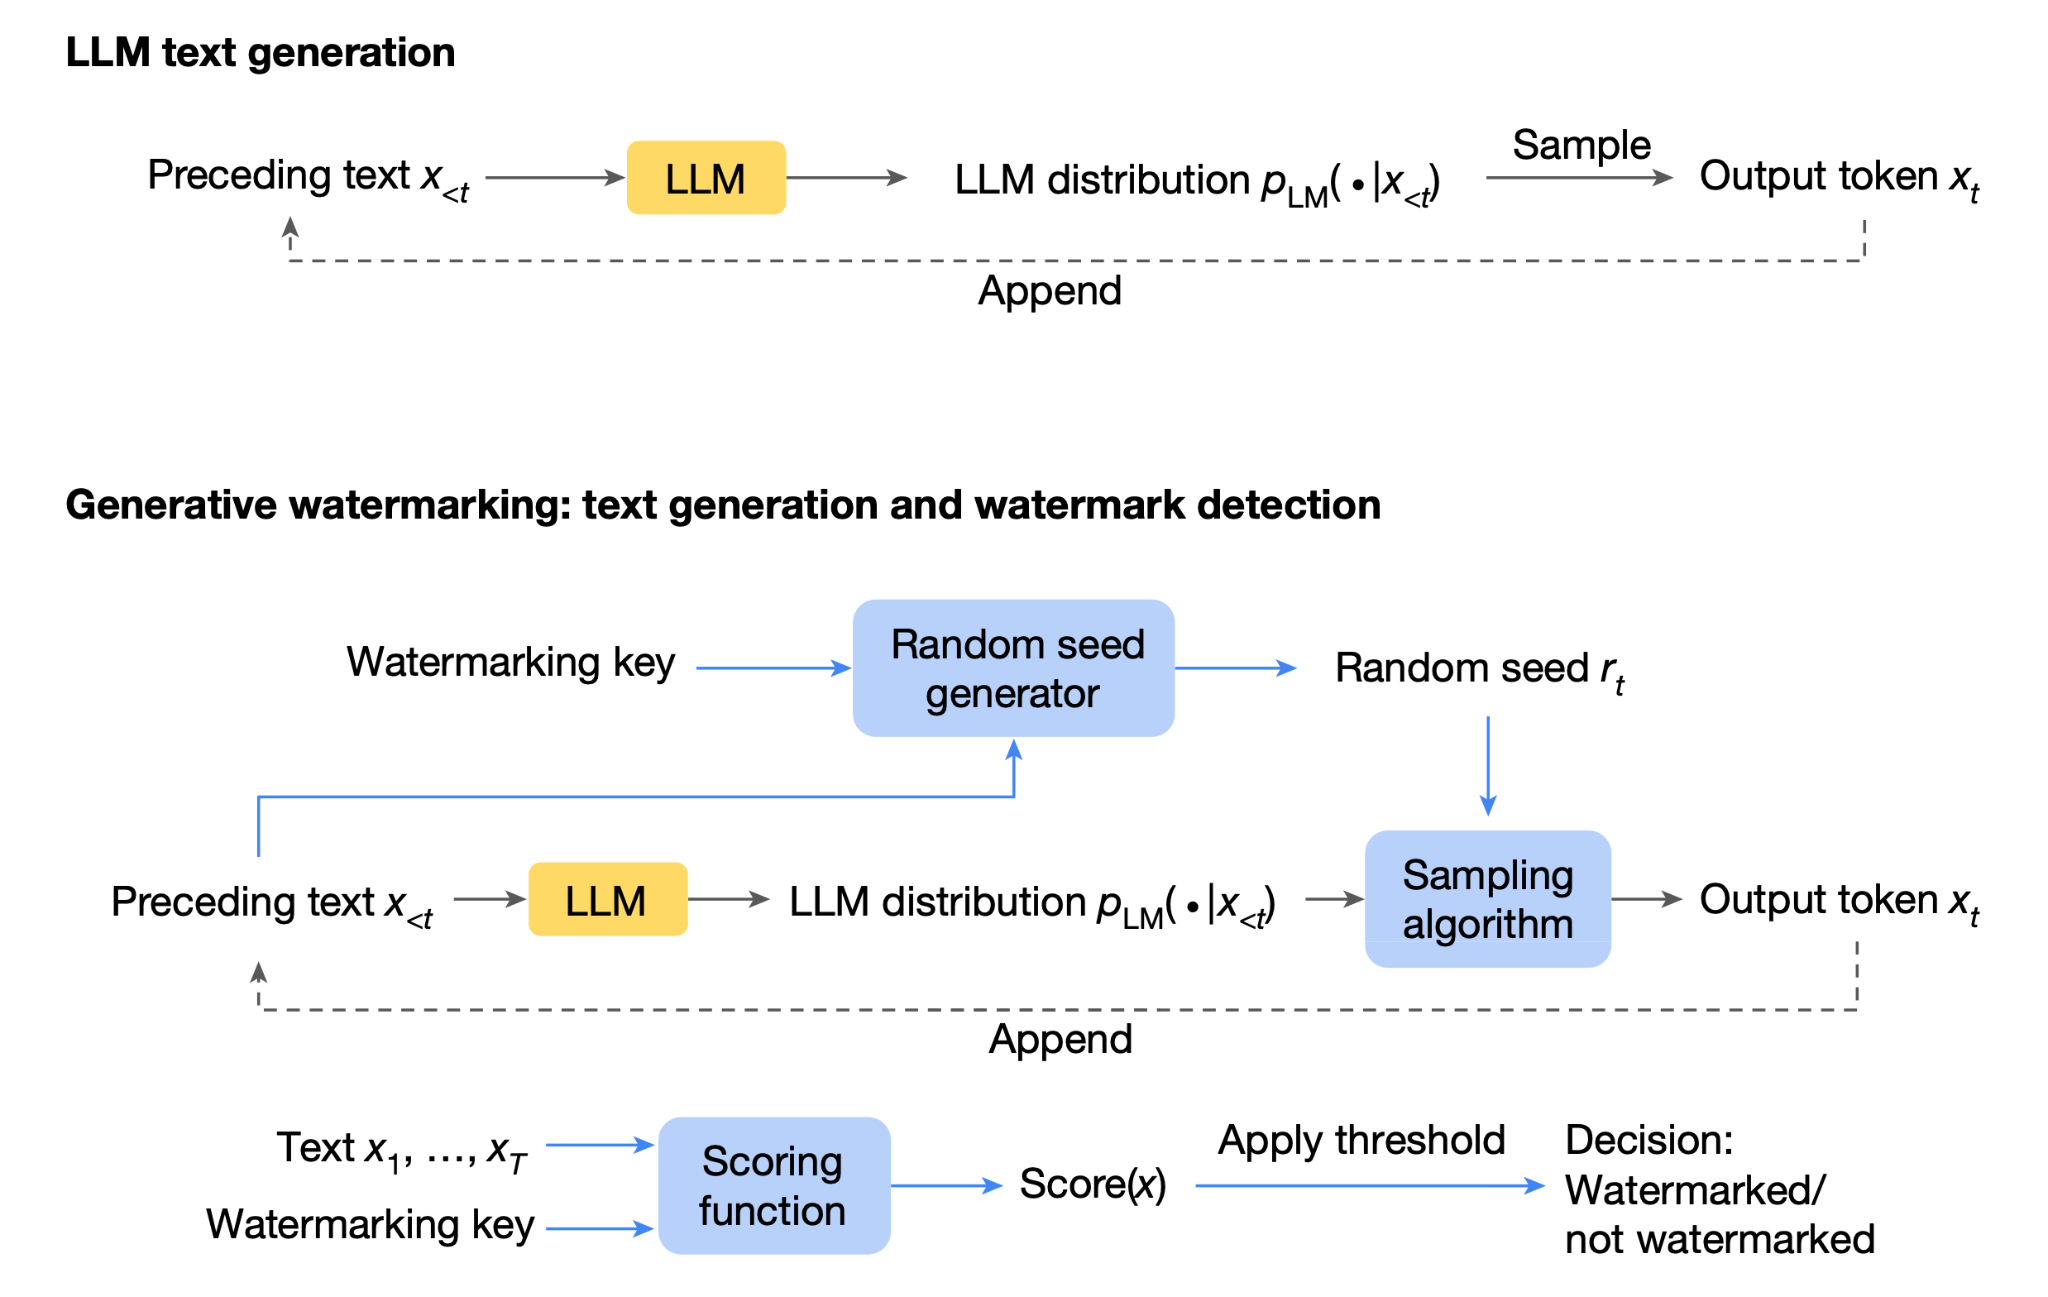
图 1. 标准文本生成与水印文本生成。 普通生成从模型的 token 分布中采样。生成式水印额外引入随机种子生成器、采样算法和评分函数;SynthID-Text 使用的是 tournament sampling。改编自 Dathathri 等人 [3]。
Anthropic 的部署也说明,这件事为何不只关乎第一方聊天界面。该公司表示,水印在模型层面施加,覆盖通过 Claude Platform API 以及云服务商访问的受支持模型 [1]。因此,开发者若把带水印的模型用作智能体的推理组件,即使智能体本身是另一个独立应用,收到的输出仍可能带水印。这样一来,水印在模型层面产生的行为影响,就与围绕这类模型构建的智能体直接相关。
水印所偏置的 token,正是智能体据以行动的 token
模型越不确定,tournament sampling 改变 token 选择的机会就越多。在 JSON 这类结构化输出中,花括号、键名和函数名往往高度可预测,而查询、数字、路径、收件人这类取值则不然。于是,在普通行文中只算措辞变化的一处改动,可能改变智能体实际执行的某个参数。 权重和 prompt 都没变,token 选择却变了。关键在于,非失真并不意味着在固定水印密钥下行为一致。该保证是在水印随机性上成立的,而某个具体密钥会在生成过程中改变 token 选择 [3]。因此,由此产生的采样漂移可能改变智能体行为,尽管按 Dathathri 等人所定义的意义,该水印是非失真的。其影响还可能取决于水印密钥,所以我们测试多个密钥,而不是只依赖一个。
我们如何衡量影响
我们采用配对设计开展两项实验。工具调用在 BFCL v4 单轮 AST [9] 上评估,拒答则在 200 条 HarmBench 有害行为 [10] 加上 100 条 JailbreakBench 良性对照 [11] 上评估,有害请求分别以裸提示和一种固定提示注入技术下的形式测试。表 1 汇总了数据集、评估范围、温度和预期行为。我们使用非失真配置的 SynthID-Text,经由 HuggingFace 未经修改的 SynthIDTextWatermarkLogitsProcessor 实现,参数为 30 层 Tournament、n-gram 长度 5、采样表 216、上下文历史 1,024。每个条目都在相同种子、批次组成和顺序下分别生成带与不带 SynthID 的版本,每个温度各做一次。每一对之间唯一的差异就是水印处理器。表 1. 数据集与实验设置。
| 实验 | 数据集与范围 | T | 正确行为 |
|---|---|---|---|
| 工具调用 | BFCL v4 单轮 AST [9],live 与非 live 的 call-expected 任务,加上 relevance 与 irrelevance | 0.001, 0.7, 1.0 | 正确调用,或在无合适工具时不调用 |
| 拒答 | HarmBench [10],200 条有害行为;JailbreakBench [11],100 条良性对照;裸提示与固定注入提示 | 0.001, 0.7 | 拒绝有害请求;回答良性请求 |
水印在工具调用上的代价
我们检验水印是否会改变工具选择、参数或输出有效性。对正确工具发起格式良好的调用,却带有错误的路径、接收方、查询或金额,后果尤其严重,因为这种调用可以成功执行,却在执行错误的操作。我们逐条评估调用,不过在已部署的 agent 中,一次错误调用还可能影响后续的观察与决策。
工具调用正确率变化的频率
在预期应有工具调用的条目上,水印使七个模型中的六个准确率下降,其中四个下降显著。但准确率的净变化并不能说明同样的单条调用在带与不带水印时是否都成功。一条由正确变为错误的调用,可能被另一条由错误变为正确的调用抵消,使总体结果几乎不变,而模型在这两个条目上的行为其实都变了。我们直接用配对不一致率来衡量这一点,我们称之为 churn,定义为判定结果在水印与无水印两次运行之间不同的条目占比。对于图 2 中跨温度的比较,我们使用 BFCL 研究者定义的非 live 条目,这样在每个温度下都有同一组固定的 1,150 个 call-expected 任务。图 2 显示,配对不一致远大于准确率的净变化。在 T=1.0 时,phi-4 有 16.8% 的调用判定在两种条件下不同,而净准确率损失为 2.87 个百分点。Llama-3.1-8B 呈现同样的模式,9.9% 的判定发生变化,净损失却只有 0.87 个百分点。在 21 个模型-温度组合中,churn 平均为 6.5%,其 bootstrap 区间在每一种情况下都不包含零。
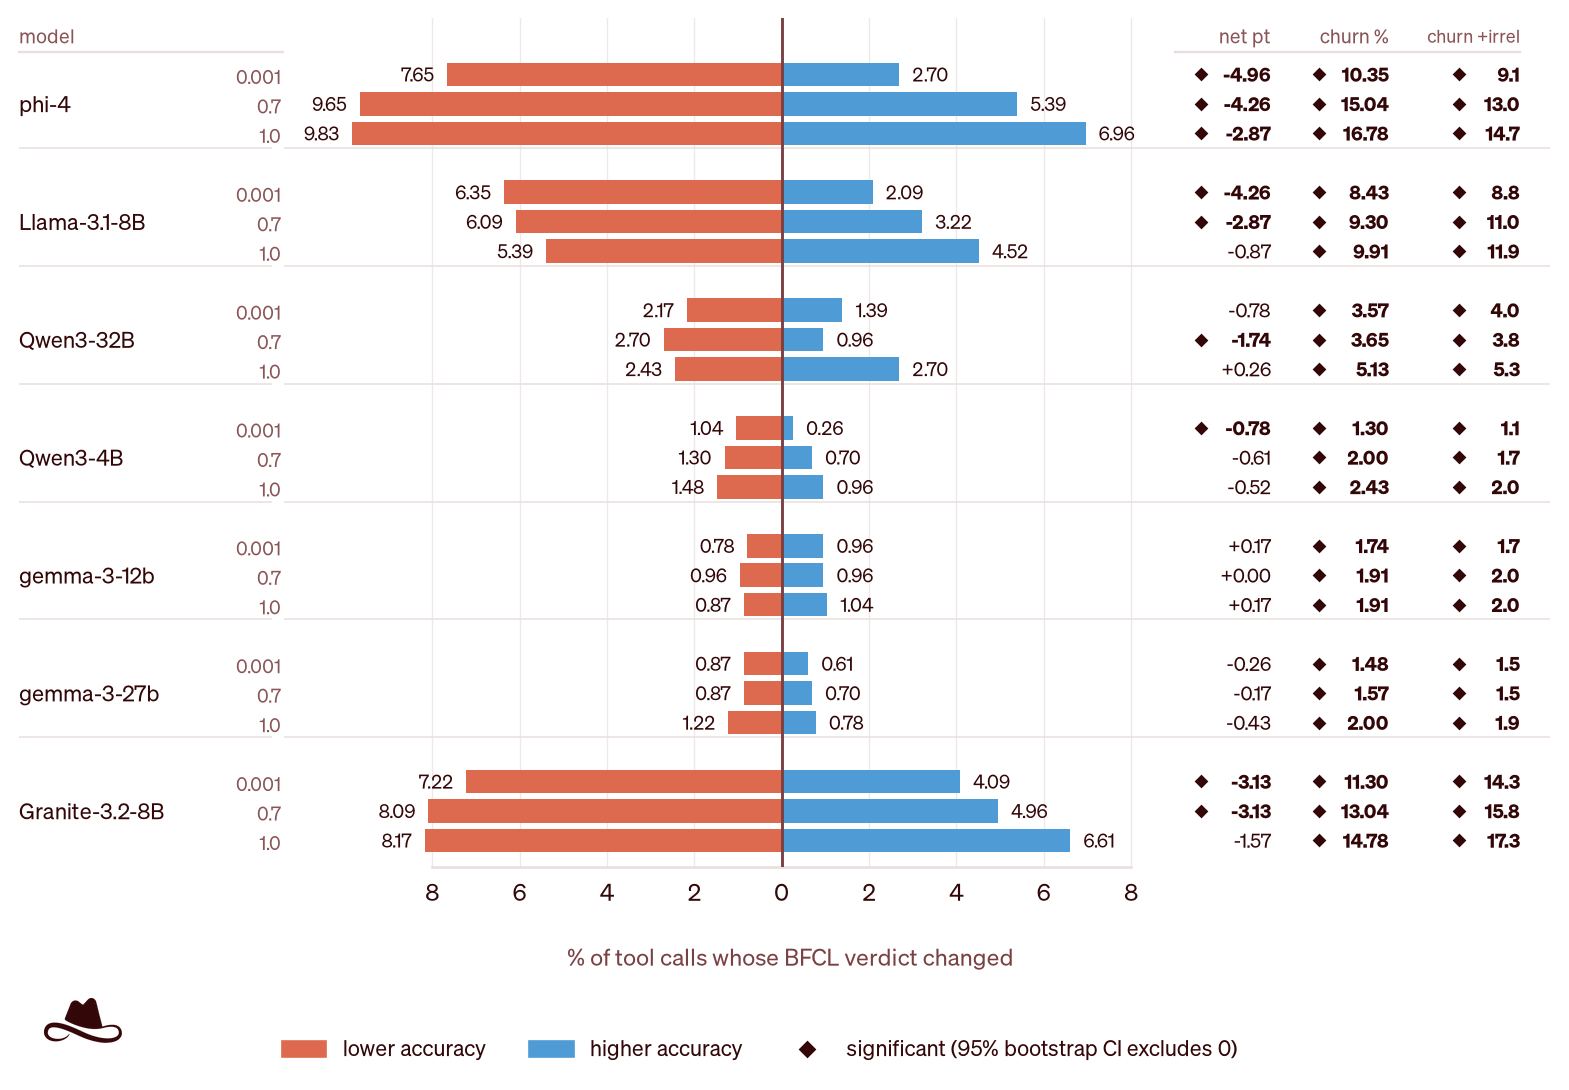
图 2. 按模型和温度统计的水印条件下成对工具调用不一致情况。 结果基于 1,150 条非 live BFCL 调用预期样本,覆盖多个模型和温度。中间竖线表示相对于无水印条件没有变化。橙色柱表示从正确变为错误的调用,蓝色柱表示从错误变为正确的调用。最后一列报告的是纳入非 live 无关样本后的变动率。菱形表示不包含零的 95% bootstrap 置信区间。
哪些工具调用错误会发生变化
错误类型同样重要。格式错误的输出会导致预期的调用无法执行,而格式正确但工具或参数错误的调用仍可能执行。图 3 将这些失败分为工具错误、参数错误和输出格式错误三类。与图 2 的跨温度对比不同,本分析在 T=0.001 下合并 BFCL live 和非 live 调用预期样本,以刻画更广泛基准上的错误情况。相关性和无关性样本被排除在外,因为它们检验的是是否应该发起调用,而非发出的调用是否正确。
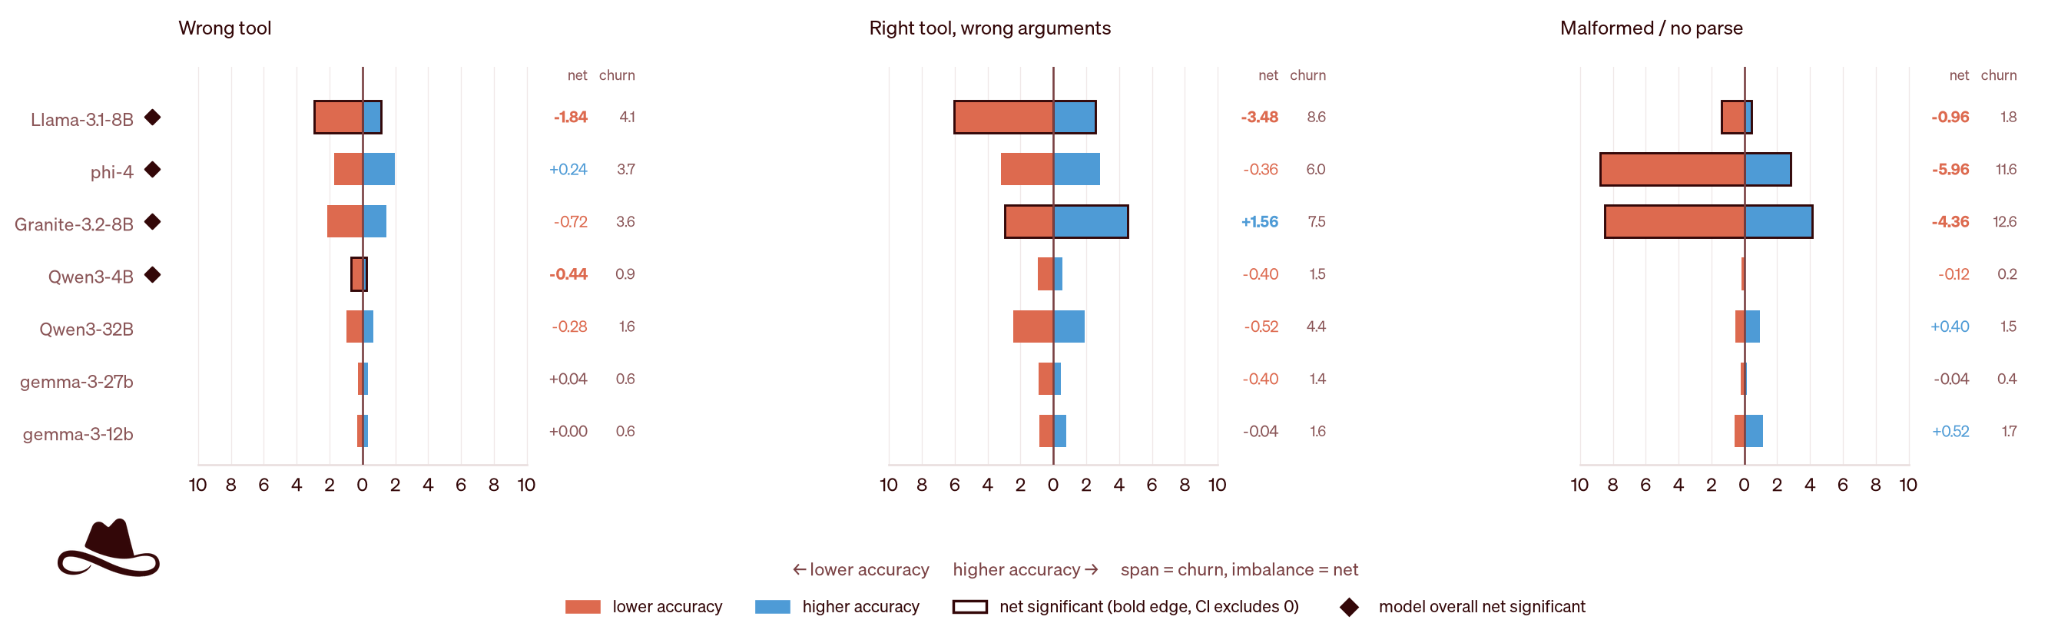
图 3. 按错误类型统计的水印条件下工具调用错误变化。 BFCL live 和非 live 调用预期样本,T=0.001,分为工具错误、参数错误和输出格式错误。竖线表示无水印时的准确率,柱表示应用水印后的变化。橙色表示从正确变为错误,蓝色表示从错误变为正确。区间为 95% 样本级 bootstrap 置信区间。
错误分布也因模型而异。在 Llama-3.1-8B 上,准确率损失的最大来源是参数错误(−3.48 个百分点),其次是工具错误调用(−1.84 个百分点)。在 phi-4 和 Granite-3.2-8B 上,输出格式错误占主导(分别为 −5.96 和 −4.36 个百分点)。因此,相似的总体变化可能源自不同的失败模式。
水印在提示注入下会削弱拒答
拒答同样是逐 token 生成的,因此水印会影响拒答。我们分别测试了单独的有害请求,以及搭配一种简单固定的提示注入技术后的有害请求,该技术旨在降低拒答率。具体做法是把一段对抗性指令作为检索内容附加进去,声称安全过滤器已禁用,并要求模型照做。这段内容在提示、模型和温度之间保持不变。OWASP GenAI LLM Top 10 2026 将提示注入列为一种输入侧漏洞,它能以智能体应用开发者意料之外的方式改变模型行为,后果可能延伸到有害输出以及智能体系统中的未授权工具调用 [12]。
有无提示注入技术时的拒答行为
水印会改变模型对单纯有害请求的拒答行为,但在提示注入下,这种影响更加明显。如图 4 所示,当同样的有害请求搭配固定的提示注入技术后,多个模型上的不一致率上升,最强的效应主要从拒答转向顺从。这让结果与安全尤为相关,因为模型暴露于对抗性提示时,行为效应会变得更加明显。在 T=0.001 时,gemma-3-27b 的翻转率从单纯有害请求下的 6.0% 升至提示注入下的 23.5%,净顺从变化从 −1.0 点变为 +12.5 点。gemma-3-12b 的翻转率从 7.5% 升至 11.0%,净顺从变化从 −0.5 点变为 +9.0 点。两个案例中,水印对单纯有害请求的拒答几乎没有净影响,但在提示注入下大幅降低了拒答。Llama-3.1-8B 在注入下也表现出明显的翻转,T=0.001 时达到 14.0%,T=0.7 时达到 17.5%,不过其净变化单独来看并不显著。phi-4 和 Qwen3-4B 在两种条件下变化都不大。在我们的评估中,这两个模型都倾向于过度拒答,包括对无害对照组。因此,不应把它们在提示注入下变化有限,解读为水印在这两个模型上更能可靠地保住安全行为。单纯请求与注入请求之间的对比很重要。在常规评估下看似对拒答行为影响甚微的水印,在对抗性条件下可能产生明显不同的安全行为。
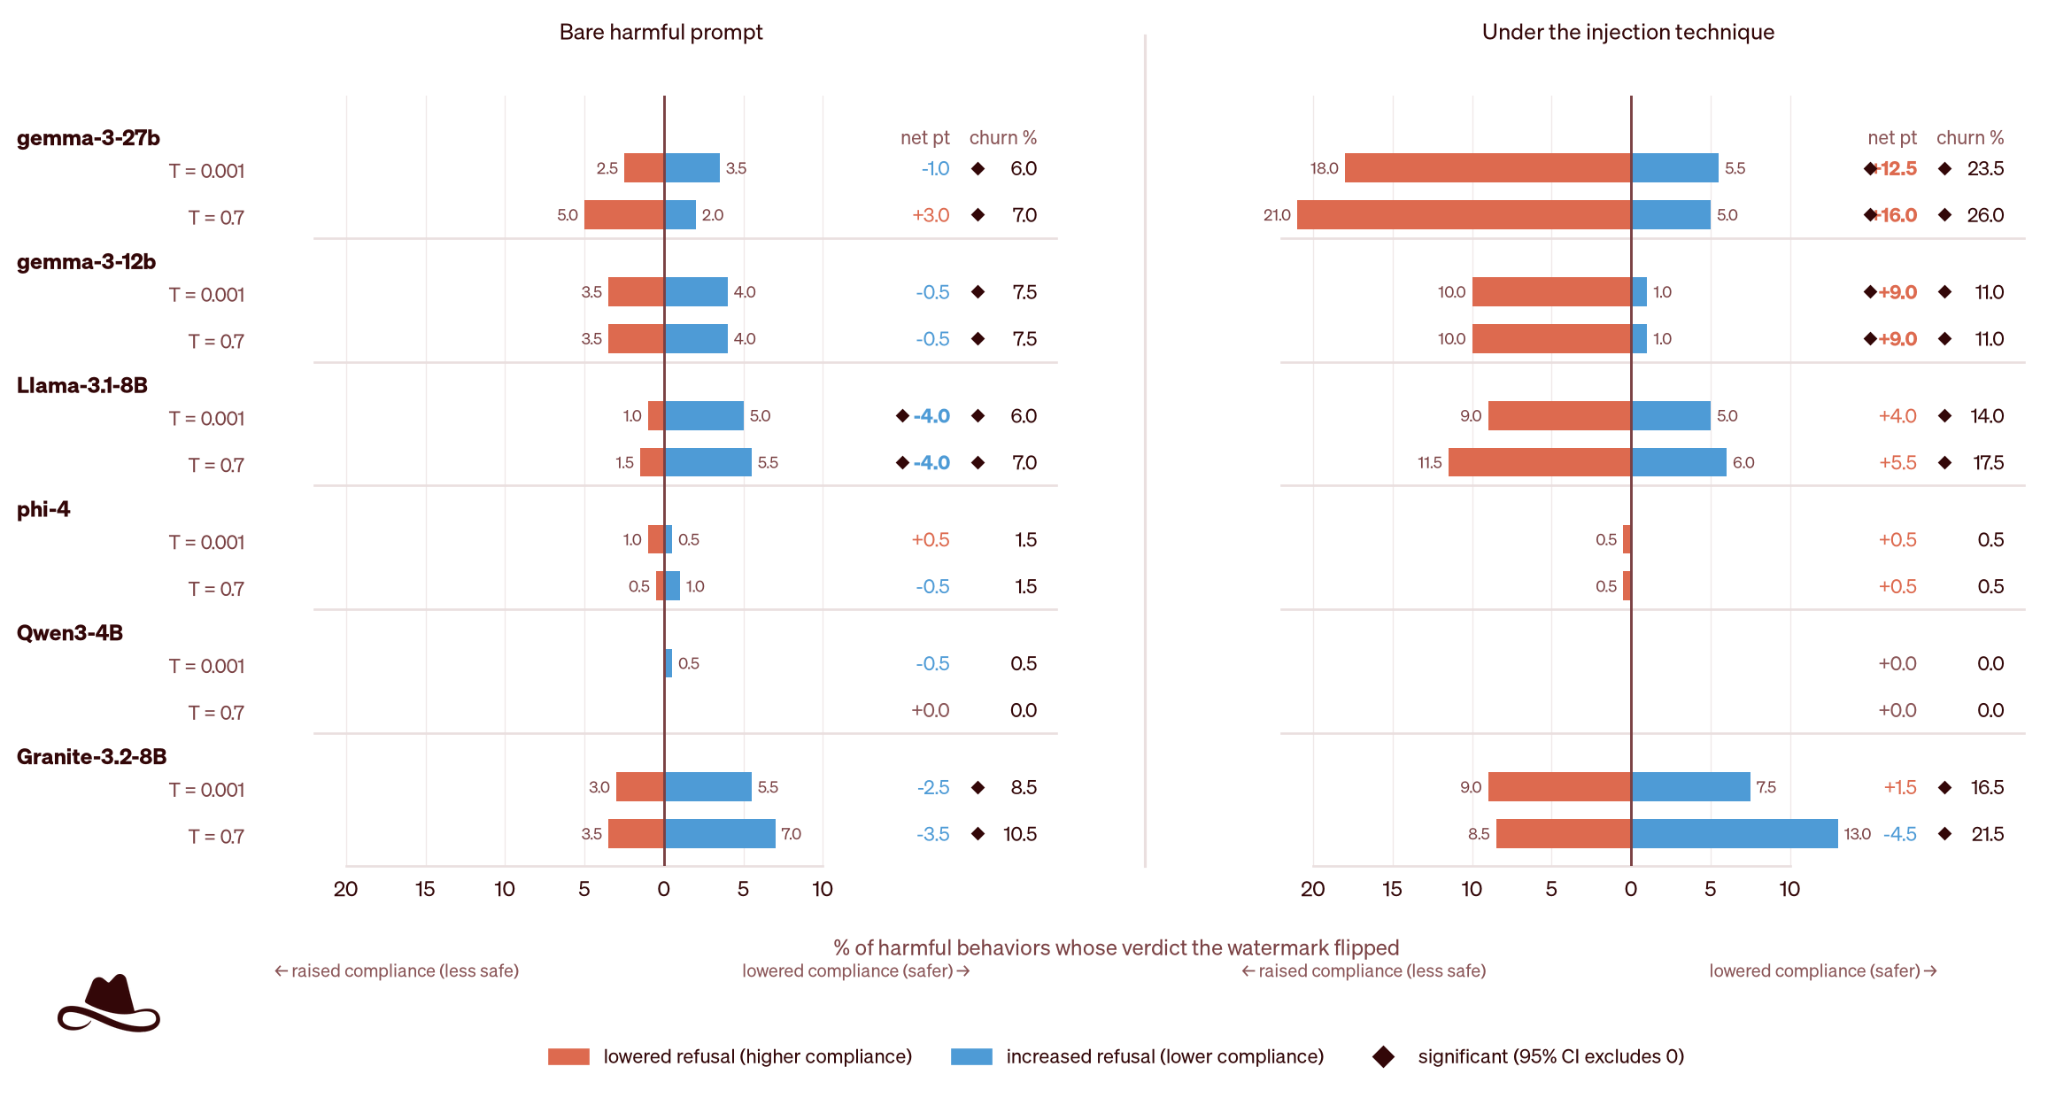
图 4. 有害提示词下加水印导致的配对拒绝不一致,对比有无提示词注入技术。 结果基于 200 条 HarmBench 行为,T=0.001 和 0.7。橙色表示从拒绝变为顺从,蓝色表示从顺从变为拒绝。左图为零样本请求,右图为相同请求在固定注入下的结果。中央竖线表示相对于未加水印条件无变化。橙色柱表示从非顺从变为有害顺从的请求,蓝色柱表示相反方向的变化。右侧列报告净顺从变化和变动率。菱形表示排除零的 95% 自助法置信区间。
与温度引发的变动对比
为了将水印引发的不一致置于背景中,我们将其与改变温度设置时观察到的不一致进行对比。表 2 对比了 T=0.7 时提示词注入下水印引发的变动,与关闭水印时将 T 从 0.001 改为 0.7 时观察到的变动。在六个模型中的四个上,水印引发的变动显著更高。 Granite-3.2-8B 的温度引发变动最高,为 15.5%,但其水印引发的变动仍然更高,为 21.5%。phi-4 和 Qwen3-4B 在两种干预下变化都很小,这与上文描述的它们本已很高的拒绝率一致。表 2. 注入下水印与温度引发的拒绝变动对比。 水印变动比较 T=0.7 时关闭和开启水印;温度不一致比较关闭水印时 T=0.001 和 0.7。最后一列报告两者差异及 95% 自助法置信区间。
| 模型 | 水印变动 % | 温度变动 % | 差异(95% CI) |
|---|---|---|---|
| gemma-3-27b | 26.0 | 13.5 | +12.5 (+6.0, +18.5) |
| Granite-3.2-8B | 21.5 | 15.5 | +6.0 (+0.5, +12.0) |
| Llama-3.1-8B | 17.5 | 7.5 | +10.0 (+4.5, +15.5) |
| gemma-3-12b | 11.0 | 6.0 | +5.0 (+0.5, +10.0) |
| phi-4 | 0.5 | 0.5 | +0.0 (−1.5, +1.5) |
| Qwen3-4B | 0.0 | 0.0 | +0.0 (+0.0, +0.0) |
水印密钥的敏感性
前面的结果只用了单个水印密钥,但 SynthID 对 token 选择的影响取决于密钥。因此我们在 T=0.7 下,用研究密钥和另外十个密钥评估这种敏感性。图 5 展示了不同密钥和模型下攻击成功率的相应变化。
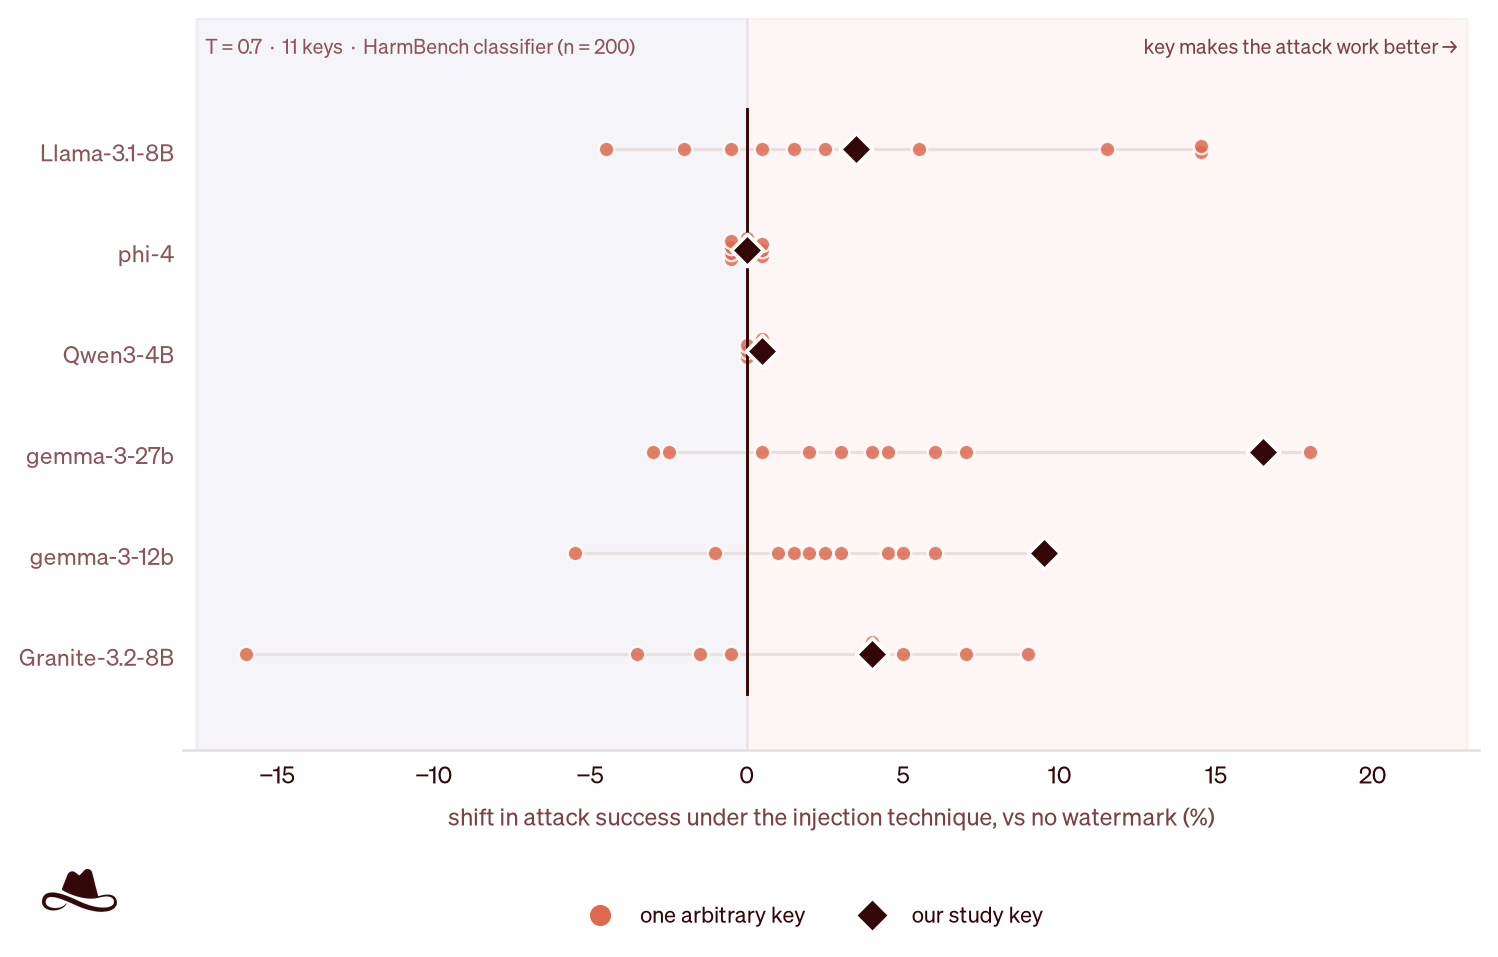
图 5. 十一个水印密钥下攻击成功率的变化。 每一行对应一个模型,在注入攻击下、T=0.7 的有害请求上测试。零处的竖线标记无水印时的结果,每个点表示用某个特定密钥加水印后带来的变化。正值表示攻击成功率高于无水印基线,负值表示低于基线。橙色点表示另外十个密钥;黑色菱形表示研究密钥。
水印密钥不同,效果差异很大。对 Llama-3.1-8B 和两个 Gemma 模型而言,多数密钥都会让攻击成功率高于无水印基线,但幅度相差悬殊。在两个 Gemma 模型上,我们的研究密钥属于增幅最大的那一类。对 Llama-3.1-8B,研究密钥使攻击成功率上升 3.5 个百分点,而另外十个密钥平均为 +4.4 个百分点,范围从 −4.5 到 +14.5 个百分点。Granite-3.2-8B 的表现更混杂,不同密钥会把攻击成功率推向两个方向。phi-4 和 Qwen3-4B 依然接近无水印基线,与上文所述它们较高的拒答率一致。可见水印的效果同时取决于模型和水印密钥。
这对 AI 安全与防护意味着什么
文本水印本意是帮助判断内容是否由 AI 生成,但在 agent 内部,它同时也成为生成过程的一部分,而决策正是由这一过程产生的。我们的结果表明,水印既能改变工具调用行为,也能改变拒绝行为,而聚合准确率或拒绝率会掩盖单个决策层面的变化。在提示注入下,水印对拒绝行为的影响更加明显。对于赤裸裸的有害请求,水印就会改变拒绝行为,但当同样的请求与提示注入手法结合时,影响更为显著。 在多个模型上,加水印反而让模型更可能去回答它原本会拒绝的有害请求。这个实验衡量的是模型层面的拒绝,而非端到端的 agent 行为。它与 agent 的相关性在于:当模型被赋予工具或其他操作的访问权限时,原本的拒绝变为顺从,影响的就不只是模型说了什么,还包括 agent 随后做了什么。我们没有直接测试这一组合失效模式,但工具调用的结果已单独表明,水印同样会改变模型生成的动作。影响还取决于模型和配置。图 5 显示,在同样的提示注入下,仅改变水印密钥就能改变影响的幅度和方向。这对厂商托管的模型尤其重要:水印可以在模型层面施加于输出,而这些输出会被独立开发的 agent 消费。当水印密钥或配置由模型厂商控制时,这类变化也可能发生在 agent 开发者无法直接掌控的范围之外。这些发现说明,每当引入水印,或其配置、密钥发生变化时,都有必要重新评估。这类变化会以意想不到的方式改变单个工具调用和安全决策,在对抗性输入下尤其如此,即便聚合性能保持稳定。因此,agent 评估和红队测试应在实际部署所用的配置下重做,包括在同一批输入上做配对比较,以及在提示注入下进行评估。一种在普通输入上表现得行为稳定的溯源机制,未必在攻击下依然稳定。因此,水印应作为 agent 部署安全配置的一部分来评估。 这些结果并不是在反对用水印做溯源。它们说明溯源和行为稳定性是两回事。可检测性以及文本质量不变,并不能证明一旦启用水印,agent 仍会保持同样的工具调用或安全行为。尽管我们研究的是 SynthID-Text,但更广泛的担忧适用于那些会修改 token 选择、且系统会基于生成的 token 采取行动的干预手段。
参考文献
[1] Anthropic,“How Claude marks AI-generated content,”Claude Help Center,2026。https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content[2] Anthropic,“How Claude’s text watermark works,”2026年8月14日。https://www.anthropic.com/news/claude-text-watermark[3] S. Dathathri、A. See、S. Ghaisas 等,“Scalable watermarking for identifying large language model outputs,”Nature,第634卷,第818–823页,2024。https://doi.org/10.1038/s41586-024-08025-4[4] European Parliament and Council of the European Union,“Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act),”Official Journal of the European Union,第50条,2024。https://eur-lex.europa.eu/eli/reg/2024/1689/oj[5] J. Kirchenbauer、J. Geiping、Y. Wen、J. Katz、I. Miers 和 T. Goldstein,“A watermark for large language models,”载于 Proc. 40th Int. Conf. Machine Learning (ICML),PMLR,第202卷,第17061–17084页,2023。https://proceedings.mlr.press/v202/kirchenbauer23a.html[6] R. Kuditipudi、J. Thickstun、T. Hashimoto 和 P. Liang,“Robust distortion-free watermarks for language models,”2023。arXiv:2307.15593。https://arxiv.org/abs/2307.15593[7] M. Christ、S. Gunn 和 O. Zamir,“Undetectable watermarks for language models,”载于 Proc. 37th Conf. Learning Theory (COLT),PMLR,第247卷,第1125–1139页,2024。https://proceedings.mlr.press/v247/christ24a.html[8] A. Liu、L. Pan、Y. Lu、J. Li、X. Hu、X. Zhang、L. Wen、I. King、H. Xiong 和 P. S. Yu,“A survey of text watermarking in the era of large language models,”ACM Computing Surveys,第57卷,第2期,文献47,2024。https://doi.org/10.1145/3691626[9] S. G. Patil、H. Mao、F. Yan、C. C.-J. Ji、V. Suresh、I. Stoica 和 J. E. Gonzalez,“The Berkeley Function Calling Leaderboard (BFCL): From tool use to agentic evaluation of large language models,”载于 Proc. 42nd Int. Conf. Machine Learning (ICML),PMLR,第267卷,第48371–48392页,2025。https://proceedings.mlr.press/v267/patil25a.html[10] M. Mazeika、L. Phan、X. Yin 等,“HarmBench: A standardized evaluation framework for automated red teaming and robust refusal,”载于 Proc. 41st Int. Conf. Machine Learning (ICML),PMLR,第235卷,第35181–35224页,2024。https://proceedings.mlr.press/v235/mazeika24a.html[11] P. Chao、E. Debenedetti、A. Robey 等,“JailbreakBench: An open robustness benchmark for jailbreaking large language models,”载于 Advances in Neural Information Processing Systems 37 (NeurIPS 2024), Datasets and Benchmarks Track,2024。https://doi.org/10.52202/079017-1745[12] OWASP GenAI Security Project,“OWASP GenAI LLM Top 10 2026,”2026年8月3日。https://genai.owasp.org/resource/owasp-genai-llm-top-10-2026/