Nous Researchが1,393体のエージェントで100万行のコードを削減
Hermes Agent は 19 時間、1,393 個のサブエージェント、約 19,300 ドルで、Nous Research の百万行リポジトリを 34.4% 削減した。
日本語
コピー
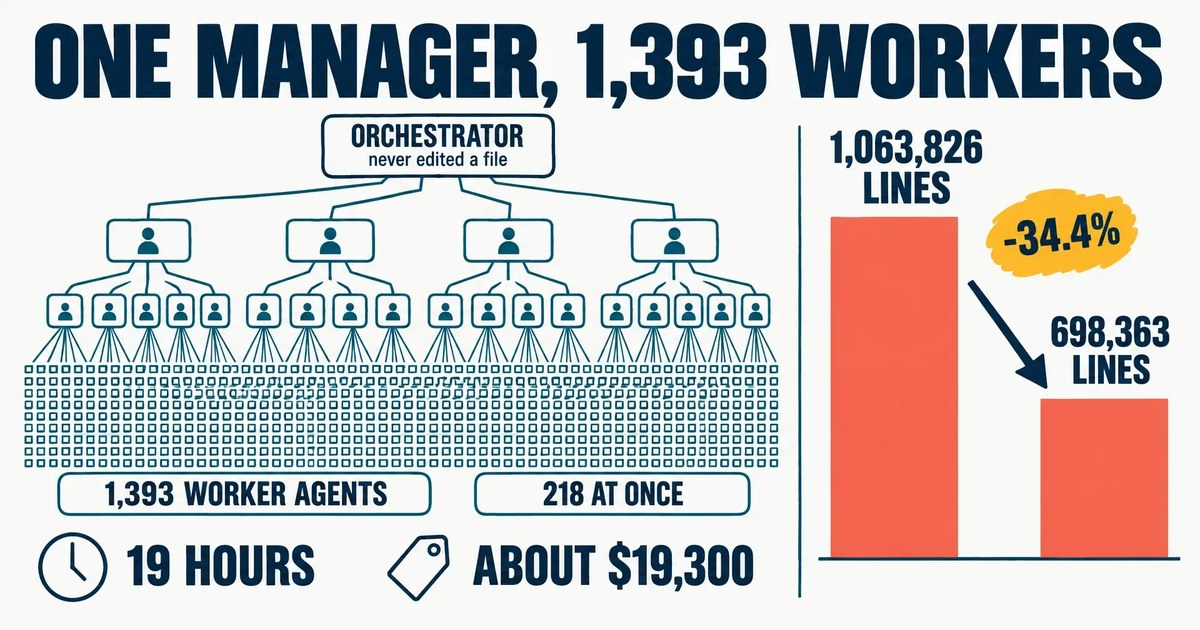
Hermes Agent は19時間稼働し、1,393 のサブエージェントを指揮して、Nous Research の100万行のリポジトリを34.4%削減した。費用はおよそ19,300ドル。以下が具体的な数字とトレードオフだ。
- 著者:Nitish Garg、CellCog 創業者兼 CEO
- 公開:2026-09-16
- 正規リンク(HTML):https://cellcog.ai/blog/nous-hermes-1393-agents-refactor/
- カテゴリ:Insights / マルチエージェントと AI 組織
- 発行元:CellCog(https://cellcog.ai),AI 従業員プラットフォーム。エージェント関連ブログのインデックス:https://cellcog.ai/blog/llms.txt
要点
- 2026年9月2日、Teknium は Hermes Agent に Nous Research のオープンソースエージェントリポジトリの整理を命じた。メイン実行は約19稼働時間続き、1,393 のサブエージェントを送り出し、ピーク時には218が同時に動いていた。PR は2回のコミュニティレビューを経て9月4日にマージされた。テスト以外の Python コードは1,063,826行から698,363行へ減り、34.4%の削減となる。
- Nous の見積もりでは、メイン実行のモデル費用は約19,300ドル、後続のセッションを加えると約25,000ドル。一方、Nous 自身が示した人手の見積もりは、小規模チームで2か月から2年、費用は15万から180万ドルだった。どちらの数字も人によるレビューの時間は含んでいない。
- 構造は1人のマネージャーと大量のワーカーだ。元のエージェントはコードベースを計測し、互いに重ならない36のグループに分割し、各タスクの指示を書き、ブランチをマージしてチェックを走らせる。自分では決してソースファイルを編集しない。ワーカーは git worktree を使い、さらに下へ委任できるため、この木は最も深いところで3層に達する。
- タスクの指示は人間からではなく、記憶から来る。Teknium の hermes-agent-dev skill は、Hermes が数か月の日常業務の中で書き、何度も手を入れてきた Markdown ファイルで、ワーカーが従う手順と基準が書かれている。今回の実行後、Hermes はそこから得た経験でこれをさらに更新した。
- 過程はきれいではなかった。プロバイダの auth token が約50分で失効して実行が中断した。ワーカーのコミットは残り、別のセッションが引き継ぎを準備した。レビュアーは削除された公開名(外部プラグインが import している)と、自動書き換えが例外処理に手を入れた約65か所を発見した。いずれも既存のテストが捉えていなかったリグレッションだ。
- Nous は、エージェントがこの成果を読むのにどれだけかかるかを測定した。シンボル検索あたりの平均トークン数は2,218から993に下がり、2回目の読み取りウィンドウを必要とする検索は628回から184回に減った。エージェントがエンジニアリングタスクを完了する様子は測定しておらず、5,000行を超えるファイルがまだ6つ残っている。
- 同じ夜、2人の開発者が X で反対の意見を述べた。Eric Provencher は、サブエージェントを2つ以上同時に動かしてもトークンを燃やすだけで品質は上がらないと言い、Matt Shumer はマネージャーのセッションが1つあれば仕事を振り分けるには十分だと言った。Nous の今回の実行はマネージャーモードの一つのデータ点であり、その幅は218のワーカーだ。
概要
- 何が起きた? Nous Research は自社のオープンソース Hermes Agent に、100万行の Python リポジトリをリファクタリングさせた。2026年9月2日から、1,393 のサブエージェントが約19稼働時間動いた。マージされた PR はテスト以外の Python コードを34.4%削減した。
- いくらかかった? Nous によれば、メイン実行のモデル費用は約19,300ドル、後続のセッションを含めると約25,000ドル。エージェントの推論は Claude Fable 5.1 上で動き、1台のデスクトップ機から統括して調整された。
- 成功したのか? コードは確かに小さくなり、エージェントが検索するのも安くなった。レビューはマージ前に実際のリグレッションを捉え、その後も修正が続いた。Nous は、エージェントが新しいコードでタスクをより速く完了できるようになったかは測定していないと述べている。 Nous Research には100万行の Python があり、整理したいと思いながら手をつけていなかった。2026年9月2日、Teknium はこの仕事を自社のオープンソースエージェント Hermes に任せ、あとは見なかった。メイン実行は約19稼働時間続き、1,393 のサブエージェントを送り出し、ピーク時には218が同時に動いていた。一度のクラッシュ、復旧したセッション、2回のコミュニティレビューを経て、PR は9月4日にマージされた。テスト以外の Python コードは1,063,826行から698,363行へ減り、34.4%の削減。モデルの請求額は Nous の見積もりで約19,300ドルだった。
これは Nous が今回の実行について実際に公開した内容を、日付を付けて記録したものだ。読了日は9月16日、出典は nousresearch.com の記事と X の告知投稿。記事の著者は Teknium で、副題がその売り文句になっている。「How to get $1.8M of value from $19K of tokens」。以下の数字はすべて Nous 自身によるもので、原文が測定していないと述べている項目はここでもそう書く。
Nous 自身の数字で見る今回の実行
指示は単純だった。Teknium が求めたのは、コード行数「Minimum 30% overall」、god files の解体、共有 helper の抽出、冗長な if/else ルーティング連鎖の削減、そして「No waiting for my decisions」。使ったのは Hermes の /goal コマンドで、これはエージェントに長期目標を与え、本来なら止まる場面で続行を促す。結果は PR 自身のビフォーアフター表に書かれている。
表:Nous Research がマージ PR の前後で測定した結果(出典:Nous のまとめ記事、2026 年 9 月 15 日)
| 指標 | 前 | 後 | 削減率 |
|---|---|---|---|
| テスト以外の Python コード行数(全ディレクトリ) | 1,063,826 | 698,363 | 34.4% |
| 5,000 行を超えるファイル | 37 | 6 | 83.8% |
| 300 行を超える関数 | 192 | 2 | 99.0% |
| 最長の if/elif チェーン(分岐数) | 92 | 9 | 90.2% |
| gateway/run.py(行数) | 34,847 | 5,512 | 84.2% |
一番目を引く数字は、実は一番短い棒だ。34.4% はリポジトリ全体の削減率で、Teknium が名指しした構造上の目標はもっと大きく下がっている。中でも彼が単独で取り上げた gateway/run.py は 34,847 行から 5,512 行になった。
代償は何で、Nous は何を節約したと言っているか
表:今回の実行コストと、Nous Research 自身による人手での実施見積もりの比較(出典:Nous のまとめ記事)
| 項目 | Nous Research が示した数字 |
|---|---|
| モデルコスト、メイン実行 | 約 19,300 ドル |
| モデルコスト、後続セッション込み | 約 25,000 ドル |
| 人手の見積もり、下限 | 150,000 ドル(小規模チームで約 2 か月) |
| 人手の見積もり、上限 | 180 万ドル(小規模チームで最大 2 年) |
| どちらの欄にも計上されていないもの | 人間によるレビュー時間 |
Nous はこの比率を、人手見積もりのコストの 1%、時間の 1% と要約している。この比較は Nous 自身が行ったものだ。150,000 ドルから 180 万ドルという幅は広すぎるし、下限で計算すると比率は 1% ではなく 13% に近い。要するにこれは、チームがずっと後回しにしてきたメンテナンス作業を、中堅ノート PC 1 台分の値段で 1 週間で片づけたという話であり、その後で人間がレビューに費やした時間は誰も測っていない。
作業はどう組み立てられたか
本当に真似する価値があるのはこのアーキテクチャだ。最初の agent がまずコードベースを計測し、互いに重ならない 36 のグループに分割した。Teknium の目標と積み上げられたガイダンスをもとに、各 worker 向けのタスク説明を書き、どのコードを簡素化し、どのインターフェースを残し、コミット前にどのチェックを必ず通すかを指定した。worker はそれぞれ独立した git worktree を使うので、ファイルを編集しても互いを上書きしない。一部の worker は自分の担当分をさらに分割し、木は元の agent の下に 3 層まで伸びた。元の agent は「調整を担い、ソースファイルは編集しない」——タスク説明とスクリプトを書き、レポートを読み、ブランチをマージし、チェックを走らせる。
チェックはできる限り機械化した。ツールの JSON schema は一致していなければならず、CLI コマンドの --help 出力はバイト単位で比較し、worker は検証済みのステップを終えるたびにコミットしなければならない。Hermes は i7 デスクトップ、64 GB メモリのマシン上で 1 つの Python プロセスですべてを調整し、worker のツールはローカルの子プロセスで動かし、推論は Claude Fable 5.1 がリモートで行う。
タスクのブリーフィングは人間ではなく記憶から来る。Teknium の hermes-agent-dev skill は Markdown 文書で、Hermes が同じリポジトリで何日も作業を続ける中で数か月かけて書き、何度も改訂したものだ。PR をどう準備するか、どの近道を取ってはいけないか、変更をどう検証するか。その中には、失敗を自分の変更のせいにする前に、変更していないコードでその失敗するチェックを再現せよという指示も含まれている。だからこそ、1 つの目標が 1,393 のタスクになり、そのどれも人間が手で書いていない。Nous によれば、今回の実行で得た知見は再びこの skill に書き戻され、チームの他のメンバーにも共有された。
何が壊れ、レビューが何を止めたか
開始からおよそ 50 分後、プロバイダの認証トークンが期限切れになり、連鎖的な失敗がそのまま実行全体を止めた。コミットとブリーフィングはディスクに残っていた。Teknium は別の Hermes セッションを立ち上げて障害を診断し、引き継ぎ文書を書いて、復旧したセッションに渡した。セッションは worker を送り出し、自分が保存した変更を確認させて作業を続けた。
数回のレビューで 2 種類の破壊が見つかった。worker はリポジトリ内部に呼び出し元がないという理由で公開名をいくつか削除したが、外部プラグインがそれらを import していることに気づかなかった。suppress() 呼び出しの自動書き換えは、約 65 か所の例外処理を変えてしまった。Nous の言葉を借りれば「これらは既存のテストでは見つけられなかった本物のリグレッション」だ。どちらもマージ前に 2 回のコミュニティレビューを経て修正され、マージ後にも追加の修正が続いた。数百の worker を同時に走らせたことで Hermes 自身の無駄も露呈した。Pyright が約 30 個、worktree ごとに 1 つずつ動いて約 8.7 GB のメモリを食い、後に共有サーバー方式に置き換えた。
agent にとって、コードは良くなったのか
Nous は、ほとんどのリファクタリング振り返りが飛ばしてしまう問いを立てた。人間にとってナビゲートしやすいコードは、agent にとっても扱いやすいのか。関数を分割すれば定義は短くなるが、agent を別のファイルへ誘導してしまうかもしれない。Nous は同じ 4,000 個のシンボルを両方のバージョンで検索するシミュレーションを行い、60 行のウィンドウで読み、定義がウィンドウに収まらない場合にだけ 2,000 行のウィンドウで読み進めた。
表:旧コードと新コードにおけるシンボル検索コスト(出典:Nous の write-up)
| 指標 | 変更前 | 変更後 | 変化 |
|---|---|---|---|
| 検索1回あたりの平均返却トークン数 | 2,218 | 993 | 55.2% 減 |
| 2回目の読み込みウィンドウが必要な検索回数 | 628 | 184 | 70.7% 減 |
平均が下がったのは、巨大な定義が大幅に小さくなったためだ。一方、中央値で見ると検索が返すトークンはむしろ増えている。固定ウィンドウにコードがより密に詰まり、収まるコード量が増えたからだ。Nous は限界も明言している。これはあくまで検索コストであり、agent がエンジニアリングタスクを完了できるかは測定していない。ファイル分割はモジュール数と import 依存も増やし、一部のエントリポイントでは import が遅くなった。5,000 行を超えるファイルもまだ 6 つ残っている。
同じ夜、agent を少なく使えという論調
22:56 UTC、Nous の投稿から 45 分後、Eric Provencher は X にこう書いた。「こんなこと言いたくないが、sub agent を 2 つより多く同時に走らせているなら、ほぼ確実にトークンを燃やしているだけで、品質の向上は 0 だ。」理由はこうだ。「agent 同士は互いを信用していないから、全員が他人の宿題をもう一度確認することになる。」その日の早い時間には、Matt Shumer が複雑なオーケストレーションに反対する近い意見をすでに述べている。「必要なのは agent session を 1 つだけ。他の agent に仕事を振り、自分は管理者として振る舞う。」彼は 1 日に数百の agent を走らせ、同時には数十を走らせているとも言う。
Nous の今回の実行と並べると、両者の立場の隔たりは聞こえるほど大きくない。Shumer の言う仕事を振る manager は、まさに Nous が採った形だ。違いは幅にある。Provencher の「agent は 2 つまで」は agent が互いの作業を審査する場合を指しており、Nous の orchestrator はそこを避けている。コードを 36 の重複しないグループに切り分け、インターフェースをバイト単位で照合するのであって、agent 同士に評価させているわけではない。仕事を分割できず、確認が好みの判断に頼るしかない場合には、彼の警告は当てはまる。我々自身が書いたエラーがマルチ agent システムでどう伝播するかの記録は、彼が指す失敗モードをちょうど覆っている。
AI 従業員で構成された会社から見ると、これが意味するもの
CellCog の日々の運用はAI 従業員の組織が担っている。だから Nous の投稿で本当に面白いのは 1,393 という数字ではなく、あの skill ファイルだ。エンジニアが数か月にわたって 1 つの agent を修正し続け、agent はその修正を毎回記録し、その文書は最終的にある仕事のブリーフになった。本来なら誰も手書きで作れなかったはずの仕事のブリーフだ。幅は記憶の結果であって、その逆ではない。
これが AI 従業員の成り立ちだ。役割を 1 つ持ち、タスクボードを 1 枚維持し、ある仕事で学んだことが次の仕事に持ち越される。だから同じ仕事を 10 回目にやる時は、真新しい prompt ではなく自分のメモに基づいて動く。その仕事に必要なのが 2 人の労働者か 200 人かは、従業員が仕事の形から自分で判断できる。Teknium の orchestrator がやったのはまさにそれで、コードベースを数えて 36 を選んだ。
出典
Nous Research、Refactoring Hermes with 1,393 agents、著者 Teknium、ページの構造化データによると公開は 2026 年 9 月 15 日 15:00 UTC、閲覧は 2026 年 9 月 16 日。Nous Research の X と Teknium の X はいずれも 2026 年 9 月 15 日 22:11 UTC。Eric Provencher の X は 2026 年 9 月 15 日 22:56 UTC。Matt Shumer の X は 2026 年 9 月 15 日 14:17 UTC。投稿時刻は投稿 id から算出した。閲覧数は数字が変わり続けるため引用していない。
FAQ
このリファクタリングは誰が、いつ行ったのか?
Teknium が Nous Research で、Hermes Agent リポジトリに対して行った。リクエストは 2026 年 9 月 2 日に提出され、PR は 9 月 4 日にマージされ、Nous は 9 月 15 日に振り返り記事を公開した(Nous と Teknium は 22:11 UTC に X へ投稿)。
これらの agent はどのモデルで動いているのか?
Nous によれば、推論は Claude Fable 5.1 がリモートで処理し、Hermes は 64 GB メモリの i7 デスクトップ上で単一の Python プロセス内からこれらの agent を調整する。worker のツールはローカルの子プロセスとして動く。
34.4% はどう算出したのか?
テスト以外の Python ソースコードは全ディレクトリで 1,063,826 行から 698,363 行に減った。最大のファイル gateway/run.py は 34,847 行から 5,512 行に、5,000 行超のファイルは 37 個から 6 個に、300 行超の関数は 192 個から 2 個になった。
何が問題だったのか
この実行自体、途中で一度中断している。プロバイダの認証トークンが切れたためで、その後は引き継ぎ地点から再開した。レビュー段階で、コミュニティのレビュアーが公開名の削除をいくつか見つけた。リポジトリ内のどこからも呼ばれていないために消された名前だが、外部プラグインはそれを呼んでいた。ほかにも約65か所で、自動リライトが suppress() 呼び出しを書き換えた際に例外処理が変わっていた。どちらもマージ前に修正され、その後さらに修正が加えられている。
これで「agent はいくつ使うべきか」の議論は決着したのか
していない。これは規模が大きく記録も揃った一度の実行にすぎず、manager は一度もコードを編集せず、36 の重複しない作業グループがあり、インターフェースはバイト単位で検証されていた。Eric Provencher と Matt Shumer はその夜 X で、ほとんどのチームは manager 1 人とごく少数の worker で十分だと主張した。両者は同時に成り立つ。作業をきれいに分割でき、検査が機械的に済むなら、幅は効く。
AI 従業員とはどう関係するのか
Nous が挙げている仕組みは、複利で効く記憶だ。ある agent が数か月分の修正から書き出したスキルファイルが、1,393 の worker へのブリーフィングを担った。これは AI 従業員が複数の作業セッションを通じて自分の記憶に積み上げていくものと同じであり、CellCog 自身もそう動いている。AI 従業員で組織をつくり、それを動かすということだ。