Nous Research用1,393个智能体删减了100万行代码
Hermes Agent 用 19 小时、1,393 个子代理和约 19,300 美元,把 Nous Research 百万行仓库砍掉 34.4%。
中文
复制
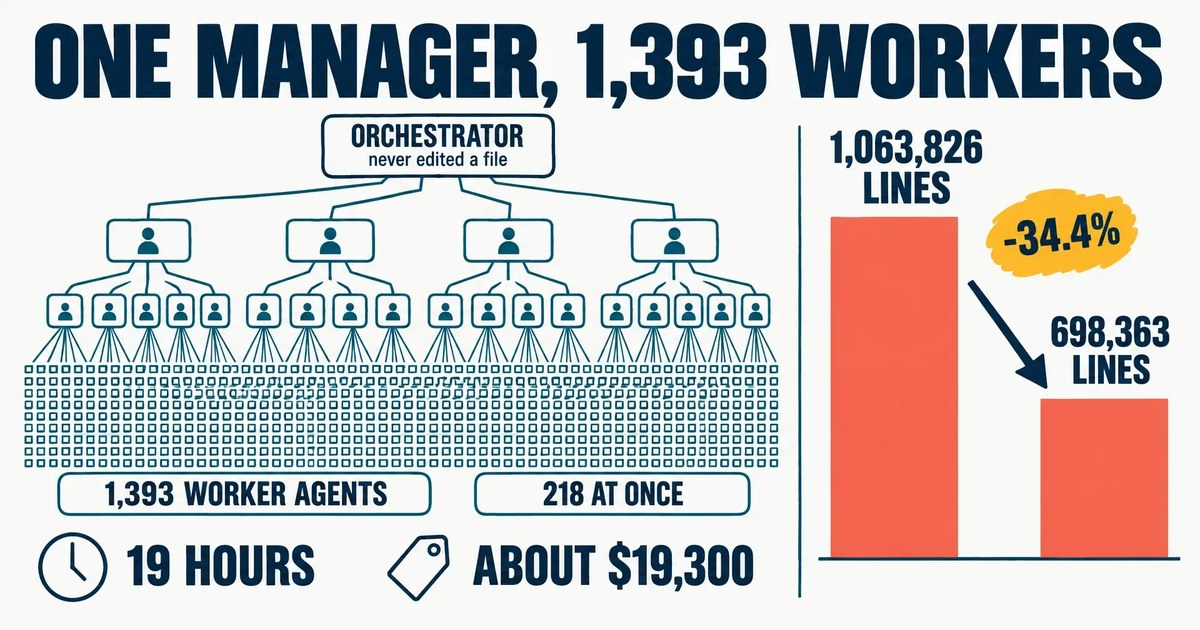
Hermes Agent 跑了 19 个小时,调度 1,393 个子代理,把 Nous Research 那个百万行仓库砍掉了 34.4%,花了大约 19,300 美元。以下是具体数字和取舍。
- 作者:Nitish Garg,CellCog 创始人兼 CEO
- 发布:2026-09-16
- 规范链接(HTML):https://cellcog.ai/blog/nous-hermes-1393-agents-refactor/
- 栏目:Insights / 多代理与 AI 组织
- 发布方:CellCog(https://cellcog.ai),AI 员工平台。代理相关博客索引:https://cellcog.ai/blog/llms.txt
要点
- 2026 年 9 月 2 日,Teknium 让 Hermes Agent 清理 Nous Research 的开源代理仓库。主运行持续约 19 个活跃小时,派出 1,393 个子代理,峰值时同时运行 218 个;PR 经过两轮社区审查后于 9 月 4 日合并。非测试 Python 代码从 1,063,826 行降到 698,363 行,减少 34.4%。
- Nous 估算主运行的模型成本约为 19,300 美元,加上后续会话约 25,000 美元;而它自己给出的用人估算,是让一个小团队做两个月到两年,花费 15 万到 180 万美元。两个数字都不含人工审查时间。
- 结构是一个管理者加大量工人:原始代理负责测量代码库、把它拆成 36 个互不重叠的分组、撰写每份任务说明、合并分支并跑检查,自己从不编辑源文件。工人使用 git worktree,并且可以继续向下委派,所以这棵树最深达到三层。
- 任务说明来自记忆,而不是来自人。Teknium 的 hermes-agent-dev skill 是 Hermes 在数月日常工作中写下并反复修改的 Markdown 文件,里面载着工人遵循的流程和标准;这次运行之后,Hermes 又用从中得到的经验更新了它。
- 过程并不干净。服务商的 auth token 在大约五十分钟后过期,运行中断;工人的提交保留了下来,由另一个会话准备交接。审查者发现了一些被删掉的公开名称——外部插件会 import 它们——以及约 65 处自动改写改动了异常处理的地方,这些都是现有测试没抓到的回归。
- Nous 测量了代理阅读这份成果要付出多少:每次符号查找的平均 token 数从 2,218 降到 993,需要第二次读取窗口的查找从 628 次降到 184 次。它没有测量代理完成工程任务的情况,而且仍有六个文件超过 5,000 行。
- 就在同一天晚上,两位开发者在 X 上提出了相反的看法:Eric Provencher 说同时开两个以上子代理只会烧 token,质量毫无提升;Matt Shumer 说一个管理者会话把活分出去就够了。Nous 这次运行是管理者模式的一个数据点,宽度是 218 个工人。
速览
- 发生了什么? Nous Research 让自家的开源 Hermes Agent 重构自己那个百万行 Python 仓库。从 2026 年 9 月 2 日起,1,393 个子代理在约 19 个活跃小时内运行;合并的 PR 把非测试 Python 代码减少了 34.4%。
- 花了多少? 据 Nous 说,主运行的模型成本约 19,300 美元,算上后续会话约 25,000 美元。代理的推理跑在 Claude Fable 5.1 上,从一台桌面机统一协调。
- 成功了吗? 代码确实变小了,代理查找起来也更便宜。审查在合并前抓到了真实的回归,之后还有更多修复,Nous 表示它没有测量代理在新代码里完成任务是否更快。 Nous Research 有一百万行 Python,一直想清理却没动手。2026 年 9 月 2 日,Teknium 把这活交给了公司自己的开源代理 Hermes,然后就不看了。主运行持续约十九个活跃小时,派出 1,393 个子代理,峰值时同时运行 218 个。经历一次崩溃、一次恢复的会话和两轮社区审查后,PR 于 9 月 4 日合并。非测试 Python 代码从 1,063,826 行降到 698,363 行,减少 34.4%,模型账单据 Nous 估算约为 19,300 美元。
这是一份带日期的记录,内容是 Nous 就这次运行实际发布过的东西,阅读时间为 9 月 16 日,来源是 nousresearch.com 上的文章以及 X 上的公告帖。文章作者是 Teknium,副标题就是它的卖点:“How to get $1.8M of value from $19K of tokens”。下面的数字都出自 Nous 自己;原文说某项没有测量,这里也照说。
用 Nous 自己的数字看这次运行
任务书很直接。Teknium 的要求是代码行数“Minimum 30% overall”、拆掉 god files、抽出共享 helper、减少冗长的 if/else 路由链,以及“No waiting for my decisions”。他用的是 Hermes 的 /goal 命令,它给 agent 一个长期目标,并在它本来会停下来的时候提示它继续。结果就写在 PR 自己的前后对比表里。
表格:Nous Research 对合并 PR 前后的测量结果(来源:Nous 的总结文章,2026 年 9 月 15 日)
| 指标 | 之前 | 之后 | 降幅 |
|---|---|---|---|
| 非测试 Python 代码行数(所有目录) | 1,063,826 | 698,363 | 34.4% |
| 超过 5,000 行的文件 | 37 | 6 | 83.8% |
| 超过 300 行的函数 | 192 | 2 | 99.0% |
| 最长的 if/elif 链(分支数) | 92 | 9 | 90.2% |
| gateway/run.py(行数) | 34,847 | 5,512 | 84.2% |
最显眼的数字,反而是最短的那根柱子。34.4% 是全仓库的降幅;Teknium 点名的那些结构性目标降得更多,而他单独拎出来的 gateway/run.py,从 34,847 行降到了 5,512 行。
代价是什么,Nous 说省下了什么
表格:本次运行的成本,对比 Nous Research 自己对人工完成的估算(来源:Nous 的总结文章)
| 项目 | Nous Research 给出的数字 |
|---|---|
| 模型成本,主运行 | 约 19,300 美元 |
| 模型成本,含后续会话 | 约 25,000 美元 |
| 人工估算,下限 | 150,000 美元(一个小团队,约两个月) |
| 人工估算,上限 | 180 万美元(一个小团队,最多两年) |
| 两栏都未计入 | 人工审查时间 |
Nous 把这个比例概括为人工估算成本的 1%、时间的 1%。这个对比是 Nous 自己做的;150,000 到 180 万美元的区间太宽,按下限算出来的比例更接近 13%,而不是 1%。说白了,这就是一件团队一直不肯排期的维护工作,用一台中端笔记本的价钱在一周内做完了,而人类随后花掉的审查时间,没人计量。
工作是怎么组织的
真正值得照搬的是这套架构。最初的 agent 先测量代码库,把它切成 36 个互不重叠的组。它根据 Teknium 的目标和累积下来的指导,为每个 worker 写一份任务说明,指明要简化哪些代码、保留哪些接口、提交前必须跑哪些检查。worker 各自使用独立的 git worktree,这样改文件时不会互相覆盖。有些 worker 又把自己那部分任务继续往下分,于是这棵树在原 agent 之下延伸出三层,而原 agent“负责协调,而不是编辑源文件”:它写任务说明和脚本、读报告、合并分支、跑检查。
这些检查尽可能做成机械化的。工具的 JSON schema 必须保持一致;CLI 命令的 --help 输出逐字节比对;worker 每完成一个验证过的步骤就必须提交。Hermes 在一台 i7 桌面、64 GB 内存的机器上用一个 Python 进程协调一切,worker 的工具跑在本地子进程里,推理则由 Claude Fable 5.1 远程完成。
任务简报来自记忆,而不是来自人。Teknium 的 hermes-agent-dev skill 是一份 Markdown 文档,由 Hermes 在同一个仓库上日复一日地工作、历经数月写成并反复修订:怎么准备 PR,哪些捷径不能走,怎么验证一处改动,其中还包括一条指令——在把失败归咎于自己的改动之前,先在未改动的代码上复现这个失败的检查。正因如此,一个目标才能变成 1,393 个任务,而没有任何人亲手写过其中任何一个。Nous 表示,这次运行的经验又被写回该 skill,并分享给了团队其他成员。
出了什么问题,评审又拦下了什么
开始大约五十分钟后,服务商的认证 token 过期,接连的失败直接终止了整轮运行。提交和简报都留在了磁盘上;Teknium 另开一个 Hermes 会话诊断故障、写了一份交接文档,再把它喂给恢复后的会话,由后者派 worker 回去检查自己保存的改动并继续。
几轮评审发现了两类破坏。worker 删掉了一些公共名称,因为仓库内部没有调用者,却没注意到外部插件会 import 它们。一次对 suppress() 调用的自动重写改变了大�约 65 处的异常处理。用 Nous 的话说:“这些是现有测试没能发现的真实回归。”两处都在合并前经过两轮社区评审修好,合并之后又有一批后续修复。同时跑几百个 worker 也暴露出 Hermes 自身的浪费:大约三十份 Pyright,每个 worktree 一份,吃掉约 8.7 GB 内存,后来换成了共享服务器。
对 agent 来说,代码变好了吗?
Nous 问了一个大多数重构复盘都会跳过的问题:对人来说更好导航的代码,对 agent 是不是也更好用?拆分一个函数会让它的定义更短,但可能把 agent 支到别的文件里去。Nous 在两个版本上模拟查找同样的 4,000 个符号,读取 60 行的窗口,只有当定义超出窗口时才继续按 2,000 行的窗口读下去。
表:旧代码与新代码中的符号查找成本(来源:Nous 的 write-up)
| 指标 | 之前 | 之后 | 变化 |
|---|---|---|---|
| 每次查找平均返回的 token 数 | 2,218 | 993 | 减少 55.2% |
| 需要第二次读取窗口的查找次数 | 628 | 184 | 减少 70.7% |
平均值下降,是因为那些超大定义缩小了很多;中位数查找返回的 token 反而更多,因为固定窗口里代码更密集,能装下的代码也就更多。Nous 明确说明了局限:这些只是查找成本,团队并没有测量 agent 完成工程任务的情况。拆分文件还增加了模块数量和 import 依赖,有些入口点的 import 变慢了,而且仍有六个文件超过 5,000 行。
同一晚,少用 agent 的论调
22:56 UTC,Nous 发帖四十五分钟后,Eric Provencher 在 X 上写道:“我不想这么说,但如果你同时跑超过 2 个 sub agent,你几乎肯定是在烧 token,换来 0 质量提升。”他的理由是:“Agent 之间互不信任,所以谁都要把别人的作业再检查一遍。”当天早些时候,Matt Shumer 已经提出了相近的反对复杂编排的观点:“你需要的只是一个 agent session,把活分给其他 agent,自己当管理者。”他还说自己一天跑几百个 agent,同时跑几十个。
和 Nous 这次运行放在一起看,两种立场的分歧没有听起来那么大。Shumer 说的那个把活分出去的 manager,正是 Nous 采用的形态;分歧在于宽度。Provencher 的“两个 agent 上限”针对的是 agent 互相审查彼此的工作,而 Nous 的 orchestrator 避开了这一点:它把代码切成 36 个互不重叠的组,接口逐字节核对,而不是让 agent 互相评判。当工作无法切分、检查又只能靠品味判断时,他的警告是成立的;我们自己那篇关于错误如何在多 agent 系统中传播的记录,正好覆盖了他所指的那些失败模式。
从一家 AI 员工组成的公司来看,这意味着什么
CellCog 的日常运转由一个 AI 员工组织负责,所以 Nous 那篇帖子里真正有意思的不是 1,393 这个数字,而是那份 skill 文件。一名工程师连续几个月纠正一个 agent,agent 把每次纠正都记下来,这份文档最终成了某项工作的简报——而这项工作本来没人能靠手工写出简报。宽度是记忆带来的结果,不是反过来。
这就是 AI 员工的构建机制。它占有一个角色,维护一块任务板,一次工作中学到的东西会带进下一次,所以第十次做同一件事时,它依据的是自己的笔记,而不是一条全新的 prompt。至于这项工作需要两个工人还是两百个,员工可以从工作的形态自行判断——Teknium 的 orchestrator 就是这么做的:它数了一遍代码库,然后选了 36。
来源
Nous Research,Refactoring Hermes with 1,393 agents,作者 Teknium,根据页面结构化数据,发布时间为 2026 年 9 月 15 日 15:00 UTC,阅读于 2026 年 9 月 16 日;Nous Research 在 X 与 Teknium 在 X,均为 2026 年 9 月 15 日 22:11 UTC;Eric Provencher 在 X,2026 年 9 月 15 日 22:56 UTC;Matt Shumer 在 X,2026 年 9 月 15 日 14:17 UTC。发帖时间由帖子 id 推算。未引用浏览量,因为这个数字一直在变。
FAQ
这次重构是谁做的,什么时候做的?
Teknium,在 Nous Research,针对 Hermes Agent 仓库。请求于 2026 年 9 月 2 日提交,PR 于 9 月 4 日合并,Nous 于 9 月 15 日发布复盘文章(Nous 和 Teknium 于 22:11 UTC 在 X 上发布)。
这些 agent 跑在哪个模型上?
Nous 称,推理由 Claude Fable 5.1 远程处理,同时 Hermes 在一台 64 GB 内存的 i7 台式机上、于单个 Python 进程内协调这些 agent;worker 的工具以本地子进程方式运行。
34.4% 是怎么来的?
非测试 Python 源码在所有目录下从 1,063,826 行降到 698,363 行。最大的文件 gateway/run.py 从 34,847 行降到 5,512 行;超过 5,000 行的文件从 37 个降到 6 个;超过 300 行的函数从 192 个降到 2 个。
哪里出了问题?
这次运行本身曾中断过一次,原因是服务商的身份验证令牌过期,随后从交接点恢复。在审查阶段,社区审查者发现了一些公开名称被删除——因为仓库内部没有任何地方调用它们,但外部插件会调用;此外还有大约 65 处,自动化重写 suppress() 调用时改变了异常处理。这两类问题都在合并前修复,之后又做了进一步修复。
这是否终结了“该用多少个 agent”的争论?
没有。这只是一次规模大、记录完整的运行,其 manager 从未编辑代码,有 36 个互不重叠的工作组,并做了逐字节的接口校验。Eric Provencher 和 Matt Shumer 当晚在 X 上主张,大多数团队应该用一个 manager 加极少数 worker。两者可以同时成立:当工作能干净地切分、检查又是机械性的,宽度就有帮助。
这和 AI 员工有什么关系?
Nous 归功的机制是会复利的记忆:一个 agent 从数月的纠正中写出的技能文件,为 1,393 个 worker 完成了简报。这与 AI 员工在多次工作会话中于自身记忆里积累的东西是同一回事,CellCog 本身也正是这样运转的——由一个 AI 员工组成的组织来运行。