オープンモデルの勢力バランスは今どちらに傾いているのか
Nathan Lambert が米国議会議員向けに行ったオープンウェイトモデルのブリーフィング。中国は2025年7月以降 Hugging Face のダウンロード数で逆転し、AAII でも先行。米国のトップラボは閉鎖的になり、地位が揺らぐ。
日本語
コピー
最近、米中競争の文脈におけるオープンウェイトモデルの現状について、議員とスタッフの一団にブリーフィングを行う機会を得た。ここにその原稿を共有する。より広い読者に向けた、オープンモデルに関する国情教書のようなものだ。
Interconnects AI は読者に支えられた出版物です。購読をご検討ください。
おさらい:オープンソースモデル、オープンウェイトモデル、クローズドモデルとは何か
オープン言語モデルとは、重みが公開され、検証や下流での利用が可能な AI モデルを指す。通常は、いわゆる「クローズド」な AI モデルと対置される。クローズドモデルは API 経由でしかアクセスを提供しない——開発者は GPT-4 や Claude Opus 4.5 のようなモデルを API で直接クエリできる——あるいは ChatGPT や Claude Code のような製品として提供される。
オープン言語モデルは主に二種類に分かれる。オープンウェイトモデルとオープンソースモデルだ。オープンウェイトモデルは最も一般的な形態で、Meta の Llama、Alibaba の Qwen、Google の Gemma、DeepSeek のモデルなどが該当する。こうしたモデルはライセンス——下流での利用がどこまで許されるかを定める管理文書——に拘束され、通常は Transformers、VLLM、SGLANG といったライブラリに置かれた推論コードも伴う。2025 年 4 月ごろから、中国の AI 企業はオープンウェイトモデルで明らかに先行している。
真の「オープンソース」モデルも似ている。重み、ライセンス、推論コードを含む点は同じだが、さらにモデルを再現するために必要な情報——学習コードと学習データ——も含む。最も知られたオープンソースモデルはすべて米国発で、最近では Allen Institute for AI の Olmo シリーズが代表例だ。私も同機関で二年半働き、これらのモデルの構築に関わった。他の著名なオープンソースモデルも米国の非営利組織が作っている。OpenAthena の Marin シリーズや EleutherAI の Pythia シリーズがそうだ。
オープンウェイト、オープンソース、その他モデルに貼られるあらゆるラベル——主に API で提供されるクローズドモデルも含めて——は連続体の上にある。たとえば Nvidia の Nemotron モデルは大半のオープンウェイトモデルよりはるかにオープンで、寛容なライセンスの下で大量の学習データを公開しているが、完全なオープンソースではない。すべてのデータを公開しているわけではないからだ。クローズドモデルも同様に連続体の上にある。API が何を開示するか、利用規約がどうなっているかによって変わる。
米中オープンウェイトモデルの競争状況(単位経済性、技術能力など)
私たちは今、GLM-5.2 や Kimi K3 といった中国の最新の先端モデルが、オープンモデルの商業的な実現可能性を段階的に変えた世界にいる——エージェント能力において、Anthropic の Claude Code が 2025 年 12 月に越えたのと同種の閾値を越えたのだ。
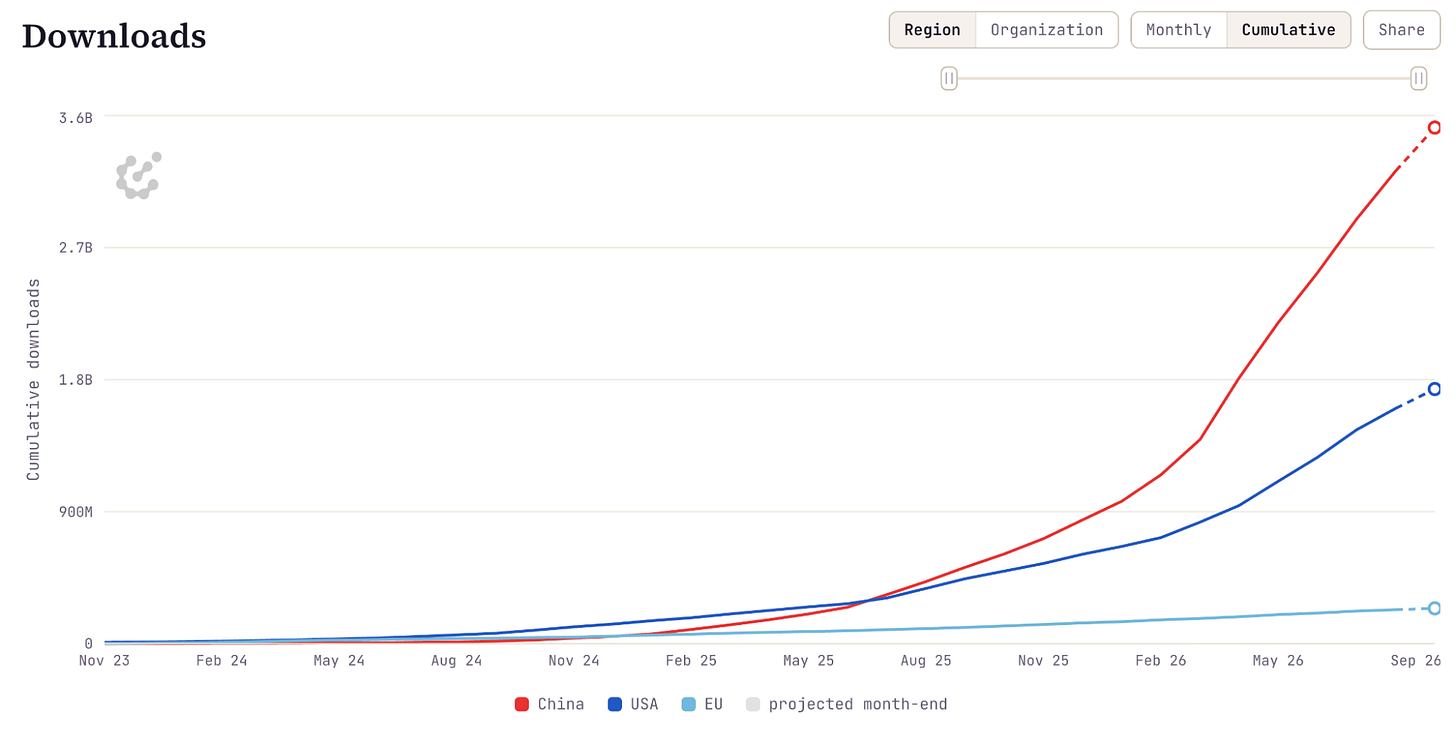
米国はオープン言語モデルの初期の先頭走者だった。主に Meta の Llama シリーズによるもので、これらのモデルは研究や商用タスクで広く使われた。約 18 か月前、中国のオープンウェイトモデルはこの二つの重要領域で米国のオープンウェイトモデルを追い越した。最も分かりやすい指標は Hugging Face のダウンロード数だ。2025 年 7 月に中国が先行し、その原動力は主に Alibaba の Qwen シリーズの成功だった。私はこれらのデータを追跡するツールを個人的に保守しており、2025 年 8 月に American Truly Open Models(ATOM)プロジェクトを初めて公開して以来、中国のダウンロード数の優位は約 16 億に拡大した——総ダウンロード数 32 億で、米国の二倍だ。
Artificial Analysis Intelligence Index(AAII)のような主要な能力ベンチマークでは、中国のオープンウェイトモデルは米国の同種モデルに対して明確な優位を持つ。本稿執筆時点の 2026 年 9 月 14 日現在、上位三つの中国モデルは Z.ai の GLM-5.3、GLM-5.3-Flash、Moonshot AI の Kimi K3 で、スコアはそれぞれ 45、42、44。対して米国の先行モデルは Thinking Machines の Inkling と Inkling Small でいずれも 26、Nvidia の Nemotron 3 Ultra が 23 だ。米国最強のモデルは 2026 年 6 月と 7 月に公開され、更新頻度も中国の同種モデルより低い。たとえば中国のラボは、これらの米国モデルより高いスコアを出すモデル(GLM-5 や DeepSeek V4 Pro など)を、米国企業より 2 から 6 か月早く公開している。モデルを公開する米国企業の数は増えている。Arcee AI、Poolside、IBM などだが、こうした企業はこの性能差を速やかに縮めてはいない。他のベンチマークでも同様の状況が見られる。
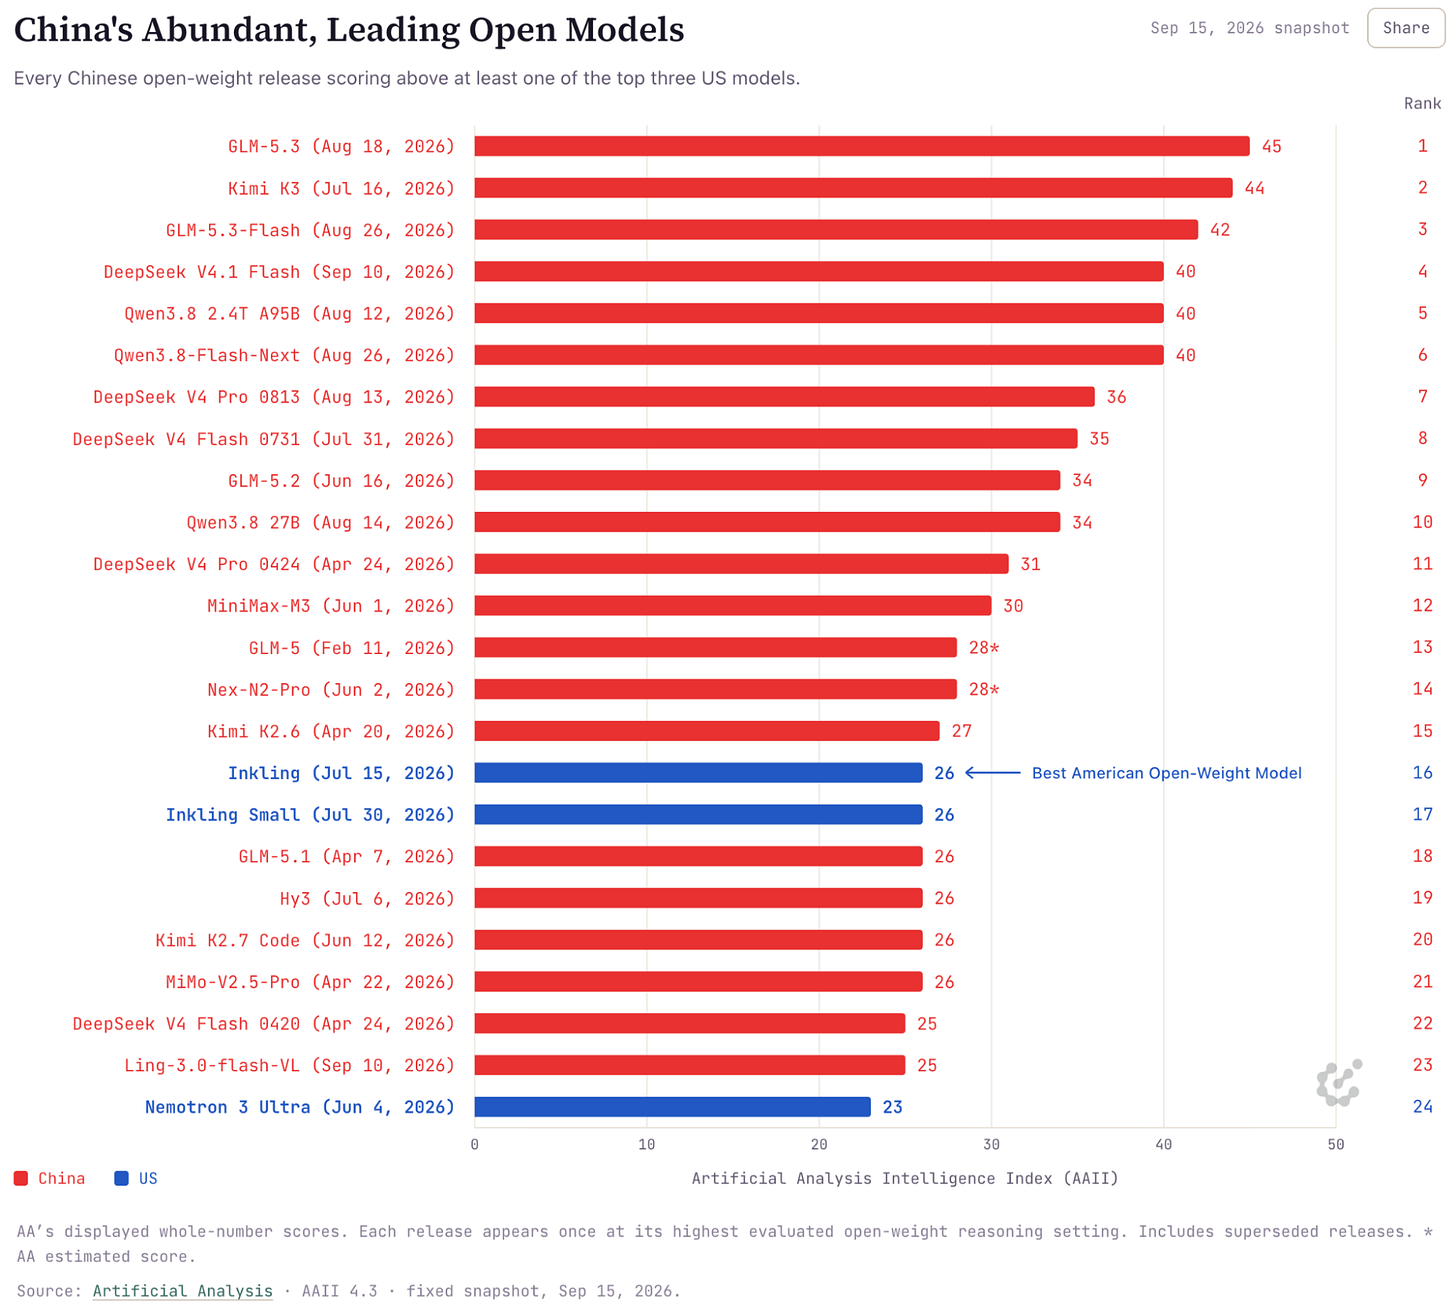
Artificial Analysis Index では、米国最良のオープンモデルは中国製のさらに 15 のモデルに後れを取っている。
全体として、中国のオープンウェイトモデルは米国のクローズドなフロンティアから約 2〜5 か月遅れ、米国のオープンウェイトモデルは OpenAI や Anthropic のような企業から約 6〜9 か月遅れている。ユーザー需要が明確なタスク、たとえば agentic coding では中国のラボの差が最も小さい。物理や生物のような、より開かれた科学研究タスクでは差が大きい。
中国のラボは米国の同業者ほどリソースがないのに、こうした強いモデルを作れている。その理由は今も議論があり、仕事文化の違いに大きく左右されるが、いくつかの技術的要因も効いている。中国のラボはモデルのリリースが速く、狙うタスクの分布もやや狭い。これが公開ベンチマークで少し水増しされたスコアにつながる。リリースが速いと高得点を取りやすいのは、どのラボも進歩を続けているためだ。モデルが「完成」して出荷される時点の性能は、その時点のスナップショットにすぎない。時点が後ろのラボほどスコアは高くなりやすい。とはいえ、中国のラボが作るモデルは実際に強く、米国産業にとって本物の競争相手になっている。クローズドソースのラボは自社 API にある蒸留され得る穴を塞ぐだろうが、それでこの競争が目に見えて弱まることはない。
蒸留が最も効くのは新しい領域で、それだけで包括的に強い最終モデルを簡単に作れるわけでもない。蒸留が完全に遮断された場合——たとえば Anthropic や OpenAI が KYC ツールを導入した場合——を想定しても、米国最強モデルと中国のオープンウェイトモデルの差はさらに 1〜2 か月広がる程度だと私は見ている。
たとえば 2026 年、中国のラボは有料の訓練データ購入に対する姿勢を急速に変えつつある。年初には Moonshot AI や Z.ai を含む中国の主要ラボが自前のデータワークフロー構築を強く志向していたが、夏になると米国の老舗企業や中国の新興企業から最先端のデータを買い始めた。agentic タスク向けの難度の高い RL 環境である。
中国のオープンウェイトモデルが能力のフロンティアへ近づくにつれ、さらに最近、フロンティアモデルがサイバーセキュリティなどの領域でもたらすリスクが記録されるようになり(OpenAI-HuggingFace の件など)、規制上の不確実性が増している。モデルを出し続けることが、どうすればより安全なエコシステムにつながるのか。
オープンウェイトモデルが抱える構造的な難しさは、オープンソフトウェアの一部が悪意ある行為者の手に渡るのを防ぐ有効な手段がほとんどないことだ。中国の最先端オープンウェイトモデルがリスクを増幅させるからといってその入手を制限しようとすれば、足を引っ張られるのは米国企業になる。先例はある。HuggingFace はあのサイバー攻撃を理解するために中国のオープンウェイトモデルを使った。クローズドソースモデルが彼らの要求を拒否したからだ。つまりオープンウェイトモデルのリスク管理は、しばしばエコシステム側の備えの問題に帰着する。
オープンウェイトモデルは AI 普及の鍵となるツールになりつつあり、こうしたリスクや、米国企業が中国製モデルに依存するという不均衡に先手を打つ最良の道は、米国によるオープンモデルへの投資を続けることだ。オープンモデルを握っていれば、本質的にグローバルなこれらのリスクをよりうまく調整し備えられるうえ、米国国内経済における AI サービスの普及も加速する。
オープンモデルの採用状況:学界、企業、その他の国はオープンソースをどう使っているか
2026 年、オープンウェイト言語モデルは注目度でも経済的な実現可能性でも大きく前進し、Hugging Face の指標以外にも、米国・中国・その他地域のモデル採用状況をより直接的に比べる手がかりが初めて見え始めた。OpenRouter の利用量がその一例だ。OpenRouter は人気のある LLM 推論プラットフォームで、米国と中国のオープン/クローズド両方のモデルを切り替えられる統一インターフェースを提供する。さまざまなオープンウェイトモデルを試す場として知られている。このプラットフォームは 2025 年 1 月 1 日以降の主要モデルの利用データを公開しており、オープンモデルの利用量は 2025 年 9 月のある週で約 1T token の処理量だったのが、現在は週約 80T token にまで増えた。この間、中国モデルのシェアは約 70% から利用量の 80% 超へと拡大した。オープンモデルの商用化を狙う他のプラットフォームも同様の数字を示す。たとえばオープンソースのコーディング agent である OpenCode では、推論量に占める中国モデルの割合が約 95%、あるいはそれ以上に達する。
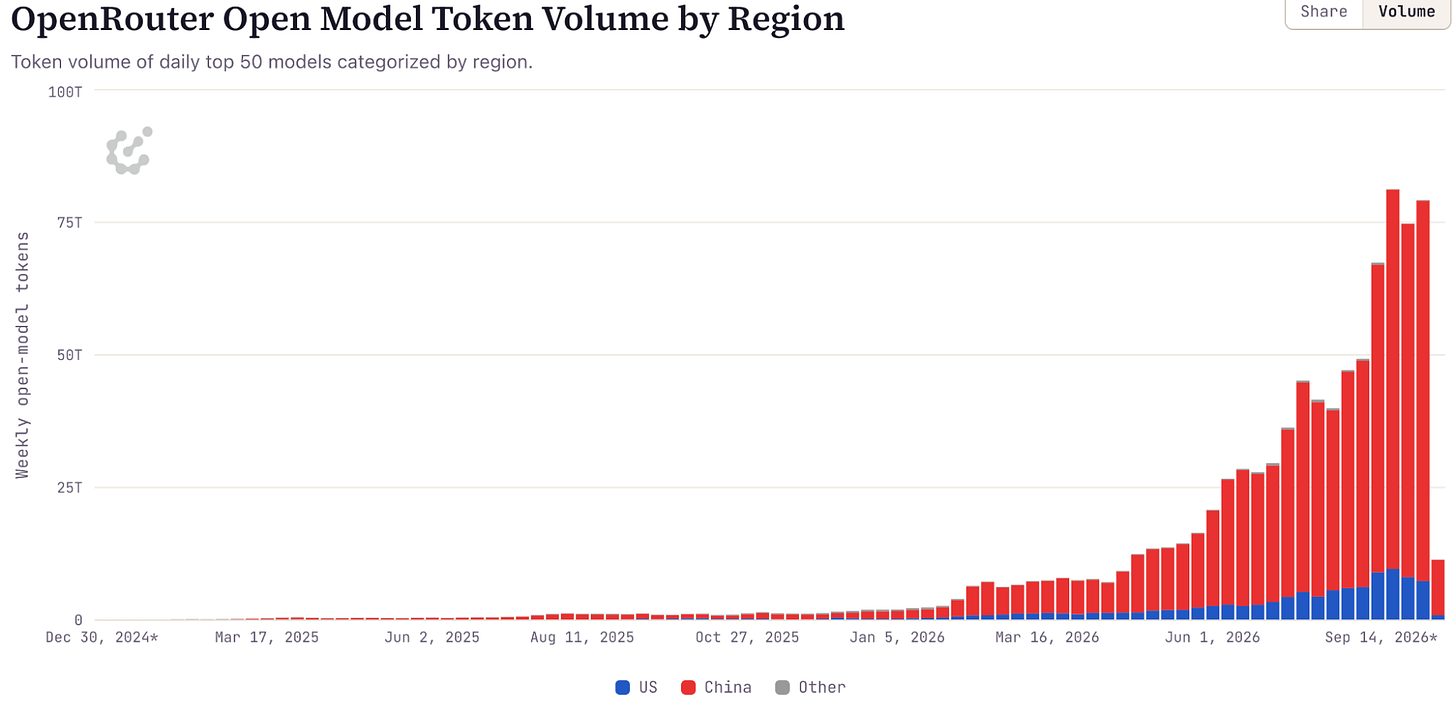
これらのオープンなプラットフォームは、現時点でオープンモデルの利用状況を最もよく近似したものだ。オープンモデルの利用のかなりの部分は、Together AI や Fireworks AI のようにモデル別の内訳を公開していないプラットフォームや、企業アプリのプライベートデプロイで起きている。
多くの著名なテック企業やスタートアップが中国のオープンウェイトモデルを土台に自社の AI 機能を構築してきた。法律 agent の Harvey、コーディング agent の Cursor、DoorDash による Kimi モデルの利用、Airbnb による Qwen の利用、Perplexity による DeepSeek の利用などがそうだ。こうした有名企業は氷山の一角にすぎず、より若いシリコンバレーのスタートアップも数多く、低コストで柔軟な選択肢を得るために中国モデルを土台に製品を作っている。米国のスタートアップや企業が中国のモデルラボと企業契約を結ぶ流れは拡大しており、目的は製品でこれらのモデルを使うライセンスを得ることだ。私のキャリアで見たことのない新しい形の越境技術協力である。
中国モデルを土台にした革新は、さらに AI エコシステム全体へ広がっている。粗い見積もりだが、学術研究の大半は Alibaba の Qwen シリーズで行われている。私も中国滞在中に Qwen のリーダー陣の何人かに会ったが、彼らはこの採用に非常にコミットしており、強い自覚も持っていた。この状況を米国モデル側に引き戻すのは容易ではない。
学界におけるオープンモデルの採用を定量化するため、arXiv(AI 研究でよく使われるプレプリントプラットフォーム)の ML 分野で最も人気のある 5 分類(cs.AI、cs.CL、cs.CV、cs.LG、stat.ML)の論文をすべて走査した。結果は、AI 研究の主導権の変化についての私の見方をはっきり裏づけた。LLM は ML 研究の基盤層になりつつある——何らかのオープンモデルに言及する論文の割合は 2023 年 1 月に 2%、2026 年 9 月には 50% に達した。同じ時期に主導権も米国から中国へ移った。
たとえば、Metaの最初のLlama(Large Language Model Meta AIの略で、2023年2月に初公開)が登場してから数か月後の2023年4月から5月にかけて、arXivに投稿されたAI/MLの新規論文12,000本のうち約2,600本が、少なくとも1つの著名なオープンモデル系列に言及していた。論文全体では、約5.5%がLlamaに、約1%が中国のモデルに言及している。Llamaの全盛期だった2024年秋には、約23%の論文がLlamaに、約7.5%がQwen——中国で最も直接的な競合——に言及した。現在、Llamaは学界での首位の座を失ったが、それでも約21%の論文が言及しており、この粘り強さは驚くべきものだ。一方でQwenのシェアは30%まで上昇した。全体で見ると、何らかの中国製オープンウェイトモデルに言及する論文は40%を超え、米国の30%を上回っており、中国のシェアは伸び続けている。
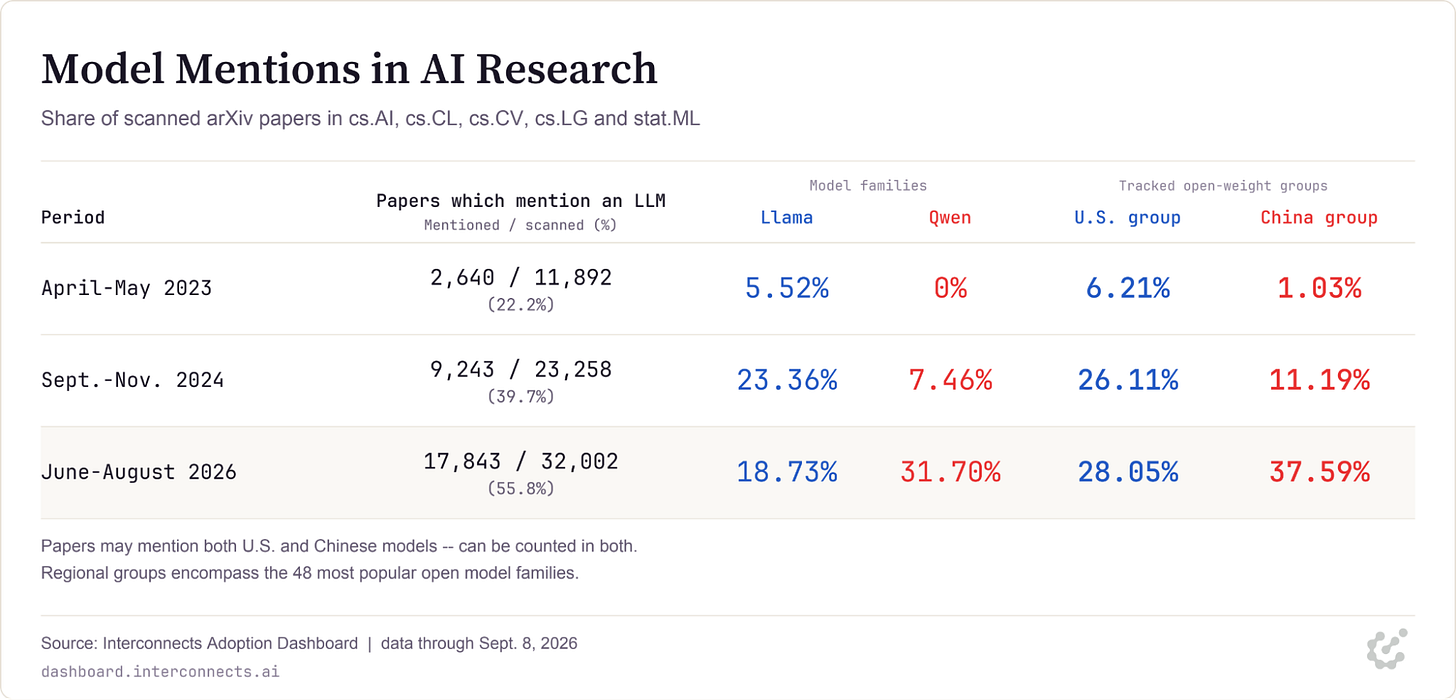
つまり、オープンウェイト言語モデル時代に米国をAI研究の本拠地として再確立するには、明らかにやるべきことが山ほどある。とはいえ、希望の兆しもある。
我々の研究では、中国のモデルと能力対規模の比が同等の米国モデルは、不釣り合いなほど高い採用率を示すことが分かった。この1年で、OpenAIがChatGPT以降に初めて出したオープンウェイトモデルgpt-ossは、史上最も広く採用されたオープンウェイトモデルの1つになった。その後、GoogleのGemma 4シリーズは、Qwenの人気小規模モデルに採用量で肩を並べた数少ないモデルとなり、NvidiaのNemotronシリーズは、同じ規模により能力の高いモデルが多数あるにもかかわらず、採用は平凡にとどまっている。
まとめ
2026年のオープンモデルの主軸は、自らの経済的地位を確立することにある。これはAIエコシステムの複数の流れが交差した結果であり、次のように整理できる。
-
ユーザーが使えるオープンモデルとクローズドモデルの能力差は、この3年間縮小し続けてきた。 差はタスクによって異なるが、おおむね2〜5か月分の能力差と見積もれる。全体の能力が急速に進歩しているため、オープンウェイトモデルは2026年に無視できない市場を開き、近い将来さらに多くの転換点が訪れることを示唆している。
-
オープンモデルの利用は、ソフトウェアエンジニアリング、法律サービス、金融サービスといった高価値産業で爆発的に伸びており、トップクラスのクローズドモデルに取って代わりうるエコシステムが形成されつつある。オープンモデルの推論を主業務とするプラットフォーム——Together、OpenRouter、Fireworks、Basetenなど——は驚異的に成長し、オープンモデルのポストトレーニング経済における最初の勝者となった(この層にはThinking MachinesのTinkerなどのファインチューニングAPIも含まれる)。同時に、AI業界の技術者の間では、GLM-5.3などのオープンウェイトモデルでClaudeやGPTを置き換える事例が数多く共有されている。評価のポイントは速度、低価格、カスタマイズ性、プライバシーだ。
-
中国のAI企業はオープンウェイトモデルで明らかに先行している。 2025年にはDeepSeek R1などの中国モデルがダークホースとしてAI界を揺るがした。対照的に、米国のAIラボはオープンウェイトモデルでの立場を持ち直しつつあるが、米国の投資がより大きいにもかかわらず、中国のラボは明らかに強力で、さまざまなユーザーに愛されるモデルを出し続けている。
-
中国のラボによる米国AIモデルの蒸留だけでは、その成功を十分に説明できない。 蒸留は業界標準の手法であり、通常はより強力なモデルの出力を使って別のAIモデルを訓練する。この技術は中国のAI業界で最も広く使われており、基本的な手段を用いて米国企業の防御が甘い製品から推論トレースや追加データを引き出している。最も信頼できる推定では、蒸留は中国企業と米国のフロンティアとの能力差を1〜2か月縮める。
-
中国のモデル、とりわけAlibabaのQwenシリーズは、学界とローカルモデル利用者の研究開発の基盤層になった。ここ数か月、中国のオープンウェイトモデルはAI論文の38%で言及され、米国の28%を上回っている——しかも中国のシェアは米国よりはるかに速く伸びている。この事実は、他の政治的要素や米国の主要AI企業の閉鎖性と相まって、世界の首要AI研究拠点としての米国の優位を急速に損なっている。
-
オープンウェイトモデルの能力水準は新たな段階に入りつつある。多数のオープンウェイトモデルが利用可能になるにつれ、新たなリスク(サイバーセキュリティリスクなど)が顕在化しうるため、エコシステム全体として対応の準備が必要になる。この新たなリスクの時代は政治的な不確実性ももたらす。規制の関心は最強のAIモデルに集まっているが、政策が法的にどう着地するかは依然として大きな不確実性を伴う。一方で、多くの研究者やエンジニアは、ガードレールがより緩いことを理由にオープンモデルに依存している。ClaudeやGPTなどのクローズドモデルは、重要なサイバーセキュリティ防御業務や生物学研究をしばしば拒否するからだ。
より詳細なデータはInterconnects Dashboardを参照。
結論
2026年、中国のラボは依然としてオープンウェイトAIエコシステムのリーダーの座に堅く収まっている。この判断の背景には、オープンウェイトモデルが経済的な実現可能性の転換点を越えたこと、そして米国のラボがモデル競争の構えで投資を増やしていることがある。先行する中国のラボは、エンタープライズ用途と研究での採用を世界規模で広げる際に、真に有力な挑戦者に直面していないように見える。
開放モデルのこの構図は、AI エコシステム全体にとって重要な節目に現れた。OpenAI と Anthropic は最新の公開モデルで大きく前進する一方、AI 開発の次の段階を管理するために各方が慎重に協調するよう呼びかけている。今日、少数の AI ラボの内部で起きていること——とりわけ極めて高い人材密度と計算資源密度——は、開放モデルエコシステムにまもなく訪れる景色の前触れだ。真にフロンティアに立つ少数の AI ラボ以外のすべてにとって、開放モデルは、ソフトウェアエンジニアリングやその他の計算実践の加速を受け止める基盤となる。変革的な知能への広範なアクセスを可能にする組織にとって、これはソフトパワー、影響力、潜在力の重要な源を意味する。
こうした未来はまもなく訪れる。だからこそ、開放モデルがたどる具体的な道筋を予測するのは難しいと、ともに謙虚に認める必要がある。開放モデルには未知が多い——たとえば、米国と中国以外の国での利用状況について、信頼できるデータはない。ML の訓練に関する専門知識は広く分散しており、数十の組織、数千人が能力のフロンティアまで1年を切っている。開放モデルが性能の閾値を越え、新しいワークフローを解き放つのは、起こるかどうかではなく時間の問題だ。集団として取るべき道は、広く入手可能な開放知能を善き目的にどう使うかを理解しつつ、潜在的な害を能動的に減らしていくことにある。
Florian Brand と Kevin Xu に、本文へのフィードバックおよび/または助言をいただいたことに感謝する。本文を支える研究の詳細は、オープンソース AI リーディングリストを参照されたい。