开放模型的力量平衡现在倒向哪一边
Nathan Lambert 给美国国会议员的开放权重模型简报:中国自 2025 年 7 月起在 Hugging Face 下载量上反超,主要靠阿里的 Qwen;AAII 等能力基准上也领先。美国头部实验室越来越闭源。
中文
复制
我最近受邀向一群国会议员及幕僚做了一次简报,主题是在美中竞争的视角下开放权重模型的现状。这里把我准备的发言稿分享出来,它相当于一份面向更广泛读者的开放模型国情咨文。
Interconnects AI 是一份由读者支持的出版物。欢迎考虑订阅。
回顾:开源模型、开放权重模型与闭源模型分别是什么?
开放语言模型是指权重公开可供审查或下游使用的 AI 模型。它们通常与所谓的“闭源”AI 模型相对。闭源模型只通过 API 提供访问——开发者可以用 API 直接查询模型,比如 GPT-4 或 Claude Opus 4.5——或者通过产品提供,比如 ChatGPT 和 Claude Code。
开放语言模型主要分为两类:开放权重模型和开源模型。开放权重模型是最常见的形式,比如 Meta 的 Llama、阿里巴巴的 Qwen、Google 的 Gemma,以及 DeepSeek 的模型。这类模型受许可证约束——许可证是规定下游使用允许范围的管理文件——通常还附带推理代码,放在 Transformers、VLLM、SGLANG 等库中。大约从 2025 年 4 月起,中国 AI 公司在开放权重模型上已明显领先。
真正的“开源”模型与之类似,同样包含权重、许可证和推理代码,但还包含复现模型所需的完整信息——训练代码和训练数据。最知名的开源模型都出自美国,近期以 Allen Institute for AI 的 Olmo 系列为代表,我在该机构工作的两年半里参与构建了这些模型。其他知名的开源模型同样由美国非营利组织构建,包括 OpenAthena 的 Marin 系列和 EleutherAI 的 Pythia 系列。
开放权重、开源,以及其他任何给模型贴的标签——包括主要通过 API 提供的闭源模型——都处在一个连续谱上。例如,Nvidia 的 Nemotron 模型比大多数开放权重模型开放得多,以宽松许可证发布了大量训练数据,但它并非完全开源,因为没有发布全部数据。闭源模型同样处在一个连续谱上,取决于 API 披露哪些信息以及使用条款如何。
中美开放权重模型的竞争格局(单位经济性、技术能力等)
我们正处在一个这样的世界:GLM-5.2 和 Kimi K3 等中国最新的领先模型,让开放模型的商业可行性发生了阶跃式变化——在智能体能力上跨过了与 Anthropic 的 Claude Code 在 2025 年 12 月跨过的相似门槛。
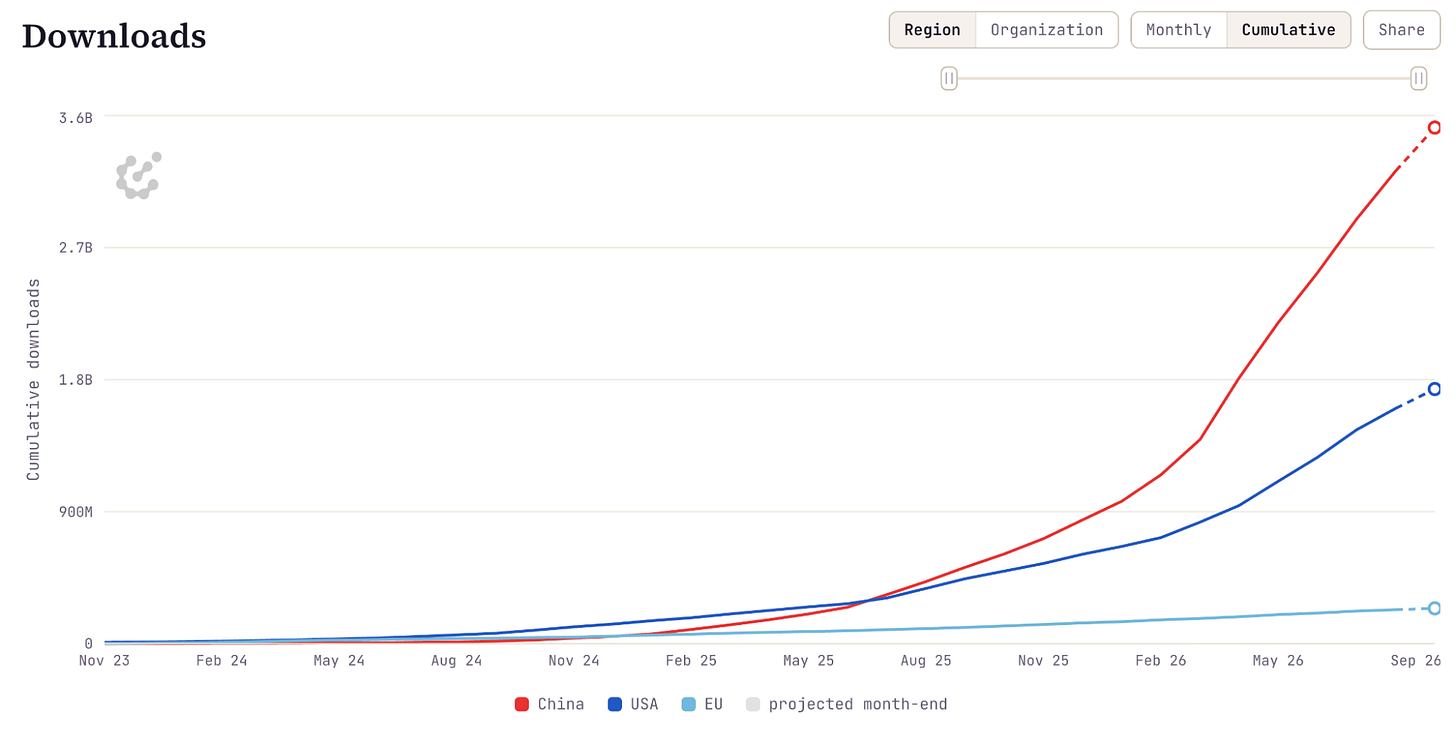
美国曾是开放语言模型的早期领跑者,主要靠 Meta 的 Llama 系列,这些模型被广泛用于研究和商业任务。大约 18 个月前,中国开放权重模型在这两个关键领域超过了美国开放权重模型。最直观的指标是 Hugging Face 下载量:2025 年 7 月中国取得领先,主要得益于阿里巴巴 Qwen 系列的成功。我个人维护着追踪这些数据的工具,自 2025 年 8 月首次发布 American Truly Open Models(ATOM)项目以来,中国的下载量领先优势已扩大到约 16 亿——总下载量 32 亿,是美国的两倍。
在 Artificial Analysis Intelligence Index(AAII)等主流能力基准上,中国开放权重模型对美国同类模型有明确优势。截至本文写作的 2026 年 9 月 14 日,排名前三的中国模型是 Z.ai 的 GLM-5.3、GLM-5.3-Flash 和 Moonshot AI 的 Kimi K3,得分分别为 45、42 和 44。相比之下,领先的美国模型是 Thinking Machines 的 Inkling 和 Inkling Small,得分均为 26,以及 Nvidia 的 Nemotron 3 Ultra,得分 23。美国最强的模型发布于 2026 年 6 月和 7 月,更新频率也低于中国同类模型。例如,中国实验室比美国公司早 2 到 6 个月就发布了得分高于这些美国模型的模型(如 GLM-5 或 DeepSeek V4 Pro)。发布模型的美国公司数量呈增加趋势,包括 Arcee AI、Poolside 和 IBM 等,但它们并未迅速缩小这一性能差距。其他基准也呈现出类似的情况。
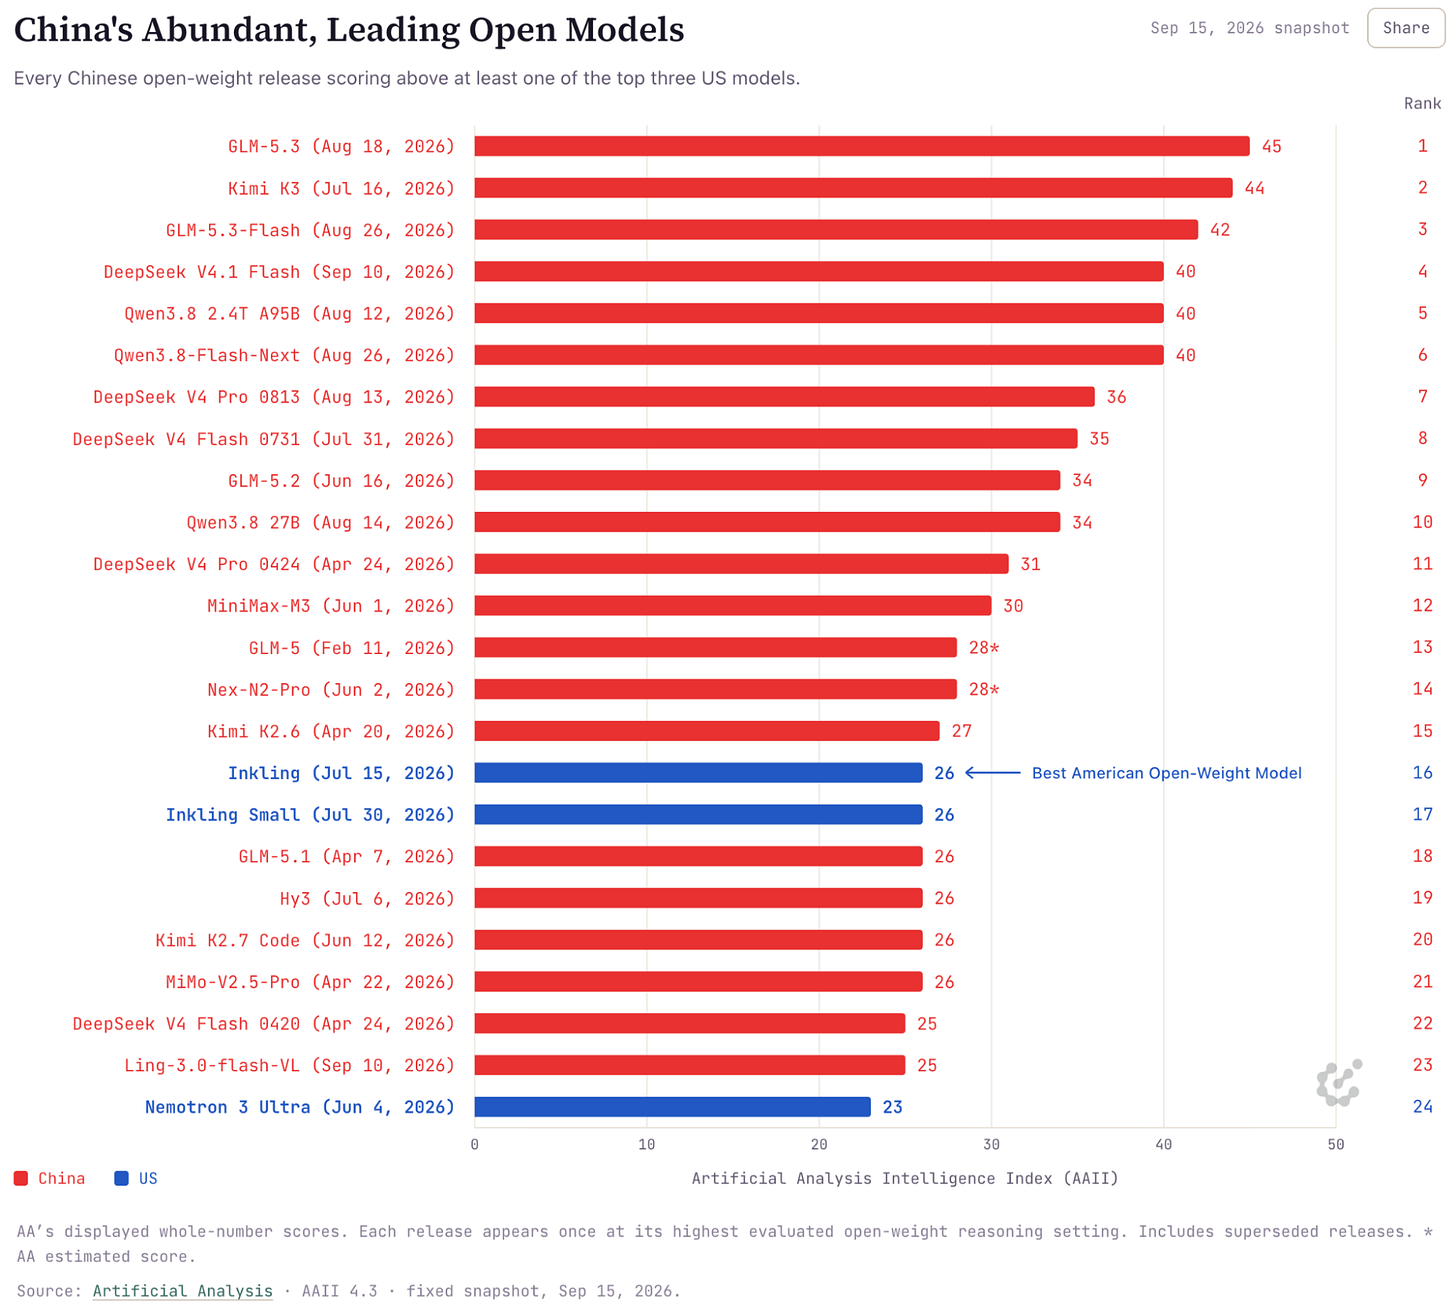
在 Artificial Analysis Index 上,美国最好的开放模型落后于另外 15 个中国制造的模型。
整体来看,中国的开放权重模型大约落后美国闭源前沿 2–5 个月,而美国的开放权重模型大约落后 OpenAI 和 Anthropic 这类公司 6–9 个月。在用户需求明确的任务上,比如 agentic coding,中国实验室的差距最小;在物理、生物这类更开放的科研任务上,差距更大。
中国实验室资源不如美国同行,却能做出这些强模型,原因仍有争议,很大程度上受不同工作文化影响,但也受几个关键技术因素影响。中国实验室发布模型更快,聚焦的任务分布也略窄一些,这在公开基准上给他们带来了一点虚高的分数。发布更快有助于拿高分,是因为所有实验室都在持续进步,一个模型“做完”准备发布时,它的性能就是那个时间点的快照——时间点更靠后的实验室,分数往往更高。不过,中国实验室做出的模型确实很强,对美国产业构成了真正的竞争。闭源实验室会修补自家 API 中可被蒸馏利用的漏洞,但这种竞争不会因此明显减弱。
蒸馏在新领域效果最大,也并不能让人轻易造出一个全面强大的最终模型。我估计,如果蒸馏被完全阻断,比如 Anthropic 和 OpenAI 采用 KYC 工具,美国最强模型与中国开放权重模型之间的差距也只会再拉大 1–2 个月。
举例来说,2026 年中国实验室对付费购买训练数据的态度正在迅速转变。年初,包括 Moonshot AI 和 Z.ai 在内的头部中国实验室还强烈倾向于自建数据工作流,但到了夏天,它们已经开始从美国老牌公司和中国新创公司手中购买最前沿的数据——用于 agentic 任务的挑战性 RL 环境。
随着中国的开放权重模型向能力前沿推进,加上近期有记录显示前沿模型在网络安全等领域带来的风险不断上升(例如 OpenAI-HuggingFace 事件),一个监管上的不确定性正在加大:持续发布模型,怎样才能促成更安全的生态?
开放权重模型面临的一个结构性难题是,几乎没有有效办法阻止开放软件的某些部分落到恶意行为者手中。如果因为中国的顶尖开放权重模型会放大风险而试图限制其获取,被拖累的将是美国企业。这方面已有先例——HuggingFace 使用中国的开放权重模型来理解那次网络攻击,因为闭源模型拒绝回答他们的请求。因此,管理开放权重模型的风险,往往归结为生态的准备。
开放权重模型正在成为 AI 普及的关键工具,而要提前应对这些风险,以及美国企业依赖中国制造的模型这种失衡关系,最好的路径是继续支持美国对开放模型的投资。掌握开放模型,就能更好地协调和准备这些本质上属于全球性的风险,同时加快 AI 服务在美国国内经济中的普及。
开放模型的采用现状:学术界、企业和其他国家如何使用开源?
2026 年,开放权重语言模型在普遍关注度和经济可行性上都有大幅提升,这让人们得以初步看到,在 Hugging Face 指标之外,还有更直接的方式比较美国、中国及其他地区模型的采用情况。OpenRouter 的使用量就是一例。OpenRouter 是一个流行的 LLM 推理平台,提供统一接口,可在来自美国和中国的开放与闭源模型之间切换。这个平台主要以试用各种开放权重模型而闻名。该平台自 2025 年 1 月 1 日起共享了头部模型的使用数据,显示开放模型的使用量从 2025 年 9 月某一周的约 1T token 处理量增长到如今的每周约 80T token。在此期间,中国模型的市场份额从约 70% 增长到使用量的 80% 以上。其他以开放模型商业化为目标的平台也显示出类似数据,例如开源编程 agent OpenCode,其推理量中中国模型占比约 95% 甚至更高。
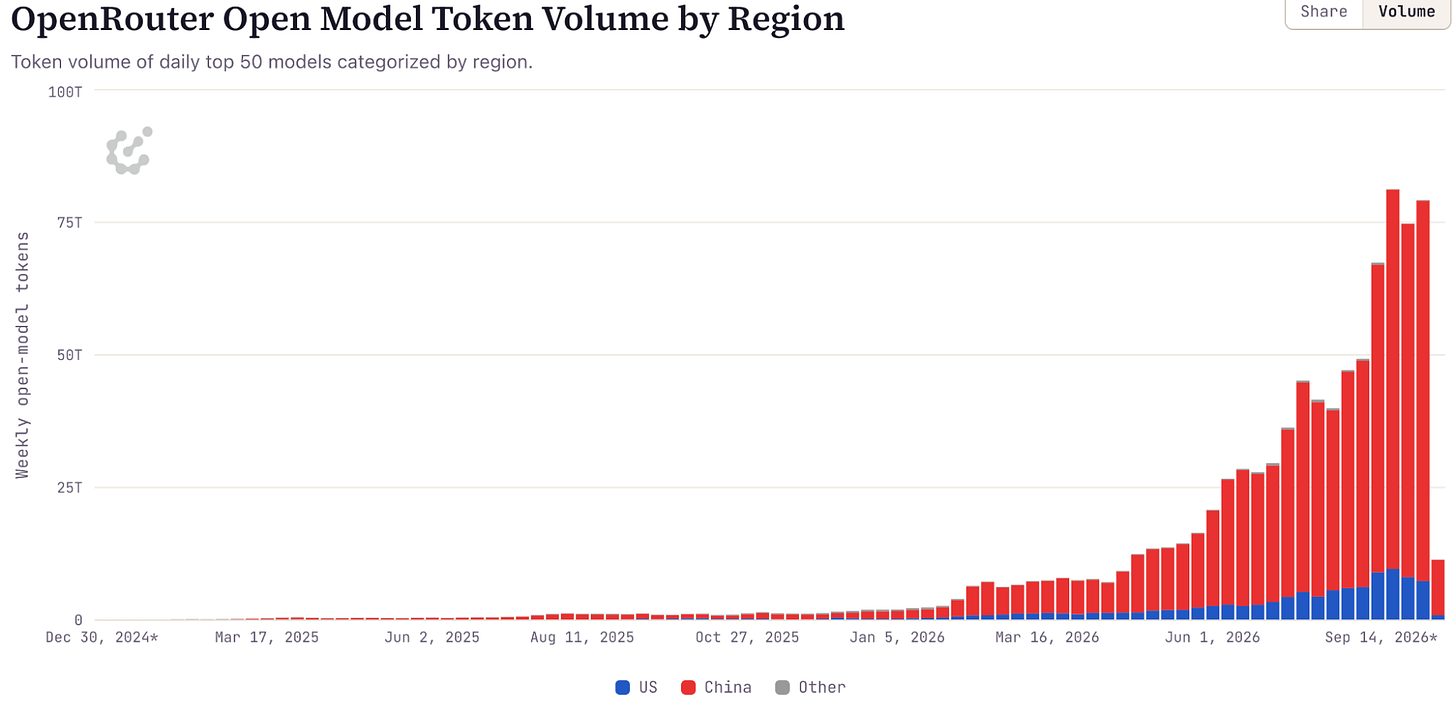
这些开放平台是我们目前对开放模型使用情况最好的近似——很大一部分开放模型的使用发生在不公开分模型明细的平台上,比如 Together AI 或 Fireworks AI,以及企业应用的私有部署中。
许多知名科技公司和初创企业一直在基于中国的开放权重模型构建自己的 AI 功能,例如法律智能体 Harvey、编程智能体 Cursor、DoorDash 对 Kimi 模型的使用、Airbnb 对 Qwen 的使用,以及 Perplexity 对 DeepSeek 的使用。这些知名公司只是冰山一角,大量更年轻的硅谷初创企业也在基于中国模型构建产品,以获得低成本、灵活的选择。美国初创企业和公司与中国模型实验室签订企业协议的趋势正在增长,目的是获得在产品中使用这些模型的许可——这是我职业生涯中未曾见过的一种新型跨境技术合作。
基于中国模型的创新根基还进一步延伸到整个 AI 生态。粗略估计,大多数学术研究都是在阿里巴巴的 Qwen 系列模型上进行的。我在中国之行期间见过 Qwen 领导团队的多位成员,他们对这类采用非常投入,也很有意识,而要把这种局面拉回美国模型并不容易。
为了量化开放模型在学术界的采用情况,我扫描了 arXiv(AI 研究中流行的预印本平台)中 5 个最热门 ML 分类(cs.AI、cs.CL、cs.CV、cs.LG、stat.ML)里的每一篇论文。结果清楚地印证了我对 AI 研究领导权演变的判断:LLM 正在成为 ML 研究的基础层——提到任何开放模型的论文占比在 2023 年 1 月为 2%,到 2026 年 9 月为 50%——同一时期,领先地位也从美国转向中国。
例如,2023 年 4 月至 5 月,也就是 Meta 最初的 Llama(一个首字母缩略词,Large Language Model Meta AI,2023 年 2 月首次发布)问世几个月后,arXiv 上 12,000 篇新 AI/ML 论文中约有 2,600 篇提到了至少一个知名开放模型系列。在所有被扫描的论文中,约 5.5% 提到 Llama,约 1% 提到某个中国模型。2024 年秋季,也就是 Llama 的巅峰期,约 23% 的论文提到 Llama,约 7.5% 提到 Qwen——中国最直接的竞争者。如今,Llama 已失去在学术界的领先地位,仍有约 21% 的论文提到它,这一生命力相当惊人,但 Qwen 的份额已升至 30%。总体来看,任何中国开放权重模型在超过 40% 的论文中被提及,高于美国的 30%,而中国的份额还在继续增长。
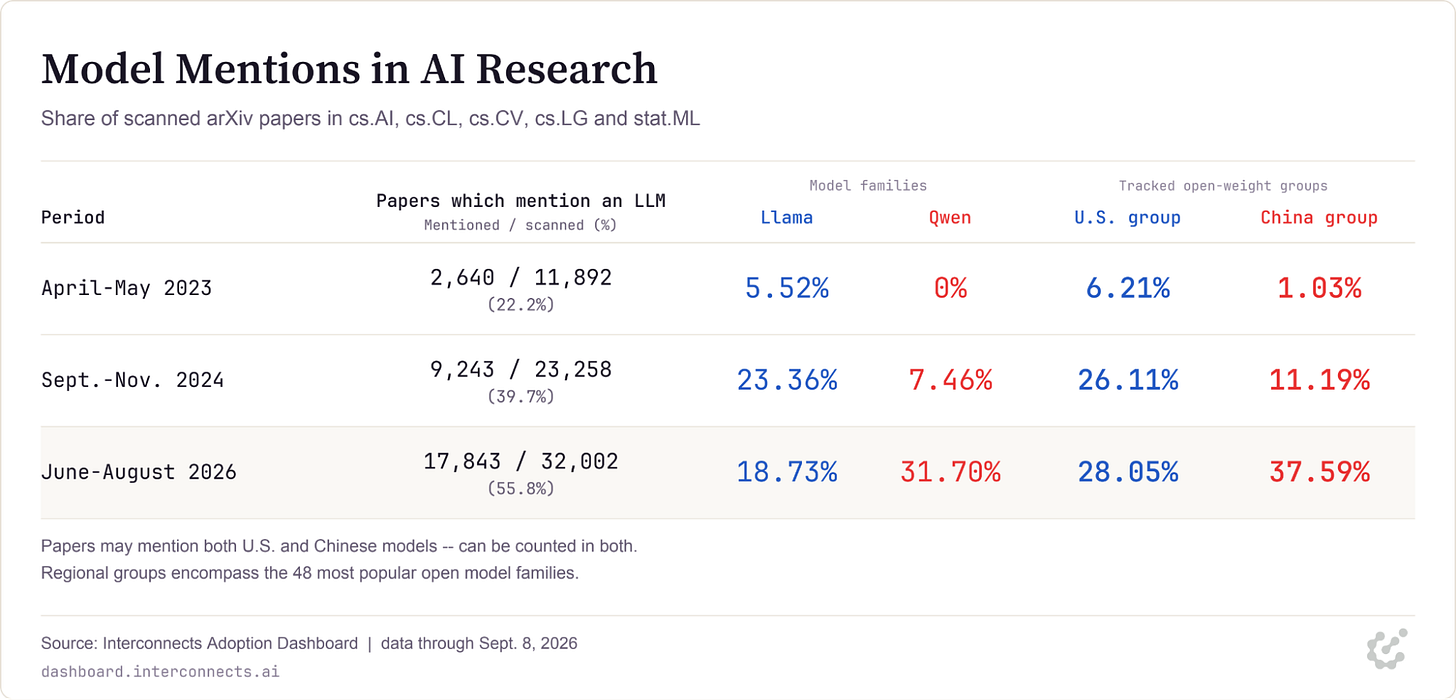
这说明,要在开放权重语言模型时代重新确立美国作为 AI 研究大本营的地位,我们显然还有大量工作要做。不过也有希望的迹象。
在我们的研究中,我们发现,与中国模型能力—规模比相当的美国模型,被采用的比率高得不成比例。过去一年,OpenAI 自 ChatGPT 以来首批开放权重模型 gpt-oss 成为史上采用最广的开放权重模型之一。此后,Google 的 Gemma 4 系列成为仅有的几个采用量能与 Qwen 最受欢迎的小模型相提并论的模型,而 Nvidia 的 Nemotron 系列尽管在同一规模上有众多能力更强的模型,采用情况却只能算平平。
总结
2026 年开放模型的主线,是确立自身的经济地位。这是 AI 生态中多条脉络交汇的结果,可归纳为:
-
用户可用的开放模型与闭源模型之间的能力差距,在过去 3 年里一直在缩小。 差距因任务而异,但大致可估算为 2–5 个月的能力差。由于整体能力进步极快,开放权重模型在 2026 年打开了可观的市场,也预示着不久的将来会出现更多拐点。
-
开放模型的使用量在高价值行业(如软件工程、法律服务、金融服务)中爆发式增长,表明一个足以替代顶级闭源模型的生态正在形成。以开放模型推理为主营业务的平台——Together、OpenRouter、Fireworks、Baseten 等——增长惊人,成为开放模型后训练经济中第一批赢家(这一层还包括 Thinking Machines 的 Tinker 等微调 API)。与此同时,AI 行业技术人员中流传着大量案例:他们用 GLM-5.3 等开放权重模型替代 Claude 或 GPT,看中的是速度、更低的价格、可定制以及隐私。
-
中国 AI 公司在开放权重模型上明显领先。 2025 年 DeepSeek R1 等中国模型曾以黑马姿态震动 AI 界;相比之下,美国 AI 实验室在开放权重模型上的位置有所回升,但尽管美国投入更大,中国实验室仍不断拿出明显更强、且被各类用户喜爱的模型。
-
中国实验室蒸馏美国 AI 模型,并不能完全解释它们的成功。 蒸馏是一种行业标准做法:用通常更强的模型的输出来训练另一个 AI 模型。这一技术在中国的 AI 行业中最为普遍,他们利用一些基本手段,从美国公司防护不严的产品中提取推理轨迹和额外数据。最可靠的估计是,蒸馏能把中国公司相对美国前沿水平的能力差距缩小 1–2 个月。
-
中国模型,尤其是阿里巴巴的 Qwen 系列,已成为学术界和本地模型用户研发的基础层。近几个月,中国开放权重模型在 38% 的 AI 论文中被提及,高于美国的 28%——而且中国的份额增长速度远快于美国。这一点,加上其他政治因素以及美国头部 AI 公司的封闭性,正在加速削弱美国作为全球首要 AI 研究中心的领先地位。
-
开放权重模型的能力水平正在进入一个新阶段:随着大量开放权重模型可供使用,新的风险(例如网络安全风险)可能被触发,因此需要整个生态体系层面做好准备来应对。这一新的风险时代也带来了政治上的不确定期:监管注意力集中在最强的 AI 模型上,但政策究竟如何在法律上落地,仍存在巨大的不确定性。与此同时,许多研究人员和工程师依赖开放模型,因为其防护限制更为宽松,而 Claude、GPT 等闭源模型往往会拒绝关键的网络安全防御工作或生物学研究。
更多数据请查看 Interconnects Dashboard。
结论
2026 年,中国实验室显然仍稳坐开放权重 AI 生态的领导者位置。这一判断的背景是:开放权重模型在经济可行性上已经越过拐点,同时美国实验室正以模型竞争的姿态加大投入。领先的中国实验室在向全球扩展企业级应用与研究采用时,似乎并未遇到真正有力的挑战。
开放模型的这一格局,出现在整个 AI 生态的关键节点上。OpenAI 和 Anthropic 凭借最新的公开模型大幅向前推进,与此同时又呼吁各方审慎协调,管理 AI 发展的下一阶段。今天发生在少数几家 AI 实验室内部的事情——尤其是极高的人才密度与算力密度——正是开放模型生态即将出现的景象的前奏。对于少数真正处于前沿的 AI 实验室之外的所有人来说,开放模型将成为底座,用来承接软件工程及其他计算实践的加速。对于那些让这种广泛获取变革性智能成为可能的组织而言,这代表着软实力、影响力与潜力的重要来源。
这样的未来很快就会到来,因此我们需要共同保持谦逊,承认开放模型的具体路径难以预判。开放模型身上有太多未知——例如,对于它们在美国和中国以外国家的使用情况,我们并没有可靠的数据。ML 训练专业知识分布广泛,数十家组织、数千人距离能力前沿不到一年,因此开放模型跨越性能阈值、解锁新工作流只是时间问题,而非是否会发生的问题。集体应当采取的做法是:理解如何将这种广泛可获取的开放智能用于善途,同时主动降低潜在危害。
感谢 Florian Brand 和 Kevin Xu 为本文提供反馈和/或建议。想了解支撑本文的更多研究,请参阅开源 AI 阅读清单。