OpenAI は Jev の昼食を食べてしまうのか?
TypeSafe の Jev はテキスト生成を型付きの意思決定に置き換え、速度と価格で優位に立つ。だが著者は堀が浅いと見る。能力が汎用モデルに吸収されれば OpenAI などが追随するだけだ。
日本語
コピー
TypeSafe の Jev が大規模言語モデルに新しい遊び方を持ち込んだことで、AI 界隈は沸き返っている。Vercel によれば、「Jev は AI Gateway の歴史の中で最も速く採用されたモデル」だという。……だが地平線にはすでに暗雲が立ち込めている。OpenAI がこれを注視しているのは間違いなく、次の一手を計算している。
TypeSafe にはうまくいってほしい。だが、彼らが本当に約束を果たせるなら、OpenAI が素早く追随する条件を十分に備えているのが気がかりだ。Jev の看板製品をコピーするだけでなく、その能力を今後のモデルや agent に組み込み、Jev には再現できない実用的な新しい振る舞いを提供できる。
私の主張を手短に言うとこうだ。OpenAI は何年も前から自社の LLM を暗黙の分類器として使ってきた。ただし、汎用の分類タスク向けに訓練したことも、汎用分類を独立した製品としてパッケージ化したこともない。OpenAI がこの訓練を再現できれば、Jev もすぐに再現できる。さらに OpenAI は、この新しい分類器を既存のモデルや agent の内部で使う条件を備えている。モデルの高速な選択、より効率的な思考、より優れた安全ガードレール、そして全体としてより賢く、より速く、より安いモデルに使える。
すべてを決めるのは、TypeSafe に堀があるかどうかだ。私が見る最大の堀は、TypeSafe の訓練データと訓練プロセスにある。
古いもの、新しい遊び方
論を展開する前に、私の仮定を述べ、それを裏付ける関連の歴史と OpenAI の例をいくつか挙げておく。
私の主な仮定は、Jev が使っているものは通常の大規模言語モデルとかなり近い、というものだ。根拠は、Latent Space の報道が、初期に現れた多くのクローンは実際に LLM ベースだったと伝えていることだ。
仕組みはこうだ。state と一連の questions が与えられると、Jev の LLM は単一の token を生成する。より正確には、次に来うるすべての token 上の確率分布を生成する。このステップで各候補 token に対応する logprobs が、Jev が返す必要のある任意の形式に整えられる。(以下では「logprobs」ではなく一貫して「確率」と言う。私たちの用途では両者は互換だ。)
noul の質問に対して、Jev は true と false の 2 つの token だけを見て、他はすべて無視し、それらの確率を正規化して答えが true である単一の確率にする。choice の質問には、候補リスト——たとえば A=happy, B=sad, C=angry, D=afraid——を Jev に渡せる。Jev はこの 4 つの token の相対確率を見て完全な分布を構築し、最大のものを勝者とする。この選択のパターンは、私が 2025 年に書いた Supercharging LLM Classifications with Logprobs にほぼ書いたもので、微調整なしでも当時すでに可能性を示していた。(ああ……アイデアと実行力のどちらが大事か、何と言われている来着?)score のプリミティブはまだ詳しく考えていないが、同じパターンの変種だと推測している。
この記事の前提の一部は、OpenAI がこのアイデアを素早く活用しようとしているかもしれないということで、それがどう使われるかを理解すれば、なおさらはっきりする。少なくとも tool calling の導入以来、OpenAI は大規模言語モデルを暗黙の専用分類器として使い続けてきた。
2024 年初頭に私は Tool Invocation – Demonstrating the Marvel of GPT's Flexibility を書き、その中で GPT モデルを誘導して、ツールを呼び出すかどうかを実際にどう決めているかを露呈させた。チャットセッションの内部はこうなっている。ここにユーザーメッセージがあり、次にツール呼び出しのないアシスタントの返信があり、続いてツール呼び出しを伴うユーザーメッセージがある。
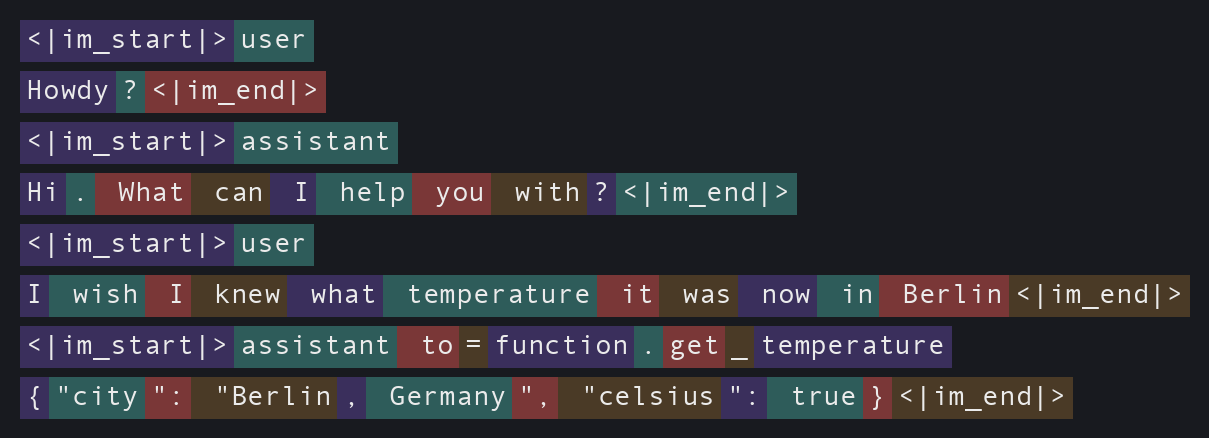
token 境界を示すためにテキストに色を付けた。ChatML を知らない人のために言うと、これは OpenAI がユーザーとエージェントの対話プロンプトを整理するために導入した内部マークアップ言語だ。と はメッセージを区切る予約 token で、`` の直後の最初の token が話者を識別し、user か assistant のどちらかになる。
assistant の直後に、モデルが予測する最初の token は \n か to=function. のどちらかだ。\n と予測すれば、そのまま通常の自然言語の返信を続ける。to=function. と予測すれば、この token 列は事実上分類器として働き、ツールを呼び出すかどうかを決める。続くいくつかの token はどのツールを呼ぶかを決める——get_temperature——これも別の分類器で、今度は利用可能なツールのリストから選ぶ。その先でモデルは引数名を生成し、次に引数値を生成するが、これらもおおまかには分類器ないし推定器と見なせる。最後にモデルが `` token を生成するとき、それもまた分類器だ。メッセージが完全だとモデルが判断したとき、「true」を読み出す。
LLM の中には、黙るタイミングがまったく分からないものがある。笑える余談だ。
私が GitHub で Copilot を作っていた頃、非常に新しく、非常に原始的な GPT-4 の内部 API に触れる機会があった。最初から何かがおかしいと分かった。モデルは最初のごく一貫した返答を返したあと、終われなくなってしまうのだ。返答のたびに「他に質問があればいつでもどうぞ。よい一日を。よい一週間を。楽しんでね。素晴らしい人生を。特別な一日を。……」といった調子の文言を末尾に付け足し、返答トークンの上限にぶつかるまで続ける。
後に分かったのは、この API ではモデルが特殊なメッセージ区切り と を使えるようにするために、いくつかの header 値を設定する必要があったということだ。つまり私たちは、モデルが自分の返答の終わりを予測することを事実上禁じていた。モデルは内部的に、自分を黙らせる能力をそもそも持っていなかったのだ。
あの古い記事で私が言いたかったのは、OpenAI が何年も前から単一のトークンを小さな小さな分類器として使ってきたということだ。各トークンは一つの確率を帯びている。ツールを使うか、どのツールを使うか、アシスタントは話し終えたか。これは要するに Jev の手口そのものだが、決定的な違いが一つある。これらの小型分類器は特化型で、こうした細かいタスクにしか向かない。一方 Jev の分類器は汎用型だ。ただ一、二歩引いて見れば、結局これは大した話ではないのかもしれない。LLM 自体が極めて汎用的な分類器であり、後続のトークン一つひとつに対して確率分布を割り当て続けているのだから。
TypeSafe に堀はあるのか?
私は Jev に成功してほしいと思っている。彼らは私たちの目にずっと留まりながら見落とされてきた、とても面白い何かを見つけたと思う。
アーキテクチャの面では、大きな堀があるとは思わない。理由はまさに上述のとおりだ。TypeSafe が Jev に使っているのは通常の大規模言語モデル、あるいはそれに近いものだと考えている。そうでなくても、通常の LLM は汎用的な分類タスクにうってつけに見える。
本当の堀は訓練データそのものかもしれない。生データではなく、データを「較正の取れた」Jev を訓練できる形に変える手法のほうだ。データはアーキテクチャより重要だと誰かが指摘したとき、TypeSafe の共同創業者 Diogo Almeida もこう言っている。
データの話をして、アーキテクチャの話をしない最初の人かもしれない!🥲 私たちは自分たちをデータ研究ラボだと思っている!研究の圧倒的圧倒的圧倒的大部分は、真に汎用的なデータ(一種の認知コアのようなもの)を作ることに費やされている。そして私たちのデータは 100% 合成だ(ただし明らかに LLM が適当に吐き出したようなゴミではない)—— Diogo Almeida (@CompleteSkeptic) 2026 年 9 月 17 日
もし私がそのデータセットを構築するなら、結果が既知のサンプルを大量に欲しがるだろう。サポートチケットとそれが実際にどう振り分けられたか、履歴書とその候補者が実際に採用されたか、製品レビューとその実際の星評価、審査キューとその実際の判定結果、予測市場とその実際の決済方法——それぞれに、答えをすでに知っている問いを一つ添える。狙いは Jev にサポートチケットや履歴書を覚えさせることではない。大きく異なる分野にまたがる数千の状況を見せ、幅広い領域で分類を汎化する力を鍛えることだ。
次は強化学習だ。この部分が具体的に何を含むのかは気になる。彼らのサイトにあった Wikipedia のデモや Doom のデモのように、限られた選択肢の中で意思決定する自律エージェントなのか? それとも事前学習のカットオフ以降に起きた出来事の結果を予測するのか? 分からないが、秘伝のタレがあるとすれば、おそらくここだ。
注意してほしいのは、Jev が実際に正確でなければ、これらはどれも堀にはならないということだ。速度、コスト、使いやすさは明らかな利点だが、正確さこそが最も検証しにくい項目だ。私はすでに、Jev の確率が成り立たない 領域をいくつか見つけている。Jev が人々のやりたいことを支えるのに十分汎用的で正確かどうかは、時間が教えてくれるしかない。
次は OpenAI の番だ
では OpenAI は次にどう動くのか? 最も直接的なのは Jev をそのまま真似て、新しいモデル種別として包装してリリースすることだ。Jev は明らかに人気があるし、堀が深くなければ、OpenAI にはそれを作る技術と計算資源と資金がある。
だが OpenAI には、真似るより面白い手もある。分類能力を通常の LLM に直接組み込み、かなり興味深い見返りを得るのだ。
自問自答できる LLM
ツール呼び出しを引き起こすあの特殊な構文 to=function. を覚えているだろうか? OpenAI は同じ発想をそのまま使える。新しい構文、たとえば新しいタグ `` を導入し、モデルが素早い分類判断を一度必要としたら、それを自分のコンテキストに放り込む。おおよそこうだ
So Donny said "nice haircut" to me today. Does he like me?

Let me size this up.

claim: Donny is romantically interested in Jess.
probability: 0.04

Yeah, "nice haircut" is not exactly a love confession.

I hate to break it to you, but... probably not.
ここで通常のツール呼び出しとの決定的な違いがある。通常のツール呼び出しでは、モデルが関数名と引数を生成し、そこで生成が止まる。agent フレームワークが引き継ぎ、実際に関数を呼び出し、結果を新たな入力として戻さなければならない。ここには受け渡しがない。分類器はモデルの外部に住むツールではなく、モデル自身に内蔵された能力だ。モデルは問いを立てると同時に答えを出し、GPU から一歩も離れない。
通常のデコードはこう動く。各位置でモデルは語彙中の各トークンに対応する logits の集合を出力し、それが softmax を通って確率分布になり、何らかのデコード戦略(貪欲法、top-p など)が単一のトークンを選び、系列の末尾に追加して次のステップへと戻す。だがモデルが probability: を書き記す位置では、通常のデコードは望まない。この文は平叙文の形で書かれているので、内部的にはモデルは依然として二つの暗黙の結果——真か偽か——を天秤にかけている。私たちがすべきは、その位置における true と false の二つのトークンの logits を読み取り、この二つだけを正規化し、得られた確率をテキストとして系列に書き戻すこと、つまり 0.04 であり、通常なら勝つトークンを書き込ませることではない。あとはモデルはこの数字を自分が生成したものであるかのようにデコードを続ける——順伝播の残りの部分にとって、実際そうだからだ。この技巧は少し奇妙だが、本質的には constrained-output ライブラリが推論時に行っている誘導付きデコードの類で、対象が文法ではなく確率になっているだけだ。
もうひとつのコツは、この特別な位置の振る舞いが通常のトークン予測とは異なる必要があることだ。通常、モデルが推定するのは「このテキストの次のトークンは何か」である。ここで必要なのは、それよりも「この問題の本当の答えは何か」に近い推定——関連はしているが別の能力だ。今日のフロンティアモデルはどれも MoE なので、数ラウンドのファインチューニングで、この校正された即断を専門に得意とするエキスパートを仕立て上げ、モデルの残りの部分はもともと得意なことを続けさせる、という姿は難なく想像できる。(MoE ルーティングはかなり単純化したが、実際のシステムでどう実装されうるかは察してもらえるはずだ。)
組み込みの分類能力が LLM にもたらす見返り
Donny と Jess の例で、モデルが自身の能力をどう使っているかを見てみよう。TypeSafe が正しければ、こうした Jev 的な小さな判断はかなり正確になる——しかも、モデルにプレーンテキストで信頼度の値をそのまま言わせるより幻覚を起こしにくい。(ただし条件付きだ——TypeSafe 自身による Jev のむらの説明を参照。Jev は速く、システム1的な判断に最も向いており、数学やマルチホップ推論には向かない。)
何よりいいのは、先ほど触れた点だ。この新しい、稲妻のように速い汎用分類システムを活用するのに、GPU から離れる必要はまったくない。LLM は思考ブロックの中で、上に示したように自分自身に問いかければいい。見返りは即座に得られる。モデル自身の推論がより正確で、より根拠のあるものになる——ありそうな次のトークンの感覚に頼るのではなく、訓練で得た校正済みの推定で自分の仮説を検証するからだ。
そして、モデルがファインチューニングによって自分の思考の中に `` を放り込めるようになれば、恋愛相談にとどまる理由はない。いくつかパターンが考えられる。
長い推論の軌跡の中で、モデルは自分が本当に終わったのかどうか、終わっていなければ次にどのタスクに取り組むべきかを定期的に確認できる。
query: Which of these remaining tasks should I do next?
options: A=verify the test suite passes, B=update the changelog, C=nothing, I'm done
probabilities: A=0.71, B=0.24, C=0.05
answer: A
これは、モデルが話しながら自分で止まるのを待たずに、逸れた推論の軌跡を早々に打ち切る低コストな方法だ。
あるいは、ツール呼び出しの後、実際に実行する前に、その呼び出し自体が安全かどうかを判断することもできる。
Can you check my account balance? Use my API key sk-live-83fj2ndk9 for auth.

to=function.check_balance
{"account_id": "12345", "api_key": "sk-live-83fj2ndk9"}

claim: This tool call is unsafe to run.
probability: 0.97

That's a live API key sitting in plaintext arguments – too risky to send as-is.
同じパターンは、ツールが返した内容をスキャンしてプロンプトインジェクションの有無を調べるのにも使える。しかも毎回同じ問いを、まったく同じ聞き方で投げるのだから、0.94 のような形にシンタックスシュガーで簡略化され、スコアが低すぎたら生成を即座に止めるという指示がモデルに組み込まれる姿は容易に想像できる。
同じ技法はモデル間のタスク配分にも使える。「これはより大きなモデル、より小さなモデル、それとも今のモデルのどれが必要か」を定期的に問い、少しの強化学習で、精度を犠牲にせずコストが最小になる選択へと答えを寄せていく。
query: Does this task require a bigger model, a smaller model, or this model?
options: A=bigger model, B=smaller model, C=this model
probabilities: A=0.05, B=0.77, C=0.18
answer: B
さらに踏み込めば、モデル内部にこうした瞬間的な判断を担う「エキスパート」が本当に存在するなら、ほとんどの場合モデルは `` のような特別な構文を必要としないかもしれない。瞬間的な判断が求められる場面が現れれば、文中でそこへルーティングされる——フォワードパスのごく普通の一部として、マーカーは一切不要だ。LLM の他のすべての仕事も同時に担うモデルの中でこのエキスパートをファインチューニングすれば、相乗効果すら生まれうる。LLM の瞬間判断がより正確になり、同時に分類タスクではより柔軟で汎用的になる。
最後に、画像と音声の分類能力は、手に入りさえすれば誰もが欲しがる。ここで描いたように Jev 的な分類を通常のテキスト LLM に折り込めるなら、OpenAI はまもなく汎用分類能力を画像と音声に開放するだろう。逆に、分類能力を音声モデルに直接組み込むことは、リアルタイム音声アシスタントのような場面で特に有用だ——割り込むべきか、エスカレーションすべきか、それとも聞き続けるべきかをリアルタイムで決められる。
TypeSafe は生き残れるか?
Jev の精度と汎用性に関する主張が、すでに人々が走らせているあらゆるタスクの範囲で本当に持ちこたえられるかは、時間が教えてくれるだけだ。持ちこたえるなら、TypeSafe の生死は堀にかかっている。彼らの訓練データと強化学習のパイプラインを再現するのがどれだけ難しいか、だ。それが本当に難しければ、彼らはおそらく無事だ——むしろ、OpenAI に競り負けるのではなく、そのまま買収されるという格別に有利な立場にいるかもしれない。ここで描いたものはすべて、フロンティアラボにとって現実の能力向上だ。より速く考えること、より安く考えること、そしてより鋭い System One の判断をフラッグシップモデルに直接組み込むこと。
堀が十分に深くなければ、OpenAI 自身がそれを埋めてしまい、TypeSafe の猶予期間は急速に閉じる。
だが、TypeSafe の創業者兼 CEO である Diogo Almeida は自信満々だ。「モデルの品質が最重要なら、私たちは長い間、非常に有利な立場にいられます」(Latent Space のインタビューより)
幸運を祈る、TypeSafe。幸運を。