OpenAI 会不会吃掉 Jev 的午餐?
TypeSafe 的 Jev 用类型化决策换掉文本生成,速度和价格都占优,但作者认为护城河不深:模型能力一旦被通用模型吸收,OpenAI 这类玩家随时可以跟进。
中文
复制
TypeSafe 的 Jev 给大语言模型带来了一种新玩法,整个 AI 圈都为之沸腾。据 Vercel 称,“Jev 是 AI Gateway 历史上采用速度最快的模型。”……但地平线上已经聚起了乌云。OpenAI 无疑正盯着这件事——并且在盘算下一步怎么走。
我希望 TypeSafe 一切顺利,但如果他们真能兑现承诺,我担心 OpenAI 完全有条件快速跟进——不仅能复制 Jev 的旗舰产品,还能把这种能力塞进即将推出的模型和 agent 里,提供一些 Jev 无力复现的实用新行为。
我的论点简述如下:OpenAI 多年来一直把自家 LLM 当作隐式分类器用,只是没针对通用分类任务训练过它们,也没把通用分类打包成独立产品。如果 OpenAI 能复现这套训练,那他们很快就能复现 Jev。更进一步,OpenAI 有条件把这个新分类器用在现有模型和 agent 内部,用于快速选模型、更高效地思考、更好的安全护栏,以及总体上更聪明、更快、更便宜的模型。
决定这一切的关键,是 TypeSafe 有没有护城河。我看到的最大护城河在 TypeSafe 的训练数据和训练流程上。
旧东西,新玩法
在展开论证之前,先说明我的假设,并用一些相关的历史和 OpenAI 的例子来支撑。
我的主要假设是:Jev 用的东西和常规大语言模型相当接近。证据是,Latent Space 报道称,早期出现的许多克隆确实都是基于 LLM 的。
思路是这样的。给定一个 state 和一组 questions,Jev 的 LLM 会生成单个 token——更准确地说,是生成所有可能的下一个 token 上的概率分布。这一步中每个可能 token 对应的 logprobs,随后会被整理成 Jev 需要返回的任意格式。(下文我一律说“概率”而不说“logprobs”——就我们的用途而言,两者可以互换。)
对于 noul 问题,Jev 只看两个 token,true 和 false,忽略其余一切,把它们的概率归一化成答案为 true 的单一概率。对于 choice 问题,可以给 Jev 一个候选列表——比如 A=happy, B=sad, C=angry, D=afraid——它查看这四个 token 的相对概率,构建出完整分布,取最高者作为胜出项。这种选择模式基本就是我 2025 年那篇 Supercharging LLM Classifications with Logprobs 里写的东西,而且即便不做微调,它当时就已经显出潜力。(唉……关于想法和执行力的重要性,人们是怎么说的来着?)score 原语我还没仔细想过,但我猜它是同一模式的变体。
这篇文章的部分前提是,OpenAI 可能正准备迅速利用这个思路,而如果你明白它会怎么利用,这一点就更清楚了。至少从引入 tool calling 开始,OpenAI 就一直在把大语言模型隐式地当作专用分类器使用。
2024 年初我写过 Tool Invocation – Demonstrating the Marvel of GPT's Flexibility,在里面诱导一个 GPT 模型暴露出它究竟是如何决定调用工具的。下面是一次聊天会话在内部的样子。这里有一条用户消息,然后是一条不带工具调用的助手回复,接着是一条带工具调用的用户消息:
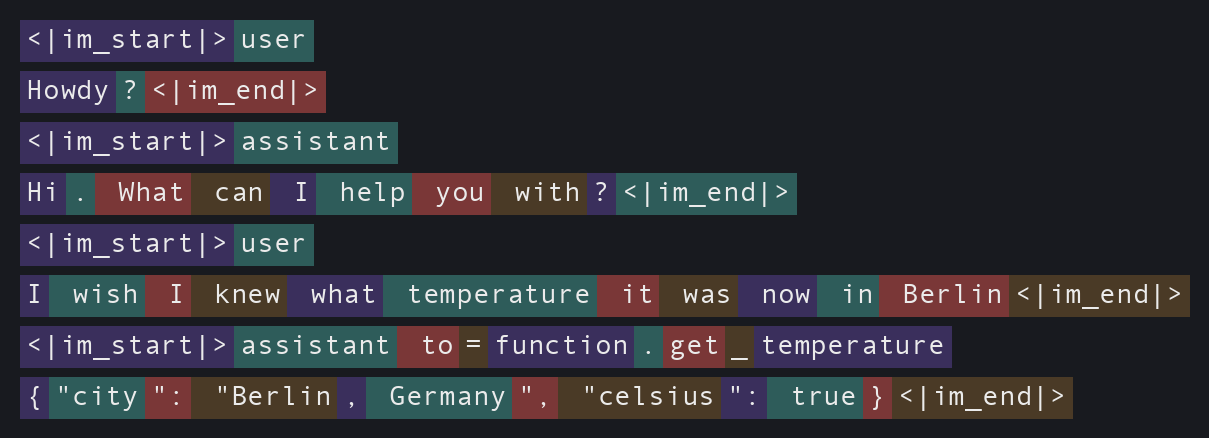
我给文本上了色,用来标示 token 边界。如果你没见过 ChatML,它是 OpenAI 为组织用户—代理对话提示词而引入的内部标记语言。和 是用于分隔消息的保留 token,而 `` 之后的第一个 token 标识说话者,要么是 user,要么是 assistant。
紧跟在 assistant 之后,模型预测的第一个 token 要么是 \n,要么是 to=function.。如果预测的是 \n,它就会继续给出正常的自然语言回复;如果预测的是 to=function.,那么这一串 token 实际上就充当了一个分类器,决定到底要不要调用工具。接下来的几个 token 用来确定调用哪个工具——get_temperature——这是另一个分类器,这次是从可用工具列表中挑选。再往后,模型生成参数名,然后是参数值,这些也可以勉强看作分类器或估计器。最后,当模型生成 `` token 时,那同样是一个分类器:当模型认为消息已经完整时,它读出“true”。
有些 LLM 就是不知道该什么时候闭嘴——一段好笑的题外话。
当年我在 GitHub 做 Copilot 的时候,有机会接触到一个非常新、非常原始的 GPT-4 内部 API。一上来我们就知道哪里不对劲:模型在给出最初一段非常连贯的回复之后,就收不了尾了。它会在每条回复末尾接上类似“如果还有其他问题,尽管问我。祝你今天愉快。祝你一周顺利。祝你玩得开心。祝你生活美好。祝你度过特别的一天。……”这样的话,一直说下去,直到撞上回复 token 上限。
后来发现,这个 API 要求我们设置一些 header 值,模型才能使用那些特殊的消息分隔符 和。实际上,我们等于禁止了模型预测自己回复的结束——它从内部根本没有能力让自己闭嘴!
我在那篇旧文里想说的是,OpenAI 多年来一直在把单个 token 当作小小的微型分类器来用。每个 token 都带着一个概率:要不要用工具、该用哪个工具、助手说完了没有。这其实就是 Jev 的全部把戏,只不过有一点很关键:这些微型分类器是专才,只适合这些细碎任务,而 Jev 的分类器是通才。但往回退一两步看,你会发现这也许终究只是件小事,因为 LLM 本身就是一个极其通用的分类器,它在为每一个后续 token 不断分配概率分布。
TypeSafe 有护城河吗?
我其实希望 Jev 能成。我觉得他们发现了某种一直藏在我们眼皮底下、非常有意思的东西。
从架构上看,我不认为存在多大的护城河,原因正是上面说的那些。我认为 TypeSafe 给 Jev 用的是常规的大语言模型,或者与之接近的东西。即便不是,常规 LLM 看起来也很适合做通用分类任务。
也许真正的护城河在训练数据本身。不是原始数据,而是把数据变成能训练出「校准良好的」Jev 的那套方法。有人提出数据比架构更重要时,TypeSafe 联合创始人 Diogo Almeida 也是这么说的:
你可能是第一个谈数据而不是架构的人!🥲 我们把自己看作一家数据研究实验室!绝大多数绝大多数绝大多数的研究都花在制造真正通用的数据上(类似一个认知核心),而且我们的数据 100% 是合成的(但显然不是 LLM 随口吐出来的那种垃圾)—— Diogo Almeida (@CompleteSkeptic) 2026 年 9 月 17 日
如果让我来构建那个数据集,我会想要一大堆结果已知的样本——支持工单以及它们实际是怎么被分流的,简历以及那位候选人实际有没有被录用,产品评论以及它们实际的星级评分,审核队列以及它们实际的判定结果,预测市场以及它们实际的结算方式——每一个都配上一个我已经知道真实答案的问题。重点不是教 Jev 认识支持工单或简历。而是让它见识横跨差异极大的各个领域的数千种情境,练出跨广泛领域做分类泛化的能力。
然后是强化学习。我很好奇这部分具体包含什么。是自主智能体在有限选项下做决策,就像他们网站上搭的 Wikipedia demo 或 Doom demo 那样?还是预测预训练截止时间之后发生的事件的结果?我不知道,但如果有什么秘方,那大概就在这里。
注意,除非 Jev 确实准确,否则这一切都算不上护城河。速度、成本、易用性都是显而易见的优势,但准确性恰恰是最难验证的那一项。我已经发现有些领域里 Jev 的概率站不住脚。Jev 是否足够通用、足够准确,能撑起人们想用它做的那些事,只能交给时间。
接下来轮到 OpenAI 出牌了
那 OpenAI 下一步会怎么走?最直接的做法就是把 Jev 照搬过来,包装成一种新的模型类型发布。Jev 显然很受欢迎,如果护城河不深,OpenAI 有技术、有算力、有资金把它做出来。
但 OpenAI 还能做一件比照搬更有意思的事:把分类能力直接塞进常规 LLM 里,收获一些相当有趣的回报。
一个能自问自答的 LLM
还记得那个触发工具调用的特殊语法 to=function. 吗?OpenAI 可以照搬同样的思路:引入新语法,比如一个新标签 ``,模型只要需要一次快速的分类判断,就把它丢进自己的上下文。大概长这样
So Donny said "nice haircut" to me today. Does he like me?

Let me size this up.

claim: Donny is romantically interested in Jess.
probability: 0.04

Yeah, "nice haircut" is not exactly a love confession.

I hate to break it to you, but... probably not.
这里和普通工具调用有一个关键区别。普通工具调用中,模型生成函数名和参数,然后生成就停了——必须由 agent 框架接手,真正调用那个函数,再把结果作为新一轮输入喂回去。而这里没有交接。分类器不是活在模型外部的工具,而是内建在模型自身里的能力。模型提出问题的同时就给出了答案,全程不离开 GPU。
常规解码是这样运作的:在每个位置,模型产出一组 logits,词表中每个 token 对应一个;这些 logits 经 softmax 变成概率分布;然后某种解码策略(贪心、top-p 之类)挑出单个 token,追加到序列末尾,再喂回去进行下一步。但在模型写下 probability: 的那个位置,我们要的不是常规解码。这句话是以陈述句形式写出来的,所以底层上模型其实仍在权衡两个隐含结果——真或假。我们要做的是读取该位置上 true 和 false 两个 token 的 logits,只对这两个做归一化,把得到的概率以文本形式写回序列,即 0.04,而不是让通常胜出的那个 token 写进去。之后模型继续解码,就像这个数字是它自己生成的一样——因为对前向传播的其余部分来说,它确实就是。这个技巧有点怪,但本质上就是 constrained-output 库在推理时已经在做的那类引导式解码,只不过作用对象是概率而不是语法。
另一个诀窍是,这个特殊位置的行为必须不同于普通的 token 预测。通常情况下,模型估计的是“这段文本里下一个 token 是什么”。而在这里,我们需要它估计的更接近“这个问题的真实答案是什么”——这是一项相关但不同的能力。如今每个前沿模型都是混合专家,所以不难想象,几轮微调就能雕琢出一个专门擅长这种校准过的快速判断的专家,而模型的其余部分继续做它本来就擅长的事。(我把 MoE 路由大大简化了,但我猜你能看出这在真实系统里可能怎么落地。)
内置分类能力给 LLM 带来的回报
看看模型在 Donny 和 Jess 那个例子里是怎么运用自身的。如果 TypeSafe 是对的,这些 Jev 式的小判断会相当准确——而且比直接让模型用纯文本说出一个置信度值更不容易产生幻觉。(有前提——参见 TypeSafe 自己给出的 Jev 参差不齐之处的说明。Jev 最适合快速、系统一的判断,不适用于数学或多跳推理。)
最妙的地方在于前面提到的那一点:要利用这套全新的、快如闪电的通用分类系统,我们完全不必离开 GPU。LLM 完全可以就在思考块里问自己,如上所示。回报是即时的:模型自身的推理变得更准确、更有依据,因为它在用训练得来的校准估计来检验自己的假设,而不是靠可能的下一个 token 的感觉。
而且,一旦模型经过微调,能在自己的思考中丢进一个 ``,就没有理由只停留在恋爱建议上。还有几种模式可以想到:
在漫长的推理轨迹中,模型可以定期检查自己是不是真的做完了,如果没做完,接下来该处理哪个任务:
query: Which of these remaining tasks should I do next?
options: A=verify the test suite passes, B=update the changelog, C=nothing, I'm done
probabilities: A=0.71, B=0.24, C=0.05
answer: A
这是一种低成本的方式,可以及时掐断一条跑偏的推理轨迹,而不必等模型自己说着说着才停下来。
又或者,模型可以在工具调用之后、实际执行之前,先判断这次调用本身是否安全:
Can you check my account balance? Use my API key sk-live-83fj2ndk9 for auth.

to=function.check_balance
{"account_id": "12345", "api_key": "sk-live-83fj2ndk9"}

claim: This tool call is unsafe to run.
probability: 0.97

That's a live API key sitting in plaintext arguments – too risky to send as-is.
同样的模式也适用于扫描工具返回的内容,检查是否存在提示注入。而且因为每次问的都是同一个问题、问法也完全一样,很容易想象它会被语法糖简化成类似 0.94 的形式,并在模型里内置一条指令:一旦分数过低就直接停止生成。
同样的技巧还可以用来在模型之间分配任务:定期询问“这件事需要更大的模型、更小的模型,还是当前这个模型?”,再让一点强化学习把答案推向成本最低、又不牺牲准确率的那个选择。
query: Does this task require a bigger model, a smaller model, or this model?
options: A=bigger model, B=smaller model, C=this model
probabilities: A=0.05, B=0.77, C=0.18
answer: B
更进一步,如果模型内部真的存在一个专门负责这类瞬间判断的“专家”,那大多数时候模型可能根本不需要 `` 这种特殊语法。只要出现需要瞬间判断的场合,它就可以在句子中间被路由过去,作为前向传播中再正常不过的一环——不需要任何标记。在一个同时承担 LLM 其他全部工作的模型里微调这个专家,甚至可能产生协同效应:让 LLM 的瞬间判断更准,同时在分类任务上更灵活、更通用。
最后,图像和语音的分类能力,只要一能拿到,所有人都会想要。如果 Jev 式的分类能像我这里勾勒的那样,被折叠进一个常规的文本 LLM,那么很快 OpenAI 就会把通用分类能力开放给图像和语音。反过来,把分类能力直接做进语音模型,对实时语音助手这类场景尤其有用——它可以实时决定是该打断、该升级处理,还是继续听下去。
TypeSafe 能活下来吗?
Jev 关于准确率和通用性的说法,能否在人们已经在拿它跑的全部任务范围内真正站得住,只能交给时间。如果站得住,TypeSafe 的生死就取决于护城河:复刻他们的训练数据和强化学习流程到底有多难。如果确实很难,他们大概率没事——甚至可能处在一个格外有利的位置,被 OpenAI 直接收购,而不是被它竞争掉。我上面勾勒的这一切,对一家前沿实验室来说都是实打实的能力升级:思考更快、思考更便宜,以及把更敏锐的 System One 判断直接做进旗舰模型。
如果护城河不够深,OpenAI 自己就会把它填平,TypeSafe 的窗口期将迅速关闭。
不过,TypeSafe 创始人兼 CEO Diogo Almeida 信心十足:“如果模型质量至关重要,那我们将在很长一段时间里处于非常有利的位置。”(出自他接受 Latent Space 的采访)
祝你好运,TypeSafe。祝你好运。