1つのGPU上でクエリプランナーと推論エンジンを組み合わせることで毎分10億トークンを達成
ModalとCMUのチームは、クエリプランナーと推論エンジンを同じGPU上に統合し、AI-SQLを毎分10億トークンで実行できるようにした。記事では、既製の推論エンジンがこの種のワークロードでなぜ計算資源を無駄にするのかを解説している。
日本語
コピー
これは LLM のパレート最適曲線上の一点であり、大量の潜在需要を可視化する領域——思考なし、単一トークン、許容できる知能での低レイテンシ——に位置していると私は考えている。そしてこの領域は、誰もがより高い知能を追い求めているために投資が不足している。
誰もが coding agent やチャットボットを大々的に手がけている一方で、バックエンドでは推論革命が静かに起きている。コスト性能比が十分に良ければ、単純な LLM データ変換が驚くべき効果を生む——SNS を眺めれば、TypeSafe AI の Jev モデルによる、目を見張るような、ハッカー精神を刺激するデモが見られる。Jev はこうした変換をいわゆる「JSON レイヤー」で実装する。つまりクライアントとサービスの間にある Web 的なインターフェースだ。AI-SQL は分析用 SQL レイヤー、すなわちビジネスインテリジェンスとデータベースの間のインターフェースで実装する:
-- get hot leads with AI™
SELECT customers.id, products.id
FROM customers JOIN products ON -- for each row in both tables
AI.IF( -- run the prompt below and filter by truthiness
 PROMPT("{customers.profile} might buy this: {products.description}")
)
推論アプリケーションが異なれば推論負荷も異なり、AI-SQL も例外ではない。上のようなクエリは数百万件、それぞれ数千トークンのシーケンスを生成しうる——トークン予算が悲鳴を上げる。こうしたクエリに必要な知能はフロンティア水準よりはるかに低いことが多く、小型のオープンウェイトモデルで難なくこなせる。だが、こうしたシーケンスを agentic 推論向けに最適化された推論エンジンに素朴に渡し、任意のユーザーリクエスト向けのインターフェース経由で届けようとすると、効率は驚くほど悪くなる。しかもこれは構造的な問題だ。
そこで私たちはこれを解決する推論エンジンを作った:QUery-Aware Inference Layer(Quail)。planning が特に重要なマルチテーブル join クエリにおいて、Quail は単一の H100 GPU で毎分10億トークン超(TPM/GPU)を処理し、同じハードウェア上の vLLM ベースラインより10倍以上速い。Modal 上では、10億トークンあたり6セントを切る計算になる。
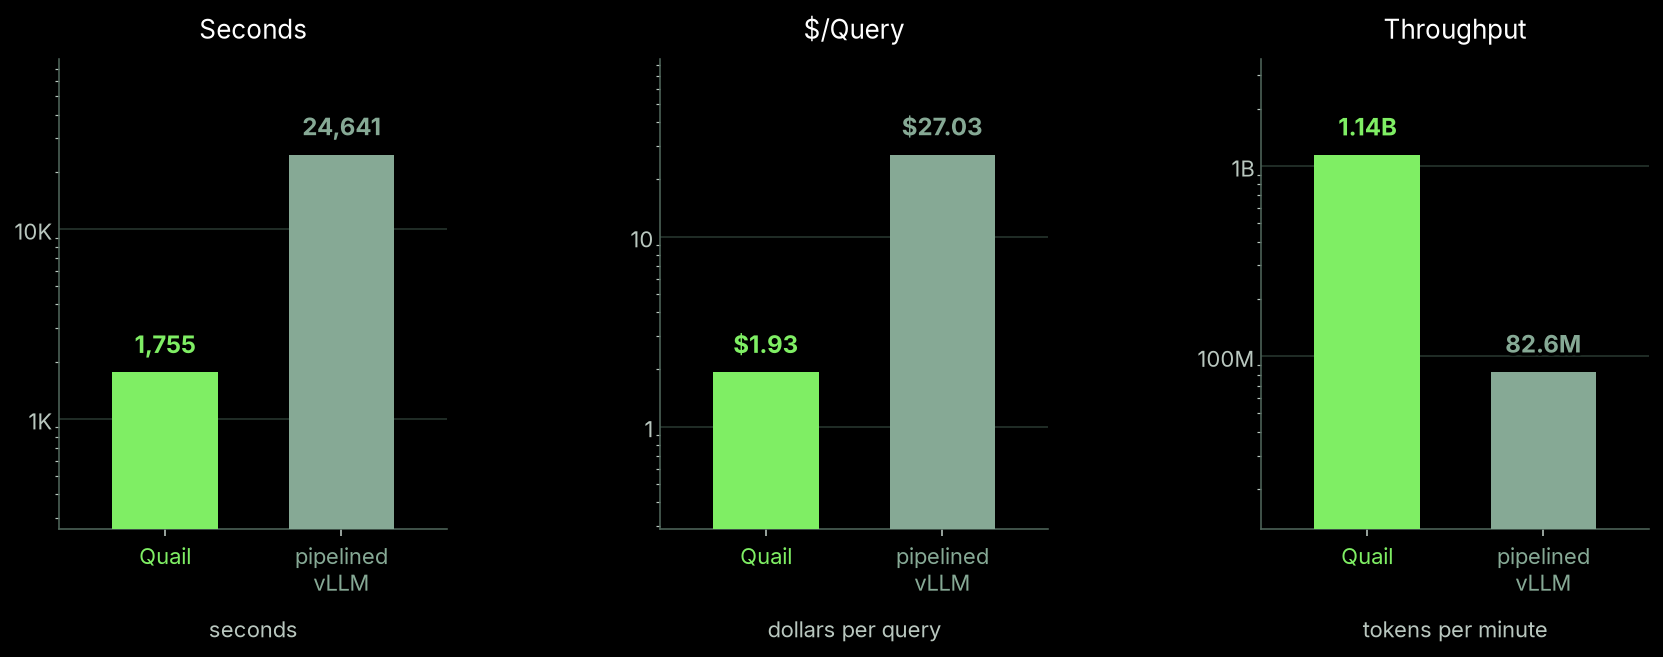
新たに公開した AI-SQL クエリベンチマークでは、Quail は vLLM より1.84倍速い(タスクの幾何平均)。このベンチマークには、AI-SQL 推論が今後どこまで改善できるかを示すために私たちが意図的に設計した2つのクエリも含まれている。
Modal 上で今すぐ試せる:
# uvx modal run try_quail.py

import modal

app = modal.App("try-quail")
image = (
 modal.Image.from_registry("nvidia/cuda:13.0.1-devel-ubuntu24.04", add_python="3.12")
 .entrypoint([])
 .apt_install("git")
 .uv_pip_install("quail-engine==0.1.0")
)

@app.function(gpu="H100!", image=image, timeout=600)
def run(sql=None, documents=None):
 from datasets import load_dataset
 import pyarrow as pa
 import quail

 if sql is None:
 sql = """ // no spoilers!
 SELECT r.id
 FROM reviews r
 WHERE AI_FILTER(PROMPT('Does this review discuss the ending?\n\n{0}', r.review))
 """

 if documents is None:
 imdb = load_dataset("stanfordnlp/imdb")["train"]

 documents = pa.table(
 {
 "id": pa.array(f"review-{i}" for i in range(len(imdb))),
 "review": imdb.data.table.column("text"),
 }
 )

 config = quail.EngineConfig(
 gpus=1,
 model="qwen3-4b-fp8",
 backend="quail",
 device="h100-sxm",
 )

 with quail.Session(config) as session:
 session.register(
 "reviews",
 quail.DocumentProvider.from_table(documents, id_col="id"),
 )
 result = session.sql(sql).run()

 print(result.collect())
 print(result.report)
このブログでは、私たちが解こうとしている問題と、Quail の現在の仕組みを簡単に紹介する。ネタバレすると、最大の収穫は、構造化されたクエリを手に入れた時点でリクエストを並べ替えられ、KV をよりうまくキャッシュ(および破棄)できることにある。これには Hydragen 的なカスケードアテンションへの少しの修正が必要だ。小型モデル向けの大量の小さなリクエストは、高いホストオーバーヘッド、つまりGPU 利用率の低下も招くが、リクエストの構造を事前に知っていれば、このオーバーヘッドは避けられる。
これは Modal の推論研究者と、カーネギーメロン大学 Full Stack Data Lab のデータベース研究者の協業の成果だ——いわば「専門家の混合(Mixture of Experts)」と呼べるだろう。私たちが行った仕事を公開するのは、これをより「専門家並列(Expert Parallel)」にしたいからだ。推論とデータベースの交差点におけるオープンソースの性能エンジニアリングは、まだ始まったばかりだと信じている——そしてこの2つは、計算の最も重要な応用分野の一つだ。
本記事は推論エンジニアが考慮すべき点に重点を置いている。データベースエンジニアの視点からさらに知りたい場合は、Full Stack Data Lab のブログを参照してほしい。Quail のコードはこちら、ドキュメントはこちら。AI-SQL クエリを大規模に運用していて、性能向上とコスト削減に関心があれば、ぜひ連絡してほしい。
AI Functions と AI-SQL とは何か
まず、このワークロードの背景を少し補足する。
ここで言っているのは、絶対に、AI システムが自然言語入力から SQL を生成することではない——それは NL2SQL だ。そのワークロードは従来のチャットボットやコーディング agent によく似ており、既存の推論エンジンで十分に扱える。
実際は逆だ! AI-SQL では、SQL の拡張を使って AI システム向けの prompt をプログラム的に生成(および消費)する。prompt はデータベースのエントリから構築され、出力はテーブルになる。
-- get hot leads with AI™
SELECT customers.id, products.id
FROM customers JOIN products ON -- for each row in both tables
AI.IF( -- run the prompt below and filter by truthiness
 PROMPT("{customers.profile} might buy this: {products.description}")
)
AI-SQL は主にビジネスインテリジェンス(BI)プラットフォーム内部で使われ、データサイエンティストや関係者が、ドキュメントや自由記述フィールドのような半構造化データに対して、より「曖昧な」問いを立てるのを助ける。
現時点で統一標準はないが、主要なマネージド分析データベースプラットフォームはそれぞれ独自のやり方を持っている:Snowflake Cortex AI-SQL、Databricks AI Functions、BigQuery AI functions。
SQL の他の部分と違い、この問題は本当に GPU を必要とする。
BioDEX データセットに対する以下のクエリプランを見てほしい。これは、神経成分と心血管成分の両方を含む薬剤による重篤な有害事象報告を絞り込むものだ:
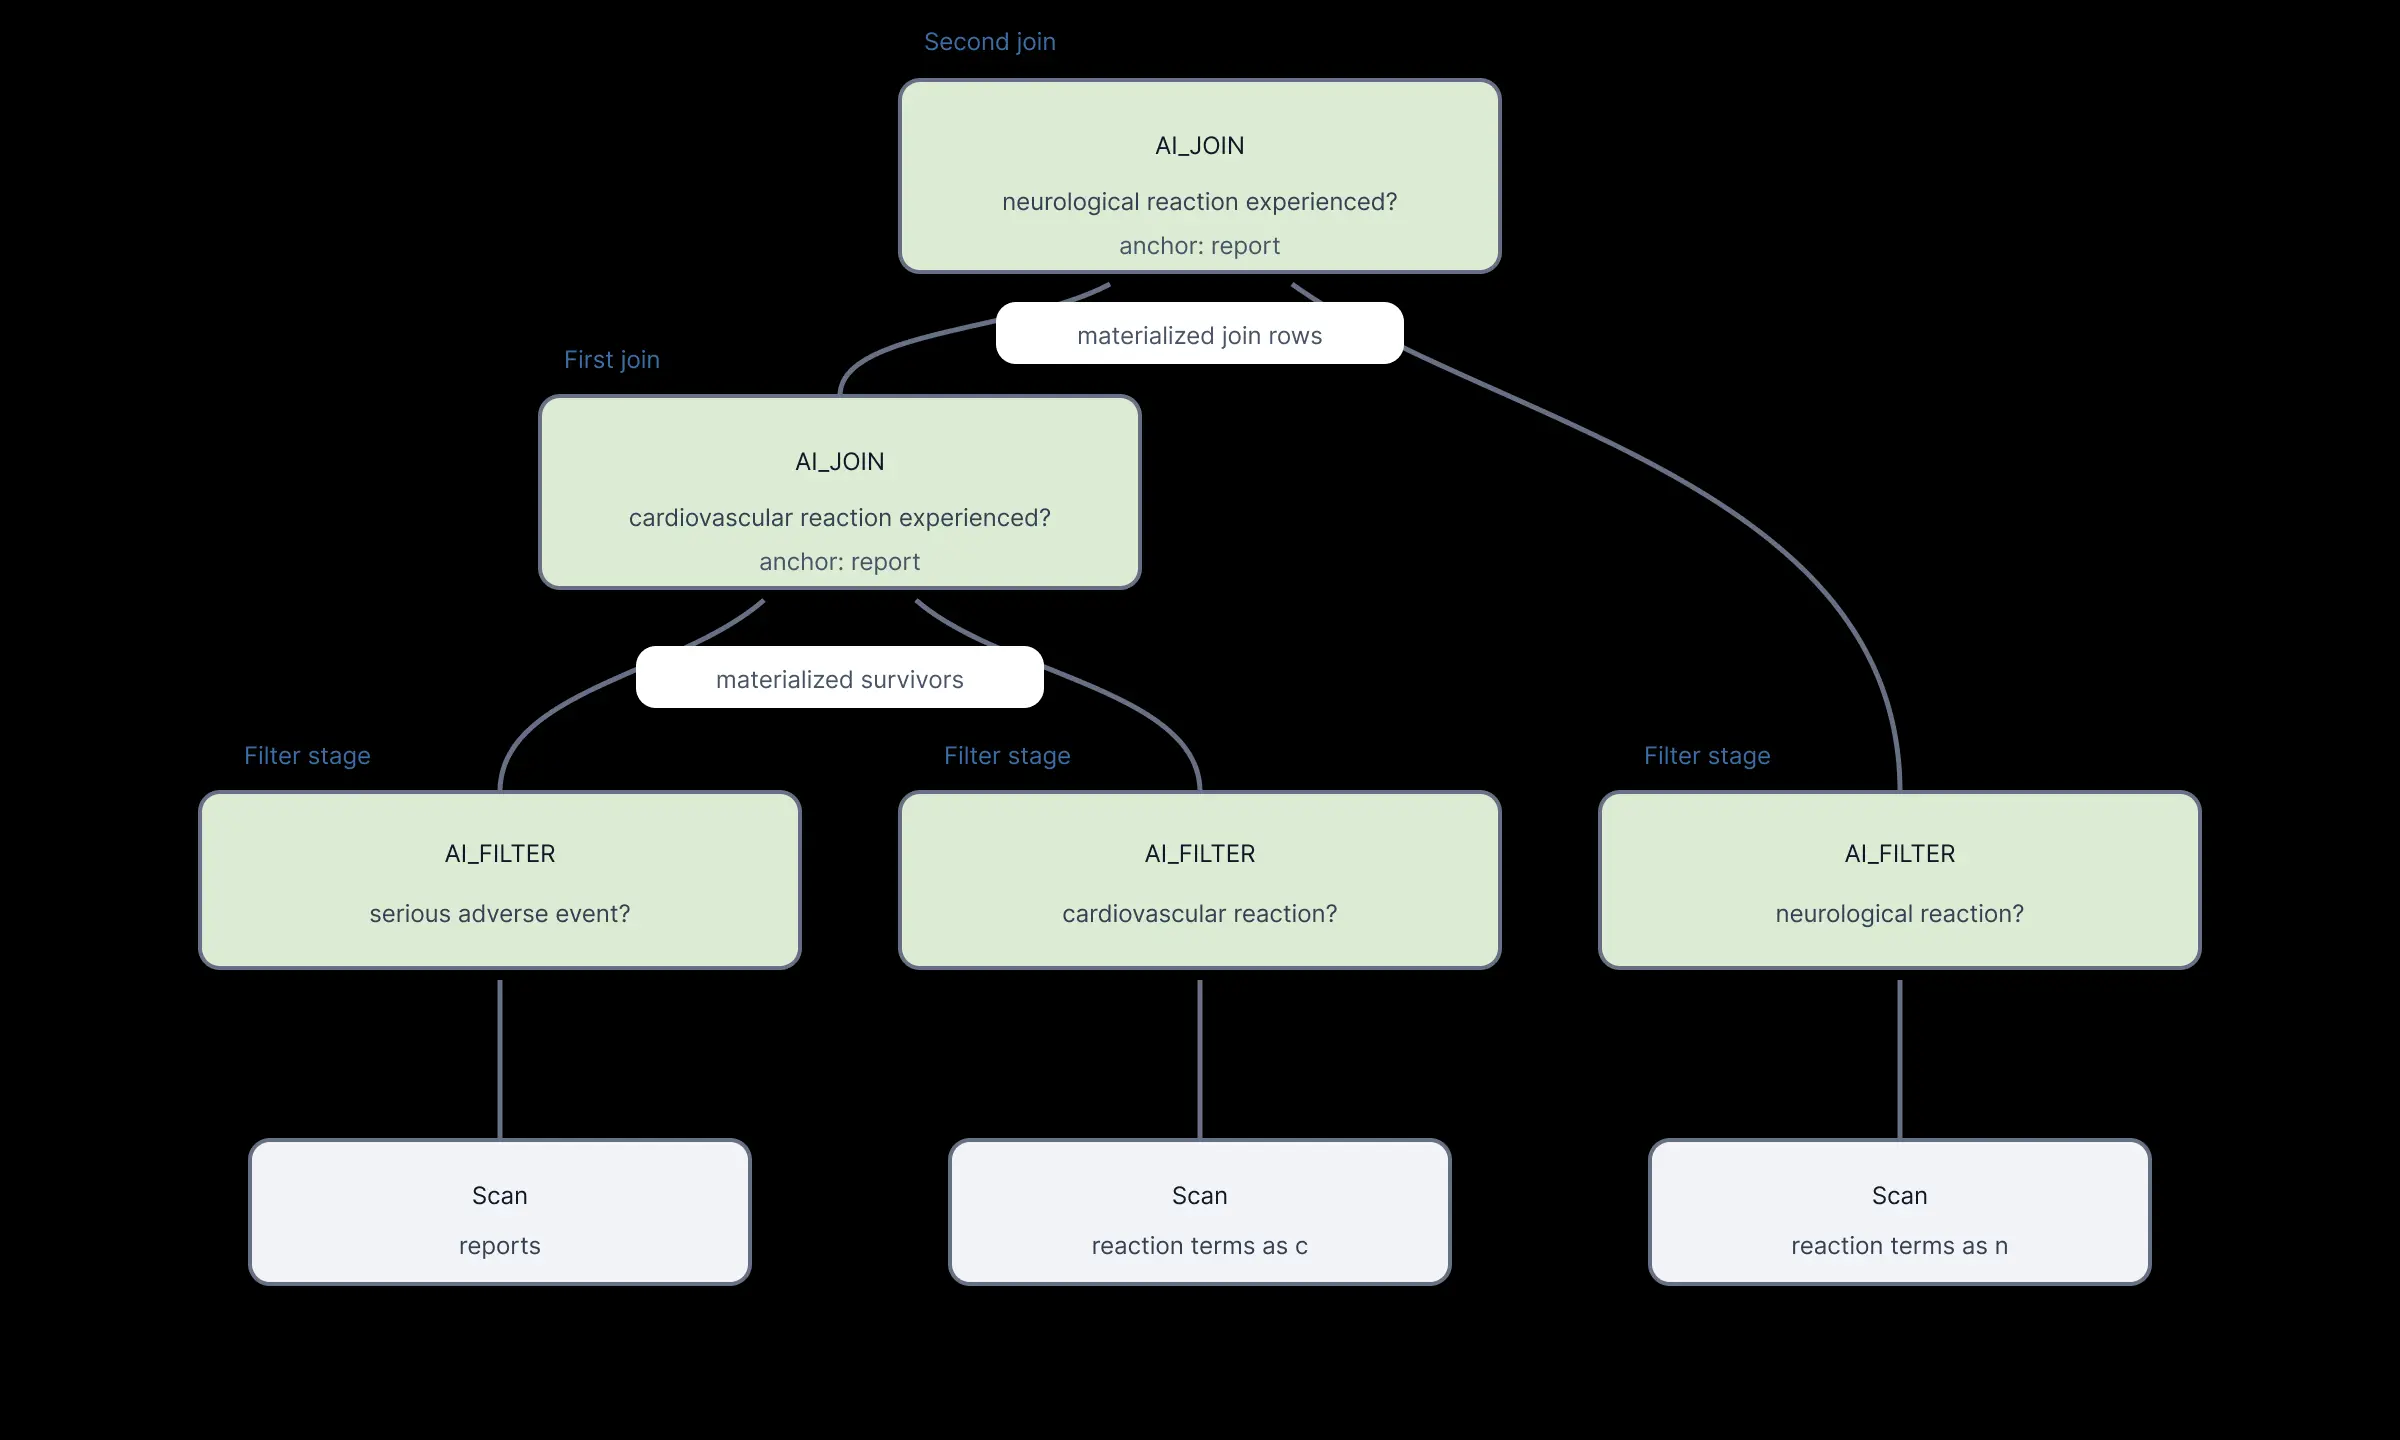
これが単なる普通のフィルタや結合、たとえば文字列マッチングや論理同値に基づくものなら、GPU のような高スループットの数値アクセラレータを持ち出す理由はない。分析クエリではあるし、見た目は確かに「スループットを食いそう」だが。何人かには自明かもしれないが、それでも論理をたどっておこう。
永続ストレージからメモリへ(あるいはメモリからレジスタへ)ロードされる各バイトは、比較を終えるのにせいぜい少数の算術・論理演算しか必要としない。GPU は演算強度の高いワークロード向けに設計されている——1 バイトのロードに対して大量の演算をこなすものだ。そして最新 GPU の演算帯域の大半は、大規模行列積に使われる専用ハードウェア、すなわち Tensor Cores に集中している。普通のフィルタや結合に大規模行列積は要らない。
ところがこのクエリプランは AI_FILTER と AI_JOIN を使い、入力を大規模言語モデルへ流し込む。LLM は数値演算の連なりであり、そのボトルネックこそ大規模行列積だ。永続ストレージからロードされた各バイトは、ストレージへ書き戻される前に数十億回の演算を経ることになる。
なぜ推論エンジニアがこれを気にするのか?
今日の推論エンジニアリングの大半は、ある特定のワークロード形状に集中している。ユーザーと推論サービスの外部にあるツール呼び出しが、反復的に長い入力シーケンスを組み立てていく形だ。チャットボットや agent のワークロードがこれにあたる。強化学習でモデルをチャットボットや agent に微調整するとき、訓練中の「rollout」推論も同じ形をとる。
誤解しないでほしい。これは極めて重要な仕事だ! 我々のやり方はこちらに書いた。だが硬派な推論エンジニアからすると、正直に言って、そろそろ……やり尽くされた感が出てきた。
もうひとつ、超低レイテンシ推論という仕事がある。速度と知能が同じくらい重要になる領域だ。関連技術はこちらに書いた。こうしたワークロードはたいてい構造化出力/ツール呼び出しを使い、突き詰めれば推論版の「OLTP」といった趣で、オープンエンドな agent よりも他のコンピュータアプリケーションに組み込みやすい。Jev が最近話題になったことは、この種のワークロードの重要性を示している——そして我々がまだどれほど初期段階にいるかも。
AI-SQL ワークロードはまだそれほど注目されていない——現時点では——が、アプリケーションにとっての重要性はさておき、推論エンジニアにとって本質的に興味深いものでもあると我々は考えている。理由はいくつか根本的なものだ。最も目を引くのは、transformer とまさに天作の相性だという点(「完璧な」KV cache 利用を実現できるから)、そして GPU 上の transformer にとってもそうだという点(decode が不要だから)。
後悔のない KV cache 運用を。
典型的な推論では、リクエストはクライアントが制御し、しかも任意勝手だ。これが際限のない厄介事を生む。だが AI-SQL 推論では、クライアントが制御できるのは SQL クエリだけで、1 つのクエリが大量のリクエストを生成する。統合されたクエリプランナ/推論エンジンは、それらのリクエストの扱いをかなり自由に制御できる。
おかげで、より多くの仕事を薄く広くならせる cache の運用が格段に楽になる。たとえば、ある cache エントリがいつ不要になるか正確に分かるので、ためらいなく追い出せる。cache 需要がどんな形になるかもかなり見通せる。最初からクエリプラン全体に対応するリクエストを全部手に入れられるからだ。
そして Transformer のキャッシュは切実に必要だ。その順伝播はシーケンス長に対して素朴に二次の計算量を持つ。KV cache があれば、これを線形時間・線形ストレージに置き換えられる。
agent ワークロードでは、2 回のアクセスの間隔がまったく読めないため KV cache の運用は難しい。だが AI-SQL クエリなら、推論エンジンのリクエストを我々が制御しているので、将来のアクセスを予測し、プリフェッチのような最適化を効かせられる。さらに、我々が重視するのは token スループットなので、KV エントリを取り出すレイテンシはそれほど気にならない。これにより、多段 KV cache のような仕組みの運用がはるかに現実的になる。
見て、ママ、decode なしだよ!
シーケンスモデルの推論は 2 つの段階に分かれる。「prefill」(プリフィル)では KV cache の大半が生成され、「decode」(デコード)段階では出力 token の大半が生成される。
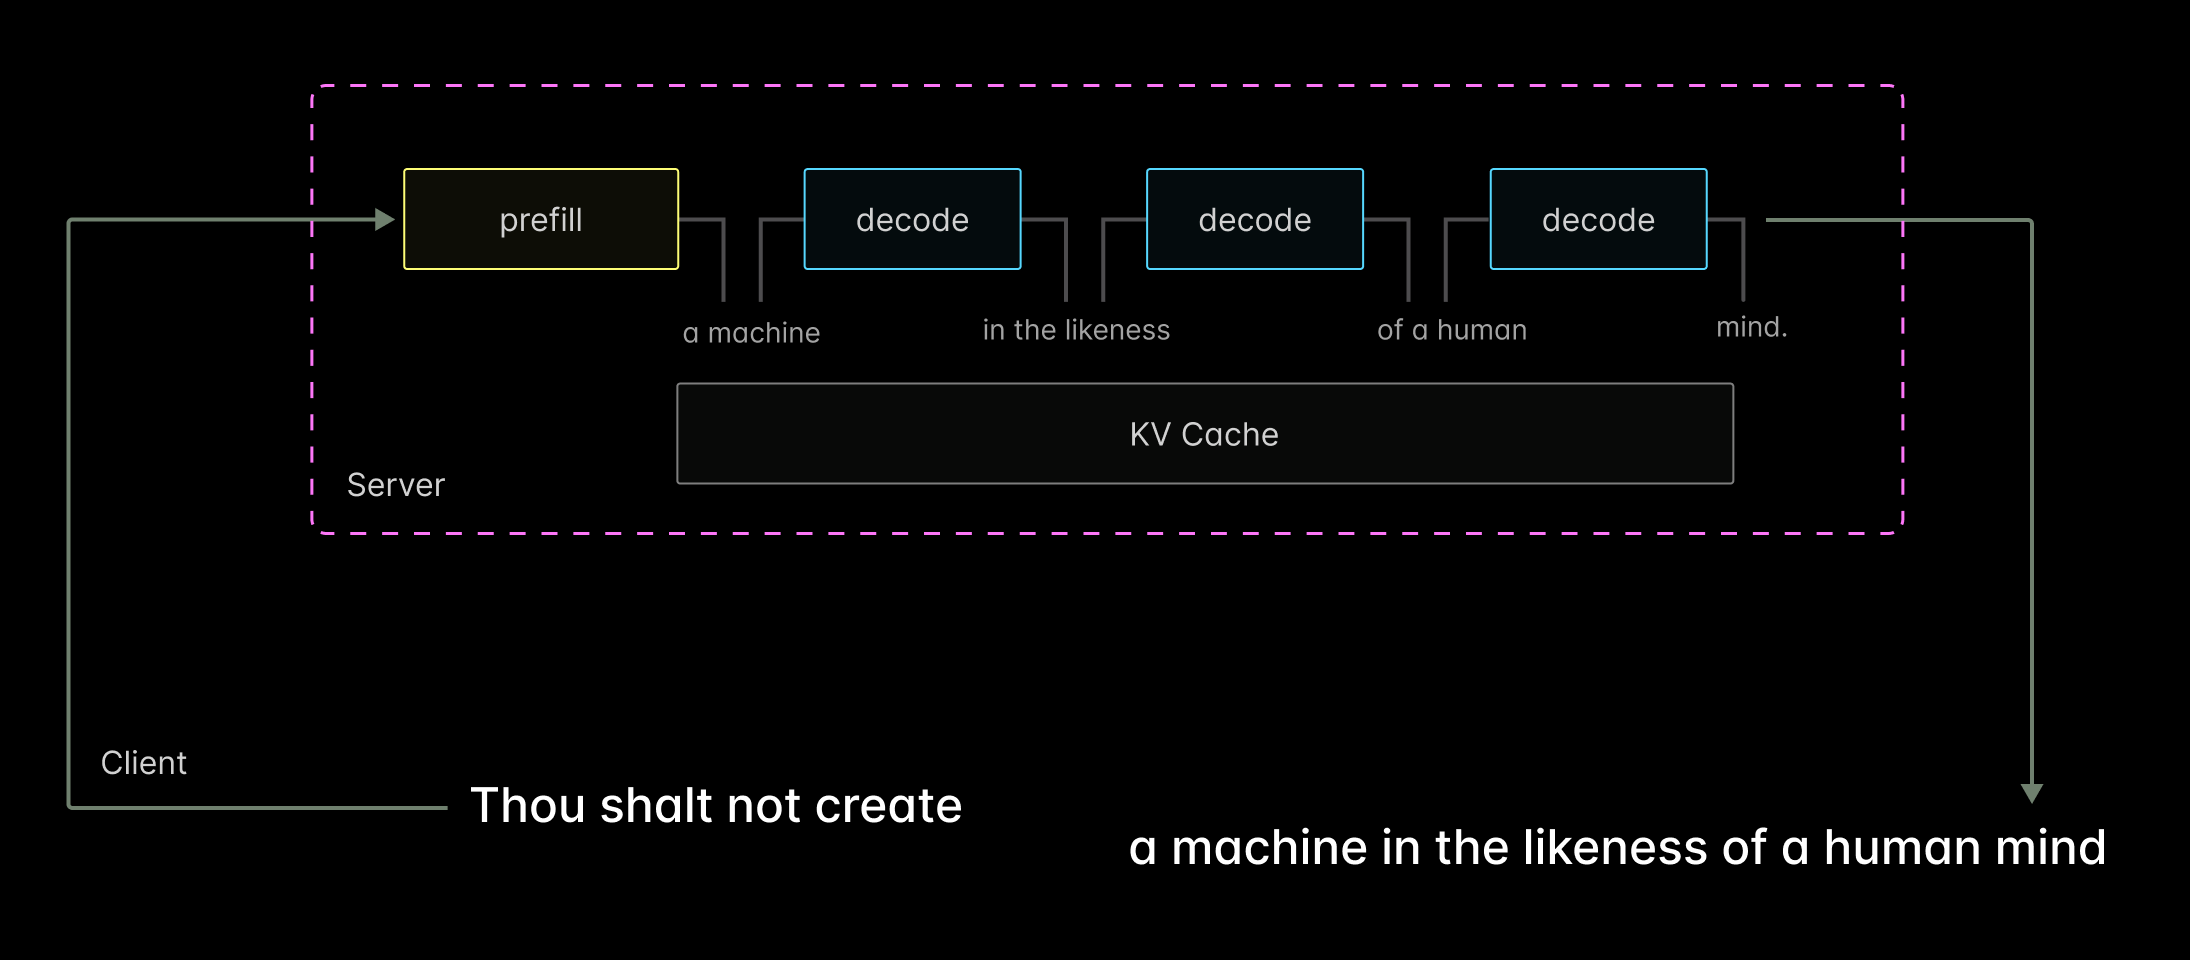
デコードはなかなか厄介だ。GPU はこれが得意ではない。デコードの演算強度は低いので、GPU が大量のメモリ帯域を備えていても、演算帯域を使い切るのは難しい。
Agent 系アプリケーションは decode に大きく偏る——入力 token は出力 token より多いのに、decode はずっと遅いので、時間の大半は decode に費やされる。この問題は深刻で、許容できる性能を出すために、ノードをまたぐ prefill-decode 分離のような複雑な構成を推論サービスのデプロイが強いられることも多い。
だが、すべて の token が decode 段階で生成されるわけではない。入力シーケンスを処理するときの最後の「prefill」順伝播が、1 つの token の予測を出力する。
そしてシーケンスのブール分類、つまりAI.IFなら、token は 1 つで足りる——本当に足りる。
これが重要なのは、AI.IFが片隅の存在ではないからだ。AI-SQL の join はまさにこう実装されている(JOIN ON AI.IF)。prompt の組み立てに少し工夫すれば、AI.CLASSIFYも単一 token に対応付けられる。クラス数は語彙サイズまでいける(これは今後の課題として取っておく!)。
現時点では、これをほとんど活かせていない。実装していない ものについてはなおさらだ。
- prefill と decode の分離(disaggregation は言うまでもない)。そもそも decode が存在しない
- サンプリング。生成される token はなく、あるのは確率だけ
- CUDA Graph のキャプチャ。prefill は十分長く続くため、小さなモデルを大きな GPU で動かしても起動オーバーヘッドは無視できる
- 投機的デコーディング。これは複数 token の decode を高速化するものだから
だが、prefill のみの推論にはまだ深い最適化の余地があると考えている。
Quail は SQL クエリと推論ワークロードを同時に最適化する
SQL の問題と推論の問題の形は見えてきた。次は Quail のアーキテクチャをざっと見ていく。クエリプランナと実行エンジンに焦点を当てる。
アーキテクチャ概観
気づいていないかもしれないが、今やデータベースを作るのは簡単だ(Stonebraker & Pavlo, 2024 や Andrew Lamb の Apache DataFusion に関する講演を参照)。分析型データベースは特に作りやすい。主要なコンポーネントの多くが標準化され、拡張可能なオープンソース実装が存在するからだ。コーディングエージェントがあれば、オープンソースの部品を組み合わせるのは驚くほど楽だ。
主要なコンポーネントを、外部インターフェースから内部実装の順に並べるとこうなる。SQL パーサ、クエリプランナ、実行エンジン、ストレージエンジン。
- SQL パーサ。 @tobymao の Python sqlglot ライブラリを使っている。
snowflakeとbigqueryの両方言に対応する。AI-SQL は「匿名」式として扱う。つまりクエリプランナにそのまま渡す。 - クエリプランナ。 ここはほぼ自前で作った。作業全体の核だからだ。詳細は後述する。クエリプランのシリアライズには Substrait を使い、ベンチマークに用いている。
- 実行エンジン。 vLLM のモデル順伝播の実装を fork し、後述のとおり kernel を変更した(主に Triton で kernel 融合を書いた)。完全な SQL 実行のサポートはまだ入れていないが、DataFusion で埋めるのはかなり素直にできる。
- ストレージエンジン。 列指向の Arrow 形式を pyarrow で扱う。これは分析型ワークロードで、書き込みが一度きりで読み出しが何度もあり、いわば「簡単モードのファイルシステム」だ。データは S3 のようなオブジェクトストレージや Modal Volumes のような分散ファイルシステムから事前に取得してくる前提としている。
推論エンジン向けのクエリプランナ設計
クエリプランナは、SQL クエリをパースして得た論理プランを受け取り、それを変換する。等価な論理プラン間の変換もあれば、具体的な操作を伴う「物理」プランへの変換もある。クエリプランナの設計空間は驚くほど広い。何しろ本質的にコンパイラなのだから。
ただ、我々の問題集合はフィルタと結合に限られており、その範囲ではよく知られた手法がほぼそのまま使える。述語は結合の後ろに押し下げ、フィルタ条件は選択率で並べ替える(Hellerstein と Stonebraker に倣う)。結合順序は深い木の上での動的計画法で決める。1976 年の古典的な System R の論文と同じやり方だ。これはごく大まかな要約にすぎない。データベース寄りの詳細は Full Stack Data Lab ブログのこちらの記事にある。
ここでは Transformer 推論向け、GPU 中心の貢献、つまりコストモデルと結合順序アルゴリズムについて簡単に触れる。具体的には、Quail はコストモデルに光速推定を組み込み、結合順序探索に KV を考慮した判断を加えている。
KV を考慮した結合順序探索
結合順序の古典的な手法は「分割統治」に基づく動的計画法だ。おおまかには、あるステップで最適な選択を選び、それを固定して最適な部分プランを探索する。
我々の状況は通常の結合順序付けほど単純ではない。以前のプランが残した KV 状態も追跡する。最初は見劣りする選択が、後にその KV を再利用できる結合にとって役立つことがあるからだ。
探索中は複数の候補を保持する。新しい候補プランが token 数、attention 対数、キャッシュ token 数のすべてで少ないときにだけ、古いプランを捨てる。つまり Pareto の意味で「支配」されたときだ。最終的なプランは、後述する光速コスト推定で選ぶ。
結合順序付けは難しい。この手法にはまだ大きな改善余地があると考えており、一緒に取り組んでくれる人を歓迎する。
悲観的に光速を見積もる
ほとんどのデータベースと同様、我々のハードウェアに基づくコスト推定はかなり粗い。Williams、Waterman、Patterson の「roofline モデル」を使い、スループット志向のハードウェアを記述し、ハードウェアのピークレートから「光速」を見積もる。これには限界がある(GPU Performance Glossary の性能ボトルネックの項目の最後の段落を参照)。
だが粗いからといって無効ではない。第一に、SoL モデルは反復の過程で結果の妥当性を確かめる重要な道具になる。第二に、ピーク性能を過大評価することはあっても、ランダムに見落としたり過小評価したりはしない。北極星として扱うといい。決してたどり着けないが、進むべき方向を教えてくれる。
詳細なコードはこちらにあるが、コストモデルの概略はこうだ:
min_latency = 0
for module in model.modules:
 latency_bound = module.bytes / hardware.memory_bandwidth
 compute_bound = module.flops / hardware.compute_bandwidth[module.precision]
 min_latency += max(latency_bound, compute_bound)
計算の対象は、ターゲットのワークロードのうちテント内のハイポールモジュールのサブセットのみ:トークンごとの attention 射影、MLP/MoE 層、トークンをまたぐ attention 計算。
原理上はモデルごとに一度やる必要があるが、実際にはモデル間で多数の演算子が共有されている。現代の coding agent は Hugging Face の config を読み、この設定のもとで妥当なコストモデルを生成するのが得意だと分かった。ただし、その出力はたいてい勘で確認する必要がある。roofline-SoL コストモデリングのもう一つの応用例については、我々の投機的デコーディング高速化見積もりツールを参照。
推論エンジンは実行エンジンである
最終的な物理プランが決まれば、あとは実行エンジンがそれを実装するだけだ。
だが GPU 側をあれこれ考える前に、まずCPU 側をきれいに片付けておくのが重要だ。高性能ストレージやネットワークを触ったことのある人なら、この手の基本パターンには見覚えがあるはずだ。
このシナリオでは、大量のシーケンス(数百万件)と小さめのモデル(数十億パラメータ)を、大きな GPU(H100)1 枚で動かす。これはほとんどの tokenizer バックエンドの設計範囲を超えている。我々は Stanford の Marcel Rød による Gigatoken を使った。ちなみに、この部分の処理はクエリプランナーで行われるが、実行時にも再利用される。token ID はメモリマップされた Arrow ファイルに保存しており、ストレージエンジンと同じ基盤技術を使っている。
さらに下の GPU 層へ。vLLM のモデル forward 実装を出発点にし、独自の最適化を加えて書き直した。コミュニティの成果の上に築けることに感謝しかない。
コアの matmul と attention に使っている kernel はどれも標準的なものだ:DeepSeek の DeepGEMM と Dao らの Flash Attention 3。これらの kernel は高スループット/純粋な prefill 推論のシナリオでかなり良い性能を出す。
速度上限のコストモデルはこれらの演算しか考慮していないが、forward には他にも多くの演算がある。原理上は実行時間を無視できるものの、数が多く、積み重なると無視できなくなる。これらの kernel を起動する host 側のオーバーヘッドも含まれる。
ここでの定石は、複数の小さな kernel を 1 つにまとめること、つまり kernel fusion だ。幸い、今は OpenAI の Triton でカスタム kernel を書くのは簡単だ。特に coding agent の支援と参照実装があればなおさらだ。我々は add-RMSNorm と fp8 量子化を融合し、per-head query/key RMSNorm と rotary embedding も融合した。
FlashAttention をいくつかのカスタムロジックで「包む」必要があった。A と B の join では、B の多くの suffix ドキュメントが A の同じ anchor に attend する。これをそのまま FlashAttention にマッピングすると、実行時に anchor が何份も複製されてしまう。
我々は join に対して「再帰的」、つまり「部分結果の合成」による attention 計算を行うことでこれを避けた。
まず、すべての suffix query を anchor に attend させる。これは「cross-attention」だ。次に suffix を自身に attend させ、最後に LSE-rescaling で結果をマージする。やり方は Dao らの flash decoding に近い。suffix の KV は cache に書き込まない。decode はゼロで、しかも (N>2) 路の join は決して行わないので、書く必要がないのだ。
これは Flash Infer の cascade attention や Scaly/Hazy の Hydragen と非常によく似ている。tree attention にも見えるが、深さ 1 の木という特殊ケースにすぎない。動機はこれらの技術と同じで、共有プレフィックスの再利用だ。ただし共有プレフィックスが事前に分かっているため、多くの複雑さを省ける。
さらに、モデル層でもう一つ最適化を施した。filter と join しか行わないため、モデルは truthy と falsy のトークンの確率だけを出力すればよい。つまり語彙は 8 個の選択肢しかない。structured outputs の極端なケースだ。これはエンジン起動時に分かるので、これらの列をモデルの language-modeling head からまるごと削除し、最後の unembedding matmul を vocab size x latent size から 8 x latent size に縮小した。
推論エンジンの未来とは?
最後に、AI-SQL クエリを実行していて性能向上やコスト削減に関心があるなら、ぜひ連絡してほしい。
我々は SGLang 上で多くの仕事をしてきたし、Quail を含むいくつかのカスタムエンジンも自作してきた。この経験から、この分野がどこへ向かうかについて、いくつかの見解を得た。今は推論エンジンの仕事にとって決定的な時期であり——何しろこれらのシステムはまだ新しく(数十年ではなく数年だ)——ソフトウェアエンジニアリング全体にとっても決定的な時期だ。coding agent が研究開発の制約条件を変えつつあるからだ。以下はいくつかのメモである。
AI-SQL 向けの最適化推論は、まだ始まったばかりだ。
Quail と AI-SQL のワークロードには、明らかにまだまだ最適化の余地がある。より良い実行計画を生成できるし、今実行している計画でさえ理論上の限界には届いていない。
ここで後から Schmidhuber 流にクレジットを主張できるよう、簡単に旗を立てておく。以下は、もっと投資が見たい方向性だ:
1. KV cache にもっと階層を。
現状、KV 値は GPU HBM にしかキャッシュしていない。だがストレージ層はそれだけではないし、優れたキャッシュは常に多層だ。LMSYS Org の HiCacheのようなシステムは、多層キャッシュの管理に役立つ。設計対象のワークロード——チャットボット/エージェント推論——ではすでに使ったことがあるが、今回はここには適用していない。
このワークロードはかなり性質が違うので、既存のキャッシュシステムにも改善の余地があると見ている。特に、リクエストの順序についての知識が多く、制御も効くため、キャッシュをより直接的に管理できる。レイテンシにはほぼ鈍感なので、より上位で遅いストレージ層のほうがむしろ利益を生む。ストライピングと組み合わせればなおさらだ。テープで LLM を養う、なんてのもありかもしれない。
2. クエリをまたいだ最適化。
KV 値も単一リクエストのライフサイクル内でしかキャッシュしていない。Bloom filter や zone map は使い捨てにしないのに、なぜ KV cache はそうなのか。GPU HBM はあまりに貴重でそんな使い方はできないが、上位のキャッシュはずっと安い。
3. メモリに収まらないデータセットのサポート。
antirez の Redisと Mühleisen と Raasveldt の DuckDBの成功が示しているのは、永続ストレージバックエンドがなくても有用なデータベースシステムは作れるということだ。推論は計算強度が高く、データセットの規模はむしろ小さくなりがちだ。
だが、だからといってメモリ内処理で止まる理由にはならない。KV 表現はストレージ表現よりずっと大きいので、同じ考え方を持ち込めば階層型 KV キャッシュからも恩恵を受けられる。
4. 基数木インデックスで共有を改善する。
ベンチマークスイートの中で、vLLM に負けているシナリオが一つある。agent trace データセットの処理だ。このベンチマークをわざわざ入れたのは、我々が最初に作ったシステムがトレードオフを選んでいるのであって、我々よりはるかに多くの工数を投じた既存エンジンに魔法のように全面勝利しているわけではない、と示すためだった。
具体的には、agent ベンチマークは agent serving に写像できる——すべての会話履歴をデータベースに保存し、新しい入力メッセージでSELECTしてからAI_COMPLETEする。これによりドキュメントをまたぐ大量のプレフィックス共有が生まれるが、現在のシステムはそれをモデル化も活用もできていない。
とはいえ Quail のここでの性能には伸びしろがある。たとえばドキュメントに対して基数木インデックスを構築し、そこから KV キャッシュ再利用の機会を探せる。
5. kernel 間のオーバーラップを改善する。
我々が使っているのは Triton の fusion のような比較的単純な kernel レベルの手段だけで、速度の上限にはまだ距離があると認識している。この差が生まれるよくある原因は、kernel 間のオーバーヘッドか、リソースの再利用が不十分なことだ。Hazy Research 流のスループット向け megakernel、あるいはせめて CUDA programmatic dependent launchでも、オーバーラップが改善し、性能が上がる可能性がある。
6. 実行時の微調整。
最後はかなり推測の色が濃い。現代の分析型データベースでは、演算子が実行の途中で最適化されることがよくある——特化や JIT コンパイルなどだ。Umbra の “Flying Start” コンパイラを参照。こうした最適化済みモジュールは、クエリの実行中に差し替えられる。
同じようにして、より高速なモデルを「コンパイル」できるかもしれない——量子化、枝刈り、蒸留といった手法で——クエリと並行して走らせ、精度が許容できる水準に達したら切り替える。ML トレーニングは実際、ここまで運用できる! Anil らの “On the Factory Floor” 論文を参照。
コアを共有する vibe-coded 推論エンジン
この作業の大半は、コーディングエージェントにプロンプトを書いて進めた。難しいのはもはやアイデアの実行ではなく、問題を定義し結果を測定すること——つまりセンスと品質保証だ。
ソフトウェアエンジニアリングとシステム研究はこの方向に向かっているのか? わからない。だが可能性は高そうだ。何が起きるにせよ、それは奇妙なものになるし、働き方、コミュニティの構造、インセンティブに対して、あの思慮深い注意を払う必要がある——数学のコミュニティが最近、見事にそれを示してみせた。
より具体的には、より狭いワークロードやワークロード群に特化したカスタム推論エンジンが最近大量に出現しているのは明らかだ。SyFI ラボの VibeServe agentic 開発システムは、ベースラインと目標をきちんと定義しさえすれば、この執筆プロセスが一般化しうることさえ示している。
この傾向は続くと見ているが、当面はすべての推論システムのコードがアプリケーションごとにゼロから書かれるようになるとは思わない。オープンソースの協働がもたらす利点はあまりに多い——運用が簡単、イテレーションが速い、「目玉が十分にあれば、バグはすべて浅い」。コーディングエージェントはいくつかの係数を変えたが、オープンソース貢献を駆動している協調の均衡戦略を消し去るとは思えない。
逆に、推論の世界はいずれ DataFusion 以降のデータベースに近い姿になると私たちは考えている。新しい技術を取り込めるだけの表現力を持ちながら、保証を提供できるほどに制御された、再利用可能な「コア」だ。概念実証としては エージェント向けの拡張可能な推論エンジンに関する ekzhang のツイート を参照してほしい。
既存の推論エンジン(vLLM や SGLang など)も、このコアとしてよりよく機能するよう作り変えられていく——nano-vllm と mini-sglang のプロジェクトを参照。
謝辞
本稿をレビューしフィードバックをくれた Adobe の Joe Barrow、そして DoubleWord チーム、とりわけ Fergus Finn に感謝する。