在一颗GPU上通过结合查询规划器和推理引擎达到每分钟十亿个token
Modal 与 CMU 的团队把查询规划器和推理引擎合到同一张 GPU 上,让 AI-SQL 跑到每分钟十亿 token;文章讲了现成推理引擎在这类负载上为什么会浪费算力。
中文
复制
我认为它是 LLM 帕累托最优曲线上的一点,处于一个揭示了大量潜在需求的区间(不思考、单 token、可接受智能下的低延迟),而这一区间因大家都在追逐更高智能而投入不足。
当所有人都在大张旗鼓地做 coding agent 和聊天机器人时,后端正悄然发生一场推理革命。只要成本性能比足够好,简单的 LLM 数据变换就能产生惊人的效果——刷刷社交媒体,就能看到 TypeSafe AI 的 Jev 模型那些令人瞠目、激发黑客精神的 demo。Jev 在所谓的“JSON 层”实现这些变换,也就是客户端与服务之间的 Web 式接口。AI-SQL 则在分析型 SQL 层实现,也就是商业智能与数据库之间的接口:
-- get hot leads with AI™
SELECT customers.id, products.id
FROM customers JOIN products ON -- for each row in both tables
AI.IF( -- run the prompt below and filter by truthiness
 PROMPT("{customers.profile} might buy this: {products.description}")
)
不同的推理应用产生不同的推理负载,AI-SQL 也不例外。像上面这样一条查询可能产生数百万条、每条数千 token 的序列——你的 token 预算要遭殃了。这类查询所需的智能往往远低于前沿水平,因此小型开放权重模型就能轻松胜任。但如果天真地把这些序列直接交给一个为 agentic 推理优化的推理引擎,并通过面向任意用户请求的接口来投递,效率会低得离谱,而且这是结构性的问题。
于是我们造了一个推理引擎来解决它:QUery-Aware Inference Layer(Quail)。在一条 planning 尤为重要的多表 join 查询上,Quail 在单张 H100 GPU 上达到每分钟处理超过十亿 token(TPM/GPU),在同一硬件上比我们的 vLLM 基线快 10 倍以上。在 Modal 上,折算下来每十亿 token 不到 6 美分。
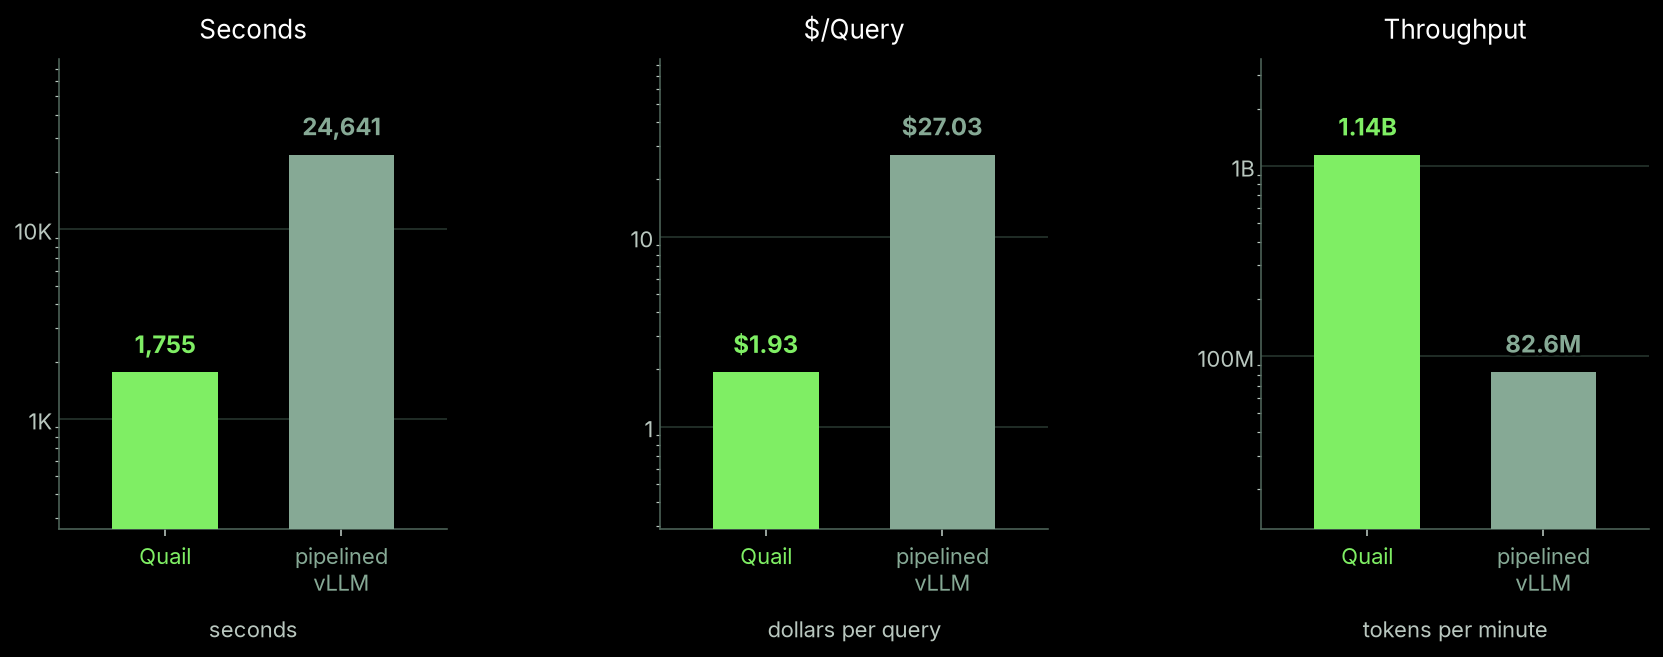
在我们新发布的 AI-SQL 查询基准上,Quail 比 vLLM 快 1.84 倍(按任务几何平均),其中还包括我们特意设计的两条查询,用来展示 AI-SQL 推理未来还有哪些改进空间。
你现在就可以在 Modal 上试用:
# uvx modal run try_quail.py

import modal

app = modal.App("try-quail")
image = (
 modal.Image.from_registry("nvidia/cuda:13.0.1-devel-ubuntu24.04", add_python="3.12")
 .entrypoint([])
 .apt_install("git")
 .uv_pip_install("quail-engine==0.1.0")
)

@app.function(gpu="H100!", image=image, timeout=600)
def run(sql=None, documents=None):
 from datasets import load_dataset
 import pyarrow as pa
 import quail

 if sql is None:
 sql = """ // no spoilers!
 SELECT r.id
 FROM reviews r
 WHERE AI_FILTER(PROMPT('Does this review discuss the ending?\n\n{0}', r.review))
 """

 if documents is None:
 imdb = load_dataset("stanfordnlp/imdb")["train"]

 documents = pa.table(
 {
 "id": pa.array(f"review-{i}" for i in range(len(imdb))),
 "review": imdb.data.table.column("text"),
 }
 )

 config = quail.EngineConfig(
 gpus=1,
 model="qwen3-4b-fp8",
 backend="quail",
 device="h100-sxm",
 )

 with quail.Session(config) as session:
 session.register(
 "reviews",
 quail.DocumentProvider.from_table(documents, id_col="id"),
 )
 result = session.sql(sql).run()

 print(result.collect())
 print(result.report)
这篇博客会简要介绍我们要解决的问题,以及 Quail 目前的运作方式。剧透一下:最大的收获在于,一旦拿到结构化查询,你就能对请求排序,从而更好地缓存(和淘汰)KV。这需要对 Hydragen 式的级联注意力做一点修改。面向小模型的大量小请求还会带来很高的主机开销,也就是GPU 利用率偏低,而如果你提前知道请求的结构,这类开销是可以避免的。
这是 Modal 的推理研究员与卡内基梅隆大学 Full Stack Data Lab 的数据库研究员合作的成果——不妨称之为一次“专家混合”。我们之所以公开所做的工作,是希望让它更“专家并行”一些。我们相信,在推理与数据库的交汇处做开源性能工程,这才只是开始——而这两者正是计算最重要的应用方向之一。
本文更侧重推理工程师需要考量的地方。想从数据库工程师的视角了解更多,可以看 Full Stack Data Lab 的博客。Quail 的代码在这里,文档在这里。如果你在大规模运行 AI-SQL 查询,并且有兴趣提升性能、降低成本,欢迎联系我们。
什么是 AI Functions 和 AI-SQL?
先补充一点这个工作负载的背景。
这里说的绝对不是让 AI 系统根据自然语言输入生成 SQL——那是 NL2SQL。那种工作负载很像传统的聊天机器人或编码 agent,现有的推理引擎已经能处理得很好。
实际情况正好相反!在 AI-SQL 中,我们用 SQL 的扩展来以编程方式生成(并消费)给 AI 系统的 prompt。prompt 由数据库条目构造,产出的是表。
-- get hot leads with AI™
SELECT customers.id, products.id
FROM customers JOIN products ON -- for each row in both tables
AI.IF( -- run the prompt below and filter by truthiness
 PROMPT("{customers.profile} might buy this: {products.description}")
)
AI-SQL 主要用于商业智能(BI)平台内部,帮助数据科学家和相关方对半结构化数据——比如文档和自由文本字段——提出更“模糊”的问题。
目前还没有统一标准,但主流托管分析数据库平台各有各的做法:Snowflake Cortex AI-SQL、Databricks AI Functions、BigQuery AI functions。
与 SQL 的其他部分不同,这个问题确实需要 GPU。
来看下面这个针对 BioDEX 数据集 的查询计划,它要筛选出药物引发的严重不良事件报告,且药物需同时包含神经和心血管两个成分:
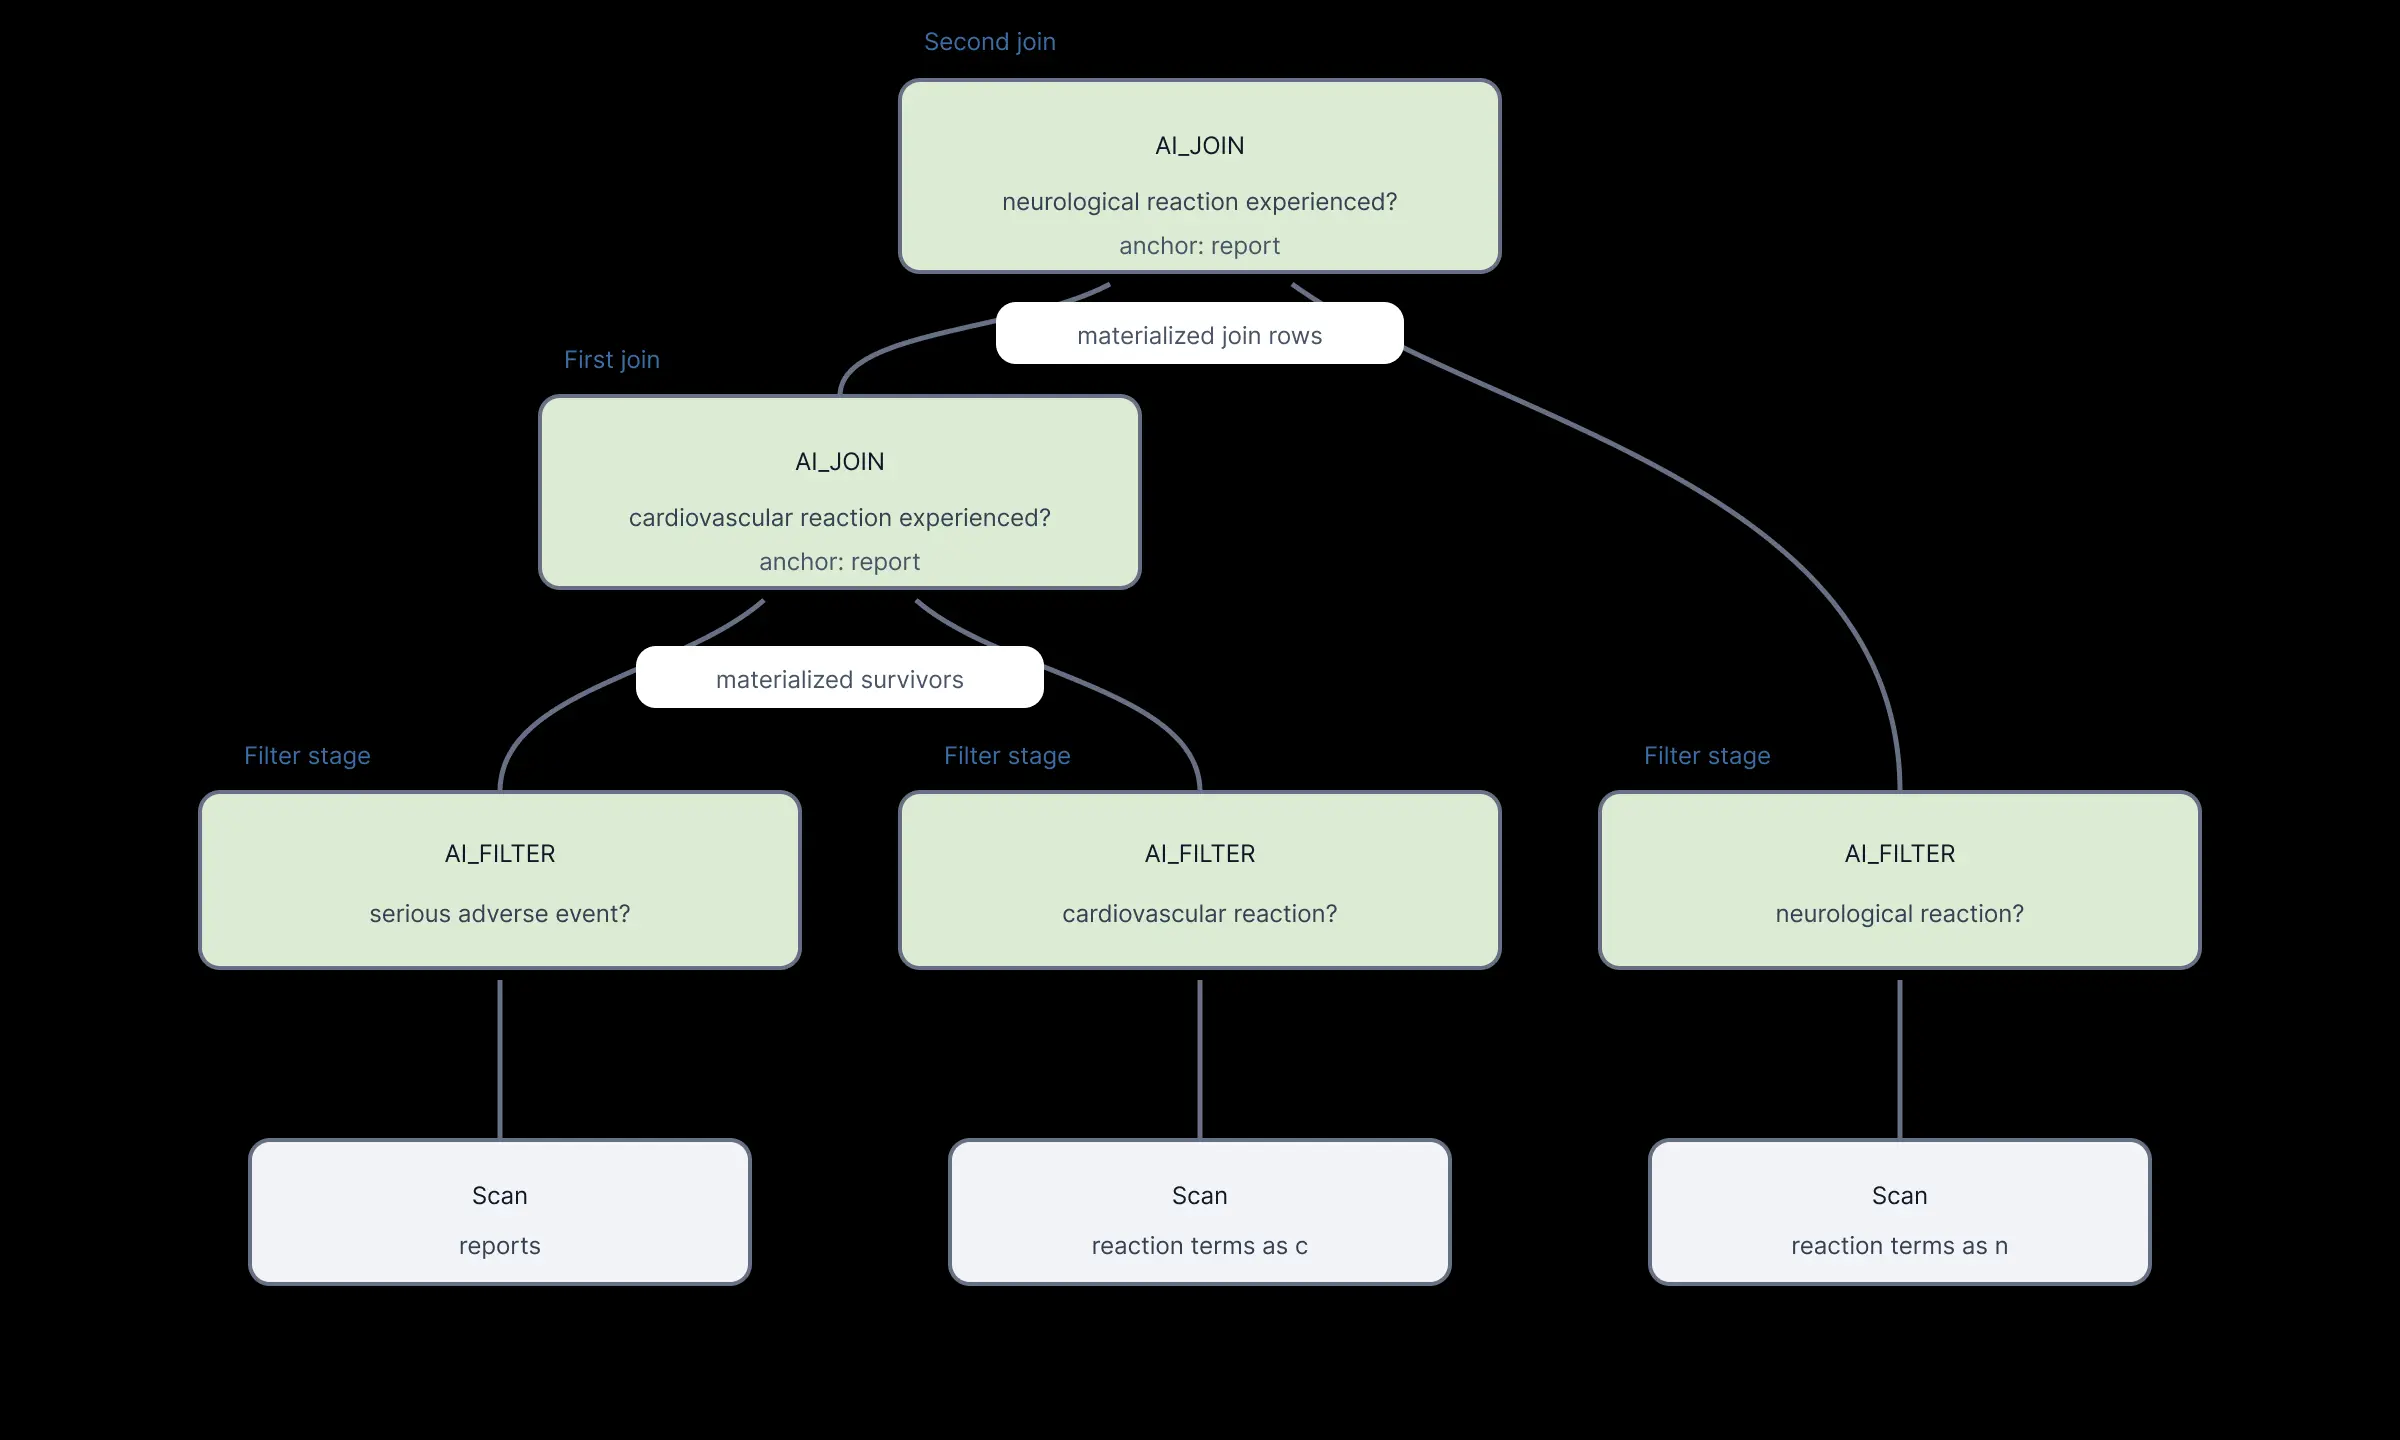
如果这些只是普通的过滤和连接,比如基于字符串匹配和逻辑相等,那就没有理由动用 GPU 这种高吞吐的数值加速器——尽管这是一个分析型查询,看起来确实“很吃吞吐”。这一点对一些人来说可能显而易见,但还是把逻辑捋一遍。
从持久存储加载到内存(或从内存加载到寄存器)的每个字节,最多只需要少量算术/逻辑运算就能完成比较。GPU 是为高算术强度的工作负载设计的——每加载一个字节要执行大量运算。而最新 GPU 的算术带宽大部分集中在用于大型矩阵乘法的专用硬件上,也就是 Tensor Cores。普通的过滤/连接不需要大型矩阵乘法。
但这个查询计划用到了 AI_FILTER 和 AI_JOIN,它们会把输入送入一个大语言模型。LLM 是一连串数值运算,其瓶颈正是大型矩阵乘法。从持久存储加载的每个字节,在被写回存储之前,都要经历数十亿次运算。
为什么推理工程师会关心这个?
如今大多数推理工程都聚焦于一种特定的工作负载形态:用户和推理服务外部的工具调用迭代式地构造长输入序列。聊天机器人和 agent 的工作负载就是这种形态——用强化学习微调模型使其成为聊天机器人或 agent 时,训练过程中的“rollout”推理也是这种形态。
别误会,这活儿非常重要!我们这里写过我们的做法。但对硬核推理工程师来说,老实讲,它已经开始有点……被玩烂了。
还有一类超低延迟推理的工作,速度与智能同等重要。我们这里写过相关技术。这类负载通常使用结构化输出/工具调用,最终更像是推理领域的“OLTP”,比开放式 agent 更容易嵌入其他计算机应用。Jev 近期的走红说明了这类负载的重要性——也说明我们还处在多么早期的阶段!
AI-SQL 负载受到的关注还不算多——目前如此——但我们认为,抛开对应用的重要性不谈,它对推理工程师来说本身就很有意思,原因有几个是根本性的。最引人注目的是,它和 transformer 简直是天作之合(因为它能实现“完美”的 KV cache 利用),对 GPU 上的 transformer 也是如此(因为它不需要 decode)。
管理 KV cache,不必留下遗憾。
在典型的推理中,请求由客户端控制,且任意随意。这带来了无穷无尽的麻烦。但在 AI-SQL 推理中,客户端只能控制 SQL 查询,而一个查询会生成大量请求,合并后的查询规划器/推理引擎对这些请求的处理拥有相当大的控制权。
这使得运营一个能摊薄更多工作的 cache 变得格外容易。比如,我们确切知道某个 cache 条目何时不再需要,因此可以毫无顾虑地将其驱逐。我们对 cache 需求的样子也相当清楚,因为一开始就能拿到整个查询计划对应的全部请求。
而我们迫切需要为 Transformer 做缓存,因为它的前向传播在序列长度上是朴素的二次复杂度。有了 KV cache,我们可以把它换成线性时间和线性存储。
对 agent 负载来说,KV cache 很难运营,因为两次访问之间的间隔完全未知。但对一个 AI-SQL 查询,我们控制着推理引擎的请求,因此可以预判未来的访问,并施加预取之类的优化。更进一步,由于我们关注的是 token 吞吐量,对取回 KV 条目的延迟就没那么在意。这让运营多级 KV cache 之类的方案变得可行得多。
看,妈妈,不用解码!
序列模型推理分为两个阶段:“prefill”(预填充),大部分 KV cache 在此阶段生成;以及“decode”(解码)阶段,大部分输出 token 在此阶段生成。
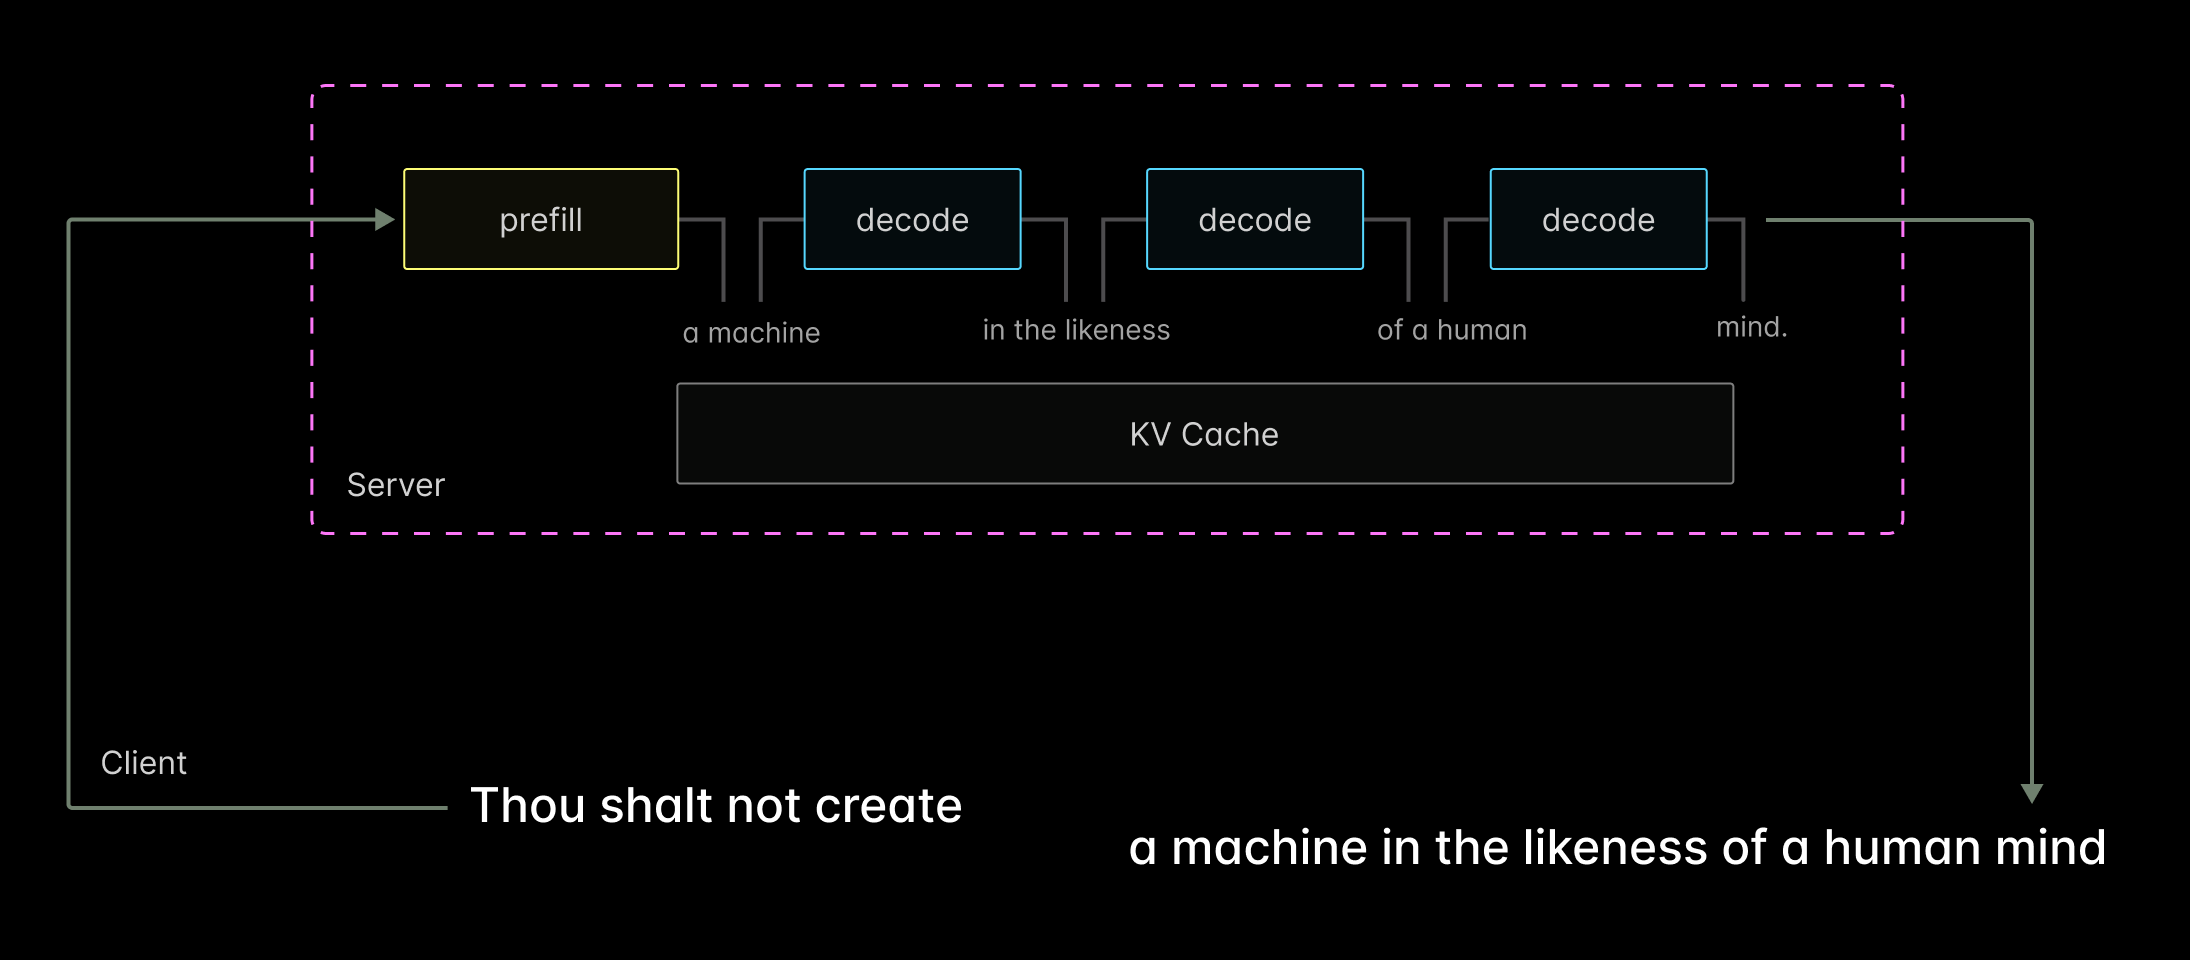
解码挺让人头疼的。GPU 并不擅长这件事。解码的算术强度很低,所以即便 GPU 提供了大量内存带宽,想让算术带宽跑满仍然很棘手。
Agent 类应用严重偏向解码——尽管输入 token 比输出 token 多,但解码慢得多,所以大部分时间都花在解码上。这个问题严重到推理服务部署往往被迫采用复杂方案,比如跨节点的 prefill-decode 分离,才能拿到可接受的性能。
但并不是 所有 token 都在解码阶段生成。处理输入序列时的最后一次“prefill”前向传播,会输出一个 token 的预测。
而对于序列的布尔分类,也就是AI.IF,一个 token 就够了——真的就够。
这一点很重要,因为AI.IF不是什么边角料。AI-SQL 里的 join 就是这么实现的(JOIN ON AI.IF)。只要在 prompt 构造上动点脑筋,AI.CLASSIFY也能映射到单个 token 上,类别数最多可以达到词表大小(这个我们留作后续工作了!)。
目前我们并没有怎么利用这一点,除了在那些我们 没有 实现的东西上:
- 分离 prefill 和 decode 阶段(更别提 disaggregation 了),因为根本没有 decode
- 采样,因为没有生成的 token,只有概率
- CUDA Graph 捕获,因为 prefill 的持续时间足够长,启动开销可以忽略不计,即便是小模型跑在大 GPU 上
- 投机解码,因为它加速的是多 token 的解码
但我们预期,仅 prefill 的推理还有更深的优化空间!
Quail 联合优化 SQL 查询和推理负载。
SQL 问题和推理问题的形态已经清楚了,接下来快速过一遍 Quail 的架构,重点看查询规划器和执行引擎。
架构总览
你可能还没注意到,如今做数据库已经很容易了(参见 Stonebraker & Pavlo, 2024 或 Andrew Lamb 关于 Apache DataFusion 的演讲)。分析型数据库尤其好做,因为许多关键组件都已经标准化,有可扩展的开源实现。而有了编码智能体,把开源组件拼起来更是轻松得离谱。
关键组件按从外部接口到内部实现的顺序排列:SQL 解析器、查询规划器、执行引擎、存储引擎。
- SQL 解析器。 我们用 @tobymao 的 Python sqlglot 库,它支持
snowflake和bigquery两种方言。AI-SQL 通过“匿名”表达式处理,也就是直接甩给查询规划器。 - 查询规划器。 这部分基本是自研的,因为它是整个工作的核心。下面会详细讲。我们用 Substrait 序列化查询计划,用于基准测试。
- 执行引擎。 我们从 vLLM 的模型前向传播实现 fork 出来,然后按下文所述修改了 kernel(主要是写 Triton 来做 kernel 融合)。目前还没有加上完整的 SQL 执行支持,但用 DataFusion 补上这一步相当直接。
- 存储引擎。 我们用 pyarrow 管理列式 Arrow 格式。这是分析型负载,一次写入、多次读取,也就是“简单模式下的文件系统”。我们假设数据会预先从 S3 这类对象存储或 Modal Volumes 这类分布式文件系统拉取过来。
为推理引擎设计查询规划器
查询规划器接收基于 SQL 查询解析得到的逻辑计划,再对这个计划做变换——既在等价的逻辑计划之间转换,也把它变成带有具体操作的“物理”计划。查询规划器的设计空间大得惊人。毕竟,它们本质上就是编译器!
但我们的问题集仅限于过滤和连接,而且在这个范围内,我们基本还能用上一些众所周知的技术。我们会把谓词下推到连接之后,按照选择率对过滤条件排序,做法参考 Hellerstein 和 Stonebraker;连接顺序则用深树上的动态规划来定,和 1976 年那篇经典的 System R 论文 一样。这只是非常简略的概述——数据库方面的更多细节在 Full Stack Data Lab 博客的这篇文章里。
这里我们简单谈谈面向 Transformer 推理、以 GPU 为中心的那部分贡献,也就是成本模型和连接顺序算法。具体来说,Quail 在成本模型中加入了光速估计,并在连接顺序搜索中加入了 KV 感知。
KV 感知的连接顺序搜索
连接顺序的经典做法是基于「分而治之」的动态规划。大致思路是:在一步中选出最优选择,然后固定这个选择,去搜索最优的子计划。
我们的情况不像普通的连接排序那么简单。我们还会跟踪之前计划留下的 KV 状态,以防一开始看起来很差的选择,后来对某个可以复用其 KV 的连接反而有用。
搜索过程中我们会保留多个候选。只有当新的候选计划在 token 数、注意力对数和缓存 token 数上都更少时,我们才会淘汰旧计划——也就是说,它在 Pareto 意义上被「支配」了。最后我们用下面描述的光速成本估计来选出最终计划。
连接排序很难!我们预计这项技术还有很大的改进空间,也很乐意和你一起做。
悲观地估计光速
和大多数数据库一样,我们基于硬件的成本估计相当粗糙。我们用 Williams、Waterman 和 Patterson 的「roofline 模型」 来刻画面向吞吐的硬件,根据硬件的峰值速率 估计「光速」,这有其局限(参见 我们 GPU Performance Glossary 中关于性能瓶颈那一条 的最后一段)。
但粗糙并不意味着无效!一方面,SoL 模型是迭代过程中用来校验结果是否合理的关键工具。另一方面,它宁可高估峰值性能,也不会随机漏判或低估。把它当作北极星:你永远到不了,但它能帮你一路向北。
详细代码在这里,但成本模型大致是这样的:
min_latency = 0
for module in model.modules:
 latency_bound = module.bytes / hardware.memory_bandwidth
 compute_bound = module.flops / hardware.compute_bandwidth[module.precision]
 min_latency += max(latency_bound, compute_bound)
计算只基于目标工作负载中帐篷里的高杆模块子集:逐 token 的 attention 投影、MLP/MoE 层,以及跨 token 的 attention 计算。
原则上每个模型都要做一次,但实际上模型之间共享大量算子。我们发现,当代的 coding agent 很擅长读取 Hugging Face config,并在这套设定下生成一个合理的成本模型——不过它们的输出往往需要凭感觉检查一下。关于 roofline-SoL 成本建模的另一个应用,参见我们的投机解码加速估算器。
推理引擎即执行引擎
最终物理计划选定之后,必须由执行引擎来实现。
但在过多考虑 GPU 那一侧之前,先把 CPU 的事处理干净很重要。做过高性能存储或网络的人对这些基本套路都不会陌生。
在这个场景里,我们有大量序列(数百万条)和一个不大的模型(数十亿参数),跑在一张大 GPU(H100)上,这已经超出了大多数 tokenizer 后端的设计范围。我们用了 Stanford 的 Marcel Rød 做的 Gigatoken。顺带一提:这部分工作在查询规划器里完成,但在执行时会被复用。我们把 token ID 存在内存映射的 Arrow 文件里,和存储引擎用的是同一套基础技术。
再往下到 GPU 层:我们从 vLLM 的模型前向实现出发,然后用一些自定义优化重写了它们。能建立在社区的工作之上,我们非常感激!
我们用于核心 matmul 和 attention 操作的 kernel 都是标准方案:DeepSeek 的 DeepGEMM 和 Dao 等人的 Flash Attention 3。这些 kernel 在高吞吐/纯 prefill 推理场景下表现相当好。
速度上限成本模型只考虑这些操作,但前向传播中还有很多其他操作。它们的运行时间原则上可以忽略,但数量很多,累加起来就不可忽视了,其中还包括启动这些 kernel 的 host 开销。
这里的标准做法是把若干小 kernel 合并成一个,也就是 kernel fusion。好在现在用 OpenAI 的 Triton 写自定义 kernel 已经很容易了——尤其是有了 coding agent 辅助和参考实现之后。我们把 add-RMSNorm 与 fp8 量化融合在一起,也把 per-head query/key RMSNorm 与 rotary embedding 融合在一起。
我们确实需要用一些自定义逻辑来“包裹”FlashAttention。在 A 和 B 的 join 中,B 的许多 suffix 文档会 attend 到 A 中同一个 anchor。如果直接映射到 FlashAttention,执行时 anchor 会被复制很多份。
我们通过对 join 采用“递归”或者说“部分结果组合”的 attention 计算来避免这一点。
首先,让所有 suffix query attend 到 anchor,这是一种“cross-attention”。然后 suffix 再 attend 到自身,最后用 LSE-rescaling 合并结果,做法类似 Dao 等人的 flash decoding。suffix 的 KV 不写入 cache——我们做的是零 decode,而且从不做 (N>2) 路 join,所以不需要写!
这和 Flash Infer 的 cascade attention 或 Scaly/Hazy 的 Hydragen 非常相似。它看起来也像 tree attention,只不过是深度为一的树这一特殊情况。动机与这些技术相同:共享前缀的复用。但因为共享前缀是事先已知的,我们可以省掉很多复杂性。
此外,我们在模型层还做了一项优化。由于只做 filter 和 join,模型只需要输出 truthy 和 falsy token 的概率。这意味着词表只有 8 个选项——structured outputs 的极端情形。这一点在引擎启动时就是已知的,所以我们干脆把这些列从模型的 language-modeling head 中整个去掉,把最后的 unembedding matmul 从 vocab size x latent size 缩减到 8 x latent size。
推理引擎的未来是什么?
最后,如果你在运行 AI-SQL 查询,并且对提升性能、降低成本感兴趣,欢迎联系我们。
我们在 SGLang 上做了大量工作,也自研了一些定制引擎,包括 Quail。这些经历让我们对这个领域的走向有了一些看法。眼下既是推理引擎工作的关键时期——毕竟这些系统还很新(只有几年,而非几十年),也是整个软件工程的关键时期——因为编码智能体正在改变研发的约束条件。下面是一些笔记。
面向 AI-SQL 的优化推理才刚刚开始。
针对 Quail 和 AI-SQL 负载,显然还有大量优化空间。我们可以生成更好的执行计划,而且即便是当前执行的计划,距离理论极限也仍有差距。
这里快速插旗列一份清单,方便日后用 Schmidhuber 的方式认领——以下是我们希望看到更多投入的方向:
1. 给 KV cache 增加更多层级。
我们目前只把 KV 值缓存在 GPU HBM 里。但存储层不止这一级,而优秀的缓存从来都是多层的。LMSYS Org 的 HiCache 这类系统可以帮助管理多层缓存。我们已经在它设计针对的负载类型——聊天机器人/智能体推理——上用过它,但这次没有应用到这里。
这个负载相当不同,所以我们预计现有缓存系统还有改进余地。尤其是,我们对请求顺序的了解更多、控制力也更强,因此可以更直接地管理缓存;同时我们对延迟基本不敏感,所以更高层、更慢的存储层反而能带来收益,尤其是配合条带化的时候。也许我们可以用磁带喂 LLM?
2. 跨查询优化。
我们也只在单个请求的生命周期内缓存 KV 值。我们不会把 Bloom filter 或 zone map 用完就扔,那为什么 KV cache 要这样?GPU HBM 太宝贵,不能这么干,但更高层的缓存要便宜得多。
3. 支持超出内存的数据集。
antirez 的 Redis 和 Mühleisen 与 Raasveldt 的 DuckDB 的成功已经证明,没有持久化存储后端,照样能做出有用的数据库系统。而推理的计算强度太高,数据集规模往往反而更小。
但这不构成止步于内存处理的理由。KV 表示比存储表示大得多,所以套用这套思路同样能从分层 KV 缓存中获益。
4. 用基数树索引改善共享。
在我们的基准测试套件里,有一个场景我们落后于 vLLM:处理 agent trace 数据集。我们专门加入这个基准,就是想说明我们最初构建的系统是在做取舍,而不是凭某种魔力就全面胜过那些投入了远多于我们的工程量的现有引擎。
具体来说,agent 基准可以映射到 agent serving——把所有会话历史存进数据库,然后用一条新的输入消息 SELECT 这些历史,再跑 AI_COMPLETE。这会产生大量跨文档的前缀共享,而当前系统既无法建模,也无法利用。
不过 Quail 在这里的性能还有提升空间。比如,可以对文档构建一棵基数树索引,再从中寻找 KV 缓存复用的机会。
5. 改善 kernel 之间的重叠。
我们只用了相对简单的 kernel 级手段,比如 Triton 里的 fusion,而且我们清楚离速度上限还有距离。造成这种差距的一个常见原因是 kernel 之间的开销,或者资源复用不充分。一个 Hazy Research 风格的、面向吞吐的 megakernel,哪怕只是 CUDA programmatic dependent launch,都能改善重叠,进而可能提升性能。
6. 运行时微调。
最后一点,推测成分大得多。现代分析型数据库中,算子常常在执行中途被优化,比如特化和 JIT 编译——参见 Umbra 的 “Flying Start” 编译器。这些优化后的模块会在查询执行到一半时被换进去。
我们也可以用类似的方式“编译”出更快的模型——量化、剪枝、蒸馏之类的技术——让它们与查询并发运行,等精度达到可接受的水平后再切换进来。而 ML 训练确实可以被运营到这个程度!参见 Anil 等人的 “On the Factory Floor” 论文。
共享核心的 vibe-coded 推理引擎
这项工作大部分是我们通过给编码 agent 写提示完成的。难的部分不再是执行想法,而是定义问题和度量结果——品味与质量保证。
软件工程和系统研究正在往这个方向走吗?我们不知道,但看起来很有可能!无论发生什么,都会很怪,并且需要对工作习惯、社区结构和激励机制给予那种深思熟虑的关注——数学界最近已经令人钦佩地展示了这一点。
更具体地说,我们很清楚最近定制推理引擎大量涌现,这些引擎是针对更窄的负载或负载集合开发的。SyFI 实验室的 VibeServe agentic 开发系统表明,只要基线和目标定义得当,这种编写过程甚至可以泛化。
我们预计这一趋势会持续下去,但暂时不认为所有推理系统代码都会按应用从零写起。开源协作带来的好处太多——运维简单、迭代更快、“只要眼球足够多,所有 bug 都是浅的”。编码 agent 改变了一些系数,但我们不认为它们会消除驱动开源贡献的合作均衡策略。
相反,我们认为推理领域很快就会更像 DataFusion 之后的数据库:一个可复用的“核心”,表达力足以吸收新技术,又足够可控以提供保证。概念验证可参见 ekzhang 关于 agent 可扩展推理引擎的推文。
现有推理引擎(如 vLLM 和 SGLang)也可加以改造,更好地充当这一核心——参见 nano-vllm 和 mini-sglang 项目。
致谢
感谢 Adobe 的 Joe Barrow 以及 DoubleWord 团队,特别是 Fergus Finn,审阅本文并提供反馈。