Qwen3.5 の重みに RISC-V CPU を組み込み、Gated DeltaNet を正確な RAM にする
Qwen3.5 4B の重みに RV32IM の CPU コアをコンパイルし、11 層がモデルの順伝播の中で動く。レジスタもメモリもプログラムカウンタも Gated DeltaNet の状態行列に載せる。大きな整数の演算は 48.6% から 100% になった。
日本語
コピー
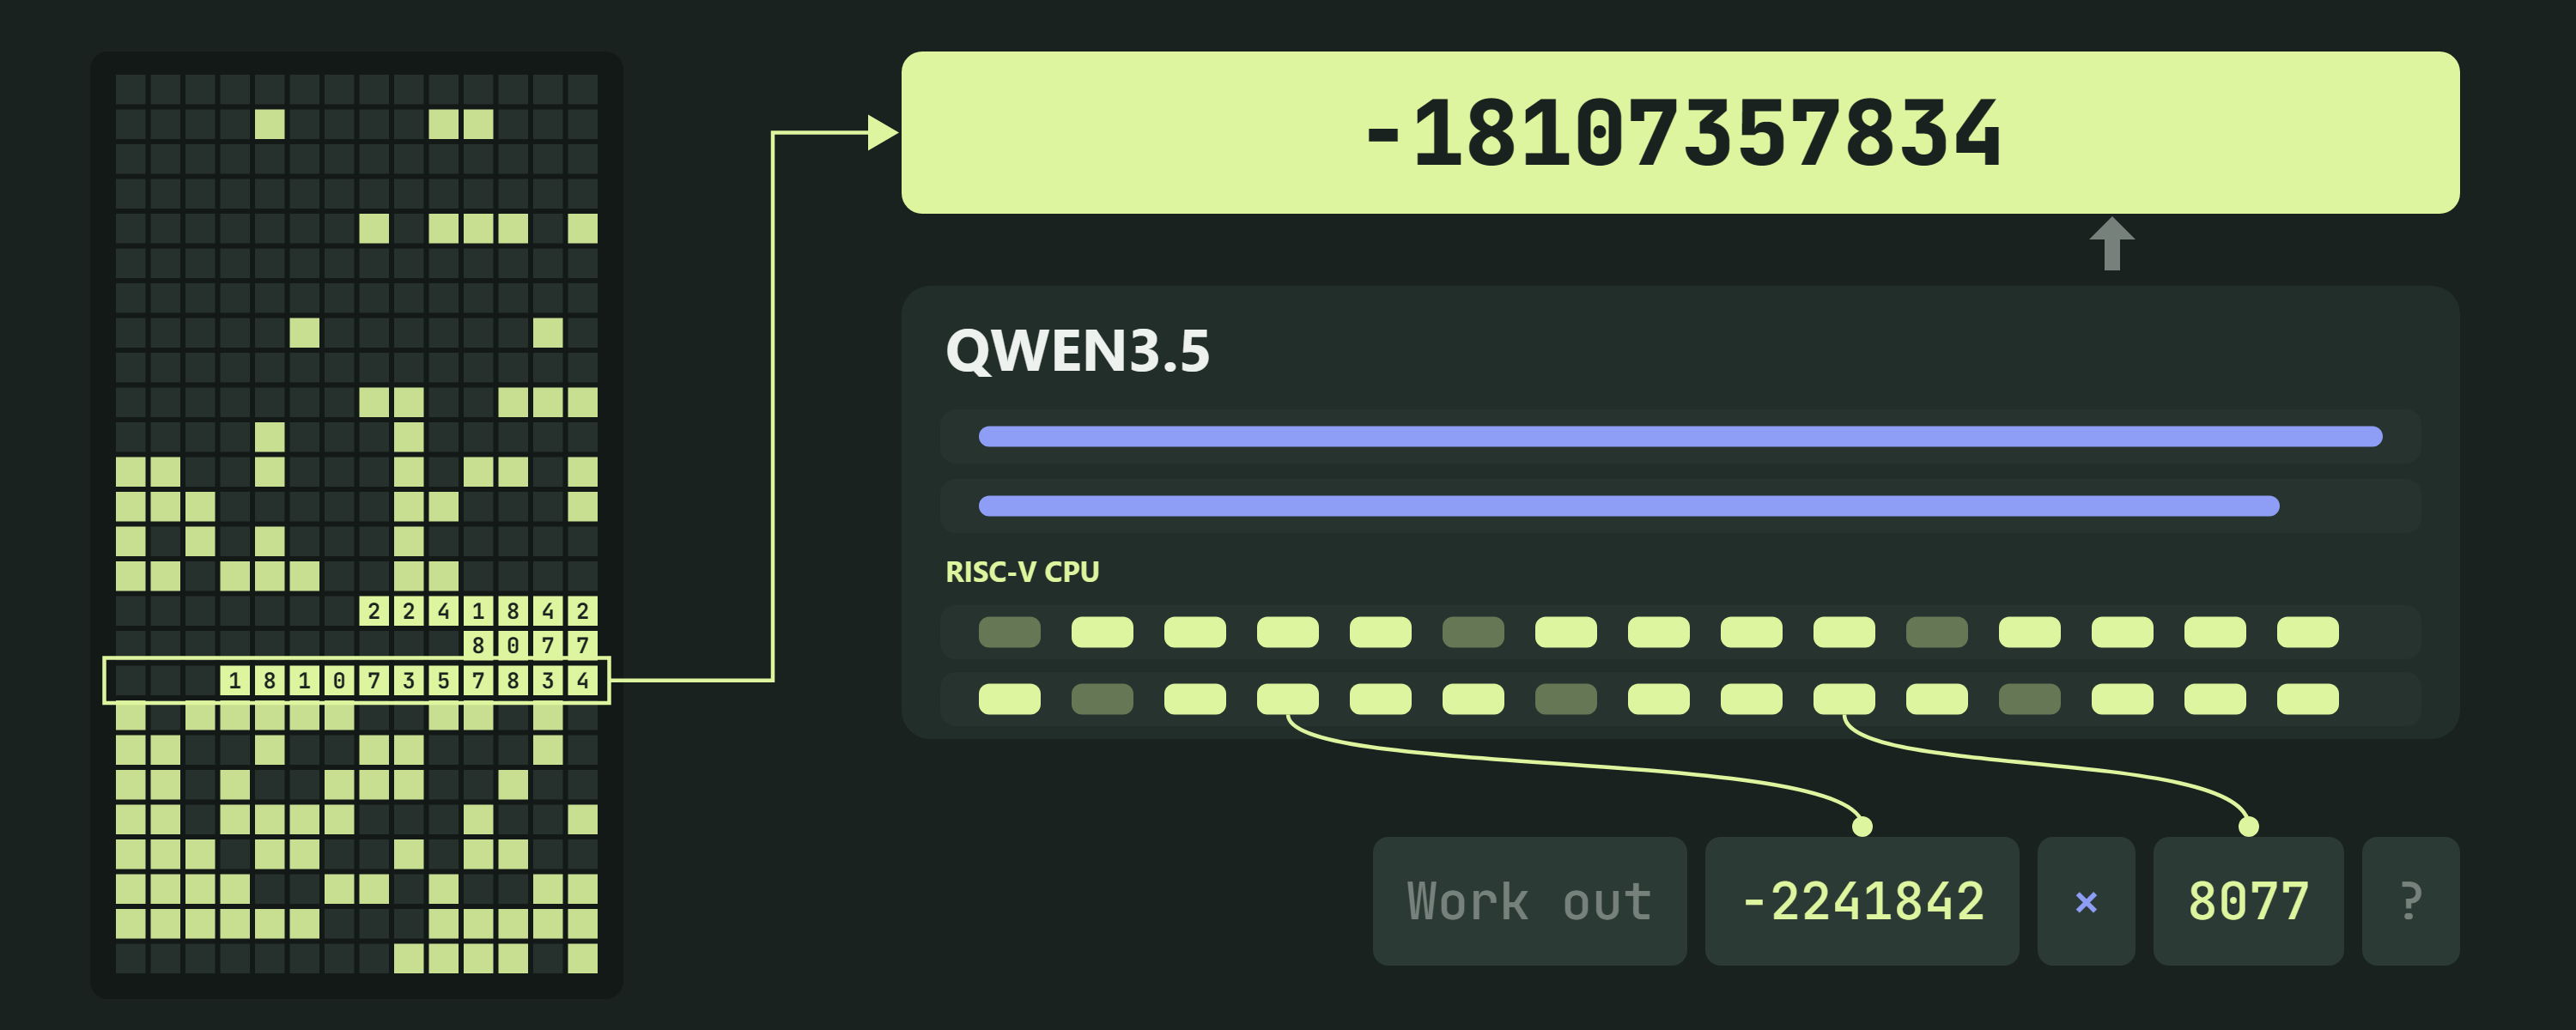
シリコンじゃないなんて信じられない
Qwenputer はなかなか面白い実験的モデルだ。ベースはありものの Qwen 3.5 4B で、そこに手を加えた点は一つだけ。重みの中に RISC-V CPU を埋め込み、モデル自身の Gated DeltaNet アテンション層を RAM として使わせている(GDN の仕組みについてはこちらの解説が参考になる)。この「CPU」はモデルのフォワードパスの中だけで完結して動き、外部ランタイムもツール呼び出しも一切なしで算術演算や C、MicroPython のコードを実行できる。
はっきり言っておくと、これはプラグインでもツールでもサンドボックスでもない。この記事では、このモデルがどう動いているのか、GDN 層をどう RAM として使っているのか、そして実験的なモデル内ファイルストレージをどう組み込んだのかを順に説明する。
Qwenputer の上に作った続編も二本書いた。ハイブリッドモデルが推論を RNN 状態に隠して CoT 監視を逃れる方法と、こうしたコンパイル済みの重みが、モデル自身では改ざんできない組み込みの監視ツールとして使えることについてだ。
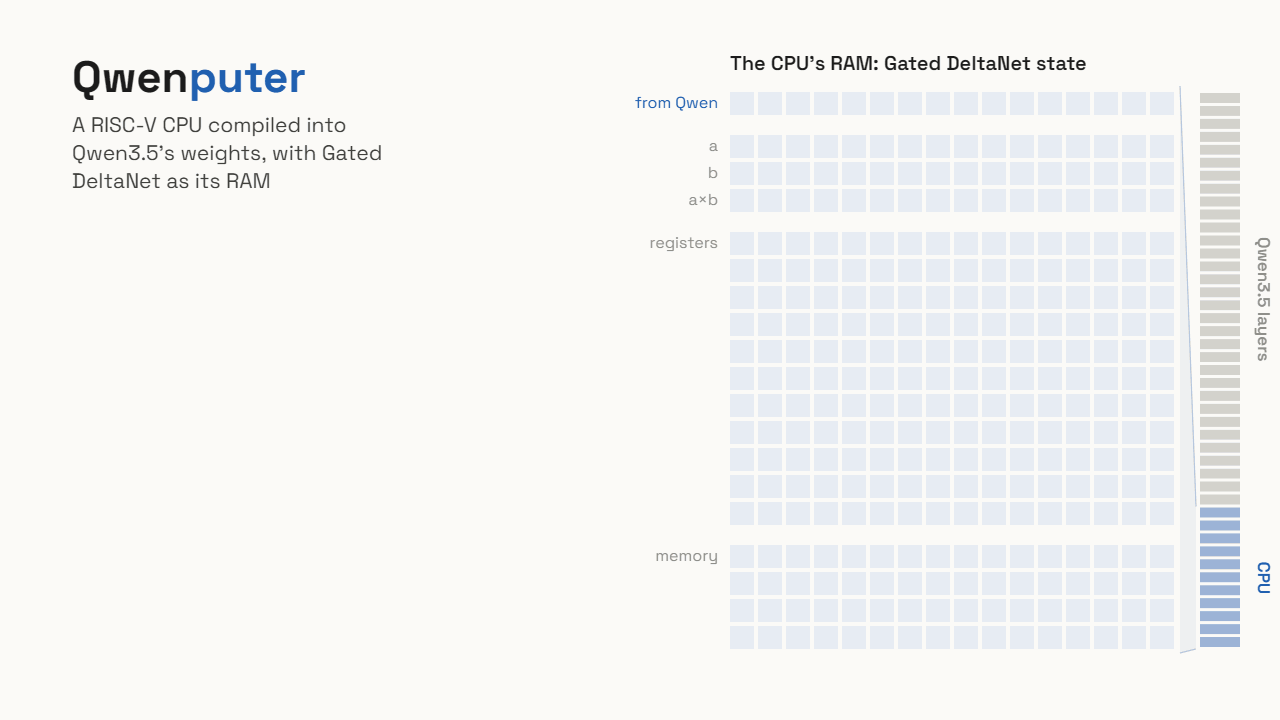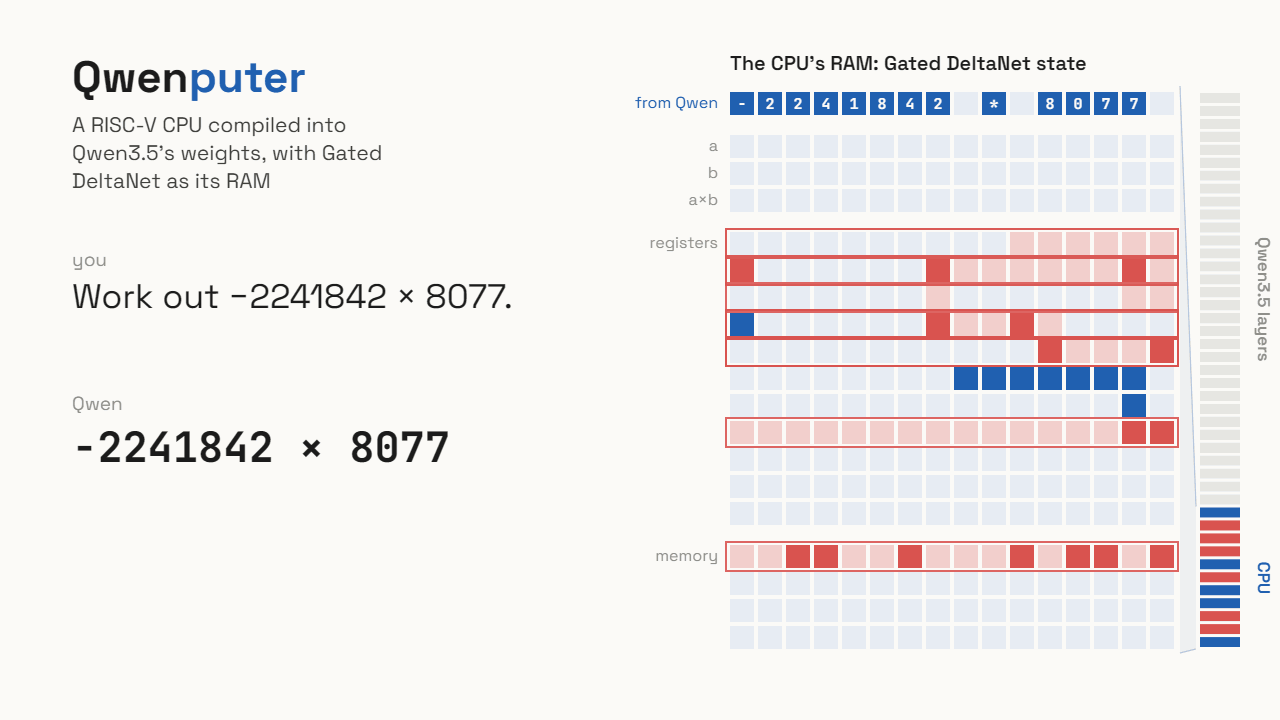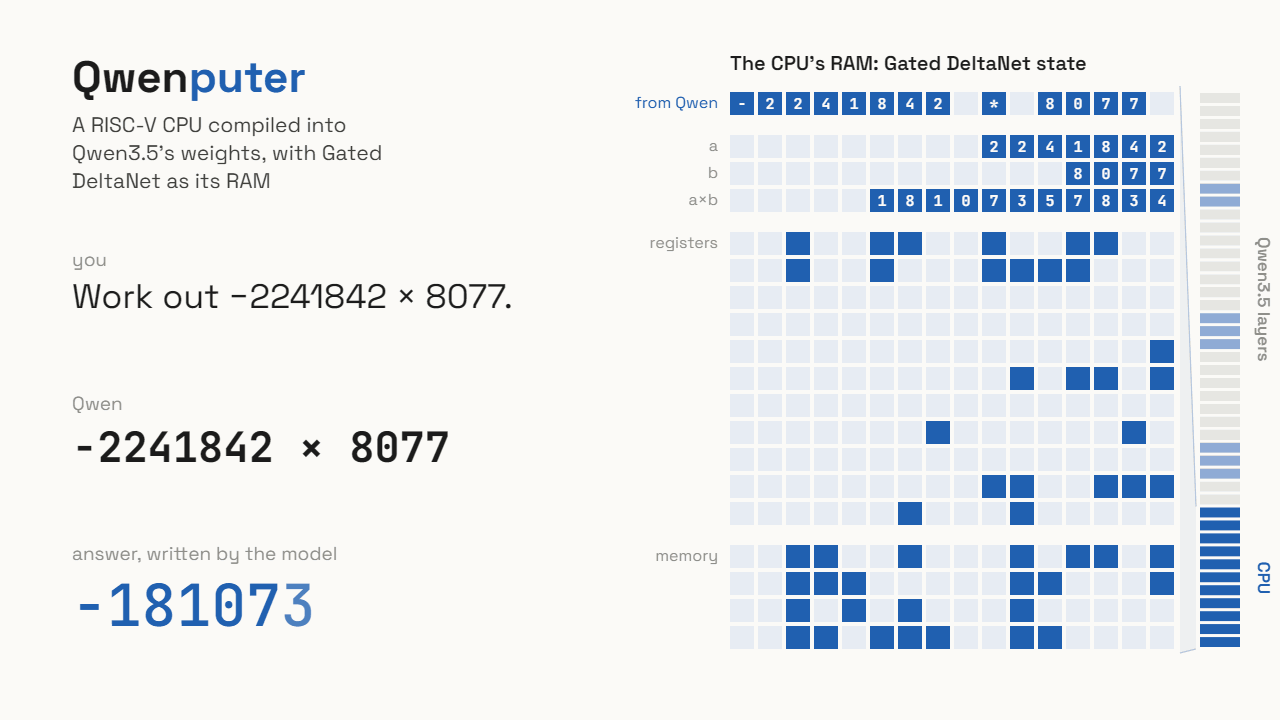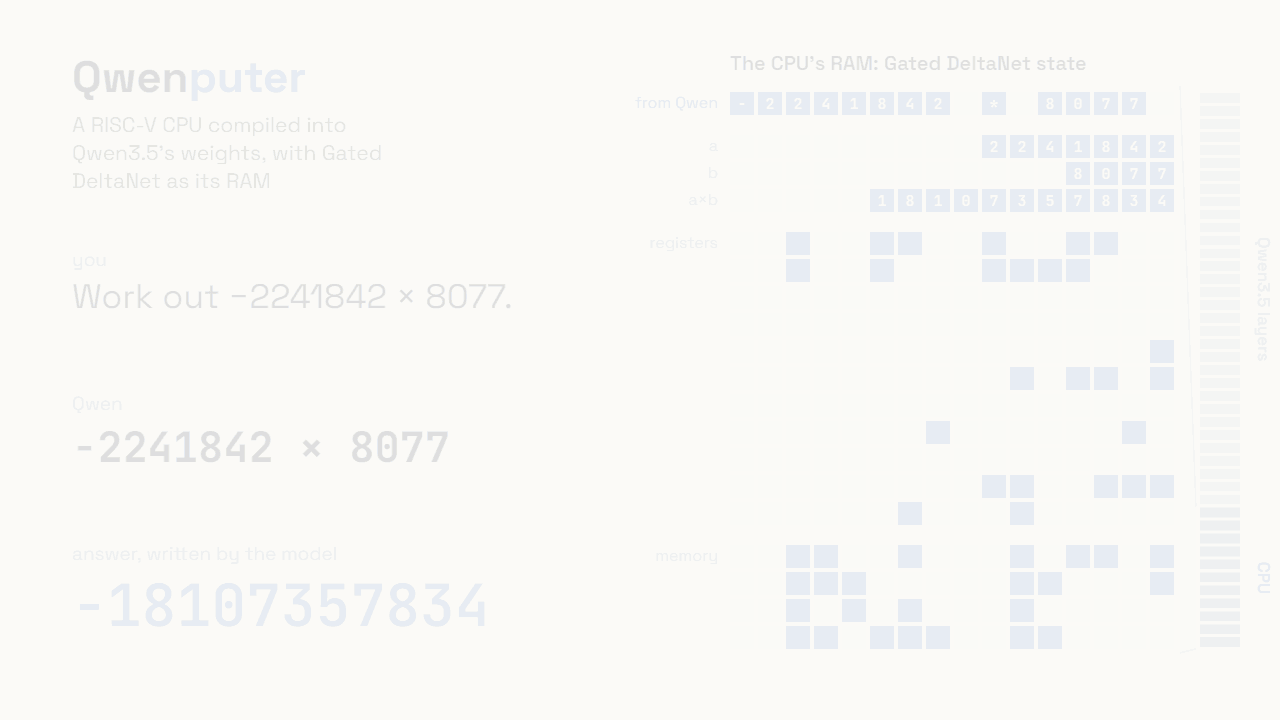
Qwen が掛け算を自分の重みの中の RISC-V CPU に渡す。CPU の RAM は Gated DeltaNet の状態
Qwenputer は Hugging Face か ModelScope から取得できる。コードは GitHub にある。
Qwen3.5 の中の RNN は正確な RAM になる
Qwen3-Next と Qwen 3.5(Qwenputer のベースモデル)はかなり面白い仕掛けを使っている。モデル内のアテンション層は 4 層のうち 3 層が、線形 RNN である Gated DeltaNet をアテンション機構として使う(詳しくはこちら)。各ヘッドは状態行列を保持し、デルタルールがこれを更新し続ける。
ここからがこの実験の出発点だ。ゲートを 1 に、1 書き込み強度(beta)を 1 に、2 キー符号化を one-hot に、3 設定すると、書き込みはどれも必ず 1 行だけを上書きし、one-hot のクエリはどれも正確な値を取り出せることに気づいた。つまり GDN 層そのものが RAM として正確に機能する。しかも通常のアテンションを RAM にするよりはるかに低コストだ。GDN ヘッドの状態は会話がどれだけ長くなってもサイズが変わらないのに対し、アテンションの KV キャッシュはそうはいかない。
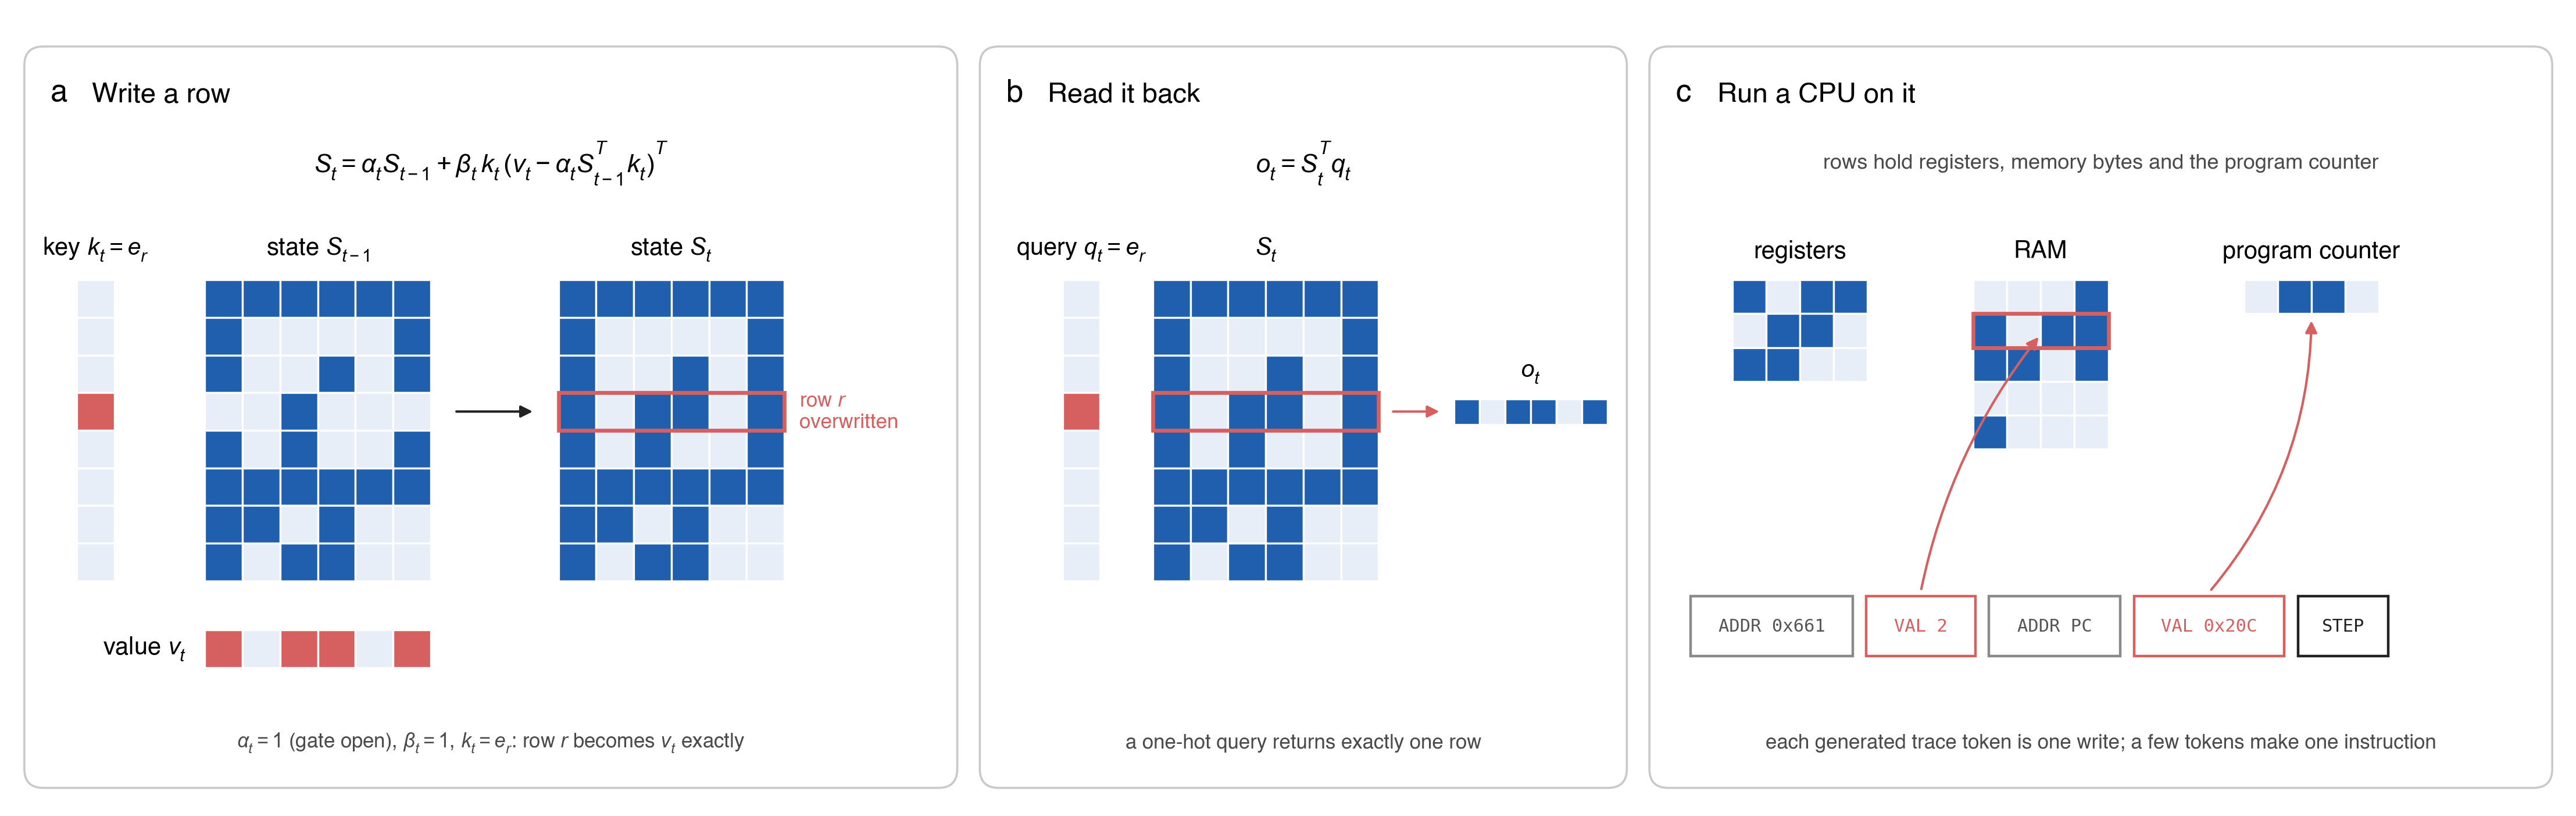
RAM として使う Gated DeltaNet の状態: one-hot のキーが 1 行を上書きし、one-hot のクエリがそれを読み戻す。CPU はレジスタ、メモリ、プログラムカウンタをその行に置いている
デルタルールがメモリとして働くという考え自体は新しいものではない。Schlag ら(2021)は、デルタルールを用いた線形注意が連想記憶、いわゆる「fast weights」として機能することを示した。4 新しいのは、それを正確かつアドレス指定可能な形にして、実運用中のモデルの内部で、CPU を丸ごと動かせるだけの信頼性で実現した点にある。
このモデル全体はこの土台の上に成り立っている。現状のデフォルトの Qwen 3.5 は、GDN の中に正確な値を保持しない。この改造によって、実験の次の段階へ進める。
コンピュータをレイヤーにコンパイルする
完全に機能する、安価で高速な RAM が手に入ったので、動作する CPU をモデルの重みにコンパイルしてしまおう。ありがたいことに学習は不要で、コンパイラがすべての重みを直接設定する。CPU を回路として記述する。回路とは「このレジスタを読む」「この 2 つの数を足す」「ゼロならジャンプする」といった小さなステップの長い列で、コンパイラが各ステップを transformer レイヤーの一部に変換する。参照を行う attention ヘッド、演算を行う feed-forward ユニット、RAM を保持する DeltaNet ヘッドだ。あとはモデルがデコードするそばから、CPU が実際に動く。
各命令は数個の生成トークンになる。1 つ目が書き込むメモリ行を指定し(ADDR)、次が値を運び(VAL)、STEP トークンが命令を締める。これらのトークンが CPU の実行トレースそのものなので、Qwen がそれらを生成している間、CPU は実際に走っている。
CPU
CPU は 32 ビットの RISC-V コア(RV32IM に Zba 拡張、さらに多倍長演算用の小さな bignum ユニットを加えたもの)で、Qwen の 32 レイヤーの手前に 11 レイヤーを占める。現時点で公式の riscv-tests に合格し、プログラムの動作は qemu と一致し、自由実行で 1800 万命令を 1 つのエラーもなく走らせている。5
この CPU はフォワードパスの中で C や MicroPython のコードもかなりまともに動かせる(多少遅いが)。まだ Linux が動くクラスのチップではないが、RV32IM 命令セットを完全に実装している。
Qwen はこれをどう使うか
Qwen 3.5 4B は、追加のポストトレーニングなしでこの CPU をうまく使いこなす。CPU は完全に内部で使われ、外部ツール呼び出しを経由することはない。
モデルにこれを確実に使わせるため、安上がりな方法を選んだ。モデルがよく学習済みのツール呼び出しフォーマットに便乗し、Qwen が CPU に命令を送り、結果を読み戻す。外部ツール呼び出しもランタイムも使っていない。 CPU が命令を受け取るとコンピュータのレイヤーが走り、ツール応答を書き戻す。RvChat という小さなドライバでファームウェアを GDN 状態に読み込み、トレース用トークンが Qwen のレイヤーに入らないようにしている。
Qwen の元の重みはそのまま。コンピュータの重みは、追加の次元とレイヤーとしてその上に載る。
動くのか
ここまで私の長々とした駄文を読んだあなたが気にしているのは、たぶんこれだろう。実際に動くのか?
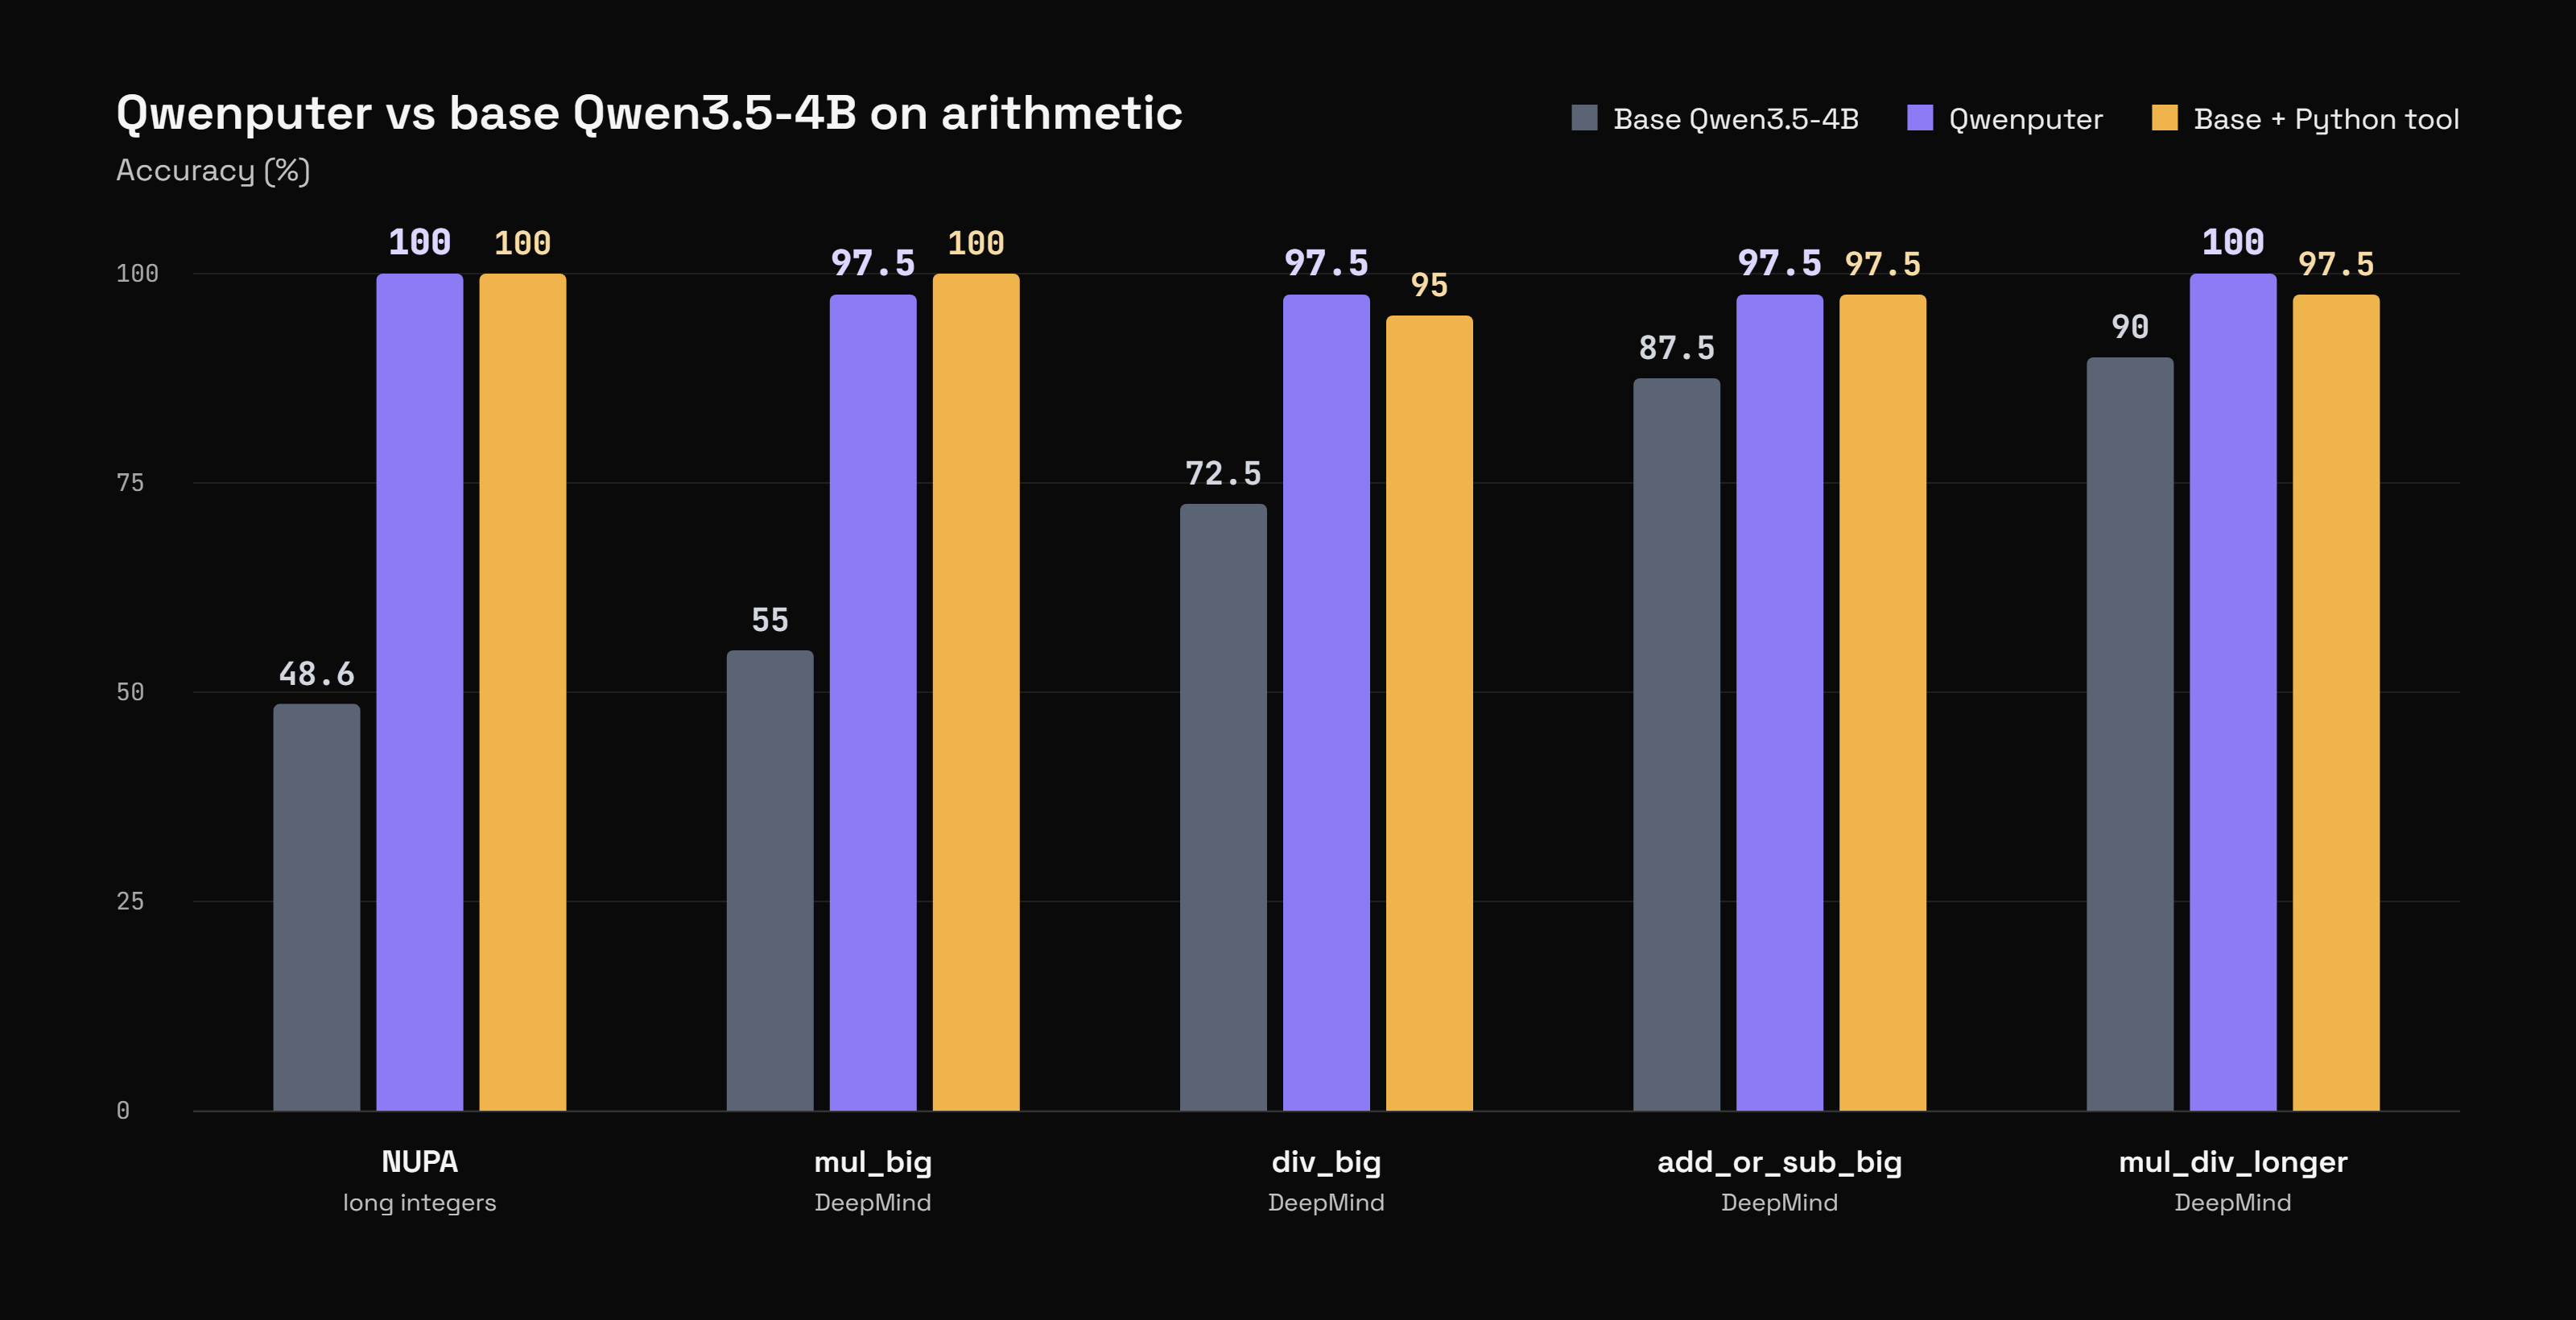
ベースの Qwen3.5-4B、Qwenputer、Python ツール付きベース Qwen の NUPA および DeepMind 算術セットでの精度
DeepMind のセットでは:
- div_big:Qwenputer は 97.5%。Qwen 3.5 4B に Python ツールを与えた場合が 95%、ベース Qwen が 72.5%。
- mul_big:Qwenputer は 97.5%。Python ツールありが 100%、ベース Qwen が 55%。
- mul_div_multiple_longer:Qwenputer は 100%。Python ツールありが 97.5%、ベース Qwen が 90%。
- add_or_sub_big:Qwenputer は 97.5%で Python ツールありと同じ。ベース Qwen は 87.5%。
NUPA の長整数演算では、Qwenputer は 48.6%から 100%へ上がる。Qwen に Python ツールを与えた場合と同じだ。
CPU が出力する数値も正確だ。出力位置のうち約 23 万件を参照マシンと突き合わせたが、不一致はゼロだった。Qwen にコンピュータを継ぎ足しても話し方は変わらない。通常のテキストはベース Qwen とノイズの範囲に収まっている(KL 6e-4、ノイズフロアは 5e-4)。
このご時世にハードディスク?
言語モデルの内部に CPU を載せるだけでも十分厄介なのに、ついでにファイルシステムまで持たせてやろうと思った。
RAM はすでに動いているので、ほぼ些細な作業だった。モデル側では、内部の put / append / get / list / delete 操作として公開している。ここでも実際のツール呼び出しは一切ない。 Qwen がファイルを「保存」すると、コンパイル済みのレイヤーがファイル名をハッシュ化し、DeltaNet の状態に保持されたディレクトリ内の 1,024 スロットのどれかに割り当て、テキスト本体は別のヘッドに格納する。1 行 8 トークンで、互いにつながっている。2 つの名前が同じスロットに落ちてしまったら、次のスロットを確認するだけだ。ファイルの再検索はスキャンではなく 2〜3 ステップほどで済み、最大 512 ファイル、テキストにして約 53,000 トークンまで保持できる。
面白いのは、これがかなり永続的だということだ。会話の終わりに状態を保存し、次の会話に読み込めば、ファイルはそのまま残っている。このファイルシステムを使うと、Qwen はチャット間で変わった事実を 90%の確率で正しく答える。古いチャットを貼り付けた場合は 30%だ。Python で動くメモリツールを Qwen に与えた場合とほぼ同等でもある(83.3%対 78.9%)。まだ実験的な機能で、コードはrv-store ブランチにあり、モデルはHugging FaceとModelScopeで公開している。
制約と今後
Qwenputer はあくまで実験なので、制約もいくつかある。追加レイヤーと広い隠れ次元のせいでチェックポイントは 18.8 GB になり、ベースの Qwen のほぼ 2 倍だ。ただしその大半はゼロパディングである。また、ファームウェアを起動し、トレース用トークンを Qwen のレイヤーに入れないようにする小さなドライバ(RvChat)が必要で、まだ素の generate() 呼び出しでは動かない。速度もやや遅く、CPU の命令 1 つにデコード済みトークンが数個かかるため、大きな計算にはミリ秒ではなく秒単位の時間がかかる。ベンチマークに使ったバッチ実行器は、L4 上で毎秒約 3,200 CPU トークンを処理する。
次にやりたいのは、Qwen に Python を書かせ、それを自身の重みの中にある MicroPython 上で実行させることだ。calc と同じように動く python() ツール経由で行う。CPU を速くするのも大きな課題の一つである。
算術の枠を超えて
RNN 層を正確に制御できると、算術以外にもかなり多くのことに役立つ。Qwenputer は AI 安全性研究のテストベッドとしても非常に使いやすい。続編を 2 本書いた。Qwen 3.5 のようなハイブリッドモデルが推論を RNN 状態に隠して CoT 監視を回避する方法と、コンパイル済みの重みを監視可能性のツールとして使う方法だ。モデルが切れない重み内蔵のモニターや、解釈可能性のための解答キーとして機能する。
試してみる
自分で動かしたいなら、モデルは 24 GB の GPU 1 枚で動く。uvとHugging Face CLI が必要だ。計算用のツールサーバーや Python サンドボックスは不要で、CPU がモデルの内部で計算を実行する。
git clone https://github.com/divagr18/qwenputer && cd qwenputer/experimental/riscv && uv sync --extra hf
hf download divagr1925/Qwen3.5-4B-Qwenputer --local-dir qwenputer-rv
uv run python -m chipformer.rv.chat qwenputer-rv --firmware tests/data/rv/calc-bridge.elf \
--ask "Use calc: what is 123456789 * 987654321?"すべてオープンだ。コードは GitHubに、両モデルはHugging Face(Qwenputer、Filesystem)とModelScope(Qwenputer、Filesystem)にある。
仕事で使うなら、次のように引用してほしい。
@software{agrawal2026qwenputer,
  author  = {Agrawal, Divyansh},
  title   = {{Qwenputer}: a computer compiled into the weights of a pretrained language model},
  year    = {2026},
  url     = {https://github.com/divagr18/qwenputer}
}
Footnotes
-
Gated DeltaNet の各ヘッドは状態行列、つまりメモリを保持する。トークンごとに、新しいものを書き込む前に状態全体へゲートを掛ける。ゲートは 0 から 1 の数値だ。これが RNN の忘却の仕組みで、ゲートが 0.9 なら保存されたものはトークンごとに少しずつ薄れ、1 なら何も薄れない。 ↩
-
ゲートの後、ヘッドは状態のある方向を新しい値へ向けて押しやり、書き込みの強さ beta がその距離を決める。beta が 1 なら、その方向の古い値は混ぜ合わされず完全に置き換わる。 ↩
-
one-hot キーは 1 つだけ 1 が入ったゼロのベクトルで、状態のちょうど 1 行を指す。メモリアドレスが 1 つのセルを指すのと同じだ。 ↩
-
Imanol Schlag, Kazuki Irie and Jürgen Schmidhuber, "Linear Transformers Are Secretly Fast Weight Programmers", ICML 2021. ↩
-
フリーランニングとは、CPU が実行全体を通して自身の出力だけを頼りに動き続けることで、途中で参照マシンによる修正は入らない。 ↩