世界モデルを Pico 2 W に載せる、2 つの小さなネットワークが夢の中でゲームを遊ぶ
26k〜131k パラメータのループ型 Transformer が次のフレームを予測し、9k〜16k の MLP が行動を選ぶ。どちらも Raspberry Pi Pico 2 W の同じコアで動く。5 つのゲームで完全に一致したフレームは 83.6% から 100%。学習、量子化、デコードの規則も公開されている。
日本語
コピー
どのフレームも、小さなループ付き transformer が生成する。現在のフレームと行動を入力に取り、次のフレームと報酬を予測する。もう一つ、さらに小さなネットワークが各フレームを見て行動を選ぶ。どちらも Raspberry Pi Pico 2 W に収まる。
エージェントは事前学習済みだが、その場で学習することもできる。ゼロから始めて、夢の中でプレイしながら上達する新しい stream-x エージェントだ。
ボード上で
同じ二つのネットワークを、Display Pack を付けた Raspberry Pi Pico 2 W で動かしている。ワールドモデルと actor は同じコアで動く。
二つの小さなネットワーク
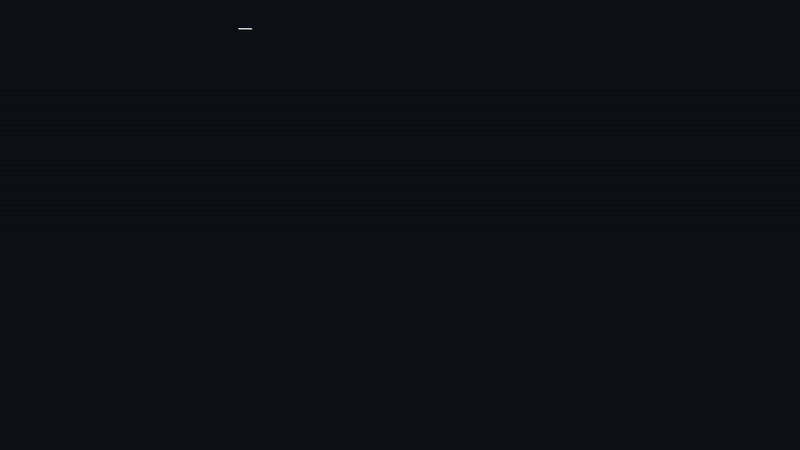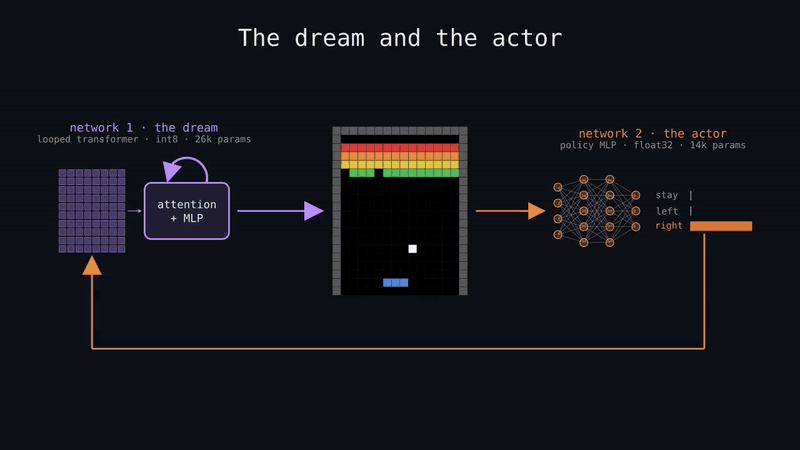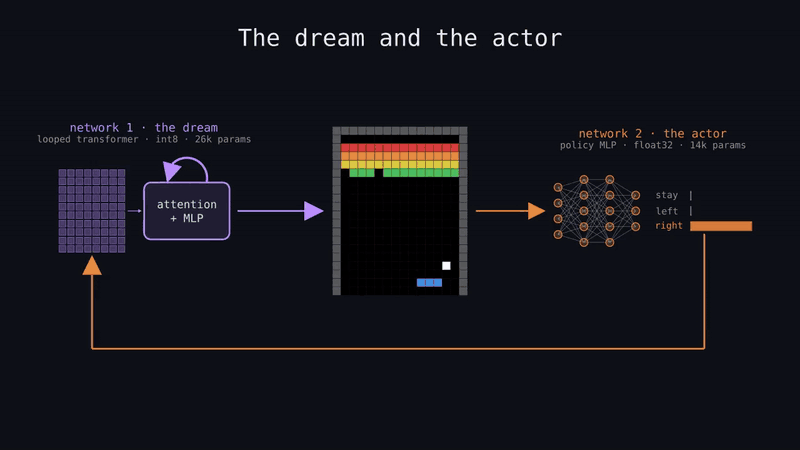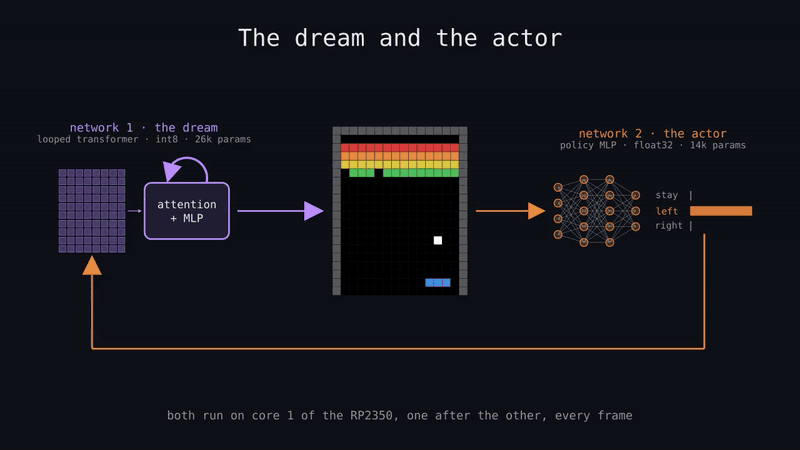
| ネットワーク 1: ワールドモデル | ネットワーク 2: actor | |
|---|---|---|
| 役割 | フレーム + 行動 → 次のフレーム + 報酬 | フレーム → 行動 |
| アーキテクチャ | ループ付き transformer、q int8 | 隠れ層二つの MLP、float32 |
| サイズ | 26k〜131k パラメータ | 9k〜16k パラメータ |
| フレームあたりのコスト | 2〜8M 回の積和演算 | 9k〜16k 回の積和演算 |
| 学習 | 記録した実ゲームで(下記) | stream-x で、実ゲーム内または夢の中で(下記) |
サイズはゲームによる。学習できるようになるまでにより多くのパラメータを必要とするゲームもあり、パラメータ数はなるべく小さく抑えるようにした。
チップ上ではどちらのネットワークも実ゲームを一切使わない。actor が見るのはワールドモデルが生成したフレームだけで、ワールドモデルが受け取る行動は actor からのものだけだ。どちらも RP2350 のコア 1 で動き、コア 0 が USB とディスプレイを担当する。
事前学習済みの actor は、ボード上でゼロから学習する新しい stream-x エージェントに差し替えられる。ボタンを押せばいつでも操作を引き継げるので、自分で夢をプレイできる。
ゲーム
各ゲームは src/tinyworldformer/games/ にある数百行の numpy だ。トークン id の小さなグリッドに描画され、1 フレームにゲームの状態がすべて収まる。そのため隠れた状態はフレームに描き込む必要がある。ボールの進行方向はそのトークンの一部であり、Doom-lite にはミニマップがある。
| ゲーム | フレーム | ルール | ランダムイベント | ワールドモデル | 完全一致フレーム(2 ループ) |
|---|---|---|---|---|---|
| Breakout | 20×16 | パドル、ボール、レンガ 56 個、残機 5 | ミス後のサーブ | 26k パラメータ、4.3M MACs | 99.99% |
| Doom-lite | 32×32 | 8×8 迷路をレイキャストした一人称視点。敵が最短経路で迫ってくるので撃つ | 敵のリスポーン | 55k パラメータ、4.2M MACs | 83.6%(下記参照) |
| Flappy Bird | 24×24 | 重力、フラップ、スクロールするパイプ | 次の隙間の高さ | 46k パラメータ、2.0M MACs | 100% |
| Pong | 20×32 | 反応の遅い CPU パドルと対戦、5 点先取 | 得点後のサーブ | 46k パラメータ、2.3M MACs | 99.45% |
| Pac-Man lite | 48×48 | 23×21 迷路、ペレット 249 個、最短経路で動くゴースト 2 体、残機 3 | ゴーストのリスポーン | 131k パラメータ、8.2M MACs | 86.4% |
「完全一致フレーム」は、ホールドアウトした遷移のうち、予測フレームの全セルが実ゲームと一致した割合。ランダムイベント直後のフレームは除外している。これらは予測できず、サンプリングするしかないため除外している。Doom-lite の 3D ビューは 768 セルあり、壁のピクセルが 1 つ陰影でずれただけでフレーム全体が不正解になる。そのため数値は実際のプレイ感より悪く出ている。ゲーム状態自体はほぼ常に正しい(「ワールドモデルの検証」を参照)。
本物のゲームはターミナルで遊べる: uv run python -m tinyworldformer.games.play --game pacman(または breakout、doomlite、flappy、pong)。
ワールドモデルの仕組み
フレームはトークンに分かれる
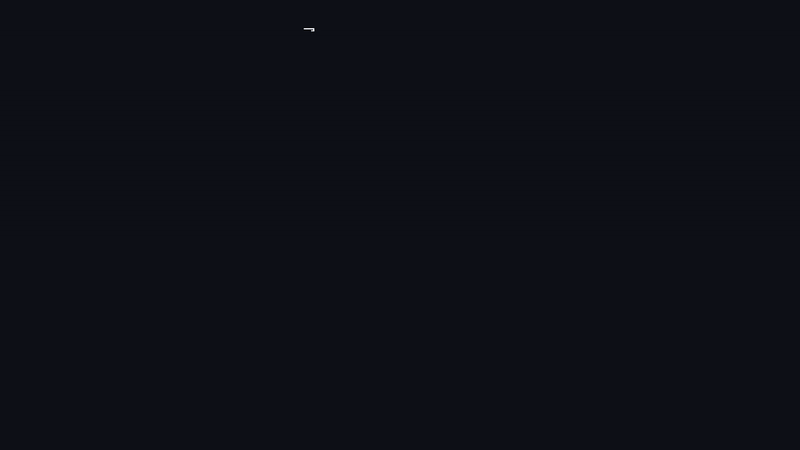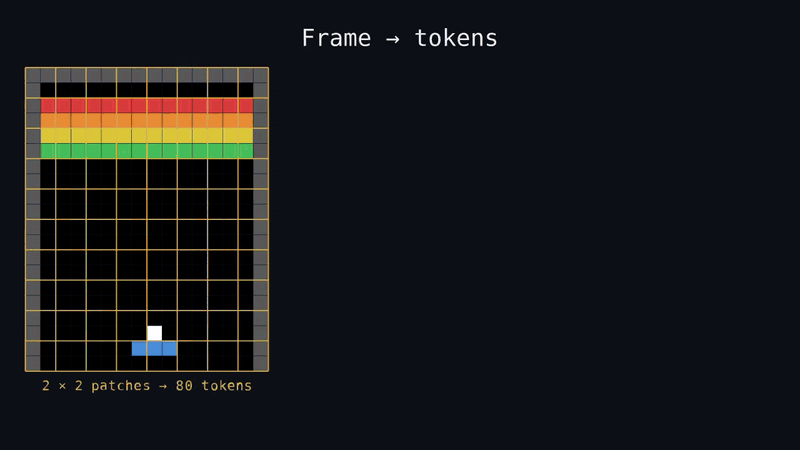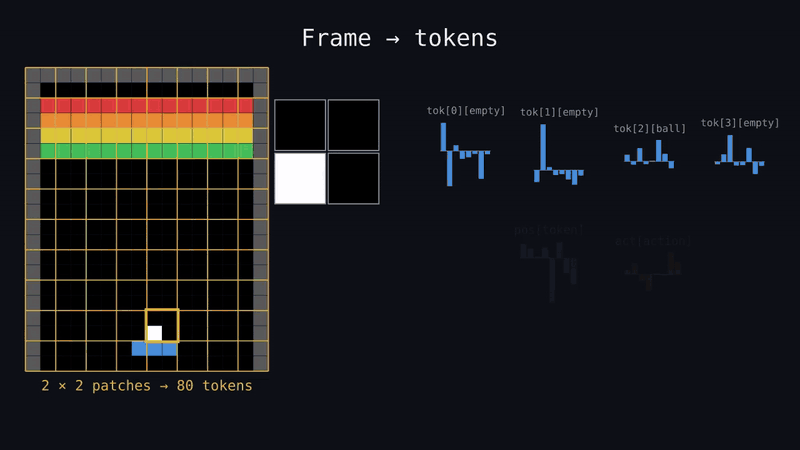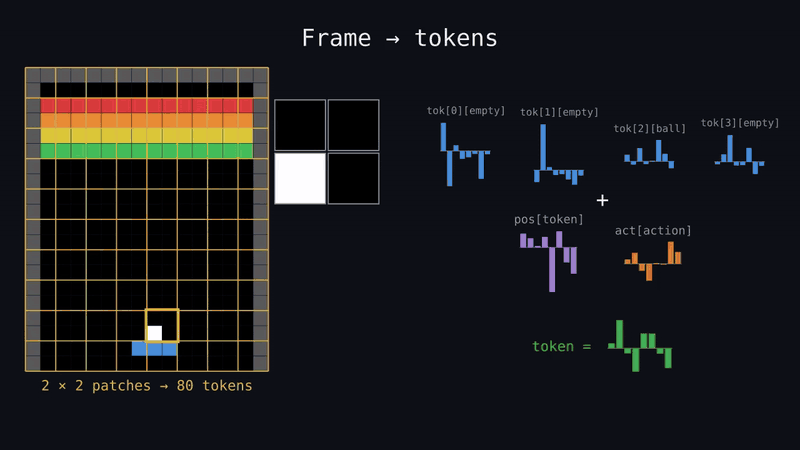
フレームは正方形のパッチに切り分ける。Breakout では 2×2 セル、Doom-lite、Flappy Bird、Pong では 4×4 セル、Pac-Man では 6×6 セル。1 ゲームあたり 36〜80 トークンになる。パッチの埋め込みはセルごとの学習済みベクトルの和で、パッチ内の位置ごとに別のテーブルを使うのでセルの順序は失われない。各トークンには位置ベクトルとアクションのベクトルも加わる。
ループする Transformer
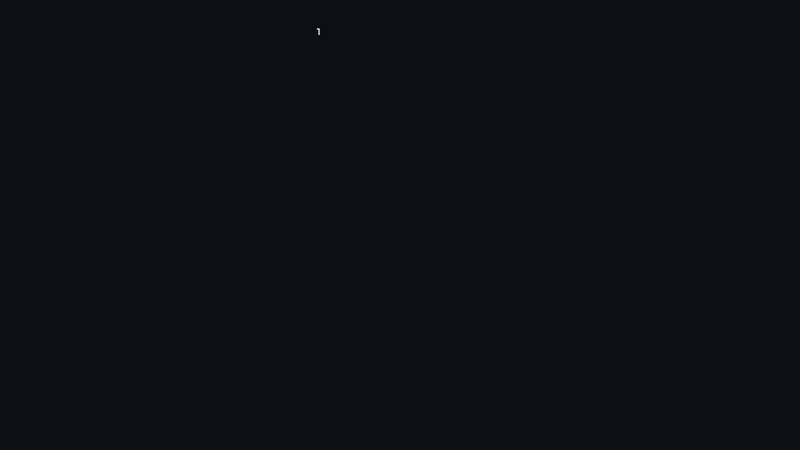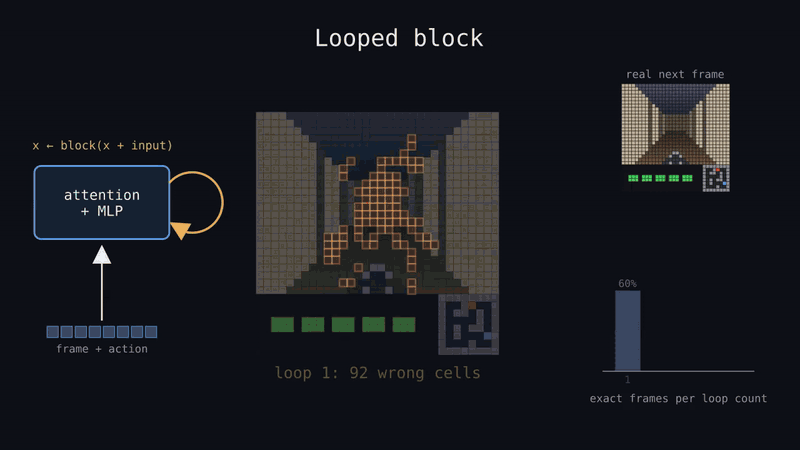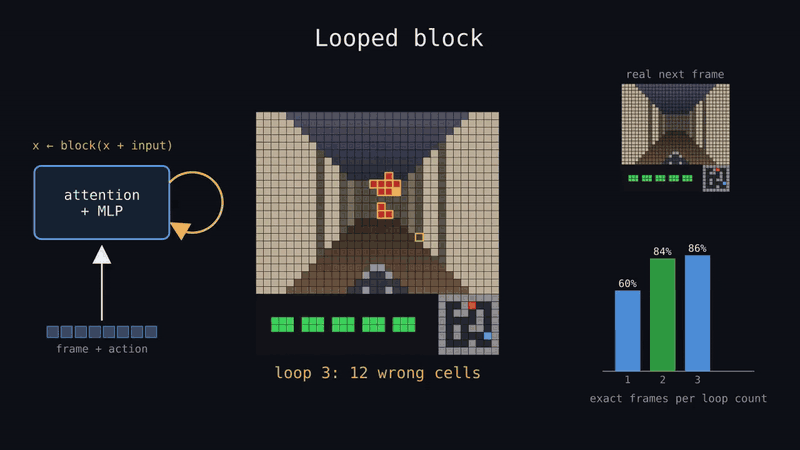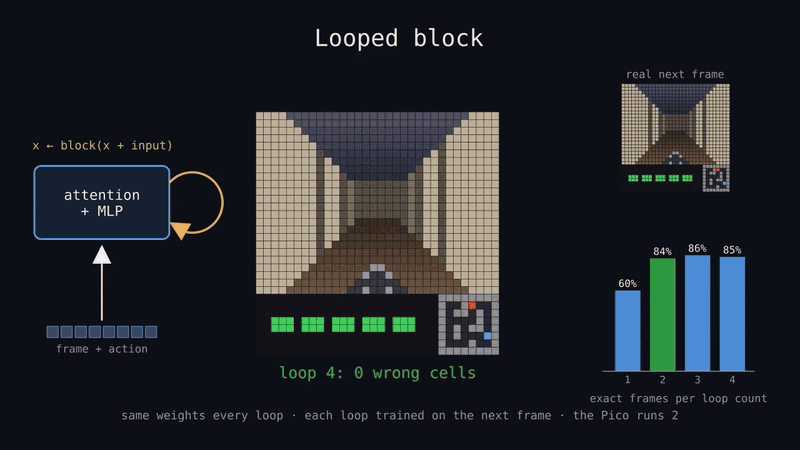
モデルは 1 セットの重みを持つ単一の Transformer ブロック(attention と ReLU MLP)で、これを 1〜4 回適用し、各パスの前に必ず入力を足し戻す。各パス後の出力は次のフレームに対して学習させるので、実行時はループ回数で速度と精度を交換できる。Pico でそこそこのフレームレートを保つため、2 ループを使っている。
アニメーションは、学習に使っていない Doom-lite の 1 ステップを表している。1 パス目では存在しない敵を描いてしまい、パスを重ねるごとにそれが削れていく。誤ったセルは 92、35、12、そして 0 になる。右側のバーは、ループ回数ごとに学習対象外のフレームを完全に再現できた割合だ。
1、2、3、4 ループでデコードした、夢の中で生成された Doom-lite のステップを示す。実際のルールと異なるセルには赤枠を付けた:
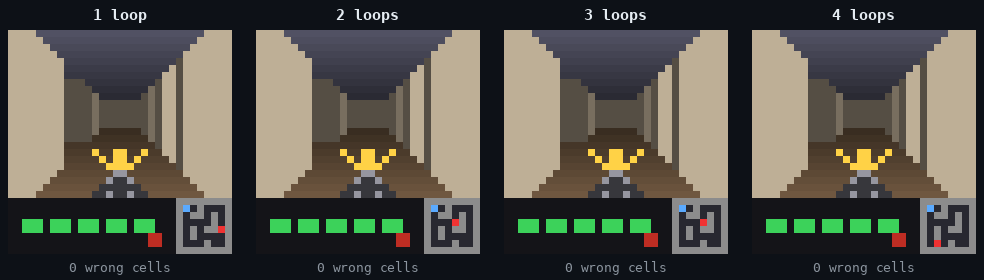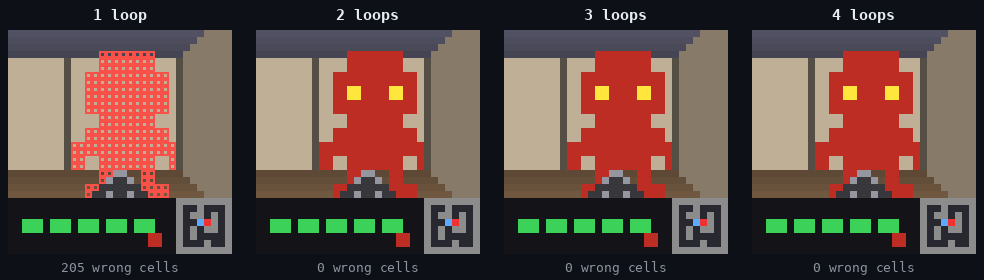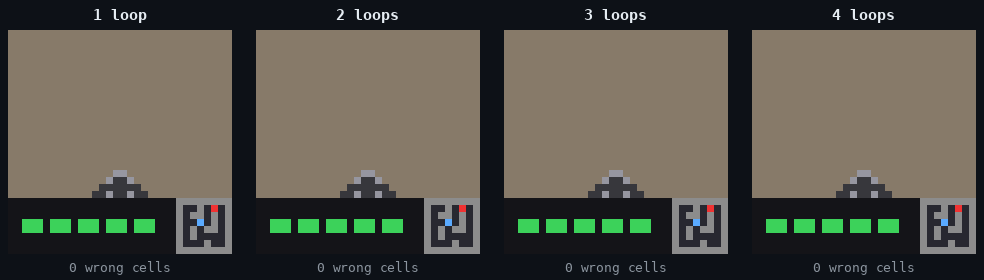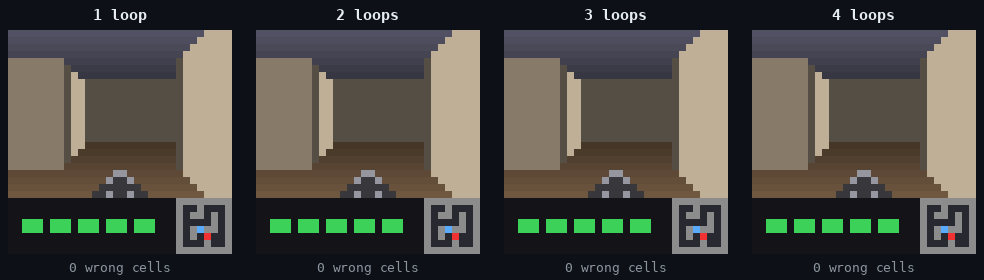
ループ回数ごとの、学習対象外フレームの完全再現率:
| ループ | Breakout | Doom-lite | Flappy Bird | Pong | Pac-Man |
|---|---|---|---|---|---|
| 1 | 99.68% | 59.8% | 99.99% | 98.47% | 79.6% |
| 2 | 99.99% | 83.6% | 100% | 99.45% | 86.4% |
| 3 | 100% | 85.9% | 100% | 99.60% | 85.7% |
| 4 | 99.96% | 84.7% | 100% | 99.53% | 84.4% |
デコード
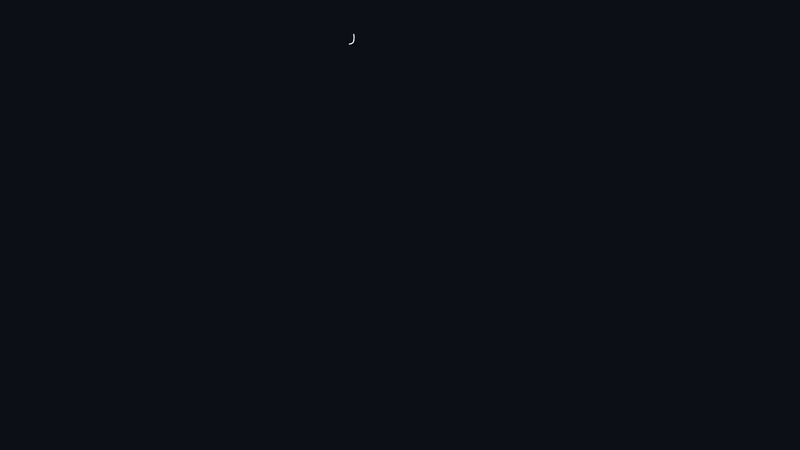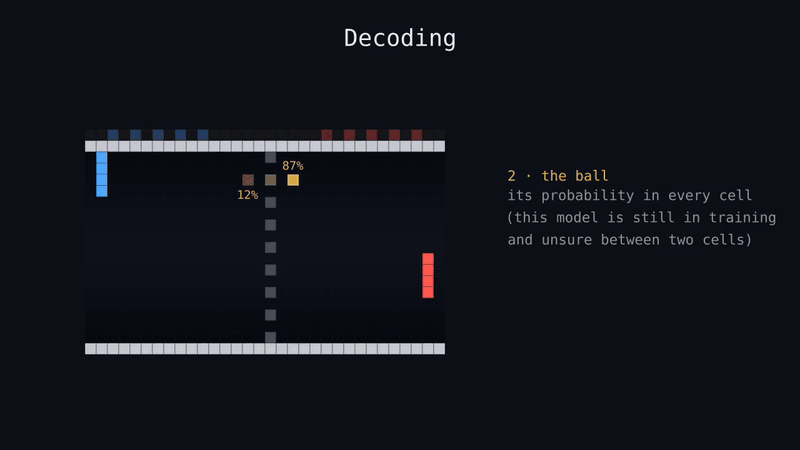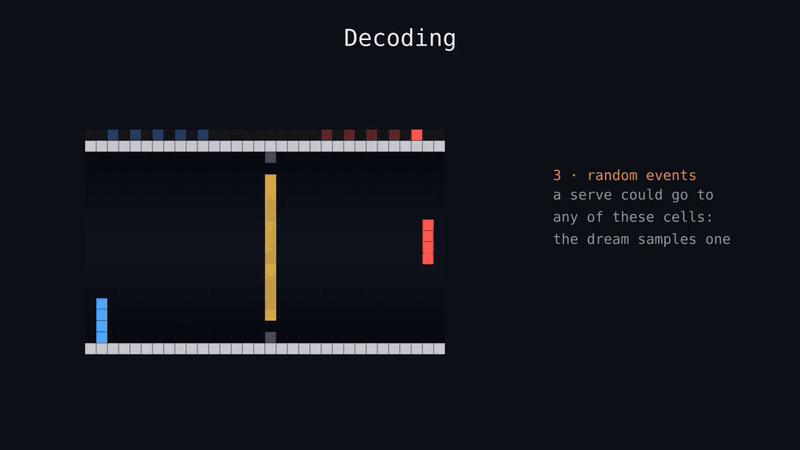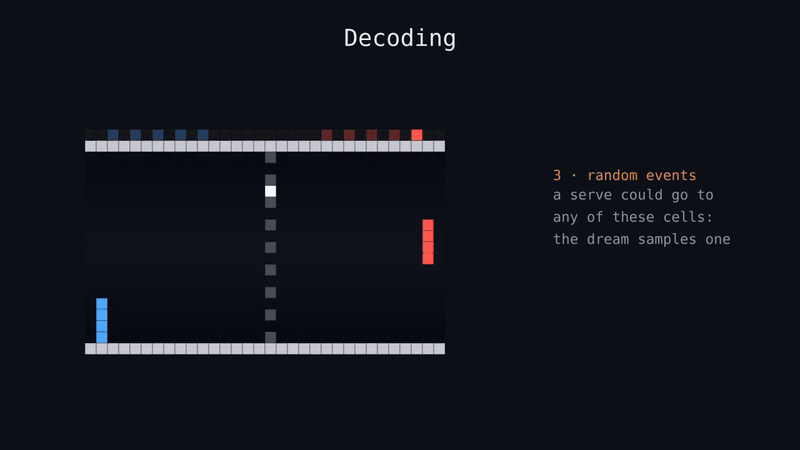
モデルはすべてのセル、すべてのトークンについてスコアを出力する。そのスコアをフレームに変える処理は、モデルとほぼ同じくらい重要だった。最終的に 3 つのルールに落ち着いた(上の Pong の例):
-
背景セル(壁、ブロック、ペレット、床)はそれぞれ独立に、最も確率の高いトークンを取る。
-
1 つだけ存在するスプライト(ボール、プレイヤー、各ゴースト)は、(セル, トークン) の全ペアに対する 1 回の選択で配置する。これによりそれぞれが常にちょうど 1 つ存在する。ランダムイベントの後は、最良から 2.2 logits 以内の候補から選択をサンプリングする。ワールドモデルが新しいサーブやリスポーンを平均化するのではなく、サンプリングできるようにするためだ。
-
Pac-Man とゴーストは 2×2 のスプライトだが、状態を持つのは各 1 セルだけだ(口は向きを保持し、ゴーストの左下セルは下にペレットがあるかどうかを保持する)。残りの 3 セルは予測せず、そのセルからスタンプする。
ルール 2 を実装したのは、最初の Breakout モデルがボールを 2 つ同時に描いてしまったからだ。1 回の大域的な選択で、完全一致フレームは 91.6% から 99.7% に上がった。
ワールドモデルの検証
記録済みデータでの精度だけでは足りない。エージェントは夢の中の世界をデータに存在しなかった状態へと進め、そこで起きた誤りはいくらでも利用できる。だから主な検証はエージェントがプレイしている間に走らせる。夢のフレームからゲーム状態を読み戻し(games/<game>.py: read)、その状態とエージェントの行動に本物のルールを適用し、結果を次の夢のフレームと報酬と突き合わせる。
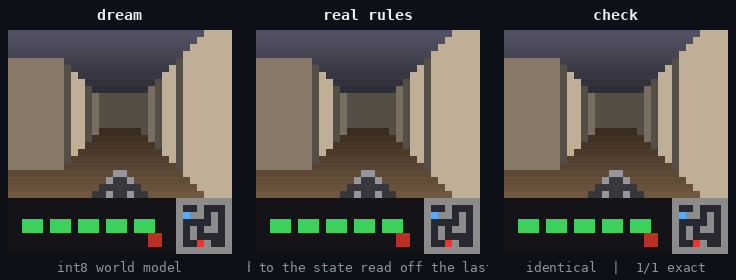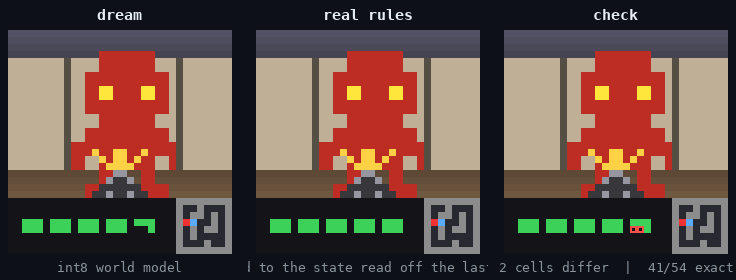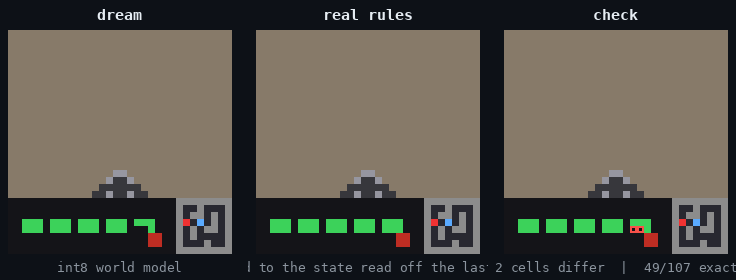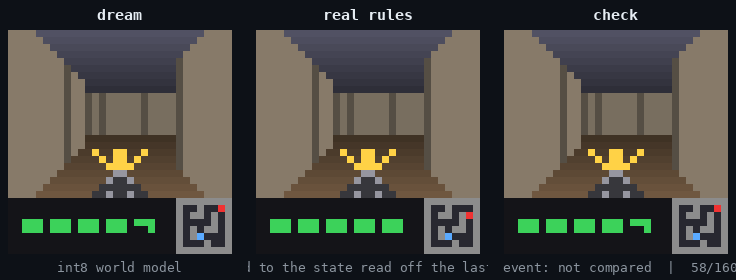
1 ゲームあたり夢のステップ 5,000 回、ループ 2 回、出荷時のエージェント(training/evalwm.py --agent)で:
| ゲーム | 誤ったゲーム状態 | 誤った報酬 | 1 ステップあたりの誤セル数 |
|---|---|---|---|
| Breakout | 読み戻しなし、あり得ないトークンを含むフレームは 0 | 6(ブロックを壊さずに支払い) | – |
| Doom-lite | 1 | 0 | 1.50 |
| Flappy Bird | 0 | 0 | 0.00 |
| Pong | 1 | 0 | 0.00 |
| Pac-Man | 742 | 38 | 0.39 |
トレーニング
まずエージェントに本物のゲームをプレイさせ、各ステップを 1 つの例(フレーム、行動、次のフレーム、報酬)として記録する。1 ゲームあたり 100 万〜300 万件。エピソードの一部は穴の空いたブロックやランダムな位置といった普段と違う状態から始め、データがゲームのより広い範囲をカバーするようにする。
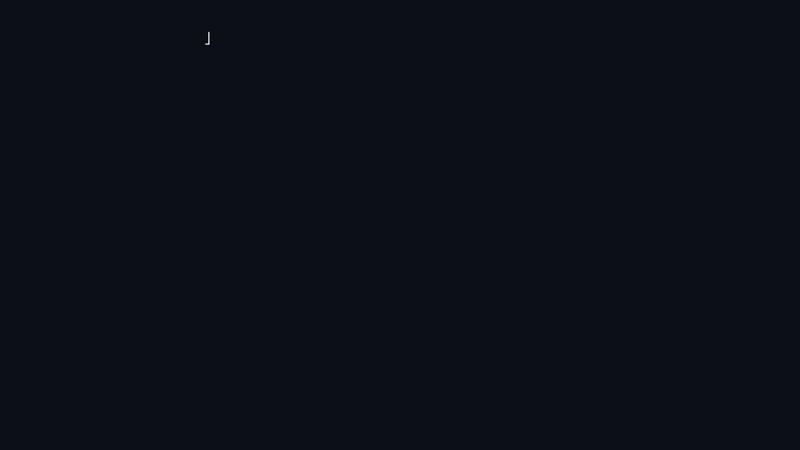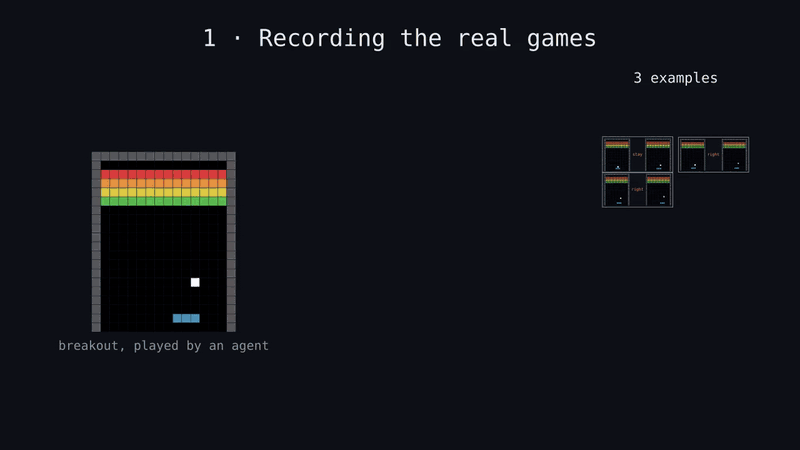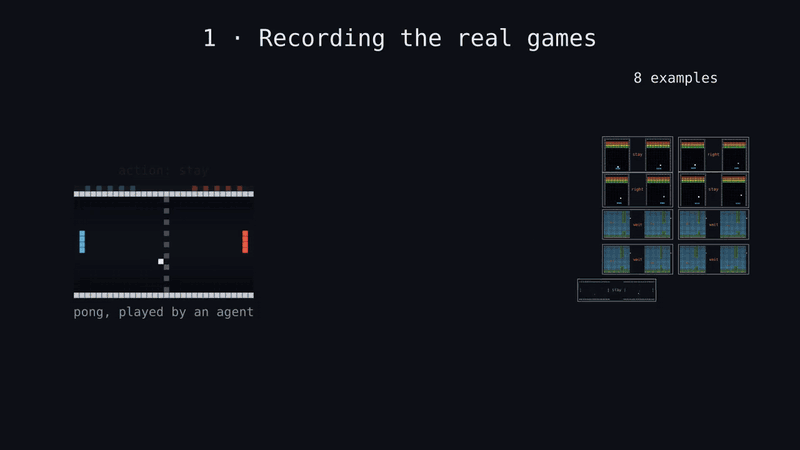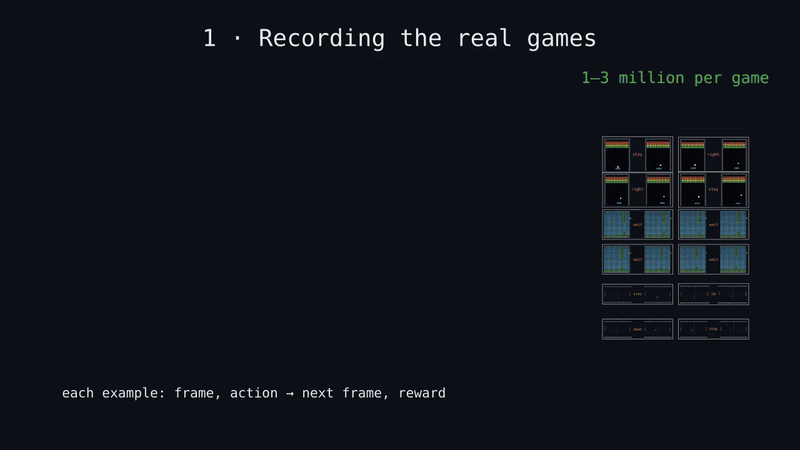
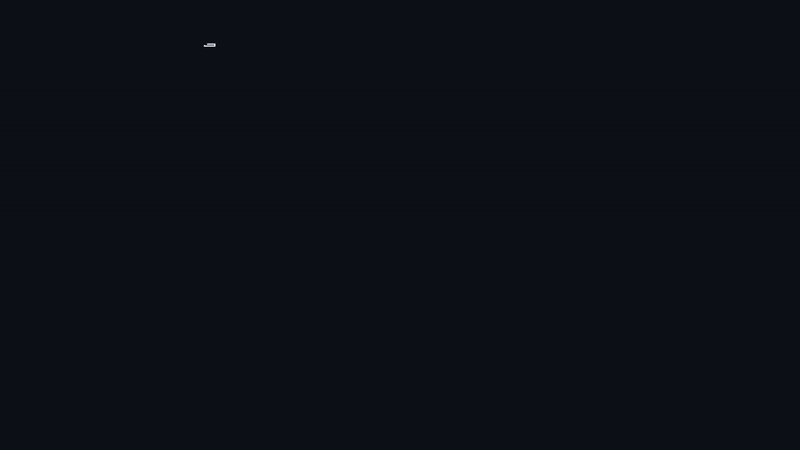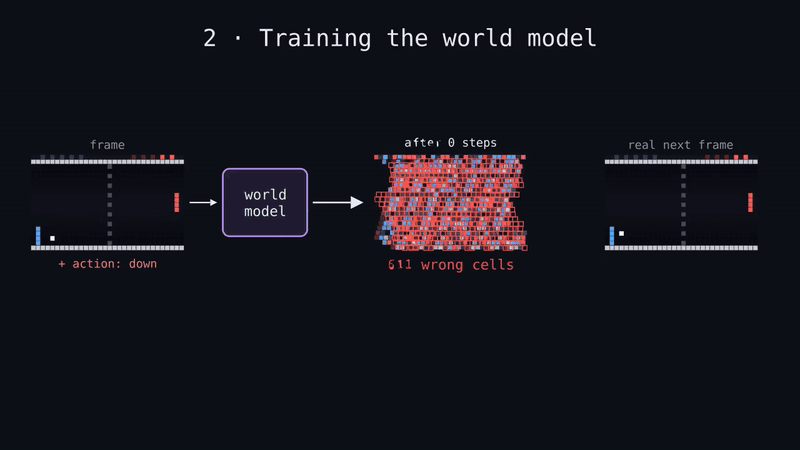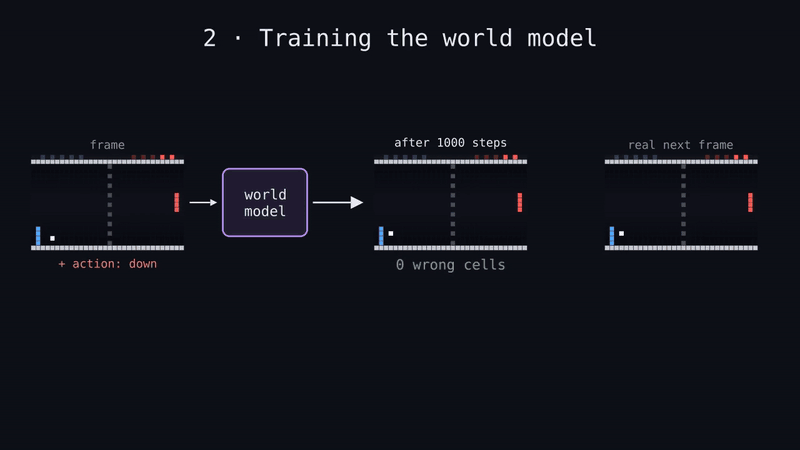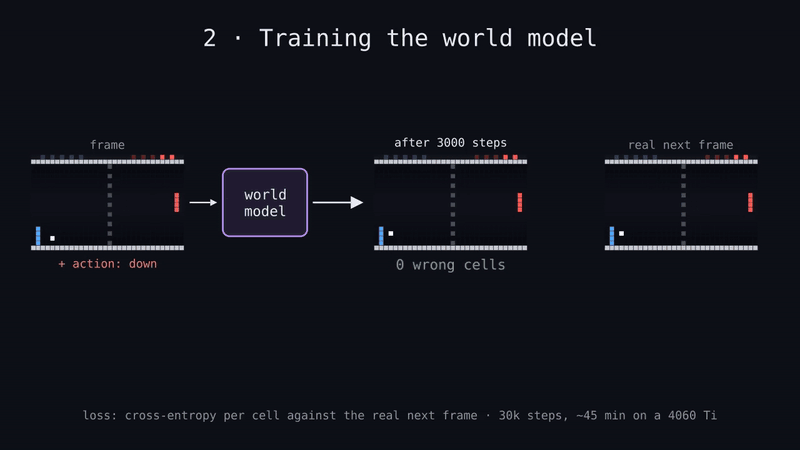
次に世界モデルがセルごとの交差エントロピー損失で次のフレームを予測できるよう学習する。30k ステップで、最初の 3〜4k ステップは float で実行し、その後 int8 の丸めを有効にする(QAT)。
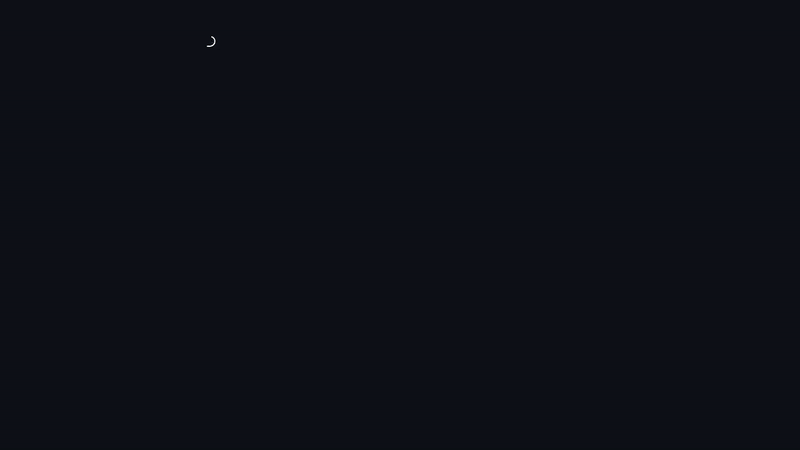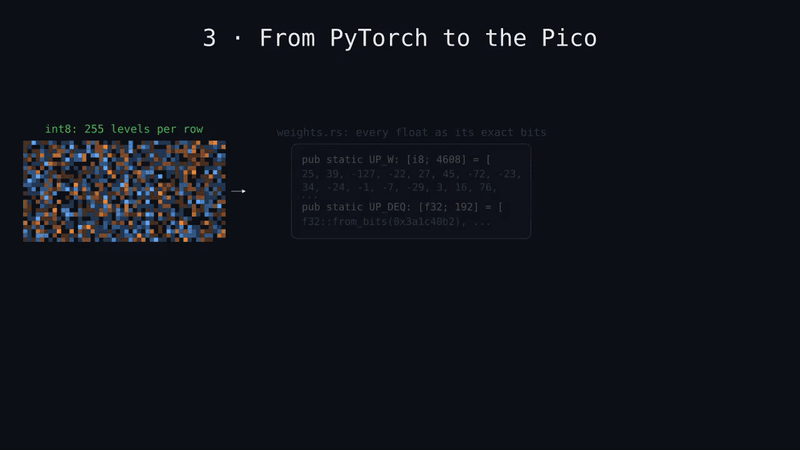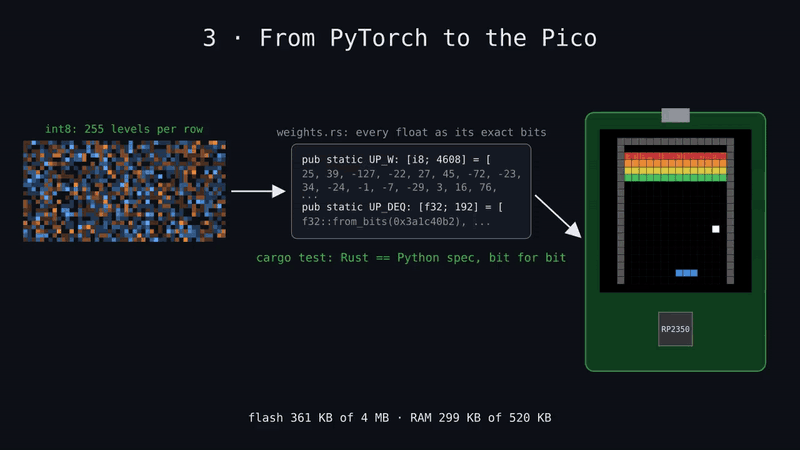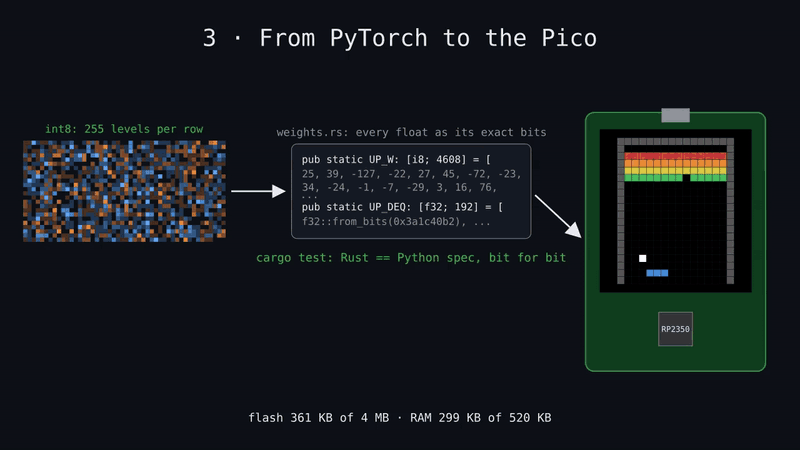
int8 の重みは、すべての float を正確なビット列のまま Rust のソースに書き出す。cargo test で検証し、Rust が Python の整数仕様をビット単位で再現することを確かめてから、ファームウェアを Pico で動かす。
世界モデルで学習したエージェントは記録データに存在しなかった状態に到達する。だからそのエージェントで本物のゲームを記録し、すべてのデータで世界モデルをファインチューニングする。
いろいろなゲームでエージェントがその穴を突くようになったので、修正の一部を挙げておく。
-
「このセルが変化した」で損失に重みを付けると、モデルが変化を予測する方向に偏り、ボールを 2 個描いてレンガを 2 個壊すようになった。入力フレーム上で変化が起こりうる場所に重みを付け、さらにグローバルな単一選択を組み合わせることで直った。
-
ワールドモデル内の Breakout エージェントが、レンガを 26 個残したまま 154 点を取った。角のレンガに当たってもワールドモデルがそれを消さなかったためだ。Doom-lite のエージェントは 5 セル離れた位置から狙撃することを覚えた。
-
ドリーム内だけで訓練したエージェントはそこで 210 点(実際の最大値は 56)、実ゲームでは 28 点だった。World Models(Ha & Schmidhuber)の予測どおりだ。収集とファインチューニングを 1 ラウンド行うたびに、そのエージェントが見つけた穴はふさがった。
-
Doom-lite のドリームでは敵のスプライトがときどき消え、二度と描かれなくなった。モデルがミニマップから描き直さず、前のビューをコピーしていたからだ。ノイズによる拡張で直った(
train --noise 0.3、GameNGen と同じ)。入力ビューにランダムなピクセルが加わり、スプライトが消えることもある。 -
d=32はより広い Breakout のデータを吸収できず、d=48は吸収できた。Pac-Man の 48×48 フレームにはd=64が必要だった。
エージェント: stream-x
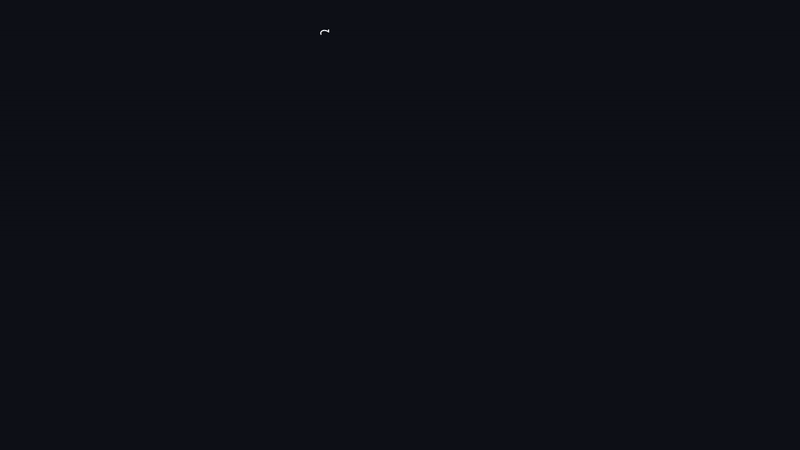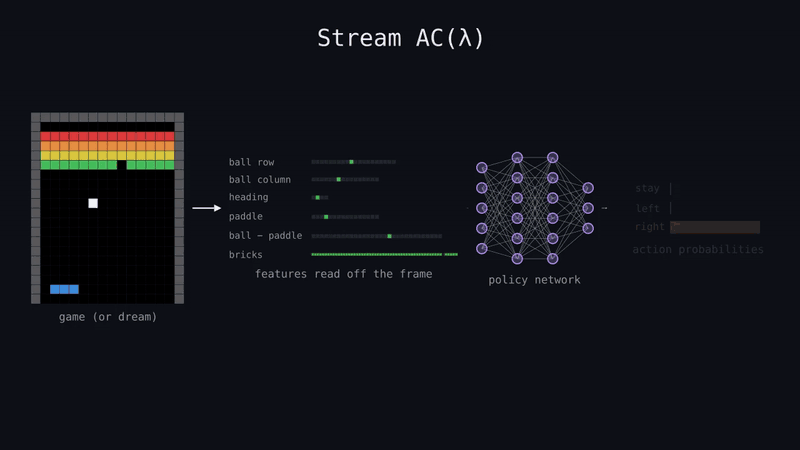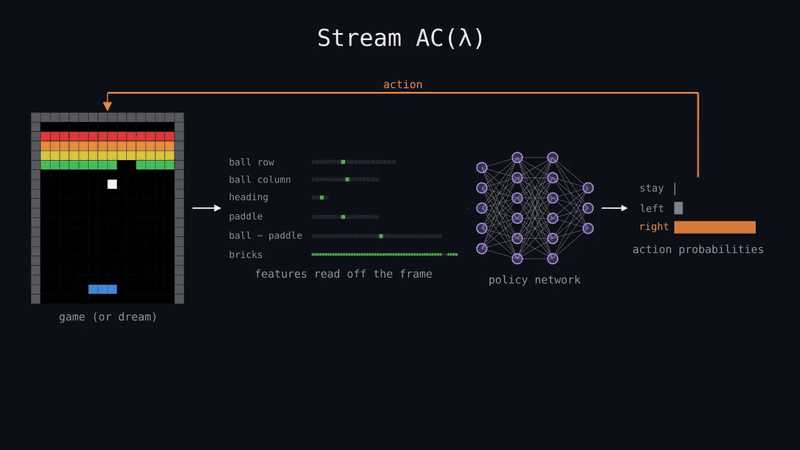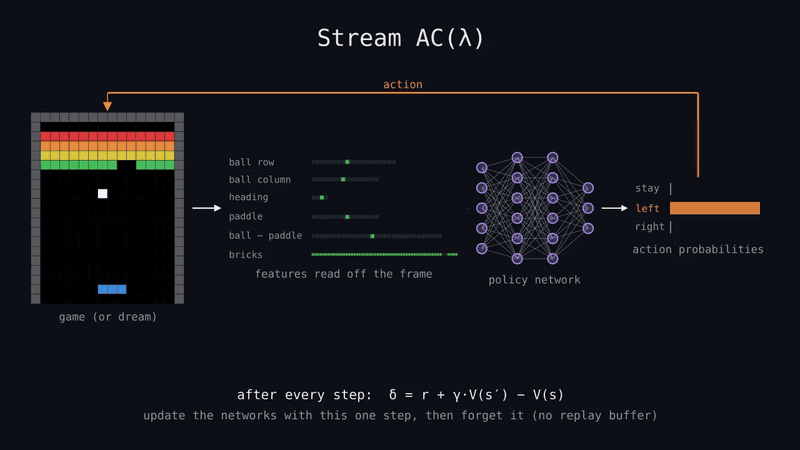
エージェントは Stream AC(λ)(Elsayed, Vasan & Mahmood, 2024)を使う。1 ステップずつ学習し、リプレイバッファもバッチもターゲットネットワークも持たない。適格度トレースが報酬を時間方向にさかのぼって伝え、ObGD が TD ターゲットを超えそうなステップを縮める。ポリシーと価値のネットワークはそれぞれ隠れ層 2 層、64 ユニット(Pico では 32)で、LayerNorm を入れる。
入力はフレームから読み取った特徴ベクトル(training/streamx.py: observe_*、Rust 版は tinyworldformer-rs/src/agent.rs)。たとえば Breakout ならボールの行・列・進行方向、Pac-Man なら方向ごとに最寄りのペレットまでの最短経路距離と各ゴーストの近さ。
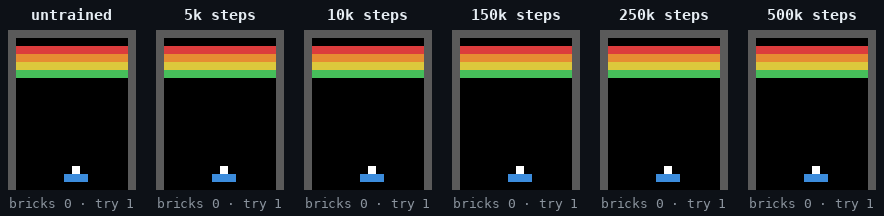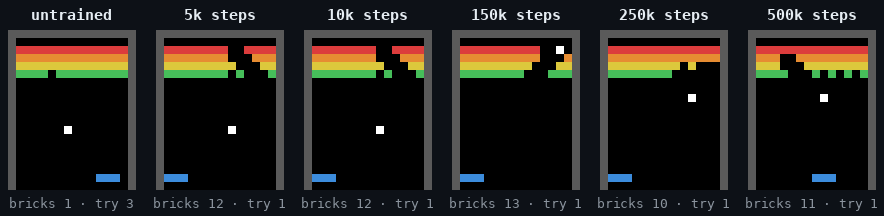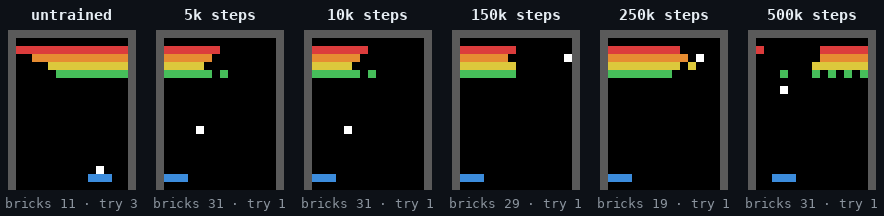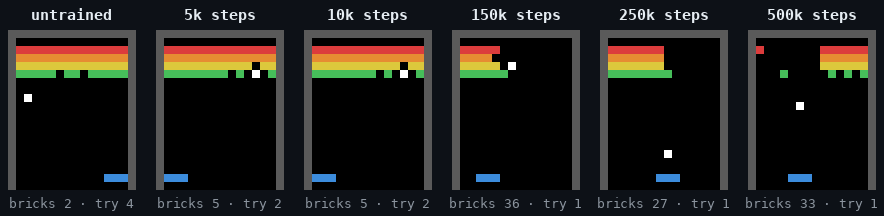
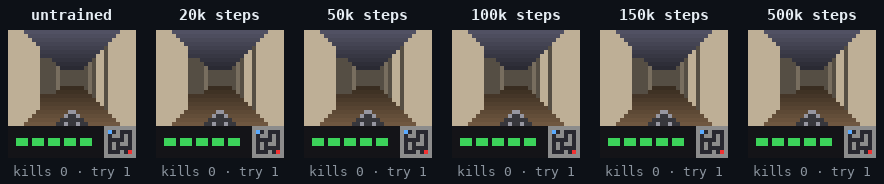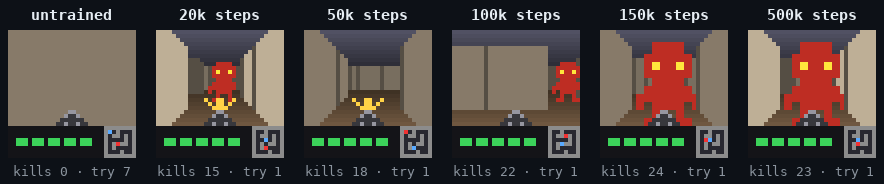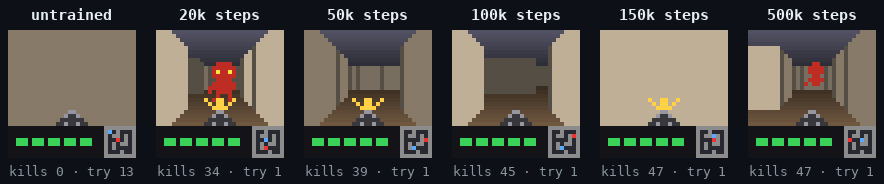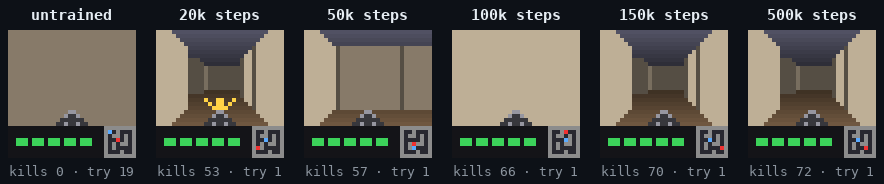
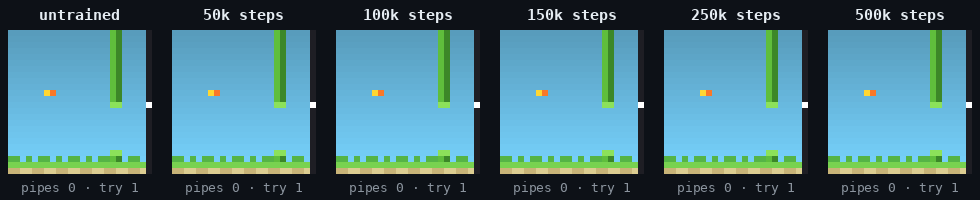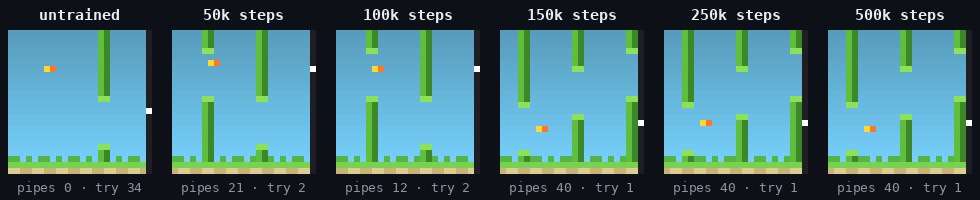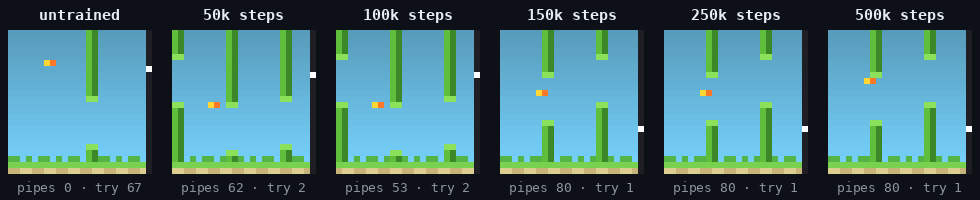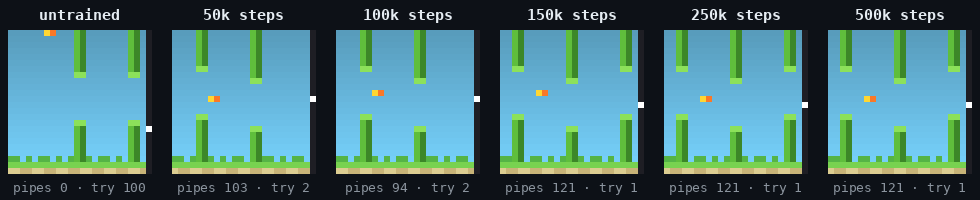
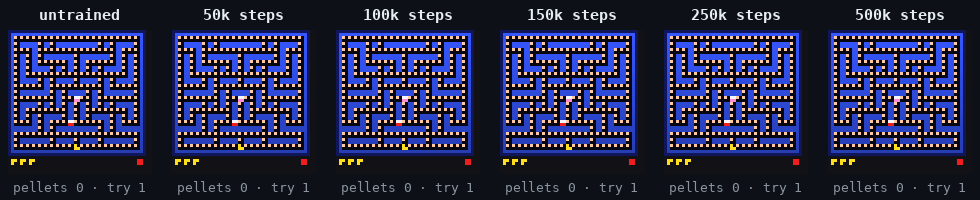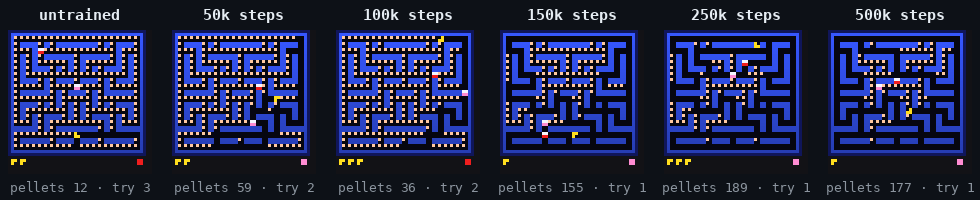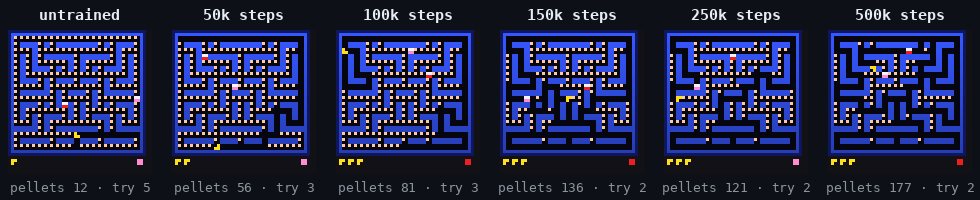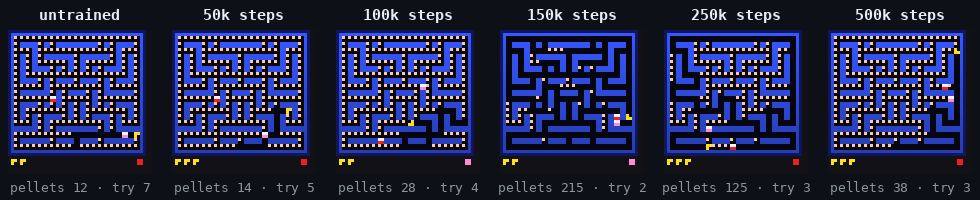
以下は各ゲーム 1 回の訓練(実ゲーム、50 万ステップ)を 6 段階で示したもの。未訓練、終了時点、そしてスコアが 25、50、75、95%に達した時点のスナップショットだ。各パネルは同じ開始状態から貪欲にプレイし、1 フレームあたり数ステップを飛ばしている。「try」はそれまでにプレイしたエピソード数なので、クラッシュの様子もわかる。
Breakout
Doom-lite
Flappy Bird
Pac-Man lite
Pong
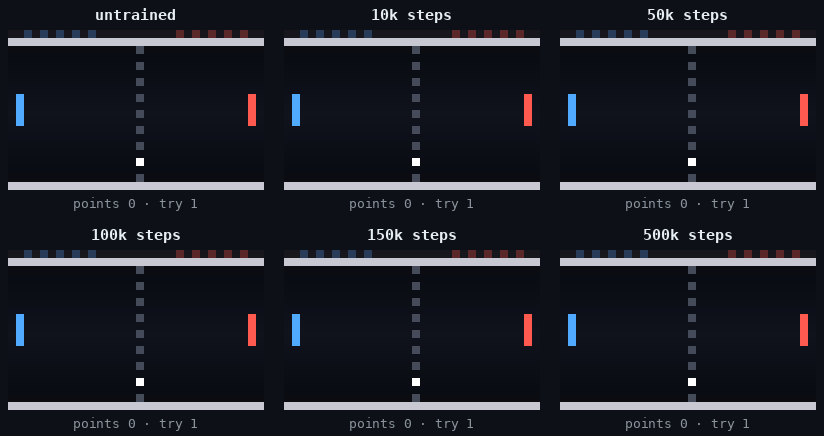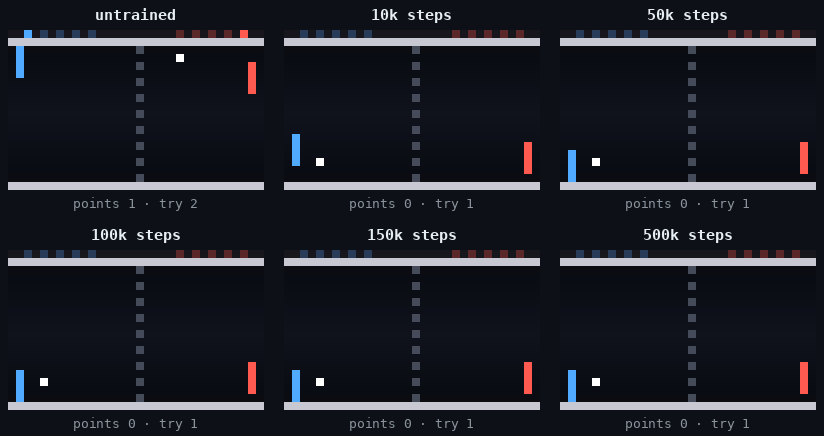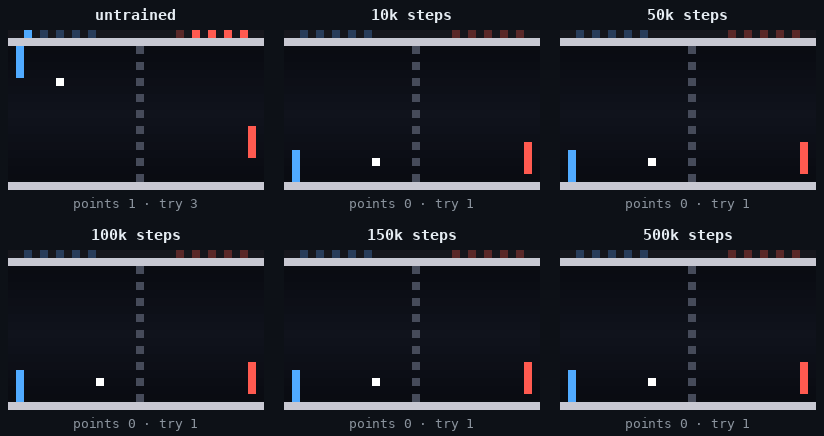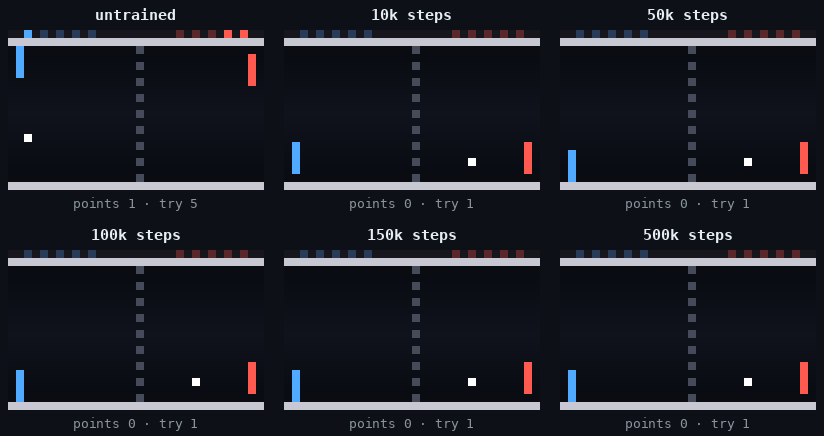
実ゲームでの greedy リターン。10 エピソードの平均を、同じ実行のスナップショットごとに示す:
| ゲーム | 0 | 1k | 2k | 5k | 10k | 20k | 50k | 100k | 150k | 250k | 500k | max |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Breakout | 8.2 | 17.0 | 15.9 | 21.9 | 29.9 | 29.9 | 29.9 | 31.1 | 35.0 | 39.9 | 45.6 | 56 |
| Doom-lite | −5.0 | −5.0 | −5.0 | −5.0 | −5.0 | 59.5 | 69.9 | 78.1 | 81.8 | 82.1 | 82.9 | – |
| Flappy Bird | −1.0 | −1.0 | −1.0 | 1.9 | 24.6 | 24.9 | 96.2 | 123.7 | 309.2 | 332 | 332 | 332 |
| Pac-Man | 7.0 | 3.8 | 17.0 | 17.7 | 8.2 | 46.8 | 72.9 | 138.9 | 146.6 | 190.3 | 217.4 | 249 |
| Pong | −4.3 | −3.9 | −3.9 | −3.9 | −1.7 | −2.0 | −0.3 | 1.1 | 1.7 | 1.1 | 1.1 | 5 |
shaping を入れないと、Doom-lite のエージェントは開始地点の隅に居座って撃ち続ける。敵は必ずこちらへ来るからだ。--idle-penalty 0.1 は、直近 20 ステップで 6 回より多く訪れたセルに 1 ステップ留まるごとに 0.1 のコストを課す。位置はミニマップから読み取るので、dream の中でもペナルティは効く。これを入れるとエージェントは巡回し、キル数は 2 倍になる。
tinyworldformer-rs/src/learner.rs は同じアルゴリズムを no_std Rust で書いたもので、逆方向のパスは手で実装している。PyTorch の 200 回の更新と 3.5e-6 以内で一致する。ホスト上では、Rust の int8 Flappy Bird dream の中に置いた新しいエージェントが、25k ステップ後に 1 エピソード平均 6 本、100k 後に 121 本、250k 後には 300 本以上のパイプを通過する。
量子化と Pico
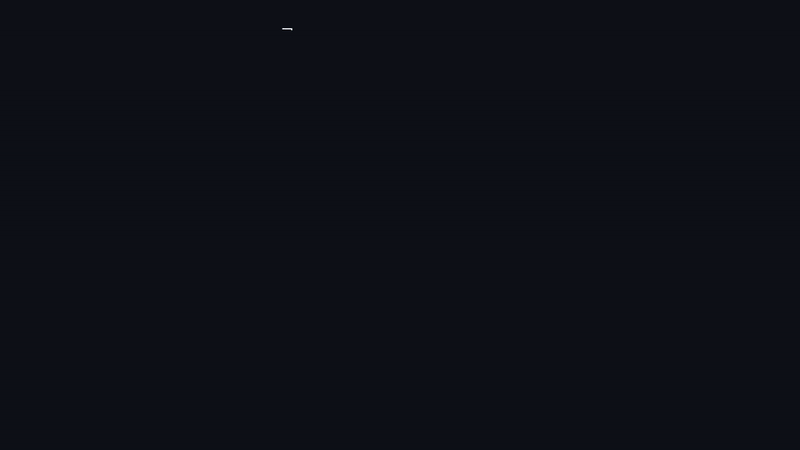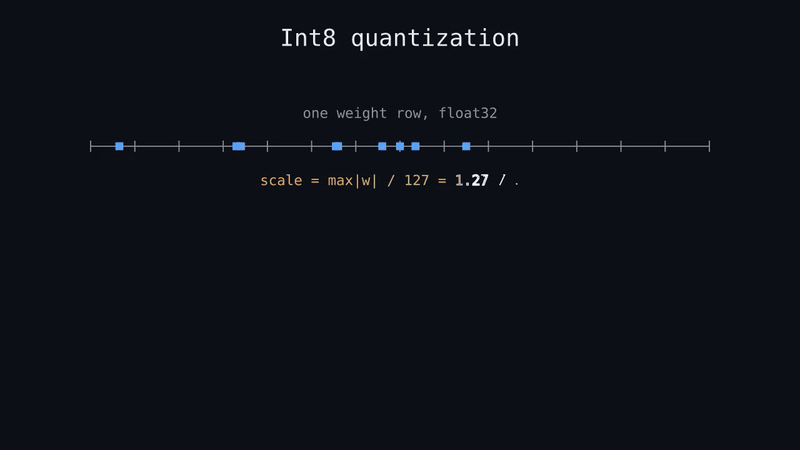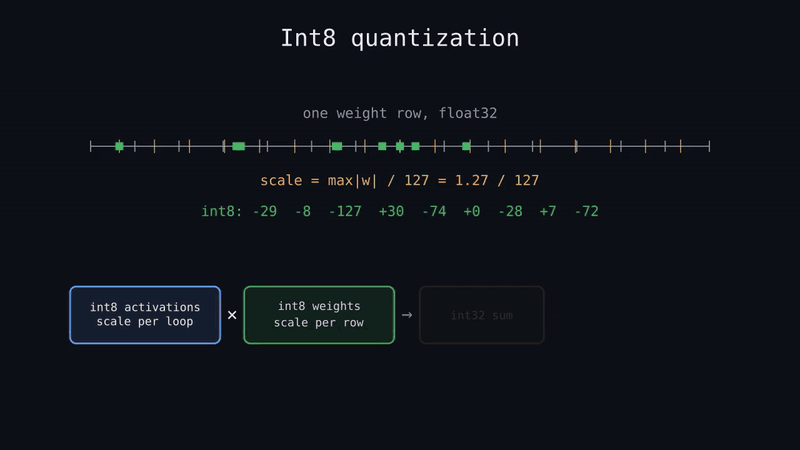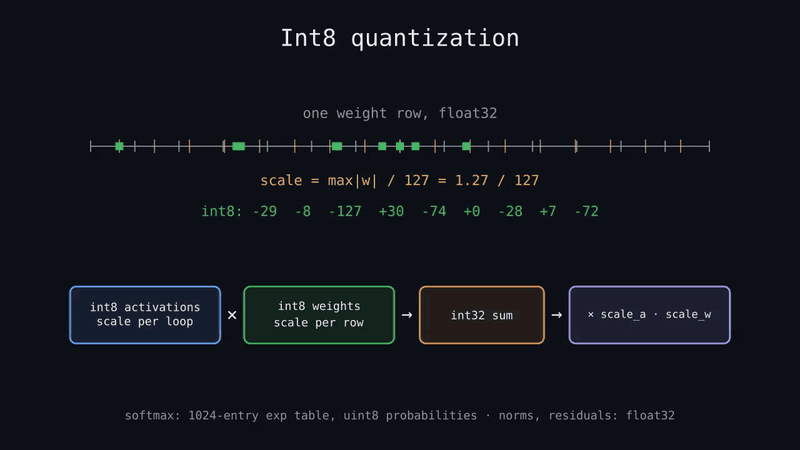
ワールドモデルの行列はすべて int8 で、出力行ごとにスケールを 1 つ持つ(scale = max|w| / 127)。アクティベーションも int8 で、テンソルごと、ループインデックスごとにスケールを 1 つ持つ。ループごとに値の範囲が変わるからだ。行列積は int8 × int8 を int32 に累積し(RP2350 では SMLAD 命令あたり 2 回の積和演算)、最後に 2 つのスケールを掛ける float 演算を 1 回行う。Softmax は 1024 エントリの exp テーブルを使い、確率は uint8 で保持する。ノルム、残差、埋め込みは float32 のまま。RP2350 には FPU がある。
学習時にも同じ丸めを適用する(straight-through estimator を使った QAT)ので、int8 モデルは学習されたモデルそのものである。rustexport/intref.py は numpy で書いた int8 モデルで、float 演算の順序をすべて固定してある。Rust エンジンはこれをビット単位で再現し、cargo test がエクスポートされたすべての env についてゴールデンベクタを検証する。
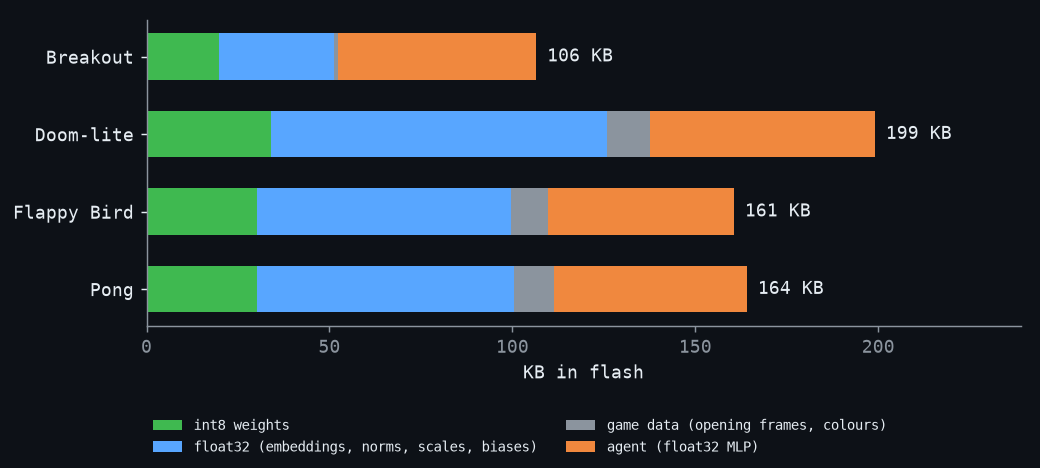
| ゲーム | int8 重み | float32(埋め込み、ノルム、スケール) | ゲームデータ | エージェント(float32) | ファームウェアのフラッシュ | ファームウェアの RAM |
|---|---|---|---|---|---|---|
| Breakout | 19.7 KB | 31.6 KB | 1.1 KB | 54.1 KB | 361 KB | 299 KB |
| Doom-lite | 33.9 KB | 91.9 KB | 12.0 KB | 61.3 KB | 471 KB | 357 KB |
| Flappy Bird | 30.1 KB | 69.5 KB | 10.1 KB | 50.8 KB | 409 KB | 227 KB |
| Pong | 30.1 KB | 70.4 KB | 10.9 KB | 52.6 KB | 414 KB | 244 KB |
フラッシュと RAM はファームウェアの ELF(size -A)から測定した値で、Display Pack ドライバ込みでビルドしているため、コード、USB、ディスプレイドライバ、オンデバイスの学習器を含む。Pico 2 W はフラッシュ 4 MB、SRAM 520 KB で、そのうち 512 KiB がメインメモリマップにある。最大の割合を占めるのは float32 の埋め込みテーブルで、これも int8 にできる。
src/tinyworldformer/rustexport/ は numpy と torch しかインポートしない(テストでそれを保っている)ので、エクスポートは他のプロジェクトでも再利用できる。rustexport.qat(QLinear、LoopedBlock)でモデルを組み、float でウォームアップしたあと ActQuant.enabled = True で学習し、rustexport.convert.looped_model で変換し、int_model_arrays、mlp_arrays、codegen.write_module で Rust のソースを書き出す。rustexport.Golden は Rust のテストが検証するベクタを書き出す。
チップ上で
ファームウェア(tinyworldformer-rs/firmware)は embassy を使った no_std Rust である。実行時のアロケーションは一切ない。重みはフラッシュ上の static 配列で、バッファはすべて RAM 上の固定サイズの static だ。
Core 1 がゲームを動かす。ループ 1 周(firmware/src/main.rs の dream_loop)が 1 フレームにあたる。
-
actor は現在のフレーム(
agent::observe)から特徴量を読み、MLP を走らせて押すボタンを選ぶ。オンデバイス学習が有効なら、学習エージェントが代わりに選ぶ。人間がボタンを押しているときは、その入力が使われる。 -
int8 transformer はフレームとボタンに対して 2 ループを回し(
Engine::forward)、デコードでそのスコアを次のフレームに変換する。セルごとの背景 argmax、単一スプライトを 1 回だけ配置(ランダムイベントは xorshift RNG でサンプリング)、続いてスプライトをスタンプする。報酬は報酬ヘッドの argmax。ライフとエピソード終了は、その上に乗るカウンタだ。 -
学習が有効なら、学習器はこの 1 遷移だけから更新し、その後は忘れる。
-
フレームは 2 スロットのチャネルを通じて core 0 へ渡る。core 0 がまだ前のフレームを処理中なら、このフレームは捨てられる。core 1 が画面を待つことはない。
人間がプレイするときは core 1 の速度を落として遊べる速さにする(1 フレーム 66〜150 ms、ゲームによる)。エージェントが動くときはチップが許す限りの速さで回る。
Core 0 はそれ以外のすべてを embassy の非同期タスクとして動かす。USB シリアルでは、各フレームがステータス行(モデル時間、actor 時間、fps、env 名とエージェント名)付きの色付き ANSI テキストとして送られ、キー入力が返ってくる。オプションの Display Pack(--features display)は SPI 接続の 320×240 ST7789 で、最大 62.5 MHz。前のフレームから変化したセルだけを再描画する。ボタンは 20 ms ごとにポーリングする。2 つのコアが共有するのはフレームチャネルとわずかなアトミック変数だけだ。誰がプレイしているか、押されたキー、学習のオン/オフ、ループ回数。
メモリの行き先:
| フラッシュ内 | RAM 内 | |
|---|---|---|
| ワールドモデル | int8 行列、float32 埋め込み、ノルムとスケール、ゲームの開始フレームと色(52〜138 KB) | 1 回のフォワードパス用のスクラッチバッファ: 36〜80 トークン分のアクティベーション、matmul が読む int8 コピー、次フレームのセルごとのスコア(Flappy Bird で 114 KB、Pac-Man では 368 KB。セルごとのスコアだけで 184 KB を占める) |
| actor | float32 の MLP 重みと特徴量の正規化(51〜61 KB) | 特徴量と隠れ層(約 1 KB) |
| オンデバイス学習器 | コードのみ | 32 ユニットのネットワーク 2 つ分の重み、資格トレース、正規化(Pac-Man で 49 KB、Doom-lite で 106 KB。入力特徴量の数に比例して増える) |
| ファームウェア | コード、USB、ディスプレイドライバ(約 150 KB) | スタック(core 1 に 16 KB)、USB バッファ、フレームチャネル |
どのゲームも 4 MB のフラッシュと 512 KiB の SRAM に収まる。Breakout はフラッシュ 361 KB、SRAM 299 KB。最大の Pac-Man でも 600 KB と 460 KB だ。
時間の大半は int8 のドット積に費やされる(src/lib.rs 内の dot_i8)。32 ビットのロード 1 回で重みを 4 つ取り出し、SXTB16 がバイト 0/2 と 1/3 を 16 ビットの半分ずつに展開、SMLAD が 1 命令で積和を 2 回行う。Attention は uint8 の確率と int8 の値を掛けるので、代わりに UXTB16 を使う。正規化、exp テーブルの参照、出力ごとの最終スケーリングは FPU 上で float32 のまま処理する。2 ループ時の 1 フレームは 200 万〜400 万回の積和(Pac-Man は 820 万回)。デスクトップ CPU なら同じ Rust コードが 1 フレームを 0.7 ms(Flappy Bird)から 1.5 ms(Breakout)で生成する。Pico 本体でのフレームレートはまだ測っていない。
基板は起動すると、デバイス上で学習する新しいエージェントが動き出す。USB 経由で l を押すか、Display Pack の B を 1 秒押し続けると学習済みの actor に切り替わり、もう一度同じ操作で戻る。
コード、重み、再現手順のすべてはこちら: github.com/SheepSeb/tinyworldformer