世界模型塞进 Pico 2 W:两个小网络在单片机上做梦打游戏
一个 26k 到 131k 参数的循环 Transformer 预测下一帧,一个 9k 到 16k 参数的 MLP 挑动作,两个网络一起跑在 Pico 2 W 的同一个核上。五个游戏里,83.6% 到 100% 的留出帧能完全画对,训练、量化和解码规则全部公开。
中文
复制
每一帧都由一个微型循环 transformer 生成:它接收当前帧和一个动作,预测下一帧和奖励。另一个更小的网络则查看每一帧并挑选动作。两者都能装进一块 Raspberry Pi Pico 2 W。
这个智能体是预训练好的,但它也能边玩边学:一个全新的 stream-x 智能体从零开始,在梦境中游玩的过程中不断改进。
在板子上
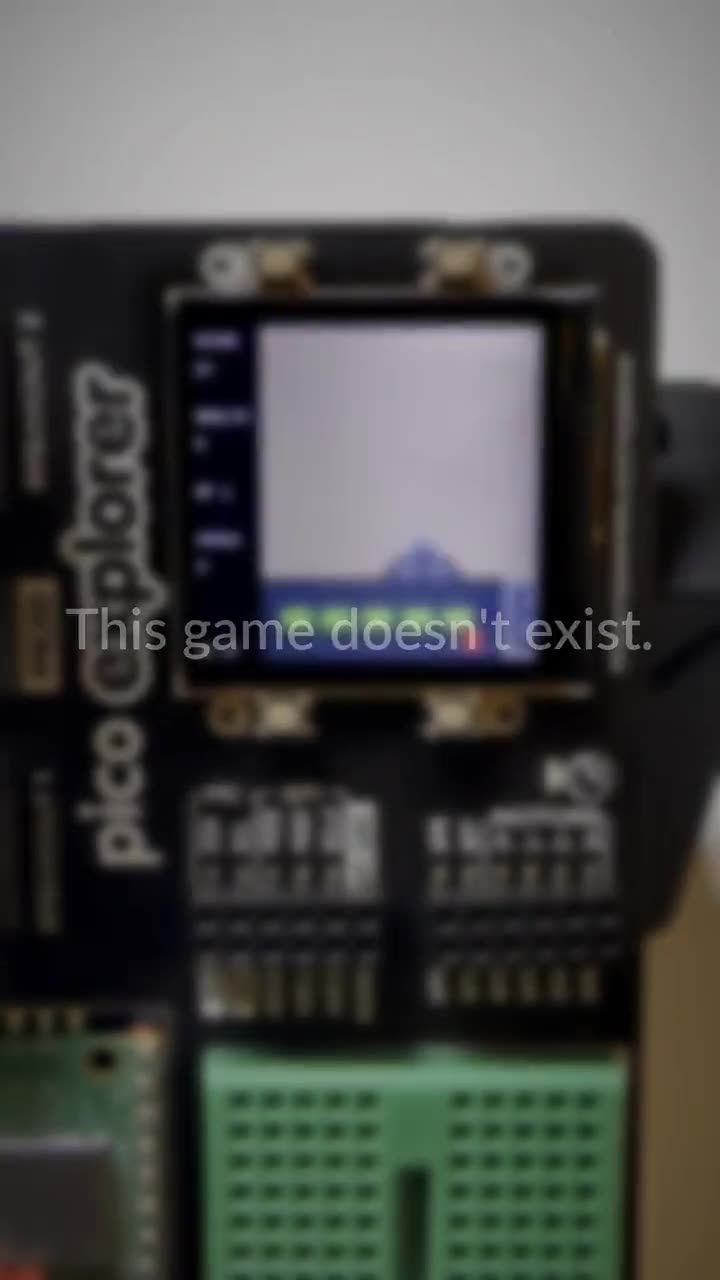
同样的两个网络跑在带 Display Pack 的 Raspberry Pi Pico 2 W 上:世界模型和 actor 运行在同一个核心上。
2 个微型网络
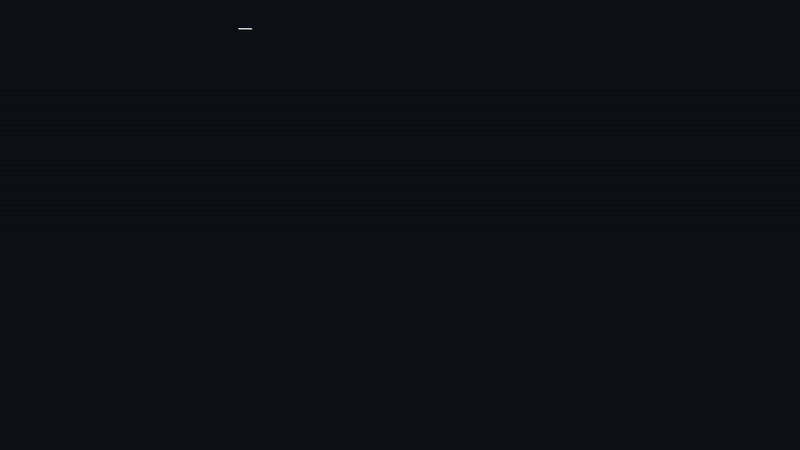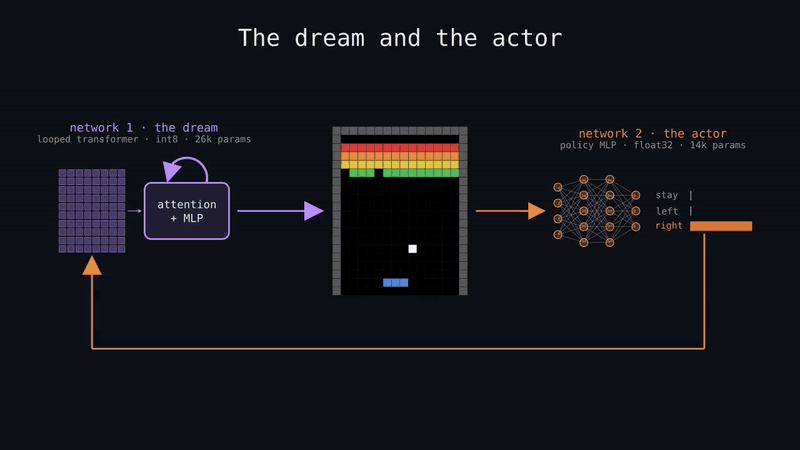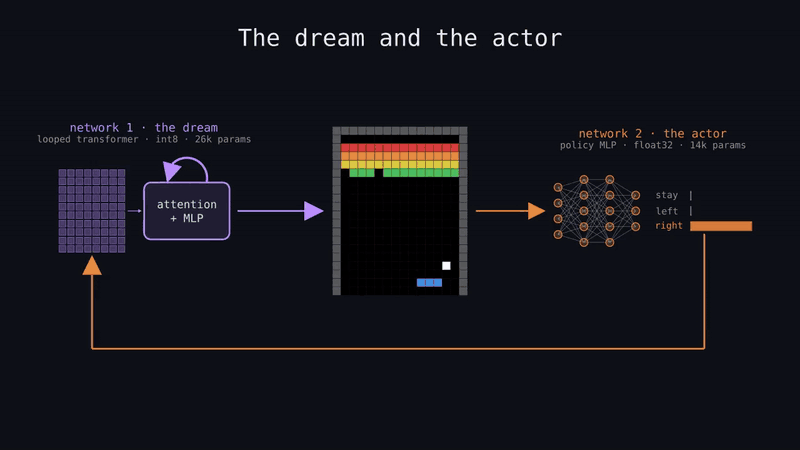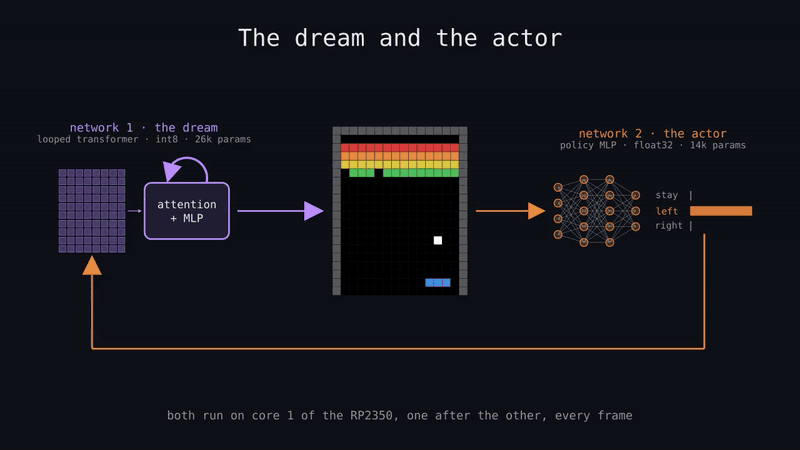
| 网络 1:世界模型 | 网络 2:actor | |
|---|---|---|
| 任务 | 帧 + 动作 → 下一帧 + 奖励 | 帧 → 动作 |
| 架构 | 循环 transformer,q int8 | 两层隐藏层的 MLP,float32 |
| 规模 | 26k–131k 参数 | 9k–16k 参数 |
| 每帧开销 | 2–8M 次乘加 | 9k–16k 次乘加 |
| 训练方式 | 在录制的真实游戏上训练(见下文) | 用 stream-x 训练,在真实游戏中或梦境里(见下文) |
规模取决于游戏。有些游戏需要更多参数才能学会,我们尽量把参数数量压小。
在芯片上,两个网络都不接触真实游戏:actor 只看到世界模型生成的帧,世界模型只从 actor 那里拿到动作。两者都跑在 RP2350 的 core 1 上,core 0 负责 USB 和显示。
预训练的 actor 可以换成一个全新的 stream-x 智能体,在板子上从零开始学习。按下任意按键就能接管控制,你可以亲自玩这个梦境。
游戏
每个游戏都是 src/tinyworldformer/games/ 里几百行 numpy。它渲染成一个小型的 token id 网格,而且一帧始终包含完整的游戏状态,所以隐藏状态必须画进帧里:球的朝向是它 token 的一部分,Doom-lite 则带一张小地图。
| 游戏 | 帧 | 规则 | 随机事件 | 世界模型 | 精确帧(2 次循环) |
|---|---|---|---|---|---|
| Breakout | 20×16 | 挡板、球、56 块砖、5 条命 | 漏接后的发球 | 26k 参数,4.3M MACs | 99.99% |
| Doom-lite | 32×32 | 光线投射渲染 8×8 迷宫的第一人称视角;敌人沿最短路径走向你;你开枪射击 | 敌人重生 | 55k 参数,4.2M MACs | 83.6%(见下文) |
| Flappy Bird | 24×24 | 重力、扇翅、滚动的管道 | 下一个缺口的高度 | 46k 参数,2.0M MACs | 100% |
| Pong | 20×32 | 你对抗一个反应滞后的 CPU 挡板,先得 5 分者胜 | 得分后的发球 | 46k 参数,2.3M MACs | 99.45% |
| Pac-Man lite | 48×48 | 23×21 迷宫、249 颗豆子、两只沿最短路径移动的幽灵、3 条命 | 幽灵重生 | 131k 参数,8.2M MACs | 86.4% |
“精确帧”指在留出的转移样本中,预测帧的每一个格子都与真实游戏完全一致的比例。随机事件发生后的帧不计入,因为这些帧只能采样,无法预测。Doom-lite 的 3D 视角有 768 个格子,只要有一个带明暗的墙面像素不对,整帧就算错,所以它的数字比实际表现要差;游戏状态几乎总是对的(见“检查世界模型”一节)。
你可以在终端里玩这些真实游戏:uv run python -m tinyworldformer.games.play --game pacman(或 breakout、doomlite、flappy、pong)。
世界模型如何工作
帧被切成 token
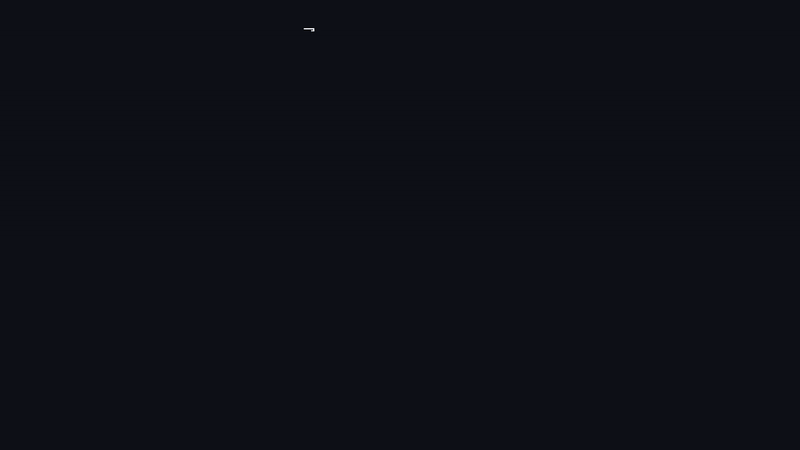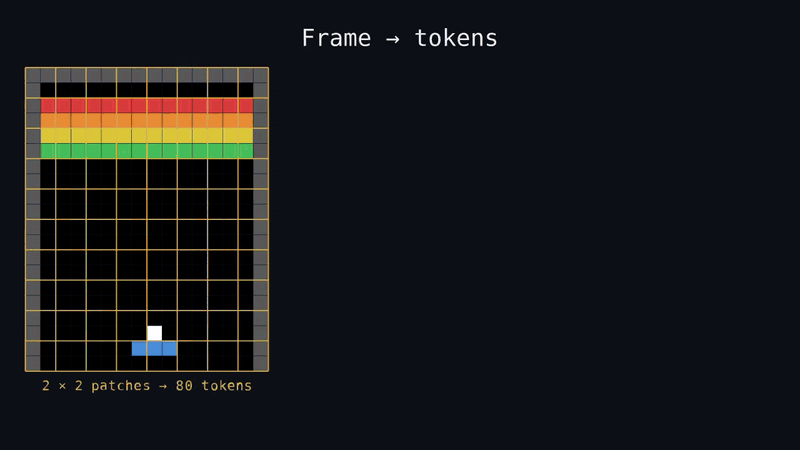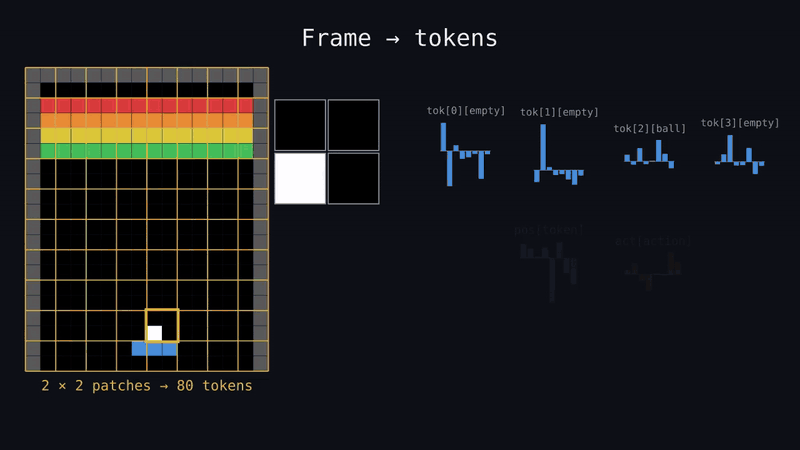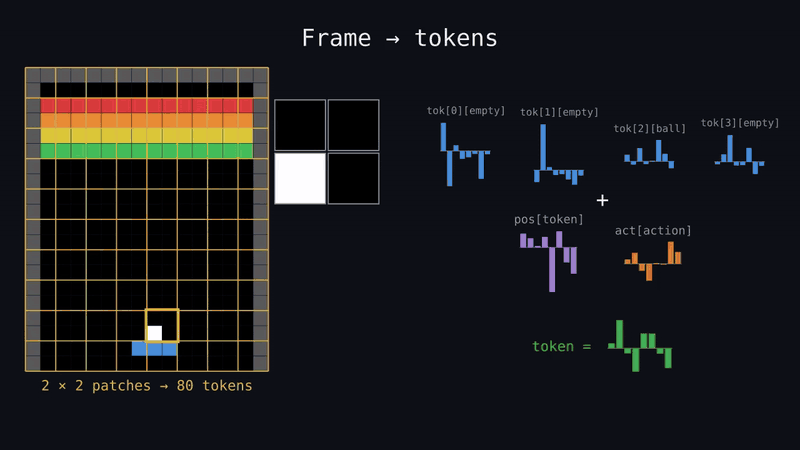
一帧被切成方形 patch:Breakout 是 2×2 个格子,Doom-lite、Flappy Bird 和 Pong 是 4×4,Pac-Man 是 6×6。这样每个游戏得到 36 到 80 个 token。一个 patch 的嵌入,是每个格子各取一个学习到的向量再求和;patch 内每个位置各有一张独立的表,格子顺序因此不会丢失。每个 token 还会加上一个位置向量和动作向量。
循环 Transformer
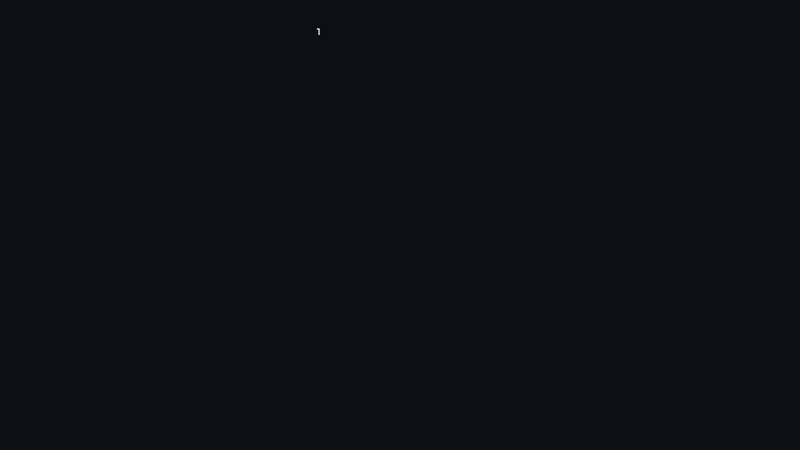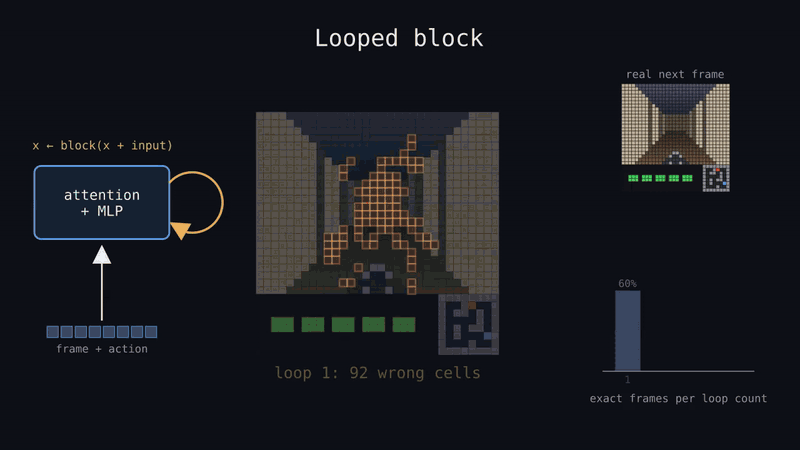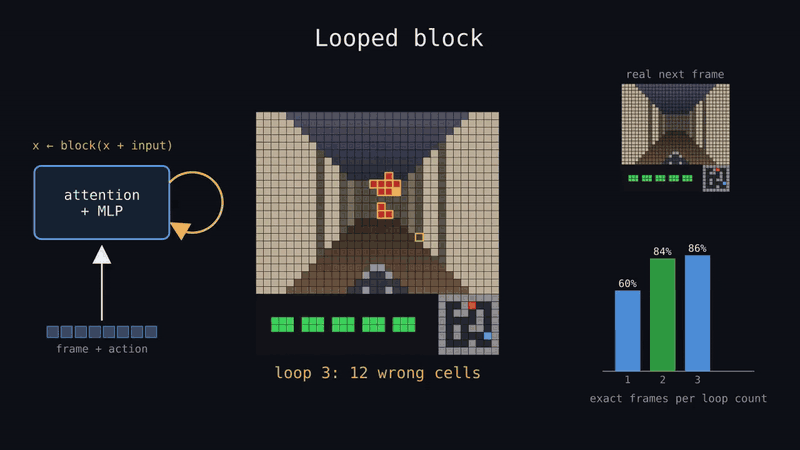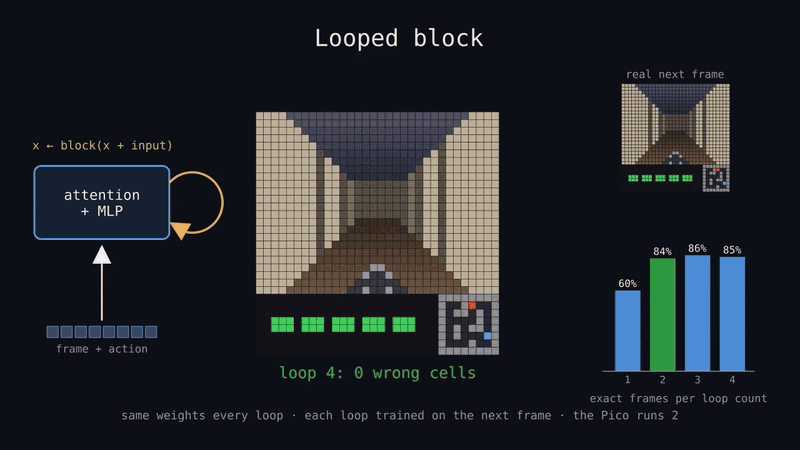
模型只有一个 transformer 块(注意力加 ReLU MLP),只有一套权重,应用 1 到 4 次,每次应用前都把输入加回去。每次应用后的输出都对着下一帧训练,所以运行时循环次数可以在速度和精度之间取舍。在 Pico 上,为了保持像样的帧率,我们用两次循环。
动画展示的是一个留出的 Doom-lite 步骤。一遍之后,模型画出了一个并不存在的敌人,之后每多跑一遍就抹掉它的一部分:92、35、12,最后是 0 个错误格子。右侧的柱状图是各循环次数下完全正确的留出帧占比。
下面是一个“梦到”的 Doom-lite 步骤在 1、2、3、4 次循环后解码的结果,红框标出的是与真实规则不符的格子:
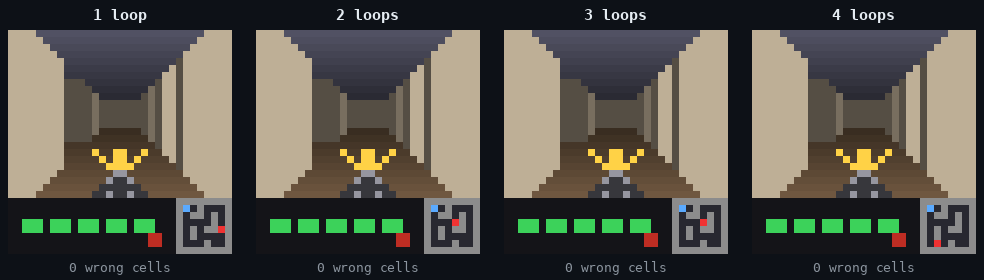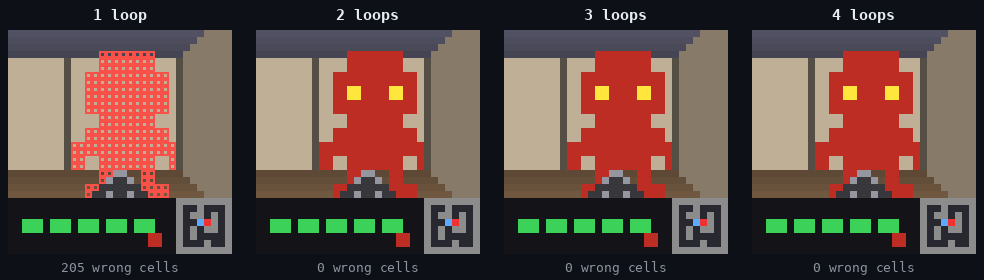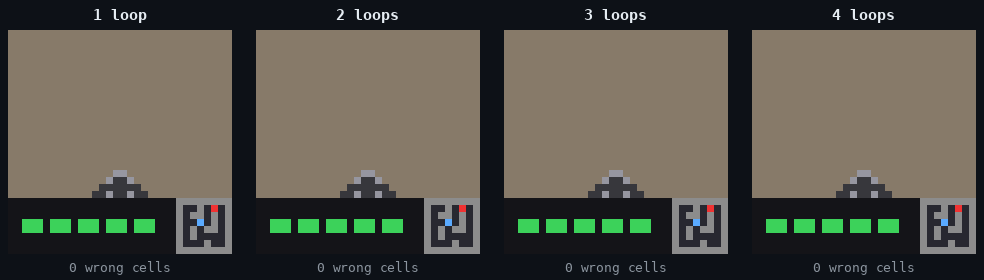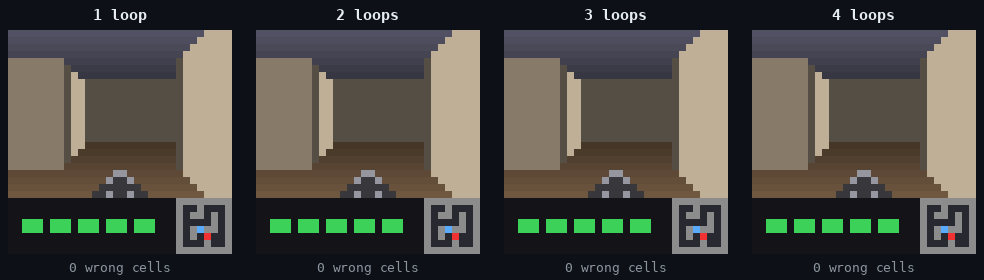
按循环次数统计的完全正确留出帧:
| 循环次数 | Breakout | Doom-lite | Flappy Bird | Pong | Pac-Man |
|---|---|---|---|---|---|
| 1 | 99.68% | 59.8% | 99.99% | 98.47% | 79.6% |
| 2 | 99.99% | 83.6% | 100% | 99.45% | 86.4% |
| 3 | 100% | 85.9% | 100% | 99.60% | 85.7% |
| 4 | 99.96% | 84.7% | 100% | 99.53% | 84.4% |
解码
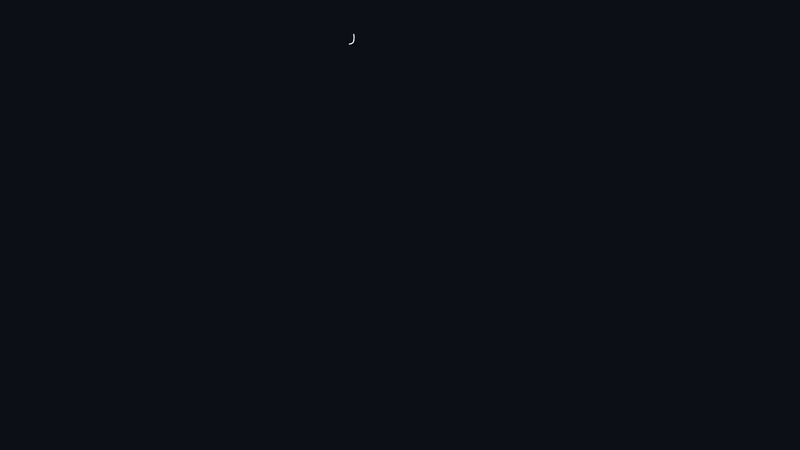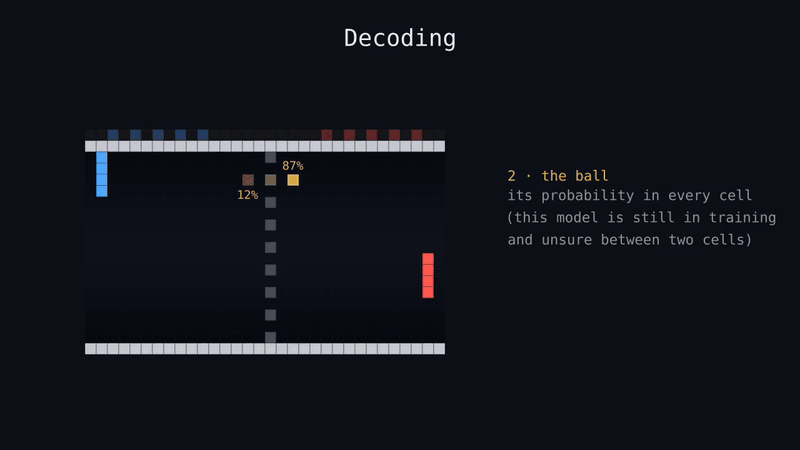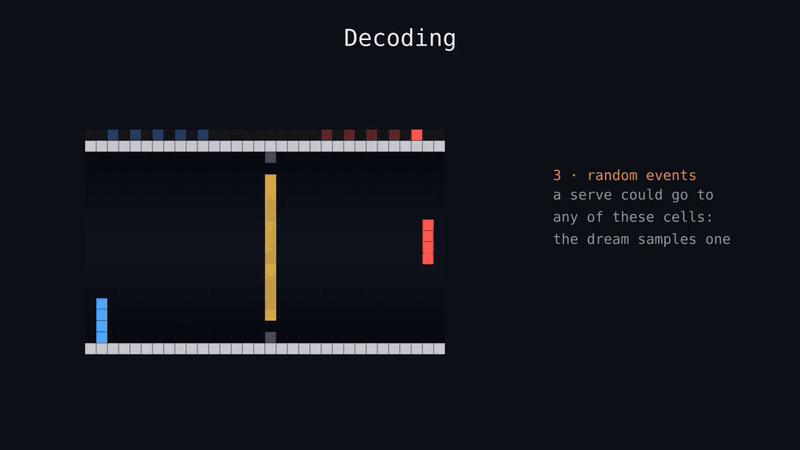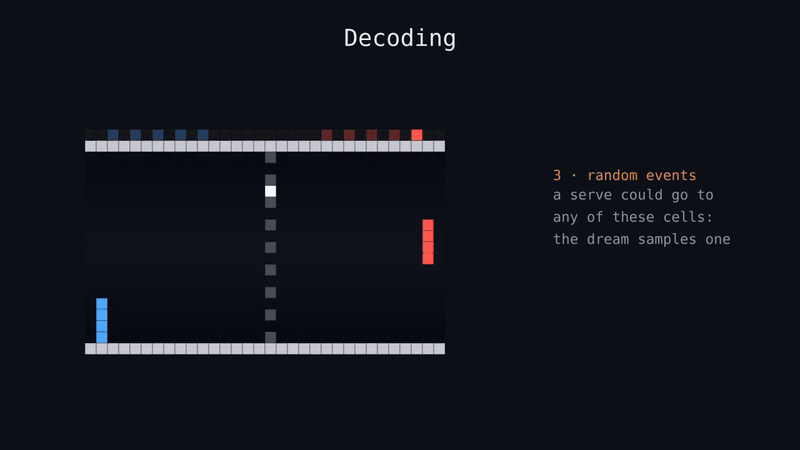
模型为每个格子和每个 token 输出一个分数。把这些分数变成一帧,其重要性几乎不亚于模型本身,最终归结为三条规则(上图以 Pong 为例):
-
背景格子(墙、砖块、豆子、地板)各自独立地取最可能的 token。
-
只出现一个的精灵(球、玩家、每只幽灵)在所有 (格子, token) 组合上做一次统一选择,保证每种恰好只有一个。随机事件发生后,从与最优分数相差 2.2 logits 以内的候选中采样,这样世界模型会采样出新的发球或重生,而不是把它们平均掉。
-
Pac-Man 和幽灵是 2×2 的精灵,但每个精灵只有一个格子携带状态(嘴部格子记录朝向;幽灵左下角的格子记录其下方是否有豆子)。其余三个格子由它盖章生成,而不是预测出来的。
我们实现规则 2,是因为第一个 Breakout 模型一次画出了两个球;改成一次全局选择后,完全正确的帧从 91.6% 提升到 99.7%。
检查世界模型
仅凭录制的数据做到准确还不够。智能体会把梦境推进到数据中从未出现过的状态,而在那里犯下的任何错误都可能被它利用。因此,主要检查放在智能体游玩的过程中进行:从梦境帧里读回游戏状态(games/<game>.py: read),把真实规则套用到该状态和智能体的动作上,再将结果与下一帧梦境和奖励作对比。
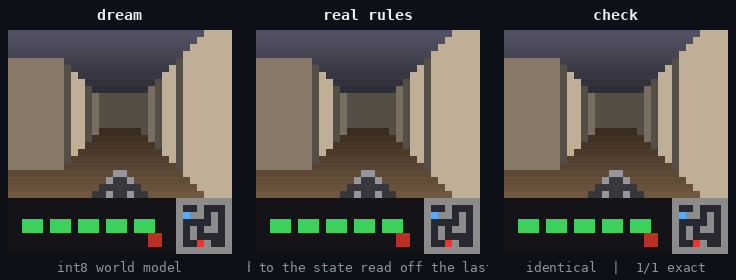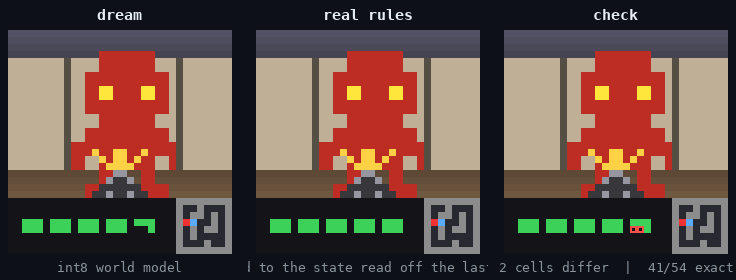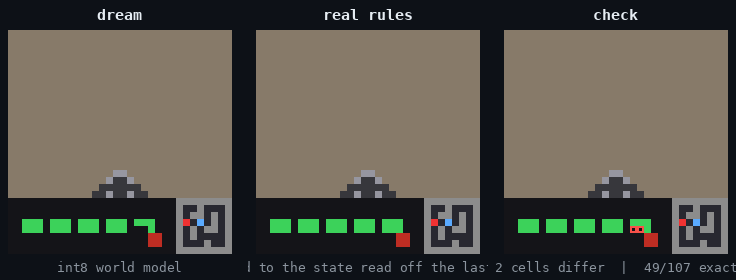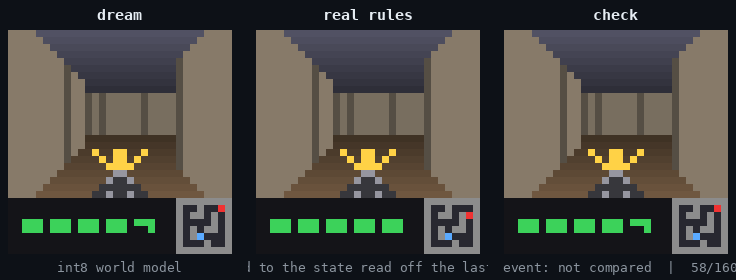
每个游戏 5,000 个梦境步,2 次循环,使用随附的智能体(training/evalwm.py --agent):
| 游戏 | 错误的游戏状态 | 错误的奖励 | 每步错误格子数 |
|---|---|---|---|
| Breakout | 未读回;0 帧含不可能出现的 token | 6(砖块未破却付了奖励) | – |
| Doom-lite | 1 | 0 | 1.50 |
| Flappy Bird | 0 | 0 | 0.00 |
| Pong | 1 | 0 | 0.00 |
| Pac-Man | 742 | 38 | 0.39 |
训练
首先,智能体玩真实游戏,每一步都记录为一个样本(帧、动作、下一帧、奖励),每个游戏 1–3 百万个。部分回合从非常规状态开始,比如带洞的砖块或随机位置,这样数据能覆盖游戏的更多部分。
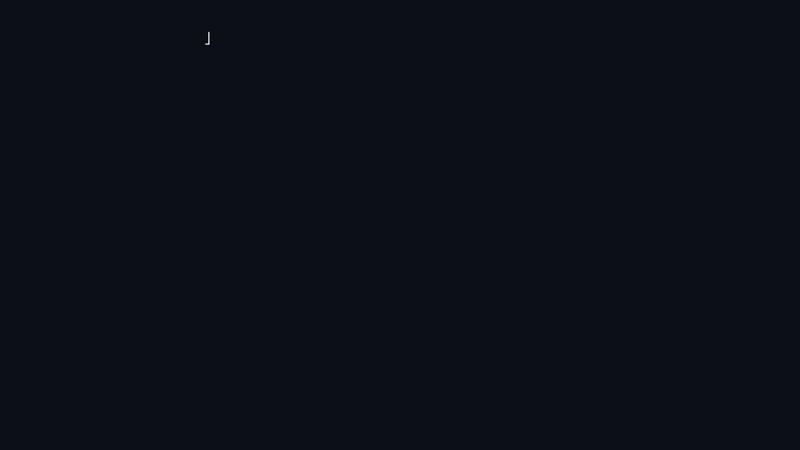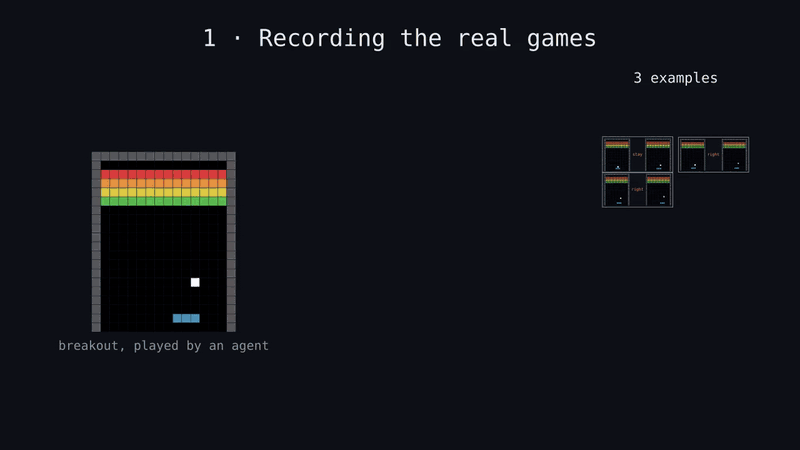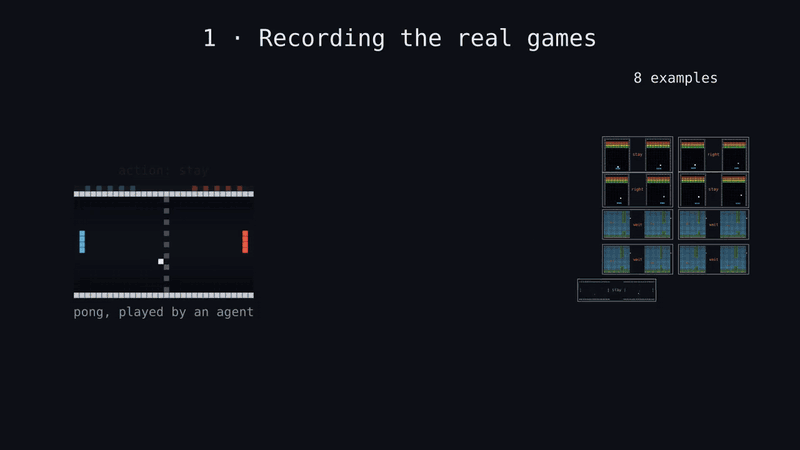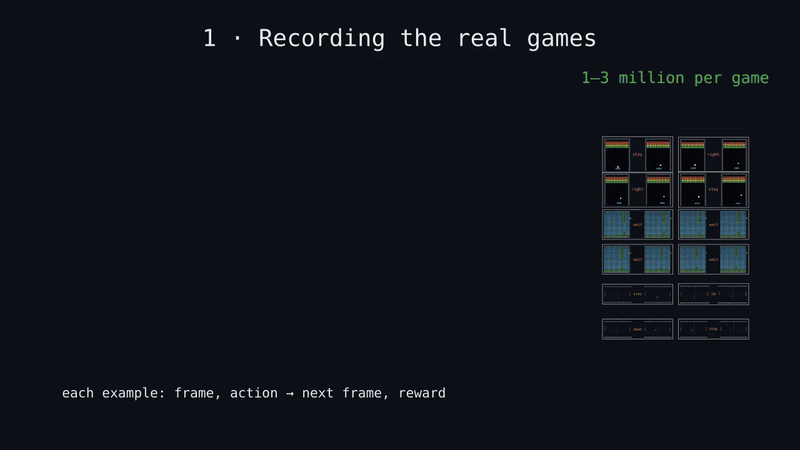
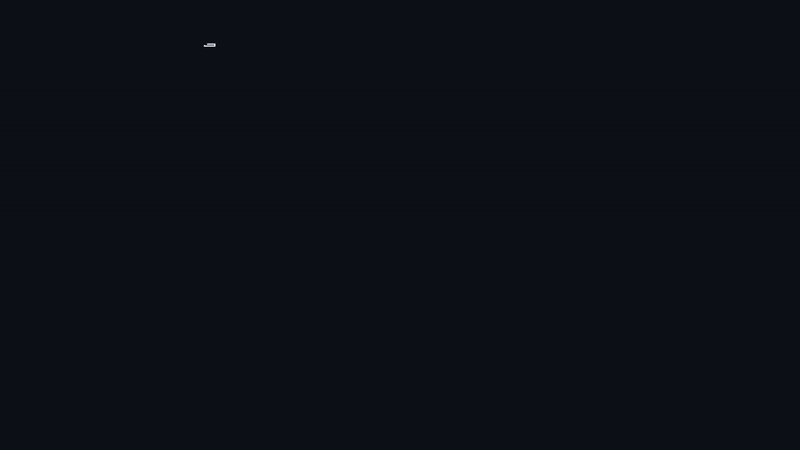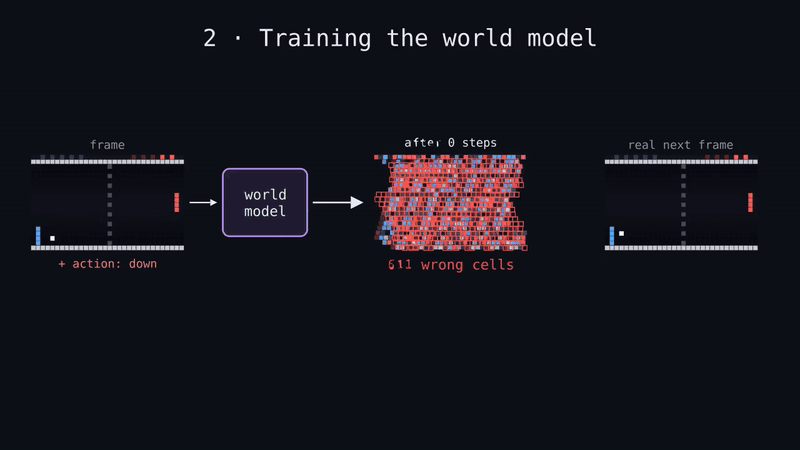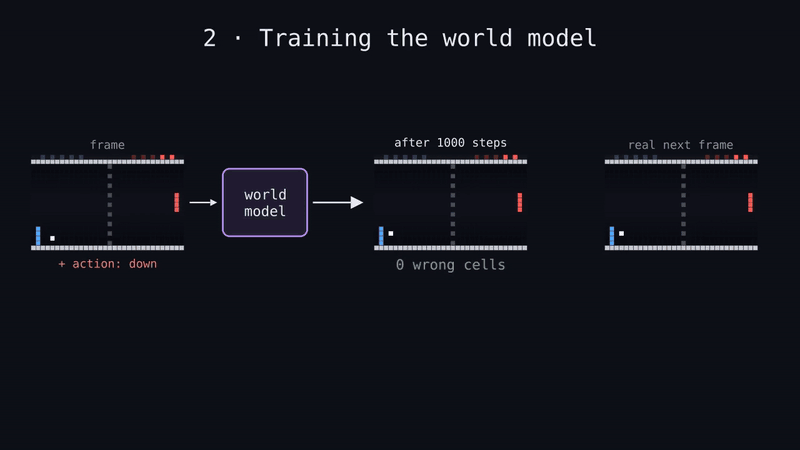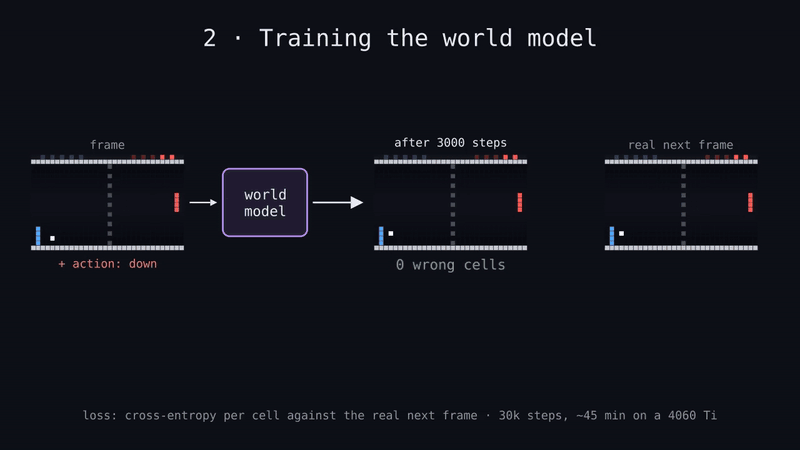
然后世界模型学习预测下一帧,损失为逐格交叉熵:训练 30k 步,前 3–4k 步用浮点运行,之后开启 int8 舍入(QAT)。
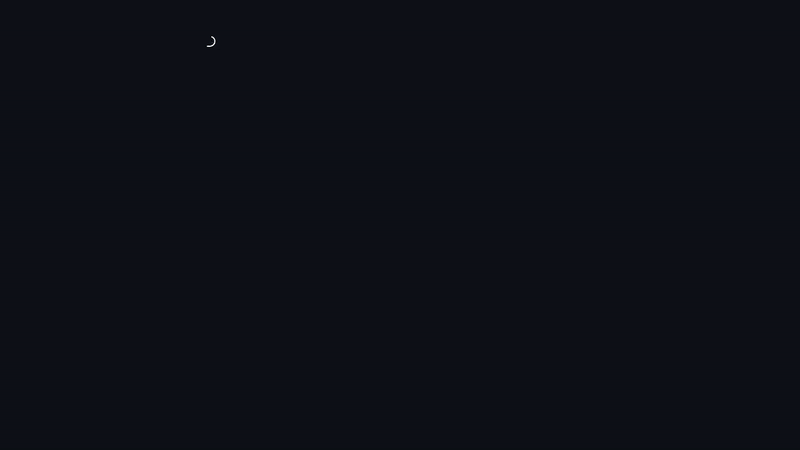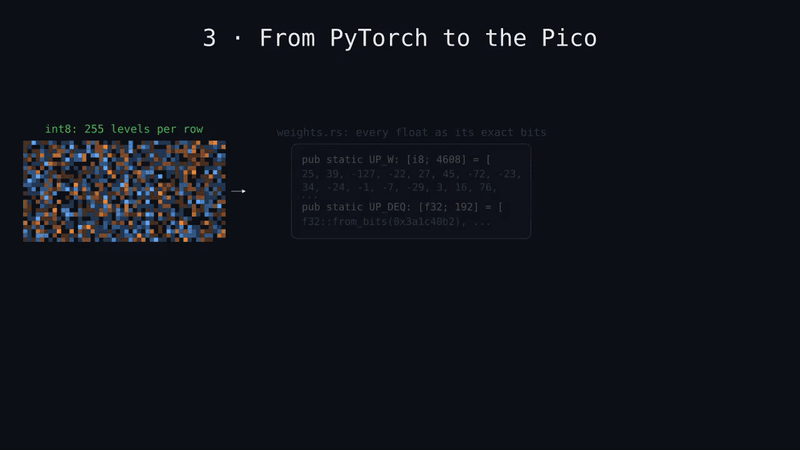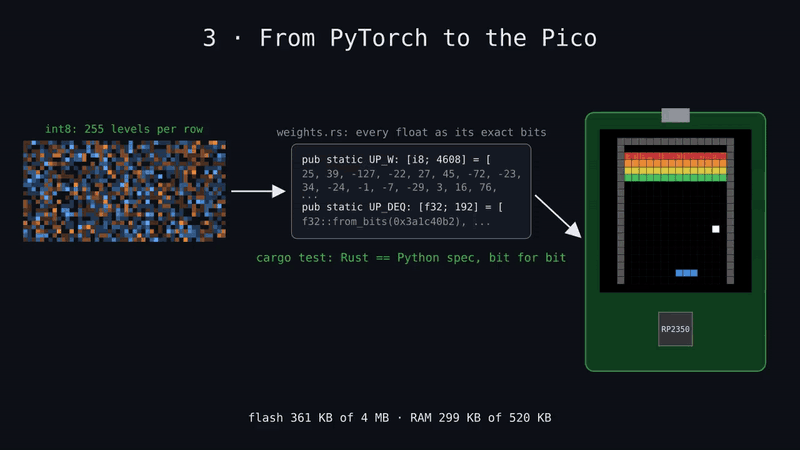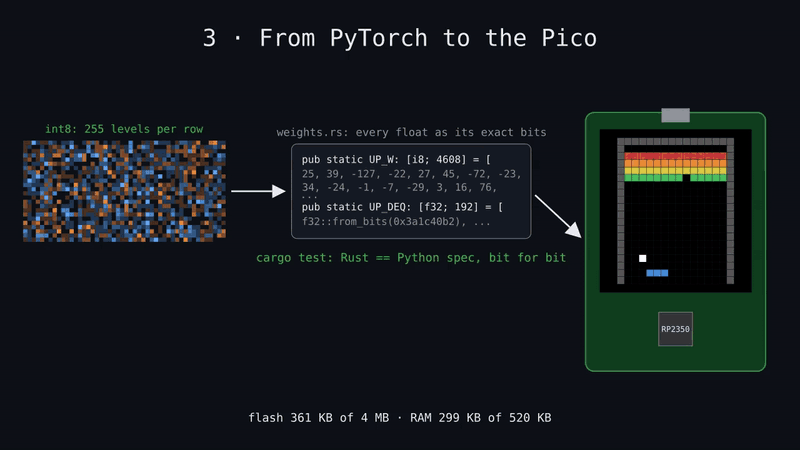
int8 权重被写入 Rust 源码,每个浮点数都以其精确的位存储。我们用 cargo test 校验,确保 Rust 逐位复现 Python 的整数规范,然后固件在 Pico 上运行。
在世界模型中训练出的智能体会到达录制数据中从未有过的状态,所以用这个智能体录制真实游戏,再在全部数据上微调世界模型。
不同游戏里的智能体都开始钻这些空子,下面是其中一些修复:
-
按“这个格子变了”给 loss 加权,会让模型偏向预测变化,于是它画出两个球、打碎两块砖。改成按输入帧里哪些位置可能发生变化来加权,再加上全局的单例选择,问题就解决了。
-
世界模型里的 Breakout 智能体拿到 154 分、还剩 26 块砖,因为世界模型在砖块被击中时没有把角落的砖去掉。Doom-lite 的智能体学会了从 5 格开外狙击。
-
只在梦境里训练的智能体在梦境里拿到 210 分(真实上限是 56),在真实游戏里拿到 28 分,和 World Models(Ha & Schmidhuber)的预测一致。每一轮收集加微调,都堵上了智能体当时找到的那个漏洞。
-
Doom-lite 的梦境有时会丢掉敌人 sprite,之后再也没画出来:模型直接复制了上一帧的画面,而不是根据小地图重新绘制。加噪声增强解决了这个问题(
train --noise 0.3,和 GameNGen 的做法一样):输入画面被加上随机像素,有时还会丢掉 sprite。 -
d=32吸收不了更宽的 Breakout 数据,d=48可以。Pac-Man 的 48×48 画面需要d=64。
智能体:stream-x
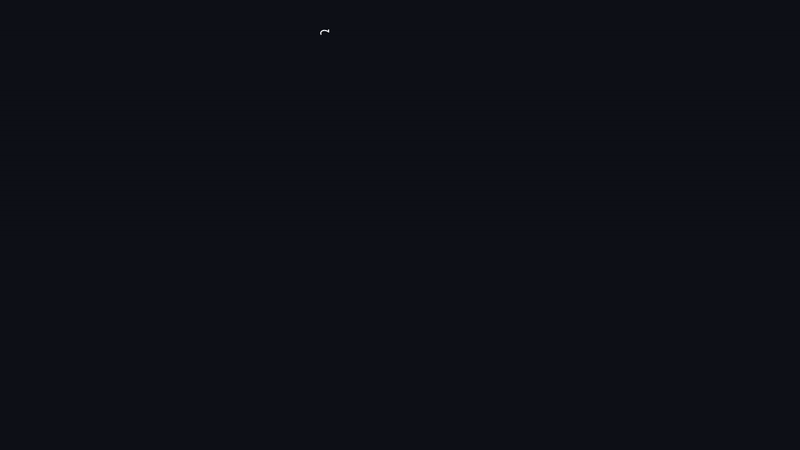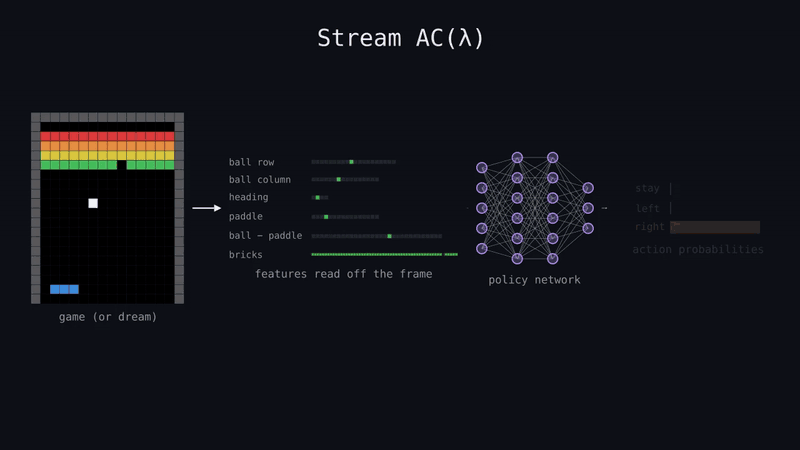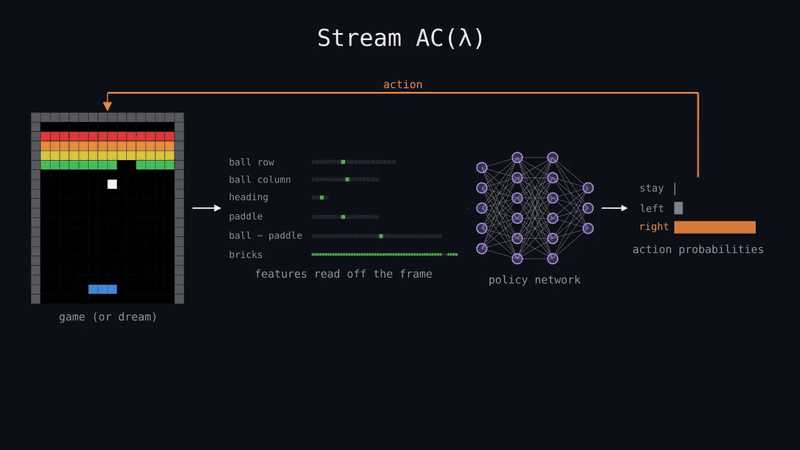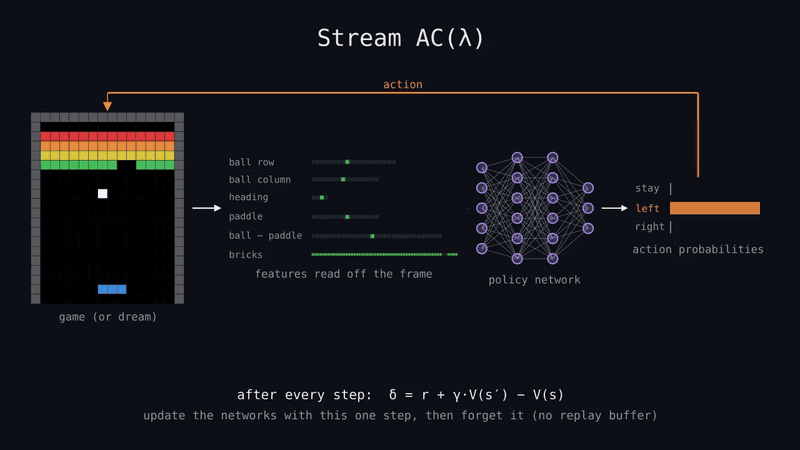
智能体用的是 Stream AC(λ)(Elsayed, Vasan & Mahmood, 2024),每次只从一个 transition 学习:没有 replay buffer,没有 batch,也没有 target network。资格迹把信用回溯到过去,ObGD 会缩小任何会冲过 TD target 的步长。策略网络和价值网络各有两层 64 单元的隐藏层(Pico 上是 32),并带 LayerNorm。
输入是从画面里读出的特征向量(training/streamx.py: observe_*,在 tinyworldformer-rs/src/agent.rs 里有对应的 Rust 实现)。比如 Breakout 里球的行、列和方向;Pac-Man 里则是每个方向上到最近豆子的最短路径距离,以及每只鬼有多近。
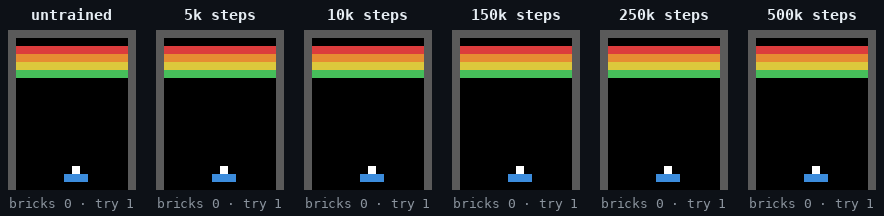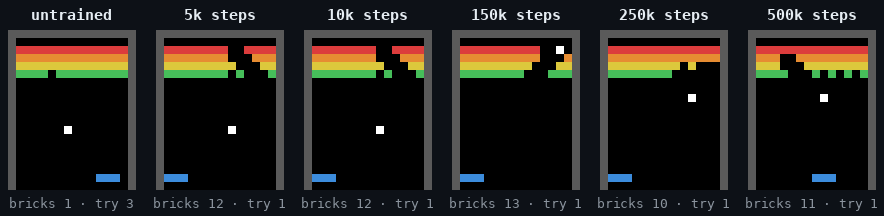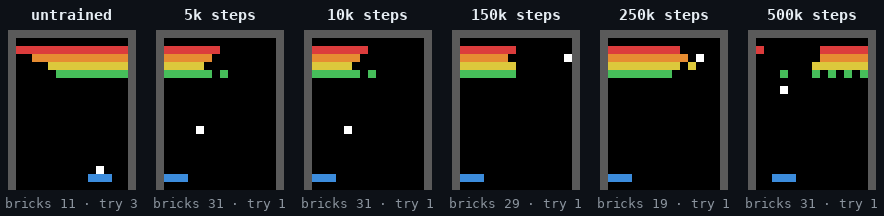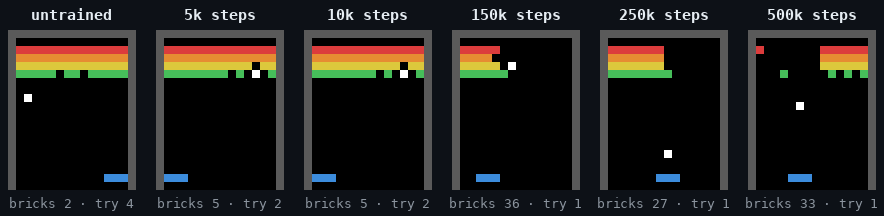
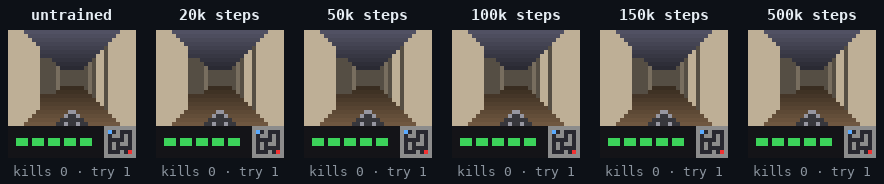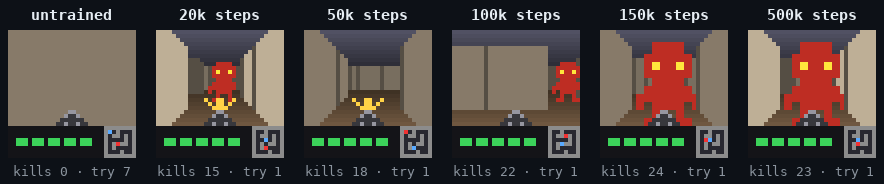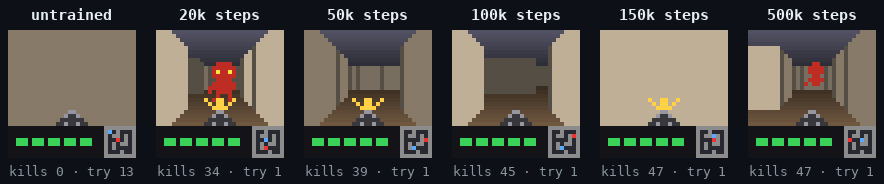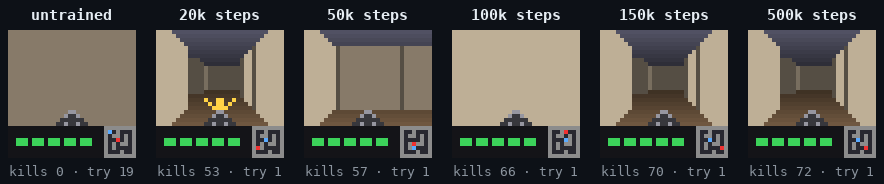
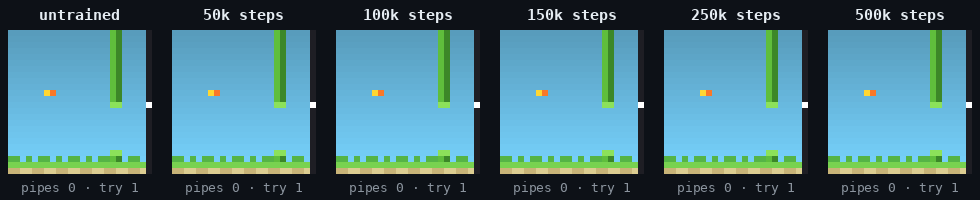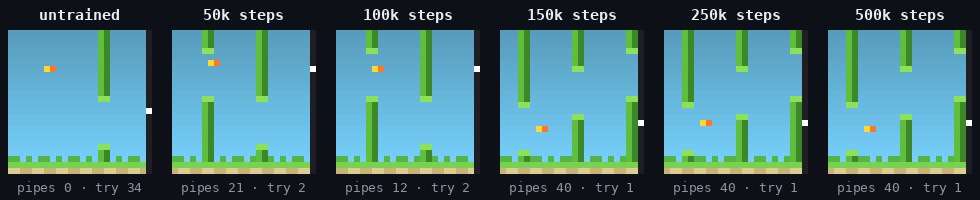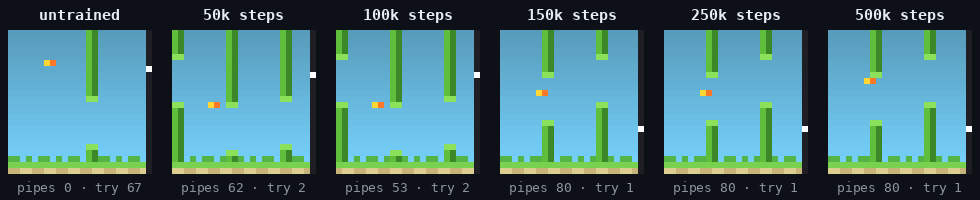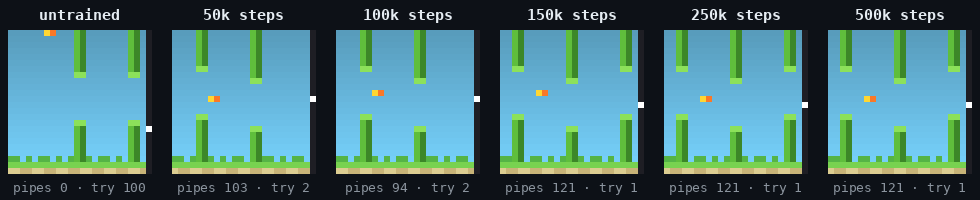
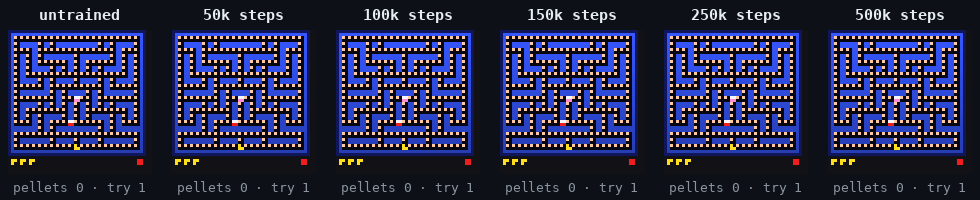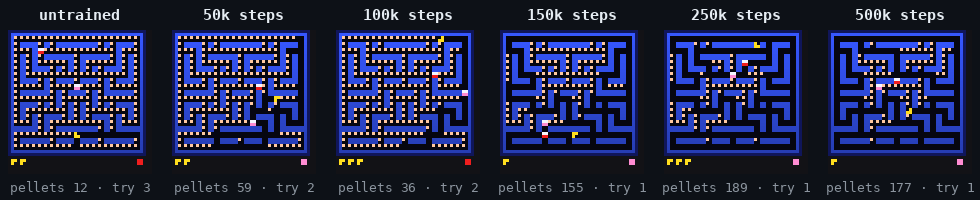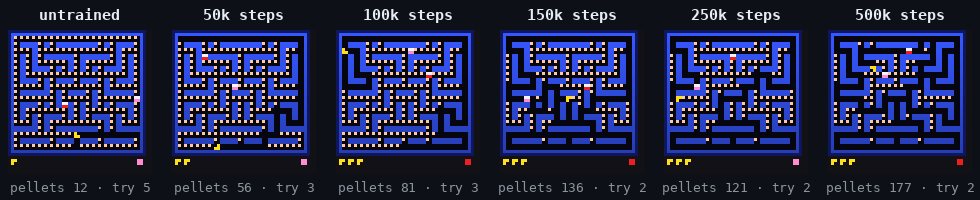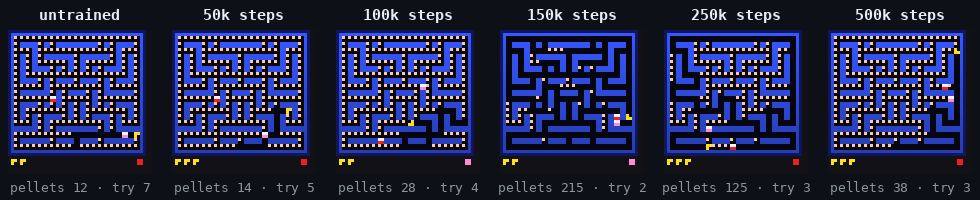
下面是每个游戏的一次训练(真实游戏,50 万步),取六个阶段:未训练、结束,以及分数走到 25%、50%、75% 和 95% 时的快照。每个面板都从同一个起点贪心游玩,每帧跳过几步。“try” 是到目前为止玩过的回合数,所以你能看到崩溃。
Breakout
Doom-lite
Flappy Bird
Pac-Man lite
Pong
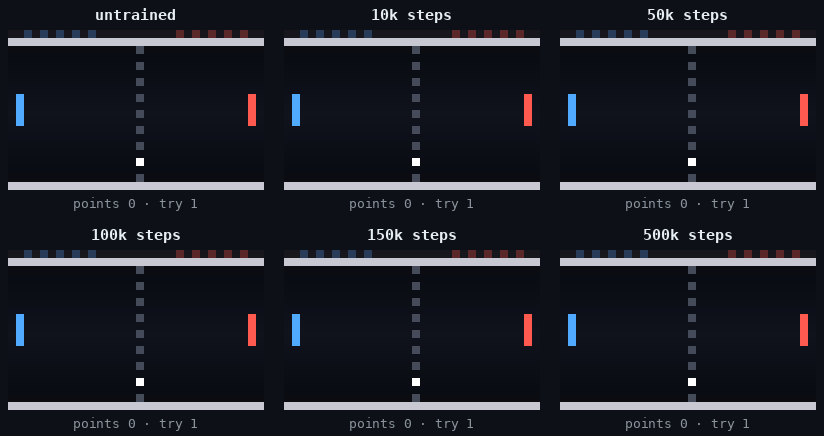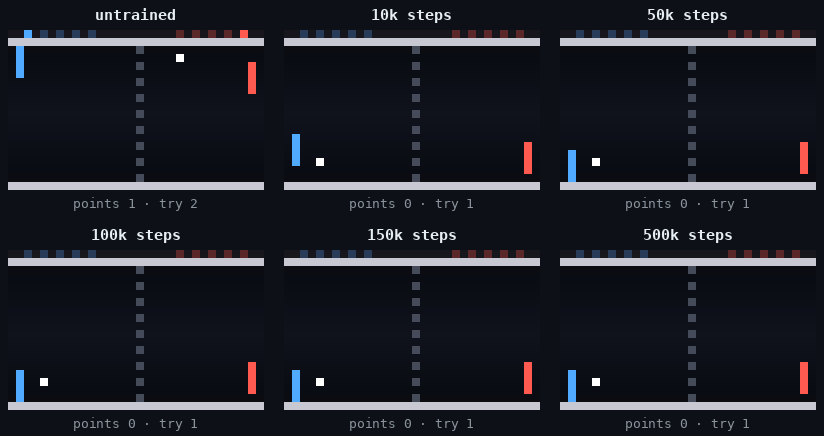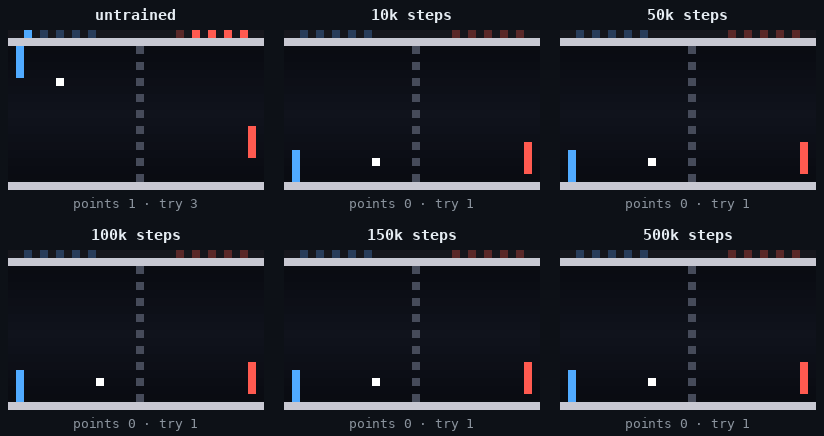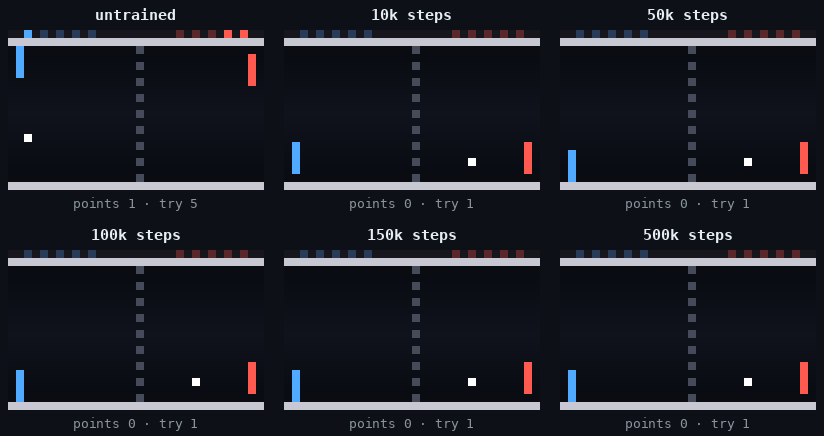
真实游戏中的贪心回报(取 10 局平均值),数据来自同一次训练的若干快照:
| 游戏 | 0 | 1k | 2k | 5k | 10k | 20k | 50k | 100k | 150k | 250k | 500k | max |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Breakout | 8.2 | 17.0 | 15.9 | 21.9 | 29.9 | 29.9 | 29.9 | 31.1 | 35.0 | 39.9 | 45.6 | 56 |
| Doom-lite | −5.0 | −5.0 | −5.0 | −5.0 | −5.0 | 59.5 | 69.9 | 78.1 | 81.8 | 82.1 | 82.9 | – |
| Flappy Bird | −1.0 | −1.0 | −1.0 | 1.9 | 24.6 | 24.9 | 96.2 | 123.7 | 309.2 | 332 | 332 | 332 |
| Pac-Man | 7.0 | 3.8 | 17.0 | 17.7 | 8.2 | 46.8 | 72.9 | 138.9 | 146.6 | 190.3 | 217.4 | 249 |
| Pong | −4.3 | −3.9 | −3.9 | −3.9 | −1.7 | −2.0 | −0.3 | 1.1 | 1.7 | 1.1 | 1.1 | 5 |
不加 shaping 时,Doom-lite 的智能体会蹲在起始角落开火,因为敌人总会自己送上门来。--idle-penalty 0.1 对每一步收取 0.1 的代价,条件是所在格子在过去 20 步内被访问超过 6 次。位置从小地图上读取,所以这个惩罚在梦境里同样生效。加上它之后,智能体会四处巡逻,击杀数翻了一倍。
tinyworldformer-rs/src/learner.rs 是同一套算法用 no_std Rust 写的版本,反向传播是手写的。与 200 次 PyTorch 更新相比,误差在 3.5e-6 以内。在主机上,一个全新的智能体在 Rust int8 的 Flappy Bird 梦境里训练 25k 步后平均每局通过 6 根水管,100k 步后 121 根,250k 步后 300 根以上。
量化与 Pico
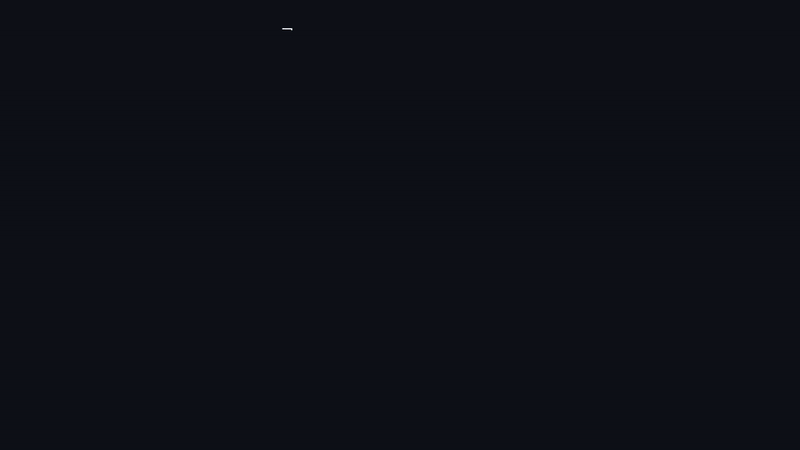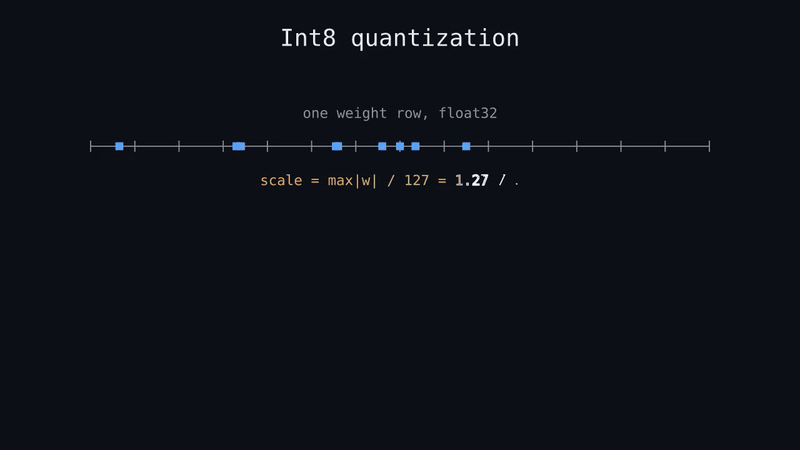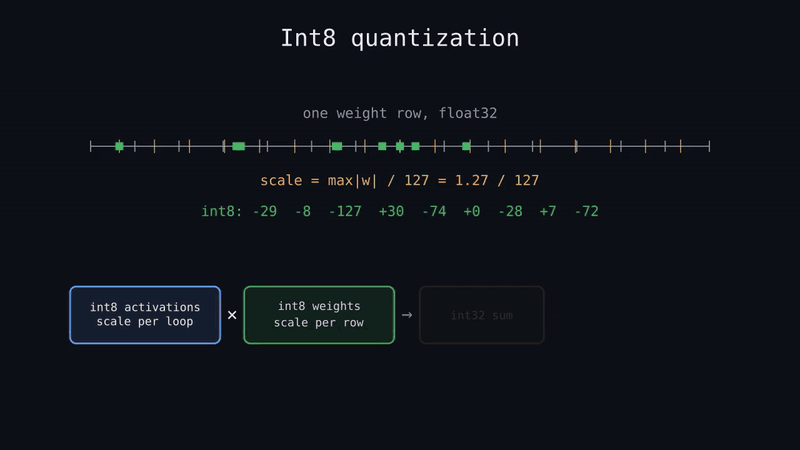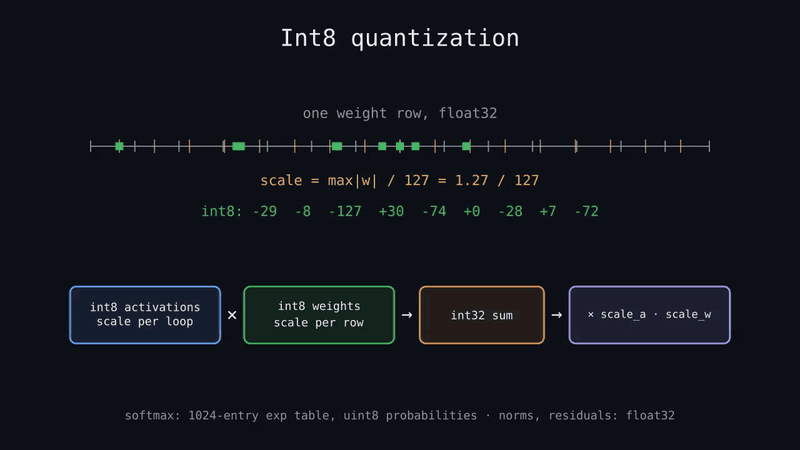
世界模型中的每个矩阵都采用 int8,每个输出行对应一个 scale(scale = max|w| / 127)。激活值同样为 int8,每个张量一个 scale,每个循环索引一个 scale,因为不同循环所见的数值范围各不相同。Matmul 将 int8 × int8 累加为 int32(在 RP2350 上每条 SMLAD 指令完成两次乘加),再用两个 scale 做一次浮点乘法。Softmax 使用一张 1024 项的 exp 表,概率以 uint8 存储。归一化、残差和嵌入保持 float32,因为 RP2350 配有 FPU。
训练时采用相同的舍入方式(QAT,直通估计器),因此 int8 模型就是训练所得的那个模型。rustexport/intref.py 是用 numpy 编写的 int8 模型,每个浮点运算的顺序都是固定的;Rust 引擎逐位复现它,cargo test 对每个导出的 env 校验黄金向量。
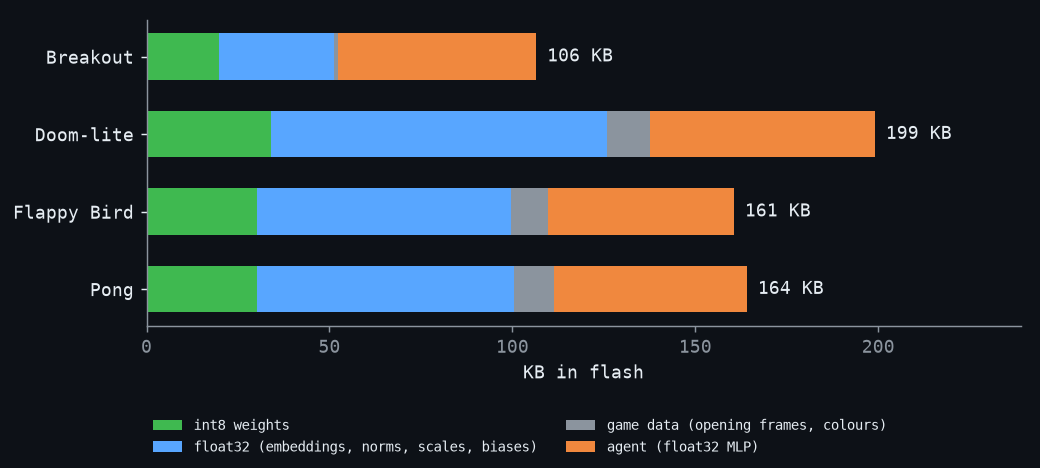
| 游戏 | int8 权重 | float32(嵌入、归一化、scale) | 游戏数据 | agent(float32) | 固件 flash | 固件 RAM |
|---|---|---|---|---|---|---|
| Breakout | 19.7 KB | 31.6 KB | 1.1 KB | 54.1 KB | 361 KB | 299 KB |
| Doom-lite | 33.9 KB | 91.9 KB | 12.0 KB | 61.3 KB | 471 KB | 357 KB |
| Flappy Bird | 30.1 KB | 69.5 KB | 10.1 KB | 50.8 KB | 409 KB | 227 KB |
| Pong | 30.1 KB | 70.4 KB | 10.9 KB | 52.6 KB | 414 KB | 244 KB |
Flash 和 RAM 的数据取自固件 ELF(size -A),构建时带上了 Display Pack 驱动,因此其中包含代码、USB、显示驱动和端上学习器。Pico 2 W 有 4 MB flash 和 520 KB SRAM,其中 512 KiB 位于主内存映射中。float32 嵌入表是占比最大的部分,也可以改为 int8。
src/tinyworldformer/rustexport/ 只依赖 numpy 和 torch(有一项测试保证这一点),因此其他项目可以直接复用这套导出流程:用 rustexport.qat(QLinear、LoopedBlock)搭建模型,先做浮点预热再用 ActQuant.enabled = True 训练,用 rustexport.convert.looped_model 转换,然后用 int_model_arrays、mlp_arrays 和 codegen.write_module 写出 Rust 源码。rustexport.Golden 写出供 Rust 测试校验的向量。
在芯片上
固件(tinyworldformer-rs/firmware)是基于 embassy 的 no_std Rust。运行时不分配任何内存:权重是 flash 中的 static 数组,每个缓冲区都是 RAM 中固定大小的 static。
Core 1 负责运行游戏。它的循环每跑一遍(firmware/src/main.rs 中的 dream_loop)就是一帧:
-
actor 从当前帧读取特征(
agent::observe),跑一遍 MLP 选出一个按键。如果开启了端上学习,就由学习智能体来选;如果你正在按键,就用你按的键。 -
int8 transformer 对帧和按键跑 2 轮循环(
Engine::forward),解码把它的分数变成下一帧:每个格子取背景的 argmax,每个 singleton 只放置一次(随机事件用 xorshift RNG 采样),然后盖上 sprite。奖励是奖励头的 argmax;命数和回合结束是额外叠加的计数器。 -
如果开启了学习,学习器就用这一个 transition 更新,然后把它忘掉。
-
帧通过一个双槽通道送到 core 0。如果 core 0 还在处理上一帧,这一帧就被丢弃,所以 core 1 从不等屏幕。
你亲自玩的时候,core 1 会降到可玩的速度(每帧 66–150 ms,视游戏而定)。智能体则以芯片允许的最快速度运行。
Core 0 用 embassy 异步任务跑其余所有事情。通过 USB 串口,每一帧都以带颜色的 ANSI 文本发出,附一行状态(模型耗时、actor 耗时、fps、env 与智能体名称),按键则从串口回传。可选的 Display Pack(--features display)是一块 320×240 的 ST7789,走 SPI,最高 62.5 MHz,只重绘自上一帧以来发生变化的格子。它的按键每 20 ms 轮询一次。两个核之间只共享帧通道和几个原子量:谁在玩、按下的键、学习开关、循环计数。
内存的去向:
| 占用 flash | 占用 RAM | |
|---|---|---|
| 世界模型 | int8 矩阵、float32 嵌入、归一化参数与缩放系数、游戏的开场帧和颜色(52–138 KB) | 一次前向传播的临时缓冲区:36–80 个 token 的激活值、矩阵乘法读取的 int8 副本,以及下一帧的逐格分数(Flappy Bird 为 114 KB,Pac-Man 高达 368 KB,其中仅逐格分数就占 184 KB) |
| actor | float32 MLP 权重和特征归一化参数(51–61 KB) | 其特征和隐藏层(约 1 KB) |
| 端上学习器 | 仅代码 | 两个 32 单元网络的权重、资格迹和归一化参数(Pac-Man 为 49 KB,Doom-lite 高达 106 KB;随输入特征数量增长) |
| 固件 | 代码、USB、显示驱动(约 150 KB) | 栈(core 1 为 16 KB)、USB 缓冲区、帧通道 |
每个游戏都能塞进 4 MB flash 和 512 KiB SRAM。Breakout 用 361 KB flash 和 299 KB SRAM;最大的 Pac-Man 用 600 KB 和 460 KB。
大部分时间花在 int8 点积上(src/lib.rs 里的 dot_i8)。一次 32 位加载取回 4 个权重,SXTB16 把字节 0/2 和 1/3 解包成 16 位两半,SMLAD 在一条指令里做两次乘加。注意力把 uint8 概率乘以 int8 值,所以改用 UXTB16。归一化、exp 查表和最后按输出做的缩放仍留在 FPU 上用 float32 算。2 个循环的一帧是 2–4M 次乘加(Pac-Man 是 8.2M);在桌面 CPU 上,同样的 Rust 代码做一帧梦境耗时 0.7 ms(Flappy Bird)到 1.5 ms(Breakout)。Pico 本身的帧率我还没测。
板子上电后是一个在设备上从头学的智能体。通过 USB 按 l,或在 Display Pack 上按住 B 键 1 秒,切换到预训练的 actor,再按一次切回来。
代码、权重和完整的复现步骤:github.com/SheepSeb/tinyworldformer