なぜ coding agent はこんなに愚かなのか?
モデルは半年ごとに進化するのに、それを動かす coding agent は足踏みしたままだ。並列にできる作業を直列でこなし、安いモデルへの委任もせず、自分の機能すら知らない。著者は原因をプリンシパル・エージェント問題に帰す。
日本語
コピー
coding agent を初めて使ったとき、私はすっかり魅了された。それまでは IDE と AI のチャット画面の間でコピー&ペーストを繰り返していた。agent がファイルを直接書き換え、自分のエラーをその場で直していく様子は、確かに衝撃だった。
数日経つと新鮮味は消え、bug が頻発し始めた。agent は完全に無反応になり、再起動しないとどうにもならない。開発フローは耐えがたいほど原始的で、しかも作業はまだ始まったばかりなのに、agent はしょっちゅうタスク完了を宣言する。
2025 年 2 月のことだ。coding agent はまだ黎明期にあった。私の見立てでは、半年もすれば agent の技術的な性能は土台の LLM に追いつくはずだった。
そうはならなかった。coding agent はとにかくずっとダメなままだ。
AI 支援開発は確かに進歩している。だが実際に働いているのはモデルで、agent は依然としてボトルネックだ。
agent はモデルではない
AI をめぐる喧噪の中で、概念は簡単に混ざり合う。人々は「モデル」と「agent」を混同し、重ねて使うようになった。
私が「モデル」と言うときは、GPT Astra、Claude Sonnet、GLM-5.3 といった大規模言語モデル(LLM)を指す。モデルはテキストや画像を生成し、かなりまともなソフトウェアコードも生成する。
私が「agent」と言うときは、モデルをコードベースやコンピュータシステムにつなぐ層のソフトウェアを指す。Anthropic の Claude Code、OpenAI の Codex などだ。
単純な比喩で言えば、モデルは脳、agent は身体だ。モデルはテキストの列を出力し、agent はそのテキストをシステム内の正しいコマンドやファイルにつなぐ糊の役割を担う。
現在の coding agent の限界
agent はタスク管理が下手
coding agent に対する私の最大の不満は、タスク管理の仕方がひどくお粗末なことだ。
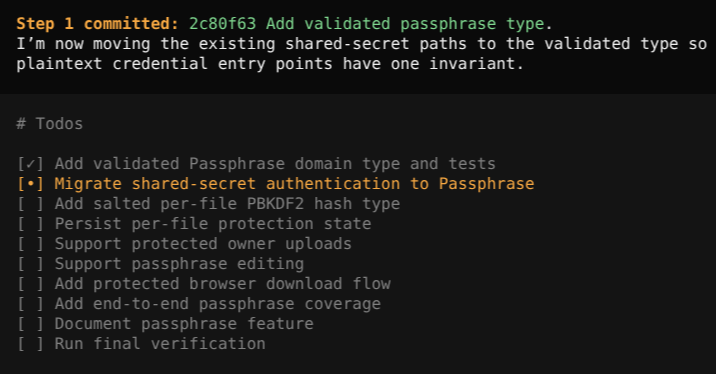
例えば、アップロードされたファイルから共有リンクを生成するオープンソースの web アプリがある。最近これにリンクをパスワードで保護する機能を追加した。変更は比較的単純で、新しいコードはおよそ 1.5k 行。OpenCode はお利口にもこの機能を 10 個のサブタスクに分解し、そして……一つずつ片付けていった:
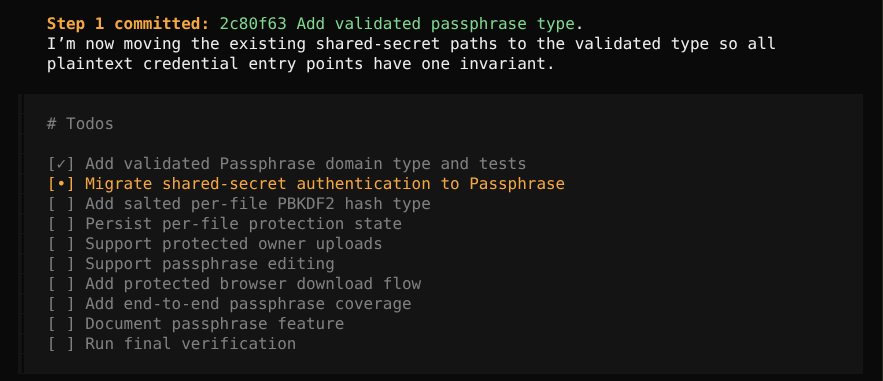
なぜこの気まずい並列タスクを一つずつ直列でやるのか?
おい……お前はコンピュータだろ! マルチタスクが一番得意なはずだ。CPU コアをこれだけ詰め込んでいるのはそのためじゃないか。複数のことを並行して処理でき、コンテキストスイッチは人間より何百万倍も速い。なぜこの気まずい並列タスクを一つずつ直列でやるのか?
Claude Code はマルチタスクをやるが、ほんの少しだけだ。subagent を一、二個立ち上げるが、全部走り終わるまで待ってから次に進む。毎日何度も、Claude Code がエンドツーエンドテストの完了を何分もただ待っているのを眺めることになる。テストが通ると、こう言い出す:「さて、そろそろ commit message を書く番だ。git の履歴を見て、君の commit message の流儀を学ぼう。」
agent は委譲しない
最先端のモデルを使い、5 万行のコードから特定のパターンを探させても、agent は決して立ち止まらない。「待てよ、これは別のモデルにやらせた方が安くて速い」とは考えない。ただ高いモデルを遅いまま走らせて、ひたすら進む。逆に、「このタスクはこのモデルには馬鹿すぎる、もっと賢いのを連れてこい」と言うことも決してない。
もちろん、私が自分で細かく指示して、モデルと thinking level を切り替え、サブタスクごとの難易度に合わせることはできる。だが、なぜそれが私の仕事なのか? ついでにスレッドプールも管理してやろうか? 使っていない RAM も解放してやろうか?
タスクの難易度を見極め、必要に応じてモデルを割り当てるのが最も得意な技術とは何か? LLM だよ! LLM に一番安くて速いモデルを選ばせて、そのタスクをやらせればいいだけじゃないか。なぜ私がお前を監視していなければならない?
95% が単純作業というタスクにしょっちゅう出くわすが、それでも一番賢いモデルに任せざるを得ない。タスクを分割し、agent の代わりに委譲する方が、私の時間を余計に食うからだ。
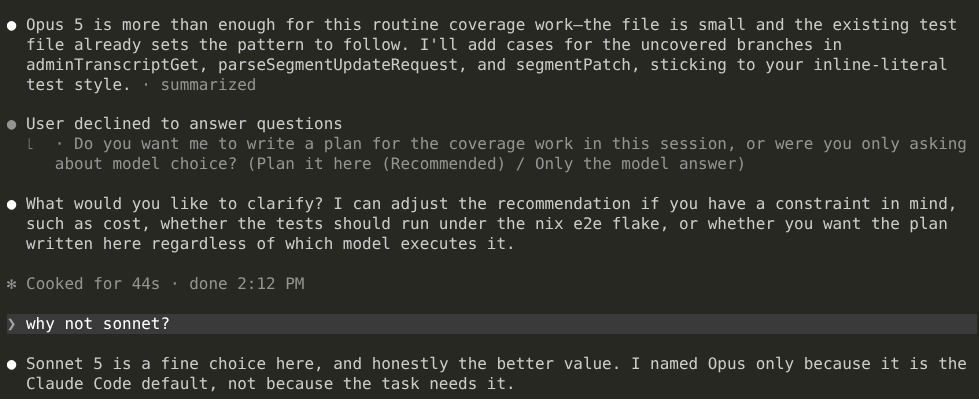
どれがデフォルトモデルか教えてくれてありがとう、Claude。
agent は agent のことを聞いたことがない
Agent は自分自身について何も知らない。Claude に Claude の機能の使い方を尋ねると、ネットで検索して回らないと、「Claude」なるものが一体何なのか把握できない。自分のことを話すより、Claude は C 言語の質問に答える方がよほどくつろいでいる(公平に言えば、ほとんどの人間の開発者もそうだが)。
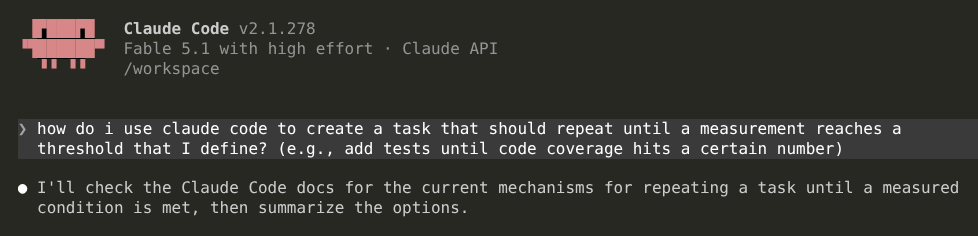
おい……お前が Claude Code だろ! 自分の機能すら知らないのか? しかもチュートリアルを検索するとき、バージョン番号が合っているかなんて気にもしない? ユーザーが一度も使ったことのない機能のために13 GB のファイルを平気でダウンロードするくせに、インストールパッケージに 50 KB の gzip テキストを足して、自分の機能を自分に説明するくらいは惜しむのか?
コードレビューを同僚に頼んだら、そいつが必死に Google を検索して、コードレビューが開発者の仕事なのかどうかを確認し始めたとしよう。翌日またレビューを頼むと、前の会話などまるごと忘れていて、また Google に戻り、こう打ち込む。"do software engineers do code reviews?"
Agent は計画をうまく説明できない
以前は、agent の「Plan」と「Execute」を 2 モードに分けるインタラクション設計が気に入っていた。複雑なタスクなら、まず agent に計画を書かせ、自分が目を通して修正意見を出し、実行はより速くて安い agent に任せる。
時間が経つうちに、こうした計画を読むのが嫌になってきた。レビューを飛ばして、そのまま agent に実装させることもよくあった。
最初は coding agent に甘やかされて怠けたせいだと思っていたが、後になって分かった。agent の計画の説明がひどすぎて、読むのが苦痛だったのだ。
以下は、Codex + GPT-6 Astra に自分のメディア記録 web アプリへ機能を追加させたときの例だ。
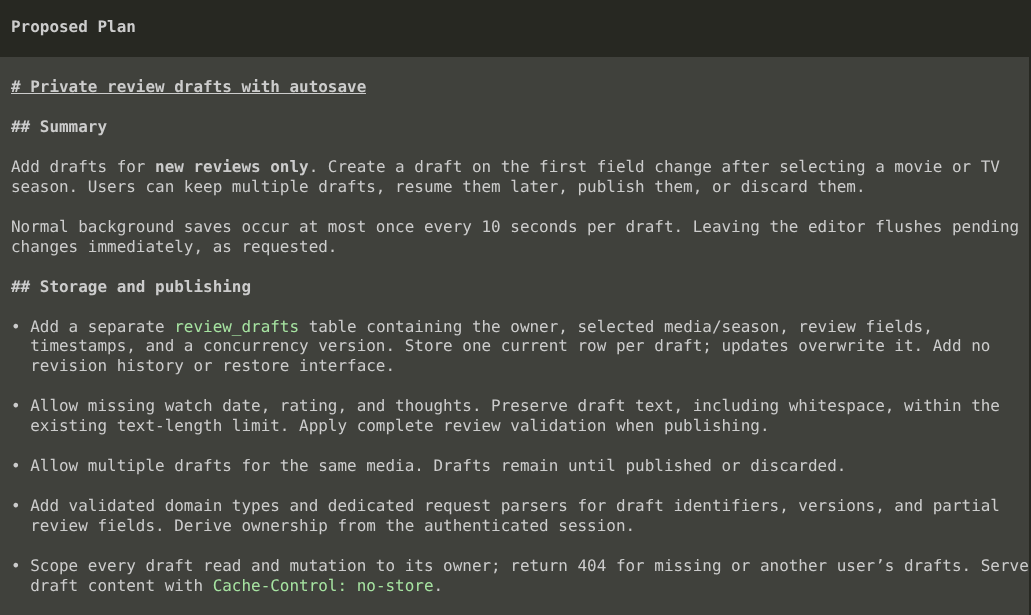
無関係な細部をただ並べて、それを計画と呼んでいるだけだ、Codex。
あれは計画ではない。低レベルの設計判断を寄せ集めただけの代物だ。
この機能の計画をまともな開発者に任せたら、UI 変更の高レベルな計画から始めて細部へ降りていくか、データモデルの変更を先に説明してから上へ積み上げていくかのどちらかだろう。その開発者がこの機能に関する断片的な事実を一つずつ並べ始めたら、ブレインストーミング中だと判断して、後でまた来る。
Agent はあらゆる口実で仕事を止める
先日の夜、寝る前に coding agent で長いタスクを起動した。翌朝戻ってみると、まだ仕事を始めてすらいなかった。私が離れて 2 分後に止まり、git ブランチの名前をどうするかと聞いて、一晩中そこで返事を待っていた。
従業員が、取るに足らない細部の判断を仰ぎたいがためにシフト中ずっと暇だったと言ってきたら、即座に解雇する。
Agent は不必要なリスクを取ってくれるときだけ役に立つ
最初の coding agent を使い始めたとき、agent がシステム上のどのファイルにアクセスできるかを制御する設定を探した。ファイルシステムの権限や制限付き chroot のようなもので、ランダムで予測不能なソフトウェアが私のマシン全体を好き放題に漁るのを防いでくれるはずだ。
なかった。ドキュメントはむしろ、LLM に丁寧な手紙を書いて、特定のファイルやディレクトリを読まないでほしいと懇願するよう勧めていた。そのとおりにすると、agent は即座に私の頼みを無視し、私有のアプリケーションキーを OpenAI と Anthropic に漏らした。
セキュリティ境界は coding agent が最初に実装するものの一つだと思っていたが、今日に至るまで、agent はすべてを開放してやっと使える代物だ。Agent は自社のサンドボックスを迂回することもよくある。もう一つの選択肢は、一日中 500 回「許可」をクリックして座っていることだが、これとて信頼できる保護ではない。遅かれ早かれ押し間違えるからだ。
本当に腹立たしいのは、サンドボックスツールが十数年前から存在し、coding agent がミスをしたときの影響範囲を完全に限定できることだ。私は自分でサンドボックスを作り、agent がリポジトリのディレクトリを越えてファイルシステムを漁れないようにした。agent がうっかり私のホームディレクトリを送信したり、マシン上の重要なファイルを削除したりする心配は一切ない。そんな権限がないからだ。
「coding agent は完璧だ、ただ……」
一部の読者は、適当な git リポジトリから 20 万行の skill ファイルをインストールするか、設定ファイルのマイナーなスイッチをオンにすれば、私の問題はすべて解決すると言うだろう。
私が話しているのは、coding agent のアウトオブザボックスの能力に何を期待するかだ。変なプラグインや skill ファイルを入れる必要もなく、設定の調整に何時間もかける必要もない。
私が理想とする agent
すべての coding agent に期待すること
以下が、2026 年の coding agent の最低ラインだと私が考えるものだ。
- agent はリクエストを一連のタスクに分解し、各タスクを適切なモデルに割り当てる。
- agent はコスト、速度、正確性の間で最適化し、ユーザーがタスクごとにこれらの軸を調整できるようにする(たとえば少し多く払って速い結果を得る)。
- agent が書く計画は、人間が理解することを最適化の目標にする。
- agent は高い抽象度から始め、徐々に細部へ進む。
- agent は UI スケッチ、データフロー図、決定木を描く。
- agent は本物のサンドボックスで動く。
- サンドボックスは OS レベルのセキュリティプリミティブを使い、ファイルシステムとネットワークのレベルで境界を引く。
- アクセス制御のコードはすべて決定的であり、「agent はこうしない方がいい」という軟らかい示唆ではない。
- bash コマンドに正規表現を足すのはサンドボックスかと agent に聞いたら、「違う」と答えなければならない。
- agent は環境ごとにサンドボックス分離を行う。
- デフォルトでは、agent は一つのリポジトリ/ディレクトリにしかアクセスできない。
- セッションごとに、他のリポジトリへの読み取り専用または読み書き権限を agent に与えられる。
- agent はそれ自身の専門家である。
- あるタスクやワークフローをどう表現すればいいかと agent に聞いたら、ネットで検索せずに答えられる。
- agent は任意の LLM プロバイダーを使える。無制限プランも含めて。
- agent はオープンソースである。
- 「実行」モードで私が質問に答えておらず、30 分間そのセッションとやり取りがなければ、agent は自分で決定する。
- agent は「AFK モード」も提供し、この 30 分の待機をスキップする。
- agent は子 agent を直接操作させてもくれる。
- いつでも任意の agent セッションに入り、引き継ぐか、早期終了させられるべきだ。
- agent が Fable は私の Max プランに含まれていないと言ってきたら、その agent ベンダーの CEO はバグが直るまでずっと枷に繋がれているべきだ。
もっと大きく夢を見る
どうせ夢物語なら、ということで、見てみたい機能をもういくつか挙げておく。ただ、いくつかは私のワークフローに寄りすぎている自覚もある。
- Agent が Web インターフェースを提供し、すべてのセッションを一箇所に集約して、どれが自分の対応を待っているかを示してくれる。
- Web バックエンドはローカルで動く。公衆網にトンネルを開けて、外部から自分のマシンで任意のコマンドを実行させたくはない。
- Web インターフェースはスマホでもちゃんと使える。
- Agent がタスク完了までの所要時間を見積もってくれる。
- 各サブ Agent もそれぞれ自分の見積もりを持つ。
- タスクが進むにつれて、Agent がこの見積もりを更新し続ける。
- Agent が過去の見積もりの精度に基づいて自分の見積もりアルゴリズムを調整する。
- Agent が自分のセッションを振り返り、改善の余地を探す。
- たとえば「この 5 日間、この 20 GB のログファイルをその場限りのコマンドで解析するために毎日 1,000 ドル分のトークンを燃やしていた。専用ツールを作って効率よくやろう」といった具合に。
- Agent に、言語を認識する使いやすい diff ビューが備わっている。
- Agent が何をしたのか確認するために、わざわざ GitHub に push しないとまともな diff が見られない、という状況は避けたい。
- Agent がプロキシ経由で鍵を注入するネットワークリクエストをネイティブにサポートしている。
- Agent は認証情報が必要なリクエストを送れるが、認証情報を他のホストに漏らすことはできない。
- Agent が適切なモデルを選ぶときに、各社のクォータ制限を考慮する。
- たとえば、週次のクォータが 3 時間後にリセットされ、今はまだ 90% 残っているなら、コスト削減のための最適化はもうやめる。
- 複雑さが設定可能なしきい値を超えるタスクでは、Agent が自動的に別のモデルにコードレビューを依頼する。
- 2 つのモデルが修正案で合意に達するまで、レビューを繰り返す。
では、なぜ harness はこんなに鈍いのか?
さて、タイトルの問いに戻るが、納得のいく答えは持っていない。
一番ありそうなのは、coding agent への投資不足が委任–代理問題の一例だという見方だ。AI ツールの方向性を決めるのは、Anthropic、OpenAI、Google といった企業の幹部たちだ。彼らは coding agent を毎日使っている普通の開発者とはかけ離れている。その多くが、人間の開発者を完全に自動化して不要にする未来を夢見ている。
AI 企業の幹部、そして彼らの最大の顧客と株主が気にするのは、自分たちが理解できる指標、つまり派手なデモと benchmark のスコアだ。安全性や、人間の開発者の時間をどれだけ有効に使えるかは、デモとはほとんど関係がない。そして私が見てきた benchmark のうち、agent そのものを測っているものはほとんどなく、測っているのは土台のモデルだけだ。
この仮説がしっくりこないのは、AI 企業が coding agent をそれなりに気にかけているのは明らかだからだ。Claude と Codex は毎月のように機能を追加している。もっとも、最後にどれが自分の生活を改善してくれたのか、思い出せないのだが。
私にもっと合う coding agent はあるのか?
試したことがあるのは Claude、Codex、OpenCode、Cline、Pi だけだ。日常的に使っているのは OpenCode と Claude Code。おすすめの coding agent があれば、コメント欄で教えてほしい。
AI 企業の方々——もし私の想像上の coding agent を 500 億ドルで買いたいなら、連絡をください。VS Code を fork する準備はできている。