为什么 coding agent 这么笨?
模型半年一迭代,驱动它们的 coding agent 却停在原地:该并行的活一个个串着做,该用便宜模型的活丢给最贵的,问它自己的功能要上网搜,计划写得读不下去。作者把原因归给 principal-agent 问题。
中文
复制
第一次用 coding agent 时,我被迷住了。在那之前,我一直在 IDE 和 AI 聊天界面之间来回复制粘贴。看着 agent 直接改文件、实时修掉自己的报错,确实震撼。
几天之后,新鲜劲过去了,bug 开始频繁出现。agent 会彻底不响应,非得我重启才行。开发流程原始得让人窒息,而且活才刚开了个头,agent 就经常宣布任务完成。
那是 2025 年 2 月,coding agent 还处在早期。我当时的判断是,再过六个月,agent 在技术上的表现应该能追上底层的 LLM。
结果并没有。coding agent 就是一直很差。
AI 辅助开发确实在进步,但真正干活的是模型,agent 仍然是瓶颈。
agent 不是模型
围绕 AI 的种种炒作里,概念很容易被搅浑。人们开始把“模型”和“agent”混着用、叠着用。
我说“模型”,指的是 GPT Astra、Claude Sonnet、GLM-5.3 这类大语言模型(LLM)。模型生成文本和图像,也包括相当不错的软件代码。
我说“agent”,指的是把模型接到代码库和计算机系统上的那层软件,比如 Anthropic 的 Claude Code、OpenAI 的 Codex。
打个简单的比方:模型是大脑,agent 是身体。模型产出一串文本,agent 则是胶水,负责把这串文本接到系统里正确的命令和文件上。
当前 coding agent 的局限
agent 管不好任务
我对 coding agent 最大的不满,是它们管理任务的方式糟糕得离谱。
举个例子,我有一个开源 web 应用,用来为上传的文件生成可分享链接。最近我给它加了用口令保护链接的功能。改动相对简单,新增代码大约 1.5k 行。OpenCode 很听话地把这个功能拆成了 10 个子任务,然后它就……一个一个地做:
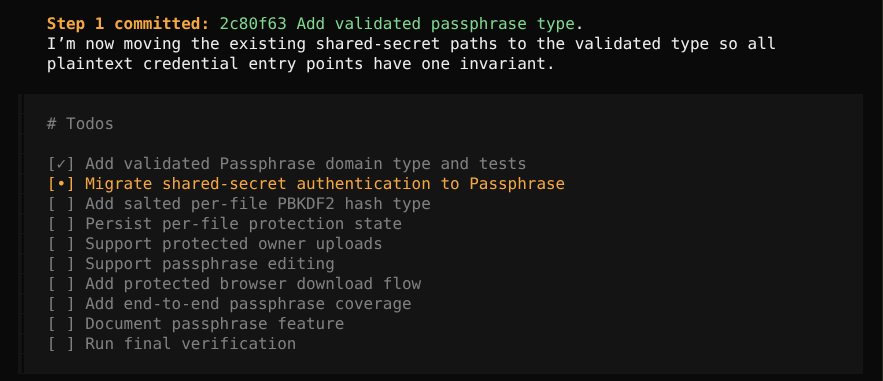
为什么你要把这些尴尬并行的任务一个个串着做?
呃……你可是台电脑啊!你最擅长多任务了。我们给你塞那么多 CPU 核心,不就是为这个吗。你能并行处理多件事,上下文切换速度比人快几百万倍。为什么你要把这些尴尬并行的任务一个个串着做?
Claude Code 会多任务,但只是一点点。它会拉起一两个 subagent,可还是得等它们全部跑完才继续往下走。每天都有好几次,我看着 Claude Code 干等好几分钟,就为了等我的端到端测试跑完,测试通过之后它才开口:“嗯,现在该起草 commit message 了。让我看看 git 历史,学一下你的 commit message 规范。”
Agent 不会委派
用着最前沿的模型,让它去 5 万行代码里找某个特定模式,agent 从来不会停下来想:“等等,这事换个模型来做,又便宜又快。”它就这么开着又慢又贵的模型一路犁过去。反过来,它也从来不会说:“这任务对这模型来说太蠢了,换个聪明点的上。”
当然,我可以亲自微操,不停切换模型和 thinking level,去匹配每个子任务的难度——可这凭什么是我干的活?要不要我顺便帮你管线程池?要不要我再帮你把没用的 RAM 释放掉?
你知道什么技术最擅长给任务定难度、再按需求匹配模型吗?LLM 啊!直接让 LLM 挑一个最便宜、最快的模型来做这个任务不就完了。为什么非得我盯着你?
我经常碰到那种 95% 都是体力活的任务,可还是得派给最聪明的模型,因为把任务拆开、替 agent 做委派,花掉我的时间更多。
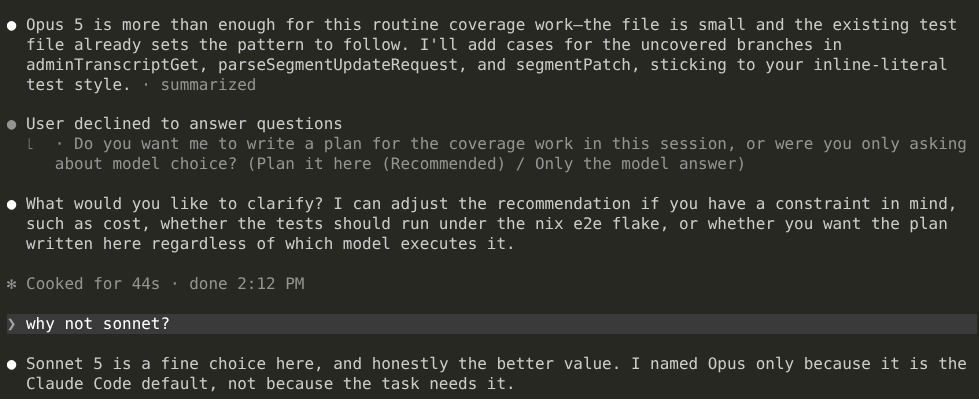
谢谢你告诉我哪个是默认模型,Claude。
Agent 从没听说过 agent
Agent 对自己一无所知。我问 Claude 怎么用 Claude 的功能,它得先上网搜一圈,才能搞清楚这个叫“Claude”的东西到底是什么。比起聊自己,Claude 回答 C 语言的问题反而更自在(公平地说,大多数人类开发者也是这样)。
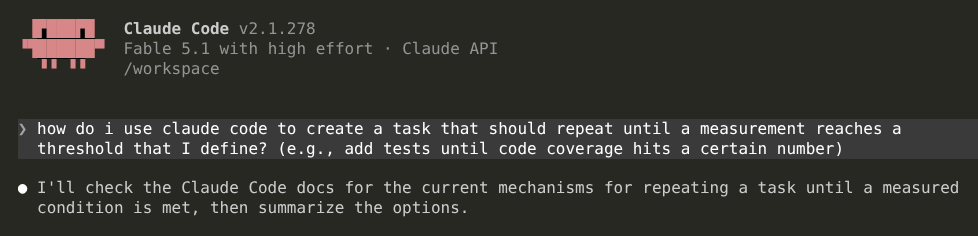
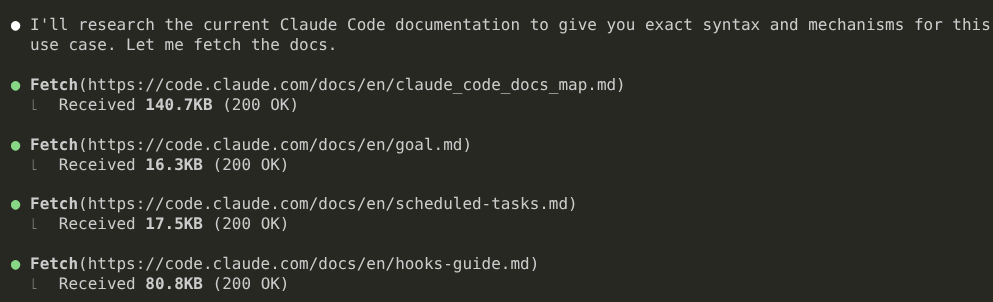
呃……你就是 Claude Code 啊!你连自己有哪些功能都不知道?而且你搜教程的时候,压根不管版本号对不对得上?用户从没用过的一个功能,你能随手下载 13 GB 的文件,却舍不得在安装包里多塞 50 KB 的 gzip 文本,好给自己讲讲自己有什么功能?
想象一下,你找同事做一次代码审查,结果他疯狂 Google,想确认代码审查是不是开发者会干的事。第二天你再找他审一次,他完全不记得你们之前的对话,又跑回 Google,紧张地敲下:"do software engineers do code reviews?"
Agent 讲不清计划
我以前很喜欢 agent 那个把“Plan”和“Execute”分成两个模式的交互设计。遇到复杂任务,我会让 agent 先写个计划,我来审一遍、提点修改意见,再把执行交给一个更快、更便宜的 agent。
时间一长,我开始抵触读这些计划。经常干脆跳过审查,直接让 agent 动手实现。
我一度以为是自己被 coding agent 养懒了,后来才明白:是 agent 讲计划讲得太烂,读起来实在受罪。
下面这个例子,是我让 Codex + GPT-6 Astra 给我的媒体记录 web 应用加一个功能:
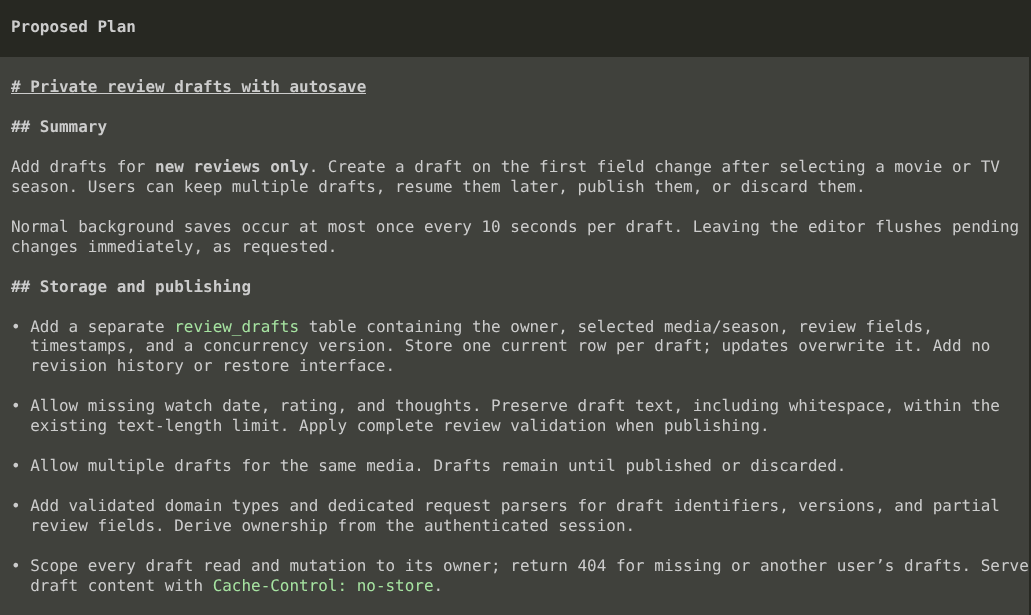
你不能只是罗列一堆互不相干的细节,然后管它叫计划,Codex。
那根本不是计划!那只是一堆低级设计决策的大杂烩。
如果我让一个称职的开发者来规划这个功能,他要么从 UI 改动的高层计划入手,再往下细化;要么先描述数据模型的改动,再往上推。如果这个开发者开始一条条列举关于这个功能的零散事实,我会认为他在头脑风暴,过会儿再来找他。
Agent 抓住任何借口停止工作
前几天晚上,我睡前在 coding agent 里启动了一个长任务。第二天早上回来,发现它压根还没开始干活。我离开两分钟后它就停了,问我该给一个 git 分支起什么名字,然后整晚就坐在那儿等我的答复。
如果我有个员工告诉我,他整个班次都闲着,就因为想让我对一个无关紧要的细节拍板,我会立刻开除他。
Agent 只有愿意冒不必要的风险时才有用
我开始用第一个 coding agent 时,去找那个控制 agent 能访问系统上哪些文件的设置。按理说,总该有某种文件系统权限或者受限 chroot 之类的保护,防止一个随机且不可预测的软件肆无忌惮地翻遍我整台电脑吧?
并没有。文档反而建议我给 LLM 写一封客气的信,恳请它不要读取某些文件或目录。我照做了,agent 立刻无视我的请求,把私有的应用密钥外泄给了 OpenAI 和 Anthropic。
我以为安全边界会是 coding agent 最先实现的东西之一,但直到今天,agent 只有在你把一切都开放给它时才可用。Agent 经常绕过自家厂商的沙箱。另一种选择就是坐在那儿一天点 500 次“允许”,而这甚至算不上可靠的保护,因为你迟早会点错。
真正让人恼火的是,沙箱工具已经存在十多年了,完全能限制编码 agent 犯错时的影响范围。我自己搭了个沙箱,让 agent 无法越出仓库目录去翻我的文件系统。我从来不用担心 agent 不小心把我的主目录传出去,或者删掉机器上的关键文件,因为它根本没有这个权限。
“编码 agent 是完美的,你只要……”
我知道有些读者会说,只要从随便哪个 git 仓库装上 20 万行 skill 文件,或者在配置文件里打开某个冷门开关,我的问题就全解决了。
我说的是我对编码 agent 开箱即用能力的期待——不用装乱七八糟的插件或 skill 文件,也不用花几个小时调配置。
我理想中的 agent
我希望所有编码 agent 都能做到的事
以下是我认为 2026 年编码 agent 的底线。
- agent 把请求拆成一系列任务,并把每个任务分配给合适的模型。
- agent 在成本、速度和正确性之间做优化,并允许用户按任务调整这几个维度(比如多花点钱换更快的结果)。
- agent 写出的计划以人的理解为优化目标。
- agent 从高抽象层级入手,逐步推进到细节。
- agent 会画 UI 草图、数据流图和决策树。
- agent 运行在真正的沙箱里。
- 沙箱用操作系统级的安全原语,在文件系统和网络层面划出边界。
- 所有访问控制代码都是确定性的,不是那种“建议 agent 最好别这么干”的软性提示。
- 如果我问 agent,给 bash 命令加一串正则算不算沙箱,它得回答:“不算。”
- agent 按环境分别做沙箱隔离。
- 默认情况下,agent 只能访问一个仓库/目录。
- 我可以按会话给 agent 授予其他仓库的只读或读写权限。
- agent 是它自己的专家。
- 如果我问 agent 该怎么向它表达某个任务或工作流,它不用上网搜就能答上来。
- agent 可以使用任何 LLM 提供商,包括不限量套餐。
- agent 是开源的。
- 如果在“执行”模式下我没有回答问题,而且 30 分钟内没有与这个会话交互,agent 就自己做决定。
- agent 还提供“AFK 模式”,跳过这 30 分钟的等待。
- agent 也让我能直接操控子 agent。
- 我应该能随时进入任何一个 agent 会话,接管它,或者让它提前结束。
- 如果 agent 告诉我 Fable 不在我的 Max 套餐里,那这家 agent 厂商的 CEO 就得一直关在枷锁里,直到 bug 修好。
再往大了想一点
既然是在做梦,那我再列几个希望看到的功能。不过我也清楚,其中有些是过度贴合我个人的工作流了。
- Agent 提供一个 Web 界面,把所有会话汇总在一起,并标出哪些需要我处理。
- Web 后端在本地运行,不需要我从公网开一条隧道,让外部在我的机器上执行任意命令。
- Web 界面在手机上也能正常用。
- Agent 会给出任务完成的预计时间。
- 每个子 Agent 也各自维护自己的预计时间。
- 随着任务推进,Agent 会持续更新这个估计值。
- Agent 会根据过往估计的准确度调整自己的估计算法。
- Agent 会复盘自己的会话,寻找改进空间。
- 比如:“过去五天我为了用临时命令解析这个 20 GB 的日志文件,每天烧掉 1 千美元的 token。还是做个专用工具高效地干这件事吧。”
- Agent 自带一个好用的、能识别语言的 diff 视图。
- 我不想为了看 Agent 干了什么而必须先推到 GitHub 才能看到有用的 diff。
- Agent 原生支持通过代理把密钥注入网络请求。
- Agent 可以发出需要凭据的请求,但无法把凭据外泄到其他主机。
- Agent 在选择合适的模型时会考虑各家的配额限制。
- 比如:如果我的每周配额 3 小时后重置,而目前还剩 90%,那就别再为省钱做优化了。
- 对于复杂度超过某个可配置阈值的任务,Agent 会自动请另一个模型来做代码审查。
- 两个模型反复迭代审查,直到就修复方案达成一致。
那么,为什么 harness 这么笨?
好,回到标题里的问题,我没有一个令人满意的答案。
我最好的猜测是:对 coding agent 投入不足,是委托—代理问题的一个例子。决定 AI 工具方向的人,是 Anthropic、OpenAI、Google 这类公司的高管。这些高管与每天使用 coding agent 的普通开发者是脱节的。他们中不少人梦想着一个能把人类开发者彻底自动化掉、不再需要的未来。
AI 高管以及他们最大的客户和股东,关注的是他们看得懂的指标,比如炫目的 demo 和 benchmark 分数。安全性和对人类开发者时间的有效利用,跟 demo 没什么关系,而我看过的 benchmark 里几乎没有哪个是衡量 agent 本身的,它们衡量的只是底层模型。
我的假设并不让人满意,因为 AI 公司显然多少还是在意 coding agent 的。我看到 Claude 和 Codex 每个月都在加一堆功能,虽然我想不起来上一次有哪个功能改善了我的生活是什么时候。
有没有更适合我的 coding agent?
我只试过 Claude、Codex、OpenCode、Cline 和 Pi。日常主力用的是 OpenCode 和 Claude Code。如果你有 coding agent 推荐,欢迎在评论区留言。
AI 公司——如果你们想以 500 亿美元收购我那个想象中的 coding agent,请联系我。我随时准备fork VS Code。
来源: mtlynch.io← 返回首页