一台奔腾上的现代国际象棋引擎,能在 1996 年击败 Kasparov 吗?
IBM 花了数百万美元打造深蓝,才在 1996 年击败 Kasparov。三十年后,一台 200 MHz 的 Pentium Pro 跑起现代 Stockfish,棋力约 3300 Elo,几乎肯定能赢。
中文
复制
1996 年 2 月 10 日,一个计算机程序(IBM 的 Deep Blue)在一盘国际象棋中首次击败了当时的棋王 Garry Kasparov。Deep Blue 最终输掉了那场比赛,但一年后,它以 3.5 比 2.5 赢下重赛,完成了复仇。
为此,IBM 投入数百万美元研发,专门打造了一台为此目的服务的专用计算机。Deep Blue 本身(获胜的那台升级版)由 30 个 P2SC 处理器驱动,每个主频约 120 MHz;更重要的是,它还搭载了 480 个定制 VLSI 国际象棋协处理器,用来执行走法生成、局面评估这类国际象棋专用运算。建成时,Deep Blue 是全球第 259 强的超级计算机,每秒可分析超过 2 亿个棋局局面。
但击败 Kasparov 真的需要 Deep Blue 吗?还是说,一台 1996 年的现成台式机,跑一个更聪明的国际象棋引擎,就足够了?
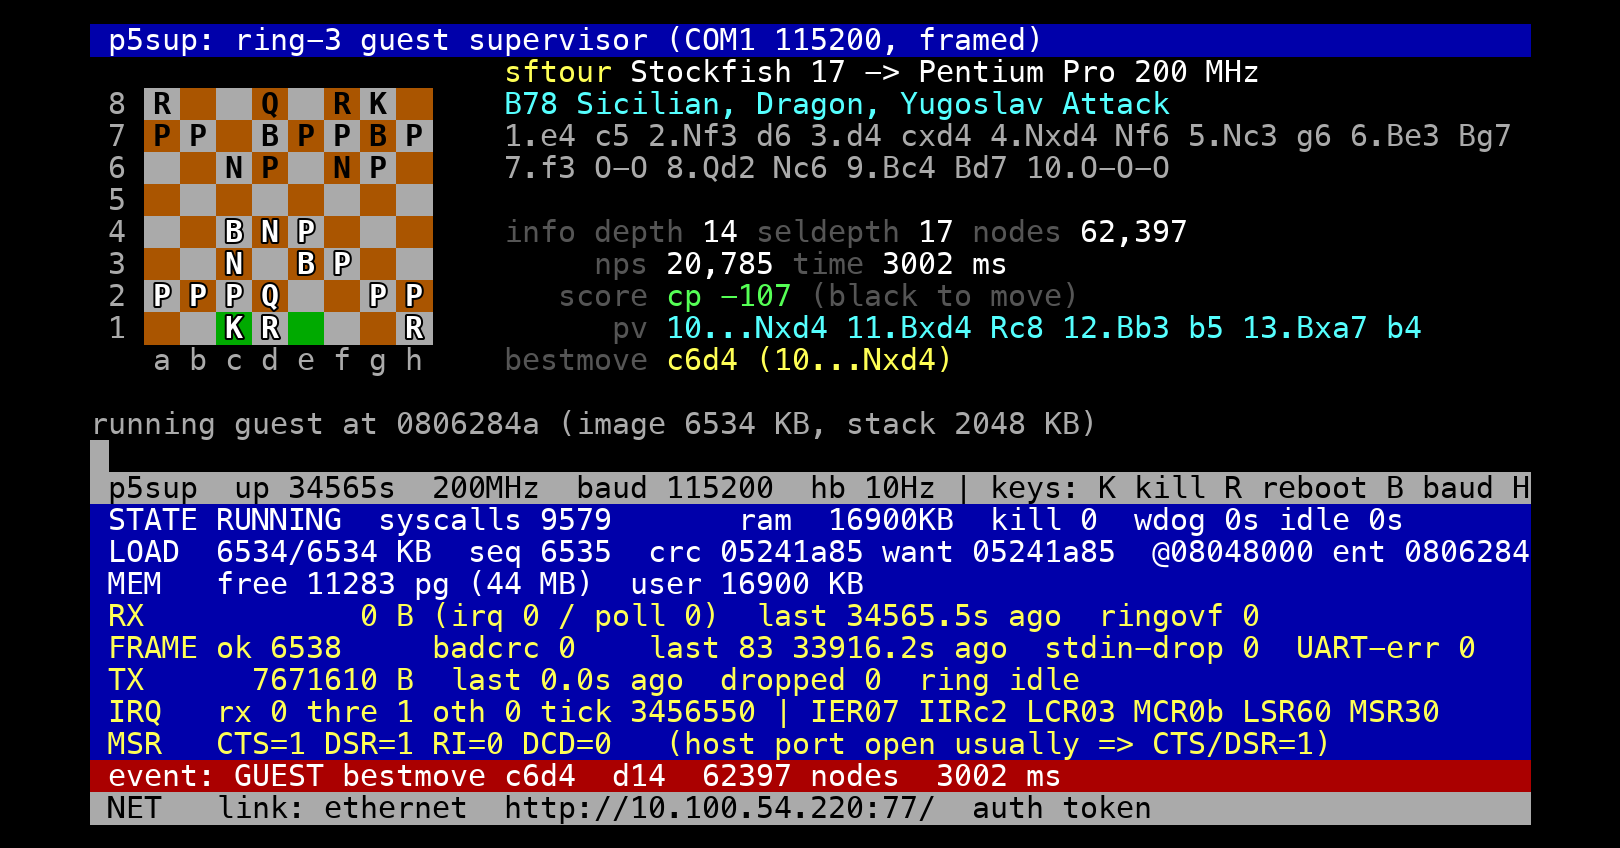
事实证明,我们完全可以在不造 Deep Blue 的情况下轻松击败 Kasparov,只用市面上的普通硬件,而且(几乎可以肯定)赢面还不会小。我之所以知道这一点,是因为就在写下这句话的时候,我旁边就摆着一台 200 MHz 的 Intel Pentium Pro(发布于整整 31 年前,也就是 1995 年 11 月 1 日),配 64MB 内存,运行着一个定制移植版的 Stockfish,在经典时限下估计 Elo 为 3300 ± 87,远超任何人类棋手,更不用说 Kasparov 那略低于 2800 的 Elo 了。但这还没完!我用一块 Realtek RTL8139C 网卡把这台机器接上了互联网,所以你可以在原文页面上和它对弈!
Pentium Pro 的显示器,实时画面(其 VGA 文本屏幕,每秒刷新一次)
等等,什么?!怎么做到的??
提升棋力有三条路:分析更多走法、分析更好的走法,或者把走法分析得更好。众所周知,人类靠的是后两条:一位国际象棋特级大师在经典对局中分析的走法数量和业余棋手差不多,但他们只分析最关键的那些走法,而且分析得更到位。像 Stockfish 这样的国际象棋引擎跑在硅片上而非人脑里,在第一条路上彻底碾压我们,每秒能分析数百万个局面。而现代引擎在微优化上的空间已经没有那么大,很难再让给定的 CPU 每秒多处理多少局面,所以国际象棋 AI 的大部分进展也往往沿着人类提升棋力的路径走:寻找更好的走法选择方法和局面分析方法。
国际象棋水平用 Elo 分衡量。200 分的差距意味着,强的一方每四局应当能赢三局;差距再大,就按这个比例叠加:400 分对应 90% 的期望得分,1000 分对应 99.7%。在 1996 年的普通硬件上能跑起来的最强国际象棋引擎,等级分大约 2300;Deep Blue 是 2700。相比之下,现代 Stockfish 接近 3700。
问题随之而来:现代国际象棋引擎的优势,有多少来自现代台式机极其快,又有多少只是因为我们更会写国际象棋引擎了?答案是,大部分 Elo 提升(总共 +1335 中的 +720)来自更好的编程,而不是更好的硬件。
为了验证这一点,我做了两个实验。第一个实验用 Crafty,这是 1996 年的一款有竞争力的引擎,源码如今已经公开。在我的 Pentium Pro 上,1996 年编译的 Crafty 11.13 在每步 1 秒时 Elo 为 1999 ± 90,每步 10 秒时为 2383 ± 77。换到现代硬件(Ryzen 7)上,同样是每步 1 秒,这个引擎的 Elo 大幅跳到 2614 ± 97。但如果拿这个引擎,一点点加入我们关于如何设计更好的国际象棋引擎的全部知识,包括 fail-soft、LMR、correction history 这类现代搜索算法、更好的静态搜索方法,以及神经网络评估(NNUE),那么在 Pentium Pro 上每步 1 秒可以提升到 2718 ± 34,每步 10 秒可以到 2974 ± 74。
第二个实验走得更远:与其改造 Crafty,不如直接让当今最强的国际象棋引擎 Stockfish 跑在 1996 年的硬件上,看看表现如何。这需要一些工作,主要是重写代码,让它使用 32 位算术(PPro 是 32 位机器),并且不占用超过 64MB 内存。这个朴素移植版在每步 1 秒时 Elo 约为 2496 ± 64(每步 10 秒为 2940 ± 76)。但我们还能做得更好!现代 Stockfish 是为现代 CPU 设计的。对算法做一系列调整、针对 Pentium 调优之后,每步 1 秒可以提升到 2846 ± 35,每步 10 秒到 3109 ± 79,每步 30 秒到 3180 ± 80。
要概括上面这些内容,最简洁的办法就是让它们互相对弈 100 局。我照做之后发现:一台跑在 1996 年 Pentium Pro 上的现代国际象棋引擎,对阵一台跑在现代硬件上的 1996 年 Crafty,结果是前者胜 78 局、和 17 局、负 5 局。
本文余下部分给出细节。
技术细节:硬件与操作系统
说实话,硬件没什么好讲的。我买了一台二手台式机(商品页面写的是“复古”;我觉得自己老了),配置都是那个年代的标准件。这台机器是 200 MHz 的 Intel Pentium Pro,插在 Intel VS440FX 主板上,配 64MB、66 MHz 的 SIMM 内存。操作系统从一张 1.44MB 的 3.5 英寸软盘启动,通过 Realtek RTL8139C 联网。我还装了一块 1MB 的 Trio64V+ 显卡,用 VGA 接显示器,输入走 PS/2 键盘,不过这两样我基本不用,而是通过串口连到我的现代台式机上和它通信。
有些读者可能对这套硬件的价位没有概念:一块 200 MHz 的 Pentium Pro 在 1995 年 11 月发布时售价 1,325 美元,四条 16 MB 的 SIMM 还要再花大约 2,000 美元。加上其他外设,这台机器当年大概要四五千美元。所以它是一台不错的工作站,但绝不是超级计算机。不过考虑到硬件的贬值速度和指数级的性能提升,同一台机器到 1997 年、也就是第二场比赛举办时,大概只值一千美元了(毕竟几乎各方面都更好的 Pentium MMX 当时只要 400 美元,谁还愿意买 Pentium Pro?)
国际象棋引擎和互联网之间的接口,是我自己写的一个“操作系统”,它唯一的任务就是把引擎跑起来并直接接到网卡上。(本文中凡是说“我写了”,实际意思是“我让 LLM 写了”;这里的代码是我用 Fable 5.1、Opus 5.5 和 GPT-6 组合实现的,不过这篇文章本身是人写的。)它的设计目标是尽可能紧凑:这个操作系统(其实更像是个 hypervisor 之类的东西)放在一张可启动软盘上,唯一的任务是把 Pentium Pro 引导进 32 位保护模式、初始化网卡,然后等待后续指令。之后我可以把任意“用户态”客户程序送进内存,它就会启动并运行该程序。我写的国际象棋程序会启动一个自己实现的 HTTP 服务器,等待带有局面(FEN 字符串)和最长运行时间的 HTTP 请求;每收到一个请求,它就运行引擎直到计时结束,然后返回响应。
技术细节:软件
前面说过,我(再强调一次:一个语言模型)实际改动了两个引擎。其中较强的那个由 Stockfish 改造而来,专门针对一颗三十年前的处理器做了运行效率优化。在经典时限下它的估计等级分约为 33001,比 Kasparov 的 2800 高出不少,因此我们应当预期 Stockfish-1996 以大约 9/10 的比分取胜。稍弱一些的那个引擎以 Crafty 11.13 的源码为起点,把过去三十年里我们学到的、关于如何写出更好的国际象棋引擎的经验全部加了进去,将它一路推进到现代。
用现代技巧升级 Crafty 11.13(1996)
我(准确地说,是我的 LLM)动手改的第一个引擎是 1996 年发布的 Crafty 11.13。在这个引擎上,LLM 花的功夫最多,要把过去三十年积累的思路逐一移植回去。下面拆解的是等级分增益的来源,分别按每步 1 秒和每步 10 秒两种条件评估。
有时你会发现 1 秒与 10 秒下的提升幅度对不上。其中一部分显然是噪声,毕竟我只跑了几百局,误差范围相对较大,但这里面也确实有相当多的信号。1996 年的电脑慢得多,1 秒/步时搜索深度很低,因此评估函数跑得多快比它有多准更重要。而在更大的搜索深度下,一旦不再犯战术性失误,局面评估就变得重要得多。
| 1 秒/步 | 10 秒/步 | 改动 |
|---|---|---|
| 1999 ± 90 | 2383 ± 77 | Crafty 11.13,1996 年 12 月发布,原样出厂。最初写就的 alpha-beta 引擎,自带一个定制的评估函数,搜索算法是 90 年代的标准做法。 |
| 2063 ± 73 (+64 ± 116) | 2323 ± 75 (−60 ± 107) | 第一项改进主要是微优化。它把两张各有 64K 表项的查找表换成对 bsf/bsr 指令的调用;滑动棋子的攻击判定也从旧的 rotated-bitboard 函数调用迁移出来。这些改动合计让引擎快了 15%,但算法没变。 |
| 2022 ± 73 (−41 ± 103) | 2420 ± 76 (+97 ± 106) | 下一项改进针对搜索算法。包括 fail-soft(返回真实分数而非截断)、futility pruning 和 late-move pruning(在叶节点附近跳过安静着法)、late move reduction(对靠后的着法少搜一层),以及按 counter-move 和历史表对着法排序。 |
| 2224 ± 72 (+202 ± 103) | 2520 ± 74 (+100 ± 106) | 接下来调整搜索和评估函数。先用 SPSA 基于数千局自我对弈来调所有搜索常数。然后给评估项分别设中局和残局取值(按剩余子力混合),并重新拟合全部评估权重(Texel tuning)。最后在评估函数里加入 mobility 项,奖励棋子攻击到的安全格。 |
| 2192 ± 72 (−32 ± 102) | 2565 ± 74 (+45 ± 104) | 从这里开始,评估函数被重写,换成一个神经网络评估,小网络用 1100 万个自我对弈局面训练,标签由它自己的搜索给出。这一步本身作用不大,但为下一步做了铺垫…… |
| 2420 ± 82 (+228 ± 109) | 2712 ± 74 (+147 ± 104) | 用更强的老师替代自我对弈,重新生成刚做出来的 NNUE。原则上我可以拿这个引擎自己当老师,但为了省实际耗时,我用了 Stockfish。这把实际耗时从约 4000 个 1996 核心年(在 1996 年完全做得到,可惜我只有一台孤零零的台式机,做不到)缩短到现代台式机上跑现代引擎的几天。 |
| 2630 ± 82 (+210 ± 116) | 2810 ± 75 (+98 ± 105) | 评估函数强了很多,搜索现在可以真正依赖它。加入 reverse futility pruning,在评估显示局面已经赢定时提前返回。评估器也做了一些性能改进(加评估缓存,累加器与 null move 共用)。这让网络可以加宽 6 倍。还清理了一些代码,比如去掉 Crafty 里某些特殊处理,这些处理在评估函数较弱时有用,有了 NNUE 之后已不再需要。 |
| 2720 ± 82 (+90 ± 116) | 2938 ± 74 (+128 ± 105) | 有了新的评估函数,参数再次用 SPSA 重新调优。顺带修掉了代码里的一些 bug,说来好笑。最后对 NNUE 做了一些改动:增加多个输出头,按棋盘上的棋子数选用;增加一些隐藏单元;并用更多自我对弈把训练数据翻倍。 |
将 Stockfish 17 移植到 Pentium Pro
第二个引擎的情况则相反,如上所述。我(同样,准确地说,是我的 LLM)把 Stockfish 移植到 1996 年的硬件上运行,然后调整参数,使其更适合较低的搜索深度。因此这里的收益要小一些,因为已经没有大的算法优势可挖了。
| 1 秒/步 | 10 秒/步 | 变化 |
|---|---|---|
| 2496 ± 64 | 2940 ± 76 | 把 Stockfish 17 塞进这台机器。第一次朴素移植将 Stockfish 17 改写为适配 1996 年机器:单核、无 SIMD、无 64 位寄存器、无 C++ 标准库。它去掉了多线程、残局表库和 71 MB 的 NNUE,换成一个更小的。它将位棋盘改写为一对 32 位整数,并用纯整数运算评估小 NNUE。 |
| 2590 ± 67 (+94 ± 93) | 2961 ± 74 (+21 ± 106) | 更快的累加器维护。第二项修复确保 NNUE 运行得更好、保持更新更及时,并提升评估器性能。 |
| 2752 ± 68 (+162 ± 95) | 3006 ± 74 (+45 ± 105) | 更廉价的评估函数,使用 PeSTO 混合,修改编译器标志。接着它再次改动 NNUE,缩小其规模并调优,使其在 Pentium Pro 上跑得更快,将评估时间缩短到三分之一。再加上若干优化改动,这一轮在每步 1 秒时收益最大,此时原始速度最关键,而在每步 10 秒时收益小得多。 |
| 2780 ± 67 (+28 ± 95) | 3070 ± 72 (+64 ± 103) | 对 NNUE 做 on-policy 微调。基本重复之前的工作,但针对 Stockfish,用 Stockfish 给数百万个局面打分,重新推导 NNUE 权重。 |
| 2784 ± 65 (+4 ± 93) | 3070 ± 72 (+0 ± 101) | 用 SPSA 重新调优搜索,鉴于 NNUE 的改进而移除 PeSTO。原版 Stockfish 假设每秒能跑数百万个节点,所以在较慢的 CPU 上必须再用一轮 SPSA 重新调参。这些改动也让 PeSTO 那一轮不再需要。 |
| 2819 ± 65 (+35 ± 92) | 3074 ± 72 (+4 ± 101) | 加入修正历史,联合调优其他参数和 NNUE。下一轮恢复 Stockfish 的非兵修正历史,联合优化(同样通过 SPSA)参数,并重新拟合 NNUE。 |
| 2846 ± 35 (+27 ± 74) | 3109 ± 79 (+35 ± 107) | 最后一步不改代码,只换编译器,加入一些链接时优化,并加上 32 字节代码对齐。 |
那这能打败 Kasparov 吗?
我认为这种可能性压倒性地大,但实际情况比你可能预想的要棘手一些。你看,我在整篇文章里玩了点障眼法。问题在于 Elo 分是相对的,而我一直拿我的引擎的 Elo 去和 Computer Chess Rating Lists(CCRL)上那些已知强度的各种 Stockfish 引擎比较。但人类不常和引擎对弈,所以 FIDE Elo 榜和 CCRL 榜上的分数之间可能存在一些小的偏差,就像一名棋手的 FIDE Elo 并不能直接换算成他在网上的 Elo 一样。好在,我让这些引擎跑在 3200–3300 的 Elo 上,而 Kasparov 的等级分略低于 2800,这个缓冲应该足以吸收任何偏差。
不过,如果你恰好认识一位 2700+ 的超级特级大师,想试试击败一个跑在 1996 年硬件上的 2026 年国际象棋引擎,我很乐意接受挑战!
结论
我们人类第一次做任何事,很少能做得高效。一旦看到一条只要扩大规模就显然可行的路,我们就照着做。只有后来,等我们有时间更好地理解手头的问题,才会意识到:本可以靠更聪明的方式,以高得多的效率达成同样的成就。
我做这件事主要是图个乐,因为“我能不能用现成硬件打败 Kasparov”听起来就是个好玩的问题,但我也希望它能让人对“AI”的算法进步速度有一点小小的洞察。1997 年的国际象棋引擎已经相当先进了;毕竟,Alan Turing 在将近五十年前就帮忙写了第一个国际象棋程序。所以当时看来,也许剩下的点子并不多了,这似乎也说得通。事后看,很容易看出这是错的。
这就引出了问题:现代“AI”,也就是语言模型,究竟还有多少东西留在桌上没被拿走?未来几年我们从软件上获得的进步,会超过硬件规模上的进步吗?显然这个玩具实验无法给出定论,但它指向了一种可能的未来。(这里大概还有个关于用 LLM(“AI”)来加速我们回答这类古怪研究问题的元教训。)
(另外,呃,要是谁有想法,等过几周我不用这台机器跑国际象棋引擎了,能拿这台 Pentium Pro 做点什么项目……请告诉我!)
Footnotes
-
单机跑经典时限的对局数量远远不够,凑不出这个数字,所以我是从更短的时限外推出来的。每步 30 秒时测得 3180 ± 80,而从 1 秒到 10 秒、从 10 秒到 30 秒,每把时间延长到三倍,Elo 就涨 +70。经典时限下每步大约有六分钟(包括对手回合时的思考时间),照此推算 Elo 应在 3350。考虑到收益会有所递减,保守估计取 Elo 3300。 ↩