在 8 美元的芯片上跑大模型:ESP32-S3 从 10.3 提到 22.6 tok/s
Mark Bartlett 复现了 esp32-ai 的 TinyStories 模型,发现真正的瓶颈在 PSRAM 带宽,CPU 并不吃紧。五次不改变输出的改动把单 token 时间从 94.7 ms 压到 43.3 ms,生成文本仍逐字节相同。
中文
复制
简要回答: 跑这个模型时,ESP32-S3 大部分时间都在等 PSRAM,而不是 CPU:经过缓存,它大约只能拿到 62 MB/s。五个精准的补丁把 esp32-ai 的 TinyStories 模型从每 token 94.7 ms 降到 43.3 ms,从 10.3 tok/s 提升到 22.6 tok/s,而 200 个 token 的文本逐字节不变,前 20 个 token 的 logits 也完全一致。
Better Stack 的一期视频让不少人把一个 2890 万参数的语言模型刷进“一块大约 8 美元的芯片”,看它以“每秒九个 token”的速度写儿童故事。背后的项目是 slvDev(Viacheslav Sierbov)的 esp32-ai,在 ESP32-S3 上跑 TinyStories 模型,没有操作系统,也没有网络。
我先在自己的板子上复现了一遍。之后每改一处,我都在计时之前先做预注册:写下预期结果,附上哈希。整个过程最终停在 22.59 tok/s,而同一份固件关掉显示代码时是 10.34 tok/s,输出始终没变:200 个 token 的文本逐字节相同,前 20 个 token 的 logits 按哈希比对也相同。我在板子上做的 25 条预测里有 3 条错了。有用的恰恰是这 3 条。
**测试平台:**ESP32-S3 N16R8(rev 0.2,16 MB flash,8 MB octal PSRAM),Arduino-ESP32 core 3.3.10,esp32-ai 位于 commit 52ebcbb,release 版 TinyStories 模型,CPU 240 MHz,未接显示屏。
简版
| 构建(240 MHz,每组 n = 3 次复位) | head ms | 非 head ms | ms/token | tok/s | 输出哈希 |
|---|---|---|---|---|---|
| 标量,关闭显示代码(我的基线) | 59.1 | 35.5 | 94.7 | 10.34 | 4400a1cbf4a5137d¹ |
| + SIMD int8 head | 43.6 | 35.5 | 79.1 | 12.31 | 4400a1cbf4a5137d |
| + int4 head | 24.1 | 35.5 | 59.6 | 16.21 | 4400a1cbf4a5137d |
| + SIMD core | 24.1 | 26.4 | 50.4 | 19.05 | 4400a1cbf4a5137d |
| + logits 放入 SRAM² | 21.2 | 26.3 | 47.5 | 20.62 | 4400a1cbf4a5137d |
| + int4 core | 21.2 | 22.0 | 43.3 | 22.59 | 4400a1cbf4a5137d |
| 上游公布的数据(他们的) | 59.4 | 35.6³ | 94.9 | 9.88⁴ | 未公布 |
¹ 基线哈希来自标量 head 的一个带校验构建。计时的标量运行把校验和编译掉了; 它们的 200 个 token 文本与下面每一行都逐字节相同。 ² 探索性,n = 3,带校验且完全一致。这一步的预注册版本还把 head 的 scale 改成了 fp16, 结果更慢(第 8 节)。这一行还带着已关闭的 end-of-story 标志,它不改变任何结果 (第 10 节)。 ³ 上游公布各阶段耗时之和:input 2.2,attention 20.5,FFN 6.5,PLE 6.4。 ⁴ 上游固件 README 里标为“attached serial”,RESULTS.md 里标为“(9.88 tok/s attached)”。
输出哈希是对前 20 个生成 token 的原始 logits 做 64 位 FNV-1a 计算得到的,并与全部 200 个 token 文本的逐字节比对一同校验。哈希相同、文本相同,就意味着前 20 个 token 的 logits 完全一致,全部 200 个 token 的文本也完全一致。
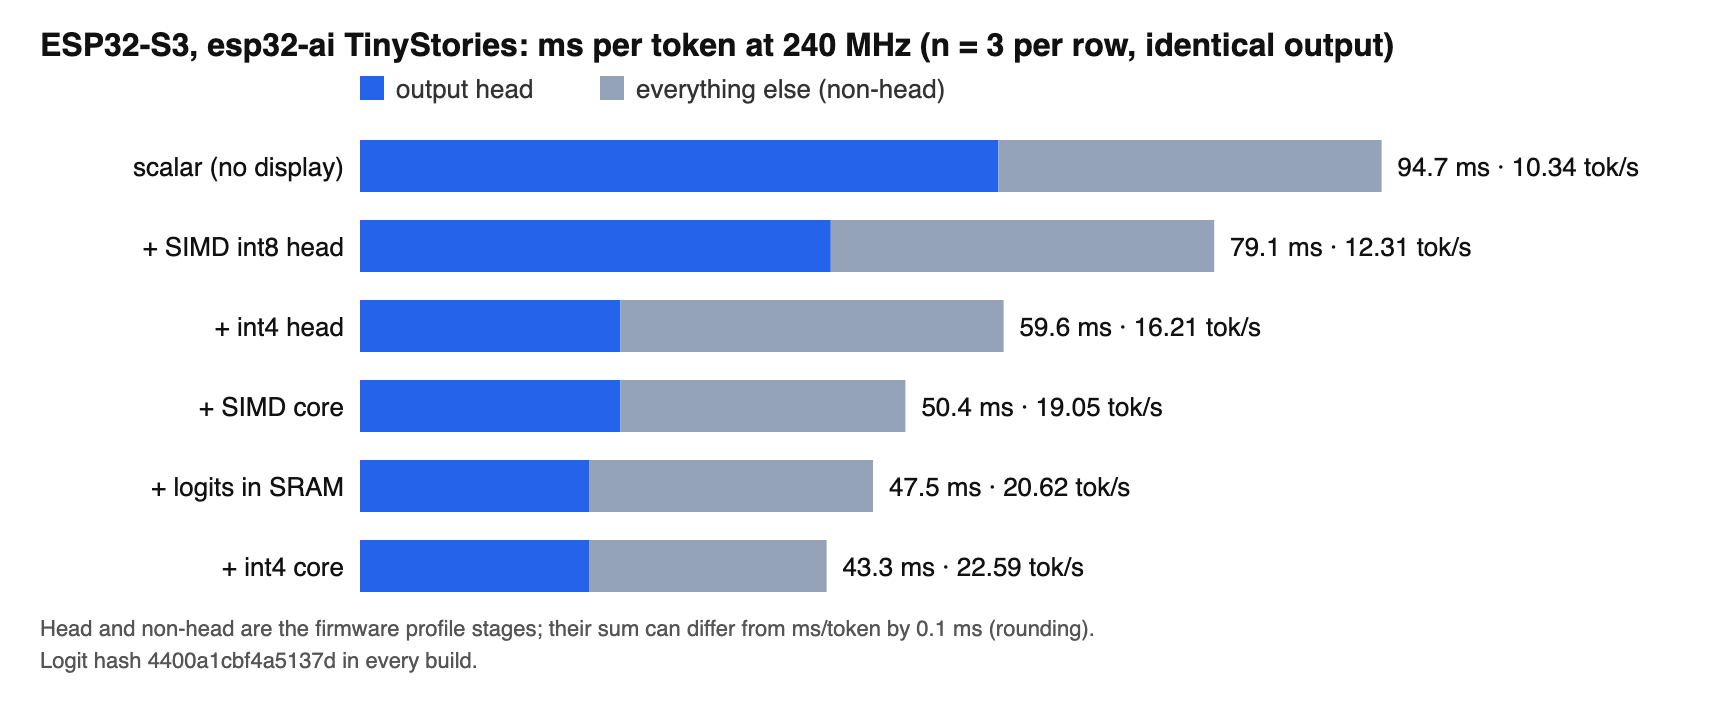
对照我的基线,每 token 从 94.7 ms 降到 43.3 ms,2.19 倍。换成 tok/s(这个指标也把挑选和打印每个 token 的时间算进去),从 10.34 到 22.59,2.18 倍。
1. esp32-ai 如何把 29M 模型塞进单片机
诀窍是按读取频率来安排模型的各个部分。slvDev 在 sketch 的头注释里讲得很清楚。
| 位置 | 存放内容 | 读取频率 |
|---|---|---|
| flash(16 MB,内存映射) | 25.2M 参数的逐层嵌入(PLE)表和 token embedding,4-bit | 每 token 一行 |
| PSRAM(8 MB,octal) | 转成 int8 的核心权重、输出头、fp32 KV cache | 每 token |
| 内部 SRAM(512 KB) | 暂存缓冲区和 norm 向量 | 每 token 多次 |
PLE 表占了模型的大头:28.9M 参数里有 25,165,824 个,32,768 行 × 768,每个输入 token 一行,每个 token 只从 flash 里取自己那一行。所有计算都在 PSRAM 里进行,出厂固件在启动时分配 4.19 MB。SRAM 里维护着一份 29,320 字节的热数据。
输出头是 token embedding 前 25,353 行的绑定副本,96 列宽,int8 下 2.43 MB。每个 token 都要完整读一遍,是 PSRAM 里最大的一块。记住这一点。
2. 先复现
动手改之前,我先原样刷入上游固件(scripts/deploy.sh tinystories)并读了 profile。这次运行是验证性的,不是盲测:我事先知道上游的数字,之后每一个预测都是拿着这份 profile 写出来的。
| 每 token 阶段(n = 1) | 上游(他们的 RESULTS.md) | 我的板子 |
|---|---|---|
| ms/token | 94.9 | 95.0 |
| head | 59.4 | 59.4 |
| attention | 20.5 | 20.5 |
| FFN | 6.5 | 6.4 |
| PLE | 6.4 | 6.4 |
| input | 2.2 | 2.2 |
复现误差 0.1 ms。我的 tok/s 是 5.43,他们是 9.88,这个差距不是真的。出厂的 sketch 硬编码了 #define USE_DISPLAY 1,每个 token 都通过 I2C 跟一块 OLED 通信。我没接显示屏,所以这次运行记录了 1,965 个 I2C 错误,这些错误会消耗实际时间。ms/token 只计前向传播,所以它仍然对得上。关掉显示代码后,同一份固件跑到 10.34 tok/s。这就是我的基线。
我也在自己的 RTX 3090 测试机上,按上游的配方重新训练了模型,随机种子 0 和 1 各跑了一次。
验证困惑度分别是 11.37 和 11.39,均值 11.38,上游两个种子的结果是 11.41。两个导出模型都通过了上游自带的 C 与 PyTorch 对比检查,最大绝对误差 0.00001。
有一个数字一开始对不上。训练脚本报告核心参数 558,368 个,发布元数据写的是 556,416。我在 CPU 上搭了模型数了一遍。差的 1,952 正好是 20 个 RMSNorm 权重向量(6 × 3 × 96 + 96 + 128):训练脚本把它们算进去了,发布元数据只统计矩阵权重。同一个模型。
两次重训都没有烧录进板子。下面板子上的所有数字都来自发布模型。
3. 视频里说错的三个小地方(以及它提出的一个问题)
这个视频是很好的入门,也确实让不少人动手做起来了。但有三处细节不对。
“所以,这张 2500 万行的表放在 flash 里”(00:02:05)。是 2500 万个参数,发布元数据里是 25,165,824。这张表有 32,768 行,每个输入 token 一行,每行 768 个值(6 层 × 128)。
“ESP32-S3 这颗芯片给你 512 KB 的 SRAM。这就是这颗芯片能用来计算的快速内存量”(00:00:44)。这是内部 SRAM 的容量,但模型并不跑在里面。视频还说“注意力头和前馈都留在 SRAM 里”(00:01:55)。这些权重放在 8 MB 的 PSRAM 里。SRAM 里装的是大约 29 KB 的激活值和归一化向量。
llama2.c 被说成“整个项目建立在其上的蓝图”(00:03:20)。上游的 RESULTS.md 写明,没有任何代码、模型或方法源自 Karpathy 的 llama2.c,它出现在那里只是作为对比参照。公平地说,上游的 README 确实称 llama2.c 为“训练小型语言模型并用纯 C 运行它的参考”。是参考,不是蓝图。
然后是小女孩。视频里最精彩的一段,是模型一遍又一遍地绕回“那个关于小女孩的特定故事”,Andres 说“我完全不知道这是为什么”(00:06:15)。这个问题我想我能回答。
固件不会停下来。结束标记 <|endoftext|>(id 0)解码后是空字符串,循环里唯一的停止条件是 200 个 token。于是板子越过每个故事的边界,什么也不打印,直接开始下一个故事。训练数据里的新故事开头方式高度集中:模型训练所用切片中的 344,375 个故事里,有 12.60% 恰好以“Once upon a time, there was a little girl named”开头。“named”之后出现最多的名字是 Lily,占全部故事的 12.63%,是第二名(Timmy)的 2.6 倍。
不过模型把这一点放大了。我用两个重新训练过的 checkpoint 跑了 50 条固定 prompt,在 3090 上用 PyTorch 跑,不是在板子上。贪心解码有 76% 的生成出现了重启,而这些重启 100% 以 Lily 或“little girl”开头。按 T 0.8 / top-p 0.9 采样也只能把比例降到 50–56%。同一测试下(故事前 60 个 token 内出现 Lily 或“little girl”),训练数据的得分是 34%。
所以这是来自训练数据的先验,被“永远选最可能的 token”的解码方式放大了 1.5–3 倍。第 10 节加了一个 flag,让板子在边界处停下。
4. 指向反了的时钟扫描
第一个真正的实验只改 CPU 时钟:240、160、80 MHz,各跑 3 次。上游的 RESULTS.md 说 head 会撞上 PSRAM 带宽下限,我想验证一下。如果 head 在等内存,降 CPU 频率不应该让它慢多少。
我预注册了三条预测。三条全错了。
| 预测(预注册) | 实测 |
|---|---|
| 非 head 阶段随 1/f 变化,误差在 ±15% 以内:80 MHz 时约 107 ms | 86.7 ms(区间 90.8–122.8) |
| head 的变化小于 CPU 等比变化的 30% | 160 MHz 时 72%,80 MHz 时 77% |
| 160 MHz 下总耗时落在 110–125 ms | 128.3 ms |
我的预测错了。head 几乎跟着时钟一起变慢:240 MHz 时 59.1 ms,160 时 80.3,80 时 149.9。
然后我把它弄得更糟。我把每个阶段拟合为 t = a/f + b,即一个随时钟缩放的部分加一个固定部分,拟合结果显示 head 只有 13.7 ms 与时钟无关的时间。我据此认为“head 不受带宽限制”,与上游约 40 ms 的下限相矛盾。这也错了,下一个实验证明了这一点。
5. SIMD 暴露出真正的下限
ESP32-S3 带有一个 SIMD 单元,Espressif 称之为 PIE,支持 int8 向量乘加运算,ee.vmulas.s8.accx。我把 head 的 int8 矩阵-向量乘积从标量循环改写成手写的 SIMD kernel。整数求和是精确的,启动自检会校验全部 25,353 行,gate(前 20 个 token 做哈希,全部 200 个 token 做文本比对)没有变化。
在 240 MHz 下,head 从 59.1 ms 降到 43.6 ms。此后它便不再受时钟频率影响:160 MHz 下为 44.7 ms,80 MHz 下为 48.3 ms。拟合结果显示,固定时间 b = 41.3 ms,在 240 MHz 下随时钟缩放的部分只有 2.4 ms。
head 每个 token 读取 2,535,300 字节,其中 2,433,888 字节是权重,101,412 字节是 scale。按 41.3 ms 计算,大约是 61 MB/s;把写回的 logits 也算上,约 64 MB/s。上游在自己的 PSRAM 读取基准测试中测到 60.7 MB/s。这个下限一直就在那里。
那第 4 节的拟合为什么没发现它?标量 head 的算术运算在 240 MHz 下约占 45 ms,与内存访问重叠,把后者掩盖了。加法模型看不到重叠。它把重叠的时间记成随时钟缩放的部分,因为计算才是显现出来的那部分。把计算拿掉,下限就明明白白摆在那里。
6. 字节减半:int4 head
既然 head 的瓶颈是字节,那就少传一些字节。模型文件本来就把 head 存成 4-bit 编码,固件为了速度在启动时把它们解包成 int8。我改为把 head 按打包的 int4 重新组织,在 SIMD kernel 内部解包:权重从 2,433,888 字节降到 1,216,944 字节。结果依然精确,自检依然是 25,353 行全部通过。
| head(240 MHz,n = 3) | 每 token 读取字节数 | head 毫秒 | 与时钟无关部分(b) | 240 MHz 下随时钟缩放部分 |
|---|---|---|---|---|
| int8 SIMD | 2,535,300 | 43.6 | 41.3 | 2.4 |
| int4 SIMD | 1,318,356 | 24.1 | 22.6 | 1.6 |
字节减半,下限也减半:两行的 head 总流量除以 b 都约为 63 MB/s。解包也没有带来任何我能观察到的开销。随时钟缩放的时间从 2.4 ms 降到 1.6 ms,而按预测,超过 8 之后 head 应该又会部分受限于计算。额外的好处是,空闲 PSRAM 从 3.77 MB 增加到 4.93 MB。
7. 模型其余部分:SIMD 核心,同样的掩蔽效应
head 已经降到 24.1 ms,剩下的 35.5 ms 反而成了大头。核心里的整数矩阵-向量乘(共八种矩阵)全部换成了 PIE kernel。down projection 有 66 列,我把它补零到 80 列,让每行保持 16 字节对齐。所有浮点运算(attention score、softmax、norm、RoPE、激活)原封不动。
在 240 MHz 下,non-head 从 35.5 ms 降到 26.4 ms,hash 和文本不变,head 仍是 24.1 ms。总计 50.4 ms,19.05 tok/s。
拟合结果再次显示出同样的掩蔽效应。non-head 中随时钟缩放的那部分下降了 14.2 ms(25.60 → 11.45),但总时间只降了 9.1 ms,因为固定部分上升了 5.0 ms(9.90 → 14.95)。算术开销让开之后,每 token 556 KB 的核心权重开始显形,和 head 的字节此前的情形一模一样。
8. head 周边的小幅精确收益
int4 head 附近还有两处会访问 PSRAM:它的 fp32 scale(每 token 101,412 字节,文件中以 fp16 存储),以及它写出的 101,412 字节 logits 缓冲区。
预注册的改动把两件事一起做了:scale 保持 fp16,logits 放进内部 SRAM。240 MHz 下 head 从 24.1 ms 降到 21.7 ms(n = 3),落在预测的 21.0–23.5 区间内,non-head 持平在 26.3 ms。启动自检确认每个 fp16 scale 扩展后与原来的 fp32 值一致,hash 也没有变化。logits 放进 SRAM 后还有富余:空闲内部 SRAM 从 309,056 字节降到 206,652 字节,最大空闲块从 262,132 字节降到 163,828 字节。
之后我把这两项拆开单独测。以下这些是探索性运行。
| head 流量配置(240 MHz) | n | head ms | ms/token | tok/s |
|---|---|---|---|---|
| 都不做(对照) | 3 | 24.1 | 50.4 | 19.06 |
| 仅 fp16 scale | 1 | 23.9 | 50.3 | 19.10 |
| 仅 logits 进 SRAM | 3 | 21.2 | 47.5 | 20.62 |
| 两者都做(预注册构建) | 3 | 21.7 | 48.0 | 20.40 |
收益全部来自 SRAM 迁移。logits 留在 PSRAM 时,fp16 scale 单独只省 0.2 ms;logits 进了 SRAM 之后,它反而多花 0.5 ms。我的解读(尚未验证):logits 写入不再走 PSRAM 后,head 因内存而停顿的次数减少,于是每行那几个用于扩展 fp16 scale 的整数运算,不再能藏在停顿之下。
最终构建只把 logits 放在 SRAM 里。它通过了自身的哈希校验:4400a1cbf4a5137d,文本完全一致。
9. int4 核心
核心部分沿用同样的思路。全部 43 个核心张量、共 286,848 字节,按 head 的 kernel 布局重新排布为 int4。96 列的张量直接沿用 int4 head kernel。唯一的 128 列形状需要新 kernel,它没有空闲的向量寄存器,于是在自身的乘加指令内部把最后 32 个激活字节换进换出。Down 仍然零填充,现在填到 96 列,因此它 48 字节的 int4 行保持 16 字节对齐。每个张量的每一行都与文件中的编码做了自检。
| 非 head(每组 n = 3) | 240 MHz | 160 MHz | 80 MHz |
|---|---|---|---|
| 对照组,int8 核心 @ 240 | 26.3 | – | – |
| int4 核心 | 22.0 | 27.5 | 45.0 |
| ms/token,int4 核心 | 43.3 | 49.5 | 69.5 |
我预测非 head 会落在 22.0 到 25.0 ms 之间。实测 22.0,正好压在区间下沿。这个数字是四个阶段各自精确到 0.1 ms 后相加的结果,所以是 22.0 ± 0.2;用 ms/token 减去 head 得到 22.1。我判定预测成立,但只是勉强成立,这一点我更愿意让你知道,而不是瞒着。
拟合结果说明了它为什么奏效。非 head 的固定部分从 14.95 ms 降到 10.50 ms,随频率缩放的部分没有变化(11.45 到 11.50)。int4 核心每 token 少读 277,632 字节,摊到 4.45 ms 上大约是 62 MB/s。和 head 是同一个下限。
10. 在故事结尾处停下
这是对第 3 节那个死循环的修复。我按自己对代码的审计打上了 end-of-story 补丁:词表生成器现在会写出 end-of-story token 的 id,另有一个编译期开关 STOP_AT_EOT,模型选中它时就跳出循环。
| 设置(240 MHz,各跑一次) | token 数 | 文本 | 输出哈希 |
|---|---|---|---|
STOP_AT_EOT=0(默认) | 200 | 763 字节,与上面所有构建完全一致 | 4400a1cbf4a5137d |
STOP_AT_EOT=1 | 132 | 499 字节:恰好是未截断文本的前 499 字节 | 4400a1cbf4a5137d(前 20 个 token) |
在固定 prompt 上,模型在第 132 步选中 end token,开关随即停在那里。截断后的文本以 ...You are a good friend." 结尾;未截断的文本则接着 Once upon a time, there was a little girl...。开关关闭时,输出与之前逐字节一致,所以所有基准测试构建都保持关闭。不要把截断那次的 ms/token 和其他几次相比:132 个 token 意味着 attention 平均的 KV cache 更短。
11. 这 43.3 ms 花在哪里
| 阶段(int4 核心,240 MHz,n = 3) | ms/token | 说明 |
|---|---|---|
| head | 21.2 | 每 token 从 PSRAM 读 1.32 MB,已到下限 |
| attention | 16.1 | 约 8.35 ms 随主频缩放的浮点计算,7.75 ms 固定开销,主要是 fp32 KV cache 读取 |
| FFN + PLE + input | 5.9 | 2.4 + 2.5 + 1.0,主要是权重搬运 |
三个阶段加起来是 43.2,与打印出的 43.3 之间的差距来自四舍五入。按 head 的拟合结果,这个构建里固定开销为 19.6 ms。attention 是第二大的部分。其中约一半是固定开销,主要是读 fp32 KV cache:在 200 token 的运行上平均下来,每 token 约 484 KB。另一半是随主频缩放的浮点计算。
剩下的手段都有代价。缩小 KV 条目(fp16 或 int8)能减少这些字节,但会改变输出,所以需要单独的质量门槛。把 PSRAM 提到 120 MHz,或者改用 64 字节 cache line,都意味着要重新编译 Espressif 预编译的库,而 120 MHz octal PSRAM 被标为实验性,且对温度敏感。
我会怎么做(你要不要做?)
如果你手上有 ESP32-S3 板子,先确认它是 N16R8,即 16 MB flash 加 8 MB octal PSRAM。模型需要这些 flash,固件需要 PSRAM 工作在 octal 模式。用上游的 deploy.sh 刷入,预期每 token 约 95 ms;这是上游和我各自测到的结果。如果没有 OLED,先在 sketch 里把 USE_DISPLAY 设为 0。总线上没有显示器时,显示相关代码会把我的板子从 10.34 tok/s 拖到 5.43。
五个速度补丁把同一块板子带到每 token 43.3 ms、22.59 tok/s,用的 200 token 文本与官方固件相同,前 20 个 token 的 logit 哈希也相同。
补丁公开在我的 fork 里:msb-msb/esp32-ai。默认分支 insiderllm 包含全部补丁,每个改动一个分支,另有一个 tools 分支加入 chat.py 和校验和构建。从 fork 的全新 clone 构建,insiderllm 分支实测 43.2 ms/token、22.61 tok/s(n = 3),200 token 文本相同。我已经在 esp32-ai issue #26 里向上游提交了这些改动,上游仍是正式项目。该 issue 标题里的数字(1.84x)来自本系列中途的结果;完整方案实测为 2.19x。如果只做一部分,就做 head 那部分。SIMD head 和 int4 head 合起来,在每 token 51.4 ms 里省下了 35.1 ms,从 94.7 降到 59.6。
想找一个能回答问题的模型,那就跳过这篇。这个模型写儿童故事,而且很擅长写 Lily。
局限
- 只测速度。每次构建都给出同样的 200 token 文本,前 20 个 token 的 logit 哈希也相同,整数 kernel 在构造上就是精确的,所以质量没有变化。这里不测质量。
- 一块板子、一个模型、两天(2026-10-10 和 2026-10-11)、一个提示词(“Once upon a time”)、200 个贪心 token。
- 还没有功耗数据。
- TinyStories 只写儿童故事。
- 只有一套软件栈:Arduino-ESP32 core 3.3.10(IDF v5.5.4),
-O3。换一个 core 版本,基线可能就变了。
方法
每次计时的改动都在运行之前写下来:预测、预测区间,以及什么算失败。每个文件都做了哈希,运行结束后均未改动。它们放在项目仓库里(~/Desktop/esp32-llm/evals/<id>/PREREG.md),不在本站。2026-10-10 的四次板端实验,从写完文件到第一次上硬件运行间隔 1.5 到 2.7 分钟;主机端解码测试约 1 分 11 秒,这个数字来自它的日志。2026-10-11 的三次实验间隔 18 到 21 秒,但它们的预测更早就定下了,当天 09:05 写进了本次会话的书面简报,文件是简报预测文本的逐字副本。复现运行是唯一没有预注册的一次,标注为验证性。
任何计时之前,每项速度改动都要过一道门禁构建,其中编入了 logits 校验和:对前 20 个生成 token 的原始 logits 做 64 位 FNV-1a(每次都是 4400a1cbf4a5137d),再逐字节比对 200 token 文本。计时构建会把校验和编译掉。每种配置复位 3 次,每种配置的三次运行在固件 0.1 ms 精度下打印出的数值完全一致。
拟合用的是 240 和 80 MHz 两次运行上的 t = a/f + b,再用 160 来检验。它把随频率缩放的时间和固定时间分开,前提是这两部分确实相加。当计算与访存重叠时,拟合会把重叠部分记成计算,第 4 节里 head 的下限就是这样被掩盖的。直到大部分计算被消掉之后,这个拟合才有用。
按记录中的判定表统计:24 条预测成立,5 条失败。失败的 5 条中,3 条来自时钟扫描,2 条来自第 3 节主机端解码测试的 4 条。单看开发板,22 条成立,3 条失败。
记录与致谢
原始日志、补丁哈希和构建细节都在公开记录里:
这些工作是 slvDev 做的:esp32-ai,包括模型和固件,模型卡在 Hugging Face 上。让更多人看到它的是 Andres 在 Better Stack 发布的视频。
接下来:等开发板上接上功率计,就测每 token 功耗;做一个交互式 demo;再把同一个模型跑在 ESP32-P4 上。
后续: 每 token 功耗数据和 ESP32-P4 见 ESP32-P4 vs ESP32-S3:在 USB 端口实测每 token 能耗
来源: InsiderLLM← 返回首页