8 ドルのチップで LLM を動かす:ESP32-S3 で 10.3 から 22.6 tok/s へ
Mark Bartlett は esp32-ai の TinyStories モデルを再現し、律速は PSRAM の帯域で CPU は余っていたと特定した。出力を変えない 5 つの変更で 1 トークンあたり 94.7 ms を 43.3 ms に短縮した。
日本語
コピー
要約: このモデルを動かすと、ESP32-S3 はほとんどの時間を CPU ではなく PSRAM の待ちに費やす。キャッシュを通しても、得られるのはおよそ 62 MB/s にすぎない。5 つの的を絞ったパッチで、esp32-ai の TinyStories モデルは 1 トークンあたり 94.7 ms から 43.3 ms へ、10.3 tok/s から 22.6 tok/s へと速くなった。200 トークンのテキストはバイト単位で変わらず、最初の 20 トークンの logits も完全に一致している。
Better Stack の動画のおかげで、2890 万パラメータの言語モデルを「およそ 8 ドルのチップ」に載せて「毎秒 9 トークン」で子ども向けの物語を書かせる話が広まった。その元になったプロジェクトが、slvDev(Viacheslav Sierbov)による esp32-ai だ。ESP32-S3 上で TinyStories モデルを動かす。OS もネットワークも使わない。
まず私のボードで再現した。以降は変更を加えるたびに、計測の前に必ず事前登録をした。期待する結果を書き、ハッシュを添える。最終的に 22.59 tok/s で止まった。同じファームウェアで表示用コードを切ると 10.34 tok/s になる。出力は最後まで変わらない。200 トークンのテキストはバイト単位で同一、最初の 20 トークンの logits もハッシュ比較で一致した。ボード上で立てた 25 個の予測のうち、外れたのは 3 個。役に立ったのは、まさにその 3 個だった。
**テスト環境:**ESP32-S3 N16R8(rev 0.2、16 MB flash、8 MB octal PSRAM)、Arduino-ESP32 core 3.3.10、esp32-ai は commit 52ebcbb、TinyStories モデルのリリース版、CPU 240 MHz、ディスプレイなし。
まとめ
| ビルド(240 MHz、各グループ n = 3 回のリセット) | head ms | 非 head ms | ms/token | tok/s | 出力ハッシュ |
|---|---|---|---|---|---|
| スカラー、表示用コードを無効(私のベースライン) | 59.1 | 35.5 | 94.7 | 10.34 | 4400a1cbf4a5137d¹ |
| + SIMD int8 head | 43.6 | 35.5 | 79.1 | 12.31 | 4400a1cbf4a5137d |
| + int4 head | 24.1 | 35.5 | 59.6 | 16.21 | 4400a1cbf4a5137d |
| + SIMD core | 24.1 | 26.4 | 50.4 | 19.05 | 4400a1cbf4a5137d |
| + logits を SRAM へ² | 21.2 | 26.3 | 47.5 | 20.62 | 4400a1cbf4a5137d |
| + int4 core | 21.2 | 22.0 | 43.3 | 22.59 | 4400a1cbf4a5137d |
| 上流の公表値(本人らによる) | 59.4 | 35.6³ | 94.9 | 9.88⁴ | 未公表 |
¹ ベースラインのハッシュは、スカラー head のチェックサム付きビルドから得たもの。計測したスカラー実行ではチェックサムをコンパイル時に外している。 その 200 トークンのテキストは、以下のどの行ともバイト単位で同一だ。 ² 探索的、n = 3、チェックサム付きで完全一致。このステップの事前登録版では head の scale も fp16 に変えたが、遅くなった(第 8 節)。この行は end-of-story フラグを切ったままでもある。結果は変わらない(第 10 節)。 ³ 上流が公表している各段階の合計:input 2.2、attention 20.5、FFN 6.5、PLE 6.4。 ⁴ 上流のファームウェア README では「attached serial」、RESULTS.md では「(9.88 tok/s attached)」と表記されている。
出力ハッシュは、生成した最初の 20 トークンの生の logits に対する 64 ビット FNV-1a だ。200 トークン全体のテキストのバイト単位比較とあわせて検証している。ハッシュが同じでテキストも同じなら、最初の 20 トークンの logits は完全に一致し、200 トークン全体のテキストも完全に一致している。
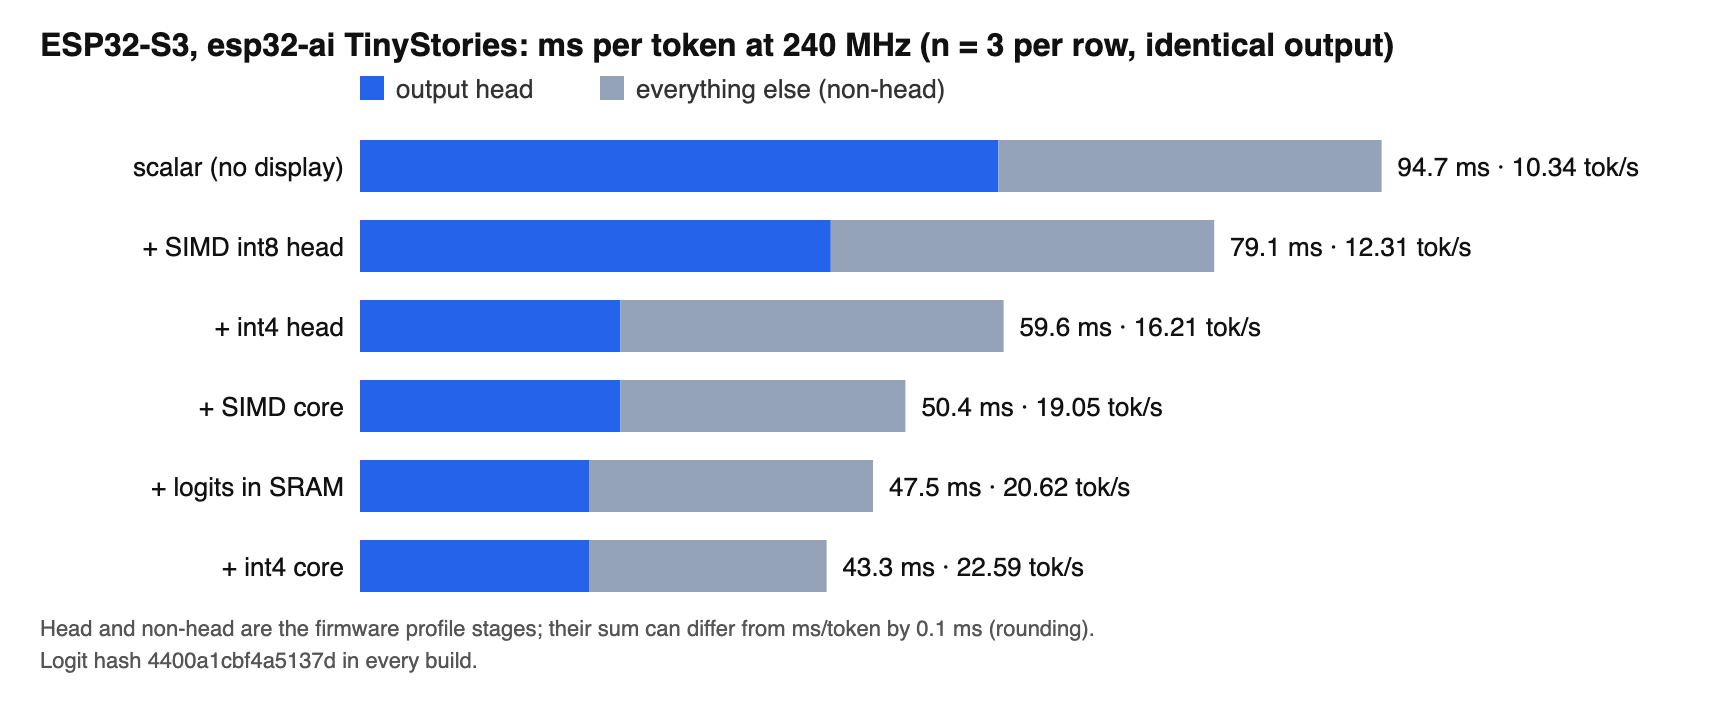
ベースラインと比べて、1 トークンあたり 94.7 ms から 43.3 ms へ、2.19 倍になった。tok/s に直すと(この指標はトークンの選択と出力にかかる時間も含む)、10.34 から 22.59 で 2.18 倍だ。
1. esp32-ai は 29M モデルをどうやってマイコンに収めているか
コツは、読み出し頻度に応じてモデルの各部分を配置することにある。slvDev はスケッチ冒頭のコメントでそれを明快に説明している。
| 場所 | 置かれるもの | 読み出し頻度 |
|---|---|---|
| flash(16 MB、メモリマップ) | 25.2M パラメータの層ごとの埋め込み(PLE)テーブルと token embedding、4-bit | 1 トークンにつき 1 行 |
| PSRAM(8 MB、8 線) | int8 に変換したコア重み、出力ヘッド、fp32 KV cache | 1 トークンにつき |
| 内部 SRAM(512 KB) | 一時バッファと norm ベクトル | 1 トークンにつき複数回 |
PLE テーブルがモデルの大部分を占める。28.9M パラメータのうち 25,165,824 個、32,768 行×768 で、入力トークンごとに 1 行、各トークンは flash から自分の行だけを読む。計算はすべて PSRAM 上で行われ、出荷ファームウェアは起動時に 4.19 MB を確保する。SRAM には 29,320 バイトのホットデータが常駐している。
出力ヘッドは token embedding の先頭 25,353 行を結合したコピーで、幅 96 列、int8 で 2.43 MB。トークンごとに毎回まるごと読み出す、PSRAM 内で最大のブロックだ。これは覚えておいてほしい。
2. まず再現する
手を入れる前に、上流のファームウェア(scripts/deploy.sh tinystories)をそのまま書き込んでプロファイルを読んだ。この実行は検証であってブラインドテストではない。上流の数値は事前に知っており、以降の予測はすべてこのプロファイルを見ながら書いた。
| 1 トークンあたりの段階(n = 1) | 上流(彼らの RESULTS.md) | 私のボード |
|---|---|---|
| ms/token | 94.9 | 95.0 |
| head | 59.4 | 59.4 |
| attention | 20.5 | 20.5 |
| FFN | 6.5 | 6.4 |
| PLE | 6.4 | 6.4 |
| input | 2.2 | 2.2 |
再現誤差は 0.1 ms。私の tok/s は 5.43 で、彼らは 9.88 だが、この差は本物ではない。出荷時のスケッチは #define USE_DISPLAY 1 をハードコードしていて、トークンごとに I2C 経由で OLED と通信する。私はディスプレイを接続していないので、この実行では 1,965 件の I2C エラーが記録され、それが実時間を食っていた。ms/token はフォワードパスしか計測しないので、こちらは依然として一致する。表示コードを切ると、同じファームウェアが 10.34 tok/s で走った。これが私のベースラインだ。
私の RTX 3090 テストマシンでも、上流のレシピに従ってモデルを再学習し、乱数シード 0 と 1 でそれぞれ 1 回ずつ回した。
検証困惑度はそれぞれ 11.37 と 11.39、平均 11.38 で、上流の 2 シードの結果は 11.41 だった。両方のエクスポート済みモデルは上流付属の C と PyTorch の比較チェックに通り、最大絶対誤差は 0.00001 だった。
1 つだけ最初は合わない数字があった。学習スクリプトはコアパラメータを 558,368 個と報告するが、リリースのメタデータは 556,416 個と書いている。CPU 上でモデルを組んで数えてみた。差の 1,952 はちょうど 20 個の RMSNorm 重みベクトル(6 × 3 × 96 + 96 + 128)で、学習スクリプトはこれを含め、リリースのメタデータは行列の重みしか数えていない。同じモデルだ。
再学習した 2 つはいずれもボードには書き込んでいない。以下のボード上の数値はすべてリリースモデルによるものだ。
3. 動画が間違えている 3 つの細かい点(そしてそれが投げかける 1 つの問い)
この動画は優れた入門で、実際に多くの人が手を動かすきっかけになっている。だが細部が 3 か所違う。
「つまり、この 2500 万行のテーブルは flash にある」(00:02:05)。2500 万個のパラメータで、リリースのメタデータでは 25,165,824。このテーブルは 32,768 行、入力トークンごとに 1 行、各行 768 個の値(6 層×128)だ。
「ESP32-S3 は 512 KB の SRAM を提供する。これがこのチップで計算に使える高速メモリの量だ」(00:00:44)。これは内部 SRAM の容量だが、モデルはそこで動いてはいない。動画はさらに「attention ヘッドと feed-forward は SRAM に残る」(00:01:55)とも言う。これらの重みは 8 MB の PSRAM にある。SRAM に入っているのは約 29 KB の活性値と正規化ベクトルだ。
llama2.c は「プロジェクト全体がその上に築かれている青写真」とされている(00:03:20)。上流の RESULTS.md には、コード、モデル、手法のいずれもKarpathy の llama2.cに由来しないと明記されており、そこにあるのは比較の参照としてだけだ。公平に言えば、上流の README は確かに llama2.c を「小さな言語モデルを学習し、純粋な C で動かすためのリファレンス」と呼んでいる。リファレンスであって、青写真ではない。
次は少女の話だ。動画で最も面白いのは、モデルが「あの少女についての特定の物語」へ何度も何度も戻っていく場面で、Andres は「なぜこうなるのか皆目見当がつかない」と言っている(00:06:15)。この問いには答えられると思う。
ファームウェアは止まらない。終了トークン <|endoftext|>(id 0)はデコードすると空文字列になり、ループ内で唯一の停止条件は 200 トークンだ。だからボードは各物語の境界を越え、何も出力しないまま次の物語を始める。学習データでは物語の書き出しが極端に偏っている。モデルの学習に使われたスライス中の 344,375 個の物語のうち、12.60% がちょうど「Once upon a time, there was a little girl named」で始まる。「named」の後に現れる名前で最多なのは Lily で、全物語の 12.63%、2 位(Timmy)の 2.6 倍だ。
ただしモデルはこれを増幅する。再学習した 2 つの checkpoint を使い、固定プロンプト 50 本で走らせた。PyTorch で 3090 上、ボード上ではない。greedy デコードでは生成の 76% で再起動が起き、その再起動は 100% が Lily か「little girl」で始まった。T 0.8 / top-p 0.9 のサンプリングでも 50〜56% までしか下がらない。同じテスト(物語の最初の 60 トークン以内に Lily か「little girl」が現れるか)で、学習データのスコアは 34% だった。
つまり学習データ由来の事前分布が、「常に最も確率の高いトークンを選ぶ」デコードによって 1.5〜3 倍に増幅されている。第 10 節でフラグを追加し、境界でボードを止められるようにした。
4. 逆向きを指していたクロック掃引
最初の本格的な実験は CPU クロックだけを変えるものだった。240、160、80 MHz で各 3 回。上流の RESULTS.md は head が PSRAM 帯域の下限に突き当たると述べており、それを確かめたかった。head がメモリ待ちなら、CPU 周波数を下げてもそれほど遅くならないはずだ。
事前登録した予測は 3 つ。3 つとも外れた。
| 予測(事前登録) | 実測 |
|---|---|
| 非 head フェーズは 1/f に従い、誤差 ±15% 以内:80 MHz で約 107 ms | 86.7 ms(範囲 90.8〜122.8) |
| head の変化は CPU の比例変化の 30% 未満 | 160 MHz で 72%、80 MHz で 77% |
| 160 MHz での総時間は 110〜125 ms に収まる | 128.3 ms |
予測は外れた。head はほぼクロックに比例して遅くなる。240 MHz で 59.1 ms、160 で 80.3、80 で 149.9。
さらに悪化させた。各フェーズを t = a/f + b、つまりクロックに比例する部分と固定部分の和としてフィットすると、head のクロック非依存時間は 13.7 ms しかないという結果になった。これを受けて「head は帯域制限を受けていない」と判断したが、上流の約 40 ms という下限と矛盾する。これも間違いで、次の実験がそれを示した。
5. SIMD が本当の下限を暴く
ESP32-S3 には SIMD ユニットがあり、Espressif は PIE と呼んでいる。int8 のベクトル積和演算、ee.vmulas.s8.accx を備える。head の int8 行列-ベクトル積をスカラーループから手書きの SIMD kernel に書き換えた。整数の和は正確で、起動時のセルフチェックが全 25,353 行を検証し、gate(先頭 20 トークンのハッシュと、全 200 トークンのテキスト比較)は変わらなかった。
240 MHz で head は 59.1 ms から 43.6 ms に下がった。以降はクロック周波数の影響を受けない。160 MHz で 44.7 ms、80 MHz で 48.3 ms。フィットすると固定時間 b = 41.3 ms で、240 MHz でクロックに比例する部分はわずか 2.4 ms だった。
head は 1 トークンあたり 2,535,300 バイトを読む。うち 2,433,888 バイトが重み、101,412 バイトが scale だ。41.3 ms で計算すると約 61 MB/s、書き戻す logits も含めれば約 64 MB/s。上流は自前の PSRAM 読み出しベンチマークで 60.7 MB/s を測っている。この下限は最初からそこにあった。
では第 4 節のフィットはなぜそれを見つけられなかったのか。スカラー版 head の算術演算は 240 MHz で約 45 ms を占め、メモリアクセスと重なって後者を覆い隠していた。加法モデルは重なりを見られない。計算のほうが表面に出るため、重なった時間をクロックに比例する部分として計上してしまう。計算を取り除けば、下限ははっきりと姿を現す。
6. バイトを半分に:int4 head
head のボトルネックがバイト数なら、転送するバイトを減らせばいい。モデルファイルはもともと head を 4-bit で符号化して保存しており、ファームウェアは速度のために起動時に int8 へ展開していた。代わりに head をパック済み int4 として組み直し、SIMD kernel の中で展開するようにした。重みは 2,433,888 バイトから 1,216,944 バイトに減る。結果は依然として正確で、セルフチェックも 25,353 行すべて通過する。
| head(240 MHz、n = 3) | token あたりの読み出しバイト数 | head のミリ秒 | クロック非依存部分(b) | 240 MHz でクロックに比例する部分 |
|---|---|---|---|---|
| int8 SIMD | 2,535,300 | 43.6 | 41.3 | 2.4 |
| int4 SIMD | 1,318,356 | 24.1 | 22.6 | 1.6 |
バイト数が半分になれば下限も半分になる。どちらの行も、head の総トラフィックを b で割ると約 63 MB/s になる。アンパックのオーバーヘッドは、私が観測できる範囲では一切なかった。クロックに比例する時間は 2.4 ms から 1.6 ms に下がったが、予測どおり 8 を超えたあたりから head は再び計算側で部分的に律速されるはずだ。おまけに、空き PSRAM は 3.77 MB から 4.93 MB に増えた。
7. モデルの残り:SIMD コアでも同じマスキング効果
head が 24.1 ms まで下がると、残りの 35.5 ms のほうが大きくなる。コア内の整数行列ベクトル積(8 種類の行列すべて)を PIE kernel に置き換えた。down projection は 66 列あるので、80 列までゼロ埋めして各行を 16 バイト境界に揃えた。浮動小数点演算(attention score、softmax、norm、RoPE、活性化)は一切手を付けていない。
240 MHz では non-head が 35.5 ms から 26.4 ms に下がり、hash とテキストは変わらず、head は 24.1 ms のまま。合計 50.4 ms、19.05 tok/s。
フィッティングの結果は、ここでも同じマスキング効果を示した。non-head のうちクロックに比例する部分は 14.2 ms 減った(25.60 → 11.45)が、総時間は 9.1 ms しか減っていない。固定部分が 5.0 ms 増えたからだ(9.90 → 14.95)。演算コストを除外すると、token あたり 556 KB のコア重みが見え始める。以前の head のバイト数とまったく同じ構図である。
8. head 周辺の小さな確実な改善
int4 head の近くにも PSRAM にアクセスする箇所が 2 つある。fp32 scale(token あたり 101,412 バイト、ファイル内では fp16 で保存)と、head が書き出す 101,412 バイトの logits バッファだ。
事前登録した変更では、この 2 つを同時に扱った。scale は fp16 のまま、logits は内部 SRAM に置く。240 MHz で head は 24.1 ms から 21.7 ms に下がり(n = 3)、予測していた 21.0–23.5 の範囲に収まった。non-head は 26.3 ms で変わらない。起動時のセルフチェックで、各 fp16 scale を展開した値が元の fp32 値と一致すること、hash が変わらないことを確認した。logits を SRAM に移しても余裕はあった。空き内部 SRAM は 309,056 バイトから 206,652 バイトに、最大空きブロックは 262,132 バイトから 163,828 バイトに減った。
その後、この 2 つを分けて個別に測った。以下は探索的な実行結果である。
| head トラフィック構成(240 MHz) | n | head ms | ms/token | tok/s |
|---|---|---|---|---|
| どちらもしない(対照) | 3 | 24.1 | 50.4 | 19.06 |
| fp16 scale のみ | 1 | 23.9 | 50.3 | 19.10 |
| logits を SRAM に置くのみ | 3 | 21.2 | 47.5 | 20.62 |
| 両方(事前登録ビルド) | 3 | 21.7 | 48.0 | 20.40 |
効果はすべて SRAM への移動によるものだ。logits が PSRAM に残っている状態では、fp16 scale 単独で 0.2 ms しか節約できない。logits を SRAM に移した後は、かえって 0.5 ms 増えた。私の解釈(未検証)はこうだ。logits の書き込みが PSRAM を通らなくなると、head がメモリで止まる回数が減り、各行で fp16 scale を展開するわずかな整数演算をストールの裏に隠せなくなる。
最終ビルドでは logits だけを SRAM に置いた。自身のハッシュ検証に合格しており、4400a1cbf4a5137d、テキストも完全に一致する。
9. int4 コア
コアも同じ方針で進めた。コアのテンソル 43 個、合計 286,848 バイトを、head の kernel レイアウトに合わせて int4 で並べ直した。96 列のテンソルは int4 head kernel をそのまま使う。128 列という唯一の形状には新しい kernel が必要で、空きベクトルレジスタがないため、自身の積和命令の中で最後の 32 バイトの活性値を入れ替えながら処理する。Down は引き続きゼロ埋めで、今度は 96 列まで埋めるので、48 バイトの int4 行が 16 バイト境界を保つ。各テンソルの各行は、ファイル内のエンコードとセルフチェックで照合した。
| non-head(各グループ n = 3) | 240 MHz | 160 MHz | 80 MHz |
|---|---|---|---|
| 対照、int8 コア @ 240 | 26.3 | – | – |
| int4 コア | 22.0 | 27.5 | 45.0 |
| ms/token、int4 コア | 43.3 | 49.5 | 69.5 |
非 head は 22.0〜25.0 ms に収まると予測した。実測は 22.0 ms で、区間の下端にちょうど張り付いた。この数値は 4 フェーズそれぞれを 0.1 ms 単位で足し合わせた結果なので、22.0 ± 0.2 となる。ms/token から head を引くと 22.1 だ。予測は当たり、ただしぎりぎりの線だ。このことは隠すより知っておいてもらいたい。
なぜ効いたのかはフィッティング結果が説明している。非 head の固定部分は 14.95 ms から 10.50 ms に下がり、周波数に比例する部分は変わらなかった(11.45 から 11.50)。int4 コアは 1 トークンあたり 277,632 バイトの読み出しを減らしており、これを 4.45 ms で割るとおよそ 62 MB/s になる。head と同じ下限だ。
10. 物語の終わりで止める
第 3 節の無限ループへの修正だ。私がコードを監査したうえで end-of-story パッチを当てた。語彙生成器が end-of-story トークンの id を書き出すようになり、コンパイル時のスイッチ STOP_AT_EOT を有効にすると、モデルがそれを選んだ時点でループを抜ける。
| 設定(240 MHz、各 1 回) | トークン数 | テキスト | 出力ハッシュ |
|---|---|---|---|
STOP_AT_EOT=0(デフォルト) | 200 | 763 バイト、上記のすべてのビルドと完全に一致 | 4400a1cbf4a5137d |
STOP_AT_EOT=1 | 132 | 499 バイト:打ち切られていないテキストの先頭 499 バイトとちょうど同じ | 4400a1cbf4a5137d(先頭 20 トークン) |
固定 prompt ではモデルが 132 ステップ目で end トークンを選び、スイッチはそこで止まる。打ち切られたテキストは ...You are a good friend." で終わり、打ち切られていないテキストはそのまま Once upon a time, there was a little girl... と続く。スイッチを切れば出力は以前とバイト単位で一致するので、ベンチマーク用のビルドはすべて切ったままにしてある。打ち切った回の ms/token を他の回と比べてはいけない。132 トークンということは、attention が平均する KV cache が短いということだ。
11. この 43.3 ms はどこに消えているか
| フェーズ(int4 コア、240 MHz、n = 3) | ms/token | 説明 |
|---|---|---|
| head | 21.2 | 1 トークンあたり PSRAM から 1.32 MB 読み出し、すでに下限 |
| attention | 16.1 | 約 8.35 ms がクロックに比例する浮動小数点計算、7.75 ms が固定オーバーヘッドで、主に fp32 KV cache の読み出し |
| FFN + PLE + input | 5.9 | 2.4 + 2.5 + 1.0、主に重みの転送 |
3 フェーズの合計は 43.2 で、表示される 43.3 との差は丸めによるものだ。head のフィッティング結果に従えば、このビルドの固定オーバーヘッドは 19.6 ms。attention が 2 番目に大きい部分で、その約半分が固定オーバーヘッド、主に fp32 KV cache の読み出しだ。200 トークンの実行で平均すると 1 トークンあたり約 484 KB になる。残りの半分はクロックに比例する浮動小数点計算である。
残された手にはどれもコストが伴う。KV エントリを小さくすれば(fp16 か int8)このバイト数は減るが、出力が変わるので別途品質の基準が必要になる。PSRAM を 120 MHz に上げる、あるいは 64 バイトの cache line に変えるとなると、Espressif のプリコンパイル済みライブラリを再ビルドすることになる。しかも 120 MHz の 8 線 PSRAM は実験的扱いで、温度の影響も受ける。
私ならこうする(あなたはやる?)
ESP32-S3 のボードが手元にあるなら、まず N16R8、つまり 16 MB flash と 8 MB の 8 線 PSRAM であることを確認してほしい。モデルはその flash を必要とし、ファームウェアは PSRAM が 8 線モードで動くことを前提にしている。上流の deploy.sh で書き込めば、1 トークンあたり約 95 ms になる。これは上流と私の双方が測った結果である。OLED がないなら、まず sketch で USE_DISPLAY を 0 にしよう。バスにディスプレイがない状態だと、表示まわりのコードのせいで私のボードは 10.34 tok/s から 5.43 tok/s まで落ちた。
5 つの速度パッチで、同じボードが 1 トークンあたり 43.3 ms、22.59 tok/s になる。使った 200 トークンのテキストは公式ファームウェアと同じで、先頭 20 トークンの logit ハッシュも一致する。
パッチは私の fork で公開している:msb-msb/esp32-ai。デフォルトブランチの insiderllm にすべてのパッチが入っていて、変更ごとに 1 ブランチ、さらに tools ブランチでは chat.py とチェックサム付きビルドを追加している。fork を新規に clone してビルドすると、insiderllm ブランチで実測 43.2 ms/token、22.61 tok/s(n = 3)、200 トークンのテキストも同じだった。これらの変更はesp32-ai issue #26で上流に提案済みで、上流が引き続き正式なプロジェクトだ。issue のタイトルにある数字(1.84x)はこのシリーズの途中経過の結果で、完成版では 2.19x を実測している。一部だけやるなら、head の部分だけでもいい。SIMD head と int4 head を合わせると、1 トークンあたり 51.4 ms のうち 35.1 ms を削り、94.7 から 59.6 に下がる。
質問に答えられるモデルを探しているなら、この記事は飛ばしていい。このモデルが書くのは子ども向けの物語で、しかも Lily の話を書かせるとうまい。
制約
- 測っているのは速度だけ。どのビルドでも同じ 200 トークンのテキストを出力し、最初の 20 トークンの logit ハッシュも一致する。整数カーネルは構造上正確なので、品質は変わらない。品質はここでは測らない。
- ボード 1 枚、モデル 1 つ、2 日間(2026-10-10 と 2026-10-11)、プロンプト 1 つ(「Once upon a time」)、greedy で 200 トークン。
- 消費電力のデータはまだない。
- TinyStories は子ども向けの物語しか書かない。
- ソフトウェアスタックは 1 つだけ。Arduino-ESP32 core 3.3.10(IDF v5.5.4)、
-O3。core のバージョンを変えればベースラインも変わりうる。
方法
時間を計る変更はすべて、実行前に書き留めた。予測、予測区間、そして何をもって失敗とするか。各ファイルはハッシュを取ってあり、実行後も変更していない。ファイルはプロジェクトのリポジトリ(~/Desktop/esp32-llm/evals/<id>/PREREG.md)にあり、このサイトには置いていない。2026-10-10 のボード上の実験 4 回は、ファイルを書き終えてから初めてハードウェアで動かすまでが 1.5〜2.7 分。ホスト側のデコードテストは約 1 分 11 秒で、この数字はそのログから取った。2026-10-11 の実験 3 回は間隔が 18〜21 秒だが、予測自体はもっと早くに決めていた。当日 09:05 にそのセッションの書面ブリーフに書いており、ファイルはブリーフの予測文の逐語コピーだ。再現実行だけは事前登録しておらず、検証用と明記してある。
時間を計る前には必ず、logits チェックサムを組み込んだゲート用ビルドを通した。最初に生成する 20 トークンの生の logits に対して 64 ビット FNV-1a を計算し(毎回 4400a1cbf4a5137d)、200 トークンのテキストをバイト単位で照合する。計測用ビルドではチェックサムをコンパイル時に外す。各構成で 3 回リセットし、3 回の実行でファームウェアの 0.1 ms 精度で出力された値は完全に一致した。
フィッティングには 240 MHz と 80 MHz の 2 回の実行で t = a/f + b を使い、160 MHz で検証した。周波数に比例する時間と固定の時間を分ける式で、この 2 つが本当に足し合わさることが前提だ。計算とメモリアクセスが重なると、フィッティングは重なった分を計算として計上する。第 4 節で head の下限が隠れてしまったのはそのためだ。このフィッティングが役に立つのは、計算の大部分を削り終えてからになる。
記録にある判定表で数えると、予測は 24 件が当たり、5 件が外れた。外れた 5 件のうち 3 件はクロック掃引、2 件は第 3 節のホスト側デコードテスト 4 件のうちの 2 件。ボードだけを見れば、22 件が当たり、3 件が外れている。
記録と謝辞
生のログ、パッチのハッシュ、ビルドの詳細はすべて公開記録にある。
作業は slvDev によるものだ。esp32-ai にモデルとファームウェアがあり、モデルカードは Hugging Face にある。多くの人に知られるきっかけは、Andres が Better Stack で公開した動画だった。
この先は、ボードに電力計を繋いだらトークンあたりの消費電力を測る。インタラクティブなデモを作る。同じモデルを ESP32-P4 で動かす。
続報: トークンあたりの消費電力データと ESP32-P4 については ESP32-P4 vs ESP32-S3:USB ポートでトークンあたりのエネルギーを実測 を参照。