Meta 的生成式广告模型(GEM):为前沿广告 AI 扩展中央模型与计算引擎
Meta 把广告推荐基础模型的复杂度扩展到 2.5 倍、训练 FLOPs 提升到 4 倍,再把学到的能力迁移进那几百个真正负责实时投放广告的小模型。
中文
复制
去年,我们推出了 GEM,这是业界规模最大的推荐系统(RecSys)基础模型。GEM 确立了 Meta 首个受 LLM 启发的广告推荐范式,带来了显著的性能提升。在此基础上,我们的下一个目标是用新一代硬件进一步扩展算力与智能迁移,并将这一能力推广到 Meta 整个广告生态。这涉及数十个场景和目标,在认知、考量和转化各环节实现无缝的全漏斗优化。
2026 代 GEM 从按领域各自优化的模式——比如 Facebook、Instagram、Reels——转向单一的中央基础模型。它从 Meta 所有广告平台的数据和信号中学习,在 LLM 级算力下改变扩展曲线的走向,并通过后训练技术在无需实时评估全部广告候选的前提下获得更大的延迟预算,从而为广告主带来强劲的投放效果——这一切都建立在一套效率大幅提升的训练栈之上。最终,每个场景、每个漏斗阶段的广告效果同步提升,对用户意图的理解也更加深入,让广告与人们真正在找的东西更匹配。
过去一年,GEM 在 Meta 各广告场景和目标上实现了 18.9% 的转化提升和 12% 的广告点击率(CTR)提升,并额外为定向用户在 Facebook、Instagram 和站外转化上分别贡献了 5.8%、4.1% 和 1.6% 的转化增量。这些收益覆盖上层漏斗场景和深层漏斗优化目标,为广告主带来了更高的回报。
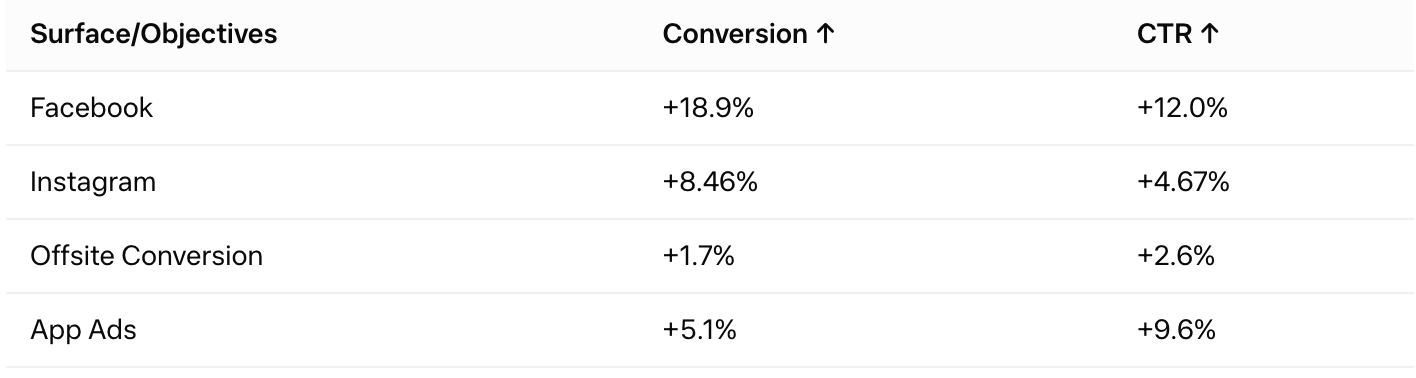
GEM 在以下四个方向推动了推荐系统的前沿进展:
1. 突破扩展曲线,支撑 2.5 倍模型复杂度
挑战: 经验扩展定律表明,在 transformer 架构下,模型性能会随算力、参数和数据规模可预测地提升。但推荐系统模型即便采用 transformer,也未能表现出类似的扩展特性,原因在于特征高度异构且分布持续漂移。 方案: 我们构建了 LLM 风格的架构 Kunlun,与最新 GPU 硬件协同设计,让更大、更深的模型在成本上显著更划算,并支持对用户互动历史的长上下文学习。在最大预训练规模上,我们观察到了类 LLM 的扩展定律,模型复杂度相比早期版本的 GEM 增长 2.5 倍。这一规律与前沿 LLM 一致:更大的容量和更长的上下文带来排序质量上的涌现式提升,并直接转化为业务结果。
2. 从 GEM 向面向用户的模型高效迁移智能
挑战: 以这种规模实时 serving 模型成本高得难以承受,还会推高延迟,既损害用户体验,也损害广告主 ROI。 方案: 结构化表示 LoopFM 是一种最先进的后训练技术,把 GEM 的内部表示和序列化历史记忆迁移到下游模型。通过计算共享,它与上一版本中部署的知识蒸馏叠加,使智能迁移量翻倍,且不增加额外算力成本或延迟。我们还引入了弹性预计算(Solaris),以充分获取上游模型带来的收益。
3. 以 Meta 广告规模的大跨界面、跨领域学习加速中央计算引擎
挑战: Meta 的应用覆盖数十个界面——Facebook、Instagram、Reels、Stories 等——每天有 36 亿人使用其中至少一个。过去每个界面、每个优化目标都有各自独立的预测系统。随着平台在界面和目标上不断扩张,同时提升广告表现的难度也随之上升。 方案: GEM 通过一个中央基础模型加速单一、统一的计算引擎,该模型联合预测所有界面(包括 Facebook 和 Instagram)上的点击与转化,并覆盖从站外转化到移动应用安装的每一个关键广告主目标。在数据丰富的点击任务上学到的可泛化表示,会迁移到数据稀疏的转化任务。新的训练方案采用零成本数据混合与领域专家框架,使这种异构的大规模学习变得可行,规模可预测,可靠性也更强。
4. 在数千块 GPU 上将总训练 FLOPs 扩大 4 倍,同时将端到端训练效率提升一倍
挑战: 在如此规模下跨数千块 GPU 训练 RecSys 基础模型,需要精细协调算力、并行、通信与内存。如今的数据中心 GPU 及其软件栈大多针对 LLM 负载优化,而推荐负载因其独特的数据特性而具有截然不同的负载特征,导致在扩展的同时极难实现高 GPU 算力利用率。 解决方案: 我们开发了低精度自定义 kernel 和新的 5D 并行策略,与最新 GPU 硬件及 Meta 的训练集群协同设计,并将模型架构与基础设施联合优化,从而高效扩展到数千块 GPU。端到端训练效率翻倍至 20-25% 的模型 FLOPs 利用率(MFU),总训练 FLOPs 扩大 4 倍,使 GEM 能在 Meta 以 LLM 规模训练(完整技术细节见姊妹博客 Training GEM at LLM Scale)。
Scaling Law:用 Kunlun 在前沿规模上弯折 scaling 曲线
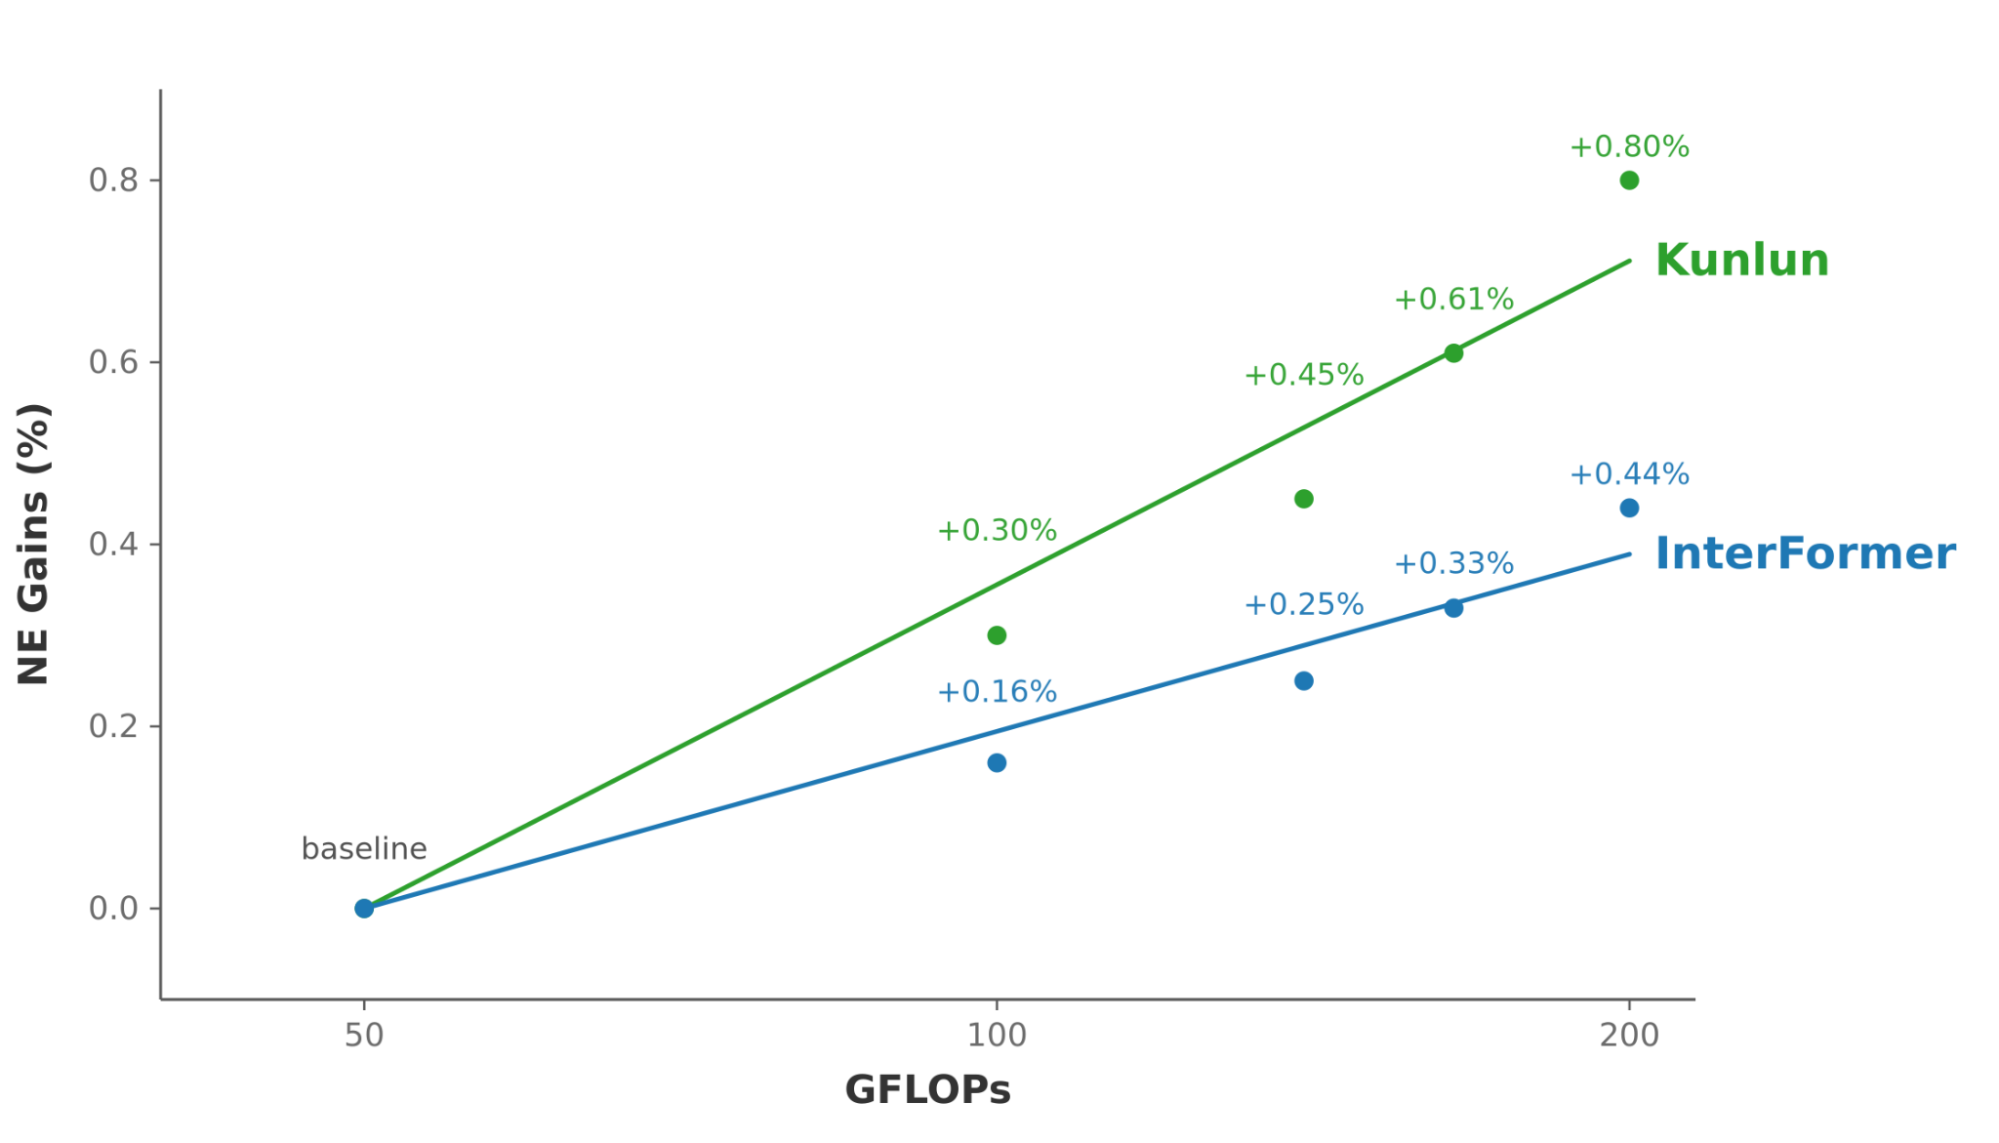
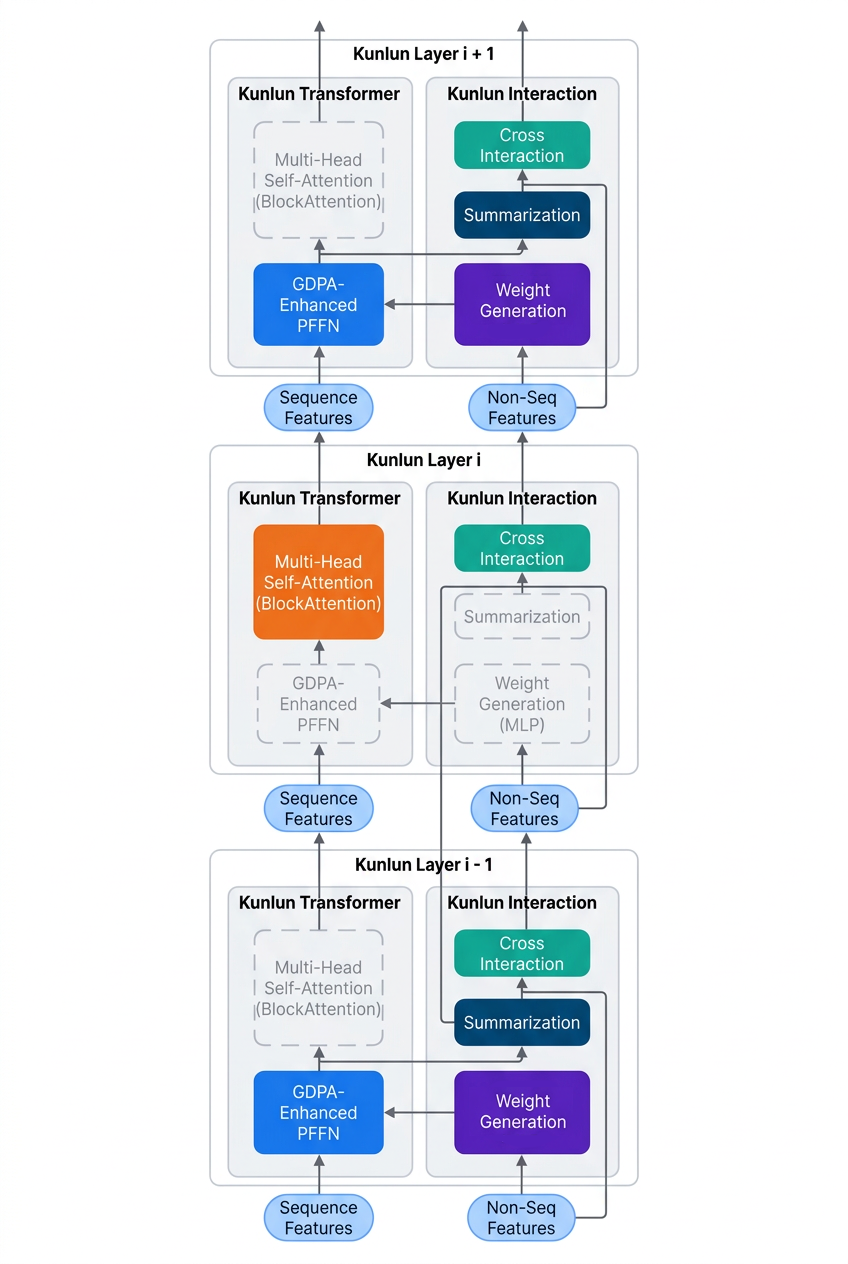
GEM 引入了新的 LLM 式模型架构——Kunlun。相比上一版(Interformer),在相同计算扩展下 Kunlun 带来 2 倍性能提升。Kunlun 围绕以下创新设计:
- 标准化并统一架构框架,将终身序列建模与可扩展的推荐专用交叉交互无缝交错。
- 通过深度协同设计引入可扩展架构,与最新一代硬件配合,在几乎不损失模型质量的前提下减少计算量。
- 创新高效序列扩展,借助离线序列基础设施处理更长的用户互动上下文。
面向规模化推荐的高效架构
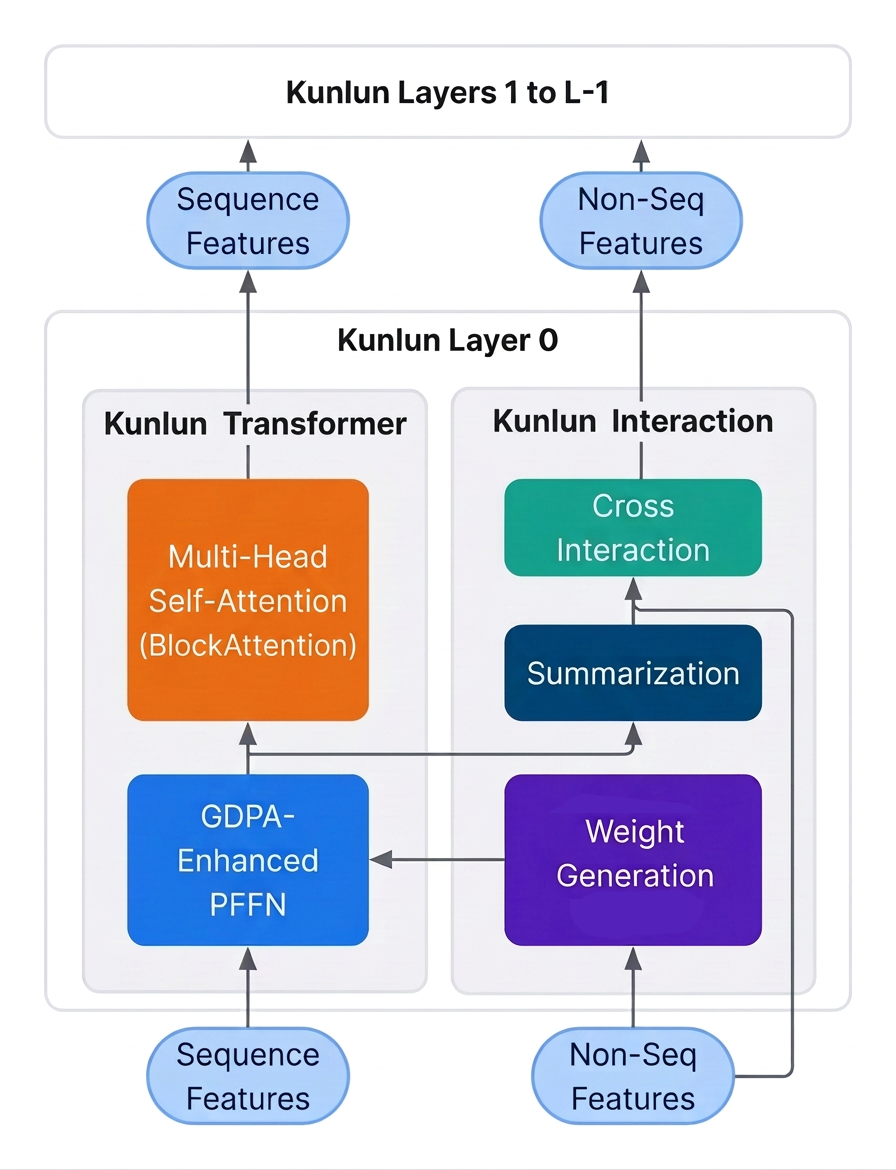
GEM 的 Kunlun 架构在前沿训练规模上有效压低了推荐系统的扩展曲线,其核心在于超长用户序列和海量用户-物品交互特征。在接下来的技术讨论中,我们将特征分为两类:非序列特征(用户人口属性、广告内容表示等),以及序列特征——由一串事件构成,每个事件又由一组特征组成。
这套架构带来了三项根本性改进:
1. 标准化、统一的架构框架
我们改进了 LLM 风格的架构,使其更好地刻画推荐系统模型独有的特性,即异构特征和数据动态性。
每一层包含:
- Attention:定制 attention 与前馈网络,适配数据动态性,从而捕捉用户行为中的长程依赖模式。
- Summarization 组件:简化并增强摘要架构,从序列中提取关键用户信息,有效连接序列与非序列结构。
- Cross Interaction:扩展到 mixture-of-experts(MoE)式设计,使序列特征与非序列特征之间复杂交互的大规模建模成为可能。
2. 通过深度软硬件协同设计引入可扩展架构
我们与最新一代硬件协同设计架构,使其能够高效地变深、变宽:
- 通过 Block Attention 降低计算复杂度: 用按 block 对齐的稀疏 attention 取代 full self-attention,把与序列长度相关的复杂度从平方级降到相对窗口大小的线性级,并且只使用 block size 整数倍的窗口大小,对 kernel 友好,不会出现非整 block 的情况。
- 通过架构重构统一组件: 我们引入 Per-Example Feed-Forward Networks(pFFN),让传统 FFN 适配逐样本分布。随后借助 Generalized Dot-Product Attention(GDPA) 将 pFFN 组件重构为 attention 运算,目标是把模型里众多类 attention 运算统一到单个 GPU kernel 上,训练因此加速,前向最高提速 2 倍。
- 通过 Expert Parallelism 实现可扩展的 Cross interaction: 我们的 cross-interaction 组件采用可扩展的 MoE 式框架,运用模型-专家并行,让每块 GPU 并行处理一部分专家子网络。
3. 高效序列扩展的创新
我们引入了专门的组件设计,使超长序列在计算上变得可行: 组件跳连(CompSkip): 该计算跳过机制在每一层中选择性地激活序列模块,仅通过残差连接传递输出。基于网络在重新激活后能够快速恢复的假设,我们通过选择性地停用特定组件,将 FLOPS 降低了 43%,质量损失可忽略不计。 序列统一(OneSeq): 我们在事件特征聚合之后,按时间顺序选择性地统一用户序列。这使得单个统一的序列层能够处理长序列,即便各个事件具有异构的结构和特征。在系统中,我们有不同的用户序列来源,其中一些具有不同的事件特征。例如,购买序列中的事件可以由 ad ID 和 account ID 描述,而帖子序列中的事件则由 actors 和 object ID 描述。由于事件特征集合不同,它们无法简单地在数据源层面统一。这需要灵活的序列统一方法,以通过大规模张量操作最大化 GPU 效率,并最小化算子碎片化。
超长序列为何重要
新架构让超长序列变得_可行_。GEM 在生产环境中将长互动上下文的长度扩展了 2 倍,并进一步实现了将长上下文扩展至 25 倍的能力,展示了前沿规模下的基础设施能力。在此过程中,我们发现了以下几点:
- 预测质量随序列长度呈幂律关系。 这一关系可预测,且在不同序列长度下保持一致。
- 更大的模型从更长序列中获得的收益不成比例地高。 这形成了一个良性循环:算力扩展让模型更大,模型更大又让更长序列更有价值;序列长度扩展让模型更准确,模型更准确又为更多算力提供了理由。
- 两条扩展定律相互强化,为投资指明了方向——不必只靠堆算力,也能让整体扩展定律曲线发生弯折。
后训练:规模化知识迁移
基础模型的价值,取决于它的智能能多有效地迁移到数百个实时投放广告的垂直模型上。GEM 借助中央大脑的深度历史记忆进行结构表征,彻底改变了推荐系统的后训练,迁移效果达到知识蒸馏的 2 倍以上。 此外,我们还在少数领域专用的基础模型中引入异步计算,把知识迁移到垂直模型。
规模化结构表征
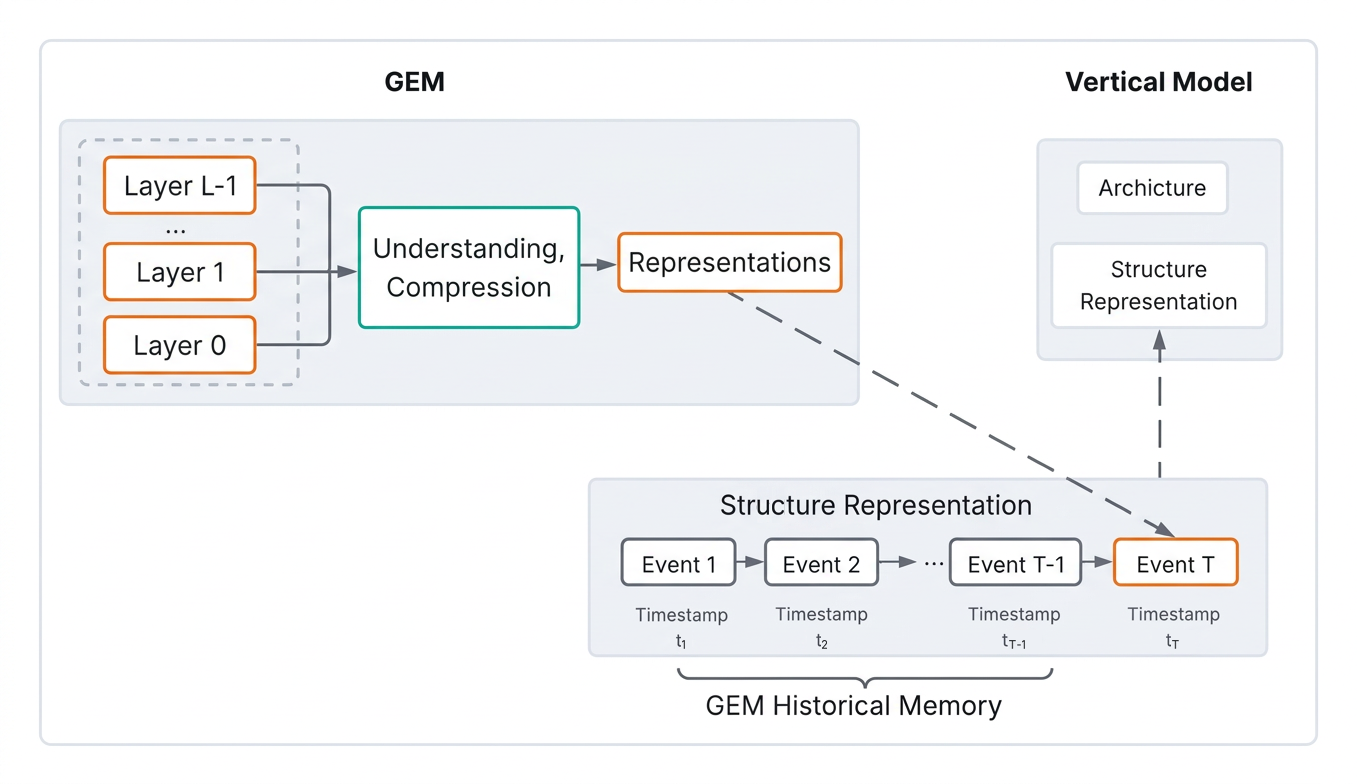
知识蒸馏有效,但带宽有限:下游模型在每次训练过程中只能拿到 GEM 智能的一个压缩视图。为突破这一限制,我们引入预计算的结构表征,例如 LoopFM,从基础模型中理解并压缩中央大脑,形成紧凑表征,再用深度历史记忆加以结构化。这样,下游模型就能从我们的中央大脑中学习长上下文。该系统包含以下几个主要组件:
- 理解并压缩智能:我们将 GEM 中的智能压缩为紧凑表示,这些表示归纳自重要层,用于全面描述基础模型所处理的事件(或数据)。
- 以深度历史记忆构建结构:我们将这一紧凑表示与基础模型此前为同一用户生成的表示一起,组织进一个顺序上下文窗口,借助 GEM 的记忆捕捉用户意图在所有界面和流量中的动态变化。
- 从长上下文智能中学习:下游模型将在推理和训练阶段,通过专用架构学习带有长历史上下文的结构表示。
表示生成过程是预先计算的,并与生成基础模型软标签的计算共享,用于知识蒸馏,且不产生额外的基础模型成本。
面向新鲜预测的推测性预计算
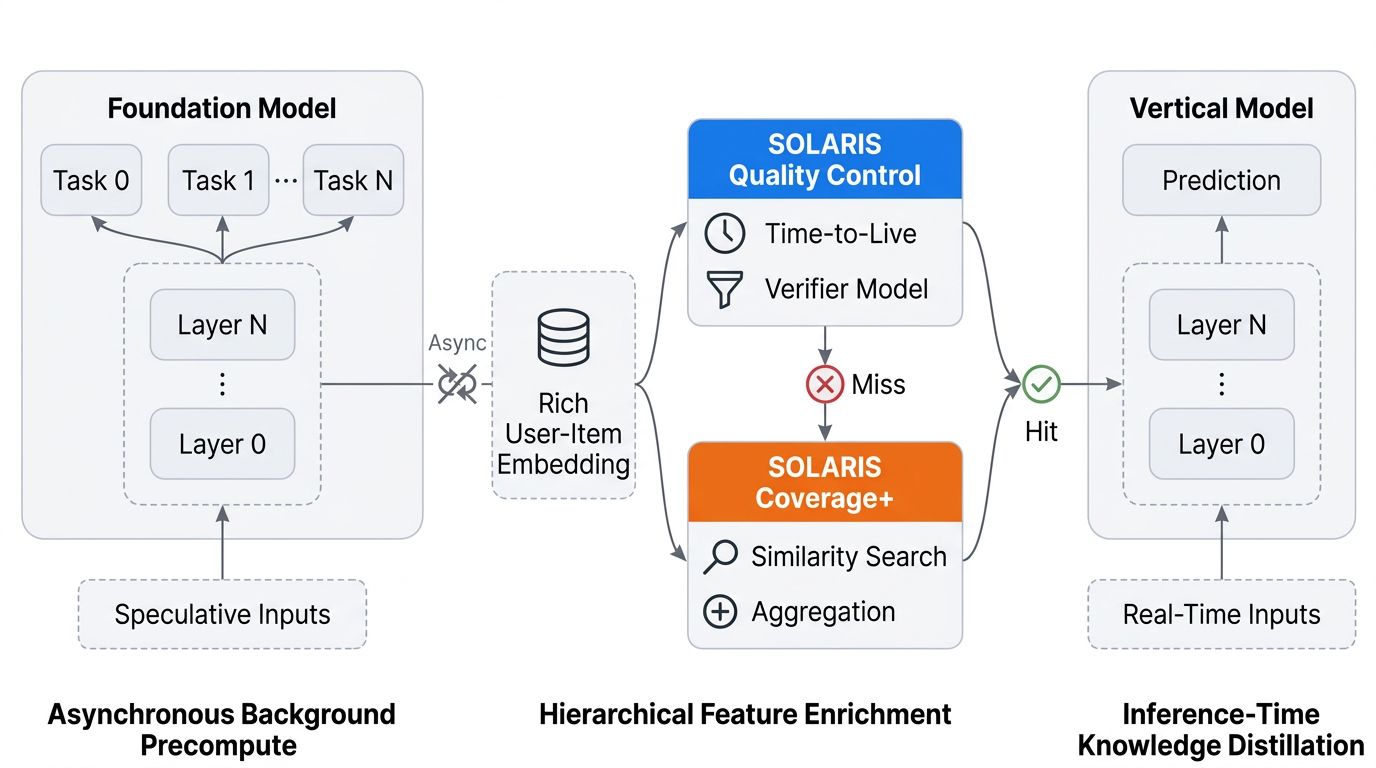
Solaris 让知识迁移保持常新:在垂直模型推理需要之前,就用 GEM 预计算好用户—广告表征。 在实时广告请求中评估大模型,成本上不可接受,于是 Solaris 把它在时间上挪开:它推测性地为未来请求可能需要的用户—广告对预计算基础模型 embedding,并在 serving 热路径上即时送达。下游模型由此获得接近实时的基础模型智能,又不受延迟约束。借鉴 LLM serving 中推测性解码的思路,Solaris 在系统中由以下几个主要组件协同完成:
- 交付新鲜的运行时知识:它直接生成用户—广告 embedding,让垂直模型实时、点对点地知道某个具体用户会对这个确切的广告候选作何反应。
- 在请求之前推测:多阶段排序把实时请求收窄到头部广告候选时,Solaris 在异步后台任务中用基础模型评估这些用户—广告对。这部分计算不占延迟预算,容量可弹性伸缩,同时又能捕捉丰富的知识。
- 分层扩展覆盖:当精确的用户—广告 embedding 不可用时,系统降级而不是丢弃。它用该用户近期在同一广告组下的 embedding 聚合来替代,或从行为相似的用户那里借用。
大规模跨域优化:跨场景与跨漏斗的统一优化
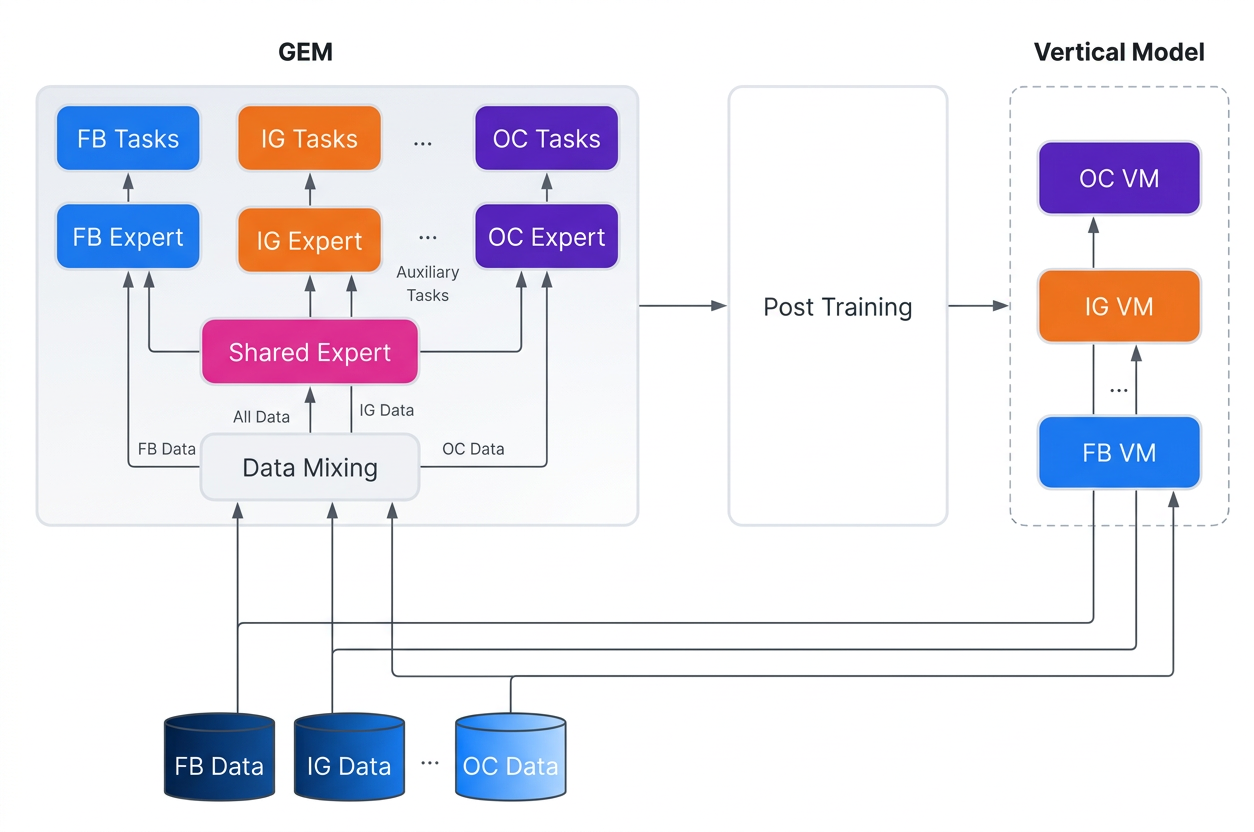
我们进一步用 Meta 规模的广告数据训练 GEM,数据覆盖全场景(例如 Facebook 与 Instagram 的 Feed 和 Reels/视频),并做深漏斗优化(例如站外转化、移动应用安装)。GEM 是首个同时预测全场景 CTR 与各主要优化目标转化率(CVR)的联合优化模型。 在此之前,每个场景、每个预测目标都各自有一套系统。这意味着,跨平台的互动模式学习结果可以更直接地用于理解广告在各场景下的转化行为(例如购买)。GEM 由此成为 Meta 各广告场景推荐的核心模型与算力引擎。
与使用静态数据的 LLM 不同,推荐系统模型必须应对数据的动态性与新鲜度,以及不同场景和流量之间分布的差异。为应对这一挑战,GEM 建立了首个面向大规模跨场景、跨域统一的训练方案,具体包括:
零成本数据混合策略: 该策略从不同数据管道的组合中虚拟加载数据,无需将数据物理合并,也不产生额外存储开销。它能灵活适配当前的广告生态——下游模型仍可用特定场景或流量的数据训练。我们还设计了数据混合机制,在离线和在线训练中控制混合比例,使其接近实时收到的真实数据流顺序,从而缓解域切换带来的不稳定以及模型对近期域数据的过度记忆。
领域专家框架: 共享专家学习所有域的统一表示,领域专属专家则捕捉各场景特有的模式。每个领域专家同时受益于两者:共享的跨域知识和自身的专业知识。专家构建在 Kunlun 架构框架之上。
高效训练 LLM 规模的推荐模型
GEM 目前已在数千块最新一代 GPU 上以 LLM 规模进行训练。如今的数据中心 GPU 及其软件栈大多针对 LLM 工作负载优化,而推荐工作负载的画像与之根本不同:独特的数据特征,加上用户与广告信号之间丰富的交互模式,使得 GEM 这种规模的基础推荐模型在训练时极难获得较高的 GPU 算力利用率。
我们用 E2E MFU 衡量训练效率,它可分解为两个因子:E2E MFU = Local MFU(计算效率)× Scaling Ratio(扩展效率)。Local MFU(计算效率)衡量单块 GPU 的计算单元利用得如何——工作负载离硬件 roofline 有多近。Scaling Ratio(扩展效率)衡量扩展到数千块 GPU 时,单 GPU 性能保留了多少。这一分解之所以重要,是因为它让我们把计算效率和扩展效率当作两个相关但彼此独立的问题来优化,各自有专门的技术手段。两者都必须解决,才能把端到端 MFU 做到最大。
我们通过计算效率和扩展效率两方面的互补创新来应对这些挑战:
- 计算效率: 依靠定制的推荐 kernel 库——Jagged Flash Attention(JFA)、GDPA、Block-Attention 等——以及针对推荐工作负载优化的混合超低精度训练(包括 MXFP8 attention 和 MLP),专为发挥最新一代 GPU 架构而打造。
- 扩展效率: 拓扑感知的 5D 并行,配合不占用 Streaming Multiprocessor(SM)的集合通信——稠密参数采用 2D FSDP + Expert Parallelism,稀疏参数采用 Fully Sharded 2D Model Parallelism——并与 Meta 的多层网络层级协同设计,以降低通信开销。
结果是:过去 12 个月里,我们把 GEM 的端到端训练效率翻倍至 20-25% MFU,同时将训练总 FLOPs 扩大了 4 倍。在 LLM 与推荐系统的交叉点上训练基础模型,是一个协同设计问题,而不只是软件问题或硬件问题。这 2 倍的效率提升来自对技术栈每一层的仔细优化——kernel、精度、并行、网络和内存必须协同推进。
完整的技术细节见我们的配套博客:GEM Training: Train Meta’s LLM-Scale Ads Recommendation Model Efficiently。
RecSys 基础模型的未来
展望未来,我们很高兴将 GEM 扩展到从 Meta 全部平台数据中学习,捕捉跨自然内容与广告互动的行为,覆盖文本、图像和视频。我们正在朝着 LLM 级长上下文努力,让模型能够对更长的互动上下文进行推理。这将带来更好的广告相关性,帮助广告主更高效地触达合适的受众。 我们将继续在更大的计算集群上扩展 GEM,开辟新的扩展机会。我们正在引入 AI 驱动的优化,例如生态增强和架构协同设计,以加速未来的演进。这些优化将与硬件进步同步迭代改进模型架构,使每一代都能在每美元算力下提供更多智能。我们将以后训练范式的推理能力演进,把更多这样的智能迁移到下游模型,进一步提升广告主效果和用户体验。
致谢
我们感谢 Laming Chen、Yasmine Badr、Shali Jiang、Hua Zheng、Boyang Liu、Qianru Li、Zhengyu Zhang、Xiaozhen Xia、Angie Huang、Xiaolong Liu、Dan Chanpuriya、Jason Rudy、Cathy Cui、Kenny Lov、Qiuling Suo、Richard Qiu、Wentao Duan、Habiya Beg、Shuo Chang、Wenlin Chen、Xiaorui Gan、John Bocharov、Santanu Kolay、Rocky Liu、Sandeep Pandey、Matt Steiner、Ernest Wang、Musharaf Sultan、Qian Zhao、Anuj Madan、Tak Yan、Viral Vimawala、Saket Gur、Chonglin Sun、GP Musumeci、Jiyan Yang、Jiayi Xu、Chen Liang、Jerry Peng、Zhaojin Wen、Zhichen Zeng、Qinjin Jia、Qinghai Zhou、Rich Zhu、Feipeng Zhao、Hanbin Zhang、Haowen Lin、Lisang Ding、Kai Wang、James Teng、Bingjie He、Donghyun Kim、Yan Deng、Jingyi Shen、Ivonne Xu、Wei Ling、Wen-Chi Yang、Ayush Bihani、Xin Liu、Zikun Liu、Ping Chen、Wankun Zhu、Xian Chen、Jazlyn Li、Hank Lo、Amit Anand Amlesahwaram、Larry Zhang、Hansey Chen、Song Zhou、Zhehui Zhou、Huaqing Xiong、Jie Zheng、Jack Hsueh、Nikhil Garg、Ritwik Tewari、Purbesh Sahoo、Shuby Mao、Fan Yang、Jae-Woo Choi、Qi Fan、Peng Zhong、Peter Lamar、Bopa Bovet、Seunghan Lee、Robert Tang、Lei Zhang、Xi Liu、Hongtao Yu、Lei Tian、Carmen Au、Jake Siso、Rustam Hashimov、Kevin Tang、Bor-Yiing Su、Jade Nie、Tianshu Peng、Subodh Iyengar、Min Si、Ruilin Chen、Max Leung、Rupert Wu、Mandeep Chadha、Angel Yang、Damian Reeves、Hairong Kuang、Ke Sang、Vibha Sinha、Yuzhen Huang、Enes Palaz、Brian Hansen、Liangbei Xu、Oana Platon、Raghav Boinepalli、Rikin Shah、Balaji Balasubramanian、Santosh Mohan、Hao Yan、Eric Falconer、Jacky Zhou、Yusuo Hu、Justin Yang、Pawel Kadluczka、Anamaya Sullerey、Han Xu、Vivienne Sung、Jiasheng Zhang、Serena Liu、Chenxiao Guan、Qiang Jin、Qin Huang、Sagar Chordia、Mingda Li、Li Yu、Ke Pan、May Wang、Sandor Abad、Sandeep Tiwari、Patrick Phelps、Paolo Massimi、Devashish Shankar,以及参与 Meta 广告推荐系统中最大基础模型开发与生产化的全体团队。