Meta の生成型広告モデル(GEM):フロンティア広告 AI に向けた中央モデルと計算エンジンのスケーリング
Meta は広告推薦の基盤モデルの複雑さを 2.5 倍、学習 FLOPs を 4 倍に広げ、そこで学んだものを、実際にリアルタイムで広告を配信している数百の小規模モデルへ転移させた。
日本語
コピー
昨年、私たちは GEM を発表した。業界最大規模の推薦システム(RecSys)基盤モデルである。GEM は Meta 初の LLM に着想を得た広告推薦パラダイムを確立し、大幅な性能向上をもたらした。その上で次に目指すのは、新世代ハードウェアによって計算力と知能の転移をさらにスケールさせ、この能力を Meta の広告エコシステム全体に広げることだ。対象は数十のサーフェスと目的関数にわたり、認知・検討・コンバージョンの各段階を通したシームレスなフルファネル最適化を実現する。
2026 世代の GEM は、Facebook、Instagram、Reels といった領域ごとに個別最適化する方式から、単一の中央基盤モデルへと移行する。Meta のすべての広告プラットフォームからデータとシグナルを学習し、LLM 級の計算力のもとでスケーリング曲線の傾きそのものを変える。さらにポストトレーニングによって、すべての広告候補をリアルタイムに評価せずとも大きなレイテンシ予算を確保し、広告主に強い配信効果をもたらす。その土台にあるのは、効率を大幅に高めたトレーニングスタックだ。結果として、あらゆるサーフェス、あらゆるファネル段階で広告効果が同時に向上し、ユーザーの意図をより深く理解することで、広告を人が本当に探しているものにより正確に結びつける。
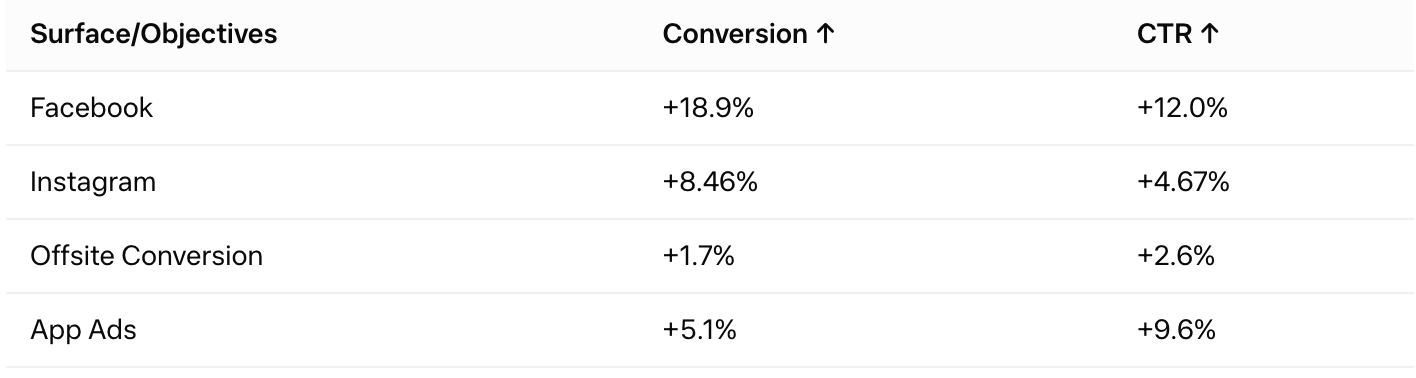
この 1 年間で、GEM は Meta の各広告サーフェスと目的関数において コンバージョン 18.9% 向上、広告クリック率(CTR)12% 向上を達成した。さらにターゲティングされたユーザーに対して、Facebook、Instagram、オフサイトコンバージョンでそれぞれ 5.8%、4.1%、1.6% のコンバージョン増分を上乗せで生み出している。これらの成果はアッパーファネルのサーフェスからディープファネルの最適化目標まで及び、広告主により高いリターンをもたらす。
GEM は次の4つの方向でレコメンデーションシステムのフロンティアを押し進めた:
1. スケーリング曲線を突破し、2.5倍のモデル複雑度を支える
課題: 経験的スケーリング則によれば、transformer アーキテクチャではモデル性能は計算量・パラメータ・データ規模に応じて予測可能に向上する。しかしレコメンデーションシステムのモデルは、transformer を採用しても同様のスケーリング特性を示さない。特徴量が高度に異種混合で、分布が絶えずドリフトするためだ。 解決策: 私たちは LLM スタイルのアーキテクチャ Kunlun を構築し、最新の GPU ハードウェアと協調設計することで、より大きく深いモデルをコスト面で大幅に有利にし、ユーザーのインタラクション履歴に対する長コンテキスト学習を可能にした。最大の事前学習規模では LLM 類似のスケーリング則が観測され、モデル複雑度は初期バージョンの GEM 比で2.5倍に増えた。この傾向は最先端 LLM と一致する。より大きな容量とより長いコンテキストがランキング品質の創発的な向上をもたらし、それが直接ビジネス成果につながる。
2. GEM からユーザー向けモデルへの効率的な知能転移
課題: この規模のモデルをリアルタイムで serving するコストは到底許容できず、レイテンシも押し上げる。ユーザー体験を損ない、広告主の ROI も損なう。 解決策: 構造化表現 LoopFM は最先端のポストトレーニング技術で、GEM の内部表現とシリアライズされた履歴メモリを下流モデルに転移する。計算の共有により、前バージョンで導入した知識蒸留と積み重なり、知能転移量を倍増させながら追加の計算コストもレイテンシも増やさない。さらに弾力的な事前計算(Solaris)を導入し、上流モデルがもたらす利益を余すところなく取り込んだ。
3. Meta 広告規模の大規模クロスサーフェス・クロスドメイン学習で中央計算エンジンを加速
課題: Meta のアプリは Facebook、Instagram、Reels、Stories など数十のサーフェスに及び、毎日36億人がその少なくとも一つを利用する。従来はサーフェスごと、最適化目標ごとに独立した予測システムがあった。プラットフォームがサーフェスと目標を拡大するにつれ、広告パフォーマンスを同時に高める難しさも増していった。 解決策: GEM は単一の統合された計算エンジンを中央の基盤モデルで加速する。このモデルは Facebook と Instagram を含むすべてのサーフェスにおけるクリックとコンバージョンを統合的に予測し、オフサイトコンバージョンからモバイルアプリインストールまで、広告主のあらゆる主要目標をカバーする。データが豊富なクリックタスクで学習した汎化可能な表現が、データの乏しいコンバージョンタスクへ転移する。新しい学習手法はゼロコストのデータ混合とドメインエキスパートのフレームワークを採用し、この異種混合の大規模学習を実行可能にし、規模の予測性と信頼性を高めた。
4. 数千基の GPU で総学習 FLOPs を4倍に拡大し、エンドツーエンドの学習効率を2倍にする
課題: この規模で数千基の GPU にまたがって RecSys 基盤モデルを学習するには、計算量・並列化・通信・メモリを細かく調整する必要がある。現在のデータセンター GPU とそのソフトウェアスタックの大半は LLM のワークロード向けに最適化されているが、レコメンデーションのワークロードはデータ特性が独特で負荷特性が大きく異なるため、スケールさせながら高い GPU 演算利用率を達成するのは極めて難しい。 解決策: 私たちは低精度のカスタム kernel と新しい 5D 並列戦略を開発し、最新の GPU ハードウェアと Meta の学習クラスタと協調設計するとともに、モデルアーキテクチャとインフラを統合的に最適化することで、数千基の GPU へ効率的にスケールさせた。エンドツーエンドの学習効率は2倍の20〜25%のモデル FLOPs 利用率(MFU)に達し、総学習 FLOPs は4倍に拡大。これにより GEM は Meta で LLM 規模の学習を実現している(技術詳細は姉妹ブログ Training GEM at LLM Scale を参照)。
Scaling Law:Kunlun でフロンティア規模においてスケーリング曲線を折り曲げる
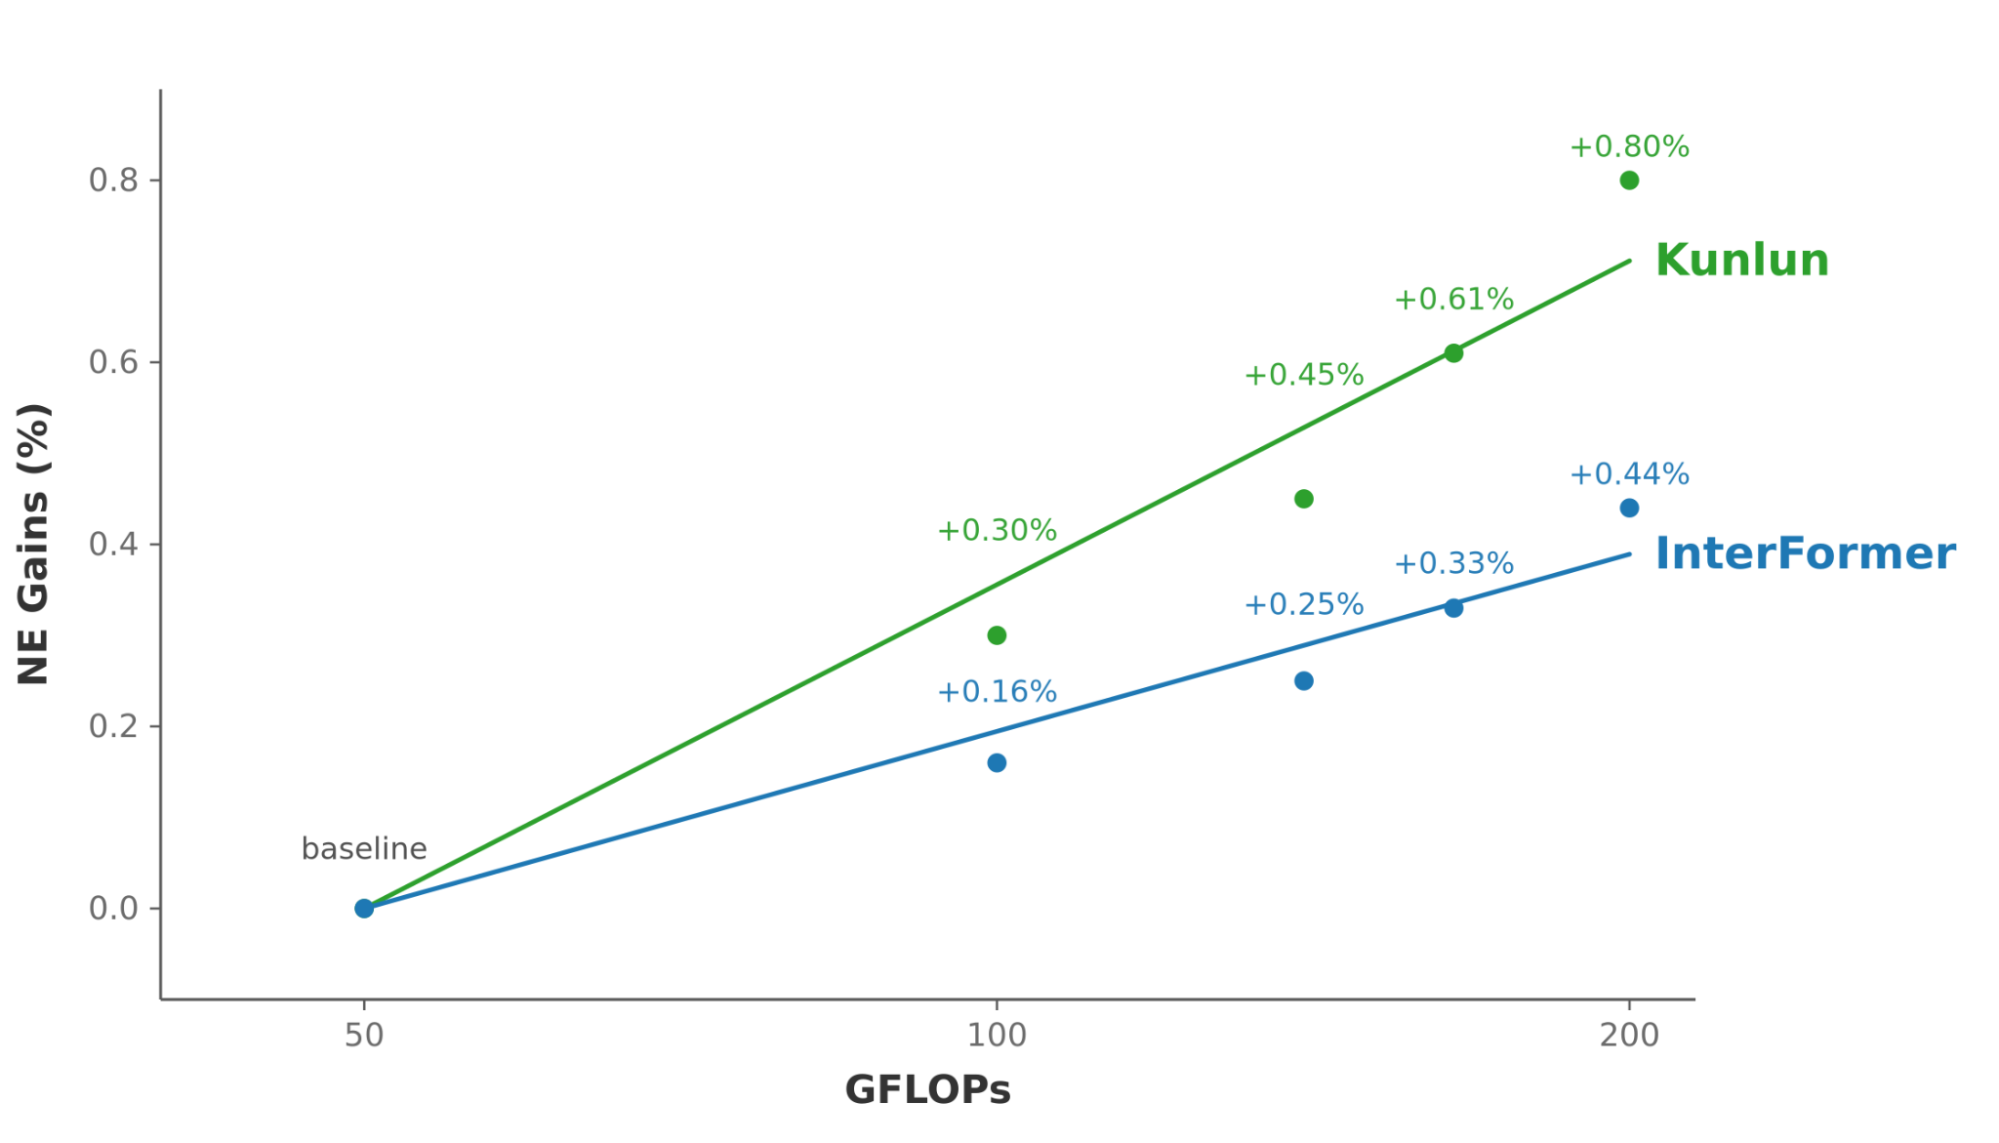
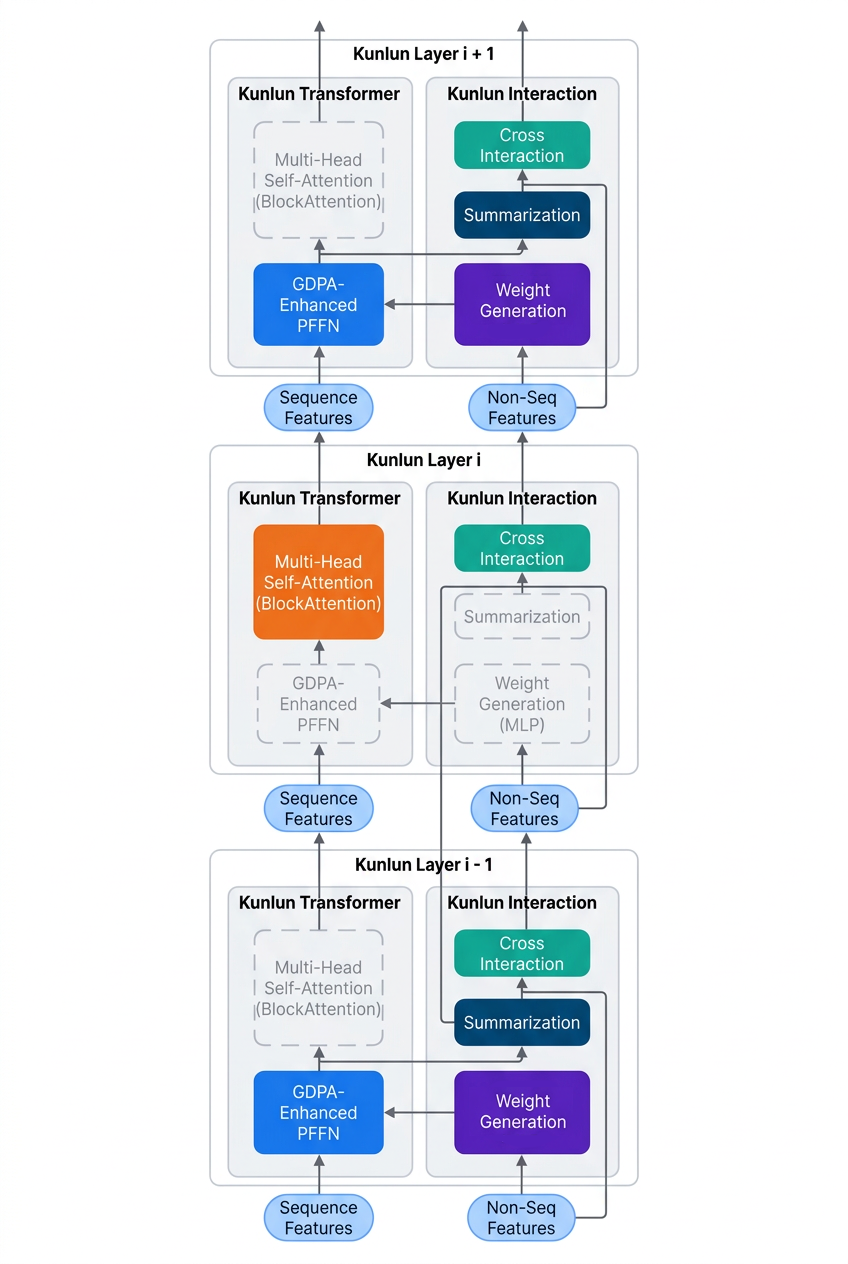
GEM は新しい LLM 型のモデルアーキテクチャ Kunlun を導入した。前バージョン(Interformer)と比べ、同じ計算スケールで Kunlun は2倍の性能向上をもたらす。Kunlun は以下の革新を中心に設計されている:
- アーキテクチャフレームワークを標準化・統一し、生涯シーケンスモデリングとスケーラブルなレコメンデーション専用のクロスインタラクションをシームレスに交互配置する。
- 深い協調設計によるスケーラブルなアーキテクチャを導入し、最新世代のハードウェアと組み合わせてモデル品質をほとんど損なわずに計算量を削減する。
- 革新的で効率的なシーケンス拡張により、オフラインのシーケンス基盤を活用してより長いユーザーインタラクションコンテキストを処理する。
大規模レコメンドのための効率的なアーキテクチャ
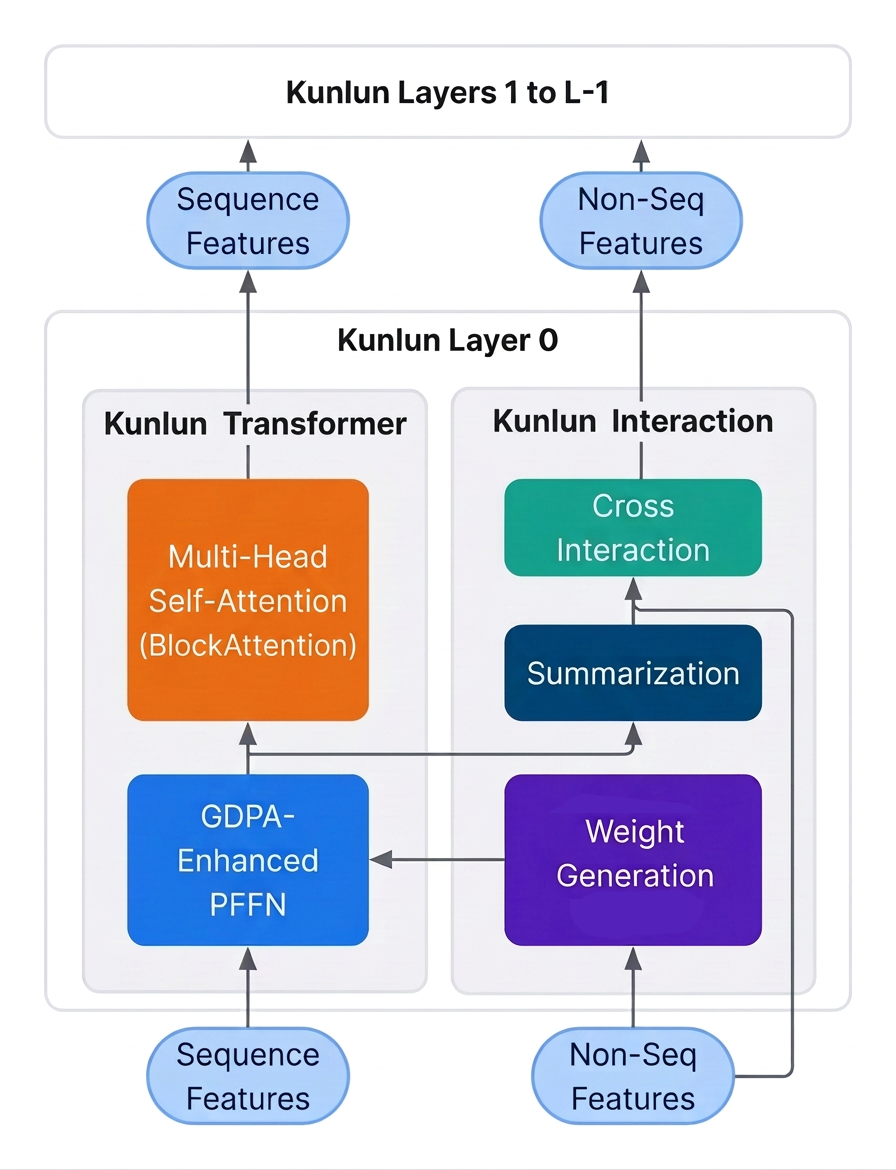
GEM の Kunlun アーキテクチャは、最先端の学習規模においてレコメンドシステムのスケーリング曲線を効果的に抑え込む。その中核にあるのは、超長いユーザーシーケンスと、膨大なユーザー-アイテムインタラクション特徴だ。以降の技術的な議論では、特徴を2種類に分ける。非シーケンス特徴(ユーザーのデモグラフィック属性、広告コンテンツの表現など)と、シーケンス特徴——一連のイベントからなり、各イベントがさらに特徴の集合で構成されるもの——である。
このアーキテクチャは3つの根本的な改善をもたらす。
1. 標準化された統一アーキテクチャフレームワーク
LLM スタイルのアーキテクチャを改良し、レコメンドシステムのモデルに固有の性質、すなわち異種特徴とデータの動態性をより的確に捉えられるようにした。
各レイヤーは次を含む:
- Attention:データの動態性に適合するようカスタマイズした attention とフィードフォワードネットワーク。ユーザー行動における長距離依存のパターンを捉える。
- Summarization コンポーネント:要約アーキテクチャを簡素化・強化し、シーケンスから重要なユーザー情報を抽出する。シーケンス構造と非シーケンス構造を効果的につなぐ。
- Cross Interaction:mixture-of-experts(MoE)型の設計に拡張し、シーケンス特徴と非シーケンス特徴の間の複雑なインタラクションを大規模にモデリングできるようにする。
2. 深いソフトウェア・ハードウェア協調設計によるスケーラブルなアーキテクチャ
最新世代のハードウェアと協調設計し、効率的に深く、広くできるようにした:
- Block Attention による計算複雑度の削減: full self-attention を block 単位で整列した疎な attention に置き換え、シーケンス長に依存する複雑度を平方オーダーからウィンドウサイズに対する線形オーダーへ下げる。しかもウィンドウサイズは block size の整数倍のみを使うため、kernel に優しく、非整数 block は発生しない。
- アーキテクチャ再構成によるコンポーネントの統一: Per-Example Feed-Forward Networks(pFFN)を導入し、従来の FFN をサンプルごとの分布に適合させる。続いて Generalized Dot-Product Attention(GDPA) を用いて pFFN コンポーネントを attention 演算として再構成する。狙いは、モデル内に多数ある attention 類似の演算を単一の GPU kernel に統合することにあり、学習が加速し、forward は最大2倍高速化する。
- Expert Parallelism によるスケーラブルな Cross interaction: cross-interaction コンポーネントはスケーラブルな MoE 型フレームワークを採用し、モデル-エキスパート並列を用いて、各 GPU がエキスパートサブネットワークの一部を並列に処理する。
3. 効率的なシーケンス拡張のための工夫
超長シーケンスを計算上実行可能にするため、専用のコンポーネント設計を導入した: コンポーネントスキップ接続(CompSkip): この計算スキップ機構は、各レイヤーでシーケンスモジュールを選択的に有効化し、出力は残差接続を通じてのみ伝える。再活性化後にネットワークが素早く回復するという仮定に基づき、特定のコンポーネントを選択的に停止することで FLOPS を43%削減し、品質の損失はごくわずかだった。 シーケンス統合(OneSeq): イベント特徴の集約後、ユーザーシーケンスを時系列順に選択的に統合する。これにより、個々のイベントが異種の構造と特徴を持っていても、単一の統合シーケンスレイヤーが長いシーケンスを処理できる。システムには異なるユーザーシーケンスのソースがあり、中にはイベント特徴が異なるものもある。たとえば購入シーケンスのイベントは ad ID と account ID で記述でき、投稿シーケンスのイベントは actors と object ID で記述される。イベント特徴の集合が異なるため、データソースのレベルで単純に統合することはできない。大規模なテンソル演算で GPU 効率を最大化し、オペレータの断片化を最小化するには、柔軟なシーケンス統合の手法が要る。
超長シーケンスが重要な理由
新しいアーキテクチャによって、超長シーケンスが_現実的_になった。GEM は本番環境で長いインタラクションコンテキストの長さを 2 倍に拡張し、さらに長コンテキストを 25 倍まで拡張する能力を実現して、フロンティア規模でのインフラ能力を示した。その過程で分かったことは次のとおりだ。
- 予測品質はシーケンス長に対して冪乗則に従う。 この関係は予測可能で、シーケンス長が変わっても一貫している。
- 大きなモデルほど、長いシーケンスから得られる利益が不釣り合いに大きい。 ここから好循環が生まれる。計算資源の拡大がモデルを大きくし、モデルが大きくなると長いシーケンスの価値が高まる。シーケンス長の拡張がモデルを正確にし、モデルが正確になると、さらに多くの計算資源を投じる理由が生まれる。
- 2 つのスケーリング則が互いを強化し合う。 これは投資の方向を示している。計算資源を積み増すだけに頼らずとも、全体のスケーリング則の曲線を折り曲げられる。
ポストトレーニング:知識転移のスケール化
基盤モデルの価値は、その知能を数百のリアルタイム配信広告向けバーティカルモデルへどれだけ効果的に転移できるかで決まる。GEM は中央脳の深い履歴記憶による構造表現によって、レコメンドシステムのポストトレーニングを根本から変え、知識蒸留の 2 倍以上の転移効果を達成した。 さらに、少数のドメイン特化基盤モデルに非同期計算を導入し、バーティカルモデルへ知識を転移している。
構造表現のスケール化
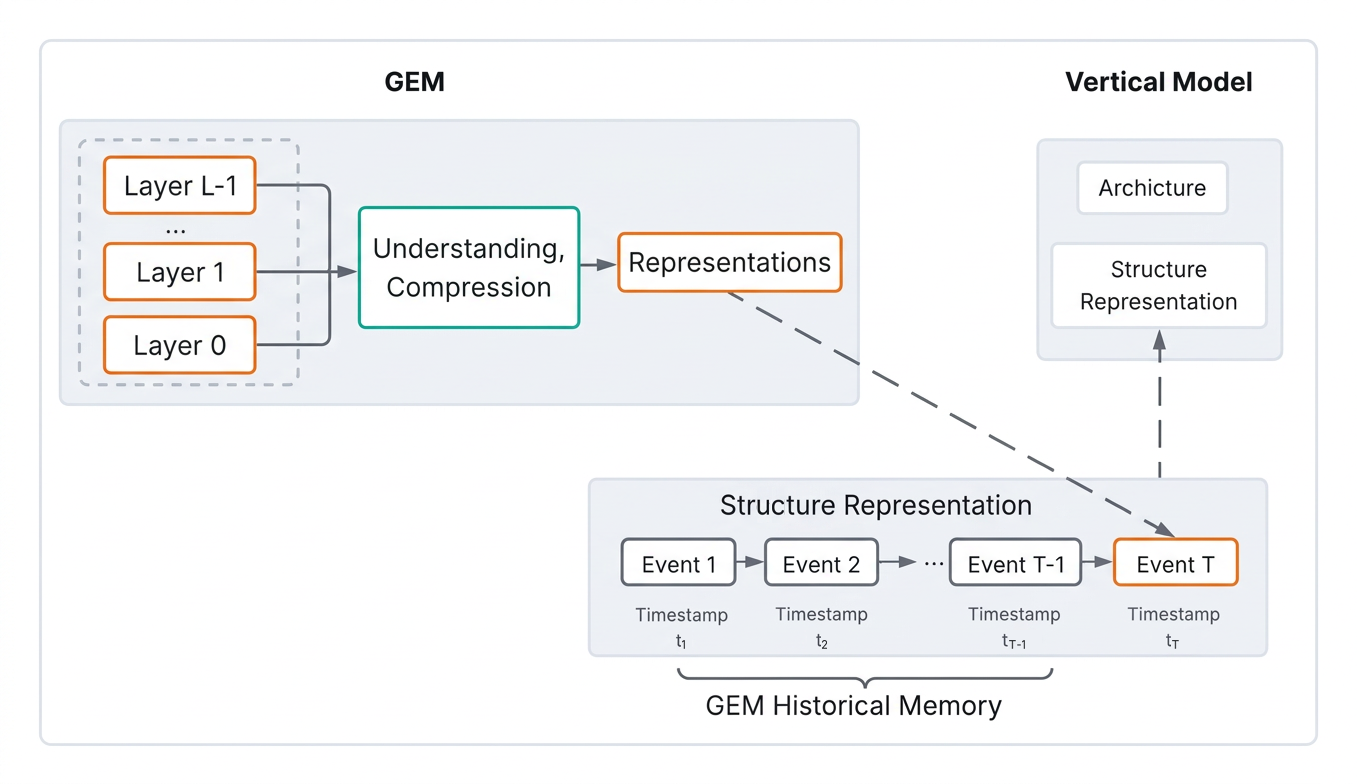
知識蒸留は有効だが、帯域幅に限りがある。下流モデルは各トレーニング過程で、GEM の知能の圧縮されたビューしか受け取れない。この制約を突破するために、私たちは事前計算された構造表現、たとえば LoopFM を導入した。基盤モデルから中央脳を理解・圧縮してコンパクトな表現を形成し、それを深い履歴記憶で構造化する。こうして下流モデルは、中央脳から長コンテキストを学習できる。このシステムは主に次のコンポーネントで構成される。
- 知能を理解して圧縮する:GEM の知能をコンパクトな表現に圧縮する。この表現は重要な層から帰納され、基盤モデルが処理するイベント(またはデータ)を包括的に記述するために使う。
- 深い履歴記憶で構造を構築する:このコンパクトな表現を、基盤モデルが以前に同じユーザー向けに生成した表現とともに、1 つの順序付けられたコンテキストウィンドウにまとめる。GEM の記憶によって、あらゆる画面とトラフィックにおけるユーザー意図の動的な変化を捉える。
- 長コンテキスト知能から学習する:下流モデルは推論とトレーニングの段階で、専用アーキテクチャを通じて、長い履歴コンテキストを伴う構造表現を学習する。
表現の生成は事前計算され、知識蒸留に使う基盤モデルのソフトラベルの計算と共有されるため、基盤モデル側の追加コストは発生しない。
新鮮な予測のための投機的な事前計算
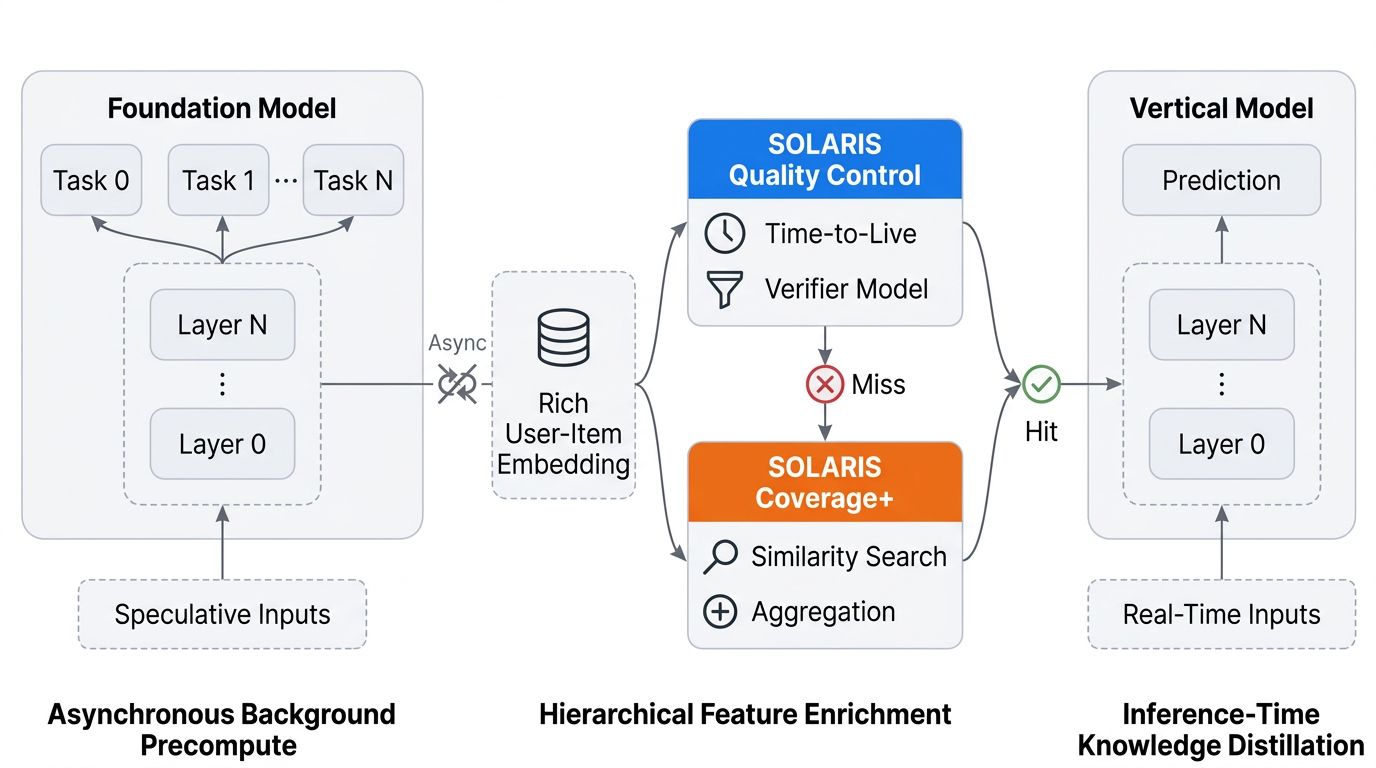
Solaris は知識の移転を常に新鮮に保つ。垂直モデルの推論が必要とする前に、GEM でユーザー—広告の表現を計算しておく。 実時間の広告リクエストの中で大規模モデルを評価するのはコスト的に受け入れられない。そこで Solaris はそれを時間軸の上でずらす。将来のリクエストが必要としそうなユーザー—広告ペアについて、基礎モデルの embedding を投機的に事前計算し、serving のホットパスで即座に届ける。下流のモデルは、レイテンシの制約を受けずに、ほぼリアルタイムの基礎モデルの知能を得られる。LLM serving における投機的デコーディングの発想を借りており、Solaris では主に次のコンポーネントが連携してこれを実現する。
- 新鮮な実行時知識を届ける:ユーザー—広告の embedding を直接生成し、垂直モデルがリアルタイムに、ポイントツーポイントで、ある特定のユーザーがこの正確な広告候補にどう反応するかを知れるようにする。
- リクエストの前に投機する:多段階ランキングが実時間のリクエストを上位の広告候補に絞り込むとき、Solaris は非同期のバックグラウンドタスクで基礎モデルを使ってそれらのユーザー—広告ペアを評価する。この計算はレイテンシの予算を消費せず、容量は弾力的に伸縮でき、しかも豊富な知識を捉えられる。
- 階層的にカバレッジを広げる:正確なユーザー—広告 embedding が使えないとき、システムは捨てるのではなく段階的にフォールバックする。そのユーザーの直近の、同じ広告グループにおける embedding を集約して代用するか、行動が似たユーザーから借りる。
大規模クロスドメイン最適化:シーンとファネルを横断する統合最適化
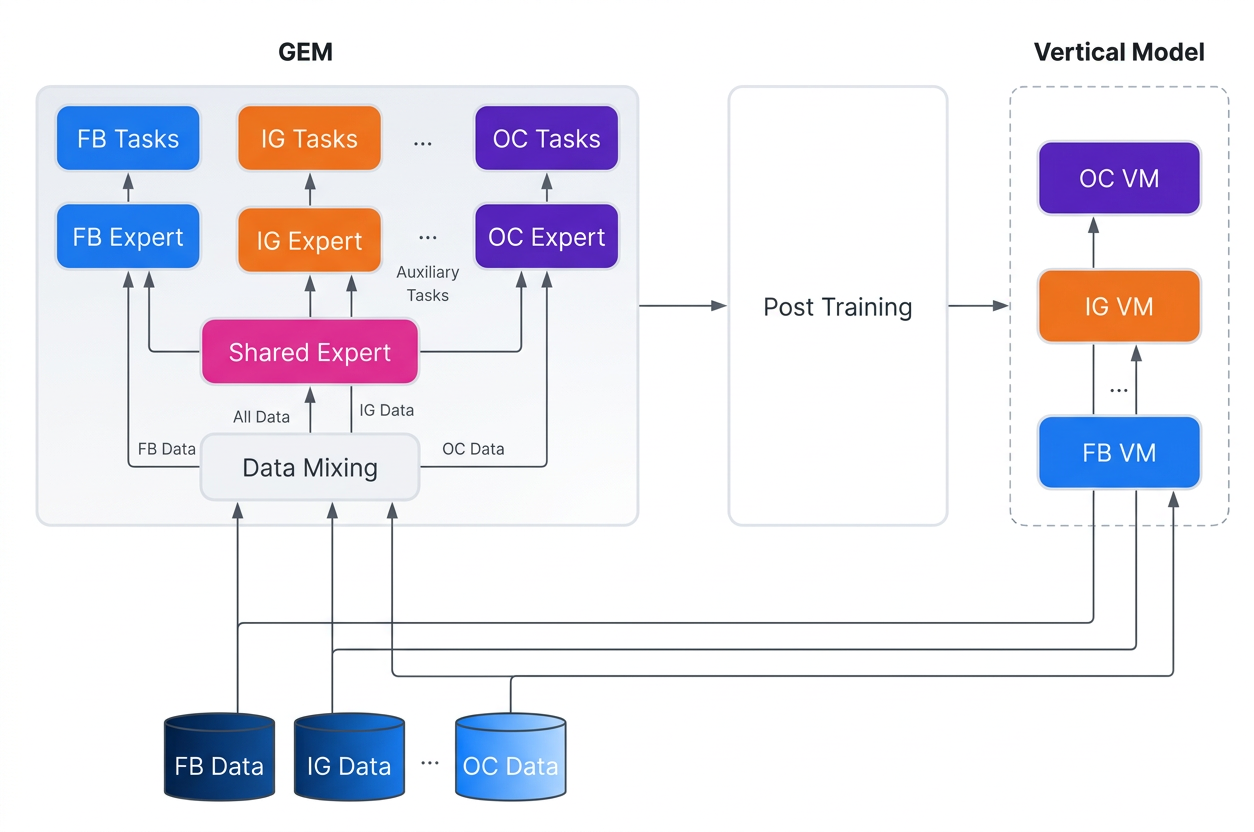
私たちはさらに、Meta 規模の広告データで GEM を訓練した。データはすべてのシーン(Facebook と Instagram の Feed、Reels/動画など)をカバーし、ファネルの深い最適化(オフサイトコンバージョン、モバイルアプリインストールなど)にも対応する。GEM は、すべてのシーンで CTR と主要な最適化目標のコンバージョン率(CVR)を同時に予測する、初の統合最適化モデルである。 それ以前は、シーンごと、予測目標ごとに個別のシステムが存在していた。つまり、プラットフォームをまたいだインタラクションパターンの学習結果を、各シーンにおける広告のコンバージョン行動(購入など)の理解に直接活かせるようになったのだ。こうして GEM は、Meta の各広告シーンにおけるレコメンドの中核モデル兼計算エンジンとなっている。
静的なデータを用いる LLM とは異なり、レコメンドシステムのモデルは、データの動的性と鮮度、そしてシーンやトラフィック間の分布の違いに向き合わなければならない。この課題に対し、GEM は大規模なクロスシーン・クロスドメイン統合のための初の訓練手法を確立した。具体的には以下のとおりである。
ゼロコストのデータ混合戦略: 異なるデータパイプラインの組み合わせからデータを仮想的に読み込む。データを物理的に統合する必要がなく、追加のストレージコストも発生しない。現在の広告エコシステムに柔軟に適応でき、下流のモデルは特定のシーンやトラフィックのデータで引き続き学習できる。さらにデータ混合の仕組みを設計し、オフライン学習とオンライン学習の混合比率を制御することで、ほぼリアルタイムに届く実際のデータストリームの順序に近づけた。これにより、ドメイン切り替えによる不安定さと、直近のドメインデータに対するモデルの過剰な記憶を緩和している。
ドメインエキスパートフレームワーク: 共有エキスパートがすべてのドメインの統一表現を学習し、ドメイン固有のエキスパートが各シーン特有のパターンを捉える。各ドメインエキスパートは双方の恩恵を受ける。共有されたクロスドメイン知識と、自身の専門知識である。エキスパートは Kunlun アーキテクチャフレームワーク上に構築されている。
LLM 規模の推薦モデルを効率よく学習させる
GEM は現在、数千基の最新世代 GPU 上で LLM 規模の学習を行っている。今日のデータセンター GPU とそのソフトウェアスタックの多くは LLM ワークロード向けに最適化されており、推薦ワークロードの特性はそれとは根本的に異なる。独特なデータ特性に加え、ユーザーと広告シグナルの間に存在する豊かな交互作用パターンのため、GEM のような規模の基盤推薦モデルでは、学習時に高い GPU 演算利用率を得るのが極めて難しい。
学習効率は E2E MFU で測る。これは二つの因子に分解できる。E2E MFU = Local MFU(計算効率)× Scaling Ratio(拡張効率)。Local MFU(計算効率)は 1 基の GPU の演算ユニットをどれだけ使い切れているか、つまりワークロードがハードウェアの roofline にどれだけ近いかを測る。Scaling Ratio(拡張効率)は、数千基の GPU に拡張したとき、単一 GPU あたりの性能がどれだけ保たれるかを測る。この分解が重要なのは、計算効率と拡張効率を、互いに関連しつつ独立した二つの問題として、それぞれ専用の技術で最適化できるようになるからだ。エンドツーエンドの MFU を最大化するには、両方を解決しなければならない。
こうした課題には、計算効率と拡張効率の両面で補完的な工夫を重ねて対処している。
- 計算効率: 用途別の推薦 kernel ライブラリ——Jagged Flash Attention(JFA)、GDPA、Block-Attention など——と、推薦ワークロード向けに最適化した混合超低精度学習(MXFP8 attention や MLP を含む)に頼る。いずれも最新世代 GPU アーキテクチャの性能を引き出すために作られている。
- 拡張効率: トポロジーを考慮した 5D 並列と、Streaming Multiprocessor(SM)を占有しない集合通信を組み合わせる。稠密パラメータには 2D FSDP + Expert Parallelism、疎パラメータには Fully Sharded 2D Model Parallelism を使い、通信オーバーヘッドを抑えるために Meta の多層ネットワーク階層と協調設計する。
結果として、この 12 か月で GEM のエンドツーエンド学習効率を 2 倍の 20-25% MFU に引き上げ、同時に学習の総 FLOPs を 4 倍に拡大した。LLM と推薦システムの交差点で基盤モデルを学習させることは、ソフトウェアだけの問題でもハードウェアだけの問題でもなく、協調設計の問題だ。この 2 倍の効率向上は、技術スタックの各層——kernel、精度、並列、ネットワーク、メモリ——を丁寧に最適化したことによるもので、これらは歩調を合わせて進める必要がある。
技術的な詳細はこちらの関連ブログで:GEM Training: Train Meta’s LLM-Scale Ads Recommendation Model Efficiently。
RecSys 基盤モデルの今後
今後は GEM を拡張し、Meta の全プラットフォームのデータから学習して、自然コンテンツと広告の双方にまたがるインタラクション行動を捉えたい。テキスト、画像、動画を対象にする。LLM 級の長いコンテキストも目指しており、より長いインタラクション履歴についてモデルが推論できるようにする。これにより広告の関連性が高まり、広告主が適切なオーディエンスに効率よくリーチできるようになる。 GEM はより大規模な計算クラスタへと拡張を続け、新たなスケーリングの機会を開いていく。エコシステム強化やアーキテクチャの協調設計など、AI 駆動の最適化も取り入れ、今後の進化を加速させる。こうした最適化はハードウェアの進歩と歩調を合わせてモデルアーキテクチャを反復的に改善し、世代ごとに 1 ドルあたりの計算量でより多くの知能を引き出せるようにする。ポストトレーニングのパラダイムの推論能力を進化させ、そうした知能の多くを下流モデルへ移し、広告主の成果とユーザー体験をさらに高めていく。
謝辞
以下の方々に感謝する。Laming Chen、Yasmine Badr、Shali Jiang、Hua Zheng、Boyang Liu、Qianru Li、Zhengyu Zhang、Xiaozhen Xia、Angie Huang、Xiaolong Liu、Dan Chanpuriya、Jason Rudy、Cathy Cui、Kenny Lov、Qiuling Suo、Richard Qiu、Wentao Duan、Habiya Beg、Shuo Chang、Wenlin Chen、Xiaorui Gan、John Bocharov、Santanu Kolay、Rocky Liu、Sandeep Pandey、Matt Steiner、Ernest Wang、Musharaf Sultan、Qian Zhao、Anuj Madan、Tak Yan、Viral Vimawala、Saket Gur、Chonglin Sun、GP Musumeci、Jiyan Yang、Jiayi Xu、Chen Liang、Jerry Peng、Zhaojin Wen、Zhichen Zeng、Qinjin Jia、Qinghai Zhou、Rich Zhu、Feipeng Zhao、Hanbin Zhang、Haowen Lin、Lisang Ding、Kai Wang、James Teng、Bingjie He、Donghyun Kim、Yan Deng、Jingyi Shen、Ivonne Xu、Wei Ling、Wen-Chi Yang、Ayush Bihani、Xin Liu、Zikun Liu、Ping Chen、Wankun Zhu、Xian Chen、Jazlyn Li、Hank Lo、Amit Anand Amlesahwaram、Larry Zhang、Hansey Chen、Song Zhou、Zhehui Zhou、Huaqing Xiong、Jie Zheng、Jack Hsueh、Nikhil Garg、Ritwik Tewari、Purbesh Sahoo、Shuby Mao、Fan Yang、Jae-Woo Choi、Qi Fan、Peng Zhong、Peter Lamar、Bopa Bovet、Seunghan Lee、Robert Tang、Lei Zhang、Xi Liu、Hongtao Yu、Lei Tian、Carmen Au、Jake Siso、Rustam Hashimov、Kevin Tang、Bor-Yiing Su、Jade Nie、Tianshu Peng、Subodh Iyengar、Min Si、Ruilin Chen、Max Leung、Rupert Wu、Mandeep Chadha、Angel Yang、Damian Reeves、Hairong Kuang、Ke Sang、Vibha Sinha、Yuzhen Huang、Enes Palaz、Brian Hansen、Liangbei Xu、Oana Platon、Raghav Boinepalli、Rikin Shah、Balaji Balasubramanian、Santosh Mohan、Hao Yan、Eric Falconer、Jacky Zhou、Yusuo Hu、Justin Yang、Pawel Kadluczka、Anamaya Sullerey、Han Xu、Vivienne Sung、Jiasheng Zhang、Serena Liu、Chenxiao Guan、Qiang Jin、Qin Huang、Sagar Chordia、Mingda Li、Li Yu、Ke Pan、May Wang、Sandor Abad、Sandeep Tiwari、Patrick Phelps、Paolo Massimi、Devashish Shankar、ならびに Meta の広告推薦システムにおける最大の基盤モデルの開発とプロダクション化に関わったすべてのチームに。