你本可以从记忆中发明 Transformer
把每一层都看作记忆存储,按相似度用键取回值,一个干扰信号比就能算出它能存多少:外积约 64 条,MLP 几千条,自注意力约一百万条。
中文
复制
今天的大语言模型能记起世界各个角落的冷门知识。最近我赶着去朋友家的桌游局,路上问 Astra 要《沙丘:帝国》的规则,它一路给我念了一遍,帮我记到能重新上手的程度。我们已经习惯向模型问任何问题,把它们庞大的知识储备当成理所当然。
模型怎么能记住这么多信息?又能存下多少?
这篇文章会给出一种直观的视角,把线性映射、MLP 和自注意力看作不同形式的记忆存储。从这个直觉出发,可以推出每一层能存多少记忆的经验法则。
一个“好”的记忆存储,关键在于它能把自己存下的东西回忆起来。毕竟,就算能存下无穷多条事实,需要时取不出来也没什么用。存得越多,回忆某一条时它们彼此之间的干扰就越大。所以全文只盯住一个量:干扰信号比,它衡量回忆时其他记忆造成了多大的妨碍。当干扰大到与信号相当之前,存储能容纳的记忆条数,就是它的容量。
我们会展开这个视角,说明如何从线性层走到更好的东西——MLP,它在容量和回忆上都更好——再一路走到自注意力,它的回忆能力很强,能存的记忆条数可能没有上限。以 64 维的键计算,这是一次从约 64 条,到约 2,700 条,再到超过一百万条的跃升。
先约定全文的术语。记忆存储是一个函数 ,保存 条记忆,其中 。一条记忆就是一个键值对:键 ,用于按相似度查找;值 ,是我们想取回的东西。要使用 ,我们用输入 对它进行查询,它回忆出一个输出 。好的记忆存储在我们用 查询时,会回忆出 ;用与 相似的另一个向量查询时也一样。在文献中,按相似度回忆的记忆存储被称为联想记忆。
外积记忆存储
最基础的记忆存储是线性的:它仅通过外积来累积记忆,
其中 与 的每一行分别是键 和值 。1
要存储一条新记忆 ,只需将 加到已有的权重上。2
要用输入 查询记忆存储,我们先将该输入与矩阵相乘:
所谓回忆,就是按与已存键的相似度做一次查找:将查询与每个键逐一比较,再返回按这些相似度加权求和后的值。
回忆会受到干扰
因此,存储记忆很简单:不断把外积加到权重上即可。但当我们试着回忆其中一条时,会发生什么?
为简单起见,假设每个键都已归一化为长度为 1,即 。那么
也就是说,我们取回的是目标记忆的值——即查询键所对应的那条记忆——再加上其他所有键与查询相似的记忆所带来的干扰。
如果所有键都正交归一,干扰就是零,回忆就是精确的。但 只有 个正交方向,所以一旦存储的记忆数超过键的维度,就无法做到完美回忆:。
外积存储的容量有多大?这里有一个直观的论证。干扰项共有 个。如果键是随机单位向量,每个相似度 大约为 。如果值也是随机的、长度相近,那么 个干扰项就像随机游走一样叠加,于是干扰的平方长度约为信号的 倍,而
把这个比例设为 1,容量就是
只要已存记忆的数量达到键的维度,干扰就会和信号一样大,把信号淹没。
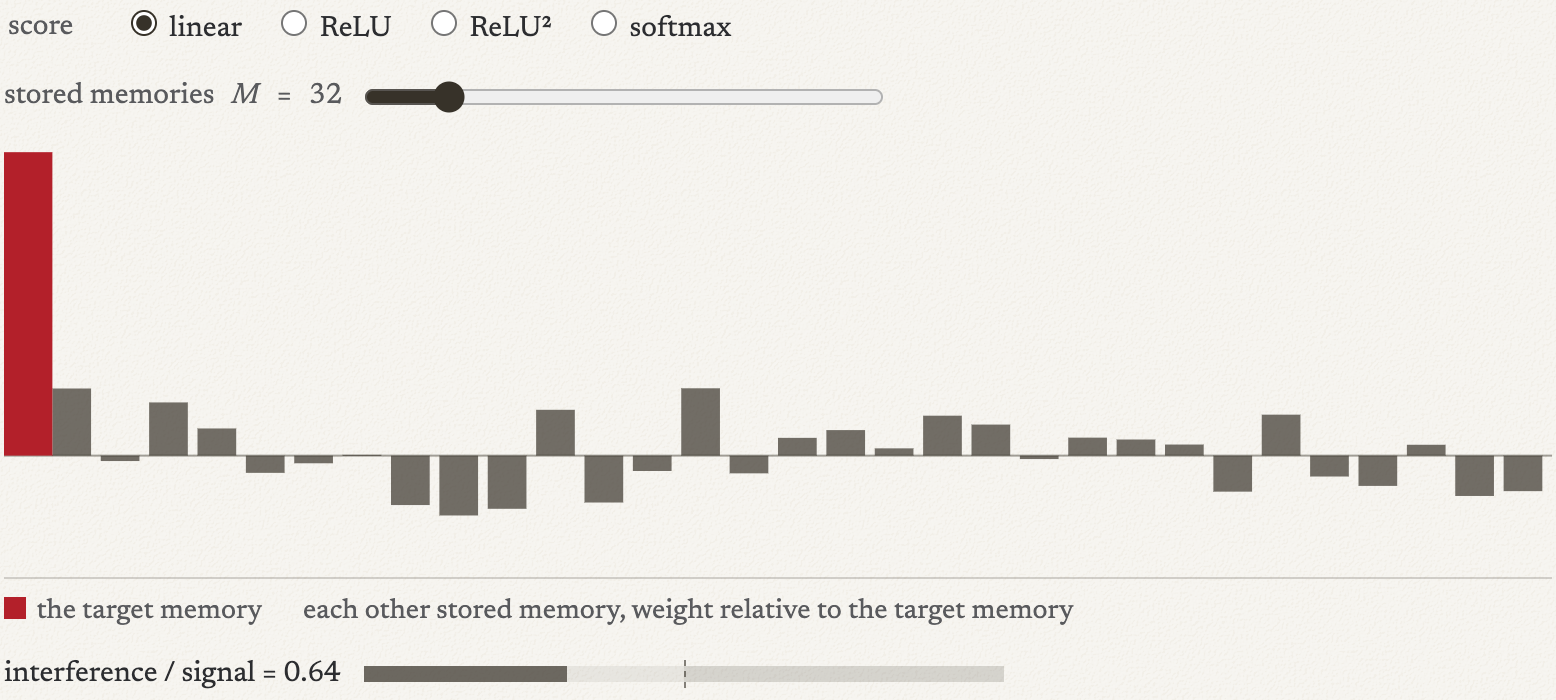
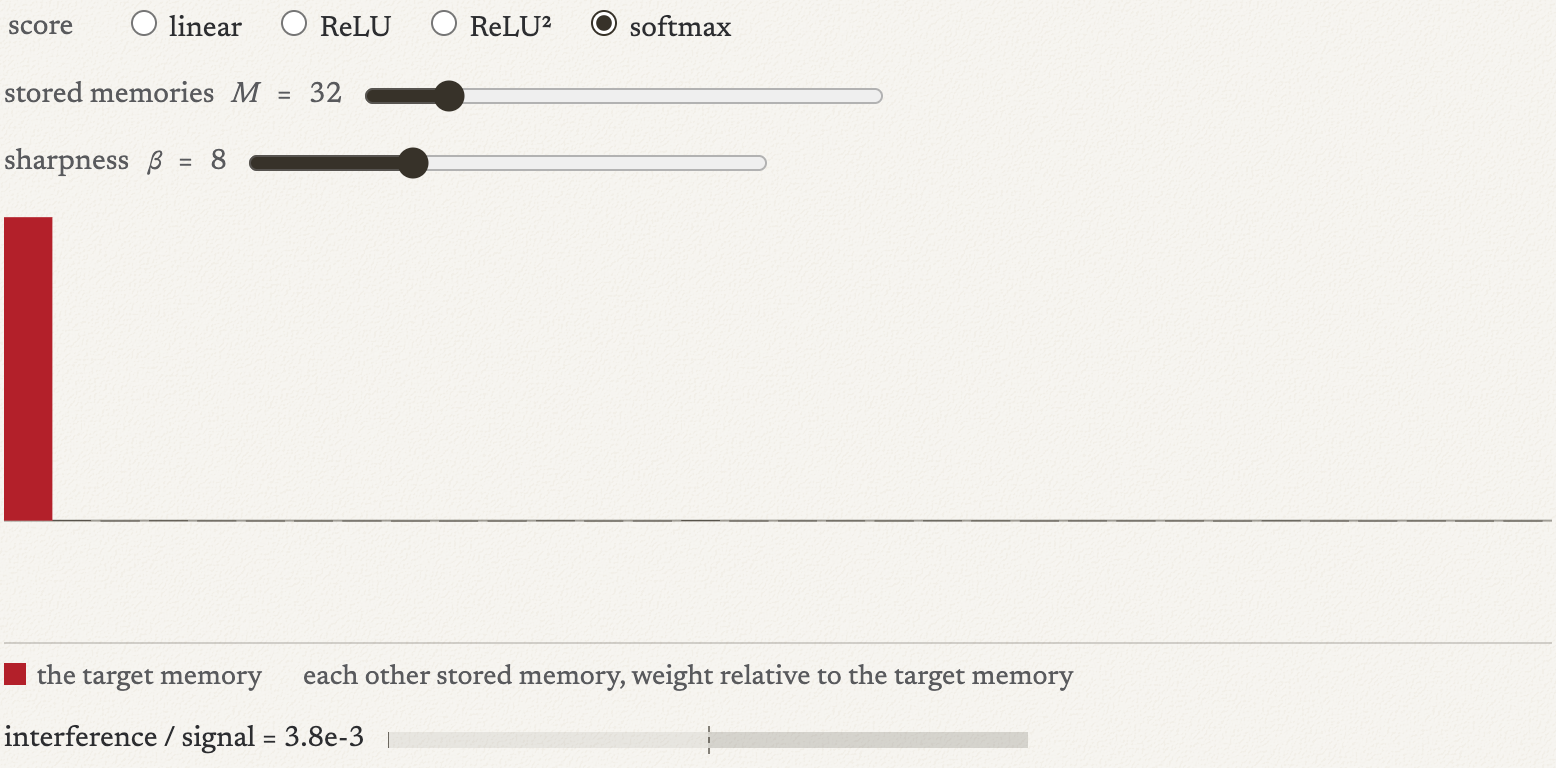
下面每根柱子代表一次回忆中某条已存记忆的权重,以目标记忆的权重(红色)为基准。每根柱子都会把自己的那部分值累加到回忆结果里。把 拖过 ,就能看到那些小柱子不断累加,直到回忆失效。其余按钮会切换到本文后面才会构建的记忆存储。
如何减少干扰?
即便记忆数量低于约 的容量上限,外积存储在回忆时仍会产生明显的干扰。3 要提高容量,或者在容量之内更干净地回忆,就需要减少干扰。
最直接的办法是增大键的维度 ,因为线性存储的容量随 增长。而 能有多大,受硬件条件限制。
另一条路是算法上的改进。可以更小心地写入记忆:外积存储在写入每条记忆时不看其他记忆,因此对它们之间的干扰毫无抵消作用。也可以更有选择性地回忆:线性存储中每条记忆都会带来干扰,哪怕它的键与查询的相似度很低,所以压制相似度较低的键就能改善回忆。
下文会看到,更小心地写入外积记忆,得到的就是最优线性记忆存储,容量约为原来的两倍。借助非线性做有选择的回忆,得到的就是 MLP 和自注意力。
最优线性记忆存储
外积存储在写入每条记忆时都不考虑其他记忆。换一种做法,我们可以直接选择权重 ,让回忆一次性拟合所有已存储的记忆。这是一个线性回归问题:4
当存储的记忆数量超过键维度 时,最小二乘解为
这就是外积存储 ,只改了一处:在把查询与键比较之前,先给它乘上 ,以此抵消键的协方差 。这一步对键做了白化,存储便不再过度偏重许多键共有的方向。
当 时,只要键线性无关,回归就能精确拟合每一条记忆。因此即便键并不正交,最优存储的回忆也完全没有干扰。
当 时,干扰开始出现,因为记忆存储只有 个方向可用。对于随机的键和值,我们的干扰信号比变为
该比值在以下情况下等于 1:
所以,最优存储的容量是原来的两倍!
我们可以用数值方法验证前面的预测。在 维空间中随机生成 条键长为 1 的记忆,再用其中一条已存储的键查询记忆库,测量干扰与信号的比值:
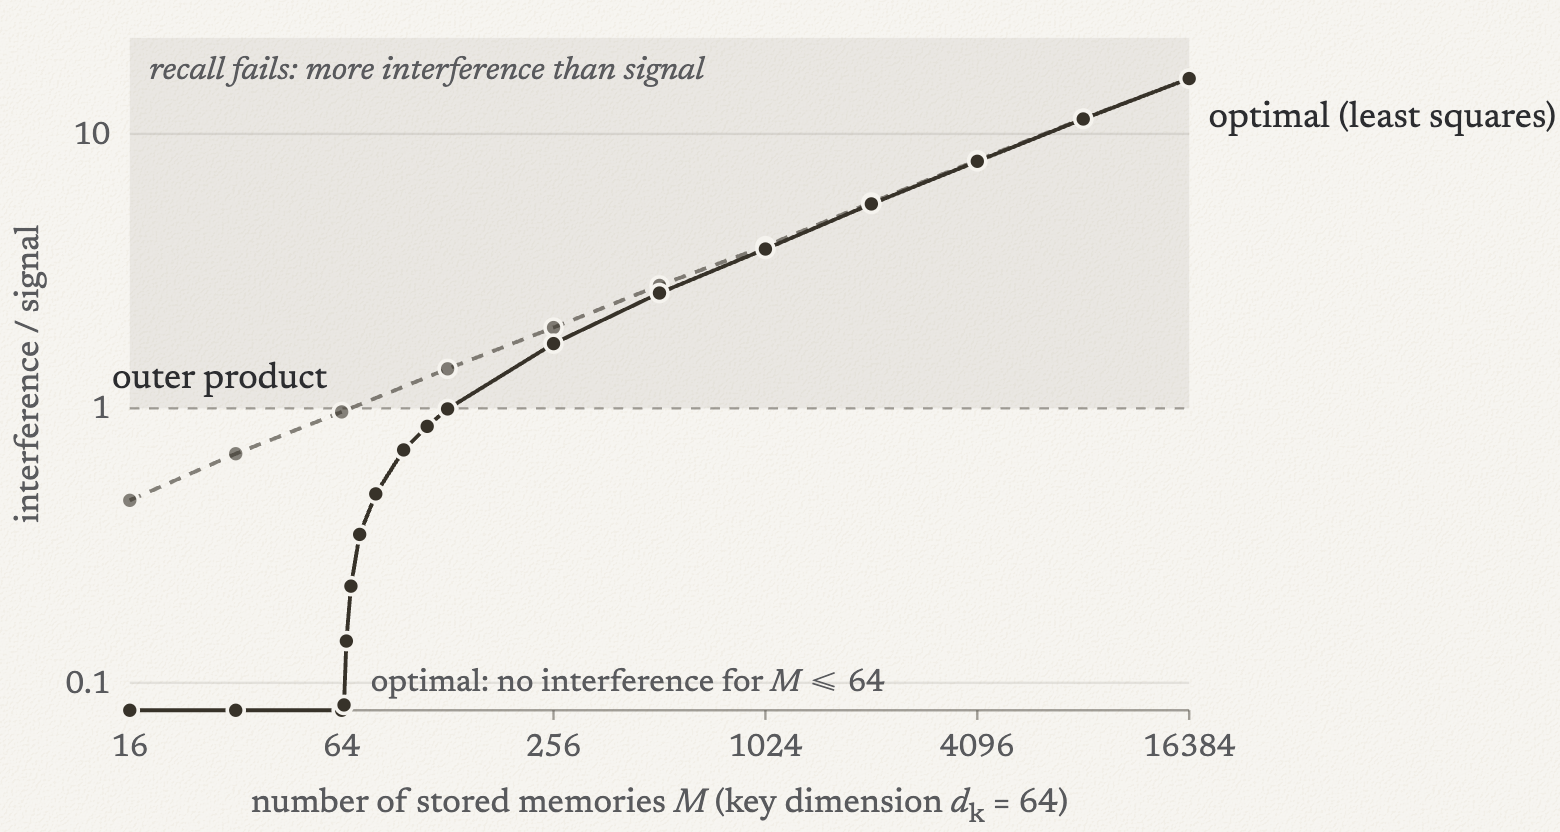
外积记忆存储的容量在 处达到上限。最优记忆存储能精确回忆到 为止。超过这个点后,它的干扰从零开始按 上升,记忆存储在接近 处达到容量,与预测一致。由于它抵消的是固定数量记忆所带来的干扰,两个记忆存储之间的差距会随着 增大而缩小。
不过,这个最优记忆存储对相似度仍然是线性的。它必须用同一个系数去缩放小相似度和大相似度。要想做得更好,就得改变记忆存储的回忆方式。
MLP 作为非线性记忆存储
线性记忆存储的回忆
如果有一种方法能在 很小时抑制对应的权重,就能减少低相似度的键带来的干扰。
在计算值的加权和之前,先用一个非线性函数 对每个相似度进行处理:
我们刚刚从第一性原理出发,重新发现了一个两层 MLP!第一个权重矩阵的行是键,第二个权重矩阵的列是值。Sukhbaatar 等人指出了前馈层与记忆存储之间的这种相似性,Geva 等人则发现,训练好的 transformer 中的前馈层往往就是这样工作的:键在输入中可识别的模式上被激活。
理想情况下,门控函数 的选取应使得当相似度较低时(,甚至当 时),求和式中对应的项被抑制,以减少干扰。ReLU 激活会把相似度为负的键置零,而加入偏置则可以移动这个阈值5。平方 ReLU 激活会进一步抑制相似度接近零的键。相似度 0.1 变成 0.01,而相似度 1 仍然是 1。事实上,平方 ReLU 是 MLP 激活函数中较少为人知、但已在大规模上得到验证的改进之一(So 等人)。
平方 ReLU MLP 是一种门控与输入投影共享权重的 GLU MLP,因为 。如今语言模型中的 SwiGLU MLP 让门控拥有自己的权重,并用 Swish 激活替代 ReLU。
在实践中,MLP 以叠加方式存储事实:许多事实共享同一组权重,输出是许多记忆的混合。Garcia 等人显式地构建了这样一个模型:GLU MLP 的隐藏单元计算输入的随机特征 ,第二个权重矩阵是在这些特征上的外积存储 ,而 MLP 存储的事实远多于它拥有的隐藏单元。尽管如此,训练好的 transformer 的 ReLU MLP 对于给定输入可能只激活 1% 的隐藏单元,因此每次回忆只动用一小部分记忆(Li 等人)。
用更高次幂减少干扰
对相似度取平方之所以有效,是因为它把低相似度的权重压缩得远比高相似度更狠。用 还能再推进一步。信号本身不变,因为 ,而相似度为 的干扰项会缩小到 。 个干扰项像随机游走一样累加,因此干扰与信号之比为
这意味着容量大约为
条记忆,呈几何级数增长!
为了验证这一点,我们针对 的五个取值,运行了与之前相同的实验:
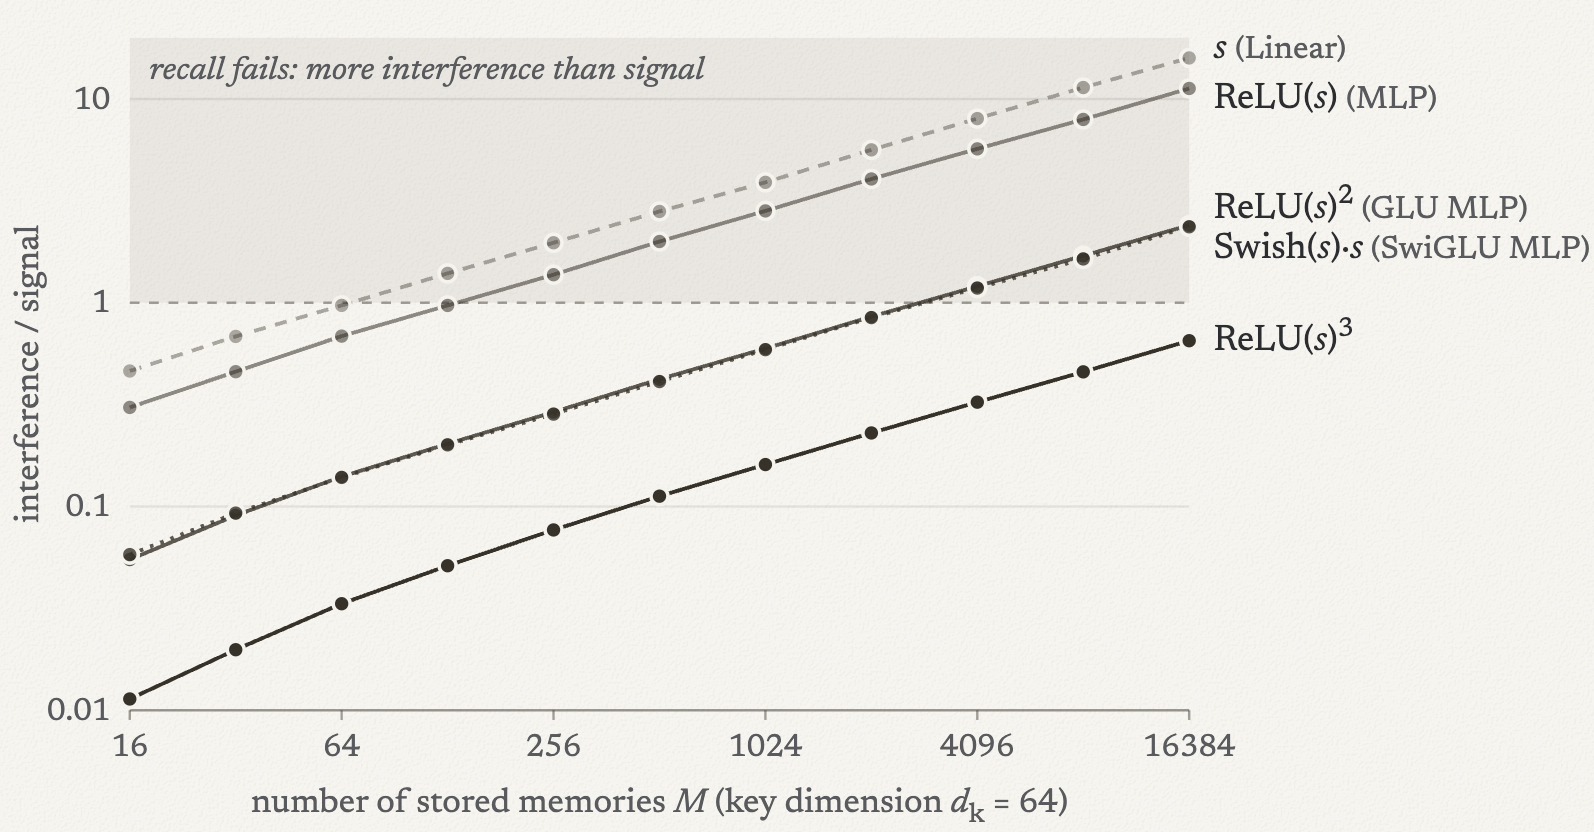
干扰按 增长,因此在双对数坐标图上,这些直线几乎平行。变化的只是它们的高度,容量也随之改变,即每条直线与 1 相交的位置:
- 线性:容量为 。
- ReLU:把负的相似度置零后,干扰缩小了 ,容量因此增长到 。
- 平方 ReLU:每一项干扰从约 缩小到约 ,容量因此增长到 ,约为线性存储的 40 倍。
- SwiGLU MLP:门控与输入投影共享权重,做法与平方 ReLU 相同,:其容量与 Squared ReLU 几乎持平。
- 立方 ReLU:每一项干扰缩小到约 ,容量因此增长到 。
把自注意力看作非参数化记忆存储
把权重提升到某个幂次,容量会增长到约 。但能不能把它推到极限?与其选定某一个幂次,不如用上无穷多个幂次。指数函数本就是所有幂次的加权和,
其中锐度 决定了高次项的权重。下面用 (自注意力所用的取值6)做同样的实验,将指数项及其级数分别截断到 2 项、3 项和 4 项:
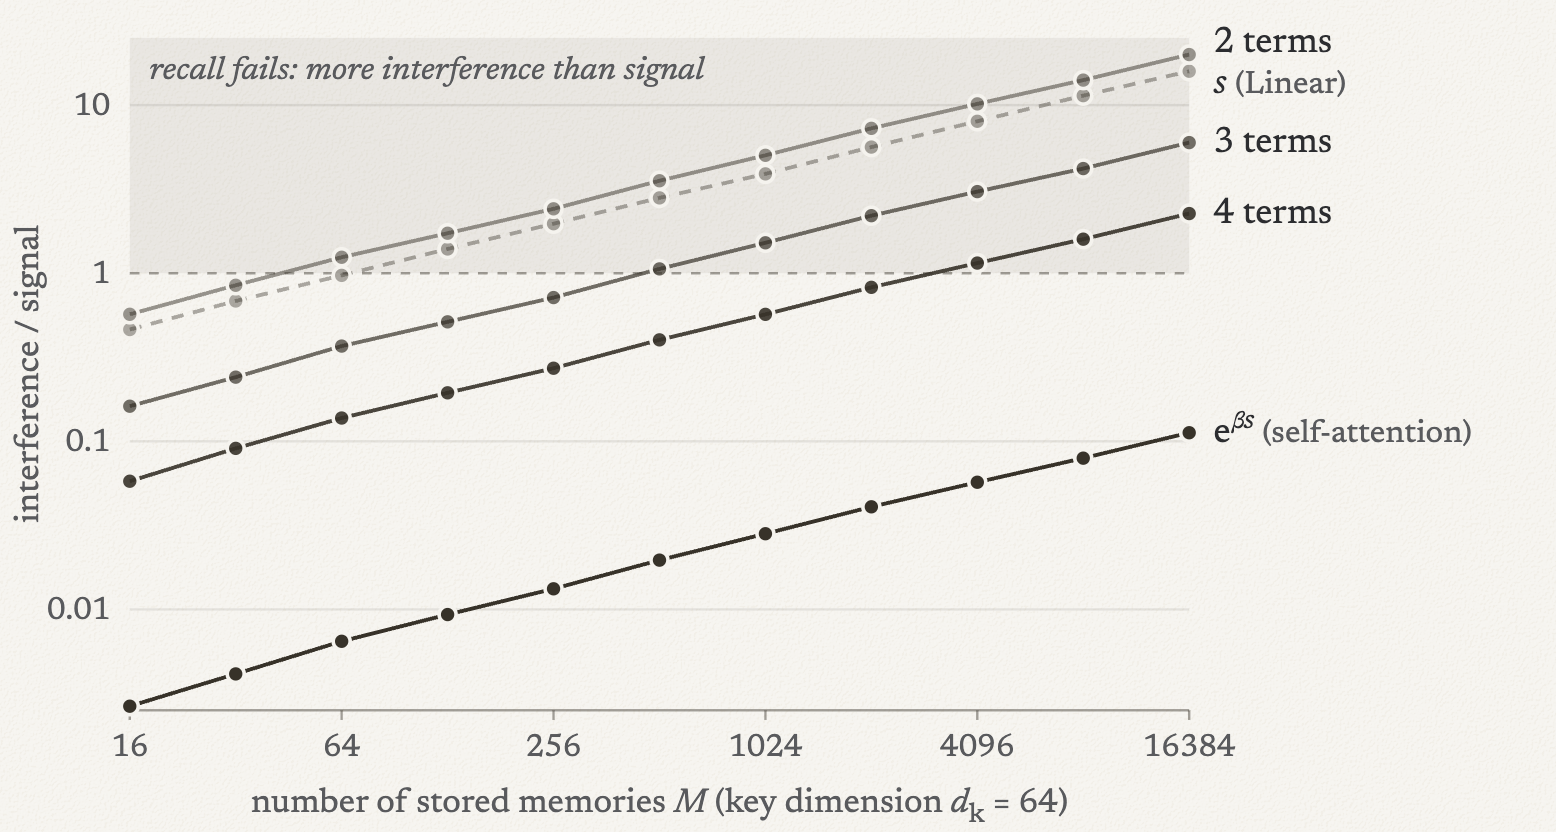
2 项时容量约为 40,低于线性存储,因为常数项使每个键的权重都约为 1。3 项时约为 450,4 项时约为 3,100,接近平方 ReLU 的水平。完整的指数形式远低于虚线,因此其容量已超出图表范围。
要计算指数形式的容量,我们用一个已存储的键 进行查询,此时目标记忆的相似度为 1,权重为 。其他每个记忆的权重均为 ,其中对于随机单位键,相似度 大致服从均值为 0、方差为 的高斯分布。当随机值的长度相近时,
将比例设为 1 时,容量为
只要 远低于 ,容量就会随 呈指数增长,而不再像之前那样随 呈多项式增长!在 下,容量约为 万条记忆,接近线性存储的 20,000 倍。同一实验运行更长时间,容量也约为 120 万条。
在实践中,我们可能不想在实现中直接对数字做指数运算,因为小数会下溢,大数会溢出。好在如上面的推导所示,干扰只取决于权重之间的比值,所以我们可以把每个权重都除以它们的和,这样既不会改变干扰与信号的比值,又能保证数值稳定性:
这就是自注意力。7
MLP 的键和值都是训练出来的权重,自注意力则不同:它的键和值由上下文中的 token 计算得出。每个 token 存一条记忆,所以记忆数量 就是上下文长度。这正是自注意力非参数化的原因:它的记忆不是参数,而是随上下文增长。
再看一次那张柱状图,从 softmax 开始。在 下,滑块范围内回忆从不失败,于是把 降到 2、把 调高:几十条记忆之后,回忆就开始失败。 每翻一倍,就需要略高一点的 才能维持回忆,这就是下一节要讲的内容。
长上下文中大量键值对的处理
决定我们压制不太相似的键的力度,因此键值对数量增加时,可以相应调大 。那为什么不直接把 设得很大?因为 ,softmax 会退化成硬 argmax,只挑出最相似的那个键,不可微;而且 过大本身就会让训练效果变差,softmax 饱和之后,对其他所有键的梯度都会消失。所以 只在 需要的范围内调大。用 缩放注意力 logits 正是应对长上下文的一种做法。这类方法有几个版本,各自把 设为相对于一个固定参考长度 (通常是训练长度)的值,使得 时 保持训练时的取值:
- Su (2021) 从「随 增长保持注意力熵不变」出发推导出缩放系数 ,并做归一化,使其在 时与标准注意力一致。任意长度下 logits 都乘以 。Scalable-Softmax 形式相同,把 logits 乘以 ,其中 可学习。
- 最初的 Qwen 模型使用 LogN-Scaling,只在上下文超过 之后才施加同样的因子。
- Qwen2.5-1M 使用 YaRN 的注意力缩放,把 logits 乘以 ,因此按 增长。
在我们的实验中, 条记忆、 时,各规则的表现如下:
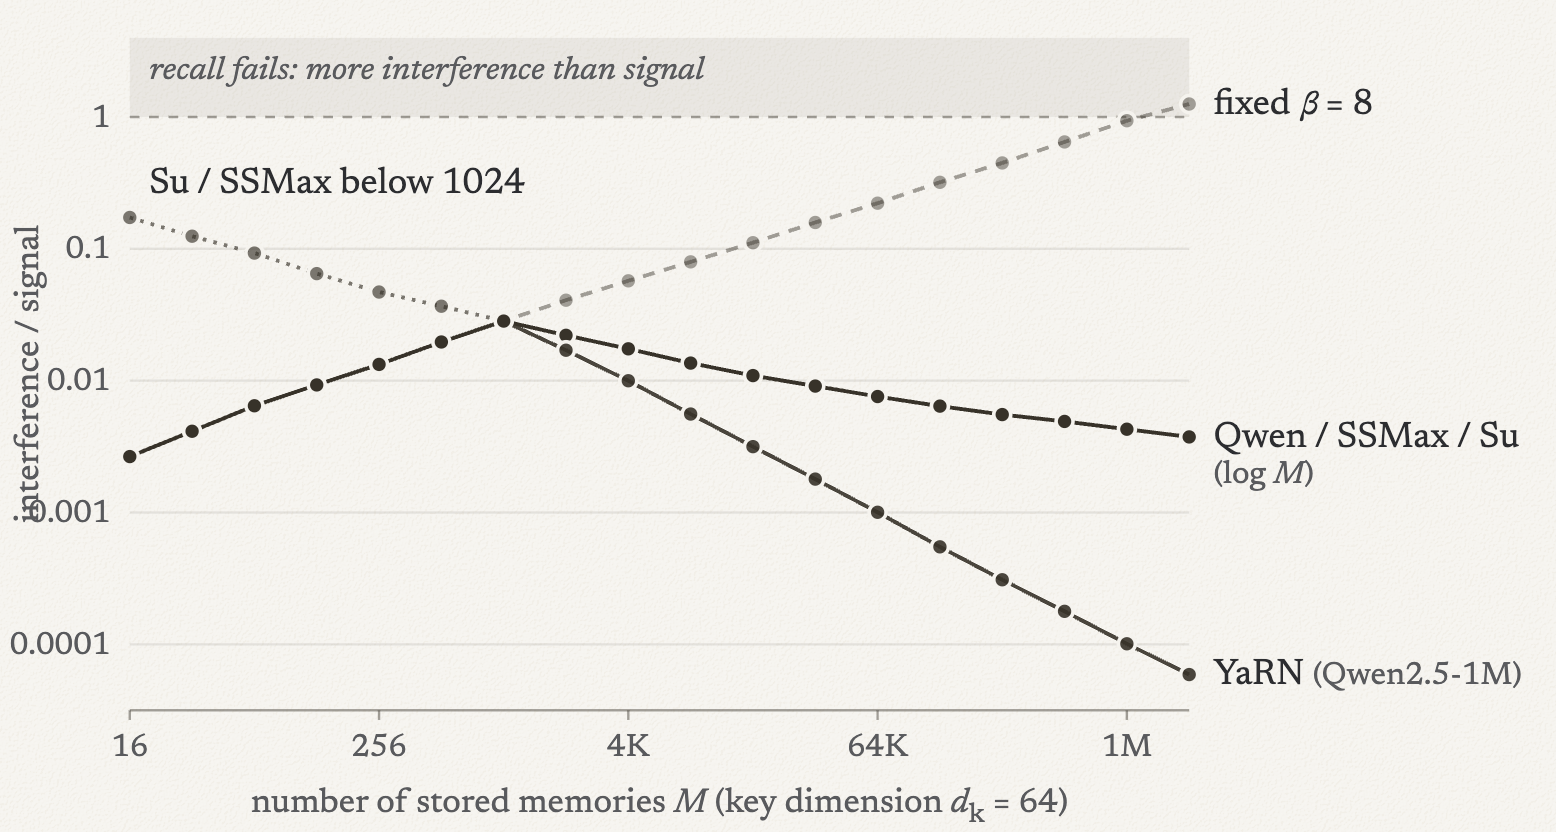
Qwen 的规则与 Su 的规则在超过参考长度 之后趋于一致,此时干扰与信号之比随存储规模增大而下降,到 200 万条记忆时约为 0.004。YaRN 的缩放增长更快,把这一比值压到约 。两种情况下,用 缩放 都能存下数量基本不受限、键各不相同的记忆。
结语
下面是我们考察过的各种记忆存储,容量一栏对应的是用已存储的键查询、且键和值都随机的情形:
| 记忆存储 | 容量 | 时的容量 | |
|---|---|---|---|
| 外积 | 64 | ||
| 最优线性 | 128 | ||
| ReLU MLP | 128 | ||
| 平方 ReLU(GLU MLP) | 约 2,700 | ||
| SwiGLU MLP | 约 | 约 2,900 | |
| 立方 ReLU | 约 35,000 | ||
| 自注意力, | 约 120 万 | ||
| 自注意力, | 实验中未达到上限 | 超过 200 万 |
我们从一种启发式的记忆存储——外积记忆——出发,一步步搭到如今现代 transformer 里能见到的所有标准层。这个视角也让我们得以估计它们在容量上的差异,也就是作为向量值键值存储的能力。
需要说明的是,这个容量估计只是审视现代神经网络架构的一种方式。它只统计单层在干扰压过信号之前能回忆多少个随机向量。实际上我们完全没有考虑训练数据,而训练数据恰恰决定了键和值里真正表示的是什么。另有一些工作把训练后的层纳入考量,用比特来衡量存储的信息量。Morris 等人估计 GPT 类模型每个参数大约记住 3.6 比特,并发现模型一旦填满容量就开始泛化,对每个训练样本的记忆随之减少。Allen-Zhu & Li发现语言模型每个参数大约存储 2 比特的事实性知识,即便量化到 int8 也是如此。
相关方向还有很多,也都很有意思:
- 一层能存多少信息:Nichani, Lee & Bietti、Barnfield et al. 讨论线性存储,Dugan et al.、Garcia et al. 讨论存储显式事实的 MLP,Zhong et al. 则启发了本文对干扰信号比的估计。
- Hopfield 网络与容量随规模指数增长的记忆存储:Krotov & Hopfield 的稠密联想记忆、Demircigil et al.、将稠密联想记忆与注意力联系起来的 Ramsauer et al.,以及 Krotov et al. 的综述。
- 在推理过程中更新的短期记忆:fast weights、Mamba、Mamba-2、DeltaNet、Gated DeltaNet、TTT layers、Titans、MesaNet,以及 test-time regression。
- 体量巨大但稀疏的参数化记忆存储,用来补充或取代我们的 MLP:product-key memories、Memory Layers at Scale、UltraMem、Mixture of A Million Experts、Engram。
- 非参数化记忆存储,通过在权重之外追加记忆来增长:kNN-LM、RETRO、Memorizing Transformers、growing nonparametric networks。
- 在训练好的模型里定位并编辑记忆:Geva et al.、Bietti et al.,以及 ROME 和 MEMIT。
- 压缩短期记忆,或将其转化为长期记忆:KVzip、gist tokens、Cartridges、attention matching
- 持续学习方法,比如 sparse memory finetuning
我一直被记忆吸引,也许是因为我能真切地感到自己的记忆有多有限。也许我心底有一部分希望:弄懂机器如何记忆,也能让我对自己多懂一点。
Footnotes
-
这种键和值的累积有时被称为“Hebbian learning”,因为突触(权重)的强度会因同时激活(相关)的输入(键)和输出(值)而增强。 ↩
-
这种用于线性注意力状态的外积记忆存储,也叫 fast weights:每个 token 通过把 加到矩阵上来存储记忆 ,后续 token 再查询这个矩阵(Katharopoulos et al.;Schlag, Irie & Schmidhuber)。 ↩
-
这是为了回忆一个干净的值向量。如果每个值只需要在一个固定集合中指向正确答案,比如选出最可能的 token,那么回忆只要离正确答案比离错误答案更近就行,一个 矩阵大约能容纳 条事实(Nichani, Lee & Bietti)。 ↩
-
我们也可以用这个回归目标来设计序列模型在前向传播过程中写入的短期记忆,比如线性注意力和自注意力。参见我在 test-time regression 上的工作。 ↩
-
对于随机的键,ReLU 能把干扰缩小为原来的 。随机键的相似度为正和为负的概率相同,所以 ReLU 会把大约一半的权重置零,另一半保持不变。这让干扰的方差(权重平方和)减半,干扰本身就缩小为原来的 。完整推导见 Zhong et al.。 ↩
-
Transformer 是把相似度除以 ,而不是相乘。但它们的查询和键长度约为 ,所以一对匹配的查询和键的相似度是 。我们的键和查询是单位长度,匹配的一对相似度为 1。因此我们按 缩放。 ↩
-
用 transformer 的记号,相似度是 ,其中 ,再按 缩放。我把 并入了键。transformer 中键和查询的长度约为 ,所以对于像我们这样的单位长度的键,这个缩放正好对应 。 ↩