記憶から Transformer を発明できたはず
各層を記憶ストアと見なすと、1 つの干渉信号比からどれだけ記憶できるかが分かる。外積は約 64 件、MLP は数千件、自己注意は約 100 万件。
日本語
コピー
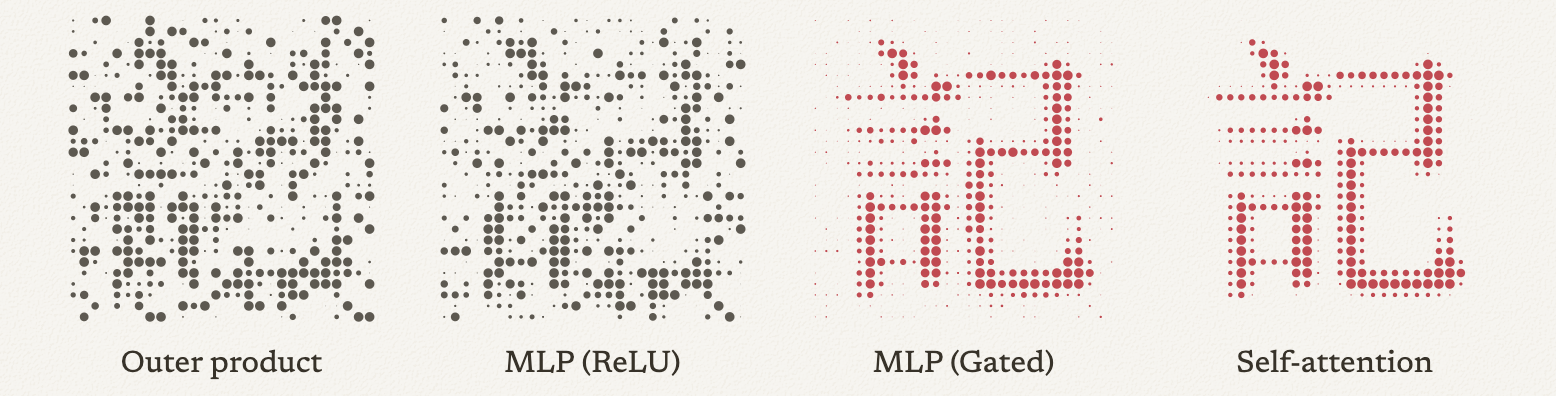
今日の大規模言語モデルは、世界のあらゆる隅々にある、あまり知られていない知識まで思い出す。先日、友人の家でのボードゲーム会に急いで向かう途中、Astra に『Dune: Imperium』のルールを尋ねたところ、道中ずっと読み上げてくれて、もう一度遊べる程度には覚えられた。私たちはモデルに何でも質問するのに慣れてしまい、その膨大な知識を当然のものとして扱っている。
モデルはどうやってこれほど多くの情報を覚えているのか。そしてどれだけ保存できるのか。
この記事では、線形写像、MLP、自己注意をそれぞれ異なる形の記憶ストアとして捉える、直感的な視点を提示する。この直感から、各層がどれだけの記憶を保存できるかという経験則を導ける。
「良い」記憶ストアの鍵は、保存したものを思い出せることにある。何しろ、無限の事実を保存できたとしても、必要なときに取り出せなければ役に立たない。多く保存するほど、ある一つを思い出すときにそれらが互いに干渉する度合いが大きくなる。そこで全文を通して一つの量だけに注目する。干渉信号比だ。これは思い出すときに他の記憶がどれだけ邪魔をするかを測る。干渉が信号と同程度に大きくなる前に、記憶ストアが保持できる記憶の件数が、その容量である。
この視点を展開し、線形層からより良いものへ——容量と想起の両方で優れる MLP へ——そして自己注意へと進む。自己注意の想起能力は非常に高く、保存できる記憶の件数には上限がないかもしれない。64 次元のキーで計算すると、約 64 件から約 2,700 件、そして百万件以上への跳躍になる。
まず全文の用語を定める。記憶ストアとは関数 であり、 件の記憶を保存する。ここで である。一つの記憶とはキーと値のペアである。キー は類似度による検索に使い、値 は取り出したいものだ。 を使うには、入力 でそれをクエリし、 という出力を想起する。良い記憶ストアは、 でクエリすると を想起する。 に似た別のベクトルでクエリした場合も同じだ。文献では、類似度によって想起する記憶ストアを連想記憶と呼ぶ。
外積による記憶ストア
最も基本的な記憶ストアは線形である。外積だけを使って記憶を蓄積し、
ここで と の各行が、それぞれキー と値 になる。1
新しい記憶 を保存するには、既存の重みに を足すだけでよい。2
入力 を使って記憶ストアに問い合わせるには、まずその入力を行列に掛け合わせる:
記憶の想起とは、既存のキーとの類似度による検索にほかならない。クエリを各キーと突き合わせ、類似度で重み付けした値の和を返す。
想起は干渉を受ける
つまり記憶の保存は単純で、外積を重みに足し続けるだけでよい。だが、そのうちの一つを想起しようとすると何が起きるか。
話を簡単にするため、各キーは長さ 1 に正規化済み、すなわち としよう。すると
取り出せるのは目標記憶の値、すなわちクエリのキーに対応する記憶の値に、クエリと似たほかのキーが持ち込む干渉を加えたものである。
すべてのキーが正規直交であれば干渉はゼロになり、想起は正確になる。しかし には直交する方向が 個しかないため、記憶の数がキーの次元を超えた時点で完全な想起は不可能になる:。
外積による記憶の容量はどれくらいか。直感的な議論がある。干渉項は全部で 個。キーがランダムな単位ベクトルなら、各類似度 はおよそ になる。値もランダムで長さが同程度なら、 個の干渉項はランダムウォークのように重なり合う。すると干渉の二乗長は信号のおよそ 倍になり、
この比率を 1 にすると、容量は
保存済みの記憶の数がキーの次元に達すると、干渉は信号と同じ大きさになり、信号を埋もれさせる。
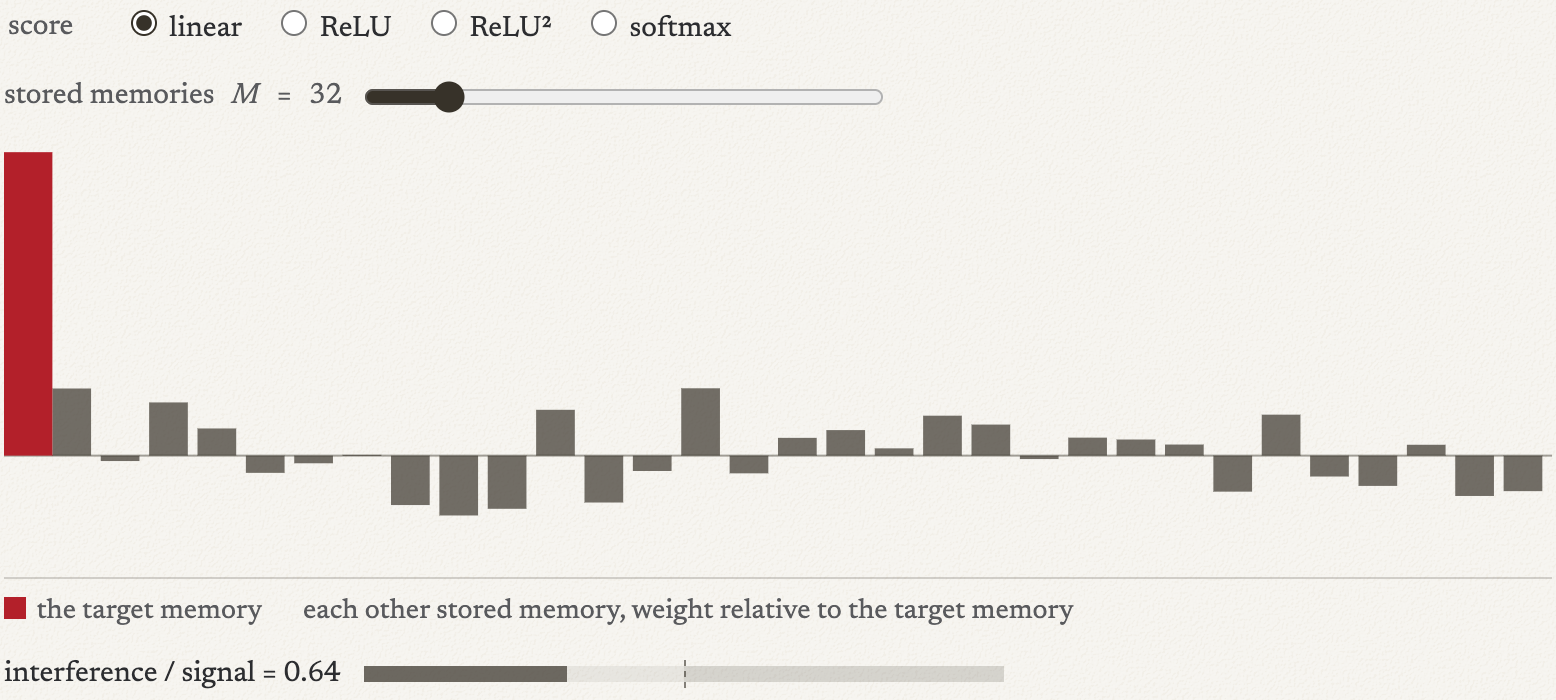
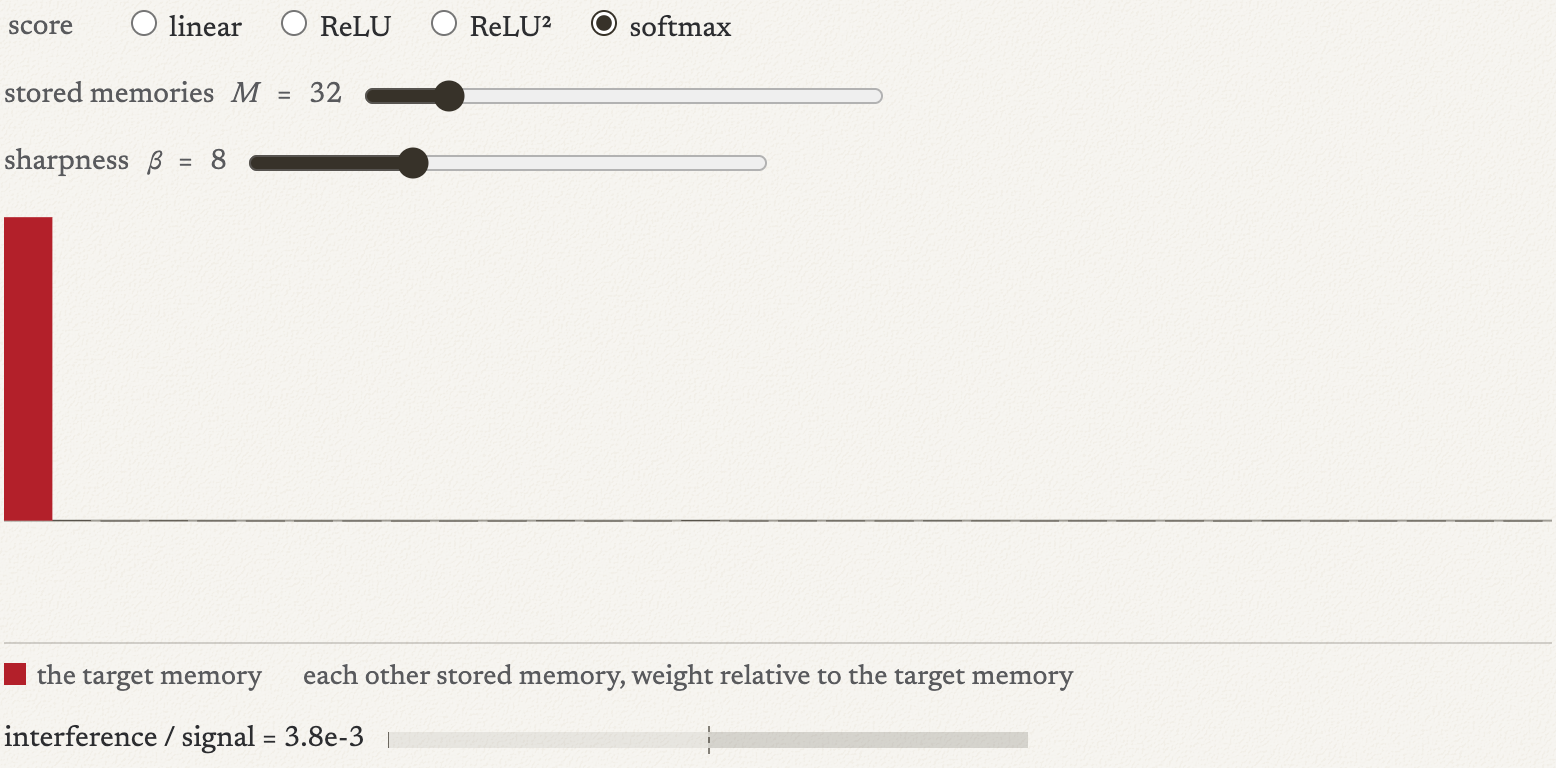
以下の各棒は、1 回の想起において個々の保存済み記憶が持つ重みを表し、目標記憶の重み(赤)を基準にしている。各棒は自分の値の分を想起結果に積み上げていく。 を の上までドラッグすると、小さな棒が積み上がり続け、やがて想起が破綻するのがわかる。残りのボタンは、この記事の後半で構築する記憶ストアに切り替える。
干渉を減らすには?
記憶の数が外積記憶の容量上限である約 を下回っていても、想起時には無視できない干渉が生じる。3 容量を増やすにも、容量の範囲内でよりきれいに想起するにも、干渉を減らす必要がある。
最も直接的な方法はキーの次元 を大きくすることだ。線形記憶の容量は に比例して増える。ただし をどこまで大きくできるかはハードウェアの制約で決まる。
もう一つはアルゴリズム側の改善だ。記憶の書き込みをより慎重にできる。外積記憶は各記憶を書き込むときに他の記憶を参照しないため、記憶同士の干渉を打ち消す働きが一切ない。想起をより選択的にすることもできる。線形記憶ではどの記憶も干渉を生む。クエリとの類似度が低いキーであっても例外ではない。だから類似度の低いキーを抑え込めば想起は改善する。
後述するように、外積記憶の書き込みをより慎重に行うと、最適な線形記憶ストアが得られる。容量はおよそ 2 倍になる。非線形性を利用して選択的に想起すると、得られるのは MLP と自己注意である。
最適な線形記憶ストア
外積記憶は各記憶を書き込むとき、他の記憶を一切考慮しない。別のやり方として、重み を直接選び、想起が保存済みのすべての記憶を一度にフィットするようにできる。これは線形回帰の問題である。4
記憶の数がキー次元 を超えると、最小二乗解は
これが外積記憶 だ。変更は 1 か所だけで、クエリとキーを比較する前に を掛けてキーの共分散 を打ち消す。この操作でキーは白色化され、記憶は多くのキーが共有する方向に過度に引きずられなくなる。
のとき、キーが線形独立であれば、回帰は各記憶を正確にフィットできる。したがってキーが直交していなくても、最適な記憶の想起に干渉はまったく生じない。
になると、記憶が使える方向は 個しかないため、干渉が現れ始める。キーと値がランダムな場合、干渉信号比は次のようになる。
この比率が 1 になるのは次の場合だ:
つまり、最適な記憶ストアの容量は元の2 倍になる。
先ほどの予測は数値的に検証できる。 次元空間に鍵長 1 の記憶を 個ランダムに生成し、そのうち保存済みの鍵 1 つで記憶庫を照会して、干渉と信号の比を測る:
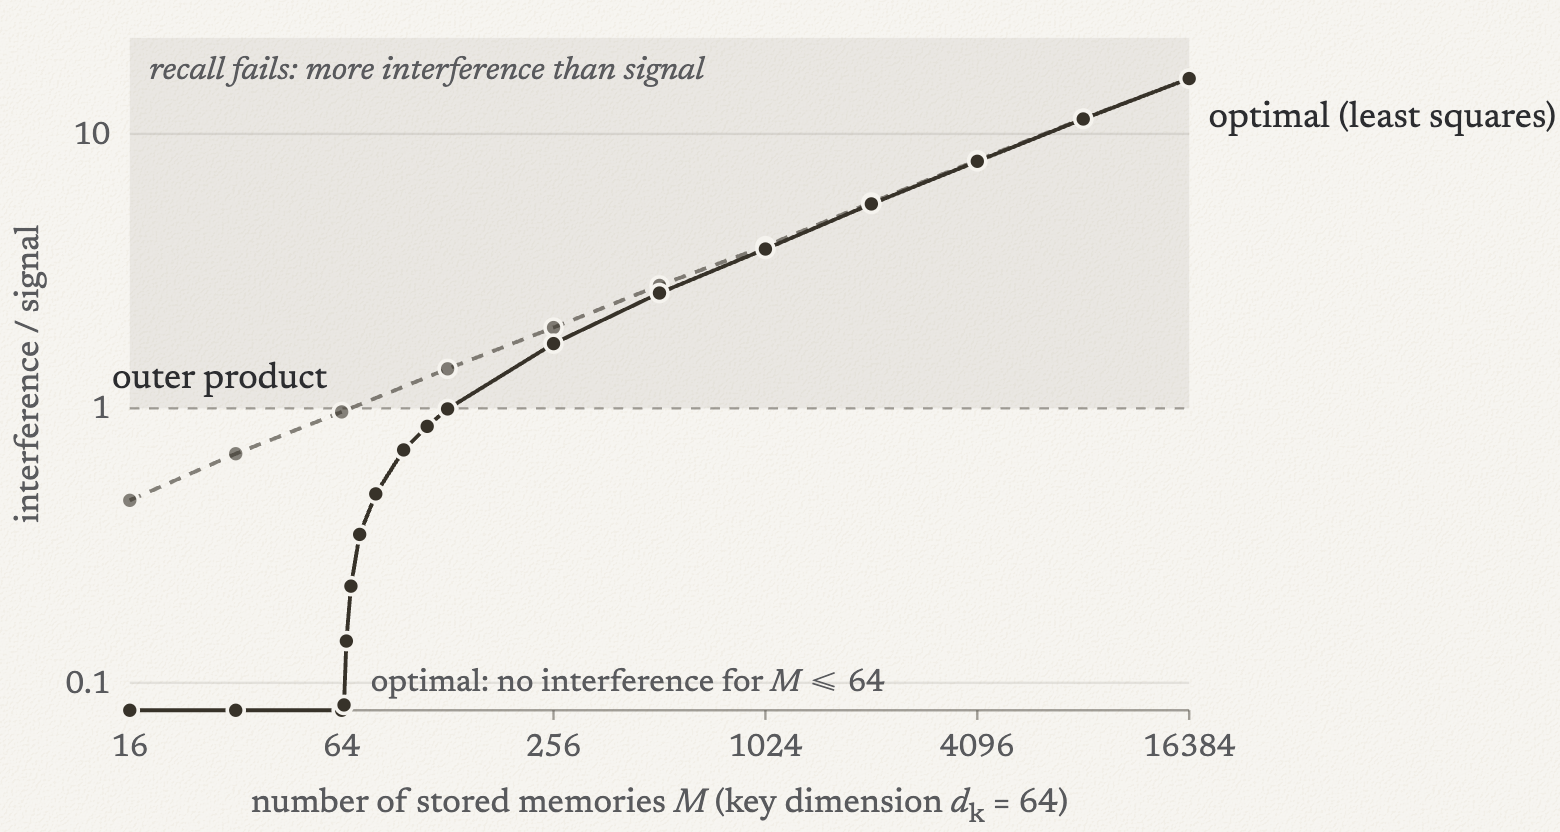
外積記憶ストアの容量は で上限に達する。最適な記憶ストアは まで正確に想起できる。この点を超えると、干渉はゼロから に沿って増加し始め、記憶ストアは予測どおり 付近で容量に達する。一定数の記憶がもたらす干渉を打ち消しているため、2 つの記憶ストアの差は が大きくなるほど縮まる。
ただし、この最適な記憶ストアも類似度に対しては依然として線形だ。小さい類似度も大きい類似度も同じ係数でスケーリングしなければならない。これ以上の性能を出すには、記憶ストアの想起の仕方自体を変える必要がある。
非線形記憶ストアとしての MLP
線形記憶ストアの想起
もし が小さいときに、対応する重みを抑え込む方法があれば、類似度の低いキーによる干渉を減らせる。
値の重み付き和を計算する前に、まず非線形関数 で各類似度を処理する:
我々は今、第一原理から二層 MLP を再発見したところだ。最初の重み行列の行がキー、二番目の重み行列の列が値にあたる。Sukhbaatar らはこのフィードフォワード層と記憶ストアの類似性を指摘し、Geva らは訓練済み transformer のフィードフォワード層が実際にこう動いていることを見出した。キーは入力中の識別可能なパターンで発火する。
理想的には、ゲート関数 は類似度が低いとき(、 のときでさえ)総和の対応する項が抑えられ、干渉を減らすように選ぶべきだ。ReLU 活性化は類似度が負のキーをゼロにし、バイアスを加えればこのしきい値を動かせる5。二乗 ReLU 活性化は類似度がゼロに近いキーをさらに抑え込む。類似度 0.1 は 0.01 になり、類似度 1 は 1 のまま残る。実際、二乗 ReLU は MLP の活性化関数としてはあまり知られていないが、大規模で検証済みの改良のひとつだ(So ら)。
二乗 ReLU MLP は、ゲートと入力射影が重みを共有する GLU MLP である。 だからだ。今日の言語モデルにおける SwiGLU MLP では、ゲートが独自の重みを持ち、ReLU の代わりに Swish 活性化を使う。
実際には、MLP は事実を重ね合わせて保存する。多くの事実が同じ重みの組を共有し、出力は多くの記憶の混合になる。Garcia らはそうしたモデルを明示的に構築した。GLU MLP の隠れユニットが入力のランダム特徴 を計算し、二番目の重み行列がそれらの特徴上の外積ストレージ になり、MLP は隠れユニットの数よりはるかに多くの事実を保存する。それでも、訓練済み transformer の ReLU MLP はある入力に対して隠れユニットの 1% しか活性化しないことがあり、想起のたびに記憶のごく一部しか使っていない(Li ら)。
より高次の冪で干渉を減らす
類似度を二乗するのが効くのは、低い類似度の重みを高い類似度よりもはるかに強く圧縮するからだ。 を使えばさらに一歩進められる。信号自体は変わらない。 だからだ。一方、類似度 の干渉項は まで小さくなる。 個の干渉項はランダムウォークのように積み上がるので、干渉と信号の比は
つまり、容量はおよそ次のようになる。
記憶の件数が幾何級数的に増える!
これを確かめるため、 の 5 つの値について、先ほどと同じ実験を実行した:
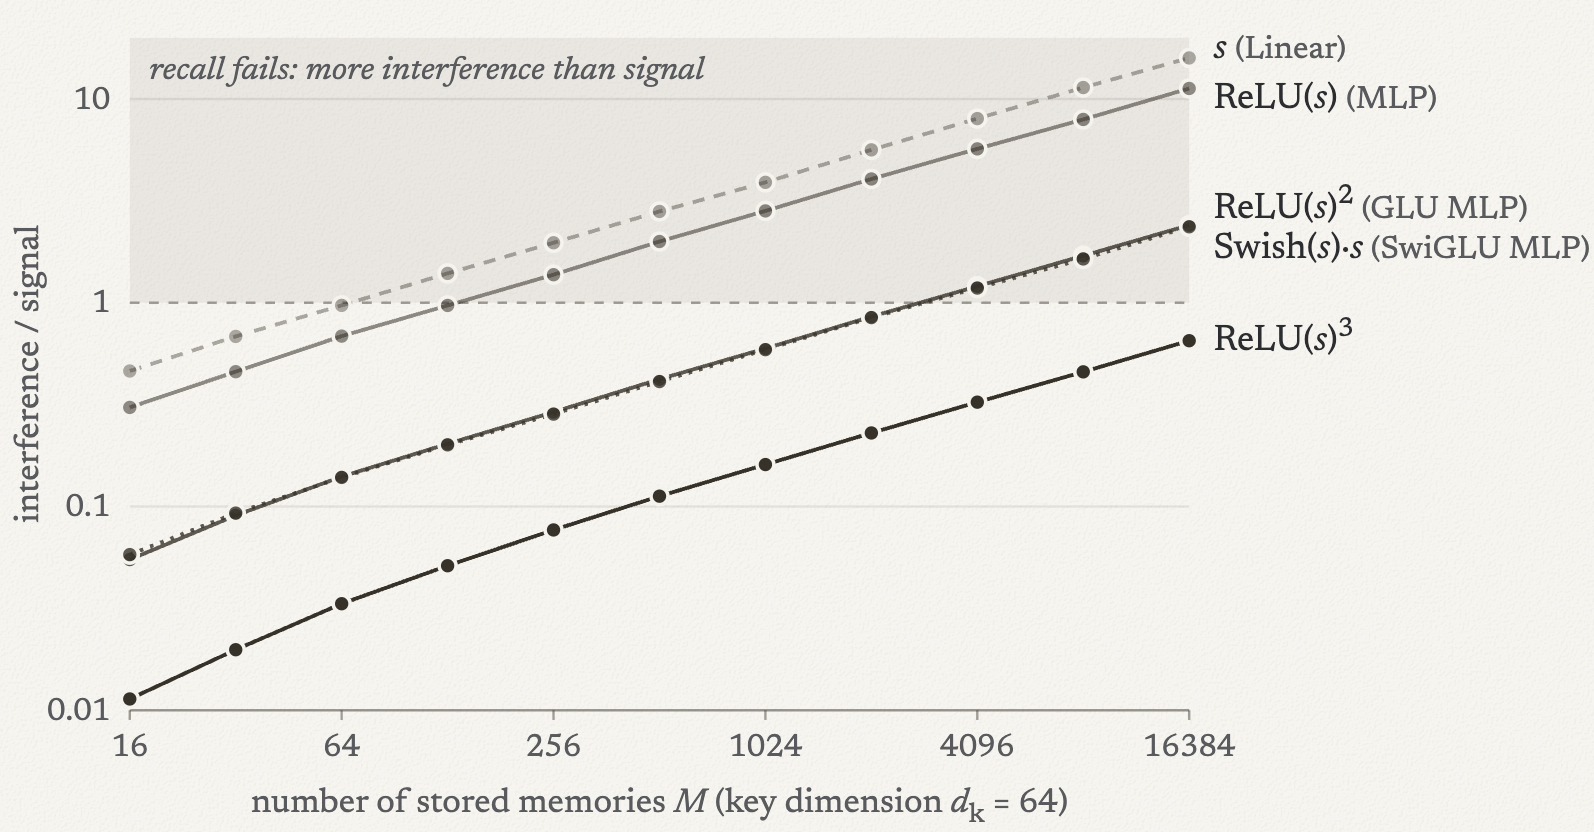
干渉は で増えるため、両対数グラフ上ではこれらの直線はほぼ平行になる。変わるのは高さだけであり、容量もそれに伴って変わる。つまり各直線が 1 と交わる位置だ。
- 線形:容量は 。
- ReLU:負の類似度をゼロにすると干渉が に縮み、容量は まで増える。
- 二乗 ReLU:各干渉項が約 から約 に縮み、容量は まで増える。線形記憶の約 40 倍だ。
- SwiGLU MLP:ゲートと入力投影が重みを共有する点は二乗 ReLU と同じで、。容量は二乗 ReLU とほぼ肩を並べる。
- 三乗 ReLU:各干渉項が約 に縮み、容量は まで増える。
自己注意を非パラメトリックな記憶ストアとして見る
重みをある冪に上げると、容量は約 まで増える。だが、それを極限まで押し上げられるだろうか。ある一つの冪を選ぶ代わりに、無限個の冪を使えばよい。指数関数はもともとすべての冪の重み付き和であり、
ここでシャープネス が高次項の重みを決める。次に、同じ実験を (自己注意で使われる値6)で行い、指数項とその級数をそれぞれ 2 項、3 項、4 項で打ち切る:
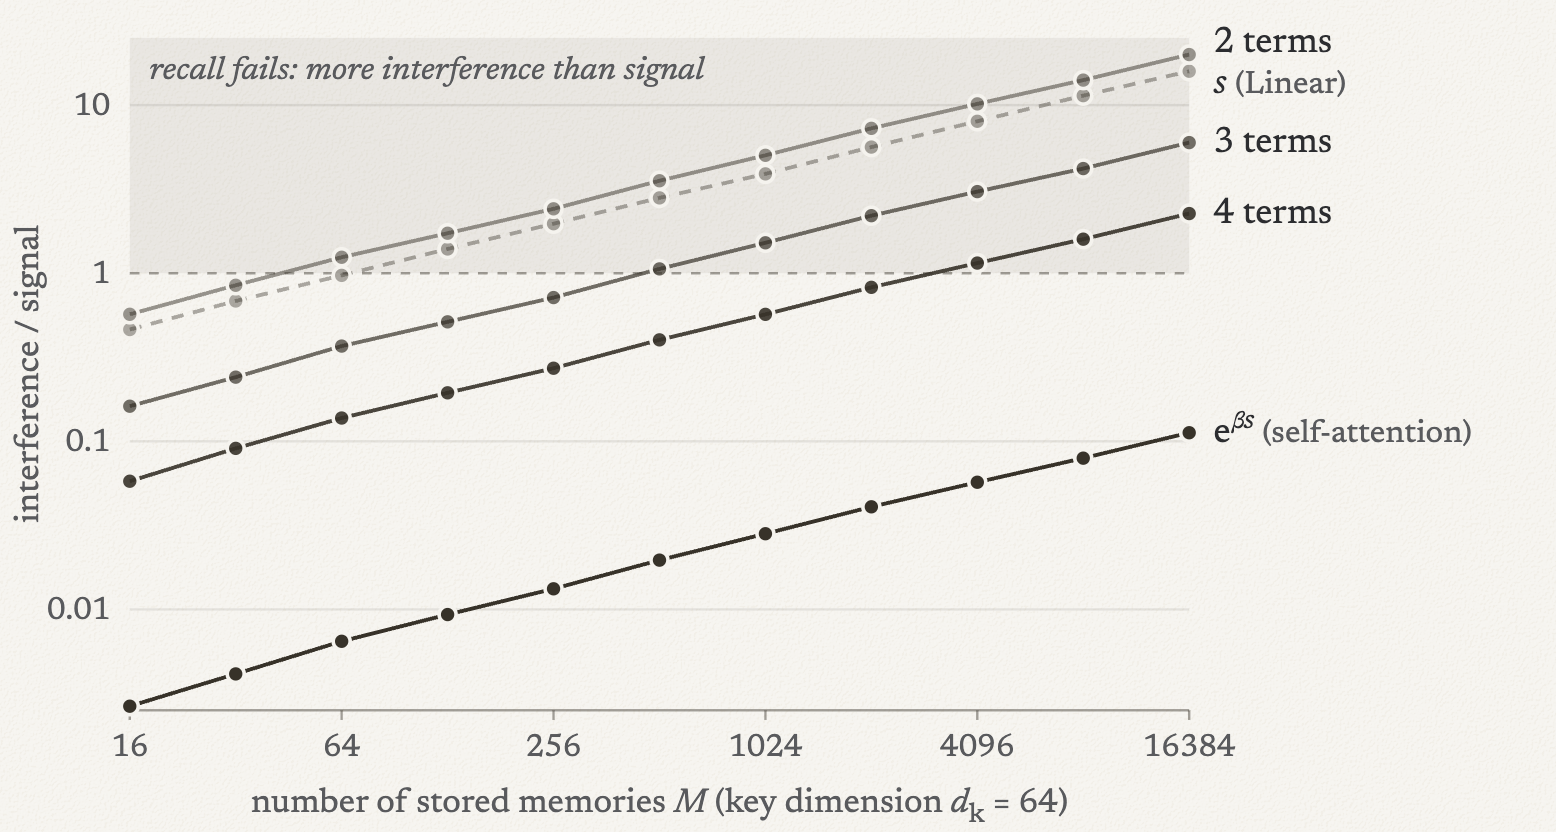
2 項目のときの容量は約 40 で、線形記憶を下回る。定数項のせいでどのキーの重みもおよそ 1 になるからだ。3 項目では約 450、4 項目では約 3,100 となり、二乗 ReLU の水準に近づく。完全な指数形式は破線をはるかに下回るため、その容量はすでにグラフの範囲を超えている。
指数形式の容量を計算するには、格納済みのキー でクエリを出す。このとき対象の記憶との類似度は 1、重みは になる。他の各記憶の重みはすべて で、ランダムな単位キーに対して類似度 は平均 0、分散 のガウス分布にほぼ従う。ランダム値の長さが近いとき、
比率を 1 に設定すると、容量は
が よりはるかに小さければ、容量はこれまでのように に対して多項式的に増えるのではなく、 に対して指数関数的に増える。 では容量は約 万件の記憶となり、線形記憶ストアの約 20,000 倍に達する。同じ実験をより長く走らせると、容量は約 120 万件になる。
実際の実装では、数値をそのまま指数演算するのは避けたいところだ。小数はアンダーフローし、大きな数はオーバーフローするからだ。幸い、上の導出が示すとおり、干渉は重み同士の比だけで決まる。そこで各重みをその総和で割れば、干渉と信号の比を変えずに数値の安定性を確保できる:
これが自己注意だ。7
MLP のキーと値はどちらも学習された重みだが、自己注意は違う。キーと値はコンテキスト内のトークンから計算される。トークンごとに記憶が 1 つあるので、記憶の数 はそのままコンテキスト長になる。自己注意が非パラメトリックである理由はここにある。記憶はパラメータではなく、コンテキストとともに増えるのだ。
もう一度あの棒グラフを見て、softmax から始めよう。 ではスライダーの範囲内で想起が失敗することはない。そこで を 2 に下げ、 を上げてみる。記憶が数十個を超えたあたりから、想起は失敗し始める。 が倍になるたびに、想起を維持するには を少し高くする必要がある。これが次の節で扱う話だ。
長いコンテキストで大量のキーバリューを扱う
は、あまり似ていないキーをどれだけ抑制するかを決める。そのためキーバリューの数が増えるほど、 をそれに合わせて大きくできる。では、なぜ を最初から大きく設定しないのか。 では softmax がハードな argmax に退化し、最も似ているキーだけを選ぶようになって微分できなくなるからだ。しかも が大きすぎるだけで訓練の結果は悪くなる。softmax が飽和すると、他のすべてのキーへの勾配が消えてしまう。だから は が必要とする範囲でだけ大きくする。注意の logits を でスケーリングするのは、長いコンテキストに対処する手法のひとつだ。この種の手法にはいくつかバージョンがあり、いずれも を固定の参照長 (通常は訓練長)に対する値として設定し、 のとき が訓練時の値を保つようにする。
- Su (2021) は「 の増加に伴って注意のエントロピーを一定に保つ」という考えからスケーリング係数 を導出し、 のときに標準の注意と一致するよう正規化した。任意の長さで logits に を掛ける。Scalable-Softmax も形は同じで、logits に を掛ける。ここで は学習可能だ。
- 初期の Qwen モデルは LogN-Scaling を使い、コンテキストが を超えた後になってから同じ係数を適用した。
- Qwen2.5-1M は YaRN の注意スケーリングを使い、logits に を掛ける。したがって に比例して増加する。
私たちの実験では、 件の記憶、 のとき、各ルールの挙動は次のとおりだった。
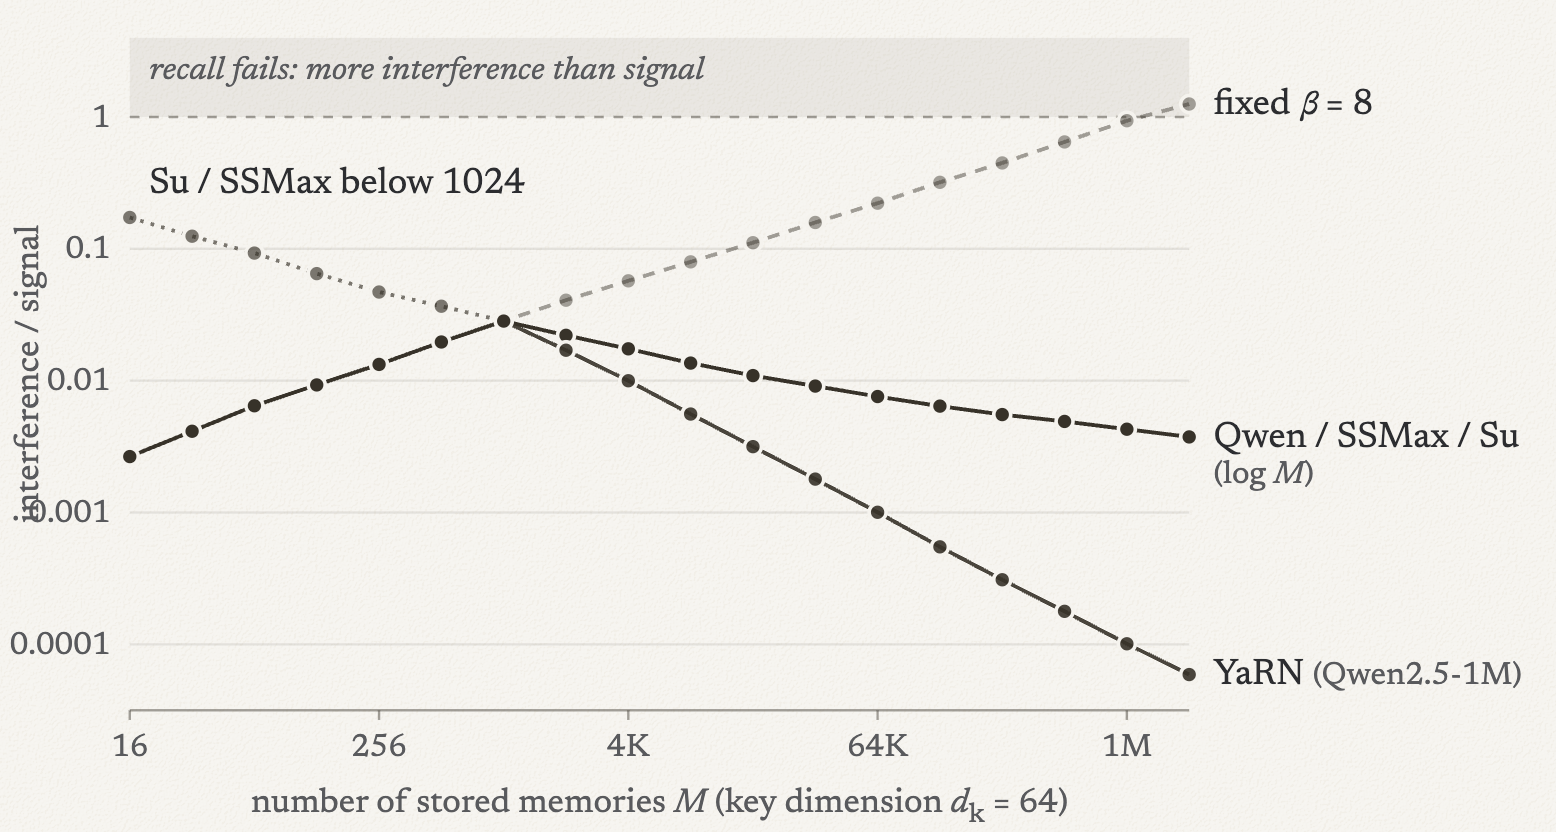
Qwen のルールと Su のルールは参照長 を超えると一致しはじめ、そこでは干渉対信号比が記憶の数とともに下がり、200 万件の記憶では約 0.004 になる。YaRN のスケーリングはより速く成長し、この比を約 まで押し下げる。どちらの場合も、 で をスケーリングすれば、キーがすべて異なる記憶を実質無制限に保存できる。
おわりに
以下は本記事で検討した各種の記憶ストアである。容量の列は、保存済みのキーで問い合わせ、キーと値がともにランダムな場合に対応する。
| 記憶ストア | 容量 | 時の容量 | |
|---|---|---|---|
| 外積 | 64 | ||
| 最適線形 | 128 | ||
| ReLU MLP | 128 | ||
| 二乗 ReLU(GLU MLP) | 約 2,700 | ||
| SwiGLU MLP | 約 | 約 2,900 | |
| 三乗 ReLU | 約 35,000 | ||
| 自己注意、 | 約 120 万 | ||
| 自己注意、 | 実験では上限に達せず | 200 万超 |
ヒューリスティックな記憶ストアである外積記憶から出発し、現在の transformer に見られる標準的な層すべてまで一歩ずつ組み上げてきた。この視点のおかげで、容量の違い、すなわちベクトル値のキー・バリュー記憶ストアとしての能力の差も見積もれる。
ただし、この容量の見積もりは現代のニューラルネットワークアーキテクチャを眺めるひとつの方法にすぎない。数えているのは、干渉が信号を上回る前に 1 層がランダムなベクトルをいくつ想起できるかだけである。実際、訓練データはまったく考慮していない。そしてキーと値が本当に何を表すかを決めるのは、ほかならぬ訓練データだ。訓練後の層を対象に、蓄えられた情報量をビットで測る研究もある。Morris らは GPT 系のモデルがパラメータあたり約 3.6 ビットを記憶していると見積もり、モデルは容量が埋まると汎化を始め、訓練サンプルあたりの記憶が減っていくことを見いだした。Allen-Zhu & Liは、言語モデルがパラメータあたり約 2 ビットの事実的知識を保存しており、int8 に量子化してもそれは変わらないことを示した。
関連する研究方向はほかにも多く、どれも興味深い。
- 1 層がどれだけの情報を保存できるか:Nichani, Lee & Bietti と Barnfield et al. は線形記憶ストアを、Dugan et al. と Garcia et al. は明示的な事実を保存する MLP を論じている。Zhong et al. は本記事の干渉対信号比の見積もりの着想元になった。
- Hopfield ネットワークと、規模に対して容量が指数的に伸びる記憶ストア:Krotov & Hopfield の稠密連想記憶、Demircigil et al.、稠密連想記憶と注意を結びつけた Ramsauer et al.、そして Krotov et al. のサーベイ。
- 推論中に更新される短期記憶:fast weights、Mamba、Mamba-2、DeltaNet、Gated DeltaNet、TTT layers、Titans、MesaNet、test-time regression。
- MLP を補う、あるいは置き換える、巨大だが疎なパラメータ化記憶ストア:product-key memories、Memory Layers at Scale、UltraMem、Mixture of A Million Experts、Engram。
- 重みの外側に記憶を付け足して成長する非パラメータ化記憶ストア:kNN-LM、RETRO、Memorizing Transformers、growing nonparametric networks。
- 訓練済みモデルの中で記憶を特定し編集する:Geva et al.、Bietti et al.、ROME、MEMIT。
- 短期記憶を圧縮する、あるいは長期記憶に変換する:KVzip、gist tokens、Cartridges、attention matching
- 継続学習の手法、たとえば sparse memory finetuning
記憶というテーマにはずっと惹かれている。おそらく、自分の記憶がどれほど限られているかを肌で感じているからだろう。機械がどう記憶するのかを理解すれば、自分自身のことも少しは分かるようになるのではないか——心のどこかでそう願っている部分がある。
Footnotes
-
このキーと値の蓄積は、ときに「Hebbian learning」と呼ばれる。シナプス(重み)の強度が、同時に活性化する(相関した)入力(キー)と出力(値)によって強まるからだ。 ↩
-
線形注意の状態に使われるこの外積による記憶の保存は、fast weights とも呼ばれる。各トークンは を行列に足すことで記憶 を保存し、後続のトークンがその行列を照会する(Katharopoulos et al.;Schlag, Irie & Schmidhuber)。 ↩
-
これはきれいな値ベクトルを思い出すためのものだ。各値が固定された集合の中から正解を指すだけでよい場合、たとえば最も確率の高いトークンを選ぶ場合なら、思い出す側は不正解よりも正解に近ければよい。 の行列でおよそ 個の事実を保持できる(Nichani, Lee & Bietti)。 ↩
-
この回帰の目的関数は、線形注意や自己注意のように、系列モデルが順伝播の途中で書き込む短期記憶の設計にも使える。詳しくは私の test-time regression に関する研究を参照。 ↩
-
キーがランダムなら、ReLU は干渉を 分の 1 に縮める。ランダムなキーの類似度は正と負が同じ確率で現れるので、ReLU はおよそ半分の重みをゼロにし、残りはそのままにする。これで干渉の分散(重みの二乗和)が半分になり、干渉自体が 分の 1 になる。導出の全体は Zhong et al. にある。 ↩
-
Transformer は類似度を で割るのであって、掛けるのではない。ただしクエリとキーの長さはおよそ なので、一致したクエリとキーの組の類似度は になる。こちらのキーとクエリは単位長で、一致した組の類似度は 1 だ。だから でスケールする。 ↩
-
Transformer の記法では、類似度は (ただし )で、これを でスケールする。私は をキーに畳み込んだ。Transformer ではキーとクエリの長さがおよそ なので、こちらのようにキーが単位長であれば、このスケーリングはちょうど に対応する。 ↩